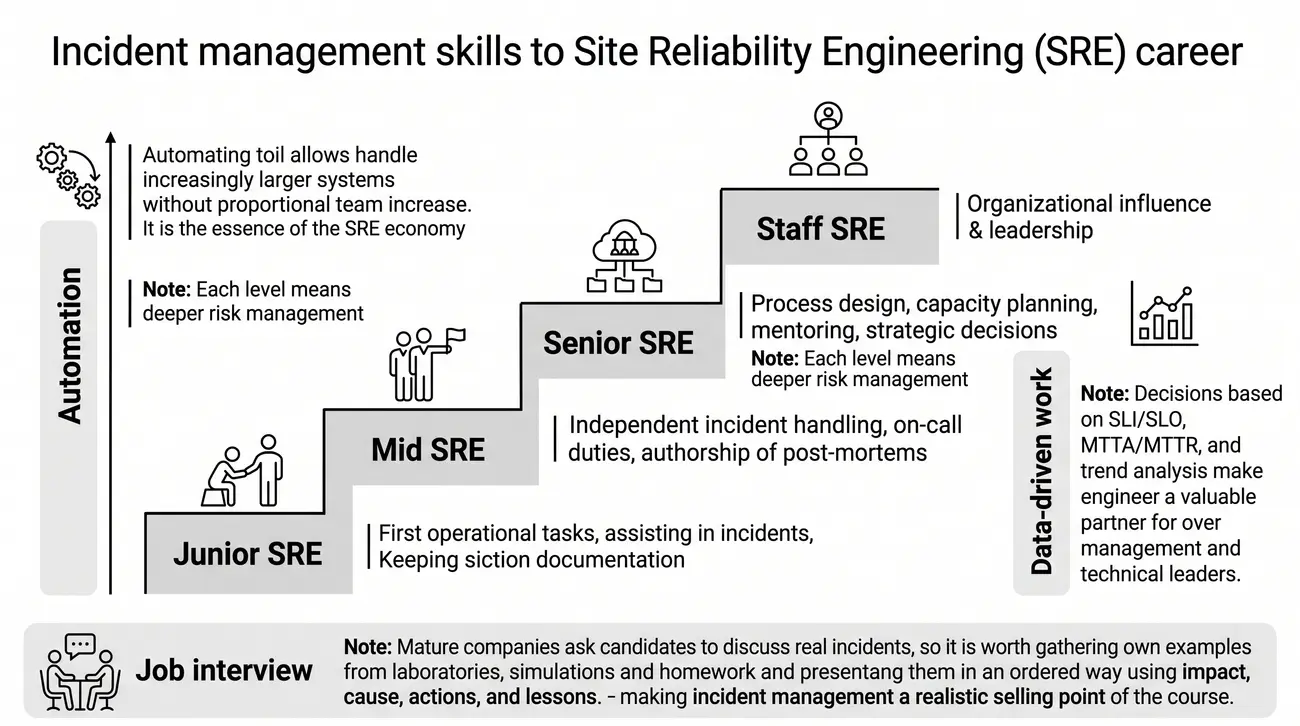
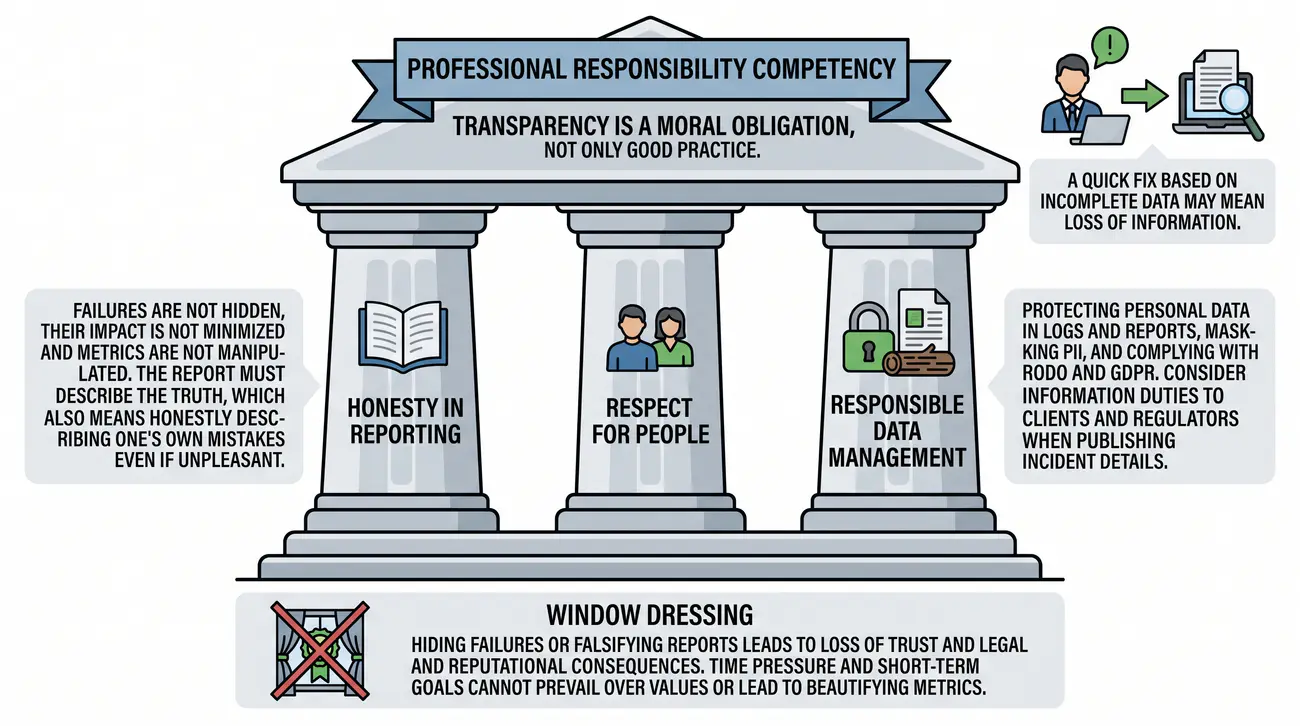
1/55 Zarządzanie incydentem
Zarządzanie incydentem: Pełny cykl obsługi awarii: Detection → Response → Diagnosis → Recovery → Verification → Documentation. Kluczowe elementy: blameless post-mortem, Root Cause Analysis (RCA), action items z owner/due date. Celem nie jest unikanie awarii, lecz szybkie i skuteczne reagowanie.

Awaria to nie koniec świata, lecz procedura: wykryj, zareaguj, zdiagnozuj, przywróć, zweryfikuj i udokumentuj.

  • Cykl zarządzania incydentem – obejmuje uporządkowany proces od wykrycia awarii przez mitygację aż po dogłębną analizę post-mortem.
  • Kultura bez obwiniania – podejście blameless skupia się na faktach i wadach procesowych, eliminując szukanie winnych w zespole.
  • Analiza przyczyn źródłowych – metody dochodzenia RCA pozwalają dotrzeć do sedna awarii i wdrożyć trwałe zabezpieczenia systemowe.
  • Wskaźniki czasu reakcji – metryki MTTD, MTTA oraz MTTR mierzą obiektywną sprawność organizacji w opanowywaniu zakłóceń usług.
  • Zwieńczenie inżynierii SRE – profesjonalna obsługa awarii łączy wiedzę o telemetrii, wysokiej dostępności i procedurach dyżurów.
Action items z owner/due date: Działania z właścicielem i terminem; celem zarządzania incydentem nie unikanie awarii, lecz szybkie reagowanie (blameless, RCA).
proces
Zarządzanie incydentem w ujęciu SRE: W tradycyjnych firmach awaria wywołuje panikę, wzajemne obwinianie i gorączkowe próby naprawy „na żywej produkcji”. W filozofii SRE incydent to po prostu kolejny proces inżynieryjny: powołujemy dowódcę (Incident Commander), tworzymy odizolowany kanał na czacie, najpierw mitigujemy (przywracamy działanie, np. rollbackiem), a dopiero po powrocie spokoju badamy przyczyny w ramach bezwzględnie bezkarnego raportu Blameless Post-mortem.

Zarządzanie incydentem to jeden z najważniejszych obszarów kompetencji inżyniera SRE: niezawodność usług nie polega na absolutnym unikaniu awarii, lecz na umiejętności szybkiego i skutecznego reagowania, gdy już wystąpią. W modelu SRE incydent nie jest porażką, lecz naturalną konsekwencją działania złożonych systemów rozproszonych; kluczowe jest wyciągnięcie wniosków i zapobieganie powtórzeniu. Zarządzanie incydentem obejmuje cały cykl - od wykrycia, przez reakcję i diagnozę, po dokumentację i analizę przyczyn źródłowych (RCA) - a profesjonalne zespoły SRE przekształcają nieuniknione awarie w trwałe ulepszenia systemowe.

Proces incydentu w modelu SRE to uporządkowany cykl, który rozpoczyna się od wykrycia (detection) - może to być alert z systemu monitoringu, zgłoszenie użytkownika lub automatyczne wykrycie anomalii w metrykach. Kolejnym etapem jest reakcja (response), obejmująca triage (ocenę priorytetu), powiadomienie odpowiedniego zespołu i uruchomienie procedury eskalacji. Po opanowaniu sytuacji następuje diagnoza (diagnosis), w której inżynierowie analizują metryki, logi i trasy (traces), aby zidentyfikować przyczynę problemu. Usunięcie (mitigation/recovery) może oznaczać rollback, restart usług, przełączenie na kopię zapasową lub tymczasowe obejście problemu. Weryfikacja (verification) potwierdza, że usługa działa poprawnie, a dokumentacja (documentation) i analiza przyczyn źródłowych (Root Cause Analysis) domykają cykl. Każdy z tych etapów omówimy szczegółowo na kolejnych slajdach.

Post-mortem to raport tworzony po zakończeniu incydentu, który podsumowuje przebieg zdarzenia, identyfikuje przyczyny źródłowe i proponuje działania zapobiegawcze. W filozofii SRE post-mortem musi być blameless - oznacza to, że celem dokumentu nie jest wskazanie winnych, lecz zrozumienie, w jaki sposób systemy, procesy i procedury zawiodły. Dopiero gdy zespół czuje się bezpiecznie i nie obawia się sankcji, może otwarcie dzielić się informacjami niezbędnymi do przeprowadzenia rzetelnej analizy. Post-mortem jest jednocześnie narzędziem edukacyjnym dla całej organizacji - jego lektura pozwala innym zespołom uczyć się na cudzych błędach bez konieczności ich powtarzania. W kolejnych slajdach poznamy strukturę raportu post-mortem, techniki RCA oraz kulturę blameless, która stanowi fundament skutecznego zarządzania incydentami w nowoczesnych organizacjach SRE.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina inżynierska traktująca zarządzanie awariami jako systemowy proces ciągłego doskonalenia usług.
ITIL – Information Technology Infrastructure Library – biblioteka infrastruktury IT; Zbiór powszechnie stosowanych praktyk w zakresie zarządzania usługami teleinformatycznymi.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; Prawny kontrakt biznesowy określający dopuszczalne czasy przestoju i kary za ich przekroczenie.
SLO – Service Level Objective – cel poziomu usług; Wewnętrzny wskaźnik inżynierski, którego naruszenie definiuje zaistnienie poważnego incydentu.
MTTR – Mean Time To Recover – średni czas przywrócenia sprawności; Kluczowy parametr sprawności zespołu SRE mierzony od wystąpienia usterki do wznowienia poprawnej obsługi ruchu.

2/55 Co to jest incydent
Incydent vs outage vs degradation: Incydent to nieplanowane zakłócenie usługi wpływające na użytkowników. Outage = całkowita niedostępność (zero odpowiedzi). Degradation = pogorszenie jakości (wolniejsze strony, timeouty, błędy częściowe). Kluczowe kryterium: naruszenie SLO lub zagrożenie error budget.

Incydent, outage i degradacja to trzy poziomy tego samego: coś działa gorzej, niż powinno. Kryterium: SLO i error budget.

  • Definicja incydentu IT – incydent to nieplanowane zakłócenie lub spadek jakości usługi, który realnie wpływa na komfort użytkowników.
  • Całkowita awaria Outage – oznacza pełną niedostępność kluczowych funkcji biznesowych i wymaga natychmiastowej mobilizacji sztabu.
  • Stan degradacji Degradation – polega na spowolnionym działaniu serwisu lub błędach u części klientów przy pozornej pracy platformy.
  • Kryteria oceny skutków – wpływ awarii ocenia się w wymiarach dostępności, wydajności, spójności danych oraz bezpieczeństwa sieci.
  • Zagrożenie celów SLO – z punktu widzenia inżynierii SRE incydentem jest każde zjawisko, które zagraża dotrzymaniu obietnic jakościowych.
Kryterium incydentu: Naruszenie SLO lub zagrożenie budżetu błędów; outage to zero odpowiedzi, degradacja to pogorszenie jakości.
incydent

Zgodnie z międzynarodową normą PN-EN ISO/IEC 20000-1 oraz biblioteką ITIL 4 obowiązuje ścisła taksonomia zdarzeń operacyjnych:
- Incydent: nieplanowane przerwanie lub pogorszenie jakości świadczonej usługi teleinformatycznej, wymagające natychmiastowego przywrócenia sprawności,
- Problem: nieznana, pierwotna przyczyna wystąpienia jednego lub wielu incydentów, podlegająca systematycznej analizie w ramach Problem Management,
- Żądanie usługi (Service Request): formalna prośba użytkownika o standardowe świadczenie (np. reset hasła, nadanie uprawnień, utworzenie maszyny testowej).

Incydent to zdarzenie zakłócające normalne działanie usługi i mające negatywny wpływ na użytkowników lub wewnętrzne procesy biznesowe; nie każde niepożądane zdarzenie jest incydentem w rozumieniu SRE - kluczowym kryterium jest wpływ na użytkowników oraz naruszenie uzgodnionych poziomów jakości usługi (SLO/SLI). Jeśli żadne SLO nie zostało naruszone i użytkownicy nie odczuwają problemu, zdarzenie kwalifikuje się jako błąd wymagający naprawy, a nie incydent uruchamiający pełną procedurę awaryjną; fundamentalne pytanie brzmi "czy nasz klient odczuwa skutki tego zdarzenia oraz czy naruszony został error budget?".

Precyzyjna terminologia angielska pozwala zespołowi SRE jednoznacznie opisać skalę i typ problemu, co jest kluczowe w komunikacji wewnętrznej oraz z klientami. Incident to ogólne określenie każdego nieplanowanego zdarzenia zakłócającego działanie usługi - może nim być zarówno awaria bazy danych, jak i zakłócenie sieciowe. Outage oznacza całkowitą niedostępność usługi - użytkownicy w ogóle nie mogą korzystać z funkcjonalności, co jest najbardziej krytyczną formą incydentu. Degradation (degradation) to pogorszenie jakości usługi, przy której usługa działa, ale funkcjonuje gorzej niż zwykle - przykładowo strony ładują się znacznie wolniej, część funkcji jest niedostępna lub występują okresowe błędy. Odpowiednie rozróżnienie tych terminów pozwala zespołowi szybko ocenić wagę sytuacji i ustawić priorytety, a także informować klientów w sposób jasny i precyzyjny. W praktyce zespoły często operują również pojęciami takimi jak partial outage (częściowa awaria), affecting subset of users lub blast radius opisującym obszar oddziaływania awarii.

Podczas klasyfikacji incydentu kluczowe jest również określenie wpływu (impact) na cztery podstawowe wymiary: dostępność usługi, wydajność, integralność danych oraz bezpieczeństwo. Utrata danych lub naruszenie bezpieczeństwa mają zwykle znacznie poważniejsze konsekwencje niż krótkotrwała niedostępność, dlatego zmieniają również sposób prowadzenia incydentu. Właściwa diagnoza typu incydentu jest pierwszym krokiem dobrego triage i decyduje o tym, jakie zasoby zostaną zaangażowane oraz jak szybko zostanie zorganizowana reakcja. Terminologia: incident (incydent), outage (całkowita niedostępność), degradation (degradacja, pogorszenie jakości), impact (wpływ), error budget (budżet błędów).

Wyjaśnienie skrótów użytych na slajdzie:
ITIL – Information Technology Infrastructure Library – metodyka ITIL; Standard operacyjny definiujący incydent jako nieplanowane przerwanie lub pogorszenie jakości usługi.
SLA – Service Level Agreement – umowa o poziomie usług; Formalne zobowiązanie wobec klientów podlegające ochronie w trakcie trwania incydentu.
SLO – Service Level Objective – cel jakościowy usługi; Punkt odniesienia pozwalający obiektywnie stwierdzić czy dane odchylenie metryki stanowi incydent.
SLI – Service Level Indicator – wskaźnik poziomu usług; Empiryczny pomiar jakości usługi (np. odsetek odpowiedzi poprawnych) w czasie rzeczywistym.
KPI – Key Performance Indicator – kluczowy wskaźnik efektywności; Syntetyczny miernik działalności operacyjnej podsumowujący stabilność systemów w organizacji.

3/55 Różnica: incydent, problem, żądanie
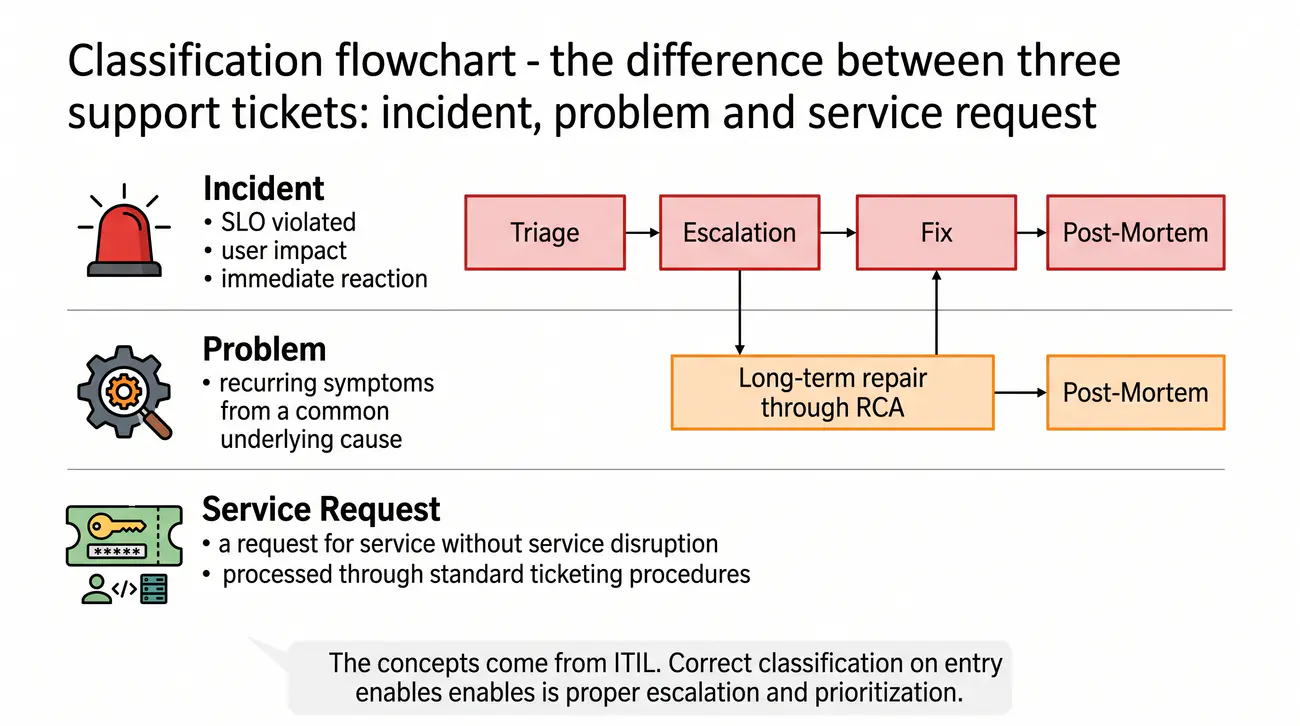
Trzy kategorie zgłoszeń (ITIL/SRE): Incydent = nieplanowane przerwanie usługi (wymaga natychmiastowej reakcji). Problem = ukryta przyczyna źródłowa generująca wiele incydentów (długoterminowa naprawa). Żądanie (service request) = prośba o usługę bez zakłócenia ciągłości (hasło, konto, środowisko).

Trzy szufladki zgłoszeń: incydent (ratuj teraz), problem (napraw przyczynę) i żądanie (zwykła prośba). Nie myl ich.

  • Obsługa incydentu Incident – w metodykach ITIL oraz SRE wymaga natychmiastowej akcji w celu jak najszybszego przywrócenia usług.
  • Natura problemu Problem – pojęcie odnosi się do ukrytej, głębszej wady architektury wywołującej powtarzające się serie awarii w systemie.
  • Standardowe żądanie Request – to rutynowa prośba użytkownika, na przykład o uprawnienia, niewynikająca z żadnej awarii technicznej.
  • Klasyfikacja zgłoszeń – właściwe rozróżnienie pojęć decyduje o doborze procedury i chroni inżynierów przed chaosem organizacyjnym.
  • Redukcja żmudnej pracy Toil – zespoły SRE skupiają się na incydentach łamiących cele SLO i trwałym usuwaniu problemów z architektury.
Problem (ITIL/SRE): Ukryta przyczyna źródłowa wielu incydentów do długoterminowej naprawy; obok incydentu (natychmiast) i żądania (bez zakłócenia).
klasy

W taksonomii ITIL 4 i normie ISO/IEC 20000-1 incydent wymaga natychmiastowej mitygacji (przywrócenia działania), problem wymaga analizy przyczyn źródłowych (Problem Management), natomiast żądanie usługi jest standardową procedurą operacyjną.

Trzy kategorie zgłoszeń obsługiwanych przez zespoły operacyjne - incydent (incident), problem (problem) i żądanie (service request) - wymagają różnych procesów, narzędzi i poziomów priorytetu; w ramach ITIL lub metodyk zwinnych poprawne sklasyfikowanie zgłoszenia na wejściu decyduje o tym, czy trafi ono do właściwego zespołu sprawnie i czy zostanie obsłużone zgodnie z procedurą. Mylenie tych kategorii prowadzi do chaosu, straconego czasu, niezadowolenia użytkowników i negatywnie wpływa na metryki wydajności zespołu operacyjnego.

Incydent (incident) to nieplanowane przerwanie działania usługi, które narusza SLO i wpływa na użytkowników - wymaga on natychmiastowej reakcji i dorozumianego priorytetu. Problem (problem) oznacza natomiast ukrytą, jeszcze niezidentyfikowaną przyczynę źródłową, która może generować jeden lub wiele incydentów. Klasycznym przykładem problemu jest wolny zapis na dyskach w klastrze bazy danych: dopóki tego nie naprawimy, pojawiać się będą kolejne incydenty, takie jak time outy zapytań czy restarty węzłów. Zarządzanie problemem to proces długoterminowy, realizowany między innymi właśnie przez analizę przyczyn źródłowych (RCA) i tworzenie post-mortem. Żądanie (service request) to natomiast zwykła prośba o pomoc lub zmianę - na przykład odzyskanie hasła, utworzenie konta, instalacja oprogramowania czy przygotowanie środowiska testowego. Żądania nie są awariami; realizowane są zgodnie z ustalonymi procedurami i poziomami usług, często przez dedykowany system biletowy (ticketing) lub samoobsługowy portal.

W praktyce zespoły SRE stosują jasne kryteria klasyfikacji zgłoszeń, aby uniknąć niejednoznaczności. Zgłoszenie kwalifikujemy jako incydent, gdy są naruszone lub zagrożone SLO i występuje wpływ na użytkowników; jako problem, gdy obserwujemy powtarzające się symptomy sugerujące wspólną przyczynę źródłową; jako żądanie, gdy użytkownik prosi o standardową usługę lub zmianę bez zakłócenia ciągłości działania. Poprawne rozróżnienie tych kategorii ułatwia priorytetyzację pracy, poprawną eskalację, dokładne metryki oraz - co najważniejsze - skierowanie zasobów tam, gdzie są one najbardziej potrzebne. Terminologia: incident, problem, service request, incident vs problem, ITIL (Information Technology Infrastructure Library).

Wyjaśnienie skrótów użytych na slajdzie:
ITIL – Information Technology Infrastructure Library – biblioteka dobrych praktyk ITIL; Metodyka wyznaczająca formalne granice pomiędzy incydentami, problemami i wnioskami o zmianę.
CAB – Change Advisory Board – komitet doradczy ds. zmian; Organ oceniający ryzyko wprowadzania trwałych poprawek poawaryjnych do systemów produkcyjnych.
RFC – Request for Change – wniosek o zmianę; Formalny dokument w procedurze ITIL rejestrujący planowaną modyfikację architektury w celu eliminacji problemu.
CMDB – Configuration Management Database – baza danych zarządzania konfiguracją; Centralne repozytorium informacji o elementach infrastruktury i relacjach między nimi.
KEDB – Known Error Database – baza znanych błędów; Repozytorium wiedzy zawierające udokumentowane obejścia awaryjne dla zidentyfikowanych problemów.

4/55 Poziomy ważności (severity)
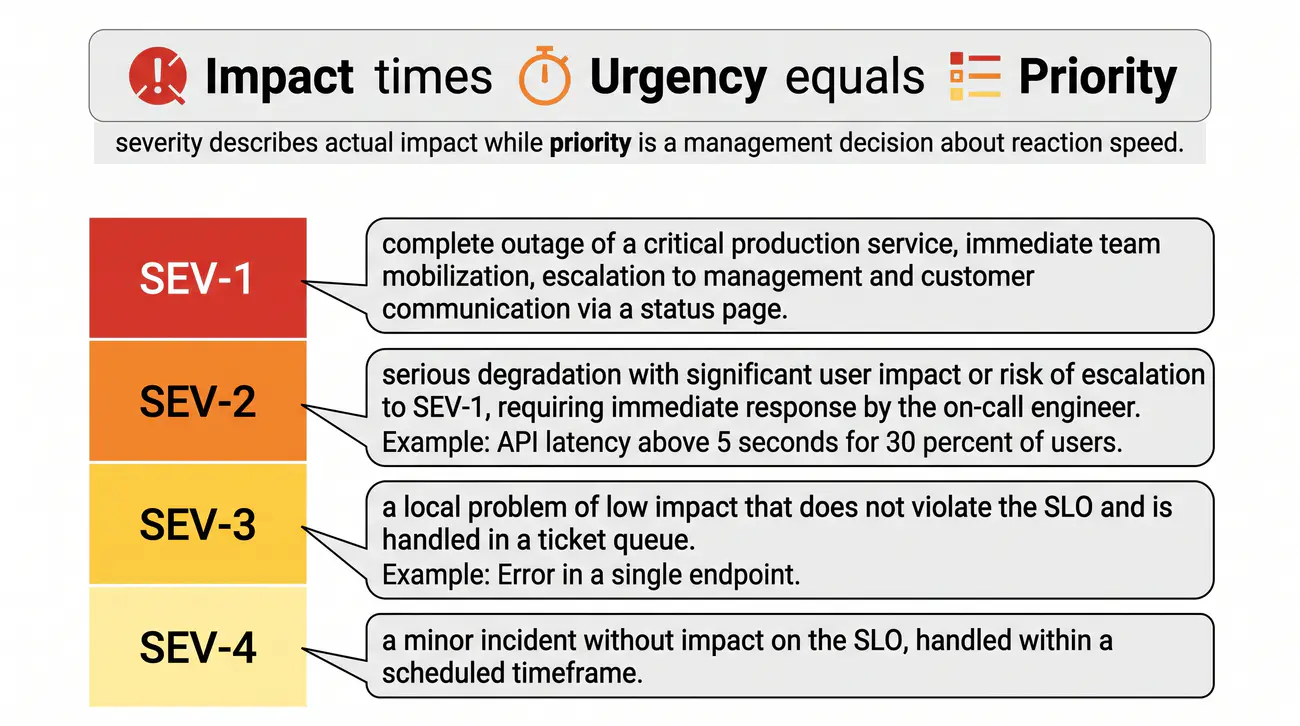
Severity (SEV-1 do SEV-4): Severity = faktyczny wpływ awarii na usługę (impact). Priority = decyzja zarządcza o szybkości reakcji. Severity × urgency = priorytet. SEV-1: całkowity outage kluczowej usługi → natychmiastowa eskalacja. SEV-4: lokalny problem niskiego wpływu → kolejka zgłoszeń.

Severity to wpływ, priority to decyzja. SEV-1 budzi wszystkich, SEV-4 czeka w kolejce. Zależność: wpływ × pilność.

  • Skala ważności Severity – stopień istotności określa rzeczywisty wpływ awarii na biznes i wyznacza tempo reakcji zespołów technicznych.
  • Poziom krytyczny Sev-1 – oznacza paraliż newralgicznych funkcji biznesowych i wymaga natychmiastowego zwołania całego sztabu kryzysowego.
  • Poziom wysoki Sev-2 – sygnalizuje poważne obniżenie wydajności lub utratę redundancji, wymagając pilnej interwencji inżynierów dyżurnych.
  • Poziomy Sev-3 oraz Sev-4 – dotyczą drobnych usterek lokalnych lub wad kosmetycznych i są rozwiązywane w standardowych godzinach pracy.
  • Obiektywne kryteria oceny – przypisanie wagi musi wynikać z twardych zapisów w regulaminie, eliminując kłótnie w trakcie trwania awarii.
Severity kontra priority: Severity to faktyczny wpływ (SEV-1: outage kluczowej usługi → eskalacja; SEV-4: lokalny problem → kolejka), priority to decyzja o tempie reakcji.
skala

Klasyfikacja incydentów opiera się na obiektywnej matrycy wpływu biznesowego (Impact) oraz pilności (Urgency):
- Sev1 / P1 (Krytyczny): całkowita niedostępność krytycznej usługi dla klientów zewnętrznych, brak obejścia awaryjnego (Workaround), natychmiastowe zaangażowanie dowódcy incydentu i dyżurnych SRE w trybie 24/7,
- Sev2 / P2 (Poważny): istotna degradacja wydajności lub niedostępność ważnego podsystemu dla znacznej grupy użytkowników przy istnieniu ograniczonego obejścia,
- Sev3 / P3 (Umiarkowany): częściowa usterka nieblokująca kluczowych procesów biznesowych,
- Sev4 / P4 (Niski): drobna wada kosmetyczna lub marginalny błąd niemający wpływu na realizację celów SLO.

Poziomy ważności incydentu - severity (dotkliwość, poziom krytyczności) - decydują o kolejności i intensywności reakcji zespołów operacyjnych, a severity odróżnia się od priorytetu (priority): severity opisuje faktyczny wpływ awarii na usługę i jej użytkowników, natomiast priority to decyzja zarządcza o tym, jak szybko i z jakim zaangażowaniem reagować. Związek jest złożony - wysoka severity nie musi automatycznie oznaczać najwyższego priorytetu, gdy np. awaria w nocy dotyka bardzo małej grupy użytkowników; właściwe zrozumienie relacji severity, impact i urgency stanowi podstawę skutecznego triage.

Severity klasyfikujemy najczęściej w kilku stopniach, na przykład od SEV-1 (incydent krytyczny) do SEV-4 (incydent niskiej ważności). Incydent krytyczny (SEV-1) to całkowita niedostępność kluczowej usługi produkcyjnej (outage) lub poważne naruszenie danych - wymaga natychmiastowej mobilizacji zespołu, niezwłocznej eskalacji do kierownictwa i zwykle także komunikacji z klientami. SEV-2 oznacza poważną degradację działającej usługi z istotnym wpływem na użytkowników lub ryzyko eskalacji do SEV-1 - reakcja musi nastąpić natychmiast, często w ramach dyżuru (on-call). SEV-3 i SEV-4 to problemy o niskim lub lokalnym wpływie, które nie naruszają SLO i można je obsłużyć w kolejce zgłoszeń w wyznaczonym czasie. Kluczowe jest, aby definicje poziomów były jednoznaczne i udokumentowane, ponieważ subiektywna ocena „czy to jest poważne?” wywołuje opóźnienia w eskalacji i niepotrzebne alarmy.

W praktyce poziom severity (impact) w incydencie oceniamy na podstawie procentu użytkowników dotkniętych awarią, czasu trwania degradacji oraz wpływu na przychody i przepisy prawne. Urgency (pilność) określa natomiast, jak szybko trzeba podjąć działanie - zależy od marginesu czasowego, w jakim można zapobiec dalszemu pogorszeniu sytuacji. W dojrzałych organizacjach przyjęte są szablony klasyfikacji, na przykład: SEV-1 = dostępność usług poniżej SLO + wpływ na przychody lub bezpieczeństwo, SEV-2 = degradacja dla ponad X% użytkowników. Dobrze zaprojektowany system klasyfikacji incydentów skraca czas eskalacji, zmniejsza stres zespołu dyżurnego i zapewnia zgodność oczekiwań z interesariuszami biznesowymi. Terminologia: severity (dotkliwość), impact (wpływ), urgency (pilność), priority (priorytet), escalation (eskalacja), SEV-1/SEV-2.

Wyjaśnienie skrótów użytych na slajdzie:
P1 – Priority 1 Incident – incydent o priorytecie pierwszym (krytycznym); Najwyższy stopień zagrożenia oznaczający całkowity paraliż kluczowej usługi biznesowej.
P2 – Priority 2 Incident – incydent o priorytecie drugim (poważnym); Poważne zakłócenie funkcji systemu dotykające znaczną grupę użytkowników przy braku pełnego przestoju.
P3 – Priority 3 Incident – incydent o priorytecie trzecim (umiarkowanym); Usterka o ograniczonym zasięgu niepowodująca krytycznych strat biznesowych dla organizacji.
P4 – Priority 4 Incident – incydent o priorytecie czwartym (niskim); Drobny defekt lub usterka estetyczna rozwiązywana w standardowym toku prac zespołu.
Sev1 – Severity 1 Outage – awaria stopnia 1; Alternatywne nazewnictwo incydentu krytycznego powszechnie stosowane w międzynarodowych korporacjach technologicznych.

5/55 Cykl zarządzania incydentem
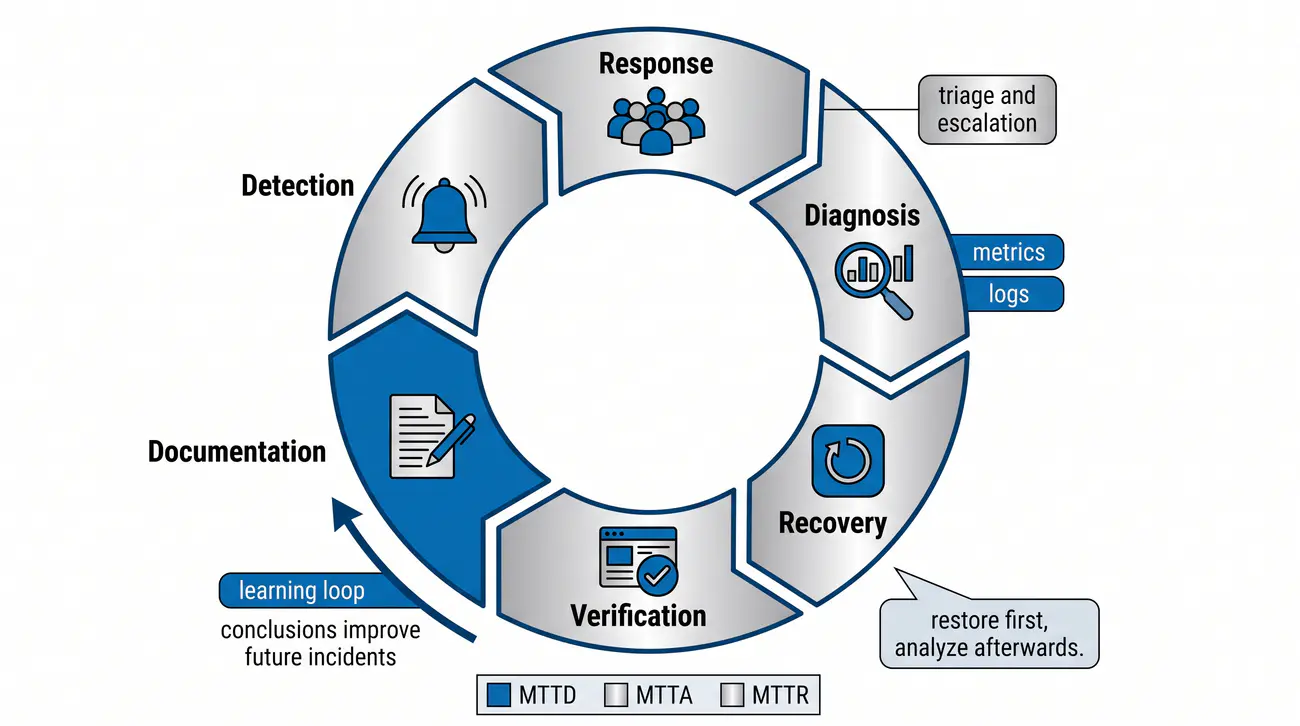
Incident Lifecycle (6 faz): Detection → Response (triage + eskalacja) → Diagnosis (metryki + logi) → Recovery (mitigation/rollback) → Verification (testy + SLO check) → Documentation (timeline + RCA + post-mortem). Zamknięta pętla: dokumentacja i wnioski poprawiają jakość kolejnych incydentów.

Sześć faz od alertu do nauki: wykryj, zareaguj, zdiagnozuj, przywróć, zweryfikuj i udokumentuj. Pętla się zamyka.

  • Sześć faz obsługi awarii – cykl życia incydentu obejmuje wykrycie, wstępną reakcję, diagnozę, mitygację, weryfikację i dokumentację.
  • Automatyczna detekcja – faza wykrycia polega na zarejestrowaniu anomalii przez sondy monitoringu zanim zgłoszenia nadejdą od klientów.
  • Uruchomienie sztabu kryzysowego – w fazie reakcji ustala się priorytet incydentu i otwiera wydzielony kanał łączności dla uczestników akcji.
  • Złota zasada mitygacji – nakazuje w pierwszej kolejności przywrócić działanie serwisu użytkownikom, a dopiero potem dociekać przyczyn.
  • Etap formalnego domknięcia – po opanowaniu sytuacji sporządza się raport post-mortem w celu wyciągnięcia trwałych wniosków na przyszłość.
Zamknięta pętla: Dokumentacja i wnioski poprawiają kolejne incydenty; 6 faz: detection → response → diagnosis → recovery → verification → documentation.
cykl

Pełny cykl zarządzania incydentem (incident lifecycle) porządkuje end-to-end obsługę awarii w zespołach SRE jako zamkniętą pętlę (loop) - ostatni etap, dokumentacja i wnioski, poprawia jakość wszystkich wcześniejszych etapów przy kolejnych incydentach. Sześć faz to wykrycie (detection), eskalacja/reakcja (response), diagnoza (diagnosis), usunięcie (mitigation/recovery), weryfikacja (verification) oraz dokumentacja i nauka (documentation & learning); każda faza ma swoich właścicieli, kryteria wejścia i wyjścia oraz typowe narzędzia. Zrozumienie cyklu jako całości jest ważniejsze niż znajomość poszczególnych faz - o jakości procesu decyduje ciągłość i brak luk między etapami.

Pierwsza część cyklu - detection, response, recovery - odpowiada za ograniczenie wpływu awarii na użytkowników w czasie rzeczywistym. Detection polega na wykryciu, że coś jest nie tak, za pomocą monitoringu, alertingu lub zgłoszeń użytkowników. Response to natychmiastowa reakcja: triage, powiadomienie zespołu, zebranie podstawowych informacji i decyzja o eskalacji. Recovery to przywrócenie usługi do pełnej sprawności, często w trybie tymczasowym (mitigation). W tej fazie obowiązuje zasada „przywracaj najpierw, analizuj potem” - priorytetem jest ograniczenie wpływu na użytkowników, a dopiero później pełne zrozumienie przyczyn. Każda minuta zwłoki w tych etapach przekłada się bezpośrednio na utracone przychody, niezadowolonych klientów i pogłębiające się szkody wizerunkowe.

Druga część cyklu obejmuje weryfikację i dokumentację, które domykają proces i dostarczają materiału do nauki organizacji. Verification potwierdza, że usługa działa zgodnie z oczekiwaniami - najlepiej przez monitorowanie metryk powiązanych ze SLO, ponieważ subiektywna ocena „wszystko działa” może być myląca. Documentation polega na zapisaniu osi czasu (timeline), decyzji, akcji i ich skutków, a także na przeprowadzeniu analizy przyczyn źródłowych (RCA). Raport post-mortem powstający na tej podstawie opisuje nie tylko to, co się stało, ale przede wszystkim co zrobimy, aby zapobiec powtórce. W tym sensie cykl zarządzania incydentem nie kończy się bynajmniej na usunięciu awarii - kończy się dopiero wtedy, gdy wnioski zostaną wdrożone (action items) i poprawi się jakość monitoringu, architektury i procesów. Terminologia: incident lifecycle, detection, response (reakcja), recovery (przywrócenie), verification (weryfikacja), timeline (oś czasu).

Wyjaśnienie skrótów użytych na slajdzie:
MTTD – Mean Time To Detect – średni czas wykrycia incydentu; Czas od zaistnienia anomalii w systemie do jej rejestracji przez automatyczny system monitoringu.
MTTA – Mean Time To Acknowledge – średni czas potwierdzenia wezwania; Czas od wygenerowania alertu do formalnego potwierdzenia podjęcia działań przez inżyniera.
MTTM – Mean Time To Mitigate – średni czas mitygacji usterki; Czas potrzebny na przywrócenie sprawności usługi dla użytkownika za pomocą obejścia lub rollbacku.
MTTR – Mean Time To Recover – średni czas pełnej naprawy; Całkowity czas liczony do trwałego wyeliminowania defektu i wdrożenia docelowej poprawki.
Post-mortem – Post-mortem Retrospective – retrospektywa poawaryjna; Końcowy etap cyklu życia incydentu poświęcony wyciągnięciu wniosków i wdrożeniu usprawnień.

6/55 Wykrywanie incydentu
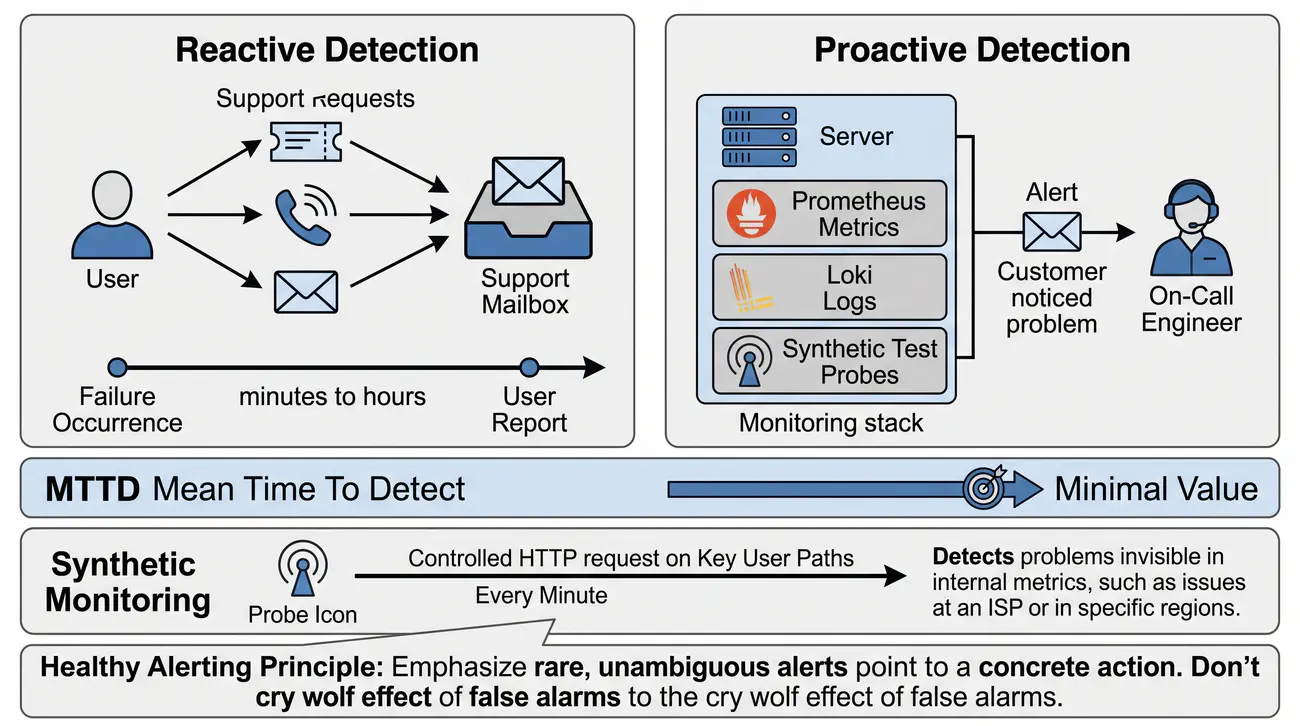
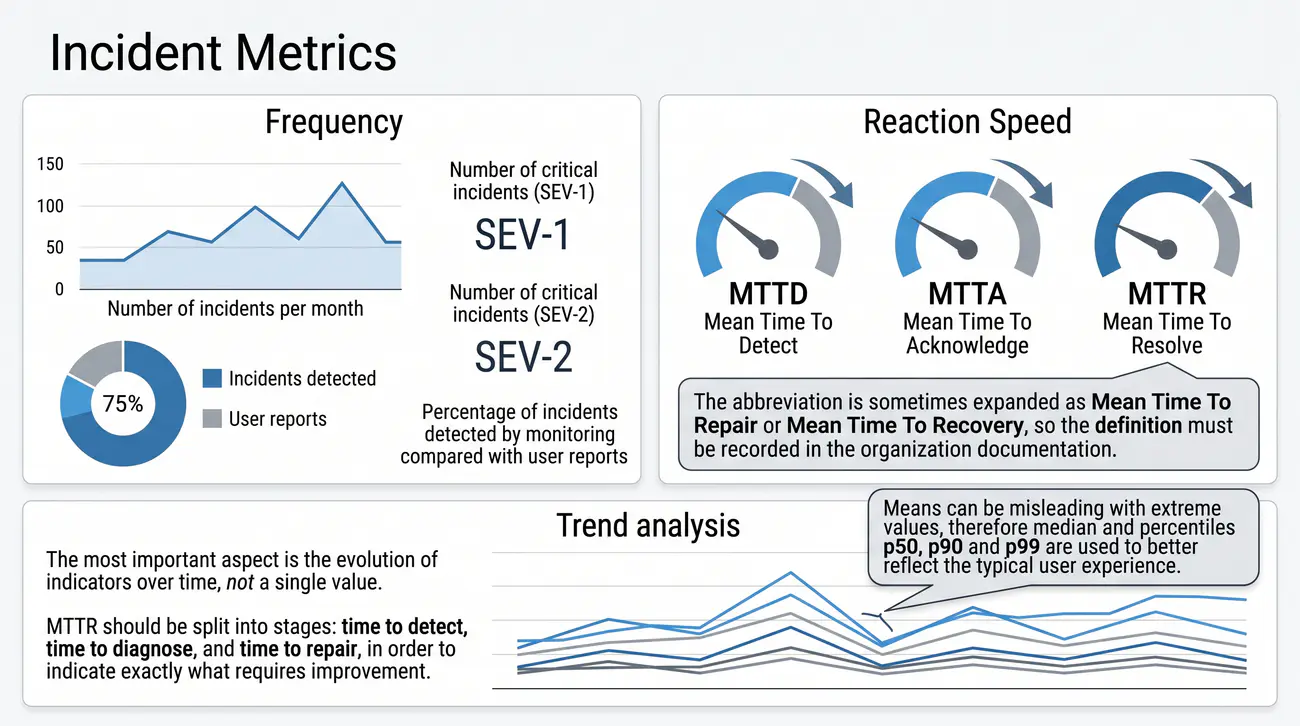
Proaktywne vs reaktywne wykrycie: Zgłoszenie użytkownika (reaktywne) = późne wykrycie, degradacja MTTA/MTTR. Automatyczny monitoring (proaktywne) = alert zanim zauważy klient. Dojrzały SRE: dominacja wykrycia automatycznego. Metryka: MTTD (Mean Time To Detect) oraz % incydentów wykrytych przez monitoring.

Awarię wykrywa monitoring albo klient. Monitoring jest szybszy i tańszy - dąż do automatycznego wykrywania.

  • Proaktywne wykrywanie anomalii – polega na automatycznym wychwyceniu awarii przez systemy telemetrii zanim klienci odczują jakiekolwiek skutki.
  • Reaktywne zgłoszenia od ludzi – ma miejsce wtedy, gdy zespół dowiaduje się o problemie z telefonów na infolinię lub skarg w mediach.
  • Czas detekcji MTTD – wskaźnik mierzy minuty upływające od momentu faktycznego wystąpienia usterki do jej wykrycia przez monitoring.
  • Alerty oparte na celach SLO – dobre reguły alarmowe badają tempo wypalania budżetu błędów, chroniąc inżynierów przed fałszywym szumem.
  • Sondy syntetyczne Blackbox – cyklicznie symulują typowe zachowania użytkowników, weryfikując dostępność platformy z różnych zakątków świata.
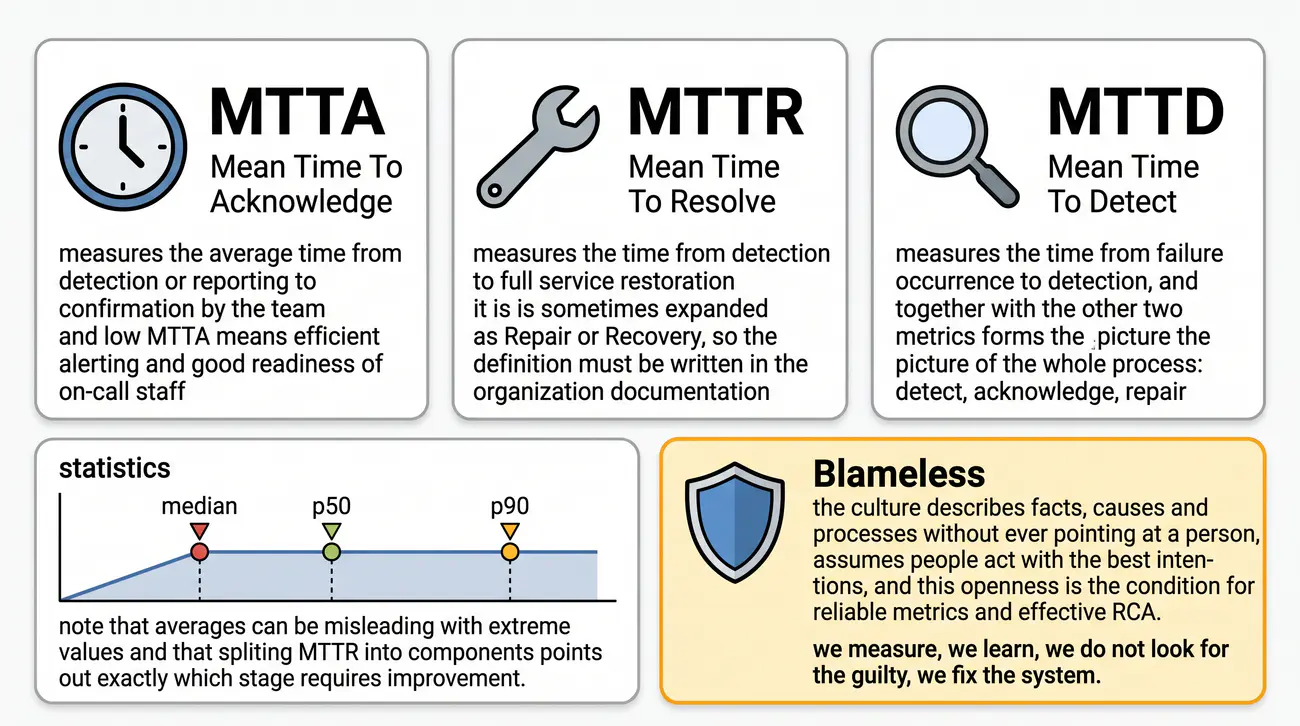
MTTD (Mean Time To Detect): Średni czas do wykrycia; dojrzały SRE stawia na automatyczny monitoring zamiast zgłoszeń użytkowników.
wykrycie

Wykrywanie incydentów w systemach produkcyjnych - pierwszy i decydujący krok całego cyklu - dzieli się na dwie drogi: zgłoszenie użytkownika (reaktywne wykrycie) i automatyczny monitoring (proaktywne wykrycie). Różnica nie jest jedynie techniczna - ma głęboki wpływ na metryki niezawodności i jakość procesu; celem dojrzałego zespołu SRE jest przesunięcie momentu wykrycia awarii jak najbliżej jej wystąpienia i jak najdalej od momentu, w którym zauważy ją klient. Im więcej czasu upłynie między tymi momentami, tym większy obszar oddziaływania awarii i tym trudniejsza naprawa - dlatego organizacje stawiają na monitoring i alerting, nie zaś na zgłoszenia użytkowników jako główne źródło informacji o problemach.

Zgłoszenie użytkownika (user report) to najstarsza i najbardziej naturalna forma wykrycia awarii - klient informuje przez ticket, telefon lub e-mail, że zauważył problem. Jego wadą jest oczywista zwłoka: od wystąpienia błędu do zgłoszenia mija zwykle od kilku minut do kilku godzin, a często nawet więcej. Działanie w trybie reaktywnym oznacza, że awaria aktywna jest zazwyczaj przez długi czas przed jej zauważeniem, co drastycznie pogarsza wskaźniki MTTA (Mean Time To Acknowledge) i MTTR (Mean Time To Resolve). Ponadto zgłoszenia użytkowników są często nieprecyzyjne i pochodzą z różnych źródeł, co utrudnia triage. Zgłoszenia mają jednak również zalety - trafnie opisują realny odbiór usługi przez klienta i działają jak „drugie ucho” monitoringu, szczególnie w przypadkach, których nasze metryki nie przewidziały (na przykład problemy z jakością połączenia po stronie ISP, których nie widzimy z poziomu naszej infrastruktury).

Automatyczny monitoring to proaktywne wykrycie oparte na metrykach, logach, trace'ach i syntetycznych testach (synthetic monitoring). Dobre systemy monitoringu, takie jak Prometheus z Alertmanagerem omawiane w wykładzie 6, potrafią wykryć naruszenie SLO i poinformować dyżurnego zanim awaria zostanie zauważona przez klientów. Kluczowe pojęcia to MTTD (Mean Time to Detect), progi i reguły alertów, a także healthy alerting - oznacza to, że alerty są rzadkie, jednoznaczne i wskazują na konkretne działanie. Skuteczność wykrywania mierzymy wskaźnikiem MTTD (Mean Time To Detect) oraz odsetkiem incydentów wykrytych przez monitoring w porównaniu z tymi zgłoszonymi przez użytkowników - dojrzałe zespoły dążą do dominacji wykrycia automatycznego. Terminologia: user report, monitoring, detection, MTTD (Mean Time To Detect), proactive vs reactive detection, synthetic monitoring.

Wyjaśnienie skrótów użytych na slajdzie:
Alertmanager – Prometheus Alertmanager Component – komponent Prometheus Alertmanager; System powiadomień stanowiący podstawowe źródło automatycznego wykrywania incydentów.
Prometheus – Prometheus Monitoring Server – serwer monitoringu Prometheus; Silnik analityczny rejestrujący przekroczenia progów jakościowych w czasie rzeczywistym.
LogQL – Log Query Language – język zapytań LogQL; Narzędzie wykrywające nagły skok częstości występowania krytycznych błędów w strumieniach logów.
Pager – PagerDuty / On-call notification system – system powiadamiania dyżurnego; Urządzenie wzywające inżynierów do reakcji w fazie wykrywania incydentu.
NOC – Network Operations Center – centrum operacyjne sieci; Zespół inżynierów operacyjnych monitorujący ekrany telemetrii w trybie ciągłym 24/7.

7/55 Reakcja na incydent
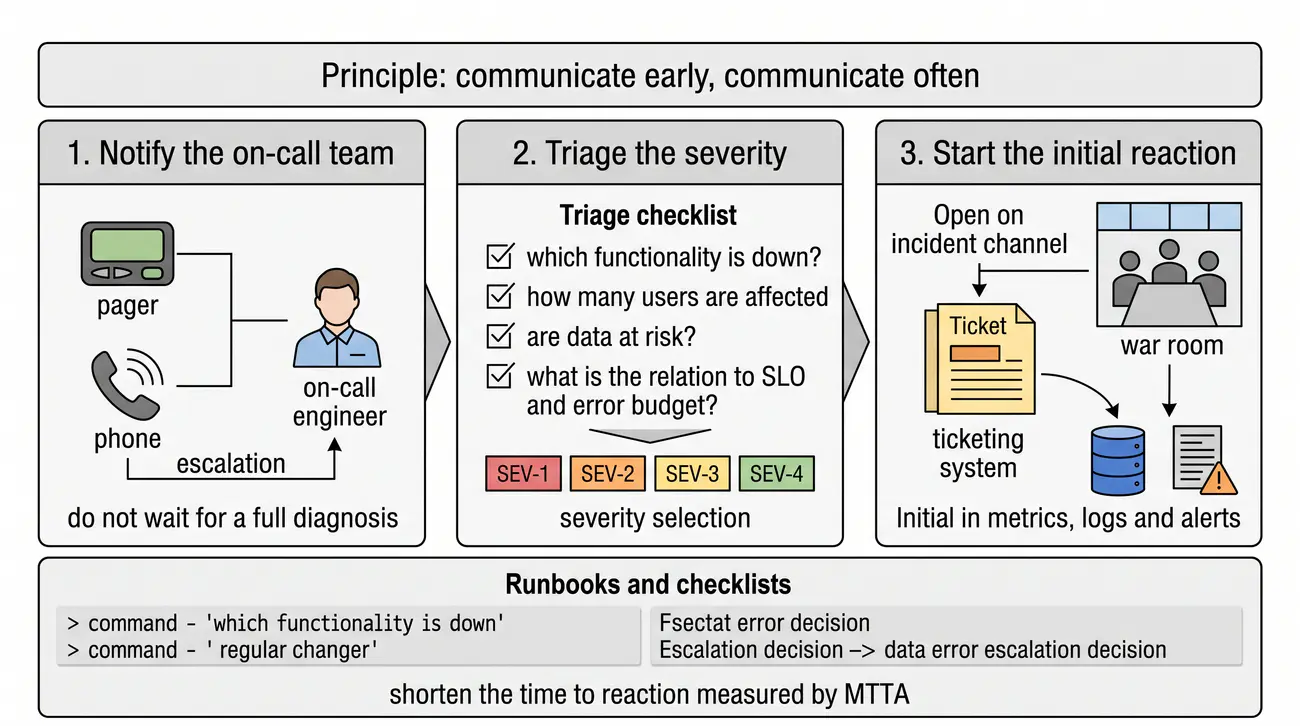
Initial response (reakcja wstępna): Pierwsze minuty decydują o przebiegu incydentu. Trzy podstawowe czynności: 1) powiadom właściwy zespół (on-call), 2) oceń priorytet (triage: SEV-1-SEV-4), 3) rozpocznij wstępną reakcję. Zasada: „communicate early, communicate often" - nie zwlekaj z powiadomieniem do pełnego zrozumienia problemu.

Pierwsze minuty wygrywają incydent: powiadom, oceń, zacznij. Nie czekaj, aż zrozumiesz wszystko.

  • Pierwsze minuty kryzysu – natychmiastowe podjęcie działań po odebraniu alarmu zapobiega rozprzestrzenianiu się paniki i chaosu decyzyjnego.
  • Potwierdzenie zgłoszenia ack – inżynier dyżurny natychmiast potwierdza alert, wstrzymując automatyczną eskalację powiadomień do przełożonych.
  • Wstępna weryfikacja objawów – dyżurny ocenia skalę problemu na dashboardach telemetrycznych i decyduje o ewentualnym powołaniu sztabu.
  • Uruchomienie kanału incydentu – utworzenie dedykowanego pokoju rozmów pozwala zebrać wszystkich zaangażowanych ekspertów w jednym miejscu.
  • Poczucie kontroli nad sytuacją – metodyczne postępowanie według z góry ustalonych procedur daje zespołowi pewność i spokój w kryzysie.
Communicate early, communicate often: Powiadamiaj wcześnie i często, nie czekając na pełną diagnozę; pierwsze minuty: on-call, triage, wstępna reakcja.
reakcja

Pierwsze minuty krytycznej fazy każdego incydentu - reakcja (initial response) - w dużej mierze decydują o ostatecznym czasie naprawy: zespół musi wykonać trzy podstawowe czynności - powiadomić odpowiednie osoby, ocenić priorytet incydentu (triage) i rozpocząć wstępną reakcję. Nie należy zwlekać z powiadomieniem do momentu pełnego zrozumienia problemu - informacje wstępne mają wartość samą w sobie, bo pozwalają zaangażować właściwych ludzi i równolegle prowadzić diagnozę; zasada "communicate early, communicate often" to jedna z najważniejszych praktyk zarządzania incydentem.

Triage to proces oceny i priorytetyzacji incydentu, wykonywany na podstawie objawów i wpływu na użytkowników. Osoba dyżurna (on-call engineer) odpowiada na pytania: „Która funkcjonalność nie działa?“, „Ilu użytkowników jest dotkniętych?“, „Czy zagrożone są dane?“, „Jaki jest związek z SLO i error budget?“. Na tej podstawie przypisuje poziom severity (SEV-1 do SEV-4) i decyduje o eskalacji. W triage bardzo ważne jest, aby nie zaniżać ani nie zawyżać oceny powagi: niedoszacowany incydent pozostanie bez reakcji, a przeszacowany wygeneruje fałszywy alarm i zmarnuje zasoby. W dojrzałych zespołach triage wspiera się runbookami i dedykowanymi checklistami, które precyzyjnie definiują kryteria klasyfikacji, a także automatycznymi regułami eskalacji w Alertmanagerze.

Wstępna reakcja (initial response) obejmuje również takie działania jak otwarcie kanału incydentu (incident channel), rozpoczęcie wpisu o zdarzeniu w systemie biletowym, wstępne zgromadzenie danych (metriki, logi, alerty) oraz powiadomienie władz wyższego szczebla, jeśli wymaga tego severity. Ważnym elementem jest również „workload management” - ulokowanie uwagi zespołu na rozwiązywaniu problemu, a nie na komunikacji: temu służy przypisanie ról opisane na slajdzie 9. Pierwsze minuty to czas największego zamieszania i ryzyka błędnych decyzji, dlatego profesjonalne zespoły wdrażają procedury tak, aby plan działania był możliwy do wykonania nawet przy wysokim poziomie stresu. Terminologia: triage (selekcja, priorytetyzacja), initial response (reakcja wstępna), escalation (eskalacja), on-call (dyżur), runbook (podręcznik postępowania), incident channel (kanał incydentu).

Wyjaśnienie skrótów użytych na slajdzie:
Triage – Incident Triage Assessment – segregacja i ocena incydentu; Wstępna analiza skali usterki pozwalająca przypisać właściwy poziom ważności (Sev1-Sev4).
Ack – Acknowledge Signal – potwierdzenie podjęcia działań; Sygnał inżyniera informujący system o objęciu opieki nad incydentem i blokujący dalszą eskalację.
Runbook – Emergency Operational Runbook – awaryjna instrukcja operacyjna; Procedura techniczna stanowiąca podstawę pierwszych działań mitygacyjnych na produkcji.
WarRoom – Incident War Room Channel – pokój kryzysowy incydentu; Dedykowana przestrzeń komunikacyjna uruchamiana w celu koordynacji działań ratunkowych.
Rollback – Immediate Version Rollback – natychmiastowe wycofanie wersji; Najczęstsze działanie pierwszej reakcji polegające na cofnięciu ostatnio wdrożonych zmian.

8/55 Rola komunikatora incydentu
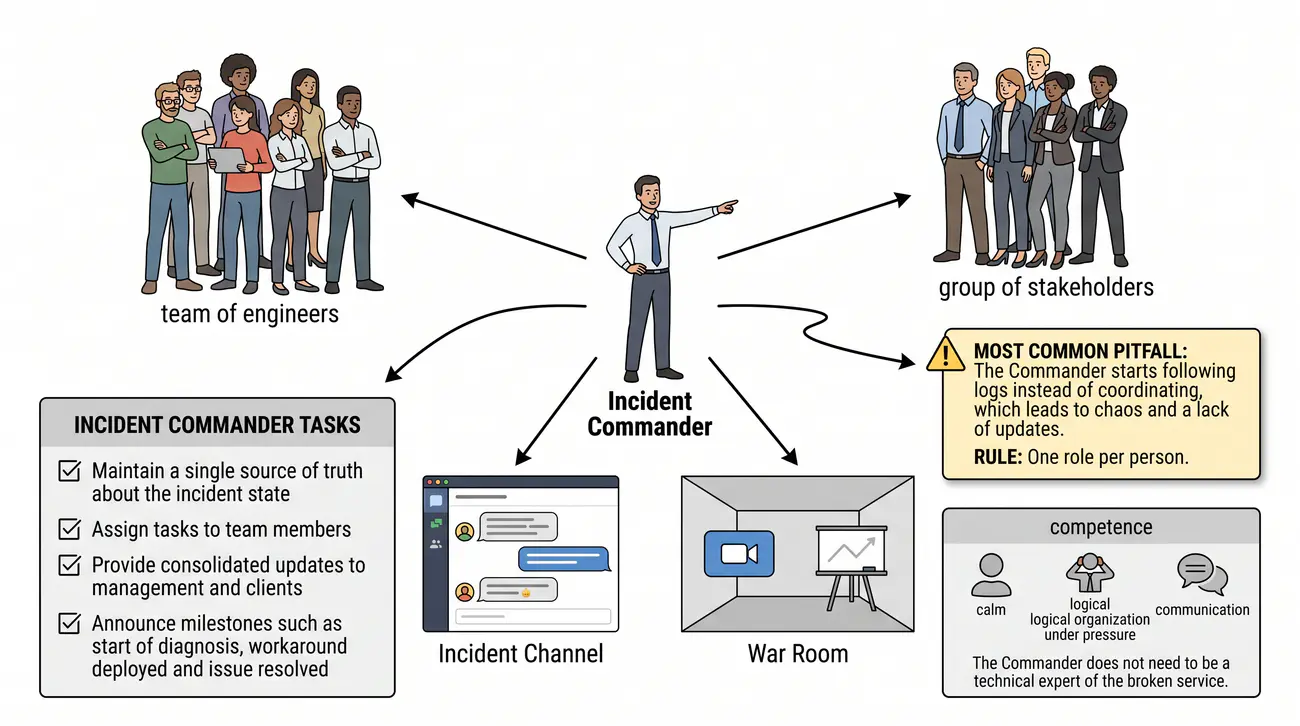
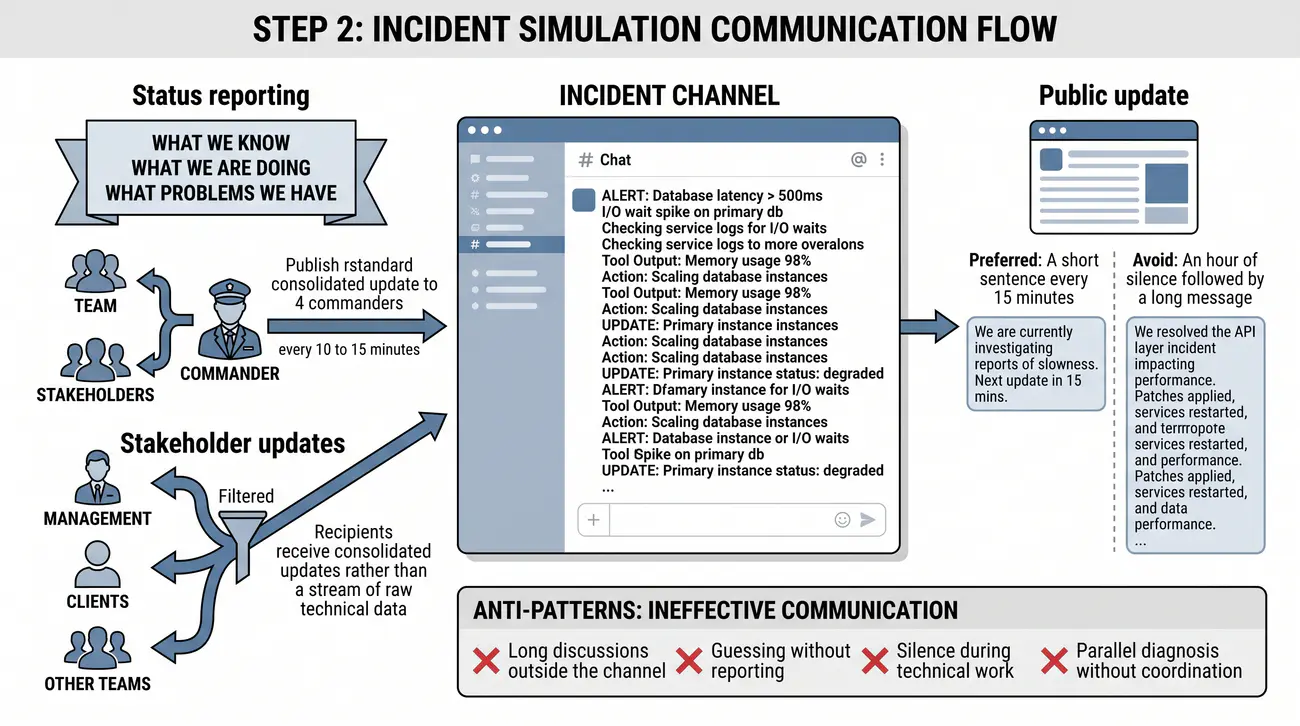
Incident Commander (komunikator): Osoba odpowiedzialna za koordynację akcji i komunikację. Jedno zadanie: organizacja, nie rozwiązywanie problemu technicznego. Prowadzi kanał incydentu (incident channel), tworzy war room, przekazuje skonsolidowane aktualizacje, pilnuje milestone'ów. Oddziela komunikację od diagnozy - inżynierowie skupiają się na naprawie.

Komunikator nie naprawia - organizuje. Jeden kanał, jedno źródło prawdy i statusy zamiast chaosu.

  • Model dowodzenia ICS – Incident Command System to sprawdzona w ratownictwie hierarchia zarządzania kryzysowego zaadaptowana do IT.
  • Rola Incident Commandera – dowódca posiada pełną władzę operacyjną na czas awarii i koordynuje wszystkie działania diagnostyczne zespołu.
  • Autorytet dowódcy incydentu – decyzje dowódcy są wiążące dla wszystkich uczestników akcji, w tym dla menedżerów wyższego szczebla.
  • Delegowanie i porządek – głównodowodzący nie analizuje logów osobiście, lecz rozdziela zadania techniczne i dba o dyscyplinę na kanale.
  • Brak chaosu kompetencyjnego – jednoosobowe przywództwo eliminuje sprzeczne polecenia i przyspiesza podejmowanie trudnych decyzji.
War room: Wirtualne centrum dowodzenia przy poważnej awarii; commander prowadzi kanał, aktualizacje i milestone’y, oddzielając komunikację od diagnozy.
kanał

W trakcie incydentów o krytycznym priorytecie zespół operacyjny przyjmuje strukturę Incident Command System (ICS) opisaną w podręczniku PagerDuty Incident Response:
- Dowódca Incydentu (Incident Commander – IC): posiada najwyższy autorytet decyzyjny, wyznacza strategię i koordynuje prace; IC nie wykonuje poleceń na konsoli ani nie analizuje kodu,
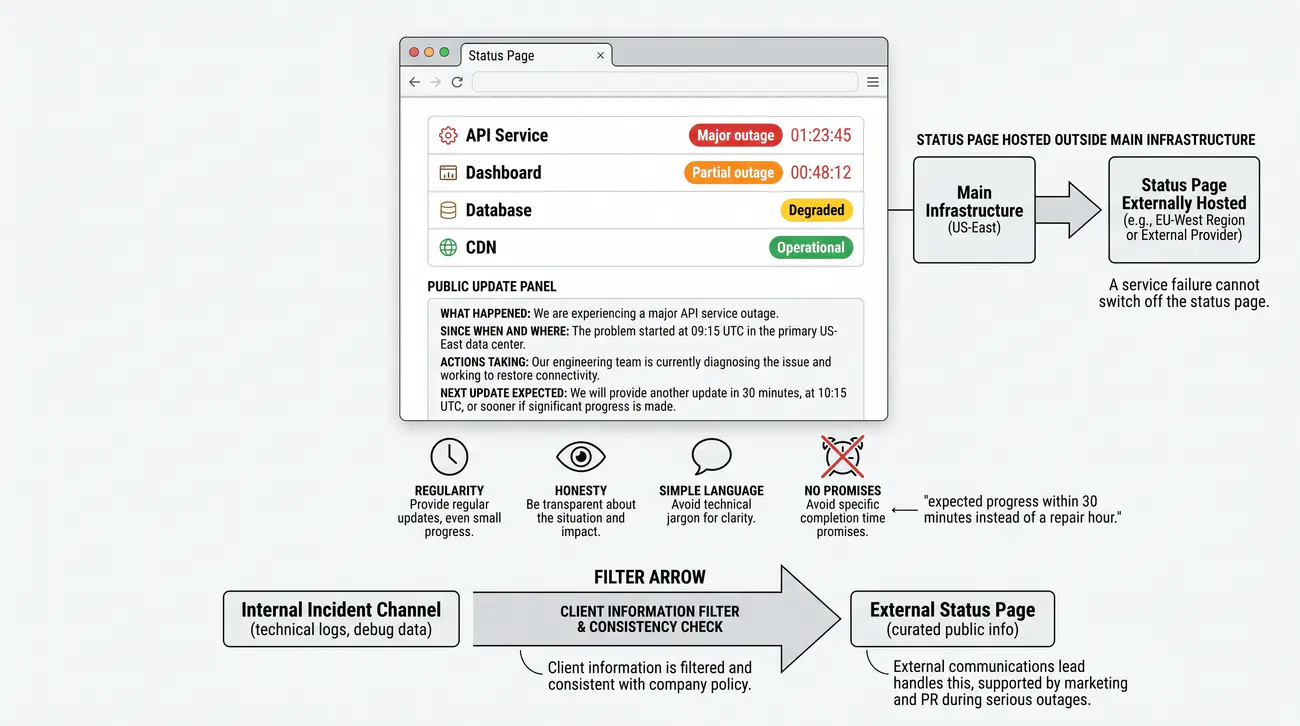
- Oficer Komunikacji (Communications Lead – CL): prowadzi publiczne aktualizacje na stronie statusowej i chroni inżynierów przed zapytaniami menedżerów,
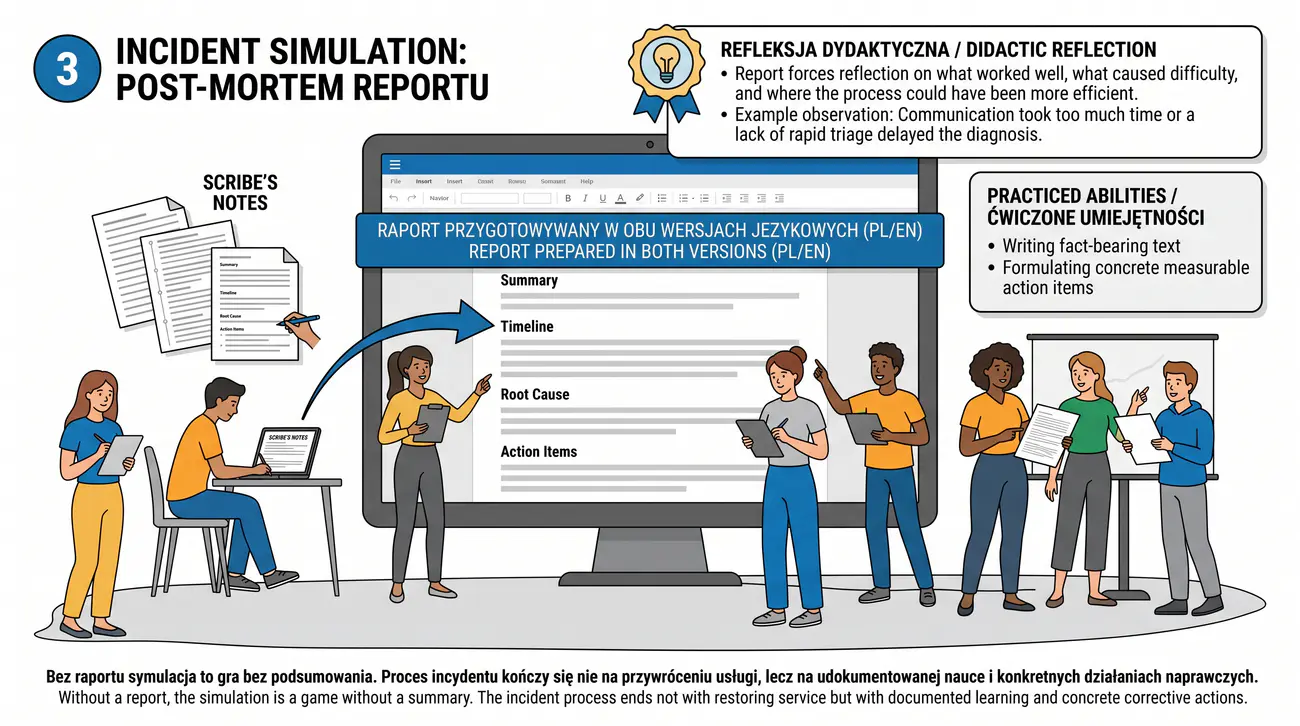
- Skryba (Scribe): precyzyjnie rejestruje każde działanie, hipotezę i decyzję na chronologicznej osi czasu w czasie UTC,
- Lider Operacyjny / Eksperci (Operations Lead / SMEs): inżynierowie techniczni realizujący diagnozę i procedury mitygacji.

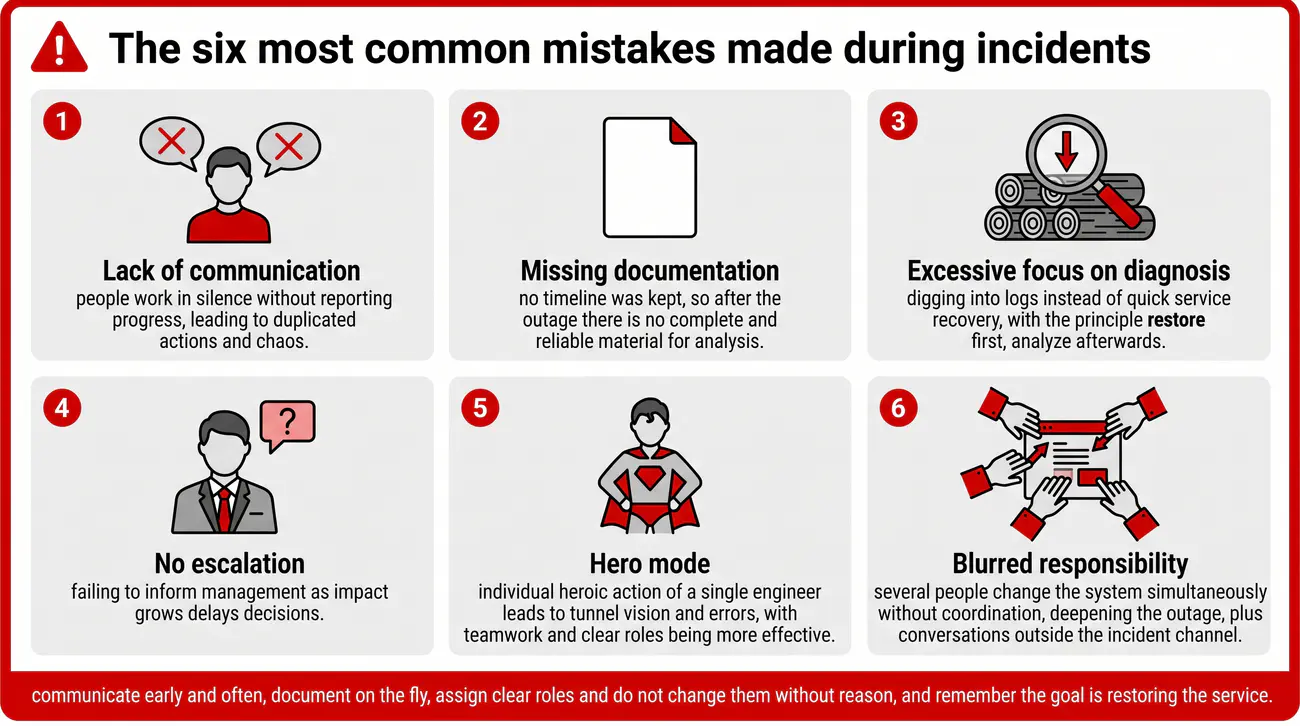
Komunikator incydentu (incident commander) odpowiada za zarządzanie komunikacją podczas awarii: jednocześnie działa wiele osób, zespół otrzymuje informacje z różnych źródeł, a zainteresowane strony - kierownictwo, klienci, dyżurni - chcą wiedzieć, co się dzieje. Bez jednej osoby odpowiedzialnej za porządek komunikacyjny pojawia się chaos: każdy pyta wszystkich, informacje są sprzeczne lub nieaktualne, a czas zespołu technicznego marnuje się na odpowiadanie zamiast na naprawę. Rola komunikatora oddziela przepływ informacji od procesu technicznego rozwiązywania problemu i pozwala inżynierom skupić się na diagnozie i naprawie.

Komunikator zakłada i prowadzi kanał incydentu (incident channel) - dedykowane miejsce komunikacji (najczęściej czat lub kanał komunikatora zespołowego, np. Slack), do którego wpływa cała wymiana informacji. W poważniejszych incydentach tworzony jest także war room - wirtualne lub fizyczne miejsce spotkania inżynierów prowadzących diagnozę. Do zadań komunikatora należy: utrzymywanie jednego, aktualnego źródła prawdy o stanie incydentu, wyznaczanie zadań poszczególnym osobom według ich ról, przekazywanie skonsolidowanych aktualizacji do kierownictwa i klientów, pilnowanie, aby nie zbaczać od celu, oraz ogłaszanie milestone'ów (początek diagnozy, wdrożenie workaround, potwierdzenie rozwiązania). Komunikator nie musi być ekspertem technicznym od uszkodzonej usługi - jego zadaniem jest koordynacja, nie rozwiązywanie problemu.

W filozofii SRE rolę komunikatora najczęściej pełni osoba o rozwiniętych kompetencjach przywódczych, która potrafi zachować spokój i logicznie organizować pracę nawet w stresie. Istotne jest, aby komunikator posiadał jasny zakres decyzji - może podejmować decyzje operacyjne (kto robi co, kiedy zakończyć działanie), ale decyzje strategiczne, takie jak np. dwuletnie planowanie naprawy, konsultuje z kierownictwem. W wielu organizacjach istnieją gotowe listy kontrolne (checklist) dla komunikatora, w których opisano schemat prowadzenia spotkań statusowych, format zgłoszeń i sposób oznaczania etapów incydentu. Taka formalizacja znacząco zwiększa skuteczność działania nawet przy mało doświadczonych zespołach. Terminologia: incident commander (komunikator, kierownik incydentu), incident channel (kanał incydentu), war room (pokój sytuacyjny), incident response, communication plan (plan komunikacji).

Wyjaśnienie skrótów użytych na slajdzie:
CL – Communications Lead – oficer komunikacji incydentu; Rola w zespole ratunkowym dedykowana wyłącznie do zarządzania przepływem informacji zewnętrznych i wewnętrznych.
StatusPage – Public Service Status Page – publiczna strona statusowa; Oficjalny portal, na którym Communications Lead publikuje rzetelne komunikaty o postępach w usuwaniu awarii.
B2B – Business to Business – relacja biznesowa przedsiębiorstw; Klienci korporacyjni wymagający bezpośrednich, formalnych powiadomień o statusie awarii krytycznej.
PR – Public Relations in Crisis – relacje publiczne w kryzysie; Koordynacja przekazu medialnego w sytuacjach awarii dotykających setek tysięcy konsumentów.
Stakeholder – Business Stakeholder – interesariusz biznesowy; Menedżerowie, działy prawne i zarząd informowani przez oficera komunikacji o skutkach incydentu.

9/55 Role w zespole incydentu
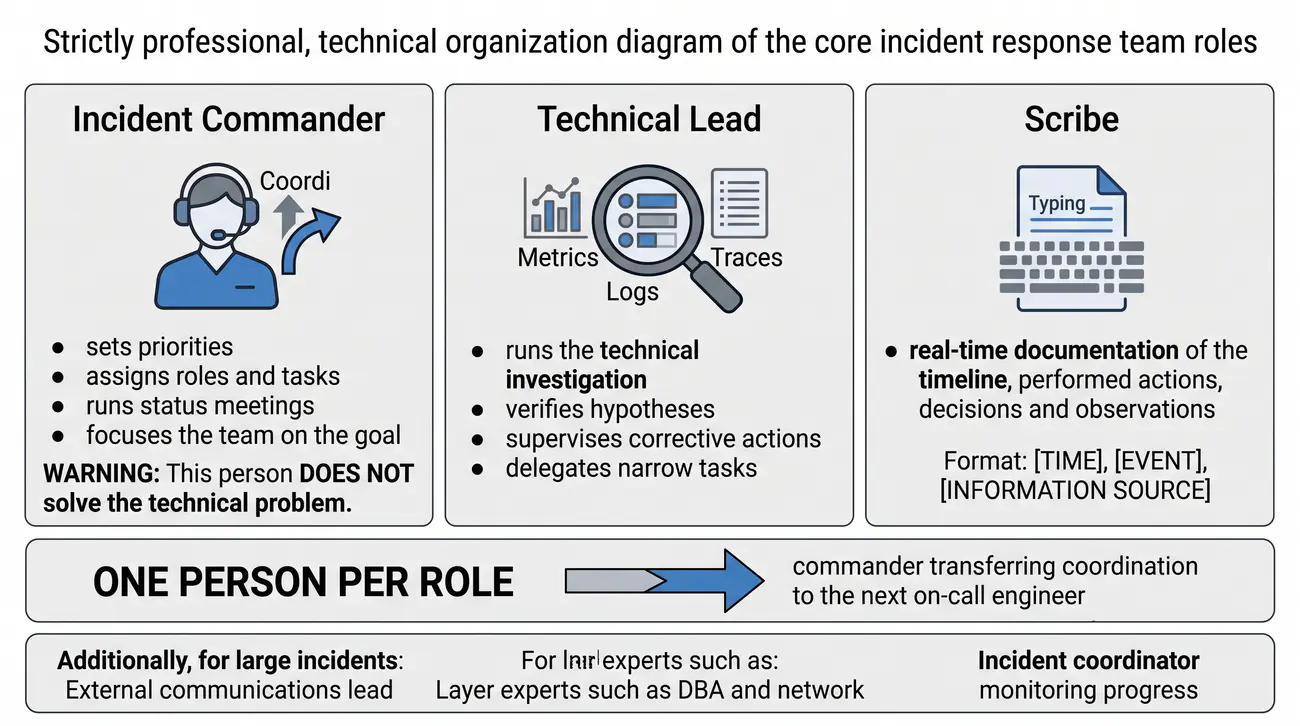
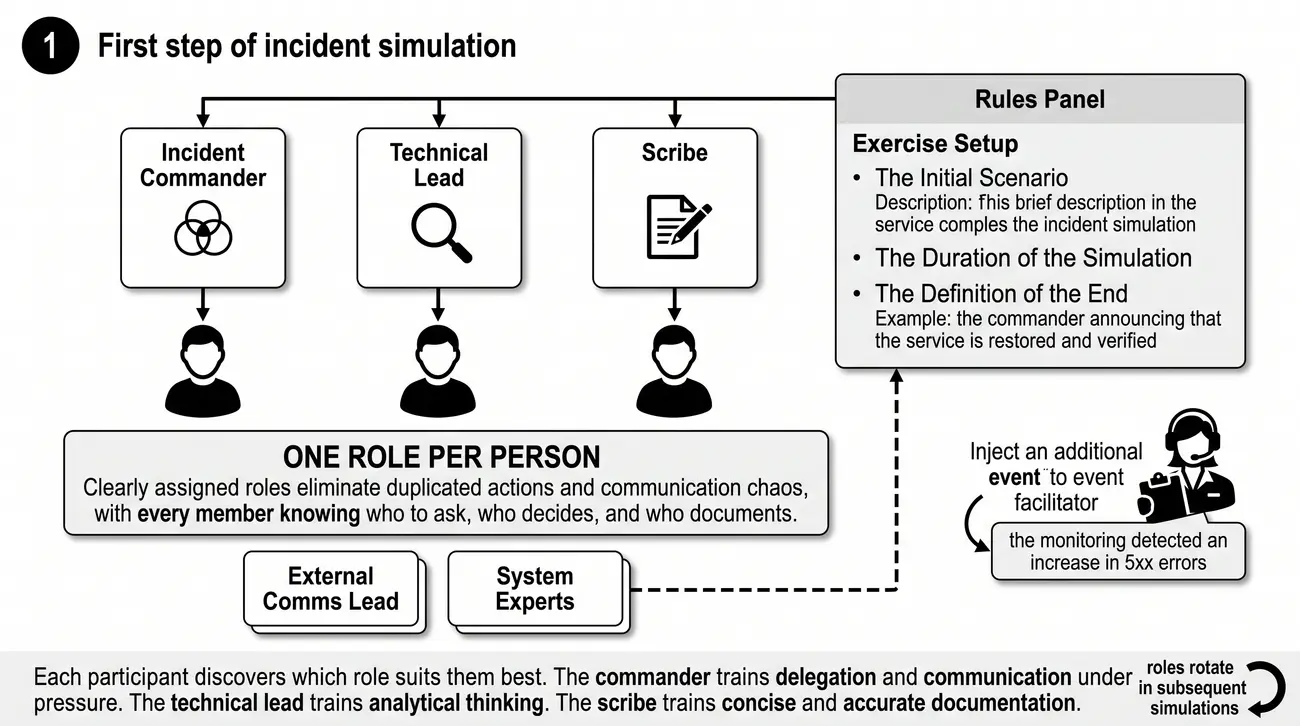
Role w zespole incydentu: 1) Incident Commander (komunikator) - koordynacja. 2) Technical Lead (osoba diagnozująca) - analiza danych, hipotezy, naprawa. 3) Scribe (skryba) - dokumentacja timeline w czasie rzeczywistym. Zasada: „one person per role" - jedna rola na osobę, jedna osoba na rolę. Większe awarie: external comms lead, eksperci warstw, incident coordinator.

Trzy role wystarczą: commander dowodzi, technical lead diagnozuje, scribe pisze. Jedna osoba, jedna rola.

  • Zadania oficera łącznikowego – Communications Lead odpowiada za redagowanie jasnych komunikatów dla zarządu oraz aktualizację stron statusu.
  • Spokojna praca ekspertów – oddelegowanie komunikacji pozwala badaczom technicznym skupić się wyłącznie na analizie logów i naprawie.
  • Oficer operacyjny Operations Lead – zarządza pracą inżynierów wykonujących bezpośrednie operacje weryfikacyjne i wdrożeniowe na serwerach.
  • Rola skryby Scribe – odpowiada za precyzyjne odnotowywanie w dzienniku każdej podjętej decyzji, zmiany w systemie i znacznika czasu.
  • Zgrana struktura sztabu – harmonijna współpraca ról funkcyjnych sprawia, że sztab kryzysowy działa jak precyzyjny mechanizm zegarowy.
One person per role: Jedna rola na osobę i jedna osoba na rolę (commander, technical lead, scribe; większe awarie: external comms, eksperci).
role

W modelu Incident Command System (ICS) kluczowa jest zasada jednoosobowego dowodzenia (Incident Commander) oraz separacji ról operacyjnych od komunikacyjnych, co pozwala inżynierom skupić się wyłącznie na mitygacji awarii.

Role w zespole incydentu opierają się na zasadzie rozdzielenia kompetencji: jedna osoba koordynuje, inna diagnozuje, jeszcze inna dokumentuje, dzięki czemu poszczególne działania nie kolidują ze sobą, a żadna osoba nie jest przeciążona wieloma obowiązkami naraz. Podstawowy model zakłada trzy stałe role: komunikatora (incident commander), osobę odpowiedzialną za diagnozę (technical lead / ops lead) oraz skrybę (scribe); w większych awariach dochodzą kolejne - osoba odpowiedzialna za komunikację z klientami (external communications lead), eksperci od poszczególnych warstw systemu czy osoba monitorująca działania (incident co-ordinator).

Incident commander, czyli komunikator, ma jedno zadanie - koordynację całej akcji. Nie rozwiązuje problemu technicznego, lecz decyduje o priorytetach, przydziela role i zadania, prowadzi spotkania statusowe i koncentruje zespół na celu. Jego przeciwieństwem jest jedna z najczęstszych pułapek: komunikator, który sam zaczyna „śledzić” logi zamiast koordynować. Osoba diagnozująca (technical lead) prowadzi techniczne dochodzenie - analizuje metryki, logi i ślady (traces), weryfikuje hipotezy i nadzoruje wykonanie czynności naprawczych. Może delegować wąskie zadania (np. sprawdzenie jednej maszyny) innym inżynierom, samodzielnie zachowując ogólny obraz sytuacji. Skryb (scribe) dokumentuje przebieg incydentu w czasie rzeczywistym: oś czasu (timeline), wykonane działania, decyzje i obserwacje, dzięki czemu po awarii powstaje pełny zapis umożliwiający rzetelny post-mortem.

Z przydzieleniem ról wiąże się też zasada „one person per role” - każda rola przypada dokładnie jednej osobie, a jedna osoba pełni w danym momencie dokładnie jedną rolę. Dzięki temu komunikacja jest jednoznaczna, odpowiedzialność jasno przypisana, a siatka przekazywania informacji nie tworzy pętli. W modelu Google SRE zalecana jest również rotacja ról przy dłuższych incydentach, aby uniknąć zmęczenia decyzyjnego, oraz automatyczne skojarzenie odpowiedzialności - na przykład komunikator odchodzący z dyżuru przekazuje koordynację następnemu dyżurnemu. Dobrze przydzielone role drastycznie skracają czas reakcji i niezmiennie zmniejszają liczbę błędów popełnianych w trakcie akcji, zwłaszcza w awariach rozciągniętych w czasie. Terminologia: incident commander, technical lead, scribe (skryba), incident roles, single responsibility, rotation, handover (przekazanie dyżuru).

Wyjaśnienie skrótów użytych na slajdzie:
IC – Incident Commander – dowódca incydentu; Jednoosobowy lider posiadający pełną władzę decyzyjną i koordynujący wszystkie działania ratunkowe.
Scribe – Incident Scribe / Historian – skryba incydentu; Osoba odpowiedzialna za skrupulatne notowanie przebiegu awarii, hipotez, poleceń i wyników testów.
SME – Subject Matter Expert – ekspert dziedzinowy; Inżynier posiadający głęboką wiedzę specjalistyczną o danym komponencie (baza danych, sieć, kod aplikacji).
OpsLead – Operations Lead – lider operacyjny incydentu; Koordynator inżynierów technicznych zarządzający bezpośrednim wdrażaniem procedur mitygacyjnych.
ICS – Incident Command System – system dowodzenia incydentem; Ustandaryzowana hierarchia organizacyjna zaadaptowana ze służb ratowniczych do inżynierii SRE.

10/55 Diagnoza i analiza przyczyn
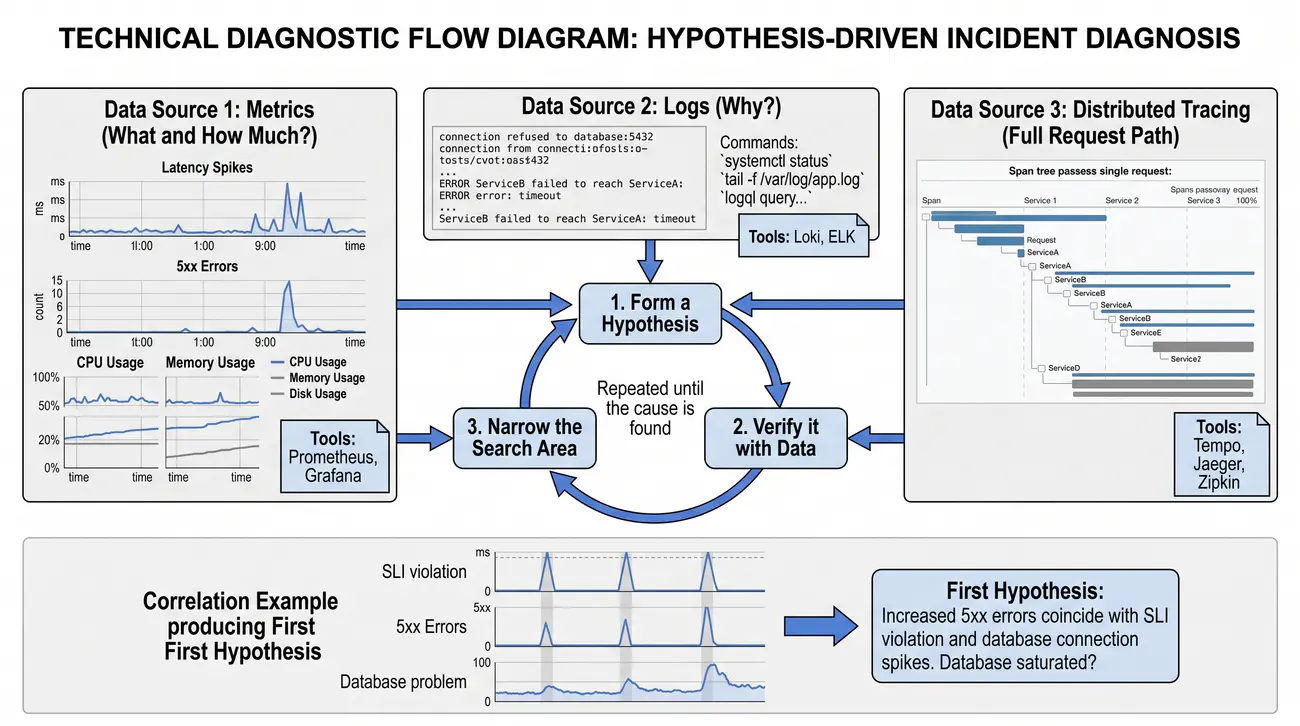
Diagnoza (hypothesis-driven): Metryki (SLI/SLO, wykład 2) odpowiadają „jakie/ile" - pokazują stan liczbowo (latency, błędy, CPU, dysk). Logi (Loki/ELK, wykład 4) odpowiadają „dlaczego" - komunikaty błędów, ślady żądań. Trace'y (Tempo/Jaeger) pokazują pełną ścieżkę żądania. Proces: hipoteza → weryfikacja danymi → zawężanie obszaru.

Diagnoza to nie zgadywanie: metryki (ile), logi (dlaczego) i ślady (gdzie), spięte hipotezą.

  • Wydzielona przestrzeń łączności – wszelka dyskusja w trakcie awarii musi odbywać się na osobnym kanale czatu, redukując ogólny szum w firmie.
  • Dyscyplina wypowiedzi – wpisy na kanale incydentu powinny być zwięzłe, rzeczowe i oparte wyłącznie na sprawdzonych faktach i pomiarach.
  • Regularne meldunki sytuacyjne – oficer komunikacji publikuje podsumowanie statusu co pół godziny, informując o postępach i kolejnych krokach.
  • Wizualna tablica zadań – pozwala każdemu uczestnikowi błyskawicznie sprawdzić, kto aktualnie pracuje nad danym problemem technicznym.
  • Kompletny ślad zdarzeń – zapis wypowiedzi z kanału stanowi bezcenne źródło danych do późniejszego odtworzenia precyzyjnej osi czasu.
Podejście hipotezowe: Hipoteza → weryfikacja danymi → zawężanie obszaru; metryki mówią jakie/ile, logi - dlaczego, trace’y pokazują ścieżkę.
diagnoza
CLI · Linux: diagnostyka usługi
user@server:~$ systemctl status myservice ● myservice.service - Example service Active: failed (Result: exit-code) user@server:~$ sudo journalctl -u myservice -n 30 ERROR: connection refused to 127.0.0.1:3306 # początek diagnostyki przyczyny awarii

W trakcie trwania aktywnego incydentu naczelną zasadą SRE jest bezwzględny prymat mitygacji nad poszukiwaniem przyczyny źródłowej. Celem zespołu jest jak najszybsze zminimalizowanie wpływu awarii na użytkowników za pomocą sprawdzonych działań: automatycznego rollbacku ostatniego wydania, przełączenia ruchu na zapasowe centrum danych (failover), restartu niesprawnych węzłów lub odcięcia ruchu nadmiarowego (load shedding). Szczegółowe dochodzenie przyczyn usterki (RCA) rozpoczyna się dopiero po przywróceniu zielonego stanu wskaźników SLI.

Diagnoza incydentu - proces ustalenia, co faktycznie się zepsuło i dlaczego - opiera się przede wszystkim na dwóch źródłach danych: metrykach i logach, uzupełnianych w nowoczesnych systemach przez trasy (traces) i metadane infrastrukturalne. Metryki odpowiadają na pytania "jakie" i "ile" - pokazują stan systemu liczbowo: opóźnienia, błędy, użycie CPU, pamięci, dysku, ruch sieciowy; logi odpowiadają na "dlaczego" i "co dokładnie się wydarzyło" - podniesione błędy, komunikaty, ślady wykonania pojedynczych żądań. W praktyce diagnoza to iteracyjny proces hipotez: inżynier stawia hipotezy na podstawie metryk, weryfikuje je w logach i trace'ach, a następnie zawęża obszar poszukiwania aż do znalezienia przyczyny.

Metryki, znane z wykładu 2 (SLI/SLO) i wykładu 3 (Grafana), pozwalają szybko zlokalizować, która warstwa systemu jest dotknięta problemem. Obserwując spike'y (skoki) na wykresach można ustalić, czy problem tkwi w warstwie aplikacji, bazy danych, sieci czy infrastruktury. Kluczowe znaczenie ma tutaj korelacja: naruszenie metryk SLI (np. wzrost latencji), wzrost liczby błędów 5xx i niska dostępność infrastruktury w tym samym czasie pozwalają od razu postawić pierwszą hipotezę. Metryki same w sobie nie mówią jednak, dlaczego coś się stało - tutaj niezbędne są logi. Logi (wykład 4, Loki/ELK) umożliwiają rekonstrukcję przebiegu zdarzeń: znajdziemy w nich konkretne komunikaty błędów (np. connection refused), ślady requestów oraz ślady być może wcześniej przeoczonych problemów, takich jak stopniowy wzrost opóźnień czy ostrzeżenia o odmowach połączeń.

Nowoczesna diagnostyka coraz częściej wspiera się również trace'ami (distributed tracing, np. Tempo lub Jaeger), które pokazują pełną ścieżkę pojedynczego żądania przez wszystkie usługi i pozwalają zmierzyć, który fragment systemu wprowadza opóźnienie. W dobrej praktyce diagnozę prowadzimy zgodnie z zasadą „hypothesis-driven” - zamiast akcji losowych stawiamy konkretną hipotezę, projektujemy test ją weryfikujący, po czym albo ją potwierdzamy, albo odrzucamy i przechodzimy do następnej. Należy również pamiętać o tym, że diagnoza nie powinna być prowadzona w pojedynkę w poczuciu tryumfu, lecz z dokumentowaniem kroków, tak aby osoba przejmująca pracę (np. w trakcie zmiany dyżuru) mogła szybko wejść w kontekst. Terminologia: metrics (metryki), logs (logi), traces (trasy), SLI/SLO (poziomy usług), hypothesis-driven diagnosis, correlation (korelacja), distributed tracing.

Wyjaśnienie skrótów użytych na slajdzie:
RCA – Root Cause Analysis – analiza przyczyn źródłowych; Systematyczny proces badania śladów telemetrycznych w celu wykrycia defektu technicznego.
Hypotheses – Scientific Diagnostic Hypotheses – hipotezy diagnostyczne; Metodologia eliminowania podejrzeń poprzez rygorystyczne testowanie faktów w telemetrii.
TraceID – Distributed Trace Identifier – identyfikator śladu rozproszonego; Unikalny klucz żądania umożliwiający prześledzenie drogi zablokowanego zapytania w mikroserwisach.
SpanID – Span Execution Identifier – identyfikator podzadania; Klucz operacji wskazujący dokładnie, która funkcja lub kwerenda bazodanowa wywołała błąd.
Logs – Centralized Log Aggregation – scentralizowane rejestry logów; Podstawowe źródło danych historycznych wykorzystywane przez inżynierów do analizy awarii.

11/55 Usunięcie i przywrócenie
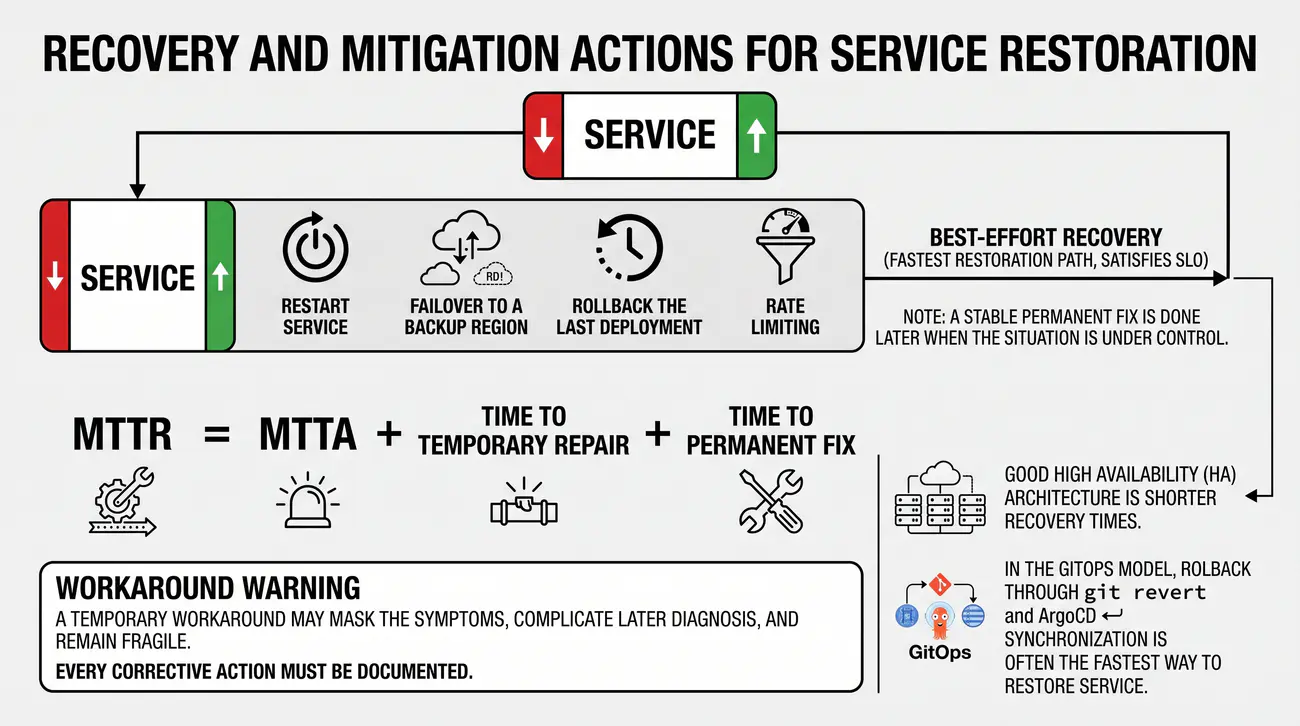
Recovery i mitigation: Priorytet: jak najszybciej przywrócić dostępność usługi (recovery), nawet tymczasowo (mitigation). Typowe działania: restart usługi, failover na zapasowy region, rollback wdrożenia, rate limiting. Trwała naprawa (permanent fix) - po opanowaniu awarii. Zasada: „przywracaj najpierw, analizuj potem".

Najpierw ulga, potem leczenie: mitigation wraca usługę ludziom, permanent fix usuwa przyczynę. Kolejność święta.

  • Zintegrowany stos narzędziowy – nowoczesna obsługa incydentów łączy systemy powiadamiania, komunikatory, wideokonferencje i dokumentację.
  • Platformy dyżurów on-call – narzędzia takie jak PagerDuty koordynują grafiki inżynierów i dbają o skuteczne budzenie właściwych osób.
  • Błyskawiczne mostki łączności – integracje botów pozwalają powołać wirtualny pokój dowodzenia i dedykowany kanał czatu jednym kliknięciem.
  • Systemy rejestracji zgłoszeń – narzędzia ticketowe służą do formalnego śledzenia postępów prac naprawczych oraz decyzji zarządczych.
  • Zewnętrzne portale statusowe – informują klientów o prowadzonych pracach naprawczych, odciążając infolinię firmy od setek zapytań.
Permanent fix: Trwała naprawa dopiero po opanowaniu awarii; najpierw recovery/mitigation (restart, failover, rollback, rate limiting) - „przywracaj najpierw, analizuj potem”.
przywrócenie

Prymat mitygacji nad dochodzeniem przyczyn oznacza, że w pierwszej kolejności wdrażane są procedury przywracające działanie usługi (rollback, failover, degradacja funkcjonalności), a badanie logów i kodu odkłada się do fazy RCA.

Etap usunięcia problemu i przywrócenia usługi (recovery) to cel nadrzędny każdej akcji incydentalnej: zanim zespół w pełni zrozumie przyczynę źródłową, priorytetem jest jak najszybsze przywrócenie dostępności usługi. W tym celu stosuje się rozwiązania tymczasowe, zwane mitigation (łagodzenie skutków), które nie usuwają przyczyny, lecz ograniczają jej wpływ: wyłączenie i ponowny start uszkodzonej usługi, przełączenie ruchu na zapasowy region (failover), wycofanie (rollback) ostatniego wdrożenia lub ograniczenie ruchu (rate limiting) do czasu naprawy. Filozofia jest prosta: najpierw zmniejszamy wpływ awarii do zera, dopiero później - w spokojnych warunkach - wykonujemy pełną naprawę (permanent fix) i przygotowujemy post-mortem.

Wybór między mitigation a permanent fix to często trudna decyzja pod presją czasu. Z jednej strony workaround (obejście) przywraca usługę niemal natychmiast i minimalizuje wpływ na użytkowników; z drugiej - może maskować objawy i utrudniać późniejszą diagnozę oraz może być kruchym, tylko tymczasowym rozwiązaniem. Dlatego dobre zespoły stosują zasadę „best-effort recovery”: wybierają najszybsze rozwiązanie, które przywraca usługę do zgodnego z SLO poziomu, a dopiero po opanowaniu sytuacji zajmują się stabilną i trwałą naprawą. Ważne jest również udokumentowanie każdej akcji naprawczej - dokładnego czasu, poleceń, efektów - ponieważ pozwoli to w post-mortem ocenić trafność decyzji i opisać powtarzalne kroki w runbooku.

W kontekście recovery warto pamiętać o wskaźniku MTTR (Mean Time To Resolve) oraz jego składowych: MTTA (czas do potwierdzenia), MTTD (czas do wykrycia), czas do naprawy tymczasowej (workaround) i czas do naprawy trwałej (fix). Zespoły SRE starają się rozdzielić te składowe w analizach, ponieważ skrócenie czasu naprawy tymczasowej osiąga się innymi metodami (automatyzacja failover, dobre runbooki, procedura „one-click recovery”) niż skrócenie czasu naprawy trwałej (inwestycje w jakość kodu, monitoring, inżynierię niezawodności). End-stage recovery oznacza również potwierdzenie, że rzeczywiście zostaliśmy w zgodzie z planem: przywrócenie SLO, zniesienie ograniczeń ruchu, weryfikacja integralności danych. Terminologia: recovery (przywrócenie), mitigation (łagodzenie skutków), workaround (obejście tymczasowe), rollback (wycofanie wdrożenia), failover (przełączenie awaryjne), MTTR (Mean Time To Resolve).

Wyjaśnienie skrótów użytych na slajdzie:
Mitigation – Incident Mitigation Action – mitygacja skutków incydentu; Działanie przywracające dostępność usługi dla klientów bez konieczności trwałego usunięcia błędu w kodzie.
Workaround – Operational Workaround – obejście awaryjne; Tymczasowa zmiana procedury lub konfiguracji omijająca uszkodzony komponent systemowy.
Rollback – Software and Config Rollback – wycofanie kodu i konfiguracji; Powrót do poprzedniej wersji artefaktu za pomocą procedury git revert lub przełączenia symlinka.
Hotfix – Emergency Production Hotfix – awaryjna łatka produkcyjna; Szybka modyfikacja kodu wdrażana poza standardowym cyklem wydań w celu odblokowania usługi.
Failover – Automated Cluster Failover – automatyczne przełączenie awaryjne; Skierowanie ruchu do zapasowego centrum danych w celu ominięcia uszkodzonej infrastruktury.

12/55 Weryfikacja po awarii
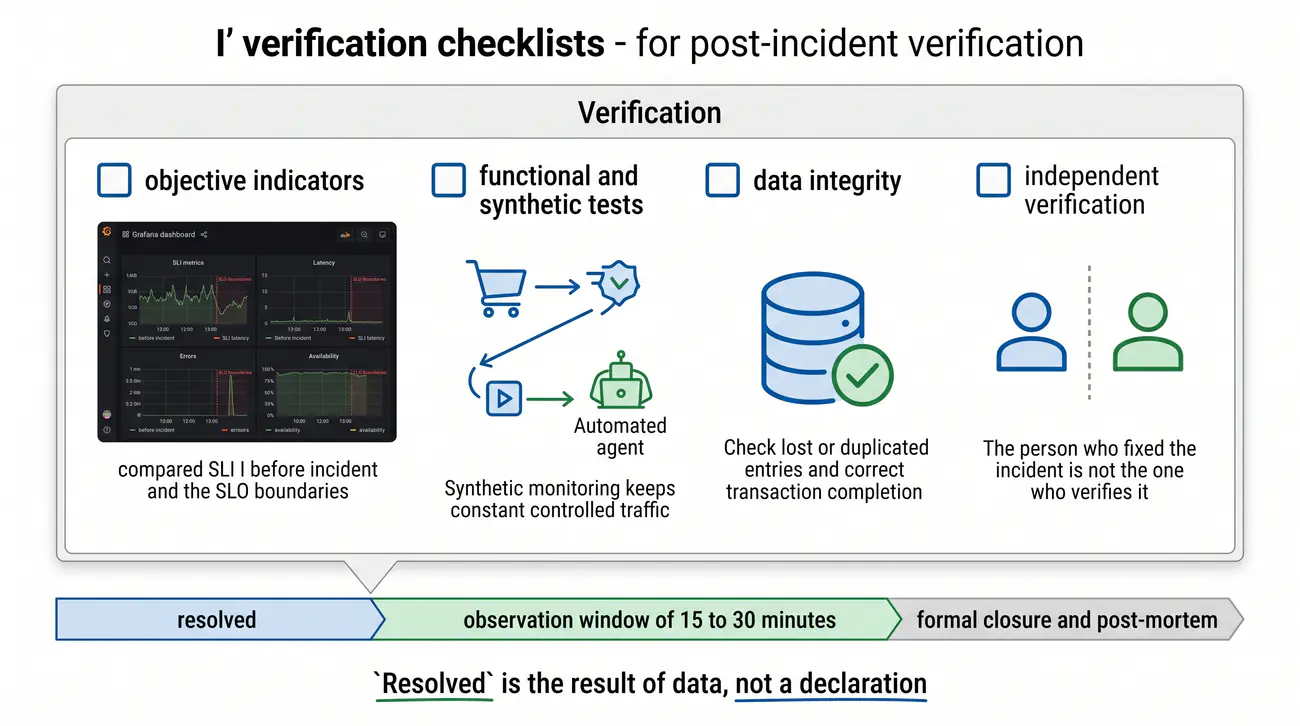
Verification (weryfikacja po awarii): Potwierdzenie, że usługa działa poprawnie, oparte na obiektywnych wskaźnikach, nie wrażeniach: metryki SLI/SLO (wykład 2), testy funkcjonalne i syntetyczne, monitoring po naprawie (15-30 min). Osoba naprawiająca ≠ osoba weryfikująca. Bez weryfikacji incydent łatwo się powtarza.

„Chyba działa” to za mało: weryfikuj danymi, testami i obcą parą oczu. Bez tego incydent wraca.

  • Metodyczne stawianie hipotez – diagnozowanie awarii polega na formułowaniu przypuszczeń i ich szybkiej weryfikacji w metrykach i logach.
  • Korelacja czasowa zdarzeń – zestawienie nagłego skoku opóźnień z błędami w logach z tego samego ułamka sekundy ułatwia wykrycie usterki.
  • Weryfikacja ostatnich wdrożeń – analiza zmian w kodzie i konfiguracji jest pierwszym krokiem dochodzenia, gdyż zmiany są głównym źródłem awarii.
  • Koniec z chaotycznym zgadywaniem – inżynierowie zastępują nerwowe próby chłodną analizą twardych danych telemetrycznych z platformy.
  • Precyzyjna izolacja modułu – zawężenie poszukiwań do konkretnego mikroserwisu oszczędza cenny czas i pozwala dobrać właściwą naprawę.
Rozdział ról naprawa/weryfikacja: Naprawiający to nie weryfikujący; obiektywne SLI/SLO, testy i 15-30 min monitoringu, inaczej incydent wraca.
weryfikacja

Weryfikacja po awarii potwierdza, że usługa rzeczywiście działa poprawnie po wdrożeniu działań naprawczych; bywa pomijana lub wykonywana pobieżnie, co jest jednym z częstszych błędów - incydent uznany za "rozwiązany" na podstawie subiektywnego wrażenia może się szybko powtórzyć, gdy przyczyna źródłowa nie została do końca usunięta. Weryfikację warto oprzeć na obiektywnych wskaźnikach powiązanych ze SLO: sprawdzić metryki poziomu usług (SLI), wykonać testy funkcjonalne i syntetyczne przechodzące przez kluczowe ścieżki użytkownika oraz monitorować system jeszcze przez pewien czas po naprawie, aby wychwycić ewentualne nawroty. Dopiero pozytywna weryfikacja uprawnia do ogłoszenia "resolved" i zamknięcia incydentu.

Kluczową zasadą jest oddzielenie weryfikacji od samej naprawy - osobę naprawiającą (lub przynajmniej proces) należy poddać niezależnemu sprawdzeniu. Oznacza to m.in., że metryki monitorujemy w dedykowanym dashboardzie, a nie pamiętając tylko, że „wartości się ustabilizowały”. W praktyce wykorzystujemy tu narzędzia obserwowalności (Grafana, Prometheus, Loki) do porównania wartości z okresem sprzed awarii i z granicami SLO, oraz systemy testowania syntetycznego, które emitują ruch testowy dokładnie przez ścieżki, które zawiodły (np. checkout koszyka zakupowego przy awarii płatności). Weryfikacja integralności danych - np. spójności bazy danych po awarii - jest równie istotna, szczególnie w systemach transakcyjnych, gdzie mogły wystąpić utracone lub zduplikowane wpisy.

Po pozytywnej weryfikacji incydent przechodzi do etapu „resolved/monitoring”, gdzie usługa jest nadal obserwowana przez określony czas (np. 15-30 minut), a zespół pozostaje w trybie gotowości na wypadek nawrotu. Dopiero po tym momencie można zakończyć incydent formalnie (closure) i przejść do analizy przyczyn oraz przygotowania post-mortem. Warto pamiętać, że weryfikacja i późniejsze monitorowanie po awarii to również element kultury blameless - zamiast ogłaszać tryumf, traktujemy rozwiązanie jako hipotezę, którą trzeba jeszcze potwierdzić w warunkach produkcyjnych. Terminologia: verification (weryfikacja), post-incident monitoring (monitoring po awarii), resolved/closed status, synthetic testing, data integrity (integralność danych).

Wyjaśnienie skrótów użytych na slajdzie:
SmokeTest – Post-deployment Smoke Test – test dymny weryfikacji; Zestaw podstawowych testów weryfikujących poprawność działania kluczowych funkcji po wdrożeniu mitygacji.
Canary – Canary Traffic Verification – kanarkowa weryfikacja ruchu; Stopniowe wpuszczanie ruchu użytkowników (np. 5%) w celu potwierdzenia stabilności nowej konfiguracji.
SLI – Service Level Indicator – wskaźnik poziomu usług; Główny parametr weryfikacyjny: incydent uważa się za zażegnany dopiero wtedy, gdy SLI powróci do normy.
HealthCheck – System Health Check Probes – sondy kontroli kondycji; Automatyczne testy sprawdzające poprawność odpowiedzi punktów końcowych aplikacji.
Metrics – Telemetry Metrics Dashboard – pulpit metryk telemetrycznych; Wizualne potwierdzenie na wykresach powrotu latencji i liczby błędów do poziomu sprzed awarii.

13/55 Dokumentacja incydentu
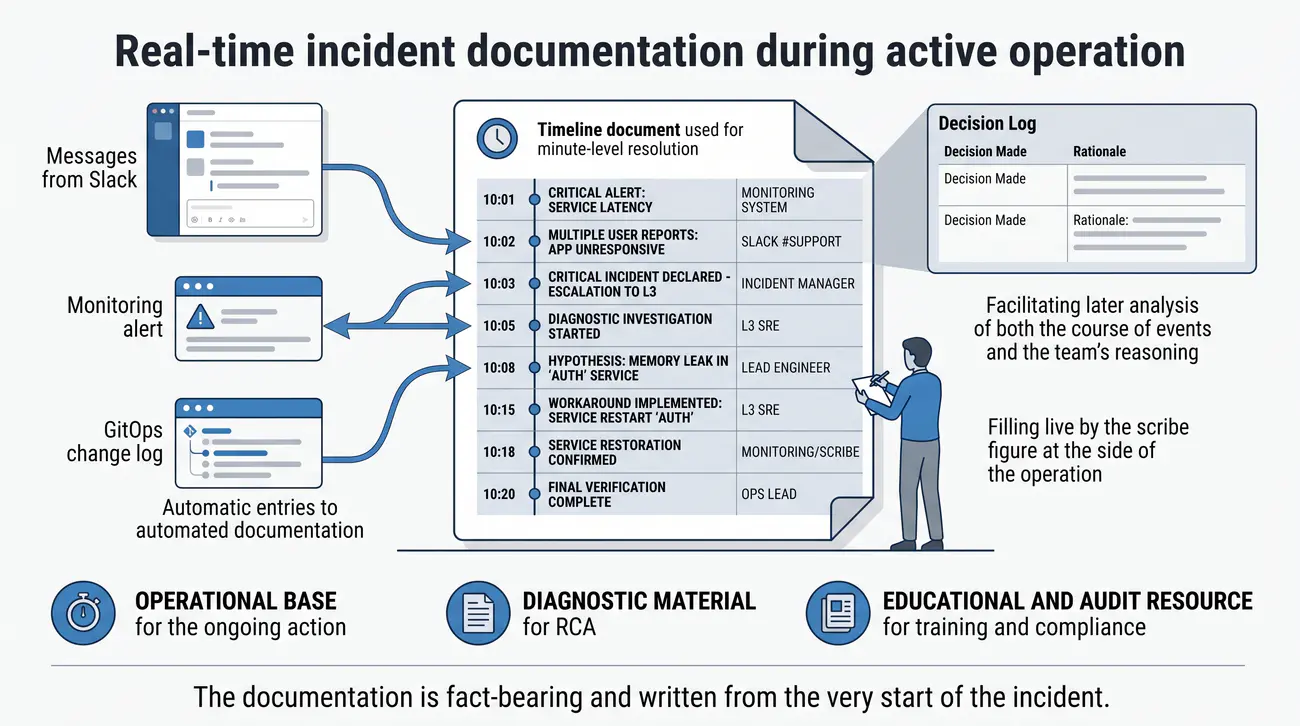
Dokumentacja incydentu: Systematyczny zapis prowadzony W trakcie awarii (nie po niej!): oś czasu (timeline) z timestampami, wykonane działania, decyzje i ich uzasadnienia (decision log), obserwacje. Produkt: pełny log incydentu - baza dla RCA, post-mortem i szkoleń. Dokumentujemy „na żywo", z rozdzielczością minutową.

Pisz w trakcie, nie po: oś czasu, decyzje i obserwacje na żywo. Po awarii jest za późno na pamięć.

  • Pierwszeństwo mitygacji – nadrzędnym celem inżynierów podczas pożaru jest mitygacja, czyli jak najszybsze przywrócenie działania usługi.
  • Obejście zamiast poprawki – mitygacja polega na przywróceniu sprawności, na przykład wycofaniem wersji, bez dociekania detali błędu.
  • Unikanie debugowania w pożarze – pisanie łatek w kodzie źródłowym w trakcie awarii krytycznej niepotrzebnie wydłuża czas niedostępności.
  • Spokojna analiza po naprawie – dopiero po upewnieniu się, że klienci mogą korzystać z platformy, zespół przechodzi do badania przyczyn usterki.
  • Filozofia ochrony biznesu – zasada ta stanowi rdzeń podejścia SRE i drastycznie ogranicza straty finansowe ponoszone przez przedsiębiorstwo.
Decision log: Dziennik decyzji z uzasadnieniami; z osią czasu, działaniami i obserwacjami na żywo - baza RCA, post-mortem i szkoleń.
dokumentacja

Dokumentacja incydentu to systematyczny zapis zdarzeń prowadzony w trakcie awarii, nie po jej zakończeniu: uchwycenie osi czasu (timeline) ze znacznikami czasu, notatek o wykonanych działaniach, podjętych decyzjach oraz obserwacjach i zależnościach między nimi. Produktem jest pełny log incydentu, który po awarii stanowi bazę dla analizy przyczyn źródłowych (RCA), post-mortem i szkolenia zespołu; najważniejszą zasadą jest dokumentowanie "na żywo" - trudno odtworzyć kolejność zdarzeń z pamięci po kilku godzinach, a pełny bieżący zapis jest też bardziej wiarygodny. Szczególnie cenny jest zapis samych decyzji i ich uzasadnień ("decision log"), bo pozwala ocenić nie tylko co się stało, ale również dlaczego zespół działał w danym kierunku.

Oś czasu (timeline) jest sercem każdej dokumentacji incydentu. Powinna zawierać wpisy o minutowej lub nawet sekundowej rozdzielczości: moment wystąpienia alertu, moment zgłoszenia użytkownika, chwilę eskalacji, rozpoczęcie diagnozy, postawienie pierwszej hipotezy, wdrożenie workaround, moment przywrócenia usługi i moment weryfikacji. Ważne jest, aby nie łączyć wpisów w całość z późniejszej perspektywy - najlepiej, aby skryba (scribe) zapisywał fakty tak, jak się dzieją, w formie „czas - zdarzenie - źródło informacji”. W dojrzałych organizacjach automatyczne mechanizmy pomagają utrzymywać oś czasu: wpisy z komunikatora, alerty z systemu sterowania, logi zmian w GitOps (kto i kiedy zmienił manifest) - wszystko to w późniejszej analizie może być ze sobą skorelowane.

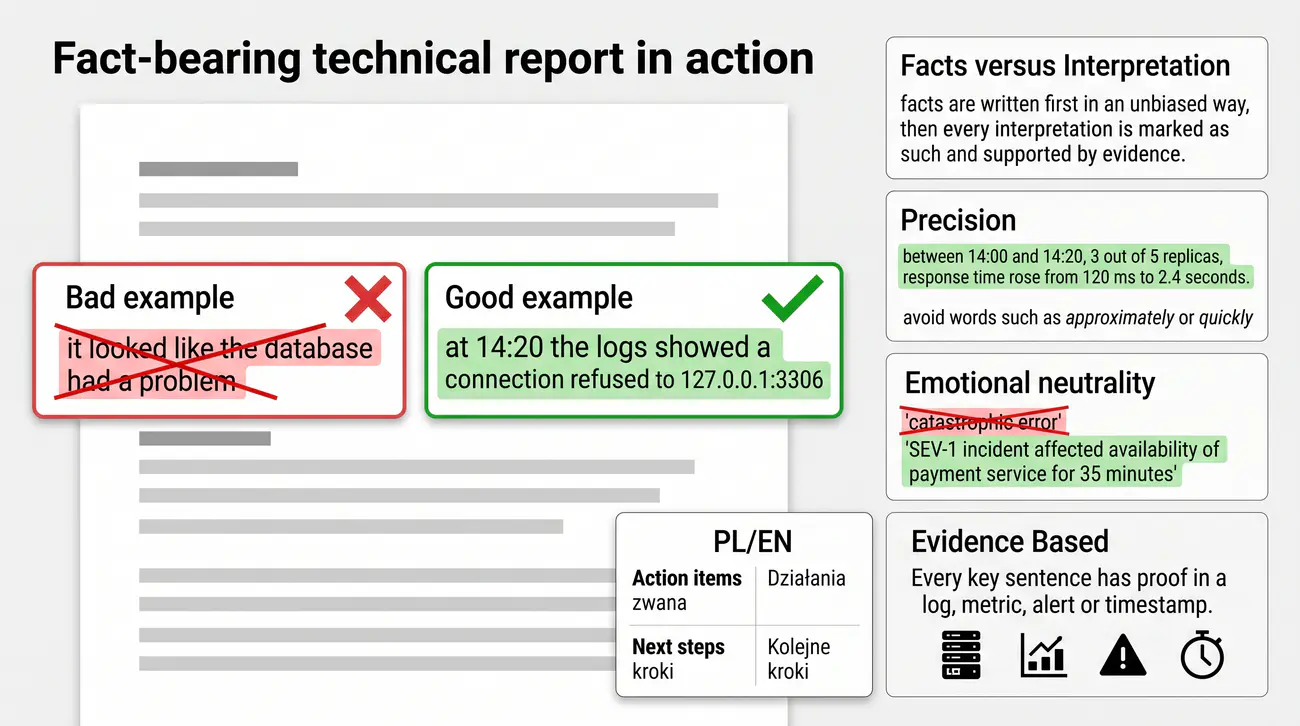
Dobra dokumentacja incydentu pełni trzykrotną funkcję: operacyjną (baza dla bieżącej akcji), diagnostyczną (materiał do RCA), oraz edukacyjną i auditingową (zgody organizacyjne, szkolenia, potwierdzenie zgodności z procedurami). Przy dokumentowaniu warto stosować się do zasad: nie pomijać małych zdarzeń (mogą okazać się kluczowe), notować zgłoszenia i decyzje bez emocji (fact-bearing), oraz konsekwentnie prowadzić wpisy od początku incydentu. Po zakończeniu awarii dokumentacja jest przeglądana i porządkowana w postaci czytelnego logu, który staje się początkową sekcją raportu post-mortem. Terminologia: incident timeline (oś czasu incydentu), incident log (dziennik incydentu), decision log (dziennik decyzji), scribe, timestamp (znacznik czasu), fact-bearing (oparty na faktach).

Wyjaśnienie skrótów użytych na slajdzie:
Timeline – Chronological Incident Timeline – chronologiczna oś czasu zdarzeń; Precyzyjny zapis kolejnych etapów awarii prowadzony w czasie UTC na potrzeby raportu.
UTC – Coordinated Universal Time – uniwersalny czas koordynowany; Jednolity standard zapisu czasu eliminujący chaos stref czasowych w zespołach rozproszonych.
Audit – Regulatory Audit Documentation – dokumentacja audytu regulacyjnego; Zbiór dowodów operacyjnych wymagany przez zewnętrzne instytucje kontrolne i ubezpieczycieli.
ChatLog – Incident War Room Chat Log – zapis czatu pokoju kryzysowego; Transkrypcja dyskusji technicznej inżynierów stanowiąca surowy materiał do analizy poawaryjnej.
IncidentReport – Formal Incident Report – formalny raport z incydentu; Oficjalny dokument podsumowujący przyczyny, przebieg i straty wywołane awarią produkcyjną.

14/55 Analiza przyczyn źródłowych (RCA)
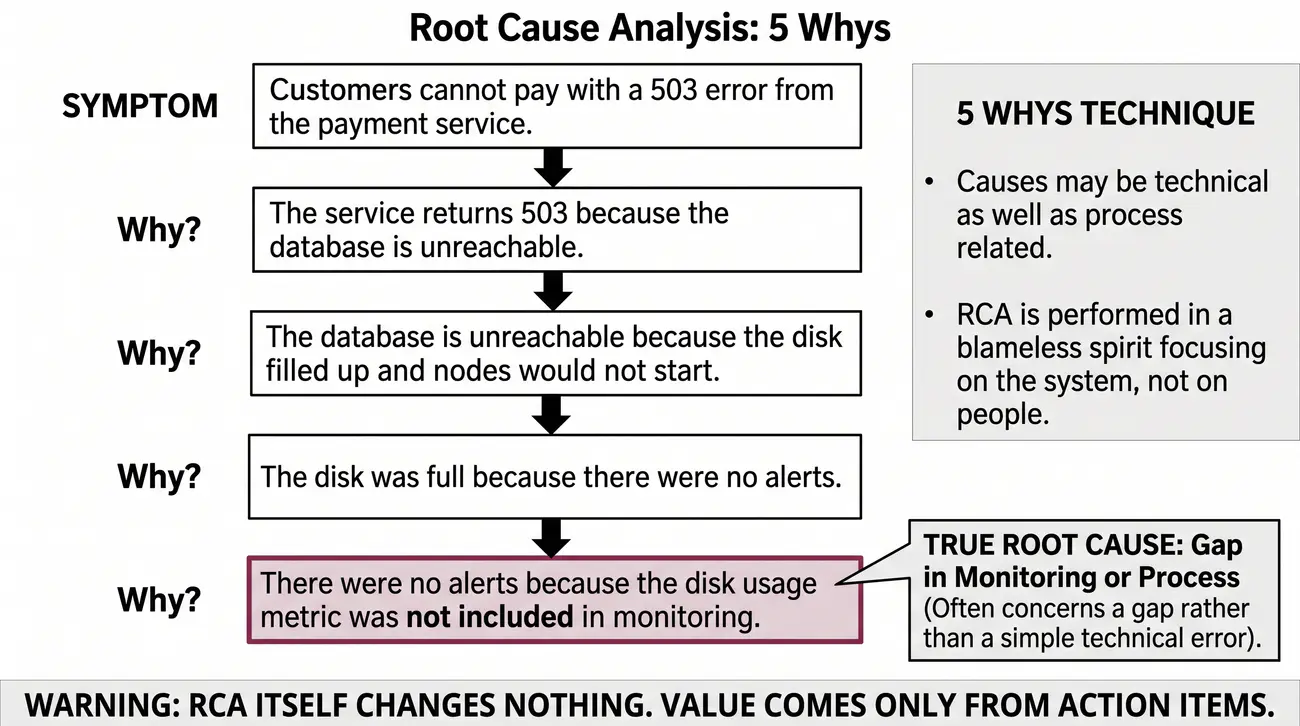
Root Cause Analysis (RCA): Systematyczne dochodzenie do przyczyny źródłowej - takiej, której usunięcie zapobiegnie nawrotowi. Technika 5 Whys: pytamy „dlaczego?" warstwa po warstwie (zwykle 5×), aż dotrzemy od objawów do źródła. Ważne: przyczyny mogą być techniczne, ale też procesowe (brak alertu, nieaktualny runbook, luka w monitoringu). RCA w duchu blameless - skupiamy się na systemie, nie na osobach.

RCA pyta, dlaczego w ogóle się stało - i szuka przyczyny, której usunięcie zapobiegnie powrotowi.

  • Wycofanie zmian git revert – podstawową techniką mitygacji w GitOps jest natychmiastowe odwrócenie commita i powrót do stabilnej wersji.
  • Restart zawieszonych podów – zrestartowanie procesów lub węzłów pozwala szybko przywrócić sprawność w sytuacjach wycieków pamięci RAM.
  • Przełączenie ruchu Failover – skierowanie zapytań do zapasowego centrum danych ratuje platformę w przypadku fizycznej awarii sprzętu lub łącza.
  • Ograniczanie przepustowości Rate Limiting – restrykcyjne limity na brzegu sieci chronią serwery wewnętrzne przed zalewem nadmiernego ruchu.
  • Wyłączenie funkcji degradacja – świadome wygaszenie mniej ważnych modułów pozwala ocalić kluczowe procesy w krytycznym przeciążeniu.
5 Whys: Pięć razy „dlaczego?” od objawów do źródła; przyczyny techniczne i procesowe, w duchu blameless - na system, nie na ludzi.
RCA

W złożonych architekturach teleinformatycznych rzadko występuje pojedyncza przyczyna awarii (Root Cause). Tradycyjna metoda 5 Whys musi być uzupełniona o wieloczynnikowy diagram rybiej ości (diagram Ishikawy) oraz analizę drzewa błędów (Fault Tree Analysis). Zdarzenie awaryjne dekomponuje się na sześć wymiarów: oprogramowanie (defekt w kodzie), infrastruktura (awaria łącza/sprzętu), procesy (brak bramki testowej w CI), ludzie (przemęczenie nocnym dyżurem), procedury (nieaktualny runbook) oraz środowisko (nagły skok ruchu zewnętrznego).

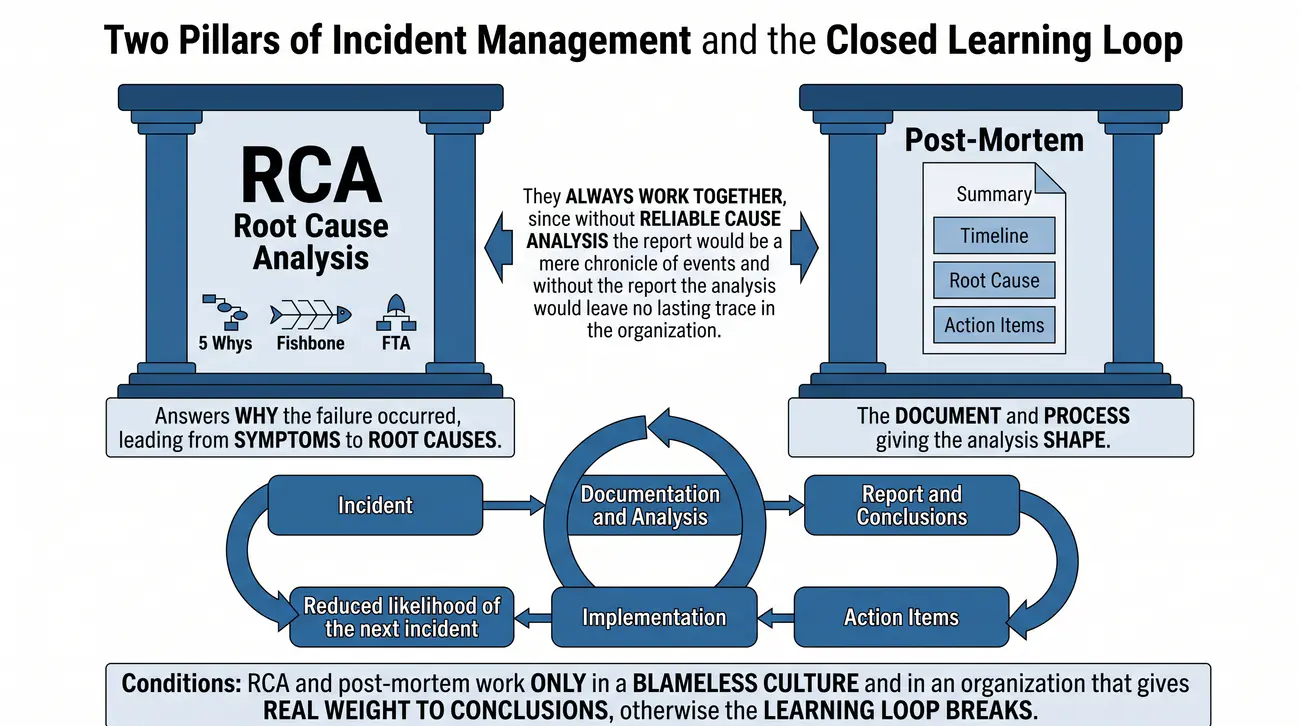
Analiza przyczyn źródłowych (Root Cause Analysis - RCA) wykonywana po incydencie odpowiada na pytanie "dlaczego ten incydent w ogóle miał miejsce?": to systematyczne dochodzenie zmierzające do znalezienia przyczyn (przyczyn) źródłowych, czyli takich, których usunięcie zapobiegnie nawrotowi problemu. Możliwych przyczyn jest zwykle wiele i nie wszystkie mieszczą się w warstwie technicznej - błąd w kodzie, ale równie dobrze nieaktualny runbook, luka w monitoringu, złe procedury wdrożeniowe czy błąd komunikacyjny w zespole. Dlatego skuteczna RCA odbywa się w duchu blameless - skupia się na systemie i procesie, nie na osobach.

Najbardziej znaną techniką RCA jest metoda 5 Whys, polegająca na wielokrotnym zadawaniu pytania „dlaczego?” - w standardowej praktyce pięć razy - za każdym razem wchodząc o jedną warstwę głębiej. Przykładowy łańcuch: (1) „Dlaczego klienci nie mogą płacić?” - „Bo usługa płatności odpowiada błędem 503.” (2) „Dlaczego odpowiada 503?” - „Bo połączyła się z bazą danych, która była nieosiągalna.” (3) „Dlaczego baza była nieosiągalna?” - „Bo węzły klastra się nie restartowały po przepełnieniu dysku.” (4) „Dlaczego dysk się przepełnił?” - „Bo zabrakło alertów na stopień wypełnienia dysku.” (5) „Dlaczego brakowało alertów?” - „Bo metryka użycia dysku nie była uwzględniona w monitoringu.” Jak widać, prawdziwa przyczyna źródłowa dotyczy często braku w monitoringu czy procesie, a nie prostego błędu technicznego. Metodę 5 Whys stosuje się do problemów stosunkowo prostych, gdzie przyczyna wynika z jednego, linearnego łańcucha przyczyn.

Warto pamiętać o ograniczeniach RCA: po pierwsze, nie zawsze istnieje jedna przyczyna źródłowa - wiele awarii wynika ze współdziałania wielu czynników (np. połączenia drobnych błędów), dlatego stosujemy wtedy techniki takie jak diagram Ishikawy czy FTA, które opisujemy na następnym slajdzie. Po drugie, wysiłek włożony w RCA powinien być proporcjonalny do wagi incydentu - analiza pełnowartościowa to etap po przywróceniu usługi, nie zaś w trakcie jej trwania. Po trzecie, RCA sama w sobie nic nie zmienia - dokumentuje przyczyny, ale wartość przynoszą dopiero wynikające z niej action items. Dlatego w nowoczesnym SRE mówi się raczej o „build learning without blame”, łącząc RCA z post-mortem i kulturą blameless. Terminologia: root cause analysis (analiza przyczyn źródłowych), root cause (przyczyna źródłowa), 5 Whys (5 x dlaczego), contributing factors (czynniki współprzyczyniające się), corrective actions (działania naprawcze).

Wyjaśnienie skrótów użytych na slajdzie:
RCA – Root Cause Analysis – analiza przyczyn źródłowych; Dyscyplina inżynierska poszukująca systemowych słabości architektury leżących u podstaw incydentu.
5Whys – Five Whys Diagnostic Technique – technika pięciu dlaczego; Metoda wielokrotnego zadawania pytania 'dlaczego' w celu dotarcia do źródła problemu.
Ishikawa – Ishikawa Fishbone Diagram – diagram rybiej ości Ishikawy; Narzędzie graficzne dekomponujące przyczyny awarii na kategorie ludzi, procesów, sprzętu i metod.
FTA – Fault Tree Analysis – analiza drzewa błędów; Dedukcyjna metoda analizy niezawodności odwzorowująca logiczne relacje pomiędzy uszkodzeniami.
HumanError – Human Error Illusion – złudzenie błędu ludzkiego; Błędne założenie, że winę ponosi człowiek; w SRE uważa się, że system powinien być odporny na pomyłki.

15/55 Techniki RCA
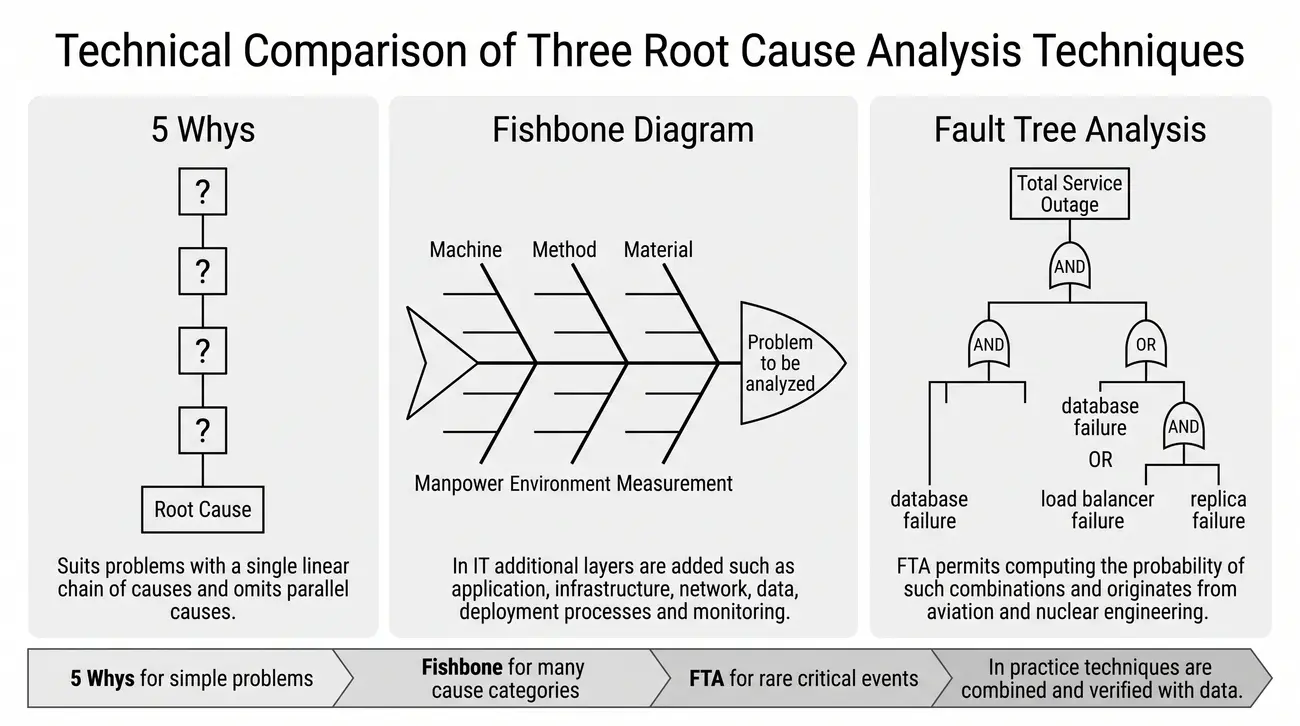
Trzy techniki RCA: 1) 5 Whys - pionowe drążenie jednej przyczyny (proste problemy). 2) Diagram Ishikawy (fishbone) - równoległe badanie wielu kategorii przyczyn (6M: Maszyna, Metoda, Materiał, Człowiek, Środowisko, Pomiar). 3) Fault Tree Analysis (FTA) - model logiczny bramek AND/OR dla złożonych, krytycznych awarii. Wybór techniki zależy od złożoności problemu.

Trzy narzędzia do przyczyn: 5 Whys na proste, fishbone na wiele, FTA na krytyczne. Łącz je i weryfikuj danymi.

  • Weryfikacja parametrów platformy – po wykonaniu kroków mitygacyjnych zespół musi upewnić się, że telemetria faktycznie powróciła do normy.
  • Stabilizacja wykresów SLO – poziomy błędów oraz czasy odpowiedzi serwisu powinny opaść do bezpiecznych, zadeklarowanych wartości.
  • Automatyczne testy dymne – wykonanie scenariuszy testowych potwierdza poprawność działania kluczowych ścieżek zakupu i logowania klientów.
  • Kilkanaście minut obserwacji – inżynierowie powinni monitorować stan platformy przez pewien czas przed ogłoszeniem zakończenia kryzysu.
  • Ochrona przed nawrotem awarii – pospieszne odwołanie alarmu bez rzetelnego sprawdzenia grozi ponownym wybuchem pożaru w systemie.
Diagram Ishikawy (fishbone): Równoległe badanie kategorii 6M (maszyna, metoda, materiał, człowiek, środowisko, pomiar); FTA to bramki AND/OR dla krytycznych awarii.
diagram Ishikawy

Wielowymiarowa analiza RCA (diagram Ishikawy i drzewo błędów) zapobiega powierzchownemu przypisaniu winy pojedynczemu czynnikowi, ujawniając splot uwarunkowań systemowych, organizacyjnych i technologicznych.

Techniki analizy przyczyn źródłowych (RCA tools) dobiera się do charakteru problemu, bo metoda 5 Whys nie jest jedynym narzędziem - a dla złożonych awarii często nie jest najbardziej odpowiednim. Trzy podstawowe techniki to 5 Whys (pionowe drążenie jednej przyczyny), diagram Ishikawy, zwany też fishbone lub diagramem rybiej ości (badanie wielu możliwych kategorii przyczyn jednocześnie) oraz analiza drzewa błędów FTA (Fault Tree Analysis), modelująca logiczne zależności między błędami elementarnymi a awarią systemu; wybór zależy od liczby potencjalnych przyczyn i złożoności systemu.

Diagram Ishikawy (fishbone) bada przyczyny równolegle w kilku kategoriach. Klasyczny podział obejmuje 6M: Maszyna (Machine), Metoda (Method), Materiał (Material), Człowiek (Manpower), Środowisko (Mother Nature/Environment) oraz Pomiar (Measurement), a w układach informatycznych często dodaje się takie kategorie jak Warstwa aplikacji, Infrastruktura, Sieć, Dane, Procesy wdrożeniowe, Monitoring. Przy osi ryby rysujemy problem (np. „czasami występuje błąd 500 na przelewie”), a następnie w każdym z „żebr” zapisujemy wszystkie możliwe przyczyny w danej kategorii. Takie podejście gwarantuje, że nie skupimy się wyłącznie na najbardziej oczywistej przyczynie technicznej, lecz eksplorujemy także przyczyny procesowe i organizacyjne. Po wygenerowaniu wszystkich potencjalnych przyczyn grupuje się je i weryfikuje danymi (metryki, logi), aby wybrać te najprawdopodobniejsze.

Fault Tree Analysis (FTA) to technika wywodząca się z inżynierii lotniczej i jądrowej, polegająca na formalnym modelowaniu awarii jako wyniku kombinacji zdarzeń elementarnych połączonych bramami logicznymi AND/OR. Tworzymy drzewo, którego korzeniem jest badana awaria (np. „całkowita niedostępność usługi”), a gałęziami kolejne przyczyny: awaria bazy danych LUB awaria równoważenia ruchu I jednoczesna awaria repliki. FTA pozwala określić, które kombinacje elementarnych błędów prowadzą do katastrofy, oraz obliczyć prawdopodobieństwo wystąpienia przy założonych prawdopodobieństwach zdarzeń bazowych. Jest więc szczególnie przydatna do analizy zdarzeń rzadkich, ale bardzo krytycznych, oraz do projektowania systemów odpornych pojedynczo na awarie (single points of failure). Terminologia: fishbone diagram / diagram Ishikawy, fault tree analysis (FTA), 5 Whys, contributing factors, OR/AND logic gates, single point of failure.

Wyjaśnienie skrótów użytych na slajdzie:
5Whys – Five Whys Root Cause Exploration – metoda dociekania 5 Whys; Praktyczne narzędzie dociekania luk proceduralnych opracowane przez Sakichiego Toyodę.
Ishikawa – Cause and Effect Fishbone Diagram – diagram przyczynowo-skutkowy; Wieloczynnikowa analiza zapobiegająca przedwczesnemu zakończeniu dochodzenia poawaryjnego.
Fishbone – Fishbone Analysis Method – metoda analizy rybiej ości; Kategoryzacja defektów ułatwiająca identyfikację słabości w automatyzacji i testach.
FTA – Fault Tree Analysis in Engineering – drzewo niezawodnościowe FTA; Sformalizowany graf bramek logicznych (AND, OR) modelujący sekwencję załamania systemu.
FMEA – Failure Mode and Effects Analysis – analiza rodzajów i skutków zdatności; Proaktywna metoda oceny ryzyka wystąpienia usterki stosowana przed wdrożeniem zmian.

16/55 Post-mortem (wprowadzenie)
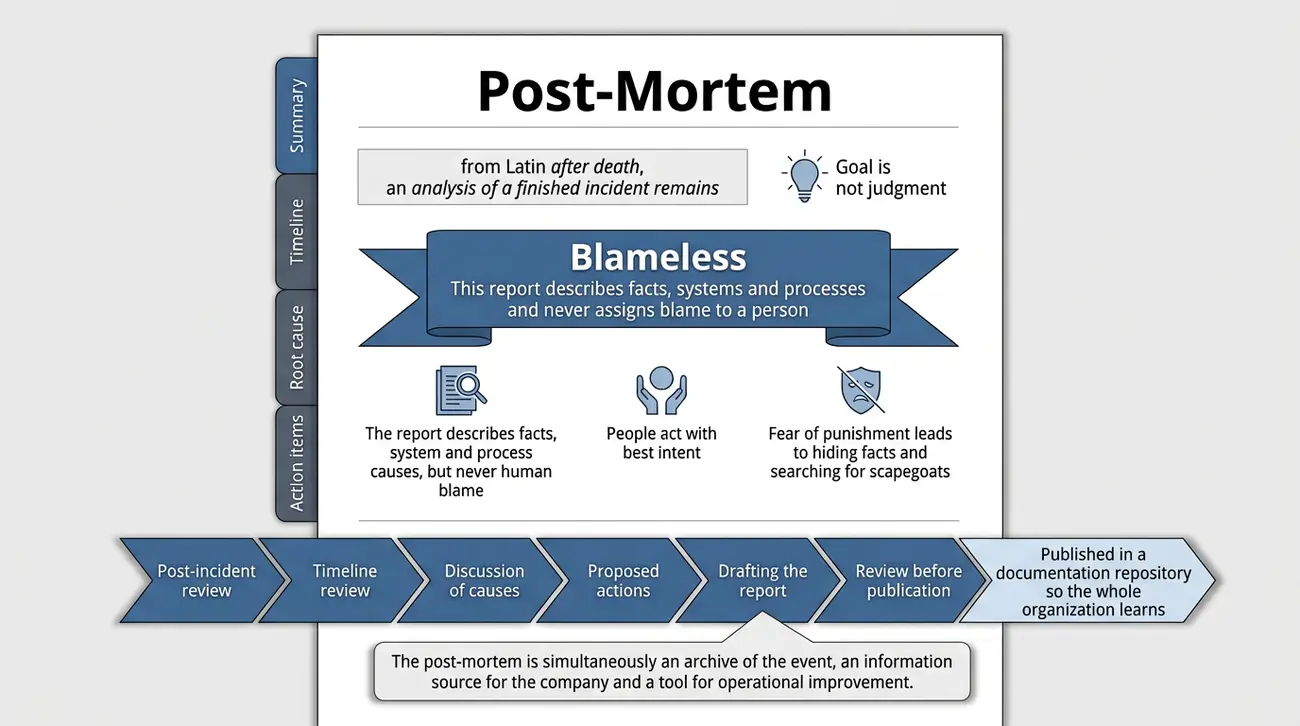
Post-mortem (blameless): Formalny raport po incydencie: podsumowuje przebieg zdarzenia, identyfikuje przyczyny źródłowe (RCA) i proponuje konkretne działania zapobiegawcze (action items z owner i due date). Nazwa z łaciny „po śmierci" - analiza zakończonej awarii. Klucz: raport jest blameless - opisuje fakty, systemy i procesy, nigdy nie wskazuje winy człowieka. Cel: nauka, nie osąd.

Post-mortem to nauka, nie nekrolog: fakty, przyczyny i działania, żeby ten sam błąd nie wrócił.

  • Formalne zakończenie akcji – dowódca rozwiązuje sztab kryzysowy w momencie, gdy stabilność platformy została potwierdzona telemetrią.
  • Podziękowanie i zamknięcie kanału – lider dziękuje inżynierom za zaangażowanie, porządkuje dokumentację i zamyka dedykowany pokój awaryjny.
  • Komunikat na stronie statusu – oficer łącznikowy publikuje oficjalną notatkę potwierdzającą pełne przywrócenie sprawności usług firmy.
  • Wyznaczenie terminu post-mortem – dowódca ustala datę spotkania analizy powypadkowej oraz wyznacza autora wstępnego szkicu raportu.
  • Czas na odpoczynek i regenerację – sprawne domknięcie procedury operacyjnej pozwala dyżurnym inżynierom odpocząć po wyczerpującej akcji.
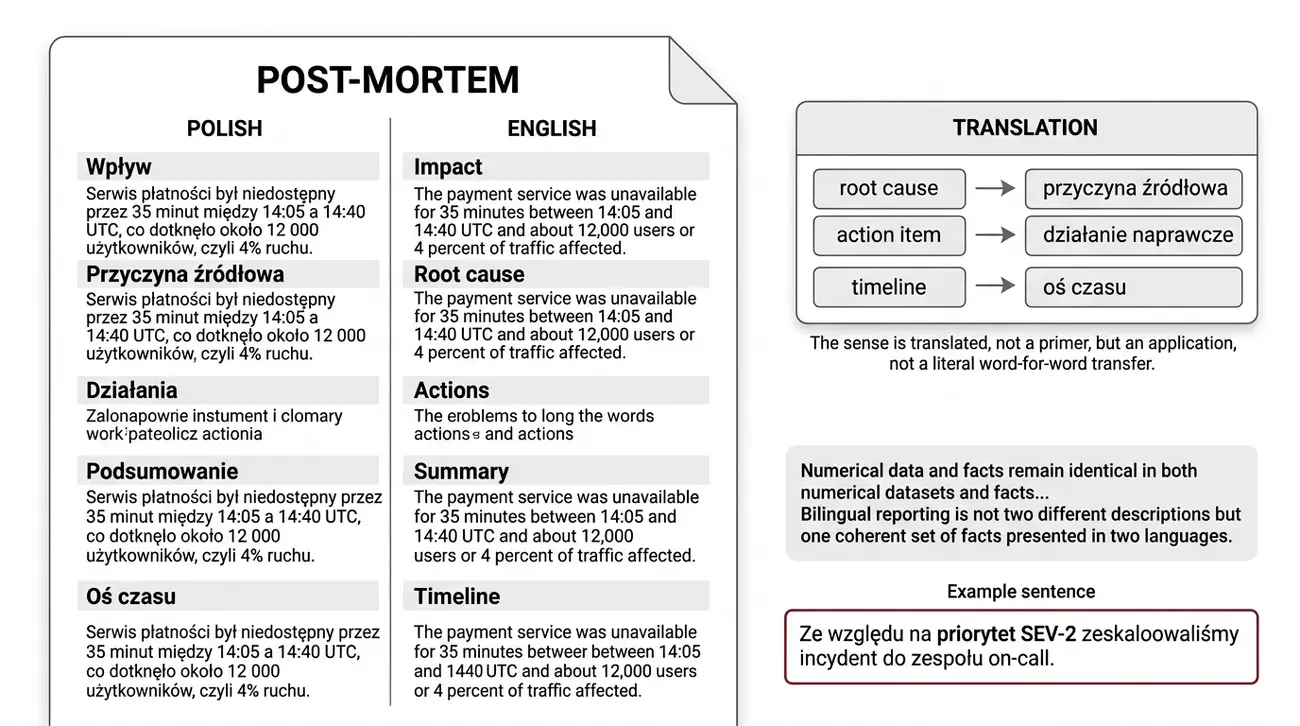
Post-mortem (łac. „po śmierci”): Formalny raport po zakończonej awarii: przebieg, przyczyny (RCA) i zapobieganie (action items) - nauka, nie osąd.
post-mortem

Zgodnie z kanonem Google SRE: Postmortem Culture, błąd człowieka jest zawsze objawem głębszej niewydolności systemowej, a nie pierwotną przyczyną awarii. Karaniem inżynierów za pomyłki organizacja wymusza ukrywanie incydentów i paraliżuje rozwój. Raport poawaryjny zakłada dobrą wolę pracowników i skupia się na pytaniu: „jakie zabezpieczenia techniczne zawiodły, że pojedyncze działanie administratora doprowadziło do załamania klastra?”.

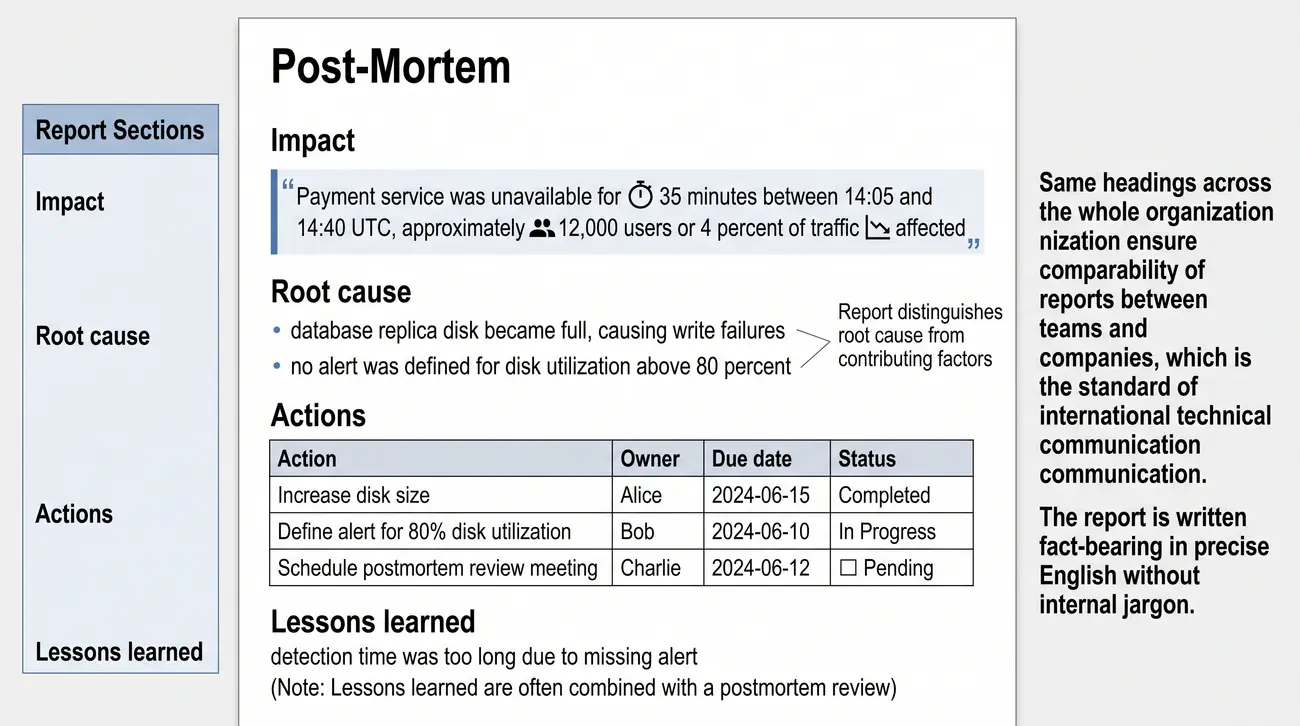
Post-mortem to najważniejszy produkt procesu zarządzania incydentem w modelu SRE: formalny raport tworzony po zakończeniu incydentu, który podsumowuje przebieg zdarzenia, identyfikuje przyczyny źródłowe (za pomocą technik RCA) oraz proponuje konkretne działania zapobiegawcze (action items). Nazwa wywodzi się z łaciny (dosłownie "po śmierci") i w kontekście technicznym oznacza analizę już zakończonej awarii, ale cel nie jest bynajmniej nekrologiczny - to nauka: organizacja ma wyciągnąć wnioski, naprawić system i procesy tak, aby ten sam błąd nie zdarzył się ponownie. Rolą post-mortem nie jest osąd, lecz doskonalenie - dokument jest jednocześnie archiwum zdarzenia, źródłem informacji dla organizacji i narzędziem działania operacyjnego.

W filozofii SRE post-mortem ma być blameless, czyli pozbawiony obwiniania (blameless post-mortem). Oznacza to, że dokument opisuje fakty, przyczyny systemowe i procesowe, ale nigdy nie wskazuje winy człowieka. Podstawowe założenie brzmi: ludzie działają zgodnie z najlepszą intencją i dostępną im wiedzą, a to, że doszło do błędu, jest najczęściej skutkiem luk w systemie, procesie lub narzędziach, a nie złośliwości czy niedbalstwa jednostki. Uznanie, że nie należy obarczać winą człowieka, jest warunkiem tego, aby członkowie zespołu mieli odwagę otwarcie opowiadać o swoich działaniach podczas incydentu - a bez uczciwego opisu zdarzeń niemożliwa jest rzetelna analiza. W kulturze, w której za błędy karze się ludzi, naturalną reakcją jest ukrywanie faktów i szukanie kozłów ofiarnych, co prowadzi do powtarzania tych samych awarii.

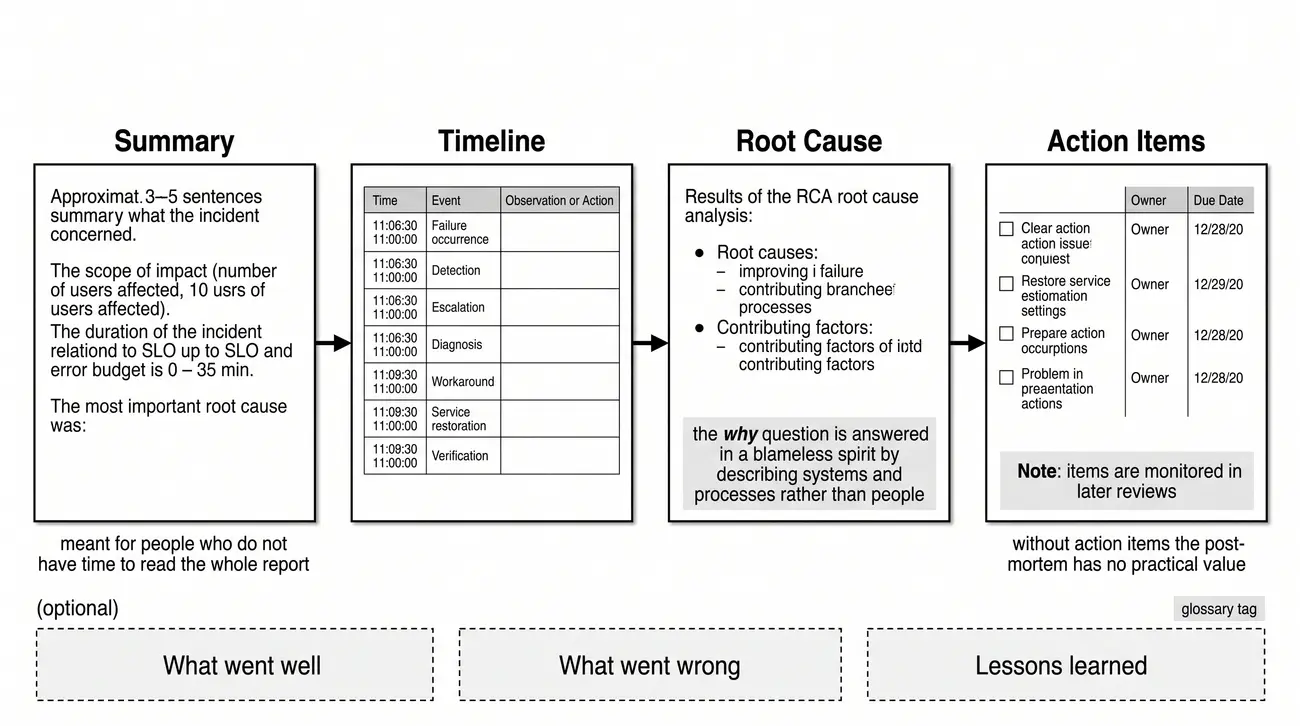
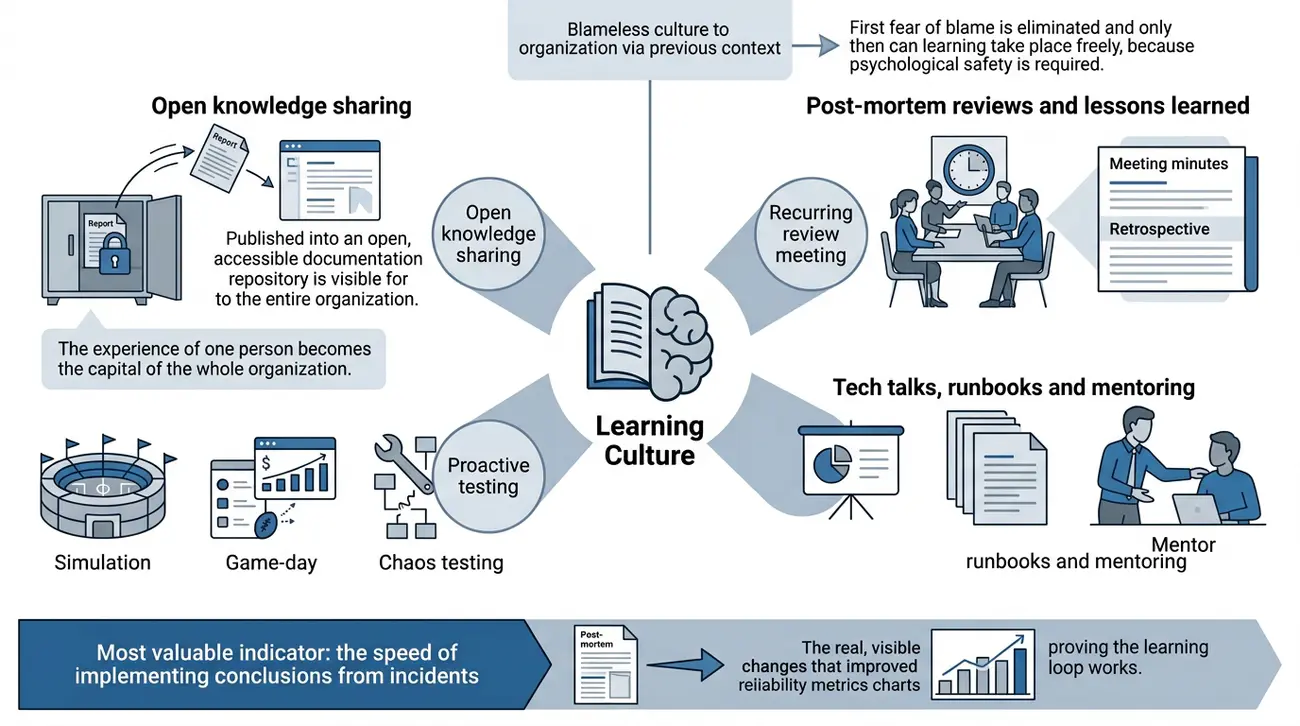
Proces przygotowania post-mortem ma stały rytm: krótko po zakończeniu incydentu organizowane jest spotkanie przeglądowe (post-incident review), podczas którego zespół przechodzi przez oś czasu, omawia przyczyny i proponuje działania. Raport powstaje następnie w oparciu o zebrany materiał i jest przeglądany przed publikacją. Dobrze napisany post-mortem ma jasną strukturę (omówioną na slajdzie 18), jest napisany fact-bearing i zawiera listę action items z przypisanymi właścicielami i terminami. W wielu firmach, które dbają o kulturę uczenia się, publikuje się post-mortemy w repozytorium dokumentacji, tak aby każdy mógł z nich skorzystać. Terminologia: postmortem / post-mortem, blameless post-mortem, post-incident review, RCA, action items, learning organization.

Wyjaśnienie skrótów użytych na slajdzie:
Post-mortem – Blameless Post-mortem Document – raport poawaryjny post-mortem; Ustrukturyzowany dokument inżynierski analizujący przebieg awarii i definiujący usprawnienia.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Praktyka traktująca każdy post-mortem jako bezcenną inwestycję w przyszłą stabilność platformy.
Learning – Organizational Learning from Failure – organizacyjne uczenie się na błędach; Transformacja trudnych doświadczeń awaryjnych w trwałe procedury i automatyzację.
ActionItems – Corrective Action Items – korygujące zadania naprawcze; Konkretne zobowiązania inżynierskie usuwające podatności wykazane w trakcie incydentu.
Retrospective – Incident Retrospective Session – retrospektywa poawaryjna; Spotkanie zespołu inżynierskiego analizujące przebieg akcji ratunkowej w atmosferze szacunku.

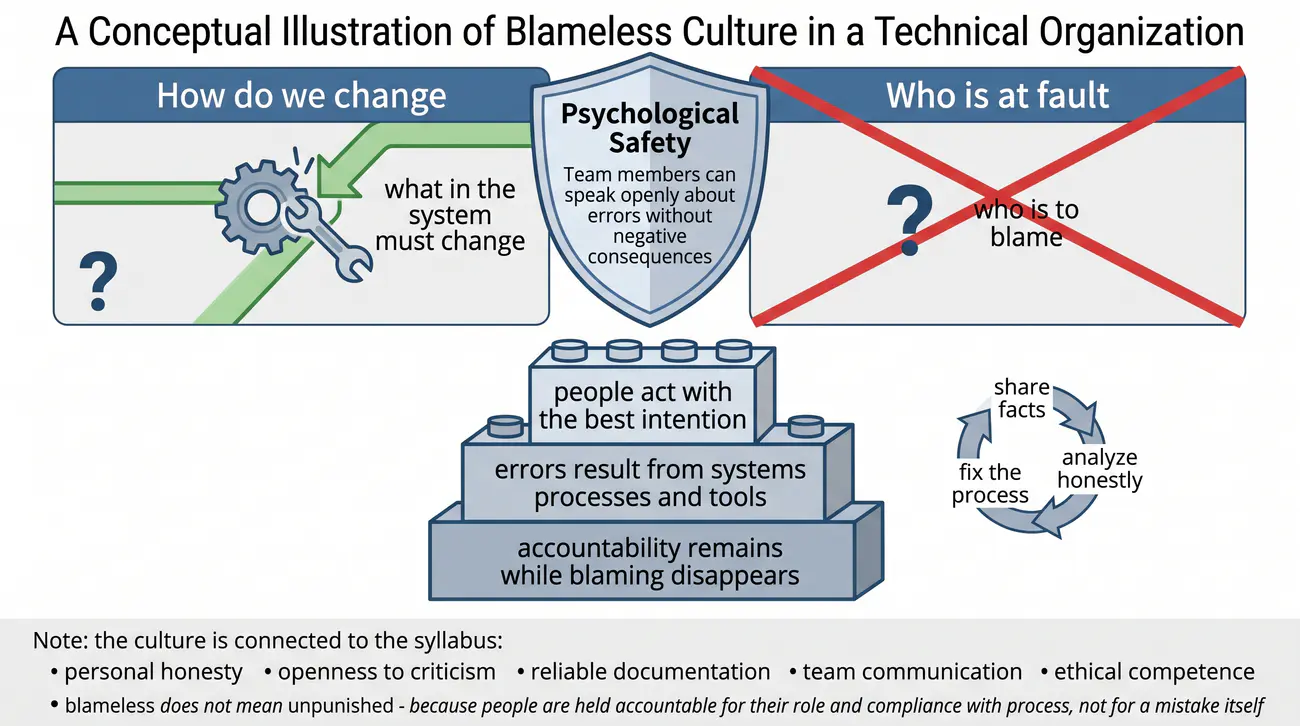
17/55 Kultura bez obwiniania
Blameless culture (kultura bez obwiniania): Ludzie działają zgodnie z najlepszą intencją; błędy wynikają z systemu, procesów i narzędzi, nie ze złej woli jednostek. Pytanie „co w systemie musi się zmienić?", nie „kto zawinił?". Wymaga psychological safety (bezpieczeństwa psychologicznego) - tylko wtedy zespół otwarcie dzieli się faktami i szybko się uczy. Odpowiedzialność (accountability) pozostaje, winienie - znika.

Większość błędów to wina systemu, nie ludzi. Zamień „kto zawinił” na „co zmienić” - i zadbaj o bezpieczeństwo mówienia.

  • Istota raportu powypadkowego – post-mortem to techniczny dokument opisujący przebieg usterki, jej przyczyny oraz wnioski na przyszłość.
  • Instytucjonalna nauka na błędach – celem raportu jest rzetelne wyciągnięcie lekcji z potknięcia i trwałe uodpornienie architektury na awarie.
  • Brak polowania na czarownice – dokument nie służy szukaniu winnych ani karaniu ludzi, lecz obiektywnej ocenie procedur i narzędzi IT.
  • Powszechny dostęp do wiedzy – raporty z awarii powinny być jawne wewnątrz firmy, stanowiąc bezcenną bazę wiedzy dla wszystkich zespołów.
  • Wyznacznik dojrzałości SRE – kultura regularnego sporządzania dokumentów post-mortem świadczy o wysokiej klasie inżynierskiej organizacji.
Psychological safety: Bezpieczeństwo psychologiczne umożliwiające otwartość; odpowiedzialność zostaje, winienie znika - pytanie o system, nie o winnego.
kultura

Bezpieczeństwo psychologiczne (Psychological Safety) oraz kultura Blameless stanowią fundament inżynierii niezawodności – błąd ludzki traktowany jest jako szansa na utwardzenie procedur i automatyzacji.

Kultura bez obwiniania (blameless / no blame) opiera się na fundamentalnym założeniu, że zdecydowana większość błędów w systemach wynika nie ze złej woli jednostek, lecz z niedoskonałości systemów, procesów i narzędzi, w których te jednostki pracują: ludzie działają zwykle zgodnie z najlepszą intencją, a ich zachowanie jest odpowiedzią na warunki - nieaktualną dokumentację, brak jasnych procedur, przeciążenie, opóźnienia w alertach. Poprawna kultura zmienia perspektywę z "kto zawinił?" na "co w systemie musi się zmienić, aby to się nie powtórzyło?" - taka zmiana nie jest tylko altruistyczna, jest skuteczniejsza w osiąganiu głównego celu, jakim jest niezawodność usług.

Kultura no blame ma bezpośredni wpływ na jakość danych, na których opiera się analiza przyczynowo-skutkowa. Inżynier, który wie, że za szczere opisanie swojego działania nie spotka go kara, będzie mówił prawdę o swoich decyzjach i błędach. Inżynier, który boi się kary, będzie minimalizować, ukrywać lub przesuwać odpowiedzialność na innych - a konsekwencją jest niekompletne lub zniekształcone źródło informacji w RCA. Tym samym organizacja, która kultywuje winnych, tkwi w błędnym kole powtarzających się awarii, nie wiedząc, dlaczego. Kluczowym pojęciem jest tu psychological safety (psychologiczne bezpieczeństwo) - przekonanie, że można mówić o błędach bez obawy o negatywne konsekwencje. Bez psychologicznego bezpieczeństwa blameless post-mortem pozostaje formą bez treści.

Ważne jest jednak, aby nie mylić kultury blameless z bezkarnością czy brakiem odpowiedzialności (accountability). Blameless nie oznacza, że nie pociąga się nikogo do rozliczeń - oznacza, że rozliczamy ludzi za ich rolę i zgodność z procesem, ale nie za fakt samej pomyłki. Kultura bez obwiniania współgra z kompetencjami etycznymi i współpracy (odniesienia K01, K03 z sylabusa): wymaga osobistej uczciwości, otwartości na krytykę, rzetelności w dokumentowaniu oraz umiejętności komunikacji zespołowej. W dobrze zaprojektowanej organizacji inspekcja po incydencie kończy się wnioskami systemowymi i działaniami naprawczymi, a nie zwolnieniami czy degradacjami. Chroni to nie tylko morale zespołu, ale przede wszystkim pozwala sprawniej doskonalić systemy. Terminologia: blameless culture, no blame, psychological safety, accountability (odpowiedzialność), incident review, learning from failure.

Wyjaśnienie skrótów użytych na slajdzie:
Blameless – Blameless Engineering Culture – kultura inżynierska bez obwiniania; Naczelna zasada SRE: szukanie winnych niszczy kulturę dzielenia się wiedzą i prowadzi do zatajania awarii.
PsychologicalSafety – Psychological Safety in Teams – bezpieczeństwo psychologiczne w zespole; Warunek konieczny otwartej komunikacji o błędach bez obawy przed sankcjami dyscyplinarnymi.
Etsy – Etsy Blameless Post-mortem Pioneer – praktyka pionierska firmy Etsy; Organizacja, której inżynierowie (John Allspaw) spopularyzowali kulturę bez obwiniania w branży IT.
GoogleSRE – Google SRE Cultural Canon – kanon kulturowy Google SRE; Zbiór zasad nakazujący eliminację błędu człowieka z raportów na rzecz naprawy systemów.
SystemicFailure – Systemic and Latent Failures – awarie systemowe i ukryte; Rzeczywiste źródła problemów wynikające z wad architektury, niejasnych procedur i braku bramek w CI.

18/55 Struktura raportu post-mortem
Struktura post-mortem: 1) Summary (streszczenie, 3-5 zdań: co, wpływ, przyczyny). 2) Timeline (oś czasu: czas - zdarzenie - obserwacja). 3) Root cause (przyczyny źródłowe + contributing factors). 4) Action items (działania z owner i due date, monitorowane). Opcjonalnie: What went well / What went wrong, Lessons learned.

Raport ma cztery filary (plus dodatki): streszczenie, oś, przyczyny i działania z właścicielem. Reszta to przyprawy.

  • Dobre intencje pracowników – kultura blameless zakłada, że inżynierowie podejmują najlepsze możliwe decyzje w oparciu o posiadaną wiedzę.
  • Systemowa natura błędów – potknięcie człowieka jest zawsze skutkiem wadliwych procesów, mylących narzędzi lub luk w procedurach.
  • Destrukcyjny wpływ strachu – karanie pracowników niszczy zaufanie i sprawia, że ludzie zaczynają ukrywać błędy przed przełożonymi.
  • Właściwe pytanie badawcze – zamiast pytać, kto popsuł system, zespół SRE bada, dlaczego platforma pozwoliła na destrukcyjny krok.
  • Otwartość buduje odporność – zastąpienie lęku transparentnym dialogiem pozwala organizacji błyskawicznie wykrywać i usuwać wady.
Contributing factors: Czynniki współprzyczyniające się obok przyczyny głównej; struktura: summary, timeline, root cause, action items (plus well/wrong, lessons).
szablon
Filozofia Blameless Post-mortem: Dlaczego w Google SRE nigdy nie obwinia się człowieka? Załóżmy, że inżynier Janek przypadkowo wpisał DROP DATABASE na produkcji. Tradycyjny menedżer zwolniłby Janka. Podejście SRE mówi: Dlaczego Janek miał uprawnienia do jednoczesnego usunięcia bazy bez podwójnego potwierdzenia? Dlaczego system nie wymusił kopii zapasowej przed destrukcyjnym zapytaniem? Jeśli zwolnisz Janka, kolejny inżynier zrobi dokładnie to samo, a reszta zespołu zacznie ukrywać błędy ze strachu. System musi być odporny na pomyłki człowieka!

Ustandaryzowany raport Post-mortem opisany w monografii Google SRE Workbook musi zawierać następujące sekcje formalne:
1. Streszczenie wykonawcze (Executive Summary) i parametry dotkliwości (Severity, data, IC),
2. Mierzalny wpływ biznesowy (czas przestoju, procent dotkniętych żądań, utracony budżet błędów),
3. Precyzyjna chronologia zdarzeń z dokładnością do minuty w standardzie UTC,
4. Analiza techniczna przyczyn i wyzwalaczy (Trigger and Underlying Causes),
5. Czynniki pozytywne (co zadziałało sprawnie) oraz czynniki losowe (gdzie dopisało nam szczęście),
6. Tabela mierzalnych zadań zapobiegawczych (Action Items) w formacie: Zadanie, Właściciel, Priorytet, Identyfikator w systemie Jira.

Standardowa struktura raportu post-mortem gwarantuje, że dokument jest kompletny, czytelny i użyteczny dla całej organizacji: trzy zasadnicze sekcje - streszczenie (summary), oś czasu wydarzeń (timeline) oraz przyczyny i działania zapobiegawcze (causes & actions) - odpowiadają etapom procesu myślowego prowadzącego od ogólnego obrazu, przez szczegółowy przebieg, po konkretne wnioski operacyjne. Dzięki niej każdy czytelnik może szybko ocenić wagę incydentu, zrozumieć, co się wydarzyło, oraz dowiedzieć się, co zostanie zrobione, aby taka awaria już się nie powtórzyła; dobra struktura jest równie ważna jak sama treść merytoryczna.

Summary (streszczenie) to krótkie, 3-5 zdaniowe podsumowanie otwierające raport. Powinno zawierać: czego dotyczył incydent (np. całkowita niedostępność wyszukiwarki produktowej), zakres wpływu (ile użytkowników, jak długo, jaki ma to związek ze SLO/error budget) oraz najważniejszą przyczynę źródłową. Streszczenie pełni funkcję informacyjną dla osób, które nie mają czasu na czytanie całości - kierownictwa, innych zespołów, klientów. Timeline (oś czasu) to chronologiczny zapis przebiegu incydentu z dokładnymi znacznikami czasu (timestampami): wystąpienie awarii, wykrycie, eskalacja, diagnoza, workaround, przywrócenie usługi, weryfikacja. Oś czasu jest najcenniejszym źródłem uczenia się, ponieważ pozwala ocenić, ile czasu zajęły poszczególne etapy i gdzie proces zadziałał dobrze, a gdzie mógł być sprawniejszy. Dobra timeline ma format tabeli: czas - zdarzenie - obserwacja/działanie.

Sekcja przyczyn i działań jest sercem raportu. W części „przyczyny” opisujemy wyniki analizy RCA (przyczyny źródłowe i czynniki współprzyczyniające się), w części „actions” - konkretne action items, czyli działania zapobiegawcze. Każde działanie powinno być jednoznacznie sformułowane, mieć przypisanego właściciela (owner) i termin realizacji (due date), najlepiej w formie checklisty, którą można śledzić w kolejnych przeglądach. Dobrze napisany post-mortem zawiera także refleksję po każdym działaniu: co zostało zrobione, co nie i dlaczego. Część organizacji dodaje dodatkowo sekcję „what went well / what went wrong” (co poszło dobrze, co źle) oraz „lessons learned”, co jeszcze bardziej wzmacnia walor edukacyjny dokumentu. Terminologia: postmortem structure, summary, timeline, root cause, action items, owner, due date, post-incident review, what went well/what went wrong.

Wyjaśnienie skrótów użytych na slajdzie:
ExecutiveSummary – Post-mortem Executive Summary – streszczenie wykonawcze raportu; Zwięzły opis awarii, jej skutków biznesowych i podjętych działań przeznaczony dla kierownictwa.
Impact – Quantifiable Business and SLO Impact – mierzalny wpływ biznesowy; Precyzyjne wyliczenie strat: liczba dotkniętych zapytań, spadek konwersji, zużyty budżet błędów.
Timeline – Detailed UTC Event Timeline – szczegółowa oś czasu w UTC; Zestawienie kolejnych faktów, od pierwszej anomalii po wdrożenie trwałej poprawki.
RootCause – Technical Root Cause Analysis – techniczna przyczyna źródłowa; Dogłębne wyjaśnienie mechanizmu usterki z odniesieniem do kodu i konfiguracji.
ActionItems – Preventative Action Items Table – tabela działań zapobiegawczych; Lista konkretnych zadań z przypisanymi identyfikatorami Jira, właścicielami i terminami.

19/55 Pisanie raportu technicznego
Technical report (fact-bearing): Raport oparty wyłącznie na faktach i obserwacjach - bez emocji, spekulacji i ocen. Zamiast „wyglądało na to, że baza miała problem" → „o 14:20 w logach zaobserwowano connection refused do 127.0.0.1:3306". Separacja faktów od interpretacji; każda interpretacja oznaczona i poparta dowodami. Wymagana dwujęzyczność PL/EN (międzynarodowe zespoły SRE).

Raport techniczny to fakty z dowodami, zero emocji i dwa języki. Każde zdanie ma paragon.

  • Bezpieczeństwo psychologiczne – to warunek, w którym pracownik nie boi się otwarcie przyznać do pomyłki w konfiguracji infrastruktury.
  • Błyskawiczne ujawnienie pomyłki – inżynier, który skasował tabelę, informuje o tym natychmiast, skracając diagnostykę o wiele godzin.
  • Eliminacja błądzenia po omacku – szczere wskazanie własnego błędu ratuje zespół przed żmudnym testowaniem dziesiątek fałszywych tropów.
  • Przykład idzie z góry – liderzy techniczni powinni otwarcie opowiadać o swoich przeszłych awariach, budując kulturę prawdy i szacunku.
  • Najtrwalszy fundament stabilności – zaufanie i wzajemne wsparcie personelu są najskuteczniejszą tarczą ochronną każdego ekosystemu IT.
Fact-bearing: Styl oparty na faktach - liczby, czasy, komunikaty zamiast wrażeń; interpretacje oznaczone i poparte dowodami, dwujęzycznie PL/EN.
fragment raportu

Pisanie raportu technicznego (technical report) - zarówno w post-mortem, jak i w codziennej komunikacji operacyjnej - opiera się na stylu fact-bearing, czyli wyłącznie na faktach i obserwacjach, bez emocji, spekulacji i ocen: zamiast "wyglądało na to, że baza danych miała problem" piszemy "w dniu X o godzinie Y w logach zaobserwowano connection refused do hosta Z". Obiektywny opis faktów ma znaczenie nie tylko dla czytelności, ale dla samego przebiegu analizy - każda subiektywna ocena może wypaczyć wnioski i skierować uwagę na fałszywe tropy. W raporcie obowiązuje też zasada separacji faktów od interpretacji: najpierw bezstronny opis zdarzeń, potem hipotezy, przy czym każda interpretacja musi być oznaczona jako taka i poparta dowodami.

Raport techniczny w modelu SRE charakteryzuje się także precyzyjnym językiem: podajemy konkretne liczby (czas, liczba wpisów, wielkość ruchu), nazwy komponentów, dokładne komunikaty błędów i identyfikatory (np. ID żądań, numery wersji). Unikamy słów mglistych typu „mniej więcej”, „niektóre usługi”, „szybko” - zamiast tego „okres 14:00-14:20, 3 z 5 replik, czas odpowiedzi wzrósł z 120 ms do 2,4 s”. Ważna jest również neutralność emocjonalna - nawet w raportach z bardzo stresujących awarii nie używamy określeń wartościujących jak „katastrofalny błąd”, a zamiast tego „SEV-1 incident affected availability of payment service for 35 minutes”. Taka forma buduje obiektywną bazę do analizy przyczyn i ułatwia innym zespołom wykorzystanie dokumentu w procesach szkoleniowych.

Zasada dwujęzyczności (PL/EN) wymaga, aby raport techniczny - szczególnie taki, który ma trafić do szerszego grona odbiorców, w tym międzynarodowych zespołów i klientów - był przygotowany zarówno po polsku, jak i po angielsku. W praktyce oznacza to, że sekcje i nagłówki, kluczowe terminy (np. root cause, action items, timeline) oraz podsumowanie przygotowujemy w obu językach, a tłumaczenie służy równolegle jako słownik terminologiczny (glossary). Dwujęzyczność ułatwia również pracę w zespołach, w których część inżynierów operuje w języku angielskim, a wymagania rekrutacyjne firm z branży technologicznej praktycznie zawsze przewidują raportowanie w języku angielskim. Terminologia: technical report, fact-bearing (oparty na faktach), evidence-based (oparty na dowodach), neutral tone (neutralny ton), technical writing, PL/EN reporting.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina wymagająca rzetelnego, technicznego języka pozbawionego emocji w dokumentacji.
Markdown – Markdown Documentation Format – format dokumentacji Markdown; Standard zapisu plików post-mortem przechowywanych w repozytoriach kodu źródłowego.
Git – Git version control system – system kontroli wersji Git; Platforma wersjonowania i przeglądu raportów poawaryjnych przez całą organizację inżynierską.
CodeReview – Post-mortem Peer Review – recenzja raportu poawaryjnego; Proces weryfikacji faktów zawartych w raporcie przez uczestników akcji ratunkowej.
TechnicalWriting – Clear Technical Writing Standards – standardy precyzyjnego pisarstwa technicznego; Kultura jasnego formułowania myśli inżynierskich poparta wykresami i wyciągami z logów.

20/55 Język raportu (PL/EN)
Język raportów (PL/EN): Narracja po polsku, terminy techniczne także po angielsku (w nawiasach): severity (ważność), triage (selekcja), mitigation (łagodzenie skutków), root cause analysis (analiza przyczyn źródłowych), action items (działania zapobiegawcze), timeline (oś czasu). Spójna terminologia (raz ustalone tłumaczenia, seed terms) = jednoznaczna komunikacja zespołowa. Zgodność z efektem uczenia się U05 z sylabusa.

Po polsku z angielskimi terminami w nawiasach - konsekwentnie, ze słownikiem. Sens po obu stronach identyczny.

  • Kryteria sporządzenia raportu – post-mortem jest obowiązkowy po każdym incydencie poziomu Sev-1 i Sev-2 w oficjalnej klasyfikacji.
  • Naruszenie celów jakościowych – dokument tworzy się również wtedy, gdy awaria naruszyła budżet błędów SLO lub zagroziła spójności danych.
  • Cenne anomalie brzegowe – warto opisywać nietypowe, z pozoru drobne usterki, których przebieg ujawnił nieznane dotąd luki w platformie.
  • Jednoznaczne zasady uruchomienia – oparcie procedury na jasnych wytycznych usuwa uznaniowość i wyrabia w zespole zdrowe nawyki.
  • Szansa na rozwój architektury – każda nieprzewidziana awaria produkcyjna powinna być traktowana jako bezcenna lekcja ulepszania systemów.
Seed terms: Raz ustalone tłumaczenia terminów (severity, triage, mitigation, RCA, action items, timeline) jako spójna terminologia zespołu (efekt U05).
dwujęzyczny

Język raportu i polityka dwujęzyczności (PL/EN) w dokumentacji incydentów: raporty przygotowuje się po polsku, a techniczne terminy - w nawiasach lub jako komplementarne tłumaczenia - podaje się również w wersji angielskiej. Ma to praktyczne uzasadnienie: terminologia techniczna jest niemal w całości anglojęzyczna i obiegowa w globalnej społeczności inżynierów, a podawanie obu wersji uczy właściwych pojęć w obu językach, co jest wymagane w środowisku zawodowym. Spójna terminologia jest też warunkiem jednoznacznej komunikacji w zespole operacyjnym - jeśli jeden inżynier mówi "eskalacja", a inny "wzmocnienie reakcji", może dojść do nieporozumień w krytycznym momencie; słownictwo ustala się raz i stosuje konsekwentnie w całej dokumentacji.

Polską narrację raportu uzupełniamy o angielskie terminy w każdym miejscu, gdzie definiujemy pojęcia techniczne: severity (ważność), triage (selekcja), mitigation (łagodzenie skutków), root cause analysis (analiza przyczyn źródłowych), action items (działania zapobiegawcze), timeline (oś czasu). Taki słownik pojęć (glossary) może też stanowić ostatnią sekcję raportu, w której zebrane jest tłumaczenie wszystkich użytych terminów - staje się wtedy również bazą do powtarzających się raportów. W praktyce używamy stałych, ustalonych tłumaczeń (seed terms), a nie każdorazowo wymyślonych odpowiedników, aby zachować spójność językową między dokumentami. To samo podejście jest oczekiwane w zadaniach domowych (slajd 35) - wersja PL i EN tego samego raportu musi opisywać identyczne fakty.

Zgodność z sylabusem (U05) oznacza, że umiejętność przygotowania raportu w obu językach jest jednym z efektów uczenia się, które student musi potwierdzić w zadaniach i na zaliczeniu. W praktyce oznacza to, że sens zdania po polsku i po angielsku musi być tożsamy - nie wystarczy „opisać po swojemu”, trzeba oddać dokładnie te same fakty, terminy i wnioski. Umiejętność swobodnego przełączania między PL i EN jest wysoce poszukiwana na rynku pracy, gdzie wiele firm operuje w międzynarodowych zespołach i prowadzi dokumentację głównie po angielsku. Dobra praktyka to prowadzenie od początku dwujęzycznego słownika własnego (np. w notatkach), który budujemy w miarę pisania kolejnych raportów. Terminologia: translation (tłumaczenie), glossary (słownik pojęć), PL/EN reporting, terminology consistency (spójność terminologiczna), learning outcome U05.

Wyjaśnienie skrótów użytych na slajdzie:
Polish – Polish Technical Terminology – polska terminologia techniczna; Używanie poprawnych polskich odpowiedników pojęć informatycznych w dokumentacji wewnętrznej.
English – English as Global IT Standard – język angielski jako standard globalny; Wymóg sporządzania raportów w języku angielskim w międzynarodowych strukturach inżynierskich.
GlobalTeam – Geographically Distributed Teams – zespoły rozproszone geograficznie; Inżynierowie pracujący w różnych krajach wymagający jednolitego języka dokumentacji.
B2B – Business to Business Communication – komunikacja z klientami korporacyjnymi; Oficjalne raporty poawaryjne przekazywane partnerom zagranicznym w języku angielskim.
Terminology – Standardized SRE Terminology – ustandaryzowana terminologia SRE; Spójne stosowanie pojęć (SLO, SLI, MTTR, Outage, Mitigation) we wszystkich dokumentach.

21/55 Działania zapobiegawcze
Action items (działania zapobiegawcze): Konkretne działania wynikające z RCA, zapobiegające powtórce incydentu. Kryteria SMART: konkretne, mierzalne, osiągalne, istotne, rozliczalne. Każde działanie ma owner (właściciela) i due date (termin). Postęp monitorowany (follow-up) w cyklicznych przeglądach. Bez follow-up post-mortem nie ma wartości.

Action items to SMART z właścicielem i terminem, śledzone do zamknięcia. Bez follow-up raport jest dekoracją.

  • Struktura dokumentu post-mortem – wzorcowy raport zawiera syntetyczne streszczenie, precyzyjną oś czasu oraz głęboką analizę przyczyn.
  • Streszczenie dla interesariuszy – w kilku zdaniach przedstawia naturę awarii, czas przestoju oraz szacowany wpływ na użytkowników.
  • Głęboka analiza techniczna – sekcja badawcza szczegółowo wyjaśnia, jak zachował się system i jakie zjawiska doprowadziły do awarii.
  • Wymierne zadania korygujące Action Items – lista konkretnych prac technicznych mających zapobiec powtórzeniu się awarii w przyszłości.
  • Właściciele i terminy realizacji – każde zadanie zapobiegawcze musi mieć przypisanego konkretnego inżyniera oraz termin wykonania.
Kryteria SMART: Konkretne, mierzalne, osiągalne, istotne, rozliczalne - z owner i due date oraz follow-up w przeglądach; bez tego post-mortem bez wartości.
działania

Raport poawaryjny bez wdrożonych usprawnień stanowi czysty dług techniczny. Każde zadanie naprawcze (Action Item) musi posiadać ściśle określony priorytet powiązany z klasyfikacją awarii: zadania zapobiegające powtórzeniu incydentu Sev1 muszą trafić do bieżącego sprintu programistycznego jako priorytet bezwzględny (Blocker). Zgodnie z wytycznymi Atlassian Incident Management Handbook niewykonanie zadań poawaryjnych w terminie 30 dni skutkuje automatyczną eskalacją do dyrekcji technicznej.

Działania zapobiegawcze (action items) to materialny rezultat każdego post-mortem: bez nich raport po incydencie pozostaje wyłącznie dokumentacją historyczną, a wartość przynoszą dopiero konkretne zmiany w systemach, procesach i narzędziach. Dobrze sformułowane działanie jest konkretne (jednoznaczny cel), mierzalne (jak sprawdzimy, że zostało wykonane), osiągalne w rozsądnym czasie, istotne dla omawianego problemu oraz rozliczalne - z przypisanym właścicielem (owner) i terminem realizacji (due date). Krótko mówiąc, action items opisuje się zgodnie z konwencją zbliżoną do kryteriów SMART.

Każde działanie zapobiegawcze powstaje bezpośrednio z przyczyny źródłowej znalezionej w analizie RCA - jeśli przyczyna brzmi „brak alertu na wypełnienie dysku sieciowego”, działaniem będzie „utworzyć regułę alertu threshold 80% użycia dysku katalogu /var/log, owner: zespół SRE, termin: 7 dni”. W praktyce z jednego incydentu powstaje zwykle od jednego do kilkunastu action items o różnej wadze: niektóre są natychmiastowe (np. zmiana konfiguracji), inne długoterminowe (np. przeprojektowanie fragmentu architektury). Ważne jest, aby nie tworzyć list „życzeniowych” bez właścicieli i terminów - tak jak nie posiadający właściciela błąd w kodzie nigdy nie zostanie naprawiony, tak w praktyce nieposiadający właściciela action item nie zostanie wdrożony.

Po stworzeniu listy działań konieczne jest ich śledzenie (follow-up), które odbywa się w ramach cyklicznych przeglądów post-mortem - np. na cotygodniowym spotkaniu zespołu lub za pomocą dedykowanej tablicy (incident action tracking). Odpowiedzialność za domknięcie działań często przypada osobie pełniącej funkcję „action item tracker” lub po prostu liderowi technicznemu. W dojrzałych organizacjach działanie uznaje się za zamknięte dopiero po udokumentowaniu jego realizacji (np. link do zmiany w repozytorium GitOps) i sprawdzeniu, że faktycznie zmieniło stan systemu. Takie domykanie pętli (closing the loop) jest kwintesencją cyklu uczenia się w SRE: bez follow-up post-mortem nie ma wartości, a bez realizacji action items równie dobre jest jego niepisanie. Terminologia: action items (działania), owner (właściciel), due date (termin), follow-up (monitorowanie), SMART goals, closing the loop, action tracking.

Wyjaśnienie skrótów użytych na slajdzie:
ActionItems – Post-mortem Action Items – zadania naprawcze poawaryjne; Najważniejsza sekcja raportu post-mortem gwarantująca, że awaria nie powtórzy się w przyszłości.
Owner – Single Directly Responsible Individual – jednoosobowy właściciel zadania; Zasada przypisywania konkretnego inżyniera imiennie do każdego zadania zapobiegawczego.
Priority – Action Item Priority Matrix – priorytetyzacja zadań naprawczych; Oznaczanie zadań jako Blocker, High lub Medium w zależności od stopnia eliminacji ryzyka.
DueDate – Strict Remediation Due Date – nieprzekraczalny termin realizacji; Sztywny harmonogram wdrożenia poprawki (np. 14 dni dla zadań po awarii Sev1).
Jira – Issue Tracking System – system śledzenia zadań; Narzędzie korporacyjne, do którego automatycznie trafiają zadania z raportu poawaryjnego.

22/55 Wprowadzanie wniosków
Wdrażanie wniosków (continuous improvement): Raport i action items to dopiero początek - wnioski muszą trafić do realnych zmian. Obszary: doskonalenie monitoringu i alertingu (nowe reguły, progi, burn rate), zmiany architektury (HA), poprawa procesów wdrożeniowych, aktualizacja runbooków, szkolenia. Systematyczne wdrażanie zmniejsza toil i poprawia metryki niezawodności - sedno pętli uczenia się w SRE.

Raport to początek: wnioski muszą wejść w monitoring, architekturę, procesy i głowy. Inaczej to papier.

  • Oś czasu Timeline – to precyzyjne, chronologiczne zestawienie wszystkich faktów, pomiarów i decyzji podjętych w trakcie opanowywania incydentu.
  • Jednolity standard czasu UTC – wszystkie znaczniki godzinowe w raporcie muszą być zapisane w strefie UTC, eliminując chaos stref.
  • Kluczowe punkty zwrotne – oś dokumentuje czas wystąpienia usterki, moment alarmu, dołączenie dowódcy i skuteczne wdrożenie mitygacji.
  • Ścisłe oparcie na logach – wpisy w osi czasu muszą bazować na twardych zapisach z serwerów i komunikatorów, a nie na zawodnej pamięci.
  • Przejrzysty obraz zdarzeń – dokładna chronologia pozwala obiektywnie ocenić opóźnienia decyzyjne i usprawnić przyszłe procedury dyżurne.
Continuous improvement: Ciągłe doskonalenie - wnioski trafiają do monitoringu, architektury, procesów, runbooków i szkoleń, zmniejszając toil.
wdrażanie

Wdrażanie wniosków z incydentów zapobiega powstawaniu długu technicznego – zadania o priorytecie Blocker muszą być implementowane w bieżącym sprincie, pod rygorem automatycznej eskalacji do dyrekcji technicznej.

Wprowadzanie wniosków z incydentów w życie organizacji zamyka pętlę ciągłego doskonalenia (continuous improvement): samo napisanie raportu post-mortem i lista action items to dopiero początek - wnioski muszą zostać faktycznie wdrożone, aby przyniosły trwałą wartość. Najczęstsze obszary to doskonalenie monitoringu i alertingu, zmiany w architekturze, poprawa procesów wdrożeniowych, aktualizacja runbooków i szkolenie zespołu; po incydencie niewykrytym przez monitoring naturalne jest dodanie reguł lub zmiana progów, a klasycznym efektem są lepsze runbooki - szczegółowe instrukcje skracające czas reakcji osoby dyżurnej.

Wprowadzanie wniosków w życie powinno się odbywać w sposób systematyczny, a nie „raz na jakiś czas”. Dobra praktyka to łączenie action items z systemem śledzenia (np. issue tracker, tablica SCRUM, repozytorium GitOps), regularne przeglądy post-mortem i ewidencja stanu działań. W wielu organizacjach działa rytmul: po każdym incydencie w ciągu kilku dni odbywa się spotkanie przeglądowe, na którym weryfikujemy postęp w realizacji działań i usuwamy przeszkody. Ważne jest również, aby wnioski z incydentu trafiły do szerszego zespołu - nie tylko do jego uczestników - na przykład przez publikację w repozytorium dokumentacji, sekcję „lessons learned” w przeglądzie kwartalnym czy krótkie prezentacje (tech talk). Tylko wtedy organizacja jako całość uczy się, a nie tylko wąska grupa zaangażowanych osób.

Z punktu widzenia SRE wdrożenie wniosków ma jeszcze jeden istotny wymiar: zmniejsza ilość pracy powtarzalnej (toil) i poprawia metryki niezawodności. Działania takie jak automatyzacja reakcji (np. automatyczny restart usługi po wykryciu awarii), rozszerzenie zakresu monitoringu czy wzmocnienie architektury HA wynikają zwykle właśnie z analizy incydentów. Każdy zrealizowany action item jest więc inwestycją, która zmniejsza prawdopodobieństwo kolejnej awarii lub skraca czas jej trwania. Dlatego właśnie cykl „wykryj - napraw - wyciągnij wnioski - wdroż poprawki” jest sednem pętli uczenia się w modelu SRE i jednocześnie łącznikiem między tym wykładem a pozostałymi modułami kursu (metryki, monitoring, alerting, HA, GitOps). Terminologia: continuous improvement, monitoring improvement, alert tuning, runbook update, lessons learned, learning loop, incident follow-up.

Wyjaśnienie skrótów użytych na slajdzie:
Sprint – Agile Development Sprint – sprint programistyczny; Cykl wytwórczy, do którego planowania obowiązkowo włącza się zadania naprawcze z incydentów.
Backlog – Product Backlog Prioritization – zarządzanie rejestrem zadań produktu; Rejestr wymagań, w którym zadania niezawodnościowe mają pierwszeństwo przed nowymi funkcjami.
CI/CD – Continuous Integration / Continuous Delivery – ciągła integracja i wdrażanie; Automatyzacja nowych testów regresyjnych zapobiegających ponownemu pojawieniu się błędu.
TechDebt – Technical Debt Remediation – spłata długu technologicznego; Eliminacja przestarzałych komponentów ujawnionych jako słabe ogniwa w trakcie incydentu.
Review – Monthly Action Items Review – miesięczny przegląd zadań poawaryjnych; Spotkanie dyrekcji technicznej weryfikujące terminowość wdrażania poprawek.

23/55 Metryki incydentów
Metryki incydentów: Dwa wymiary: częstotliwość (liczba incydentów/miesiąc, SEV-1/SEV-2, % wykrytych przez monitoring) i szybkość reakcji (MTTD, MTTA, MTTR). Obserwowanie trendów (nie pojedynczych wartości) pomaga zapobiegać powtórkom i planować zasoby zespołu. Stosuj medianę i percentyle (p50, p90) - średnie bywają mylące. Związek z wykładem 6 i error budget.

Mierz częstotliwość i szybkość - i patrz na trendy, nie punkty. Mediany i percentyle zamiast średnich.

  • Analiza przyczyn źródłowych RCA – proces badawczy polega na dociekaniu pierwotnych czynników, które zainicjowały sekwencję zdarzeń awarii.
  • Wieloczynnikowa natura awarii – w systemach rozproszonych rzadko występuje jedna przyczyna, zazwyczaj mamy do czynienia z ich splotem.
  • Pozorne symptomy a sedno sprawy – powierzchowne spojrzenie wskazuje na błąd człowieka, podczas gdy sedno tkwi w braku mechanizmów obrony.
  • Strukturyzowane metody dochodzenia – inżynierowie sięgają po sprawdzone techniki analityczne, takie jak 5 Whys lub diagram przyczyn Ishikawy.
  • Trwała eliminacja słabości – rzetelne przeprowadzenie analizy RCA gwarantuje, że identyczny problem nigdy więcej nie zaskoczy platformy.
Trendy zamiast punktów: Obserwacja trendów częstotliwości i reakcji (mediany, percentyle p50/p90, nie średnie) do zapobiegania i planowania zasobów.
metryki

Matematyczna relacja wskaźników operacyjnych opiera się na dekompozycji cyklu awarii: MTTD (wykrycie) + MTTA (potwierdzenie) + MTTM (mitygacja/obejście) = czas niedostępności dla użytkownika. Z kolei MTTR odzwierciedla całościowy czas do trwałego usunięcia przyczyny źródłowej, a MTBF (Mean Time Between Failures) mierzy stabilność architektury między kolejnymi awariami.

Metryki incydentów oceniają jakość procesu zarządzania incydentami - zasada "jeśli czegoś nie mierzysz, nie możesz tego poprawić" jest tu w pełni aktualna. Podstawowe metryki dotyczą dwóch wymiarów: częstotliwości występowania (liczba incydentów w miesiącu, liczba incydentów krytycznych SEV-1/SEV-2, odsetek wykrytych przez monitoring) oraz szybkości reakcji i naprawy - wskaźniki czasowe, z których najbardziej znane to MTTA (Mean Time To Acknowledge - średni czas od wykrycia do przyjęcia incydentu) i MTTR (Mean Time To Resolve - średni czas od wykrycia do przywrócenia usługi). W literaturze MTTR bywa również rozwijany jako Mean Time To Repair lub Mean Time To Recovery - znaczenie jest podobne, ale definicja powinna być zapisana w dokumentacji każdej organizacji.

Metryki incydentów służą nie tylko do oceny zespołu, ale przede wszystkim do wykrywania trendów i planowania zasobów. Jeśli obserwujemy rosnącą liczbę incydentów generowanych przez jeden komponent, jest to sygnał do wzmocnienia jego niezawodności (lub do planowania prac nad modernizacją). Jeśli MTTA rośnie, może to oznaczać problemy z alertingiem, zbyt długie kolejki zgłoszeń lub niedobór osób dyżurnych. Jeśli zaś MTTR rośnie przy stabilnym MTTA, problem leży w diagnozie lub naprawie - być może brakuje runbooków, nieautomatyzowanych działań naprawczych albo kompetencji osoby dyżurnej. Taka analiza trendów jest analogiczna do analizy metryk SLI/SLO z wykładu 2 - decyzje podejmujemy na podstawie danych, a nie przeczuć.

Przy interpretacji metryk należy zachować ostrożność i zdrowy rozsądek. Średnie (mean) mogą być mylące przy skrajnie zróżnicowanych czasach naprawy - dlatego warto stosować także medianę i percentyle (np. p90, p99), które lepiej pokazują typowe doświadczenie użytkownika. Metryki powinny być też rozpatrywane łącznie: niski MTTR przy jednoczesnym dużej liczbie incydentów może świadczyć o doraźnym usuwaniu objawów awarii bez eliminacji przyczyn źródłowych, a nie o dojrzałej inżynierii niezawodności. Najważniejsza jest ewolucja wskaźników w czasie (trend), a nie ich wartość bezwzględna. Terminologia: incident frequency (częstotliwość incydentów), MTTA (Mean Time To Acknowledge), MTTR (Mean Time To Resolve), MTTD (Mean Time To Detect), percentiles (percentyle), trend analysis, error budget, on-call load.

Wyjaśnienie skrótów użytych na slajdzie:
MTTR – Mean Time To Recover – średni czas naprawy; Metryka mierząca sprawność diagnozy, wdrożenia poprawki i przywrócenia zielonego stanu usług.
MTTA – Mean Time To Acknowledge – średni czas potwierdzenia; Miara szybkości reakcji inżyniera dyżurnego po odebraniu wezwania z systemu monitoringu.
MTTD – Mean Time To Detect – średni czas wykrycia usterki; Parametr oceniający czułość i kompletność reguł alertowych w systemie Prometheus.
MTBF – Mean Time Between Failures – średni czas między awariami; Wskaźnik stabilności systemu określający jak długo infrastruktura pracuje bez poważnego incydentu.
MTTF – Mean Time To Failure – średni czas do wystąpienia awarii; Statystyczna miara bezawaryjności pojedynczych komponentów sprzętowych i programowych.

24/55 Symulacja awarii (ćwiczenie)
Incident simulation (symulacja awarii): Ćwiczenie w grupach - studenci przechodzą przez kolejne etapy incydentu w bezpiecznych warunkach: wykrycie → triage → komunikacja → naprawa → raportowanie. Metoda fire drill / game-day / chaos exercise. Skład łączy teorię z praktyką, ćwiczy role, komunikację i radzenie sobie ze stresem. Ujawnia luki w procedurach zanim staną się realnym problemem.

Teorię zamień w odruch: rozegraj awarię w grupie, bez ryzyka produkcji. Presja prawdziwa, skutki żadne.

  • Metodologia pięciu pytań 5 Whys – technika polega na wielokrotnym zadawaniu pytania 'dlaczego', aby dotrzeć do sedna napotkanej anomalii.
  • Przejście do procesów bazowych – celem metody jest wyjście poza błąd programisty i ustalenie, czemu testy nie wykryły wady w kodzie.
  • Unikanie powierzchownych ocen – prosta reguła zmusza zespół do wnikliwej refleksji nad kulturą wytwarzania i konfiguracji platformy.
  • Systemowe zabezpieczenia platformy – prawidłowo przeprowadzone 5 Whys prowadzi do wdrożenia automatycznych barier na poziomie firmy.
  • Uniwersalne narzędzie inżyniera – technika doskonale sprawdza się w codziennej pracy SRE, stanowiąc intuicyjny wstęp do głębokiego RCA.
Fire drill: Ćwiczenie pożarowe w bezpiecznych warunkach (wykrycie → triage → komunikacja → naprawa → raport); ujawnia luki procedur przed realną awarią.
symulacja
Praktyka metody 5 Whys (Pięć razy dlaczego): Przykład z życia:
1. Dlaczego serwer przestał działać? Bo baza danych nie odpowiadała.
2. Dlaczego baza nie odpowiadała? Bo skończyła się pamięć RAM na serwerze.
3. Dlaczego skończyła się pamięć? Bo zapytanie analityczne zaciągnęło 50 milionów wierszy bez paginacji.
4. Dlaczego programista napisał takie zapytanie? Bo nie wiedział, że tabela tak urosła od zeszłego roku.
5. Dlaczego nie wiedział? Bo w środowisku testowym używamy bazy z zaledwie 100 wierszami!
Wniosek: Prawdziwą przyczyną nie był „brak pamięci RAM”, lecz brak testów z reprezentatywnym wolumenem danych!

Ćwiczenie symulacji awarii (incident simulation) to praktyczne narzędzie nauki zarządzania incydentem w bezpiecznych warunkach: studenci przeprowadzają symulowaną awarię w grupach i przechodzą kolejne etapy incydentu - od wykrycia, przez triage i komunikację, po raportowanie. Taka praktyka symulacyjna (fire drill, game-day, chaos exercise) jest powszechnie stosowana w dojrzałych organizacjach SRE jako metoda szkolenia i testowania przygotowania; symulacja nie stwarza realnego ryzyka (brak systemów produkcyjnych, które mogłyby ucierpieć), a mimo to oddaje presję, wielowątkowość i niepewność prawdziwego incydentu. To najlepszy sposób, aby przekuć teorię w umiejętności praktyczne.

Typowa symulacja awarii składa się z trzech kroków: przygotowania, rozegrania scenariusza i podsumowania. W kroku przygotowania każdemu uczestnikowi przydzielana jest rola (komunikator, osoba diagnozująca, skryba), ustalane są zasady komunikacji i cele ćwiczenia. Scenariusz przygotowuje prowadzący - może to być napisany na kartce opis awarii (np. „usługa płatności nie odpowiada od 10 minut, klienci zgłaszają problem”), a uczestnicy muszą reagować w sposób zgodny z procedurami. W kroku rozegrania grupa przechodzi przez cały cykl incydentu, prowadząc realną komunikację: kanał incydentu, aktualizacje statusu, decyzje o eskalacji, działania naprawcze. W kroku podsumowania uczestnicy przygotowują raport post-mortem z symulacji, analizują oś czasu i wyciągają wnioski. Dzięki symulacji studenci ćwiczą zarówno umiejętności twarde (diagnoza, narzędzia), jak i miękkie (komunikacja, praca zespołowa, radzenie sobie ze stresem).

Symulacje awarii mają jeszcze jedną, niezwykle ważną wartość dla organizacji: ujawniają luki w procedurach, runbookach i narzędziach, zanim te staną się problemem w prawdziwej awarii. Jeśli w trakcie symulacji zespół nie potrafi szybko znaleźć runbooka albo nie wie, kto decyduje o eskalacji, to właśnie teraz - a nie podczas produkcyjnej awarii - należy to skorygować. W modelu Google SRE przeprowadzane są regularne game-days (dzień gry), podczas których inżynierowie celowo wprowadzają awarie lub przechodzą symulowane scenariusze, aby sprawdzić gotowość zespołu. Terminologia: simulation (symulacja), fire drill (ćwiczenie awaryjne), game-day (dzień gry), chaos exercise (ćwiczenie chaosowe), scenario, roles, retrospective (retrospektywa).

Wyjaśnienie skrótów użytych na slajdzie:
GameDay – SRE GameDay Simulation – ćwiczenia awaryjne GameDay; Zaplanowane symulacje awarii produkcyjnych weryfikujące zgranie zespołu i aktualność procedur.
WheelOfMisfortune – Wheel of Misfortune Exercise – koło nieszczęścia (gra symulacyjna SRE); Praktyka szkoleniowa odgrywania ról, w której inżynierowie mierzą się z historycznymi awariami.
Chaos – Chaos Engineering Principles – zasady inżynierii chaosu; Kontrolowane wstrzykiwanie awarii w celu weryfikacji odporności architektury i procedur alarmowych.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Kultura organizacyjna traktująca regularne ćwiczenia symulacyjne jako standard operacyjny.
Training – Continuous Operational Training – ciągłe szkolenie operacyjne; Budowanie nawyków inżynierskich umożliwiających bezstresowe działanie pod presją czasu.

25/55 Przeprowadzenie symulacji (krok 1)
Krok 1 - role: Na starcie symulacji każdy uczestnik otrzymuje rolę: incident commander (komunikator, koordynacja), technical lead (osoba diagnozująca), scribe (skryba, dokumentacja). Według modelu ze slajdu 9. Role dodatkowe: eksperci warstw, komunikacja z klientami. Zasada: jedna rola na osobę.

Krok 1 to role: commander, diagnozujący i skryba (model ze slajdu 9) plus dodatki. Jedna rola na głowę.

  • Diagram przyczynowo-skutkowy Ishikawy – zwany wykresem rybiej ości, pozwala na wszechstronną klasyfikację czynników awarii.
  • Główne kategorie analizy – bada przyczyny w obszarach ludzi, metod wytwarzania, maszyn i narzędzi, pomiarów oraz otoczenia.
  • Szeroka perspektywa badawcza – graficzna struktura ułatwia dostrzeżenie powiązań pomiędzy odległymi elementami wielkiego ekosystemu IT.
  • Wsparcie złożonych katastrof – diagram doskonale sprawdza się przy skomplikowanych awariach infrastruktury o wielu nakładających się wadach.
  • Wyjście poza sam kod – zastosowanie metody zapobiega jednostronnemu skupianiu się na aplikacji z pominięciem procesów organizacyjnych.
Przydział ról: Commander, diagnozujący i skryba według modelu (slajd 9) plus eksperci i komunikacja z klientami; jedna rola na osobę.
przygotowanie

Symulacja awarii składa się z trzech kroków; krok 1 to przydzielenie ról - działa sprawnie tylko wtedy, gdy każdy uczestnik wie, za co konkretnie odpowiada. Na starcie prowadzący przydziela role zgodnie z modelem: komunikatora (incident commander) koordynującego akcję i komunikację, osobę odpowiedzialną za diagnozę (technical lead) zajmującą się samym problemem oraz skrybę (scribe) dokumentującego wszystko na bieżąco. W zależności od liczebności grupy można dodać role dodatkowe, takie jak osoba komunikująca się z "klientami" (symulowanymi przez prowadzącego) lub eksperci od konkretnych obszarów systemu.

Jasno przydzielone role porządkują całą akcję i uczą uczestników współpracy zespołowej. Każdy wie, do kogo skierować pytanie, kto podejmuje decyzje i kto dokumentuje - eliminuje to dublowanie działań i chaos komunikacyjny, który jest jednym z najczęstszych problemów w trakcie prawdziwych awarii. Ważne jest również poinformowanie wszystkich o regułach ćwiczenia: jaki jest scenariusz początkowy, ile czasu trwa symulacja, czym jest „zakończenie” incydentu (np. zgłoszenie przez komunikatora, że usługa jest przywrócona i zweryfikowana). Prowadzący może celowo wprowadzać dodatkowe zdarzenia (np. „monitoring właśnie wykrył wzrost błędów 5xx”), aby zmusić grupę do reagowania na zmieniającą się sytuację.

Krok 1 ma także istotny walor dydaktyczny: pozwala każdemu uczestnikowi sprawdzić, w której roli czuje się najlepiej i które kompetencje musi jeszcze rozwinąć. Komunikator uczy się delegowania i komunikacji pod presją, osoba diagnozująca trenuje analityczne myślenie i posługiwanie się danymi, a skryba doskonali umiejętność zwięzłej i dokładnej dokumentacji. W kolejnych symulacjach role warto rotować, aby każdy mógł przećwiczyć wszystkie funkcje - w prawdziwym zespole również obowiązuje rotacja, co zwiększa elastyczność organizacji. Terminologia: roles (role), incident commander, technical lead, scribe, rotation (rotacja), scenario setup, team collaboration.

Wyjaśnienie skrótów użytych na slajdzie:
InjectFailure – Controlled Failure Injection – wstrzyknięcie kontrolowanej usterki; Inicjalny krok symulacji polegający na programowym wywołaniu anomalii w środowisku testowym.
Scenario – Incident Simulation Scenario – scenariusz symulacji incydentu; Udokumentowany plan ćwiczeń określający cel dydaktyczny i zakres symulowanej usterki.
IC – Incident Commander Roleplay – odgrywanie roli dowódcy incydentu; Ćwiczenie jednoosobowego przywództwa i podziału zadań przez wyznaczonego studenta.
RolePlay – Emergency Role Playing – odgrywanie ról kryzysowych; Podział uczestników na dowódcę, skrybę, oficera komunikacji i ekspertów technicznych.
Monitoring – Telemetry Dashboard Inspection – inspekcja wskaźników telemetrycznych; Weryfikacja czy uczestnicy symulacji potrafią zidentyfikować anomalię na wykresach Grafany.

26/55 Przeprowadzenie symulacji (krok 2)
Krok 2 - komunikacja: Trzy elementy: raportowanie statusu (regularne komunikaty: co wiemy, co robimy, jakie problemy), prowadzenie kanału incydentu (incident channel, wszystkie dane w jednym miejscu), aktualizacje dla interesariuszy (status page / public update). Zasada: komunikuj nawet niepełne informacje. Sprawna komunikacja = klucz do opanowania chaosu.

Krok 2 to komunikacja: status co kwadrans, wszystko w kanale, interesariusze po ludzku. Milczenie to chaos.

  • Drzewo analizy błędów FTA – to sformalizowana, graficzna technika modelowania awarii za pomocą logicznych bramek koniunkcji i alternatywy.
  • Szczytowe zdarzenie niepożądane – główną katastrofę umieszcza się na górze grafu, rozpisując pod nią wszystkie stany składowe usterki.
  • Bramka logiczna AND – wskazuje, że do wystąpienia incydentu konieczne było jednoczesne zajście kilku niezależnych awarii technicznych.
  • Bramka logiczna OR – obnaża istnienie pojedynczego punktu awarii SPOF, w którym jednostkowa usterka niszczy działanie całego podsystemu.
  • Matematyczna precyzja analizy – metodologia pozwala na wyliczenie prawdopodobieństwa wystąpienia awarii i identyfikację słabych ogniw.
Formuła statusu: „Co wiemy, co robimy, jakie problemy” co 10-15 minut; komunikuj nawet niepełne informacje - to klucz do chaosu.
reakcja

Krok 2 symulacji awarii to komunikacja - sprawna komunikacja w największym stopniu decyduje o końcowym sukcesie akcji, bo nawet najlepsza diagnoza techniczna nie pomoże, jeśli nie dotrze do właściwej osoby w odpowiednim czasie i formie. Ćwiczymy trzy podstawowe elementy: raportowanie statusu (regularne, zwięzłe komunikaty o postępie), prowadzenie kanału incydentu (incident channel) oraz aktualizacje dla interesariuszy (np. symulowanych klientów). Uczestnicy uczą się też, co nie jest komunikacją efektywną: długie dyskusje poza kanałem, zgadywanie bez raportowania, milczenie w trakcie pracy technicznej czy prowadzenie diagnostyki równolegle przez wiele osób bez koordynacji.

Raportowanie statusu opiera się na prostej, standardowej formule: co wiemy, co robimy, jakie mamy problemy. Komunikator zbiera te informacje z kanału incydentu i co ustalony interwał (np. co 10-15 minut) publikuje skonsolidowaną aktualizację, która trafia zarówno do zespołu, jak i dalej - do kierownictwa i klientów. W symulacji kluczowe jest, aby komunikować nawet wtedy, gdy nie mamy wystarczających danych - zamiast ciszy podajemy status „diagnoza trwa, wstępna hipoteza: przeciążenie bazy danych”. Takie postępowanie wtłacza w nawyk uczciwe i otwarte komunikowanie postępu, który jest również podstawą komunikacji z prawdziwymi klientami (temat slajdu 29).

Kanał incydentu jest jedynym miejscem, w którym wymieniamy informacje operacyjne: wszelkie decyzje, dane z narzędzi, szczegóły techniczne zapisujemy tam w formie tekstowej (a nie tylko w notatkach prywatnych), aby skryba mógł z łatwością zbudować oś czasu. Podczas symulacji ćwiczymy także tzw. update message - krótkie komunikaty w stylu status page update, które są gotowe do opublikowania na stronie statusowej. Dobra praktyka wskazuje, że w trakcie incydentu lepiej podać raz na 15 minut krótkie, konkretne zdanie, niż milczeć przez godzinę i potem wydać obszerny komunikat. Terminologia: status report (raportowanie statusu), incident channel (kanał incydentu), status update (aktualizacja statusu), stakeholders (interesariusze), external communication, update frequency.

Wyjaśnienie skrótów użytych na slajdzie:
Triage – Simulated Incident Triage – symulowana segregacja incydentu; Ocena powagi sztucznie wywołanej usterki i podjęcie decyzji o powołaniu pokoju kryzysowego.
WarRoom – War Room Coordination Exercise – ćwiczenie koordynacji w pokoju kryzysowym; Uruchomienie dedykowanego kanału komunikacji i synchronizacja działań uczestników.
Runbook – Runbook Execution and Validation – wykonanie i walidacja instrukcji; Praktyczne sprawdzenie czy instrukcja awaryjna zawiera aktualne polecenia i jasne kroki.
Diagnostic – Diagnostic Reasoning Process – proces wnioskowania diagnostycznego; Formułowanie i weryfikacja hipotez na podstawie logów i metryk systemowych.
Hypotheses – Testing Operational Hypotheses – testowanie hipotez operacyjnych; Odrzucanie błędnych podejść i zawężanie kręgu podejrzanych komponentów w trakcie symulacji.

27/55 Przeprowadzenie symulacji (krok 3)
Krok 3 - raport: Na zakończenie każda grupa przygotowuje raport post-mortem z symulacji (best PL/EN): summary → timeline → root cause → action items. Powtórzenie struktury ze slajdu 18 i całego procesu zarządzania incydentem. Prezentacja i wspólna analiza - podsumowanie działań i wniosków utrwala cały proces.

Krok 3 to raport: post-mortem z symulacji po polsku i angielsku. Bez raportu gra nie liczy się do wyniku.

  • Czynniki sprzyjające Contributing Factors – w architekturze chmurowej awaria niemal zawsze wynika ze zbiegu wielu drobnych okoliczności.
  • Pozornie niewinne warunki – czynniki sprzyjające same w sobie nie wywołałyby katastrofy, lecz ułatwiły jej gwałtowny i groźny rozwój.
  • Przykłady okoliczności towarzyszących – nieaktualna dokumentacja, absencja inżyniera lub nietypowy skok ruchu mogą spotęgować awarię.
  • Identyfikacja wszystkich słabości – analiza post-mortem musi precyzyjnie opisać wszystkie te elementy, aby zapobiec ich ponownej kumulacji.
  • Pokora wobec złożoności – zrozumienie wieloczynnikowej natury uczy zespoły wdrażania wielowarstwowych mechanizmów obronnych w chmurze.
Best PL/EN: Raport dwujęzyczny z symulacji (summary → timeline → root cause → action items); prezentacja utrwala cały proces.
zakończenie

Krok 3 symulacji awarii to przygotowanie raportu: po zakończeniu rozgrywania scenariusza każda grupa tworzy raport post-mortem z symulowanego incydentu, wykorzystując dokumentację zebraną przez skrybę podczas ćwiczenia. To moment scalenia całej wiedzy z wykładu: oś czasu (timeline), analiza przyczyn, wnioski i action items; raport jest praktycznym powtórzeniem struktury - od streszczenia, przez timeline, po przyczyny i działania zapobiegawcze. W zależności od rozmiaru grupy raport może być przygotowany wspólnie (np. w edytorze współpracy) lub indywidualnie, najlepiej w obu wersjach językowych PL/EN.

Przygotowanie raportu ma walor dydaktyczny, ponieważ zmusza uczestników do refleksji nad całym przebiegiem incydentu: co zadziałało dobrze, co sprawiło trudność, gdzie proces można było prowadzić sprawniej. Analiza osi czasu dostarcza cennych obserwacji - np. okazuje się często, że sama komunikacja zajęła zbyt dużo czasu albo że brak szybkiego triage spowodował opóźnienie diagnozy. Pisząc raport, studenci rozwijają umiejętność pisania fact-bearing (opartego na faktach) i formułowania konkretnych, mierzalnych action items. Raporty są następnie prezentowane i omawiane - grupy porównują swoje podejścia i wyciągają wspólne wnioski.

Krok 3 domyka całe ćwiczenie, nadając mu sens, który wykracza poza samą zabawę w awarię. Bez raportu symulacja byłaby jedynie grą bez podsumowania - a właśnie dokumentacja i wnioski są celem każdego prawdziwego incydentu w modelu SRE. Uczestnicy widzą w praktyce, że proces zarządzania incydentem kończy się nie na przywróceniu usługi, lecz na udokumentowanej nauce i konkretnych działaniach naprawczych. Terminologia: postmortem report (raport po awarii), synthesis (synteza), timeline analysis, feedback, deliverables, group presentation.

Wyjaśnienie skrótów użytych na slajdzie:
Mitigation – Mitigation Strategy Execution – wykonanie strategii mitygacji; Pomyślne przywrócenie sprawności usługi w środowisku ćwiczeniowym za pomocą obejścia.
PostMortem – Drafting Exercise Post-mortem – sporządzenie ćwiczeniowego raportu; Wspólne spisanie raportu poawaryjnego na gorąco bezpośrednio po zakończeniu symulacji.
Debrief – Incident Debriefing Session – sesja podsumowująca ćwiczenia; Wspólna dyskusja o tym co zadziałało poprawnie, a co wymaga poprawy w komunikacji zespołu.
Feedback – Constructive Peer Feedback – konstruktywna informacja zwrotna; Wymiana uwag pomiędzy uczestnikami symulacji w duchu bezpieczeństwa psychologicznego.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Ewaluacja umiejętności inżynierskich studentów w warunkach zbliżonych do realiów rynkowych.

28/55 Najczęstsze błędy przy incydentach
Typowe błędy: 1) Brak komunikacji (milczenie, brak aktualizacji, dublowanie działań) - komunikuj nawet niepełne informacje. 2) Pominięcie dokumentacji (brak timeline → brak materiału do analizy) - dokumentuj na bieżąco. 3) Nadmierna koncentracja na diagnozie zamiast na recovery. 4) Brak eskalacji przy rosnącym wpływie. 5) „Hero mode" pojedynczego inżyniera. 6) Rozmowy poza kanałem incydentu.

Pięć kardynalnych błędów podczas incydentu: milczenie, brak zapisu przebiegu zdarzeń, chaotyczne próby naprawy zamiast metodycznego działania, zaniechanie eskalacji oraz postawa samozwańczych bohaterów.

  • Zadania naprawcze Action Items – stanowią najważniejszy owoc procesu analizy awarii i decydują o praktycznej wartości raportu post-mortem.
  • Konkretne i weryfikowalne cele – zadania muszą być sformułowane precyzyjnie, unikając ogólnikowych i pustych haseł o poprawie jakości.
  • Imienna odpowiedzialność za realizację – przypisanie właściciela do każdego punktu gwarantuje terminowe wdrożenie zaplanowanych poprawek.
  • Skupienie na automatyzacji – zadania powinny koncentrować się na automatycznych testach, wzmocnieniu architektury i usuwaniu punktów SPOF.
  • Gwarancja realnych zmian – bez rzetelnego wdrożenia działań naprawczych dokument powypadkowy staje się bezużytecznym plikiem w archiwum.
Hero mode: Tryb „samotnego bohatera” - jedna osoba robi wszystko poza kanałem; obok milczenia, braku timeline, diagnozy zamiast recovery i braku eskalacji.
błędy

Najczęstsze błędy podczas incydentów wynikają z czynnika ludzkiego i komunikacyjnego, nie tylko technicznego: brak komunikacji - osoby pracujące nad problemem milczą, nie informują o postępach ani o zmiennych hipotezach, co prowadzi do sytuacji, w której pozostali członkowie zespołu nie wiedzą, co się dzieje, i duplikują działania - oraz pominięcie dokumentacji w trakcie awarii: w ferworze walki nikt nie prowadzi osi czasu, a po zakończeniu nie ma pełnego i wiarygodnego materiału do analizy. Oba błędy są szczególnie groźne, bo nie dają od razu widocznych objawów - szkody ujawniają się dopiero podczas post-mortem, kiedy okazuje się, że nie wiemy, co dokładnie się wydarzyło.

Do innych częstych błędów należą: nadmierna koncentracja na diagnozie zamiast na przywróceniu usługi („kopanie w logach” zamiast szybkiego recovery), brak eskalacji przy rosnącym wpływie awarii, prowadzenie rozmów poza wyznaczonym kanałem incydentu, zgadywanie przyczyn zamiast opierania się na danych oraz samodzielne „heroiczne” działanie pojedynczego inżyniera zamiast pracy zespołowej. Klasycznym problemem jest także „rozmycie odpowiedzialności”: kilka osób próbuje jednocześnie wprowadzać zmiany w systemie bez koordynacji, co może pogłębić awarię. Uczenie się na tych błędach jest celem szkoleń i symulacji - lepiej popełnić je podczas ćwiczenia niż podczas produkcyjnej awarii.

Z błędu czyni się więc zalecenia praktyczne: komunikuj nawet niepełne informacje (postępuj zgodnie z zasadą „communicate early, communicate often”), dokumentuj wydarzenia na bieżąco, przydzielaj jasne role i nie zmieniaj ich w trakcie akcji bez uzasadnienia, a przede wszystkim pamiętaj, że celem jest przywrócenie usługi, nie perfekcyjna diagnoza w trakcie awarii. Analiza listy typowych błędów i ich przeciwdziałań stanowi doskonałą podstawę do budowania runbooków i checklist, które w kolejnych awariach prowadzą zespół za rękę. Terminologia: common mistakes, communication gap, missing documentation, hero mode, lack of escalation, tunnel vision, checklist, runbook.

Wyjaśnienie skrótów użytych na slajdzie:
HeroCulture – Hero Culture Anti-pattern – antywzorzec kultury bohaterów; Szkodliwe zjawisko polegające na poleganiu na improwizacji pojedynczych 'gwiazd' zamiast na procedurach.
Blaming – Blaming Culture Anti-pattern – antywzorzec obwiniania; Toksyczna postawa szukania winnych prowadząca do zatajania problemów i paraliżu decyzyjnego.
NoIC – Lack of Clear Incident Commander – brak jednoznacznego dowódcy; Sytuacja chaosu organizacyjnego, w której wielu inżynierów podejmuje sprzeczne działania.
Uncommunicated – Uncommunicated Production Changes – niezakomunikowane modyfikacje; Wdrażanie chaotycznych poprawek na produkcji bez informowania reszty zespołu ratunkowego.
PrematureClosing – Premature Incident Closing – przedwczesne zamknięcie incydentu; Zakończenie akcji ratunkowej przed pełną weryfikacją metryk, prowadzące do natychmiastowego nawrotu awarii.

29/55 Komunikacja z klientem
Komunikacja z klientem: Strona statusowa (status page): statusy per usługa - operational / degraded / partial outage / major outage. Publiczne aktualizacje (public updates): co się stało, od kiedy, jakie działania, kiedy kolejna aktualizacja. Zasady: regularność, uczciwość, prosty język, brak obietnic terminowych bez pokrycia. Przejrzysta komunikacja buduje zaufanie nawet podczas awarii. Status page hostowana poza główną infrastrukturą.

Klient czyta status page, nie logi: cztery statusy, regularne update i zero obietnic bez pokrycia.

  • Priorytetyzacja w rejestrze zadań – wnioski z raportu post-mortem powinny trafiać bezpośrednio do głównego backlogu projektowego firmy.
  • Najwyższa ranga w sprintach – inżynierska dyscyplina nakazuje traktowanie zadań poprawiających niezawodność z najwyższym priorytetem w pracach.
  • Cykliczny przegląd realizacji – zespół musi regularnie weryfikować postęp prac nad zaleceniami, zapobiegając ich spychaniu na dalszy plan.
  • Weryfikacja testami odporności – wdrożenie poprawek powinno być potwierdzane dedykowanymi testami regresyjnymi lub eksperymentami chaosu.
  • Ciągły wzrost odporności – konsekwentne domykanie zaleceń powypadkowych jest jedyną skuteczną drogą do budowy trwałej niezawodności systemów.
Statusy usługi: operational / degraded / partial outage / major outage na stronie poza główną infrastrukturą; regularnie, uczciwie, prosto, bez pustych obietnic.
status

W trakcie incydentu komunikacja zewnętrzna musi być prowadzona w sposób profesjonalny i spokojny za pośrednictwem dedykowanej strony statusowej hostowanej poza infrastrukturą główną. Zabrania się podawania spekulacji lub obwiniania dostawców zewnętrznych. Pierwszy komunikat potwierdzający badanie problemu (Investigating) musi ukazać się w czasie do 15 minut od wykrycia awarii Sev1, a kolejne aktualizacje publikowane są w równych odstępach czasu (co 30 minut) aż do pełnego przywrócenia sprawności (Resolved).

Komunikacja z klientami podczas incydentu ma ogromne znaczenie dla reputacji firmy i zaufania użytkowników - nawet poważna awaria nie musi oznaczać utraty zaufania, jeśli organizacja komunikuje się przejrzyście, rzetelnie i terminowo. Podstawowym narzędziem jest strona statusowa (status page) pokazująca, które usługi działają normalnie (operational), które mają problemy (degraded/partial outage) oraz które są całkowicie niedostępne (major outage); przykładowe narzędzia to Statuspage (Atlassian), Cachet, Instatus czy dedykowany serwis we własnej infrastrukturze. Status page powinna działać także wtedy, gdy sama usługa pada - dlatego często hostowana jest poza główną infrastrukturą, w innym regionie lub u zewnętrznego dostawcy.

Obok strony statusowej stosuje się publiczne aktualizacje (public updates) publikowane na samej stronie statusowej, w mediach społecznościowych lub na blogu technicznym. Aktualizacje powinny informować: co się stało (ogólnie, bez zbędnych szczegółów technicznych), skąd i od kiedy problem występuje, jakie działania podejmuje zespół, oraz kiedy można spodziewać się kolejnej aktualizacji. Kluczowe zasady skutecznej komunikacji kryzysowej to: regularność (komunikaty co ustalony interwał, nawet jeśli nie ma nowych informacji), uczciwość (nie ukrywamy skali problemu, nie ściemniamy), prostota języka oraz jednoznaczne określenie działań użytkownika (czy musi zrobić coś samodzielnie, np. ponowić płatność, czy też czekać). Ważne jest też, aby nie obiecywać terminów naprawy, których nie możemy dotrzymać - zamiast konkretnej godziny lepiej podać „spodziewany postęp w ciągu 30 minut”.

W komunikacji z klientami bardzo ważna jest rola zaplanowania kanałów: wewnętrzny komunikator (np. incident channel) i zewnętrzna strona statusowa powinny być rozdzielone, aby informacje dla klientów były przefiltrowane i spójne z polityką firmy. Osobą odpowiedzialną za komunikację zewnętrzną bywa dedykowany członek zespołu incydentu (external communications lead), wspierany przez dział marketingu czy PR przy poważnych awariach. Transparentna komunikacja buduje zaufanie nawet w trakcie awarii - klienci wolą wiedzieć, co się dzieje, niż żyć w niepewności i domyślać się, że coś z firmą jest nie tak. Terminologia: status page (strona statusowa), public update (aktualizacja publiczna), operational/degraded/major outage, crisis communication (komunikacja kryzysowa), transparency (przejrzystość), status update frequency.

Wyjaśnienie skrótów użytych na slajdzie:
StatusPage – Public Service Status Page – publiczna strona statusowa; Podstawowe narzędzie transparentnej komunikacji z klientami podczas awarii systemów.
Transparency – Radical Operational Transparency – radykalna transparentność operacyjna; Budowanie długofalowego zaufania klientów poprzez uczciwe i szybkie informowanie o awariach.
SLA – Service Level Agreement Claims – roszczenia z tytułu umowy SLA; Procedura naliczania rekompensat finansowych dla klientów poszkodowanych w wyniku incydentu.
Credit – Service SLA Financial Credit – kredyt finansowy za naruszenie SLA; Automatyczna bonifikata na fakturze przyznawana klientom biznesowym po przekroczeniu limitu przestoju.
Trust – Customer Trust Preservation – ochrona zaufania klientów; Nadrzędny cel profesjonalnej komunikacji kryzysowej w inżynierii usług cyfrowych.

30/55 Raport po angielsku (przykład)
Przykład EN (English template): Standardowe sekcje międzynarodowego raportu: 1) Impact - ilościowo: „Payment service was unavailable for 35 minutes (14:05-14:40 UTC). ~12,000 users (4% of traffic) affected." 2) Root cause - przyczyna techniczna + przyczyny systemowe. 3) Actions - tabela: Action, Owner, Due date, Status. 4) Lessons learned. Standard spotykany w międzynarodowych firmach technologicznych.

Raport EN w czterech częściach: Impact liczbami, Root cause z systemem, Actions tabelą i Lessons na koniec.

  • Metryki sprawności operacyjnej – systematyczny pomiar czasu obsługi awarii pozwala obiektywnie ocenić dojrzałość zespołu i telemetrii.
  • Średni czas wykrycia MTTD – określa liczbę minut od momentu pojawienia się wady do jej zarejestrowania przez systemy obserwacji.
  • Średni czas potwierdzenia MTTA – mierzy, ile czasu upływa od wysłania powiadomienia do oficjalnego podjęcia akcji przez dyżurnego inżyniera.
  • Średni czas naprawy MTTR – definiuje całkowity czas potrzebny zespołowi na przywrócenie sprawności platformy i zakończenie awarii.
  • Główny cel optymalizacji SRE – dążenie do skracania tych wskaźników jest fundamentem doskonalenia procesów inżynierii niezawodności.
Impact: Sekcja wpływu ilościowo (czas, użytkownicy, SLO, skutki); z root cause, actions (tabela) i lessons learned - standard międzynarodowy.
wzór

Angielski wzór raportu z incydentu to powszechny standard w branżach technologicznych na całym świecie, oparty na trzech kluczowych sekcjach: Impact (wpływ), Root cause (przyczyna źródłowa) oraz Actions (działania). Używanie tych samych nagłówków ma ogromną praktyczną wartość: raporty z różnych zespołów, firm i dostawców stają się porównywalne, a członkowie międzynarodowych zespołów mogą szybko odnaleźć w nich potrzebne informacje. Standardowe sekcje spotyka się niemal we wszystkich dojrzałych organizacjach SRE, więc umiejętność czytania i tworzenia takiego raportu jest podstawą pracy zawodowej inżyniera w globalnym środowisku.

Sekcja Impact opisuje skutki awarii w sposób ilościowy i mierzalny: czas trwania incydentu, liczbę dotkniętych użytkowników, wpływ na dostępność usługi (związek ze SLO), ewentualne konsekwencje finansowe czy prawne. Przykładowe zdania: „Payment service was unavailable for 35 minutes between 14:05 and 14:40 UTC. Approximately 12,000 users (4% of traffic) were affected.” Taki opis pozwala ocenić wagę incydentu i porównywać go z innymi. Sekcja Root cause opisuje wynik analizy przyczyn - zarówno bezpośrednią przyczynę techniczną (np. „database replica disk became full, causing write failures”), jak i przyczyny pośrednie (np. „no alert was defined for disk utilization above 80%”). Dobry raport rozróżnia contributors (czynniki współprzyczyniające się), co pozwala na skuteczne działanie zapobiegawcze.

Sekcja Actions to lista konkretnych działań zapobiegawczych, często w formie tabeli z kolumnami: Action, Owner, Due date, Status. Standardowy raport kończy się sekcją Lessons learned lub postmortem review, w której opisane są wnioski wyciągnięte z przebiegu incydentu (np. „detection time was too long due to missing alert”). Należy pamiętać o zasadach omówionych na slajdzie 19: raport piszemy fact-bearing, po angielsku precyzyjnie i bez zbędnych ozdobników, unikając żargonu wewnętrznego. Terminologia: impact (wpływ), root cause (przyczyna źródłowa), actions (działania), contributing factors, owner, due date, lessons learned, English template, international communication.

Wyjaśnienie skrótów użytych na slajdzie:
Outage – Major Service Outage – poważna awaria usługi; Termin angielski oznaczający całkowitą niedostępność systemu w międzynarodowym raporcie technicznym.
RootCause – Underlying Technical Root Cause – techniczna przyczyna źródłowa; Szczegółowe wyjaśnienie usterki w sekcji raportu przeznaczonej dla inżynierów.
Mitigation – Mitigation and Workaround Steps – kroki mitygacji i obejścia; Opis działań ratunkowych podjętych w celu szybkiego przywrócenia ruchu w wersji angielskiej.
ActionItems – Follow-up Action Items Table – tabela dalszych działań zapobiegawczych; Zestawienie zadań naprawczych z terminami i odpowiedzialnymi inżynierami w raporcie EN.
UTC – Universal Coordinated Timezone – uniwersalna strefa czasowa UTC; Obowiązkowy standard zapisu znaczników czasu w anglojęzycznej dokumentacji poawaryjnej.

31/55 Raport po polsku (odpowiednik)
Przykład PL: Polski odpowiednik z tymi samymi sekcjami, co wersja EN: Wpływ / Impact, Przyczyna źródłowa / Root cause, Działania / Actions. Przykład: „Usługa płatności była niedostępna 35 minut (14:05-14:40). Dotkniętych ok. 12 000 użytkowników (4% ruchu)." Tłumaczenie terminów: root cause → przyczyna źródłowa, action item → działanie naprawcze, timeline → oś czasu. Te same fakty, spójne tłumaczenie.

Po polsku te same fakty: lustrzane sekcje, sens zamiast kalki i narracja naturalna jak u siebie.

  • Złudzenie średniej arytmetycznej – tradycyjna średnia bywa myląca, maskując nieliczne, lecz katastrofalne w skutkach wielogodzinne awarie.
  • Percentyle p90 oraz p95 – pozwalają poznać rzeczywisty czas trwania najtrudniejszych incydentów, z jakimi mierzyła się organizacja.
  • Interpretacja wskaźnika p95 – wartość informuje, że dziewięćdziesiąt pięć procent awarii zostało opanowanych w czasie krótszym niż dany próg.
  • Identyfikacja słabych punktów – analiza przypadków ze skrajnego ogona rozkładu ujawnia luki w procedurach eskalacji rzadkich awarii.
  • Standard inżynieryjny Google – opieranie analizy efektywności na percentylach stanowi powszechnie uznany standard współczesnego SRE.
Lustrzane sekcje: Wpływ/Impact, Przyczyna/Root cause, Działania/Actions (plus Summary, Timeline); te same fakty, spójne tłumaczenie.
wzór

Polski odpowiednik raportu z incydentu ma te same sekcje co wersja angielska: Wpływ (Impact), Przyczyna źródłowa (Root cause) oraz Działania (Actions); dwujęzyczne prowadzenie dokumentacji incydentalnej (PL/EN) stosuje się w zespołach działających w Polsce, ale współpracujących z zagranicznymi partnerami lub klientami - pozwala udostępniać raporty obu grupom odbiorców bez tłumaczenia na gorąco. Polski wzorzec nie jest prostym tłumaczeniem angielskiego - przyjmuje naturalne dla polskiego czytelnika sformułowania i strukturę, zachowując techniczną precyzję: Wpływ - "Usługa płatności była niedostępna 35 minut (14:05-14:40). Dotkniętych zostało ok. 12 000 użytkowników (4% ruchu).", Przyczyna źródłowa - "Przepełnienie dysku repliki bazy danych spowodowało błędy zapisu; brak alertu o użyciu dysku powyżej 80%.", Działania - "Dodać regułę alertu o użyciu dysku; zaktualizować runbook; zweryfikować pojemność dysków.".

Porównanie wersji PL i EN tego samego raportu jest znakomitym ćwiczeniem dydaktycznym, które uczy spójnego tłumaczenia terminologii technicznej. Przy tłumaczeniu kluczowe jest zachowanie idei, nie dosłowny przekład poszczególnych słów - na przykład „root cause” przetłumaczymy jako „przyczyna źródłowa”, „action item” jako „działanie naprawcze”, a „timeline” jako „oś czasu”. Ważne jest również, aby dane liczbowe i fakty były identyczne w obu wersjach - dwujęzyczność nie oznacza dwóch różnych opisów tego samego zdarzenia, lecz jeden, spójny zbiór faktów. Praktyka mówienia po polsku z terminami technicznymi w języku angielskim (jak w zdaniu „Ze względu na priorytet SEV-2 eskalowaliśmy incydent do zespołu dyżurnego”) w naturalny sposób zbliża całą dokumentację do standardu przyjętego w branży, w której angielski jest lingua franca.

W tabeli porównawczej PL/EN widać, że sekcje są lustrzane: Wpływ / Impact, Przyczyna źródłowa / Root cause, Działania / Actions - a dodatkowe sekcje, takie jak Podsumowanie / Summary i Oś czasu / Timeline, także mają swoje angielskie odpowiedniki. To właśnie ta spójność strukturalna umożliwia automatyczne porównywanie raportów w systemach zarządzania incydentami i sprawia, że dokument jest jednoznaczny niezależnie od języka odbiorcy. Terminologia: odpowiednik (equivalent), tłumaczenie terminów (term translation), spójność faktów (fact consistency), glossary (słownik pojęć), PL/EN parallel reporting.

Wyjaśnienie skrótów użytych na slajdzie:
Incydent – Zarządzanie incydentem w języku polskim – zarządzanie incydentem; Oficjalny polski termin oznaczający nieplanowane przerwanie świadczenia usługi teleinformatycznej.
Przyczyna – Przyczyna źródłowa awarii – przyczyna źródłowa; Polski odpowiednik pojęcia Root Cause stosowany w dokumentacji kierowanej do krajowych organów.
Naprawa – Naprawa i mitygacja – działania naprawcze; Opis czynności technicznych przywracających normalne funkcjonowanie infrastruktury w raporcie PL.
Działania – Działania korygujące i zapobiegawcze – działania zapobiegawcze; Wymóg normatywny definiujący zadania mające zapobiec ponownemu wystąpieniu usterki.
Wnioski – Wnioski poawaryjne – wnioski inżynierskie; Podsumowanie lekcji wyciągniętych przez zespół z przebiegu sytuacji kryzysowej.

32/55 Kultura uczenia się
Learning culture (kultura uczenia się): Organizacja systematycznie przekształca doświadczenia - zwłaszcza błędy i incydenty - w trwałą wiedzę i poprawę procesów. Fundament: otwarte dzielenie się wiedzą (post-mortem, timeline, wnioski widoczne dla całej organizacji, nie tylko uczestników). Wymaga psychologicznego bezpieczeństwa i kompetencji komunikacyjnych (K03). Elementy: przeglądy post-mortem, lessons learned, tech talki, runbooki, mentoring.

Organizacja uczy się, gdy wiedza wychodzi z głów do repozytorium. Najpierw blameless, potem reszta.

  • Finansowy wymiar przestoju – każda poważna awaria generuje wymierne straty wynikające z utraconych zamówień oraz kar umownych SLA.
  • Utrata reputacji na rynku – długotrwała niedostępność platformy niszczy zaufanie klientów i ułatwia ich odpływ do konkurencyjnych firm.
  • Kalkulacja kosztu godziny awarii – precyzyjne wyliczenie strat ułatwia uzasadnienie biznesowi konieczności inwestycji w redundancję.
  • Ukryte koszty pracownicze – w budżecie awarii należy uwzględnić nadgodziny dyżurnych oraz straty z powodu wstrzymania prac nad produktem.
  • Wspólny język z zarządem – przeliczenie technicznych parametrów na liczby finansowe buduje zrozumienie dla celów inżynierii niezawodności.
Lessons learned: Lekcje w repozytorium (post-mortemy, tech talki, runbooki, mentoring); doświadczenie jednostki staje się wiedzą organizacji (K03).
nauka

Kultura uczenia się (learning culture) to jeden z filarów organizacji działających w modelu SRE: organizacja systematycznie przekształca doświadczenia - szczególnie te związane z błędami i incydentami - w trwałą wiedzę i ulepszenia procesów, aby nie tylko naprawić bieżący problem, ale zrozumieć, jak unikać podobnych w przyszłości i jak lepiej współpracować. Fundamentem jest otwarte dzielenie się wiedzą: raporty post-mortem, osie czasu incydentów, analizy i wnioski są udostępniane całemu zespołowi (a często i całej firmie), nie trafiają wyłącznie do "szafki" uczestników - tylko wtedy doświadczenie jednostki staje się kapitałem całej organizacji. Taka postawa przekłada się na mniej powtarzających się incydentów, szybszą diagnozę i większą dojrzałość operacyjną.

Kultura uczenia się łączy się ściśle z kompetencjami współpracy i komunikacji (odniesienie do wymagania K03 z sylabusa). Aby dzielić się wiedzą, trzeba umieć ją komunikować: opisać fakty, sformułować wnioski, przedstawić je w przystępny sposób, a także przyjąć uwagi od innych. Otwarta wymiana wiedzy wymaga też psychologicznego bezpieczeństwa - w przeciwnym razie nikt nie będzie chciał publicznie mówić o błędach. Dlatego kultura uczenia się jest naturalnym kolejnym krokiem po kulturze blameless omówionej na slajdach 16 i 17: najpierw eliminujemy strach przed byciem winnym, potem możemy swobodnie się uczyć. W praktyce elementami kultury uczenia się są: regularne przeglądy post-mortem, sekcje „lessons learned” w retrospektywach, tech talki i prezentacje, dokumentacja wiedzy (wiki, runbooki) oraz mentoring mniej doświadczonych członków zespołu.

Warto podkreślić, że kultura uczenia się to nie tylko reagowanie na awarie, lecz także proaktywne testowanie systemów (symulacje, game-day, chaos testing) oraz systematyczne doskonalenie narzędzi i procesów. Organizacja ucząca się (learning organization) nie boi się przyznać, że coś nie zadziałało - traktuje to jako dane wejściowe do poprawy. W ujęciu SRE najbardziej wartościowym wskaźnikiem kultury uczenia się jest tempo implementacji wniosków z incydentów: jeżeli po każdym post-mortem wprowadzamy realne zmiany i widać ich skutek w metrykach, to znak, że pętla uczenia się działa. Terminologia: learning culture (kultura uczenia się), learning organization, knowledge sharing (dzielenie się wiedzą), lessons learned, continuous improvement, psychological safety, mentorship.

Wyjaśnienie skrótów użytych na slajdzie:
LearningOrganization – Learning Organization Paradigm – paradygmat organizacji uczącej się; Koncepcja zarządzania, w której przedsiębiorstwo stale modyfikuje swoje procedury pod wpływem doświadczeń.
Kaizen – Kaizen Continuous Improvement – filozofia ciągłego doskonalenia Kaizen; Japońska filozofia małych, systematycznych ulepszeń leżąca u podstaw kultury SRE.
ContinuousImprovement – Continuous Process Improvement – ciągłe doskonalenie procesów; Zasada eliminacji długu technicznego i procedur operacyjnych po każdej awarii.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina techniczna, w której kultura uczenia się jest traktowana na równi z kodem źródłowym.
PsychologicalSafety – Psychological Safety Climate – klimat bezpieczeństwa psychologicznego; Atmosfera w zespole umożliwiająca otwarte zgłaszanie wątpliwości i przyznawanie się do błędów.

33/55 Podsumowanie incydentów (cz. 1)
Podsumowanie cz. 1: Dwa filary: RCA (Root Cause Analysis - szukanie przyczyn źródłowych; techniki: 5 Whys, fishbone, FTA) i post-mortem (raport: summary, timeline, root cause, action items). Razem tworzą zamkniętą pętlę doskonalenia (learning loop): incydent → dokumentacja → RCA → raport → action items → wdrożenie → mniej/łagodniejsze incydenty.

Dwa filary incydentów: RCA szuka przyczyn, post-mortem nadaje kształt. Razem zamykają pętlę nauki.

  • Szczera komunikacja zewnętrzna – relacje z użytkownikami w kryzysie powinny być przejrzyste, uczciwe i pozbawione technicznego bełkotu.
  • Publiczny skrót post-mortem – publikacja oficjalnego podsumowania buduje wizerunek odpowiedzialnej firmy potrafiącej uczyć się na błędach.
  • Elementy oświadczenia dla klientów – komunikat powinien wyjaśnić przyczyny, przeprosić za niedogodności i opisać kroki zapobiegawcze.
  • Budowanie zaufania w trudnościach – klienci biznesowi doceniają otwartość i chętniej przedłużają kontrakty z wiarygodnym partnerem IT.
  • Długofalowa lojalność użytkowników – właściwie zaopiekowany kryzys wizerunkowy może paradoksalnie wzmocnić pozycję rynkową przedsiębiorstwa.
Learning loop: Pętla uczenia incydent → dokumentacja → RCA → raport → action items → wdrożenie → mniej incydentów; filary RCA i post-mortem.
podsumowanie

Pierwsza część podsumowania pojęć zarządzania incydentem opiera się na dwóch filarach: RCA (Root Cause Analysis - analiza przyczyn źródłowych) oraz post-mortem (raport po incydencie, dokumentacja i nauka). RCA odpowiada za zrozumienie, dlaczego awaria wystąpiła - prowadzi od objawów do przyczyn źródłowych przy użyciu technik takich jak 5 Whys, diagram Ishikawy czy FTA; post-mortem to dokument i proces, który nadaje tej analizie kształt, pozwala opisać pełny przebieg zdarzenia i zaplanować działania naprawcze. Oba narzędzia działają w parze: bez rzetelnej analizy przyczyn raport byłby jedynie kroniką zdarzeń, a bez raportu analiza nie miałaby trwałego śladu w organizacji.

Z punktu widzenia cyklu doskonalenia organizacji, RCA i post-mortem tworzą razem zamkniętą pętlę (closed loop): incydent → dokumentacja i analiza przyczyn → raport i wnioski → action items → wdrożenie → (potencjalnie kolejny, ale mniej prawdopodobny incydent). Każdy krok tej pętli zależy od poprzedniego: bez dobrej dokumentacji prowadzonej w trakcie awarii analiza przyczyn będzie rozmyta; bez analizy wnioski będą powierzchowne; bez action items nic nie zostanie realnie zmienione. Dlatego właśnie tak dużo uwagi poświęcamy w tym kursie dyscyplinie dokumentacyjnej i ścisłości analitycznej - to one decydują o jakości całej pętli uczenia się. Warto też pamiętać, że RCA i post-mortem są skuteczne tylko w kulturze blameless (slajd 17) i w organizacji, w której wnioskom nadaje się wagę (slajd 22).

Podsumowując tę część materiału: student powinien umieć samodzielnie przeprowadzić prostą analizę przyczyn (np. metodą 5 Whys) i przekształcić jej wynik w strukturę raportu post-mortem. Powinien też rozumieć, że proces ten nie kończy się na napisaniu dokumentu - kończy się wtedy, gdy wykonane zostaną zaplanowane działania zapobiegawcze. Te dwie kompetencje będą następnie weryfikowane w zadaniach domowych (slajd 35) oraz w części 2 podsumowania (slajd 34), gdzie uzupełnimy obraz o metryki i kulturę blameless. Terminologia: RCA, postmortem (post-mortem), closed loop, action items, learning loop, incident management, blameless culture.

Wyjaśnienie skrótów użytych na slajdzie:
ICS – Incident Command System – system dowodzenia incydentem; Podsumowanie pierwszej części wykładu poświęconej organizacji ról i procedur ratunkowych.
IC – Incident Commander Role – rola dowódcy incydentu; Kluczowa funkcja przywódcza zapewniająca spokój i koordynację w trakcie kryzysu produkcyjnego.
Severity – Incident Severity Classification – klasyfikacja ważności incydentu; Rygorystyczna gradacja awarii od P1 do P4 porządkująca priorytety reakcji operacyjnej.
Mitigation – Priority of Fast Mitigation – priorytet szybkiej mitygacji; Zasada przedkładania natychmiastowego przywrócenia ruchu nad dociekanie przyczyn błędu.
Timeline – Accurate Timeline Keeping – prowadzenie precyzyjnej osi czasu; Rola skryby w dokumentowaniu każdego kroku i decyzji na osi czasu w standardzie UTC.

34/55 Podsumowanie incydentów (cz. 2)
Podsumowanie cz. 2: Kluczowe pojęcia: MTTA (Mean Time To Acknowledge - czas do przyjęcia incydentu przez zespół), MTTR (Mean Time To Resolve - czas do przywrócenia usługi), MTTD (Mean Time To Detect) i blameless (kultura bez winy). Mierzenie i analiza trendów (mediany, percentyle) pozwala ocenić jakość procesu i planować zasoby. Blameless = warunek skuteczności RCA i metryk.

Trzy zegary incydentu (MTTD/MTTA/MTTR) plus blameless jako paliwo. Mierz trendami i percentylami.

  • Wymogi prawne RODO – europejskie rozporządzenie nakłada prawny obowiązek zgłoszenia wycieku danych do urzędu w terminie do 72 godzin.
  • Zaangażowanie inspektora IOD – incydenty zagrażające poufności danych osobowych wymagają natychmiastowego udziału prawników w sztabie.
  • Kary za zatajanie incydentów – próby ukrywania awarii bezpieczeństwa grożą gigantycznymi sankcjami finansowymi i odpowiedzialnością karną.
  • Rygorystyczne normy sektorowe – standardy takie jak PCI-DSS precyzyjnie regulują procedury audytu i zgłaszania awarii płatniczych.
  • Ścisła współpraca z działem prawnym – inżynierowie SRE muszą ściśle koordynować akcję z prawnikami, dbając o legalność podejmowanych kroków.
Blameless jako warunek: Bez kultury bez winy dane do RCA i metryk są nierzetelne; MTTA/MTTR/MTTD z trendami mierzą jakość procesu.
słownik

Druga część podsumowania zagadnień incydentów skupia się na dwóch kluczowych pojęciach: metrykach MTTA/MTTR oraz kulturze blameless. MTTA (Mean Time To Acknowledge) mierzy średni czas od wykrycia awarii (lub zgłoszenia) do potwierdzenia incydentu i rozpoczęcia działań, a MTTR (Mean Time To Resolve) - czas od wykrycia do pełnego przywrócenia usługi; wraz z częstotliwością incydentów i MTTD (time to detect) pozwalają zobiektywizować ocenę procesu i obserwować jego poprawę w czasie. Niskie MTTA oznacza sprawny alerting i dobrą gotowość dyżurnych; niskie MTTR świadczy o skutecznych procedurach, runbookach i narzędziach oraz o dobrej współpracy zespołu podczas akcji.

Mierzenie tych wskaźników ma praktyczny sens tylko wtedy, gdy zbiera się je systematycznie i porównuje w trendach. Warto przy tym pamiętać o ograniczeniach średnich - stosuje się również medianę i percentyle (p50, p90), które lepiej oddają typową reakcję. Analiza składników MTTR bywa najbardziej pouczająca: można rozbić go na czas do wykrycia, czas do diagnozy i czas do naprawy, co wskaże dokładnie, który etap wymaga poprawy. Przykładowo, jeśli czas do diagnozy systematycznie dominuje, oznacza to potrzebę lepszych metryk, logów lub runbooków, a nie szybszych restartów. Wskaźniki incydentów łączą się też z pojęciem error budget i SLO (wykład 2) - analiza trendów MTTA/MTTR wspiera decyzje o alokacji zasobów zespołu.

Drugie kluczowe pojęcie z tej części to blameless - kultura bez obwiniania, bez której cały system post-mortem zawodzi. Przypomnijmy najważniejsze: blameless post-mortem opisuje fakty, przyczyny i procesy, ale nigdy nie wskazuje winnego; zakłada, że ludzie działają zgodnie z najlepszymi intencjami, a błędy wynikają z systemu; buduje bezpieczeństwo psychologiczne umożliwiające szczerą wymianę informacji. Ta kultura jest warunkiem skuteczności zarówno RCA, jak i metryk - bo tylko przy pełnej otwartości danych zebrane metryki i wnioski są wiarygodne. Razem MTTA/MTTR i blameless tworzą spójny obraz dojrzałego zespołu incydentowego: mierzymy, uczymy się i nie szukamy winnych, lecz naprawiamy system. Terminologia: MTTA (Mean Time To Acknowledge), MTTR (Mean Time To Resolve), MTTD (Mean Time To Detect), SLO, error budget, blameless, psychological safety, trending.

Wyjaśnienie skrótów użytych na slajdzie:
BlamelessPostMortem – Blameless Post-mortem Philosophy – filozofia analizy poawaryjnej bez obwiniania; Podsumowanie drugiej części wykładu poświęconej rzetelnemu wyciąganiu wniosków.
5Whys – Five Whys Diagnostic Method – metoda diagnostyczna 5 Whys; Technika dociekania ukrytych wad systemowych i luk proceduralnych.
ActionItems – Measurable Action Items Tracking – śledzenie mierzalnych zadań naprawczych; Konkretne zobowiązania inżynierskie stanowiące jedyną gwarancję poprawy niezawodności.
MTTR – Mean Time To Recover Metric – metryka średniego czasu naprawy; Wskaźnik podsumowujący sprawność zespołu i skuteczność procedur runbookowych.
Culture – Resilient Engineering Culture – odporna kultura inżynierska; Wartości organizacyjne stawiające na współpracę, automatyzację i bezpieczeństwo psychologiczne.

35/55 Praca własna: zadania (incydent)
Zadania własne (homework): Trzy części: 1) Raport z incydentu (pełna struktura post-mortem: summary, timeline, root cause, action items), 2) Analiza przyczyn (przynajmniej jedna technika RCA, np. 5 Whys - od objawów do przyczyny źródłowej), 3) Wersja PL i EN (te same fakty, spójne terminy). Ocena: struktura, precyzja, jakość action items, zgodność wersji językowych. Dokument fact-bearing.

Zadanie domowe: pełny post-mortem PL/EN z RCA. Struktura, precyzja i action items - jak na rekrutacji.

  • Praktyczny warsztat powypadkowy – ćwiczenie sporządzania raportu post-mortem pozwala studentom przećwiczyć formułowanie wniosków na faktach.
  • Analiza autentycznej osi czasu – uczestnicy badają przebieg symulowanej awarii, wskazując błędy komunikacji oraz braki w monitoringu.
  • Definiowanie działań naprawczych – zadaniem studenta jest zaplanowanie konkretnych zadań korygujących wraz z terminami i wagami ważności.
  • Precyzyjny warsztat językowy – ćwiczenie uczy zwięzłego stylu technicznego oraz wyrabia nawyk konstruktywnego podejścia do błędów.
  • Kluczowa kompetencja rynkowa – umiejętność rzetelnego prowadzenia dochodzenia powypadkowego jest niezwykle ceniona w pracy inżyniera SRE.
Document fact-bearing: Dokument oparty na faktach jako kryterium oceny; raport + RCA (5 Whys) + spójne PL/EN ze strukturą, precyzją i action items.
zadania

Zadania do pracy własnej (homework) praktycznie stosują całą wiedzę zdobytą na tym wykładzie w trzech częściach: przygotowanie raportu z incydentu, analiza przyczyn źródłowych oraz przygotowanie wersji raportu w języku polskim i angielskim. Ćwiczenie sprawdza jednocześnie umiejętności praktyczne (pisanie dokumentu o ustalonej strukturze), analityczne (przeprowadzenie RCA na podstawie podanego opisu awarii) oraz językowe (dwujęzyczne raportowanie zgodnie z wymaganiami sylabusa). Zadanie jest też bezpośrednim przygotowaniem do symulacji, a jego wyniki mogą być prezentowane na kolejnych zajęciach.

Przygotowanie raportu polega na opisaniu scenariusza incydentu (np. awarii usługi płatności według podanego przez prowadzącego przebiegu) z zachowaniem pełnej struktury post-mortem: streszczenie (summary), oś czasu (timeline), przyczyny (root cause) oraz działania zapobiegawcze (action items). Należy pamiętać o wszystkich zasadach z wykładu: styl fact-bearing, precyzyjne oznaczenie czasów, jednoznaczne przypisanie właścicieli i terminów dla działań, neutralność emocjonalna. Analiza przyczyn wymaga zastosowania co najmniej jednej techniki RCA (np. 5 Whys) i wykazania, w jaki sposób doszło się od objawów do przyczyny źródłowej. Wersje PL i EN powinny opisywać te same fakty - tłumaczenie ma być spójne co do treści i terminologii.

Zadanie to ma również wymiar praktyczny dla przyszłej pracy zawodowej: umiejętność napisania czytelnego, rzetelnego raportu po awarii jest jednym z kluczowych efektów uczenia się kursu SRE i niemal standardowym pytaniem na rozmowach rekrutacyjnych w branży („opisz incydent, który rozwiązywałeś”). Podczas oceny zwracana będzie uwaga na strukturę, precyzję, poprawność analizy przyczynowej, jakość action items oraz zgodność wersji językowych. Warto przy tym pamiętać o tym, że raport pisze się także po to, aby go ktoś przeczytał - dlatego czytelność, spójność i zwięzłość są równie ważne jak poprawność techniczna. Terminologia: homework, incident report, root cause analysis, PL/EN version, action items, deliverable, assessment criteria, technical writing.

Wyjaśnienie skrótów użytych na slajdzie:
IncidentSimulation – Hands-on Incident Simulation – praktyczna symulacja incydentu; Samodzielne zadanie laboratoryjne polegające na opanowaniu sztucznie wywołanej awarii.
RunbookDrafting – Operational Runbook Drafting – tworzenie instrukcji operacyjnych; Opracowanie przez studentów brakujących procedur awaryjnych dla wdrożonych usług.
PostMortemWriteup – Complete Post-mortem Writeup – sporządzenie pełnego raportu post-mortem; Zadanie zaliczeniowe polegające na przygotowaniu profesjonalnego raportu poawaryjnego.
Lab – Academic Computer Laboratory – akademickie laboratorium komputerowe; Środowisko ćwiczeniowe, w którym studenci testują procedury zarządzania incydentem.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Praktyczna weryfikacja kompetencji inżynierskich zdobytych w trakcie całego kursu.

36/55 Narzędzia wspierające incydenty
Narzędzia wspierające incydenty: Trzy kategorie: 1) Dokumentacja - wiki (Confluence, Notion, GitBook), szablony post-mortem, runbooki. 2) Komunikacja - czaty (Slack, Teams), wideokonferencje (war room), kanały incydentu, status pages. 3) Systemy zarządzania incydentem - PagerDuty, Incident.io, Opsgenie, FireHydrant, Grafana OnCall (integracja alerting, eskalacja, dokumentacja). Integracja narzędzi w spójny pipeline = szybka reakcja.

Trzy szufladki narzędzi: dokumenty, komunikacja i platformy. Izolowane wydłużają, zintegrowane leczą.

  • Dedykowane systemy zarządzania incydentem – organizacje wdrażają platformy informatyczne automatyzujące proces tworzenia post-mortem.
  • Automatyczny import danych – nowoczesne narzędzia same importują kluczowe wpisy z czatu oraz wykresy telemetryczne do szablonu raportu.
  • Bezpośrednia integracja z Jirą – mechanizmy platformy ułatwiają zamianę zaleceń powypadkowych w gotowe zadania w systemie projektowym.
  • Wspólne repozytorium post-mortem – centralny rejestr raportów ułatwia przeszukiwanie historii i zapobiega powielaniu dawnych błędów.
  • Skupienie na sednie problemu – automatyzacja edycji dokumentów uwalnia inżynierów od żmudnej pracy, pozwalając skupić się na analizie RCA.
Grafana OnCall: Zarządzanie dyżurami zintegrowane z alertingiem; obok PagerDuty, Incident.io, Opsgenie, FireHydrant oraz wiki, runbooków i status pages.
narzędzia

Narzędzia wspierające zarządzanie incydentami to ekosystem współpracujących aplikacji w trzech głównych kategoriach: narzędzia dokumentacji, narzędzia komunikacji oraz specjalistyczne systemy zarządzania incydentami (incident management platforms). Do dokumentacji zaliczamy systemy wiki (Confluence, Notion, GitBook), repozytoria wiedzy, szablony raportów post-mortem oraz runbooki - instrukcje "co zrobić, gdy..."; do komunikacji - czaty zespołowe (Slack, Teams, Discord), wideokonferencje dla war roomu i dedykowane kanały incydentu. Do specjalistycznych platform należą PagerDuty, Incident.io, Opsgenie, FireHydrant czy Grafana OnCall, które integrują alerting (wykład 6), eskalację, koordynację zespołu i dokumentację w jednym miejscu.

Dobrze skonfigurowane narzędzia mają bezpośredni wpływ na czas reakcji i jakość naprawy. Automatyczne utworzenie kanału incydentu, automatyczne rozpoczęcie osi czasu, szybkie wezwanie zespołu (on-call escalation) czy gotowy szablon post-mortem to funkcje, które skracają MTTA/MTTR i redukują pracę ręczną (toil). W połączeniu z alertami (wykład 6) platformy do zarządzania incydentami potrafią również automatycznie łączyć alerty w zgłoszenia, oznaczać priorytet, komunikować status w intranetowym portalu i dostarczać skonsolidowane raporty. Kluczowa jest integracja narzędzi w spójny pipeline - narzędzia izolowane (osobny czat, osobny ticket, osobna wiki bez połączeń) wydłużają proces i generują chaos.

W procesie wyboru narzędzi warto kierować się zasadą proporcjonalności: mały zespół może korzystać z lekkiego rozwiązania (czat + wiki + proste biletowanie), podczas gdy duża organizacja potrzebuje platform zautomatyzowanych i skalowalnych. Istotne jest, aby narzędzia wspierały również kulturę blameless - np. przez łatwe publikowanie post-mortem i śledzenie action items w sposób przejrzysty, bez obwiniania. W praktyce bywa to wyzwanie, gdy narzędzia tego samego dostawcy są świetnie zintegrowane, ale drogie, a rozwiązania open source (np. Grafana OnCall, Zulip, Confluence-free wiki) wymagają większego wysiłku operacyjnego. Konfiguracja, szablony i dokumentacja procesów są często ważniejsze niż sam wybór marki narzędzia. Terminologia: documentation tools, communication tools, incident management platform, PagerDuty, Opsgenie, Grafana OnCall, runbook, escalation, ticketing, tool integration.

Wyjaśnienie skrótów użytych na slajdzie:
PagerDuty – PagerDuty Incident Management – platforma PagerDuty; Komercyjny system automatyzacji dyżurów i orkiestracji powiadomień alarmowych.
Opsgenie – Atlassian Opsgenie – system Opsgenie; Narzędzie integrujące harmonogramy dyżurów z kanałami eskalacji i komunikatorami zespołowymi.
FireHydrant – FireHydrant Incident Management Platform – platforma FireHydrant; Wyspecjalizowane środowisko automatyzujące tworzenie kanałów Slack i dokumentów post-mortem.
IncidentIO – Incident.io Slack-native Platform – platforma Incident.io; Nowoczesne narzędzie zarządzania incydentami zintegrowane natywnie z komunikatorem Slack.
Slack – Slack Incident Collaboration Channel – kanał współpracy w Slacku; Wirtualna przestrzeń koordynacji działań zespołu ratunkowego w trakcie aktywnej awarii.

37/55 Łączenie tematów cyklu
Spójna całość kursu: Wykład 8 domyka osiem modułów SRE. Zarządzanie incydentem łączy je w praktyce operacyjnej: Wykład 2 (SLI/SLO, error budget) → wymiary wpływu. Wykłady 3-4 (Grafana, Loki) → diagnosis. Wykład 5 (HA, load balancing) → recovery/failover. Wykład 6 (alerting) → detection. Wykład 7 (GitOps, ArgoCD) → rollback (najszybsza droga do przywrócenia usługi). SRE = myślenie całościowe (holistic thinking).

Wykład 8 spina kurs: każdy moduł dokłada cegłę do incydentu - od SLO, przez diagnozę i recovery, po rollback.

  • Wewnętrzne seminaria techniczne – wnioski z najciekawszych analiz powinny być omawiane na ogólnych forach inżynierskich w organizacji.
  • Weryfikacja pokrewnych platform – otwarta prezentacja awarii pozwala innym zespołom sprawdzić własne aplikacje pod kątem podobnych luk.
  • Wspólna baza wiedzy o awariach – regularne publikowanie dokumentów post-mortem buduje kulturę ciągłego uczenia się w całej korporacji.
  • Prezentacja dla nowych kadr – omówienie minionych kryzysów jest doskonałym materiałem szkoleniowym dla nowo zatrudnionych inżynierów.
  • Transmisja dobrych praktyk – transfer wiedzy pomiędzy zespołami zapobiega powstawaniu odizolowanych silosów kompetencyjnych w firmie.
Holistic thinking: Myślenie całościowe - wykład 8 spina moduły: SLO (wpływ), Grafana/Loki (diagnoza), HA (recovery), alerting (detection), GitOps (rollback).
mapa kursu

Ósmy, ostatni wykład łączy wszystkie wcześniejsze moduły kursu w jedną, spójną całość - zarządzanie incydentem korzysta z każdego tematu poruszanego w poprzednich wykładach i najpełniej wykorzystuje go w praktyce operacyjnej. Z wykładu 2 (metryki, SLI/SLO) pochodzi język opisu wagi incydentu: naruszenie SLO i zużycie error budget to precyzyjna miara wpływu; z wykładów 3-4 (Grafana, Loki) - narzędzia diagnozy (metryki i logi); z wykładu 5 (HA i Load Balancing) - mechanizmy recovery (failover, restart przez orchestrator, redundancja skracająca czas naprawy); z wykładu 6 (alerting) - wykrywanie incydentów; z wykładu 7 (GitOps) - rollback do ostatniego dobrego stanu w repozytorium Git, często najszybsza droga do przywrócenia usługi.

Takie łączenie tematów ma głębszy sens dydaktyczny: pokazuje, że SRE to zawód syntetyczny, wymagający myślenia całościowego, a nie tylko wąskiej specjalizacji w jednym narzędziu. Inżynier SRE, który projektuje awarię, musi rozumieć jednocześnie metryki i SLO (żeby wiedzieć, co mierzyć), monitoring i logi (żeby wiedzieć, czego szukać), architekturę HA (żeby wiedzieć, jak przełączyć usługę), alerting (żeby wiedzieć, kto i kiedy zostanie poinformowany) oraz GitOps (żeby wiedzieć, jak wycofać zmianę). W tym kontekście zarządzanie incydentem jest swoistym „sprawdzianem integracyjnym” całego zestawu umiejętności SRE - dlatego właśnie ten wykład wieńczy cały kurs.

Z praktycznego punktu widzenia oznacza to, że przygotowując się do zaliczenia lub do roli SRE, nie należy uczyć się tematu incydentów w izolacji. Warto przeanalizować przykładowy scenariusz awarii i wykonać go „wszystkimi dostępnymi narzędziami” z całego kursu: zgłosić alert (wykład 6), sprawdzić SLO (wykład 2), zlokalizować problem w metrykach i logach (wykłady 3-4), przywrócić usługę z wykorzystaniem HA (wykład 5) i wdrożyć zmiany przez GitOps (wykład 7). Taki symulowany przepływ jest najlepszą syntezą całego materiału i jednocześnie zapowiedzią sposobu pracy w rzeczywistych, produkcyjnych środowiskach. Terminologia: SRE skill set, integration, HA, alerting, GitOps, SLO/SLI, observability, end-to-end scenario, holistic thinking.

Wyjaśnienie skrótów użytych na slajdzie:
Observability – Observability Pillars Integration – integracja filarów obserwowalności; Syntetyczne połączenie metryk, logów i śladów rozproszonych w procesie diagnostyki.
Metrics – Prometheus Telemetry Metrics – metryki telemetryczne Prometheus; Źródło natychmiastowej detekcji anomalii i wyzwalania alertów w trakcie awarii.
Logs – Centralized Log Aggregation – centralizacja logów w Loki/ELK; Szczegółowy kontekst zdarzeń wykorzystywany przez ekspertów w fazie badania przyczyn.
HA – High Availability Architecture – architektura wysokiej dostępności; Zdublowane komponenty i mechanizmy failover chroniące przed incydentami o priorytecie P1.
GitOps – GitOps Declarative Operations – deklaratywne operacje GitOps; Pojedyncze źródło prawdy umożliwiające błyskawiczny i bezpieczny rollback za pomocą git revert.

38/55 Praktyczne wnioski dla SRE
Inżynier SRE (engineering approach to operations): Łączy administrację, automatyzację, monitorowanie i analitykę danych (SRE skill set). Projektuje systemy odporne na awarie (design for failure): redundancja, fail-safe, automatyzacja redukująca toil, decyzje oparte na danych (metryki > opinie), dokumentacja operacyjna (runbooki, post-mortemy). Od "strażaka" do projektanta niezawodności.

Od strażaka do projektanta: mniej gaszenia, więcej projektowania systemów, które gaszą się same.

  • Cykl ciągłego doskonalenia – proces zarządzania incydentami zamyka obieg informacji w obserwowalności i procedurach inżynierii SRE.
  • Informacja zwrotna dla monitoringu – wnioski powypadkowe bezpośrednio zasilają reguły Alertmanagera i wzbogacają pulpity w Grafanie.
  • Audyt architektury platformy – powtarzające się awarie są sygnałem do konieczności przebudowy sieci, redundancji i mechanizmów równoważenia.
  • Udoskonalanie potoków GitOps – awarie wynikające ze złych manifestów skutkują dodaniem nowych bramek walidacyjnych w repozytorium kodu.
  • Trwała odporność ekosystemu – harmonijne połączenie wszystkich modułów telemetrycznych tworzy samouczącą się organizację technologiczną.
Design for failure: Projektowanie z założeniem awarii (redundancja, fail-safe); od „strażaka” do projektanta - automatyzacja, dane, dokumentacja.
rola

Praktyczne wnioski dla inżyniera SRE wynikające z całego kursu: zawód łączy kilka dyscyplin - administrację systemów, automatyzację, monitorowanie i analitykę danych - a szeroka perspektywa pozwala nie tylko prowadzić operacje, ale przede wszystkim projektować systemy odporne na awarie i ciągle je ulepszać. W kontekście incydentów inżynier SRE nie jest tylko "strażakiem" reagującym na alerty - projektuje cały system tak, aby awarii było jak najmniej, aby były wykrywane automatycznie, naprawiane szybko i aby każda dostarczała wiedzy redukującej ryzyko kolejnych. Taki sposób myślenia nazywamy engineering approach to operations i odróżnia on SRE od tradycyjnego administrowania.

Praktyczne wnioski dla SRE można ująć w kilku zasadach. Po pierwsze: systemy projektujemy z myślą o awariach (design for failure) - zakładamy, że każdy podzespół może się popsuć, i budujemy redundancję oraz bezpieczne domyślne zachowania (fail-safe). Po drugie: wszystko automatyzujemy, co się da - automatyzacja redukuje toil, usuwa błędy ludzkie z powtarzalnych działań i przyspiesza recovery. Po trzecie: opieramy się na danych, a nie na opiniach - metryki SLI/SLO, logi, MTTA/MTTR i analiza trendów są podstawą decyzji. Po czwarte: budujemy i utrzymujemy dokumentację operacyjną (runbooki, post-mortemy), bo to ona umożliwia szybką reakcję i naukę całej organizacji. Po piąte: rozwijamy umiejętności miękkie - komunikację, współpracę pod presją i kulturę blameless.

W kategoriach „SRE skill set” (zestawu umiejętności SRE omówionego szerzej w podsumowaniu przedmiotu na slajdzie 54) ten wykład domyka profil: po jego ukończeniu student zna pełny zestaw kompetencji - od metryk i SLO, przez monitoring i logi, HA, alerting i GitOps, aż po zarządzanie incydentem i pisanie post-mortem. Taki profil to w praktyce przepis na osobę, która potrafi zbudować, utrzymać i bronić produkcyjne systemy w środowisku high-scale. W dalszej perspektywie umiejętności te przekładają się bezpośrednio na ścieżkę kariery (Junior, Mid, Senior, Staff SRE), ponieważ każdy z tych poziomów wymaga coraz głębszego zarządzania ryzykiem i coraz bardziej systemowego myślenia o niezawodności. Terminologia: SRE skill set, engineering approach to operations, design for failure, automation, data-driven decisions, runbook, observability, resilience (odporność).

Wyjaśnienie skrótów użytych na slajdzie:
ToilReduction – Systematic Toil Reduction – systematyczna redukcja pracy żmudnej; Kluczowy wniosek SRE: automatyzacja powtarzalnych zadań operacyjnych uwalnia czas na inżynierię.
Automation – Infrastructure and Operational Automation – automatyzacja infrastruktury i operacji; Zastąpienie manualnych interwencji administratora powtarzalnymi skryptami i operatorami.
SLOMonitoring – Continuous SLO Monitoring – ciągłe monitorowanie celów SLO; Orientacja wszystkich działań zespołu inżynierskiego wokół ochrony budżetu błędów.
Resiliency – Systemic Architectural Resiliency – systemowa odporność architektury; Projektowanie usług z założeniem, że awaria komponentów sprzętowych i sieciowych jest nieunikniona.
PostMortem – Continuous Learning via Post-mortems – ciągłe uczenie się przez analizy post-mortem; Trwałe podnoszenie niezawodności dzięki wyciąganiu konstruktywnych wniosków z każdego incydentu.

39/55 Najlepsze praktyki zarządzania incydentem
Najlepsze praktyki zarządzania incydentem: 1) Jasno przydzielone role (commander, technical lead, scribe) - jedna rola na osobę. 2) Dokumentacja na bieżąco (timeline, decyzje). 3) Komunikacja w wyznaczonym kanale + cykliczne raportowanie statusu. 4) Kultura blameless. 5) Każdy incydent kończy się przeglądem i post-mortem z action items. Dodatkowo: runbooki, checklisty, symulacje/game-day, dobre alerting i SLO, automatyczna eskalacja. Stosowanie na co dzień skraca czas reakcji i poprawia jakość napraw.

Pięć zasad dojrzałego incydentu: role, kanał, blameless, domknięcie i przygotowanie. Plus dbanie o ludzi.

  • Inżynieria odporności Resilience – zakłada, że w wielkich systemach rozproszonych awarie sprzętu i oprogramowania są rzeczą nieuniknioną.
  • Projektowanie na wypadek awarii – nowoczesny system tworzy się tak, aby potrafił zachować ciągłość działania mimo awarii pojedynczych węzłów.
  • Kontrolowana degradacja Graceful Degradation – platforma potrafi ograniczyć mniej ważne funkcje, chroniąc kluczowe procesy transakcyjne.
  • Człowiek jako siła adaptacyjna – personel traktowany jest jako elastyczny zasób ratunkowy, a nie wyłącznie źródło pomyłek operacyjnych.
  • Synergia nauk o bezpieczeństwie – koncepcja łączy doświadczenia awiacji i energetyki jądrowej z nowoczesnymi wzorcami chmurowymi.
Checklisty i game-day: Runbooki, listy kontrolne i symulacje obok ról, dokumentacji, blameless i eskalacji; codzienna praktyka skraca reakcję.
praktyki

Najlepsze praktyki zarządzania incydentem to wypracowane przez lata zasady, które zwiększają skuteczność zespołów operacyjnych w realnych awariach: przypisywanie jasnych ról z góry (incident commander, technical lead, scribe) i nieodchodzenie od nich w trakcie akcji; dokumentowanie wszystkiego na bieżąco (dokumentacja, oś czasu, decyzje); prowadzenie komunikacji w wyznaczonym kanale incydentu z cyklicznym raportowaniem statusu; kultura bez obwiniania (blameless), która gwarantuje otwartość informacji i skuteczną analizę przyczyn. Wreszcie - każdy incydent kończymy przeglądem i raportem post-mortem z konkretnymi action items; żaden incydent nie może przejść bez wyciągnięcia wniosków.

Najlepsze praktyki obejmują również aspekty techniczne realizowane zanim dojdzie do incydentu: przygotowanie runbooków i checklist (co robić krok po kroku dla typowych awarii), regularne symulacje i game-day, dobre alerting i monitoring powiązany ze SLO, a także automatyczną eskalację w systemie dyżurowym (on-call rotation, escalation policy). Nie bez znaczenia jest też uporządkowana dokumentacja architektury i wiedza operacyjna zespołu - w czasie awarii nie ma czasu na szukanie, gdzie jest serwis X. Dobre praktyki to również zarządzanie stresem i zmęczeniem: przy długich incydentach obowiązuje rotacja zadań i osób, przerwy oraz ustalanie limitów czasu pracy pod presją, aby nie dopuścić do pogłębienia błędów przez zmęczonych inżynierów.

Stosowanie tych praktyk na co dzień skraca czas reakcji, poprawia jakość napraw i wzmacnia morale zespołu. Ważne jest, aby nie traktować ich jako twardych, sztywnych przepisów - to zestaw rozsądnych wzorców, które należy adaptować do wielkości zespołu, skali systemu i charakteru organizacji. W małym zespole role mogą pełnić te same osoby w różnych incydentach, ale zasada „jedna rola na osobę” pozostaje aktualna. Wartość najlepszych praktyk objawia się najmocniej wtedy, gdy zespół je regularnie ćwiczy w praktyce (np. co kwartał) i aktualizuje na podstawie własnych doświadczeń z post-mortem. Terminologia: best practices, roles, documentation, incident channel, blameless culture, runbook, checklist, escalation policy, on-call rotation, stress management, post-incident review.

Wyjaśnienie skrótów użytych na slajdzie:
ICS – Incident Command System Standards – standardy systemu dowodzenia incydentem; Wdrożenie jednoosobowego przywództwa i precyzyjnego podziału ról w sytuacjach kryzysowych.
ClearRoles – Clearly Defined Incident Roles – jasno zdefiniowane role w zespole; Separacja funkcji dowodzenia, komunikacji, notowania faktów i technicznej mitygacji.
FastMitigation – Priority of Fast Service Mitigation – priorytet szybkiej mitygacji usługi; Przedkładanie wznowienia ruchu dla użytkowników ponad dociekanie przyczyn usterki.
BlamelessReview – Blameless Retrospective Reviews – retrospektywy bez obwiniania; Budowanie kultury zaufania i bezpieczeństwa psychologicznego sprzyjającej innowacjom.
ActionTracking – Rigorous Action Items Tracking – rygorystyczne śledzenie zadań naprawczych; Egzekwowanie terminowości wdrażania poprawek zapobiegających ponownemu wystąpieniu awarii.

40/55 Przygotowanie do roli dyżurnego
On-call readiness (przygotowanie do roli dyżurnego): Dyżurny (on-call engineer) to pierwsza linia reagowania: odbiera alert, robi triage, eskalację, wstępne działania naprawcze. Gotowość = znajomość systemów, runbooków, architektury, narzędzi komunikacji i procedur eskalacji. Dobry onboarding (shadowing), jasny harmonogram, handover, limity czasu dyżuru. Dobrze przygotowany dyżurny = niższy stres, szybsza reakcja, niższe MTTA/MTTR.

Dyżurny to pierwsza linia: alert, triage, eskalacja i pierwsze kroki. Gotowość robi różnicę między stresem a rutyną.

  • Warsztaty symulacyjne GameDays – kontrolowane ćwiczenia pożarowe, podczas których zespół celowo wstrzykuje awarie na środowisku testowym.
  • Trening procedur ratunkowych – inżynierowie doskonalą odruchy dowodzenia, komunikacji i diagnostyki pod bezpieczną kontrolą instruktorów.
  • Weryfikacja gotowości operacyjnej – symulacje obnażają luki w regułach alertowych, przedawnione runbooki oraz brak uprawnień personelu.
  • Opanowanie zamiast paraliżu – regularny trening w zespole eliminuje stres i buduje pewność siebie w obliczu prawdziwej katastrofy produkcyjnej.
  • Żywe procedury awaryjne – systematyczne próby przekształcają teoretyczne instrukcje w sprawnie działające automatyzmy inżynierów.
Shadowing: Wdrażanie przez towarzyszenie doświadczonym; gotowość to systemy, runbooki, architektura, komunikacja i eskalacja z limitami dyżuru.
dyżury

Przygotowanie do roli dyżurnego (on-call readiness) to zestaw działań zapewniających, że inżynier pełniący dyżur skutecznie i bezpiecznie reaguje na incydenty: dyżurny (on-call engineer) to pierwsza linia reagowania - odbiera alert, odpowiada za triage, eskalację i ewentualne wstępne działania naprawcze, często w nagłych porach dnia i nocy. Gotowość (readiness) oznacza, że inżynier zna swoje systemy, wie, gdzie szukać informacji, ma dostęp do niezbędnych narzędzi i zna procedury eskalacji. Dobrze przygotowany dyżurny to niższy stres, szybsza reakcja i mniejsze ryzyko błędów pod presją - co bezpośrednio przekłada się na niższe MTTA i MTTR.

Podstawą gotowości dyżurnego jest znajomość runbooków - szczegółowych instrukcji „co robić, gdy...”, opisanych wcześniej w wykładzie. Runbook wskazuje dyżurnemu sekwencję działań: najpierw potwierdź alert, sprawdź strony statusowe i dashboards, wykonaj polecenia diagnostyczne, zastosuj opisaną procedurę przywracania usługi lub przekaż incydent do właściwego zespołu zgodnie z zasadami eskalacji. Ważne są także: znajomość architektury i topologii systemów, dostęp do logów i metryk, działający monitoring i alerty, oraz prawidłowe skonfigurowane narzędzia komunikacji (telefon, czat, wideokonferencja). Dojrzałe zespoły przeprowadzają również onboarding dyżurowych - okres szkoleniowy, w którym nowy inżynier „cieni” doświadczonego dyżurnego (shadowing) zanim sam zacznie pełnić dyżury.

Właściwe przygotowanie dyżuru obejmuje też aspekty organizacyjne i zdrowotne: jasny harmonogram (rotation) uwzględniający obciążenie, zasady przekazywania dyżuru (handover), procedury awaryjne, a także limit czasu trwania pojedynczego dyżuru, aby zmęczenie nie obniżało jakości decyzji. Współcześni dostawcy narzędzi dyżurowych (np. Grafana OnCall, PagerDuty) umożliwiają m.in. wyznaczanie nadgodzin, automatyczne przypominanie o przekazaniu dyżuru. Role takich on-call readiness good practices w modelu SRE jest również powiązana z pojęciem error budget: dyżurni powinni być nie tylko „strażakami”, lecz spokojnymi i dobrze poinformowanymi specjalistami, którzy oprócz doraźnego opanowywania awarii potrafią poprawnie ocenić, kiedy należy wstrzymać wdrażanie zmian w systemie. Terminologia: on-call (dyżur), readiness (gotowość), runbook, escalation policy, handover (przekazanie dyżuru), shadowing, rotation (grafika dyżurów), on-call load.

Wyjaśnienie skrótów użytych na slajdzie:
On-callPrep – On-call Duty Preparation Checklist – lista kontrolna przygotowania do dyżuru; Zestaw czynności weryfikacyjnych wykonywanych przez inżyniera przed objęciem dyżuru alarmowego.
RunbookAudit – Operational Runbook Regular Audit – regularny audyt instrukcji operacyjnych; Upewnienie się, że wszystkie procedury awaryjne zawierają aktualne polecenia i kontakty.
AccessCheck – Emergency Production Access Check – weryfikacja uprawnień awaryjnych; Sprawdzenie ważności kluczy SSH, certyfikatów VPN i dostępów do konsoli chmurowych.
EscalationPath – Clear Escalation Path Verification – weryfikacja ścieżki eskalacji; Znajomość kontaktów do inżynierów wsparcia drugiego poziomu oraz dowódców incydentu.
PagerTest – Hardware and App Pager Connectivity Test – test łączności pagera; Praktyczne sprawdzenie odbioru powiadomień testowych na telefonie przed rozpoczęciem zmiany.

41/55 Materiały i literatura (incydent)
Materiały i literatura: Kanon literatury SRE: „Site Reliability Engineering" (SRE Book, sre.google) - rozdziały o incydentach i post-mortem; artykuł „Postmortem Culture: Learning from Failure" (John Allspaw); artykuły o blameless post-mortem; publiczne post-mortemy dużych firm (GitHub 2022, AWS, Slack) jako gotowe wzorce struktury i języka; status pages dużych usług. Zweryfikowana lista linków na platformie Moodle.

Kanon na półkę: SRE Book, Allspaw i prawdziwe post-mortemy gigantów. Linki zweryfikowane na Moodle.

  • Eksperymenty inżynierii chaosu – stanowią proaktywne uzupełnienie analizy awarii, weryfikując odporność platformy przed nadejściem problemu.
  • Powtórzenie scenariusza awarii – po wdrożeniu poprawek zespół powinien celowo wywołać tę samą usterkę narzędziami wstrzykiwania błędów.
  • Ostateczny sprawdzian zabezpieczeń – pomyślne przejście próby chaosu stanowi obiektywny dowód, że wdrożone poprawki faktycznie działają.
  • Proaktywne odkrywanie słabości – łamanie komponentów w kontrolowanych warunkach pozwala usunąć wady zanim dostrzegą je użytkownicy.
  • Pętla samodoskonalenia jakości – połączenie procedur post-mortem z eksperymentami chaosu napędza stały rozwój stabilności oprogramowania.
Postmortem Culture (Allspaw): „Postmortem Culture: Learning from Failure” Johna Allspawa; obok SRE Book i publicznych post-mortemów (GitHub, AWS, Slack) oraz Moodle.
strony

Materiały i literatura do pogłębienia wiedzy z tego wykładu: najważniejszym źródłem są oficjalne materiały Google - znany artykuł "Postmortem Culture: Learning from Failure" autorstwa Johna Allspaw oraz rozdziały z książki "Site Reliability Engineering" (Google/SRE Book), publikowanej na stronie sre.google. To Google ukształtowało model zarządzania incydentem i post-mortem stosowany dziś przez zespoły na całym świecie, dlatego materiały te są powszechnie uznawane za kanon literatury SRE; warto sięgnąć także po artykuły o blameless post-mortem oraz blogi zespołów operacyjnych dużych podmiotów (GitHub, AWS, Slack), które opisują prawdziwe analizy incydentów i wyciągnięte z nich wnioski.

Szczególnie pouczające są publiczne raporty post-mortem publikowane przez duże firmy po awariach - np. raporty GitHub o awarii w 2022 roku czy analizy incydentów z portfeli chmurowych. Takie materiały pokazują w praktyce, jak wygląda dobrze napisany raport: pełna oś czasu, analiza przyczyn, działania naprawcze, komunikacja z klientami. Student znajdzie w nich gotowe wzorce struktury, języka i sposobu myślenia. Warto także obserwować strony statusowe (status pages) dużych usług, aby nauczyć się komunikacji publicznej w trakcie awarii, oraz czytać nasze oficjalne szkolenia i dokumentację narzędzi (Grafana, PagerDuty, Chronosphere itp.), które często zawierają sekcje o praktykach incydentalnych.

Do materiałów kursowych należy również repozytorium tego przedmiotu, w którym znajdują się slajdy, wzory raportów post-mortem, szablon osi czasu i lista kontrolna przygotowania dyżuru. Prowadzący przekazuje ponadto zweryfikowaną listę linków (na platformie Moodle), aby studenci nie musieli szukać na własną rękę i uniknęli niezweryfikowanych źródeł. Umiejętność samodzielnego studiowania i krytycznej oceny źródeł jest ważnym elementem rozwoju zawodowego - w branży SRE pojawia się stale nowe narzędzia i praktyki, dlatego umiejętność aktualizacji wiedzy jest równie ważna jak same kompetencje techniczne. Terminologia: SRE book, postmortem culture, blameless post-mortem, case studies, status page, verified links, self-study, learning resources.

Wyjaśnienie skrótów użytych na slajdzie:
GoogleSRE – Google Site Reliability Engineering Canon – kanon Google Site Reliability Engineering; Podstawowa literatura akademicka definiująca nowoczesne zarządzanie incydentami.
Workbook – The Site Reliability Workbook O'Reilly – podręcznik The Site Reliability Workbook; Rozdziały poświęcone praktyce reagowania na awarie i szablonom raportów poawaryjnych.
Allspaw – John Allspaw Incident Engineering Research – badania inżynierskie Johna Allspawa; Prace naukowe i artykuły dotyczące odporności systemów i kultury bez obwiniania.
OReilly – O'Reilly Media Technical Publishing – wydawnictwo techniczne O'Reilly Media; Wiodący wydawca monografii z zakresu inżynierii niezawodności i systemów rozproszonych.
PagerDutyGuide – PagerDuty Incident Management Guide – przewodnik zarządzania incydentami PagerDuty; Otwarte źródło procedur ratunkowych szeroko adaptowane w przemyśle technologicznym.

42/55 Pytania kontrolne
Pytania kontrolne: 1) Jak poprawnie napisać post-mortem? → struktura (summary, timeline, root cause, action items), styl fact-bearing, dwujęzyczność PL/EN, działania z owner/due date. 2) Dlaczego post-mortem powinien być blameless? → kultura bez winy gwarantuje otwartość danych, bez której RCA i metryki są nierzetelne. Te pytania wracają na egzaminie i podczas rekrutacji.

Dwa pytania wracają na egzaminie i rekrutacji: jak napisać post-mortem i dlaczego blameless. Umiej je odtworzyć.

  • Weryfikacja wiedzy z zarządzania – seria pytań kontrolnych pozwala sprawdzić zrozumienie różnic między mitygacją a badaniem przyczyn awarii.
  • Kluczowa rola kultury blameless – czy potrafisz wyjaśnić, dlaczego brak obwiniania pracowników jest warunkiem dotarcia do prawdy o awarii?
  • Organizacja ról w modelu ICS – zastanów się, jak podział zadań pomiędzy dowódcę a inżynierów eliminuje chaos w trakcie poważnego pożaru.
  • Cechy dobrych zadań naprawczych – jakie kryteria musi spełniać zadanie w raporcie post-mortem i jak zapewnić jego terminową realizację?
  • Solidna powtórka przed egzaminem – samodzielne rozwiązanie tych pytań pozwala usystematyzować wiedzę i gwarantuje sukces na zaliczeniu.
Pytania rekrutacyjne: Struktura post-mortem i sens blameless wracają na egzaminie i rekrutacji; wymagają odtworzenia, nie rozpoznania.
pytania

Pytania kontrolne weryfikują opanowanie kluczowych zagadnień wykładu: "jak poprawnie napisać post-mortem?" wymaga znajomości struktury raportu (summary, timeline, root cause, action items), zasad fact-bearing, dwujęzyczności PL/EN oraz sposobu formułowania działań naprawczych; "dlaczego post-mortem powinien być blameless?" wymaga zrozumienia związku między kulturą bez obwiniania a jakością danych potrzebnych do analizy przyczyn - bez otwartości informacji (bezpieczeństwo psychologiczne) raport nie będzie rzetelny, a bez rzetelnego opisu zdarzeń działania zapobiegawcze będą chybione. Te dwa pytania pojawiają się stale na egzaminach i podczas rekrutacji, ponieważ w zwięzły sposób sprawdzają istotę podejścia SRE do awarii.

Oprócz dwóch podstawowych pytań warto powtórzyć pozostałe tematy z wykładu: czym różni się incydent od problemu i żądania; jak klasyfikować severity (impact vs urgency); jak wygląda pełny cykl incydentu (detection, response, recovery); jakie są role członków zespołu incydentu; jak przeprowadzić RCA (5 Whys, fishbone, FTA); czym są MTTA/MTTR i jak je interpretować; jak komunikować się z klientami (status page, aktualizacje). Pomocny sposób utrwalania wiedzy to samodzielne odpowiedzenie na pytania na piśmie oraz przećwiczenie opisu przykładowego incydentu zgodnie ze wszystkimi zasadami. W razie wątpliwości warto wrócić do odpowiednich slajdów i do literatury wskazanej na slajdzie 41.

Pytania kontrolne mają również przygotować do zadań domowych i zaliczenia - prowadzący może przekształcić ich treść w konkretne polecenia (np. „przeanalizuj opisany incydent i napisz raport post-mortem w wersji PL i EN”). Warto więc nie tylko znać odpowiedzi, ale także umieć je zastosować w praktyce, na konkretnym przykładzie. Dobrym ćwiczeniem jest nakreślenie własnego scenariusza awarii (np. „w nocy wzrosła latencja usługi X”) i przeprowadzenie go przez całą ścieżkę: triage, eskalacja, diagnoza, naprawa, weryfikacja, post-mortem, action items. Terminologia: kontrol questions, postmortem writing, blameless, RCA, MTTA/MTTR, severity, incident lifecycle, self-assessment, exam preparation.

Wyjaśnienie skrótów użytych na slajdzie:
IncidentLifecycle – Incident Management Lifecycle Questions – pytania z cyklu życia incydentu; Weryfikacja znajomości faz detekcji, mitygacji i analizy post-mortem na egzaminie.
Roles – Incident Command Roles Examination – sprawdzian znajomości ról w zespole; Test umiejętności rozróżnienia zadań dowódcy incydentu, oficera komunikacji i skryby.
Blameless – Blameless Culture Principles Test – test zasad kultury bez obwiniania; Pytania sprawdzające zrozumienie psychologicznych i systemowych aspektów analizy awarii.
5Whys – Five Whys Practical Application – praktyczne zastosowanie metody 5 Whys; Zadanie egzaminacyjne polegające na przeprowadzeniu dekompozycji przyczyn usterki.
MTTR – Mean Time To Recover Calculations – kalkulacja wskaźników MTTR i MTTA; Zadania obliczeniowe weryfikujące poprawność wyliczania metryk niezawodności.

43/55 Podsumowanie końcowe kursu
Podsumowanie kursu: Osiem wykładów = jedna spójna całość: SLI/SLO i error budget (2), monitoring/grafika/logi (3-4), HA i load balancing (5), alerting i dyżury (6), GitOps i CI/CD (7), incydenty i post-mortem (8). Pełny profil inżyniera SRE: projektować → mierzyć → monitorować → reagować na awarie → analizować (RCA, post-mortem) → wdrażać wnioski (GitOps). Podstawa do pracy operacyjnej z produkcyjnymi systemami w skali.

Osiem wykładów, jedna droga: projektuj, mierz, monitoruj, reaguj, analizuj i wdrażaj wnioski. Profil inżyniera SRE.

  • Etyczne standardy inżyniera SRE – profesjonalizm wymaga bezwzględnego stawiania prawdy, bezpieczeństwa danych i dobra klientów na pierwszym miejscu.
  • Kategoryczny zakaz fałszerstw – niedopuszczalne jest ukrywanie incydentów, manipulowanie wykresami dostępności czy zrzucanie winy na kolegów.
  • Obowiązek zgłaszania kompromisów – inżynier ma moralny obowiązek ostrzegać zarząd przed niebezpiecznymi oszczędnościami w architekturze.
  • Szacunek i kultura prawdy – uczciwe i przejrzyste postępowanie buduje prestiż zawodu inżyniera SRE i tworzy zdrowe środowisko w zespole.
  • Społeczna misja stabilności – odpowiedzialność za ciągłość działania usług to misja, od której zależy codzienne życie milionów ludzi.
Profil inżyniera SRE: Projektować → mierzyć → monitorować → reagować → analizować (RCA, post-mortem) → wdrażać wnioski (GitOps).
podsumowanie

Końcowe podsumowanie całego kursu SRE przypomina, że osiem wykładów stanowi nie zbiór izolowanych tematów, lecz jedną, spójną całość przygotowującą do pracy w modelu Site Reliability Engineering: od definicji SLI/SLO i zarządzania error budget (wykład 2), przez monitoring, wizualizację i logi (wykłady 3-4), architekturę HA i Load Balancing (wykład 5), alerting i dyżury (wykład 6), GitOps i CI/CD (wykład 7), aż po zarządzanie incydentem i post-mortem (wykład 8). Każdy moduł wnosi inny element, ale dopiero wszystkie razem tworzą pełną kompetencję operacyjną; ostatni wykład pokazuje, że wszystkie wcześniejsze elementy służą jednemu celowi - utrzymaniu usług w zgodzie ze zdefiniowanymi poziomami niezawodności.

W modelu SRE kluczowe jest powiązanie wszystkich tych umiejętności z metrykami i danymi: decyzje operacyjne podejmujemy na podstawie pomiarów (SLI/SLO, MTTA/MTTR, error budget), a nie opinii i przeczuć. Inżynier SRE potrafi przejść pełną ścieżkę: zaprojektować wskaźniki jakości, wdrożyć monitoring i alerting, reagować na awarie, analizować przebieg zdarzeń (RCA, post-mortem) i wprowadzać zmiany w systemach przez GitOps. Tak zbudowany zestaw kompetencji umożliwia pracę z produkcyjnymi systemami w środowiskach o wysokiej skali, w których błędy kosztują czas i pieniądze. Warto pamiętać, że kurs dostarcza fundamentów - po jego ukończeniu rozwój wiedzy następuje w praktyce: na własnych projektach, w zespole, w trakcie prawdziwych incydentów.

To podsumowanie końcowe kursu potwierdza, że student dysponuje narzędziami do samodzielnej nauki i rozwoju: zna ekosystem narzędzi (Prometheus, Grafana, Loki, ArgoCD, Docker, Kubernetes), metodyki (SLO, blameless post-mortem, GitOps) oraz sposób myślenia (engineering approach to operations). Dalsze rozwijanie ścieżki kariery SRE opisane jest w podsumowaniu przedmiotu (slajd 54) i może obejmować certyfikacje oraz budowanie własnych projektów. Najważniejsze jest podjęcie praktyki - teoria bez zastosowania szybko się ulotni, natomiast własne eksperymenty i doświadczenia operacyjne budują trwałą wiedzę. Terminologia: SRE foundation, skill set, SLO/error budget, observability, incident management, continuous learning, production systems, engineering mindset.

Wyjaśnienie skrótów użytych na slajdzie:
SREFullCourse – Complete SRE Academic Curriculum – kompletny program akademicki SRE; Syntetyczne podsumowanie 8 wykładów łączących teorię systemów z praktyką inżynierską.
Foundations – Engineering Reliability Foundations – fundamenty niezawodności inżynierskiej; Utrwalenie zasad budowy budżetu błędów, wskaźników SLI/SLO i eliminacji pracy żmudnej.
Operations – Modern Infrastructure Operations – nowoczesne operacje infrastrukturalne; Przegląd narzędzi telemetrii, monitoringu, logowania i automatyzacji wysokiej dostępności.
Automation – Declarative GitOps Automation – deklaratywna automatyzacja w modelu GitOps; Rola repozytorium kodu jako nadrzędnego źródła prawdy w cyklu życia usług cyfrowych.
IncidentManagement – Holistic Incident Management – holistyczne zarządzanie incydentami; Finałowy moduł kształtujący odporność organizacyjną i kulturę ciągłego uczenia się.

44/55 Egzamin i zaliczenie (informacje)
Zaliczenie: Na ocenę składają się: 1) Zadania domowe i prace praktyczne (np. raport post-mortem PL/EN slajd 35), 2) Aktywność na zajęciach (symulacje, dyskusje), 3) Egzamin/zaliczenie końcowe. Wszystko zgodne z sylabusem. Kryteria oceny post-mortem: struktura, precyzja faktograficzna, trafność RCA, kompletność action items, zgodność PL/EN. Zapoznanie się z kryteriami już teraz ułatwia planowanie pracy.

Ocena z trzech źródeł: zadania domowe, aktywność i egzamin - wszystko z sylabusa. Kryteria znasz z góry.

  • Wymagania wobec Incident Commandera – rola dowódcy wymaga nie tylko wiedzy technicznej, lecz przede wszystkim opanowania i empatii w stresie.
  • Filtrowanie szumu i decyzje – dowódca potrafi uważnie słuchać ekspertów, odsiewać zbędne domysły i podejmować trudne decyzje w niepewności.
  • Łagodzenie sporów na kanale – dbałość o obniżenie emocji w trakcie gaszenia awarii pozwala inżynierom zachować pełną trzeźwość myślenia.
  • Troska o kondycję współpracowników – dobry dowódca zarządza rotacją zmęczonych inżynierów i przekazuje dowodzenie świeżej osobie przy długiej akcji.
  • Kapitał przywódczy menedżera – doświadczenie zebrane w roli dowódcy incydentu stanowi doskonałą szkołę nowoczesnego zarządzania w IT.
Kryteria post-mortem: Struktura, precyzja, trafność RCA, kompletność action items, zgodność PL/EN; domowe, aktywność i egzamin zgodnie z sylabusem.
zaliczenie

Zasady egzaminu i zaliczenia przedmiotu pozwalają świadomie zaplanować naukę: na ocenę końcową składają się zadania domowe oraz prace praktyczne, aktywność na zajęciach oraz wyniki egzaminu/zaliczenia, zgodnie z wymaganiami sylabusa. Zadania domowe (m.in. raport post-mortem w wersji PL i EN wraz z analizą przyczyn źródłowych) pozwalają praktycznie sprawdzić większość efektów uczenia się z modułu; aktywność (udział w symulacjach, ćwiczeniach, dyskusjach) jest równorzędnym elementem oceny ciągłej i buduje codzienny nawyk pracy zespołowej. Szczegółowe kryteria punktacji i progi zaliczenia prowadzący podaje na początku semestru oraz na dedykowanej stronie kursu.

Ważne jest, aby studenci poznali kryteria oceny zanim przystąpią do pracy nad zadaniami - pozwala to skupić wysiłek na tym, co faktycznie jest oceniane, i uniknąć nieporozumień przy oddawaniu prac. Do typowych kryteriów oceny raportu post-mortem należą: poprawność struktury (summary, timeline, root cause, action items), precyzja i obiektywność opisu (fact-bearing), trafność przeprowadzonej analizy przyczyn (np. poprawnie zastosowana technika 5 Whys), realizowalność i kompletność action items oraz zgodność wersji PL i EN. Przy ocenie aktywności zwracana jest uwaga na jakość współpracy w grupie podczas symulacji, kulturę komunikacji oraz otwartość na informację zwrotną.

Egzamin końcowy weryfikuje wiedzę teoretyczną z zakresu wszystkich ośmiu wykładów - pytania będą nawiązywać do pojęć przedstawionych na slajdach, w tym także do tych z tego modułu (severity, cykl incydentu, RCA, post-mortem, MTTA/MTTR, blameless, narzędzia incydentalne). Studenci mają możliwość przygotowania się dzięki pytaniom kontrolnym (slajd 42), literaturze (slajd 41) oraz archiwum zadań z poprzednich edycji. W razie wątpliwości dotyczących zasad oceniania należy skontaktować się z prowadzącym (kontakt podany na slajdzie 50) - lepiej wyjaśnić zasady wcześniej, niż dopiero po otrzymaniu oceny. Terminologia: grading (ocenianie), assessment criteria (kryteria oceny), syllabus (sylabus), exam (egzamin), continuous assessment (ocena ciągła), deadline (termin oddania), feedback.

Wyjaśnienie skrótów użytych na slajdzie:
ExamGuidelines – Final Examination Formal Guidelines – formalne wytyczne egzaminu końcowego; Zasady przeprowadzania sprawdzianu wiedzy teoretycznej i obrony projektów laboratoryjnych.
PracticalLabs – Practical Laboratory Defense – obrona ćwiczeń laboratoryjnych; Weryfikacja działających wdrożeń Prometheusa, Grafany, Loki, klastrów HA i potoków GitOps.
TheoryTest – Theoretical Knowledge Assessment – test wiedzy teoretycznej; Pytania testowe sprawdzające znajomość norm międzynarodowych, protokołów i matematyki SRE.
Grading – Academic Grading Criteria – akademickie kryteria oceniania; Przejrzysta punktacja premiująca rzetelność techniczną, automatyzację i wnioski poawaryjne.
Assessment – Competence Assessment Framework – ramy oceny kompetencji inżynierskich; Ocena gotowości studenta do podjęcia pracy na stanowisku młodszego inżyniera SRE / DevOps.

45/55 Pożegnanie z tematem
Zakończenie tematu: Podsumowanie punktów kluczowych: definicja incydentu → cykl zarządzania → role → diagnostyka → RCA → post-mortem → narzędzia → symulacje → najlepsze praktyki. Wskazanie literatury (slajd 41) i podziękowanie za uwagę. Przed nami praktyczne utrwalenie: symulacje awarii (ćwiczenia) i zadania domowe (slajd 35). Temat incydentów = łącznik teorii z realną pracą operacyjną SRE.

Łącznik teorii z ogniem: definicje, cykl, role, metryki, RCA i post-mortem - potem symulacje i zadania.

  • Pułapka błędu konfirmacji – podczas dochodzenia inżynierowie muszą wystrzegać się szukania dowodów pod z góry założoną tezę diagnostyczną.
  • Złudzenie wiedzy po fakcie – należy unikać myślenia Hindsight Bias, czyli fałszywego przekonania, że rozwój wypadków był oczywisty od początku.
  • Ryzyko przedwczesnych wniosków – nie wolno zamykać śledztwa po odnalezieniu pierwszej lepszej usterki, która mogła być zaledwie wtórnym objawem.
  • Dyscyplina dowodów z telemetrii – metodyczne weryfikowanie hipotez w logach i metrykach chroni zespół przed błędnymi wnioskami naprawczymi.
  • Naukowe podejście do awarii – traktowanie dochodzenia powypadkowego jak ścisłego eksperymentu naukowego gwarantuje dotarcie do sedna problemu.
Łącznik teorii z praktyką: Incydenty spinają definicje, cykl, role, RCA i post-mortem z symulacjami i zadaniami (slajd 35) oraz literaturą (slajd 41).
zakończenie

Zamknięcie tematu zarządzania incydentem i raportowania przypomina najważniejsze punkty i wskazuje kierunek dalszej pracy: po omówieniu całego materiału - od definicji incydentu, przez cykl zarządzania, role, diagnozę, RCA i post-mortem, aż po narzędzia, symulacje i najlepsze praktyki - student dysponuje pełnym obrazem procesu. Wykład wskazuje literaturę uzupełniającą do pogłębienia wybranych zagadnień oraz dziękuje za uwagę; pożegnanie z tematem to jednak nie koniec pracy - przed studentami są ćwiczenia praktyczne (symulacje awarii) i zadania domowe, w których cała zdobyta wiedza znajdzie zastosowanie w praktyce.

Temat zarządzania incydentem należy do najbardziej praktycznych modułów kursu SRE. To właśnie tutaj teoria z poprzednich wykładów łączy się z realną pracą operacyjną: jednego dnia inżynier buduje monitoring i alerty, innego - gasi awarię i pisze post-mortem. Dlatego tak ważne jest utrwalenie tego materiału przez ćwiczenia: symulacje pozwalają przećwiczyć reakcję w bezpiecznych warunkach, a zadania domowe wymuszają samodzielne przejście przez cały proces (dokumentacja → analiza → raport → działania). Zamknięcie tematu podziękowaniem ma również wymiar praktyczny - podkreśla, że kurs to współpraca: pytania, wątpliwości i dyskusje, które pojawiały się podczas wykładu, wzbogaciły przekaz i są częścią dobrej kultury uczenia się.

Dalsza droga po tym module prowadzi do szerszego podsumowania przedmiotu (slajd 54) oraz informacji o egzaminie i zaliczeniu (slajd 44). Warto zatem potraktować ten blok jako punkt kontrolny: jeśli któreś z pojęć nie jest już jasne (np. różnica między incydentem a problemem, struktura post-mortem, metoda 5 Whys), najlepiej wrócić do odpowiednich slajdów i literatury. Umiejętności z zakresu zarządzania incydentem są stale oczekiwane na rynku pracy, dlatego ich solidne opanowanie to nie tylko warunek zaliczenia, ale realna wartość zawodowa. Terminologia: module wrap-up, key takeaways, further reading, practical exercises, homework, review points, self-study.

Wyjaśnienie skrótów użytych na slajdzie:
SREMindset – Site Reliability Engineering Mindset – mentalność inżyniera niezawodności; Podejście stawiające na automatyzację, dowody empiryczne i ciągłe doskonalenie systemów.
ProfessionalEngineering – Professional IT Engineering Standards – profesjonalne standardy inżynierii IT; Stosowanie formalnych norm, procedur bezpieczeństwa i rygoru dokumentacyjnego w pracy.
SystemStability – Long-term Systemic Stability – długoterminowa stabilność systemowa; Projektowanie architektury odpornej na awarie i bezpiecznej dla danych użytkowników.
StudentSupport – Continued Academic Mentorship – ciągłe wsparcie mentorskie; Dostępność wykładowcy w ramach konsultacji akademickich i projektów dyplomowych.
WrapUp – Final Course Wrap-up – formalne zamknięcie cyklu wykładów; Podsumowanie osiągnięć dydaktycznych i życzenia sukcesów w pracy zawodowej studentów.

46/55 Podsumowanie wkładu w karierę
Kariera SRE: Umiejętności przekładają się na ścieżkę: Junior SRE (asysta przy incydentach, dokumentacja) → Mid SRE (samodzielne prowadzenie, on-call, autorstwo post-mortem) → Senior SRE (projektowanie procesów, mentoring, architektura odporności) → Staff SRE (organizational impact). Dwa klucze rozwoju: automatyzacja (redukcja toil, skalowanie bez proporcjonalnego wzrostu zespołu) i praca na danych (SLI/SLO, MTTA/MTTR, trendy). Własne przykłady incydentów = argument na rozmowach rekrutacyjnych.

Kurs to kariera: Junior asystuje, Mid prowadzi, Senior projektuje, Staff zmienia organizację. Dwa klucze: automatyzacja i dane.

  • Fizjologia stresu w incydencie – długotrwała akcja ratunkowa wywołuje potężny wyrzut hormonów stresu i prowadzi do fizycznego wyczerpania dyżurnego.
  • Higiena dyżuru on-call – inżynierowie powinni pamiętać o podstawowych nawykach: głębokim oddychaniu, piciu wody i krótkich odejściach od ekranu.
  • Odpowiedzialność dowódców sztabu – liderzy mają obowiązek monitorować poziom zmęczenia zespołu i bezwzględnie odsuwać osoby wyczerpane brakiem snu.
  • Czas na pełną regenerację – po ciężkiej nocnej walce inżynier ma zagwarantowane prawo do odpoczynku i snu przed powrotem do normalnej pracy.
  • Troska o zdrowie fundamentem SRE – dbałość o kondycję psychofizyczną personelu jest warunkiem zachowania długofalowej stabilności całej firmy.
T-shape skills: Szerokie podstawy plus głęboka specjalizacja; z continuous learning i przykładami incydentów jako argumentem rekrutacyjnym (Junior → Staff).
przyszłość

Wkład umiejętności z kursu w rozwój kariery w modelu SRE: zarządzanie incydentem i pisanie post-mortem to zestaw umiejętności przekładający się bezpośrednio na ścieżkę kariery - od Junior SRE (pierwsze zadania operacyjne, asystowanie przy incydentach, prowadzenie dokumentacji), przez Mid SRE (samodzielne prowadzenie incydentów, on-call, autorstwo post-mortem), aż po Senior i Staff SRE (projektowanie procesów incydentalnych, mentoring, architektura odporności). Każdy z tych poziomów wymaga coraz głębszego rozumienia nie tylko narzędzi, ale także procesów i kultury organizacyjnej; umiejętność szybkiej, metodycznej reakcji na awarie i przekształcania ich w systematyczne ulepszenia odróżnia doświadczonego inżyniera SRE od administratora realizującego wyłącznie bieżące zadania.

Dwie cechy wyróżniają tę ścieżkę rozwoju: automatyzacja i praca na danych. Inżynier, który potrafi zautomatyzować powtarzalną pracę (toil) i podejmować decyzje na podstawie metryk (SLI/SLO, MTTA/MTTR, analiza trendów), jest w stanie obsługiwać coraz większe systemy bez proporcjonalnego wzrostu zespołu - to właśnie sedno ekonomii modelu SRE. Umiejętność pisania rzetelnych raportów (PL/EN), prowadzenia RCA i wdrażania action items czyni z niego również cennego współpracownika dla zespołu zarządzania i liderów technicznych, którzy potrzebują wiarygodnych danych do planowania. Kultura blameless i komunikacja pod presją budują zaufanie w zespole, które jest kluczowe w środowisku o dużej skali.

W szerszej perspektywie wykład ten dostarcza również kompetencji przekładających się na rekrutację: dojrzałe firmy technologiczne w trakcie rozmów kwalifikacyjnych proszą o omówienie prawdziwych incydentów, a umiejętność opowiedzenia o nich w sposób uporządkowany (wpływ, przyczyna, działania, wnioski) robi realną różnicę. Dlatego student po kursie powinien zgromadzić własne przykłady działań incydentalnych - np. z laboratoriów, symulacji i zadań domowych - które będzie mógł przywołać w przyszłości. Podsumowanie wkładu w karierę to zatem automatyczny „argument sprzedażowy” całego kursu: teoria + narzędzia + proces + praktyka = konkurencyjny profil na rynku pracy. Terminologia: career path (ścieżka kariery), Junior/Mid/Senior/Staff SRE, automation, data-driven work, incident ownership, personal portfolio, hiring process, SRE skills.

Wyjaśnienie skrótów użytych na slajdzie:
SRECareer – SRE Professional Career Path – ścieżka kariery zawodowej w SRE; Perspektywy rozwoju na rynku pracy na stanowiskach Site Reliability Engineer i DevOps Engineer.
MarketDemand – High Market Demand for SRE Skills – wysokie zapotrzebowanie rynkowe; Rynkowe znaczenie umiejętności łączenia programowania z operacjami teleinformatycznymi.
DevOpsTransition – DevOps to SRE Maturity Transition – transformacja dojrzałości DevOps do SRE; Wdrażanie twardych wskaźników inżynierskich w tradycyjnych działach administratorskich.
CloudNative – Cloud Native Engineering Competence – kompetencje w ekosystemie Cloud Native; Biegłość w posługiwaniu się narzędziami orkiestracji kontenerów i telemetrii CNCF.
EngineeringGrowth – Continuous Engineering Growth – ciągły rozwój inżynierski; Znaczenie nieustannego poszerzania wiedzy o nowych protokołach, architekturach i standardach.

47/55 Wnioski etyczne
Etyka (ethics): Praca z incydentami ma wymiar etyczny: uczciwość w raportowaniu (nie zatajamy, nie minimalizujemy, nie manipulujemy metrykami), szacunek wobec ludzi (klienci, współpracownicy), odpowiedzialne zarządzanie danymi (RODO/GDPR, maskowanie PII w logach i raportach). Przejrzystość (transparency) = moralne zobowiązanie, nie tylko dobra praktyka. Związek z kompetencją K02 odpowiedzialności zawodowej. Blameless łączy się z etyką: brak obwiniania, ochrona prywatności.

Incydenty to też etyka: prawda w raportach, szacunek do ludzi i RODO w danych. Transparentność to obowiązek.

  • Faza stabilizacji po awarii – po zakończeniu działań ratunkowych następuje kontrolowany powrót całego ekosystemu do standardowych parametrów.
  • Płynne wyłączanie obejść – inżynierowie stopniowo wyłączają tymczasowe filtry, przywracają limity i ostrożnie wznawiają zadania w kolejkach.
  • Ochrona przed wtórnym szokiem – należy kontrolować napływ wstrzymanego ruchu, aby nie wywołać wtórnego przeciążenia baz danych i serwisów.
  • Ostateczne potwierdzenie zdrowia – dopiero po pełnym rozładowaniu zatorów i ustabilizowaniu metryk można uznać platformę za wyleczoną.
  • Spokojne przejście do codzienności – metodyczne zakończenie fazy awaryjnej formalnie przywraca rutynowy tryb pracy zespołów technicznych.
Transparency: Przejrzystość jako moralne zobowiązanie (K02); uczciwe raporty, szacunek do ludzi, RODO i maskowanie PII - blameless w etyce.
etyka

Obsługa incydentów teleinformatycznych podlega rygorystycznym regulacjom ustawowym:
- Zgodnie z Ustawą o krajowym systemie cyberbezpieczeństwa (wdrażającą wymogi Dyrektywy NIS 2) podmioty kluczowe i ważne mają ustawowy obowiązek zgłoszenia incydentu poważnego do właściwego zespołu CSIRT GOV lub CERT Polska w ciągu 24 godzin od wykrycia,
- W przypadku naruszenia poufności danych osobowych administrator ma obowiązek zawiadomić Urząd Ochrony Danych Osobowych w terminie 72 godzin od stwierdzenia naruszenia (art. 33 RODO),
- Operatorzy telekomunikacyjni podlegają ponadto rygorom zgłaszania incydentów do organu Urzędu Komunikacji Elektronicznej zgodnie z ustawą Prawo komunikacji elektronicznej.

Etyczny wymiar pracy z incydentami to nieodłączna część odpowiedzialnej kariery inżyniera: praca styka się z wartościami etycznymi - uczciwością w raportowaniu (nie zatajamy awarii, nie minimalizujemy ich wpływu, nie manipulujemy metrykami), szacunkiem wobec ludzi (klientów, współpracowników) oraz odpowiedzialnym zarządzaniem danymi (zwłaszcza osobowymi, regulowanymi przez RODO). Uczciwość jest szczególnie istotna: raport post-mortem musi opisywać prawdę - nie tylko jako dokument formalny, ale dlatego, że właściwe wnioski nie są możliwe na podstawie zniekształconych danych. Etyczne postępowanie obejmuje również powstrzymanie się od obwiniania ludzi (kultura blameless) oraz ochronę prywatności osób, których dane mogły zostać naruszone.

Wymiar etyczny łączy się z kompetencjami K02 w sylabusie, czyli odpowiedzialnością zawodową. Odpowiedzialność zawodowa inżyniera oznacza, że zdaje on sobie sprawę z konsekwencji swoich decyzji operacyjnych - np. że szybkie „naprawienie” awarii przez przywrócenie usługi z niepełnych danych może spowodować utratę informacji, a że opublikowanie szczegółów incydentu publicznie może naruszyć obowiązki informacyjne wobec klientów lub regulatorów. Etyczny inżynier waży decyzje także w kontekście zaufania społecznego: przejrzystość wobec klientów (status page, uczciwe komunikaty) jest nie tylko dobrą praktyką komunikacyjną, ale również moralnym zobowiązaniem. Naruszenia - jak ukrywanie awarii lub fałszowanie raportów - doprowadzają do utraty zaufania i mogą mieć poważne konsekwencje prawne i reputacyjne.

W praktyce wprowadzanie wartości etycznych do codziennej pracy przekłada się na konkretne zachowania: uczciwe opisywanie błędów (nawet kosztem przyznania się do własnego błędu), ochrona danych osobowych w logach i raportach (maskowanie PII), transparentne komunikaty zewnętrzne, poszanowanie czasu i pracy innych, a także powstrzymanie się od „window dressing” - upiększania metryk czy raportów w celu poprawy wrażenia. Dyskusja etyczna w tym miejscu kursu ma przygotować studentów do sytuacji, w których presja czasu i optymalizacja celów krótkoterminowych konkurują z wartościami - i wskazać, że inżynier zajmujący się niezawodnością (reliability) odpowiada także za zaufanie społeczne. Terminologia: ethics (etyka), professional responsibility, transparency (przejrzystość), PII protection, RODO/GDPR, honesty in reporting, trust (zaufanie), accountability.

Wyjaśnienie skrótów użytych na slajdzie:
PublicTrust – Public Trust in Digital Infrastructure – zaufanie publiczne do usług cyfrowych; Etyczna odpowiedzialność inżyniera za ciągłość działania usług bankowych, medycznych i krytycznych.
DataIntegrity – Uncompromising Data Integrity – bezkompromisowa integralność danych; Ochrona informacji użytkowników przed zniszczeniem lub utratą w wyniku awarii infrastruktury.
Transparency – Ethical Operational Transparency – etyczna transparentność operacyjna; Uczciwe informowanie społeczeństwa o awariach bez zatajania prawdy i fałszowania metryk.
UserRespect – Respect for End-User Time and Privacy – szacunek dla prywatności i czasu użytkownika; Projektowanie systemów stabilnych i nienaruszających praw obywatelskich w świetle RODO.
EngineeringEthics – Professional Code of Engineering Ethics – kodeks etyki zawodowej inżyniera; Standardy moralne nakazujące rzetelność, odpowiedzialność i dbałość o dobro wspólne.

48/55 Zapowiedź dalszych prac
Dalsze prace: Kolejne zajęcia: praktyczne ćwiczenia utrwalające zarządzanie incydentem - labs/workshops: symulacje awarii (slajd 24) i przygotowanie kompletnego post-mortem. Bezpieczne środowisko = rozegranie całego cyklu: role, komunikacja pod presją, diagnoza, dokumentacja. Zapowiedź motywuje do powtórki materiału (struktura raportu, cykl, role) i przygotowania własnych pytań.

Dalej warsztat: symulacje, kompletny post-mortem i omówienie zadań. Bezpieczna piaskownica przed ogniem.

  • Kanon podręczników Google SRE – oficjalne publikacje o zarządzaniu incydentami i kulturze post-mortem są obowiązkową lekturą każdego inżyniera.
  • Nauki o bezpieczeństwie człowieka – książki z dziedziny psychologii błędu i lotnictwa pomagają zrozumieć mechanizmy powstawania pomyłek w stresie.
  • Otwarte raporty post-mortem – studiowanie publicznych analiz awarii czołowych gigantów technologicznych uczy rozwiązywania nietypowych problemów.
  • Standardy ratownictwa ICS – warto zgłębić międzynarodowe wytyczne zarządzania kryzysowego, które stały się wzorcem organizacji sztabów SRE.
  • Szerokie horyzonty inżynierskie – łączenie wiedzy o technologii z naukami humanistycznymi pozwala budować bezpieczne i odporne ekosystemy.
Labs/workshops: Laboratoria rozegrania cyklu (role, presja, diagnoza, dokumentacja); zapowiedź motywuje do powtórki struktury, cyklu i ról.
dalej

Dalsze zajęcia praktyczne utrwalają i pogłębiają temat zarządzania incydentem, przekształcając wiedzę w umiejętności: w bezpiecznym środowisku można przećwiczyć cały proces - od symulacji awarii po przygotowanie kompletnego raportu post-mortem. Ćwiczenia praktyczne (labs, workshops) są nieocenione, ponieważ polegają na działaniu: student uruchamia narzędzia, przydziela role, komunikuje się pod presją, diagnozuje i dokumentuje - robi dokładnie to samo, co robiłby w środowisku produkcyjnym.

Zapowiedź dalszych prac powinna również zmotywować do powtórzenia materiału: uczestnicy, którzy przed zajęciami odświeżą sobie strukturę raportu, cykl incydentu i role zespołu, znacznie lepiej wykorzystają czas ćwiczeń. Warto też przygotować własne przykłady i pytania - najlepsza nauka odbywa się wtedy, gdy student aktywnie poszukuje odpowiedzi i konfrontuje pomysły z prowadzącym i rówieśnikami. To dojrzewanie do samodzielności jest istotnym elementem kształcenia: inżynier SRE nie może czekać na gotowe odpowiedzi, lecz musi umieć eksperymentować, testować hipotezy i wyciągać wnioski z porażek.

W szerszym kontekście zapowiedź ta podkreśla cykliczny charakter modelu uczenia się w SRE: teoria prowadzi do ćwiczeń, ćwiczenia do obserwacji i wniosków, a wnioski z kolei skłaniają do doskonalenia procedur i narzędzi. Zapowiedziane zajęcia będą także okazją do omówienia zadań domowych (slajd 35) i wspólnej analizy przykładowego kompletnego post-mortem (slajd 51). Warto więc od samego początku traktować ten przedmiot jak zaproszenie do praktyki, a nie tylko do zapamiętywania pojęć - właśnie praktyka odróżnia kurs przygotowujący do pracy w SRE od zwykłego wprowadzenia teoretycznego. Terminologia: next steps, hands-on (praktyka), workshop, labs, practice, team exercise, review, continuous improvement.

Wyjaśnienie skrótów użytych na slajdzie:
AdvancedSRE – Advanced SRE Graduate Studies – zaawansowane studia inżynierii niezawodności; Zapowiedź specjalistycznych kursów magisterskich poświęconych zaawansowanej telemetrii.
CloudArchitecture – Distributed Cloud Systems Architecture – architektura rozproszonych systemów chmurowych; Przedmioty kontynuujące tematykę skalowania wielochmurowego i odporności na katastrofy.
ChaosEngineeringLabs – Specialized Chaos Engineering Labs – zaawansowane laboratoria inżynierii chaosu; Praktyczne warsztaty wstrzykiwania awarii w klastrach produkcyjnych.
ProjectWork – Engineering Degree Project Work – inżynierskie prace dyplomowe; Możliwość realizacji prac dyplomowych pod kierunkiem wykładowcy w tematyce SRE.
Graduation – Academic Engineering Graduation – ukończenie cyklu kształcenia inżynierskiego; Uzyskanie kwalifikacji inżyniera informatyki o specjalności systemowej.

49/55 Omówienie zadań domowych
Omówienie zadań domowych: Na kolejnych zajęciach studenci prezentują wyniki zadań (krótkie prezentacje/omówienia w grupach) i wspólnie analizują napotkane problemy. Forma: wymusza wykonanie pracy, uczy przez porównanie (czyjeś rozwiązanie vs własne), tworzy przestrzeń na pytania i feedback. Przy post-mortem: struktura, precyzja, poprawność RCA (łańcuch 5 Whys!), kompletność action items, spójność PL/EN. Obrona decyzji = krytyczne myślenie = kultura uczenia się (slajd 32).

Prace omawiamy wspólnie: prezentacje, porównania i obrona decyzji. Peer review uczy nie mniej niż ocena.

  • Zwieńczenie programu SRE – zarządzanie incydentami łączy biegłość techniczną, opanowanie emocjonalne oraz kulturę dialogu o błędach.
  • Najważniejszy kapitał z awarii – największą wartością usterki jest wiedza, jaką organizacja potrafi wyciągnąć ze swojego bolesnego potknięcia.
  • Filar dojrzałego biznesu – kultura bez obwiniania, precyzyjne procedury dowodzenia i twarde metryki decydują o rynkowym sukcesie firmy.
  • Spokój wobec nieuchronności – profesjonalny inżynier SRE nie obawia się awarii, lecz traktuje je jako naturalną szansę na wzmocnienie platformy.
  • Gotowość na wyzwania rynkowe – przyswojenie tych standardów doskonale przygotowuje studentów do pełnienia odpowiedzialnych ról w nowoczesnym IT.
Obrona decyzji: Prezentacja raportów z krytycznym myśleniem; struktura, precyzja, łańcuch 5 Whys, action items i PL/EN pod feedbackiem grupy.
zadania

Sposób omawiania zadań domowych na kolejnych zajęciach: studenci przedstawiają wyniki wykonanych zadań - najczęściej w formie krótkich prezentacji lub omówień w grupach - i wspólnie analizują napotkane problemy. Taka forma ma dwa główne cele: wymusza doprowadzenie pracy do końca i samodzielne zmierzenie się z trudnościami oraz tworzy przestrzeń do nauki przez porównanie - każdy student widzi, jak inni podeszli do tego samego zadania, i konfrontuje własne rozwiązanie z alternatywnymi podejściami. Omawianie to też doskonała okazja do zadawania pytań: prowadzący oraz koledzy mogą wskazać mocne strony rozwiązania i zasugerować ulepszenia.

Przy omawianiu raportu post-mortem szczególną uwagę zwracamy na strukturę, precyzję faktograficzną, poprawność analizy przyczyn (czy łańcuch 5 Whys prowadzi do właściwej przyczyny źródłowej?) oraz kompletność action items. Omawiana jest także jakość wersji PL i EN - ich spójność terminologiczna i informacyjna. Studenci powinni być przygotowani do obrony swoich decyzji: np. wyjaśnienia, dlaczego uznali daną przyczynę za źródłową lub dlaczego zaproponowali konkretne działanie naprawcze. Tego typu dialog kształtuje umiejętność krytycznego myślenia i prezentowania argumentów, które są ważne w pracy zespołowej i podczas rozmów z interesariuszami.

Omawianie zadań domowych ma również wymiar kultury uczenia się opisanej na slajdzie 32: dzielenie się rozwiązaniami i otwarte przyjmowanie uwag buduje atmosferę, w której błędy są naturalną częścią nauki, a nie powodem do wstydu. Warto więc zgłaszać nawet rozwiązania niekompletne - dyskusja na ich temat często przynosi więcej wiedzy niż prezentacja rozwiązania „idealnego”. Prowadzący może również wskazać rozwiązania ucznia jako przykład dla grupy, jeśli są szczególnie dobre lub ciekawe. Niezależnie od formy, cel jest wspólny: przekuć indywidualną pracę studenta w wiedzę dostępną dla całej grupy i w gotowość do przyszłych ról operacyjnych. Terminologia: homework review, presentation (prezentacja), group discussion, peer feedback, defense of decisions, constructive criticism, knowledge sharing.

Wyjaśnienie skrótów użytych na slajdzie:
FinalReview – Comprehensive Homework Review – kompleksowy przegląd zadań domowych; Omówienie nadesłanych projektów i raportów poawaryjnych opracowanych przez studentów.
HomeworkFeedback – Individualized Academic Feedback – indywidualna informacja zwrotna; Wskazówki wykładowcy dotyczące poprawy czytelności osi czasu i precyzji wskaźników.
PostMortemGrading – Post-mortem Assessment Criteria – ocena jakości raportu post-mortem; Weryfikacja kompletności sekcji, bezstronności wywodu i realności zadań naprawczych.
SREPortfolio – Professional SRE Project Portfolio – profesjonalne portfolio inżynierskie; Wykorzystanie zrealizowanych laboratoriów jako dowodu kompetencji w procesach rekrutacyjnych.
Mentoring – Faculty Academic Mentoring – akademickie wsparcie mentorskie; Indywidualne konsultacje naukowe wspierające rozwój talentów technologicznych.

50/55 Wsparcie studentów
Wsparcie studentów: W razie pytań: wyznaczone kanały kontaktu z prowadzącym - czat kursowy (Slack, pytania publiczne → wiedza dla całej grupy), e-mail (pytania prywatne), konsultacje (office hours). Wsparcie rówieśników (peer support): wspólna praca, dyskusje, sesje powtórkowe, wzajemne recenzowanie raportów. Zasada: najpierw poszukaj sam (materiały, literatura, FAQ), potem pytaj. Cierpliwość wobec siebie - nauka to proces.

Pytaj mądrze: publiczne na Slacku (dla wszystkich), prywatne mailem, trudne na konsultacjach. Najpierw szukaj sam.

  • Siła seminaryjnej pracy grupowej – wspólne analizowanie przypadków i recenzowanie raportów post-mortem uczy spojrzenia na tekst oczami innych.
  • Konstruktywny feedback kolegów – koleżeńska informacja zwrotna pozwala wyłapać nielogiczności w osi czasu i zbyt ogólne zadania korygujące.
  • Symulacje pod presją czasu – zespołowe rozwiązywanie scenariuszy laboratoryjnych buduje bezcenne odruchy współpracy w warunkach stresu.
  • Solidarność i wymiana wiedzy – dzielenie się notatkami i spostrzeżeniami wzmacnia ducha współpracy i ułatwia opanowanie trudnego materiału.
  • Prawdziwe mistrzostwo inżynierskie – dojrzałość zawodowa rozwija się w dyskusji, wzajemnym szacunku i ciągłym dążeniu do najwyższej jakości.
Peer support: Wsparcie rówieśnicze (wspólna praca, sesje, recenzje); najpierw szukaj sam (materiały, FAQ), potem pytaj - cierpliwość to proces.
pomoc

Kanały wsparcia w nauce przedmiotu: w razie pytań dotyczących materiału, zadań domowych czy organizacji zajęć studenci korzystają z wyznaczonych kanałów kontaktu z prowadzącym - najczęściej czatu przeznaczonego do spraw kursu (np. Slack), adresu e-mail uczelni oraz konsultacji (office hours), podczas których można porozmawiać indywidualnie. Zasada jest prosta: na pytania "publiczne" odpowiada się na czacie (dzięki czemu korzysta z nich cała grupa), a na pytania prywatne (np. dotyczące oceny) - indywidualnie. Wsparcie to jest częścią kultury uczenia się: prowadzący jest dostępny nie tylko po to, aby oceniać, ale przede wszystkim, aby pomagać w zrozumieniu materiału i rozwiązywaniu problemów.

Równie ważne jest wsparcie rówieśników (peer support). Studenci bardzo często skuteczniej wyjaśniają sobie nawzajem pojęcia, bo znają te same konteksty i świeżo przerabiają te same zagadnienia. Wspólna praca nad zadaniami, dyskusje na grupie, organizowanie sesji powtórkowych czy wzajemne recenzowanie raportów post-mortem to praktyki, które znacząco podnoszą efektywność nauki. Warto pamiętać o zasadzie „dokumentuj pytania i odpowiedzi” - jeśli rozwiązaliśmy jakiś problem wspólnie, zapisanie wniosku w notatkach i podzielenie się nim z grupą pomaga wszystkim i oszczędza czas w przyszłości. Obok wsparcia rówieśników istotna jest też cierpliwość wobec siebie - nauka zarządzania incydentem to proces, a popełnianie błędów w zadaniach jest jego naturalną częścią.

Z praktycznego punktu widzenia warto od początku wiedzieć, do kogo i w jakiej sprawie można się zwrócić: do prowadzącego w sprawach merytorycznych i formalnych, do koordynatora przedmiotu w sprawach zapisów i zwolnień, a do kolegów z grupy w sprawach bieżących. Kontakt na czacie grupowym nie powinien jednak zastępować własnej pracy - przed zadaniem pytania warto najpierw samodzielnie poszukać odpowiedzi (w materiałach, literaturze, notatkach), co buduje samodzielność, którą SRE ceni tak bardzo. Terminologia: support channels, office hours, Slack, e-mail, peer support, Q&A, self-study, documentation of questions, feedback loop.

Wyjaśnienie skrótów użytych na slajdzie:
OfficeHours – Faculty Academic Office Hours – konsultacje akademickie prowadzącego; Wyznaczone godziny dyżuru dydaktycznego w sali 205 przeznaczone na pomoc studentom.
SlackChannel – Course Community Slack Channel – kanał dyskusyjny społeczności kursu; Przestrzeń wymiany wiedzy i wzajemnej pomocy technicznej pomiędzy studentami.
PeerSupport – Student Peer-to-Peer Support – wsparcie koleżeńskie; Kultura współpracy i wspólnego rozwiązywania problemów laboratoryjnych.
FacultyResources – Faculty Computing Laboratory Resources – zasoby wydziałowego laboratorium obliczeniowego; Dostęp do serwerów i klastrów uczelnianych do eksperymentów badawczych.
AcademicHelp – Ongoing Academic Course Assistance – bieżąca pomoc dydaktyczna; Otwarte kanały kontaktu z prowadzącym w sprawach merytorycznych przedmiotu.

51/55 Przykładowy kompletny postmortem
Przykładowy post-mortem: Kompletny wzór raportu omawiamy i analizujemy wspólnie na zajęciach - krok po kroku, „od środka": summary (streszczenie wpływu), timeline (osi czasu z godzinami i zdarzeniami), root cause (łańcuch od objawów do źródła), action items (owner + due date). Wzorzec jako szablon do własnych raportów. Analiza uczy rozpoznawać typowe błędy: ogólnikowe wnioski, subiektywne opisy, pominięte czynniki współprzyczyniające się.

Ucz się na gotowcu: rozbierz wzorcowy raport „od środka” - strukturę, poziom i typowe błędy.

  • Wzorcowy raport post-mortem – szczegółowa analiza kompletnego dokumentu pozwala studentom zobaczyć przełożenie teorii na realną praktykę.
  • Elementy idealnego raportu – wzorcowy dokument zawiera precyzyjną chronologię zdarzeń, analizę 5 Whys oraz zadania z przypisanymi datami.
  • Rzeczowy język bez emocji – warto zwrócić uwagę na obiektywny opis faktów i całkowity brak personalnego obwiniania personelu za pomyłkę.
  • Praktyczny szablon zaliczeniowy – analiza referencyjnego układu ułatwia przygotowanie własnej pracy końcowej bez błędów metodologicznych.
  • Profesjonalna wizytówka zespołu – wzorowy raport buduje zaufanie kierownictwa do kultury inżynieryjnej i dojrzałości procedur wdrożonych w SRE.
Błędy raportów: Ogólniki, subiektywizm i pominięte współprzyczyny; analiza wzorca „od środka” uczy struktury na faktach.
raport

Wzorcowy raport poawaryjny według standardu Google SRE zawiera kompletne sekcje formalne: streszczenie menedżerskie, precyzyjną oś czasu UTC, analizę przyczyn źródłowych i czynników sprzyjających oraz tabelę Action Items z przypisanymi właścicielami w systemie Jira.

Przykładowy kompletny post-mortem omawiany i analizowany wspólnie na zajęciach: analiza gotowego raportu krok po kroku to jedna z najskuteczniejszych metod nauki pisania własnych dokumentów - student widzi poprawnie napisany raport "od środka", poznaje wszystkie sekcje i sposób, w jaki łączą się ze sobą fakty, przyczyny i działania. Wzorcowy raport pokazuje w praktyce wszystko, co omówiono w teorii: strukturę (summary, timeline, root cause, action items), styl fact-bearing, sposób przedstawiania osi czasu, zastosowanie techniki RCA (np. 5 Whys) oraz język PL/EN. Dzięki temu studenci widzą, jaki poziom szczegółowości i precyzji jest oczekiwany w zadaniu domowym i na egzaminie.

Podczas wspólnej analizy prowadzący zatrzymuje się na kluczowych fragmentach raportu i wyjaśnia, dlaczego napisano je w określony sposób: jak streszczenie podsumowuje wpływ awarii, dlaczego oś czasu zawiera dokładne godziny i nazwy zdarzeń, w jaki sposób analiza przyczyn prowadzi od objawów do źródłowej przyczyny oraz dlaczego każde działanie zapobiegawcze ma właściciela i termin. Omawiane są również typowe błędy, których w raporcie nie ma, ale które łatwo popełnić - na przykład ogólnikowe wnioski („należy zwiększyć niezawodność”) zamiast konkretnych action items, opis subiektywny („baza danych była przeładowana”) zamiast opisu opartego na danych, czy sekcja przyczyn pomijająca czynniki współprzyczyniające się. Taka analiza przygotowuje do krytycznego czytania własnych dokumentów.

Przykładowy kompletny post-mortem służy również jako szablon (template), do którego studenci mogą wracać podczas przygotowywania raportów samodzielnych - zachowując strukturę i poziom szczegółowości, a podmieniając dane i treść na własne. Wiele organizacji prowadzi repozytoria własnych post-mortem, które pełnią funkcję wzorców dla nowych członków zespołu - dlatego umiejętność wzorowania się na dobrych przykładach jest uznaną praktyką zawodową. Po tej analizie studenci powinni być w stanie samodzielnie ustalić sekwencję pisania: najpierw zebrać fakty i oś czasu, potem wykonać RCA, następnie opisać wnioski i zaproponować action items, a na końcu sformułować streszczenie i przekazać dokument w wersji PL/EN. Terminologia: sample report, template (szablon), case analysis (analiza przypadku), timeline, root cause, action items, best practices, pitfalls.

Wyjaśnienie skrótów użytych na slajdzie:
CompletePostMortem – Complete Reference Post-mortem Document – kompletny referencyjny dokument post-mortem; Wzorcowy przykład raportu poawaryjnego analizujący rzeczywisty incydent z życia infrastruktury.
Incident123 – Reference Incident Case Study – studium przypadku awarii referencyjnej; Szczegółowy opis awarii kaskadowej spowodowanej wygaśnięciem certyfikatu TLS.
OutageAnalysis – End-to-End Outage Breakdown – pełna dekompozycja techniczna przestoju; Prezentacja chronologii zdarzeń, wykresów latencji i logów zrzutu połączeń w raporcie wzorcowym.
ActionTable – Structured Action Items Table – ustrukturyzowana tabela działań naprawczych; Modelowe zestawienie zadań z jednoznacznym przypisaniem ról i terminów wykonania.
LessonsLearned – Systemic Lessons Learned Summary – podsumowanie wyciągniętych lekcji; Wnioski inżynierskie pokazujące jak awaria przekształciła się w trwałe wzmocnienie systemów.

52/55 Najczęściej zadawane pytania
FAQ: Odpowiedzi na najczęściej zadawane pytania o przedmiot i metody oceny: progi zaliczenia, termin egzaminu (pisemny/ustny), terminy oddawania zadań, praca w grupach, korzystanie z literatury. Pytania merytoryczne: „czy każda awaria musi mieć post-mortem?" (tak, w proporcji do wpływu), „jak głęboko RCA?" (5 Whys proste, FTA złożone), „czy raport zawsze dwujęzyczny?" (wymaganie U05). FAQ aktualizowane na bieżąco - rozwianie wątpliwości = skupienie na nauce.

FAQ żyje z kursem: formalności, merytoryka i samodzielność. Sprawdź, zanim napiszesz.

  • Najczęstsze pytania studentów FAQ – zestawienie rozwiewa wątpliwości dotyczące formy zaliczenia kursu, punktacji oraz terminów oddania prac.
  • Wymóg kultury bez obwiniania – przypominamy, że raport post-mortem musi bezwzględnie realizować założenia filozofii blameless pod rygorem oceny.
  • Dobór metodologii RCA – w pracach zaliczeniowych rekomendujemy stosowanie metody 5 Whys dla usterek prostych oraz diagramu Ishikawy dla złożonych.
  • Przejrzyste zasady i konsultacje – wszystkie kryteria oceniania są w pełni jawne, a w razie wątpliwości zapraszamy na cotygodniowe konsultacje.
  • Nawyk samodzielnego szukania wiedzy – korzystanie z bazy pytań i odpowiedzi uczy zasady documentation first, tak pożądanej w nowoczesnym IT.
Proporcjonalność post-mortem: Każda awaria w proporcji do wpływu; głębokość RCA (5 Whys vs FTA) i dwujęzyczność (U05) - FAQ rozwiewa wątpliwości.
FAQ

Sekcja FAQ (Frequently Asked Questions) zbiera najczęściej zadawane pytania o przedmiot i metody oceny, aby rozwiać typowe wątpliwości studentów, zanim jeszcze się pojawią, i pozwolić im skupić się na nauce, a nie na formalnościach. Najczęstsze pytania dotyczą zasad zaliczenia końcowego (progi, forma egzaminu), terminów oddawania zadań, dopuszczalności pracy w grupach, zasad korzystania z literatury oraz możliwości odrobienia zajęć. Umieszczenie odpowiedzi w jednym miejscu oszczędza czas prowadzącego i studentów oraz zapewnia spójność informacji - odpowiedzi udzielone publicznie są takie same dla wszystkich, co eliminuje nieporozumienia i poczucie niesprawiedliwości.

Do FAQ trafiają również pytania merytoryczne dotyczące tematyki incydentów, np.: „czy każda awaria musi mieć post-mortem?”, „jak głęboko przeprowadzać analizę przyczyn?”, „czy raport musi być zawsze dwujęzyczny?”. Odpowiedzi bazują na praktyce SRE: post-mortem powinien powstać po każdym incydencie mającym wpływ na użytkowników (im większy wpływ, tym poważniejsza analiza); głębokość analizy zależy od wagi incydentu (do prostych awarii wystarczy 5 Whys, do złożonych - FTA i diagram Ishikawy); dwujęzyczność raportów jest wymaganiem tego przedmiotu (U05) i standardem w firmach międzynarodowych. Sekcja FAQ jest aktualizowana na bieżąco - jeśli w trakcie semestru pojawiają się nowe, powracające pytania, prowadzący dodaje je do listy, co czyni z niej żywy dokument, a nie raz zamknięty zbiór.

Dla studentów ważne jest, aby przed zapisaniem się na konsultacje lub napisaniem wiadomości do prowadzącego najpierw sprawdzić FAQ - wiele odpowiedzi znajduje się już tam. Taka praktyka buduje nawyk samodzielnego poszukiwania informacji i szacunku dla czasu innych, który obowiązuje również w pracy z incydentami (zanim zapytasz kogoś w zespole, sprawdź runbook i dokumentację). FAQ wspiera więc nie tylko dydaktykę, ale i kulturę współpracy charakterystyczną dla środowisk SRE. Terminologia: FAQ (najczęściej zadawane pytania), grading rules (zasady oceniania), deadlines, group work policy, assessment, self-service, documentation first.

Wyjaśnienie skrótów użytych na slajdzie:
FAQ – Frequently Asked Questions – najczęściej zadawane pytania; Zestawienie odpowiedzi na typowe wątpliwości studentów dotyczące dyżurów i narzędzi SRE.
OnCallFears – Addressing On-call Duty Concerns – przezwyciężanie obaw przed dyżurami; Porady psychologiczne i techniczne jak zachować spokój podczas pierwszych nocnych wezwań pagera.
ToolingChoices – Infrastructure Tooling Selection Criteria – kryteria doboru narzędzi infrastruktury; Dyskusja o przewagach i ograniczeniach poszczególnych technologii (Prometheus, Loki, ArgoCD).
Certification – Industry SRE and Cloud Certifications – certyfikacje branżowe SRE i chmurowe; Omówienie wartości międzynarodowych egzaminów (CKA, CKS, Google Cloud Professional SRE).
JobInterviews – Technical SRE Job Interviews Preparation – przygotowanie do rozmów kwalifikacyjnych; Typowe pytania rekrutacyjne z zakresu diagnostyki, korelacji metryk i architektury HA.

53/55 Sprawdzenie kompetencji
Sprawdzenie kompetencji (learning outcomes): Mapowanie efektów uczenia się na sylabus: wiedza (K01-K03), umiejętności (U01-U05), kompetencje społeczne. Przykłady: „potrafi przygotować raport PL/EN" (U05) → sprawdzane w zadaniu domowym (slajd 35) i egzaminie; „rozumie kulturę blameless" (K01/K03) → pytanie kontrolne (slajd 42) i obserwacja symulacji. Student widzi, co dokładnie będzie weryfikowane - świadome przygotowanie do zaliczenia.

Efekty mapujesz na dowody: K01-K03, U01-U05 i społeczne - każdy z narzędziem weryfikacji.

  • Zestawienie efektów uczenia się – pozwala studentom samodzielnie zweryfikować stopień opanowania materiału przed egzaminem końcowym.
  • Równowaga wiedzy i kompetencji – kurs łączy twarde umiejętności konfiguracji narzędzi z miękkimi kompetencjami komunikacji i kultury blameless.
  • Sprawdzian samodzielności – przejrzyj listę efektów i uczciwie oceń, czy potrafisz samodzielnie przeprowadzić procedurę analizy powypadkowej.
  • Uzupełnienie ewentualnych braków – w razie zidentyfikowania luk w wiedzy zachęcamy do powrotu do slajdów, dokumentacji i ćwiczeń w konsoli.
  • Pewny start w branży technologicznej – opanowanie materiału gwarantuje bezproblemowe zdanie egzaminu i solidną pozycję na rynku pracy IT.
Learning outcomes: Efekty K01-K03, U01-U05 i społeczne mapowane na zadania (U05 → slajd 35) i egzamin; student wie, co będzie weryfikowane.
efekty

Sprawdzenie kompetencji mapuje efekty uczenia się na sylabus przedmiotu i pokazuje, które kompetencje będą weryfikowane: efekty uczenia się (learning outcomes) to formalnie zdefiniowana lista umiejętności i wiedzy, którą student powinien posiadać po ukończeniu przedmiotu, w sylabusie odnosząca się do oznaczeń - np. wiedza (K01-K03), umiejętności (U01-U05) i kompetencje społeczne (obowiązki etyczne, praca zespołowa). Sekcja pokazuje w przejrzysty sposób, jak każda część materiału o incydentach przekłada się na formalne efekty: zarządzanie incydentem i post-mortem odpowiadają konkretnym umiejętnościom, a kultura blameless i komunikacja - kompetencjom społecznym. Dzięki temu student świadomie planuje przygotowanie do zaliczenia.

Mapowanie na sylabus ma również praktyczne znaczenie dla jakości nauczania: prowadzący może zaplanować zadania i pytania egzaminacyjne tak, aby weryfikowały każdy zapisany efekt. Na przykład efekt „student potrafi przygotować raport z incydentu po polsku i angielsku (U05)” jest sprawdzany w zadaniu domowym (slajd 35) i podczas egzaminu; efekt „student rozumie zasady kultury blameless (K01/K03)” jest weryfikowany pytaniem kontrolnym (slajd 42) oraz obserwacją pracy w grupie podczas symulacji. Dzięki takiemu powiązaniu cele dydaktyczne nie pozostają pustymi deklaracjami, lecz mają swoje konkretne narzędzia weryfikacji. Student, który analizuje tablicę mapowania, widzi, że wszystkie tematy - od SLA, przez monitoring, po incydenty - służą realnym kompetencjom zawodowym.

Sprawdzenie kompetencji zachęca również do samooceny: student może przed zaliczeniem przejrzeć listę efektów i dla każdego zadać sobie pytanie „czy potrafię to zrobić?”. Tam, gdzie odpowiedź brzmi „nie”, warto wrócić do odpowiednich slajdów, literatury i ćwiczeń - a w razie wątpliwości skorzystać ze wsparcia (slajd 50). Jeśli wszystkie efekty są pokryte, można przystąpić do egzaminu z przekonaniem, że materiał został opanowany kompleksowo, a nie tylko „odtworzony na pamięć”. Terminologia: learning outcomes, syllabus mapping, competencies, verification (weryfikacja), self-assessment (samoocena), grading criteria, U05/K01/K02/K03, study plan.

Wyjaśnienie skrótów użytych na slajdzie:
SkillMatrix – SRE Engineering Skill Matrix – matryca kompetencji inżyniera SRE; Samoocena studenta w kluczowych domenach: obserwowalność, automatyzacja, wysoka dostępność i incydenty.
ObservabilityCompetence – Observability Practical Competence – praktyczne kompetencje w obserwowalności; Umiejętność pisania zapytań PromQL/LogQL i konstruowania ergonomicznych pulpitów.
GitOpsSkills – Declarative GitOps Technical Skills – techniczne umiejętności w modelu GitOps; Sprawność w definiowaniu manifestów Kustomize i zarządzaniu aplikacjami w ArgoCD.
IncidentReadiness – Operational Incident Readiness – gotowość do reagowania na incydenty; Znajomość ról ICS, procedur mitygacji i metodyki sporządzania raportów post-mortem.
FinalCheck – Comprehensive Course Competence Check – końcowa weryfikacja kompetencji akademickich; Potwierdzenie opanowania materiału wymaganego do uzyskania zaliczenia z przedmiotu.

54/55 Podsumowanie przedmiotu
Podsumowanie przedmiotu (SRE Skill Set): 1) SLI/SLO/Error Budget (wykład 2) - definiowanie jakości usługi. 2) Monitoring & Wizualizacja (wykłady 3-4) - Prometheus, Grafana, Loki, Tempo. 3) HA & Load Balancing (wykład 5) - Nginx, HAProxy, keepalived, redundancja, failover. 4) Alerting & On-call (wykład 6) - Alertmanager, burn rate, eskalacja. 5) GitOps & ArgoCD (wykład 7) - declarative deployment, sync, rollback. 6) Incident Management & Post-mortem (wykład 8) - RCA, blameless, runbooki, action items. Soft skills: blameless, komunikacja, on-call readiness. T-shape skills + continuous learning + ścieżka kariery (Junior → Staff) i certyfikacje (CKA, CKAD, CKS).

Twarda technika i miękkie kompetencje: SLI i K8s obok blameless i komunikacji. Cytat Treynora na koniec.

  • Synteza wiedzy z całego kursu – moduł łączy w spójną całość metryki, wskaźniki SLI/SLO, logowanie, wysoką dostępność, GitOps i incydenty.
  • Inżynier o profilu T-shape – nowoczesny inżynier niezawodności posiada głęboką wiedzę specjalistyczną połączoną z szerokim zrozumieniem operacji.
  • Trzy filary sukcesu technologicznego – automatyzacja żmudnej pracy, decyzje oparte na telemetrii i kultura zaufania budują stabilność IT.
  • Ponadczasowa definicja SRE – jak pisał twórca SRE w Google, Ben Treynor: SRE to podejście, gdy projektowanie operacji powierza się programistom.
  • Mocny fundament pod przyszłość – wiedza zdobyta na wykładach stanowi solidną bazę pod projektowanie bezpiecznych platform rozproszonych.
SRE Skill Set: SLI/SLO (2), monitoring (3-4), HA (5), alerting (6), GitOps (7), incydenty (8) plus soft skills - komplet operacyjny w skali.
podsumowanie

Podsumowanie przedmiotu syntetyzuje kluczowe umiejętności i wiedzę nabyłą w trakcie całego kursu SRE - to nie koniec nauki, to początek praktycznej drogi SRE. Zestaw umiejętności (SRE Skill Set) obejmuje: SLI/SLO/Error Budget (wykład 2 - definiowanie wskaźników jakości usługi); monitoring i wizualizację (wykłady 3-4 - Prometheus, Grafana, Loki, Tempo, alerting, dashboards); HA i load balancing (wykład 5 - Nginx, HAProxy, keepalived, redundancja, failover); alerting i on-call (wykład 6 - Alertmanager, burn rate, routing, escalation, on-call rotation); GitOps i ArgoCD (wykład 7 - declarative deployment, sync, rollback, progressive delivery); oraz incident management i post-mortem (wykład 8 - RCA, blameless post-mortem, runbooks, action items). Soft skills to blameless culture, communication, on-call readiness, incident command, post-mortem writing i RCA; ścieżka kariery prowadzi od Junior SRE przez Senior i Staff SRE do SRE Manager / Principal SRE, a ciągłe uczenie się (continuous learning) to warunek przetrwania w SRE. Terminologia: SRE skill set, career path, certifications, continuous learning, T-shaped skills, full stack SRE, platform engineering, SRE maturity model.

Umiejętności techniczne (Hard Skills): SLI/SLO definition & measurement, PromQL / LogQL / TraceQL, Prometheus/Grafana/Loki/Tempo/ArgoCD/Terraform/Ansible/Kubernetes, Linux internals, Networking (TCP/IP, DNS, TLS, Load Balancing), Coding (Python/Go/Bash), IaC (Terraform, Helm, Kustomize), CI/CD (GitHub Actions, GitLab CI, ArgoCD, Tekton), Security (TLS, mTLS, RBAC, Network Policies, Secrets).

Umiejętności miękkie (Soft Skills): Blameless culture & psychological safety, Incident Command & Communication, Post-mortem writing & RCA, On-call readiness & handover, Cross-team collaboration, Stakeholder communication, Prioritization (RICE/WSJF), Time management, Stress management, Continuous learning. Terminologia: soft skills, psychological safety, blameless culture, incident command, communication, prioritization, time management, stress management, continuous learning.

Kariera SRE: Junior SRE (0-2 lata: nauka narzędzi, on-call shadowing, runbooki), Mid SRE (2-5 lat: ownership serwisów, on-call lead, runbooki, post-mortemy), Senior SRE (5+ lat: architektura, capacity planning, mentoring, strategic decisions), Staff/Principal SRE (architektura platformy, organizational impact, industry leadership). Certyfikacje: CKA (Kubernetes), CKAD (K8s App Dev), CKS (K8s Security), AWS/GCP/Azure SRE, HashiCorp Terraform, Prometheus Certified.

Podsumowanie: SRE = T-shaped skills (głębokie w 1-2 obszarach, szerokie w reszcie). Continuous learning = survival. Toil elimination = automation. Data-driven = metrics > opinions. Communication = bridge tech-biz. SRE = engineering approach to operations. "SRE is what happens when you ask a software engineer to design an operations team" - Ben Treynor.

Wyjaśnienie skrótów użytych na slajdzie:
SRECurriculum – Site Reliability Engineering Curriculum – program nauczania inżynierii niezawodności; Podsumowanie ścieżki dydaktycznej od podstaw administracji po zaawansowaną inżynierię oprogramowania.
8LecturesSummary – Eight Academic Lectures Overview – przegląd ośmiu wykładów akademickich; Syntetyczny bilans zrealizowanych zagadnień: wprowadzenie, metryki, wizualizacja, logi, HA, alerting, GitOps, incydenty.
TheoryAndPractice – Integration of Theory and Practice – integracja teorii z praktyką; Połączenie norm ISO/IEC i RFC z realnymi laboratoriami na serwerach linuksowych.
EngineeringRigor – Academic and Engineering Rigor – akademicki i inżynierski rygor merytoryczny; Wymóg precyzji pojęciowej, sprawdzania faktów i eliminacji subiektywnego żargonu.
UniversityCourse – University Computer Science Course – uniwersytecki kurs informatyki; Oficjalne zakończenie zajęć dydaktycznych dla studentów kierunku Informatyka.
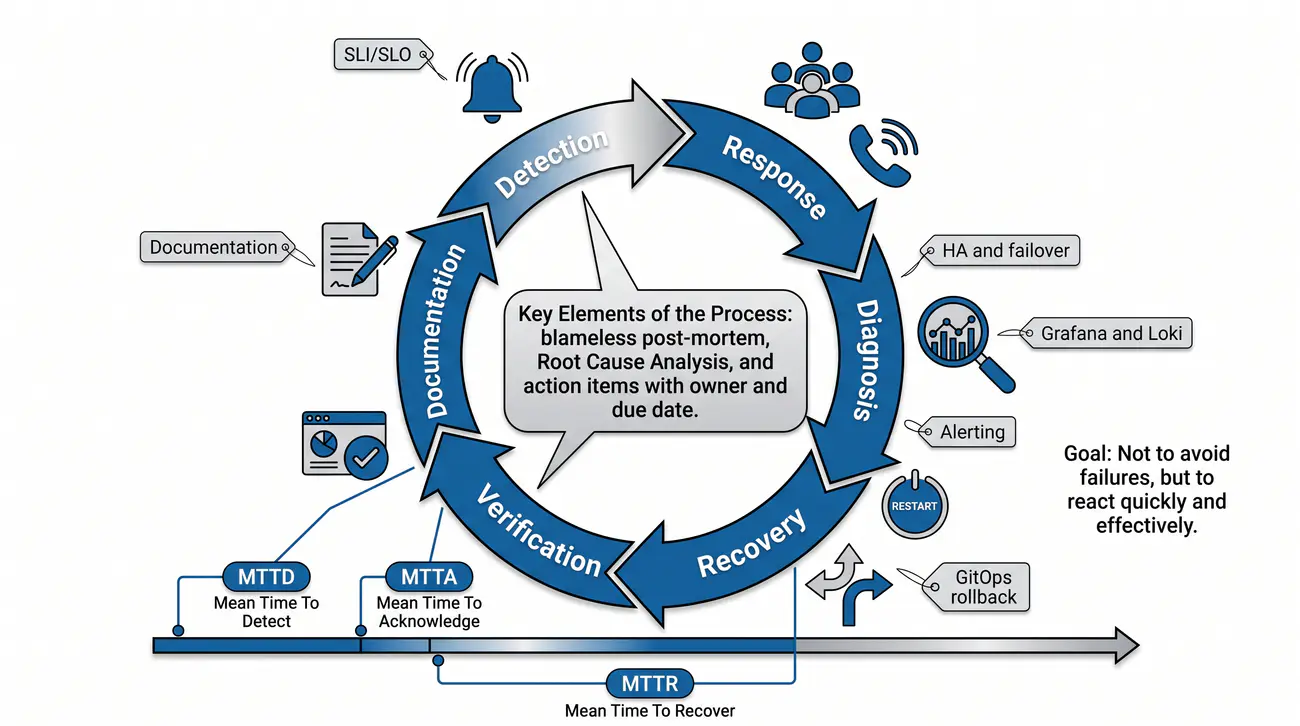
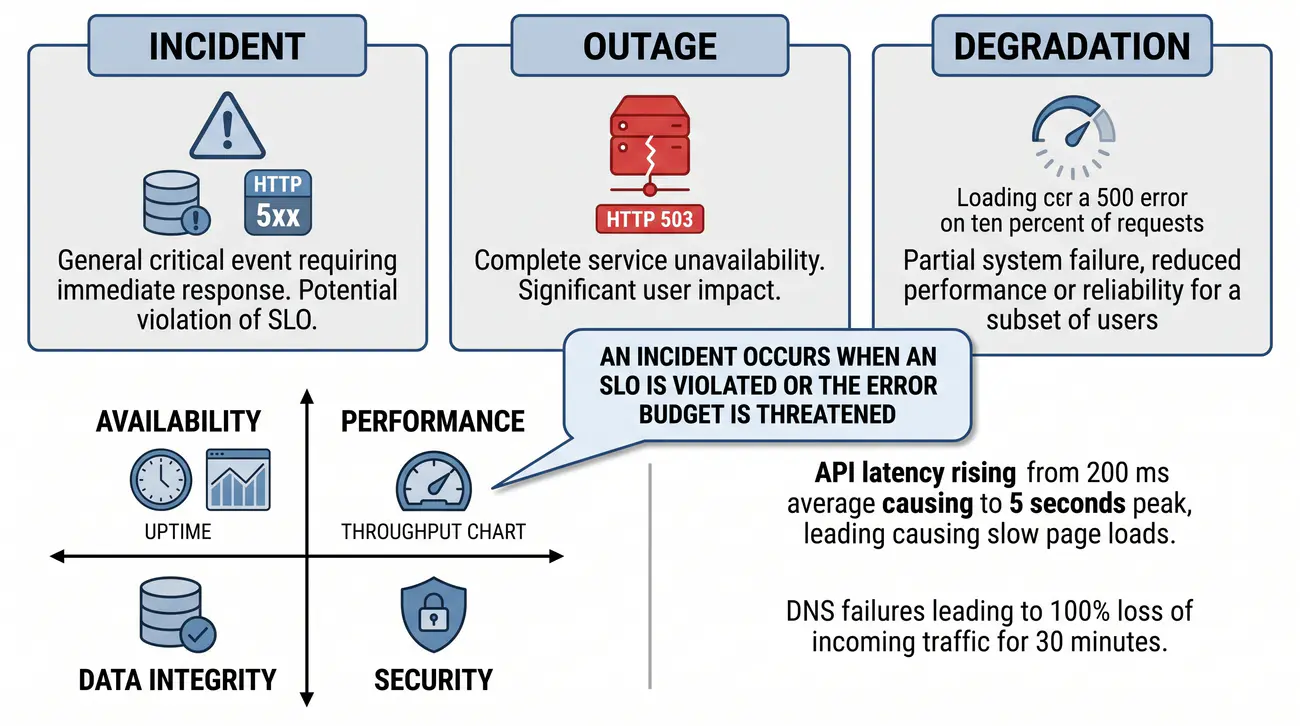
55/55 Zakończenie kursu
Zakończenie kursu: Podziękowanie za uwagę, aktywność i pytania. Co dalej: hands-on assignment (zbuduj kompletny stack w GitOps: docker-compose + CI/CD + ArgoCD + runbook), kontakt (Slack, e-mail, office hours, peer support - slajd 50), feedback (ankieta po module). Najlepszą nauką jest samodzielne budowanie i utrzymywanie własnych systemów produkcyjnych. Continuous improvement: feedback → next iteration.
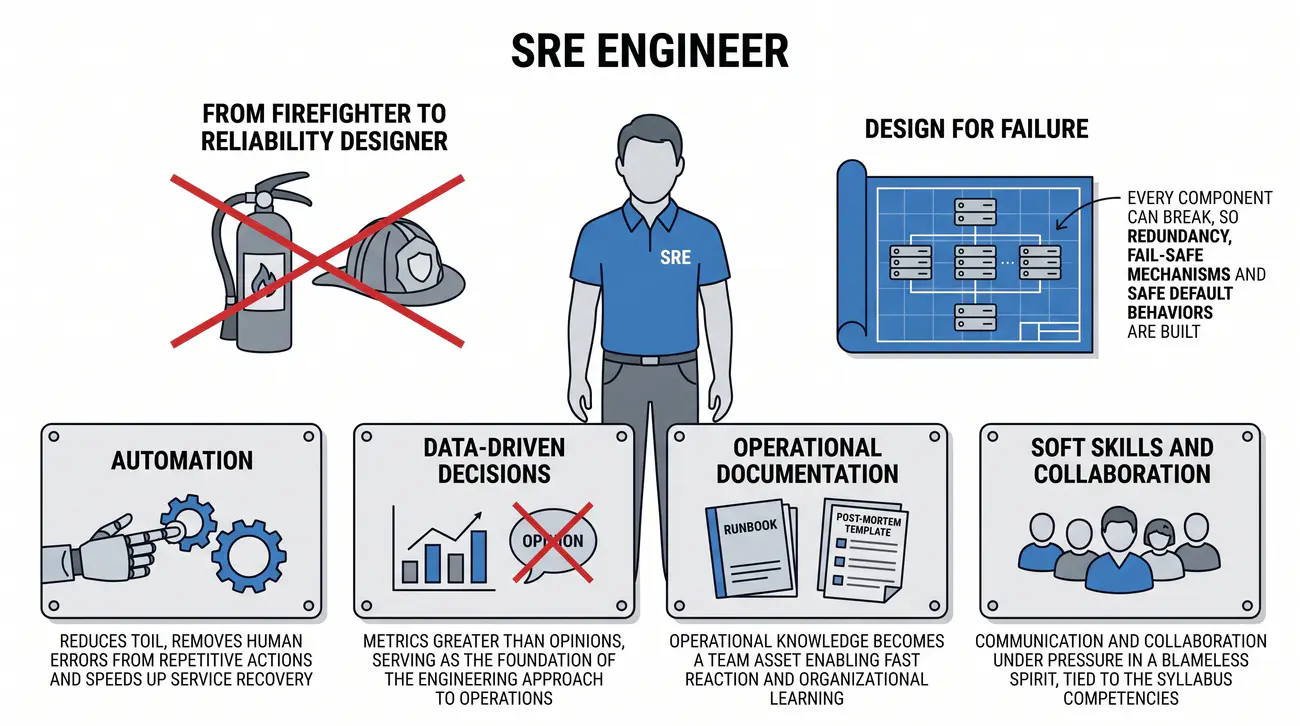
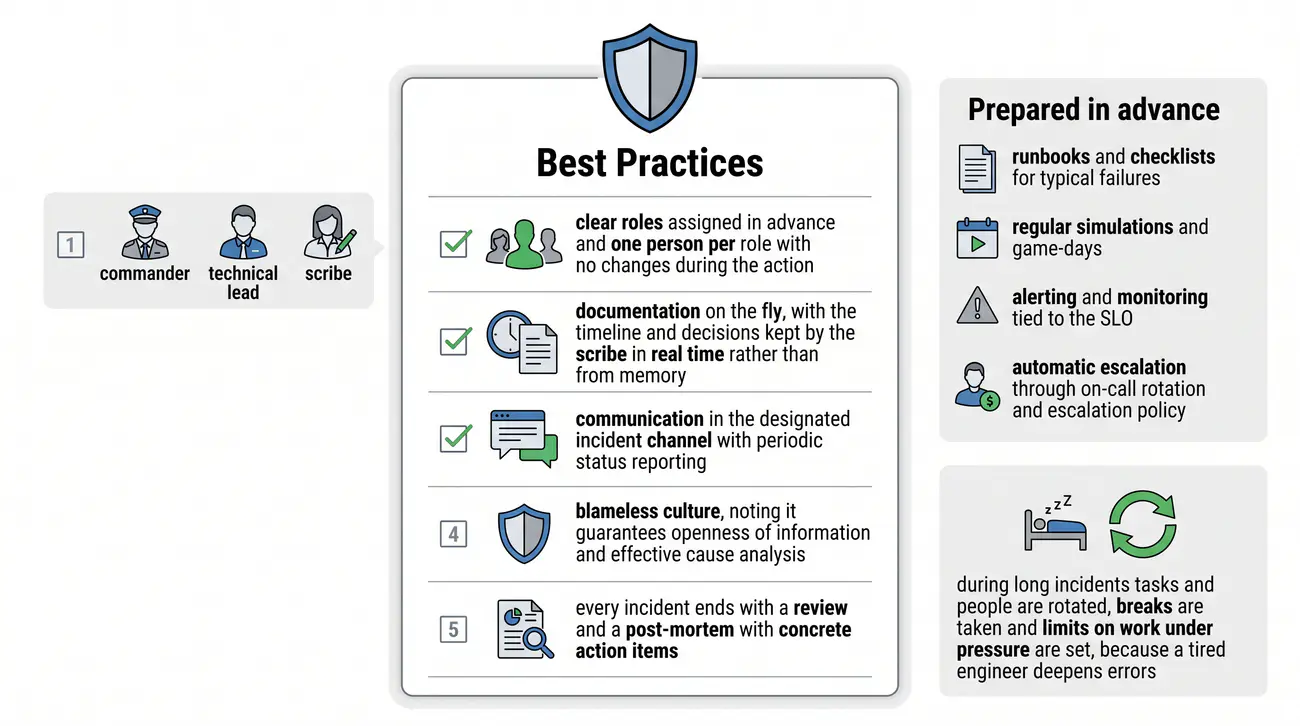
Finał kursu: kompletny stack GitOps z dokumentacją, feedback i zapowiedź wykładu 9. Najlepsza nauka to własne systemy.

  • Podziękowanie za wspólny semestr – dziękujemy za wspaniałą energię, zaangażowanie w dyskusje i dociekliwość podczas całego cyklu wykładów.
  • Realizacja zadania końcowego – ostatnim krokiem do zaliczenia jest oddanie projektu obejmującego stos GitOps oraz wzorowy raport powypadkowy.
  • Nieustanna podróż w stronę wiedzy – pamiętajcie, że SRE to ciągła podróż: łamcie systemy w bezpieczny sposób, wyciągajcie wnioski i automatyzujcie.
  • Życzenia sukcesów zawodowych – życzymy powodzenia na sesji egzaminacyjnej oraz wielu fascynujących sukcesów w projektowaniu chmur przyszłości!
  • Do zobaczenia na zaawansowanych modułach – zapraszamy na seminaria poświęcone inżynierii platformowej oraz zastosowaniom AI w operacjach IT!
Continuous improvement: Pętla feedback → next iteration; kompletny stack GitOps z runbookiem i ankietą - nauka przez budowanie własnych systemów.
zakończenie

Zakończenie kursu SRE to formalne zamknięcie modułu: co robić dalej (hands-on assignment), gdzie szukać pomocy (Slack, e-mail, office hours, peer support) i podziękowania - to nie koniec nauki, to początek praktyki. Terminologia: hands-on assignment, office hours, peer support, feedback loop, continuous learning.

Zapowiedź pracy własnej - hands-on assignment: Zadania - zbuduj kompletny GitOps stack: 1) Repozytorium Git z docker-compose.yml (min. 3 serwisy), 2) GitHub Actions / GitLab CI pipeline (build, test, push images, update compose tags), 3) ArgoCD Application (source: repo, path: compose/overlays/prod, targetRevision: main), destination: klaster, namespace. 4) Testy: sync (auto/manual), weryfikacja (kubectl get pods, curl healthcheck), rollback (git revert -> ArgoCD sync). 5) Dokumentacja: RUNBOOK (wdrażanie, rollback, debugging), CHANGELOG (wersje), README (quick start). Deadline: do wykładu 8. Repo: GitHub Classroom / GitLab / zip na Moodle. Code review = part of grading. Grade: practical competence (working stack + failover test + chaos experiment + runbook).

Kontakt i pytania - Support channels: Prowadzący dostępny: Slack (kanał #sre-course - publiczne pytania, announcements), e-mail (prowadzacy@uczelnia.pl - prywatne), office hours (poniedziałek 14-16, sala 205 / Teams). Kanał wsparcia grupy seminaryjnej: #sre-course-peers (studenci pomagają studentom - najlepsze uczenie, rubber duck debugging). COMMUNITY: Stack Overflow (tag: sre, haproxy, nginx, kubernetes), Grafana Community (community.grafana.com), Prometheus Users (prometheus.io/community), CNCF Slack (#argocd, #flux, #tekton, #kubernetes), Chaos Mesh Slack. Feedback Loop: ankieta po module (Google Forms / Microsoft Forms) - co było jasne, co nie, co dodać. Continuous Improvement: feedback -> next iteration.

Podziękowanie: Za uwagę, aktywność i pytania na wykładzie 8. Następny: Wykład 9 - Platform Engineering, AI/ML in SRE, Security-first SRE. GitOps/ArgoCD/Flux/Terraform/Ansible to fundament - teraz budujemy na nim operacyjną dojrzałość. Thank you for attention. See you in the field!

Wyjaśnienie skrótów użytych na slajdzie:
SREGraduation – SRE Course Completion and Graduation – ukończenie kursu inżynierii niezawodności; Gratulacje dla studentów za wytrwałość i opanowanie wymagającego materiału inżynierskiego.
Congratulations – Academic and Professional Congratulations – gratulacje akademickie; Uznanie prowadzącego dla zaangażowania studentów w trakcie wykładów i laboratoriów.
FutureEngineers – Next Generation of SRE Engineers – nowe pokolenie inżynierów niezawodności; Życzenia owocnej kariery w projektowaniu i utrzymaniu nowoczesnych systemów teleinformatycznych.
ResilientSystems – Building Resilient Digital Systems – budowanie odpornych systemów cyfrowych; Misja zawodowa polegająca na zapewnieniu ciągłości działania kluczowych usług społeczeństwa informacyjnego.
Farewell – Academic Farewell and Best Wishes – akademickie pożegnanie; Oficjalne zamknięcie cyklu wykładowego 'Zaawansowane utrzymanie usług i SRE'.