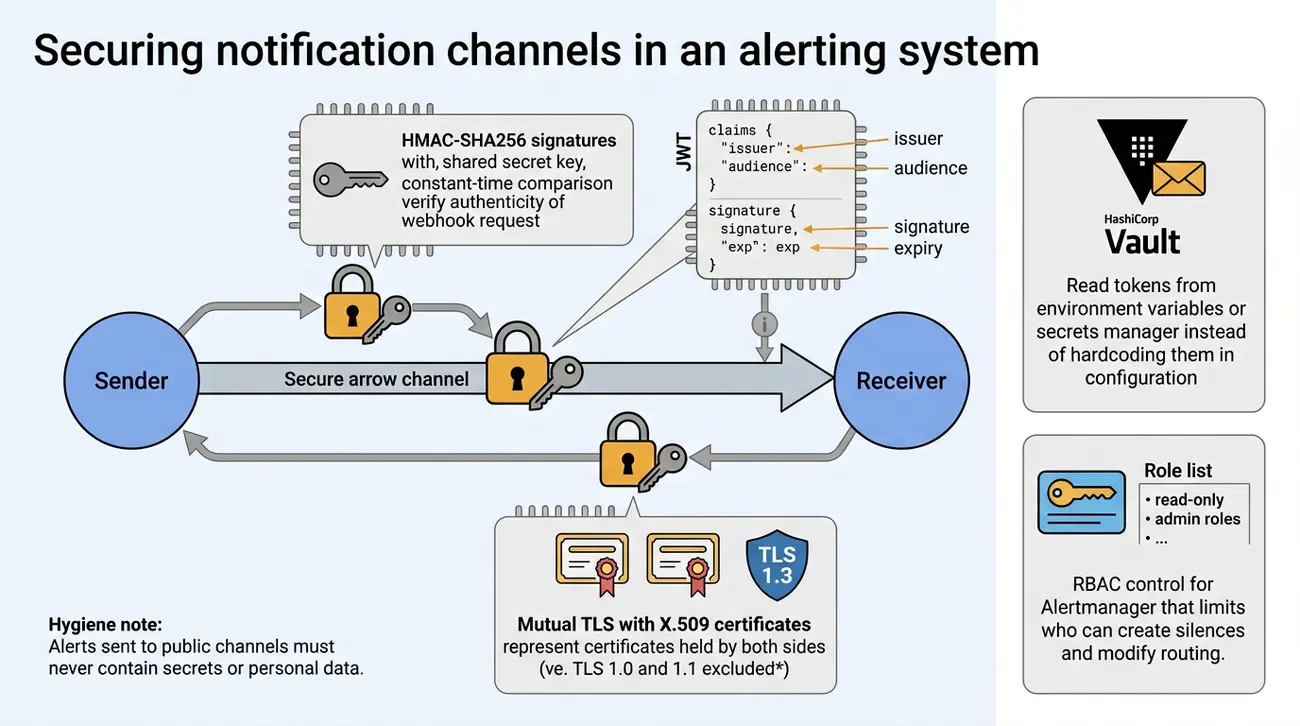
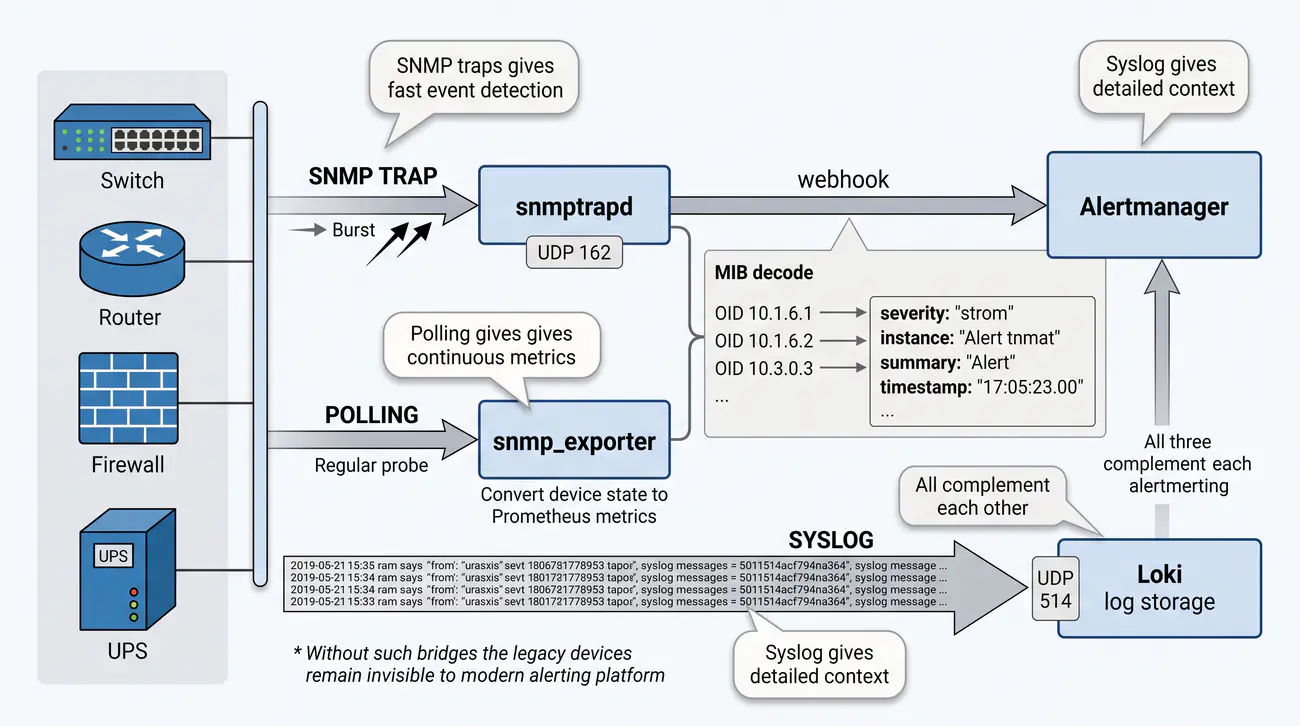
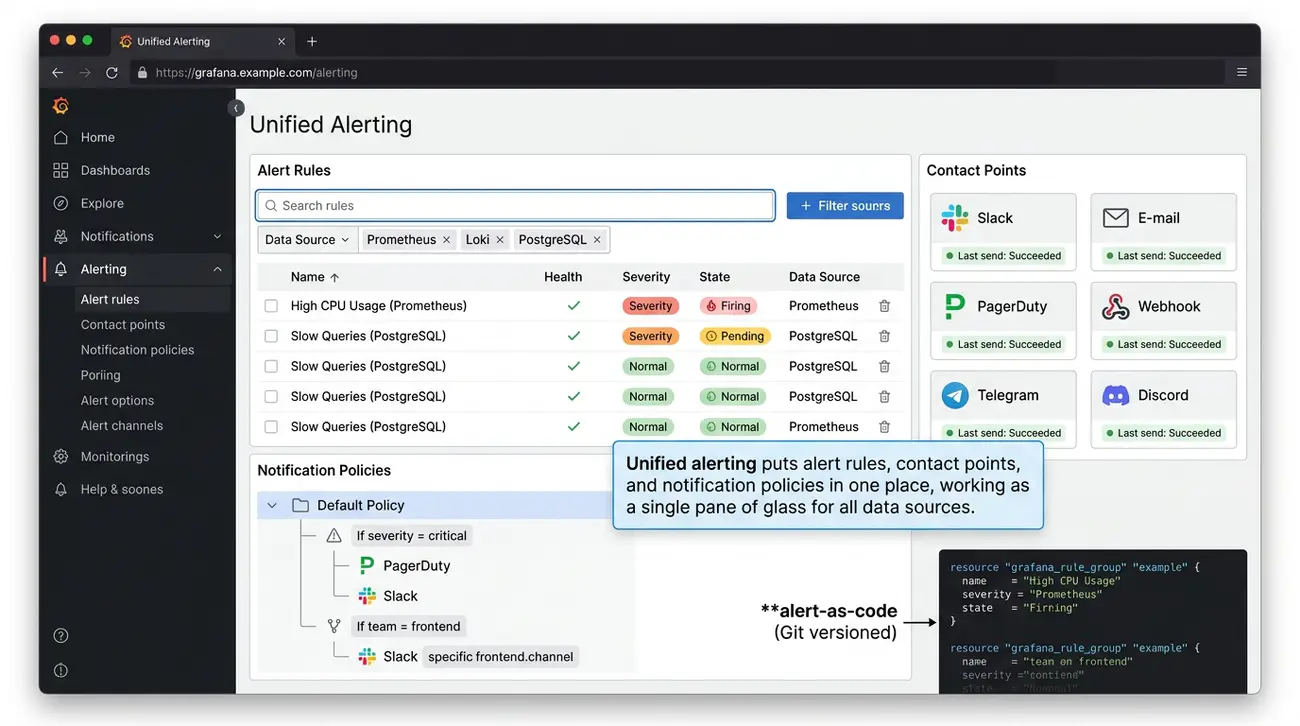
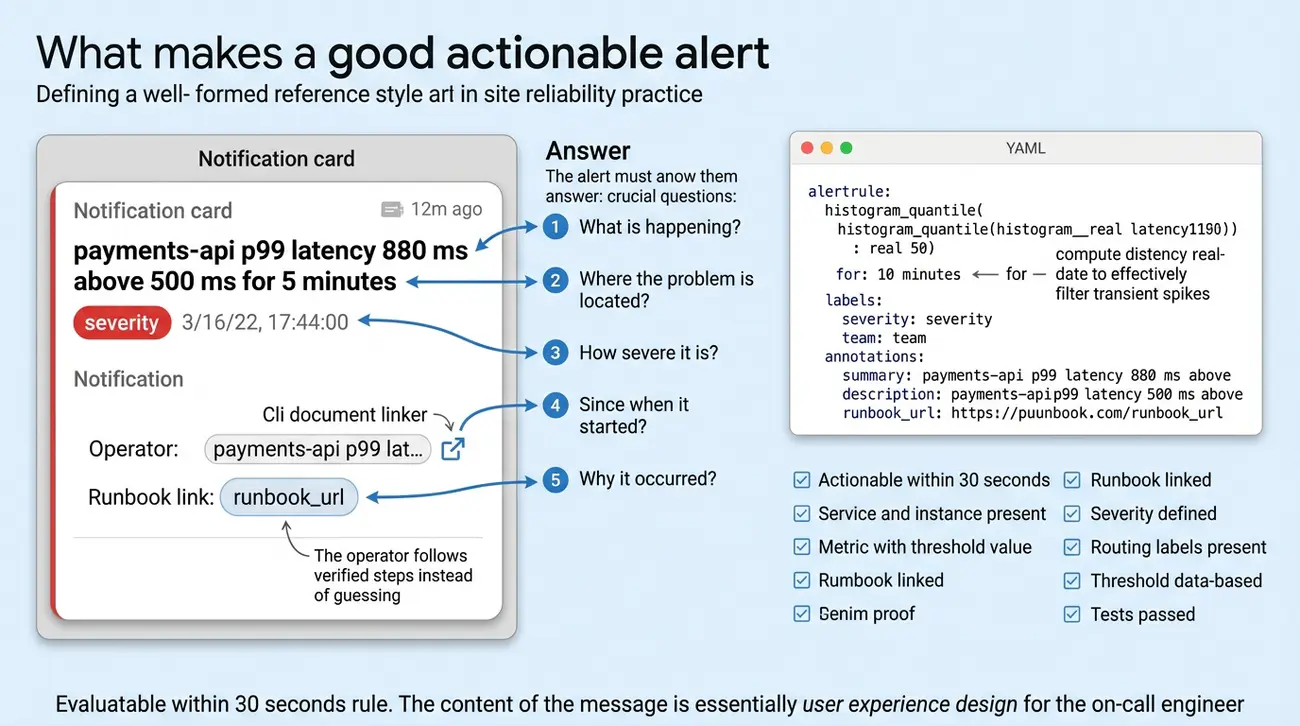
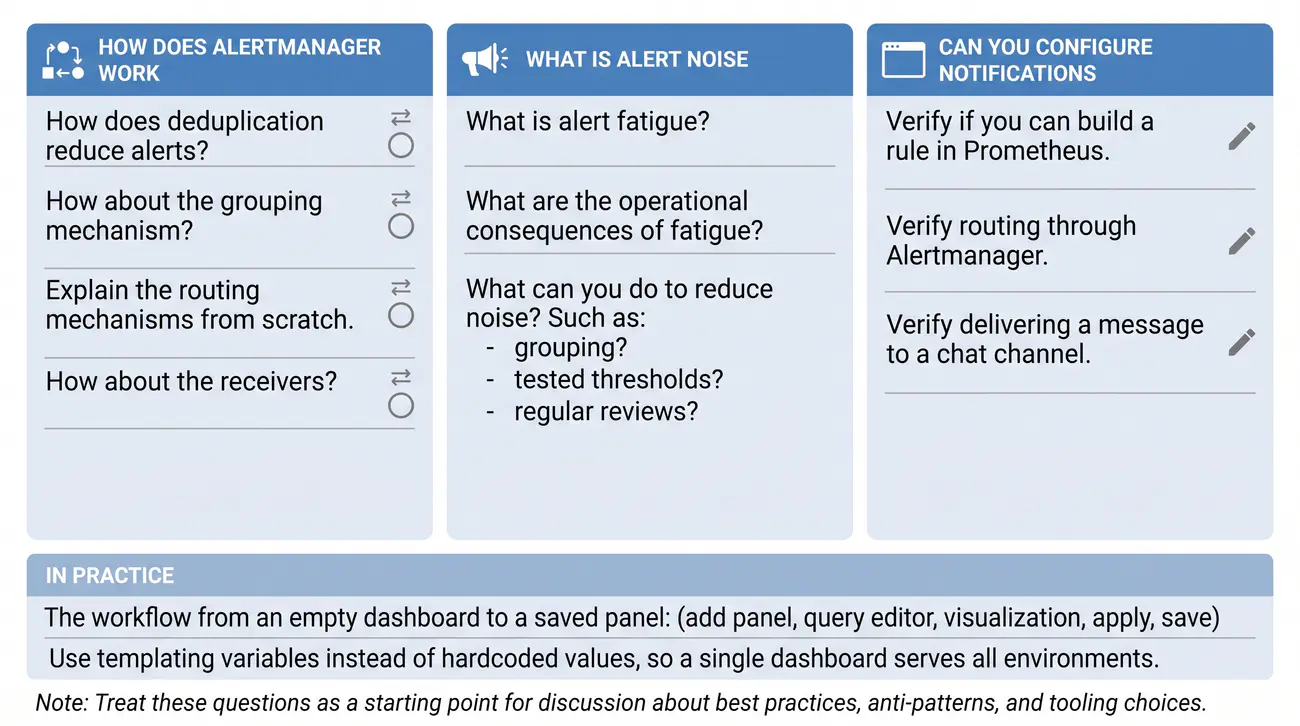
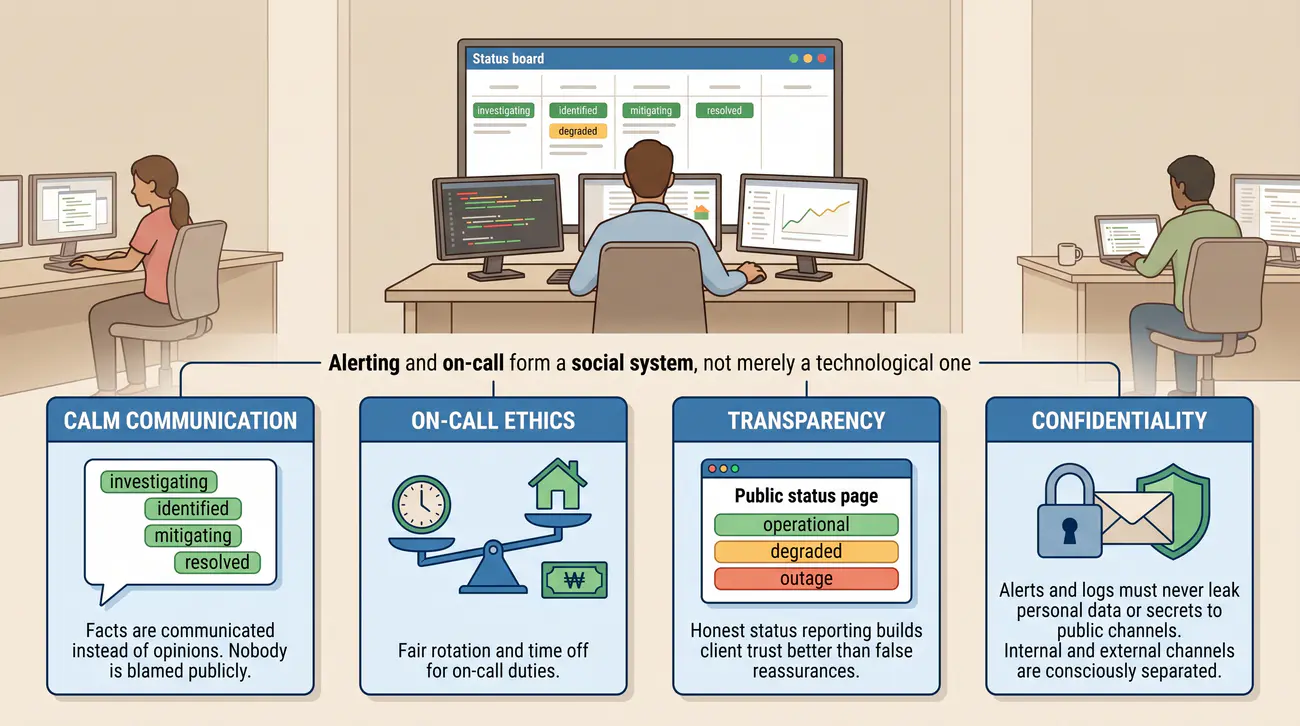
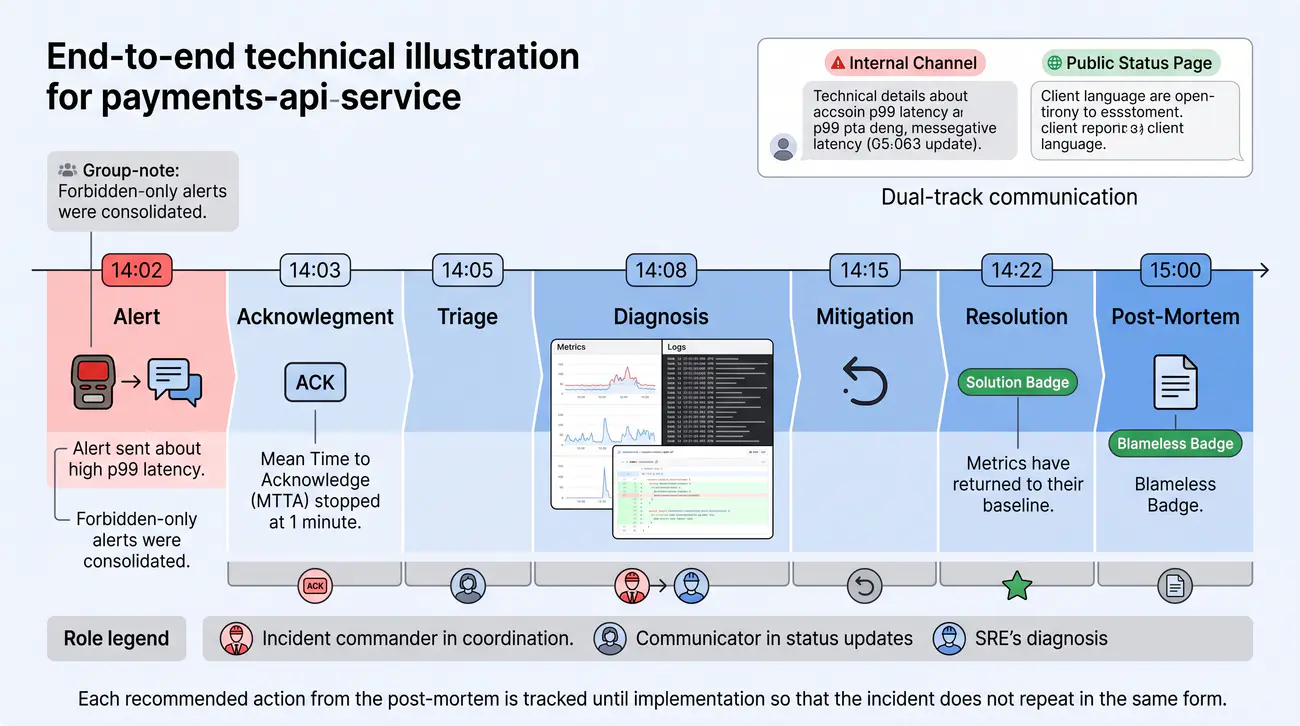
1/55 Alerting i powiadamianie
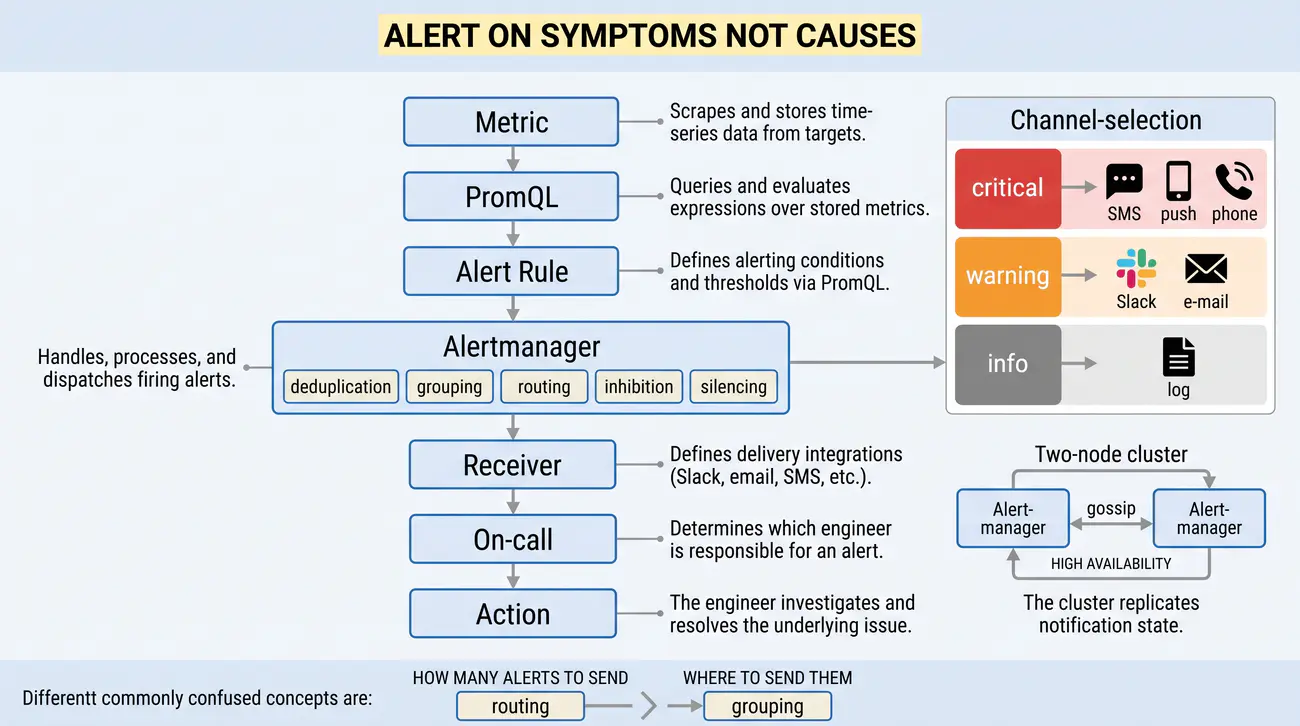
Alerting i powiadamianie: System "nerwowy" SRE - alertowanie na objawy (symptoms), nie przyczyny (causes). Alertmanager jako centralny komponent zarządzania alertami w ekosystemie Prometheus.

Alerting to most między wykresem a reakcją: budzi, zanim użytkownik zauważy. Filozofia: wołaj o objawy, nie przyczyny.

  • Układ nerwowy SRE – system powiadamiania stanowi fundament inżynierii niezawodności, alarmując zespół o usterkach zanim odczują je klienci.
  • Symptomy zamiast przyczyn – nowoczesne reguły reagują na objawy dostrzegane przez użytkowników, takie jak wysokie opóźnienia lub błędy serwera.
  • Rola Alertmanagera – odpowiada za scalanie duplikatów, grupowanie pokrewnych zdarzeń oraz inteligentne kierowanie komunikatów alarmowych.
  • Wysoka dostępność – w środowiskach produkcyjnych Alertmanager uruchamiany jest w klastrze HA, co zapobiega utracie kluczowych powiadomień.
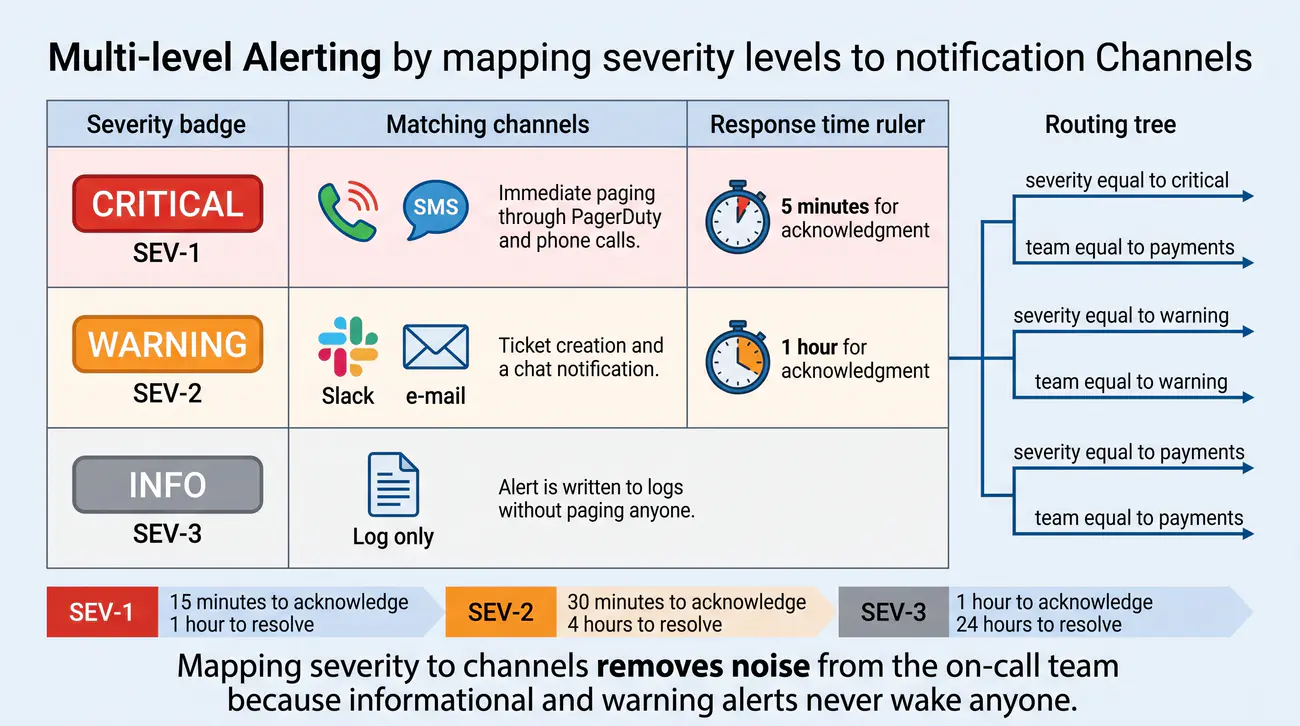
  • Różnicowanie kanałów – przekazywanie powiadomień na czat lub telefon zależy od wagi problemu, zapewniając właściwą reakcję personelu.
Symptoms vs causes: Alertowanie na objawy (skutki odczuwane przez użytkownika), nie na przyczyny; Alertmanager centralnie zarządza alertami w ekosystemie Prometheus.
powiadomienia
Wprowadzenie dla studenta: Alerting w ujęciu SRE różni się diametralnie od tradycyjnego monitoringu administratorów. Tradycyjne podejście alarmowało o przyczynach („serwer X ma 90% CPU”). Problem w tym, że 90% CPU może oznaczać, że serwer po prostu wydajnie pracuje i użytkownicy niczego złego nie doświadczają! SRE nakazuje alarmować na objawy dotykające ludzi („użytkownicy widzą błędy 500” lub „strona ładuje się powyżej 2 sekund”). Jeśli użytkownik nie cierpi, nie ma powodu budzić inżyniera w środku nocy.

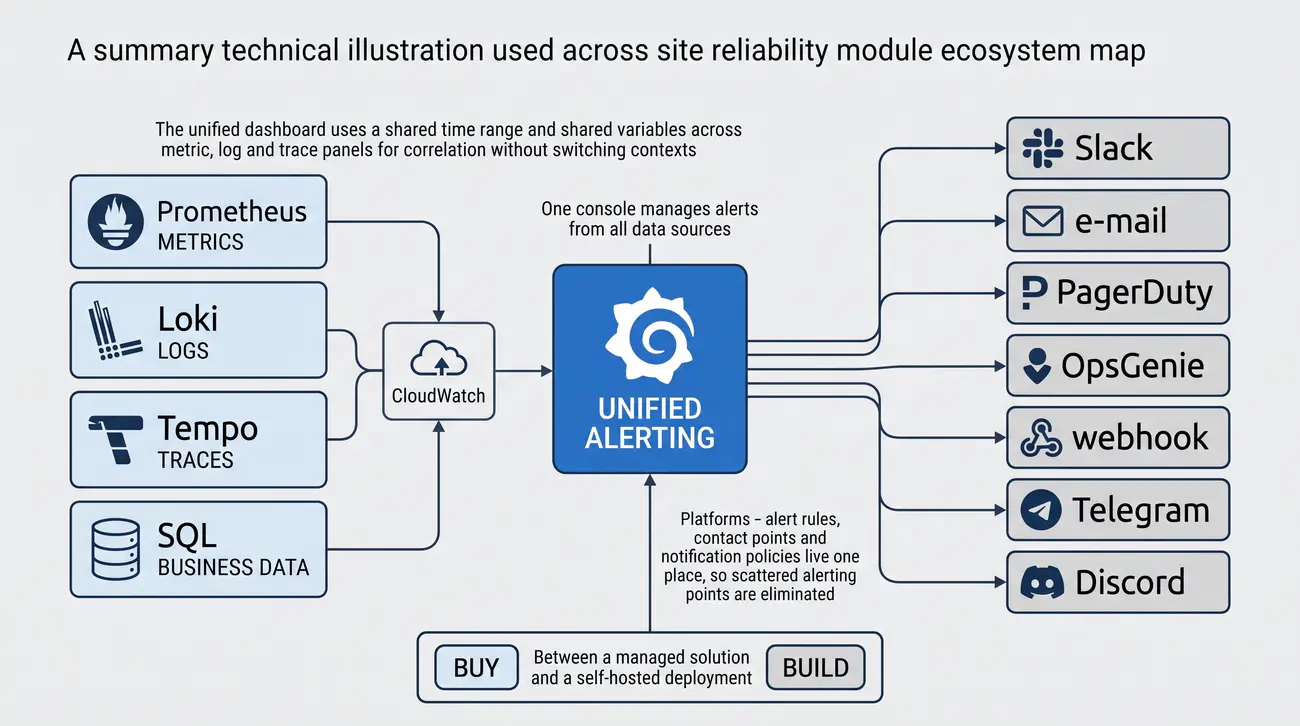
Alerting i powiadamianie to "system nerwowy" SRE - fundament modułu o wysokiej dostępności (High Availability) i odporności systemów. Skuteczne alertowanie opiera się na filozofii Google SRE: alertowanie na objawy (symptoms), a nie przyczyny (causes), co przyspiesza diagnozę i eliminuje fałszywe alarmy przy zmianach infrastruktury. Architektura opiera się na Alertmanagerze jako centralnym komponencie zarządzania alertami w ekosystemie Prometheus: deduplikacja, grupowanie, routowanie, inhibicja i wyciszanie. Integracja z popularnymi komunikatorami (Slack, Email, PagerDuty, Webhook, Telegram, Discord, Microsoft Teams) i pojęcie unified alerting UI - jednej konsoli dla alertów ze wszystkich źródeł danych (Prometheus, Loki, Tempo, SQL) - prowadzą do głębszego zanurzenia w Alertmanager w kolejnych slajdach.

Zasady skutecznego alertowania: Alertowanie na objawy (symptoms), nie przyczyny (causes) to złota zasada SRE. Alerty oparte na przyczynach (np. "CPU na 100%") są kruche - przy zmianie infrastruktury (np. dodanie rdzeni) przestają działać. Alerty oparte na objawach (np. "latency p99 > 500ms") są stabilne - mierzą to, co odczuwa użytkownik. Alert musi być actionable (operator wie co zrobić w 30 sekund), unikalny (deduplikacja grupowania), z kontekstem (runbook_url, dashboard link, severity, team). Alerting on symptoms = szybsza diagnoza, mniej fałszywych alarmów, stabilność przy zmianach.

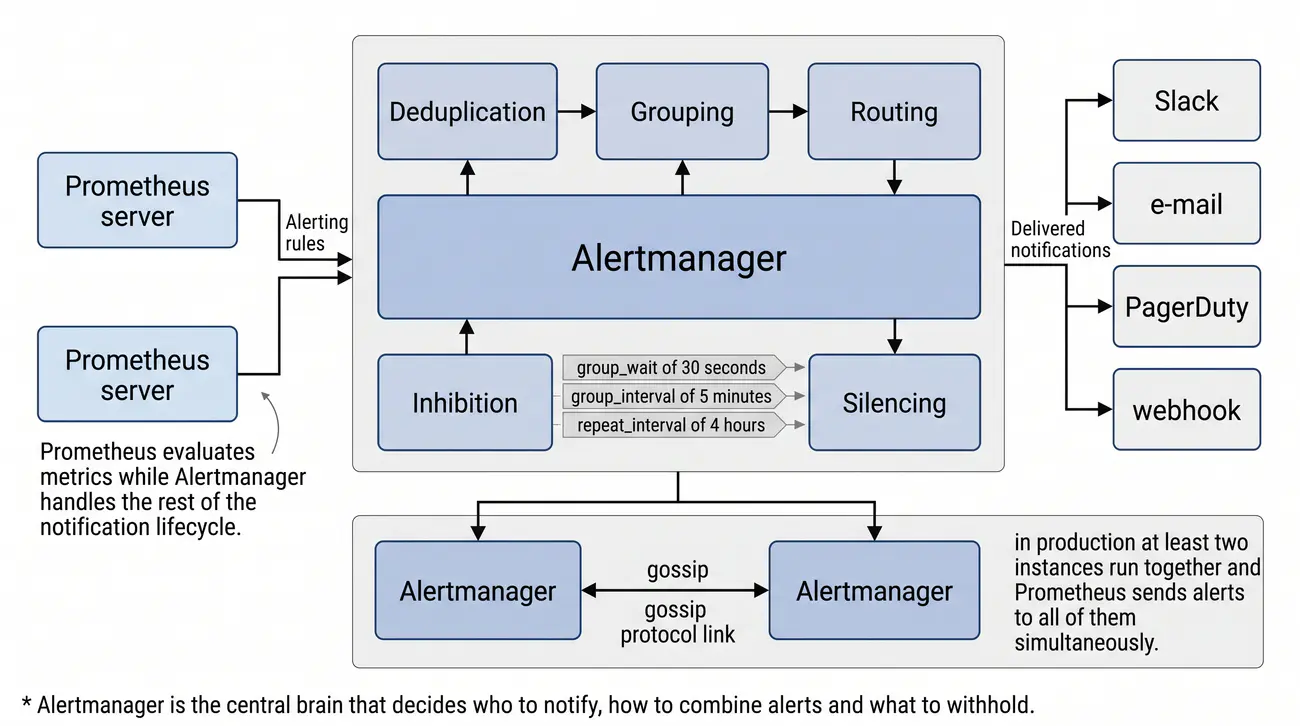
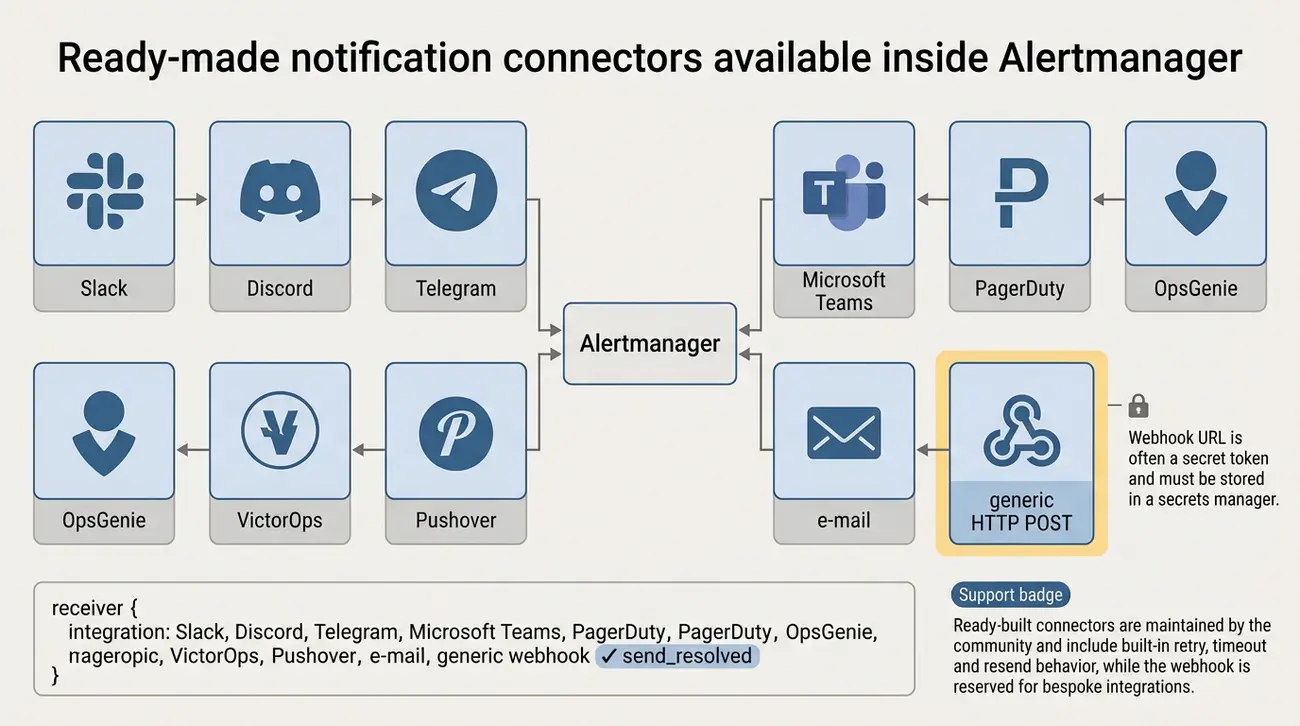
Alertmanager: Centralny komponent zarządzania alertami w ekosystemie Prometheus. Odbiera alerty z Prometheusa (i Grafana Alerting), deduplikuje (group_by - np. po alertname i clusterze), grupuje (group_wait: 30s oczekiwania na więcej alertów, group_interval: 5m interwał grupowania, repeat_interval: 4h powtarzania), routuje (route tree z matcherami, child routes dla specyficznych teamów/severity), inhibuje (inhibit_rules: critical wycisza warning, np. DB down milczy app errors), wycisza (silences: maintenance windows, deployments), dostarcza do receiverów (Slack, Email, PagerDuty, OpsGenie, Webhook, Telegram, Discord, VictorOps, Microsoft Teams). HA Alertmanager: 2+ instancje z gossip protocol (hashicorp/memberlist), shared state (silences, notifications, deduplication cache), leader election, rolling upgrades.

Integracja z komunikatorami: Slack (webhook URL / Bot Token, rich formatting: blocks, buttons: "Acknowledge", "Silence", "Runbook"), Email (SMTP, HTML/text templates), PagerDuty (API v2, severity mapping, escalation policies, conference bridge), OpsGenie (API key, on-call schedules), Webhook (custom: Jira, ServiceNow, custom bots), Telegram (Bot API, markdown), Discord (webhook, embeds), Microsoft Teams (webhook, adaptive cards), VictorOps/Splunk On-Call. Contact points = gdzie dostarczyć, notification policies = jak i kogo powiadomić (routing tree, group_by, matchers). Unified alerting UI (Grafana Alerting v2) = jedna konsola dla alertów ze WSZYSTKICH data sources (Prometheus + Loki + Tempo + SQL + CloudWatch). To eliminuje "alert w Prometheus, inny w Loki, inny w SQL" - single pane of glass dla on-call.

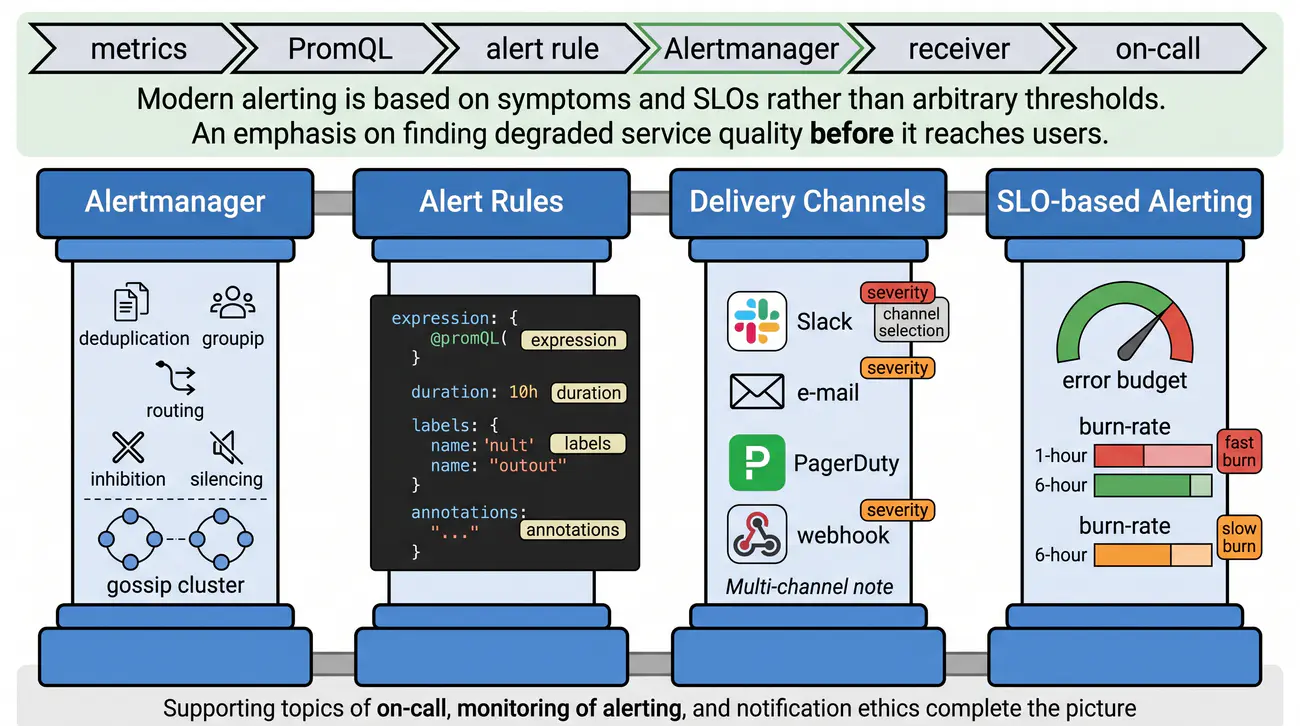
Podsumowanie: Alerting to pipeline: Metrics → PromQL → Alert Rule → Alertmanager → Receiver → On-call. Każde ogniwo musi działać niezawodnie. Actionable alerts > raw metrics. Terminologia: actionable alert, deduplication, grouping, routing, receiver, contact point, notification policy, silence, inhibition, unified alerting, HA Alertmanager.

Zanim przejdziemy do konkretnych narzędzi, warto ustalić, czym w ogóle jest alerting i dlaczego stanowi odrębny filar obserwowalności obok metryk, logów i tracingu. W poprzednich wykładach nauczyliśmy się gromadzić dane w Prometheusie i wizualizować je w Grafanie - ale same wykresy nie wystarczą, jeśli nikt ich nie ogląda w środku nocy. Alertowanie jest mostem między pasywnym monitorowaniem a aktywną reakcją operacyjną.

Filozofia Google SRE nakazuje alertowanie na objawy, a nie przyczyny - zamiast alarmować o wysokim CPU, alarmujemy o spadku latencji poniżej progu, bo to bezpośrednio dotyka użytkownika. Centralnym komponentem tej architektury jest Alertmanager, który przejmuje alerty z Prometheusa i realizuje cały cykl życia powiadomienia: deduplikację, grupowanie, routowanie, inhibicję i wyciszanie. Każde ogniwo pipeline musi działać niezawodnie.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina inżynierska traktująca powiadamianie o awariach jako element systemowej kontroli jakości usług.
AM – Alertmanager – menedżer alertów; Kluczowy komponent ekosystemu Prometheus odpowiedzialny za routing, deduplikację i wyciszanie powiadomień.
Pager – Pager / On-call notification system – system przywoławczy; Urządzenie lub aplikacja mobilna zmuszająca inżyniera dyżurnego do natychmiastowej reakcji w dzień i w nocy.
SMS – Short Message Service – krótka wiadomość tekstowa; Niezawodny kanał telekomunikacyjny GSM wykorzystywany do powiadamiania przy braku połączenia internetowego.
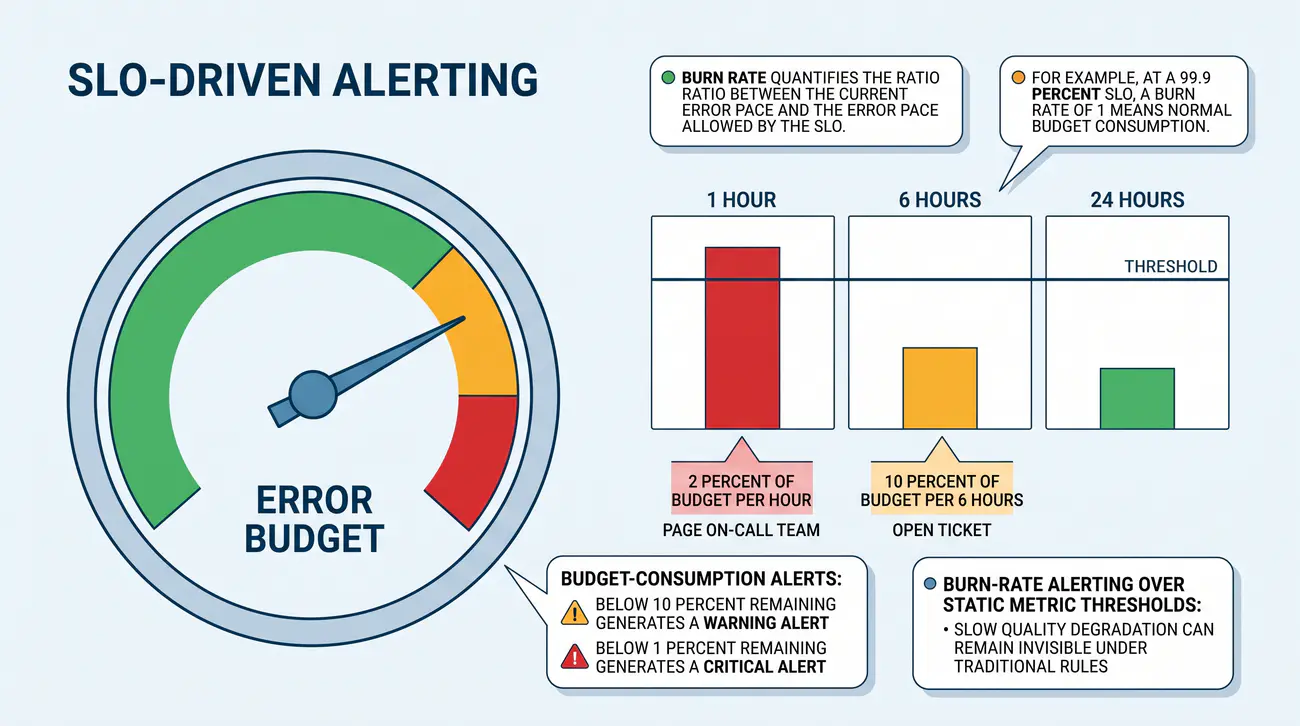
SLO – Service Level Objective – cel poziomu usług; Wskaźnik jakościowy, którego zagrożenie naruszenia stanowi podstawowe kryterium wyzwalania alertów.

2/55 Dlaczego alertowanie
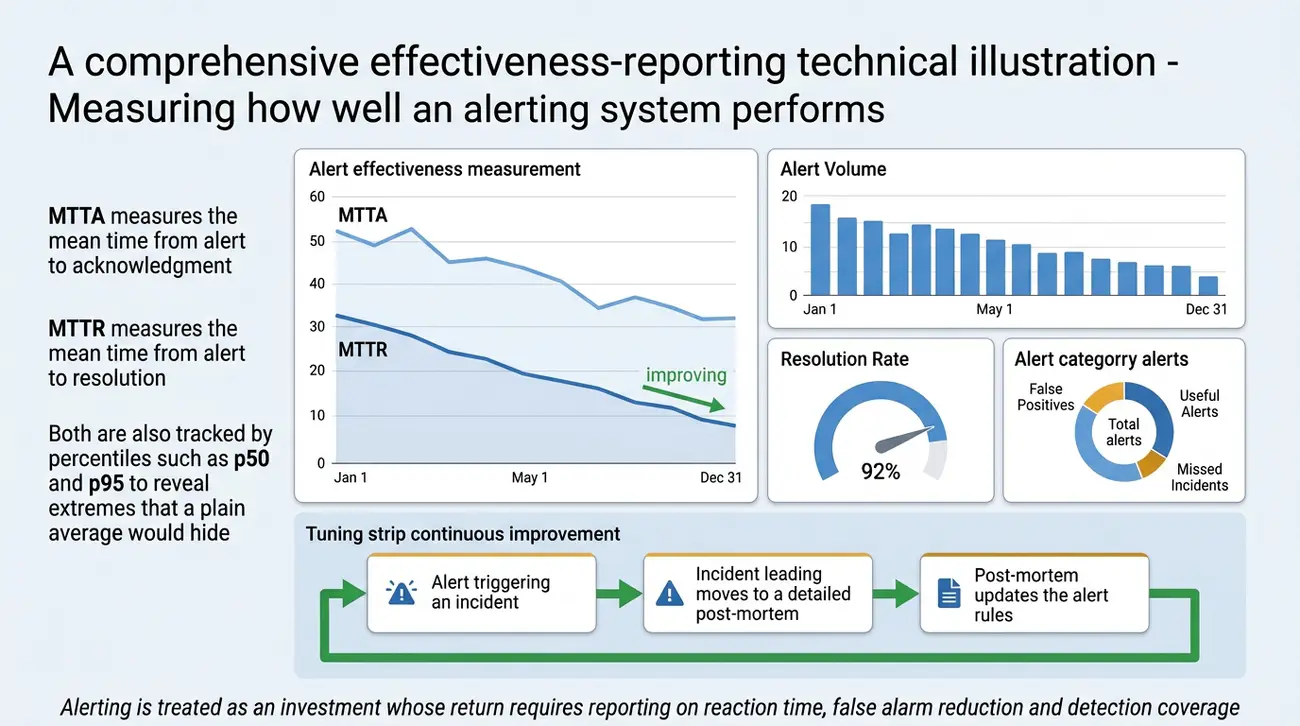
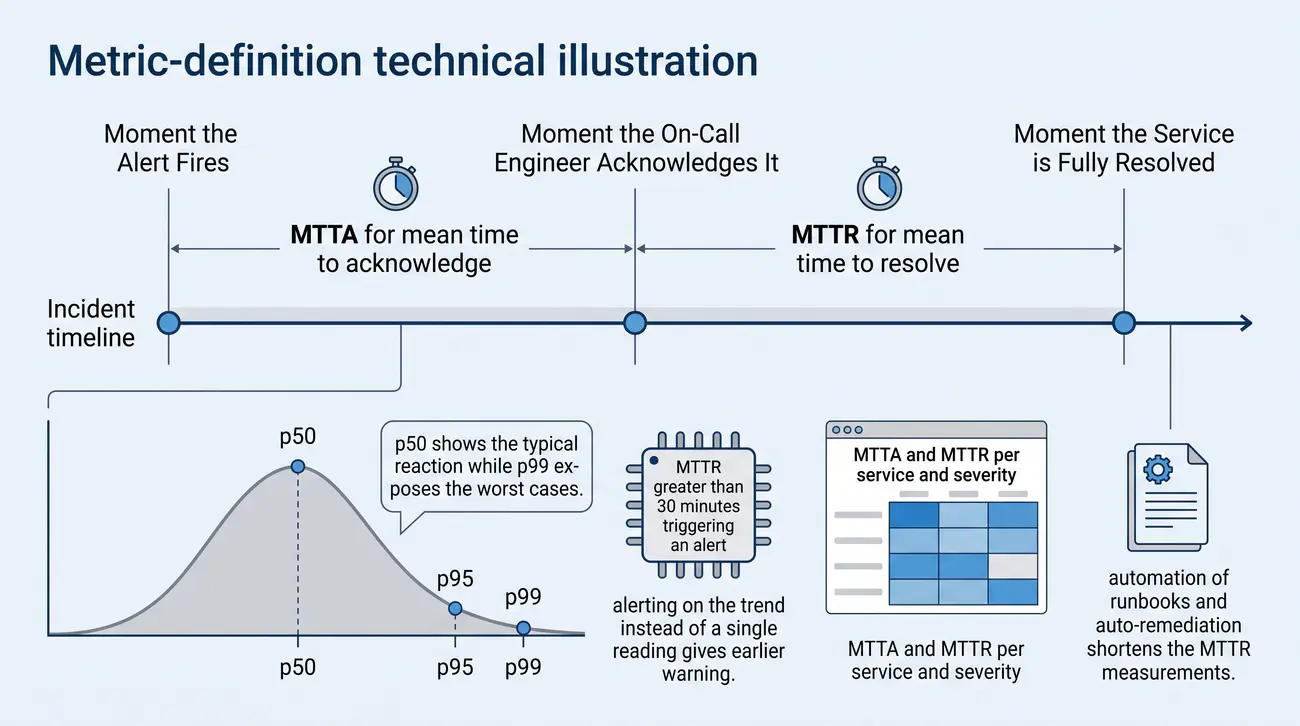
Dlaczego alertowanie: MTTA (Mean Time To Acknowledge) i MTTR (Mean Time To Resolve) to kluczowe metryki. Proaktywne wykrywanie problemów ZANIM użytkownik zgłosi = fundament niezawodności.

Po co budzić ludzi w nocy? Żeby MTTA i MTTR były małe, a koszt awarii niski. Klucz: wykryć przed użytkownikiem.

  • Czas reakcji MTTA – wskaźnik mierzy czas od wystąpienia usterki do momentu oficjalnego potwierdzenia przyjęcia zgłoszenia przez inżyniera.
  • Czas naprawy MTTR – określa całkowity czas potrzebny zespołowi na skuteczne usunięcie awarii i pełne przywrócenie działania platformy.
  • Wskaźniki wiodące – sygnały takie jak szybki spadek wolnego miejsca na dysku pozwalają interweniować zanim dojdzie do przerwania usług.
  • Wskaźniki opóźnione – parametry takie jak wskaźnik niedostępności serwisu dokumentują skalę awarii i służą do rozliczania umów biznesowych.
  • Koszt opóźnień – każda minuta zwłoki w podjęciu reakcji na incydent krytyczny zwiększa straty finansowe firmy oraz obniża zaufanie klientów.
MTTA i MTTR: Średni czas do potwierdzenia alertu i do rozwiązania incydentu; proaktywne wykrycie przed zgłoszeniem użytkownika to fundament niezawodności.
dlaczego alerting

Alertowanie jest fundamentem SRE: szybka reakcja operatora (MTTA - Mean Time To Acknowledge), skrócenie czasu reakcji (MTTR - Mean Time To Resolve), minimalizacja wpływu na użytkowników (downtime cost) i proaktywne wykrywanie (leading indicators vs lagging) to fundament inżynierii niezawodności - "You can't fix what you don't know about".

Reakcja operatora: MTTA (Mean Time To Acknowledge) = czas od wystąpienia alertu do ACK przez on-call. Cel: < 5 min dla SEV-1. Skrócenie czasu reakcji: MTTR (Mean Time To Resolve) = czas od alertu do rozwiązania. Proaktywne alerting = wykrywanie problemów ZANIM użytkownik zgłosi. To fundament inżynierii niezawodności.

Terminologia: alerting (alertowanie), notification (powiadomienie), MTTA (średni czas do potwierdzenia), MTTR (średni czas do naprawy), downtime cost (koszt przestoju), leading/lagging indicators (wskaźniki wiodące/opóźnione).

Pierwszy slajd poświęciliśmy narzędziom i architekturze, ale prawdziwe pytanie brzmi: po co w ogóle alertować? Odpowiedź kryje się w dwóch wskaźnikach - MTTA, czyli średni czas od wystąpienia alertu do jego potwierdzenia przez operatora, oraz MTTR, czyli czas od wykrycia do rozwiązania incydentu. Im niższe obie wartości, tym mniejszy wpływ awarii na użytkowników i niższy koszt przestoju.

Kluczem do niskiego MTTA jest proaktywne wykrywanie problemów, zanim zgłoszą je użytkownicy - operator powinien wiedzieć o degradacji, zanim poczuje ją końcowy odbiorca. Do tego służą wskaźniki wiodące, takie jak nasycenie zasobów czy tempo wzrostu błędów, które wyprzedzają skutki widoczne w metrykach opóźnionych jak dostępność. Poznamy cele czasowe dla różnych poziomów ważności i zrozumiemy, dlaczego regularny przegląd alertów jest tak samo istotny jak ich tworzenie.

Wyjaśnienie skrótów użytych na slajdzie:
MTTA – Mean Time To Acknowledge – średni czas potwierdzenia przyjęcia alertu; Metryka operacyjna mierząca czas od wysłania powiadomienia do jego potwierdzenia przez inżyniera.
MTTR – Mean Time To Recover – średni czas naprawy; Kluczowy wskaźnik sprawności zespołu SRE mierzony od wystąpienia usterki do przywrócenia normalnego działania usługi.
MTTD – Mean Time To Detect – średni czas wykrycia problemu; Czas potrzebny systemowi monitoringu na zarejestrowanie anomalii i wygenerowanie alertu.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; Prawny kontrakt biznesowy, którego kary finansowe są unikane dzięki szybkiej reakcji na alerty.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Praktyka inżynierska dążąca do minimalizacji czasu interwencji człowieka w rutynowe awarie.

3/55 Rodzaje powiadomień
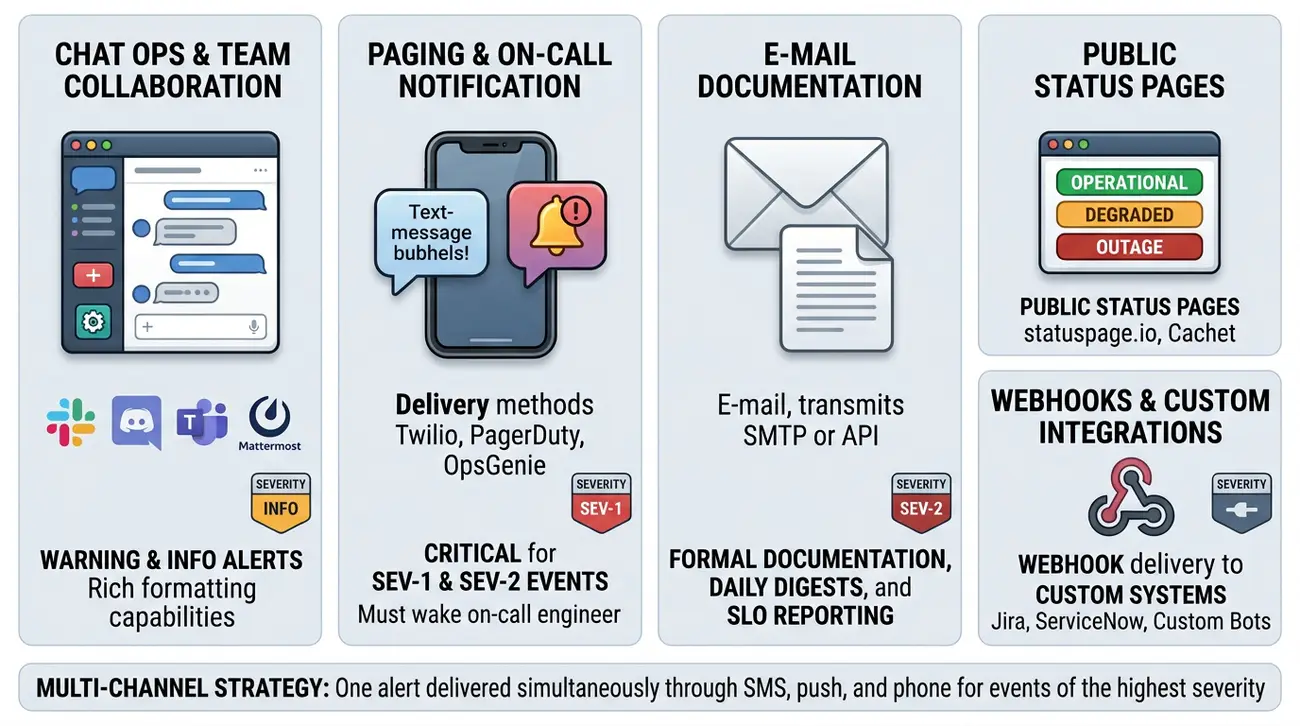
Rodzaje powiadomień: Wybór kanału zależy od severity alertu i czasu reakcji. Multi-channel strategy zapewnia redundancję - nie zależy od pojedynczego punktu awarii.

Kanał dobierasz do wagi: czat do gadania, SMS do budzenia, mail do papierów. Im wyżej, tym więcej kanałów naraz.

  • Komunikatory zespołowe – wiadomości na kanałach Slack lub Teams sprawdzają się przy ostrzeżeniach informacyjnych o niskim priorytecie.
  • Aplikacje dyżurne – dedykowane platformy potrafią ominąć nocne wyciszenie telefonu inżyniera, gwarantując skuteczne obudzenie w awarii.
  • Poczta elektroniczna – powiadomienia e-mail służą do przesyłania zbiorczych raportów i nie sprawdzają się przy natychmiastowym reagowaniu na awarie infrastruktury.
  • Strony statusowe – publiczne portale informują klientów i partnerów biznesowych o trwających pracach oraz przewidywanym czasie naprawy.
  • Uniwersalne webhooki – elastyczne punkty końcowe pozwalają na automatyczną integrację powiadomień z wewnętrznymi systemami zgłoszeń.
Multi-channel strategy: Strategia wielu kanałów z redundancją - dobór kanału do wagi alertu i czasu reakcji, bez pojedynczego punktu awarii.
kanały

Dobre praktyki pełnienia dyżurów i higieny alertowej opisano w rozdziale Google SRE: Being On-Call.

Rodzaje powiadomień (notification channels) w nowoczesnych systemach alertingu różnią się dostępnością i czasem dostarczenia, a wybór kanału zależy od severity alertu, czasu reakcji i preferencji zespołu on-call: komunikatory czatu (Slack, Discord, Microsoft Teams, Mattermost) są idealne dla warning/info z rich formattingiem, SMS/push notifications (Twilio, PagerDuty, OpsGenie) - krytyczne dla SEV-1/2 wymagających natychmiastowej reakcji, e-mail (SMTP, API) - do dokumentacji i mniej pilnych alertów, strony statusowe (statuspage.io, Cachet) - komunikacja z klientami/biznesem, a webhook - integracja z niestandardowymi systemami (Jira, ServiceNow, custom bots). Terminologia: channels, pager, push, webhook, status page.

Czat (Slack, Discord, MS Teams, Mattermost): rich formatting (blocks, markdown, buttons), threading, searchable history, @mentions. Idealne dla: daily operations, team awareness, collaboration podczas incydentu. Slack Block Kit / Discord embeds = interactive alerts (buttons: Acknowledge, Silence, Runbook).

SMS / Push (Twilio, PagerDuty, OpsGenie, VictorOps): guaranteed delivery, works bez internetu na telefonie, escalation policies. Krytyczne dla SEV-1/2 (wake up on-call). Multi-channel: SMS + push + phone call = redundancy.

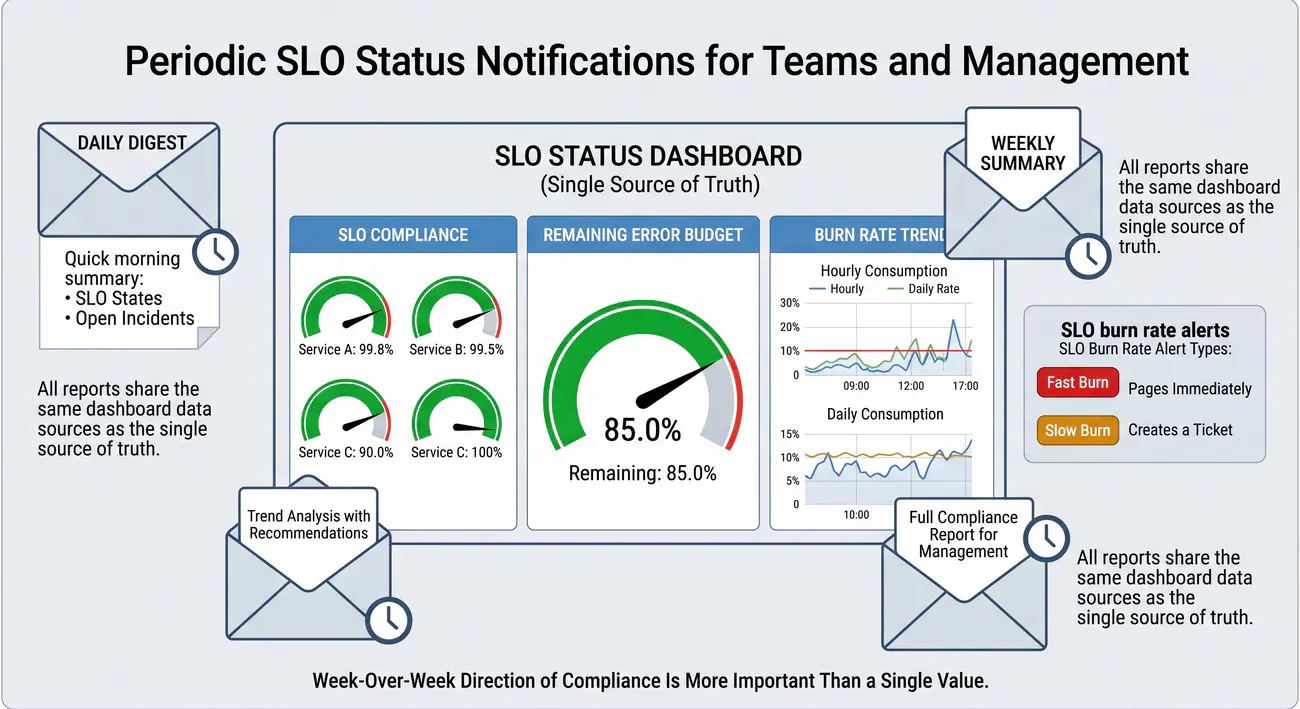
E-mail (SMTP, SendGrid, Mailgun, API): formalne dokumentowanie, audyt, compliance. HTML templates z runbook links, dashboard screenshots. Mniej pilne: daily digests, SLO reports, info alerts.

Podsumowanie: Multi-channel strategy = SEV-1: SMS+Push+Phone+Slack; SEV-2: Push+Slack+Email; SEV-3: Slack+Email; Info: Email only. Redundancja kanałów = nie zależy od pojedynczego punktu awarii. Terminologia: channels, pager, push, webhook, status page, escalation policy.

Wskaźniki MTTA i MTTR mierzą skuteczność reakcji, ale nie mówią, jak dotrzeć do osoby, która powinna zareagować. Wybór kanału powiadomienia nie jest kwestią gustu lecz inżynierii niezawodności - kanał musi pasować do wagi alertu, czasu reakcji i kontekstu operacyjnego. Subiektywne odczucie, że ktoś to zobaczy, zastępujemy multi-channel strategy z redundancją kanałów.

Każdy kanał ma swoje miejsce w hierarchii: komunikatory czatu jak Slack czy Teams sprawdzają się przy alertach informacyjnych, gdzie liczy się możliwość dyskusji. Dla SEV-1 i SEV-2 potrzebujemy SMS i push notifications przez PagerDuty lub OpsGenie, które docierają nawet bez internetu. E-maile służą do dokumentacji, strony statusowe komunikują z klientami, a webhooki integrują alerting z systemami jak Jira. Im wyższa waga alertu, tym więcej kanałów używamy jednocześnie.

Wyjaśnienie skrótów użytych na slajdzie:
Page – Urgent Pager Notification – powiadomienie natychmiastowe; Pilny alarm wzywający inżyniera dyżurnego do natychmiastowej interwencji niezależnie od pory dnia.
Ticket – Issue Tracker Ticket – zgłoszenie w systemie zadań; Zadanie operacyjne rejestrowane w kolejce (np. Jira), wymagające obsługi w normalnych godzinach pracy.
Log – Informational Log Record – wpis w rejestrze zdarzeń; Zdarzenie informacyjne rejestrowane w celach audytowych i statystycznych bez alarmowania ludzi.
P1 – Priority 1 / Critical Incident – incydent o priorytecie krytycznym; Awaria o najwyższej dotkliwości biznesowej skutkująca natychmiastowym wyzwoleniem procedury Page.
P2 – Priority 2 / Major Incident – incydent o priorytecie wysokim; Poważna degradacja części funkcjonalności wymagająca szybkiej interwencji zespołu w godzinach dziennych.

4/55 Cechy alertu
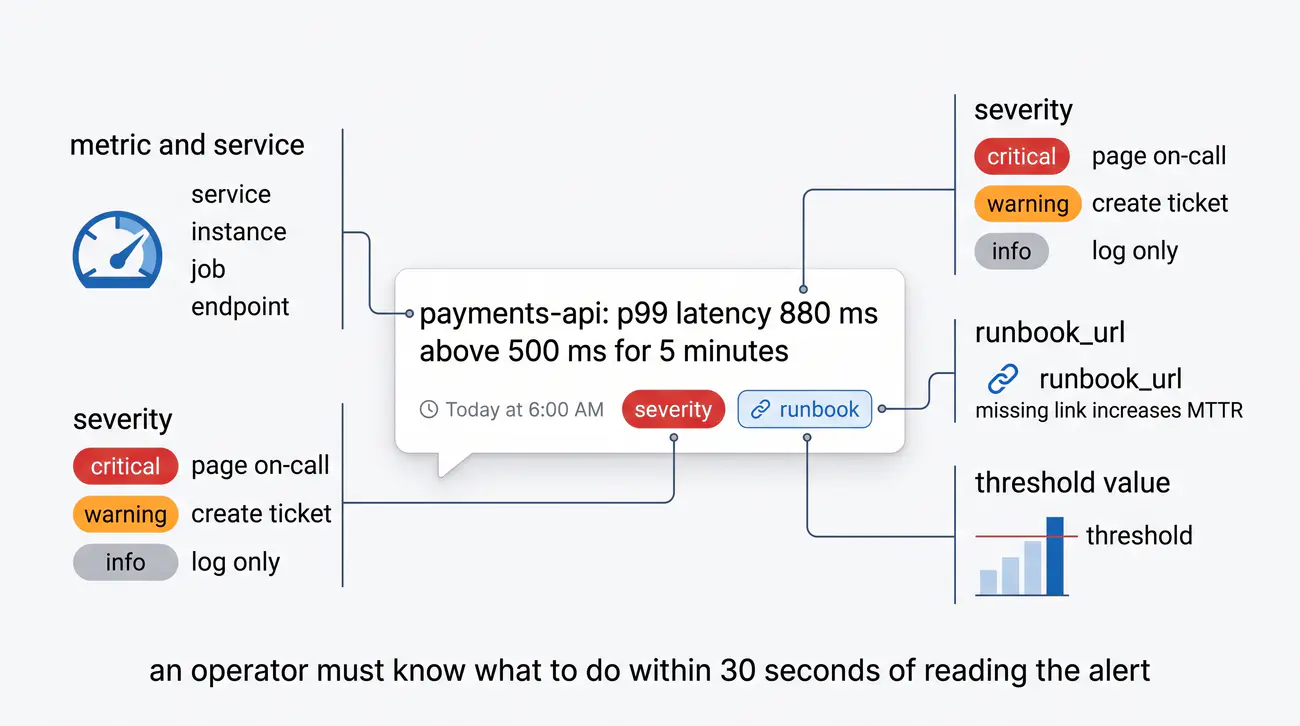
Cechy alertu: Actionable alert = operator wie co zrobić w 30 sekund. Każdy alert musi mieć: jednoznaczną treść, wskazanie usługi/metryki, severity, runbook_url.

Dobry alert odpowiada w 30 sekund: co, gdzie, jak bardzo i co robić. Bez tego to szum.

  • Wykonalność akcji – dobrze skonstruowany alert zawiera jasne wskazówki, dzięki czemu inżynier w ciągu pół minuty wie, jakie kroki należy podjąć.
  • Precyzyjny kontekst – powiadomienie powinno precyzyjnie wskazywać nazwę usługi, instancję serwera, zmierzoną wartość oraz przekroczony próg.
  • Poziom ważności – właściwy priorytet decyduje o tym, czy zdarzenie ma wywołać natychmiastowy alarm telefoniczny, czy rutynowe zadanie.
  • Odnośnik do procedury – obecność linku do aktualnego runbooka chroni dyżurnego przed chaotycznym zgadywaniem poleceń pod presją stresu.
  • Wartość i limit – zestawienie bieżącej wartości metryki z dopuszczalnym progiem pozwala inżynierowi natychmiast ocenić dynamikę anomalii.
Actionable alert: Alert, po którym operator wie co robić w 30 sekund; wymaga treści, usługi/metryki, severity i runbook_url.
cechy alertu

Zasada Actionability oznacza, że każdy alert krytyczny musi prowadzić do jednoznacznej procedury naprawczej opisanej w runbooku.

Dobry, actionable alert ma jednoznaczną treść (co się dzieje, gdzie, jak poważne), wskazanie usługi i metryki, ustalony poziom ważności (critical/warning/info) i runbook_url do procedury naprawy - actionable alert to taki, przy którym operator wie, co zrobić w 30 sekund. Terminologia: actionable alert, runbook, severity, runbook_url.

Jednoznaczna treść: alert musi zawierać co (metric name), gdzie (service, instance), jak bardzo (wartość, threshold), dlaczego (możliwa przyczyna). Brak dwuznaczności = brak odpowiedzialności.

Wskazanie usługi i metryki: alert musi zawierać labeli service, instance, job, endpoint. Bez kontekstu = niemożliwa diagnoza.

Poziom ważności: critical (page immediately), warning (ticket w godzinach pracy), info (log only). Severity = routing rule + SLA response time.

Runbook URL: każdy alert critical/warning musi mieć link do runbooka. Brak runbook = operator zgaduje = dłuższy MTTR. Actionable alert = operator wie co zrobić w 30 sekund.

Mając za sobą kanały komunikacji, skupmy się na treści alertu - nawet najlepiej dostarczony alarm jest bezwartościowy, jeśli nie niesie zrozumiałej informacji. Alert musi być actionable: operator odczytawszy go powinien wiedzieć, co zrobić w trzydzieści sekund, bez szukania kontekstu. To brzmi ambitnie, ale sprowadza się do czterech elementów tworzących strukturę dobrze skonstruowanego alertu.

Pierwszy to jednoznaczna treść: co się dzieje, na jakiej instancji, jak poważne i jaka przyczyna. Drugi to wskazanie usługi i metryki etykietami service, instance, job - bez tego diagnostyka jest niemożliwa. Trzeci to severity, determinujący kanał dostarczenia i czas reakcji. Czwarty to runbook URL, link do procedury naprawczej - jego brak oznacza dłuższy MTTR, bo operator zgaduje zamiast działać według sprawdzonego schematu.

Wyjaśnienie skrótów użytych na slajdzie:
Actionable – Actionable Alert Quality – wykonalność alertu; Podstawowa zasada SRE: alert jest uzasadniony tylko wtedy, gdy odbiorca ma możliwość wykonania konkretnej akcji naprawczej.
Runbook – Operational Runbook – instrukcja operacyjna procedur; Dokument techniczny krok po kroku opisujący diagnozę i procedurę naprawczą dla danego alertu.
SOP – Standard Operating Procedure – standardowa procedura operacyjna; Formalny zbiór zasad postępowania organizacji w trakcie obsługi zdarzeń kryzysowych.
RCA – Root Cause Analysis – analiza przyczyn źródłowych; Proces dochodzeniowy prowadzony po opanowaniu sytuacji alarmowej w celu trwałej eliminacji usterki.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Kultura inżynierska eliminująca bezużyteczne powiadomienia niewymagające interwencji człowieka.

5/55 Jak nie alarmować
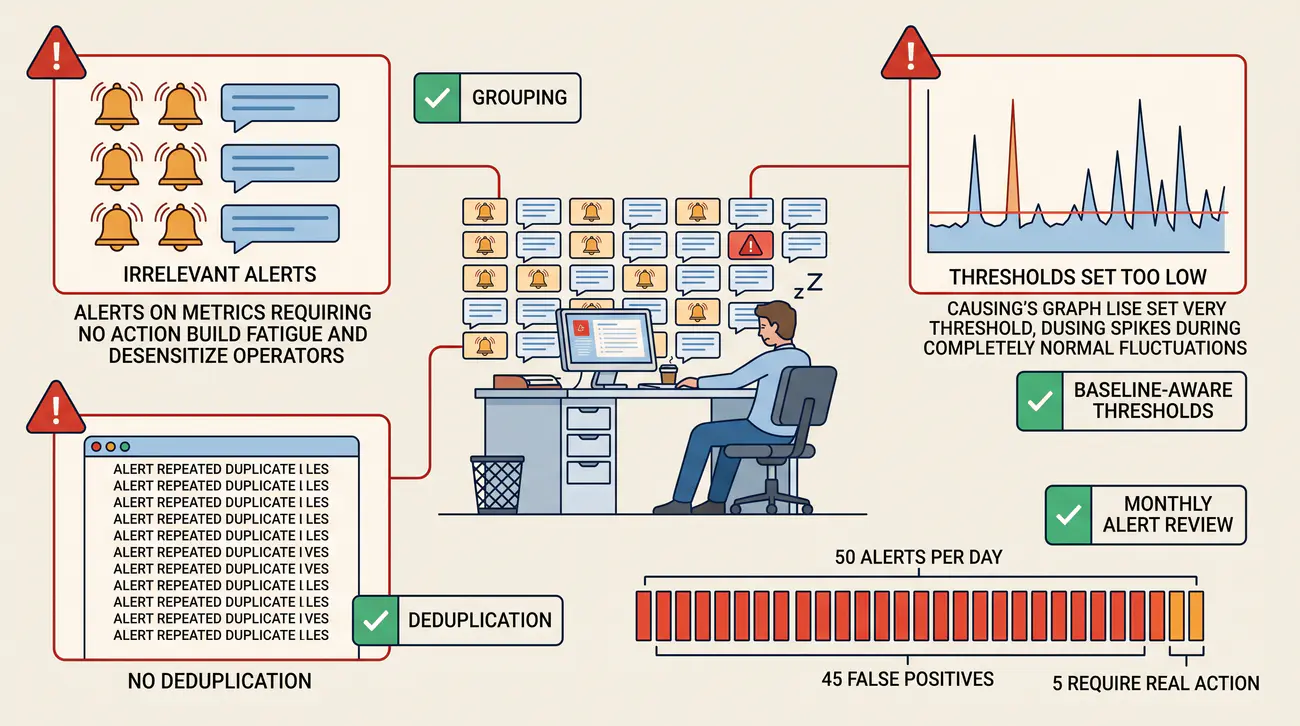
Jak nie alarmować: Alert fatigue = operatorzy ignorują alerty = prawdziwe incydenty giną w szumie. Kluczowa zasada: tylko actionable alerts z deduplikacją i regularnym review.

Słaby alert kosztuje więcej niż żaden: zgadywanie, brak eskalacji i szum. Trzy grzechy i recepty.

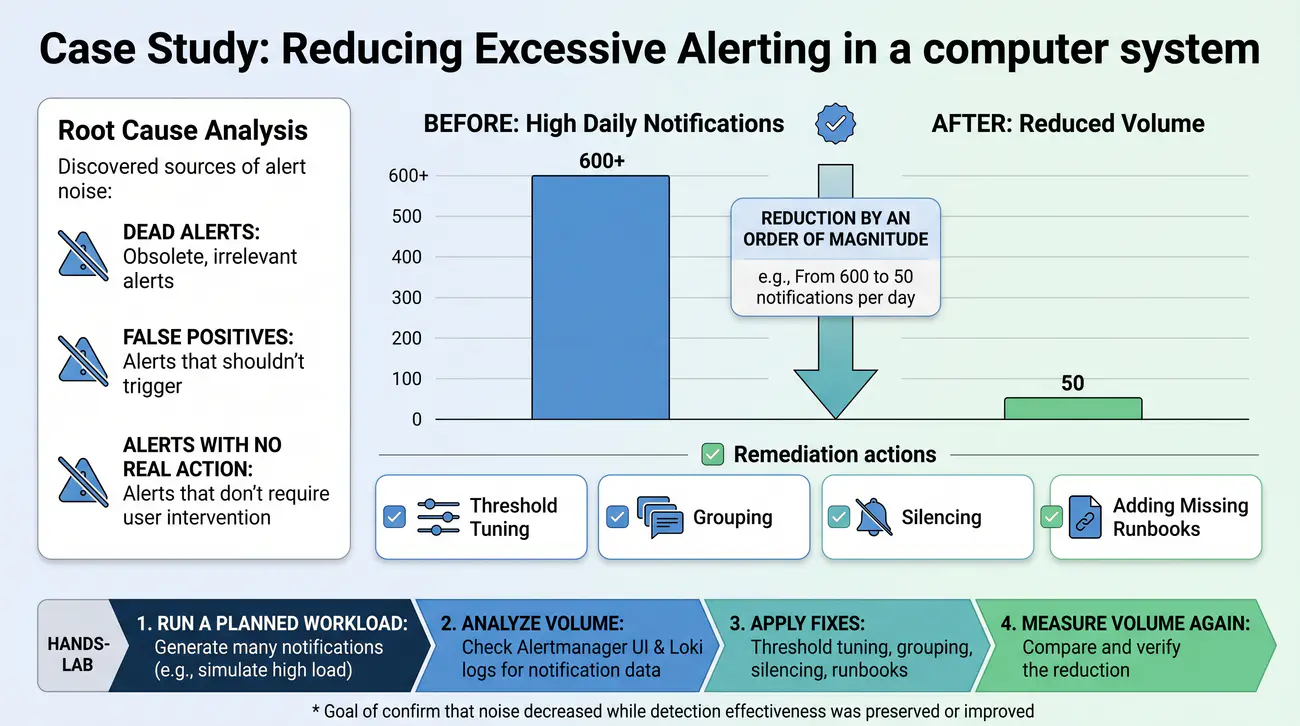
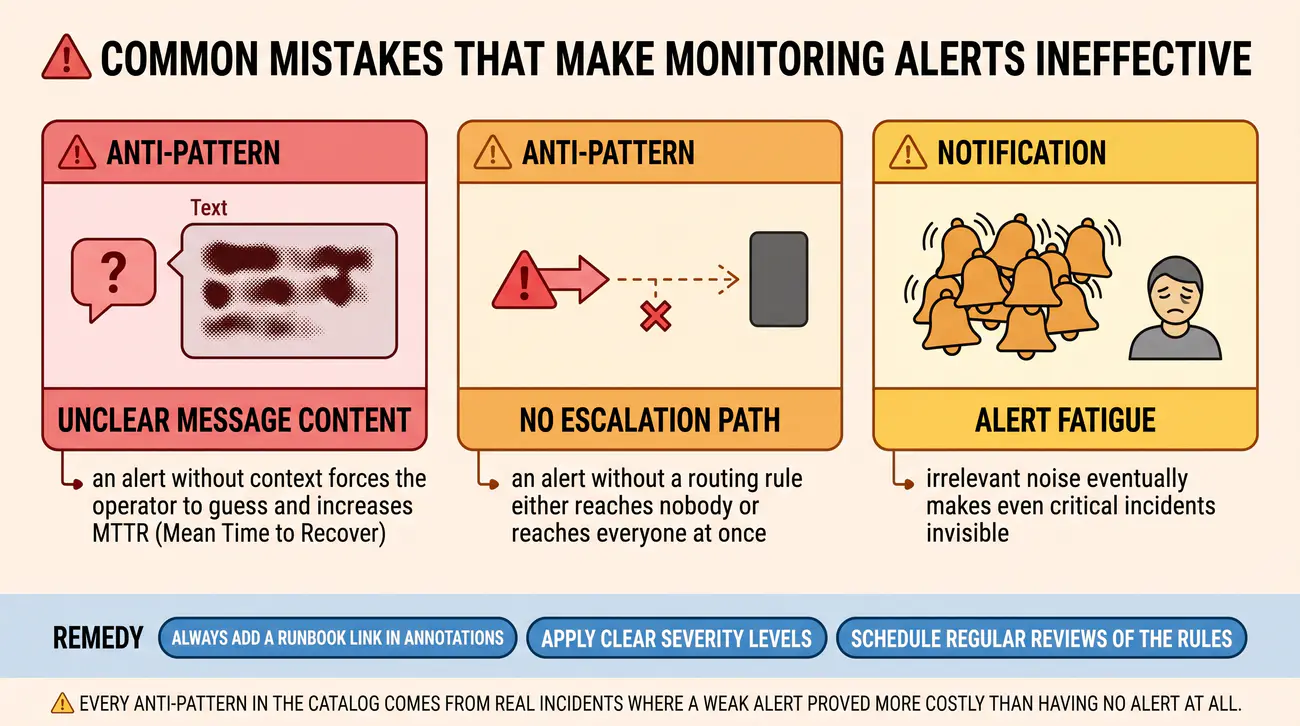
  • Zmęczenie alertami – zjawisko pojawia się w zespole, gdy inżynierowie są nieustannie zalewani setkami fałszywych lub nic nieznaczących powiadomień.
  • Ignorowanie sygnałów – znieczulenie przeciążonych dyżurnych na powiadomienia nieuchronnie prowadzi do przeoczenia faktycznego, groźnego incydentu.
  • Rozmyta odpowiedzialność – wysyłanie alertu do wszystkich pracowników naraz bez wskazania konkretnego adresata paraliżuje proces decyzyjny.
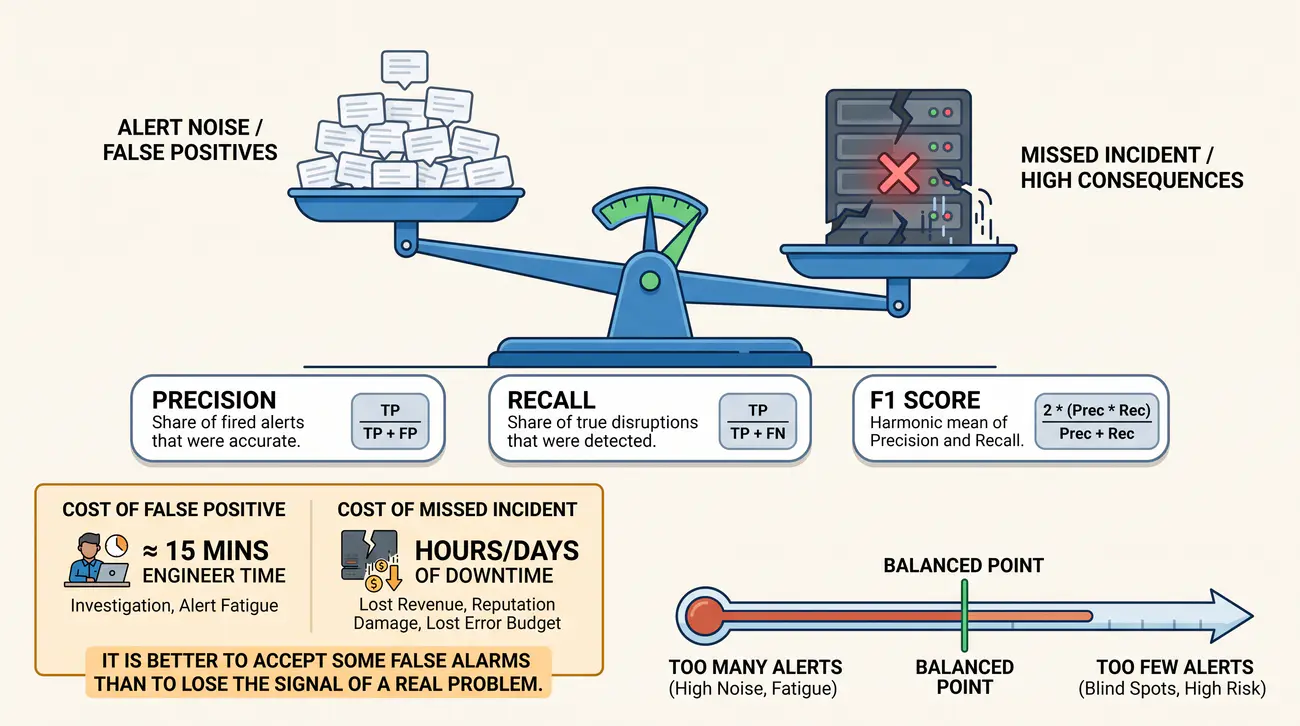
  • Zbyt wąskie marginesy – konfiguracja progów bez zapasu bezpieczeństwa powoduje lawinę fałszywych alarmów przy chwilowych pikach obciążenia.
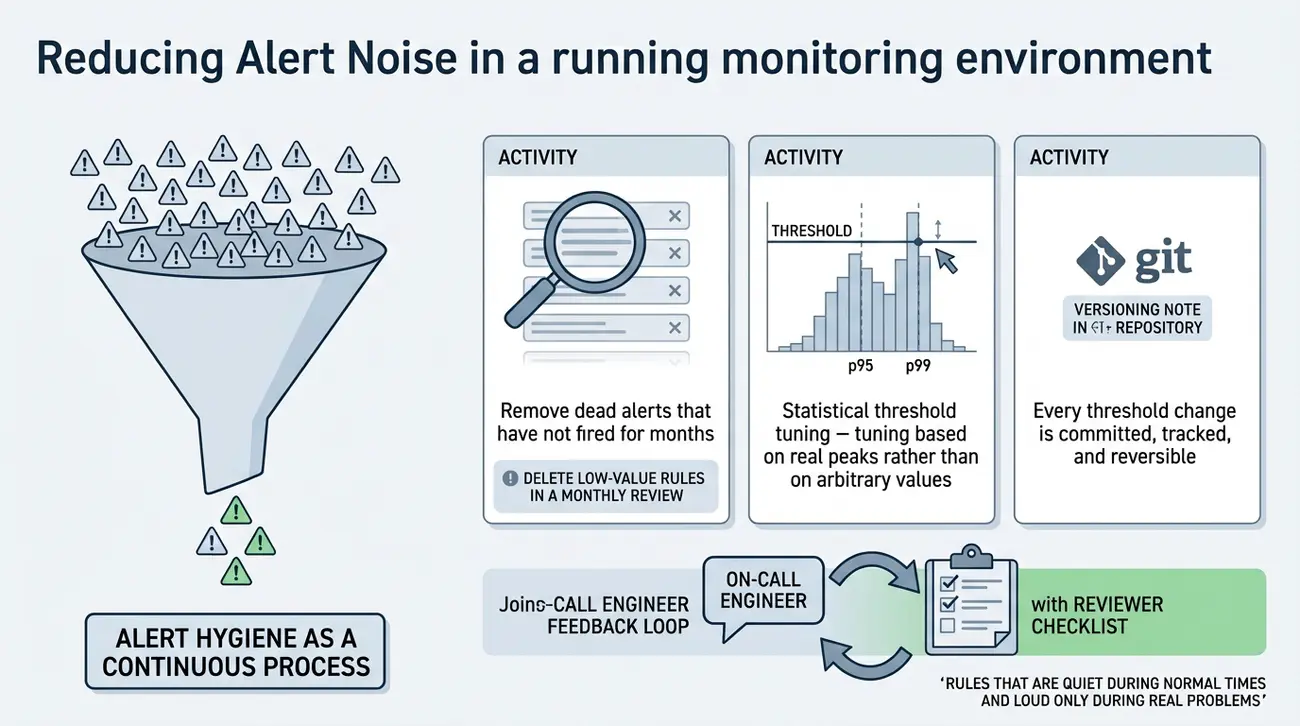
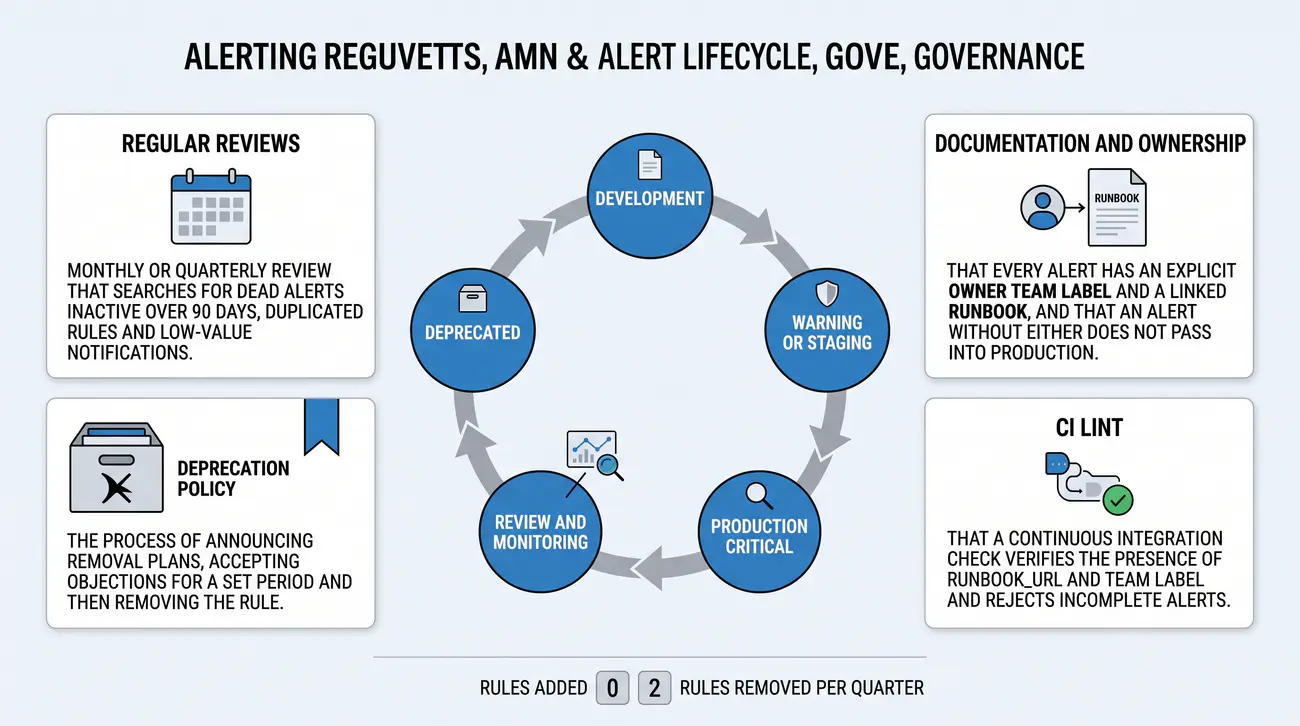
  • Higiena monitoringu – inżynierowie SRE muszą cyklicznie przeglądać działające reguły i bezwzględnie usuwać te generujące zbędny szum informacyjny.
Alert fatigue: Zmęczenie operatorów nadmiarem (głównie fałszywych) alertów prowadzące do ignorowania także prawdziwych incydentów; lekarstwo to deduplikacja i przeglądy.
szum alertów

Zjawisko zmęczenia alertami (Alert Fatigue) jest główną przyczyną przeoczenia rzeczywistych katastrof produkcyjnych. Wywoływane jest przez:
- Flapping: gwałtowne oscylowanie metryki wokół progu alarmowego generujące dziesiątki powiadomień w kilka minut (rozwiązaniem jest parametr for w regule oraz histereza progów),
- Szum informacyjny: wysyłanie ostrzeżeń o braku zagrożenia dla użytkownika (np. chwilowy skok CPU do 95% przy prawidłowym czasie odpowiedzi HTTP),
- Brak deduplikacji: otrzymywanie setek powiadomień o awarii każdego kontenera z osobna zamiast jednego zbiorczego alertu o awarii węzła.

Antywzorce alertowania to alerty nieistotne (noise), zbyt niskie progi (alert fatigue), brak deduplikacji i brak runbooków - alert fatigue sprawia, że operatorzy ignorują alerty, a prawdziwe incydenty przepadają. Terminologia: alert fatigue, noise, false positive, alert hygiene.

Alerty nieistotne: alerty na metrykach, które nie wymagają interwencji (np. CPU > 80% na deweloperskim serwerze). Każdy taki alert buduje "alert fatigue" - operatorzy zaczynają ignorować WSZYSTKIE alerty.

Zbyt niskie progi: ustawienie thresholdów tak nisko, że alerty wyzwalają się przy normalnych wahaniach. Rozwiązanie: baseline-aware thresholds (dynamic thresholds), seasonality-aware thresholds.

Efekt zmęczenia (alert fatigue): operatorzy zaczynają ignorować WSZYSTKIE alerty, bo większość to fałszywe alarmy. Rozwiązanie: deduplication, grouping, tylko actionable alerts, regularny alert review (monthly). Alert fatigue = operatorzy ignorują alerty = prawdziwe incydenty giną w szumie.

Terminologia: alert fatigue (zmęczenie alertami), noise (szum), false positive (fałszywy alarm), alert hygiene (higiena alertowania).

Cechy dobrego alertu to pozytywna strona medalu - równie ważna jest świadomość tego, jak alertów nie robić. Najgroźniejszym zjawiskiem jest alert fatigue, czyli zmęczenie operatorów nadmiarą powiadomień, z których większość nie wymaga interwencji. Gdy na dyżurnego spada pięćdziesiąt alertów dziennie, z czego czterdzieści pięć to fałszywe alarmy, zaczyna on automatycznie ignorować wszystkie, łącznie z tymi sygnalizującymi prawdziwą awarię.

Alert fatigue rodzi się z trzech antywzorców: nieistotne alerty na metrykach nie wymagających interwencji, zbyt niskie progi wyzwalające przy normalnych wahaniach oraz brak deduplikacji, przez który ten sam problem generuje dziesiątki powiadomień. Rozwiązaniem jest comiesięczny przegląd alertów, w którym zespół analizuje, które alarmy prowadziły do akcji, a które można wyeliminować. Terminologia: alert fatigue, noise, false positive, alert hygiene.

Wyjaśnienie skrótów użytych na slajdzie:
Flapping – Alert Flapping condition – migotanie alertu; Zjawisko szybkiego przełączania się stanu alertu między firing a resolved wywołane oscylacją metryki wokół progu.
Noise – Alert Noise in monitoring – szum alarmowy; Masa nieistotnych lub fałszywych powiadomień utrudniających inżynierom zauważenie realnego zagrożenia.
Fatigue – Alert Fatigue condition – zmęczenie alertami; Stan psychofizycznego przeciążenia zespołu prowadzący do ignorowania przychodzących wezwań alarmowych.
Alertstorm – Alert Storm Phenomenon – burza alertów; Lawinowe zalanie kanałów komunikacyjnych tysiącami powiadomień w trakcie pojedynczej awarii węzła nadrzędnego.
OOM – Out of Memory – wyczerpanie pamięci operacyjnej; Awaria procesu w wyniku braku pamięci RAM, która powinna być sygnalizowana pojedynczym alertem o węźle.

6/55 Eskalacja problemów
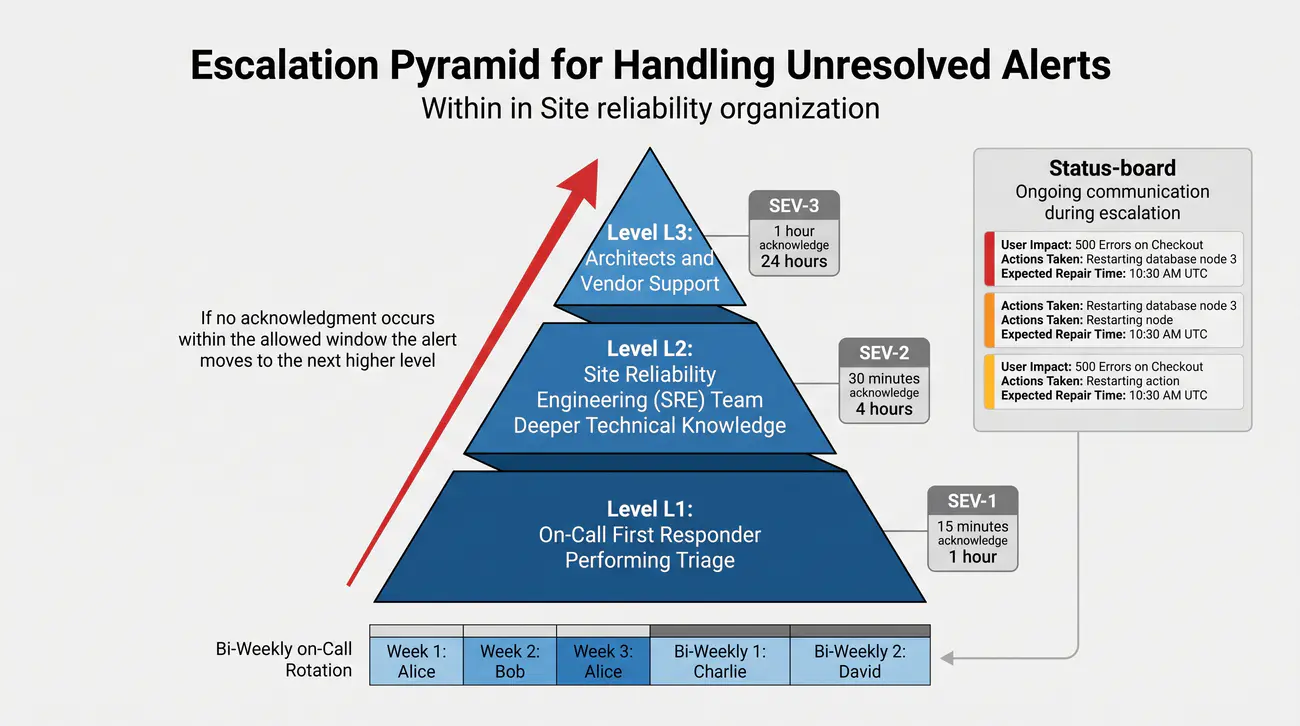
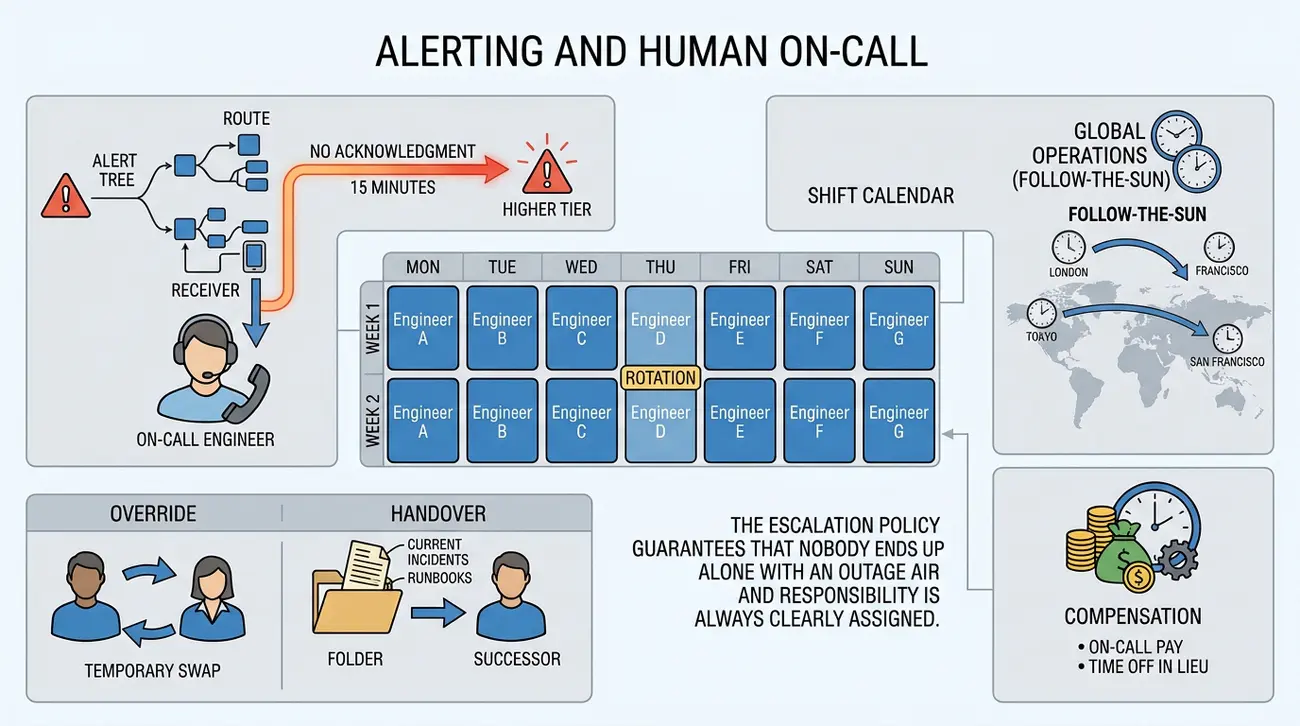
Eskalacja problemów: Polityka eskalacji definiuje poziomy reakcji (L1→L2→L3) i SLA czasowe. Automatyczna eskalacja czasowa (time-based) zapewnia, że alert nie zostanie pominięty.

Alert musi trafić do właściwej osoby na czas. Eskalacja L1→L2→L3 z zegarem to formalna siatka bezpieczeństwa.

  • Polityka eskalacji – precyzyjnie definiuje kolejne szczeble wsparcia technicznego oraz maksymalny czas oczekiwania na podjęcie reakcji.
  • Automatyczny transfer – brak potwierdzenia zgłoszenia w wyznaczonym oknie czasowym przekazuje alarm bezpośrednio do inżyniera wyższego rzędu.
  • Incydenty krytyczne – awarie o najwyższym priorytecie wymagają reakcji w kilkanaście minut i skoordynowanych działań całego zespołu technicznego.
  • Grafiki dyżurów – przejrzyste harmonogramy gwarantują, że inżynierowie pełnią wartę wymiennie, zachowując wypoczęty umysł i skupienie.
  • Komunikacja z kadrą – regularne raportowanie statusu prac zarządowi buduje zaufanie i uwalnia inżynierów od natrętnych pytań w trakcie kryzysu.
Time-based escalation: Automatyczna eskalacja czasowa (L1→L2→L3 ze SLA) gwarantująca, że żaden alert nie zostanie pominięty.
piramida eskalacji

Polityka eskalacji definiuje poziomy (L1/L2/L3), severity (SEV-1 critical business impact, SEV-2 major degradation, SEV-3 minor issue, SEV-4 low priority), SLA czasowe (SEV-1: 15 min response, 1h resolve; SEV-2: 30 min response, 4h resolve), automatyczną eskalację (time-based: brak ack w 15 min → eskalacja) i on-call rotation (weekly, follow-the-sun). Terminologia: escalation policy, severity levels, on-call rotation, SLA, time-based escalation.

Poziomy eskalacji: L1 (on-call, first responder, triage), L2 (SRE/DevOps, deep technical knowledge), L3 (architects, vendor support, management). SEV-1 = customer-facing outage, SEV-2 = major degradation, SEV-3 = minor issue, SEV-4 = cosmetic. Time-based escalation = jeśli no ack w 15 min → auto-escalate do L2.

SLA czasowe: SEV-1 (ack 15min, resolve 1h), SEV-2 (ack 30min, resolve 4h), SEV-3 (ack 1h, resolve 24h). Escalation policy = documented, tested, updated quarterly. On-call rotation = weekly/bi-weekly, follow-the-sun dla globalnych teamów.

Terminologia: escalation policy (polityka eskalacji), severity levels (poziomy ważności), on-call rotation (dyżurność), SLA (service level agreement), time-based escalation (eskalacja czasowa).

Nawet najlepiej zaprojektowany system nic nie pomoże, jeśli alert nie trafi do osoby zdolnej go rozwiązać. Polityka eskalacji definiuje, kto reaguje na dany poziom ważności i jak szybko musi to zrobić - to formalny schemat eliminujący improwizację i zapewniający, że żaden krytyczny alert nie zostanie pominięty z powodu niejasnej struktury odpowiedzialności.

Każdy poziom eskalacji ma przypisane role i czasy reakcji: L1 to pierwszy responder dokonujący triage, L2 to zespół SRE z głębszą wiedzą, L3 to architekci i dostawcy zewnętrzni. Dla SEV-1 czas na potwierdzenie wynosi piętnaście minut, a na rozwiązanie godzinę; SEV-2 daje trzydzieści minut i cztery godziny. Automatyczna eskalacja czasowa przesuwa alert wyżej przy braku potwierdzenia, a rotacja dyżurów zapewnia świeże siły.

Wyjaśnienie skrótów użytych na slajdzie:
L1 – First-Line Support – pierwsza linia wsparcia technicznego; Zespół operacyjny przyjmujący zgłoszenia i weryfikujący stan usług na podstawie standardowych instrukcji.
L2 – Second-Line Engineering Support – druga linia wsparcia inżynierskiego; Specjaliści systemowi rozwiązujący skomplikowane problemy techniczne wykraczające poza procedury L1.
L3 – Third-Line Core Engineering – trzecia linia wsparcia programistycznego; Główni architekci i autorzy oprogramowania angażowani w przypadkach krytycznych błędów w kodzie źródłowym.
On-call – On-call Engineer – inżynier pełniący dyżur alarmowy; Wyznaczony członek zespołu SRE posiadający uprawnienia i sprzęt do natychmiastowej reakcji na incydent.
EscalationPolicy – Escalation Policy in Incident Management – polityka eskalacji zgłoszeń; Automatyczny algorytm przekazujący wezwanie do kolejnego inżyniera lub menedżera w przypadku braku potwierdzenia w zadanym czasie.

7/55 Alertmanager (wprowadzenie)
Alertmanager (wprowadzenie): Centralny komponent zarządzania alertami w ekosystemie Prometheus. Odbiera alerty, deduplikuje, grupuje, routuje, inhibuje i dostarcza do receiverów.

Alertmanager to serce: bierze surowe alerty z Prometheusa i robi z nich porządek - pięć operacji.

  • Odbiór sygnałów – Alertmanager przyjmuje surowe powiadomienia z Prometheusa i poddaje je inteligentnej obróbce przed wysyłką do ludzi.
  • Deduplikacja zdarzeń – scala identyczne sygnały spływające z redundantnych serwerów monitoringu w pojedynczy, spójny komunikat.
  • Grupowanie zgłoszeń – łączy dziesiątki pokrewnych awarii w jeden czytelny raport, radykalnie redukując chaos w kanale komunikacyjnym.
  • Drzewo routingu – elastyczna hierarchia reguł kieruje powiadomienia do właściwych zespołów deweloperskich na podstawie etykiet metadanych.
  • Protokół plotkujący – instancje klastra Alertmanagera wymieniają informacje o wyciszeniach bez konieczności utrzymywania centralnej bazy danych.
Alertmanager: Centralny komponent Prometheusa; odbiera, deduplikuje, grupuje, routuje, inhibuje i dostarcza alerty do receiverów.
rola Alertmanager
Rola Alertmanagera w ekosystemie: Sam serwer Prometheus potrafi jedynie obliczać reguły (np. „jeśli odsetek błędów > 1% przez 5 minut, wyemituj alert”). Nie wie jednak, jak wysłać SMS, jak scalić 50 takich alertów w jeden, ani do kogo zadzwonić. Tę rolę przejmuje Alertmanager: odbiera strumień sygnałów, grupuje je, tłumi powiadomienia potomne (np. w sytuacji awarii całej szafy serwerowej) i kieruje do właściwego odbiorcy (Slack, PagerDuty).

Alertmanager to centralny "mózg" alertingu w ekosystemie Prometheus: Prometheus OCENIA metryki (w alerting rules - zmienia metrykę w stan "alertu"), a Alertmanager odpowiada za całą resztę cyklu życia powiadomienia - deduplikację, grupowanie, routowanie, inhibicję i wyciszanie. Pipeline: Metrics → PromQL → Alert Rule → Alertmanager → Receiver → On-call - każdy komponent odpowiada za jedno zadanie, a Alertmanager podejmuje decyzje biznesowe: KOGO powiadomić, Jak połączyć alerty i CO wstrzymać.

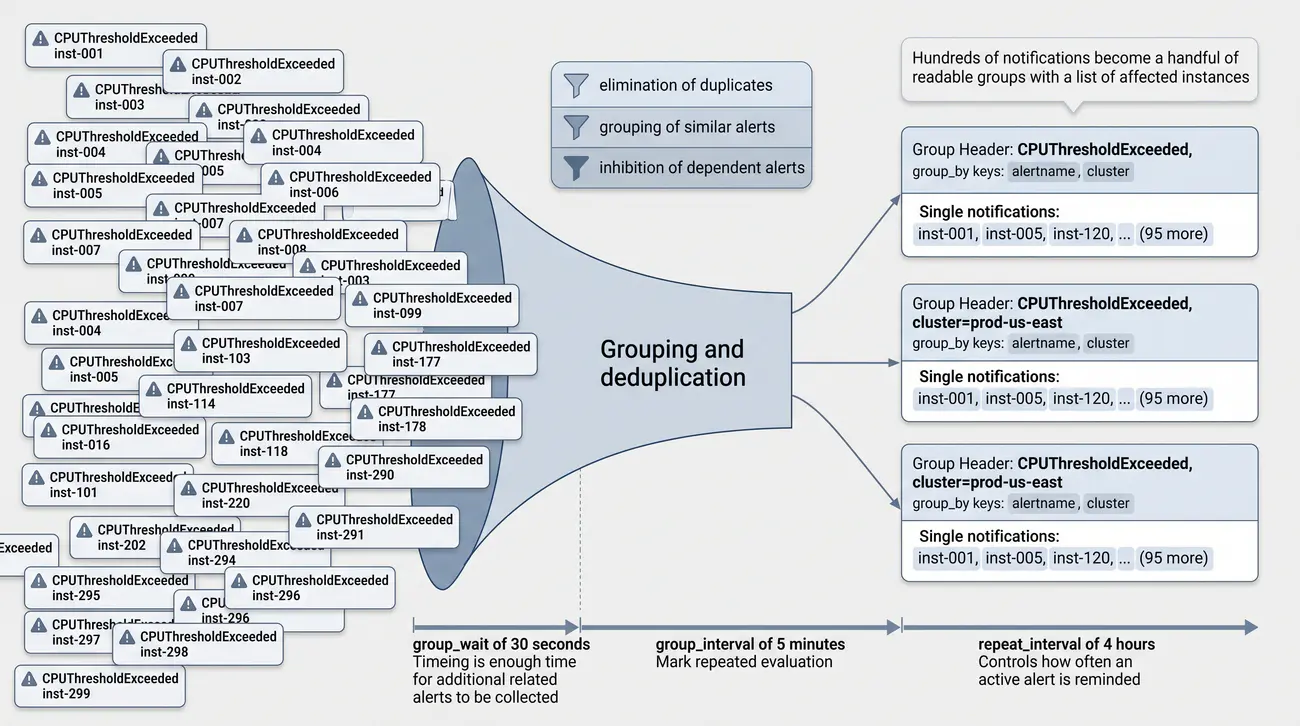
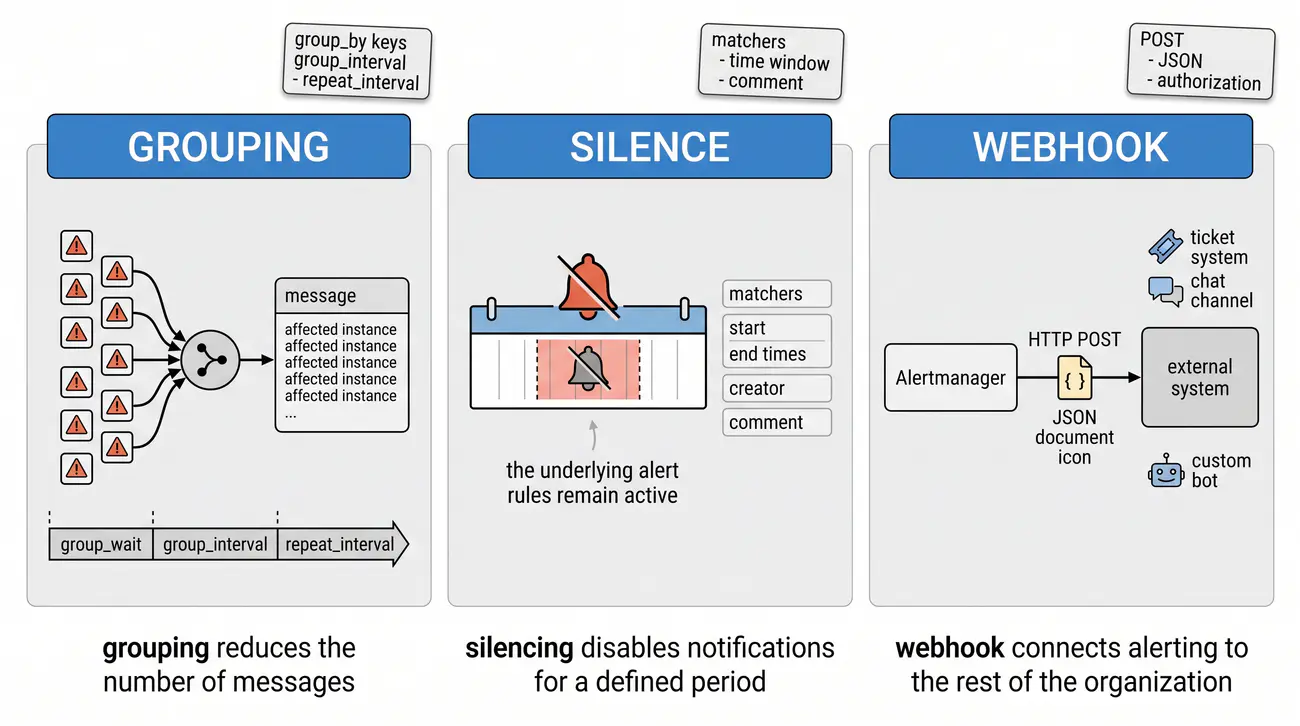
Deduplikacja i grupowanie (deduplication + grouping): to pierwsza linia obrony przed alert fatigue. Grupowanie scala alerty o wspólnych kluczach zdefiniowanych przez group_by (np. group_by: [alertname, cluster]) w JEDNĄ wiadomość - zamiast 50 oddzielnych powiadomień o 50 instancjach dostajesz jedno powiadomienie o grupie, zawierające listę dotkniętych elementów. Kluczowe parametry czasowe: group_wait: 30s - czas oczekiwania na "dociągnięcie" kolejnych alertów do grupy (kompromis między szybkością reakcji a kompletnością), group_interval: 5m - interwał ponownej oceny grupy (ile czasu między kolejnymi wysyłkami zmian w tej samej grupie), repeat_interval: 4h - jak często POWTARZAMY powiadomienie o wciąż aktywnym alercie (żeby nie milczeć godzinami, ale też nie spamować). Deduplikacja działa na poziomie notification log: jeśli dwa Prometheuse (w konfiguracji HA) wyślą ten sam alert, Alertmanager wysyła powiadomienie tylko RAZ.

Routowanie (routing): definiowane przez tzw. route tree (drzewo tras). Root route jest "catch-all" - przyjmuje WSZYSTKIE alerty i działa jak domyślna droga powiadomienia (receiver + grupowanie). Child routes to reguły dopasowujące alerty po etykietach (matchers, np. severity="critical", team="payments", service=~"web.*") i przekierowujące do specyficznych odbiorców lub zmieniające grupowanie. Przykład decyzji: severity=critical i team=payments → PagerDuty + Slack #on-call z telefonem; severity=warning → tylko Slack #alerts w godzinach pracy. Uwaga praktyczna: drzewo zbudowane niedbale powoduje, że alert "ginie" (nic nie przychodzi) albo "budzi wszystkich" (alert idzie do wszystkich receiverów naraz). Znane jest porównanie do routera sieciowego - alertmanager dopasowuje "najbardziej pasującą" trasę i tylko tam wysyła.

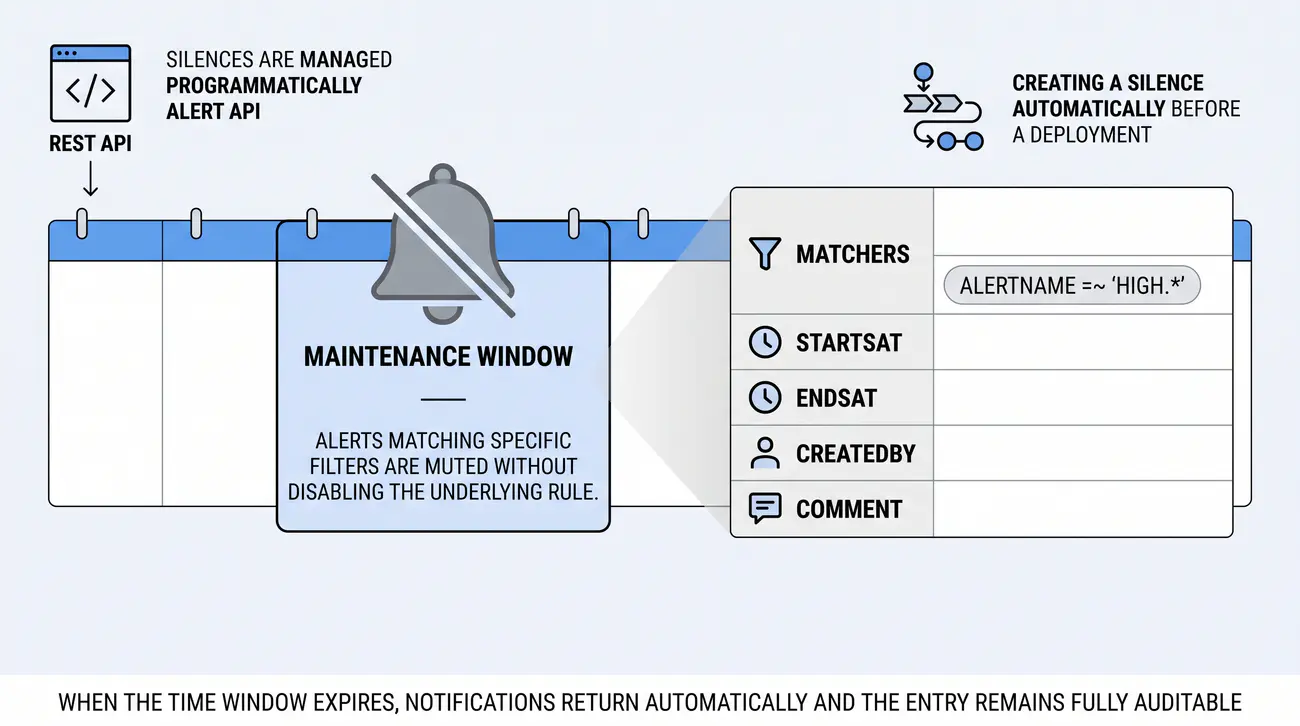
Inhibicja i wyciszanie (inhibition + silencing): inhibit_rules implementuje zasadę "tłumij objaw, jeśli znasz przyczynę" - np. source_match: service="db-critical", target_match: severity="warning", equal: [instance, service]: dopóki ten konkretny serwis jest w stanie krytycznym, wszystkie alerty warning powiązane z tym samym serwisem/instancją są MILCZĄCE. To eliminuje związaną lawinę (db down → wszystkie app errors). Silences (wyciszenia) to operacyjne narzędzie człowieka: wyciszenie alertów dopasowanych matcherami (np. alertname="HighCpuLoad", cluster="dev") na zdefiniowany czas - standardowe podczas maintenance windows i planowanych wdrożeń. Tworzone ręcznie w UI lub automatycznie przez REST API (np. z pipeline'u CI/CD przed deployem).

Wysoka dostępność (HA): Alertmanager w produkcji powinien działać jako klaster ≥2 instancji, które komunikują się protokołem gossip (biblioteka hashicorp/memberlist, port 9094 TCP/UDP). Instancje replikują między sobą stan: silences, notification log i informacje o członkach klastra - dzięki temu nawet gdy jedna instancja pada, powiadomienia są nadal wysyłane, a deduplikacja działa globalnie (dzięki pozycjonowaniu węzłów i dziennikowi powiadomień). Ważna zasada: Prometheus powinien wysyłać alerty do WSZYSTKICH instancji klastra, a nie przez load balancer. Terminologia do zapamiętania: Alertmanager, deduplication (deduplikacja), grouping (grupowanie), routing (routowanie), inhibition (inhibicja), silence (wyciszenie), notification log, gossip protocol, HA cluster.

Po omówieniu zasad i procesów przyszedł czas na Alertmanager, serce ekosystemu alertowego w Prometheusie. Podczas gdy Prometheus ocenia metryki i podejmuje decyzję, czy warunek wymaga uwagi, Alertmanager przejmuje resztę cyklu życia alertu - od otrzymania go z Prometheusa po dostarczenie powiadomienia do odbiorcy. To deklaratywny komponent w YAML realizujący pięć kluczowych operacji.

Pierwsza to deduplikacja eliminująca powiadomieniowy spam: ten sam alert z dwóch instancji Prometheusa jest wysyłany tylko raz. Druga to grupowanie przez group_by, scalające alerty o wspólnych kluczach w jeden komunikat. Trzecia to routowanie przez drzewo tras, w którym severity i team decydują o odbiorcy. Czwarta to inhibicja, tłumiąca niższe severity przy aktywnym alercie krytycznym. Piąta to wyciszanie na czas okien serwisowych, tworzone ręcznie w UI lub przez API.

Wyjaśnienie skrótów użytych na slajdzie:
CNCF – Cloud Native Computing Foundation – Fundacja Oprogramowania Chmurowego; Środowisko projektowe nadzorujące rozwój serwera Prometheus i komponentu Alertmanager.
AM – Alertmanager – menedżer alertów Prometheus; Niezależna usługa odpowiedzialna za przyjmowanie, przetwarzanie i rozsyłanie sygnałów alarmowych.
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji; Protokół, przez który serwery Prometheus przesyłają aktywne alerty do interfejsu API Alertmanagera.
API – Application Programming Interface – interfejs programowania aplikacji; Programowy punkt dostępowy Alertmanagera obsługujący żądania wyciszeń i inspekcji stanu.
YAML – YAML Ain't Markup Language – format serializacji YAML; Format plikowy służący do definiowania drzewa routingu, odbiorców i reguł powiadomień.

8/55 Reguły alertów w Prometheus
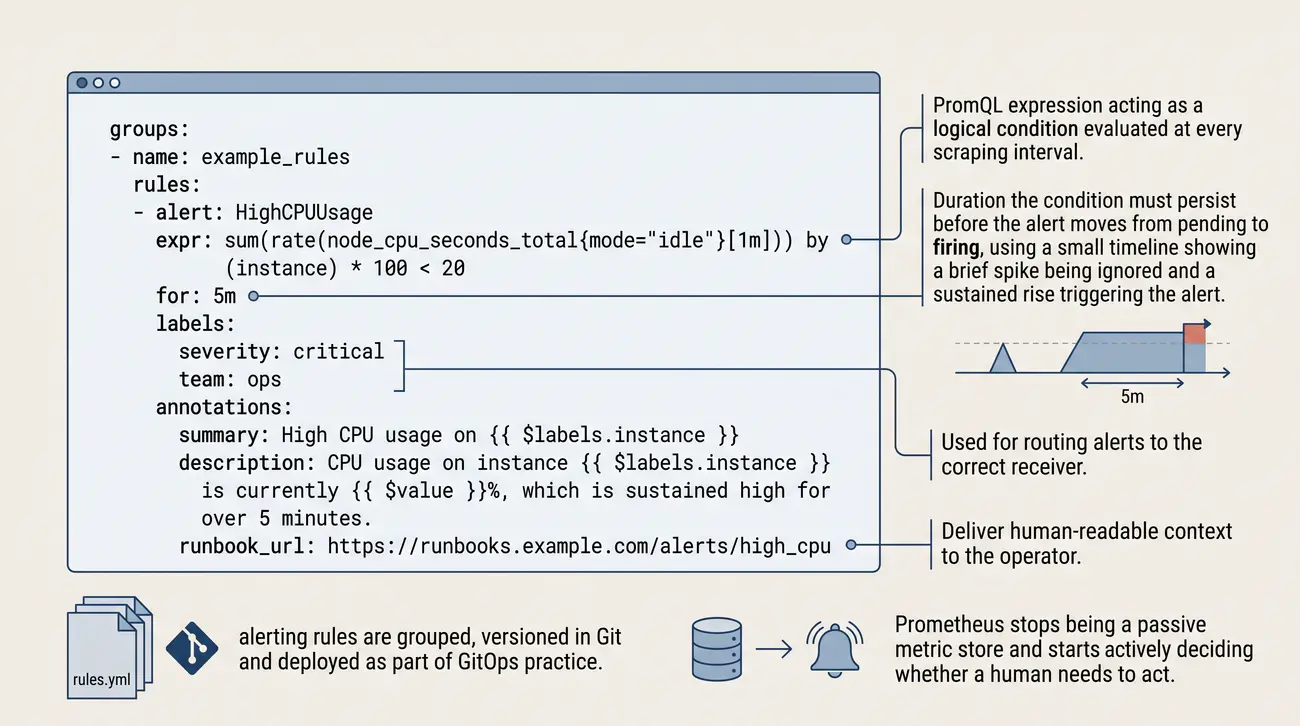
Reguły alertów w Prometheus: Alerting rules definiują warunek (expr PromQL), czas trwania (for), etykiety (labels) i adnotacje (annotations: summary, description, runbook_url). Config w formacie YAML.

Reguła to YAML z czterema polami: warunek, zwłoka, etykiety i adnotacje. Wersjonujesz w Git jak kod.

  • Pliki definicji – reguły alarmowe zapisywane są w formacie YAML z wykorzystaniem precyzyjnych wyrażeń matematycznych w języku PromQL.
  • Klauzula for – określa minimalny czas trwania anomalii przed wyzwoleniem alarmu, filtrując sekundowe, nieszkodliwe wahania w sieci.
  • Zarządzanie etykietami – metadane dołączane do reguły decydują o priorytecie zdarzenia i trasie powiadomienia w konfiguracji Alertmanagera.
  • Adnotacje opisowe – sekcja służy do umieszczania czytelnych dla dyżurnego opisów problemu oraz bezpośrednich odnośników do procedur naprawy.
  • Kontrola wersji – wszystkie pliki reguł powinny być wersjonowane w repozytorium kodu i automatycznie weryfikowane pod kątem składni.
Alerting rules: Reguły w YAML - warunek expr (PromQL), czas for, etykiety labels i adnotacje (summary, description, runbook_url).
plik reguł

Reguły alertowe definiuje się w plikach YAML zgodnie z dokumentacją Prometheus Alerting Rules:

- alert: HighErrorRate
  expr: sum(rate(http_requests_total{status=~"5.."}[5m])) / sum(rate(http_requests_total[5m])) > 0.05
  for: 2m
  labels:
    severity: page
    team: sre
  annotations:
    summary: "Wysoka stopa błędów HTTP 5xx w usłudze {{ $labels.job }}"
    description: "Odsetek błędów wynosi {{ $value | humanizePercentage }} (przekroczono próg 5%)."
    runbook_url: "https://wiki.firma.pl/sre/runbooks/high-error-rate.html"

Klucz for: 2m zapobiega fałszywym alarmom przy krótkotrwałych pikach, a pole runbook_url dostarcza inżynierowi gotową instrukcję naprawczą.

Powstawanie alertu w Prometheusie zaczyna się w alerting rules (regułach alertowych) - to moment, w którym Prometheus przestaje być tylko magazynem metryk, a podejmuje decyzję "czy sytuacja wymaga uwagi człowieka". Reguły definiuje się deklaratywnie w YAML, w blokach groups, najczęściej w plikach z rozszerzeniem .rules.yml (osobno od prometheus.yml, ładowane przez rule_files), a każda reguła składa się z czterech elementów: wyrażenia (expr), czasu trwania (for), etykiet (labels) i adnotacji (annotations). Wersjonowanie reguł w Git (GitOps) to standard - każdą zmianę progu można prześledzić i wycofać.

Wyrażenie PromQL (expr): warunek logiczny oparty na metrykach, który oceniany jest co evaluation interval (zwykle 10-15 s). Przykład: avg(rate(node_cpu_seconds_total{mode="idle"}[5m])) < 0.1 - alert, gdy średni udział czasu procesora na biegu jałowym spada poniżej 10%. Zwróć uwagę na kompozycję: rate() zamienia licznik (counter) na tempo zmian [5m], a avg() uśrednia po wszystkich instancjach - na wyjściu dostajemy jeden wektor chwilowy (instant vector) porównywany z progiem. W ekspresji odwołujemy się do threshold - wartości granicznej. Ważne: wyrażenie musi zwracać wektor z elementami > 0, gdy warunek NIE jest spełniony - element obecny = alert aktywny, brak elementu = alert resolved.

Czas trwania (for): to zapora przed flappingiem i chwilowymi pikami. Parametr for: 5m oznacza "warunek musi się utrzymywać przez co najmniej 5 minut, zanim alert przejdzie w stan firing". Do tego czasu alert jest w stanie pending (oczekujący). Dzięki temu 10-sekundowy skok CPU od deployu NIE postawi Cię na nogi w środku nocy, a 10-minutowe przeciekanie pamięci już tak. Dobór wartości for powinien wynikać z natury zjawiska: dla wypaleń dysku 1m, dla wahań ruchu popołudniowych 10-15m. Zasada: for filtrujące szumy do maksimum, ale nie opóźniające REALNEGO incydentu.

Etykiety i adnotacje (labels + annotations): labels (severity, team, service, env) to dane do routingu - na ich podstawie Alertmanager podejmuje decyzję, do kogo i jak pilnie wysłać powiadomienie. Annotations (summary, description, runbook_url) to dane dla dyżurnego - kontekst, który operator widzi w wiadomości: krótkie podsumowanie, szczegółowy opis, link do procedury. Przykład adnotacji z użyciem szablonu: summary: "High CPU on {{ $labels.instance }}" - template skopiuje nazwę instancji zbieraną z metryki, co sprawia, że ta sama reguła generuje unikalne, zrozumiałe alarmy dla każdej instancji osobno. Zasada: labels mają służyć routingu (trzymaj ich kardynalność pod kontrolą!), annotations mają służyć diagnozie.

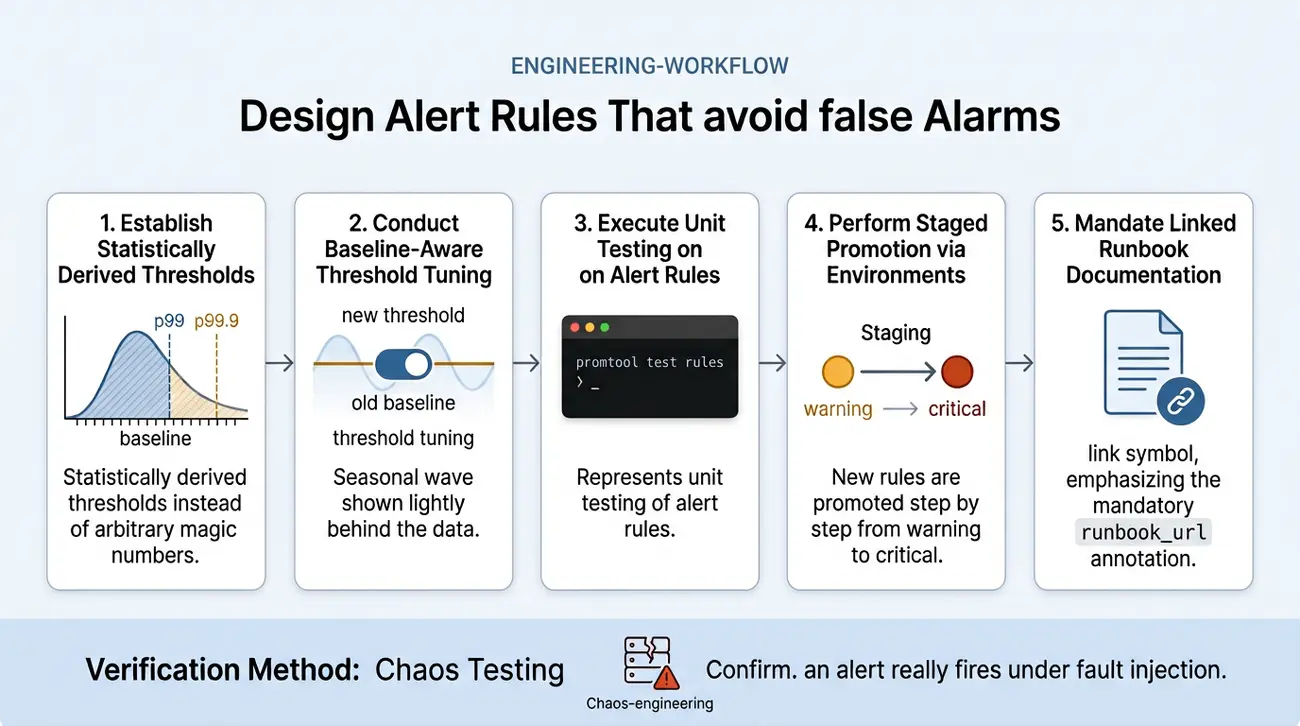
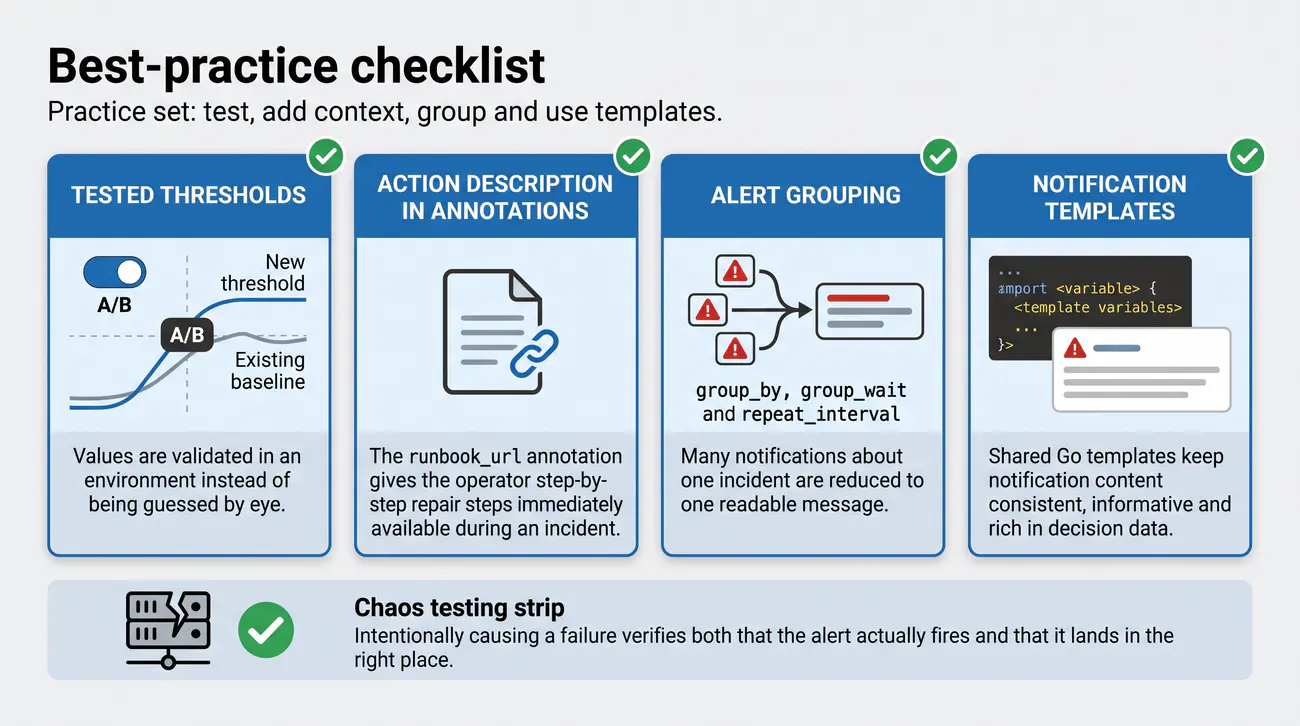
Dobre reguły = dobry alerting: dobierz progi na podstawie danych historycznych (percentyle, baseline), nie "na oko"; testuj reguły narzędziem promtool (promtool test rules) - pozwala zasymulować wejście i zweryfikować, czy alert faktycznie wyzwoli się przy zadanych danych; dzieląc kryteria na kolejne alerty (bardzo wysoki próg → critical, umiarkowany → warning) budujesz ścieżkę stagingową. Terminologia: alerting rule (reguła alertowa), expr (wyrażenie PromQL), threshold (próg), for (czas trwania), pending→firing (oczekujący→aktywny), labels (etykiety), annotations (adnotacje), summary, description, runbook_url, groups, rule_files.

Przeszliśmy od zasad alertowania przez Alertmanager do konstrukcji reguł, a teraz skupmy się na ich formalnej definicji w YAML. Alerting rules to moment, w którym Prometheus przestaje być magazynem metryk, a zaczyna aktywnie oceniać, czy sytuacja wymaga interwencji człowieka - to przejście od pasywnej obserwacji do proaktywnego reagowania, leżące u podstaw całej filozofii SRE.

Każda reguła składa się z czterech elementów: wyrażenia PromQL, parametru for, etykiet do routingu i adnotacji dla operatora. Wyrażenie to warunek logiczny oceniany co kilkanaście sekund. For pełni rolę zapory przed flappingiem - pięciominutowe utrzymywanie progu eliminuje chwilowe skoki. Etykiety severity czy team kierują alert do odbiorcy, a adnotacje summary, description i runbook_url dostarczają kontekst diagnostyczny. Reguły pakowane w grupy, ładowane z rules.yml i wersjonowane w Git jako element GitOps.

Wyjaśnienie skrótów użytych na slajdzie:
PromQL – Prometheus Query Language – język zapytań Prometheus; Język formułowania wyrażeń warunkowych ewaluowanych w poszukiwaniu anomalii.
YAML – YAML Ain't Markup Language – format plikowy YAML; Struktura zapisu reguł w plikach weryfikowanych narzędziem promtool przed wdrożeniem.
for – for duration clause – klauzula czasu trwania anomalii; Dyrektywa wymagająca, aby warunek błędu utrzymywał się przez określony czas przed wyzwoleniem alertu.
expr – expression directive – dyrektywa wyrażenia analitycznego; Kluczowe pole reguły zawierające zapytanie PromQL zwracające szeregi czasowe przekraczające limit.
labels – Alert Labels Metadata – etykiety metadanych alertu; Pary klucz-wartość (np. severity, team) decydujące o dalszej ścieżce trasowania w Alertmanagerze.

9/55 Przykładowa reguła alertu
Przykładowa reguła alertu: Pełny przykład YAML z polem alert (nazwa), expr (PromQL), for (czas trwania), annotations (summary, description, runbook_url) i labels (severity, team).

Przykład HighCpuLoad: średnie idle poniżej 10% przez 5 minut. Każde pole ma powód - sprawdź przed kopiowaniem.

  • Cykl życia alertu – w systemie Prometheus każdy alert przechodzi przez trzy kolejne fazy: nieaktywny, oczekujący oraz aktywny.
  • Stan nieaktywny – oznacza, że zdefiniowane w zapytaniu PromQL wyrażenie nie jest w danej chwili spełnione, a infrastruktura działa poprawnie.
  • Stan oczekiwania – aktywuje się w momencie wykrycia anomalii i trwa przez zadany czas zwłoki w celu odfiltrowania chwilowych skoków metryki.
  • Stan aktywny – oznacza, że przekroczenie progu utrzymuje się zbyt długo, co powoduje natychmiastowe wysłanie powiadomienia do Alertmanagera.
  • Eliminacja migotania – zrozumienie faz pozwala inżynierom dobrać parametry czasowe tak, aby alerty nie gasły i nie aktywowały się naprzemiennie (eliminacja tzw. flapowania).
Klauzula for: Czas utrzymywania warunku przed wystrzeleniem alertu; odróżnia chwilowe wahnięcie od realnego problemu.
reguła alertu
CLI · Prometheus: reguła alertu
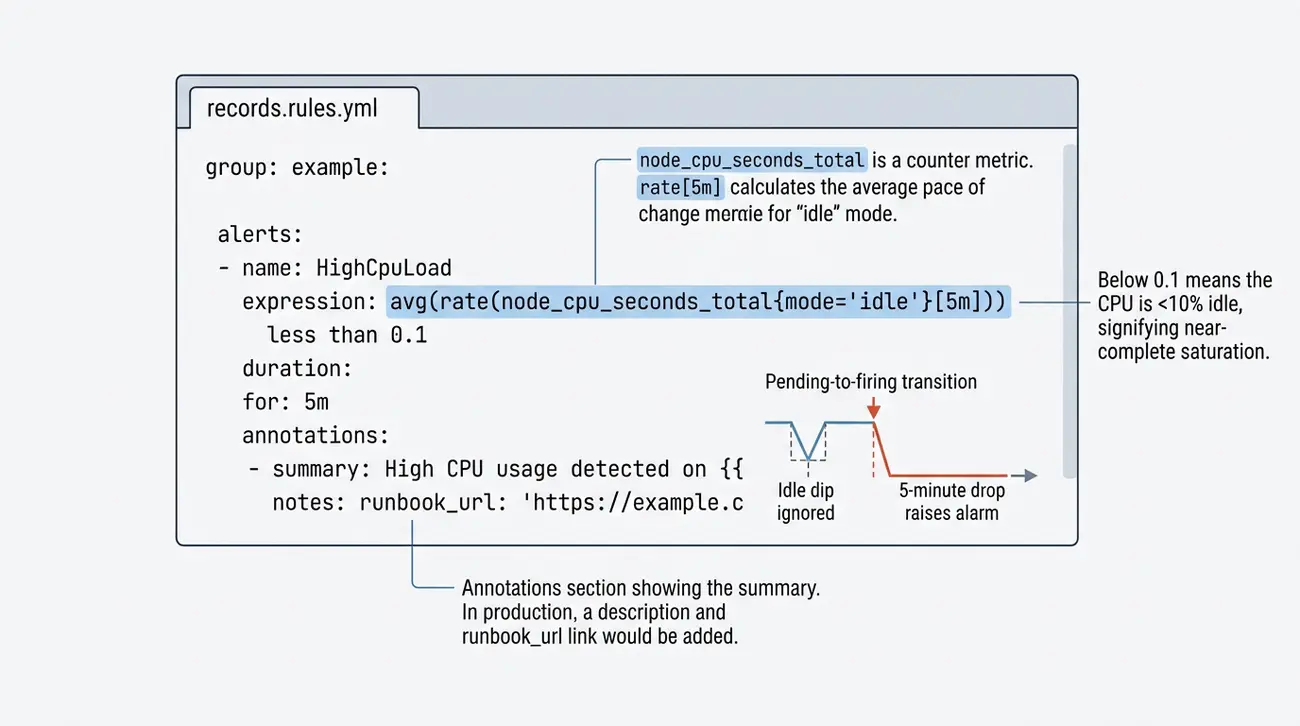
# reguła alertu (records.rules.yml) groups: - name: example rules: - alert: HighCpuLoad expr: avg(rate(node_cpu_seconds_total{mode="idle"}[5m])) < 0.1 for: 5m annotations: summary: "Wysokie obciążenie CPU"

Precyzyjna konfiguracja etykiet i adnotacji pozwala zintegrować alert bezpośrednio z systemem zarządzania incydentami i runbookami.

Reguła alertu HighCpuLoad strzeże najczęstszej przyczyny degradacji usług - nasycenia procesora. Reguły pakuje się zawsze w nazwane grupy (groups:), które Prometheus ocenia niezależnie; czytanie gotowego, produkcyjnego YAML linia po linii wyjaśnia, dlaczego każda sekcja (expr, for, labels, annotations) wygląda tak, a nie inaczej - i to najlepszy sposób nauki.

Linia group + name: example - grupy pozwalają logicznie podzielić reguły (np. group_name: "app-availability" vs "infra"). Ocena reguł w grupie odbywa się sekwencyjnie w jednym przebiegu, co ma znaczenie przy regułach nagrywających (recording rules). Pod każdą grupą znajduje się lista rules: - a w niej nasz alert: HighCpuLoad. Ekspresja: expr: avg(rate(node_cpu_seconds_total{mode="idle"}[5m])) < 0.1. Rozbijamy ją: node_cpu_seconds_total to metryka licznikowa (counter - rośnie w nieskończoność), więc przez rate(...[5m]) wyliczamy ŚREDNIE tempo przyrostu w oknie 5 minut dla trybu idle (czas jałowy). Warunek < 0.1 oznacza "mniej niż 10% czasu procesora na bezczynności" - czyli praktycznie pełne nasycenie. To alert "monitoruje objaw" (nasycenie zasobu), a nie arbitrarną przyczynę, więc jest stabilny przy zmianach infrastruktury.

Parametr for: 5m jest kluczowy - przez 5 minut Prometheus trzyma alert w stanie pending i dopiero po ich upływie przechodzi w firing. Jednokrotny, krótki spadek idle (< 30 s) to najczęściej naturalne wahanie w trakcie zadań okresowych (crond, backup, index) - nie chcesz się nim budzić. Pięciominutowe utrzymywanie progu to już sygnał, że obciążenie jest trwałe i warto interweniować. Dobór for to zawsze kompromis między opóźnieniem powiadomienia a redukcją fałszywych alarmów.

Adnotacje (annotations): w przykładzie mamy summary: "Wysokie obciążenie CPU" - krótkie streszczenie widoczne na pierwszy rzut oka w Slacku/e-mailu. W produkcyjnej regule dodałbyś dwa kolejne pola: description z detalami, gdzie umieszczasz wartości z szablonów (np. description: "CPU na {{ $labels.instance }} powyżej 90% przez 5m, obecna wartość: {{ $value }}") oraz runbook_url: "https://wiki/runbooks/high-cpu" - link do procedury naprawy. Adnotacje nigdy nie służą do routingu - są czystym kontekstem dla człowieka.

Co w tym przykładzie celowo pominięto: labels. W prawdziwej regule dodałbyś m.in. severity: critical|warning, team: payments, service: web - bo to te etykiety umożliwiają Alertmanagerowi poprawne routowanie (do zespołu, na właściwy kanał, z właściwą pilnością). Praktyczna wskazówka: trzymaj taki szkielet reguły w repozytorium kodu jako szablon, a zespół wypełnia jedynie expr, for, labels i annotations - wtedy wszystkie alerty w organizacji mają identyczną strukturę i można je automatyzować. Terminologia: groups, rules, alert (nazwa), expr, for (pending → firing), annotations (summary, description, runbook_url), labels (severity, team), recording rules.

Znając teorię reguł alertowych, przyjrzymy się konkretnemu przykładowi, który pokaże, jak powyższe zasady funkcjonują w praktyce. Reguła HighCpuLoad monitoruje jeden z najczęstszych objawów degradacji usług - nasycenie procesora - i choć wydaje się prosta, kryje kilka istotnych decyzji projektowych, które warto zrozumieć przed skopiowaniem do własnego środowiska.

Wyrażenie porównujące średni udział czasu procesora na biegu jałowym z progiem dziesięciu procent w oknie pięciu minut oznacza praktycznie pełne nasycenie CPU. Parametr for pięciu minut sprawia, że jednorazowy spadek idle nie postawi nas na nogi w nocy, bo alert przechodzi z pending do firing dopiero po upływie tego czasu. Adnotacja summary dostarcza kontekst w jednym zdaniu, a wersja produkcyjna powinna zawierać description i runbook_url. Brak etykiet severity czy team oznacza, że Alertmanager nie poradzi sobie z routowaniem.

Wyjaśnienie skrótów użytych na slajdzie:
annotations – Alert Annotations Map – adnotacje informacyjne alertu; Pola tekstowe zawierające dynamiczne opisy wzbogacane szablonami Go templating.
summary – Alert Summary Field – podsumowanie alertu; Jednoliniowy, czytelny dla człowieka opis istoty problemu wyświetlany w tytule powiadomienia.
description – Alert Description Field – szczegółowy opis alertu; Rozwinięcie zawierające wyliczone wartości zmiennych i kontekst usterki.
runbook_url – Runbook URL Link – odnośnik do instrukcji operacyjnej; Bezpośredni link hipertekstowy do procedury awaryjnej stanowiący obowiązkowy element dobrego alertu.
severity – Severity Label – etykieta stopnia krytyczności; Identyfikator wagi problemu (np. page, warning, critical) sterujący kanałem powiadomień.

10/55 Konfiguracja Alertmanager
Konfiguracja Alertmanager: Plik YAML definiuje route tree (grupowanie, routowanie, powtarzanie), receivers (Slack, Email, PagerDuty, Webhook), inhibit_rules i silences. Drzewo decyzyjne dla alertów.

Alertmanager to drzewo decyzyjne w YAML: trasy, odbiorcy, tłumienie i cisza. Błąd blokuje przeładowanie.

  • Główny plik YAML – zawiera globalne definicje środowiskowe, strukturę drzewa routingu oraz listę autoryzowanych odbiorców powiadomień.
  • Trasa główna root – określa domyślne parametry grupowania oraz kanał zapasowy dla wszystkich niesklasyfikowanych komunikatów alarmowych.
  • Trasy podrzędne – dopasowują etykiety alertów, kierując awarie krytyczne do aplikacji telefonicznych, a drobne usterki na czaty zespołów.
  • Definicje odbiorców – każdy profil odbiorcy posiada indywidualną konfigurację integracji, szablonów oraz limitów powtarzania komunikatów.
  • Ochrona przed zgubieniem – poprawna hierarchia tras zapobiega gubieniu powiadomień i chroni pracowników przed zbędnym szumem z obcych domen.
Route tree: Drzewo tras decyzyjne (grupowanie, routowanie, powtarzanie) z receiverami, inhibit_rules i silences w YAML Alertmanagera.
konfiguracja

Komponent Prometheus Alertmanager zarządza cyklem życia powiadomień za pomocą drzewa routingu:
- Grupowanie (group_by: [alertname, cluster]): łączy powiadomienia o wspólnych cechach w jeden zbiorczy komunikat,
- Buforowanie (group_wait: 30s i group_interval: 5m): wstrzymuje wysyłkę w celu zebrania alertów powiązanych, drastycznie redukując liczbę powiadomień w trakcie dużej awarii,
- Okres ponawiania (repeat_interval: 4h): określa czas, po którym nierozwiązany alert zostanie przypomniany inżynierowi dyżurnemu.

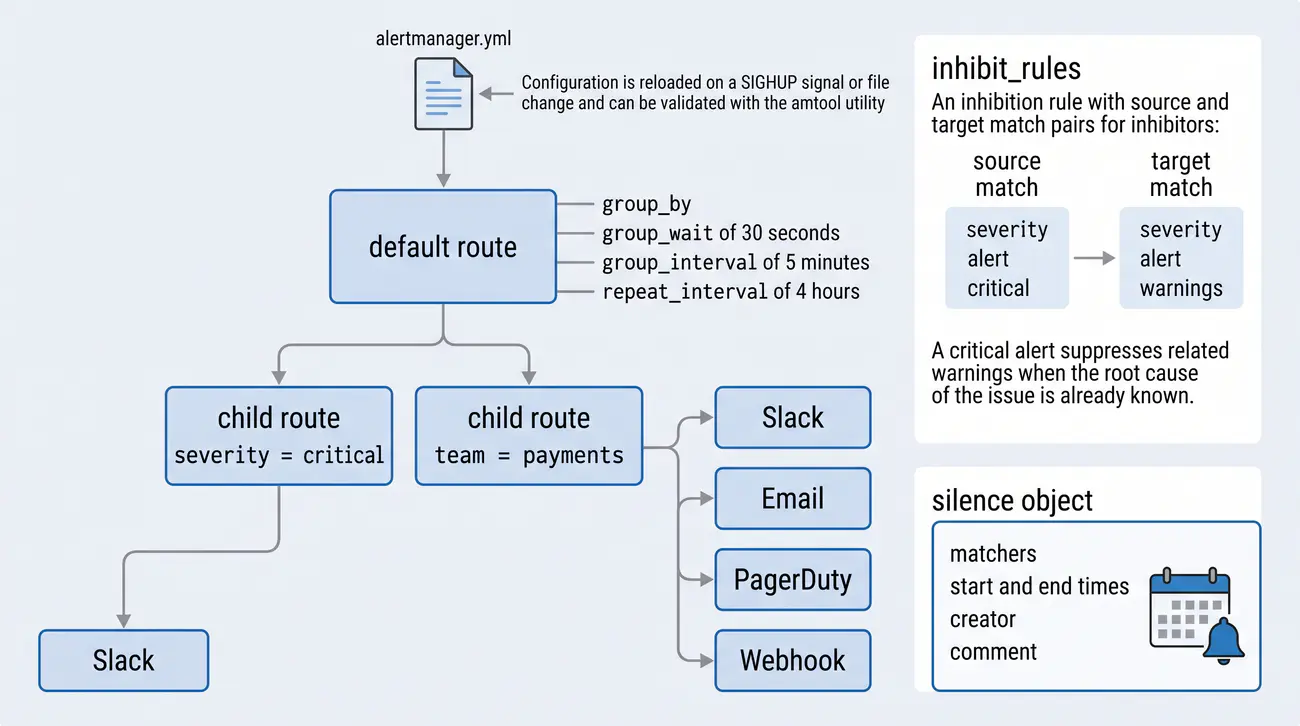
Konfiguracja Alertmanagera łączy route tree (group_by, group_wait, group_interval, repeat_interval, receiver), receivers (Slack, Email, PagerDuty, OpsGenie, Webhook, Telegram, Discord, VictorOps, Microsoft Teams), inhibit_rules i silences - wszystko w deklaratywnym YAML. Terminologia: route, receiver, inhibit_rules, silence, group_by, group_wait.

Route tree: group_by (group_by: [alertname, cluster]), group_wait (czas oczekiwania na więcej alertów), group_interval (jak często grupować), repeat_interval (jak często powtarzać). root route = default, child routes = specyficzne routing rules. To drzewo decyzyjne.

Receivers: Slack (channels, mentions, icon_emoji), Email (SMTP, templates), PagerDuty (escalation policies), OpsGenie (routing rules), Webhook (custom integrations). Multiple receivers = różne kanały dla różnych severity/teamów. Receiver = gdzie dostarczyć alert.

Inhibit_rules: source_match (source alert) → target_match (target alert) = critical wycisza warning. Silences: wyciszanie na czas (maintenance window). Inhibition rules = smart silencing.

Terminologia: route (trasowanie), receiver (odbiornik), inhibit_rules (reguły inhibicji), silence (wyciszenie), group_by (grupowanie), group_wait (czas oczekiwania na grupowanie), group_interval (interwał grupowania), repeat_interval (interwał powtarzania), inhibition (inhibicja), silence (wyciszenie).

Reguły alertów definiują, kiedy Alertmanager dostaje sygnał, ale konfiguracja tego komponentu decyduje, co z nim zrobi - gdzie wyśle, z kim połączy i kiedy wyciszy. Alertmanager jest de facto drzewem decyzyjnym zapisanym w YAML, a jego struktura wpływa na to, czy operator otrzyma pomocną informację w odpowiednim czasie, czy też zginie ona w szumie powiadomień.

Kluczowy jest route tree, hierarchia tras z rootem catch-all rozgałęziającym się w child routes dopasowujących alerty po severity czy team. Parametry group_by, group_wait, group_interval i repeat_interval kontrolują agregację - group_wait trzydzieści sekund pozwala dociągnąć kolejne alerty przed wysyłką, repeat_interval cztery godziny zapewnia przypomnienia bez spamu. Receivers obejmują Slack, e-mail, PagerDuty i webhook. Inhibit_rules tłumią niższe severity przy aktywnym krytycznym, a silences wyciszają na czas wdrożeń przez API lub UI.

Wyjaśnienie skrótów użytych na slajdzie:
route – Routing Tree in Alertmanager – drzewo routingu w Alertmanagerze; Główna sekcja konfiguracyjna określająca zasady kierowania powiadomień do odbiorców na podstawie etykiet.
receiver – Notification Receiver – odbiorca powiadomień; Nazwana konfiguracja integracji końcowej (np. kanał Slack, kolejka PagerDuty, adres e-mail).
group_by – Grouping Keys Directive – dyrektywa kluczy grupowania; Lista etykiet, według których Alertmanager łączy pojedyncze alerty w komunikaty zbiorcze.
group_wait – Group Wait Buffer Time – czas oczekiwania na grupowanie; Okres buforowania powiadomień przed wysłaniem pierwszego komunikatu ze zbioru.
repeat_interval – Repeat Interval Directive – interwał powtarzania powiadomienia; Czas, po którym Alertmanager ponawia wysłanie informacji o wciąż nierozwiązanej awarii.

11/55 Grupowanie i deduplikacja
Grupowanie i deduplikacja: Alertmanager łączy podobne alerty w grupy (group_by) i eliminuje duplikaty (dedup). "Zoom out" z setek alertów do kilku czytelnych grup.

Trzy filtry robią z lawiny porządek: deduplikacja, grupowanie i inhibicja. Setki wiadomości w kilka grup.

  • Agregacja powiadomień – łączy alerty o identycznych zestawach etykiet, na przykład z tego samego klastra, w jedną zwięzłą wiadomość.
  • Parametr group_wait – wstrzymuje pierwszą wysyłkę na kilkadziesiąt sekund, dając systemowi czas na zebranie pokrewnych anomalii w pakiet.
  • Parametr group_interval – określa, jak często Alertmanager dosyła informacje o kolejnych awariach dołączających do istniejącej grupy zdarzeń.
  • Parametr repeat_interval – definiuje odstęp czasu, po którym system ponownie przypomina dyżurnemu o nierozwiązanej i wciąż aktywnej usterce.
  • Optymalne dostrojenie – właściwe wartości parametrów pozwalają zachować równowagę pomiędzy szybkością reakcji a spokojem dyżurnego.
group_by: Klucze scalające podobne alerty w grupy; z deduplikacją robi „zoom out” z setek alertów do kilku czytelnych grup.
grupowanie

Grupowanie i deduplikacja powiadomień w Alertmanagerze chronią inżynierów przed burzą alertów (alert storm) w trakcie awarii infrastruktury sieciowej.

Grupowanie i deduplikacja alertów w Alertmanagerze realizowane są przez group_by (group_by: [alertname, cluster]), group_wait, group_interval i repeat_interval, a vector matching (ignoring/on) pozwala operować na wektorach o różnych labelach - to "zoom out" z setek alertów do kilku grup.

Grupowanie by / without: sum by (job, instance) (...) - zachowaj job, instance; sum without (instance) (...) - usuń instance, zsumuj resztę. Grouping control = precyzyjne decydowanie co zostaje w wyniku.

Vector matching: Operatory (+, *, /, itd.) działają na wektorach z matching labels. ignoring(label) / on(label) kontrola dopasowania. Join semantics = kontrola jak łączymy wektory o różnych wymiarach.

Przykłady - practical patterns: sum by (job) (rate(http_requests_total[5m])) → total RPS per job. topk(5, sum by (instance) (rate(node_cpu_seconds_total{mode!="idle"}[5m]))) → top 5 instancji by CPU usage. To gotowe wzorce do skopiowania do dashboardów/alertów.

Terminologia: aggregation (agregacja), vector (wektor), by (grupuj), without (bez), ignoring (ignoruj), on (na), group_left (dołącz lewy), group_right (dołącz prawy), topk (top N), bottomk (bottom N), vector matching (dopasowanie wektorów).

Konfiguracja Alertmanagera definiuje ścieżki i odbiorców, ale pierwszą linię obrony przed alert fatigue stanowi grupowanie i deduplikacja - mechanizmy zamieniające potencjalną lawinę powiadomień w przejrzysty zestaw informacji. Bez nich operator otrzymałby oddzielną wiadomość za każdą instancję tego samego problemu, co przy setce serwerów oznaczałoby setkę identycznych alertów.

Grupowanie scala alerty o wspólnych kluczach group_by, na przykład alertname i cluster, w jeden komunikat z opóźnieniem group_wait trzydzieści sekund, dając czas na dociągnięcie kolejnych instancji. Deduplikacja eliminuje spam: ten sam alert o identycznych kluczach jest wysyłany tylko raz, a powtórzenia w ramach group_interval i repeat_interval nie generują nowych wiadomości. W połączeniu z inhibicją tłumiącą niższe severity mechanizmy te tworzą trzywarstwowy filtr: eliminacja duplikatów, grupowanie podobnych i wyciszanie zależnych.

Wyjaśnienie skrótów użytych na slajdzie:
Deduplication – Alert Deduplication Mechanism – mechanizm deduplikacji alertów; Łączenie identycznych sygnałów alarmowych pochodzących z nadmiarowej pary serwerów Prometheus.
Grouping – Alert Grouping Mechanism – mechanizm grupowania alertów; Agregacja wielu powiązanych zdarzeń w jeden komunikat zbiorczy wysyłany do zespołu.
Alertstorm – Alert Storm Incident – zjawisko burzy alertów; Niebezpieczna lawina setek powiadomień mitygowana przez właściwe parametry buforowania.
HA – High Availability – wysoka dostępność; Układ klastrowy Alertmanagera wymieniający stany wyciszeń i powiadomień za pomocą protokołu Mesh/Gossip.
Cluster – Alertmanager High Availability Cluster – klaster wysokiej dostępności Alertmanagera; Układ wielu instancji gwarantujący brak utraty powiadomień przy awarii pojedynczego serwera.

12/55 Cichnięcia (silencing)
Cichnięcia (silencing): Wyciszanie alertów w Alertmanagerze na ustalony czas - przydatne podczas maintenance windows i planowanych wdrożeń. API pozwala na automatyzację tworzenia silences.

Silence to planowana cisza: wyciszasz powiadomienia na okno prac, nie ruszając reguły.

  • Mechanizm hamowania – pozwala na automatyczne wyciszenie powiadomień o niskim priorytecie w sytuacji, gdy wystąpiła awaria nadrzędna.
  • Awaria infrastruktury – utrata łączności z całym węzłem lub centrum danych blokuje setki bezużytecznych alertów z pojedynczych aplikacji.
  • Dopasowanie etykiet – reguła inhibition wiąże zdarzenie źródłowe ze zdarzeniami docelowymi w oparciu o wspólne metadane klastra lub regionu.
  • Redukcja lawiny – wygaszenie wtórnych objawów drastycznie ogranicza liczbę równoległych komunikatów docierających do zespołu w trakcie kryzysu.
  • Koncentracja na przyczynie – dyżurny nie traci czasu na przeglądanie setek powiadomień i skupia się bezpośrednio na usterce źródłowej.
Silence: Wyciszenie alertów na ustalony czas (maintenance, wdrożenia) bez wyłączania reguły; API pozwala je automatyzować.
silence

Wyciszanie (Silencing) w interfejsie Alertmanagera pozwala zaplanować okna serwisowe bez wyzwalania zbędnych alarmów. Równie istotne są reguły hamowania (inhibit_rules), które automatycznie wyciszają alerty niższego rzędu (np. błędy aplikacji), jeśli aktywny jest alert nadrzędny (np. brak łączności z całym węzłem lub przełącznikiem).

Silencing (wyciszanie alertów) w Alertmanagerze tworzy się przez silences (matchers, startsAt, endsAt, createdBy, comment) z regex matchers i derived fields (parsowanie JSON, wyciąganie pól, linki do trace); integracja z panelem metryk (latency p99 spike) i panelem logów (errors w tym samym czasie) w shared time range z variables to korelacja bez przełączania kontekstu. Terminologia: log panel, Loki data source, LogQL, derived fields, label filters, line filters, live tailing.

Log panel - Logs visualization: Data source: Loki (lub Elasticsearch). LogQL query: {job="nginx"} |= "error" | json | line_format "{{.message}}" → tabela: Time, Labels, Line. Live tailing (auto-refresh): nowe logi pojawiają się na górze w czasie rzeczywistym. Real-time log streaming = canary deploy monitoring, incident live debugging.

Filtrowanie - dwupoziomowe: Label filters (w query, przed pobraniem): {job="nginx", env="prod"} - filtruje streamy na poziomie Loki (szybkie, indeksowane). Line filters (po pobraniu, na liniach): |= "error" (contains), != "health" (not contains), |~ "timeout.*" (regex match), !~ "debug" (regex not match). Derived fields: parsowanie JSON (| json), wyciąganie pól, linki do trace (traceID → link do Tempo). Powerful filtering = precyzyjne wyciąganie igły ze stogu siana.

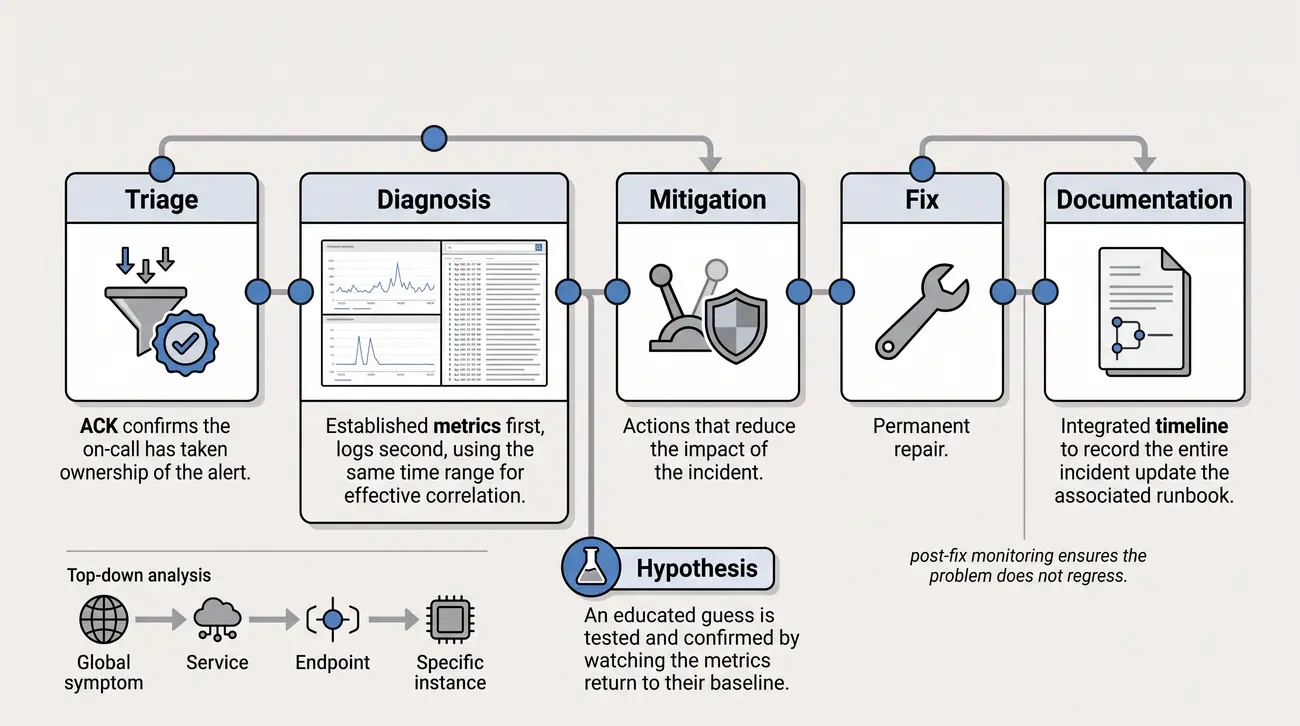
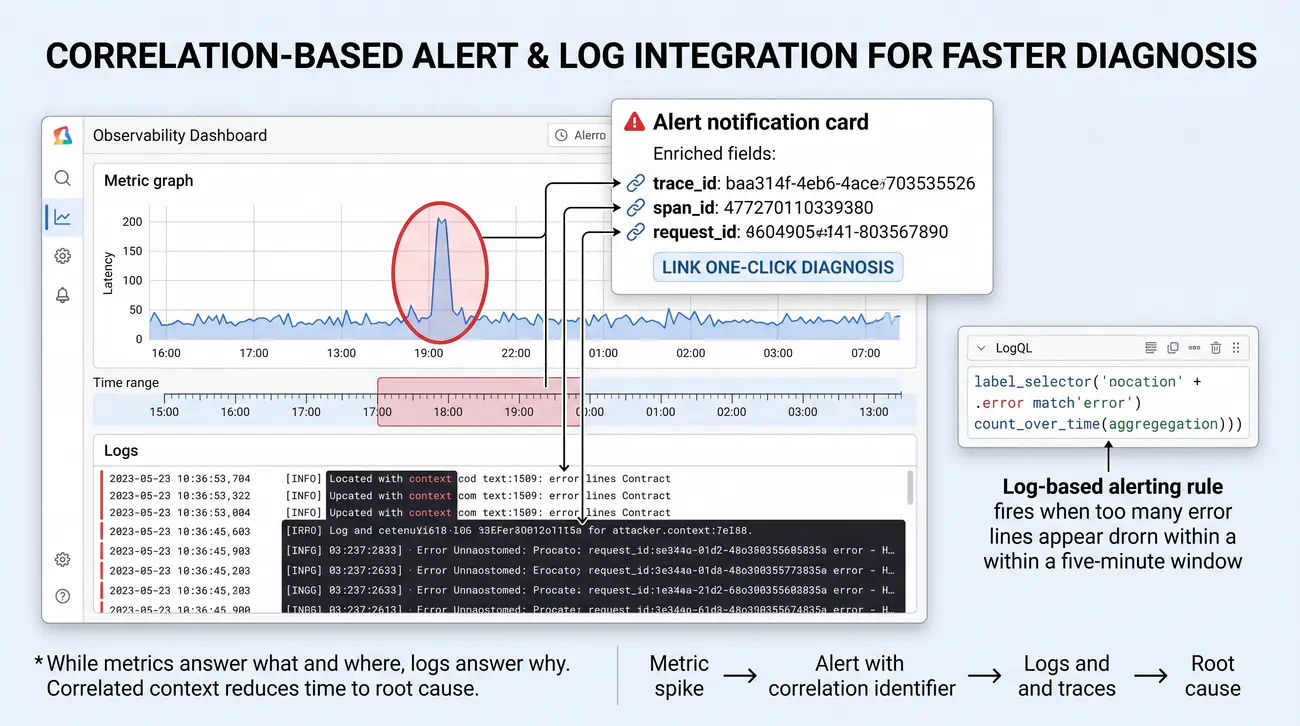
Integracja metryk i logów - unified troubleshooting: Ten sam dashboard → panel metryk (latency p99 spike) + panel logów (errors w tym samym czasie) + shared time range + variables ($instance filtruje oba). Korelacja: widzisz latency spike → patrzysz na logi w tym samym czasie → widzisz ERROR connection pool exhausted → root cause w 30 sekund. Unified troubleshooting = metrics + logs + shared context.

Terminologia: log panel (panel logów), Explore (tryb eksploracji), LogQL (zapytania Loki), derived fields (pola pochodne), label filters (filtry etykiet), line filters (filtry linii), live tailing (podgląd na żywo), correlation (korelacja), metrics-logs correlation (korelacja metryk i logów).

Poznawszy routowanie i grupowanie alertów w Alertmanagerze, warto przyjrzeć się mechanizmowi wyciszania alertów, czyli tzw. silencingowi. Pozwala on stłumić powiadomienia o alertach dopasowanych do zdefiniowanych matcherów bez wyłączania samej reguły, co odróżnia go od usuwania reguły czy zmiany progów. Jest niezastąpiony podczas planowanych okien serwisowych, wdrożeń i sytuacji, gdy zespół aktywnie pracuje nad rozwiązaniem problemu.

Konfiguracja wyciszenia opiera się na matcherach odwołujących się do etykiet alertname, cluster i severity, a ich wartość może być dokładnie określona lub wyrażona jako wyrażenie regularne, na przykład alertname =~ High.*, co pozwala wyciszyć cały rodzaj alertów naraz. Każde wyciszenie ma pola startsAt, endsAt, createdBy i comment, a cały obiekt tworzy się i usuwa przez REST API, co umożliwia automatyzację w pipeline'ie CI/CD przed planowanym wdrożeniem lub harmonogramowo zgodnie z kalendarzem konserwacji.

Wyjaśnienie skrótów użytych na slajdzie:
Silence – Alertmanager Silence Rule – wyciszenie alertu; Tymczasowa blokada wysyłania powiadomień zdefiniowana w interfejsie graficznym lub przez API.
Maintenance – Maintenance Window – okno prac serwisowych; Zaplanowany okres rekonfiguracji systemów, w trakcie którego powiadomienia są planowo wyciszane.
Regex – Regular Expression Matcher – dopasowanie wyrażeniem regularnym; Wzorzec selekcji etykiet w wyciszeniach (np. instance=~'node-0[1-5].*').
Author – Silence Author Identifier – identyfikator autora wyciszenia; Imię i nazwisko lub login inżyniera zakładającego wyciszenie na potrzeby audytowalności.
Comment – Silence Explanation Comment – komentarz uzasadniający wyciszenie; Obowiązkowe pole tekstowe wyjaśniające przyczynę i numer zgłoszenia serwisowego (np. 'Prace planowe JIRA-1234').

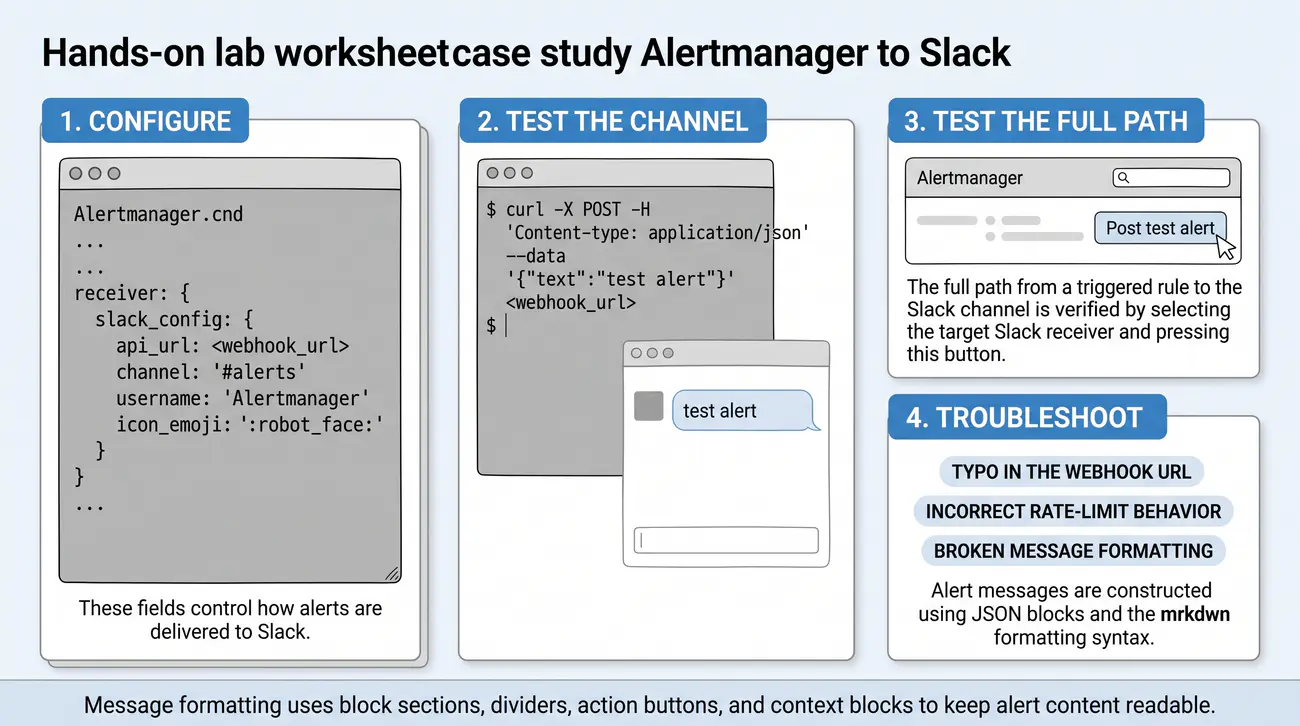
13/55 Integracja ze Slack/Discord
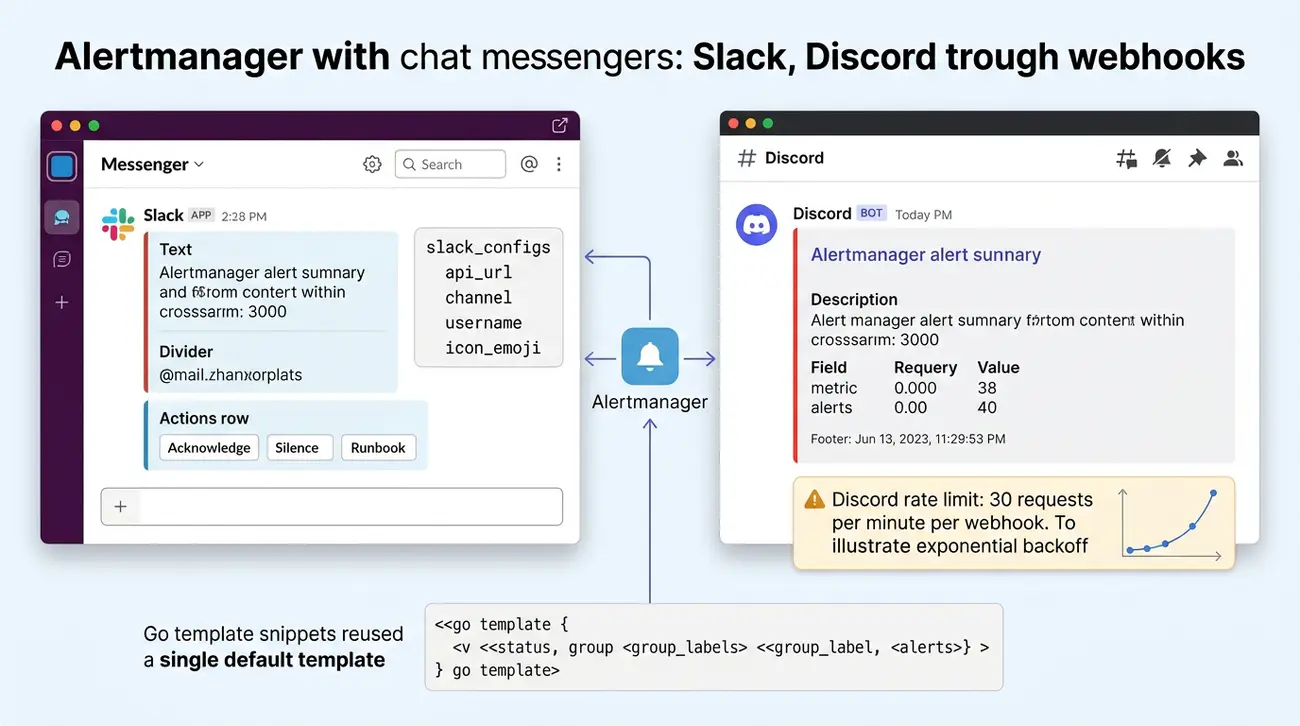
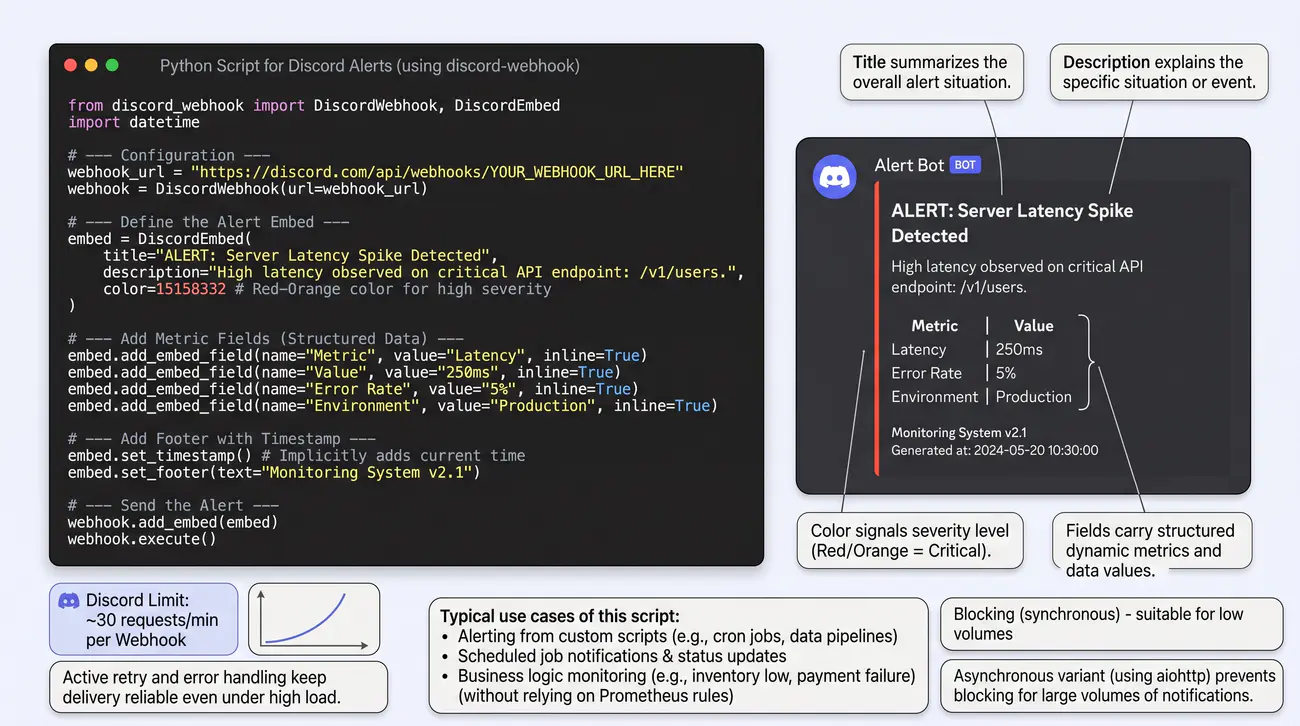
Integracja ze Slack/Discord: Alertmanager wysyła alerty przez webhook URL do kanałów czatu. Slack Block Kit i Discord embeds umożliwiają interaktywne powiadomienia z przyciskami (Acknowledge, Silence, Runbook).

Czat to najpopularniejszy kanał: wiadomość ląduje na telefonie i komputerze naraz, a przyciski skracają reakcję.

  • Czasowe wyciszenia – funkcja silences pozwala operatorom na zablokowanie powiadomień pasujących do określonych etykiet na zadany czas.
  • Okna serwisowe – wyciszenia są niezastąpione podczas planowanych prac konserwacyjnych, migracji baz danych oraz restartów węzłów.
  • Szybkie nakładanie – dyżurny może nałożyć wyciszenie za pośrednictwem interfejsu graficznego Alertmanagera lub narzędzia konsolowego amtool.
  • Komentarz i autor – każde wyciszenie musi zawierać zwięzłe uzasadnienie biznesowe oraz nazwisko inżyniera nakładającego blokadę powiadomień.
  • Samoczynne wygasanie – automatyczny upływ czasu ważności wyciszenia chroni monitoring przed trwałym oślepieniem przez zapomnienie operatora.
Slack Block Kit: Interaktywne bloki wiadomości z przyciskami (Acknowledge, Silence, Runbook); webhook URL dostarcza alerty na kanał czatu.
webhook

Integracja Alertmanagera ze Slackiem i Discordan wymaga konfiguracji webhook URL, receivera (slack_configs, discord_configs), szablonów wiadomości (templates) i formatowania (markdown, blocks). Terminologia: webhook, incoming webhook, slack_config, discord_config, template.

Slack webhook: Incoming Webhook URL, channel override, username, icon_emoji. Slack blocks (blocks JSON): sections, dividers, actions (buttons), context. Formatting: markdown (mrkdwn), bold, italic, code blocks. Slack Block Kit Builder = visual builder.

Discord webhook: webhook URL, content, embeds (title, description, color, fields, footer, timestamp), username/avatar override. Rate limits: 30 requests/minute per webhook. Rate limit handling = exponential backoff.

Templates: Go templates (.tmpl) w Alertmanagerze. Variables: {{ .Status }}, {{ .GroupLabels }}, {{ .CommonAnnotations }}, {{ .Alerts }}. Custom templates = branding, dodatkowe pola, linki do runbooków/dashboardów. Reusable templates = consistent formatting.

Terminologia: webhook (webhook), incoming webhook (webhook przychodzący), slack_config, discord_config, template (szablon), markdown, blocks, embed, rate limit.

Integracja Alertmanagera z komunikatorami czatowymi, takimi jak Slack czy Discord, stanowi najczęściej spotykany kanał dostarczania alertów w nowoczesnych zespołach operacyjnych. Wiadomość na czacie pojawia się natychmiast na telefonie i komputerze, co czyni ją idealnym medium dla alertów o niskiej i średniej pilności, a jednocześnie umożliwia szybką współpracę podczas diagnozy problemu - operator widzi alert i może jednym kliknięciem otworzyć runbook.

Integracja ze Slackiem wymaga skonfigurowania pola slack_configs, gdzie podajemy Incoming Webhook URL i docelowy kanał, a szablony Go (.tmpl) umożliwiają wstawianie wartości z metadanych alertu. Bloki i przyciski buduje się w formacie JSON znanym jako Slack Block Kit. Discord działa podobnie - webhook URL i embedy z kolorystyką odpowiadającą severity - z jednym ograniczeniem: limit trzydziestu żądań na minutę wymusza obsługę rate limit i eksponencjalny backoff.

Wyjaśnienie skrótów użytych na slajdzie:
Webhook – Incoming Webhook Integration – przychodzące wywołanie sieciowe webhook; Mechanizm odbierania powiadomień przez platformy Slack i Discord za pomocą protokołu HTTP POST.
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji; Standard komunikacyjny przesyłający ładunek danych z Alertmanagera do komunikatora.
POST – HTTP POST Request – żądanie HTTP POST; Metoda protokołu HTTP przenosząca ciało komunikatu w formacie JSON.
JSON – JavaScript Object Notation – format JSON; Struktura danych opisująca listę aktywnych alertów przekazywana w ładunku webhooka.
Bot – ChatOps Notification Bot – bot powiadomień operacyjnych; Zautomatyzowana aplikacja publikująca sformatowane wiadomości na dedykowanych kanałach zespołowych.

14/55 Integracja z e-mailem
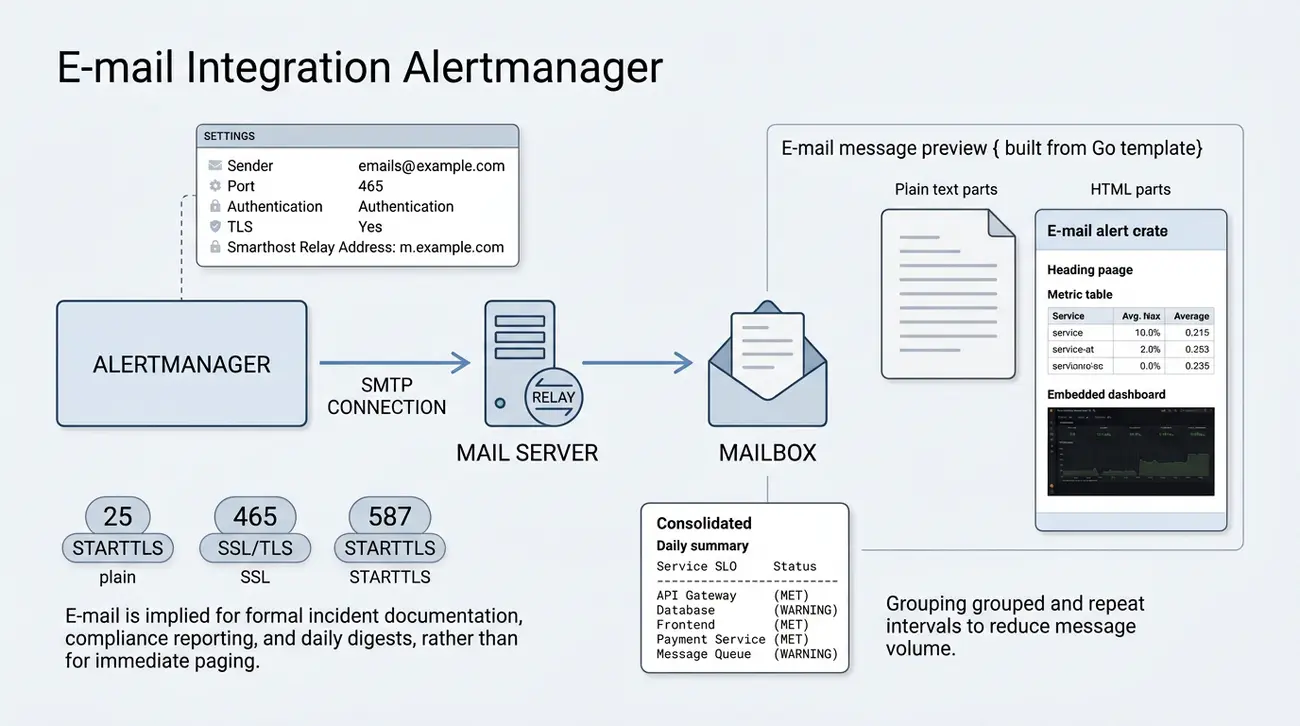
Integracja z e-mailem: Konfiguracja SMTP (host, port, auth, TLS) w email_config. Szablony HTML/text dla formatowania treści. Deduplikacja przez grouping + repeat_interval.

Poczta elektroniczna nie służy do natychmiastowego opanowywania awarii, lecz do formalnego raportowania i rejestrowania zdarzeń.

  • Klaster wysokiej dostępności – instancje Alertmanagera tworzą rozproszoną sieć wymieniającą stany za pomocą lekkiego protokołu plotkującego.
  • Równoległe wysyłanie – serwery Prometheus dostarczają sygnały do wszystkich węzłów Alertmanagera, eliminując zależność od load balancera.
  • Deduplikacja w klastrze – węzły synchronizują wiedzę o wysłanych komunikatach, dzięki czemu inżynier otrzymuje dokładnie jedną wiadomość.
  • Bezprzerwowa praca – awaria fizyczna jednej z maszyn nie przerywa dostarczania powiadomień, gdyż pozostałe węzły natychmiast przejmują ruch.
  • Odporność sieciowa – klaster radzi sobie z chwilowymi partycjami sieci, dbając o to, by żadne krytyczne ostrzeżenie nie zostało utracone.
repeat_interval: Odstęp ponawiania powiadomienia o trwającym alercie; z grupowaniem ogranicza szum w email_config (SMTP, TLS, szablony).
e-mail alert

Integracja z e-mailem w Alertmanagerze to konfiguracja SMTP (host, port, auth, TLS), email_config (to, from, smarthost, auth), templating (HTML, text) i deduplication. Terminologia: SMTP, email_config, template, smarthost, authentication.

Konfiguracja SMTP: host, port (25/465/587), TLS (STARTTLS/SSL), auth (PLAIN/LOGIN/CRAM-MD5). email_config: to (lista odbiorców), from (nadawca), smarthost (relay SMTP), auth (username/password), headers (nagłówki custom). Template: Go templates (.tmpl) z HTML/text parts. Deduplication: grouping + repeat_interval.

Terminologia: SMTP (Simple Mail Transfer Protocol), email_config (konfiguracja e-mail), template (szablon), smarthost (relay SMTP), authentication (autentykacja), deduplication (deduplikacja).

Chociaż komunikatory czatowe zdominowały codzienną komunikację operacyjną, poczta elektroniczna pozostaje kanałem niezastąpionym w wielu scenariuszach alertowych - służy do formalnego dokumentowania incydentów, raportowania zgodności z SLO i wysyłania codziennych podsumowań, a w niektórych organizacjach jest jedynym kanałem akceptowanym przez politykę bezpieczeństwa. Integracja wymaga skonfigurowania połączenia SMTP z uwierzytelnianiem i szyfrowaniem oraz zdefiniowania szablonów wiadomości.

Kluczowe parametry to adres serwera SMTP, czyli tzw. smarthost, port - najczęściej pięćset osiemdziesiąty siedem z STARTTLS lub czterysta sześćdziesiąt pięć z natychmiastowym SSL - oraz dane uwierzytelniające obsługujące mechanizmy PLAIN, LOGIN i CRAM-MD5. W sekcji email_config definiujemy odbiorców i nadawcę, a szablony .tmpl wiadomości można przygotować w formacie HTML i tekstowym. Email łączy się z groupingiem i powtarzaniem, by wysyłać jedno podsumowanie zamiast wielu pojedynczych alertów.

Wyjaśnienie skrótów użytych na slajdzie:
SMTP – Simple Mail Transfer Protocol – prosty protokół przesyłania poczty; Tradycyjny protokół sieciowy wykorzystywany do doręczania raportów i powiadomień niekrytycznych.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Kryptograficzny protokół zabezpieczający sesję SMTP przed podsłuchem w sieci teleinformatycznej.
STARTTLS – Opportunistic TLS Extension – rozszerzenie negocjacji szyfrowania STARTTLS; Komenda protokołu SMTP podnosząca zwykłe połączenie tekstowe do szyfrowanej sesji TLS.
RFC – Request for Comments – dokument standaryzacji RFC; Zbiór oficjalnych specyfikacji protokołów pocztowych IETF.
MIME – Multipurpose Internet Mail Extensions – wielocelowe rozszerzenia poczty internetowej; Standard kodowania formatu HTML i załączników graficznych w wiadomościach pocztowych.

15/55 Powiadomienia przez Pythona
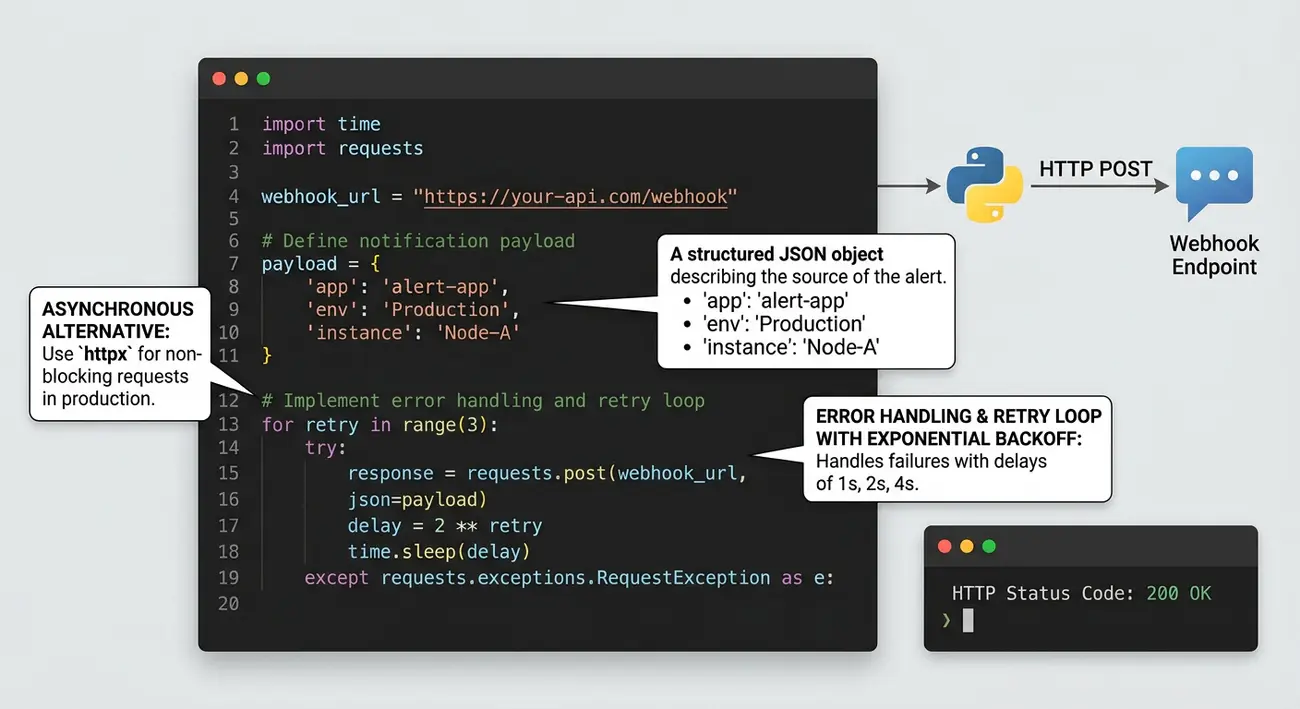
Powiadomienia przez Pythona: Wysyłka webhook przez requests/httpx z JSON payload. Retry logic (exponential backoff) zapewnia niezawodność dostarczania powiadomień.

Gdy gotowca brak, Python gada webhookiem: POST z JSON-em, backoff na błędy i batch przy skali.

  • Silnik szablonów Go – Alertmanager wykorzystuje zaawansowany język szablonów do precyzyjnego formatowania wiadomości trafiających do ludzi.
  • Wstrzykiwanie zmiennych – dynamiczne pola pozwalają wstawiać do treści alertu bieżące wartości metryk, nazwy hostów oraz czas trwania usterki.
  • Spójny format – jednolita struktura wizualna wiadomości w całej organizacji ułatwia inżynierom szybkie wychwycenie kluczowych faktów pod presją.
  • Dostosowanie do kanału – szablony umożliwiają tworzenie bogatych tabel HTML dla poczty oraz zwięzłych kart ze statusem na komunikatorach.
  • Weryfikacja składni – pliki szablonów powinny być testowane za pomocą polecenia amtool przed ich wdrożeniem na serwery produkcyjne.
Exponential backoff: Wykładnicze wydłużanie przerw między ponowieniami (retry) wysyłki webhooka przez requests/httpx; zapewnia niezawodność doręczenia.
kod Python
CLI · Python: webhook na czat
import requests data = {'text': 'ALERT: wysoki błąd 500'} r = requests.post('https://hooks.slack.com/services/T0/B0/x', json=data) print('Status:', r.status_code)

Wysyłka powiadomień przez webhook w Pythonie używa requests/httpx, JSON payload, retry logic (exponential backoff), error handling i logging - przykład kodu gotowy do użycia. Terminologia: webhook, requests, httpx, retry, exponential backoff, JSON payload.

Wysyłka na webhook - HTTP Push: POST /loki/api/v1/push (JSON payload: streams: [{stream: {labels}, values: [[timestamp, line]]}). Batchowanie (batch_size, flush_interval) = throughput. Retries + exponential backoff = reliability. Async (httpx/aiohttp) = non-blocking.

Etykiety aplikacji - Labels: {app="myapp", env="prod", version="1.2.3", instance="pod-123"}. Static labels (fixed) + dynamic labels (runtime). Label hygiene = bounded cardinality! Label = query dimension. Over-labeling = cardinality explosion.

Przykład kodu Pythona: requests.post(url, json=payload, headers={"Content-Type": "application/json"}) + retry logic. Weryfikacja: Grafana Explore → LogQL: {app="myapp"} → sprawdź logi. End-to-end test = confidence.

Terminologia: webhook (webhook), requests (biblioteka), httpx (async HTTP), retry (ponowne próby), exponential backoff (eksponencjalne wycofywanie), JSON payload (ładunek JSON).

Alertmanager musi czasem komunikować się z systemem niestandardowym - wewnętrznym panelem incydentów, systemem ticketowym albo robotem na kanałach komunikacji, do którego nie ma gotowego konektora. W takim przypadku webhook, czyli ogólne żądanie HTTP POST z danymi JSON, staje się uniwersalnym mostem łączącym alerting z dowolnym systemem posiadającym interfejs sieciowy, a programistyczną stronę tego zagadnienia realizuje się najczęściej z poziomu Pythona.

Podstawowy wzorzec to wywołanie biblioteki requests z metodą POST, przekazanie URL webhooka i payloadu JSON, a następnie sprawdzenie kodu odpowiedzi HTTP. Kod powinien zawierać logikę ponownych prób z eksponencjalnym backoffem - na przykład po niepowodzeniu odczekaj sekundę, potem dwie, cztery - co zapewnia niezawodność w warunkach chwilowych problemów sieciowych. W środowiskach produkcyjnych warto użyć httpx do obsługi żądań asynchronicznych, a przy dużej skali zastosować batchowanie, wysyłające wiele alertów w jednym żądaniu.

Wyjaśnienie skrótów użytych na slajdzie:
PEP – Python Enhancement Proposal – standardy języka Python; Zasady czystego i czytelnego kodu programistycznego stosowane w skryptach powiadomień.
SDK – Software Development Kit – pakiet programistyczny; Zestaw bibliotek ułatwiający programową integrację z API platform powiadamiania.
requests – Python Requests Library – biblioteka requests w Pythonie; Popularna biblioteka języka Python służąca do wysyłania żądań HTTP REST do zewnętrznych webhooków.
json – Python JSON Built-in Module – wbudowany moduł json w Pythonie; Standardowa biblioteka parsująca i serializująca struktury danych alertów.
venv – Python Virtual Environment – wirtualne środowisko Pythona; Izolowane środowisko instalacji zależności skryptu zapobiegające konfliktom pakietów systemowych.

16/55 Python: wysyłka e-maila
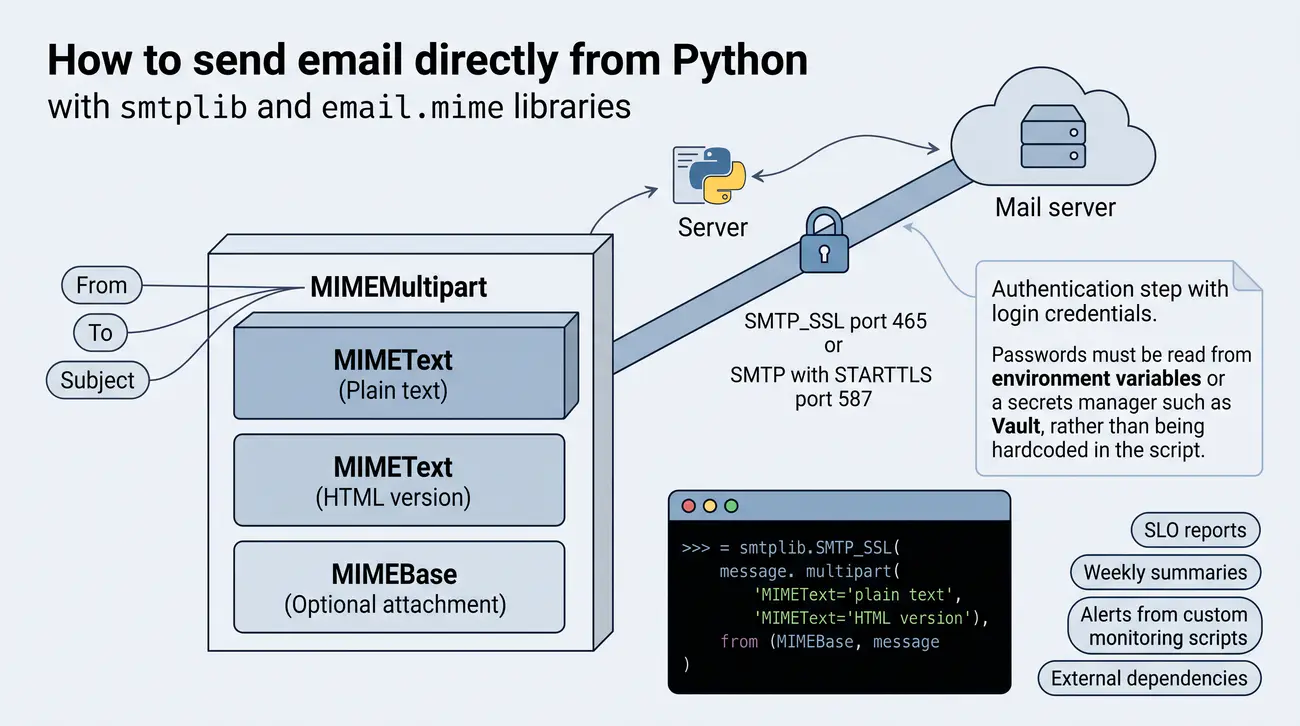
Python: wysyłka e-maila: Biblioteka smtplib + email.mime (MIMEText, MIMEMultipart) do budowy wiadomości. Bezpieczeństwo: nie zapisywać haseł w kodzie, lecz pobierać je ze zmiennych środowiskowych lub magazynu sekretów.

Mail ze skryptu: smtplib wysyła, email.mime buduje. Hasła z env, nigdy z kodu.

  • Integracja SMTP – powiadomienia pocztowe konfiguruje się poprzez wskazanie adresu serwera pocztowego, portu oraz danych logowania.
  • Szyfrowanie TLS – zabezpieczenie połączenia nowoczesnym protokołem kryptograficznym chroni szczegóły architektury przed podsłuchem w sieci.
  • Format HTML – wiadomości mogą zawierać czytelne tabele z listą dotkniętych instancji oraz bezpośrednie przyciski do nałożenia wyciszenia.
  • Rola archiwizacyjna – skrzynka pocztowa sprawdza się do gromadzenia historii incydentów oraz powiadamiania zespołów pracujących w dzień.
  • Rekordy SPF i DKIM – poprawna autoryzacja serwera pocztowego zapobiega traktowaniu komunikatów z monitoringu jako niechcianego spamu.
Sekrety poza kodem: Haseł nie hardkoduje się w skryptach - przechowuje w zmiennych środowiskowych i sekretach; smtplib z email.mime buduje wiadomości.
smtplib

Przesyłanie powiadomień przez protokół SMTP zdefiniowany w standardzie IETF RFC 5321 wymaga bezwzględnego stosowania szyfrowania warstwy transportowej. Zgodnie z wytycznymi IETF RFC 8314 zabrania się transmisji haseł otwartym tekstem. Skrypt w Pythonie musi inicjować bezpieczną sesję TLS za pomocą smtplib.SMTP_SSL() na porcie 465 lub negocjować szyfrowanie poleceniem server.starttls() na porcie 587 z weryfikacją certyfikatu.

Wysyłka e-maila bezpośrednio z Pythona - bez Alertmanagera - przydaje się przy raportach i digestach (codzienne podsumowania SLO, raporty tygodniowe), nietypowych alertach z własnego skryptu i integracji ze starymi systemami. Obie biblioteki są w standardowej bibliotece Pythona: smtplib (protokół SMTP) i email.mime (budowa wiadomości MIME) - zero zależności zewnętrznych, skrypt działa wszędzie tam, gdzie działa Python.

Budowa wiadomości: email.mime w wersji produkcyjnej składa się z trzech warstw. MIMEMultipart to kontener wiadomości wieloczęściowej - pozwala trzymać w jednej wiadomości zarówno tekst (MIMEText 'plain', kodowanie body_encoding='utf-8'), jak i wersję HTML (MIMEText 'html') - klienci pocztowi wybierają wersję, którą potrafią pokazać. Do kontenera dodajemy nagłówki: From, To, Subject (nagłówki z polskimi znakami wymagają kodowania MIME - email.header.Header lub fallback do UTF-8). Załączniki (attachmenty) dodajemy jako MIMEBase/MIMEText z nagłówkiem Content-Disposition: attachment, filename=... - np. wyeksportowany raport PDF albo zrzut ekranu dashboardu.

Wysyłka przez SMTP: klasa smtplib.SMTP_SSL('smtp.poczta.pl', 465) otwiera połączenie od razu po TLS (port 465, common dla służb firmowych), a smtplib.SMTP('smtp.poczta.pl', 587) + server.starttls() podnosi szyfrowanie na istniejącym połączeniu (STARTTLS, port 587). Zawsze wywołujemy server.login(username, password), a przy SMTP_SSL dobrym zwyczajem jest przekazać skonfigurowany ssl.create_default_context() - gwarantuje to weryfikację certyfikatu serwera. Ważny szczegół: w środowisku firmowym często nie łączysz się bezpośrednio z pocztą, lecz z relayem SMTP (smarthost) - serwerem pośredniczącym, który zajmie się resztą drogi. Po zakończeniu: server.send_message(msg) (wyśle poprawnie zakodowany obiekt MIME) i server.quit().

Bezpieczeństwo – kluczowa zasada: nigdy nie należy wpisywać haseł bezpośrednio w skryptach ani w plikach konfiguracyjnych. Hasła i dane uwierzytelniające czytamy ze zmiennych środowiskowych (os.environ['SMTP_PASSWORD']) lub z menedżera sekretów (HashiCorp Vault, cloud secrets, pieczęcie). To samo dotyczy webhooków i tokenów API - w repozytorium nie wolno przechowywać żadnych sekretów, bo publiczne repo = skompromitowane dane w ciągu minut od skanu. Dodatkowo warto owinąć wysyłkę w try/except z czasowym backoffem (ile e-maili ma powtórzyć przed porzuceniem) oraz logować jedynie identyfikatory, nigdy treść hasła czy pełną treść wiadomości.

Podsumowując, minimalny lecz kompletny wzorzec: (1) wczytaj sekrety ze środowiska, (2) zbuduj MIMEMultipart z MIMEText (plain + html) i nagłówkami, (3) wywołaj SMTP_SSL ze sprawdzonym kontekstem SSL, login, send_message, quit, (4) obsłuż błędy z retry i logowaniem. Gotowy, działający szablon skryptu znajdziecie w następnych slajdach - jeśli sensownie sparametryzowany (adres, temat, treść), będzie wielokrotnego użytku. Terminologia: smtplib, email.mime, MIMEMultipart, MIMEText, SMTP_SSL, STARTTLS, smarthost (relay SMTP), ssl.create_default_context(), Content-Disposition, attachment (załącznik), secrets management.

Niezależnie od Alertmanagera, bezpośrednia wysyłka e-maila z poziomu skryptu Pythonowego okazuje się przydatna przy generowaniu raportów SLO, podsumowań tygodniowych czy alertów z niestandardowych skryptów monitorujących. Python dostarcza dwie biblioteki standardowe, które wystarczają do tego celu: smtplib do obsługi protokołu SMTP i email.mime do budowy struktury wiadomości z nagłówkami, tekstem i załącznikami, bez żadnych dodatkowych zależności.

Wiadomość buduje się krok po kroku: kontener MIMEMultipart służy jako naczynie dla wersji tekstowej i HTML, do którego dodajemy nagłówki From, To i Subject, a opcjonalnie załączniki w postaci MIMEBase. Wysyłka realizowana jest przez klasę smtplib SMTP_SSL na porcie czterysta sześćdziesiąt pięć lub SMTP z wywołaniem starttls() na porcie pięćset osiemdziesiąt siedem. Bezwzględnie dane uwierzytelniające pobieramy ze zmiennych środowiskowych lub menedżera sekretów, nigdy nie umieszczając ich w kodzie.

Wyjaśnienie skrótów użytych na slajdzie:
smtplib – Python SMTP Protocol Client – biblioteka klienta SMTP w Pythonie; Wbudowany w standardową bibliotekę Pythona moduł do bezpiecznej komunikacji z serwerami pocztowymi.
email – Python Email Package – pakiet obsługi wiadomości e-mail w Pythonie; Biblioteka służąca do konstruowania nagłówków i treści wiadomości wieloczęściowych MIME.
SSL – Secure Sockets Layer – protokół SSL; Warstwa kryptograficzna wykorzystywana w klasie SMTP_SSL do nawiązywania bezpośrednio szyfrowanych połączeń.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Nowoczesny protokół szyfrowania wymuszany poleceniem starttls() w bezpiecznych skryptach.
Port 587 – Submission Port RFC 6409 – standardowy port nadawania poczty; Port sieciowy zarezerwowany dla uwierzytelnionych klientów poczty z wymuszonym szyfrowaniem STARTTLS.

17/55 Gotowe konektory
Gotowe konektory: Alertmanager oferuje wbudowane integracje z komunikatorami i systemami. Webhook (generic) umożliwia tworzenie niestandardowych połączeń z dowolnym systemem.

Nie pisz konektora, który już istnieje: Alertmanager ma gotowce z retry i timeoutami. Webhook zostaw na resztę.

  • Gotowe konektory – Alertmanager oferuje wbudowaną obsługę popularnych platform, takich jak Slack, Discord czy PagerDuty, bez konieczności pisania kodu.
  • Mechanizm ponawiania – fabryczne moduły integracyjne posiadają wbudowane procedury ponowień w razie problemów z łącznością sieciową.
  • Wspólne szablony – pozwalają utrzymać harmonijny układ pól i czytelną kolorystykę we wszystkich wykorzystywanych komunikatorach w firmie.
  • Oszczędność czasu – użycie oficjalnych wtyczek eliminuje potrzebę utrzymywania własnych skryptów i korzysta ze wsparcia społeczności.
  • Ochrona sekretów – tokeny uwierzytelniające i klucze webhooków muszą być bezpiecznie wstrzykiwane i chronione przed wyciekiem w repozytorium.
Generic webhook: Uniwersalny receiver do niestandardowych systemów; obok wbudowanych integracji Alertmanagera ze wspólnymi szablonami Go.
konektory

Gotowe do podłączenia kanały dostarczania alertów w Alertmanagerze to jego cenna cecha: integracje komunikatorów i systemów on-call są wbudowane - do wysłania alertu na Slacka czy do PagerDuty wystarczy odpowiedni blok receivera w YAML z kilkoma parametrami, bez pisania kodu. Gdy żaden gotowy konektor nie pasuje, wchodzi webhook - uniwersalne wyjście HTTP, dzięki któremu podłączysz dowolny system mający API.

Lista wbudowanych kanałów: komunikatory czatu - slack_configs (Slack, przez webhook URL lub token aplikacji), discord_configs (Discord webhook), telegram_configs (bot Telegram API, parse_mode, chat_id), msteams_configs (Microsoft Teams webhook z adaptive cards), hipchat/mattermost (rzadsze). On-call / Incident Management - pagerduty_configs (API v2, severity, dedup_key), opsgenie_configs (ApiKey, priority, tags), victorops_configs (Splunk On-Call, routing key, message type). Klasyka - email_configs (SMTP), webhook_configs (generic HTTP POST), pushover_configs (push do smartfona), sns (AWS SNS). Każdy konektor ma własny, specyficzny zestaw pól - wspólną cechą jest pole send_resolved (czy wysyłać powiadomienie, gdy alert przejdzie w resolved).

Webhook (generic): najważniejszy konektor dla integracji custom. Działa tak: Alertmanager robi HTTP POST z JSON-em do wskazanego URL, a JSON zawiera pełny stan alertu (status, labels, annotations, startsAt, generatorURL). Konfiguracja to kilka linii: webhook_configs: - url: "https://moj-system/api/alerts" i opcjonalnie headers/send_resolved. Na tej podstawie zbudujesz integracje z Jirą (tworzenie ticketu), ServiceNow (rejestracja incydentu), slack można robić przez webhook (bo to też HTTP), a także z własnymi botami albo automatyką (np. uruchomienie skryptu naprawczego). Dzięki temu Alertmanager staje się "szyną integracyjną" całej organizacji.

Konfiguracja w praktyce: wszystkie konektory grupuje się w sekcji receivers pliku alertmanager.yml. Każdy receiver ma unikalną nazwę (np. name: "slack-prod") i co najmniej jeden rodzaj konfiguracji. Receiver jest adresatem w trasie route tree - trasa kieruje alerty grup do receivera, a receiver wie, dokąd je wypchnąć. O tej samej wiadomości można wysłać do wielu kanałów jednocześnie, definiując w receiverze kilka integracji (np. slack_configs + pagerduty_configs razem) - to podstawa podejścia multi-channel dla alertów krytycznych. Formatowanie treści realizujemy szablonami Go (.tmpl) wspólnymi dla wszystkich kanałów, dzięki czemu wiadomości wyglądają spójnie niezależnie od kanału.

Zasada "buy vs build": korzystaj z gotowych konektorów tam, gdzie to możliwe - są utrzymywane przez społeczność, mają obsługę retry, timeoutów i resendów, a Ty dostajesz je "za darmo". Webhooka używaj wtedy, gdy potrzebujesz niestandardowego odbiorcy lub też gdy chcesz sam kontrolować transformację payloadu (np. dodać własne pola). Pamiętaj, że każdy URL/webhook odbiorcy to potencjalny sekret (np. Slack webhook URL = token) - trzymaj go w secret management, nie w otwartym configu. Terminologia: receiver (odbiorca), connector/integration (konektor/integracja), webhook (generic HTTP callback), send_resolved, parse_mode, channel override, adaptive cards, API key, routing key.

Siła Alertmanagera tknie w bogatym zestawie wbudowanych integracji umożliwiających natychmiastowe podłączenie popularnych systemów bez pisania kodu. Każdy gotowy konektor ma własny zestaw parametrów, ale wszystkie łączy wspólny interfejs w sekcji receivers pliku alertmanager.yml, a treść powiadomień formatowana jest wspólnymi szablonami Go, co zapewnia spójny wygląd niezależnie od kanału docelowego.

Na liście kanałów znajdziemy komunikatory czatu - Slack, Discord, Telegram - systemy zarządzania incydentami, w tym PagerDuty z mapowaniem severity i OpsGenie z priorytetami, a także pocztę elektroniczną i uniwersalny webhook umożliwiający połączenie z dowolnym systemem posiadającym interfejs HTTP. Każdy konfigurator posiada flagę send_resolved decydującą, czy wysłać powiadomienie o zakończeniu incydentu. Korzystaj z gotowych konektorów tam, gdzie to możliwe, a webhooka rezerwuj dla integracji niestandardowych.

Wyjaśnienie skrótów użytych na slajdzie:
PagerDuty – PagerDuty Incident Response Platform – platforma zarządzania incydentami PagerDuty; Komercyjny lider w obszarze automatyzacji dyżurów inżynierskich i wybudzania personelu.
Opsgenie – Atlassian Opsgenie – platforma reagowania na incydenty Opsgenie; Rozwiązanie firmy Atlassian integrujące alerty z harmonogramami dyżurów i powiadomieniami telefonicznymi.
VictorOps – Splunk On-Call (VictorOps) – platforma Splunk On-Call; Narzędzie wspierające kulturę DevOps i transparentne przekazywanie wiedzy o awariach w zespołach.
Webhook – Generic HTTP Webhook Receiver – uniwersalny odbiorca webhooków; Elastyczny mechanizm integracji Alertmanagera z dowolnym systemem przyjmującym żądania HTTP.
API – Application Programming Interface – interfejs programistyczny; Kanał programowej wymiany informacji o stanie awarii pomiędzy platformami operacyjnymi.

18/55 Projektowanie reguł alertów
Projektowanie reguł alertów: "Alert Engineering" jako dyscyplina - unikanie fałszywych alarmów (threshold tuning, baseline-aware), testowanie reguł (unit/integration/chaos), staging (warning→critical), dokumentacja (runbook_url).

Reguła ma wołać dokładnie wtedy, gdy trzeba: progi z danych, testy przed produkcją i droga warning→critical.

  • Grafiki dyżurów on-call – dedykowane systemy zarządzają kalendarzami inżynierów, kierując nocne telefony wyłącznie do osoby pełniącej wartę.
  • Omijanie wyciszenia – wyspecjalizowane aplikacje mobilne potrafią wymusić głośny dzwonek w telefonie nawet w aktywnym trybie 'nie przeszkadzać'.
  • Potwierdzenie ack – dyżurny jednym kliknięciem potwierdza przyjęcie zgłoszenia, co natychmiast zatrzymuje dalszą eskalację do przełożonych.
  • Płynne przekazanie warty – automatyczna synchronizacja z kalendarzem ułatwia sprawiedliwe planowanie dyżurów i przekazywanie dyżuru.
  • Raporty obciążenia – rejestrowanie nocnych pobudek pozwala kadrze technicznej monitorować poziom zmęczenia inżynierów i chronić ich zdrowie.
Threshold tuning: Strojenie progów względem baselinu; z testami reguł (unit/integration/chaos), stagingiem warning→critical i runbookiem - dyscyplina Alert Engineering.
progi

Alerting na proste progi procentowe charakteryzuje się dylematem: krótki czas wykrywania generuje fałszywe alarmy, a długi czas powoduje zbyt późne powiadomienie. Standardem inżynierii SRE opracowanym w monografii Google SRE Workbook jest podejście Multi-Window Multi-Burn-Rate:
- Alert natychmiastowy (Page): Burn Rate równy 14,4 w oknie 1h oraz w oknie 5m (wyczerpanie 2% budżetu w godzinę),
- Alert średnioterminowy (Ticket): Burn Rate równy 6 w oknie 6h oraz w oknie 30m (wyczerpanie 5% budżetu w 6 godzin),
- Warunek dwuokienny eliminuje fałszywe alarmy po ustąpieniu chwilowych zakłóceń, zachowując natychmiastową reakcję na poważne awarie.

Kodeks dobrych praktyk projektowania reguł alertów obejmuje: unikanie fałszywych alarmów (threshold tuning, baseline-aware), testowanie (unit tests dla reguł, integration tests, chaos testing), staging alerts (warning → critical) i dokumentację (runbook_url) - to "Alert Engineering" jako dyscyplina. Terminologia: false positive, threshold tuning, baseline, staging alert, runbook.

Unikanie fałszywych alarmów: threshold tuning (statystyczne progi, nie magic numbers), baseline-aware (sezonowość, trendy), lookback window (ile historii brać pod uwagę). Nie ustawiaj progu "na oko" - użyj danych historycznych (p99, p99.9). Baseline = normal behavior.

Testowanie reguł: unit tests (unit tests dla reguł: `promtool test rules`), integration tests (deploy do staging, generuj syntetyczne alerty), chaos testing (chaos engineering weryfikuje alerty). Recording rules pre-compute = szybkie alerty. Testowane reguły = pewność.

Staging alerts: warning (warning) → critical (critical) progression. Warning = early warning, critical = action required. Staging = bezpieczne wdrożenie nowych reguł. Documentation: runbook_url w adnotacjach = operator ma procedurę pod ręką. Runbook = procedura krok po kroku.

Terminologia: false positive (fałszywy alarm), threshold tuning (dostrajanie progów), baseline (linia bazowa), staging alert (alert stagingowy), runbook (instrukcja obsługi).

Napisanie reguły alertowej to dopiero początek - prawdziwym wyzwaniem jest zaprojektowanie jej tak, by wywoływała alarm dokładnie wtedy, gdy jest potrzebny, a nie przy każdym chwilowym wahaniu metryki. Dlatego w inżynierii SRE wyodrębniono dyscyplinę zwaną Alert Engineering, łączącą metody statystyczne, testowanie reguł i dokumentację proceduralną w spójny zestaw dobrych praktyk, pozwalających budować alertowanie czułe na realne problemy i jednocześnie odporne na fałszywe alarmy.

Podstawowym narzędziem jest dostrajanie progów, tzw. threshold tuning, na podstawie danych historycznych - zamiast arbitralnych magicznych liczb stosuje się percentyle p99 lub p99.9 oraz progi uwzględniające sezonowość, zwane baseline-aware. Przed wdrożeniem do produkcji reguły poddaje się testom jednostkowym za pomocą promtool test rules, a następnie testom integracyjnym w środowisku staging. Nowe reguły wprowadza się stopniowo, od warning do critical, a każdy alert musi posiadać w adnotacji link do runbook_url, czyli procedury krok po kroku.

Wyjaśnienie skrótów użytych na slajdzie:
MultiWindow – Multi-Window Alerting Strategy – strategia alertingu wielookresowego; Metoda łączenia krótkiego i długiego okna czasowego eliminująca fałszywe alarmy.
MultiBurnRate – Multi-Burn-Rate Alerting – alerting wielokrotnego tempa spalania; Zaawansowany algorytm alarmowania proporcjonalny do tempa wyczerpywania budżetu błędów.
SLO – Service Level Objective – cel poziomu usług; Punkt odniesienia wyznaczający krytyczność i dynamikę zużywania marginesu niezawodności.
SLI – Service Level Indicator – wskaźnik poziomu usług; Bezpośrednia metryka pomiarowa leżąca u podstaw wyliczania tempa spalania budżetu.
EB – Error Budget – budżet błędów; Dopuszczalna pula awarii; alarmowanie następuje po przekroczeniu krytycznego tempa jej wyczerpywania.

19/55 Alerting wielopoziomowy
Alerting wielopoziomowy: Mapowanie severity na kanały powiadomień: critical → PagerDuty/Phone (immediate), warning → Slack/Email (ticket), info → log only. Routing rules per severity determinują response time.

Nie każdy alert budzi: critical dzwoni, warning pisze, info loguje. Severity mapujesz na kanał i czas.

  • Generyczny webhook – uniwersalny odbiorca HTTP przesyła ustrukturyzowane obiekty JSON do dowolnego zewnętrznego serwera sieciowego.
  • Integracja z ticketami – umożliwia samoczynne tworzenie zadań w systemach Jira lub ServiceNow natychmiast po zarejestrowaniu problemu.
  • Automatyczna remediacja – mikroserwisy odbierające webhooki mogą uruchamiać skrypty naprawcze, takie jak restart podów lub czyszczenie dysków.
  • Uwierzytelnianie zapytań – punkty końcowe webhooków muszą weryfikować podpisy cyfrowe, zapobiegając złośliwemu manipulowaniu infrastrukturą.
  • Elastyczność ekosystemu – mechanizm pozwala na bezproblemowe połączenie monitoringu z dowolnym własnym narzędziem wewnętrznym firmy.
Mapowanie severity: critical → PagerDuty/telefon (natychmiast), warning → Slack/e-mail (ticket), info → tylko log; reguły routingu wyznaczają czas reakcji.
poziomy

Wielopoziomowy alerting rozróżnia poziomy severity (critical, warning, info) i mapuje je na kanały (critical → PagerDuty/Phone, warning → Slack/Email, info → log) oraz priorytety reakcji (SLA per severity) przez routing rules per severity. Terminologia: severity, priority, routing tree, notification policy, escalation.

Poziomy severity: critical (SEV-1/2, page immediately), warning (SEV-2/3, ticket + Slack), info (SEV-4, log only). Mapowanie: critical → PagerDuty/Phone (immediate), warning → Slack/Email (ticket), info → log only. To eliminuje noise dla on-call.

Priorytety reakcji: Critical = page now (5 min ack), Warning = ticket + Slack (1h ack), Info = log only (brak alertu). Routing rules per severity: critical → PagerDuty + Slack, warning → Slack + Email, info → log only. To determinuje response time per severity.

Terminologia: severity (poziom ważności), priority (priorytet), routing tree (drzewo routingu), notification policy (polityka powiadomień), escalation (eskalacja).

Nie każdy alert jest tak samo pilny - awaria kompletnej niedostępności wymaga natychmiastowej reakcji z budzeniem zespołu, podczas gdy chwilowe przekroczenie progu zużycia pamięci może zaczekać do następnego dnia. Wielopoziomowy system alertowania rozwiązuje ten problem, mapując poziom ważności alertu na odpowiedni kanał powiadomienia i przypisując każdemu poziomowi konkretny czas reakcji, eliminując zarówno przestoje, jak i niepotrzebne wybudzanie operatorów.

Mapowanie realizuje się przez routing tree, gdzie reguły dopasowują etykietę severity i kierują alerty do odpowiednich receiverów - severity=critical trafia do PagerDuty z powiadomieniem telefonicznym, severity=warning na Slack i pocztę, a severity=info jedynie do logów. Przypisane SLA wyznaczają sztywne ramy czasowe: SEV-1 wymaga potwierdzenia w ciągu piętnastu minut i rozwiązania w ciągu godziny, SEV-2 pozwala na trzydzieści minut do ack i cztery godziny do naprawy, a SEV-3 daje godzinę na ack i dwadzieścia cztery godziny na stabilizację.

Wyjaśnienie skrótów użytych na slajdzie:
Warning – Warning Alert Severity – ostrzegawczy stopień krytyczności; Poziom sygnalizujący zbliżanie się do limitów zasobów, niegenerujący natychmiastowego budzenia ludzi.
Critical – Critical Alert Severity – krytyczny stopień ważności; Poziom oznaczający poważne naruszenie funkcji usługi, wymagający natychmiastowej reakcji inżyniera.
Disaster – Disaster Alert Severity – katastrofalny stopień awarii; Całkowita niedostępność całego centrum danych lub systemu płatności wzywająca wszystkie zespoły SRE.
Page – Paging Alert Routing – ścieżka wezwania natychmiastowego; Kierowanie powiadomień na telefony dyżurnych dla alertów o statusie Critical.
Ticket – Ticketing Alert Routing – ścieżka rejestracji zgłoszenia; Automatyczne zakładanie zadań w kolejce dla alertów o statusie Warning.

20/55 Związek alertów z SLO
Związek alertów z SLO: SLO-driven alerting - alertowanie na ryzyko naruszenia SLO (burn rate alerting). Multi-window burn rate (fast/slow) pozwala na precyzyjne wykrywanie problemów z error budget.

Progi metryk nie widzą biznesu; burn rate tak. Wołaj o tempo jedzenia budżetu, nie o liczbę.

  • Tempo wypalania burn rate – nowoczesny alerting SRE bazuje na tempie konsumpcji budżetu błędów wyliczanym z celów jakościowych SLO.
  • Wady alertów progowych – tradycyjne progi generują zbyt wiele fałszywych alarmów przy chwilowych pikach lub przegapiają powolne wycieki.
  • Ochrona użytkowników – monitorowanie budżetu błędów skupia uwagę zespołu wyłącznie na zjawiskach, które realnie zagrażają obietnicom SLA.
  • Mnożnik konsumpcji – wskaźnik określa, ile razy szybciej niż dopuszczalny limit dany incydent pochłania margines niedostępności serwisu.
  • Priorytety biznesowe – powiązanie alertów z celami platformy pozwala inżynierom podejmować decyzje w oparciu o realny wpływ na klientów.
Burn rate alerting: Alertowanie na tempo spalania budżetu błędów (multi-window fast/slow) zamiast na statyczne progi metryk.
alert SLO
Alerting na podstawie Burn Rate (tempu wypalania budżetu): Wyobraź sobie, że Twoje SLO wynosi 99,9% dostępności w miesiącu. Twój budżet błędów to 0,1% zapytań (około 43 minuty przestoju). Jeśli wystąpiła nagła katastrofa i wypalasz 100% budżetu w godzinę (burn rate = 14.4x), alert musi zadzwonić natychmiast na telefon dyżurnego! Jeśli jednak usterka wypala budżet w tempie 2% na dobę (burn rate = 2x), budzenie człowieka w nocy jest błędem – taki alert powinien utworzyć ticket w Jira na kolejny dzień roboczy.

Wielookresowe tempo spalania budżetu (Multi-Window Multi-Burn-Rate) pozwala precyzyjnie powiązać alerty ze wskaźnikami SLO i budżetem błędów.

Alerty łączą się z SLO przez alerty o ryzyku naruszenia SLO (burn rate alerting), multi-window burn rate (fast/slow) i alert na error budget consumption - SLO-driven alerting znaczy mniej fałszywych alarmów. Terminologia: SLO alert, burn rate, error budget, multi-window burn rate, SLO compliance.

Burn rate alerting: error budget consumption rate. Fast burn: 2% budget/1h = page, slow burn: 10% budget/6h = ticket. Multi-window: 1h/6h/24h windows = różne wrażliwości. Alert na SLI breach = precision.

Error budget consumption: SLI vs SLO → error budget remaining. Alert gdy budget < 10% (warning), < 1% (critical). Alert na budget consumption = proactive. SLO-driven alerting eliminuje static threshold problems.

Terminologia: SLO alert (alert SLO), burn rate (tempo spływania budżetu), error budget (budżet błędu), multi-window burn rate (wielookienkowy burn rate), SLO compliance (zgodność z SLO).

Tradycyjne alertowanie na statyczne progi metryk ma poważną wadę - nie uwzględnia kontekstu biznesowego, to znaczy tego, ile budżetu błędów jeszcze pozostało i jak szybko się on wyczerpuje. SLO-driven alerting przenosi punkt ciężkości z poziomu pojedynczej metryki na tempo spalania error budget, czyli tzw. burn rate, co pozwala wykrywać nie tylko nagłe awarie, ale także powolne pogarszanie się jakości usługi, które przy tradycyjnych progach mogłoby pozostać niezauważone.

Burn rate definiuje się jako stosunek aktualnego tempa błędów do tego, co przewiduje SLO - przy SLO dziewięćdziesięciu dziewięciu dziewięciu procent burn rate równy jeden oznacza prawidłowe spalanie budżetu, wyższy zaś ekstremalnie szybkie wyczerpywanie zapasu. Implementacja wielookienkowa operuje na przedziałach jednej i sześciu godzin: szybkie spalanie w oknie jednej godziny, na przykład utrata dwóch procent budżetu, wywołuje alert krytyczny, a wolne spalanie w oknie sześciu godzin generuje jedynie ostrzeżenie w formie ticketu.

Wyjaśnienie skrótów użytych na slajdzie:
SLO – Service Level Objective – cel poziomu usług; Kluczowy cel inżynierski stanowiący jedyne uzasadnienie dla uruchamiania nocnych procedur alarmowych.
BurnRate – Burn Rate Consumption Index – wskaźnik tempa spalania budżetu; Mnożnik określający jak szybko usługa zmierza do całkowitego wyczerpania budżetu błędów.
EB – Error Budget – budżet błędów; Waluta inżynierska; powiadomienia alarmowe chronią przed jej całkowitym wyzerowaniem.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina techniczna eliminująca alerty niemające bezpośredniego związku z celem SLO.
Freeze – Production Release Freeze – zamrożenie wdrożeń produkcyjnych; Decyzja organizacyjna wymuszana automatycznie po wyczerpaniu budżetu błędów sygnalizowanym w alertach.

21/55 Alerty a on-call
Alerty a on-call: Alertowanie jest fundamentem systemu on-call - routing alertów do dyżurnych, eskalacja w razie braku ACK, zastępstwa (override/handover) i compensacja za dyżury.

Alert bez człowieka nic nie naprawia. On-call to rotacje, eskalacje, zastępstwa i uczciwa zapłata.

  • Wielookienkowa kontrola – metoda łączy krótkie i długie przedziały czasu, skutecznie eliminując fałszywe powiadomienia alarmowe.
  • Krótkie okno czasowe – pozwala na błyskawiczne wykrycie katastrofalnej awarii, która mogłaby pochłonąć cały budżet w ciągu kilku godzin.
  • Długie okno czasowe – upewnia się, że problem nadal występuje, zapobiegając budzeniu dyżurnego z powodu krótkotrwałej fluktuacji w sieci.
  • Wielopoziomowe alerty – zróżnicowanie progów tempa wypalania pozwala odróżnić incydent krytyczny od usterki do naprawy w dzień roboczy.
  • Standard branżowy Google – podejście wielookienkowe opisane w podręcznikach SRE eliminuje wszystkie wady tradycyjnego monitoringu progowego.
Override/handover: Zastępstwa i przekazania dyżurów; z routingiem do dyżurnych, eskalacją bez ACK i rekompensatą - ludzka strona alertingu.
on-call

Alerty łączą się z on-call przez powiadomienia dyżurnego (routing, escalation), zastępstwa (override, handover), on-call rotation (weekly, bi-weekly) i compensation; runbook jest dostępny w adnotacjach. Terminologia: on-call, rotation, escalation, override, handover, compensation.

Powiadomienia dyżurnego - routing + escalation: Alertmanager route tree → receiver → on-call. Grouping by team/service. Escalation: if no ack in 15 min → L2. Rotation: weekly/bi-weekly, follow-the-sun. On-call = first responder.

Zastępstwa - override & handover: Override (temporary takeover), Handover (przekazanie kontekstu: runbook link, current incidents, context). Schedule overrides = planned coverage. Override = ad-hoc, handover = planned. Alertmanager silences = wyciszenie dla override.

Compensation: on-call pay, time off in lieu, recognition. Fair compensation = retention. Terminologia: on-call (dyżurny), rotation (rotacja), escalation (eskalacja), override (nadpisanie), handover (przekazanie), compensation (wynagrodzenie za dyżury).

Alert sam w sobie nic nie naprawia - swoją wartość realizuje dopiero wtedy, gdy trafi do odpowiedniej osoby, w odpowiednim czasie i z odpowiednim kontekstem. Projektowanie systemu on-call, łączącego alerting z ludzką organizacją pracy, stanowi nieodzowny element strategii niezawodności, a kluczowe zagadnienia to rotacja dyżurnych, mechanizmy eskalacji, zastępstwa w razie nieobecności oraz sprawiedliwy system rekompensaty za dodatkowe obciążenie poza godzinami służbowymi.

Alertmanager route tree kieruje alerty do receiverów powiązanych z konkretnymi zespołami i rotacjami, a eskalacja czasowa zapewnia, że brak potwierdzenia w ciągu piętnastu minut automatycznie przekazuje alert do wyższego poziomu. Rotacja odbywa się w cyklach tygodniowych lub dwutygodniowych, a w organizacjach globalnych stosuje się model follow-the-sun. Zastępstwa realizowane są na dwa sposoby: override, czyli tymczasowe przejęcie dyżuru, i handover, czyli formalne przekazanie kontekstu z aktualnymi incydentami i runbookami.

Wyjaśnienie skrótów użytych na slajdzie:
On-call – On-call Duty Roster – grafik dyżurów alarmowych; Formalny harmonogram określający inżyniera pierwszego kontaktu odpowiedzialnego za infrastrukturę.
Rotation – On-call Team Rotation – rotacja personelu dyżurnego; Cykliczna zmiana ról w zespole inżynierskim zapobiegająca przeciążeniu pojedynczych pracowników.
Shift – On-call Working Shift – zmiana dyżurowa; Ściśle zdefiniowany przedział czasu (np. 12 godzin lub tydzień), w którym inżynier pozostaje w ciągłej gotowości.
FollowTheSun – Follow-the-Sun Global Support – model wsparcia podążającego za słońcem; Międzynarodowa organizacja pracy przekazująca dyżury pomiędzy zespołami w różnych strefach czasowych w dzień.
Handover – Shift Handover Meeting – przekazanie dyżuru; Formalne spotkanie zdające dyżur, na którym omawia się aktywne wyciszenia i incydenty z minionej zmiany.

22/55 Reakcja na alert
Reakcja na alert: Proces incident response: triage → diagnosis → mitigation → fix → documentation. ACK (acknowledgment) w Alertmanagerze potwierdza odbiór alertu przez on-call.

Alert to start, nie meta: triage, diagnoza, mitigacja, fix i dokumentacja. Pierwszy krok ma nazwę ACK.

  • Odsetek błędów HTTP – skuteczna reguła bada stosunek nieudanych odpowiedzi 5xx do całkowitego wolumenu zapytań trafiających do serwisu.
  • Wysokie percentyle – monitorowanie opóźnień powinno bazować na miarach p95 i p99, które precyzyjnie ujawniają problemy pojedynczych użytkowników.
  • Złudzenie średniej – poleganie na średniej arytmetycznej maskuje powolne działanie systemu u klientów oczekujących najdłużej na odpowiedź.
  • Zmienność dobowa ruchu – reguły PromQL powinny dynamicznie uwzględniać profil dobowy, unikając sztywnych progów w godzinach nocnych.
  • Filtrowanie testów – każda reguła musi posiadać etykiety filtrujące sztuczny ruch generowany przez audyty bezpieczeństwa i skanery podatności.
ACK (acknowledgment): Potwierdzenie odbioru alertu przez dyżurnego; początek łańcucha triage → diagnoza → mitigacja → fix → dokumentacja.
proces reakcji

Proces reakcji na alert (incident response) składa się z analizy (triage, diagnosis), podjęcia działań (mitigation, fix) i dokumentacji (incident timeline, runbook update), a acknowledgment (ACK) w Alertmanagerze potwierdza przejęcie alertu. Terminologia: ack, incident response, triage, mitigation, runbook, timeline.

Zawężenie zakresu: Top-down approach. Global symptom (latency spike) → which service? (topk error rate) → which endpoint? (topk latency per handler) → which instance? (per-instance metrics). Scope reduction = faster isolation. Binary search w logach (time-range narrowing).

Sprawdzenie metryk i logów: Metrics-first (latency p99, error rate, saturation) → Logs-second (errors, stack traces, correlation). Metrics = WHAT/WHERE, Logs = WHY. Time-range alignment = critical (same time window). Grafana Explore split view = metrics + logs side-by-side.

Postawienie hipotezy: Hypothesis = educated guess based on evidence. "CPU spike → GC pressure" vs "CPU spike → thread pool exhaustion". Hypothesis = testable prediction. Falsifiability = scientific method.

Weryfikacja i naprawa: Test hypothesis (scale, restart, config fix, code fix) → observe metrics → confirm resolution → document (runbook update). Verification = metrics return to baseline. Post-fix monitoring = ensure no regression. Runbook = codified knowledge.

Terminologia: troubleshoot (diagnozowanie), hypothesis testing (testowanie hipotez), scientific method (metoda naukowa), RCA (root cause analysis).

Otrzymanie alertu to nie koniec procesu, lecz jego początek - operator musi przejść od powiadomienia do zrozumienia problemu, podjęcia działań zaradczych i udokumentowania przebiegu, by uniknąć podobnych sytuacji w przyszłości. Strukturalny proces reakcji na alert, obejmujący triage, diagnozę, mitigację i dokumentację, zamienia doraźne usuwanie usterek w uporządkowaną praktykę operacyjną, a potwierdzenie odbioru alertu, zwane ACK, w Alertmanagerze jest pierwszym formalnym krokiem tego procesu.

Początkowa analiza podąża podejściem top-down: od globalnego objawu przez identyfikację usługi, potem endpointu, aż po konkretną instancję, co pozwala zawęzić zakres poszukiwań. Następnie łączy się metryki z logami - metryki wskazują co i gdzie, logi odpowiadają dlaczego - a wspólny zakres czasu umożliwia korelację bez przełączania narzędzi. Na tej podstawie formułuje się hipotezę, weryfikuje ją testowo, obserwuje powrót metryk do linii bazowej i dokumentuje przebieg incydentu wraz z aktualizacją runbooka.

Wyjaśnienie skrótów użytych na slajdzie:
Ack – Acknowledge Action – potwierdzenie przyjęcia wezwania; Czynność inżyniera dyżurnego informująca system i zespół, że ktoś podjął już pracę nad incydentem.
Acknowledge – Incident Acknowledgment State – stan potwierdzenia zgłoszenia; Status wstrzymujący dalsze próby eskalacji do kolejnych inżynierów z listy.
Triage – Incident Triage Process – wstępna segregacja incydentu; Szybka ocena skali awarii i weryfikacja czy problem dotyczy krytycznego komponentu produkcyjnego.
Runbook – Emergency Operational Runbook – awaryjna instrukcja operacyjna; Pierwsze źródło wiedzy inżyniera otwierane natychmiast po potwierdzeniu odebrania powiadomienia.
WarRoom – Virtual Incident War Room – wirtualny pokój kryzysowy; Dedykowany kanał komunikacyjny uruchamiany w celu koordynacji działań wielu inżynierów podczas dużej awarii.

23/55 Zmniejszanie szumu w praktyce
Zmniejszanie szumu w praktyce: Alert hygiene to ciągły proces - usuwanie zbędnych alertów (dead alerts), dostosowywanie progów (threshold tuning), iteracyjna poprawa na podstawie feedbacku od on-call.

Alerting gnije bez pielęgnacji: fałszywki rosną, prawdziwe giną. Higiena to comiesięczny rytuał, nie projekt.

  • Prognoza zapełnienia dysku – powiadomienia o braku wolnej przestrzeni powinny bazować na przewidywanym czasie do zapełnienia partycji.
  • Funkcja predict_linear – liniowa ekstrapolacja danych pozwala ostrzec zespół z wielodniowym wyprzedzeniem, zapobiegając nagłej awarii bazy.
  • Zużycie pamięci RAM – w środowisku Linux wysokie zużycie wynika z buforowania operacji dyskowych i wymaga badania faktycznego braku pamięci.
  • Nasycenie interfejsów sieciowych – badanie liczby odrzuconych pakietów i utraconych ramek pozwala szybko namierzyć awarie okablowania i switchy.
  • Kolejka zadań procesora – alert o wysokim obciążeniu CPU powinien badać długość kolejki Load Average, wskazującej na rzeczywiste dławienie.
Dead alerts: Martwe reguły, które nigdy nie strzelają; alert hygiene to ich usuwanie, strojenie progów i poprawki z feedbacku on-call.
porządkowanie

Wyciszanie (Silencing) w interfejsie Alertmanagera pozwala zaplanować okna serwisowe bez wyzwalania zbędnych alarmów. Równie istotne są reguły hamowania (inhibit_rules), które automatycznie wyciszają alerty niższego rzędu (np. błędy aplikacji), jeśli aktywny jest alert nadrzędny (np. brak łączności z całym węzłem lub przełącznikiem).

Zmniejszanie szumu alertów (alert hygiene) to usuwanie zbędnych reguł (dead alerts, low-value alerts), dostosowywanie progów (threshold tuning, dynamic thresholds) i ciągły proces utrzymania czystego alertingu. Terminologia: alert hygiene, noise reduction, threshold tuning, dead alert, alert fatigue prevention.

Brak zmiennych - hardcoded values: Hardcoded instance/job w zapytaniach - dashboard tylko dla jednego hosta; variables = reusability; templating required. Hardcoded = "dashboard dla web-01" zamiast "dashboard dla WSZYSTKICH web". Variables = jeden dashboard, setki wariantów (instance, job, env). Templating required = standard produkcyjny.

Szum na pulpicie - cognitive overload: 30+ paneli, brak hierarchii (critical nie na górze), wszystkie metryki na raz - cognitive overload (Miller's law: 7±2). Focus na actionable (co wymaga DECYZJI), nie na wszystko. Less is more = 5-15 paneli max, hierarchy (critical top), focus = decyzyjne w sekundy.

Brak kontaktu z zespołem - user-centered design: Dashboard zbudowany w izolacji (dev robi sam, nie pyta on-call) - nie odpowiada na potrzeby on-call (alert context), dev (debug context), mgmt (business view). Review z użytkownikami (on-call walkthrough, dev feedback, mgmt sign-off) = user-centered design. Brak kontaktu = dashboard nikogo nie służy.

Porady praktyczne - iterative dashboard development: Zacznij od pytań (co chcemy wiedzieć? jakie decyzje podejmujemy?), zbuduj minimalny (MVP: 3-5 paneli critical), iteruj (dodawaj panele po jednym na podstawie feedbacku), zbieramy feedback (on-call retro, dev survey, mgmt sign-off), wersjonuj w Git (GitOps). Iterative dashboard development = nie buduj "idealny" od razu, buduj użyteczny i ewoluuj.

Dotychczas poznaliśmy zasady konstrukcji reguł alertowych, ich grupowanie i kierowanie do właściwych kanałów powiadomień, ale żaden system nie działa bez stałej pielęgnacji - nawet najlepiej zaprojektowany alerting z czasem się zużywa, generując coraz więcej fałszywych alarmów i maskując realne problemy. Alert hygiene, czyli higiena alertowania, to nie jednorazowy projekt, lecz ciągły proces, który wymaga regularnego przeglądu, usuwania martwych reguł i iteracyjnego dostosowywania progów do zmieniającego się ruchu i infrastruktury.

W praktyce oznacza to identyfikację tzw. dead alerts, czyli reguł, które przez miesiące nie wyzwoliły żadnego użytecznego alarmu, a także korygowanie progów na podstawie danych historycznych - percentyli p95 i p99 - zamiast ustalania wartości «na oko». Kluczowe jest również wersjonowanie reguł w repozytorium Git, dzięki czemu każdą zmianę można prześledzić i wycofać, oraz regularne zebrania zespołu, na których analizujemy wolumen alertów i zbieramy feedback od dyżurnych operatorów.

Wyjaśnienie skrótów użytych na slajdzie:
Inhibit – Alert Inhibition Feature – funkcja hamowania powiadomień; Mechanizm Alertmanagera tłumiący alerty zależne na podstawie obecności alertu nadrzędnego.
InhibitRule – Inhibit Rule Configuration – konfiguracja reguły hamowania; Wpis w pliku konfiguracyjnym łączący powiadomienie źródłowe (source) z powiadomieniem tłumionym (target).
GroupBy – Group By Routing Directive – dyrektywa grupowania powiadomień; Parametr zapobiegający rozbiciu awarii klastra na setki odrębnych wiadomości tekstowych.
Threshold – Dynamic Alert Threshold – dynamiczny próg alarmowy; Wartość graniczna dopasowująca się do pory dnia lub sezonowości ruchu sieciowego.
Jitter – Alert Evaluation Jitter – losowy rozrzut ewaluacji; Rozproszenie momentu sprawdzania reguł zapobiegające jednoczesnemu obciążeniu serwera monitoringu.

24/55 Studium: nadmiar alertów
Studium: nadmiar alertów: Analiza przyczyn nadmiaru alertów (root cause analysis), iteracyjna poprawa reguł (threshold tuning, grouping, silencing) - praktyczne ćwiczenie na zajęciach (hands-on lab).

Zespół tonie w setkach alertów dziennie i ignoruje nawet krytyczne. Diagnoza: root cause, potem pętla naprawcza.

  • Nadzorowanie maszyny JVM – monitorowanie środowisk Java wymaga nadzorowania czasu trwania przerw wywoływanych przez proces Garbage Collector.
  • Wyczerpanie puli wątków – brak wolnych wątków serwera aplikacyjnego powoduje odrzucanie nowych połączeń mimo niskiego użycia procesora.
  • Pule połączeń bazodanowych – zapełnienie puli blokuje mikroserwisy, zmuszając przychodzące zapytania do oczekiwania w nieskończonych kolejkach.
  • Zliczanie wyjątków w locie – rejestrowanie nagłego skoku nieobsłużonych wyjątków programistycznych pozwala natychmiast namierzyć błędy w nowym kodzie.
  • Współpraca DevOps – alerty aplikacyjne powinny być tworzone w ścisłej współpracy programistów z inżynierami niezawodności.
Root cause analysis: Analiza przyczyny źródłowej nadmiaru alertów; iteracyjna poprawa (progi, grupowanie, wyciszanie) w ćwiczeniu hands-on.
przed/po

Studium przypadku zespołu, którego alerting przestał spełniać swoją rolę: zamiast wskazywać realne incydenty, generował setki powiadomień dziennie, a operatorzy uodpornili się na nie (alert fatigue). To najczęstsza "choroba" dojrzałego środowiska - alerting rośnie latami, reguły się mnożą, progi starej generacji przestają pasować do nowej infrastruktury i nikomu nie chce się tego sprzątać. Droga przechodzi pełną pętlę: analiza przyczyn (root cause analysis) → poprawa reguł → weryfikacja efektu; w części labowej (hands-on) te kroki wykonuje się na żywych danych.

Analiza przyczyn (dlaczego jest za dużo alertów): zbieramy dane z dziennika Alertmanagera i UI i pytamy o 5 prawd: (1) ile alertów faktycznie WYWOŁAŁO akcję incydentu, a ile było nigdy niepotrzebnych? Reguły, które w ciągu roku nie wyzwoliły żadnego użytecznego alertu, to tzw. dead alerts - kandydaci do usunięcia. (2) Czy progi są dopasowane do realnego baselinu pracy (np. alert 24/7 na CPU deweloperskiego klastra, gdzie nocą system stoi bezczynnie)? (3) Czy alerty dotyczą objawów, czy przyczyn (alerty na przyczyny kruche)? (4) Czy alerty mają grupujące matchers, żeby się scalały? (5) Czy alerty mają silences i runbooki, czy są "pustymi strzałami"? Każda z tych odpowiedzi to źródło szumu (noise) lub fałszywych alarmów (false positives).

Poprawa reguł (remediation): na podstawie analizy wykonujemy typowe działania naprawcze: threshold tuning - dostrojenie progów do danych historycznych (percentyle p95/p99, baseliny sezonowe, dynamiczne progi zamiast magicznych liczb); grouping - włączenie agregacji (group_by: [alertname, instance]), by 50 powiadomień o 1 problemie zamieniło się w 1; silencing - planowane maintenance co dwie noce nie może generować eskalujących alarmów, wyciszamy je zamiast tłumić; deduplikacja - upewniamy się, że HA nie duplikuje powiadomień; oraz dodanie runbooków do adnotacji (alert bez runbooka to w gruncie rzeczy alert bez instrukcji obsługi). Celem jest tylko actionable alerts - takich, przy których operator wie, co zrobić w 30 sekund.

Weryfikacja i iteracja: po wdrożeniu zmian mierzymy efekt na dashboardzie (alert volume, liczba powiadomień dziennie, ratio użytecznych vs zignorowanych, MTTA/MTTR). Najlepsze praktyki mówią, że po dobrej akcji sprzątającej liczba powiadomień spada o rząd wielkości (np. z 800 do 30-50 dziennie), a jednocześnie wzrasta wykrywalność realnych problemów - bo szum przestaje zasłaniać sygnał. To proces ciągły: pomiar → analiza → poprawa → weryfikacja (continuous improvement). Alert dyżurny zgłasza "fałszywą przyjemną" na retro → poprawka w review → mniejszy szum w przyszłości. To tzw. alert hygiene jako dyscyplina, a nie jednorazowa akcja.

Ćwiczenie labowe (hands-on): w praktyce wykonacie na klasycznym środowisku Prometheus+Grafana+Alertmanager: (1) uruchomicie planowane obciążenie generujące wiele powiadomień; (2) zrobicie analizę w UI Alertmanagera i w Loki (ile alertów, jakich nazw, jak długo aktywnych); (3) zaproponujecie i wdrożycie poprawki (grupy, progi, silences); (4) ponownie zmierzycie wolumen i porównacie przed/po. Efekt końcowy to udokumentowany dowód, że wdrożone zmiany realnie ograniczyły szum przy zachowaniu (lub poprawie) skuteczności wykrywania. Terminologia: root cause analysis, dead alert, noise, false positive, threshold tuning, grouping, silencing, alert hygiene, iterative improvement, before/after.

Przeanalizowaliśmy teoretyczne zasady redukcji szumu alertowego, ale dopiero konkretny przypadek zespołu, którego alerting przestał spełniać swoją rolę, pokazuje realną skalę problemu - zamiast wskazywać incydenty, system generuje setki powiadomień dziennie, a uodpornieni operatorzy zaczynają ignorować nawet krytyczne alarmy. Ten stan, powszechnie nazywany alert fatigue, jest najczęstszą «chorobą» dojrzałych środowisk, w których reguły mnożą się latami bez przeglądu, a progi starej generacji nie pasują do nowej infrastruktury.

Na kolejnych krokach przejdziemy pełną pętlę naprawczą: od root cause analysis - analizy, ile alertów faktycznie wywołało akcję, a ile było nigdy niepotrzebnych - przez dostrojenie progów, włączenie grupowania i planowe wyciszanie, aż po weryfikację efektu na dashboardzie wolumenu alertów. Ćwiczenie laboratoryjne pozwoli Państwu na żywych danych sprawdzić, czy wprowadzone zmiany realnie ograniczyły szum przy zachowaniu lub poprawie skuteczności wykrywania problemów.

Wyjaśnienie skrótów użytych na slajdzie:
AlertFatigue – Alert Fatigue Phenomenon – zespół zmęczenia alertami; Patologiczny stan operacyjny, w którym inżynierowie przestają reagować na sygnały dźwiękowe pagera.
Burnout – Engineer Occupational Burnout – wypalenie zawodowe inżyniera; Skutek przewlekłego stresu wywołanego nocnymi pobudkami przez fałszywe powiadomienia.
IgnoredAlerts – Ignored Alarm Signals – ignorowane sygnały alarmowe; Sytuacja kryzysowa, w której rzeczywista awaria zostaje zignorowana jako kolejny 'fałszywy alarm'.
Snooze – Indiscriminate Alert Snooze – bezrefleksyjne odkładanie alertu; Niewłaściwa praktyka wyciszania powiadomień bez zbadania i usunięcia pierwotnej przyczyny usterki.
Disaster – Major Production Disaster – katastrofalna awaria produkcyjna; Nieunikniony finał utrzymywania zaszumionego i nieskutecznego systemu monitoringu.

25/55 Integracja alertów z logami
Integracja alertów z logami: Przekazywanie kontekstu (trace_id, span_id, request_id) między alertami a logami. Log-based alerts (LogQL w Loki) i korelacja metrics→logs dla szybszej diagnozy.

Metryki wołają co i gdzie, logi dopowiadają dlaczego. Wzbogać alert o ID, a diagnoza to jeden klik.

  • Pętla awarii kontenera – stan CrashLoopBackOff wskazuje na powtarzające się błędy uruchomienia procesu, brak konfiguracji lub błąd bazy.
  • Brak gotowości węzła – status NodeNotReady wymaga natychmiastowej interwencji, gdyż zmusza orkiestrator do ewakuacji podów na inne maszyny.
  • Przekroczenie limitu pamięci – alerty ostrzegające o zbliżaniu się zużycia RAM do limitu chronią proces przed natychmiastowym zabiciem OOMKilled.
  • Niezgodność liczby replik – należy stale kontrolować, czy liczba zdrowych instancji w klastrze odpowiada stanowi zadeklarowanemu w manifeście YAML.
  • Metryki kube-state-metrics – dostarczają bezcennych informacji o kondycji obiektów wdrożeniowych, wolumenów i usług wewnątrz klastra.
Log-based alerts: Alerty z zapytań LogQL w Loki; kontekst (trace_id, span_id, request_id) i korelacja metrics→logs skracają diagnozę.
log a alert

Alerting łączy się z logami: metryki mówią CO się zepsuło i GDZIE (latency wzrosła na dwóch instancjach), ale NIE mówią DLACZEGO - odpowiedź na "dlaczego" kryje się w logach i trace'ach. Dobra integracja alertów z logami to taka, w której alert zawiera od razu "klucz pozwalający wejść w logi" - diagnostyka nie zaczyna się od szukania w ciemności, tylko od momentu, w którym coś już wiadomo. To fundament skracania MTTR.

Przekazanie kontekstu (context enrichment): współczesne systemy (zwłaszcza te z pełną observability: Prometheus + Loki + Tempo) propagują identyfikatory korelacji - trace_id, span_id, request_id. Jeśli aplikacja je propaguje, umieszczasz je w etykietach/adnotacjach alertu (albo łączysz z adnotacjami przez szablony): labels: trace_id: "..." albo annotation z linkiem do konkretnego trace w Tempo. Dostajesz wtedy tzw. enriched alert - powiadomienie wzbogacone o kontekst, który jest jednym kliknięciem od pełnej diagnozy: metryka → trace → logi żądania, które faktycznie zawiodły. Samo dodanie ID do alertu skraca czas powiązania punktów w czasie wielokrotnie.

Alerty oparte na logach (log-based alerts): Loki (ale też Elastic z Logstash) pozwala tworzyć alerty bezpośrednio z wzorców w logach za pomocą LogQL. Przykład: count_over_time({job="nginx"} |= "ERROR" [5m]) > 100 - alert, gdy w ciągu 5 minut zarejestrowano ponad 100 linii zawierających "ERROR". To idealne narzędzie do wykrywania zjawisk, które NIE zostawiają śladu w metrykach: błędy uwierzytelniania (bruteforce), konkretne wyjątki aplikacji, anomalie dostępu, naruszenia bezpieczeństwa. Dyskusja: alerty na logach są potężne, ale wymagają ostrożności - logi bywają zdublowane, a licznik count_over_time łatwo przestrzelić; dlatego zawsze łączysz wzorzec z progiem i wartością for. To naturalne rozszerzenie storytellingu z wykładu 4: LogQL to "drugi język" alertingu obok PromQL.

Korelacja metrics→logs (unified troubleshooting): największa wartość praktyczna pojawia się, gdy metryki i logi oglądasz w JEDNYM kontekście czasowym. W Grafanie wystarczy dashboard, na którym panel metryk (np. latency p99) i panel logów (np. błędy aplikacji) dzielą ten sam zakres czasu i te same zmienne (np. $instance) - widzisz pik opóźnienia i w tym samym oknie czasowym: błędy w logach. Dzięki temu wnioskowanie jest bezpośrednie: "latency p99 spike na tym samym czasie, w logach ERROR: connection pool exhausted" - pierwotna przyczyna w 30 sekund, bez przełączania narzędzi. To podejście nosi nazwę metrics-logs correlation i jest substytutem dla ślepego copy-paste timestampów między systemami.

Ścieżka (playbook) do zapamiętania - jak integracja alertów z logami skraca MTTR: (1) alert na metrykę (symptom) → (2) z alertu klikasz w adnotacji w panel korelacyjny Grafany z zakresem czasowym YYYY-MM-DD HH:MM:SS a) → (3) widzisz te same minuty w logach i trace'ach → (4) znajdujesz wyjątek / stack trace → (5) znasz przyczynę i naprawiasz. Terminologia: log-based alerting (alertowanie z logów), LogQL, context enrichment (wzbogacanie kontekstu), trace_id / span_id / request_id, trace correlation (korelacja trace), metrics-logs correlation, derived fields, unified troubleshooting, Loki, Logstash.

Metryki mówią, co się zepsuło i gdzie, ale nie mówią dlaczego - ta luka diagnostyczna powoduje, że operator po otrzymaniu alertu musi ręcznie szukać powiązania między pikami na wykresach a wpisami w logach, co wydłuża czas naprawy nawet o kilkadziesiąt minut. Integracja alertów z logami rozwiązuje ten problem, umożliwiając przekazywanie kontekstu - identyfikatorów żądania, śladu rozproszonego i powiązanych zdarzeń - bezpośrednio w treści powiadomienia, dzięki czemu diagnostyka zaczyna się od jednego kliknięcia.

W praktyce odbywa się to na trzech poziomach: wzbogacanie adnotacji alertów o pola takie jak trace_id, span_id i request_id, tworzenie alertów bezpośrednio z wzorców w logach za pomocą LogQL w Loki, oraz korelacja metryk z logami w jednym zakresie czasowym na dashboardzie Grafany. Każdy z tych mechanizmów skraca czas od wykrycia problemu do znalezienia pierwotnej przyczyny, a ich łączenie tworzy ścieżkę diagnostyczną, w której metryka wskazuje moment wystąpienia błędu, a logi dostarczają szczegółowy kontekst.

Wyjaśnienie skrótów użytych na slajdzie:
Loki – Grafana Loki – system gromadzenia logów Loki; Źródło zdarzeń tekstowych, z którego reguły LogQL generują alerty o anomaliach aplikacyjnych.
LogQL – Log Query Language – język zapytań LogQL; Język zapytań pozwalający na definiowanie reguł alarmowych na podstawie częstości występowania błędów w logach.
TraceID – Trace Identifier – identyfikator śladu; Unikalny identyfikator wstrzykiwany do powiadomienia alarmowego umożliwiający natychmiastową analizę rozproszoną.
SpanID – Span Identifier – identyfikator rozpiętości śladu; Klucz konkretnego podzadania ułatwiający precyzyjną lokalizację błędu w mikroserwisach.
Kibana – Kibana Log Visualization – interfejs wizualizacji Kibana; Konsola analityczna stosu ELK, do której odsyłają odnośniki zawarte w alertach logowych.

26/55 Powiadomienia o statusie
Powiadomienia o statusie: Regularne raportowanie realizacji SLO: status compliance, error budget remaining, burn rate alerts. Scheduled reports (daily/weekly/monthly) dla managementu i zespołów.

Obok alarmów są raporty: regularny SLO-status dla zespołu i zarządu. Decyzje, nie tylko gaszenie.

  • Monitoring procesów biznesowych – telemetria techniczna powinna być uzupełniona o alerty śledzące transakcje przynoszące firmie bezpośredni zysk.
  • Spadek wolumenu zamówień – nagłe załamanie liczby transakcji w sklepie internetowym może sygnalizować usterkę koszyka niewidoczną w logach serwera.
  • Błędy bramki płatniczej – brak udanych autoryzacji kart przez kilka minut niemal zawsze oznacza awarię u zewnętrznego operatora finansowego.
  • Uwzględnienie rytmu dobowego – reguły biznesowe muszą brać pod uwagę nocny spadek aktywności konsumentów, zapobiegając fałszywym alarmom.
  • Ochrona przychodów firmy – błyskawiczne wykrycie anomalii biznesowej pozwala zaangażować zarząd i ograniczyć straty finansowe przedsiębiorstwa.
Scheduled reports: Cykliczne raporty SLO (dzienne/tygodniowe/miesięczne) o compliance, budżecie i burn rate dla zespołów i zarządu.
raport

Oprócz alertów incydentowych istnieje trzeci typ powiadomień - powiadomienia statusowe (status notifications): alert alarmuje o pilnych zdarzeniach (incydentach), natomiast powiadomienie statusowe informuje regularnie o prawidłowym funkcjonowaniu systemu w średniej perspektywie - realizacji zobowiązań SLO, pozostałym error budget i trendach wskazujących na zbliżający się problem. To projekcja "zdrowia systemu" do poziomu zespołu i zarządu: dane wspierające decyzje (czy wdrożyć ryzykowną zmianę, czy wstrzymać prace), zamiast skupiać się wyłącznie na doraźnym usuwaniu awarii.

Status realizacji SLO: sercem jest dashboard (najczęściej w Grafana), który pokazuje dla każdej usługi: procent zgodności z SLO (compliance percentage - ile czasu/żądań mieści się w celu), pozostały error budget (budżet błędu = 1 − SLO; jeśli łączny błąd przekroczy budżet, łamiemy SLO) oraz historyczne trendy (czy compliance spada, czy rośnie). Standardowe panele: gauge lub stat z "remaining error budget" (np. 12% pozostało - bezpiecznie, 3% - alarm), wykresy burn rate w oknach 1h/6h/30d, tabela compliance per usługa. Ten dashboard to punkt odniesienia na codziennym stand-upie i główny argument w rozmowach o ryzyku nowych wdrożeń. Ważne: status SLO raportuje się także na poziomie pojedynczych wskaźników SLI - nie tylko zagregowanie.

SLO burn rate alerts: to zdarzenia "próg spalania budżetu" (fast/slow burn) - powiadomienie statusowe o charakterze ostrzegawczym. Gdy error budget spala się szybciej niż 1/okres rozliczeniowy, powiadamiamy proaktywnie, ZANIM budżet będzie wyczerpany. Przyjęte wzorce: multi-window (1h/6h/24h) pozwalają rozdzielić świeżo rozpoczęte awarie od długotrwałych trendów: np. burn rate 14.4 (okres 30d miesięczny) w oknie 1h → page (usługa realnie pada właśnie teraz), a burn rate 3 w oknie 6h → ticket (wolny wyciek do zaplanowania). Szczegóły i gotowe wzorce PromQL znajdą się na slajdzie 20 (Związek alertów z SLO) - tu podkreślamy funkcję powiadamiania: jest to sygnał "budżet się kurczy" podnoszony przed kryzysem, a nie po nim.

Raportowanie cykliczne (scheduled reports): kanał e-mail z zaplanowanymi podsumowaniami: daily digest (poranne podsumowanie stanu wszystkich SLO, otwarte incydenty, alerty ostatnich 24h), weekly summary (przegląd trendów, top uszkodzeń, zapas budżetu), monthly SLO report (pełny raport zgodności dla zarządu - zgodność, awarie, wykonane prace, wnioski). Realizacja: Grafana ma wbudowane Scheduled Reports (zawiera snapshot paneli/dashboardów wysyłany na e-mail), a w większych środowiskach raporty generują skrypty (Python + wysyłka e-mail z wykresami) lub narzędzia BI. Kluczowe: choć raporty piszemy dla ludzi, dane muszą pochodzić z tych samych źródeł co dashboardy - inaczej podwajasz źródła prawdy i wchodzą sprzeczności.

Dobry rytm powiadamiania statusowego w praktyce: codziennie rano - digest 1 strona dla zespołu i tech leada; co tydzień - analiza trendów z rekomendacją (gdzie budżet najszybciej "spływa"); co miesiąc - pełny raport na poziomie zarządu z porównaniem do poprzedniego miesiąca i planem działań. Każde powiadomienie statusowe powinno zawierać wskaźnik "czy jesteśmy w górze czy w dół" (WoW/MoM), bo zarząd podejmuje decyzje na podstawie kierunku, nie pojedynczej wartości. Terminologia: SLO status (status realizacji SLO), compliance percentage, error budget (budżet błędu), burn rate (tempo spalania), fast/slow burn, scheduled report, daily digest, weekly summary, monthly SLO report.

Oprócz alertów incydentowych, które alarmują o pilnych problemach, istnieje trzeci typ powiadomień – statusowe – informujące regularnie o realizacji celów SLO, dostępnym budżecie błędów oraz trendach telemetrycznych wskazujących na potencjalne anomalie. Jest to syntetyczny obraz kondycji środowiska dla zespołu i kierownictwa, wspierający decyzje o wdrożeniach oraz planowanie zasobów, zamiast ciągłego skupiania się wyłącznie na doraźnym usuwaniu awarii.

Sercem tego podejścia jest dashboard w Grafana pokazujący procent zgodności z SLO, pozostały error budget i historię spalania budżetu w oknach godzinowych i dziennych. Do tego dochodzą zaplanowane raporty - codzienne podsumowania dla zespołu, tygodniowe analizy trendów dla inżynierów oraz miesięczne raporty na poziomie zarządu - które dostarczają tych samych danych co dashboardy, ale w formie czytelnej dla osób podejmujących decyzje biznesowe.

Wyjaśnienie skrótów użytych na slajdzie:
StatusPage – Public Status Page System – strona statusu usług; Zewnętrzny, niezależny portal informujący klientów o bieżącej dostępności i prowadzonych pracach.
PublicStatus – Public Incident Communication – publiczna komunikacja o incydencie; Zasada transparentności budująca zaufanie użytkowników poprzez rzetelne informowanie o awariach.
B2B – Business to Business – relacja przedsiębiorstwo-przedsiębiorstwo; Klienci biznesowi wymagający formalnych powiadomień o awariach za pośrednictwem webhooków i e-maila.
Incident – Incident Lifecycle Management – cykl życia incydentu; Zarządzanie stanem awarii od momentu wykrycia (Investigating) do rozwiązania (Resolved).
Transparency – Operational Transparency – transparentność operacyjna; Kluczowa zasada SRE polegająca na otwartym przyznawaniu się do problemów technicznych.

27/55 Bezpieczeństwo powiadomień
Bezpieczeństwo powiadomień: Autoryzacja webhook (HMAC signatures, JWT, mTLS), szyfrowanie (TLS 1.3), secret management (Vault), RBAC dla Alertmanagera. Bezpieczeństwo kanałów powiadomień jest krytyczne.

Powiadomienia to układ nerwowy: sfałszowany webhook robi fałszywy alarm, skradziony URL otwiera kanał. Chroń jak aplikację.

  • Ochrona danych osobowych – treść komunikatów alarmowych nie może zawierać poufnych informacji o klientach, takich jak numery telefonów czy PESEL.
  • Ryzyko prawne naruszeń – ujawnienie danych wrażliwych na otwartych kanałach komunikatorów stanowi naruszenie przepisów RODO i grozi wysokimi karami.
  • Ukrywanie sekretów – alerty nie powinny zawierać haseł dostępowych, tokenów JWT ani kluczy API pojawiających się w zrzutach śladów błędów.
  • Sanityzacja komunikatów – filtry usuwające dane poufne muszą oczyszczać komunikaty przed ich wysłaniem do zewnętrznych systemów powiadomień.
  • Kontrola uprawnień RBAC – wgląd w rejestry incydentów i panele monitoringu powinien być ściśle ograniczony do autoryzowanych pracowników.
HMAC signatures: Podpisy potwierdzające autentyczność webhooka; obok JWT, mTLS, TLS 1.3, Vault i RBAC chronią „układ nerwowy” organizacji.
ochrona

Treść powiadomień przesyłanych do komunikatorów (Slack, Discord, Microsoft Teams) podlega przepisom RODO i nadzorowi Urzędu Ochrony Danych Osobowych. Bezwzględnie zabrania się dołączania do treści powiadomień danych osobowych użytkowników, haseł, zrzutów zapytań SQL zawierających PII oraz kluczy sesyjnych. Adresy webhooków zawierające tokeny autoryzacyjne nie mogą trafiać do publicznych repozytoriów kodu; muszą być wstrzykiwane jako zaszyfrowane zmienne środowiskowe.

Bezpieczeństwo systemu powiadamiania ("systemu nerwowego" organizacji) opiera się na trzech filarach: uwierzytelnianie (kto może wysyłać/odbierać), szyfrowanie (w transporcie i spoczynku) oraz zarządzanie sekretami i dostępem (kto może zarządzać alertingiem). Zagrożenia są realne: sfałszowany webhook wywołuje fałszywy alarm (Denial of Service na zespół on-call) lub zatruwa dziennik alertów, skradziony URL webhooka Slacka otwiera dostęp do kanału zewnętrznego, a wyciek sekretów z alertów do publicznego ticketa to naruszenie danych (RODO).

Autoryzacja webhook (uwierzytelnianie odbiorcy): gdy Twój system przyjmuje webhook z zewnątrz (np. własny service odbierający alerty), nie możesz ufać adresowi nadawcy - IP można podszyć. Standardy: (1) HMAC signatures - nadawca i odbiorca dzielą tajny klucz, nadawca liczy HMAC-SHA256 z treści payloadu (+ timestamp) i wysyła w nagłówku (np. X-Webhook-Signature), odbiorca przelicza i porównuje w czasie stałym (hmac.compare_digest); timestamp w zakresie ±5 min chroni przed replay. Tak robią Stripe, GitHub, Slack - to domyślna metoda branżowa. (2) JWT - token z claims (iss, aud, exp) w nagłówku Authorization: Bearer, weryfikacja sygnatury z kluczem publicznym. (3) mTLS - obie strony prezentują certyfikat X.509 w TLS-handshaku; połączenie zawrze się tylko dla zaufanych, do tego na poziomie transportu, zanim cokolwiek trafi do aplikacji. Zasada wyboru: HMAC dla większości przypadków, mTLS tam, gdzie są regulacje/prawo, JWT tam, gdzie potrzeba metadata.

Szyfrowanie (confidentiality + integrity): po pierwsze TLS w transmisji - absolutne minimum to HTTPS na każdym webhooku; rekomendacja TLS 1.3 (TLS 1.2 minimum, wyłącz 1.0/1.1 i słabe ciphery). Po drugie encryption at rest dla sekretów - klucze i tokeny przechowywane w Vault/cloud secrets leżą szyfrowane; niezależnie od przechowywania w configu. Po trzecie certyfikaty - zarządzanie cyklem życia (wydanie, odnawianie przed wygaśnięciem, odwołanie) to zadanie operacyjne, nie jednorazowe: alert na zbliżające się wygaśnięcie certyfikatu (np. 30 dni) zapobiega "awarii po cichu" na poziomie bezpieczeństwa. Po czwarte higiena w wiadomościach - alerty wysyłane na Slack/e-mail nie mogą zawierać sekretów ani danych osobowych (logi z tokenami w treści = natychmiastowy wyciek).

Zarządzanie sekretami (secret management): fundamentalna zasada - żaden webhook URL, token API czy hasło SMTP nie może być wpisany "na sztywno" w konfiguracji Alertmanagera przechowywanej w repozytorium kodu. Sekrety wczytywane są ze zmiennych środowiskowych, menedżera sekretów (HashiCorp Vault, AWS Secrets Manager, GCP Secret Manager, Azure Key Vault), albo szyfrowanych obiektów (sealed secrets/K8s Secrets, age/sops dla plików YAML). Alertmanager wspiera te wzorce (odwołania env vars w configu). Analogicznie traktujemy tokeny generyczne z webhookiem i hasła mailowe. Reguła: jeśli plik konfiguracyjny jest wersjonowany w Git, w repozytorium kodu nie ma miejsca na sekrety; kontrole CI mogą dodatkowo blokować commit z jawnym kluczem (tzw. secret scanning).

Kontrola dostępu (RBAC) i monitoring: Alertmanager i Grafana Alerting to wrażliwe systemy - osoba z dostępem do silences może WYŁĄCZYĆ alerty (a więc zamaskować awarię), a dostęp do configu może zmienić routing. Dlatego wdrożenia oparte na RBAC (role-based access control): dajemy rolę tylko do odczytu części operatorów, pełne uprawnienia nielicznym administratorom; izolujemy środowiska (dev vs prod API keys), logujemy zmiany (audit). Do tego meta-alerting (patrz slajd 37): monitorujemy metryki Alertmanagera (up, config reload, queue length) - żeby wiedzieć, że "system ostrzegania działa". Terminologia: HMAC-SHA256, constant-time compare, replay protection, JWT (iss/aud/exp), mTLS, TLS 1.3, encryption at rest, HashiCorp Vault, sealed secrets, RBAC, audit log, secret scanning.

System powiadomień alertowych pełni rolę «układu nerwowego» organizacji, a jego kompromitacja może mieć poważne konsekwencje - sfałszowany webhook wywołuje fałszywy alarm i obciąża zespół on-call, skradziony URL webhooka Slacka otwiera dostęp do kanału zewnętrznego, a wyciek sekretów z treści alertów do publicznego ticketa stanowi naruszenie danych osobowych. Dlatego bezpieczeństwo kanałów powiadomień musi być traktowane tak samo rygorystycznie jak bezpieczeństwa samej aplikacji.

Podstawowe mechanizmy obejmują uwierzytelnianie webhooków za pomocą podpisów HMAC-SHA256 z porównywaniem w czasie stałym, tokenów JWT z claims i weryfikacją sygnatury oraz dwukierunkowego TLS z prezentacją certyfikatów X.509, szyfrowanie transmisji minimalnie w TLS 1.3, zarządzanie sekretami przez HashiCorp Vault lub sealed secrets zamiast wpisywania tokenów w konfigurację, oraz kontrolę dostępu RBAC dla Alertmanagera, która ogranicza możliwość tworzenia wyciszeń i modyfikacji trasy alertów.

Wyjaśnienie skrótów użytych na slajdzie:
Vault – HashiCorp Vault Secrets Manager – menedżer tajemnic HashiCorp Vault; Dedykowana platforma bezpiecznego przechowywania tokenów API i haseł do webhooków powiadomień.
Secrets – Kubernetes Secrets Object – obiekt tajemnic w Kubernetes; Zasób orkiestratora chroniący poufne dane uwierzytelniające przed jawnym zapisem w plikach konfiguracyjnych.
Token – Bearer Authentication Token – token uwierzytelniający; Ciąg kryptograficzny uprawniający Alertmanagera do wysyłania powiadomień na kanały komunikatorów.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Szyfrowanie połączeń sieciowych gwarantujące poufność przesyłanych komunikatów alarmowych.
RODO – Rozporządzenie o Ochronie Danych Osobowych – unijne rozporządzenie o ochronie danych; Regulacja prawna wymuszająca eliminację danych osobowych z nagłówków i treści alertów.

28/55 Narzędzia syslog w alertingu
Narzędzia syslog w alertingu: SNMP trap to asynchroniczne powiadomienie o zdarzeniu wysyłane przez urządzenie sieciowe, a syslog to logowanie zdarzeń. Alertmanager może je odbierać (snmptrapd, snmp_exporter) i traktować jak zwykłe alerty.

Sieciowy sprzęt mówi SNMP i syslogiem. Dwa mostki - eksporter i snmptrapd - wprowadzają go do Alertmanagera.

  • Dbanie o zdrowie dyżurnych – organizacja harmonogramów wsparcia wymaga poszanowania czasu wolnego oraz regeneracji psychicznej inżynierów.
  • Rotacja i odpoczynek – warty dyżurne muszą być regularne i sprawiedliwe, a inżynierowie po ciężkich nocnych akcjach powinni mieć zagwarantowany urlop.
  • Kultura wsparcia bez obwiniania – organizacja musi eliminować strach przed popełnieniem błędu i wspierać dyżurnych w podejmowaniu trudnych decyzji.
  • Adekwatna rekompensata – pełnienie pogotowia technicznego poza godzinami pracy powinno wiązać się z dodatkowym wynagrodzeniem lub dniami wolnymi.
  • Przeciwdziałanie wypaleniu – permanentne przeciążenie personelu nocnymi telefonami prowadzi do rotacji kadr i drastycznego spadku bezpieczeństwa.
SNMP trap: Asynchroniczne powiadomienie urządzenia sieciowego o zdarzeniu; snmptrapd i snmp_exporter wprowadzają je do Alertmanagera jak zwykłe alerty.
syslog a alert

"Stary świat" urządzeń sieciowych (switche, routery, firewalle, UPS, kontrolery) łączy się ze stackiem Prometheus/Alertmanager przez dwa protokoły zarządzania: SNMP (Simple Network Management Protocol - polling i trapy) oraz syslog (strumień zdarzeń tekstowych). Są komplementarne: polling SNMP daje metryki (stan, ruch), trapy SNMP - niesolicited (samoistne, bez zapytania) powiadomienie o zdarzeniu, syslog - szczegółowy zapis zdarzeń; Alertmanager sam nie "rozumie" SNMP - potrzebny jest mostek, który zamieni trap/syslog na format alertu.

SNMP trap (co to jest): niesolicited PDU wysyłane przez urządzenie do menedżera sieci (NMS), gdy coś się wydarzy - bez czekania na zapytanie. Eventy typowe: linkDown/linkUp (utrata/odtworzenie łącza), coldStart/warmStart (restart urządzenia), authenticationFailure (błędny community string), BGP/OSPF state changes (session down), temperatura za wysoka, przekroczenie progu na wentylatorach. Technikalia: w SNMPv1/v2c komunikat jest w UDP na porcie 162 i uwierzytelniany community stringiem (słowo tekstowe, słaba forma auth), SNMPv3 dodaje autentykację i szyfrowanie (user-based: authUser/authProtocol + privProtocol). Trapy są asynchroniczne i "zapominane": jeśli odbiorca nie przyjmie - informacja przepada, dlatego NMS często odpowiada na trap (jego brak = retransmisja z urządzenia).

Routing do Alertmanagera (mostek): dwa komplementarne wzorce. (1) snmp_exporter - nie o trapach, a o POLLINGU: Prometheus co interwał odpytuje urządzenie (moduły MIB, np. if_mib dla interfejsów), a wyniki zamienia na metryki Prometheus (ifOperStatus, ifInOctets, ifHCInOctets...). SNMP issue → metryki (up, statusy) → reguły PromQL w Prometheusie → alert jako zwykły krok. (2) snmptrapd - demon odbierający TRAPY (nasłuchuje UDP 162); odbiera, dekoduje per MIB, a następnie (przez konfigurowany handler, np. snmptt albo mały skrypt) zamienia w powiadomienie HTTP/webhook wysyłane do Alertmanagera. Gotowe mostki w ekosystemie: project snmp_notifier (webhook, który wypchnie alert z Alertmanagera w stronę legacy NMS jako trap - kierunek odwrotny!) oraz prometheus-webhook-snmp (czyta alerty z Alertmanagera i śle trapy SNMP). Tak spina się świat cloud-native z legacy systemami NMS (Nagios, Centreon, SolarWinds).

Parsing i normalizacja (MIB/OID → wspólny format alertu): trapy przychodzą jako zbiór OID-ów (Object Identifiers) z wartościami. Zrozumienie ich wymaga słownika - czyli MIB (Management Information Base): pliku definiującego strukturę i znaczenie OID-ów, dostarczanego przez producenta urządzenia (np. MIB dla Cisco, dla UPS-ów APC). Po sparsowaniu trapów sprowadzamy je do JEDNEGO wspólnego formatu alertu: severity (z priorytetu/facility lub mapowania), instance (IP/adres urządzenia), summary (opis zrozumiały dla operatora), timestamp, zespół/obszar odpowiedzialności. Dopiero tak znormalizowany alert trafia do Alertmanagera i podlega zwykłemu routowaniu, grupowaniu i eskalacji. Bez normalizacji każdy producent "mówi inaczej" i operator nie może ujednolicić reguł.

Syslog kontra SNMP - kiedy co: syslog (UDP 514/RFC 5424) to strumień tekstowy z priorytetami - świetny do logowania i zaawansowanej diagnostyki, integrowany z Loki/ELK (wykład 4: odpowiednie parsery np. loki syslog target). SNMP traps to ustrukturyzowane PDU - lepsze dla stanu urządzeń (link up/down) i szybkiej detekcji. W praktyce produkcyjnej łączy się oba: trapping daje szybką detekcję i alert, syslog daje szczegóły do analizy przyczyn. Terminologia: SNMP (Simple Network Management Protocol), trap (pułapka - niesolicited PDU), polling (odpytywanie), community string, SNMPv2c/SNMPv3, OID (Object Identifier), MIB (Management Information Base), snmptrapd, snmp_exporter, snmp_notifier, NMS (Network Management System), syslog, RFC 5424, normalization (normalizacja).

Środowiska produkcyjne rzadko składają się wyłącznie z serwerów i aplikacji chmurowych - w ich obrębie żyją jeszcze urządzenia sieciowe: switche, routery, firewalle i UPS-y, które komunikują się za pomocą protokołów starszej generacji. SNMP trap to asynchroniczne powiadomienie wysyłane przez urządzenie, gdy wydarzy się coś nieoczekiwanego - utrata łącza, restart, przekroczenie progu temperatury - a syslog to strumień szczegółowych zdarzeń tekstowych, oba komplementarne wobec metryk zbieranych przez Prometheus.

By włączyć te «stare światy» do nowoczesnego stacku, potrzebujemy mostków: snmp_exporter odpytuje urządzenia co interwał i zamienia wyniki na metryki Prometheus, podczas gdy snmptrapd nasłuchuje na porcie UDP 162 i przez handler zamienia trapy na webhook HTTP kierowany do Alertmanagera. Przed trafieniem do systemu alertowego trapy muszą zostać sparsowane przy użyciu plików MIB od producenta urządzenia i znormalizowane do wspólnego formatu z polami severity, instance, summary i timestamp.

Wyjaśnienie skrótów użytych na slajdzie:
Syslog – Syslog Protocol – protokół Syslog; Standard przesyłania zdarzeń systemowych mogący służyć jako źródło wyzwalania reguł alarmowych.
RFC – Request for Comments – dokument standaryzacji RFC; Specyfikacje protokołu Syslog (RFC 5424) definiujące kody ważności od 0 (Emergency) do 7 (Debug).
PRI – Syslog Priority Value – wartość priorytetu Syslog; Liczba wyliczana z iloczynu kodu obiektu (Facility) i poziomu ważności (Severity).
Facility – Syslog Facility Code – kod źródła zdarzenia Syslog; Oznaczenie podsystemu generującego zdarzenie (np. auth, daemon, local0-local7).
Severity – Syslog Severity Level – poziom ważności zdarzenia Syslog; Stopień krytyczności komunikatu, dla którego poziomy 0-2 powinny bezwzględnie generować natychmiastowy alert.

29/55 Alerting w Grafana (wstęp)
Grafana Alerting: Unified alerting (v2) pozwala tworzyć reguły na danych z wielu źródeł i jedną konsolą zarządzać powiadomieniami: contact points, notification policies i silences to elementy jednego pipeline'u.

Grafana Alerting to jeden pulpit na wszystkie źródła: PromQL, LogQL i SQL w jednym pipeline, od wersji 9.

  • Pierwsza linia obrony – inżynier pełniący dyżur on-call odpowiada za natychmiastowe odebranie alarmu i wstępną klasyfikację wagi incydentu.
  • Priorytet dostępności – celem dyżurnego nie jest pisanie eleganckiego kodu, lecz jak najszybsze przywrócenie poprawnego działania usługi dla ludzi.
  • Zwoływanie sztabu kryzysowego – w obliczu rozległej katastrofy dyżurny ma pełne prawo i obowiązek wezwać do pomocy ekspertów z innych zespołów.
  • Bieżący dziennik zdarzeń – rejestrowanie podejmowanych kroków i hipotez w trakcie akcji ułatwia późniejsze odtworzenie chronologii podczas analizy awarii.
  • Przekazanie do deweloperów – po tymczasowym opanowaniu pożaru sprawa trafia do autorów kodu w celu trwałego usunięcia przyczyny usterki.
Unified alerting (v2): Reguły na wiele źródeł (PromQL, LogQL, SQL) z jedną konsolą (contact points, policies, silences); domyślny od wersji 9.
alert w Grafana

Grafana Alerting (Grafana Unified Alerting) przenosi tworzenie reguł i zarządzanie powiadomieniami z osobnych konfiguracji YAML (Prometheus + własny plik Alertmanagera) do jednej konsoli w Grafanie. Można użyć wbudowanego Alertmanagera (grafana-managed alerting) albo podpiąć zewnętrznego; unified alerting alarmuje równie dobrze na metrykach Prometheus (PromQL), jak na logach Loki (LogQL), danych biznesowych w bazach SQL, metrykach cloudowych (CloudWatch, Azure Monitor) czy trace'ach Tempo. Od wersji 9.x (po rozdzieleniu legacy vs unified) unified alerting to domyślna, kompletna wersja.

Reguły w Grafanie (alert rules): tworzysz je w edytorze bezpośrednio w UI albo deklaratywnie (Terraform/provisioning - w stylu GitOps). Dla każdej reguły wskazujesz data source i piszesz zapytanie: Prometheus/PromQL (metryki), Loki/LogQL (logi), SQL (dane biznesowe w Postgres/MySQL), CloudWatch itd. Każda reguła ma: ocenę co interwał (evaluation interval - np. co 1 min), warunek (jeśli wartość query przekracza/jest równa/niższa od progu), czas opóźnienia (for - jak w Prometheusie, stan pending→firing), oraz możliwość użycia szablonów w polach. Ważna przewaga: w Grafanie możesz zrobić "alert łączący źródła" (combined data source queries) i wzbogacić kontekst o wartości z innych zapytań - coś, czego sam Prometheus nie zrobi.

Contact points (punkty kontaktowe): to odpowiednik receiverów z Alertmanagera - definiują GDZIE dostarczyć powiadomienie: Slack, E-mail/SMTP, PagerDuty, Webhook, Telegram, Discord, Microsoft Teams, Opsgenie, Pushover, Sensu, AWS SNS i inne. Każdy kontakt point może zawierać wiele integracji (podobnie jak receiver z wieloma konfiguracjami). Tworzysz je w sekcji Alerting → Contact points, a w UI od razu widać, ile polityk używa danego punktu i jaki jest status wysyłki (delivery status - czy ostatnie powiadomienie przeszło). Dodatkowo każda integracja ma wbudowane szablony komunikatów - czyli nie musisz zaczynać od pisania szablonów Go od zera.

Notification policies (polityki powiadomień): to drzewo routingu "na etykietach" - odpowiednik route tree z Alertmanagera, ale zarządzane wizualnie. Ustawiasz: politykę domyślną (default policy - łapie wszystko, co nie trafiło do dzieci), label matchers (np. severity="critical" i team="payments"), child policies z dziedziczeniem grupowań i czasów od rodzica, oraz opcję override'ów (inne grupowanie/czasy). Do tego: silences (wyciszenia czasowe) oraz mute timings (harmonogramy ciszy - np. weekend w środowisku dev). Policies podejmują decyzje: grupowanie (group_by: ile alertów zlepić w jedną wiadomość), harmonogram wysyłek (group_wait, group_interval, repeat_interval) oraz wybór contact pointa.

Unified alerting UI i podsumowanie - jedna konsola dla WSZYSTKICH alertów: centralna lista aktywnych alertów i incydentów (ze stanami, wartościami, źródłami), natychmiastowy podgląd w korelacji z dashboardami i Explore (panel z alertem klikalny → dashboard danego serwisu), a do tego Rich History (historia stanów/ewaluacji dla danej reguły) i eksport configu w JSON/YAML/Terraform do wersjonowania. Efekt: "single pane of glass" - zamiast tego, że coś woła w Prometheusie, coś w Loki, coś w SQL, wszystkie alerty żyją i są zarządzane w JEDNYM miejscu. Terminologia: unified alerting, alert rule, evaluation interval, data source, PromQL/LogQL, contact point (punkt kontaktowy), integration (integracja), notification policy (polityka powiadomień), label matchers, default policy, child policy, silencing, mute timing, delivery status, provisioning/Terraform.

Grafana Alerting, znany jako unified alerting, przenosi tworzenie reguł i zarządzanie powiadomieniami z osobnych konfiguracji YAML do jednej konsoli w graficznym interfejsie, co eliminuje konieczność przełączania między Prometheusem a Alertmanagerem. Od wersji dziewiątej to domyślna i kompletna wersja, która pozwala alarmować na danych z dowolnego źródła - PromQL dla metryk, LogQL dla logów, SQL dla danych biznesowych czy CloudWatch dla usług chmurowych - w ramach jednego pipeline'u.

Kluczowe elementy tej architektury to contact points definiujące, gdzie trafi powiadomienie - Slack, e-mail, PagerDuty, webhook, Telegram, Discord - oraz notification policies, które na podstawie etykiet decydują, jak grupować alerty i do jakiego punktu kontaktowego je kierować. Całością zarządza się z jednego miejsca, a provisioning przez Terraform lub API umożliwia wersjonowanie konfiguracji w Git, co otwiera drogę do podejścia alert-as-code.

Wyjaśnienie skrótów użytych na slajdzie:
GrafanaAlerting – Grafana Alerting Engine – silnik alertowania platformy Grafana; Zintegrowany w Grafanie podsystem reguł alarmowych wspierający wiele zróżnicowanych źródeł danych.
UnifiedAlerting – Grafana Unified Alerting – ujednolicony system alertowania Grafana; Architektura łącząca reguły oparte na metrykach z tradycyjnymi regułami Alertmanagera.
GUI – Graphical User Interface – graficzny interfejs użytkownika; Konsola umożliwiająca wizualne definiowanie progów alarmowych bezpośrednio na wykresach paneli.
Provisioning – Declarative Alert Provisioning – deklaratywny provisioning alertów; Wdrażanie reguł alertowych Grafany za pomocą plików YAML wersjonowanych w repozytorium kodu.
ContactPoint – Grafana Alert Contact Point – punkt kontaktowy powiadomień; Definicja kanału odbiorczego (np. e-mail, Slack, webhook) w architekturze Grafana Alerting.

30/55 Kazus: dobry alert
Kazus: dobry alert: Actionable alert = operator wie, co zrobić w 30 sekund. Wskazuje usługę i metrykę, zawiera pole działania (runbook_url) i opisuje problem w adnotacjach.

Wzorowy alert przechodzi test 30 sekund: od przeczytania do pierwszej sensownej akcji. Powyżej - do poprawki.

  • Cykliczny audyt alertów – utrzymanie higieny monitoringu wymaga regularnych przeglądów, podczas których analizuje się wartość wysłanych zgłoszeń.
  • Usuwanie martwych reguł – każde powiadomienie, które nie wymagało podjęcia konkretnej akcji naprawczej, powinno zostać bezwzględnie usunięte.
  • Dostrajanie progów – podniesienie marginesów tolerancji i wydłużenie czasu trwania anomalii radykalnie zmniejsza liczbę niepotrzebnych pobudek.
  • Statystyki dyżuru – średnia liczba powiadomień przypadająca na jedną zmianę dyżurną powinna być regularnie raportowana kierownictwu technicznemu.
  • Spokojny dyżur jako cel – brak nocnych telefonów przy jednoczesnym zachowaniu wysokiej dostępności usług jest miarą dojrzałości inżynierskiej SRE.
Test 30 sekund: Miara dobrego alertu - czas od przeczytania do pierwszej sensownej akcji; powyżej pół minuty alert jest za słaby.
wzorzec

Wzorcowy alert jest tak samo ważny jak sama reguła alertowa - najważniejsza zasada SRE: dobry alert to actionable alert, przy którym dyżurny nie zastanawia się "o co tu chodzi?", tylko wie w ciągu 30 sekund, co robić. Test jest prosty i brutalny: postaw realistyczny scenariusz, daj alert zespołowi i mierz czas od przeczytania wiadomości do pierwszej sensownej akcji; jeśli przekracza 30 sekund, alert jest za słaby - bez względu na to, jak ładnie brzmi reguła w YAML. Alert jest "produktem", a jego treść to UX dla dyżurnego.

Wskazanie usługi i metryki (co/gdzie): każdy alert musi jednoznacznie odpowiedzieć na 5 pytań: CO się dzieje (jaka metryka/jaki symptom), GDZIE (usługa service, instancja instance, środowisko env, klaster cluster), w jakim stopniu (aktualna wartość względem progu; np. "p99 latency: 950ms > 500ms"), OD KIEDY (startsAt / for) i DLACZEGO (opis kontekstu). To realizuje się przez LABEL-e w regule: service="payments-api", instance="$labels.instance", severity="critical" oraz przez umiejętnie sformułowany summary. Przykład ZŁEGO: "High latency" (bez którego serwisu?) i DOBREGO: "payments-api: p99 latency 880ms > 500ms przez 5 min (instance payments-web-2)". Bez jednoznaczności operator po prostu nie wie, gdzie zaczynać - a to dłuższy MTTR.

Pole działania - runbook_url (playbook): alert krytyczny i ostrzegawczy musi odsyłać do procedury naprawczej. W adnotacjach umieszczamy runbook_url (link do wiki/dokumentacji z krokami) albo same kroki opisane w description: summary: "payments-api CPU nasycony", description: "Krok 1: zobacz panel CPU na dashboardzie x. Krok 2: sprawdź aktywność k8s. Krok 3: jeśli to burst y - zwiększ repliki HPA do n.". Runbook to skodyfikowana wiedza: wiedza utrwalona w procedurze dostępnej w miejscu incydentu, bez szukania "tego, kto pamięta". Operator nie zgaduje - wykonuje sprawdzone instrukcje. W dobrych organizacjach runbooki mają właściciela, są testowane w chaos engineering i aktualizowane po incydentach.

Przykład gotowego alertu (rozbudowany YAML): - alert: PaymentServiceLatencyHigh; expr: histogram_quantile(0.99, sum(rate(http_request_duration_seconds_bucket{service="payments-api"}[5m])) by (le, instance)) > 0.5; for: 10m; labels: severity: critical, team: payments, service: payments-api; annotations: summary: "payments-api: p99 latency {{ $value }}s > 0.5s przez 10 min", description: "Wysoka latencja płatności. Dashboard: https://grafana/d/payments. Runbook: https://wiki/payments/latency.", runbook_url: "https://wiki/payments/latency". Zauważ: używa histogram_quantile (zwraca realny p99, nie surowe wartości), "for: 10m" (eliminacja chwilowych pików), labels do routingu (severity/team) i adnotacje z wartością i mówiącymi linkami. DOBRY alert ma KLIKALNY kontekst - dyżurny nie pisze wiadomości, tylko klika.

Check-list ewaluacyjna (do kodowania nowych alertów): (1) Actionable - operator wie co zrobić w 30 s? (2) Service+instance jednoznacznie wskazane? (3) Metryka i próg z aktualną wartością? (4) runbook_url lub kroki w description? (5) severity zgodna z polityką (critical=page, warning=ticket)? (6) routing labels (team) poprawne, żeby Alertmanager dostarczył do właściwego zespołu? (7) threshold oparty o dane (percentyle), nie magiczną liczbę? (8) przetestowano przez chaos/na stagingu? Jeśli cokolwiek jest NIE, alert nie jest opublikowywalny - wraca do autora. Terminologia: actionable alert, runbook (playbook), runbook_url, severity (critical/warning/info), labels routing, annotations, histogram_quantile, 5W (what/where/how bad/since/why), MTTR.

Wzorcowy alert jest tak samo ważny jak sama reguła alertowa - najważniejsza zasada SRE brzmi: dobry alert to actionable alert, przy którym dyżurny nie zastanawia się «o co tu chodzi», tylko wie w ciągu trzydziestu sekund, co robić. Test jest prosty i brutalny: postaw realistyczny scenariusz, daj alert zespołowi i zmierz czas od przeczytania wiadomości do pierwszej sensownej akcji - jeśli przekracza pół minuty, alert jest za słaby.

Alert musi jednoznacznie odpowiedzieć na pięć pytań: co się dzieje, gdzie jest problem, jak bardzo jest poważny, od kiedy trwa i dlaczego się pojawił - realizuje się to przez etykiety z nazwą usługi i instancji, przez adnotacje z bieżącą wartością metryki i progiem oraz przez link do runbook_url prowadzącego do procedury naprawy. Brak któregokolwiek z tych elementów powoduje, że operator zgaduje zamiast działać, a to bezpośrednio wydłuża czas naprawy.

Wyjaśnienie skrótów użytych na slajdzie:
Actionable – Actionable Quality in Alerts – wykonalność alertu; Cecha wzorcowego alertu gwarantująca, że inżynier natychmiast wie jakie kroki podjąć.
Clear – Clear Alert Description – jasność komunikatu; Precyzyjny język pozbawiony wieloznaczności technicznych i zbędnego żargonu.
Direct – Direct Impact Assessment – bezpośrednia ocena wpływu; Jasne wskazanie czy awaria dotyczy użytkowników zewnętrznych czy środowiska testowego.
Runbook – Operational Runbook Link – łącze do instrukcji operacyjnej; Odnośnik w treści alertu prowadzący bezpośrednio do procedury postępowania.
Context – Rich Alert Context – bogaty kontekst diagnostyczny; Dołączenie do powiadomienia nazw klastrów, identyfikatorów węzłów i zrzutów parametrów.

31/55 Automatyzacja reakcji
Automatyzacja reakcji: Alert wywołuje akcje przez webhook do narzędzi (Ansible, Terraform, Rundeck). Pełną automatyzację (auto-remediation) warto uzupełniać kontrolą człowieka - human-in-the-loop.

Dojrzały alert nie tylko budzi, lecz naprawia: webhook do narzędzi, człowiek w pętli albo pełny automat.

  • Definicja runbooka – to precyzyjny przewodnik operacyjny opisujący krok po kroku czynności, jakie inżynier musi wykonać po otrzymaniu alertu.
  • Kompletne instrukcje – dokument zawiera gotowe polecenia konsolowe do weryfikacji objawów, procedury restartu oraz sposób wycofania wersji.
  • Unikanie improwizacji – brak aktualnej dokumentacji zmusza dyżurnego do nerwowego zgadywania poleceń pod presją uciekających minut naprawy.
  • Weryfikacja procedur – instrukcje operacyjne powinny być regularnie testowane przez mniej doświadczonych inżynierów w celu znalezienia luk.
  • Bezpośredni odnośnik – adres URL prowadzący do dedykowanego rozdziału procedury musi znajdować się bezpośrednio w treści powiadomienia.
Human-in-the-loop: Człowiek w pętli decyzji; alert wywołuje akcje webhookiem (Ansible, Terraform, Rundeck), lecz pełną automatykę uzupełnia kontrola ludzka.
automatyczna akcja

Automatyzacja reakcji (remediation automation) to krok od wykrywania do DZIAŁANIA: alert nie tylko budzi kogoś, ale może sam (lub po akceptacji) wykonać naprawę. To kolejny etap dojrzałości SRE - najpierw wykrywamy (alerting), potem reagujemy szybciej (runbooki, MTTR), wreszcie automatyzujemy powtarzalne reakcje (auto-remediation), zostawiając człowiekowi decyzje trudne i nietypowe. Kluczowe pojęcia: webhook jako "trigger", human-in-the-loop jako zasada bezpieczeństwa, auto-remediation jako cel końcowy.

Webhook do narzędzi automatyzacji: Alertmanager (i Grafana Alerting) wysyła powiadomienie HTTP (webhook) do systemu, który wykona akcję. Popularne cele: Ansible - push konfiguracji / zarządzanie (np. awaria serwera → skrypt rekonfiguracyjny); Terraform Cloud - wykonanie planu/apply w odpowiedzi na alert (np. utrata pojemności → zmiana auto_scaling); Rundeck - Job Scheduler z UI i ACL (uruchomienie "Runbook Job" na nodzie - np. restart aplikacji, wymiana dysku); GitHub Actions / GitLab CI - trigger pipeline (wystawienie hotfixa, rollback z obrazu). Webhook do tego wystarczy, bo każdy z tych systemów ma API/webhook. Wzorzec: alert z labelami (np. runbook URL) → integracja wybiera akcję → wykonuje na docelowej infrastrukturze. Uwaga: webhook musi być autoryzowany (token/HMAC) - patrz slajd 27.

Ograniczona automatyzacja - human-in-the-loop (człowiek w pętli): pełna automatyka nie zawsze jest pożądana, bo koszt błędnej akcji bywa wysoki (restart produkcyjnego DB, rollback bez wiedzy o transakcjach). Human-in-the-loop to model, w którym system przygotowuje gotową akcję (np. Rundeck proponuje "restart payments-api na instancji x 3") i czeka na zatwierdzenie przez dyżurnego; człowiek akceptuje jednym kliknięciem, widząc pełną listę kroków i (jeśli dostępne) plan wykonania. Tak działa np. "suggested runbook" łączony z alertem: Automation → validation → approval → execution → verification. Zaletą jest bezpieczeństwo (błędna akcja wstrzymana przez człowieka) przy zachowaniu szybkości (nie trzeba pisać komend ręcznie). To kompromis między pełną automatyzacją a pełną manualnością - typowy dla produkcji o wysokiej stawce.

Auto-remediation (pełna automatyzacja bez człowieka): stosujemy tam, gdzie akcja jest bezpieczna, odwracalna i dobrze znana. Klasyka: auto-scaling (HPA/VPA w Kubernetes, cloud autoscaling - przy przekroczeniu progu zasobów system sam dokłada instancje); restart dead process/kontenera (systemd restart-on-failure, Kubernetes restart policy, restart zepsutego węzła - ale z limitami "restart loop detection"); failover (przełączenie ruchu na zapasową strefę/usługę - nastrój DNS/LB); czyszczenie (wyczyszczenie starego storage itd.). Warunek wdrożenia: akcja naprawcza musi być idempotentna (wielokrotne wykonanie daje ten sam efekt) i REVERSIBLE (można ją cofnąć), a jej wykonanie musi być logowane i audytowalne. Zasada T: automatyzuj 80% rutynowych reakcji, zostaw człowiekowi 20% zdarzeń nierutynowych - i zawsze monitoruj, czy sama automatyka nie wpadła w pętlę.

Terminologia i wskazówki wdrożenia: webhook trigger, integration, human-in-the-loop, runbook automation, auto-remediation (auto-naprawa), idempotency (idempotencja - ten sam wynik przy powtórzeniach), reversibility (odwracalność), audit trail (ślad audytowy), self-healing (samoleczenie - system sam wraca do zdrowia), coordination (Ansible/StackStorm/Rundeck jako "nerw centralny" akcji) i guardrails (ograniczenia: limit wykonań na czas, rate limit, "circuit breaker" - jeśli auto-naprawa nie działa po 3 próbach, eskaluj do człowieka). Zasada bezpieczeństwa automatyzacji: najpierw URUCHAMIAJ w staging/chaos, testuj idempotencję i zachowania w sytuacjach nietypowych; dopiero potem w produkcji. Automation is a machine that needs a brake, nie tylko gaz - inaczej sama staje się źródłem incydentów.

Dotychczas mówiliśmy o wykrywaniu problemów i informowaniu ludzi, ale dojrzałe środowiska SRE idą krok dalej - alert nie tylko budzi kogoś, ale może po akceptacji lub automatycznie wykonać naprawę. Automatyzacja reakcji to kolejny etap dojrzałości: od ręcznego usuwania awarii, poprzez szybszą reakcję z wykorzystaniem instrukcji operacyjnych (runbooków), aż po pełną automatyzację powtarzalnych zadań naprawczych, pozostawiając inżynierom decyzje złożone i nietypowe.

Alertmanager i Grafana Alerting wysyłają webhook HTTP do narzędzi takich jak Ansible, Terraform czy Rundeck, które wykonują konkretne akcje - restart usługi, zmianę konfiguracji, uruchomienie planu skalowania. Model human-in-the-loop pozwala systemowi przygotować gotową akcję i czekać na zatwierdzenie dyżurnego, podczas gdy pełna auto-remediation sprawdza się tam, gdzie akcja jest bezpieczna, odwracalna i idempotentna - na przykład auto-skalowanie przy przekroczeniu progu zasobów.

Wyjaśnienie skrótów użytych na slajdzie:
SelfHealing – Self-Healing Infrastructure – infrastruktura samonaprawiająca się; Architektura automatycznie restartująca uszkodzone procesy przed zaalarmowaniem człowieka.
AutoRemediation – Automated Remediation Workflows – zautomatyzowane potoki naprawcze; Skrypty wyzwalane webhookiem w momencie nadejścia alertu (np. wyczyszczenie pamięci podręcznej).
Webhook – HTTP Automation Webhook – webhook automatyzacji; Wywołanie sieciowe uruchamiające zadanie naprawcze w zewnętrznym systemie orkiestracji.
Ansible – Ansible Automation Platform – narzędzie automatyzacji Ansible; Narzędzie wykonujące automatyczne playbooki naprawcze w odpowiedzi na sygnał z Alertmanagera.
K8s – Kubernetes Self-Healing – samonaprawianie w Kubernetesie; Wbudowany mechanizm orkiestratora automatycznie restartujący niesprawne pody na podstawie sond liveness.

32/55 Podsumowanie alertingu (cz. 1)
Podsumowanie alertingu (cz. 1): Utrwalenie najważniejszych pojęć: Alertmanager jako centrum alertów oraz dobór kanałów komunikacji do severity. Porządkuje wiedzę i pomaga uniknąć typowych błędów.

Mapa pipeline w pięciu zdaniach: centrum, kanały, mapa i pułapki nowicjuszy. Narysujesz ją na kartce.

  • Zunifikowany moduł Grafany – środowisko Grafana integruje zarządzanie alertami pochodzącymi z Prometheusa, bazy Loki oraz tradycyjnych baz SQL.
  • Wizualny kreator reguł – graficzny interfejs ułatwia tworzenie warunków logicznych inżynierom, którzy nie opanowali jeszcze składni PromQL.
  • Konfiguracja odbiorców – punkty kontaktowe Contact Points pozwalają wygodnie definiować integracje z komunikatami bezpośrednio w przeglądarce.
  • Podgląd na żywo – prezentacja historycznych wykresów metryki w oknie edycji pozwala na natychmiastową ocenę skuteczności ustawianego progu.
  • Synchronizacja reguł – Grafana może współpracować z zewnętrznym klastrem Alertmanagera, zapewniając spójne reguły w całej korporacji.
Ścieżka metryka→powiadomienie: Reguły w PromQL, Alertmanager w centrum i kanały dobrane do severity; mapa chroniąca przed typowymi błędami.
podsumowanie

Podsumowanie modułu alertingu porządkuje wiedzę w zwarty zestaw pojęć i buduje MAPĘ: co idzie gdzie, dlaczego i co można mylić. Dwie najważniejsze warstwy to: (1) Alertmanager jako centrum alertów - jego role i zachowania; (2) kanały i komunikatory - jak wybieramy drogę dostarczenia. Po tym podsumowaniu powinieneś umieć narysować pipeline od metryki do powiadomienia na kartce.

Alertmanager - centrum alertów (powtórka ról): 5 podstawowych funkcji, które warto zapamiętać zwięźle: Deduplikacja - z wielu alertów (również z HA) robi jedno powiadomienie (notification log); Grupowanie - łączenie pokrewnych alertów w grupę przez group_by i obsługę czasów (group_wait 30s, group_interval 5m, repeat_interval 4h); Routowanie - drzewo tras (route tree) z matcherami kieruje alert do właściwego zespołu/kanału (root = catch-all, child = specyficzne); Inhibicja - tłumi objaw, gdy znana jest przyczyna (critical wycisza warning, np. DB down ... app errors wyciszone); Wyciszanie (silences) - kontrolowane wyłączenie alertów na czas konserwacji (ręcznie lub przez API). Do tego H A: ≥2 instancje z gossip (memberlist), replikacja stanu (silences, notification log), fail-open. Gdy to utrwalisz, pół wykładu masz "w kieszeni".

Kanały i komunikatory (powtórka): wybór kanału = funkcja severity alertu i wymaganego czasu reakcji. Czat (Slack, Discord, Teams, Mattermost) - bieżące operacje, warning/info, rich formatting, wątki, przyciski (Acknowledge/Silence/Runbook); SMS/Push/Phone (Twilio, PagerDuty, OpsGenie) - gwarancja dostarczenia i natychmiastowe zaalarmowanie on-call dla SEV-1/SEV-2; E-mail - formalne dokumenty, digesty, raporty, dokumentacja (nie do bieżącej obsługi incydentu krytycznego); Strony statusowe (statuspage, Cachet) - komunikacja z zewnętrznymi klientami i biznesem; Webhook - integracje niestandardowe (Jira, ServiceNow, boty, automatyka). Zasada multi-channel: alert krytyczny idzie RÓWNOLEGLE kilkoma kanałami (np. SMS + push + Slack), bo żaden pojedynczy punkt nie może być SPOF czuwania.

Dlaczego podsumowanie chroni przed błędami (wartość "mapy"): typowe błędy początkujących biorą się z mieszania pojęć: mylą grouping z routingiem (grupowanie - ile powiadomień; routowanie - DOKĄD); mylą silences z inhibicją (silence - manualne wyciszenie; inhibition - automatyczne i warunkowe); mylą receiver (gdzie) z kontakt point/notification policy w Grafanie; zapominają o repeat_interval i nadużywają alertów "na wszystko". Jeśli masz jasną mapę, te błędy znikają - bo wiesz, KTO jest odpowiedzialny za co w pipeline: Prometheus wykrywa (reguła), Alertmanager decyduje (5 ról), komunikator dostarcza (kanał), człowiek reaguje.

Praktyczna wskazówka do zapamiętania tego slajdu: narysuj na kartce w pionie: Metric → PromQL (expr) → Alert Rule (for, labels, annotations) → Alertmanager (dedup → group → route → inhibit → silence) → Receiver (Slack/PagerDuty/Email/Webhook) → On-call → Action. Do każdej strzałki dopisz "co robi ten komponent". Jako ćwiczenie samodzielne: wyjaśnij KOLEŻANCE, dlaczego alert o wartości p99 podnosi się, ale przez 4 minuty nie postawi Cię na nogi (odpowiedź: for: 5m + group_wait 30s). Terminologia: pipeline alertingowy, deduplication, grouping, routing, inhibition, silence, receiver, contact point, notification policy, multi-channel, severity→channel mapping, HA cluster, notification log.

Przez ostatnich kilkanaście slajdów poznawaliśmy kolejne elementy pipeline'u alertowego - od konstrukcji reguł w PromQL, przez role Alertmanagera, aż po integrację z logami i automatyzację reakcji - i nadszedł czas, by uporządkować tę wiedzę w zwarty zestaw pojęć, który pozwoli narysować na kartce pełną ścieżkę od metryki do powiadomienia. To podsumowanie ma też praktyczną wartość: uchroni przed typowymi błędami początkujących, którzy mylą routing z grupowaniem czy silences z inhibicją.

Alertmanager pełni pięć podstawowych funkcji - deduplikację, grupowanie, routowanie, inhibicję i wyciszanie - a do tego działa w konfiguracji wysokiej dostępności z protokołem gossip i replikacją stanu. Wybór kanału komunikacji zależy od severity alertu i wymaganego czasu reakcji: czat dla bieżących operacji, SMS i push dla krytycznych incydentów wymagających natychmiastowej reakcji, e-mail dla formalnej dokumentacji, a strony statusowe do komunikacji z klientami zewnętrznymi.

Wyjaśnienie skrótów użytych na slajdzie:
Alertmanager – Prometheus Alertmanager – menedżer alertów Prometheus; Podsumowanie pierwszej części wykładu poświęconej przetwarzaniu i routingowi powiadomień.
Prometheus – Prometheus Monitoring Server – serwer monitoringu Prometheus; Silnik ewaluacji reguł alertowych operujący na szeregach czasowych TSDB.
PromQL – Prometheus Query Language – język zapytań Prometheus; Język formułowania zapytań matematycznych definiujących warunki alarmowe.
Grouping – Alert Grouping Mechanism – mechanizm grupowania powiadomień; Technika redukcji szumu łącząca powiązane alerty w pojedyncze wiadomości.
Silencing – Alert Silencing Mechanism – mechanizm wyciszania powiadomień; Narzędzie planowego blokowania alarmów na czas okien serwisowych.

33/55 Podsumowanie alertingu (cz. 2)
Podsumowanie alertingu (cz. 2): Kluczowe mechanizmy Alertmanagera: grouping scala podobne alerty, silence wycisza na czas konserwacji, a webhook uniwersalnie wysyła powiadomienia do zewnętrznych systemów.

Trzy narzędzia robią klimat dyżuru: grupowanie (mniej), wyciszanie (ciszej) i webhook (wszędzie).

  • Ekrany informacyjne w biurze – wielkoformatowe monitory w przestrzeni zespołu prezentują syntetyczne wskaźniki zdrowia platformy i aktywne awarie.
  • Intuicyjna kolorystyka – zastosowanie prostego kodu barw pozwala każdemu członkowi zespołu błyskawicznie ocenić stan kluczowych komponentów.
  • Transparentność prac – tablice telemetryczne budują kulturę otwartości i wspierają szybką koordynację działań pomiędzy zespołami inżynierów.
  • Skupienie na celach SLO – prezentowane widoki powinny koncentrować się na metrykach użytkowników i tempie zużycia budżetów błędów w serwisie.
  • Umiar wizualny – unikanie migających elementów i zbędnych wykresów chroni pracowników przed przebodźcowaniem i niepotrzebnym stresem w pracy.
Inhibition: Wyciszanie alertów pochodnych, gdy strzela nadrzędny; z grupowaniem i webhookiem - trzy filary mechaniki Alertmanagera.
słownik

Trzy mechanizmy najczęściej decydują o tym, czy alerting jest dla zespołu wsparciem, czy udręką: grouping (grupowanie - redukcja szumu), silence (wyciszenie - kontrola nad alertami w czasie operacji) i webhook (uniwersalne wyjście do świata zewnętrznego). Zrozumienie tych trzech narzędzi daje poczucie sprawczości - pozwalają kształtować doświadczenie dyżurnego według własnych potrzeb, zamiast biernie przyjmować to, co Prometheus zrobi domyślnie.

Grouping (grupowanie) - polega na scalaniu podobnych alertów w JEDEN komunikat. Alertmanager używa group_by - listy etykiet, których kombinacja tworzy klucz grupy; np. group_by: [alertname, cluster] = wszystkie alerty o tym samym alertname i klastrze lecą jako jedna wiadomość (z listą dotkniętych instancji w treści). Efekt redukcji szumu jest dramatyczny: 50 alertów z 50 instancji → 1 powiadomienie. Do tego timingi: group_wait (ile czekamy na dozbieranie alertów do grupy), group_interval (jak często analizujemy grupę ponownie - nowe alerty w grupie), repeat_interval (jak często POWTARZAMY przypomnienie o aktywnym alercie). Złe ustawienie grupowań to najczęstsza przyczyna zarówno "spamu", jak i "ciszy przy dużej awarii" - dlatego grupuj zawsze po tym, co CHCESZ widzieć razem (ten sam problem), a nie po tym, co jest przypadkowo wspólne.

Silence (wyciszenie: wyciszenie alertów na ustalony czas - nieodzowne podczas planowanych prac. Składniki: matchers (np. alertname="HighCpuLoad", cluster="dev") wybiórcza celowana; startsAt / endsAt - okno ciszy (czasem przed maintenance, by "otworzyć się" automatycznie); createdBy (kto) i comment (po co) - wymagane do audytu (silence bez komentarza to źródło zamieszania). Środowisko: tworzysz ręcznie w UI Alertmanagera lub automatycznie przez REST API (np. pipeline CI/CD przed deployem zakłada silence, po deployu je odwołuje). Uwaga: silences działają na MATCHING etykiet - zbyt szeroki matcher (albo zbyt wąski) to klasyczny błąd: szeroki wyciszy za dużo (w tym ostrzeżenia, które chcieliśmy zostawić), wąski nie wyciszy tego, co trzeba. Zawsze pisz "zgodę na wyciszenie" wprost do przycisku "Silence" w UI - projekt działający na 2 kliknięcia.

Webhook (uniwersalna wysyłka): HTTP POST z pełnym JSON-payload alertu do zewnętrznego systemu. To "konektor uniwersalny" - gdy nie ma gotowej integracji (albo wolisz własną transformację), webhook robi wszystko: integracje z systemami ticketing (Jira/ServiceNow - alert staje się zgłoszeniem), czatami (Slack/Discord/Teams - wystarczy URL), własne boty i narzędzia automatyzacji (patrz slajd 31 - Ansible, Rundeck), a także mosty do starych systemów (SNMP! patrz slajd 28). Webhook ma też ważną cechę z punktu widzenia bezpieczeństwa: sam URL bywa tokenem (Slack incoming webhook) - więc trzymaj go jak sekret i autoryzuj odbiorcę po stronie własnej (HMAC/JWT/mTLS, slajd 27). Opcje: send_resolved (czy wysyłać powiadomienie o rozwiązaniu), headers (niestandardowe nagłówki - w tym uwierzytelnienie), retry z backoffem po stronie Alertmanagera.

Zestawienie i praktyka na koniec: grupowanie zmniejsza liczbę wiadomości, wyciszenie (silence) blokuje powiadomienia na określony czas, a webhook łączy system z zewnętrznymi narzędziami. Te trzy mechanizmy razem pozwalają zbudować alerting, który jest cichy w normalnych czasach, głośny w kryzysie i wpięty w resztę organizacji. Do zapamiętania (przed przejściem do zadań): (1) group_by = klucze grupowania, (2) silences = matchers (match/!=, =~, !~) + okno czasowe + comment, (3) webhook = POST + JSON + autoryzacja. Terminologia: grouping (grupowanie), group_by, group_wait/group_interval/repeat_interval, silence (wyciszenie), matchers, startsAt/endsAt, createdBy, comment, webhook, send_resolved, payload JSON, integration (integracja), endpoint.

Podsumowanie kontynuuje utrwalenie kluczowych mechanizmów Alertmanagera, skupiając się na trzech narzędziach, które najczęściej decydują o tym, czy alerting jest dla zespołu wsparciem, czy udręką: grupowaniu redukującym szum powiadomień, wyciszaniu umożliwiającym kontrolę nad alertami w czasie operacji oraz webhookowi jako uniwersalnemu wyjściu do świata zewnętrznego. Zrozumienie tych trzech elementów daje poczucie sprawczości - pozwalają kształtować doświadczenie dyżurnego według własnych potrzeb.

Grouping scala podobne alerty w jeden komunikat dzięki parametrom group_wait, group_interval i repeat_interval, a złe ustawienie tych wartości jest najczęstszą przyczyną zarówno spamu, jak i ciszy przy dużej awarii. Silence pozwala wyciszać alert na ustalony czas z precyzyjnymi matcherami i audytowalnym komentarzem, natomiast webhook wysyła HTTP POST z pełnym JSON-payloadem do dowolnego systemu zewnętrznego - od systemów ticketingowych, przez boty czatu, aż po mosty do starych środowisk SNMP.

Wyjaśnienie skrótów użytych na slajdzie:
MultiBurnRate – Multi-Burn-Rate Alerting Architecture – architektura alertingu wielokrotnego spalania; Podsumowanie drugiej części wykładu poświęconej zaawansowanemu powiadamianiu na bazie SLO.
SLO – Service Level Objective – cel poziomu usług; Nadrzędna miara niezawodności organizująca cały system powiadamiania inżynierskiego.
On-call – On-call Engineering Practice – praktyka dyżurów inżynierskich; Zasady sprawnego pełnienia dyżurów alarmowych z zachowaniem higieny pracy.
MTTA – Mean Time To Acknowledge – średni czas potwierdzenia alertu; Wskaźnik mierzący dyscyplinę i szybkość podjęcia działań po wezwaniu pagera.
MTTR – Mean Time To Recover – średni czas przywrócenia sprawności; Miara końcowego sukcesu inżynierskiego w usuwaniu awarii produkcyjnej.

34/55 Praca własna: zadania (alerting)
Praca własna: zadania (alerting): Hands-on lab - skonfiguruj Alertmanagera, wyślij powiadomienie na czat oraz napisz skrypt w Pythonie do wysyłki alertów. Praktyczne utrwalenie materiału.

Potok składasz rękami: Alertmanager, czat i skrypt Pythona. Każdy krok z mierzalnym efektem.

  • Dedykowany kanał incydentu – podczas poważnej awarii dyskusja powinna zostać bezzwłocznie przeniesiona na odrębny kanał komunikatora firmowego.
  • Rzeczowa komunikacja – wpisy na kanale awaryjnym muszą być syntetyczne, ograniczać się do sprawdzonych faktów i podejmowanych decyzji.
  • Oficer komunikacji – wyznaczenie osoby do kontaktu z resztą organizacji odciąża inżynierów diagnozujących usterkę od pytań o status.
  • Cykliczne meldunki – publikowanie zwięzłych podsumowań co 30 minut uspokaja interesariuszy i zapewnia spójny obraz postępów akcji ratunkowej.
  • Ślad do post-mortem – kompletny zapis rozmów z kanału incydentowego stanowi kluczowy materiał badawczy podczas sporządzania raportu z awarii.
Pipeline hands-on: Metryka → reguła → powiadomienie → odbiorca; konfiguracja Alertmanagera, czat i skrypt Python jako praktyczne utrwalenie.
lista zadań

Praca własna (hands-on lab) utrwala materiał przez REALNE, działające środowisko, a nie przez czytanie. Cel jest trzystopniowy i odzwierciedla pipeline z wykładu: (1) skonfigurować Alertmanagera (config, route tree, receiver), (2) wysłać testowe powiadomienie na czat (Slack lub Discord) przez webhook, (3) napisać skrypt w Pythonie, który sam wysyła powiadomienia. Po ukończeniu umiesz ZROBIĆ od zera działający alerting: metryka/zdarzenie → alert → powiadomienie → odbiorca na telefonie/Slacku; każdy krok ma mierzalny efekt "działa".

Krok 1 - Konfiguracja Alertmanagera: uruchom Alertmanager lokalnie (najprościej: docker run --rm -p 9093:9093 -v $(pwd)/alertmanager.yml:/etc/alertmanager/alertmanager.yml prom/alertmanager albo docker compose). Minimalny plik alertmanager.yml: global: {smtp_*, resolve_timeout}; route: {group_by: [alertname], group_wait: 10s, group_interval: 5m, repeat_interval: 4h, receiver: 'default'} - albo rozbudowane drzewo z child routes (np. dla severity=critical inny receiver); receivers: z nazwami i, na początek, prostym webhook_configs: - url: 'http://localhost:8090/hook' (testowy odbiornik). Weryfikacja krokowa: otwórz http://localhost:9093 (UI), a po zmianach configu zobacz "Current Configuration" - jeśli YAML niepoprawny, Alertmanager się nie przeładuje (błąd w UI czerwony). Dodatkowe: --storage.path dla trwałego stanu.

Krok 2 - Wysyłka na czat (Slack/Discord przez webhook): (a) załóż kanał testowy i utwórz Incoming Webhook (Slack: Apps → Incoming Webhooks → Add to Slack → skopiuj URL hooks.slack.com/services/...; Discord: server settings → Integrations → Webhooks → New Webhook → URL discord.com/api/webhooks/...); (b) sprawdź webhook bezpośrednio: curl -X POST -H 'Content-type: application/json' --data '{"text":"Test alertu"}' [URL_WEBHOOKA] - powinieneś zobaczyć wiadomość na czacie; (c) podłącz jako receiver w alertmanager.yml (slack_configs: api_url, channel, username, icon_emoji ALBO webhook_configs url), przeładuj config i wyślij testowy alert z reguły (lub kliknij przycisk "Post test alert" w UI Alertmanagera → wybierz receiver). Mierzalny efekt: wiadomość na kanale z poprawnym formatowaniem.

Krok 3 - Python do wysyłki (requests/httpx): napisz skrypt notify.py, który wysyła powiadomienie na ten sam webhook: prosty wariant - requests.post(url, json={"text": "ALERT: ..."}, timeout=10); poprawny produkcyjnie - obsługa błędów (status_code != 200 → log + retry), biblioteka httpx do wersji async, dodatkowo nagłówek Content-Type i zmienne środowiskowe na webhook URL (NIE wpisuj URL w kodzie, to sekret!). Rozszerzenie wg uznania: przyjmuj argument (message/severity), wyślij w strukturze embed (Discord) z kolorem severity. Mierzalny efekt: uruchomiasz python notify.py "test" i dostajesz wiadomość w czacie.

Kroki sprawdzenia (success criteria): (1) `curl http://localhost:9093/-/healthy` → {"status":"ok"}; (2) w UI Alertmanagera widać poprawny YAML config (bez błędów parsowania); (3) klik "Post test alert" → na czacie pojawia się wiadomość testowa; (4) skrypt Python wysyła wiadomość na ten sam kanał; (5) (bonus) reguła Prometheus (np. z użyciem node_exporter) faktycznie wyzwala alert, który dociera do czatu - test E2E: wysokie obciążenie CPU / zapełnienie dysku generuje alert, Alertmanager grupuje/routuje, czat dostaje powiadomienie, a po powrocie do normalności przychodzi resolved. Czas realizacji: 1-2 h. Materiały pomocnicze: slajdy 7-15, 42-43, dokumentacja prometheus.io/docs/alerting. Terminologia: alertmanager.yml, route, receiver, webhook URL, incoming webhook, Post test alert, node_exporter, E2E test.

Przez cały wykład budowaliśmy kolejne ogniwa alertingu - od reguł PromQL, przez Alertmanagera, aż po integracje z komunikatorami. Teraz przyszedł czas, by połączyć ten potok w całość i zobaczyć, że metryka faktycznie zamienia się w powiadomienie w telefonie. Praca własna ma strukturę trzech zadań, które odzwierciedlają realny pipeline: metryka, reguła, powiadomienie, odbiorca. To nie jest ćwiczenie teoretyczne - każdy krok ma mierzalny efekt, a po ukończeniu potrafią państwo zbudować działający alerting od zera.

Zadanie pierwsze to uruchomienie Alertmanagera i minimalny alertmanager.yml z drzewem tras i receiverem, najlepiej w kontenerze Docker. Drugie to dostarczenie testowego powiadomienia na czat Slack lub Discord przez incoming webhook - zaczynamy od sprawdzenia adresu komendą curl, a kończymy przyciskiem Post test alert w interfejsie. Trzecie to skrypt w Pythonie, który sam wysyła wiadomość na ten sam webhook, z obsługą błędów i zmiennymi środowiskowymi zamiast wklejonych sekretów. Na koniec test end-to-end na przykładzie node_exportera.

Wyjaśnienie skrótów użytych na slajdzie:
VM – Virtual Machine – maszyna wirtualna; Środowisko laboratoryjne wykorzystywane przez studentów do uruchomienia demonstracyjnego stosu powiadomień.
Docker – Docker Container Platform – platforma konteneryzacji Docker; Środowisko uruchamiania Alertmanagera i emulatorów webhooków w laboratoriach akademickich.
Prometheus – Prometheus Server – serwer Prometheus; Instancja konfigurowana przez studentów w ćwiczeniach praktycznych z pisania reguł alertowych.
Alertmanager – Alertmanager daemon – demon Alertmanagera; Usługa podlegająca samodzielnej konfiguracji przez studentów pod kątem routingu i integracji.
Slack – Slack Platform Integration – integracja z platformą Slack; Docelowy kanał komunikatora, na którym studenci testują odbiór komunikatów alarmowych.

35/55 Najczęstsze błędy w alertingu
Najczęstsze błędy w alertingu: Antywzorce, które czynią alerting nieefektywnym: niejasne treści alertów, brak ścieżki eskalacji oraz szum (alert fatigue). Każdy alert musi mieć kontekst i drogę eskalacji.

Słaby alert kosztuje więcej niż żaden: zgadywanie, brak eskalacji i szum. Trzy grzechy i recepty.

  • Hierarchia ważności zdarzeń – ustandaryzowana skala priorytetów Sev pozwala na natychmiastową ocenę powagi awarii oraz potrzebnych zasobów.
  • Poziom krytyczny Sev-1 – oznacza paraliż newralgicznych funkcji biznesowych i wymaga natychmiastowego zwołania całego sztabu kryzysowego.
  • Poziom wysoki Sev-2 – oznacza częściową degradację platformy lub utratę redundancji, wymagając pilnej interwencji w godzinach pracy.
  • Poziom niski Sev-3 – drobne usterki i anomalie niefinansowe są rejestrowane w systemie zgłoszeń i planowane do naprawy w kolejnym sprincie.
  • Jednoznaczne reguły – jasny podział priorytetów eliminuje jałowe spory kompetencyjne i uruchamia z góry określone procedury eskalacyjne.
Audyt alertów: Przegląd reguł pod kątem jasności treści, ścieżki eskalacji i szumu; słaby alert bywa kosztowniejszy niż jego brak.
błędy

Katalog antywzorców (anti-patterns) przy alertingu opiera się na realnych incydentach: niejasne treści (ambiguity), brak eskalacji (no escalation path) i szum (alert fatigue) to trzy główne grzechy czyniące alerting nieefektywnym, a wręcz groźnym. To "co NIE robić" - każdy punkt to realny incydent spakowany w lekcję, czyli "Lessons Learned" dla alert engineers.

Niejasne treści: brak kontekstu (co, gdzie, jak poważne), brak runbook_url, ambiguous thresholds (co oznacza "high CPU"?). Alert bez kontekstu = operator zgaduje = wyższy MTTR. Każdy alert musi mieć: what, where, how bad, what to do. Runbook URL = mandatory dla critical/warning.

Brak eskalacji: alert fire'uje, nikt nie dostaje (brak receiver), lub wszyscy dostają (brak routing rules). Escalation policy = MUST HAVE. Multi-level escalation = safety net. Brak eskalacji = alert ginie w szumie, a awaria się wydłuża.

Porady praktyczne: Zacznij od pytań (co chcemy wiedzieć? jakie decyzje podejmujemy?), zbuduj minimalny (MVP: 3-5 paneli), iteruj (dodawaj panele po jednym na podstawie feedbacku), zbieramy feedback (on-call retro, dev survey, mgmt sign-off), wersjonuj w Git (GitOps). Iterative dashboard development = nie buduj "idealny" od razu, buduj użyteczny i ewoluuj.

Równie ważne jak wiedza, jak alerty projektować, jest wiedza, jak ich nie psuć. Antywzorce, o których teraz będziemy mówić, nie są akademicką abstrakcją - każdy z nich wywodzi się z realnych incydentów, w których słaby alert okazał się kosztowniejszy niż jego brak. Jeśli potrafią je państwo rozpoznać u siebie, zyskują narzędzie do audytu własnej konfiguracji, zanim pierwszy taki alert obudzi dyżurnego o trzeciej w nocy.

Pierwszym grzechem jest niejasna treść: alert bez informacji, co się dzieje, gdzie i jak poważnie, zmusza operatora do zgadywania i wydłuża MTTR, a niejasne progi w rodzaju wysokie CPU bywają nieczytelne. Drugim - brak drogi eskalacji, gdy alert nie trafia do żadnego receivera albo odwrotnie, do wszystkich. Trzecim - szum wywołany nieistotnymi powiadomieniami, który prowadzi do zmęczenia alertami. Remedium to link do runbooka, czytelne poziomy ważności i regularne przeglądy.

Wyjaśnienie skrótów użytych na slajdzie:
AlertOnAverage – Alerting on Averages Anti-pattern – antywzorzec alarmowania na średnich; Poważny błąd inżynierski polegający na badaniu średniej arytmetycznej latencji zamiast percentyli p99.
NoRunbook – Missing Runbook Link Anti-pattern – antywzorzec braku instrukcji operacyjnej; Błąd pozostawiający dyżurnego inżyniera bez wskazówek w środku nocy.
TooManyAlerts – Excessive Alert Volume Anti-pattern – antywzorzec nadmiaru powiadomień; Sytuacja, w której setki nieistotnych powiadomień paraliżują codzienną pracę zespołu.
HardcodedTokens – Hardcoded Credentials Anti-pattern – antywzorzec zaszytych poświadczeń; Naruszenie bezpieczeństwa polegające na umieszczaniu tokenów webhooków w otwartym kodzie.
Flapping – Uncontrolled Alert Flapping – niekontrolowane migotanie alertu; Zaniedbanie parametru 'for' wywołujące naprzemienne wysyłanie alertów i powiadomień resolved.

36/55 Bilans: szum vs przeoczenie
Bilans: szum vs przeoczenie: Celem jest równowaga między precyzją (precision) a czułością (recall) alertów. Lepiej zaakceptować część fałszywych alarmów niż przeoczyć prawdziwy incydent.

Zbyt wysoka czułość generuje szum fałszywych alarmów, natomiast zbyt niska przepuszcza realne awarie. Równowagę mierzy się precyzją i czułością (metryka F1), co wymaga ciągłej kalibracji i systematycznego strojenia progów.

  • Rola dowódcy incydentu – dowódca Incident Commander posiada pełną władzę operacyjną i koordynuje przebieg całej akcji naprawczej platformy.
  • Zarządzanie sztabem – dowódca deleguje konkretne zadania badawcze, pilnuje porządku na kanale i podejmuje kluczowe decyzje o wycofaniu zmian.
  • Zadania oficera łącznikowego – redaguje oficjalne komunikaty dla zarządu oraz przygotowuje publiczne oświadczenia dla klientów platformy.
  • Skupienie techniczne inżynierów – eksperci analizują telemetrię i testują hipotezy naprawcze, nie będąc niepokojonymi przez osoby z zewnątrz.
  • Metodyczne opanowanie kryzysu – precyzyjny podział ról zapobiega chaosowi decyzyjnemu i przyspiesza opanowanie nawet najcięższej katastrofy.
Precision kontra recall: Precyzja (mało fałszywych) przeciw czułości (zero przeoczonych); lepiej zaakceptować fałszywe alarmy niż zgubić incydent.
równowaga

Balans szumu alertów i przeoczonych incydentów wyważa się między skrajnościami: zbyt dużo alertów (alert fatigue) vs za mało (missed detection). Precision/recall, F1 score i koszt false positive vs false negative determinują, czy alert jest "worth it" - to inżynieria progów, nie zgadywanie.

Zbyt duże progi - Reactive, nie Proactive: Ustawienie alertu na `up == 0` (usługa down) albo `error_rate > 50%` = REAKTYWNE. Gdy alert wyzwala się, usługa JUŻ nie działa, użytkownicy JUŻ cierpią, SLO JUŻ naruszone. Dobre progi = LEADING INDICATORS (wskaźniki wiodące): Saturation (CPU > 80%, memory > 85%, disk > 80%, connection pool > 80%) - System NADCHODZI do limitu, ale jeszcze działa. Latency trend (p95 rośnie 10%/h) - degradacja W TRAKCIE. Error rate growth (error rate rośnie z 0.1% na 1% w 30min) - coś się psuje. Proactive > Reactive: wykrywasz problem 30-60min PRZED user impact, masz czas na mitigację (scale, restart, rollback) BEZ naruszenia SLO.

Bilans: False positive cost (alert fatigue, wasted engineer time) vs False negative cost (downtime, SLA breach, customer churn). Cost of false positive = ~15 min engineer time. Cost of false negative = $10k-1M+ per hour downtime. Math: inwestuj w sensitivity, akceptuj pewne false positives. "Lepiej 10 fałszywych alarmów niż 1 przeoczone incydent".

Terminologia: precision (precyzja), recall (czułość), F1 score, alert fatigue (zmęczenie alertami), missed detection (przeoczenie), cost of false positive vs false negative (koszt fałszywego alarmu vs koszt przeoczenia).

Każdy system alertowy porusza się między dwiema skrajnościami: zbyt wiele powiadomień znieczula zespół, a zbyt mało sprawia, że problemy przechodzą niezauważone. Ten slajd dotyczy wyważenia tych dwóch ryzyk, czyli znalezienia takiego progu, przy którym system dostarcza nam najlepszy obraz rzeczywistości. Warto już teraz podkreślić, że nikt nigdy nie osiąga idealnej równowagi - dobra konfiguracja to efekt ciągłego dostrajania progów na podstawie tego, co pokazują dane.

Do opisu tego balansu wprowadzamy metryki zaczerpnięte z klasyfikacji: precyzję, czyli ile wyzwolonych alertów było trafnych, oraz czułość, czyli jak wiele prawdziwych zakłóceń udało się wykryć, a ich harmoniczną miarą jest wynik F1. Koszty są asymetryczne: fałszywy alarm kosztuje rutynowo około piętnastu minut pracy inżyniera, podczas gdy przeoczenie incydentu to godziny przestoju i utracony budżet błędów. Stąd zasada - lepiej zaakceptować część fałszywych alarmów niż stracić sygnał o realnym problemie.

Wyjaśnienie skrótów użytych na slajdzie:
SNR – Signal-to-Noise Ratio – stosunek sygnału do szumu; Kluczowa miara jakości systemu alertowania; dążenie do maksymalizacji realnych alertów przy zerowym szumie.
FalsePositive – False Positive Alarm – fałszywy alarm (błąd I rodzaju); Alert wyzwolony w sytuacji, gdy usługa działała w pełni poprawnie dla użytkowników.
FalseNegative – False Negative Failure – niezauważona awaria (błąd II rodzaju); Najgroźniejsza sytuacja: usługa uległa awarii, lecz żaden alert nie został wygenerowany.
Precision – Alert Precision Metric – precyzja alertowania; Ułamek wygenerowanych alertów, które rzeczywiście wymagały natychmiastowej interwencji człowieka.
Recall – Alert Recall Metric – pełność alertowania; Ułamek rzeczywistych awarii produkcyjnych, które zostały pomyślnie wykryte przez reguły alertowe.

37/55 Monitorowanie samego alertingu
Monitorowanie samego alertingu: Meta-alerting (observability of observability) - testy dostarczania alertów, monitoring Alertmanagera i dead man's switch (heartbeat) gwarantują, że system ostrzegania sam nie zawiedzie.

Alerting też pada - i to po cichu. Trzy mechanizmy: testy doręczenia, własne metryki i dead man’s switch.

  • Publiczne strony statusowe – stanowią oficjalne i transparentne źródło wiedzy o dostępności serwisów dla klientów, inwestorów oraz mediów.
  • Niezależna infrastruktura – strona statusowa musi być hostowana u całkowicie odrębnego dostawcy chmury, aby działać w trakcie awarii firmy.
  • Szybka publikacja meldunków – bezzwłoczne poinformowanie użytkowników o wykryciu usterki buduje zaufanie i zapobiega zalewaniu helpdesku.
  • Aktualizacje w trakcie prac – regularne podawanie szacowanego czasu przywrócenia usług pozwala partnerom biznesowym dostosować swoje plany.
  • Podsumowanie po naprawie – opublikowanie oficjalnej notatki o rozwiązaniu problemu formalnie zamyka incydent w przestrzeni publicznej.
Dead man’s switch: Alert-heartbeat strzelający zawsze; jego brak dowodzi awarii samego systemu ostrzegania (observability of observability).
monitoring alertów

Brak alertów może oznaczać poprawną pracę systemu lub całkowitą awarię serwera Prometheus / Alertmanager. W celu wyeliminowania cichych awarii stosuje się regułę Watchdog (Dead Man's Switch), która stale ewaluuje warunek vector(1) i bezustannie wysyła powiadomienie do zewnętrznego serwisu nadzorczego (np. Dead Man's Snitch, Healthchecks.io). Jeśli zewnętrzny system nie zarejestruje sygnału życia w zadanym interwale (np. 15 minut), natychmiast uruchamia niezależną ścieżkę powiadamiania inżyniera dyżurnego.

Meta-monitoring to monitorowanie samego systemu alertingu (observability of observability): testy dostarczenia (alert delivery tests), monitoring Alertmanagera (up, config reload, queue length) i dead man's switch (heartbeat alert). Terminologia: meta-monitoring, alert delivery health, dead man's switch, heartbeat alert.

Testy dostarczenia: Chaos testing alertów (zabij proces, odłącz sieć, wstrzymaj kontener) → sprawdź czy alert dotrze. Dead man's switch: heartbeat alert co 1 min (jeśli nie przyjdzie → alert). Auto-healing: Alertmanager reload config on SIGHUP. To "who watches the watchmen".

Monitoring Alertmanagera: `up{job="alertmanager"}` = 1, `alertmanager_config_hash` (config reload detection), `alertmanager_alerts` (queue length), `alertmanager_notifications_total` (sent/failed). Alerty bazujące na tych metrykach stanowią pierwszą linię obrony systemu monitoringu.

Terminologia: meta-monitoring (meta-monitoring), alert delivery health (zdrowość dostarczania alertów), dead man's switch (przełącznik martwego człowieka), heartbeat alert (alert serca).

System alertowy sam jest oprogramowaniem, które potrafi zawieść w sposób cichy: serwer ulegnie awarii, kolejka zadań ulegnie przepełnieniu albo konfiguracja przestanie się przeładowywać, o czym zespół dowiedziałby się dopiero po zgłoszeniach użytkowników. Dlatego, podobnie jak każdy inny komponent, monitoring należy monitorować - to meta-alerting, czyli obserwowalność samej obserwowalności, po angielsku opisywana pytaniem, kto pilnuje strażników.

Ten temat rozpada się na trzy mechanizmy. Po pierwsze cykliczne testy dostarczania, w których celowo zabijamy proces albo odcinamy sieć i sprawdzamy, czy alert wciąż dociera do odbiorcy. Po drugie własne metryki Alertmanagera: wskaźnik up, zmiany konfiguracji i długość kolejki powiadomień, które obserwujemy w Grafanie. Po trzecie dead man's switch, czyli cykliczny sygnał serca - gdy nigdy nie przychodzi, sam alert jest potwierdzeniem, że w monitoringu coś uległo zerwaniu.

Wyjaśnienie skrótów użytych na slajdzie:
Watchdog – Prometheus Watchdog Alert – alert nadzorczy Watchdog; Nieustannie aktywny alert weryfikujący czy cała ścieżka powiadamiania działa bez zakłóceń.
DeadMansSwitch – Dead Man's Switch Principle – zasada czuwaka / bezpiecznika bezwładnościowego; Mechanizm wyzwalający alarm zewnętrzny w przypadku braku okresowego potwierdzenia życia.
ALERTS – ALERTS Time Series in Prometheus – szereg czasowy ALERTS w bazie Prometheus; Wewnętrzna metryka Prometheusa rejestrująca bieżący stan wszystkich zdefiniowanych reguł alertowych.
Heartbeat – Heartbeat Signal – sygnał rytmu serca; Okresowy pakiet kontrolny przesyłany do zewnętrznego serwera w celu potwierdzenia sprawności monitoringu.
Snitch – Dead Man's Snitch Service – zewnętrzna usługa nadzorcza snitch; Zewnętrzna platforma w chmurze alarmująca inżynierów w przypadku awarii całego centrum danych i serwerów Prometheusa.

38/55 Historia i dziennik alertów
Historia i dziennik alertów: Analiza częstotliwości i trendów alertów pozwala wykrywać anomalie i sezonowość. Deduplikacja oraz retention policy utrzymują dziennik w porządku.

Historia alertów to seria czasowa: trendy i sezony widać bez ML - wystarczy porównać okresy.

  • Automatyczna remediacja – mechanizmy samonaprawiania potrafią rozwiązać typowe i powtarzalne usterki bez budzenia inżynierów w środku nocy.
  • Cykliczny restart usług – wykrycie zawieszonego procesu może wywołać automatyczny restart kontenera lub bezpieczne wyczyszczenie pamięci podręcznej.
  • Skalowanie horyzontalne – samoczynne dodawanie kolejnych węzłów w chmurze pozwala bezobsługowo zneutralizować nagły napływ nowych klientów.
  • Zabezpieczenia przed pętlą – procedury naprawcze muszą posiadać sztywne limity prób, aby zapobiec zapętleniu restartów w nieskończoność.
  • Ślad w logach audytowych – każda automatyczna ingerencja skryptu naprawczego musi zostać odnotowana w rejestrze na potrzeby weryfikacji zespołu.
Retention policy: Polityka retencji dziennika alertów; z deduplikacją utrzymuje porządek, a analiza częstotliwości wykrywa anomalie i sezonowość.
dziennik

Historia i dziennik alertów obejmują analizę częstotliwości (alert frequency analysis), trendy (seasonality detection), deduplikację historyczną i retention policy - a comparative analysis wykrywa anomalie bez ML ("czy to normalne?") i waliduje capacity planning.

Porównanie z okresami: Time shift `offset 1w` / `offset 4w` w PromQL - ten sam dzień tygodnia/miesiąc temu; wykrywanie trendów/anomalii; year-over-year (YoY), week-over-week (WoW), month-over-month (MoM). To wykrywanie trendów długoterminowych i sezonowych bez ML - proste, interpretowalne, skuteczne.

Zakresy czasu w Grafana - time range picker: Relative (last 1h, 6h, 24h, 7d, 30d), Absolute (custom range: od-do), Time shift buttons (→ 1h, → 1d, → 1w) - szybkie porównanie "teraz vs godzina temu". Time range picker = UI do kontrolowania `$__range` i `$__interval` w zapytaniach. Time shift buttons = one-click time travel. To UI do comparative analysis bez pisania PromQL.

Terminologia: time range compare (porównanie zakresów czasowych), offset (przesunięcie w PromQL), time shift (przesunięcie czasowe), historical comparison (porównanie historyczne), seasonality detection (wykrywanie sezonowości), year-over-year (YoY), week-over-week (WoW).

Alerty, które na co dzień widzą państwo w kanałach komunikacyjnych, pozostawiają po sobie coś jeszcze - historię, czyli dziennik zdarzeń, który można analizować jak każdą inną serię czasową. Dopiero w tej perspektywie widać, czy alarmowanie działa racjonalnie: czy liczba powiadomień rośnie, czy pozostaje stabilna i czy charakteryzuje ją sezonowość. To również fundament oceny efektów zmian, które wprowadzaliśmy w poprzednich slajdach.

W praktyce analiza częstotliwości polega najczęściej na porównaniu bieżącego okresu z analogicznym sprzed tygodnia czy miesiąca - w PromQL służy do tego funkcja offset, a w Grafanie przygotowane przyciski przesunięcia czasowego, co pozwala wykrywać anomalie bez uczenia maszynowego. Porównania rok do roku, tydzień do tygodnia i miesiąc do miesiąca ujawniają sezonowość. Utrzymanie dziennika w porządku zapewniają deduplikacja i jawna polityka przechowywania danych.

Wyjaśnienie skrótów użytych na slajdzie:
Audit – Alert Audit Trail – ścieżka audytu powiadomień; Rejestr wszystkich wygenerowanych, wyciszonych i potwierdzonych alertów podlegający okresowym przeglądom.
HistoricalAlerts – Historical Alert Analytics – analityka historyczna alertów; Analiza statystyczna częstotliwości występowania poszczególnych alarmów w skali kwartału.
TSDB – Time Series Database – baza danych szeregów czasowych; Repozytorium przechowujące metryki ALERTS_FOR_STATE wykorzystywane do badania czasu trwania anomalii.
IncidentLog – Incident Timeline Record – oś czasu incydentu; Zestawienie chronologiczne zdarzeń wykorzystywane w trakcie tworzenia raportu poawaryjnego.
Compliance – Regulatory Compliance in Logging – zgodność z regulacjami i normami; Wymóg formalny wykazania, że wszelkie awarie były natychmiast rejestrowane i obsługiwane.

39/55 Integracja z systemami zgłoszeń
Integracja z systemami zgłoszeń: Alerty trafiają do systemów zgłoszeń (Jira, GitLab/GitHub Issues, ServiceNow, PagerDuty) z przypisaniem (assignee), synchronizacją statusu i SLA.

Nie budź do ticketów: warningi i info idą do Jiry, nie na telefon. Zgłoszenie z właścicielem i SLA.

  • Ryzyko wadliwej automatyzacji – błędnie zaprogramowana procedura samonaprawiania może przekształcić drobną usterkę w globalną katastrofę.
  • Efekt kaskadowego restartu – jednoczesne zrestartowanie wszystkich podów z powodu spowolnienia bazy prowadzi do nagłego odcięcia wszystkich ludzi.
  • Zjawisko Thundering Herd – restartowane węzły aplikacyjne rzucają się naraz do bazy danych, doprowadzając do jej całkowitego zablokowania.
  • Wykładnicze rozproszenie zapytań – algorytmy ponawiania muszą stosować losowe przesunięcia czasowe Jitter, chroniąc usługi przed przeciążeniem.
  • Wyłączniki awaryjne Circuit Breaker – automatyzacja musi posiadać bezpieczniki odcinające działanie skryptów w obliczu nietypowych anomalii.
Ślad audytowy: Formalny zapis w systemie zgłoszeń (Jira, ServiceNow, PagerDuty) z przypisaniem, statusem i SLA; alerty niskiego priorytetu nie budzą w nocy.
ticket

Integracja alertingu z systemami zgłoszeniowymi (Jira, GitLab Issues, GitHub Issues, ServiceNow, a także PagerDuty w warstwie incident managementu) ma sens, bo nie każde zgłoszenie to "SEV-1 page o 3 w nocy": wiele alertów (warning, info, powtarzające się problemy) powinno nie BUDZIĆ nikogo, lecz trafić jako widoczne, przydzielone, śledzone zgłoszenie - problem rozwiązuje się w tle, nie gubi w czacie. Alerting → ticket to formalizacja i ślad (audit), że dany problem został zauważony i jest się nim zajmować.

Systemy i integracje: w praktyce wzorce są trzy: (1) webhook z Alertmanagera/Grafany do API systemu (Jira REST API tworzy issue, GitLab/GitHub Issues API tworzy issue/summary; custom middleware dodaje pole labels, assignee, description z alertu); (2) gotowe mostki - np. Alertmanager → webhook → Jira Automation lub integracja PagerDuty z Jira Service Management (page + ticket w jednym); (3) synchronizacja dwukierunkowa realizowana przez middleware/adapters (skrypty, Apache NiFi, własne serwisy). ServiceNow - typowy wzorzec dla dużych firm: alert → nowa "incident" (z klasyfikacją), z polami odwzorowanymi (u_criticality, assignment_group, short_description). PagerDuty: integracja natywna - powiadomienie tworzy "incident" z numerem, linkami do runbooków i odpowiednim priorytetem, a potem syncuje statusy.

Przypisanie (assignee i odpowiedzialność): przypisanie z alertu/zespołu jest kluczowe, bo "problem bez właściciela" się nie rozwiązuje. Mapowanie zwykle: z etykiety team (np. labels.team=payments → Jira issue ma assignee z grupy payments), z mapy fallback (gdy brak team → domyślny queue/zespół), oraz SLA response (pole na tickecie trzyma maksymalny czas odpowiedzi). W Jira/ServiceNow konfigurujesz "routing" - po przyjściu issue, automatyczne przypisanie do konkretnego użytkownika lub kolejki. Zasada: alert bez możliwości wskazania właściciela to alert, który "zostanie zaniedbany" - dlatego w route tree dbamy o label team na każdym alercie.

Synchronizacja statusu (bi-directional sync): prawdziwa wartość tej integracji wynika z jej dwukierunkowości. Po pierwsze, synchronizacja w przód automatycznie tworzy zgłoszenie w systemie Jira po wyzwoleniu alertu, a po ustąpieniu problemu oznacza je jako rozwiązane wraz z dołączeniem metadanych diagnostycznych. Po drugie, synchronizacja wsteczna sprawia, że gdy inżynier podejmie pracę nad zgłoszeniem i zmieni jego status na „W toku”, system automatycznie wycisza alert w Alertmanagerze (silence). Zapobiega to sytuacji, w której zespół analizuje problem, a system nadal generuje nadmiarowe powiadomienia o tej samej awarii. Synchronizacja musi być idempotentna, co osiąga się przez unikalny identyfikator incydentu oraz znaczniki czasu do deduplikacji.

SLA dla ticketów i podsumowanie: zgłoszenia mają własne SLA - na poziomie systemu ticketing definiuje się czasy odpowiedzi i rozwiązania (np. specyficzny SLA dla "warning" z alertingu: response 8h, resolution 3 dni robocze), które są częścią szerszej umowy SLA wobec biznesu. Numer SLA śledzisz w Jira (moduł SLA) lub w ServiceNow (SLA Definition - metryka SLA). Dobre praktyki: (1) ticket z alertu powinien zawierać WSZYSTKIE informacje z powiadomienia (summary, runbook_url, dashboard link, generatorURL) - żeby technik w Jira nie musiał szukać; (2) oddzielaj severity page (PagerDuty/phone) od flow do ticketa (warning/info → Jira); (3) monitoruj "tickety z alertingu" osobno (ile powstało, ile przeterminowanych SLA, ile przeklasyfikowanych na incydenty). Terminologia: ticketing system (system zgłoszeń), assignee (właściciel zgłoszenia), assignment_group, bi-directional sync (synchronizacja dwukierunkowa), external_id, SLA (umowa o poziomie usług), incoming incident, queue (kolejka), Jira/ServiceNow/GitLab Issues/GitHub Issues/PagerDuty, middleware.

Nie każde zdarzenie w monitoringu zasługuje na to, by obudzić kogoś w nocy. Alerty o niższym priorytecie - ostrzeżenia, informacje, nawracające problemy - powinny trafić do miejsca, w którym będą widoczne, przypisane i śledzone aż do rozwiązania, a nie ginąć w czacie. Tutaj z pomocą przychodzą systemy zgłoszeniowe, do których alerting kieruje zgłoszenia automatycznie, tworząc jednocześnie formalny ślad audytowy, że problem został dostrzeżony.

Omówimy integracje z Jirą, systemami Issues z GitLaba i GitHuba oraz z ServiceNow i PagerDuty. Kluczowe elementy to przypisanie odpowiedzialnego, najczęściej wyprowadzane z etykiety zespołu w alercie, oraz synchronizacja dwukierunkowa: zamknięcie alertu zamyka zgłoszenie, a zmiana statusu w systemie zgłoszeń wycisza alerty w Alertmanagerze. Aby uniknąć pętli, stosujemy unikalny identyfikator zewnętrzny zgłoszenia, a dla ostrzeżeń definiujemy odrębne cele SLA.

Wyjaśnienie skrótów użytych na slajdzie:
Jira – Atlassian Jira Service Management – system zarządzania zgłoszeniami Jira; Popularna platforma rejestrowania zadań inżynierskich i śledzenia postępów prac naprawczych.
ServiceNow – ServiceNow Enterprise ITOM – platforma operacyjna ServiceNow; Korporacyjny system zarządzania incydentami i zmianami w architekturze teleinformatycznej.
Redmine – Redmine Project Management – system zarządzania projektami Redmine; Otwartoźródłowy system rejestracji błędów zintegrowany z webhookami powiadomień.
Ticket – Incident Management Ticket – zgłoszenie incydentu; Ustrukturyzowany rekord w bazie danych zawierający przypisanego inżyniera, priorytet i historię działań.
SLA – Service Level Agreement – umowa o poziomie usług; Kontrakt handlowy definiujący maksymalny dopuszczalny czas rozwiązania zgłoszenia w systemie ticketowym.

40/55 Najlepsze praktyki (cz. 1)
Najlepsze praktyki (cz. 1): Testuj progi (threshold testing, A/B), dodawaj opis akcji do adnotacji (runbook_url), grupuj alerty i używaj szablonów powiadomień. Iteracyjne ulepszanie.

Dobre praktyki w zdaniu: testuj, dopisuj kontekst, grupuj i szablonuj. Ściągawka przed produkcją.

  • Weryfikacja reguł promtool – oficjalne narzędzie pozwala na automatyczne testowanie poprawności składniowej i logicznej w potokach CI/CD.
  • Testy jednostkowe alertów – symulowanie ciągów czasowych metryk sprawdza, czy reguła PromQL aktywuje się dokładnie w zakładanych warunkach.
  • Wczesne wykrywanie błędów – sprawdzanie reguł przed wdrożeniem do repozytorium kodu zapobiega awariom paraliżującym serwer Prometheus.
  • Weryfikacja szablonów wiadomości – walidacja poprawności zmiennych w szablonach chroni zespół przed otrzymaniem pustych powiadomień na czacie.
  • Standardy jakości kodu – traktowanie reguł monitoringu jako pełnoprawnego kodu źródłowego gwarantuje najwyższą stabilność obserwowalności.
Szablony powiadomień: Wspólny format treści alertów; z testami progów (A/B), runbookiem w adnotacjach i grupowaniem - iteracyjne ulepszanie.
praktyki

Najlepsze praktyki alertingu ("cheat sheet" do code review alertów): progi testowane (threshold testing, A/B testing), opis akcji w adnotacjach (runbook_url, runbook steps), alert grouping i notification templates - z iteracyjnym usprawnianiem. Terminologia: threshold testing, A/B testing, runbook, notification template, annotation, alert grouping.

Progi testowane - threshold testing: A/B testing progów (baseline vs new threshold), chaos testing (zabij proces, wypełnij dysk) → weryfikuj alert. Automated threshold tuning (ML-based) = future. Threshold testing = eliminuje "zgaduję próg".

Opis akcji w adnotacjach: runbook_url w adnotacjach = operator ma procedurę pod ręką. Template: `summary: "High CPU on {{ $labels.instance }}", description: "See runbook: {{ .Annotations.runbook_url }}"`. Annotations = context dla on-call.

Alert grouping: group_by (alertname, cluster), group_wait (30s), group_interval (5m), repeat_interval (4h). Deduplication = 1 notification per incident. Grouping = cognitive load reduction.

Notification templates: Go templates (.tmpl) dla formatowania wiadomości. Variables: {{ .Labels }}, {{ .Annotations }}, {{ .Value }}, {{ .GeneratorURL }}. Custom templates = branding, actionable info.

Po omówieniu typowych błędów czas na pozytywną checklistę, czyli zasady, których przestrzeganie sprawia, że alerting pozostaje skuteczny także po latach eksploatacji. Ta część praktyk stanowi swego rodzaju ściągawkę do przeglądu reguł - co sprawdzić, zanim alert trafi na produkcję i zanim wystawimy go dyżurnemu. Całość można zamknąć w jednym zdaniu: testuj, dopisuj kontekst, grupuj i korzystaj z szablonów.

Pierwsza zasada to testowanie progów: zamiast ustawiać wartości na oko, porównujemy w środowisku nowy próg z dotychczasową linią bazową w trybie A/B i celowo wywołujemy awarię, by sprawdzić, czy alert faktycznie wystrzeli. Druga to umieszczenie w adnotacjach całego kontekstu - linku do runbooka i kolejnych kroków naprawy. Trzecia to grupowanie powiązanych alertów parametrami group_by, group_wait i repeat_interval, a czwarta jednolite szablony Go, które czynią treść powiadomień spójną i czytelną.

Wyjaśnienie skrótów użytych na slajdzie:
ActionableAlerts – Principle of Actionable Alerts – zasada powiadomień wykonalnych; Fundament higieny operacyjnej nakazujący usuwanie każdego alertu, który nie wymaga natychmiastowego działania.
SymptomsOverCauses – Alerting on Symptoms not Causes – alarmowanie na objawach a nie przyczynach; Praktyka wykrywania problemu od strony użytkownika (np. błędy HTTP) zamiast od strony hipotetycznych przyczyn.
Runbooks – Mandatory Operational Runbooks – obowiązkowe instrukcje operacyjne; Zasada, zgodnie z którą żadna reguła alertowa nie może trafić na produkcję bez sprawdzonego odnośnika do instrukcji.
MultiWindow – Multi-Window Multi-Burn-Rate Strategy – strategia dwuokiennego tempa spalania; Standard zapobiegający powiadamianiu dyżurnego o krótkotrwałych pikach obciążenia.
Thresholds – Statistically Sound Thresholds – uzasadnione statystycznie progi; Wyznaczanie progów alarmowych na podstawie długoterminowych linii bazowych zamiast arbitralnych założeń.

41/55 Najlepsze praktyki (cz. 2)
Najlepsze praktyki (cz. 2): Prowadź regularne przeglądy alertów (monthly/quarterly), dokumentuj runbooki i właścicieli alertów oraz zarządzaj cyklem życia reguł z polityką deprecacji.

Reguły starzeją się jak kod: przybywa, progi się rozjeżdżają, właściciele zapominają. Rytuały trzymają porządek.

  • Testy inżynierii chaosu – kontrolowane wstrzykiwanie awarii w środowisku testowym pozwala zweryfikować realną skuteczność reguł monitoringu.
  • Symulacja awarii węzła – celowe wyłączenie maszyny sprawdza, czy powiadomienie dotarło na czas oraz czy zawierało poprawną instrukcję naprawczą.
  • Wykrywanie martwych stref – brak reakcji systemu powiadamiania na celowo wywołany problem ujawnia groźne luki w pokryciu telemetrycznym.
  • Trening procedur operacyjnych – ćwiczenia wstrzykiwania błędów pomagają młodym inżynierom oswoić się ze stresem i doskonalić odruchy ratunkowe.
  • Ciągła walidacja obserwowalności – regularne próby sprawnościowe budują zaufanie do automatycznych systemów ostrzegania przed awariami.
Deprecation policy: Polityka wycofywania przestarzałych reguł; z przeglądami (miesięczne/kwartalne), runbookami i właścicielami - higiena cyklu życia.
praktyki

Druga część kodeksu najlepszych praktyk skupia się na cyklu życia alertów i ich "higienie": regularne przeglądy, dokumentacja (runbooki i właściciele), zarządzanie cyklem życia reguły i jawna polityka deprecacji. Kazus z wcześniejszego bloku pokazuje, co się dzieje, gdy tego NIE robimy - reguły się mnożą, progi przestają pasować, alerty stają się szumem; odpowiedzią są procedury, które utrzymują alerting dokładnym przez lata, nie tylko w dniu wdrożenia.

Przeglądy regularne (monthly / quarterly alert review): stały rytm przeglądu alertów to "przegląd okresowy zasobów" jak w finanse. Co robić na takim review: (1) Przejdź przez wszystkie alerty krytyczne, które możesz dostać - świetnym punktem wyjścia jest dashboard alertów (Alertmanager UI / Grafana) i pytanie: "czy ten alert jest nadal potrzebny? czy progi realne?"; (2) Wyszukaj dead alerts - alerty, które w ciągu 90 dni nie wyzwoliły się ani razu ani nie zostały wywołane ręcznie; (3) Wyszukaj "zdublowane" reguły - alerty o tych samych labelach (które powodują duplikację); (4) Przejdź przez alerty o niskiej wartości (low-value), które nigdy nie doprowadziły do podjęcia działań operacyjnych (ratio użyteczność/ignorowanie); (5) Sprawdź, czy właściciele i runbooki są aktualne. Wynik review: lista zmian (dostrojenie progu, usunięcie reguły, nowa reguła) - commity w Git, ale tylko po zatwierdzeniu.

Dokumentacja i właściciel alertów (runbook linkage + alert ownership): każdy alert na środowisku produkcyjnym musi wskazywać jednoznacznego właściciela - najczęściej przez label team i wpis w repozytorium (alertmeta: owner: team-payments, runbook: URL). Runbook to link (runbook_url) do procedury naprawy - konkretne kroki dla tego alertu. Dobra praktyka skrajna: alert bez runbooka i bez właściciela jest traktowany jako "nieopublikowany" - CI odrzuca taką regułę (lint w GitLab: sprawdza obecność annotation runbook_url i label team). Dokumentacja nie jest ozdobnikiem - ON-CALL jej potrzebuje o 3 w nocy, gdy pół umysłu śpi; procedura napisana wcześniej, przetestowana i pod ręką = krótki MTTR; zgadywanie przy gorącym alercie = długi MTTR i ryzyko błędu.

Lifecycle management (cykl życia reguły): każda reguła przechodzi etapy - pomyśl o nich jak o "uczeń → czeladnik → mistrz → emeryt": (1). Development - powstaje na podstawie analizy incydentu/problemu, pisana w staging; (2). Staging/Warning - wdrożona jako warning (bez page'owania), testowana w środowisku i w chaos; obserwacja czy generuje false positives; (3). Production/Critical - po okresie obserwacji i dostrojeniu progu podniesiona do krytycznego, z runbookiem i właścicielem; (4). Review/Monitor - stale monitorowana w review (slajd wyżej); (5). Deprecated - gdy technologia się zmienia, alert jest wycofywany wg deprecation policy. Reguła bez przydzielonego właściciela NIE może przejść do produkcji.

Deprecation policy (polityka wycofywania): rzadko mówi się o tym głośno, a zupełnie tak samo ważne jak dodawanie nowych alertów: określa, KTO, JAK i KIEDY wycofuje nieaktualne reguły. Wzór polityki: (1). Każda reguła ma metadane (created_date, owner, slack/on-call kontakt); (2). Jeśli alert nie wyzwolił się / nie był użyteczny przez 90 dni → automatyczna oznaka do przeglądu; (3). Wycofanie: komunikat na Slacku (warning "reguła X przeznaczona do usunięcia, zgłoś sprzeciw w 7 dni") → po okresie bez zgłaszania usunięcie z repo (commit + review); (4). Śledzenie wskaźnika: ile reguł usunięto/dodano kwartalnie (to też metryka higieny). Zasada: usunięcie reguły to NIE "strata" - to zmniejszenie kosztów operacyjnych, szumu i szansy na fałszywy alarm. Mniej, ale lepszych alertów = wyższa skuteczność.

Podsumowanie w 4 zdaniach: (1) Reviewuj alerty regularnie (monthly) i usuwaj dead/low-value reguły; (2) Każdy alert ma WŁAŚCICIELA (team) i RUNBOOK (runbook_url) - bez tego nie przechodzi do produkcji; (3) Prowadź jawny cykl życia: dev → warning/staging → production → review → deprecated; (4) Wycofuj reguły wg deprecation policy z ogłoszeniem i audytem. Terminologia: alert review, dead alert, low-value alert, runbook linkage, alert ownership, lifecycle management, deprecation policy, staging alert, production alert (warning→critical), CI lint, alert hygiene metrics.

Najlepsze praktyki z poprzedniego slajdu dotyczyły pojedynczej reguły; teraz zajmiemy się całym cyklem życia alertów w perspektywie miesięcy i kwartałów. System bez systematycznego przeglądu nieuchronnie degraduje się: reguł przybywa, progi przestają pasować do zmieniającej się infrastruktury, a właściciele zapominają o swoim alercie. Odpowiedzią jest proceduralna higiena alertingu - rytuały, które utrzymują system precyzyjnym długo po dniu wdrożenia.

Zaczynamy od regularnych przeglądów, w których szukamy reguł martwych, czyli nieaktywnych przez dziewięćdziesiąt dni, zduplikowanych oraz niosących niską wartość. Następnie każdy alert musi mieć jawnego właściciela i podpięty runbook, a reguły, którym tego brakuje, nie powinny przejść kontroli w linii CI. W końcu prowadzimy je przez jawny cykl życia od wersji roboczej, przez ostrzegawczą, produkcyjną, aż po wycofanie w ramach polityki deprecacji z ogłoszeniem i okresem na zgłoszenie sprzeciwu.

Wyjaśnienie skrótów użytych na slajdzie:
Grouping – Aggressive Alert Grouping – rygorystyczne grupowanie alertów; Łączenie komunikatów według klastrów i usług w celu eliminacji szumu informacyjnego.
Inhibit – Cascading Failure Inhibition – hamowanie powiadomień kaskadowych; Automatyczne wygaszanie alertów podrzędnych po zarejestrowaniu awarii węzła głównego.
SustainableOnCall – Sustainable On-call Culture – zrównoważona kultura dyżurów; Dbanie o zdrowie psychofizyczne inżynierów i przestrzeganie limitów obciążenia incydentami.
PostMortem – Blameless Post-mortem Review – przegląd poawaryjny bez obwiniania; Systematyczna analiza każdego fałszywego lub przeoczonego alertu po zakończeniu incydentu.
NoiseReduction – Continuous Noise Reduction – ciągła redukcja szumu alarmowego; Cykliczny przegląd i eliminacja reguł generujących najwięcej niepotrzebnych powiadomień w organizacji.

42/55 Studium: integracja ze Slack
Integracja ze Slackiem: Hands-on lab - konfiguracja receivera (slack_configs), test wysyłki przez webhook oraz praktyczny troubleshooting i obsługa limitów zapytań.

Slack podpinasz raz, a działa zawsze: receiver, test curlem i przycisk w UI. Pułapki to literówki i limity.

  • Koncepcja meta-monitoringu – odpowiada na kluczowe pytanie inżynierii niezawodności: kto nadzoruje system monitoringu, gdy ten sam ulegnie awarii?
  • Zewnętrzne sondy sieciowe – niezależne usługi chmurowe z zewnątrz cyklicznie badają dostępność serwerów Prometheus i Alertmanagera.
  • Ryzyko oślepienia zespołu – awaria potoków telemetrycznych jest skrajnie groźna, ponieważ pozbawia inżynierów wszelkiej wiedzy o stanie systemów.
  • Niezależna ścieżka powiadomień – kanał alarmowy meta-monitoringu musi funkcjonować w całkowitej izolacji od infrastruktury produkcyjnej firmy.
  • Fundament najwyższej dostępności – wdrożenie solidnego meta-monitoringu jest warunkiem koniecznym do uzyskania wskaźników SLA rzędu 99.99%.
slack_configs: Sekcja receivera Slack w Alertmanagerze; test webhooka, troubleshooting i limity zapytań w ćwiczeniu warsztatowym.
Slack
CLI · Slack: webhook (curl)
user@server:~$ curl -X POST -H 'Content-type: application/json' \ --data '{"text":"Alert: usługa niedostępna"}' \ https://hooks.slack.com/services/T000/B000/XXXX ok

Studium przypadku integracji Alertmanagera ze Slackiem: konfiguracja receiver (slack_configs: api_url, channel, username, icon_emoji), test wysyłki (test alert, webhook verification) i praktyczny przewodnik (troubleshooting, rate limits). Hands-on lab. Terminologia: Slack integration, webhook URL, receiver config, rate limiting, troubleshooting.

Slack receiver: slack_configs (api_url, channel, username, icon_emoji). Slack blocks (blocks JSON): sections, dividers, actions (buttons), context. Formatting: markdown (mrkdwn), bold, italic, code blocks.

Discord webhook: webhook URL, content, embeds (title, description, color, fields, footer, timestamp), username/avatar override. Rate limits: 30 requests/minute per webhook. Rate limit handling = exponential backoff.

Templates: Go templates (.tmpl) w Alertmanagerze. Variables: {{ .Status }}, {{ .GroupLabels }}, {{ .CommonAnnotations }}, {{ .Alerts }}. Custom templates = branding, dodatkowe pola, linki do runbooków/dashboardów. Template reuse = zmiana w jednym miejscu = aktualizacja wszędzie. Library panels = single source of truth dla wspólnych paneli.

Terminologia: webhook (webhook), incoming webhook (webhook przychodzący), slack_config, discord_config, template (szablon), markdown, blocks, embed, rate limit.

Przechodzimy teraz od zasad do konkretnego wdrożenia, które łączy w sobie niemal wszystko, o czym mówiliśmy: receiver, webhook, szablony i testowanie. Studium integracji ze Slackiem to warsztat krok po kroku, w którym konfigurację Alertmanagera sprawdzają państwo na własnym przykładzie, a nie na abstrakcyjnym schemacie. Tego rodzaju ćwiczenie najlepiej pokazuje, gdzie w teorii czekają na nas pułapki - od literówek w adresie URL po limity zapytań.

Zaczynamy od sekcji slack_config w pliku alertmanager.yml, w której definiujemy adres webhooka, kanał, nazwę nadawcy i ikonę. Następnie testujemy sam kanał komendą curl z prostym komunikatem, a potem już całą ścieżkę przyciskiem Post test alert w interfejsie Alertmanagera. Doświadczenie podpowiada przy okazji, jak radzić sobie z najczęstszymi problemami - błędną konfiguracją, limitami zapytań i formatowaniem wiadomości z użyciem bloków oraz składni mrkdwn.

Wyjaśnienie skrótów użytych na slajdzie:
SlackAPI – Slack Webhook and Bot API – interfejs API platformy Slack; Programowy punkt styku umożliwiający publikowanie ustrukturyzowanych bloków powiadomień (Block Kit).
IncomingWebhook – Incoming Webhook Endpoint – punkt końcowy przychodzącego webhooka; Unikalny, chroniony adres URL w platformie Slack przyjmujący żądania POST z Alertmanagera.
Channel – Dedicated Incident Channel – dedykowany kanał incydentu; Wydzielone miejsce na komunikatorze przeznaczone do dyskusji i automatycznych powiadomień o awarii.
Payload – JSON Message Payload – ładunek danych wiadomości w formacie JSON; Ustrukturyzowany dokument tekstowy zawierający kolory, tytuły i odnośniki do wykresów w komunikatorze.
Bot – Slack Integration Bot – bot integracji platformy Slack; Programowy agent reprezentujący system monitoringu w przestrzeni roboczej zespołu.

43/55 Studium: Python + Discord
Python + Discord: Hands-on - skrypt w Pythonie wysyłający alerty na webhook Discorda. Formatowanie wiadomości (embeds, fields, colors) oraz obsługa rate limits i retry.

Nadawcę budujesz od strony Pythona, gdy alert rodzi się poza Prometheusem: skrypt, cron albo logika biznesowa.

  • Mechanizm Dead Man's Switch – technika polega na stałym wysyłaniu sygnału potwierdzającego, że centralny system monitorujący poprawnie żyje.
  • Nieustannie aktywny alert – dedykowana reguła PromQL generuje ciągły sygnał kontrolny przesyłany cyklicznie do zewnętrznego serwisu czuwakowego.
  • Alarm na brak sygnału – zewnętrzny system wszczyna alarm telefoniczny wyłącznie wtedy, gdy regularny meldunek nie nadejdzie w wyznaczonym czasie.
  • Wykrywanie całkowitego paraliżu – metoda bezbłędnie namierza utratę zasilania, zerwanie łącza światłowodowego lub awarię systemu operacyjnego.
  • Pewność ciszy w nocy – zastosowanie czuwaka daje inżynierom stuprocentową gwarancję, że brak telefonów oznacza brak problemów w systemie.
Rate limits: Limity tempa API Discorda; formatowanie (embeds, fields, colors) z obsługą limitów i retry w skrypcie nadawcy.
Discord

Studium przypadku integracji Pythona z Discorde: skrypt (discord.py, discord.py-self), formatowanie wiadomości (embeds, fields, colors), webhook URL i rate limiting. Hands-on example. Terminologia: Discord webhook, discord.py, embed, rate limit, webhook URL.

Discord webhook: webhook URL, content, embeds (title, description, color, fields, footer, timestamp). Rate limits: 30 requests/minute per webhook. Retry logic = exponential backoff.

Python script: discord.py / discord-webhook library. Embed builder (title, description, color, fields, footer, timestamp). Async (aiohttp) = non-blocking. Error handling = retry + logging.

Terminologia: Discord webhook (webhook Discorda), discord.py (biblioteka), embed (wkładka), rate limit (limit zapytań), webhook URL (URL webhooka).

Poprzednie studium pokazało integrację przez receiver w Alertmanagerze; teraz odwracamy perspektywę i budujemy nadawcę od strony Pythona. To częsty scenariusz w praktyce, gdy alert to nie wynik reguły Prometheusa, lecz zdarzenie z własnego skryptu, planowane zadanie albo logika biznesowa. Dzięki odpowiedniej bibliotece i prostemu webhookowi cała wysyłka sprowadza się do kilkudziesięciu linii kodu, które można wpiąć w dowolny proces.

Do wysyłki na webhook Discorda używamy biblioteki discord.py, a wiadomość budujemy w strukturze embeda z tytułem, opisem, kolorem oznaczającym powagę oraz polami z wartościami metryk. Pamiętać trzeba o limitach zapytań - około trzydziestu na minutę na jeden webhook - dlatego w kodzie przewidujemy ponawianie prób z wykładniczym wycofaniem. Na końcu weryfikujemy odpowiedź serwera i utrwalamy poprawny skrypt jako szablon do wielokrotnego użycia.

Wyjaśnienie skrótów użytych na slajdzie:
DiscordWebhook – Discord Webhook Integration – integracja webhooka platformy Discord; Interfejs komunikacyjny Discorda obsługujący asynchroniczne powiadomienia w formacie JSON.
requests – Python Requests Module – moduł requests w Pythonie; Narzędzie programistyczne służące do szybkiego przesyłania ładunków telemetrycznych z kodu skryptu.
Embeds – Discord Rich Embeds Format – bogaty format ramek w Discordzie; Format wizualny umożliwiający kolorowanie paska bocznego wiadomości w zależności od krytyczności (np. czerwony dla awarii).
JSON – JavaScript Object Notation – format JSON; Format przesyłania sformatowanych pól tytułu, opisu i znaczników czasu do API komunikatora.
Python3 – Python 3 Runtime Environment – środowisko uruchomieniowe Python 3; Nowoczesna platforma uruchamiania zautomatyzowanych skryptów operacyjnych SRE.

44/55 Raportowanie skuteczności alertów
Raportowanie skuteczności alertów: Mierzymy czas reakcji (MTTA, MTTR), poprawiamy progi (alert tuning) i raportujemy na dashboardach efektywności (alert volume, resolution rate).

Alerting to inwestycja: mierzysz MTTA/MTTR, stroisz progi i pokazujesz trend na pulpicie.

  • Trwała rejestracja zdarzeń – wszystkie aktywowane powiadomienia, potwierdzenia odbioru i wyciszenia powinny być archiwizowane w bazie audytowej.
  • Weryfikacja czasu reakcji – baza zgłoszeń pozwala precyzyjnie zmierzyć rzeczywisty czas MTTA i wykazać dotrzymanie warunków umownych SLA.
  • Nadzór nad wyciszeniami – cykliczny audyt blokad zapobiega zamiataniu problemów pod dywan poprzez bezterminowe uciszanie trudnych alertów.
  • Kwartalne analizy trendów – dane historyczne stanowią obiektywną podstawę do planowania prac refaktoryzacyjnych i inwestycji w architekturę.
  • Spełnienie wymogów compliance – niezmienny dziennik akcji operacyjnych jest niezbędny do pozytywnego przejścia audytów bezpieczeństwa IT.
Alert volume: Wolumen alertów na dashboardzie efektywności; z MTTA/MTTR, resolution rate i strojeniem progów mierzy zwrot z alertingu.
raport

Procedury powiadamiania o incydentach teleinformatycznych w infrastrukturze krytycznej standaryzuje CERT Polska.

Raportowanie skuteczności alertów opiera się na czasie reakcji (MTTA - Mean Time To Acknowledge, MTTR - Mean Time To Resolve), poprawie (alert tuning, threshold tuning) i dashboardach efektywności (alert volume, resolution rate, MTTA/MTTR trends) - to output pipeline: dashboardy dla ludzi, raporty dla systemów/biznesu. Terminologia: MTTA, MTTR, alert tuning, effectiveness dashboard, resolution rate.

MTTA (Mean Time To Acknowledge): średni czas od alertu do ACK przez on-call. Cel: < 5 min dla SEV-1. MTTR (Mean Time To Resolve): średni czas od alertu do rozwiązania. Cel: < 30 min dla SEV-1.

Alert tuning: false positive reduction (threshold tuning, grouping), false negative prevention (coverage analysis, coverage testing). Continuous improvement loop: alert → incident → post-mortem → rule update.

Dashboard efektywności: alert volume (trend), resolution rate (%), MTTA/MTTR trends, false positive rate, false negative rate. Executive summary = business value. Alerting = investment, raport = ROI.

Terminologia: MTTA (średni czas do potwierdzenia), MTTR (średni czas do naprawy), alert tuning (dostrajanie alertów), effectiveness dashboard (pulpit skuteczności), resolution rate (wskaźnik rozwiązywania).

Na zakończenie części poświęconej warstwie powiadomień zerkniemy na kwestię, którą zespół SRE rzadko porzuca: mierzenie skuteczności samego alertingu. Alerting traktujemy jak inwestycję, a więc wymaga raportu zwrotu - czy czas reakcji się poprawia, czy maleje liczba fałszywych alarmów i czy progi nadal odpowiadają rzeczywistości. Bez takiej miary nietrudno o system, który teoretycznie działa, a w praktyce nie wnosi żadnej wartości.

Mierzymy przede wszystkim czas reakcji: MTTA, czyli średni czas do potwierdzenia alertu przez dyżurnego, oraz MTTR, czas do rozwiązania, śledząc je także w percentylach, by uchwycić wyjątkowo długie przypadki. Na tej podstawie prowadzimy ciągłe dostrajanie alertów, redukując fałszywe alarmy przez zmianę progów i grupowań, a jednocześnie dbając o wykrywanie incydentów przeoczonych. Wyniki prezentujemy na pulpcie efektywności z wolumenem alertów, wskaźnikiem rozwiązywania i trendem MTTA oraz MTTR, które pokazują kierunek zmian.

Wyjaśnienie skrótów użytych na slajdzie:
MTTA – Mean Time To Acknowledge – średni czas potwierdzenia wezwania; Parametr operacyjny analizowany na cotygodniowych przeglądach w celu weryfikacji dostępności dyżurnych.
MTTR – Mean Time To Recover – średni czas naprawy; Miara skuteczności procedur runbookowych w skracaniu rzeczywistego przestoju usługi.
SNR – Signal-to-Noise Ratio – stosunek sygnału do szumu; Odsetek alertów, które wymagały podjęcia natychmiastowych kroków naprawczych w danym miesiącu.
AlertVolume – Total Alert Volume Metric – całkowity wolumen wygenerowanych alertów; Liczba wyzwoleń pagera w podziale na zespoły, usługi i pory dnia.
PostMortem – Post-mortem Action Items – zadania naprawcze z raportu poawaryjnego; Zobowiązania inżynierskie zmierzające do poprawy czułości lub eliminacji wadliwych reguł alertowych.

45/55 MTTA i MTTR (wstęp)
MTTA i MTTR (wstęp): MTTA to czas do potwierdzenia alertu, MTTR do rozwiązania. Mierzone percentylami (p50/p95); alerting przy przekroczeniu SLA i poprawa przez automatyzację runbooków.

Dwa zegary spinają potok: MTTA (do ack) i MTTR (do fix). Liczysz percentylami, alarmujesz na SLA, skracasz automatyką.

  • Koszty platform powiadamiania – masowa wysyłka wiadomości SMS oraz automatyczne połączenia głosowe generują odczuwalne koszty operacyjne.
  • Hierarchia kanałów łączności – drogie kanały telefoniczne należy rezerwować wyłącznie dla krytycznych katastrof grożących paraliżem biznesu.
  • Darmowe komunikatory internetowe – powiadomienia o mniejszej wadze powinny bezpłatnie trafiać na kanały Slack, Discord lub na firmowy e-mail.
  • Oszczędność dzięki agregacji – grupowanie setek alertów przed ich wysłaniem do bramek SMS radykalnie obniża rachunki za usługi telekomunikacyjne.
  • Dyscyplina finansowa FinOps – inżynierowie SRE powinni stale kontrolować koszty potoków obserwowalności i optymalizować wydatki platformy.
Percentyle reakcji: MTTA/MTTR mierzone jako p50/p95; przekroczenie SLA alarmuje, a automatyzacja runbooków skraca czasy.
MTTA/MTTR

MTTA (Mean Time To Acknowledge) to średni czas do potwierdzenia alertu przez on-call, a MTTR (Mean Time To Resolve) to średni czas od alertu do rozwiązania. Dashboard agreguje p50/p95/p99 per severity, a alerting na MTTR > SLA jest proaktywny. Terminologia: MTTA, MTTR, SLA, percentile, runbook.

MTTA: średni czas do ACK. MTTR: średni czas do resolve. Percentyle: p50 (mediana), p95 (ogon), p99 (tail). Alert rule: `MTTR > 30m` → alert. Dashboard: heatmap MTTA/MTTR per service/severity. Runbook link w alert = faster MTTR.

SLA-driven MTTR: alert gdy MTTR > SLA threshold. Auto-escalation jeśli MTTR > threshold. Runbook automation = MTTR reduction. Target: MTTR < SLA per severity. Continuous improvement = MTTR trend down.

Terminologia: MTTA (średni czas do potwierdzenia), MTTR (średni czas do naprawy), SLA (umowa o poziomie usług), percentile (percentyl), runbook automation (automatyzacja runbooków), auto-remediation (auto-naprawa).

W całym dotychczasowym module budowaliśmy potok alertowania: reguły w Prometheusie, centralny Alertmanager, kanały dostarczania, polityki eskalacji. Pora zadać pytanie, które spina tę infrastrukturę w sensowną całość: jak szybko naprawdę reagujemy, gdy awaria już wystąpi. Odpowiadają na nie dwa wskaźniki - MTTA, czas do potwierdzenia alertu przez dyżurnego, oraz MTTR, czas od alertu do rozwiązania problemu. To one decydują, czy cała machineria powiadamiania realnie skraca skutki awarii, i od nich zaczyna się ocena skuteczności alertowania.

Zobaczmy też, jak te wskaźniki liczymy: zamiast prostej średniej posługujemy się percentylami p50, p95 i p99, które oddzielnie pokazują typową i najgorszą reakcję, dzięki czemu nie gubią się ogony rozkładu. Na tej podstawie budujemy alerting oparty na SLA, na przykład powiadomienie, gdy MTTR przekroczy trzydzieści minut, a pomiary per usługa i per severity trafiają na dashboardy jako heatmapy. W dalszej części slajdu, a później w całym module, zobaczycie, jak automatyzacja runbooków i auto-remediacja skracają te wskaźniki do minimum.

Wyjaśnienie skrótów użytych na slajdzie:
MTTA – Mean Time To Acknowledge – średni czas potwierdzenia alertu; Czas od wygenerowania powiadomienia przez system do naciśnięcia przycisku Acknowledge przez inżyniera.
MTTR – Mean Time To Recover – średni czas przywrócenia sprawności; Czas od rozpoczęcia awarii do pełnego wznowienia poprawnej obsługi ruchu użytkowników.
KPI – Key Performance Indicator – kluczowy wskaźnik efektywności; Parametr ilościowy wykorzystywany do oceny dojrzałości operacyjnej zespołu inżynierii niezawodności.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; Kontrakt handlowy, którego kary są bezpośrednio uzależnione od wartości parametru MTTR.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina techniczna dążąca do maksymalnego skrócenia MTTA poprzez automatyzację powiadomień.

46/55 Wykorzystanie MTTR w SRE
Wykorzystanie MTTR w SRE: Minimalizacja MTTR to cel SRE: automatyzacja reakcji (auto-remediation, auto-scaling, auto-failover), alerting oparty na SLO i ciągłe ulepszanie runbooków.

MTTR to obsesja SRE: najlepszy incydent kończy się najszybciej. Narzędzia biją ludzką szybkość.

  • Automatyczne zgłoszenia w ticketach – bezpośrednia integracja Alertmanagera z Jirą pozwala zakładać zadania dla zespołów bez pracy ludzkiej.
  • Kontekst błędu w zadaniu – zgłoszenie o usterce niskiego priorytetu od razu zawiera wykresy metryk, nazwy serwerów oraz link do runbooka.
  • Samoczynne zamykanie zadań – gdy usterka ustąpi, system potrafi samodzielnie zamknąć zgłoszenie, oszczędzając czas programistów na weryfikację.
  • Eliminacja pracy ręcznej – inżynierowie nie muszą ręcznie przepisywać danych, a historia naprawy pozostaje powiązana z kodem źródłowym.
  • Harmonijna współpraca zespołów – zautomatyzowany przepływ informacji zaciera bariery pomiędzy inżynierami utrzymania a programistami funkcji.
Najlepszy incydent: Ten, który kończy się jak najszybciej; minimalizacja MTTR przez auto-remediation, skalowanie, failover i alerting SLO.
poprawa

Wykorzystanie MTTR w SRE: automatyzacja reakcji (auto-remediation, auto-scaling, auto-failover), SLO-driven alerting (alert na MTTR > threshold) i ciągła poprawa (post-mortem → runbook update → MTTR reduction). SRE = MTTR minimization. Terminologia: auto-remediation, SLO-driven alerting, continuous improvement, MTTR reduction.

Automatyzacja reakcji: auto-remediation (restart, scale, failover), runbook automation (Ansible, Rundeck, custom scripts), auto-failover (DNS, LB, DNS failover). Auto-remediation = MTTR w minutach, nie godzinach. Trigger: alert + runbook → auto-execute.

SLO-driven alerting: alert na MTTR > SLO threshold (np. MTTR > 30min → CRITICAL). Proactive alerting: "MTTR trending up" → early warning. Alert na MTTR = leading indicator.

Terminologia: auto-remediation (auto-naprawa), SLO-driven alerting (alertowanie oparte na SLO), continuous improvement (ciągłe doskonalenie), MTTR reduction (redukcja MTTR).

Skoro wiemy już, czym są MTTA i MTTR oraz jak je mierzyć, warto postawić pytanie, jak SRE naprawdę wykorzystuje te wskaźniki w codziennej pracy. Minimalizacja MTTR nie jest tu celem samym w sobie - im krótszy czas naprawy, tym mniejszy wpływ awarii na użytkowników i tym łatwiejsze utrzymanie zobowiązań SLA. Z tego powodu filozofia SRE opiera się na założeniu, że najlepszy incydent to taki, który kończy się możliwie szybko, a najskuteczniejszy zespół to taki, który nie polega na ludzkiej szybkości, lecz na przygotowanych narzędziach.

W tym ujęciu kluczową rolę gra automatyzacja reakcji: auto-remediacja, czyli automatyczne przywracanie usługi, autoskalowanie i automatyczne przełączenie awaryjne, często uruchamiane bezpośrednio z alertu i powiązanego runbooka. Do tego dochodzi alerting oparty na SLO, który ostrzega, gdy MTTR przekroczy ustalony próg, a wraz z analizą trendów pełni rolę wskaźnika wyprzedzającego. Na koniec zobaczycie, jak zamknięcie post-mortem przekłada się na aktualizację runbooków i dalszą redukcję MTTR.

Wyjaśnienie skrótów użytych na slajdzie:
IncidentLifecycle – Incident Management Lifecycle – cykl życia incydentu; Sekwencja faz awarii: detekcja (MTTD), potwierdzenie (MTTA), diagnoza i naprawa (MTTR).
MTTD – Mean Time To Detect – średni czas wykrycia awarii; Czas upływający od rzeczywistego zepsucia się komponentu do wygenerowania alertu przez system.
MTTR – Mean Time To Recover – średni czas naprawy; Okres przestoju korygowany poprzez usprawnianie procedur runbookowych i automatyzację przełączania failover.
SLO – Service Level Objective – cel poziomu usług; Wskaźnik niezawodności, którego budżet błędów jest chroniony przez minimalizację sumarycznego czasu MTTR.
Review – Operational Metrics Review – okresowy przegląd metryk operacyjnych; Cykliczne spotkanie inżynierów analizujące incydenty o najdłuższym czasie reakcji i naprawy.

47/55 Podsumowanie narzędzi alertingu
Podsumowanie narzędzi alertingu: Przegląd ekosystemu: Grafana Alerting (unified alerting dla wielu źródeł) oraz komunikatory (Slack, Email, PagerDuty, Webhook i inne) jako kanały dostarczania.

Ekosystem w jednym zdaniu: Grafana Alerting na wiele źródeł plus komunikatory jako doręczyciele.

  • Retrospektywa potoków alarmowych – po opanowaniu incydentu zespół powinien szczegółowo ocenić sprawność działania procedur powiadamiania.
  • Analiza skuteczności alertu – należy sprawdzić, czy sygnał nadszedł na czas, czy trafił do właściwej osoby oraz czy runbook zawierał pomocne porady.
  • Luki w regułach detekcji – jeśli zespół dowiedział się o awarii od klientów, a nie z monitoringu, dopisanie nowej reguły jest bezwzględnym priorytetem.
  • Aktualizacja dokumentacji – wnioski z awarii muszą skutkować korektą progów alarmowych i natychmiastowym uzupełnieniem instrukcji naprawczych.
  • Ciągła ewolucja systemu – traktowanie każdej awarii jako szansy na naukę i usprawnienie automatyzacji jest fundamentem sukcesu kultury SRE.
Ekosystem alertingu: Grafana Alerting (wiele źródeł) plus komunikatory (Slack, e-mail, PagerDuty, webhook) jako kanały doręczenia.
mapa

Przegląd ekosystemu alertingu: Grafana Alerting (unified alerting, contact points, notification policies) i komunikatory (Slack, Email, PagerDuty, OpsGenie, Webhook, Telegram, Discord, VictorOps, Microsoft Teams) składają się na unified observability stack - jeden Grafana, wszystkie źródła, jeden alerting UI. To także decyzja "buy vs build": managed vs self-hosted.

Data sources: Prometheus (metrics), Loki (logs), Tempo/Jaeger (traces), MySQL/PostgreSQL (business data), CloudWatch (AWS), Azure Monitor, Elasticsearch. Multi-source = JEDEN dashboard: panel metryk (PromQL) + panel logów (LogQL) + panel traces (TraceQL) + panel biznesowy (SQL) - shared time range, variables, annotations. Unified observability = korelacja bez przełączania kontekstu.

Powiadomienia: Alerting contact points - Slack, Email, PagerDuty, OpsGenie, Webhook, Telegram, Discord, VictorOps, Microsoft Teams. Notification channels = alert reaches right person, right channel, right time. Contact point = gdzie dostarczyć alert.

Terminologia: plugins (wtyczki), connectors (konektory), data source plugins (wtyczki źródeł danych), panel plugins (wtyczki paneli), app plugins (Kubernetes, AWS), contact points (punkty kontaktowe), notification channels (kanały powiadomień).

Po przeanalizowaniu poszczególnych elementów - reguł, Alertmanagera i kanałów dostarczania - warto cofnąć się o krok i spojrzeć na alerting jako spójny ekosystem narzędzi. Na tym slajdzie podsumowujemy ekosystem: Grafana Alerting oferujący tak zwany unified alerting, czyli obsługę alertów ze wszystkich źródeł danych w jednym miejscu, oraz komunikatory służące jako kanały dostarczania. To dobry moment, by zobaczyć, jak poszczególne komponenty grają ze sobą, a także jaką decyzję podejmujemy, wybierając między rozwiązaniem gotowym a własną budową.

W Grafana Alerting reguły, punkty kontaktowe i polityki powiadomień żyją w jednym miejscu, dzięki czemu alerty z Prometheusa, Loki, Tempo, baz SQL czy usług chmurowych trafiają do jednej konsoli - koniec z rozproszonymi punktami alertowania. Komunikatory obejmują między innymi Slack, e-mail, PagerDuty, OpsGenie, webhook, Telegram i Discord, a punkt kontaktowy determinuje, gdzie dany alert zostanie dostarczony. Spójny alerting i powiadamianie to fundament operacyjny SRE, i to właśnie staramy się tu utrwalić.

Wyjaśnienie skrótów użytych na slajdzie:
Alertmanager – Prometheus Alertmanager Component – komponent Prometheus Alertmanager; Niezbędny element nowoczesnego stosu telemetrycznego w środowiskach Cloud Native.
PagerDuty – PagerDuty Incident Management – platforma PagerDuty; Standard przemysłowy w zakresie orkiestracji dyżurów i wielokanałowych powiadomień awaryjnych.
Opsgenie – Atlassian Opsgenie System – system Opsgenie; Wyspecjalizowana platforma zarządzania eskalacją i harmonogramami dyżurów inżynierskich.
Grafana – Grafana Alerting Module – moduł alertowania platformy Grafana; Zintegrowane narzędzie łączące wizualizację danych z elastycznym powiadamianiem wieloźródłowym.
Slack – Slack Operational Messaging – komunikator operacyjny Slack; Podstawowe narzędzie komunikacji zespołowej wykorzystywane w praktykach ChatOps.

48/55 Materiały i literatura (alerting)
Materiały i literatura (alerting): Kuratorowana lista źródeł: dokumentacja Prometheus Alerting, tutoriale Grafana Alerting oraz zweryfikowane linki (prometheus.io, grafana.com, alertmanager docs) - sprawdzone w 2024.

Połowa sukcesu to źródła: docsy twórców zamiast losowych wpisów. Lista żyje i czeka na uzupełnienia.

  • Oficjalna dokumentacja systemów – portale projektów Prometheus i Alertmanager stanowią najbardziej rzetelne źródło wiedzy o składni i funkcjach.
  • Podręczniki inżynierii Google SRE – klasyczne pozycje literaturowe szczegółowo opisują filozofię alertowania opartego na budżetach błędów.
  • Zasoby fundacji CNCF – społeczności skupione wokół rozwiązań chmurowych publikują sprawdzone biblioteki gotowych reguł i pulpitów analitycznych.
  • Publiczne raporty post-mortem – studiowanie analiz powypadkowych czołowych firm technologicznych uczy rozwiązywania nietypowych awarii.
  • Inwestycja w rozwój wiedzy – opanowanie uznanych standardów branżowych buduje wysokie kompetencje poszukiwane na nowoczesnym rynku IT.
Biblioteka alertingu: Dokumentacja Prometheus Alerting, tutoriale Grafana Alerting i Alertmanager docs (zweryfikowane 2024) zamiast losowych źródeł.
strony

Kuratowana biblioteka źródeł (Authoritative Reading List) do alertingu obejmuje dokumentację Prometheus Alerting (recording/alerting rules, Alertmanager config), tutoriale Grafana Alerting (contact points, notification policies, silencing) i Loki/LogQL - wszystkie linki ZWERYFIKOWANE (działają, aktualne, autorytatywne). To "syllabus reading list" dla tego wykładu - student ma od czego uczyć się GŁĘBOKO, nie powierzchownie. Terminologia: ELK docs, Grafana tutorials, verified links, reading list.

Dokumentacja Prometheus Alerting: prometheus.io/docs (configuration, PromQL, storage, federation, best practices, client libraries, alerting rules, service discovery). Grafana Alerting docs: grafana.com/docs (data sources, panels, variables, annotations, provisioning, alerting, Loki, Tempo). Alertmanager docs: alertmanager.io (configuration, routing, inhibition, silencing, HA). Potok metryk w Kubernetes: kubernetes.io/docs/tasks/debug/debug-cluster/resource-metrics-pipeline/ (metrics-server, kube-state-metrics, Prometheus Adapter, HPA/VPA). ALL URLs TESTED (działają 2024, HTTPS, nie 404, nie redirect loops). To living document.

Słownik Terminów - Glossary (Vocabulary Reference): Pełny glossary kluczowych pojęć: SLI (Service Level Indicator), SLO (Service Level Objective), SLA (Service Level Agreement), ERROR BUDGET (budżet błędu = 1-SLO), BURN RATE (tempo spływania budżetu), CARDINALITY (kardynalność = liczba unikalnych serii), QUANTILE (kwantyl/percentyl), HISTOGRAM (buckety + _sum + _count), SUMMARY (kwantyle client-side), GAUGE (miernik góra/dół), COUNTER (licznik monotoniczny), RECORDING RULE (pre-compute), ALERTING RULE (expr + for + labels + annotations → alert). KAŻDE definicja, wzór (jeśli dotyczy), przykład PromQL, powiązane pojęcia. TO SŁOWNIK SRE - bez niego nie czytasz docsów, nie robisz code review, nie rozmawiasz z zespołem.

Artykuły o Alertingu - Authoritative Sources (Google SRE + Grafana Labs): 1) podręcznik Google SRE Workbook "Alerting on SLOs" (sre.google/workbook - KANON: definicje, przykłady, error budget, burn rate, choosing SLOs, SLO vs SLA). 2) "Alerting Principles" - Grafana Labs (grafana.com/blog - plain English explanation, diagrams, real examples). 3) "How to pick alerting thresholds" - Google SRE (sre.google - methodology: user journey → SLI → SLO → error budget → alerting). 4) "Implementing SLOs" - Prometheus + Grafana (grafana.com/blog - practical: recording rules, alerting on SLI, dashboards). te autorytatywne źródła - nie opinie, nie case studies randomowych firm, nie marketingowe whitepaper. Ucz się od twórców modelu SRE.

Linki Zweryfikowane - Verified URLs (All Tested): PROMETHEUS DOCS: prometheus.io/docs (configuration, PromQL, storage, federation, best practices, client libraries, alerting rules, service discovery). GRAFANA DOCS: grafana.com/docs (data sources, panels, variables, annotations, provisioning, alerting, Loki, Tempo). ALERTMANAGER DOCS: alertmanager.io (configuration, routing, inhibition, silencing, HA). Potok metryk w Kubernetes: kubernetes.io/docs/tasks/debug/debug-cluster/resource-metrics-pipeline/ (metrics-server, kube-state-metrics, Prometheus Adapter, HPA/VPA). ALL URLs TESTED (działają 2024, HTTPS, nie 404, nie redirect loops). To living document.

Znajomość narzędzi to dopiero połowa sukcesu - równie ważne jest, skąd czerpiemy wiedzę o ich poprawnej konfiguracji, gdy przyjdzie nam pracować w realnym środowisku. Dlatego na tym slajdzie znajdziecie kuratorowaną listę źródeł, które mogą służyć jako autorytatywna biblioteka na czas nauki i późniejszej pracy. To nie przypadkowe wpisy z wyszukiwarki, lecz dokumentacja i materiały pochodzące od twórców poszczególnych rozwiązań, sprawdzone pod kątem aktualności, tak byście uczyli się głęboko, a nie powierzchownie.

Lista obejmuje dokumentację alertowania w Prometheusie, zawierającą reguły nagrywające i alertowe oraz konfigurację Alertmanagera, tutoriale Grafana dotyczące punktów kontaktowych, polityk powiadomień i szablonów, a także zweryfikowane linki do stron prometheus.io, grafana.com i samego Alertmanagera. Adresy przetestowano w 2024 roku: działają przez HTTPS, nie zwracają błędów i nie wpadają w pętle przekierowań, a całość to dokument żywy, który warto uzupełniać. Zapamiętajcie te źródła - będą towarzyszyć kolejnym modułom kursu.

Wyjaśnienie skrótów użytych na slajdzie:
GoogleSRE – Google Site Reliability Engineering Canonical Books – kanoniczne monografie Google SRE; Podstawowe źródła literatury branżowej definiujące pryncypia niezawodnego alertingu.
Workbook – The Site Reliability Workbook – praktyczny podręcznik SRE Workbook; Monografia wydawnictwa O'Reilly zawierająca szczegółowe formuły matematyczne dla Burn Rate Alerting.
Ewaschuk – Rob Ewaschuk Alerting Philosophy – filozofia alertingu Roba Ewaschuka; Słynny manifest inżynierski 'My Philosophy on Alerting' stanowiący fundament współczesnego monitoringu.
IETF – Internet Engineering Task Force – Grupa Robocza Inżynierii Internetowej; Instytucja publikująca standardy protokołów pocztowych i komunikacyjnych RFC.
RFC – Request for Comments – dokument standaryzacyjny RFC; Podstawowe dokumenty normatywne dla protokołów sieciowych ujęte w bibliografii.

49/55 Zapowiedź wykładu 7
Zapowiedź wykładu 7 (GitOps): Kolejny moduł: ArgoCD (continuous delivery w trybie GitOps, deployment deklaratywny) oraz Docker Compose do lokalnego rozwoju i testów.

Alerting woła, GitOps zapobiega: deklaratywne wdrożenia tną ryzyko u źródła. Za tydzień ArgoCD i Compose.

  • Zapowiedź tematyki GitOps – kolejny wykład wprowadzi metodykę GitOps oraz narzędzie ArgoCD służące do deklaratywnego wdrażania oprogramowania.
  • Pojedyncze źródło prawdy – nauczymy się synchronizować stan klastra z repozytorium kodu, eliminując ryzykowne ręczne modyfikacje na produkcji.
  • Zarządzanie kontenerami – przećwiczymy uruchamianie środowisk wielokontenerowych w oparciu o Docker Compose w ramach ćwiczeń laboratoryjnych.
  • Zapobieganie awariom u źródła – o ile alerty ułatwiają szybkie reagowanie na awarie, o tyle podejście GitOps zapobiega powstawaniu błędów u źródła poprzez kontrolę wersji.
  • Przygotowanie środowiska – zachęcamy studentów do wcześniejszego zainstalowania środowiska kontenerowego przed częścią warsztatową zajęć.
Deployment deklaratywny: ArgoCD w trybie GitOps z Docker Compose do dev/test; bezpieczne, powtarzalne dostarczanie zmian zamiast ciągłego radzenia sobie z niespodziewanymi awariami.
zapowiedź

Następny wykład 7 (GitOps) opiera się na fundamentach z tego modułu: Loki/ELK (log aggregation) to podstawa, load balancing to kolejny poziom; HA = eliminacja SPOF, load balancing = scalability + reliability. Terminologia: load balancing, HAProxy, Nginx, high availability.

Load balancing: Algorytmy (round-robin, least connections, IP hash, least time), health checks (active/passive), session persistence (sticky sessions), SSL termination. Nginx (software LB) vs HAProxy (dedicated LB) vs cloud LB (AWS ALB, GCP Cloud LB).

Diagnostyka awarii: Logi LB (access log, error log) + metryki (active connections, request rate, latency, error rate) + health check status. HA = redundancy (active-passive, active-active), failover time < 30s. SLA = uptime guarantee.

Zachęta do przygotowania: Przeczytaj Nginx/HAProxy docs, skonfiguruj lab (VM/LXC), przetestuj health checks, failover. Hands-on prep = gotowy do wykładu 5.

Zanim zamkniemy moduł alertingu, warto na chwilę wyjrzeć w przyszłość i zobaczyć, czego dotyczyć będzie kolejny wykład. Cała infrastruktura powiadamiania, którą dziś zbudowaliście, uczy nas przede wszystkim, jak szybko reagować, gdy coś już nie działa; wykład siódmy o GitOps odpowiada natomiast na pytanie, jak dostarczać zmiany w sposób bezpieczny i powtarzalny, żeby awarii po prostu nie powodować. To naturalne dopełnienie opowieści o niezawodności - alerty sygnalizują problem, a deklaratywne wdrożenia ograniczają ryzyko jego powstania.

W module GitOps pojawi się przede wszystkim ArgoCD, narzędzie ciągłego dostarczania, w którym stan pożądany opisany jest w repozytorium, a system nieprzerwanie przybliża klaster do tego stanu. Obok ArgoCD poznamy także Docker Compose, pozwalające tworzyć lokalne środowiska deweloperskie i testowe, dzięki czemu będziecie mogli samodzielnie uruchomić cały stos narzędzi na własnym komputerze. Dobrze jest więc przygotować środowisko - kontener Docker i chwilę na eksperymenty - żeby część praktyczną przejść bez przeszkód.

Wyjaśnienie skrótów użytych na slajdzie:
GitOps – GitOps Operational Framework – model operacyjny GitOps; Temat przewodni kolejnego wykładu poświęconego deklaratywnemu zarządzaniu infrastrukturą przez repozytorium Git.
ArgoCD – Argo CD GitOps Controller – kontroler GitOps ArgoCD; Deklaratywne narzędzie ciągłego dostarczania oprogramowania dla platformy Kubernetes zapowiadane na wykładzie 7.
Flux – Flux GitOps Engine – silnik GitOps Flux; Otwarty operator synchronizujący stan klastra z definicjami w repozytorium kodu.
Declarative – Declarative Infrastructure State – deklaratywny stan infrastruktury; Paradygmat definiowania pożądanego stanu systemów w kodzie wersjonowanym w systemie Git.
K8s – Kubernetes – platforma Kubernetes; Środowisko orkiestracji kontenerów stanowiące fundament wdrożeń w modelu GitOps.

50/55 Pytania kontrolne
Pytania kontrolne: Self-assessment - sprawdź, czy rozumiesz zasady działania Alertmanagera (deduplikacja, grouping, routing, receiver) oraz czym jest szum alertów i jak go ograniczać.

Samoocena zamiast sprawdzianu: odtwórz Alertmanagera i szum z pamięci. Nie umiesz? Wróć do slajdów.

  • Utrwalenie wiedzy teoretycznej – zestaw pytań kontrolnych pozwala usystematyzować wiedzę o mechanizmach routingu, grupowania i wyciszeń.
  • Rozróżnienie stanów alertu – czy potrafisz wyjaśnić różnicę między stanem pending a firing oraz rolę parametru zwłoki for w Prometheusie?
  • Zastosowanie reguł inhibition – w jaki sposób mechanizm hamowania zapobiega lawinie powiadomień podczas całkowitej utraty zasilania w szafie rack?
  • Zalety podejścia burn rate – dlaczego alertowanie oparte na tempie wypalania budżetu SLO jest bardziej skuteczne niż tradycyjne progi procentowe?
  • Samodzielna powtórka materiału – udzielenie odpowiedzi na pytania kontrolne stanowi najlepszy sprawdzian wiedzy przed zaliczeniem semestralnym.
Self-assessment: Samoocena mechaniki Alertmanagera (deduplikacja, grouping, routing, receiver) i walki z szumem - odtworzenie od podstaw, nie rozpoznawanie.
pytania

Pytania kontrolne sprawdzają wiedzę przed egzaminem i rozwiązaniem zadań: trzy kluczowe pytania dotyczą budowy panelu (workflow), pojęcia variable (templating) i zachęty do dyskusji (best practices, anti-patterns, real-world challenges, tooling choices) - to self-assessment: czy potrafisz to zrobić samodzielnie?

Jak zbudować panel - panel creation workflow: Add panel → Query editor (PromQL/LogQL) → Visualization (Time series/Gauge/Stat/Bar gauge/Heatmap/Table/Logs) → Apply → Save dashboard. Każdy panel = jedno pytanie operacyjne (title + unit + thresholds + description). Workflow = od zera do zapisanego panelu w 2 minuty.

Co to variable - templating variable: Dynamiczny filtr (instance, job, environment, handler) stosowany w zapytaniach paneli. Query variable: `$instance = label_values(node_cpu_seconds_total, instance)` - multi-select, include All, regex filter. Dashboard templating = jeden pulpit dla wszystkich. Variable = parametr, nie hardcoded value.

Zachęta do dyskusji - community learning: Otwarte pytania - best practices (mniej paneli, semantic colors), anti-patterns (hardcoded, no thresholds, no variables), real-world challenges (high cardinality, slow queries, alert fatigue), tooling choices (Grafana vs Kibana vs custom). Community learning = uczymy się od siebie nawzajem.

Zanim przejdziemy do zakończenia, zostawię państwu kilka pytań kontrolnych - to nie sprawdzian, lecz forma samodzielnej weryfikacji tego, co zostaje po wykładzie. W inżynierii niezawodności wiedza liczy się dopiero wtedy, gdy potrafimy odtworzyć działanie systemu od podstaw, a nie wtedy, gdy rozpoznajemy je w prezentacji. Te pytania układają się w logiczną całość: zaczynają od mechanizmu Alertmanagera, przez zjawisko szumu alertów, aż po pytanie, czy jesteście w stanie skonfigurować i obsłużyć powiadomienia własnoręcznie.

Pierwszy blok pytań dotyczy tego, jak działa Alertmanager - deduplikacji, grupowania, routingu i receiverów, czyli mechanizmów, które decydują o tym, kto i kiedy dostanie powiadomienie. Drugi sprawdza, czy rozumiecie, czym jest szum alertów, jakie są konsekwencje zmęczenia alertami i jak je ograniczać, na przykład przez grupowanie i regularne przeglądy. Całość zachęcam potraktować jako punkt wyjścia do dyskusji o dobrych praktykach, antywzorcach i wyborach narzędziowych - w ten sposób uczymy się nawzajem od siebie.

Wyjaśnienie skrótów użytych na slajdzie:
Alertmanager – Prometheus Alertmanager Component – komponent Alertmanager; Weryfikacja znajomości zasad konfiguracji drzewa routingu w pytaniach testowych.
Grouping – Alert Grouping and Buffering – grupowanie i buforowanie powiadomień; Zagadnienia eliminacji burz alertowych podlegające ocenie akademickiej.
Silencing – Alert Silencing Rules – reguły wyciszania powiadomień; Zasady planowego wyciszania alarmów weryfikowane w pytaniach kontrolnych.
BurnRate – Burn Rate Alerting Calculations – obliczenia wskaźnika tempa spalania; Praktyczna umiejętność kalkulacji progów alarmowych dla celów SLO na sprawdzianie wiedzy.
MTTA – Mean Time To Acknowledge – średni czas potwierdzenia wezwania; Zrozumienie kluczowych parametrów reakcji operacyjnej na egzaminie z przedmiotu.

51/55 Podsumowanie wykładu 6
Podsumowanie wykładu 6: Alertmanager (routing, grouping, inhibition, silencing, HA), kanały komunikacji, reguły alertowe (PromQL, for, labels, annotations) oraz SLO-based alerting z burn rate. Fundament alertingu w SRE.

Cztery filary na jednej mapie: centrum, reguły, kanały i strategia SLO. Do tego on-call, meta i etyka.

  • Centralny mózg obserwowalności – Alertmanager odpowiada za inteligentne filtrowanie i dostarczanie powiadomień do właściwych inżynierów.
  • Priorytet objawów nad przyczynami – profesjonalny inżynier SRE tworzy alerty chroniące użytkowników końcowych przed przerwami w dostępie do usług.
  • Organizacja procedur on-call – czytelne harmonogramy dyżurów, automatyczna eskalacja oraz dopracowane runbooki decydują o niskim czasie MTTR.
  • Skupienie na budżetach błędów – monitorowanie tempa zużycia celów jakościowych pozwala wyeliminować szum i skupić uwagę na realnych kryzysach.
  • Architektura wysokiej dostępności – klastry oparte na protokole plotkującym i meta-monitoring czuwakowy gwarantują niezawodność powiadamiania.
Cztery filary alertingu: Centrum (Alertmanager), narodziny (reguły), doręczenie (kanały) i strategia (SLO z burn rate) - fundament SRE.
zakończenie

Podsumowanie wykładu 6 prowadzi od pytania "dlaczego alertować?" (MTTA, MTTR, proaktywne wykrywanie) przez mechanikę (Alertmanager, reguły Prometheus, kanały, szum, eskalacje) aż po "jak robić to dobrze" (SLO-based alerting, on-call, bezpieczeństwo, etyka, automatyzacja) - całość zaciska się w spójną MAPĘ zamiast listy odizolowanych faktów. Cztery filary: komponent (Alertmanager), reguły (Prometheus), kanały (dostarczanie), SLO (strategia).

Filar 1 - Alertmanager (routing, grouping, inhibition, silencing, HA): to centralny "mózg" decyzyjny. Krótko: deduplikacja i grupowanie (scala setki powiadomień w garstkę grup - group_by, group_wait/group_interval/repeat_interval), routowanie (route tree z matcherami: do którego zespołu, na który kanał), inhibicja (tłumij symptom, gdy znana przyczyna - critical tłumi warning), wyciszanie (silences na maintenance, ręcznie/API). Wysoka dostępność: klaster ≥2 instancji z gossip (hashicorp/memberlist), replikacja silences i notification log, dedup globalny, fail-open. Bez poprawnego routingu alert nie dociera - bez grupowania tonie w szumie. Bez poprawnego kanału najlepsza reguła ginie w milczeniu.

Filar 2 - Reguły alertowe (PromQL, for, labels, annotations): alert rodzi się w regule Prometheus: expr (warunek PromQL - alert na objaw, np. latency, nie na przyczynę, np. CPU), for (czas od pending do firing - eliminacja flappingu), labels (severity, team, service - do routingu w Alertmanagerze), annotations (summary, description, runbook_url - kontekst dla człowieka). Dobra reguła jest: oparta na danych (percentyle, baseline), przetestowana (promtool test rules), stagingowana (warning → critical), dokumentowana (runbook_url) i- co równie ważne - żyje w Git (GitOps), jak każda konfiguracja. Bez reguł Alertmanager nie miałby czym rządzić.

Filar 3 - Kanały komunikacji (Slack, Email, PagerDuty, Webhook i inne): dostarczanie to wybór "którym kanałem, z jaką pilnością". Mapowanie na severity: critical → PagerDuty/Phone/SMS (natychmiastowy page), warning → Slack + e-mail (ticket), info → log only. Multi-channel strategy: alert krytyczny idzie równolegle przez kilka kanałów (redundancja - żaden pojedynczy kanał nie jest SPOF czuwania). Narzędzia konkretnie: Slack/Discord (rich formatting, interaktywne przyciski), E-mail (formalnie, digesty), Webhook (uniwersalny świat: Jira, ServiceNow, automatyka), a Python pozwala programowo wysyłać powiadomienia na dowolny kanał (smtplib, requests/httpx). Bez poprawnego kanału najdobra reguła ginie w milczeniu.

Filar 4 - SLO-based alerting (burn rate jako podstawa alertów): to strategiczny upgrade z "alertów na metryki" na "alerty na ryzyko naruszenia SLO". Zamiast zejścia w dół do arbitralnych progów, mierzymy tempo spalania error budget (burn rate) i alarmujemy, gdy zbliżamy się do naruszenia SLO (multi-window: 1h/6h/24h → fast burn = page, slow burn = ticket; error budget < 10% warning, < 1% critical). SLO-driven approach = mniej fałszywych alarmów, lepsza alokacja uwagi, i zgodność z filozofią SRE (alert na produktywność usługi z perspektywy użytkownika). To most do tematu z wykładu 2 (metryki i SLI/SLO) i klamra dla całego modułu alertingu.

Co z tego zabierasz na praktykę (checklist końcowa): (1) NAJPIERW objawy / SLO, później progi; (2) Alertmanager = dedup + grouping + routing + inhibition + silence (+ HA); (3) Reguła = expr + for + labels + annotations; (4) Kanał = funkcja severity (multi-channel dla SEV-1); (5) Strzeż się fałszywych alarmów - testuj (promtool, chaos), staginuj, reviewuj, wycofuj wg deprecacji. A poza tym - pozostał on-call (slajd 21), monitorowanie samego alertingu (37) i etyka (52). Praca własna: za tydzień uruchomisz własny kompleksowy alerting (zadania ze slajdu 34). Terminologia do powtórki: Alertmanager, deduplication, grouping, routing, inhibition, silence, receiver, route tree, PromQL, for, labels, annotations, runbook_url, severity mapping, multi-channel, burn rate, error budget, SLO-driven alerting, HA gossip cluster.

Wykład dobiega końca, więc czas pozbierać wszystkie wątki w jedną spójną mapę zamiast listy odizolowanych faktów. Na tym slajdzie podsumowujemy całość alertingu w czterech filarach: komponent odpowiedzialny za zarządzanie alertami, reguły, w których alerty się rodzą, kanały, którymi docierają do ludzi, oraz strategia oparta na SLO, która wyznacza, kiedy naprawdę warto alarmować. Taka struktura pozwala łatwo wrócić do dowolnego tematu i pokazuje, jak poszczególne elementy układają się w jeden sprawnie działający system.

Filar pierwszy to Alertmanager i mechanizmy routingu, grupowania, inhibicji, wyciszania oraz wysoka dostępność w klastrze gossip - centralny mózg decyzyjny alertingu. Drugi to reguły alertowe z wyrażenia PromQL, czasu for, etykiet i adnotacji, trzeci to kanały komunikacji z mapowaniem na severity i zasadą wielokanałowości, a czwarty to SLO-based alerting z budżetem błędów i tempo spalania jako podstawą alarmów. Szczegóły filarów znajdziecie w punktach na slajdzie, a powiązane wątki - on-call, monitoring alertingu i etyka - uzupełniają obraz.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Podsumowanie wykładu poświęconego budowie skutecznych i przyjaznych człowiekowi systemów powiadomień.
Alerting – Modern Telemetry Alerting – nowoczesny alerting telemetryczny; Syntetyczny bilans wiedzy o filtrowaniu, korelacji i eskalacji zdarzeń awaryjnych.
Reliability – Service Reliability Assurance – zapewnienie niezawodności usług; Cel nadrzędny łączący monitoring metryk z pracą dyżurnych inżynierów operacyjnych.
Operations – Sustainable IT Operations – zrównoważone operacje teleinformatyczne; Praktyki operacyjne chroniące inżynierów przed wypaleniem zawodowym i zmęczeniem alertami.
Automation – Notification and Remediation Automation – automatyzacja powiadomień i napraw; Kierunek rozwoju zmierzający do samonaprawiania się systemów bez udziału człowieka.
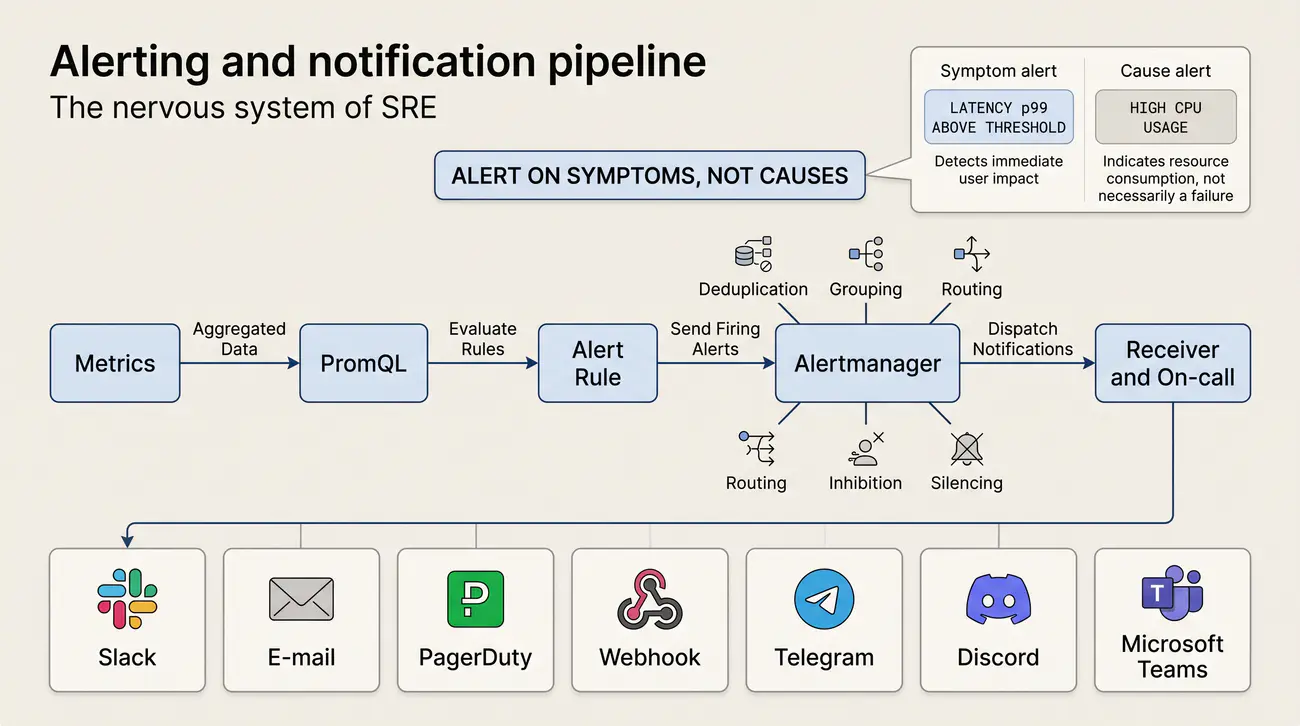
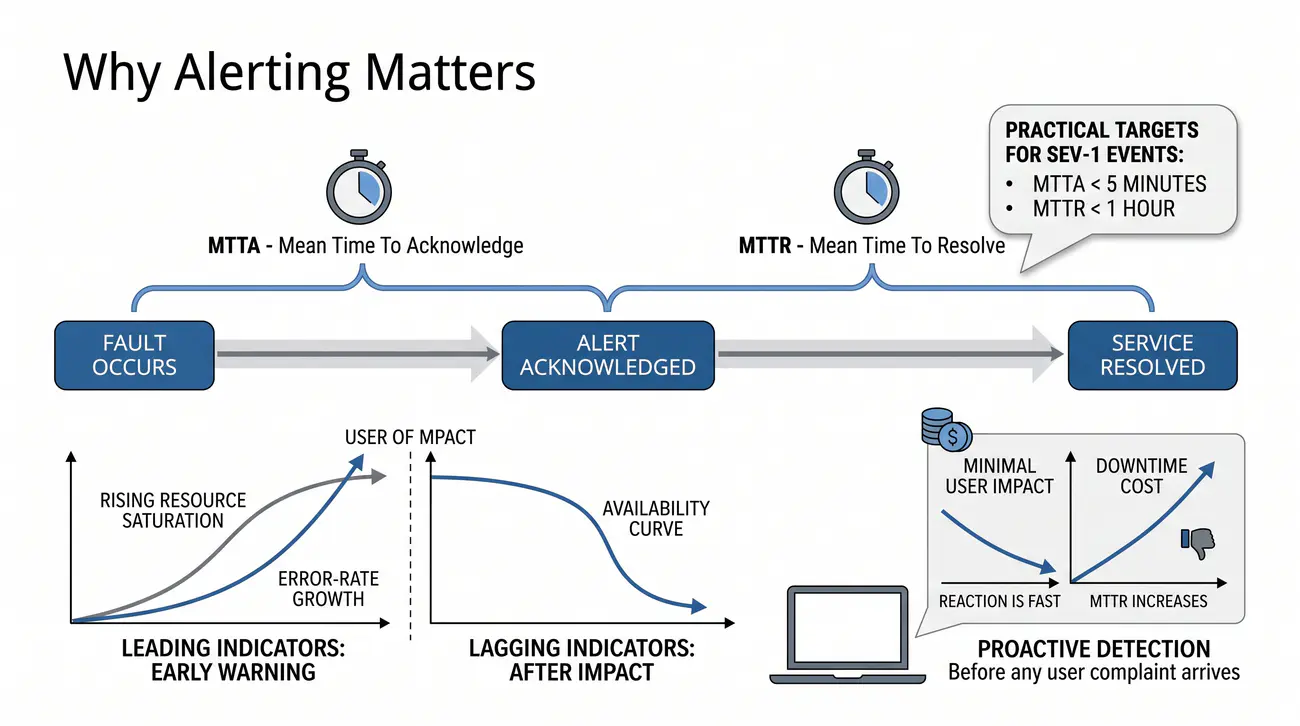
52/55 Etyka powiadamiania
Etyka powiadamiania: Spokojna komunikacja w incydencie, etyka dyżurów on-call (work-life balance, rekompensata) oraz transparentność wobec klientów (status page). Nawiązanie do K01/K02 (etyka, poufność).

Nocny telefon trafia w człowieka: fakty zamiast ocen, sprawiedliwe dyżury i prawda dla klientów.

  • Kultura wsparcia i spokoju – profesjonalizm dyżurnego opiera się na opanowaniu, badaniu twardych faktów i unikaniu wzajemnego obwiniania w stresie.
  • Prawo do regeneracji sił – zdrowa organizacja dba o odpoczynek inżynierów po nocnych incydentach, zapobiegając chronicznemu wyczerpaniu zespołu.
  • Transparentna komunikacja – uczciwe i terminowe informowanie klientów o awariach wzmacnia zaufanie do marki nawet w obliczu trudnych kryzysów.
  • Dbałość o prywatność danych – inżynierowie muszą bezwzględnie pilnować, aby w komunikatach publicznych nie publikować danych osobowych ani haseł.
  • Wspólna troska o niezawodność – współodpowiedzialność za stabilność platformy łączy zespoły operacyjne i programistyczne w harmonijną całość.
Status page: Publiczna strona statusu jako transparentność wobec klientów; ze spokojną komunikacją i etyką dyżurów (K01/K02).
etyka

Organizacja dyżurów inżynierskich podlega przepisom prawa pracy nadzorowanym przez Państwową Inspekcję Pracy (art. 151[5] Kodeksu Pracy). Czas dyżuru domowego nie może naruszać prawa pracownika do 11-godzinnego dobowego i 35-godzinnego tygodniowego nieprzerwanego odpoczynku. W kulturze Google SRE obowiązuje limit maksymalnie 2 incydentów na 12-godzinną zmianę dyżurową; przekroczenie tego limitu wymaga wdrożenia procedury naprawczej i przekazania części zadań operacyjnych z powrotem do zespołu programistycznego.

Alerting i on-call to system społeczny, nie tylko technologia: powiadamianie dotyka ludzi i organizacji - dyżurnego, który dostaje telefon o 3 w nocy, zespołu oceniającego incydent, klientów czekających na informację. Etyka powiadamiania to zbiór zasad, dzięki którym "system nerwowy" organizacji jest nie tylko sprawny, ale i sprawiedliwy, bezpieczny i ludzki - naturalne rozszerzenie problematyki z modułów K01/K02 (etyka i poufność) zastosowane do procesu powiadamiania.

Unikanie paniki - spokojna komunikacja w incydencie (calm communication): w trakcie awarii emocje rosną, ale komunikacja musi pozostać rzeczowa. Zasady dobrego tonu: (1) Wypowiadaj się faktami, nie ocenami ("usługa X nie odpowie od 14:02", nie "ktoś znowu coś zepsuł"); (2) Używaj jednej, jasnej struktury statusów (np. "investigating", "identified", "mitigating", "resolved") - każdy wie, w jakiej fazie jest awaria; (3) Komunikuj często i krótko (co 30-60 min), nawet gdy brak nowych faktów - cisza sprzyja plotkom; (4) Nigdy nie obwiniaj ludzi publicznie - winę ponoszą procesy, nie osoby (blameless post-mortems, patrz wykład 8); (5) Kieruj komunikację do JEDNEJ osoby (IC - incident commander), która decyduje, aby uniknąć chaosu wprowadzanego w kanałach. Spokojna komunikacja skraca awarię - bo kluczowe osoby mogą pracować, a nie śledzić 5 kanałów.

Etyka on-call - work-life balance i rekompensata za dyżury: dyżury są nieodłączną częścią SRE, ale muszą być ZARZĄDZANE po ludzku. Zasady: (1) Jawna polityka dyżurów (kto, kiedy, jak długo, co się liczy w czasie dyżuru vs praca), zgoda na dyżur - nie przymus; (2) Rotacja sprawiedliwa (weekly/bi-weekly, follow-the-sun dla globalnych zespołów) - nie można, by "te same osoby zawsze trafiały na dyżur"; (3) Rekompensata: on-call pay, czas wolny "w zamian" (time-off-in-lieu), uznanie w ocenie wyników - to nie dodatek, tylko ekwiwalent pracy dyżurnej; (4) Ochrona: eskalacja do L2/L3 w razie potrzeby (nikt nie zostaje sam z awarią), limity konwencji page'owania (np. nie dzwonić po 3:00 z SEV-3), rozsądne grupowanie (mniej calli); (5) Sprawiedliwość alertów: wysokie MTTA/MTTR to wskaźnik systemu, nie osobista porażka dyżurnego - wymaga działania zespołowego. Dobry on-call to taki, który przyciąga ochotników, a nie karze dyżurnych.

Transparentność wobec klientów i biznesu (status pages, komunikacja o incydentach): uczciwość względem odbiorców usługi jest wartością etyczną i biznesową. Podstawy: (1) Publiczna strona statusowa (statuspage.io, Cachet, własna) - pokazuje bieżący stan usług: "operational", "degraded", "major outage"; (2) Komunikacja incydentu = opis w języku KLIENTA (jaki jest wpływ, nie szczegóły techniczne), data/czas rozpoczęcia i zakończenia, aktualizacje w trakcie, plan zapobiegawczy na końcu; (3) Nie ukrywaj, nie zaniżaj - lepiej dłuższy "degraded" z dokładnym opisem niż kłamstwo "all systems operational"; (4) Powiadomienia o planowanych pracach (maintenance) - klient ma prawo wiedzieć, kiedy ryzykujemy; (5) Po awarii: raport post-mortem (publiczny lub wewnętrzny) buduje zaufanie - pokazuje, że wyciągnięto wnioski. Transparentność skraca "dług zaufania", który każda awaria zaciąga wobec użytkowników.

Związek z K01/K02 - etyka i poufność w powiadamianiu: moduły K01 (etyka) i K02 (poufność) znajdują tu bezpośrednie zastosowanie. Poufność - alerty i logi mogą zawierać dane wrażliwe (dane osobowe użytkowników, tokeny, adresy, ścieżki wewnętrzne); musimy: chronić treść wysyłaną w powiadomieniach (nie wysyłać payloadów z danymi osobowymi do publicznych kanałów!), rozróżniać kanał wewnętrzny (Slack) i zewnętrzny (status page - tylko niezbędne informacje), respektować politykę bezpieczeństwa (nie omijać RBAC dla silences, nie otwierać dostępu do configu "na szybko"). Etyka - odpowiedzialność za słowo i czyny: nie zgłaszamy fałszywych incydentów, nie wyciszamy alertów bez komentarza (to maskowanie problemu), nie obarczamy winą kolegów, działamy w granicach swojej kompetencji. Uczciwość w komunikacji ma w tym kontekście walor zarówno moralny, jak i bezpieczeństwa - "system nerwowy" może działać tylko, jeśli mu się ufa.

Praktyka do zabrania: (1) Ustal PRE-stabilne zasady komunikacji w incydencie (struktura statusów, IC, kanały) ZANIM wybuchnie awaria; (2) Spraw, by dyżur był sprawiedliwy (rotacja, rekompensata, ochrona) - zobaczysz spadek rotacji kadry; (3) Wdróż status page i procedurę komunikacji incydentu - zaufanie klientów mierzone jest milimetrami; (4) Traktuj K01/K02 jak narzędzie pracy: poufność w alertach = design, etyka = zachowanie. Terminologia: calm communication (spokojna komunikacja), blameless (bez obwiniania), incident commander (IC), work-life balance, on-call compensation, rotation, follow-the-sun, status page, transparency (transparentność), maintenance window, K01/K02, confidentiality (poufność), RODO compliance.

Należy pamiętać, że alerting i dyżury to system społeczny, a nie tylko technologia: powiadomienie o trzeciej w nocy trafia do konkretnego człowieka, a ocena incydentu dotyka całego zespołu i czekających klientów. Etyka powiadamiania to zbiór zasad, dzięki którym system nerwowy organizacji jest nie tylko sprawny, ale również sprawiedliwy, bezpieczny i ludzki. To naturalne rozszerzenie problematyki modułów K01 i K02, czyli etyki i poufności, zastosowane do procesu powiadamiania - i temu wątkowi przyjrzymy się na tym slajdzie.

Pierwszy obszar to spokojna komunikacja w trakcie awarii: mówimy faktami, nie ocenami, trzymamy się struktury statusów i nigdy nie obwiniamy ludzi publicznie, bo winę ponoszą procesy, nie osoby. Drugi to etyka dyżurów on-call, czyli równowaga między pracą a życiem, sprawiedliwa rotacja i rekompensata, a trzeci to transparentność wobec klientów realizowana przez stronę statusową i uczciwą komunikację o incydentach. Wreszcie wymiar poufności z K02, bo alerty i logi potrafią zawierać dane wrażliwe, których nie wolno wysyłać na publiczne kanały.

Wyjaśnienie skrótów użytych na slajdzie:
SustainableOnCall – Sustainable On-call Rotation – zrównoważony grafik dyżurów; Etyczna organizacja pracy gwarantująca brak przeciążenia i poszanowanie czasu wolnego pracownika.
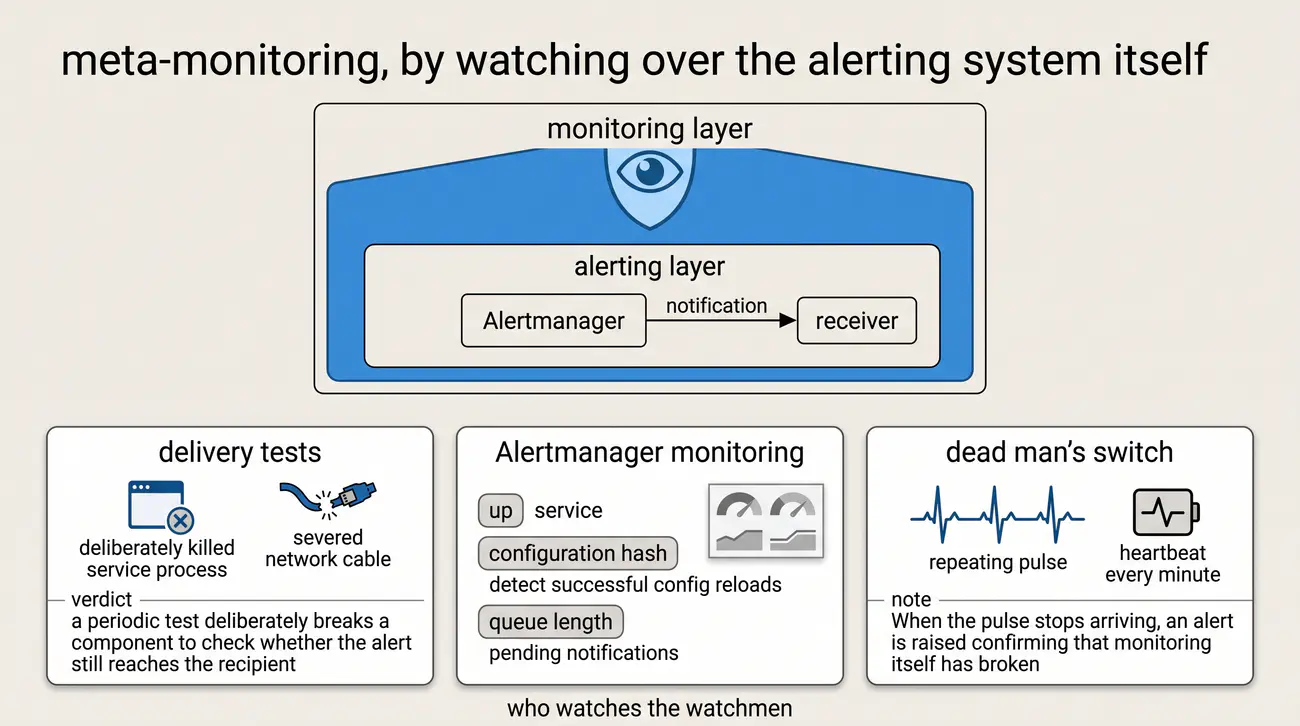
WorkLifeBalance – Work-Life Balance in Tech – równowaga między życiem zawodowym a prywatnym; Podstawowe prawo inżyniera chronione przez limitowanie nocnych interwencji operacyjnych.
PIP – Państwowa Inspekcja Pracy – Państwowa Inspekcja Pracy; Organ nadzorczy kontrolujący przestrzeganie przepisów o dobowym odpoczynku i rekompensatach za dyżury domowe.
Burnout – Occupational Burnout Prevention – profilaktyka wypalenia zawodowego; Działania kierownictwa IT zmierzające do eliminacji toksycznych dyżurów i ciągłych fałszywych alarmów.
Health – Mental and Physical Health of SRE – zdrowie psychiczne i fizyczne inżynierów SRE; Wartość nadrzędna w kulturze organizacyjnej nowoczesnych przedsiębiorstw technologicznych.

53/55 Przykład pełnego scenariusza
Pełny scenariusz incydentu: End-to-end case study: alert → ack → triage → diagnosis → mitigation → resolution → post-mortem. Pełny cykl z timestampami, ownership i komunikacją.

Jeden incydent od alertu po post-mortem: payments-api, p99 ponad próg i godzina wzorowej roboty.

  • Pełne studium przypadku – scenariusz ilustruje całą drogę od wykrycia anomalii przez Prometheus po analizę post-mortem w zespole technicznym.
  • Szybka koordynacja działań – akcja obejmuje przyjęcie alertu na telefonie, powołanie sztabu kryzysowego i wycofanie wadliwego wdrożenia aplikacji.
  • Podział ról podczas awarii – rozdzielenie zadań pomiędzy dowódcę a inżynierów technicznych pozwala przywrócić sprawność w kilkanaście minut.
  • Działania po opanowaniu sytuacji – zebranie faktów i wspólne spisanie raportu pozwala wdrożyć trwałe zabezpieczenia przed powtórzeniem się problemu.
  • Doświadczenie z realnego świata – analiza autentycznych scenariuszy przygotowuje studentów do wyzwań i standardów pracy w branży technologicznej.
Ownership: Własność incydentu na każdym etapie łańcucha alert → ack → triage → diagnoza → mitigacja → rozwiązanie → post-mortem, z timestampami.
cykl

End-to-end case study prowadzi kompletny scenariusz incydentu od momentu wystrzelenia alertu do post-mortem, z timestampami, odpowiedzialnością (ownership) i komunikacją. Wcześniejsze bloki dały narzędzia po kawałku (alert, ACK, eskalacje, diagnostyka, komunikacja z użytkownikami), a tu całość przechodzi po kolei przez jeden spójny przykład - widać, jak te kawałki układają się w realny przebieg "dopiętego" incydentu od pierwszej sekundy do wniosków.

Pełny cykl (timeline): przykładowy przebieg dla usługi payments-api. 14:02 - Alert "payments-api p99 latency > 500ms przez 5 min" trafia do PagerDuty (routing: severity=critical, team=payments, receiver=PagerDuty) i na Slack #payments-oncall; w tym samym momencie Alertmanager robi automatic group (dosypuje kolejne alerty z tego samego klastra do tej samej grupy - group_wait 30s). 14:03 - dyżurny ACK w PagerDuty (przycisk Acknowledge / komenda / ack przez API) - wskaźnik MTTA zatrzymany na 1 min (cel < 5 min). 14:05 - triage: "to nie pojedyncza instancja, p99 na całym klastrze - coś globalnego". 14:08 - diagnosis: korelacja w Grafanie ujawnia, że w tym samym oknie czasowym wystąpiło wiele błędów 500 oraz spike na wykresach wskaźników (metrics→logs); odkryto zmianę configu wdrożoną wcześniej (Git diff). 14:15 - mitigation: rollback configu (rewersja zmian) - co nie zmienia infrastruktury, tylko przywraca poprzedni config. 14:22 - metrics wracają do baseline (p99 < 200ms), alerty resolved. 14:30 - fix (trwałe rozwiązanie) i dokumentacja. 15:00 - post-mortem (formalne podsumowanie i wnioski).
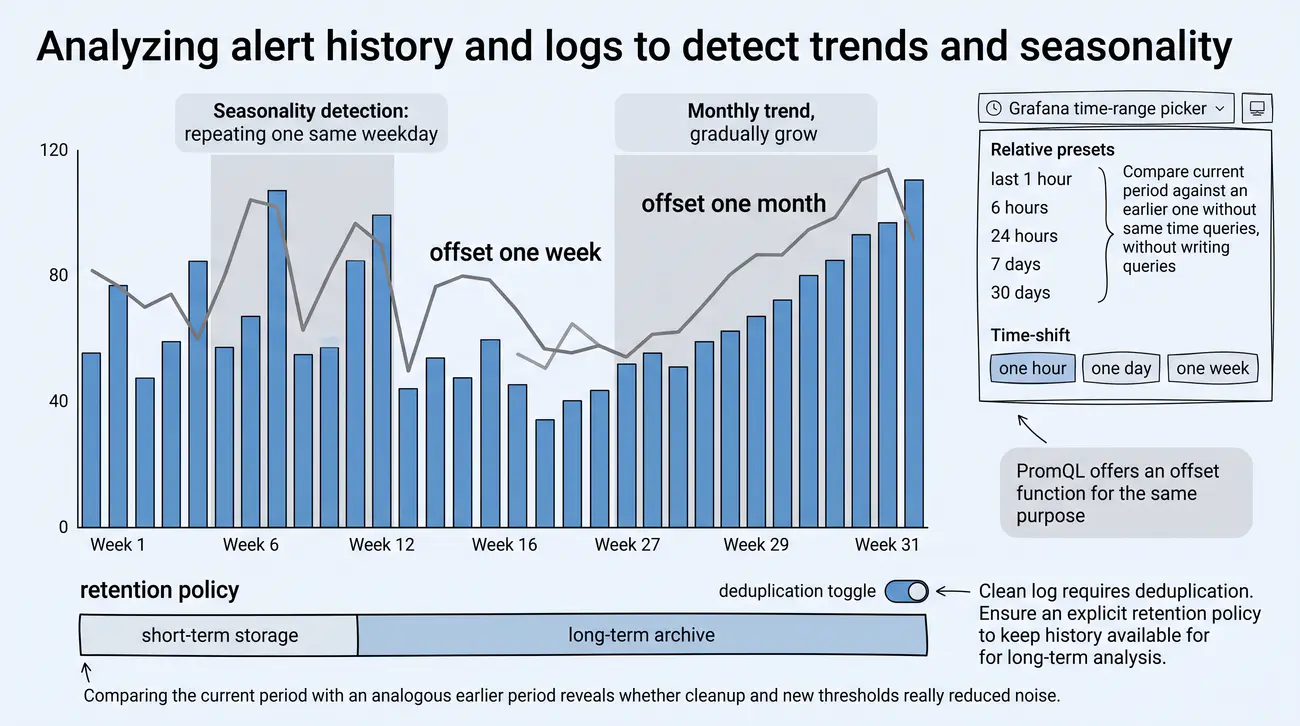
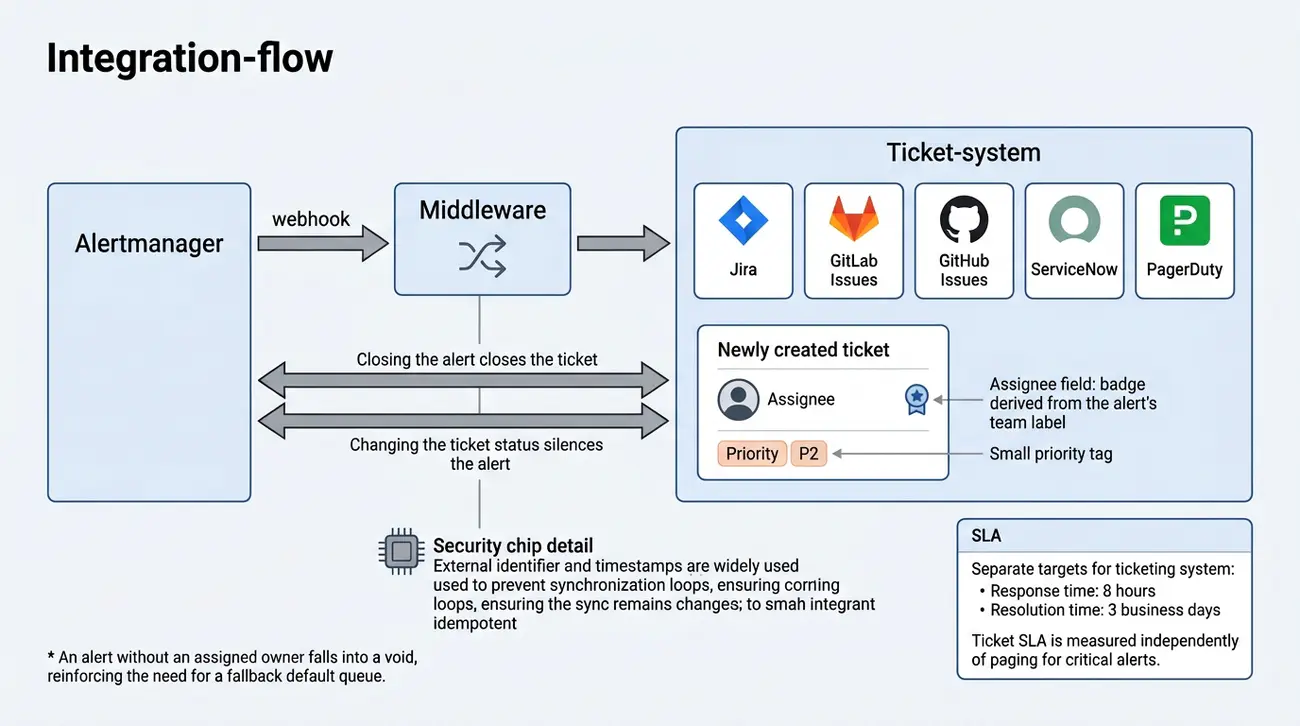
Ownership i role (kto co robi): kluczowe, by w incydencie nie było "luki odpowiedzialności". Role w standardzie: IC (incident commander) - jedna osoba decydująca o strategii (nie prowadzi diagnostyki, tylko koordynuje); Komunikator (communicator) - odpowiada za statusy na Slacku i stronie statusowej, odciąża IC; SRE/dep ostatecznych - prowadzi diagnozę i naprawę (w tym czasem 2-3 osoby z różnych teamów przy awarii cross-cutting); Osoba wdrożenia (implementation owner) - wykonuje zmiany w środowisku z zatwierdzeniem IC; Obrońca czasu / scribe - pilnuje następujących etapów i pisze timeline (żeby post-mortem miał fakty, nie wspomnienia). Zasada: KAŻDY kto działa, ma przypisaną rolę; nikt nie "dorzuca się" do kluczowych kanałów bez potrzeby - to zmniejsza szum (slajd 52: calm communication).

Komunikacja w trakcie (status updates): standardowy wzorzec: na samym starcie komunikat na kanałach zespołu ("payments-api: p99 latency > 500ms; investigating - godzina 14:03"); następnie aktualizacje co 30-60 min z ESR (Emergency Status Report - "stan, wpływ, co robimy"); równolegle zewnętrzny komunikat dla klientów (status page): uproszczony/ogólny opis wpływu - "trwa awaria Płatności - prowadzona jest diagnoza, dane kart nie są zagrożone" (bez szczegółów technicznych i sekretów - poufność, slajd 52); na zakończenie komunikat o przywróceniu usługi oraz zapowiedź post-mortem w ciągu 2-5 dni. Zasada dual-track: ten sam fakt opisujemy inaczej na wewnętrznym Slacku (szczegóły techniczne) i na zewnętrznej stronie statusowej (język klienta).

Post-mortem (nauka z incydentu): formalne zamknięcie cyklu - dokument, który odpowiada "co się stało, dlaczego, co się zmieni, by się nie powtórzyło". Struktura (szczegóły w wykładzie 8): timeline (oś czasu z faktami), przyczyny (RCA - root cause i contributing factors), wpływ (SLO, budżet, użytkownicy), działania (recommendations z właścicielami i deadlinami: np. "dodaj alert trailing wskaźnika, owner: team-payments, termin: 2 tygodnie"), i wnioski. Najważniejsze: post-mortem jest BLAMELESS (bez winnych osób - przyczyny są w procesach, nie w ludziach); każda rekomendacja ma właściciela i jest śledzona (albo cykl się nie zamyka). Efekt procesowy: alert z kolejnej zmiany config jest już inny (lepszy threshold / dodatkowy runbook), więc awaria nie powtórzy się w tej samej formie.

Ćwiczenie dla studentów (zastosuj samodzielnie): (1) prześledź 15-minutowy timeline (od alertu do resolved) z zaznaczeniem ról i komunikatów; (2) odpowiedz: Kiedy w tym scenariuszu zatrzymuje się MTTA, a kiedy MTTR? (odpowiedź: ACK = 14:03, resolve = 14:22); (3) znajdź w nim elementy z innych slajdów - inhibicja (czy pojawiła się?), grupowanie, komunikacja zewnętrzna (status page); (4) (bonus) napisz miniaturowy post-mortem dla tego incydentu z jednym działaniem właściciela. Terminologia: end-to-end scenario (scenariusz całościowy), alert, ACK (acknowledgment), triage (segregacja), diagnosis (diagnoza), mitigation (łagodzenie/ograniczenie wpływu), resolution (rozwiązanie), post-mortem, timeline, ownership (odpowiedzialność), IC (incident commander), status updates, status page, RCA (root cause analysis), blameless.

Wcześniejsze slajdy przekazywały narzędzia po kawałku: mamy alert, potwierdzenie ACK, eskalacje, diagnostykę, komunikację z użytkownikami. Czas zobaczyć, jak te kawałki układają się w całość: przechodzimy przez kompletny scenariusz incydentu - od wystrzelenia alertu aż do post-mortem. To świetny sposób na utrwalenie całego materiału: jeden konkretny przykład, w którym każdy z elementów odgrywa swoją rolę, pokazuje, jak wygląda naprawdę dopięty i dobrze poprowadzony incydent od pierwszej sekundy do wyciągniętych wniosków.

W scenariuszu przyglądamy się usłudze payments-api: o 14:02 alert o przekroczeniu latencji p99 powyżej pięciuset milisekund trafia do PagerDuty i na Slack, a dyżurny potwierdza go w ciągu minuty. Następnie triage, diagnoza przez korelację w Grafanie i sprawdzenie zmian konfiguracji w Git, ograniczenie wpływu przez wycofanie zmian, powrót metryk do normy, rozwiązanie i post-mortem. Przez cały czas mamy przypisaną odpowiedzialność, regularne statusy dla zespołu i komunikację na stronie statusowej, a każdy etap jest oddany w punktach na slajdzie.

Wyjaśnienie skrótów użytych na slajdzie:
IncidentFlow – End-to-End Incident Workflow – pełny przebieg obsługi incydentu; Przykładowa ścieżka zdarzeń: od wykrycia anomalii w PromQL przez powiadomienie po naprawę i post-mortem.
Page – Emergency Pager Alert – wezwanie alarmowe pagera; Sygnał alarmowy odbierany przez inżyniera w scenariuszu demonstracyjnym.
Ack – Acknowledgment Action – potwierdzenie podjęcia działań; Rejestracja rozpoczęcia pracy nad incydentem w systemie zarządzania awariami.
Mitigation – Incident Mitigation Steps – kroki mitygacji usterki; Zastosowanie procedur z instrukcji runbook w celu szybkiego przywrócenia sprawności usługi.
PostMortem – Post-mortem Retrospective – retrospektywa poawaryjna; Udokumentowanie przebiegu awarii i zdefiniowanie trwałych ulepszeń w regułach powiadomień.

54/55 Wnioski końcowe
Wnioski końcowe: Zachęta do dalszej nauki (continuous learning), certyfikacje (CKA, CKAD, GCP Professional Cloud DevOps Engineer) oraz społeczności (CNCF Slack, SREcon, lokalne meetupy).

Alerting to fundament, nie sufit: dalej certyfikaty, laby i ludzie. Praktyka laboratoryjna bije lekturę.

  • Praktyka kluczem do wiedzy – ciągłe doskonalenie warsztatu w laboratoriach oraz wyciąganie wniosków z awarii jest najpewniejszą drogą rozwoju kariery.
  • Wartość certyfikacji branżowych – zdobycie certyfikatów takich jak CKA lub certyfikacji chmurowych stanowi obiektywny dowód posiadanych kompetencji.
  • Aktywność w społeczności – wymiana doświadczeń na forach i śledzenie nowych wydań systemów pozwala stale poszerzać horyzonty inżynierskie.
  • Samodzielne eksperymenty – warto tworzyć własne klastry wirtualne i celowo wstrzykiwać błędy, aby budować bezcenne odruchy diagnostyczne.
  • Pasja tworzenia odpornych usług – życzymy niesłabnącego entuzjazmu w zgłębianiu inżynierii niezawodności i satysfakcji ze stabilnych systemów.
Continuous learning: Ciągłe uczenie się (certyfikacje CKA/CKAD/GCP, CNCF Slack, SREcon, meetupy); alerting to fundament, nie cel.
wnioski

Kryteria jakościowe systemów powiadamiania i zarządzania incydentami normuje Polski Komitet Normalizacyjny.

Wnioski końcowe wykładu umieszczają alerting w szerszej drodze rozwojowej inżyniera SRE: ciągła nauka (continuous learning), certyfikacje (które warto realnie CELOWAĆ) i społeczności (gdzie ta nauka naprawdę się dzieje). Alerting to fundament, nie cel sam w sobie - jest częścią pełnego stosu SRE: metryki (wykład 2), wizualizacja (3), logi (4), HA i load balancing (5), GitOps (7), incydenty i post-mortem (8).

Ciągła nauka (continuous learning) - alerting to dziedzina szybko ewoluująca, więc utrwalanie przez praktykę i aktualizację wiedzy jest warunkiem bycia skutecznym operatorem. Jak uczyć się dalej: (1) Uruchamiaj własne środowiska laboratoryjne (Prometheus + Grafana + Alertmanager + Loki w docker compose) i powtarzaj ćwiczenia z wykładu - praktyka 2 godziny tygodniowo ma większą wartość niż lektura; (2) Czytaj post-mortemy innych firm (Google SRE workbook, "Incident Management" Alexa, publikacje firm SaaS) - to najlepsze, za darmo dostępne opowieści o tym, "co naprawdę się psuje"; (3) Śledź dokumentację i release notes (Prometheus, Grafana) - nowe wersje to nowe możliwości (np. mute timings, alert rule history); (4) Ćwicz SLO/burn rate na własnych małych usługach; (5) Rozwiązuj zadania i case study (w tym z tej prezentacji) oraz dziel się wiedzą - uczenie innych to najskuteczniejsza forma nauki siebie.

Certyfikacje (realne cele): jeśli chcesz formalnie potwierdzić kompetencje, oto praktyczne kierunki. Dla Kubernetes/SRE: CKA (Certified Kubernetes Administrator) - egzamin praktyczny z administrowania klastrem; CKAD (Certified Kubernetes Application Developer) - pisanie i debugowanie aplikacji w K8s (polecany dla developerów/inżynierów platform); dalej możesz rozważyć CKS (security). Dla chmury/SRE-DevOps: GCP Professional Cloud DevOps Engineer - obejmuje monitoring, alerting, SLO, CI/CD, logowanie i bezpieczeństwo (bardzo zbliżone tematycznie do tego wykładu); analogicznie AWS DevOps Engineer czy Azure DevOps Engineer Expert. Dla prometheus/monitoring: egzaminy producentów i certyfikaty Grafana (Grafana Certified) oraz "CNCF" ogólnie. Ważna uwaga metodologiczna: certyfikacja to sprawdzian wiedzy, a nie sposób na jej zdobycie - nie nauczysz się alertingu od egzaminu; idź tą drogą mając laby za sobą, nie przed sobą.

Społeczności (gdzie ta nauka naprawdę się dzieje): wiedza SRE rozgrywa się w publicznej dyskusji i wymianach doświadczeń - dołącz tam, gdzie realnie pracuje się z tymi narzędziami: CNCF Slack (społeczność Kubernetes/Prometheus/Grafana - kanały #prometheus, #alertmanager, #grafana), SREcon (konferencja USENIX poświęcona SRE - nagrania wykładów dostępne za darmo na YouTube), lokalne meetupy (grupy DevOps/Kubernetes w Twoim mieście - network+realne case studies), konferencje Grafana/Prometheus (GrafanaCON, PromCon), a także fora/firmy blogowe (Grafana blog, Prometheus blog, Google Cloud blog) i GitHub repos (issues/discussions to szkoła prawdziwej praktyki). Zasada: bądź widoczny (help others) - tłumaczenie problemów innych to najszybsza ścieżka do biegłości.

Podsumowując wnioski końcowe: (1) Alerting to dyscyplina, nie "wtyczka" - wymaga reguł, higieny, dokumentacji i etyki; (2) Ucz się przez praktykę (laby, post-mortemy, chaos), nie przez teorię; (3) Certyfikacje (CKA/CKAD, GCP DevOps) to dobry plan na najbliższe miesiące - ale po zdobyciu realnych umiejętności; (4) Społeczności to niezastąpione źródło bieżącej wiedzy i wymiany doświadczeń; (5) Kolejny krok na Twojej drodze: wykład 7 (GitOps - ArgoCD, Docker Compose), a potem zarządzanie incydentami i post-mortemy (wykład 8). Powodzenia w praktyce - alerting, który zbudujesz, będzie działać, gdy nadejdzie prawdziwa awaria. Terminologia: continuous learning, CKA, CKAD, CKS, GCP Professional Cloud DevOps Engineer, AWS/Azure DevOps Engineer, CNCF Slack, SREcon, meetupy, PromCon, GrafanaCON, post-mortem reading, labs, blogi oficjalne.

Wnioski końcowe wykładu umieszczają alerting w szerszej drodze rozwojowej inżyniera SRE, bo choć cały moduł poświęciliśmy powiadamianiu, to jest ono fundamentem, a nie celem samym w sobie. Alertowanie wypełnia jeden element pełnego stosu budowanego przez cały kurs - obok metryk i SLO, wizualizacji, logów, wysokiej dostępności, GitOps oraz zarządzania incydentami. Warto więc zakończyć moduł nie formalnym zamknięciem tematu, lecz wskazaniem, jak rozwijać się dalej, i temu właśnie służy ten slajd.

W dalszym rozwoju pomagają nam trzy obszary: ciągła nauka, czyli własne środowiska laboratoryjne, czytanie realnych post-mortem i śledzenie dokumentacji; certyfikacje, takie jak CKA i CKAD dla Kubernetesa czy GCP Professional Cloud DevOps Engineer dla chmury; oraz społeczności - między innymi CNCF Slack, konferencja SREcon i lokalne meetupy, w których wiedza naprawdę się rozwija. Zwróćcie uwagę, że certyfikaty najlepiej podbijać, mając za sobą praktykę laboratoryjną, a nie przed sobą, i właśnie taką postawę staramy się tu wypracować.

Wyjaśnienie skrótów użytych na slajdzie:
Actionability – Core Principle of Actionability – fundamentalna zasada wykonalności; Główny wniosek wykładu: tylko alarmy wymagające natychmiastowego działania mają prawo istnieć.
QualityOverQuantity – Quality Over Quantity in Alerts – jakość ponad ilość powiadomień; Zasada inżynierska głosząca, że mniej alertów oznacza większe bezpieczeństwo i szybszą reakcję.
SLOAlignment – Direct SLO Alignment – ścisłe powiązanie z celami SLO; Kierowanie uwagi inżynierów wyłącznie na problemy zagrażające realnym doświadczeniom użytkowników.
HumanCentered – Human-Centered Operations – operacje zorientowane na człowieka; Projektowanie narzędzi monitoringu z poszanowaniem ograniczeń poznawczych i zdrowia inżynierów.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Podsumowanie inżynierskiej filozofii powiadamiania opartej na faktach, empatii i automatyzacji.

55/55 Zakończenie
Zakończenie modułu alertingu: Formalne zamknięcie: przypomnienie o zadaniach domowych (hands-on assignment), kanały pomocy (Slack, e-mail, office hours) i podziękowania. To początek praktyki, nie koniec nauki.

Koniec modułu, początek praktyki: własny system od zera nauczy więcej niż wykład. Do zobaczenia w GitOps.

  • Podziękowanie za uwagę – dziękujemy za aktywny udział w wykładzie poświęconym zaawansowanym strategiom powiadamiania i zarządzania awariami.
  • Zadania laboratoryjne – zachęcamy do praktycznego skonfigurowania Alertmanagera oraz integracji powiadomień z komunikatorem na ćwiczeniach.
  • Konsultacje i wsparcie – w razie pytań zapraszamy do dyskusji na dedykowanym kanale seminaryjnym oraz podczas cotygodniowych dyżurów dydaktycznych.
  • Materiały pomocnicze – prezentacja, gotowe szablony konfiguracyjne i polecane artykuły techniczne znajdują się w uczelnianym systemie e-learningowym.
  • Zaproszenie na kolejny wykład – do zobaczenia na zajęciach, gdzie poznamy tajniki GitOps i deklaratywnego wdrażania usług w klastrach chmurowych!
Hands-on assignment: Zadanie domowe jako początek praktyki (kanały Slack, e-mail, dyżury); wiedza utrwala się na własnym systemie.
zakończenie

Zakończenie modułu alertingu to formalne zamknięcie: co robić dalej (hands-on assignment), gdzie szukać pomocy (Slack, e-mail, office hours, peer support) i podziękowania - to nie koniec nauki, to początek praktyki.

Zapowiedź pracy własnej - hands-on assignment: Zadania - zbuduj dashboard z metryki systemowe (CPU, RAM, Disk, Network) + app metrics (latency p95/p99, error rate) + SLO panel (error budget gauge). Deadline do wykładu 7. Hands-on assignment = uczy się przez wykonywanie. To nie teoria - to praktyka.

Kontakt i pytania - support channels: Prowadzący dostępny: Slack (kanał #sre-course), e-mail (prowadzacy@uczelnia.pl), office hours (poniedziałek 14-16, sala 205). Kanał wsparcia grupy seminaryjnej: #sre-course-peers (studenci pomagają studentom - najlepsze uczenie). Community support = nie jesteś sam.

Podziękowanie: Za uwagę i aktywność na wykładzie 6. Następny: Wykład 7 - GitOps, ArgoCD, Flux. Thank you for attention.

Zakończenie modułu to formalne zamknięcie, ale też wyraźne wskazanie, co robić dalej: przypomnienie pracy domowej, kanały, z których można korzystać w razie pytań, i podziękowania za uwagę. Najważniejsze, co warto wynieść, to przekonanie, że to nie koniec nauki, lecz początek praktyki - wiedza o alertingu utrwala się dopiero wtedy, gdy zbudujecie własny, działający system i będziecie go utrzymywać. Dlatego zamiast żegnać się z tematem, zachęcam państwa, by potraktować pracę własną jako naturalne przedłużenie tego wykładu.

Praca domowa przed kolejnym wykładem to zaprojektowanie i zbudowanie dashboardu obejmującego metryki systemowe, takie jak CPU, pamięć, dysk czy sieć, metryki aplikacyjne, w tym latencję p95 i p99 oraz wskaźnik błędów, a także panel SLO z miernikiem budżetu błędów. W razie problemów jesteście państwo zaproszeni na Slack, e-mail i konsultacje w ustalonych godzinach, a studenci mogą wspierać się nawzajem przez dedykowany kanał pomocy rówieśniczej. Do zobaczenia na wykładzie siódmym o GitOps - praktyka czyni mistrza.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Zakończenie wykładu szóstego i zaproszenie do modułu poświęconego infrastrukturze deklaratywnej.
GitOps – GitOps Framework – model GitOps; Praktyka zarządzania konfiguracją systemów i reguł alertowych poprzez repozytoria kodu źródłowego.
InfrastructureAsCode – Infrastructure as Code Paradigm – paradygmat infrastruktury jako kodu; Definiowanie reguł powiadomień i routingów jako kodu podlegającego testom w potokach CI/CD.
Reliability – Continuous Reliability Improvement – ciągłe doskonalenie niezawodności; Cykliczny proces eliminacji długu technicznego w systemach monitoringu i powiadamiania.
ContinuousImprovement – Continuous Improvement Culture – kultura ciągłego doskonalenia; Praktyka SRE polegająca na regularnym przeglądzie i optymalizacji wszystkich procesów operacyjnych.