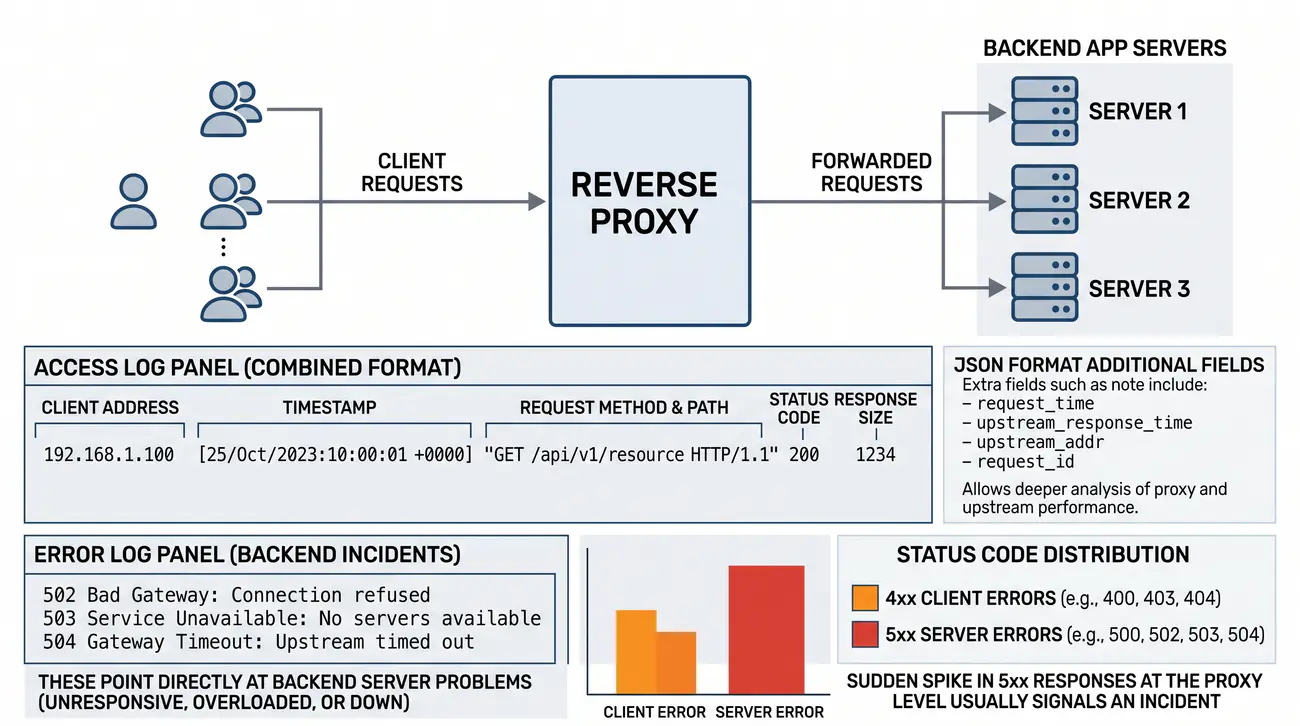
1/55 Zarządzanie logami
Zarządzanie logami: Logi to podstawa obserwowalności - pozwalają wykrywać błędy i diagnozować awarie. Poznamy Loki (Grafana Labs) i ELK Stack (Elasticsearch, Logstash, Kibana) do agregacji logów oraz język LogQL.

Metryki mówią co, logi mówią dlaczego. Ten wykład to drugi filar obserwowalności: Loki, ELK i język LogQL.

  • Chronologia zdarzeń – logi stanowią zapis operacji, który pozwala precyzyjnie odtworzyć przebieg awarii bez konieczności zgadywania przyczyn.
  • Indeksowanie w Loki – system Grafana Loki indeksuje wyłącznie etykiety, co zapewnia niskie koszty przechowywania w magazynach obiektowych.
  • Pełnotekstowy stos ELK – Elasticsearch oferuje indeks każdego słowa, co ułatwia analitykę, lecz wymaga znacznie większych zasobów RAM i CPU.
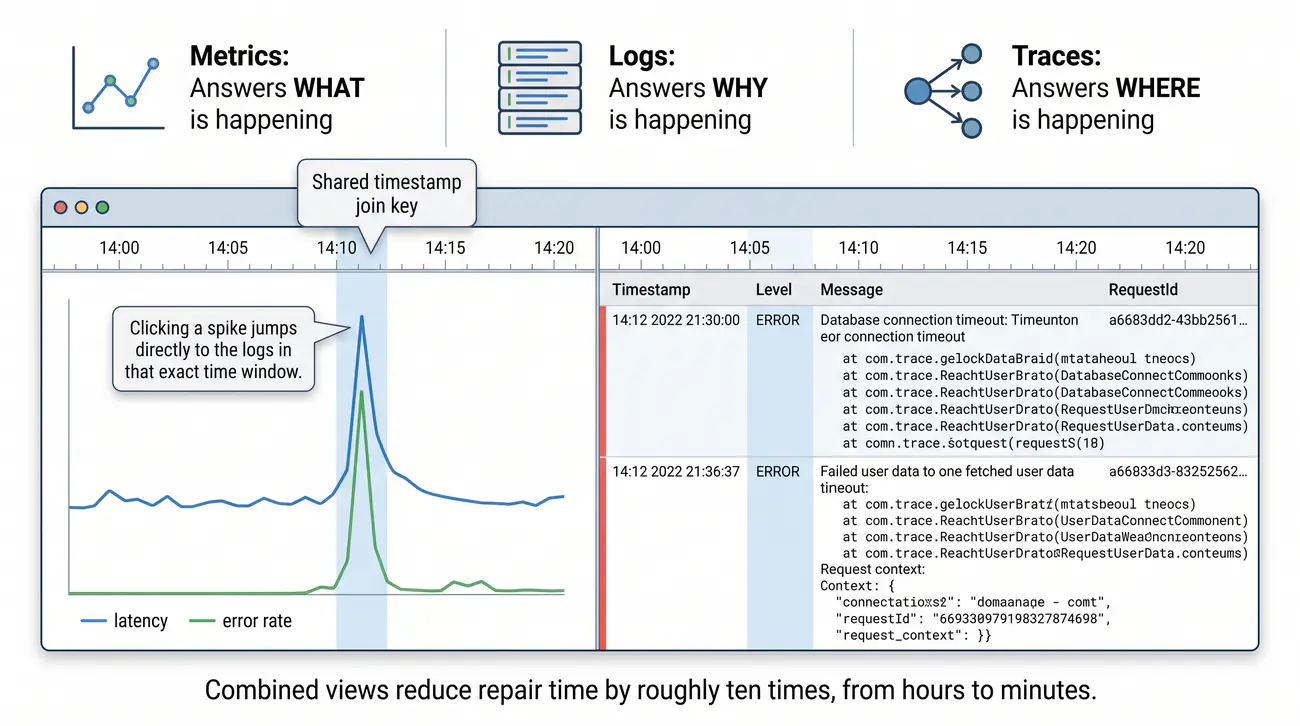
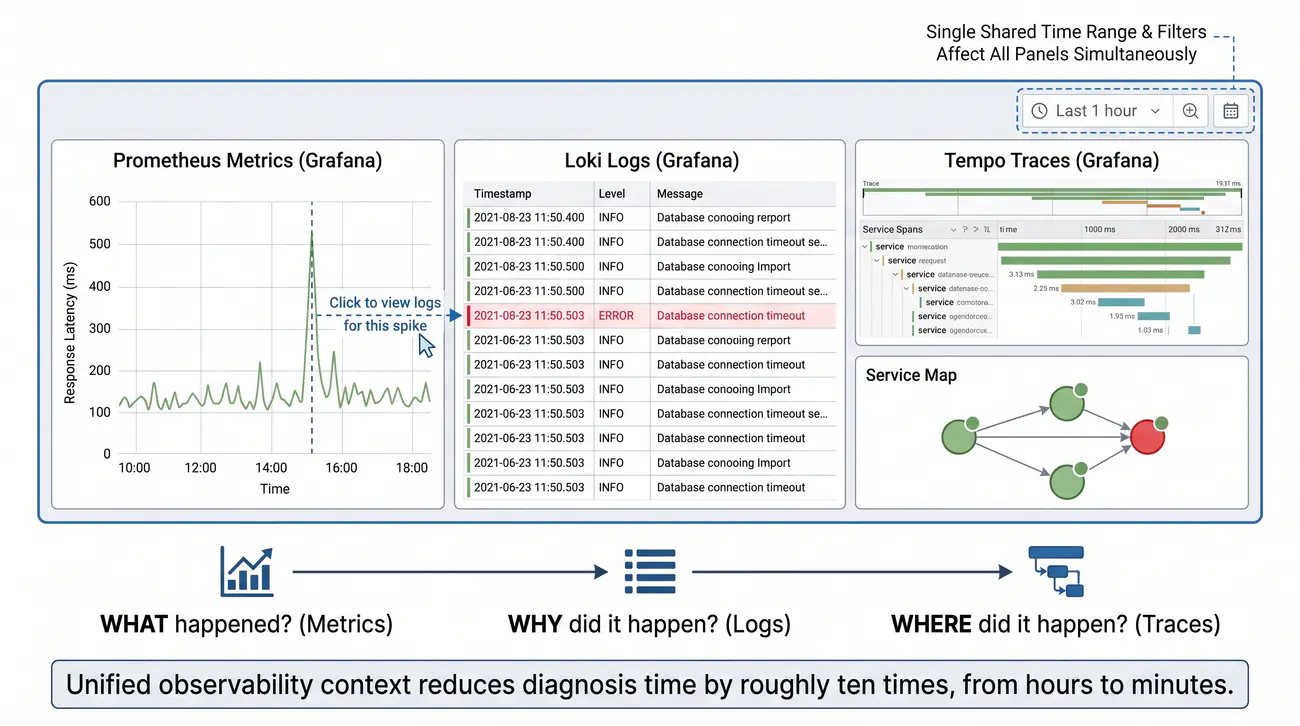
  • Korelacja z metrykami – zestawienie logów z wykresami telemetrycznymi pozwala skrócić czas diagnozy awarii z wielu godzin do zaledwie kilku minut.
  • Język zapytań LogQL – umożliwia wygodne filtrowanie milionów linii tekstu oraz wyliczanie dynamicznych metryk awaryjności w czasie rzeczywistym.
Agregacja logów: Gromadzenie logów z wielu serwisów w jednym systemie (Loki, ELK) z językiem zapytań (LogQL); logi odpowiadają na pytanie DLACZEGO, metryki - CO się dzieje.
ekran logów
Wprowadzenie dla studenta: W nowoczesnych systemach IT nie da się naprawić tego, czego nie widać. O ile metryki numeryczne (np. zużycie pamięci, liczba żądań) mówią nam co i kiedy zaczyna działać nieprawidłowo, o tyle dopiero logi tekstowe pokazują dlaczego wystąpił błąd (dokładny zrzut wyjątku, wadliwe zapytanie SQL, odmowa uprawnień). W tym module poznasz dwie wiodące filozofie: tradycyjne, pełne indeksowanie każdego słowa (ELK) oraz nowoczesne podejście chmurowe oparte na etykietach i tanim magazynie (Loki).

Logi są pierwotnym źródłem prawdy o stanie systemu - bez nich wykrywanie, diagnozowanie i rozwiązywanie problemów produkcyjnych nie jest możliwe w skali. Dwa główne podejścia do agregacji logów to Loki od Grafana Labs i ELK Stack, różniące się architekturami, zaletami i kompromisami; język LogQL pozwala przeszukiwać i analizować logi na skalę, korelacja metryk i logów drastycznie skraca czas do diagnozy MTTR, a bezpieczeństwo danych telemetrycznych obejmuje maskowanie PII i kontrolę dostępu.

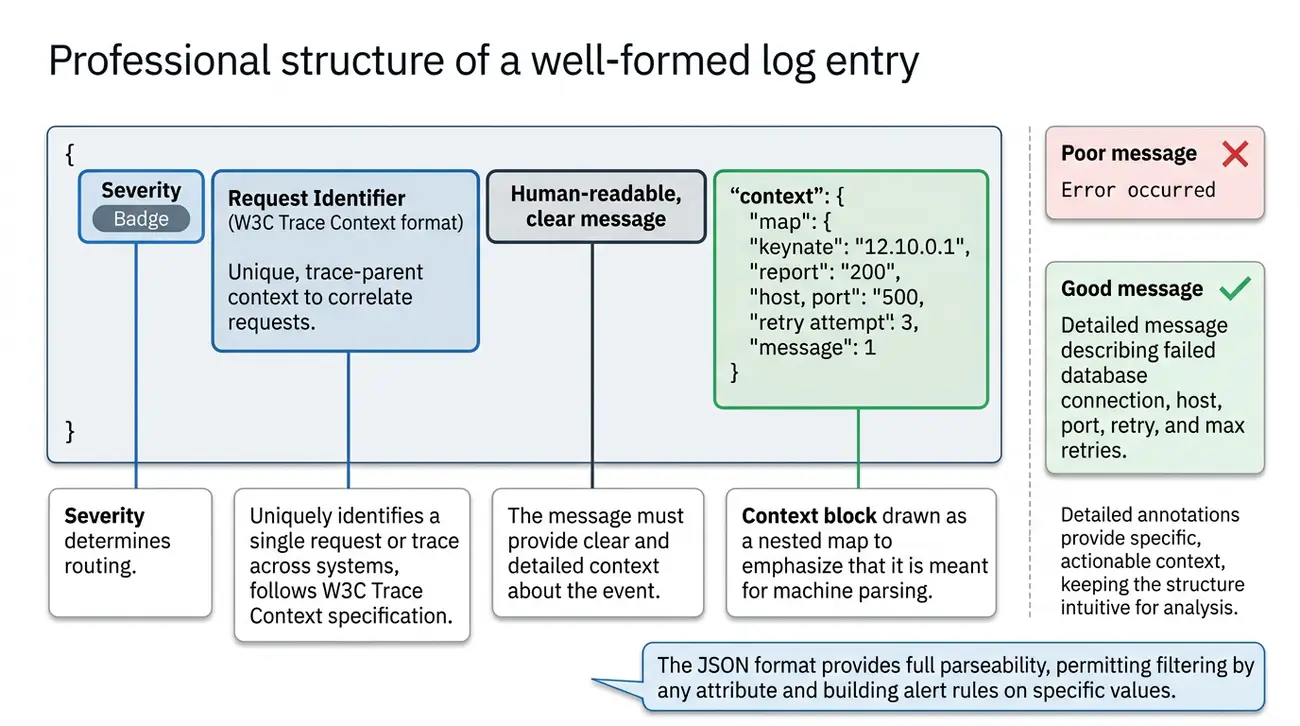
Rola logów - wykrywanie błędów: Logi zapisują sekwencję zdarzeń z pełnym kontekstem - znacznikiem czasu, poziomem ważności, składnikiem systemu i identyfikatorami korelacji - co pozwala odtworzyć dokładny przebieg awarii. Bez logów diagnostyka ogranicza się do hipotez i zgadywania; logi zamieniają spekulacje na analizę opartą na dowodach. W nowoczesnym SRE to nie "drukowanie na konsolę", lecz strukturalne dane w formacie JSON z etykietami, indeksowane i przeszukiwalne w czasie rzeczywistym. Poprawnie zestrukturyzowane logi pozwalają na automatyczne wykrywanie anomalii, korelację z metrykami i tworzenie alertów bez fałszywych pozytywów.

Loki i ELK Stack - dwa podejścia do logowania: Loki to system zaprojektowany do pracy z etykietami i metrykami - tani, szybki, z natywną integracją z Grafaną. Architektura oparta na indeksowaniu etykiet sprawia, że koszty przechowywania i dostarczania logów są 10-100× niższe niż w tradycyjnych rozwiązaniach. ELK Stack to dojrzałe rozwiązanie enterprise z pełnotekstowym wyszukiwaniem, bogatymi dashboardami, uczeniem maszynowym i SIEM, ale kosztem większych wymagań infrastrukturalnych i operacyjnych. Wybór między nimi zależy od skali, budżetu, dojrzałości zespołu i wymagań analitycznych - nie ma uniwersalnego zwycięzcy.

Podsumowanie: Logi to fundament obserwowalności - bez nich nie ma SRE. Loki = tanie, szybkie, oparte na etykietach, natywne dla Grafany, idealne dla cloud-native i Kubernetes. ELK = bogate, pełnotekstowe, kosztowniejsze, dla enterprise i compliance. Wybór = funkcja skali, budżetu, dojrzałości zespołu i wymagań analitycznych. Kluczowe: strukturalne logi JSON plus etykiety = przeszukiwalność i automatyzacja.

W poprzednich wykładach obserwowalność oparliśmy na metrykach: Prometheus i Grafana mówiły nam, co się dzieje z usługą. Dziś dochodzimy do drugiego filaru, jakim są logi, czyli zapisy zdarzeń odpowiadające na pytanie, dlaczego coś się dzieje. Metryka pokazuje skok latencji, ale przyczynę znajdziemy dopiero we wpisie logu. Ten wykład poświęcimy zarządzaniu logami w skali: poznacie Loki od Grafana Labs oraz ELK Stack, dwa wiodące podejścia do agregacji, a także język LogQL, którym zaczniecie przeszukiwać zebrane dane.

W SRE logi pełnią rolę szczególną, bo rekonstruują dokładny przebieg awarii: znacznik czasu, poziom ważności i identyfikatory korelacji pozwalają odtworzyć sekwencję zdarzeń i zamiast zgadywać, analizować na podstawie dowodów. Przekonacie się, że Loki indeksuje wyłącznie etykiety, dzięki czemu przechowywanie i dostarczanie logów jest tanie i szybkie, podczas gdy ELK stawia na pełnotekstowe wyszukiwanie kosztem większych zasobów. Na koniec pokażemy, jak korelacja metryk i logów skraca czas diagnozy, czyli MTTR.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina techniczna, w której logi stanowią fundamentalne źródło informacji do analizy przyczyn awarii.
SIEM – Security Information and Event Management – zarządzanie informacjami i zdarzeniami bezpieczeństwa; Klasa systemów analizujących zdarzenia pod kątem wykrywania zagrożeń i naruszeń polityk.
SOC – Security Operations Center – centrum operacji bezpieczeństwa; Zespół inżynierów bezpieczeństwa monitorujący i analizujący logi w czasie rzeczywistym.
NOC – Network Operations Center – centrum operacyjne sieci; Dział monitorujący stabilność i ciągłość działania infrastruktury telekomunikacyjnej.
API – Application Programming Interface – interfejs programowania aplikacji; Punkty komunikacyjne usług generujące krytyczne logi żądań i błędów.

2/55 Czym są logi
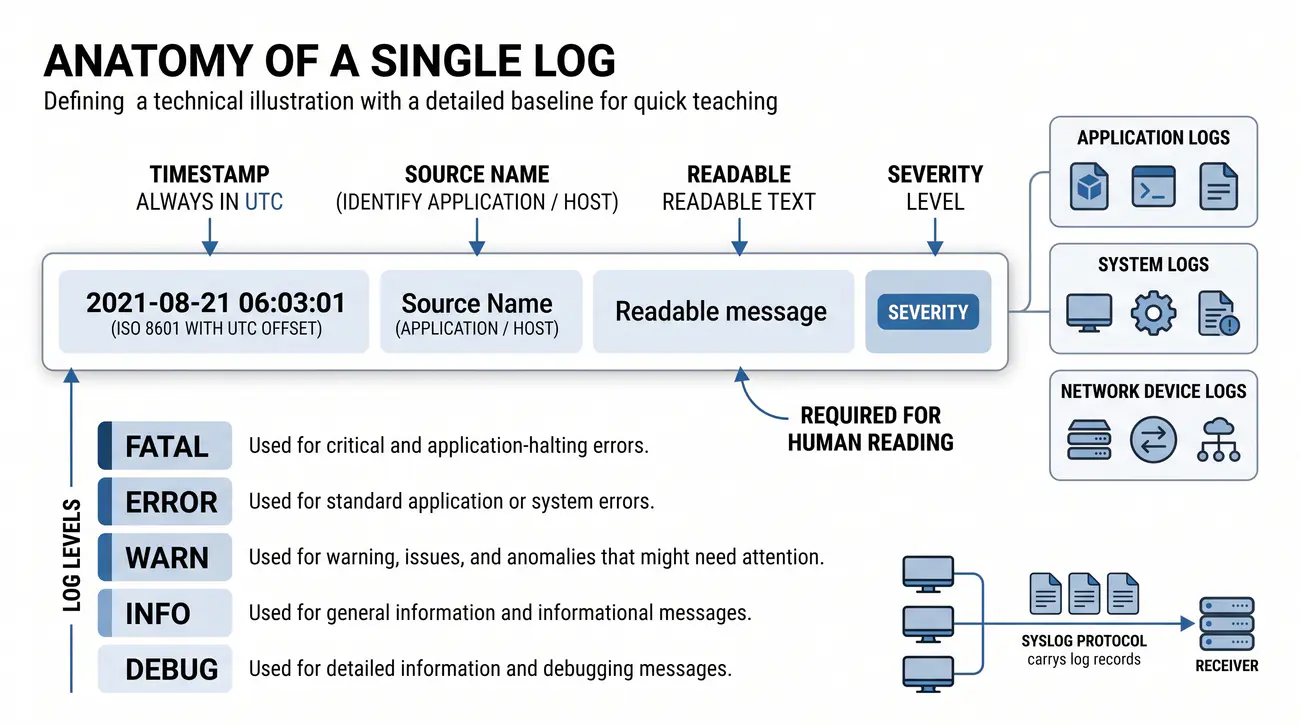
Czym są logi: Log entry to pojedynczy rekord zdarzenia - zawiera timestamp, źródło, treść i poziom ważności (log level). Logi dzielimy na aplikacyjne, systemowe i sieciowe. Protokół syslog służy do ich centralnego przesyłania.

Log to rekord zdarzenia z czterema polami. Bez wspólnej struktury nie ma automatyki - jest chaos formatów.

  • Struktura wpisu – pojedynczy rekord w logu to ustrukturyzowany obiekt zawierający znacznik czasu, nazwę źródła, treść oraz poziom istotności.
  • Standard ISO 8601 – precyzyjny znacznik czasu zapisany w strefie UTC jest niezbędny do bezbłędnej synchronizacji zdarzeń z wielu serwerów naraz.
  • Poziomy istotności – oznaczenia takie jak INFO, WARN czy ERROR pozwalają inżynierom natychmiast odróżnić rutynowe operacje od awarii krytycznych.
  • Klasyfikacja źródeł – wyróżniamy logi aplikacji, usług sieciowych oraz jądra systemu operacyjnego, różniące się strukturą i wolumenem danych.
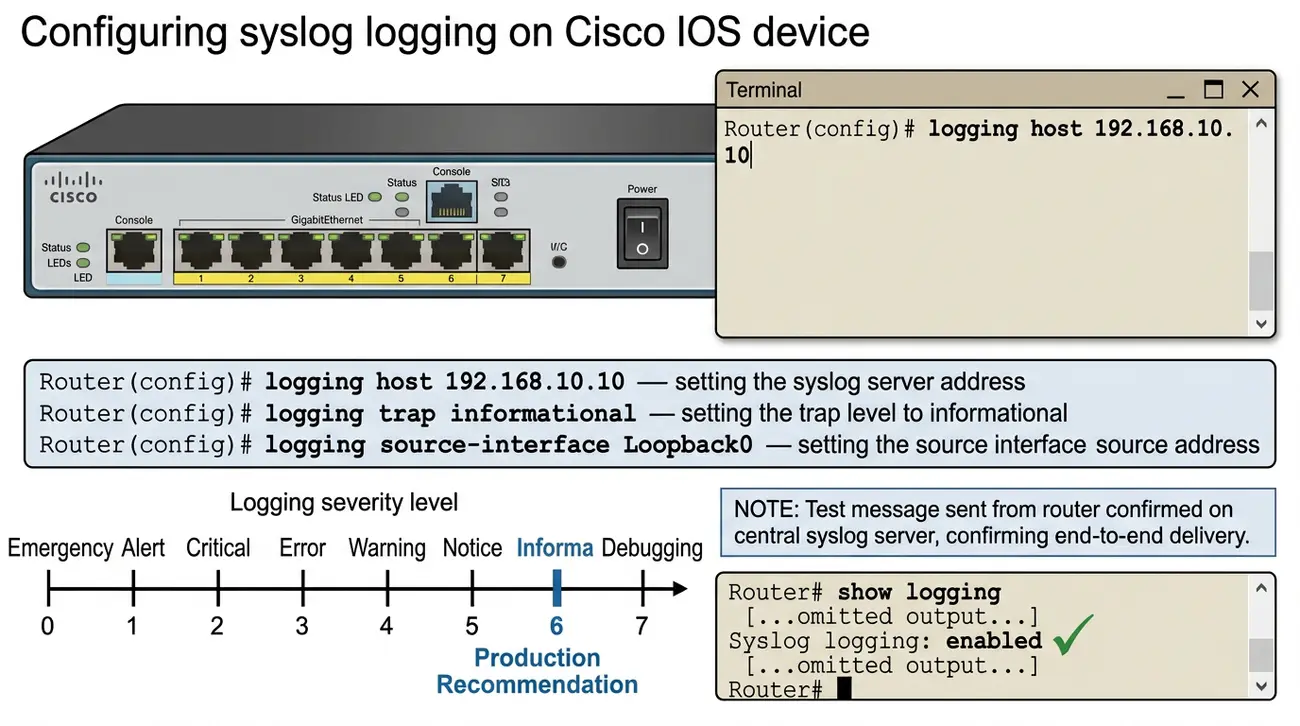
  • Protokół syslog – stanowi uniwersalny standard sieciowy służący do bezpiecznego przesyłania komunikatów z maszyn do centralnego kolektora.
Log entry: Pojedynczy rekord zdarzenia z timestampem, źródłem, treścią i poziomem ważności; logi dzielą się na aplikacyjne, systemowe i sieciowe, a syslog służy do ich centralnego przesyłania.
przykładowy log

Log entry to pojedynczy rekord zdarzenia z czterema kluczowymi polami: timestamp (czas w formacie ISO 8601/RFC 3339), source (aplikacja, host, kontener, usługa), message (treść zdarzenia) oraz severity level (DEBUG, INFO, WARN, ERROR, FATAL). Trzy główne kategorie logów to aplikacyjne (logika biznesowa, request/response, błędy kodu), systemowe (kernel, systemd, cron, usługi systemowe) i urządzeń sieciowych (syslog z routerów, switchy, firewalli, load balancerów) - każda wymaga dedykowanego pipeline'u zbierania i parsowania. Spójna struktura (log entry, log level, syslog, structured logging) to warunek konieczny automatyzacji przetwarzania.

Struktura wpisu logu: timestamp (ISO 8601, np. 2024-01-15T10:30:45.123Z) - jednolity, sortowalny, z informacją o strefie czasowej (zawsze UTC w logach!), source (np. nginx, postgres, kernel, moja-aplikacja), message (czytelna treść zdarzenia), level (DEBUG/INFO/WARN/ERROR/FATAL). Spójna struktura = automatyczna parsowalność, możliwość indeksowania i wykonywania zapytań analitycznych. Niespójne formaty to główna przyczyna problemów z agregacją logów.

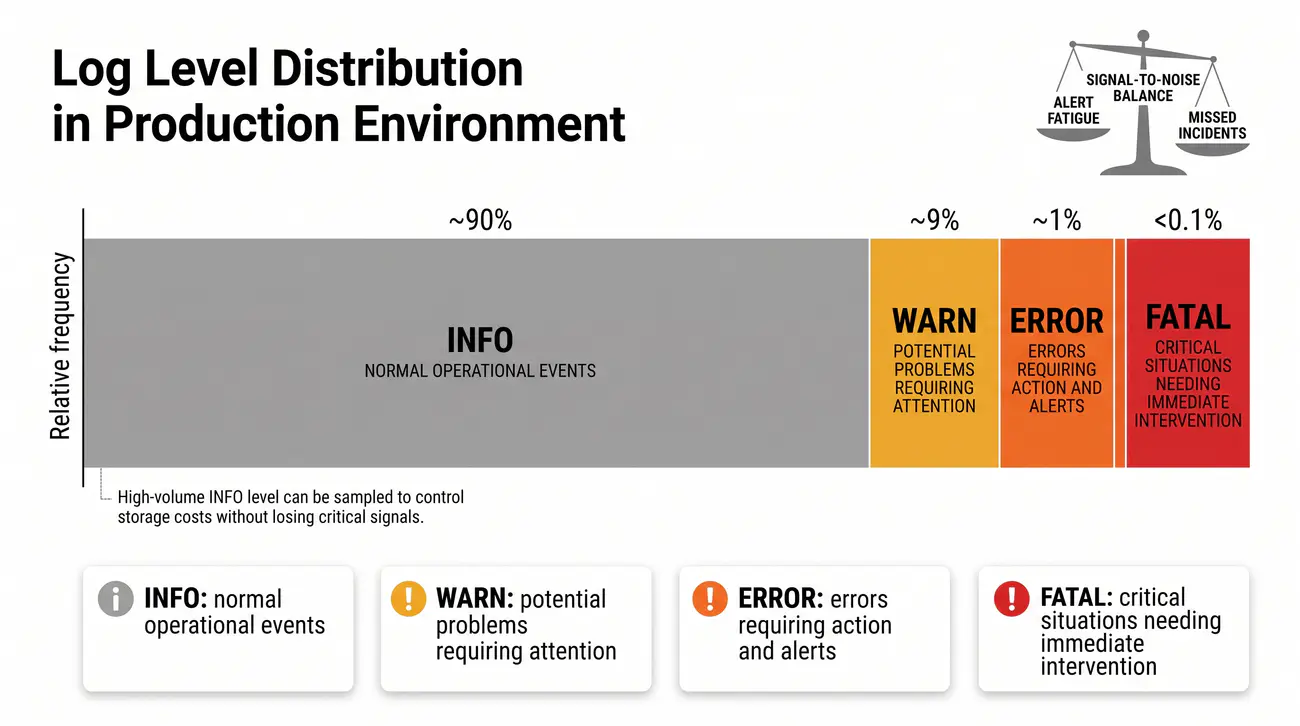
Poziomy logowania: DEBUG (szczegóły debugowe, przepływ sterowania, zmienne - tylko dev/staging), INFO (zdarzenia operacyjne: start/stop usługi, request completed, config loaded - domyślny poziom prod), WARN (potencjalne problemy: retry, deprecated API, resource near limit - wymaga uwagi), ERROR (błędy operacyjne: failed request, DB error, cache miss - wymaga akcji), FATAL/CRITICAL (krytyczne: process crash, data loss, security breach - natychmiastowa interwencja). Prawidłowe przypisywanie poziomów = filtrowanie i alertowanie bez szumu informacyjnego. Kluczowa zasada: loguj na odpowiednim poziomie, nie loguj wszystkiego na INFO.

Kategorie logów: aplikacyjne (logika biznesowa, HTTP request/response, błędy walidacji, transakcje), systemowe (kernel messages, systemd unit status, cron jobs, auditd), sieciowe (firewall ACL denies, load balancer health checks, DNS queries, BGP updates). Każda kategoria ma inne cechy: wolumen, format, priorytet, retention. Dedykowane pipeline'y = lepsza wydajność i niższe koszty.

Podsumowanie: Log = timestamp + source + message + level (minimum). Spójność = automatyzacja. Poziomy = priorytetyzacja i routing alertów. Kategoryzacja = dedykowany routing i retencja. Structured logging (JSON) = standard nowoczesnego SRE.

Zanim zajmiemy się narzędziami, ustalmy, czym właściwie jest log, bo od tego pojęcia zależy cała reszta wykładu. Log entry to pojedynczy rekord zdarzenia, który powinien zawierać cztery kluczowe pola: znacznik czasu, źródło, treść i poziom ważności. Gdy dwie usługi notują zdarzenia w różnych formatach, ich wzajemna korelacja staje się niemal niemożliwa. Dlatego właśnie od struktury logu zaczynamy - od niej zależy, czy dane w ogóle da się automatycznie przetwarzać, indeksować i analizować.

Znacznik czasu zapisujemy w formacie ISO 8601, zawsze w strefie UTC, na przykład 2024-01-15T10:30:45.123Z - taki zapis sortuje się leksykograficznie i nie budzi wątpliwości co do strefy czasowej. Poziomy informują o wadze zdarzenia: DEBUG dla szczegółów programistycznych, INFO dla działań rutynowych, WARN dla potencjalnych problemów, ERROR dla błędów wymagających reakcji i FATAL dla sytuacji krytycznych. Wreszcie logi dzielimy na aplikacyjne, systemowe i sieciowe, a do ich centralnego przesyłania służy protokół syslog.

Wyjaśnienie skrótów użytych na slajdzie:
JSON – JavaScript Object Notation – notacja obiektowa JavaScript; Podstawowy format strukturyzacji zdarzeń ułatwiający automatyczne parsowanie pól logu.
ASCII – American Standard Code for Information Interchange – amerykański standardowy kod do wymiany informacji; Tradycyjny standard kodowania znaków tekstowych stosowany w historycznych plikach logów.
UTC – Coordinated Universal Time – uniwersalny czas koordynowany; Standardowy czas referencyjny, w którym muszą być zapisywane wszystkie znaczniki czasu w logach.
ISO – International Organization for Standardization – Międzynarodowa Organizacja Normalizacyjna; Wydawca standardu ISO 8601 określającego precyzyjny format zapisu daty i czasu w logach.
PID – Process Identifier – identyfikator procesu; Unikalny numer przypisywany przez jądro systemu operacyjnego każdemu uruchomionemu programowi.

3/55 Po co centralizować logi
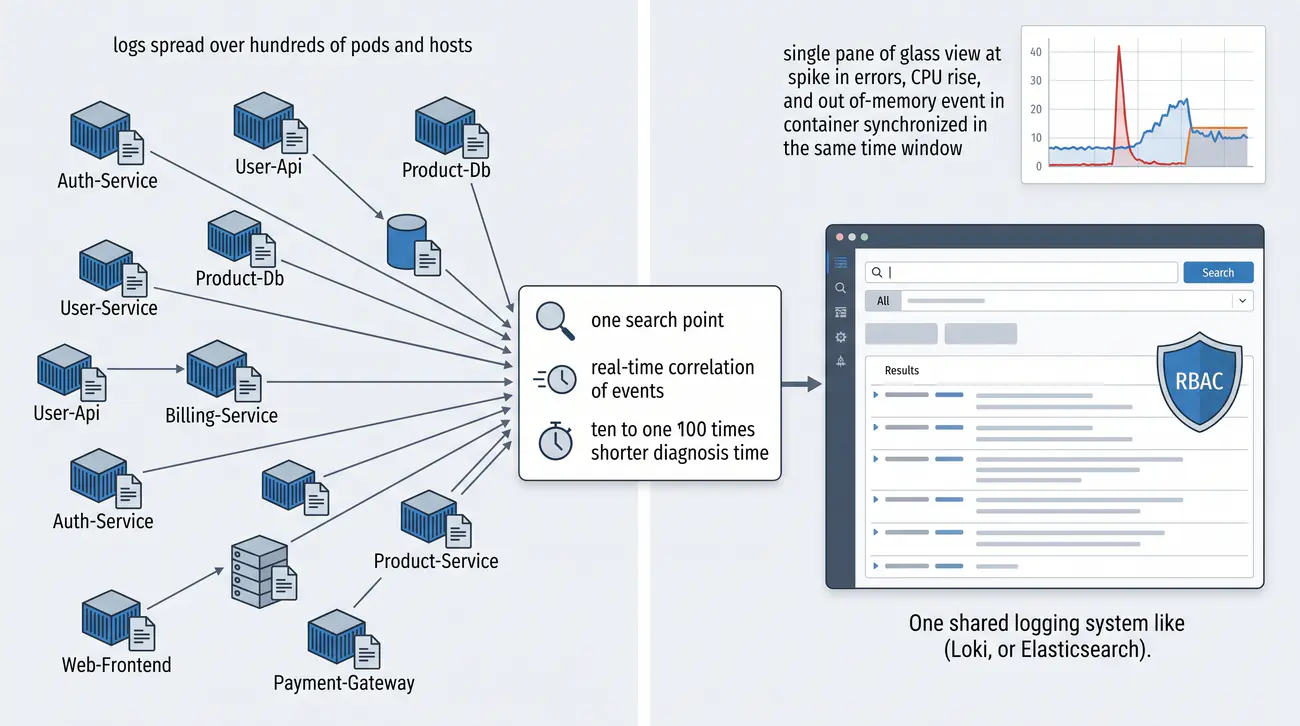
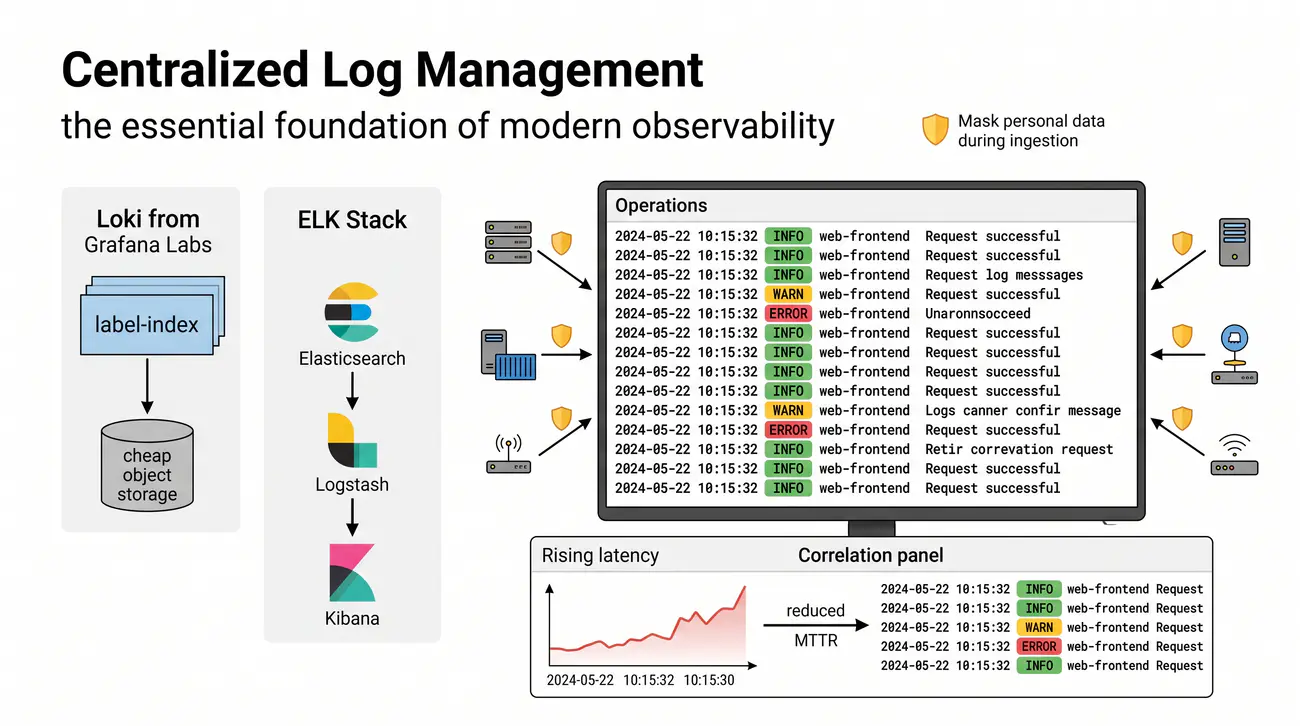
Centralizacja logów: Log aggregation - gromadzenie logów z wielu serwisów w jednym miejscu. Eliminuje silosy, umożliwia korelację zdarzeń i drastycznie skraca diagnostykę awarii. Warunek konieczny SRE w skali.

Jedno żądanie, dziesiątki serwisów, setki kontenerów. Bez centralizacji diagnostyka jest niewykonalna.

  • Wyzwania skali – nowoczesne architektury mikrousług generują miliony zdarzeń na setkach podów, wykluczając ręczne logowanie przez SSH.
  • Centralny rejestr – gromadzenie logów w jednym repozytorium z jednolitym interfejsem eliminuje chaos i ułatwia przeszukiwanie danych.
  • Przyspieszenie diagnozy – analiza zdarzeń na jednym ekranie pozwala skrócić średni czas naprawy incydentu (MTTR) nawet stukrotnie.
  • Wspólny kontekst – centralny system pozwala powiązać błąd w przeglądarce klienta z przeciążeniem bazy i restartem kontenera w tym samym czasie.
  • Wymóg niezawodności – posiadanie pojedynczego punktu widzenia na stan całego systemu zwraca się natychmiast przy pierwszej poważnej awarii.
Log aggregation: Gromadzenie logów z wielu serwisów w jednym miejscu; eliminuje silosy, umożliwia korelację i skraca diagnostykę - warunek SRE w skali.
wiele źródeł a centrala

W systemach rozproszonych pojedynczy request przechodzi przez dziesiątki serwisów, generując logi na setkach kontenerów i hostów - bez centralizacji diagnostyka to szukanie igły w stogu siana: ręczne logowanie na dziesiątki maszyn i żmudna korelacja czasów. Centralizacja rozwiązuje trzy problemy: niemożliwość porównania zdarzeń rozproszonych, brak pojedynczego punktu wyszukiwania i drastyczne wydłużenie czasu diagnostyki; log aggregation i central log management, czyli single pane of glass, to warunek możliwości SRE w skali.

Trudność porównania zdarzeń rozproszonych: W systemach mikrousługowych jeden request przechodzi przez 10-50+ serwisów. Logi rozrzucone na 50-1000+ kontenerach i podach = niemożliwe ręczne korelowanie zdarzeń w czasie. Brak centralizacji oznacza, że inżynier nie widzi całości - widzi fragmenty na osobnych maszynach. Centralizacja tworzy pojedyncze źródło prawdy, jeden spójny widok na cały system. Bez tego SRE w skali jest niemożliwe.

Jedna lokalizacja do wyszukiwania: Centralny system (Loki, Elasticsearch) = jeden endpoint API, jednolity język zapytań (LogQL/Lucene), spójne uprawnienia RBAC. Wyszukiwanie frazy "error" lub "timeout" trwa sekundy, nie godziny ręcznego ssh-owania na serwery, grepowania plików i ręcznego łączenia kropek. Zysk wydajności = diagnoza 10-100× szybsza. Centralizacja to nie wygoda - to wymóg efektywności.

Szybka diagnoza awarii: Centralizacja umożliwia korelację zdarzeń w czasie rzeczywistym - np. spike 5xx w API Gateway + spike CPU w bazie danych + network timeout w logach load balancera + OOM kill w kontenerze - wszystko widoczne na jednym ekranie w tym samym oknie czasowym. Bez centralizacji = osobne dashboardy, osobne narzędzia, ręczne łączenie kropek. MTTR skraca się z godzin do minut. To bezpośredni wpływ na dostępność usług.

Podsumowanie: Centralizacja = jeden widok na wszystkie logi. Eliminuje silosy logów (każdy zespół i usługa ma swoje). Skraca MTTR 10-100×. To nie "nice to have" - to warunek konieczny możliwości SRE w skali. Inwestycja w centralizację zwraca się przy pierwszej poważnej awarii.

Skoro każda usługa potrafi pisać logi, powstaje pytanie: dlaczego nie zostać przy plikach na poszczególnych maszynach? Odpowiedź tkwi w skali. W systemie mikrousługowym jedno żądanie przechodzi przez kilkadziesiąt serwisów, a wpisy lądują na setkach kontenerów i hostów. Ręczne przeszukiwanie tak rozproszonych danych jest niewykonalne, więc jedynym sensownym rozwiązaniem staje się centralizacja, czyli gromadzenie logów z całego środowiska w jednym miejscu. Bez niej każda kolejna warstwa skalowania czyni diagnostykę trudniejszą.

Centralizacja daje trzy korzyści, które bezpośrednio przekładają się na pracę inżyniera. Po pierwsze, jeden punkt wyszukiwania: zamiast logować się po kolei na serwery i przetrząsać pliki, wysyłamy jedno zapytanie w LogQL lub Lucene do centralnego systemu, korzystając przy tym ze spójnych uprawnień RBAC. Po drugie, korelację zdarzeń w czasie rzeczywistym - skok błędów w API Gateway widzimy obok wyczerpania puli połączeń w bazie. Po trzecie, skrócenie czasu diagnozy od dziesięciu do stu razy.

Wyjaśnienie skrótów użytych na slajdzie:
MTTR – Mean Time To Recover – średni czas naprawy; Metryka operacyjna, której redukcja zależy od szybkości przeszukiwania scentralizowanych logów.
MTTD – Mean Time To Detect – średni czas wykrycia; Czas od zaistnienia usterki do jej identyfikacji na podstawie alertu wygenerowanego ze zdarzenia w logu.
RCA – Root Cause Analysis – analiza przyczyn źródłowych; Metodyczny proces dochodzenia do pierwotnej przyczyny incydentu na podstawie korelacji wpisów w dziennikach.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; Kontrakt biznesowy, którego naruszenia dokumentuje się na podstawie wpisów z rejestrów logów.
SLO – Service Level Objective – cel poziomu usług; Wewnętrzny wskaźnik inżynierski wyliczany m.in. na podstawie częstości występowania błędów w logach.

4/55 Architektura zbierania logów
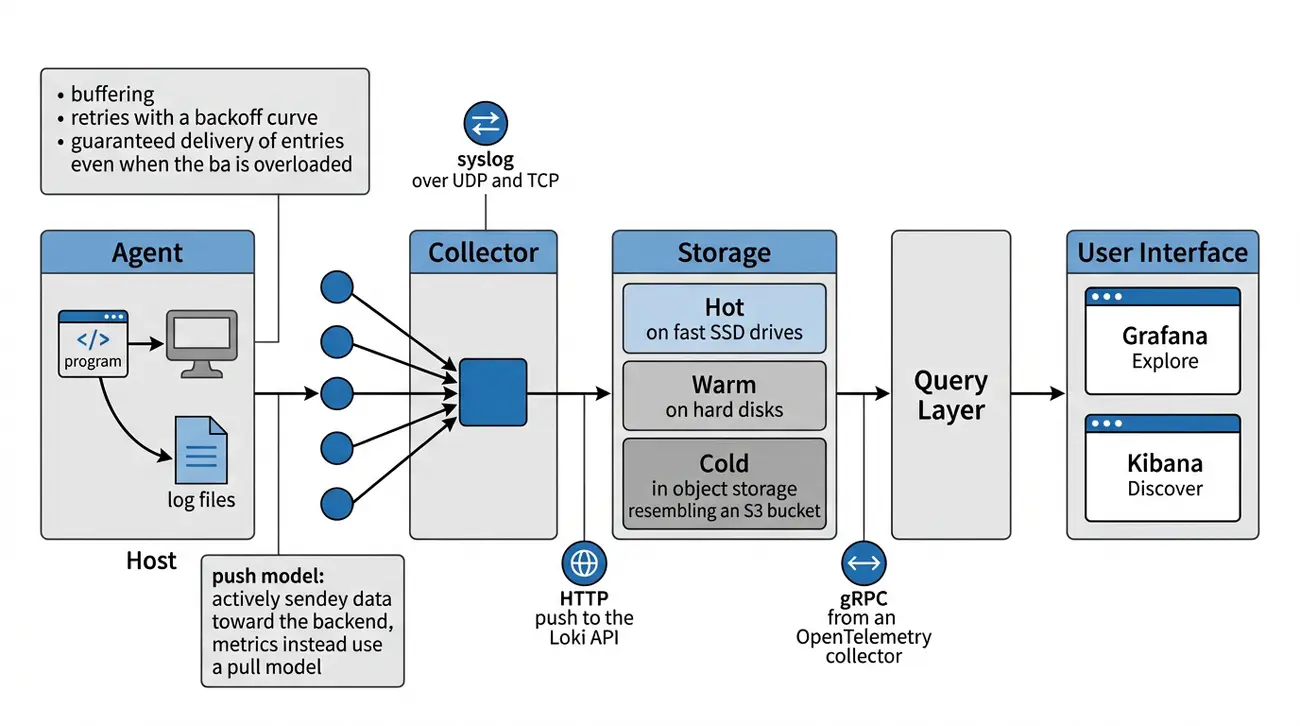
Architektura pipeline'u: Logi przechodzą przez trzy etapy: agent (zbieranie na hoście), collector (agregacja), storage (hot/warm/cold) - a następnie są przeszukiwane przez UI (Grafana Explore, Kibana Discover).

Logi płyną w drugą stronę niż metryki: to agent pcha (push), nie serwer ciągnie. Stąd cały pipeline.

  • Elementy potoku – standardowy łańcuch obejmuje agenta na hoście, węzeł agregujący, magazyn danych oraz interfejs eksploracji użytkownika.
  • Model wypychania (push) – agenci zbierający wysyłają zdarzenia do kolektora, buforując wpisy na dysku w razie chwilowej awarii sieci.
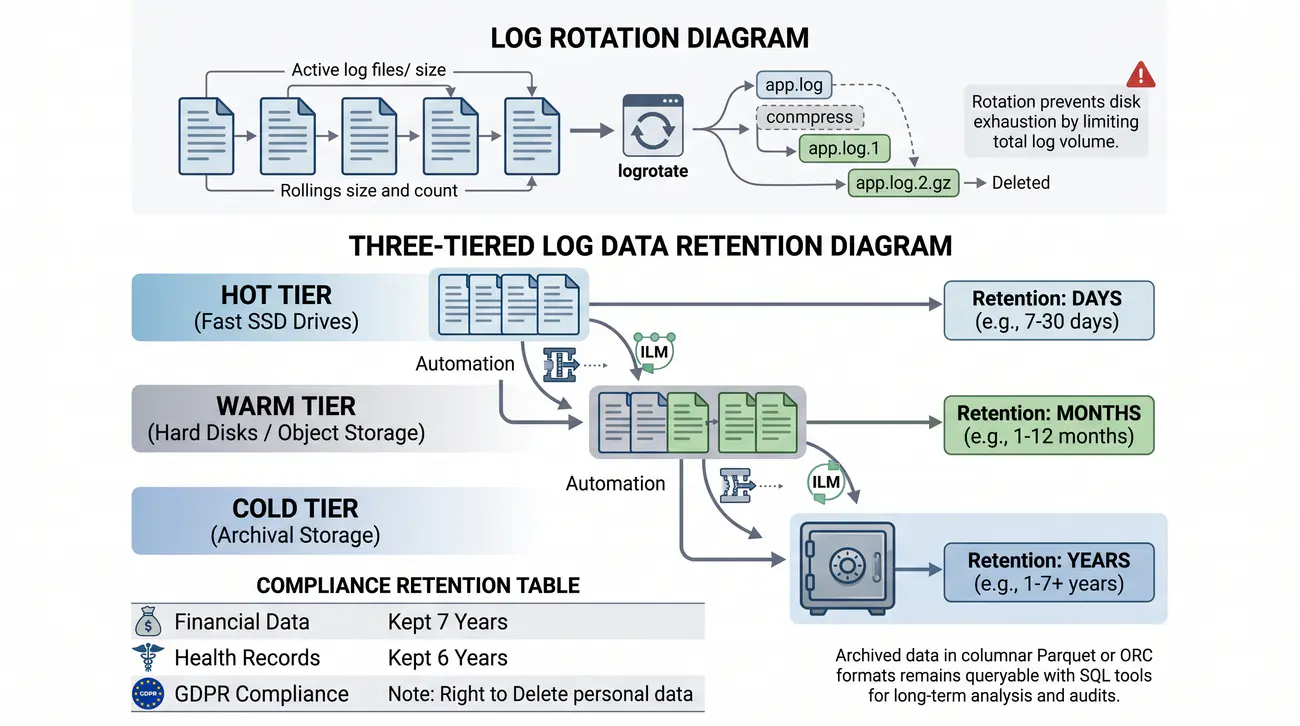
  • Warstwy przechowywania – świeże logi trafiają na szybkie dyski SSD, a starsze wpisy są automatycznie przenoszone do tanich magazynów obiektowych.
  • Odporność agenta – mechanizm ponawiania z wykładniczym opóźnieniem zapobiega bezpowrotnej utracie danych podczas przeciążenia bazy.
  • Protokoły transportowe – do przesyłania logów stosuje się strumienie gRPC, interfejs HTTP API oraz tradycyjny protokół sieciowy syslog.
Pipeline logów: Trzy etapy przepływu wpisu - agent zbiera na hoście (model push), kolektor agreguje, a magazyn warstwowy (hot/warm/cold) przechowuje do przeszukiwania w UI.
przepływ logów

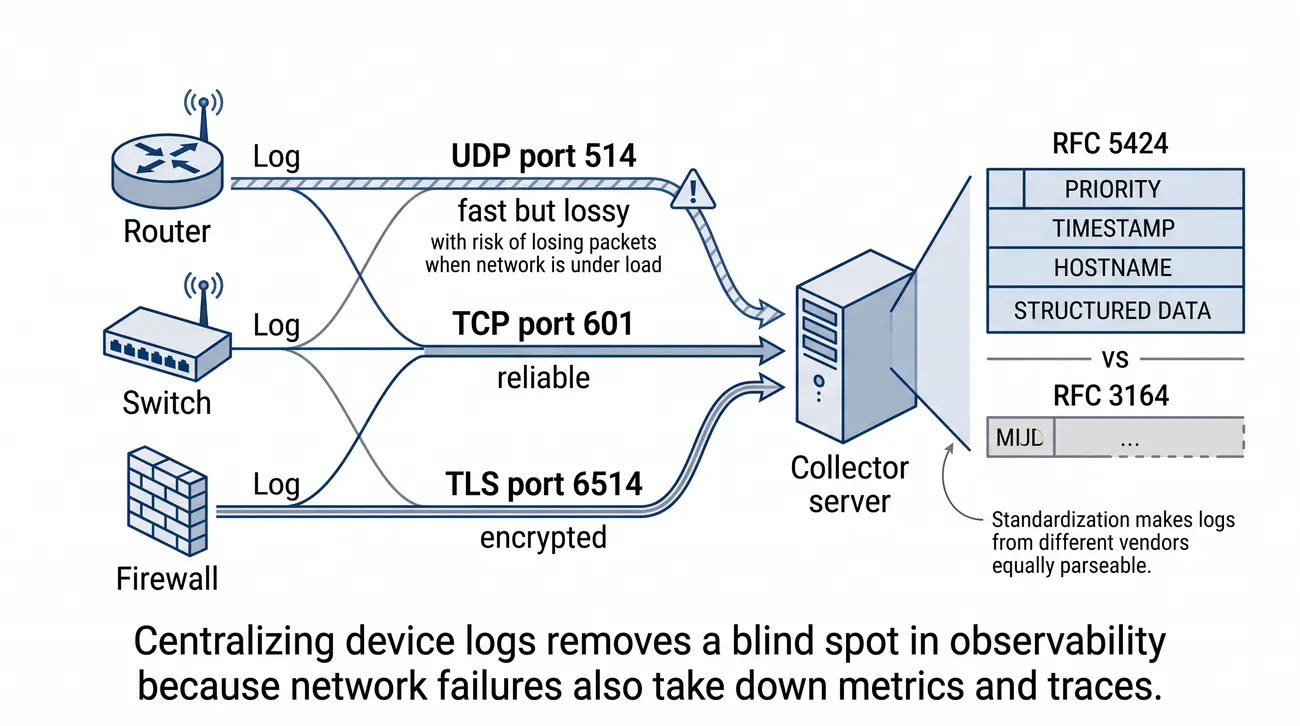
Architektura rejestrowania zdarzeń systemowych opiera się na standardzie IETF RFC 5424, który zastąpił historyczny format RFC 3164. Wprowadza on ścisłą strukturę nagłówka: kod PRI (obiekt i priorytet), mikrosekundowy znacznik czasu w formacie ISO 8601 ze strefą UTC, nazwę hosta, identyfikator aplikacji, identyfikator procesu (PROCID) oraz ustrukturyzowane bloki danych. Transmisja w sieci produkcyjnej musi być szyfrowana za pomocą protokołu TLS zgodnie ze standardem IETF RFC 5425.

Pipeline zbierania logów ma trzy kluczowe etapy: transport do klastra (modele push/pull, protokoły, buforowanie), strategie przechowywania i indeksowania (tiered storage: hot/warm/cold, label-based vs full-text indexing) oraz interfejsy przeszukiwania (Grafana Explore, Kibana Discover). Każdy etap wymaga kompromisu między kosztem, wydajnością, opóźnieniem i retencją; agent zbiera na hoście, collector agreguje, a potok prowadzi od dostarczania danych do ścieżki zapytań.

Transport do klastra: Model push (aplikacja/agent → collector → backend) to standard w cloud-native - aplikacja wysyła logi proaktywnie. Model pull (backend scrapuje agenty) - rzadszy w logach, popularny w metrykach (Prometheus). Protokoły: syslog UDP/TCP (RFC 5424, legacy network devices), HTTP/HTTPS (Loki push API, elastyczne), gRPC (OpenTelemetry Collector, wysoka wydajność, streaming). Kluczowe: buforowanie po stronie agenta (batch, retry, exponential backoff, backpressure) = odporność na tymczasowe przeciążenie backendu i uniknięcie utraty logów. Agent musi być niezawodny - to pierwszy punkt awarii.

Przechowywanie i indeksowanie - tiered storage: Hot storage (SSD/NVMe, ostatnie 24-72h, ścieżka dostarczania + zapytania w czasie rzeczywistym, drogie), Warm storage (HDD/object storage, 7-30 dni, ad-hoc queries, tańsze), Cold storage (S3/GCS/Glacier, archiwum 1-7 lat, compliance, najtańsze). Indeksowanie: Loki - oparte na etykietach (indeksujemy wyłącznie etykiety, a nie pełną treść – rozwiązanie szybkie i efektywne kosztowo), Elasticsearch - inverted index (pełnotekstowe, bogate zapytania, kosztowne RAM/CPU). Retencja per tier = optymalizacja kosztów. Loki compactor / Elasticsearch ILM = automatyzacja przepływu między tierami.

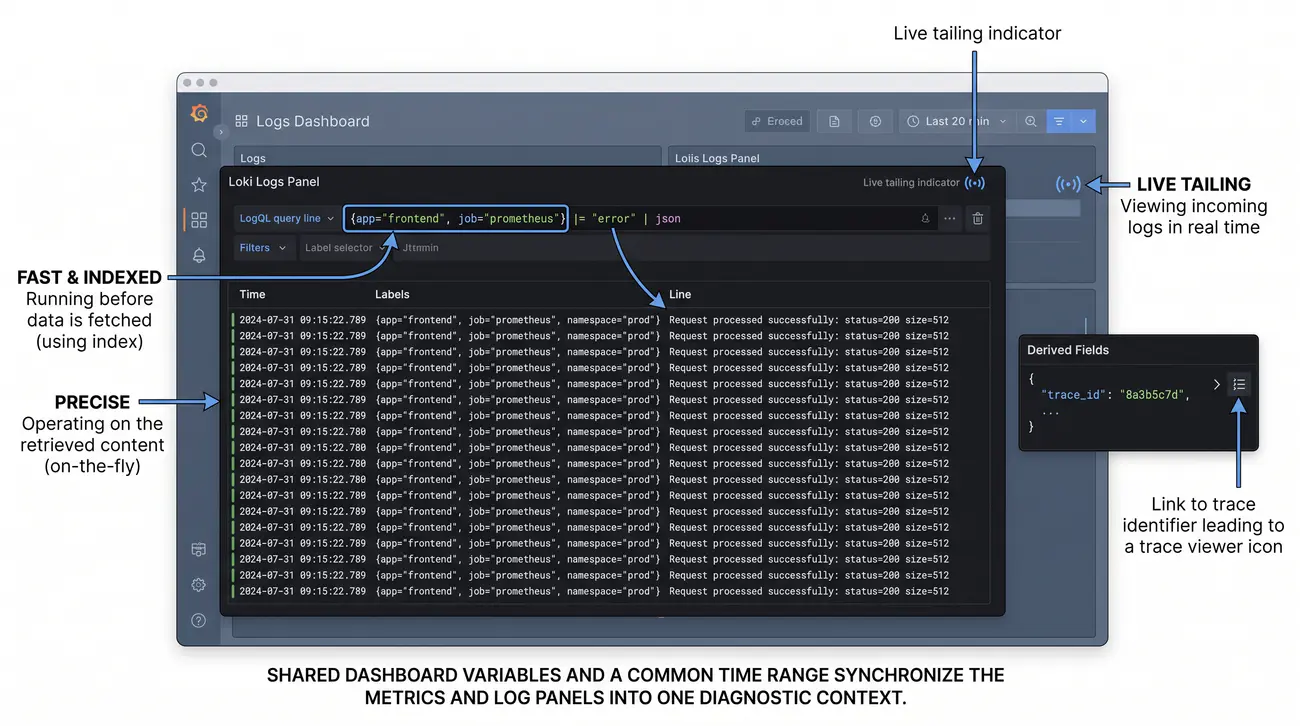
Przeszukiwanie przez UI: Grafana Explore (LogQL, split view metrics+logs, live tailing), Kibana Discover (Lucene query syntax, DSL, saved searches). Kluczowe funkcje: wspólny zakres czasowy, zmienne (templating), drill-down (klik → szczegóły), live tailing (podgląd na żywo). UI to interfejs dla inżynierów on-call w stresie - musi być szybkie, intuicyjne, z kontekstem. To nie jest pulpit dla analityków – to narzędzie do bieżącego rozwiązywania problemów i analizy incydentów.

Podsumowanie: Pipeline = agent → collector → storage (hot/warm/cold) → query → UI. Każdy etap ma kompromisy: latency vs cost, speed vs retention, features vs simplicity. Design musi wynikać z wymagań biznesowych (SLO, budżet, compliance, umiejętności zespołu), nie z mody technologicznej.

Zaraz zobaczymy, jak w praktyce wygląda przepływ logu od aplikacji do ekranu inżyniera. W logach panuje model push - to agent zainstalowany na hoście zbiera wpisy i wysyła je dalej, a nie backend, który po nie sięga, jak ma to miejsce w Prometheu i metrykach. Ten szczegół wart jest zapamiętania, bo przesądza o architekturze całego pipeline'u: pojęcia podobne do tych z wykładu o metrykach poznacie tu w innym wydaniu, z innym transportem, buforowaniem i zasadami niezawodności.

Pełny łańcuch wygląda tak: agent na maszynie odczytuje pliki logów i przekazuje je collectorowi, ten dostarcza dane do magazynu, z którego odpowiadają warstwa zapytań i interfejs, taki jak Grafana Explore czy Kibana Discover. Magazyn dzieli się na warstwy: hot na dyskach SSD obejmuje ostatnie godziny, warm sięga dni i tygodni, a cold w obiektowym przechowywaniu typu S3 archiwizuje dane na lata. Agent musi buforować wpisy, ponawiać wysyłkę i nie gubić logów nawet przy przeciążonym backendzie.

Wyjaśnienie skrótów użytych na slajdzie:
I/O – Input/Output – operacje wejścia/wyjścia; Narzut dyskowy i sieciowy generowany podczas zapisu i przesyłania strumieni logów.
CPU – Central Processing Unit – procesor; Zasób obliczeniowy serwera zużywany podczas kompresji i parsowania zdarzeń tekstowych.
RAM – Random Access Memory – pamięć operacyjna; Pamięć serwera buforująca wpisy przed ich asynchronicznym wysłaniem do bazy logów.
TCP – Transmission Control Protocol – protokół sterowania transmisją; Niezawodny protokół transportowy gwarantujący bezbłędne dostarczenie logów przez sieć.
UDP – User Datagram Protocol – protokół datagramów użytkownika; Tradycyjny protokół przesyłania logów syslog pozbawiony gwarancji doręczenia pakietów.

5/55 Format i parsowanie logów
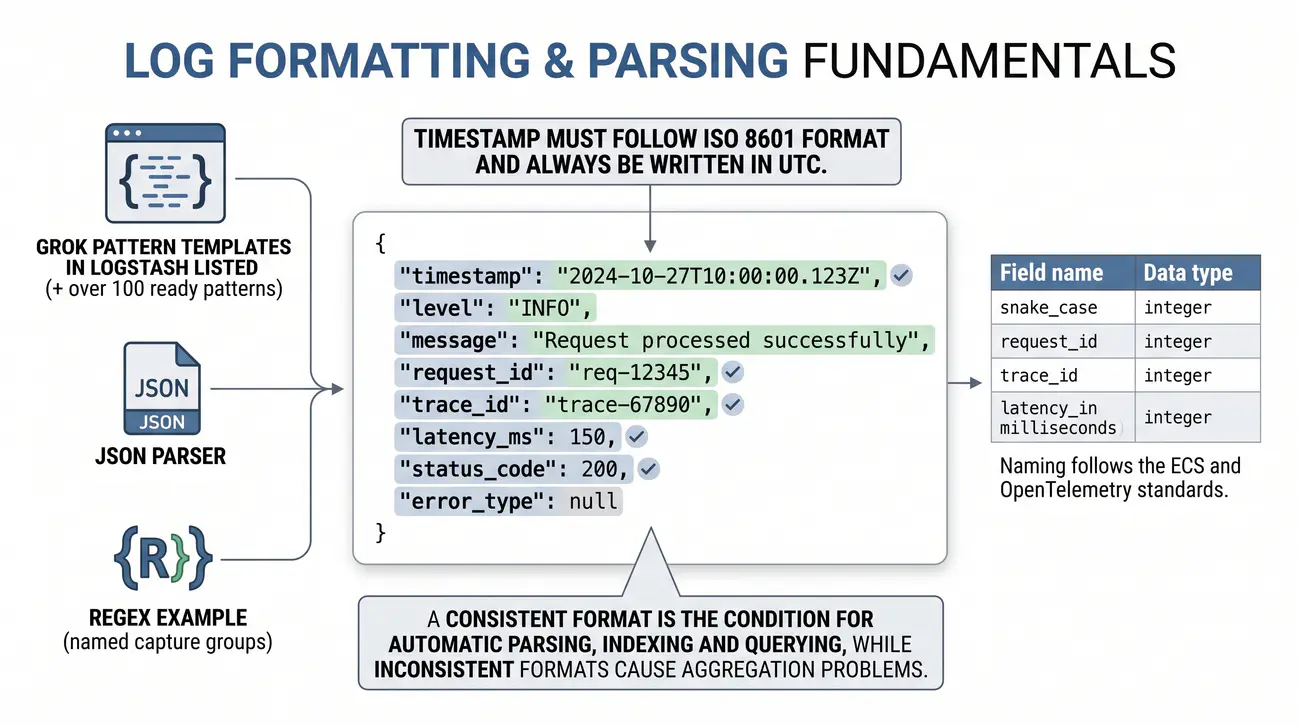
Format logów: Structured logging (JSON) z timestamp ISO 8601 (zawsze UTC) to fundament automatycznego parsowania. Spójna normalizacja pól (np. ECS, OpenTelemetry) umożliwia queryability cross-service.

Automat czyta tylko to, co umie rozebrać. Trzy filary dobrego wpisu: czas, parsowanie i wspólne nazwy pól.

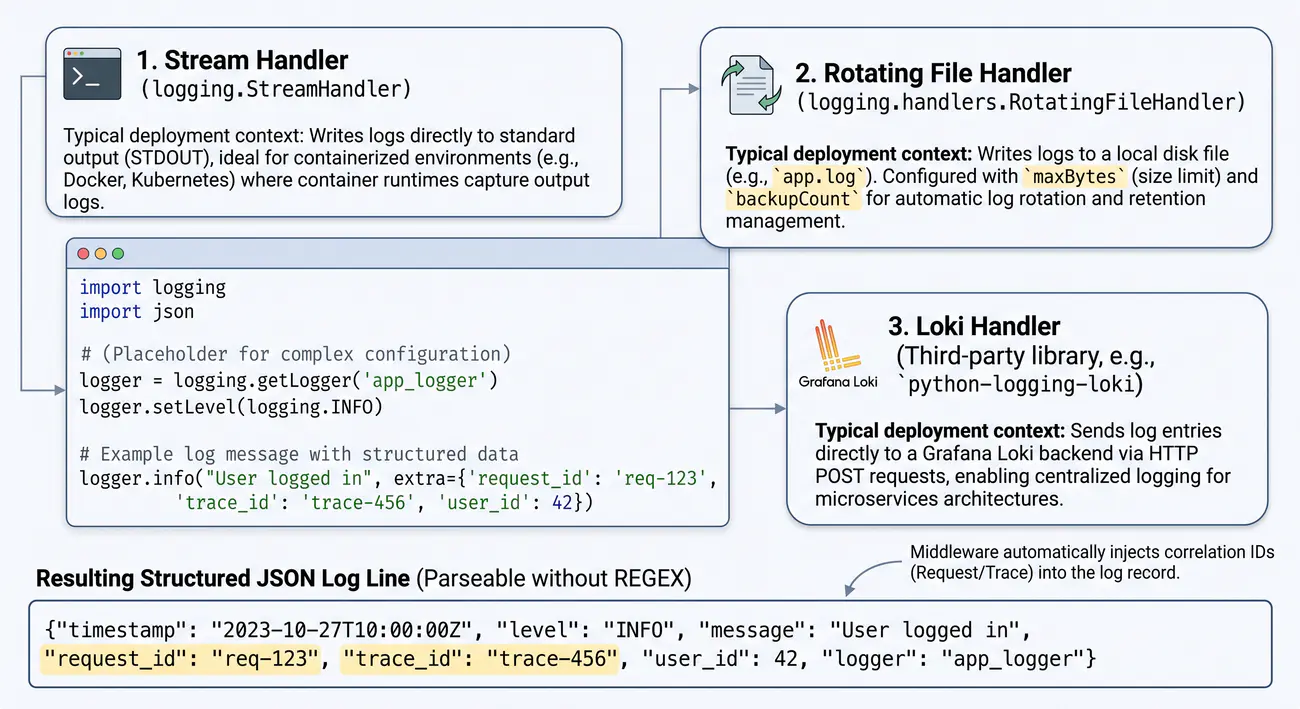
  • Format JSON – logowanie strukturalne pozwala maszynom przetwarzać parametry bez konieczności pisania obciążających wyrażeń regularnych.
  • Czas w strefie UTC – chroni systemy analityczne przed błędami sortowania wynikającymi ze stref geograficznych lub zmian czasu letniego.
  • Parsowanie tekstu – procesory potoku wyodrębniają z surowego tekstu kluczowe pola, takie jak kody odpowiedzi HTTP, czas obsługi i adres IP.
  • Ujednolicenie schematu – stosowanie standardowych nazw pól według specyfikacji OpenTelemetry ułatwia budowanie wspólnych pulpitów analitycznych.
  • Klucze korelacyjne – unikalne identyfikatory żądania oraz śladu umożliwiają natychmiastowe namierzenie powiązanych zdarzeń w klastrze.
Structured logging: Logi w formacie JSON ze znormalizowanymi polami (timestamp ISO 8601 w UTC, standardy ECS/OpenTelemetry); fundament automatycznego parsowania i zapytań między serwisami.
log w JSON

Tradycyjny, nieustrukturyzowany tekst wymaga kosztownego parsowania wyrażeniami regularnymi na serwerze agregującym. Standardem nowoczesnego oprogramowania jest generowanie zdarzeń bezpośrednio w formacie JSON zgodnym ze standardem Elastic Common Schema / OpenSearch Schema. Każdy wpis zawiera ujednolicone nazwy pól: @timestamp, log.level, message, service.name oraz unikalne identyfikatory korelacyjne.

Trzy filary formatowania i parsowania logów to: znaczniki czasu w formacie ISO 8601/RFC 3339 (jednolite, sortowalne, z strefą czasową), techniki parsowania pól (regex, Grok, parsowanie JSON, OpenTelemetry semantic conventions) oraz normalizacja danych (standaryzacja nazw pól, typów i jednostek). Bez spójnego formatu logi pozostają śmieciami tekstowymi nieprzetwarzalnymi automatycznie - inwestycja w jakość logów (structured logging, parser, log format, normalization) zwraca się przy pierwszej poważnej awarii.

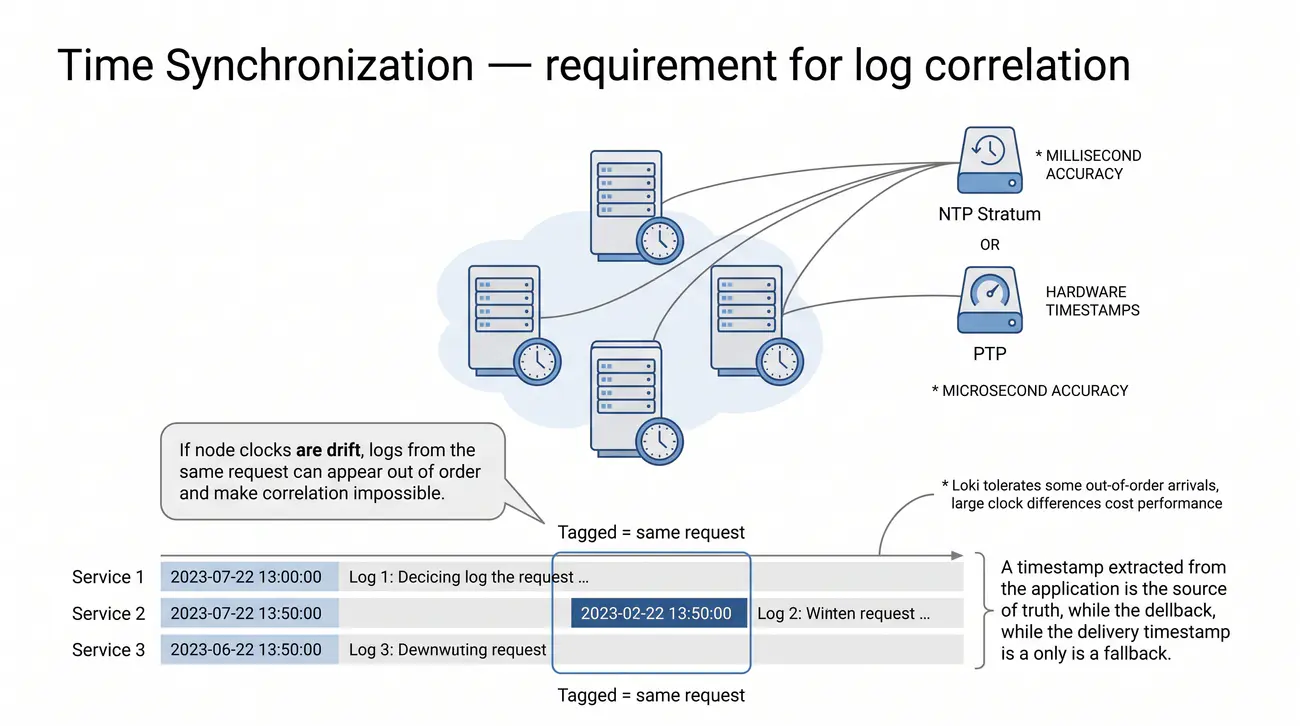
Znaczniki czasu ISO 8601/RFC 3339: Format np. 2024-01-15T10:30:45.123Z lub 2024-01-15T10:30:45.123+00:00 - jednolity, sortowalny leksykograficznie, zawiera informację o strefie czasowej (offset). UNIKAMY lokalnych formatów (dd/mm/yyyy, mm/dd/yyyy) - nieposortowalne, niejednoznaczne, zależne od locale. Timestamp to klucz korelacji (metrics-logs-traces) - musi być precyzyjny (ns/μs) i spójny we wszystkich serwisach. zawsze UTC w logach! Synchronizacja NTP/PTP = warunek konieczny.

Parsowanie pól: Grok patterns (Logstash, 120+ gotowych wzorców) / regex (Promtail, Loki pipeline stages) / parsowanie JSON (structured logging - najlepsze). Ekstrakcja kluczowych pól: request_id, user_id, trace_id, span_id, latency_ms, status_code, method, path, error_type. Nazwane grupy przechwytywania zapewniają czytelność i możliwość ponownego wykorzystania reguł. UNIKAMY ad-hoc regex - trudne w utrzymaniu, błędogenne, wolne. Standardowe wzorce (common log format, combined, JSON) = parsowalność out-of-the-box.

Normalizacja: Standaryzacja nazw pól (snake_case: request_id, response_time_ms, http_status_code), typów danych (int, float, bool, string), jednostek (ms dla latencji, bytes dla rozmiaru, percent dla wykorzystania). ECS (Elastic Common Schema) / OTel semantic conventions = standard cross-team, cross-organization. Normalizacja = możliwość zapytań cross-service (możesz zapytać "wszystkie requesty z latency > 500ms" niezależnie od serwisu). Bez normalizacji = silosy danych.

Podsumowanie: ISO 8601 (UTC!) + structured logging (JSON) + normalizacja (ECS/OTel) = parsowalne, korelowalne, przeszukiwalne logi. To inwestycja inżynierska, która zwraca się przy pierwszej awarii - różnica między 5 minutami a 5 godzinami diagnostyki.

Metryki trafiają do systemu w jednym, ścisłym formacie, więc dotąd nie musieliśmy zastanawiać się nad ich postacią. Z logami jest inaczej: każda aplikacja może pisać je po swojemu, a konsekwencją bywają wpisy, których żaden automat nie potrafi rozebrać na części. Dlatego format i parsowanie stanowią kluczową inwestycję - dobrze zaprojektowany wpis w formacie JSON da się automatycznie przetwarzać, indeksować i przeszukiwać, podczas gdy nieuporządkowany tekst pozostanie zapisem bezużytecznym przy diagnozie awarii.

Dobre formatowanie opiera się na trzech filarach. Po pierwsze, czas w ISO 8601, zawsze UTC, precyzyjny i synchronizowany przez NTP. Po drugie, parsowanie: gotowe wzorce Grok w Logstashu obsługują ponad sto dwadzieścia szablonów, a w Promtailu etapy pipeline'u wspierają wyrażenia regularne i parsowanie JSON z nazwanymi grupami przechwytywania. Po trzecie, normalizacja pól - ujednolicone nazwy w notacji snake_case, określone typy i jednostki, zgodne ze standardami ECS czy OpenTelemetry, umożliwiają zapytania w skali całego systemu.

Wyjaśnienie skrótów użytych na slajdzie:
JSON – JavaScript Object Notation – notacja obiektowa JavaScript; Format reprezentacji danych stanowiący de facto standard w nowoczesnych architekturach mikroserwisowych.
CSV – Comma-Separated Values – wartości rozdzielane przecinkami; Prosty format tabelaryczny stosowany sporadycznie w archiwalnych plikach sprawozdawczych.
ECS – Elastic Common Schema – wspólny schemat danych Elastic; Otwarta specyfikacja definiująca jednolite nazewnictwo pól dla logów, metryk i zdarzeń audytowych.
RegEx – Regular Expression – wyrażenie regularne; Wzorzec tekstowy stosowany w agentach zbierających do rozbicia surowych linii tekstu na nazwane pola.
POSIX – Portable Operating System Interface – przenośny standard systemu operacyjnego; Standard składni wyrażeń regularnych wspierany przez silniki parsowania logów.

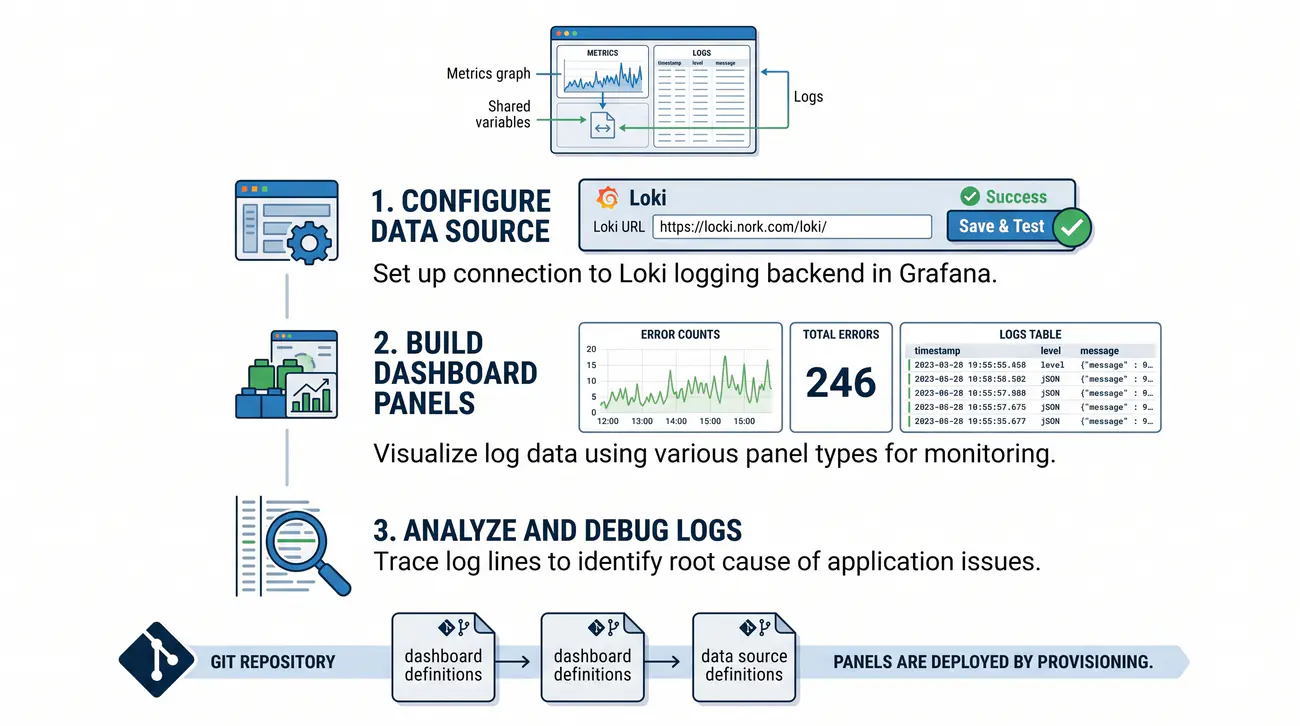
6/55 Wprowadzenie do Grafana Loki
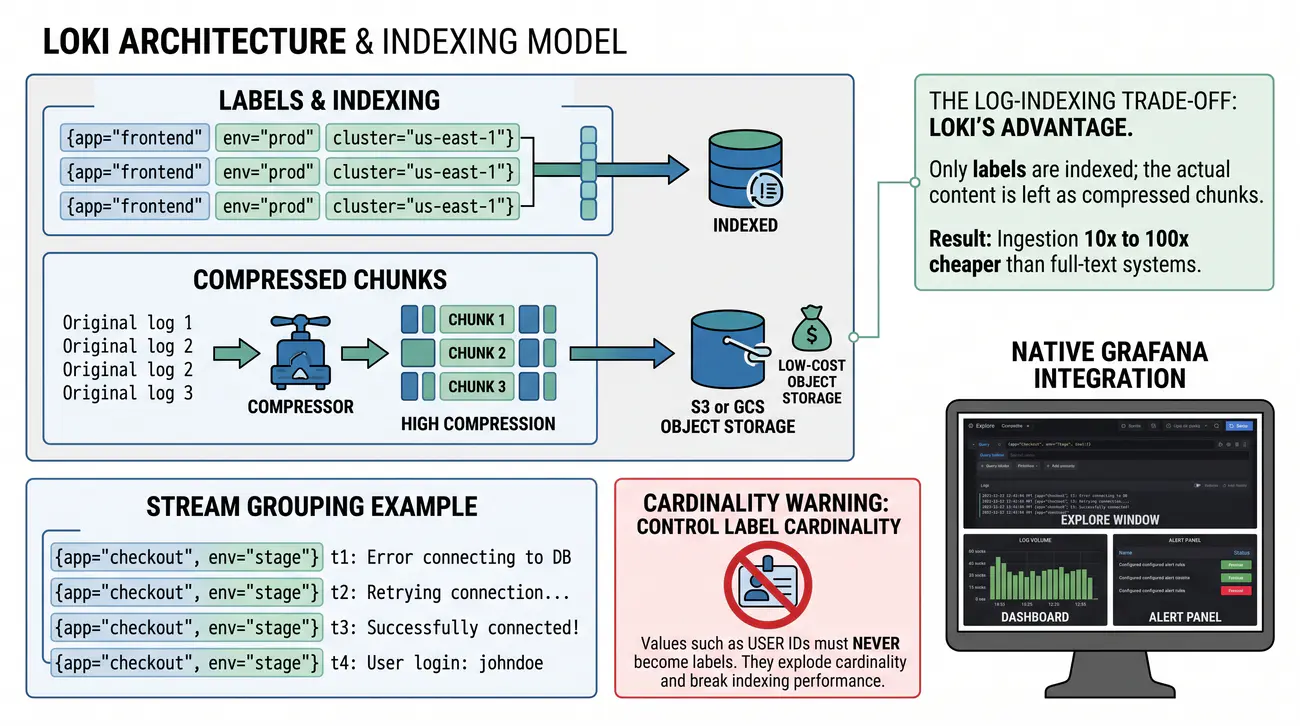
Loki: System agregacji logów od Grafana Labs. Indeksuje wyłącznie etykiety (labels), nie treść - ingest 10-100× tańszy niż ELK. Logi trafiają na object storage (S3/GCS), integracja z Grafaną out-of-the-box.

Loki indeksuje tylko etykiety, treść trzyma skompresowaną w obiektówce. Efekt: 10-100× taniej niż ELK.

  • Filozofia Loki – system stworzony przez Grafana Labs indeksuje wyłącznie etykiety metadanych, pozostawiając samą treść logów nieskompresowaną.
  • Koncepcja strumieni – zbiór wpisów posiadających identyczny zestaw etykiet, na przykład aplikację i środowisko, tworzy spójny strumień danych.
  • Oszczędność zasobów – rezygnacja z pełnego indeksu wyszukiwawczego drastycznie zmniejsza zużycie pamięci RAM oraz koszty magazynowania w chmurze.
  • Integracja z Grafaną – wspólne środowisko pozwala na płynne przechodzenie od wykresu metryk bezpośrednio do odpowiadających im wpisów w logach.
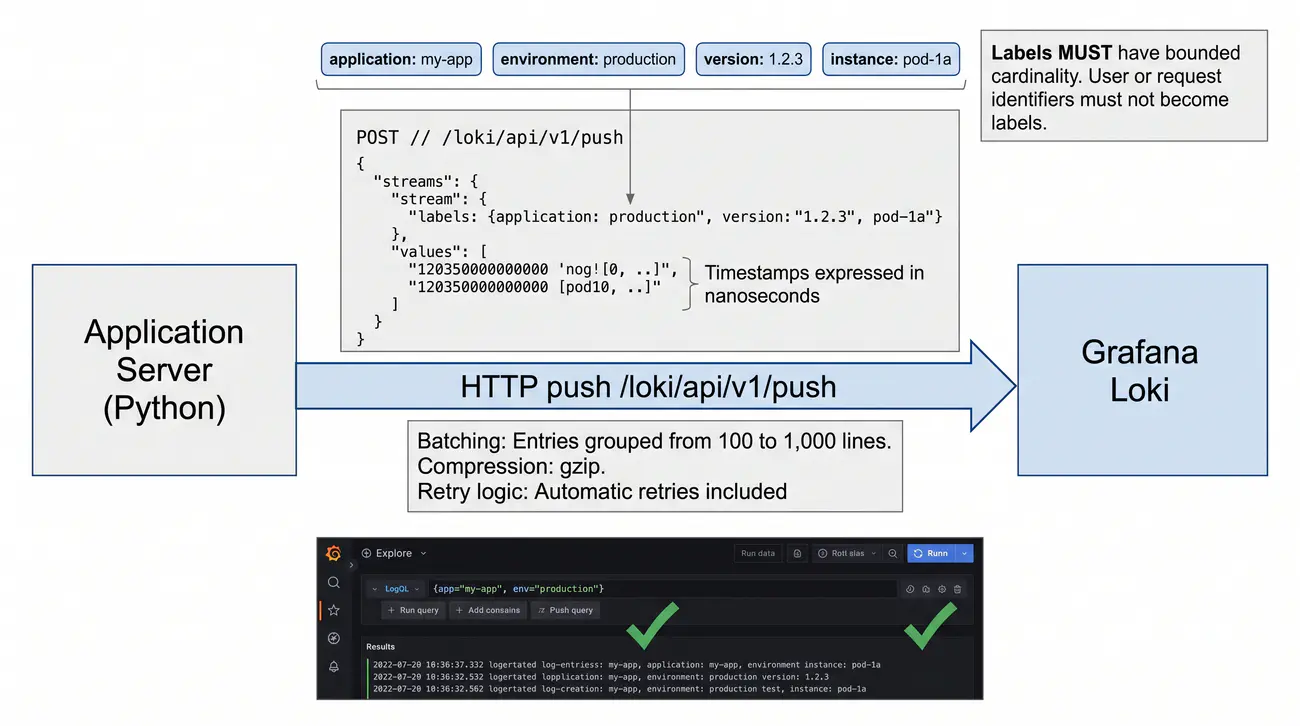
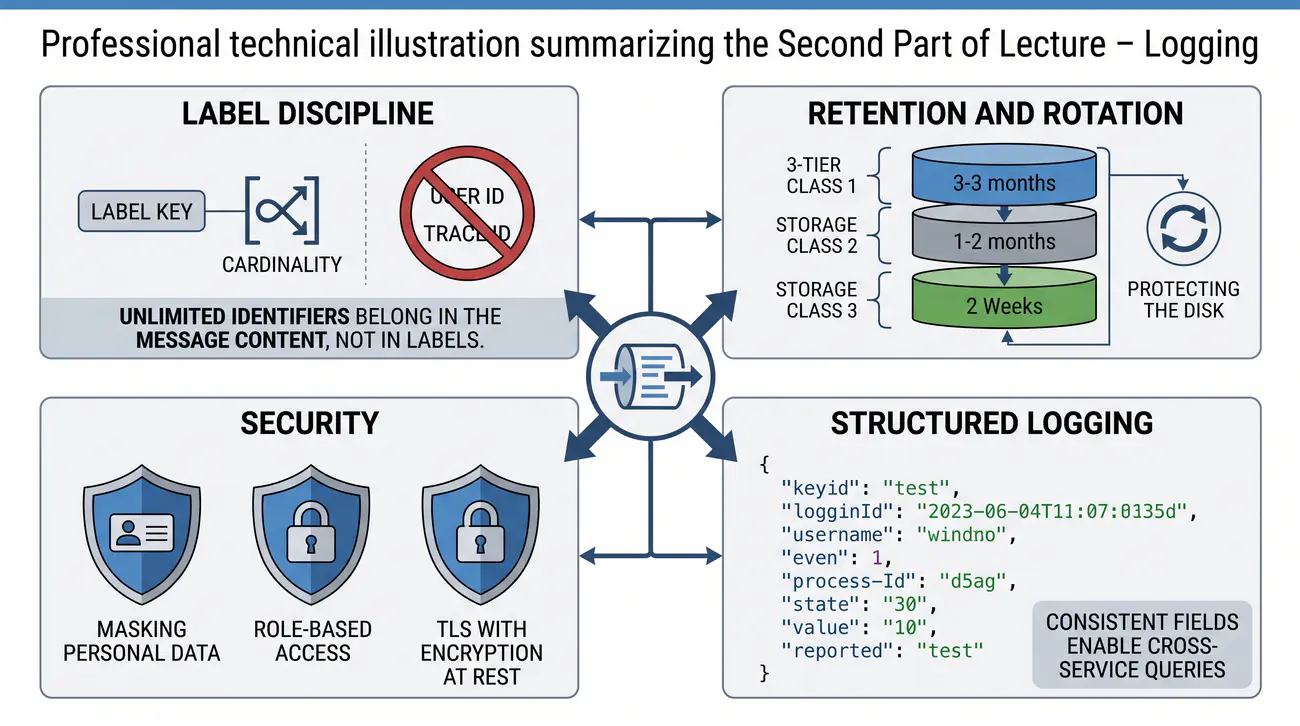
  • Dyscyplina etykiet – wysoka kardynalność, taka jak umieszczanie identyfikatora użytkownika w etykiecie, może doprowadzić do awarii klastra.
Loki: System agregacji logów od Grafana Labs indeksujący wyłącznie etykiety, nie treść; ingest 10-100× tańszy niż ELK, dane w object storage, integracja z Grafaną.
architektura Loki
Zrozumieć architekturę Loki: Dlaczego Loki stało się rewolucją w świecie SRE? Tradycyjne wyszukiwarki (jak Elasticsearch) budują ogromny indeks odwrócony każdego wyrazu, co pożera gigabajty pamięci RAM. Twórcy Loki powiedzieli: indeksujmy tylko etykiety (tak jak Prometheus indeksuje metadane metryk), a treść logów spakujmy do tanich plików na S3. Dzięki temu koszty przechowywania terabajtów logów spadają nawet o 80-90%, a korelacja z metrykami w Grafanie odbywa się za pomocą tych samych selektorów.

System Grafana Loki od Grafana Labs jest zaprojektowany dla ery cloud-native i Kubernetes: zamiast kosztownego pełnotekstowego indeksowania (inverted index jak w Elasticsearch) indeksuje wyłącznie etykiety dołączone do strumieni logów, dzięki czemu dostarczanie danych jest 10-100× tańsze i szybsze, a przechowywanie na object storage (S3/GCS/Azure Blob) niezwykle tanie. Architektura to agregacja logów przez push, grupowanie w strumienie po etykietach, chunk-based storage i natywna integracja z Grafaną (LogQL, Explore, dashboards, alerting); kluczowe pojęcia to labels, chunk i stream.

Agregacja logów: Loki dostarcza logi przez model push (Promtail, Fluent Bit, Fluentd, Docker logging driver, OpenTelemetry Collector). Logi grupowane są w strumienie po zestawie etykiet - np. {app="nginx", env="prod", cluster="eu-west-1"}. Każdy unikalny zestaw etykiet = oddzielny strumień. Brak pełnego indeksu tekstowego = tanie, szybkie dostarczanie danych (zapis O(1)). Kardynalność etykiet = kluczowy parametr - zbyt wiele unikalnych kombinacji = problemy z wydajnością (eksplozja kardynalności etykiet).

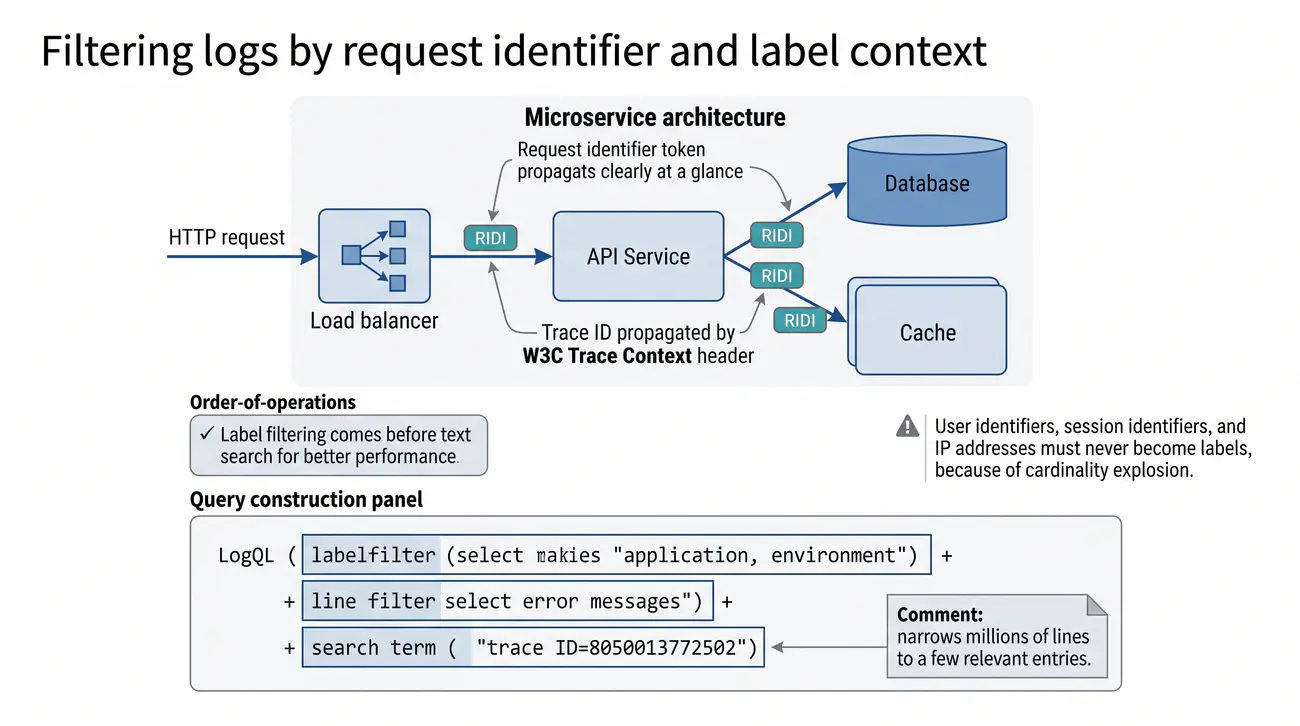
Etykiety zamiast pełnego indeksu: To serce architektury Loki. Loki indeksuje wyłącznie etykiety (indeks etykiet podobny do TSDB Prometheusa), a nie treść logów. LogQL filtruje najpierw po etykietach (szybkie, indeksowane), potem skanuje chunki po czasie w wybranych strumieniach. Kompromis: wolniejsze wyszukiwanie pełnotekstowe (trzeba przeskanować chunki), ale przechowywanie i dostarczanie 10-100× tańsze. Dla typowego przypadku SRE (szukam błędów w serwisie X w czasie Y) to idealny kompromis. Oparte na etykietach = "Prometheus dla logów".

Niskie koszty: Enkodowanie chunków (kompresja gzip, domyślnie; typowo 5-10:1), object storage (S3/GCS/Azure Blob - rozdzielenie compute od storage), brak skomplikowanego klastra Elasticsearch. Koszt ~$0.50-1.00/GB/miesiąc vs Elasticsearch ~$5-15/GB/miesiąc (wliczając replikację, RAM, operacje). Skuteczne logowanie w skali - kluczowe dla startupów i enterprise. Tryb single binary = nawet tańsze dla mniejszych wdrożeń.

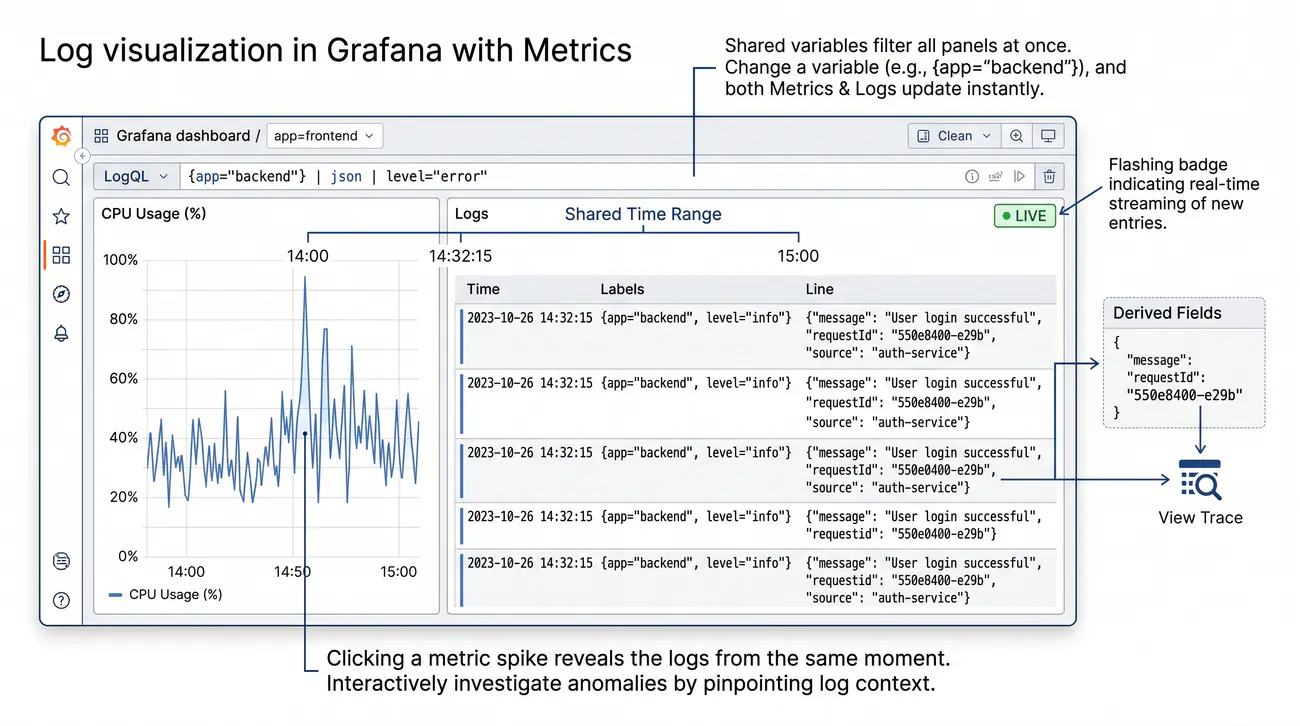
Integracja z Grafaną: Data source Loki → Explore (LogQL, live tailing), dashboards (logs panel, time series z logów via recording rules), alerts (LogQL rules w Grafana Alerting lub Loki Ruler). Zunifikowana obserwowalność: metrics (Prometheus) + logs (Loki) + traces (Tempo) w jednym UI, wspólny zakres czasowy, zmienne, korelacje. To "killer feature" - jeden pulpit do wszystkiego.

Podsumowanie: Loki = indeksowanie oparte na etykietach, object storage, tanio, natywnie z Grafaną, design cloud-native. Idealne dla: Kubernetes, mikrousług, wrażliwych na koszty zespołów używających Grafany. Kompromis: brak pełnotekstowego wyszukiwania domyślnie (regex w pipe filtrów linii). Znaj swoje kompromisy.

Przechodzimy do pierwszego z dwóch wielkich systemów logowania, czyli do Loki od Grafana Labs. Klucz do zrozumienia tego narzędzia leży w architektonicznej decyzji jego twórców: zamiast indeksować pełną treść logów, Loki indeksuje wyłącznie etykiety, samą treść zaś przechowuje jako skompresowane chunki w przechowywaniu obiektowym. To odwrócenie filozofii względem klasycznych magazynów i jednocześnie odpowiedź na koszty, które w skali chmurowej potrafią pochłonąć budżet całego projektu obserwowalności.

Skutek tej decyzji jest taki, że przyjmowanie i przechowywanie logów jest od dziesięciu do stu razy tańsze niż w ELK: zamiast drogiej pamięci RAM mamy object storage, a dane kompresujemy algorytmem gzip (domyślnym w Loki), osiągając dla tekstowych logów kompresję rzędu 5-10:1. Logi o tym samym zestawie etykiet, na przykład aplikacji, środowiska i klastra, tworzą pojedynczy strumień. Uwaga na kardynalność: wartości takich jak identyfikator użytkownika nigdy nie umieszczamy w etykiecie, bo to eksplozja kardynalności. Loki wprost integruje się z Grafaną.

Wyjaśnienie skrótów użytych na slajdzie:
CNCF – Cloud Native Computing Foundation – Fundacja Oprogramowania Chmurowego; Środowisko otwartych technologii, którego standardy implementuje system Grafana Loki.
TSDB – Time Series Database – baza danych szeregów czasowych; Koncepcja architektoniczna, z której Loki zapożyczył model indeksowania etykiet i strumieni.
PromQL – Prometheus Query Language – język zapytań Prometheus; Język zapytań stanowiący bezpośrednią inspirację składniową dla języka LogQL.
LogQL – Log Query Language – język zapytań LogQL; Dedykowany język filtrowania strumieni logów i wyliczania z nich metryk w locie.
S3 – Simple Storage Service – prosta usługa pamięci masowej; Standard magazynu obiektowego, w którym Loki przechowuje skompresowane porcje logów (chunks).

7/55 Architektura Loki (skrót)
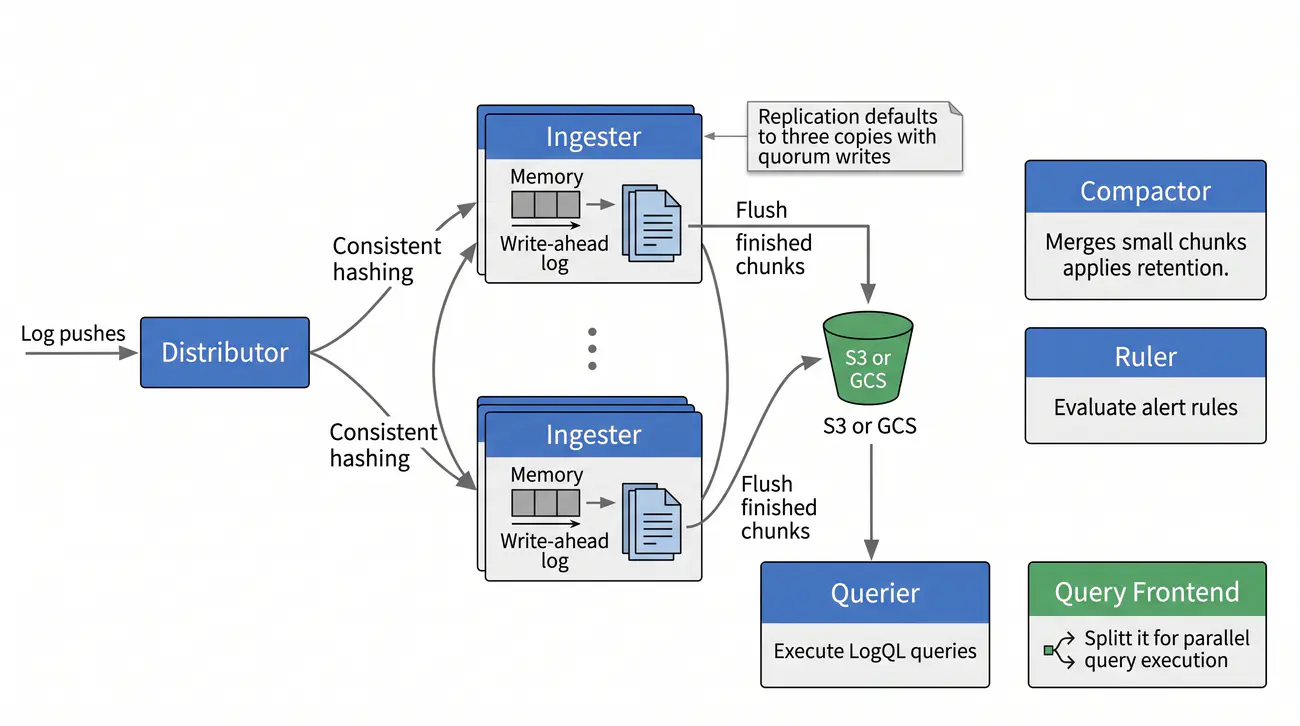
Architektura Loki: Mikroserwery: Distributor (front-end ingestu), Ingester (zapis chunków, WAL), Querier (LogQL), Compactor (kompaktacja, retencja), Ruler (alerting). Dane w object storage (S3/GCS).

Produkcyjny Loki to zespół mikroserwisów: jedne przyjmują, drugie trzymają, trzecie pytają.

  • Komponent Distributor – przyjmuje logi od agentów, waliduje limity przepustowości i rozdziela pakiety za pomocą haszowania spójnego.
  • Moduł Ingester – buforuje przychodzące linie tekstu w pamięci operacyjnej i dzienniku transakcji, po czym zapisuje je w blokach na S3.
  • Rola Queriera – wykonuje zapytania LogQL, pobierając najświeższe dane z buforów pamięci oraz archiwalne bloki z magazynu obiektowego.
  • Funkcja Compactora – odpowiada za scalanie mniejszych fragmentów danych w większe bloki oraz bezpowrotne usuwanie przeterminowanych logów.
  • Moduł Query Frontend – dzieli złożone zapytania użytkowników na mniejsze zadania równoległe i zapamiętuje wyniki w pamięci podręcznej.
Ingester: Komponent Lokiego zapisujący chunki i dziennik WAL; obok Distributora (ingest), Queriera (LogQL), Compactora (retencja) i Rulera (alerting).
składowe

Różnica architektoniczna wynika ze struktury indeksu: stos ELK / OpenSearch buduje odwrócony indeks pełnotekstowy dla każdego słowa w logu, co umożliwia błyskawiczne wyszukiwanie dowolnego ciągu znaków, lecz narzut indeksu wynosi 100–200% rozmiaru surowych danych i wymaga dużej ilości pamięci operacyjnej (pula JVM heap). Z kolei Grafana Loki indeksuje wyłącznie metadane (etykiety strumieni), natomiast samą treść logów kompresuje i składuje w tanich magazynach obiektowych (S3), radykalnie obniżając całkowity koszt posiadania (TCO) kosztem dłuższego skanowania zapytań o rzadkich kryteriach.

Architektura Loki jest mikroserwowa i horyzontalnie skalowalna, z rozdzieleniem compute od storage: komponenty (mikroserwery) komunikują się przez gRPC i mogą być skalowane niezależnie. Distributor obsługuje front-end ingestu (walidacja, przekazywanie), Ingester zapisuje chunki (replikacja, WAL), Querier wykonuje LogQL, Query Frontend zapewnia caching, dzielenie zapytań i parallelizację, Compactor zajmuje się kompaktacją, retencją i downsamplingiem, a Ruler ocenia reguły alertowe; dane (chunki) przechowywane są na storage obiektowym (S3/GCS).

Distributor: Komponent bezstanowy przyjmujący zapisy (Push API). Load balancing przez consistent hashing (ring) do ingesterów - zapewnia równomierny rozkład i minimalny reshuffingle przy skalowaniu. Walidacja: limity etykiet (max 100 etykiet/strumień), limit rozmiaru linii (domyślnie 256KB), izolacja tenantów. Przekazywanie do ingesterów przez gRPC streaming. Skalowanie horyzontalne = dodaj pody. Bezstanowy = łatwe skalowanie, rolling updates bez przestojów.

Ingester: Serce zapisu. Zapis chunków w pamięci (head block - mutowalny) + okresowy flush do S3 (niezmienne chunki). Replikacja (domyślnie 3×, quorum write) = HA i trwałość. Cykl życia chunków: active (pamięć) → flushing (zapis do S3) → flushed (potwierdzony) → completed. Odzyskiwanie po awarii: WAL (write-ahead log) na lokalnym dysku - po restarcie odtwarza niezflushowane chunki. Ingester = stateful, wymaga persistent volume / S3.

Querier / Query Frontend: Querier wykonuje LogQL - pobiera dane z ingesterów (hot, ostatnie ~2-3h) i z S3 (cold, starsze). Query Frontend (opcjonalny, zalecany): podział dużych zapytań na mniejsze równoległe, cache wyników (Redis/memcached), logika retry, deduplikacja zapytań. Parallelizacja zapytań = odpowiedź poniżej sekundy nawet na TB danych. To klucz do wydajności w skali.

Compactor / Ruler: Compactor - uruchamiany okresowo: kompaktacja chunków (łączenie małych w duże, deduplikacja), egzekwowanie retencji (usuwanie starych), downsampling (opcjonalnie). Ruler - ewaluuje reguły alertowe LogQL, wysyła alerty do Alertmanagera. Rozdzielenie odpowiedzialności = prostota operacyjna - każdy komponent robi jedną rzecz dobrze.

Podsumowanie: Architektura mikroserwowa - skalowanie horyzontalne per komponent. Object storage (S3/GCS) = rozdzielony compute/storage, nieskończone skalowanie, płatność za użycie. Skuteczny kosztowo w skali. Tryb single binary (wszystkie komponenty w jednym procesie) dla dev/small scale. Tryb mikroserwowy dla skali produkcyjnej.

W trybie produkcyjnym Loki nie jest pojedynczym procesem, lecz zespołem wyspecjalizowanych mikroserwerów, które można skalować niezależnie. Poznacie ich role, bo bez tej wiedzy trudno zdiagnozować problem z samym systemem logowania. Zwróćcie uwagę, że architektura ta powtarza wzorzec znany z warstwy metryk: rozdzielenie kanału zapisu od kanału odczytu, podział na komponenty bezstanowe i stanowe oraz liczenie oddzielone od przechowywania danych.

Spojrzymy na pięć najważniejszych komponentów. Distributor przyjmuje wpisy i dzięki spójnemu hashowaniu rozsyła je równomiernie do ingesterów, walidując przy okazji etykiety i limity. Ingester buforuje dane w pamięci, zabezpiecza je dziennikiem WAL i okresowo zrzuca na S3, pilnując replikacji z kworum. Zapytania LogQL obsługuje Querier, sięgając do świeżych danych u ingesterów i do starszych w obiektowym przechowywaniu. Compactor scala małe chunki i egzekwuje retencję, a Ruler ocenia reguły alertowe.

Wyjaśnienie skrótów użytych na slajdzie:
WAL – Write-Ahead Log – dziennik zapisu z wyprzedzeniem; Mechanizm transakcyjny chroniący napływające logi w pamięci RAM przed nagłą awarią zasilania.
RAM – Random Access Memory – pamięć operacyjna; Szybka pamięć podręczna modułu ingestera buforująca strumienie przed zrzuceniem na dysk.
SSD – Solid State Drive – dysk półprzewodnikowy; Nośnik pamięci trwałej zapewniający wysoką liczbę operacji we/wy dla lokalnych buforów bazy.
HTTP – Hypertext Transfer Protocol – protokół przesyłania dokumentów hipertekstowych; Protokół wykorzystywany do przesyłania zapytań wyszukiwania i parsowania w klastrze Loki.
gRPC – gRPC Remote Procedure Calls – zdalne wywołanie procedury gRPC; Wysokowydajny protokół RPC oparty na HTTP/2 i Protocol Buffers stosowany do wewnętrznej komunikacji w klastrze.

8/55 Agent Promtail
Promtail: Agent Loki do zbierania logów - nie tylko „wysyła", lecz przetwarza na hoście. Pipeline stages wzbogacają logi o etykiety (regex, JSON, timestamp). Offsety w positions.yaml zapewniają ciągłość po restarcie.

Promtail to nie wysyłacz, lecz procesor na hoście: parsuje, etykietuje i pilnuje ciągłości.

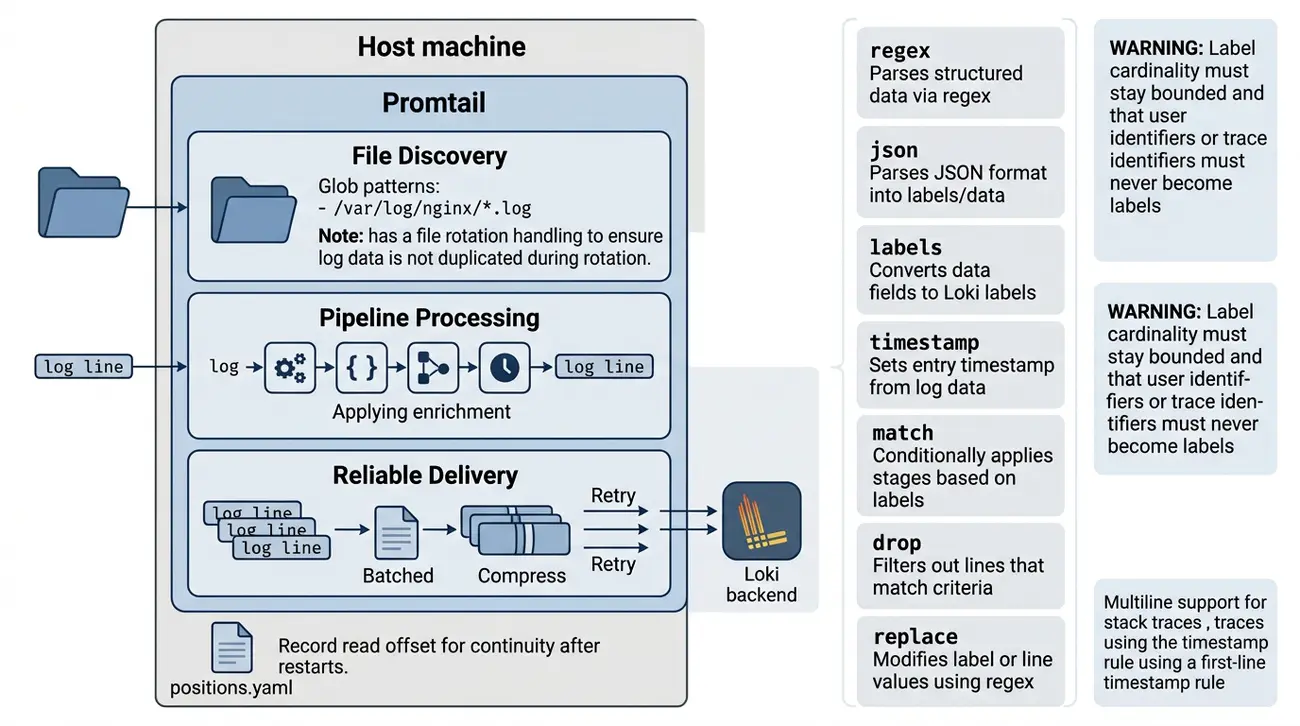
  • Rola Promtaila – jest dedykowanym agentem dla systemu Loki, monitorującym pliki dzienników i wzbogacającym wpisy o metadane przed wysyłką.
  • Mechanizm inotify – agent śledzi zmiany w systemie plików w czasie rzeczywistym i bezproblemowo radzi sobie z cykliczną rotacją plików.
  • Potok przetwarzania – etapy pipeline stages pozwalają na parsowanie formatu JSON, ekstrakcję etykiet oraz odrzucanie niechcianych wierszy.
  • Śledzenie pozycji – plik stanu positions.yaml zapamiętuje dokładny offset w plikach, zapobiegając duplikacji wpisów po restarcie usługi.
  • Obsługa wielu linii – specjalne reguły multiline potrafią połączyć wielowierszowy zrzut stosu błędu aplikacji w jeden czytelny wpis.
Pipeline stages: Etapy przetwarzania logów na hoście (regex, JSON, timestamp) wzbogacające wpisy o etykiety; offsety w positions.yaml zapewniają ciągłość po restarcie.
przepływ Promtail

Do transportu logów wykorzystuje się wyspecjalizowane agenty systemowe, takie jak Promtail, realizujące lokalne buforowanie na wypadek awarii sieci i wzbogacanie metadanych o etykiety.

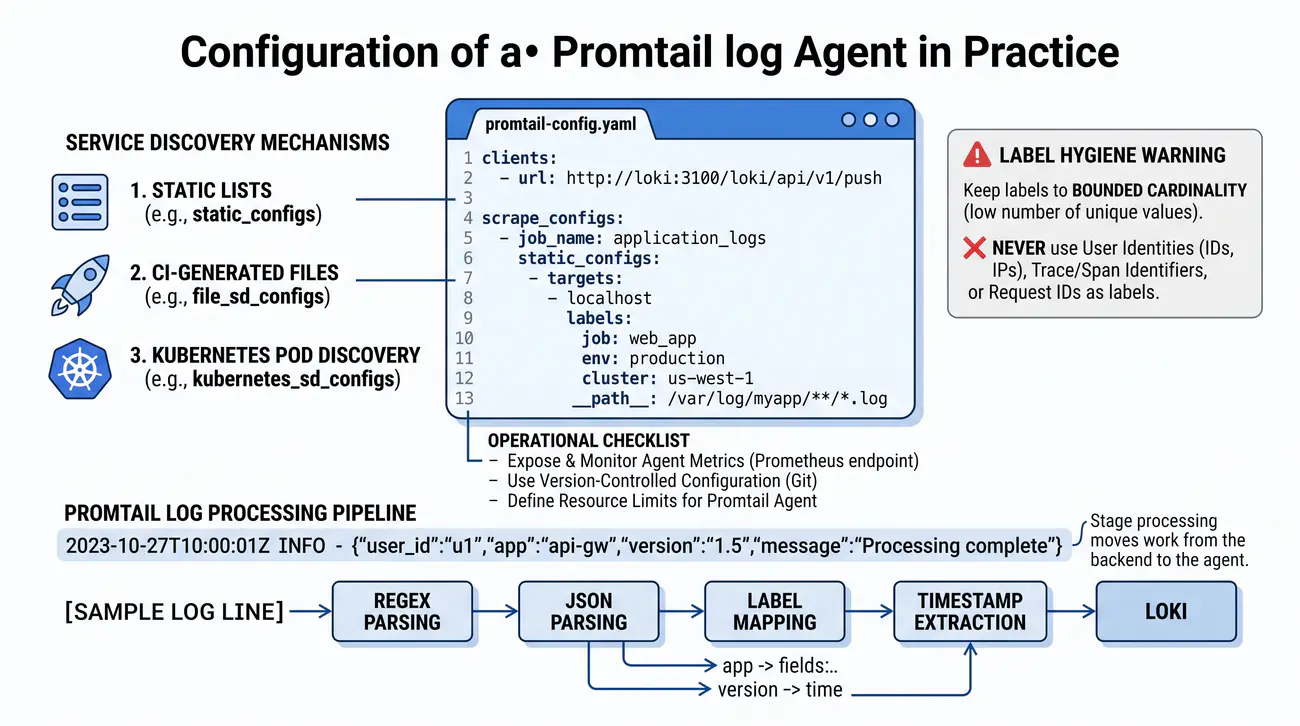
Promtail to procesor logów, nie prosty shipper: działa na hoście/kontenerze, odczytuje pliki logów, wzbogaca je o etykiety i metadane (label enrichment) i wysyła do Loki - przenosi parsowanie i wzbogacanie z backendu na krawędź (przetwarzanie po stronie agenta). Zakres obejmuje wczytywanie plików (file discovery, tailing, obsługa rotacji, multi-line), dodawanie etykiet przez pipeline stages (static_labels, regex, json, labelmap, timestamp, labels, output, match, drop, sampling) oraz wysyłkę do Loki (batching, compression, retries, backpressure, mTLS); stan śledzi plik positions.yaml.

Wczytywanie plików: Wykrywanie plików przez glob patterns (etykieta __path__) - np. /var/log/**/*.log, /var/log/nginx/*.log. Tailing: inotify (Linux, sterowany zdarzeniami) lub polling (fallback), śledzenie offsetów w positions.yaml (trwałe, przetrwałe restarty). Obsługa rotacji: wykrywa rotację (truncation, rename), automatycznie otwiera nowy plik. Wsparcie multi-line: regex firstline (np. znacznik czasu na początku linii), max_wait_time, max_lines - kluczowe dla stack trace'ów Java/Go. Solidność = zero utraty logów nawet przy restarcie agenta lub rotacji logów.

Dodawanie etykiet - pipeline stages (ciąg transformacji): static_labels (statyczne: env, cluster, team), regex (ekstrakcja pól z treści linii przez named capture groups), json (parsowanie logów JSON, auto-ekstrakcja pól), labelmap (mapowanie wartości etykiet na inne etykiety), timestamp (ekstrakcja znacznika czasu z treści linii - kluczowe!), labels (dodanie/nadpisanie etykiet na podstawie wyciągniętych pól), output (finalna treść wpisu), match (warunkowe stosowanie stadiów), drop (odrzucanie wpisów), sampling (próbkowanie probabilistyczne). Label enrichment w agencie = odciążenie Loki, bogatszy kontekst (app, env, version, host, k8s namespace/pod). Higiena etykiet = ograniczona kardynalność! Nigdy nie rób etykiety z user_id, request_id, trace_id - to eksplozja kardynalności.

Wysyłka do Loki: Batching (batch_size domyślnie 1 MB, batch_wait 1s) = przepustowość. Kompresja (snappy default, gzip opcja) = oszczędności sieciowe. Retry z exponential backoff + jitter = niezawodność. Backpressure: limit kolejki (queue_size), polityka drop (block/drop) przy przeciążeniu Loki. mTLS/wzajemne uwierzytelnianie = bezpieczeństwo w sieci. Niezawodność = co najmniej raz (możliwe duplikaty; Loki deduplikuje po timestamp+zestawie etykiet). Promtail musi być monitorowany (własne logi, metryki: promtail_build_info, promtail_config_last_reload_successful).

Podsumowanie: Promtail = przetwarzanie logów po stronie agenta (nie shipper!). Label enrichment = przeszukiwalność. Pipeline stages = potężne transformacje. Niezawodność = gotowość produkcyjna (positions.yaml, WAL-like, retries). Higiena etykiet = wyłącznie ograniczona kardynalność. To klucz do użytecznych logów w Loki.

Loki sam nie zbiera logów - potrzebuje agenta działającego na każdej maszynie i w tym kursie takim agentem będzie Promtail. Potraktujcie go nie jak prosty program wysyłający pliki, lecz jak pełnoprawnego procesora: część pracy nad logami przenosi na krawędź, tam gdzie wpisy powstają. Gdy konfigurowaliście eksporterów dla Promethea, logika przetwarzania mieszkała głównie po stronie serwera; tutaj parsowanie i wzbogacanie odbywa się na hoście i ta zmiana miejsca pracy jest istotną różnicą.

Promtail wykrywa pliki logów wzorcami glob, śledzi ich zmiany przez inotify i zapamiętuje pozycję odczytu w pliku positions.yaml, dzięki czemu po restarcie agenta nie tracimy żadnych wpisów. Kolejne etapy pipeline'u wzbogacają logi o etykiety: wyrażenia regularne, parsowanie JSON, mapowanie pól i ekstrakcja znacznika czasu z treści linii. Wysyłka do Loki działa z pakowaniem, kompresją i ponownymi próbami, gwarantując dostarczenie co najmniej raz. Pilnujecie także higieny etykiet, aby uniknąć eksplozji kardynalności.

Wyjaśnienie skrótów użytych na slajdzie:
OS – Operating System – system operacyjny; Środowisko, z którego Promtail pobiera logi systemowe, kontenery i pliki dziennika.
FHS – Filesystem Hierarchy Standard – standard hierarchii systemu plików; Układ katalogów uniksowych określający standardowe położenie dzienników (/var/log).
API – Application Programming Interface – interfejs programowania aplikacji; Interfejs platformy Kubernetes, z którego Promtail pobiera metadane podów i kontenerów.
HTTP – Hypertext Transfer Protocol – protokół HTTP; Protokół transportowy, przez który Promtail przesyła spakowane partie logów (batches) do Loki.
YAML – YAML Ain't Markup Language – format serializacji YAML; Czytelny format plikowy wykorzystywany do definicji konfiguracji etapów przetwarzania Promtaila.

9/55 Instalacja Loki (Linux, wstęp)
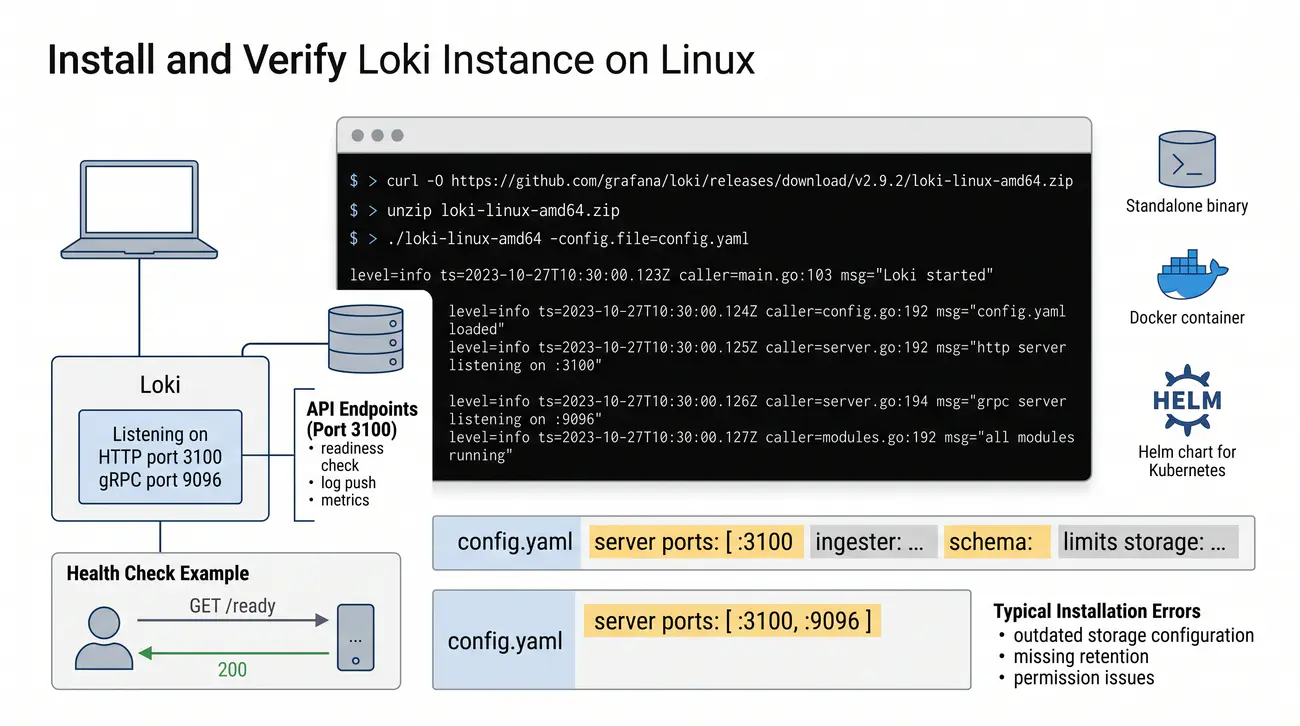
Instalacja Loki: Loki pracuje na porcie 3100 (HTTP API) i 9095 (gRPC). Konfiguracja w YAML definiuje storage, limity i schema. Health check: GET /ready → 200 OK.

Loki startuje jako jeden proces: YAML z configiem, port 3100 i health checkiem /ready.

  • Konfiguracja Promtaila – plik YAML definiuje adres serwera Loki, położenie pliku pozycji oraz listę zadań przeszukiwania katalogów na dysku.
  • Zadania zbierania – sekcja scrape_configs precyzuje ścieżki do logów oraz stałe etykiety, które mają zostać przypisane do strumienia.
  • Filtrowanie wstępne – odrzucenie zbędnych komunikatów na poziomie agenta pozwala zaoszczędzić pasmo sieciowe oraz miejsce w magazynie danych.
  • Uprawnienia systemowe – proces agenta musi posiadać prawa do odczytu plików w katalogu /var/log, na przykład poprzez przynależność do grupy adm.
  • Kontrola kardynalności – należy unikać tworzenia etykiet z wartości dynamicznych, takich jak adresy IP czy identyfikatory sesji klientów.
Port 3100: HTTP API Lokiego (gRPC na 9095); konfiguracja YAML definiuje storage, limity i schemat, a GET /ready zwracający 200 potwierdza życie serwisu.
konsola uruchomienia
CLI · Linux: uruchomienie Loki
user@server:~$ wget https://github.com/grafana/loki/releases/download/v3.7.7/loki-linux-amd64.zip user@server:~$ unzip loki-linux-amd64.zip user@server:~$ ./loki-linux-amd64 -config.file=loki-local-config.yaml level=info msg="server listening on address" addr=:3100 # Loki nasłuchuje na porcie 3100

Instalacja Loki na Linux to pobranie binarki i uruchomienie serwisu - praktyczna wiedza niezbędna do szybkiego wdrożenia PoC lub środowiska deweloperskiego. Uruchomienie możliwe na trzy sposoby (binary, Docker, Helm), konfiguracja to plik YAML z kluczowymi sekcjami, port 3100 pełni rolę API, a zdrowie instancji weryfikuje się przez /ready; znajomość tego unika typowych błędów: złej konfiguracji storage (przestarzały boltdb-shipper zamiast tsdb, filesystem storage), braku retencji i problemów z uprawnieniami.

Plik konfiguracyjny: loki-local-config.yaml - sekcje: auth_enabled (false dev, true prod - wtedy wymagany tenant ID), server (http_listen_port: 3100, grpc_listen_port: 9095), ingester (lifecycler ring, chunk_idle_period: 5m, chunk_block_size: 256KB), schema_config (index: tsdb - standard od Loki 3.x, object_store: filesystem/s3), storage_config (filesystem: directory /tmp/loki, chunk_store_config: max_look_back_period), limits_config (retention_period: 30d, ingestion_rate_mb: 4, per_stream_rate_limit: 3MB). Minimalny config = działający Loki, production = tuning limitów.

Uruchomienie serwera: Binary (./loki-linux-amd64 -config.file=loki-local-config.yaml) - najprostsze, dev/test. Docker (docker run -d -p 3100:3100 -v $(pwd)/config:/etc/loki grafana/loki:3.7.7) - izolacja, łatwe wersjonowanie. Helm (grafana/loki-stack) - production Kubernetes, HA, tryb mikroserwowy. Systemd unit dla production na VM: [Service] ExecStart=/usr/local/bin/loki -config.file=/etc/loki/loki.yaml, Restart=always. Health check: GET /ready (200 OK = gotowy do obsługi), GET /metrics (metryki Prometheus).

Port 3100: HTTP API (zapytania LogQL: /loki/api/v1/query, dostarczanie: /loki/api/v1/push, readiness: /ready, metryki: /metrics), gRPC (port 9095, komunikacja ingesterów, zapytania). Firewall: allow 3100/tcp (HTTP), 9095/tcp (gRPC internal). Reverse proxy (nginx/Traefik/Caddy) dla terminacji TLS, basic auth, rate limiting - NIE wystawiaj gołego Loki do Internetu. Przykłady CLI: wget, unzip, ./loki -config.file=... - zweryfikowane na Ubuntu 22.04/24.04.

Podsumowanie: Config YAML (storage, limits, schema) + binary/Docker/Helm + port 3100/9095 = działający Loki. Health check: /ready. Następne kroki: zapytania LogQL, wdrożenie Promtaila, dashboardy Grafana, tuning retencji.

Dość teorii - zobaczmy, jak uruchomić taki system samodzielnie. Na zajęciach instalujemy Loki na Linuksie, co najlepiej pokazuje, że całość mieści się w jednym procesie, a zaczynamy od prostej konfiguracji lokalnej. Po tym slajdzie będziecie umieli pobrać binarkę, wskazać plik konfiguracyjny i sprawdzić, czy serwis żyje. To wiedza potrzebna jeszcze w tym wykładzie, bo na tej samej instalacji uruchomimy agenta Promtail i wykonamy pierwsze zapytania w LogQL.

Loki nasłuchuje na porcie 3100, pod którym działa jego API HTTP - tam znajdują się wejścia do zapytań LogQL, przyjmowania logów, sprawdzania gotowości i metryk - oraz na porcie gRPC 9095 używanym w komunikacji wewnętrznej. Konfiguracja to plik YAML z sekcjami serwera, ingestera, schematu i limitów, a zainstalować można go trzykrotnie: jako binarkę, kontener Docker lub przez Helm w Kubernetesie. Health check to proste zapytanie GET /ready, które zwraca kod 200, gdy instancja jest gotowa do pracy.

Wyjaśnienie skrótów użytych na slajdzie:
FHS – Filesystem Hierarchy Standard – standard hierarchii plików; Standard definiujący położenie plików konfiguracyjnych (/etc/loki) i danych bazy.
APT – Advanced Package Tool – zaawansowane narzędzie pakietowe; System zarządzania pakietami w dystrybucjach Debian/Ubuntu służący do instalacji oprogramowania Loki.
systemd – systemd system and service manager – menedżer systemu i usług systemd; Podsystem PID 1 Linuksa kontrolujący uruchamianie, restarty i limity zasobów demona Loki.
CLI – Command Line Interface – interfejs wiersza poleceń; Konsola tekstowa administratora wykorzystywana do testowania i weryfikacji poprawności konfiguracji.
POSIX – Portable Operating System Interface – przenośny interfejs systemów operacyjnych; Standard uniksowy gwarantujący zgodność uprawnień i praw dostępu do plików bazy.

10/55 LogQL (podstawy)
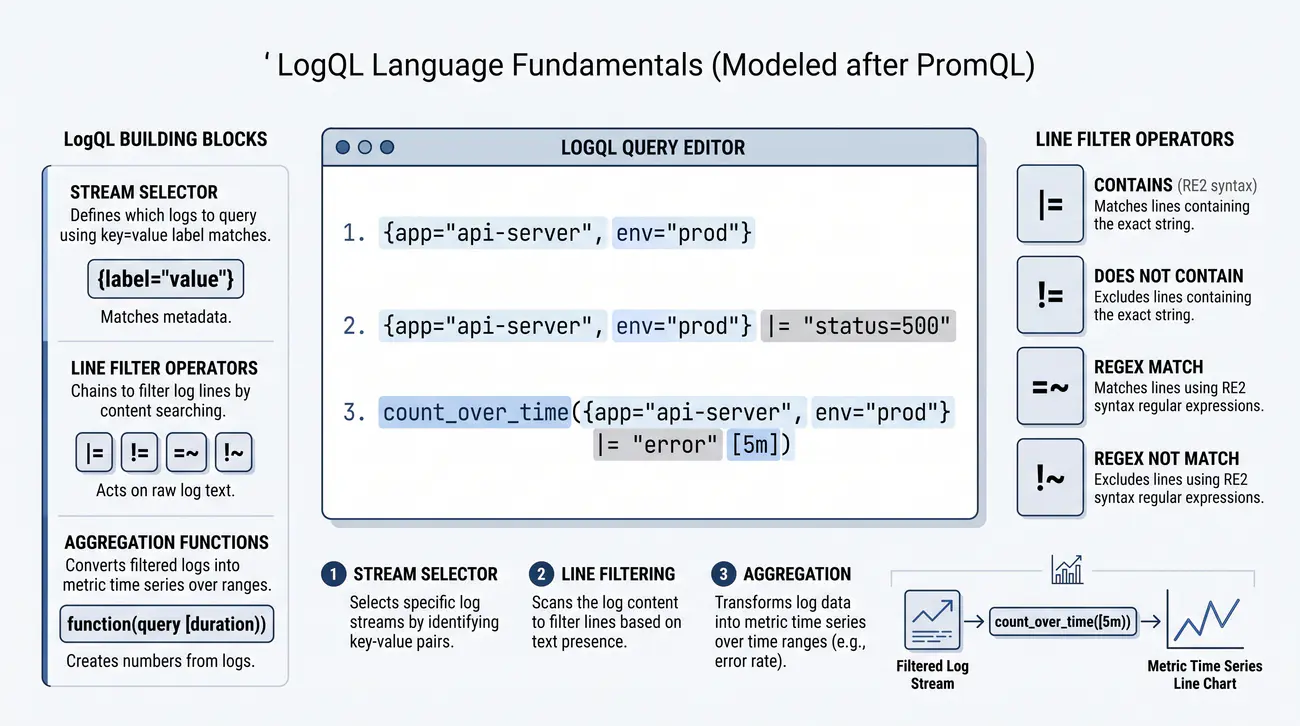
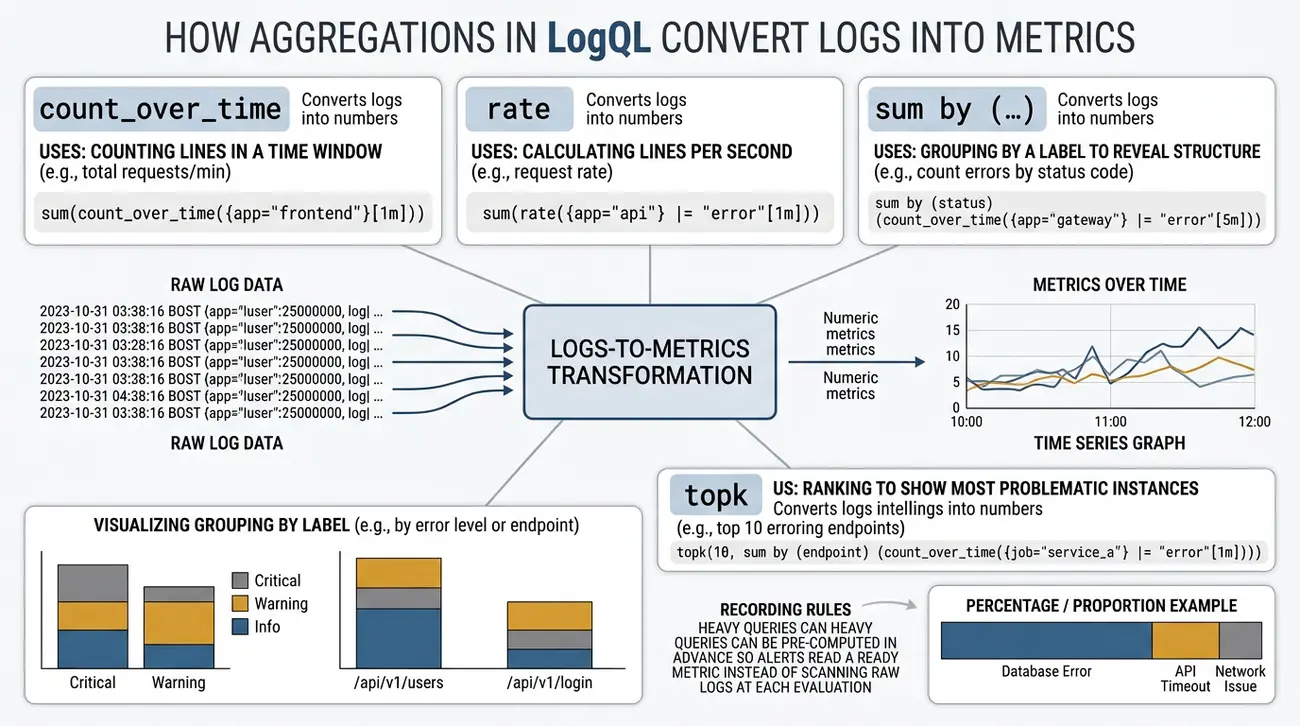
LogQL: Język zapytań Loki, wzorowany na PromQL. Składa się z stream selectora (filtry po etykietach), line filterów (tekst/regex) i agregacji (count_over_time, rate) - zamienia logi na metryki.

Znasz PromQL? LogQL to jego kuzyn: klamry wybierają strumienie, filtry tną linie, agregacje liczą.

  • Składnia LogQL – łączy wygodne selektory etykiet znane z PromQL z potokowym filtrowaniem treści wierszy za pomocą potoków tekstowych.
  • Wybór strumienia – zapytanie rozpoczyna się od wskazania etykiet w nawiasach klamrowych, co natychmiast zawęża obszar przeszukiwania bazy.
  • Filtry wierszy – operatory dopasowania tekstu pozwalają na uwzględnianie lub wykluczanie linii zawierających określone frazy kluczowe.
  • Format potokowy – kolejne filtry rozdziela się znakiem pionowej kreski, stopniowo redukując miliony wierszy do poszukiwanej usterki.
  • Wydajność zapytania – precyzyjne wskazanie etykiet przyspiesza wykonanie analizy, odciążając procesory klastra z przeszukiwania tekstu.
Stream selector: Filtr po etykietach wybierający strumienie w LogQL; dalej filtry linii (tekst/regex) i agregacje (count_over_time, rate) zamieniają logi w metryki.
przykładowe zapytanie
CLI · LogQL: pierwsze zapytanie
# LogQL: wybór logów po etykiecie {app="nginx"} # logi z błędem 500 {app="nginx"} |= "500" # liczba błędów w ostatnich 5 minutach count_over_time({app="nginx"} |~ "error" [5m])

Język LogQL obsługuje nie tylko filtrowanie strumieni, lecz również dynamiczne generowanie metryk telemetrycznych na podstawie treści zdarzeń:

# Obliczenie częstości występowania błędów HTTP 5xx w oknie 5 minut
sum by (service) (rate({namespace="prod"} |= "HTTP/1.1 5" [5m]))

# Kwantyl 99 czasu przetwarzania wyekstrahowany z logów w formacie JSON
quantile_over_time(0.99, {app="billing"} | json | unwrap duration_ms [1h])

Podejście to pozwala wyliczać wskaźniki SLI dla aplikacji bez konieczności ingerencji w ich kod źródłowy.

LogQL to język zapytań Loki zaprojektowany na wzór PromQL, ale dla logów - różnica między znalezieniem błędu w 30 sekund a 30 minut. Składnia opiera się na selektorze strumieni logów (filtruje strumienie po etykietach, jak selektor metryk w PromQL), filtrach linii (|=, !=, |~, !~ - filtrowanie po pobraniu linii), przetwarzaniu wieloetapowym (| json, | regexp, | line_format - transformacje) i funkcjach agregujących (count_over_time, rate, sum, topk - zamiana logów na metryki).

Zapytanie jak w PromQL: Selektor strumienia logów {label="value"} - filtruje strumienie po etykietach (indeks etykiet, szybkie, O(1)). Np. {app="nginx", env="prod", cluster="eu-west-1"}. Matchers etykiet: = (dokładne dopasowanie), != (nie równe), =~ (dopasowanie regex), !~ (negacja regex). To identyczne jak selektory metryk PromQL - jeśli znasz PromQL, znasz 50% LogQL. Selektor strumienia = pierwszy filtr - redukuje ilość danych do przetworzenia.

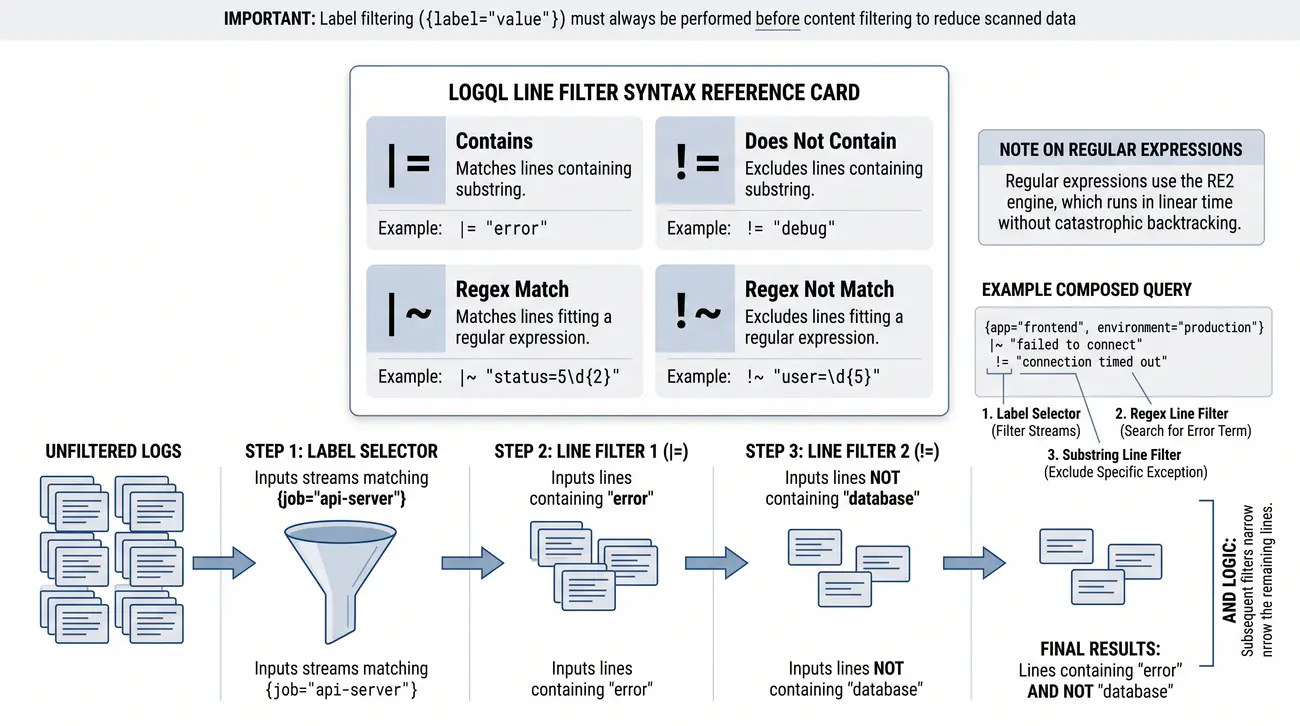
Wyszukiwanie tekstu - filtry linii (po |, na już pobranych liniach): |= "podciąg" (contains, rozróżnia wielkość liter), != "podciąg" (not contains), |~ "regex" (dopasowanie regex, składnia RE2), !~ "regex" (negacja regex). Potok = łańcuch filtrów: {app="nginx"} |= "error" | json | line_format "{{.message}}". Łańcuch = logika AND (kolejne filtry zawężają wyniki). Kolejność ma znaczenie: najpierw filtr etykiet (szybkie), potem filtr tekstowy (wolniejsze). Potok jest komponowalny - potężne przetwarzanie logów.

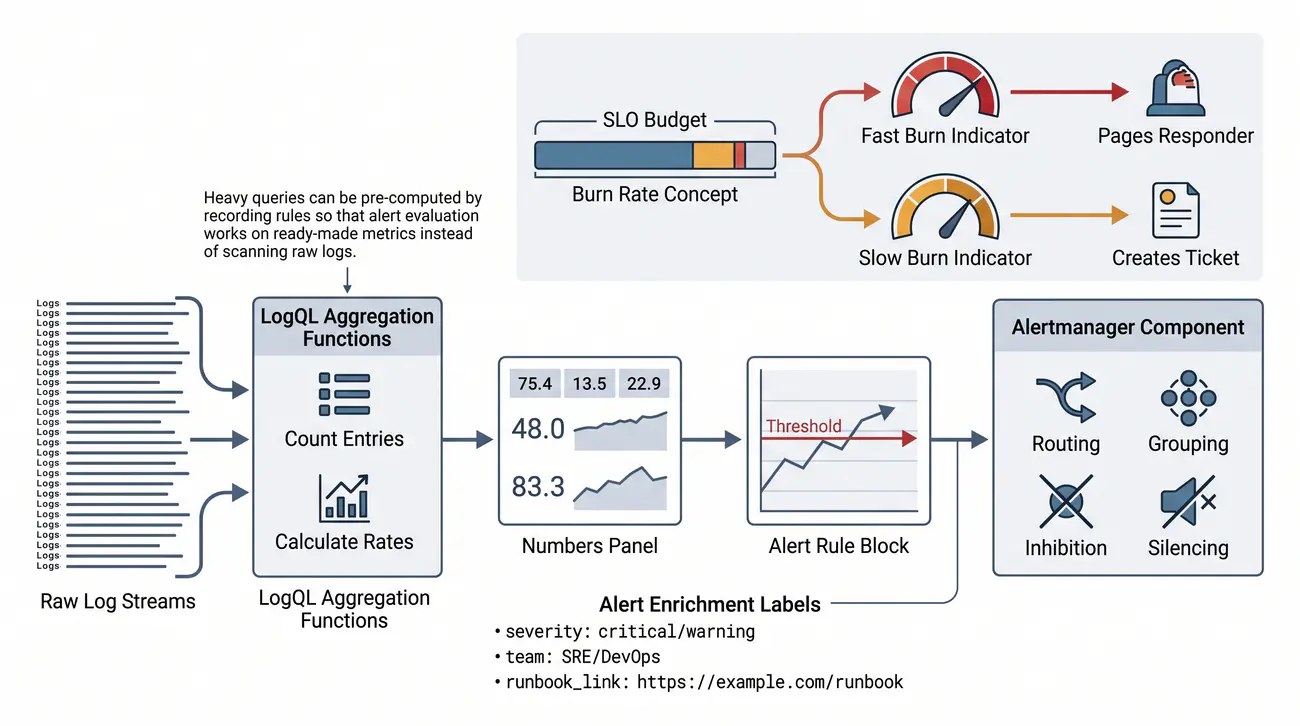
Funkcje agregujące - "metryki z logów": count_over_time([5m]) - liczba linii w oknie czasowym (counter), rate([5m]) - linie na sekundę, sum by (label) - agregacja po etykiecie (analiza wymiarowa), quantile_over_time(0.95, [5m]) - percentyl (latencja p95 z logów). To odpowiedniki PromQL: count, rate, sum, histogram_quantile. LogQL = metryki z logów! Reguły nagrywające: pre-compute ciężkich LogQL → alert na regule nagrywającej = wydajność.

Podsumowanie: LogQL = selektor etykiet (szybkie) + filtry linii (precyzja) + potok (transformacja) + agregacja (metryki). Składnia promqlowa = łatwa nauka dla znawców PromQL. Potęga = potok filtrów. Opanuj LogQL = opanuj analizę logów = MTTR w minutach.

Dobra wiadomość dla tych, którzy pracowali z Prometheusem i językiem PromQL: składnia LogQL wyda się wam znajoma, bo została zaprojektowana właśnie na jego wzór. Mamy tu selektor etykiet ograniczający zbiór strumieni, operatory dopasowania i potok przekształceń, a na końcu funkcje agregujące, które zamieniają strumienie logów w metryki. Jeśli przy metrykach budowaliście zapytania w Grafanie, okazało się, że korzystaliście z podobnych konstrukcji; teraz uczymy się eksploatować surowe dane tekstowe w ten sam sposób.

Zapytanie najczęściej zaczyna się od selektora ujętego w klamry, na przykład {app="nginx"}, który dzięki indeksowi etykiet za jednym zamachem redukuje dane do wybranego strumienia. Dalej dochodzą filtry linii: operator |= szuka podciągu tekstu, |~ dopasowuje wyrażenie regularne w notacji RE2, a wersje z wykrzyknikiem negują wynik. Na końcu stawiamy agregacje, takie jak count_over_time czy rate w oknie czasowym, obliczając w ten sposób liczbę błędów w ostatnich pięciu minutach i zamieniając logi na serie metryczne.

Wyjaśnienie skrótów użytych na slajdzie:
LogQL – Log Query Language – język zapytań LogQL; Funkcyjny język zapytań platformy Loki pozwalający na precyzyjne odpytywanie strumieni tekstowych.
PromQL – Prometheus Query Language – język zapytań Prometheus; Język pokrewny, którego logika filtrów etykiet ({app='web'}) jest identyczna w LogQL.
Regex – Regular Expression – wyrażenie regularne; Wzorzec tekstowy dopasowywany za pomocą operatorów |~ oraz !~ w wierszach logów.
JSON – JavaScript Object Notation – format JSON; Format obsługiwany przez etap parsowania '| json', automatycznie tworzący zmienne z pól obiektu.
API – Application Programming Interface – interfejs programowania aplikacji; Punkt końcowy /loki/api/v1/query_range obsługujący zapytania LogQL.

11/55 Wprowadzenie do ELK Stack
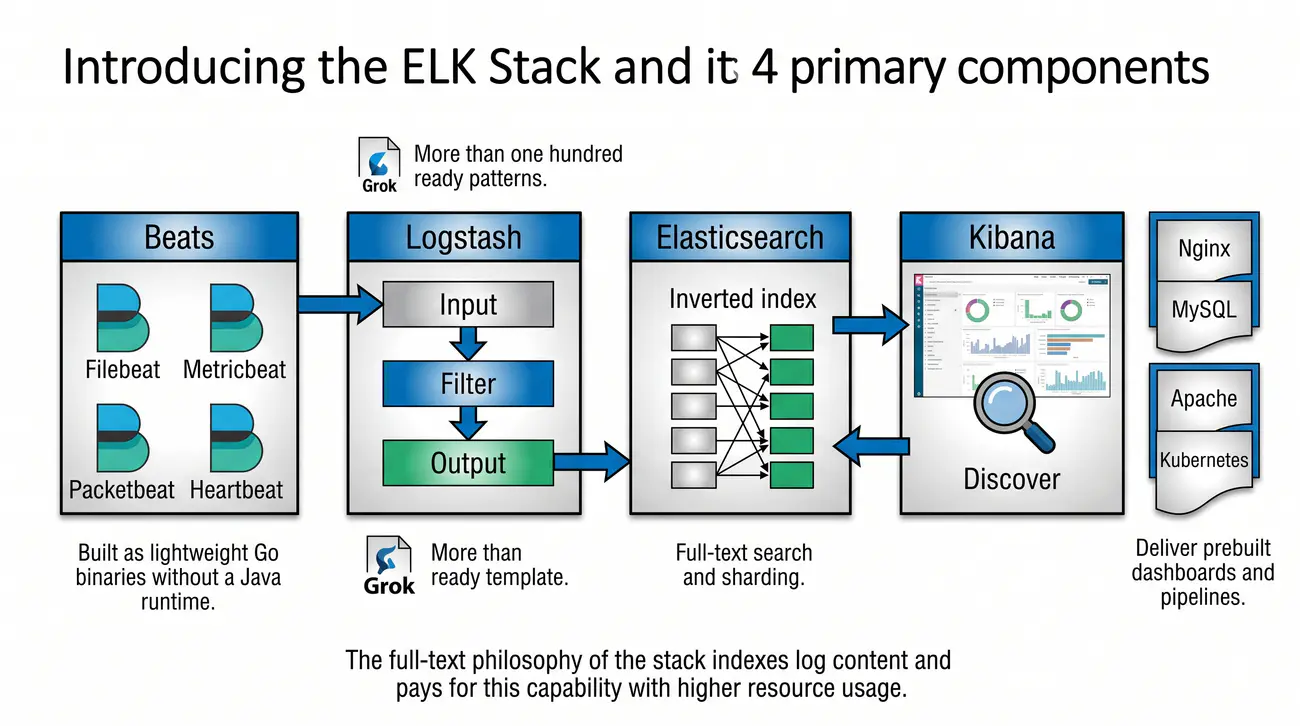
ELK Stack: Cztery komponenty: Elasticsearch (silnik wyszukiwania/indeksowania), Logstash (pipeline przetwarzania), Kibana (wizualizacja/dashboards), Beats (lekkie kolektory danych). Rozwiązanie enterprise z pełnotekstowym wyszukiwaniem.

ELK to dojrzały enterprise: pełny tekst, setki funkcji i JVM w cenie. Dopiero obok Lokiego widać kompromisy.

  • Architektura ELK – uznany stos analityczny składający się z silnika Elasticsearch, narzędzia Logstash oraz wizualnego interfejsu Kibana.
  • Lekkie agenty Beats – rodzina dedykowanych programów w języku Go, które gromadzą logi i metryki z maszyn i przesyłają je do bazy.
  • Wyszukiwanie pełnotekstowe – Elasticsearch buduje indeks odwrócony, co zapewnia błyskawiczne odnajdywanie dowolnych słów w terabajtach danych.
  • Transformacja w Logstashu – rozbudowane filtry potrafią normalizować dane, wzbogacać wpisy o geolokalizację i usuwać poufne atrybuty.
  • Analityka w Kibanic – środowisko oferuje zaawansowane możliwości wizualizacji, budowy pulpitów oraz narzędzia uczenia maszynowego.
Beats: Lekkie kolektory danych w ELK Stack (obok Elasticsearch do indeksowania, Logstasha do przetwarzania i Kibany do wizualizacji); rozwiązanie enterprise z pełnotekstowym wyszukiwaniem.
ELK stack
Podstawy składni LogQL: Składnia LogQL składa się z dwóch głównych części. Pierwsza to selektor strumienia w nawiasach klamrowych, np. {app="frontend", env="prod"}, który szybko odnajduje odpowiednie strumienie logów dzięki etykietom. Druga część to potok filtrów rozdzielanych znakiem potoku |, np. |= "error" | json | status_code >= 500, który przetwarza wiersze w locie w pamięci bez konieczności ich uprzedniego indeksowania.

ELK Stack to dojrzałe, bogate w funkcje rozwiązanie enterprise do logowania i analityki o czterech komponentach: Elasticsearch (rozproszony silnik wyszukiwania i analityki), Logstash (potok przetwarzania danych), Kibana (wizualizacja i dashboardy) i Beats (lekkie narzędzia do wysyłki danych). To fundament budowania stacku logowania w skali enterprise, gdzie wymagane są pełnotekstowe wyszukiwanie, zaawansowana analityka, SIEM i uczenie maszynowe (inverted index, pipeline, shipper).

Elasticsearch: Rozproszony silnik wyszukiwania i analityki. Inverted index (pełnotekstowe wyszukiwanie, wyszukiwanie terminów O(1)), dokumentowo zorientowany (JSON), REST API, skalowanie horyzontalne (shards, repliki), wyszukiwanie w niemal czasie rzeczywistym (odświeżanie 1s). Zastosowania: analityka logów, wyszukiwanie pełnotekstowe, analityka bezpieczeństwa (SIEM), APM. Architektura klastra: master nodes (stan klastra), data nodes (shards), coordinating nodes (routing zapytań), ingest nodes (przetwarzanie wstępne). Oparty na JVM = wymaga tuningu heap, GC.

Logstash: Potok przetwarzania danych (inputs → filters → outputs). Inputs: beats, syslog, tcp, http, file, kafka, jdbc. Filters: grok (parsowanie regex - 120+ wzorców), mutate (transformacje pól), date (parsowanie timestampów), geoip, dns, json, kv, split. Outputs: Elasticsearch, stdout, file, kafka, pagerduty. Pipeline = input → filter → output. Wtyczki = rozszerzalność (200+ wtyczek). JRuby = wymagający pamięci, wolniejszy niż agenty w Go.

Kibana: UI wizualizacji i dashboardów. Discover (wyszukiwanie ad-hoc, składnia Lucene), Visualize (wykresy, mapy, tabele, Vega), Dashboard (złożone panele), Canvas (raporty pixel-perfect), Lens (interfejs drag-drop), Maps (przestrzenne). Alerting (threshold, anomaly, ML), Reporting (eksport PDF/CSV), Spaces (multi-tenancy). UI dla analityków, menedżerów i zespołów security. Ekosystem wtyczek (Security, Observability, Maps).

Beats: Lekkie shippery (Go, pojedyncza binarka, bez JVM). Filebeat (pliki logów, multi-line, moduły), Metricbeat (metryki systemu/usług), Packetbeat (protokoły sieciowe), Heartbeat (monitorowanie dostępności), Auditbeat (audyt Linuksa), Functionbeat (serverless). Moduły (nginx, mysql, apache, kubernetes) = gotowe dashboardy, pipeline'y i szablony indeksów. Lekkie = przyjazne dla edge/IoT, wzór sidecar w Kubernetes.

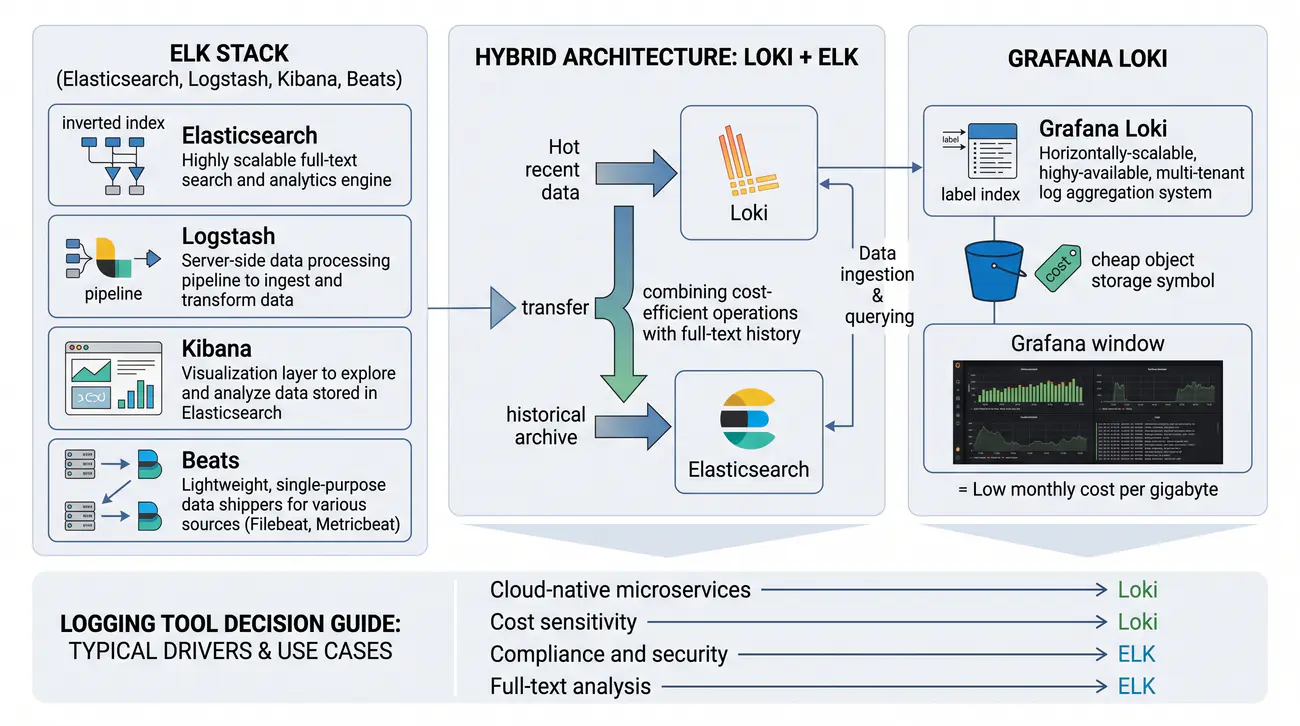
Podsumowanie: ELK = dojrzały (10+ lat), bogaty w funkcje (full-text, ML, SIEM, APM), zasobożerny (JVM, RAM, CPU, dysk), skomplikowany operacyjnie. Loki = lekki, oparty na etykietach, natywny dla Grafany, skuteczny kosztowo. Wybór = skala vs funkcje vs koszt vs wiedza zespołu. Hybryda = Loki (recent/hot) + Elasticsearch (cold/archive) = najlepsze z obu światów.

Drugim wielkim podejściem do logowania w produkcji jest ELK Stack, dojrzałe rozwiązanie klasy enterprise. Warto je poznać nie tylko po to, by umieć się nim posługiwać, lecz także dlatego, że dopiero zestawienie z Lokim ostro rysuje kompromisy całej dziedziny. ELK reprezentuje filozofię wyszukiwania pełnotekstowego: skoro treść logu jest najcenniejsza, to właśnie ją indeksujemy i przeszukujemy w dowolny sposób, płacąc za tę swobodę większymi zasobami obliczeniowymi.

Stack składa się z czterech komponentów. Elasticsearch to rozproszony silnik wyszukiwania z indeksem odwróconym i interfejsem REST; Logstash to potok przetwarzania o układzie wejście-filtry-wyjście, w którym wzorce Grok z setką gotowych szablonów rozbierają dowolny tekst; Kibana daje interfejs grafika, wyszukiwarkę, wizualizacje oraz funkcje alertingu i uczenia maszynowego; wreszcie lekkie Beats, czyli Filebeat, Metricbeat i Packetbeat, odpowiadają za wysyłkę danych z hostów. Uzupełniają je gotowe moduły dla popularnych usług.

Wyjaśnienie skrótów użytych na slajdzie:
ELK – Elasticsearch, Logstash, Kibana – stos technologiczny ELK; Klasyczny pakiet oprogramowania do centralnego zarządzania i przeszukiwania logów.
Lucene – Apache Lucene – silnik indeksowania Apache Lucene; Biblioteka wyszukiwania pełnotekstowego leżąca u podstaw działania bazy Elasticsearch.
JVM – Java Virtual Machine – maszyna wirtualna Java; Środowisko uruchomieniowe silników Elasticsearch i Logstash wymagające starannej optymalizacji pamięci heap.
REST – Representational State Transfer – architektura interfejsu REST; Styl architektury API wykorzystywany przez Elasticsearch do indeksowania i wyszukiwania dokumentów.
JSON – JavaScript Object Notation – notacja obiektowa JavaScript; Podstawowy format dokumentów indeksowanych w węzłach klastra Elasticsearch.
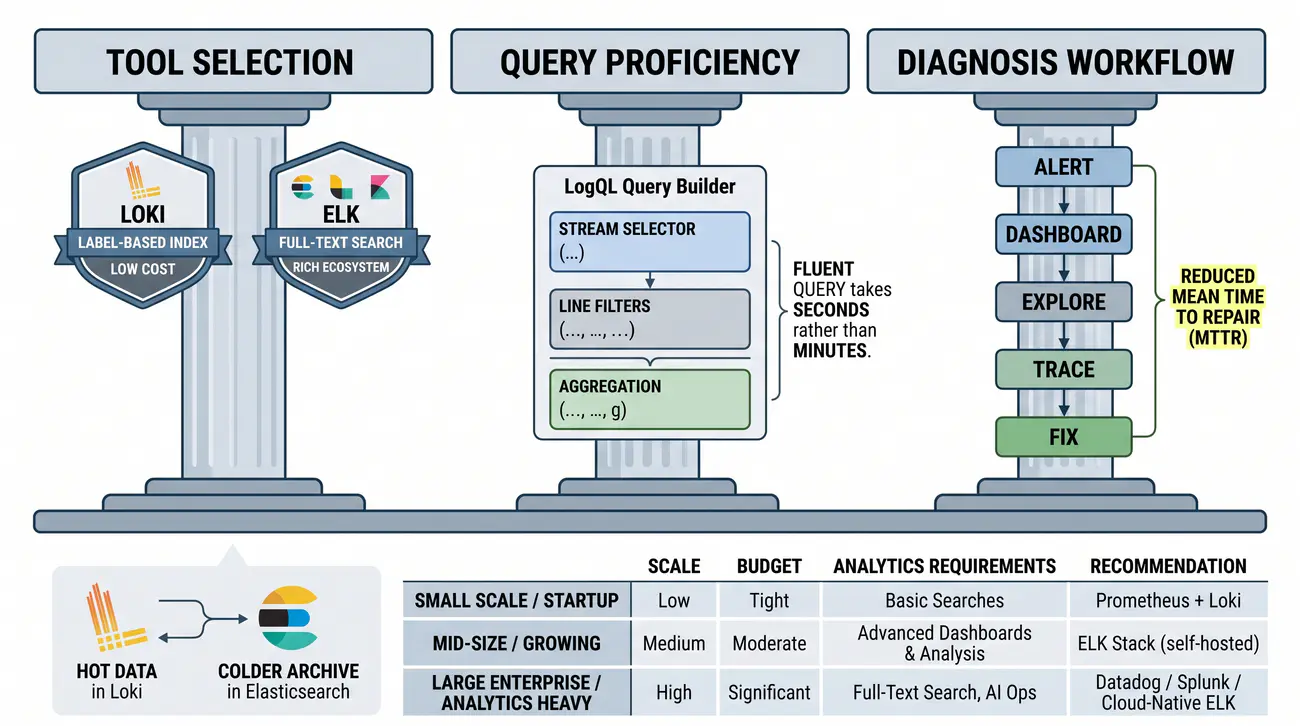
12/55 ELK vs Loki
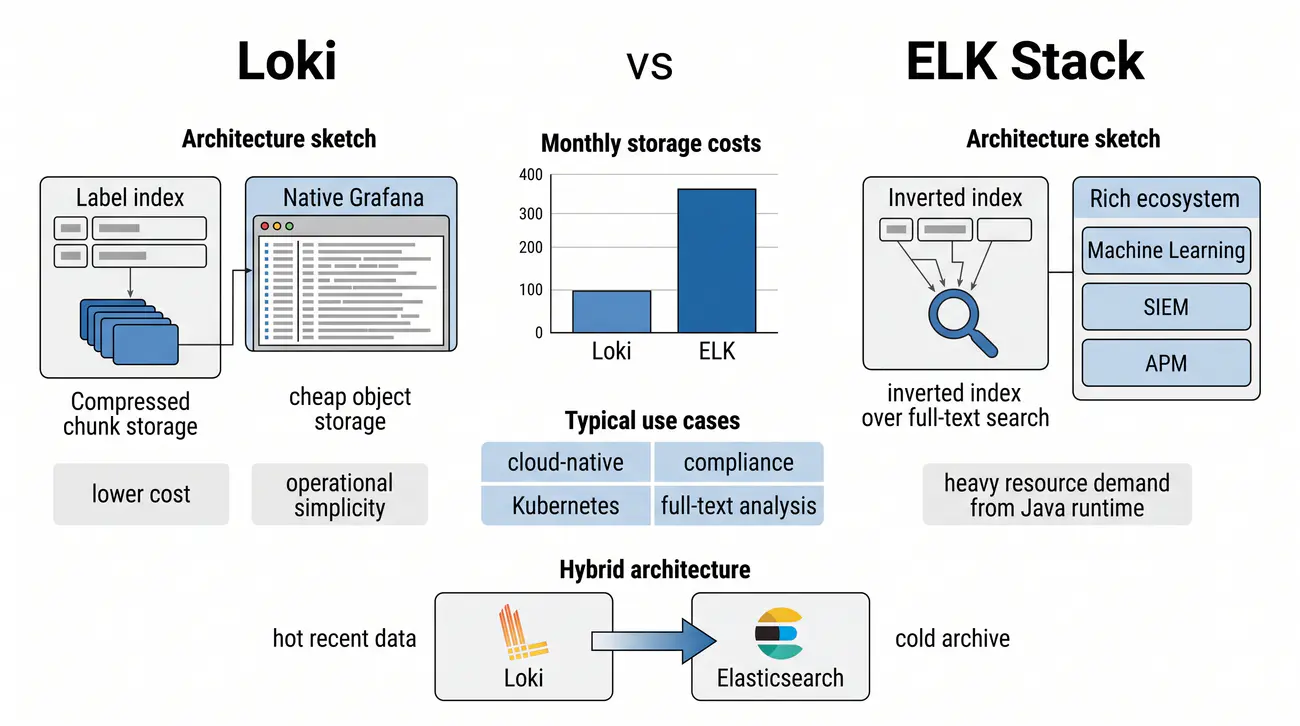
Loki vs ELK: Porównanie dwóch filozofii: Loki - label-based, tanie object storage, prostota operacyjna, Grafana-native. ELK - inverted index, full-text search, bogaty ekosystem (ML, SIEM), ale resource-heavy (JVM, RAM). Wybór = use case.

Loki czy ELK? To nie konkurs piękności, lecz TCO i przypadek użycia. Da się też połączyć oba.

  • Indeksowanie a koszty – Loki indeksuje jedynie etykiety, oferując niższe koszty, podczas gdy ELK indeksuje pełny tekst kosztem pamięci RAM.
  • Wydajność zapytań – wyszukiwanie rzadkich fraz w całej historii wykonuje się szybciej w Elasticsearch dzięki gotowym indeksom słów.
  • Złożoność operacyjna – zarządzanie klastrem Loki jest prostsze, podczas gdy duży klaster ELK wymaga stałego strojenia maszyny wirtualnej Java.
  • Środowisko chmurowe – Loki jest zoptymalizowany pod kątem platformy Kubernetes i magazynów obiektowych, stanowiąc standard w świecie SRE.
  • Model hybrydowy – organizacje często łączą oba narzędzia, wykorzystując Loki do bieżącej diagnostyki, a ELK do audytu i cyberbezpieczeństwa.
Inverted index: Odwrócony indeks pełnotekstowy ELK (droższy, JVM, bogaty ekosystem ML/SIEM) kontra indeks etykiet Lokiego (tani, prosty); wybór zależy od przypadku użycia.
tabela porównawcza

Porównanie architektur ELK i Loki wykazuje kompromis między szybkością zapytań pełnotekstowych a kosztem składowania i pamięci RAM.

ELK i Loki to dwa fundamentalnie różne podejścia do logowania - pytanie brzmi które do czego, nie które lepsze. Loki: indeksowanie oparte na etykietach, niższe koszty (object storage), prostota operacyjna i natywna integracja z Grafaną; ELK: pełnotekstowe wyszukiwanie (inverted index), bogatsze analizy i dojrzały ekosystem (Security, APM, ML), ale zasobożerny i skomplikowany operacyjnie. Wybór zależy od skali, budżetu, doświadczenia zespołu i przypadku użycia (TCO, full-text vs label search).

Loki - oparty na etykietach, niższe koszty: Indeksowanie oparte na etykietach = indeksowane są wyłącznie etykiety (metadane), a nie treść logów. Object storage (S3/GCS/Azure Blob) = tanie, skalowalne, rozdzielone compute od storage. Koszt ~10-100× niższy vs Elasticsearch (brak JVM, brak inverted index, brak repliki shardów). Idealne dla: cloud-native, mikrousług, Kubernetes, zespołów wrażliwych na koszty, użytkowników stacku Grafana. Kompromis: brak natywnego wyszukiwania pełnotekstowego (regex w filtrze linii).

ELK - bogatsze analizy: Pełnotekstowe wyszukiwanie (inverted index) = dowolne wyszukiwanie w treści, fuzzy search, wildcard, proximity. Bogaty DSL zapytań (Lucene, skrypty Painless, SQL). Dojrzały ekosystem: Security (SIEM), APM, Machine Learning (wykrywanie anomalii), Canvas (raportowanie). Koszt: RAM (heap 30GB+ dla data nodes), CPU, szybki dysk, narzut operacyjny (zarządzanie shardami, rebalancing, upgrade). Idealne dla: compliance, SIEM, złożonej analizy tekstu, starszych aplikacji, zespołów security potrzebujących full-text.

Loki - prostota i integracja z Grafaną: Single binary (Loki) + single binary (Promtail) = minimalny narzut operacyjny. Natywnie z Grafaną: Explore, dashboardy, alerty, zunifikowane metryki+logi+tracing (Tempo) w jednym UI. Niski narzut operacyjny - nie trzeba zarządzać JVM, shardami, replikacją. Loki = "Prometheus dla logów" - podobna filozofia, podobne API, podobne narzędzia. Idealne dla zespołów już używających Prometheus+Grafana.

Wybór zależny od potrzeb: Loki = cloud-native, mikrousługi, Kubernetes, wrażliwość na koszty, stack Grafana, zespół zna PromQL. ELK = compliance (SOX, HIPAA, PCI), SIEM, złożona analiza pełnotekstowa, starsze aplikacje, zespół security wymaga funkcji Elastic, zespół zna Lucene/DSL. Hybryda = Loki (recent/hot, 7-30d) + Elasticsearch (cold/archive, 1-7 lat) = najlepsze z obu światów. Nie ma srebrnej kuli - dopasuj narzędzie do przypadku, zespołu i budżetu.

Terminologia: full-text search (wyszukiwanie pełnotekstowe), label search (wyszukiwanie po etykietach), inverted index vs label index, TCO (Total Cost of Ownership). Znaj swoje narzędzia = wybieraj świadomie. Matryca decyzyjna = sterowana przypadkiem użycia.

Na poprzednim wykładzie poznaliśmy Prometheus i Grafanę - narzędzia doskonale radzące sobie z metrykami. Dziś przechodzimy do drugiego filaru obserwowalności, czyli logów, i zanim zagłębimy się w konkretne narzędzia, warto ustalić, jak podchodzić do wyboru stosu do ich agregacji. Rynek oferuje dwa dominujące rozwiązania reprezentujące odmienne filozofie projektowe: jedno stawia na prostotę i niski koszt, drugie na bogactwo funkcji analitycznych.

Porównanie nie sprowadza się do pytania, które rozwiązanie jest lepsze, lecz do konkretnej sytuacji operacyjnej. Loki indeksuje wyłącznie etykiety i przechowuje surowy tekst w tanim obiektowym magazynie, co daje koszty nawet sto razy niższe niż ELK. ELK oferuje pełnotekstowe wyszukiwanie na odwróconym indeksie i dojrzały ekosystem Security, APM i uczenia maszynowego, ale wymaga zasobów i obsługi JVM. Możliwa jest też architektura hybrydowa - Loki dla danych gorących, Elasticsearch jako chłodne archiwum.

Wyjaśnienie skrótów użytych na slajdzie:
RAM – Random Access Memory – pamięć operacyjna; Kluczowy zasób serwerowy, którego zużycie w Loki jest wielokrotnie niższe niż w Elasticsearch.
CPU – Central Processing Unit – procesor; Zasób intensywnie wykorzystywany przez Loki w trakcie wykonywania skomplikowanych zapytań skanujących.
IOPS – Input/Output Operations Per Second – liczba operacji wejścia/wyjścia na sekundę; Wskaźnik obciążenia dyskowego minimalizowany przez buforowanie strumieni w blokach.
TCO – Total Cost of Ownership – całkowity koszt posiadania; Łączny koszt zakupu, licencji, zasobów chmurowych i utrzymania infrastruktury logów.
S3 – Simple Storage Service – obiektowa pamięć masowa; Ekonomiczne repozytorium chmurowe eliminujące konieczność stosowania drogich macierzy SSD.

13/55 Diagnostyka awarii przez logi
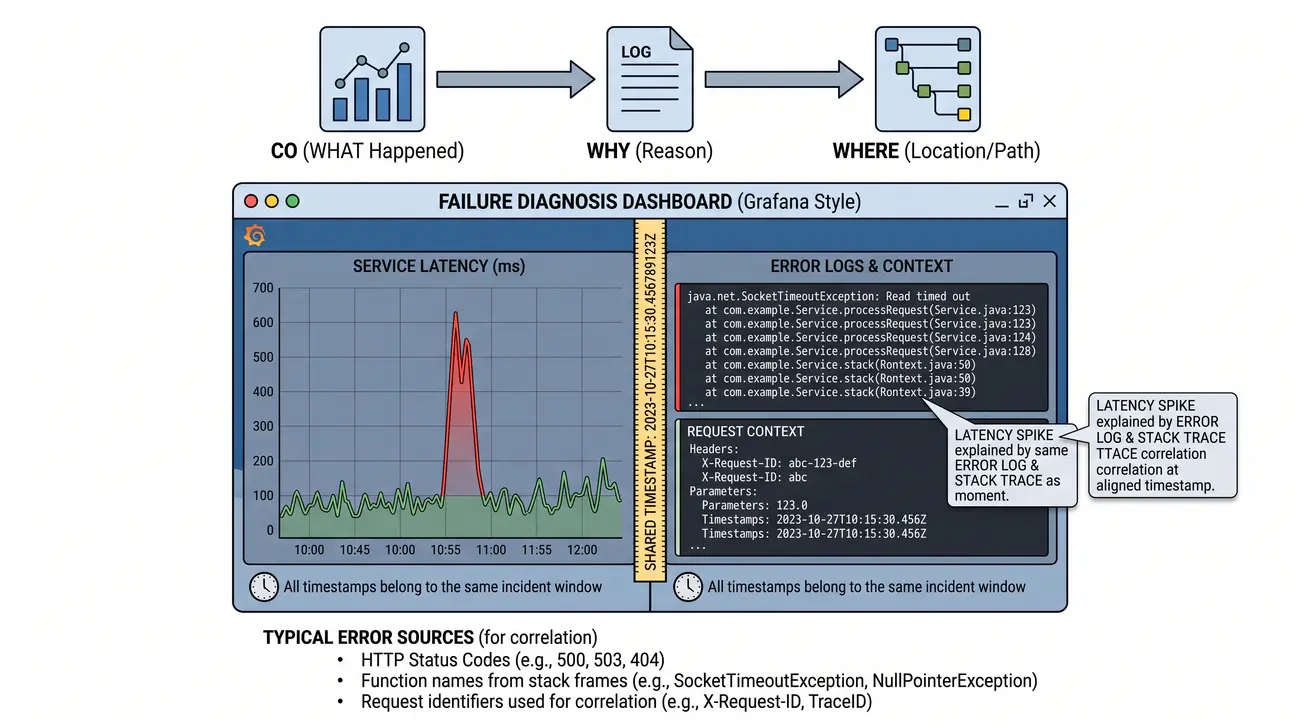
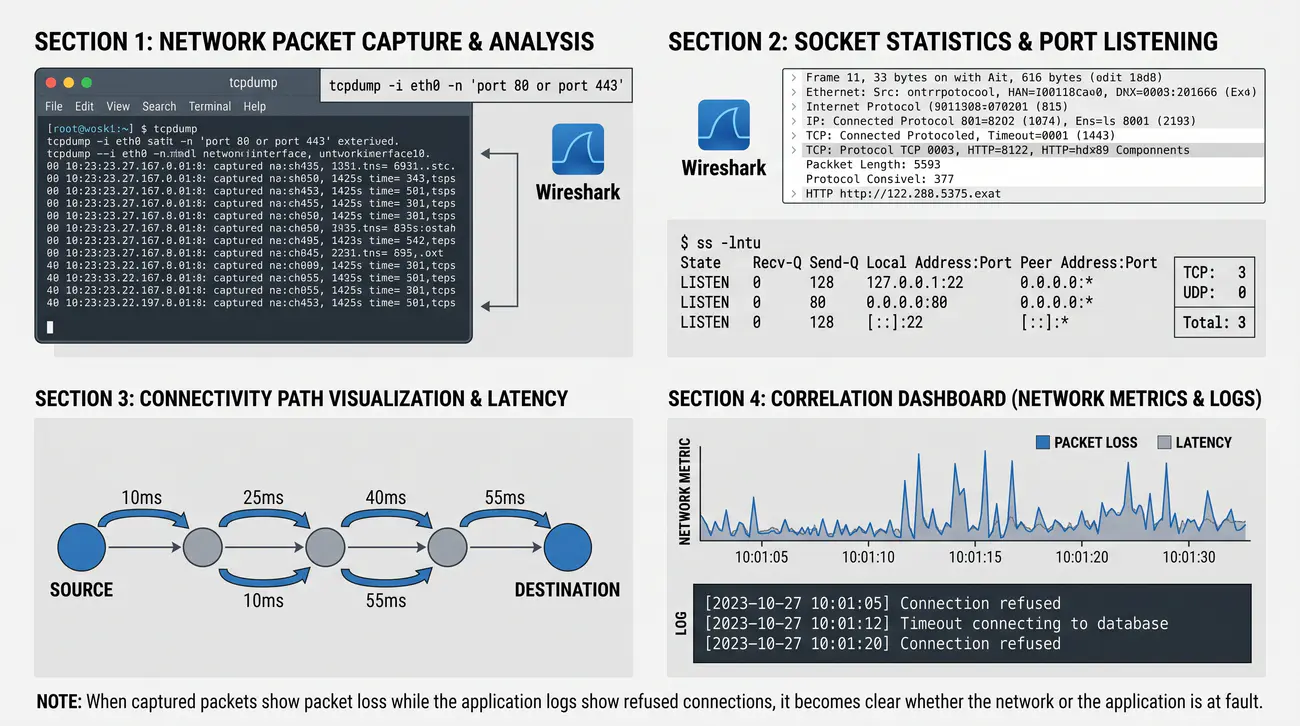
Diagnostyka przez logi: Metryki wskazują co się dzieje (np. skok opóźnień), natomiast logi wyjaśniają dlaczego (zrzut stosu, treść błędu). Workflow: metryka → logi → trace - time-range alignment kluczowe dla korelacji.

Diagnoza to łańcuch: zawęź czas, przeczytaj błędy, skoreluj z metrykami. Nanosecond timestamp spina wszystko.

  • Kolejność diagnostyki – inżynier najpierw bada wykresy metryk w celu wykrycia anomalii, a następnie analizuje logi z tego samego przedziału czasu.
  • Zawężanie zakresu – skuteczne przeszukiwanie polega na odfiltrowaniu komunikatów o poziomie ERROR oraz powiązaniu ich z nazwą mikroserwisu.
  • Identyfikator żądania – unikalny correlation ID pozwala wyizolować całą ścieżkę zapytania przechodzącego przez dziesiątki zależnych usług.
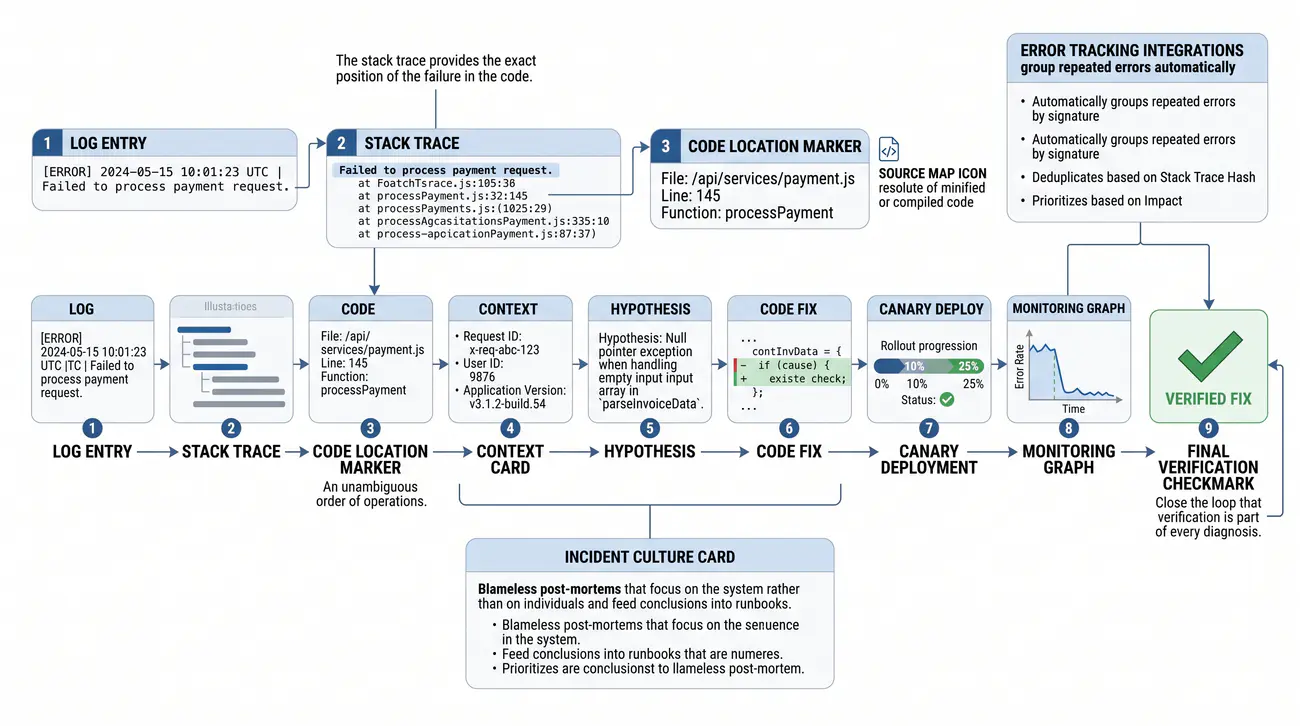
  • Zrzuty stosu wyjątków – dokładna analiza treści błędu w logu pozwala programistom zidentyfikować wadliwą linię w kodzie źródłowym aplikacji.
  • Weryfikacja zmian – sprawdzenie historii ostatnich wdrożeń ułatwia potwierdzenie hipotezy, czy awaria wynika z nowo opublikowanego wydania.
Time-range alignment: Wyrównanie zakresów czasu metryk, logów i trace’ów; warunek korelacji w workflow metryka → logi → trace.
logi i wykres

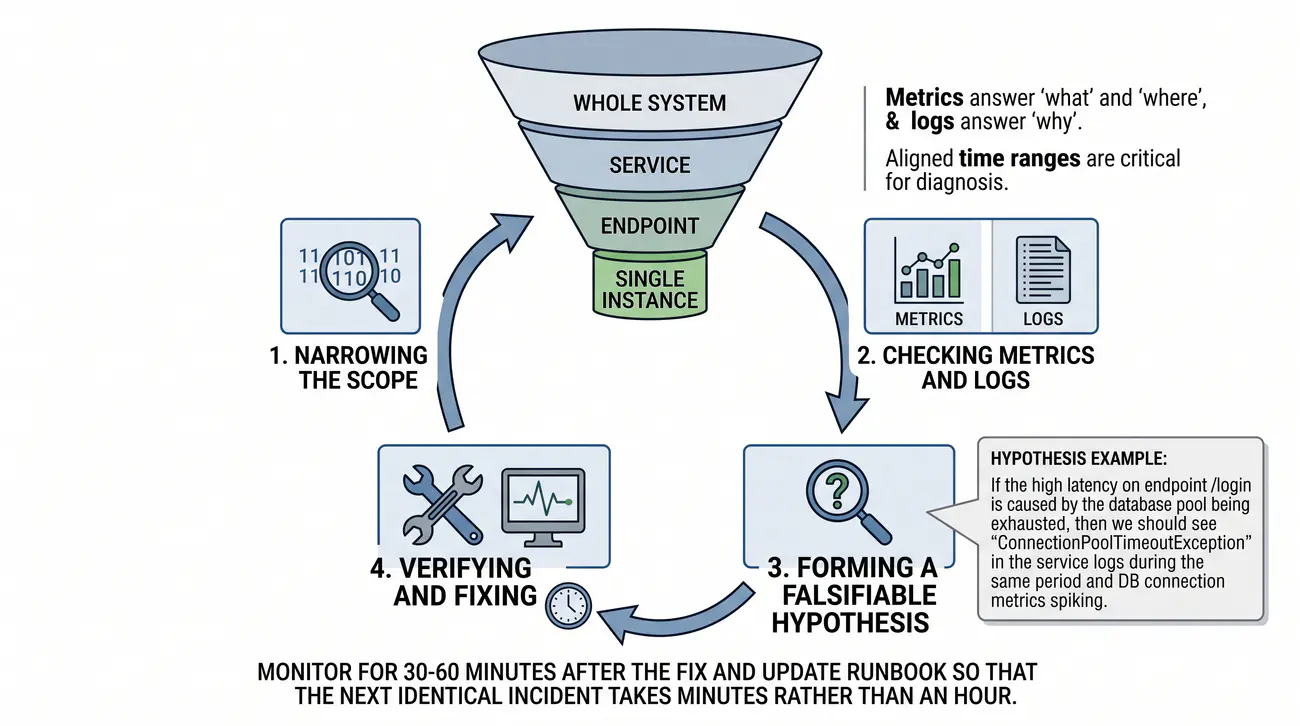
Metryki informują, co się dzieje (skok opóźnień, wzrost wskaźnika błędów), natomiast logi wyjaśniają, dlaczego (zrzut stosu, komunikat błędu, kontekst transakcji) – zrozumienie tej zależności stanowi fundament metodycznej diagnostyki w inżynierii niezawodności. Diagnostyka przez logi opiera się na uporządkowanym przepływie pracy: zawężeniu zakresu czasowego, analizie komunikatów błędów oraz korelacji telemetrii: metryka wskazuje co, logi wyjaśniają dlaczego, a ślad rozproszony (trace) precyzuje gdzie wystąpiła usterka. Podejście to skraca czas wykrycia (MTTD) i naprawy (MTTR).

Wyszukiwanie po czasie: Selektor zakresu czasowego (względny: 1h, 6h, 24h, 7d) + przesunięcie czasu (offset 1h, 1w, 1d) - kluczowe dla porównania "teraz" vs "baza". LogQL: {app="api"} [5m] offset 1h - logi sprzed godziny. Baza (ostatnie 7 dni, ten sam dzień tygodnia, ta sama godzina) vs teraz → wykrywanie odchyleń. Korelacja szeregi czasowe = szybkie triage. Zawsze ustawiaj ten sam zakres czasowy na panelach metryk i logów!

Analiza komunikatów błędów: Parsowanie stack trace (plik:linia:funkcja, zależne od frameworku: Java NullPointerException at com.example.Service.method:42, Go panic: runtime error: index out of range), mapowanie kodów błędów (HTTP 5xx, kody błędów DB: 1040 Too many connections, 1213 Deadlock), ekstrakcja kontekstu (request_id, user_id, trace_id, span_id, wersja wdrożenia). LogQL: |= "ERROR" | json | line_format "{{.message}}". Wykrywanie wzorców = pierwotna przyczyna w sekundy, nie godziny.

Kontekst dla metryk - korelacja metryk i logów: To najpotężniejsza technika SRE. Metryka (skok latencji p99) → klik na punkt na wykresie → "Logs for this trace" / Explore logs w tym samym czasie → LogQL: {job="api"} |= "ERROR" | json | line_format "{{.message}}" → widzisz: ERROR connection pool exhausted, WARN slow query > 5s, INFO retry attempt 3/3. Korelacja metryk → logów = pierwotna przyczyna w 30 sekund. Workflow: Metryka (CO) → Logi (DLACZEGO). Przejście = płynne (wspólny zakres czasowy, zmienne). Grafana Explore split view = metryki + logi obok siebie.

Podsumowanie: Filtrowanie po czasie + analiza błędów + korelacja z metrykami = pierwotna przyczyna w minuty, nie godziny. To systematyczny workflow, nie zgadywanie. Klucz: wspólny zakres czasowy + zmienne + split view. Opanuj to = opanuj reagowanie na incydenty.

W drugiej części wykładu o logach wracamy do pytania pojawiającego się przy każdej awarii: skąd wiedzieć, co dokładnie się stało i dlaczego system zaczął źle działać? Odpowiedź tkwi w połączeniu dwóch źródeł danych - metryki mówią, co się dzieje, na przykład skok latencji percentyla dziewięćdziesiątego dziewiątego, natomiast logi dostarczają przyczyny w postaci komunikatów błędów, śladów stosu i kontekstu żądania. Kluczem jest umiejętność systematycznego przechodzenia od jednego źródła do drugiego.

Praktyczny workflow zaczyna się od zawężenia zakresu czasowego - porównujemy stan bieżący z bazą historyczną, na przykład z identyczną godziną sprzed tygodnia, co pozwala odróżnić anomalię od naturalnego wzorca ruchu. Następnie analizujemy komunikaty błędów, wyciągając kody HTTP, nazwy funkcji ze stosu wywołań i identyfikatory żądań. Ponieważ oba źródła współdzielą znacznik czasu o precyzji nanosekundowej, Grafana daje widok dzielony z jednym przedziałem - w sekundy przechodzimy od obserwacji do przyczyny.

Wyjaśnienie skrótów użytych na slajdzie:
RCA – Root Cause Analysis – analiza przyczyn źródłowych; Proces badania śladów w logach mający na celu ustalenie bezpośredniego źródła awarii.
MTTR – Mean Time To Recover – średni czas przywrócenia sprawności; Kluczowy wskaźnik efektywności zespołu SRE skracany dzięki sprawnej nawigacji po logach.
MTTD – Mean Time To Detect – średni czas wykrycia; Średni czas od wystąpienia błędu do jego zaobserwowania w panelu monitoringu.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Praktyka inżynierska oparta na faktach i analizie danych telemetrycznych.
Post-mortem – Blameless Post-mortem – analiza powdrożeniowa bez obwiniania; Oficjalny raport z incydentu zawierający wyciągi z logów jako materiał dowodowy.

14/55 Wyszukiwanie anomalii
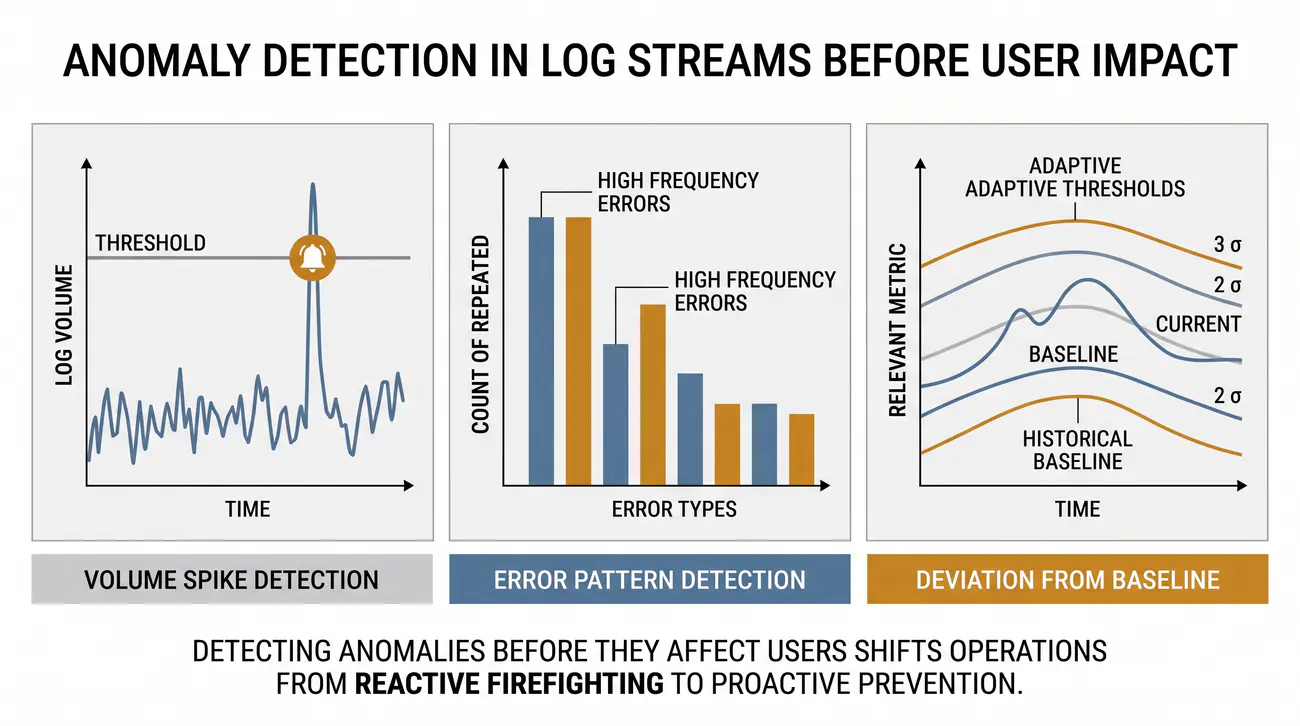
Anomaly detection: Wykrywanie anomalii przed wystąpieniem wpływu na użytkowników - volume spike (nagły wzrost logów), error pattern (powtarzające się błędy), baseline deviation (odchylenie od normy historycznej).

Lepiej łapać zagrożenie przed użytkownikami niż gasić po. Trzy techniki: skoki, wzorce i baza.

  • Nagłe skoki błędów – gwałtowny wzrost liczby wpisów o statusie błędu w jednostce czasu jest najbardziej czytelnym zwiastunem incydentu.
  • Nowe wzorce komunikatów – pojawienie się w logach nieznanych dotąd szablonów błędów sygnalizuje wprowadzenie regresji w oprogramowaniu.
  • Cisza w logach – całkowity zanik nowych zdarzeń z działającej usługi może świadczyć o zablokowaniu wątków lub awarii sieci na serwerze.
  • Automatyczne grupowanie – algorytmy analityczne potrafią łączyć tysiące podobnych wpisów w unikalne kategorie, redukując szum informacyjny.
  • Proaktywne wykrywanie – wczesne dostrzeżenie anomalii w strumieniu logów pozwala usunąć usterkę przed zauważeniem problemu przez klientów.
Volume spike: Nagły wzrost liczby logów sygnalizujący anomalię przed wpływem na użytkowników; obok powtarzalnych błędów i odchyleń od normy historycznej.
anomalia w logach

Anomalie w logach wykrywa się przed wpływem na użytkownika - to przejście z modelu reaktywnego (doraźne usuwanie awarii) na podejście proaktywne (zapobieganie incydentom). Trzy techniki to nagły wzrost liczby wpisów (wykrywanie skoków wolumenu), powtarzające się błędy (wykrywanie wzorców błędów) i porównanie z normą (wykrywanie odchyleń od bazy); proaktywne monitorowanie to klucz do wysokiej dostępności (anomaly detection, pattern, baseline, threshold).

Nagły wzrost liczby wpisów - wykrywanie skoków wolumenu: LogQL: count_over_time({app="api"}[5m]) > threshold. Skok = problem ze wdrożeniem, wzrost ruchu, DDoS, kaskadowa awaria, pętla błędów. Baza (7 dni, ta sama godzina/dzień) + odchylenie standardowe (2σ/3σ) = dynamiczny próg adaptujący się do normalnych wzorców. Alert na skok = wczesne ostrzeżenie (minuty przed wpływem na użytkownika). Grafana: panel time series z count_over_time + linia progu.

Powtarzające się błędy - wykrywanie wzorców błędów: LogQL: count by (error_type) ({app="api"} |= "error" | json). Najczęstsze typy błędów = priorytetyzacja (co naprawiać jako pierwsze). Powtarzające się błędy = systematyczny problem (bug w kodzie, zła konfiguracja, problem z zależnością). Częstotliwość wzorca = przewodnik priorytetyzacji. Automatyzacja: reguła nagrywająca co 1m → alert jeśli nowy typ błędu pojawia się > N razy.

Porównanie z normą - odchylenie od bazy: Baza = historyczny profil (sezonowość godzinowa i dzienna - hour-of-day, day-of-week). Odchylenie = |current - baza| / baza. Anomalia = odchylenie > próg (np. 2σ lub 3σ). Uwzględnianie sezonowości = mniej fałszywych pozytywów (np. mniej logów w nocy = normalne). Baza = kontekst dla alertów - bez bazy alerty to szum. Narzędzia: Grafana ML, reguły nagrywające Loki, własny PromQL na metrykach opartych na logach.

Podsumowanie: Wykrywanie anomalii = skok wolumenu + wzorzec błędów + odchylenie od bazy. Proaktywne > reaktywne. Alert na anomalię = czas na łagodzenie PRZED wpływem na użytkownika. To inwestycja w alerting, która zwraca się unikaniem incydentów.

Do tej pory mówiliśmy o diagnostyce sytuacji, w których problem już wystąpił i trzeba ustalić jego przyczynę. Równie ważne, a czasem i cenniejsze, jest wykrywanie nieprawidłowości, zanim dotkną użytkownika - system można skonfigurować tak, by ostrzegał o rosnącym zagrożeniu, porównując bieżące wartości z metrykami opisującymi normalny stan, na przykład o tej samej godzinie w poprzednich dniach. To przejście z podejścia reaktywnego na proaktywne stanowi o dojrzałości operacyjnej zespołu SRE i bezpośrednio chroni budżet błędów omawiany na poprzednim wykładzie.

Trzy podstawowe techniki to monitorowanie nagłych skoków wolumenu, wykrywanie powtarzających się wzorców błędów oraz porównywanie stanu bieżącego z profilem historycznym. Skok liczby wpisów może sygnalizować problem z wdrożeniem, atak DDoS lub kaskadową awarię - dlatego definiujemy próg na podstawie zliczenia wpisów i odchylenia standardowego, dzięki czemu alert pojawia się, zanim użytkownicy odczują skutki. Zestawienie najczęstszych typów błędów priorytetyzuje naprawy, a profil uwzględniający sezonowość godzinową eliminuje fałszywe alarmy.

Wyjaśnienie skrótów użytych na slajdzie:
IQR – Interquartile Range – rozstęp międzykwartylowy; Statystyczna miara rozrzutu danych pomagająca odróżnić incydent od naturalnych wahań wolumenu logów.
ML – Machine Learning – uczenie maszynowe; Algorytmy sztucznej inteligencji automatycznie klastrujące powtarzalne komunikaty błędów.
AI – Artificial Intelligence – sztuczna inteligencja; Zaawansowane mechanizmy detekcji nietypowych wzorców w strumieniach logów sieciowych.
STD – Standard Deviation – odchylenie standardowe; Miara zmienności rozkładu liczby wpisów w czasie służąca do wyznaczania dynamicznych progów.
SIEM – Security Information and Event Management – zarządzanie informacjami i zdarzeniami bezpieczeństwa; Narzędzie korelacji zdarzeń bezpieczeństwa wykrywające anomalie logowania użytkowników.

15/55 Filtrowanie i kontekst
Filtrowanie i kontekst: Request ID / Trace ID pozwala śledzić jeden request przez cały system. Filtry po labelach przed text search = szybsze zapytania i precyzyjna diagnostyka.

W oceanie wpisów liczy się precyzja: jeden request przez dziesiątki serwisów znajdziesz ID plus etykietami.

  • Precyzja filtrowania – łączenie warunków logicznych w języku zapytań pozwala wyeliminować miliony rutynowych wpisów z widoku dyżurnego.
  • Kontekst czasowy – funkcja podglądu sąsiadujących linii umożliwia odczytanie zdarzeń poprzedzających wystąpienie krytycznego wyjątku w kodzie.
  • Wielkość liter – stosowanie filtrów niewrażliwych na wielkość znaków zapobiega pominięciu komunikatów pisanych w różny sposób przez biblioteki.
  • Eliminacja zakłóceń – wykluczenie powtarzalnych ostrzeżeń z zewnętrznych bibliotek pomaga skupić uwagę na logach samej logiki biznesowej.
  • Zachowanie kontekstu – badanie sekwencji zdarzeń wokół błędu jest kluczem do zrozumienia, w jakim stanie znajdowała się aplikacja.
Trace ID: Identyfikator pozwalający śledzić jedno żądanie przez cały system; filtry po etykietach przed przeszukiwaniem tekstu dają szybkość i precyzję.
filtr logów

Precyzyjna diagnostyka wymaga rozróżnienia wszystkich logów od logów dla tego konkretnego requestu - w systemach obsługujących tysiące requestów na sekundę bez filtrowania tonie się w szumie. Klucz to wyszukiwanie po request ID (trace ID, correlation ID - unikalny identyfikator przepływający przez cały system) i łączenie z etykietami do kontekstualnego filtrowania; to precyzyjne debugowanie - chirurgiczna precyzja zamiast ślepego strzału (filter, context query, trace ID).

Wyszukiwanie po ID żądania: Request ID / Trace ID / Correlation ID - unikalny identyfikator przepływający przez cały system (nagłówek HTTP X-Request-ID, W3C Trace Context: traceparent). LogQL: {app="api"} | trace_id="abc-123-def" → wszystkie logi dla tego requestu we wszystkich serwisach. End-to-end tracing = podróż jednego requestu od load balancera przez API, serwisy, bazę danych, cache. To fundament rozproszonego śledzenia - bez request ID logi to chaos.

Łączenie z etykietami: Etykiety jako kontekst (app, env, version, handler, instance, k8s_namespace, k8s_pod). LogQL: {app="api", env="prod"} |= "error" → filtry po etykietach PRZED wyszukiwaniem tekstu = wydajność (mniej danych do przeskanowania) + precyzja. Filtrowanie etykiet jako pierwsze = drastyczna redukcja skanowanych danych. Higiena etykiet = ograniczona kardynalność! Nigdy nie rób etykiety z nieograniczonych wartości (user_id, session_id, request_id, IP).

Kontekst = precyzja: Request ID + Etykiety + Zakres czasowy = chirurgiczna precyzja. Zamiast "wszystkie error logi w production" (miliony linii) → "error logi dla request_id=abc-123 w app=api env=prod w ostatnich 5 min" (kilka linii). Kontekst = sygnał, redukcja szumu = szybszy MTTR. To różnica między 5 minutami a 5 godzinami debugowania.

Podsumowanie: Request ID (trace_id) + Etykiety (kontekst) + Zakres czasowy = chirurgiczna precyzja. Filtrowanie etykiet NAJPIERW (wydajność) → filtrowanie tekstu POTEM (precyzja). Kontekst = zachowanie sygnału, eliminacja szumu. To kluczowa umiejętność on-call.

W systemie mikrousługowym, gdzie w ciągu sekundy przez dziesiątki serwisów przepływają tysiące żądań, samo posiadanie logów to dopiero początek - prawdziwym wyzwaniem jest odnalezienie dokładnie tych wpisów, które dotyczą konkretnego zdarzenia. Bez precyzyjnych mechanizmów filtrowania toniemy w oceanie danych, a poszukiwanie przyczyny przypomina szukanie igły w stogu siana. Dlatego w nowoczesnych stackach obserwowalności tak ważne są identyfikatory żądań i świadome budowanie kontekstu wokół każdego zapisanego zdarzenia.

Identyfikator żądania, nazywany też trace ID lub correlation ID, to unikalny znacznik przepływający od load balancera przez API po bazę danych i cache, propagowany nagłówkiem HTTP zgodnym z W3C Trace Context. Równie istotna jest kolejność operacji: najpierw zawężamy zbiór po etykietach, takich jak aplikacja i środowisko, co eliminuje większość danych na poziomie indeksu, dopiero potem przeszukujemy treść linii. Połączenie identyfikatora żądania, etykiet i zakresu czasowego daje chirurgiczną precyzję - z milionów wpisów zostaje kilka linii.

Wyjaśnienie skrótów użytych na slajdzie:
UUID – Universally Unique Identifier – uniwersalny unikalny identyfikator; 128-bitowy ciąg znaków jednoznacznie identyfikujący pojedynczą transakcję biznesową w logach.
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji; Standard komunikacyjny, którego nagłówki (np. X-Request-ID) przenoszą kontekst transakcji.
REST – Representational State Transfer – architektura REST; Styl architektury, w którym kontekst żądania jest propagowany do wszystkich wywołań zależnych.
URL – Uniform Resource Locator – lokalizator zasobu; Ścieżka sieciowa przetwarzana przez serwer, stanowiąca kluczowe pole kontekstu w logu dostępowym.
IP – Internet Protocol – protokół internetowy; Adres sieciowy klienta lub węzła, podlegający rygorom ochrony danych osobowych.

16/55 Korelacja metryk i logów
Korelacja metryk i logów: Metrics = co (latency, error rate). Logs = dlaczego (stack trace, context). Wspólny timestamp (ns) = join key. Grafana: split view + shared time range = zunifikowana obserwowalność.

Metryki bez logów to połowa prawdy i odwrotnie. Wspólny czas spina je w diagnozę dziesięć razy szybszą.

  • Podejście zunifikowane – połączenie metryk i logów w jednym panelu Grafana tworzy spójny ekosystem obserwacji stanu infrastruktury.
  • Wspólne zmienne widoku – wybór instancji serwera na górnym pasku pulpitu automatycznie aktualizuje zarówno wykresy, jak i listę logów.
  • Przejście jednym kliknięciem – zaznaczenie podejrzanego piku na wykresie opóźnień natychmiast wyświetla logi zarejestrowane w tym ułamku sekundy.
  • Skrócenie czasu naprawy – wyeliminowanie konieczności ręcznego kopiowania zakresów czasowych pozwala zaoszczędzić cenne minuty w trakcie awarii.
  • Trójkąt obserwowalności – metryki informują o problemie, logi wyjaśniają jego przyczynę, a rozproszone ślady wskazują wadliwy komponent.
Join key: Wspólny klucz łączący dane - nanosekundowy timestamp spina metryki (co się dzieje) z logami (dlaczego wystąpił błąd); split view ze wspólnym czasem daje zunifikowaną obserwowalność.
metryki i logi razem

Manualne korelowanie wykresu ze strumieniem logów jest czasochłonne i podatne na błędy. Standardem inżynierii SRE opisanym w Google SRE Workbook jest wstrzykiwanie globalnych identyfikatorów trace_id oraz span_id do każdego wpisu logu. W interfejsie Grafany umożliwia to jednym kliknięciem przejście od wykresu z błędem do powiązanego śladu rozproszonego i odpowiadających mu wierszy dziennika.

Metryki mówią CO (skok latencji, wskaźnik błędów, nasycenie), logi DLACZEGO (stack trace, komunikat błędu, kontekst), a wspólny czas (timestamp z precyzją ns) pozwala je korelować - to fundament zunifikowanej obserwowalności. Metryki + logi + trace w jednym UI (Grafana) to mnożnik siły dla redukcji MTTR; korelacja i zintegrowany widok spinają pełny obraz obserwowalności.

Logi pokazują przyczynę problemu (dlaczego wystąpił): Stack trace (plik:linia:funkcja), komunikat błędu (connection refused, timeout, OOM), kontekst (request_id, user_id, trace_id, wersja wdrożenia). Metryki pokazują co (CO): latencja p99, wskaźnik błędów, przepustowość, CPU, pamięć, dysk, sieć. Razem = pełny obraz. Separacja = martwe pola: metryki bez logów = zgadywanie przyczyny, logi bez metryk = brak kontekstu skali problemu.

Wspólny czas = klucz korelacji: Timestamp (precyzja ns, UTC) = uniwersalny klucz łączenia. Grafana: wspólny zakres czasowy + zmienne = skorelowany widok. Panel metryk + panel logów = widok podzielony (split view), ten sam zakres czasowy. Klik na skok metryki → skok do logów w tym samym momencie (Grafana: "Show logs for this time range"). Czas = uniwersalny klucz łączenia. Bez wspólnego czasu (synchronizacja NTP/PTP) = korelacja niemożliwa.

Analiza powiązanych danych: Top-down (skok metryki → który serwis → który endpoint → logi) vs Bottom-up (błąd w logu → wpływ na metrykę). Korelacja = izolacja pierwotnej przyczyny. Narzędzia: Grafana Explore (split view), data sources Loki + Prometheus, trace Tempo (trace_id z logów → trace w Tempo). Zintegrowana obserwowalność = szybszy MTTR (zwykle redukcja 10×).

Podsumowanie: Metryki (co) + Logi (dlaczego) + Czas (kiedy) = Pełna Obserwowalność. Korelacja = mnożnik siły dla redukcji MTTR. Wspólny zakres czasowy + zmienne + split view = workflow. Opanuj to = opanuj SRE.

Przed chwilą widzieliśmy, jak filtrować logi, by znaleźć właściwe wpisy. Teraz zastanówmy się, jak połączyć je z metrykami w spójny obraz diagnostyczny - bo ani logi bez kontekstu liczb, ani metryki bez wyjaśnienia przyczyn nie dają pełnego obrazu sytuacji. To połączenie stanowi fundament obserwowalności, w którym inżynier w ciągu sekund przechodzi od sygnału alertowego do pierwotnej przyczyny problemu, zamiast zgadywać i przeszukiwać system ręcznie.

Metryki mówią, co się dzieje - widzimy skok latencji, wzrost wskaźnika błędów lub nasycenie zasobów, ale nie wiemy, który fragment kodu czy zależność jest temu winna. Logi odpowiadają na pytanie dlaczego, dostarczając stos wywołań, komunikaty o błędach i kontekst żądania. Kluczem jest wspólny znacznik czasu - w Grafanie ustawiamy identyczny zakres na panelach metryk i logów, a kliknięcie na anomalię przenosi do powiązanych wpisów. Takie podejście skraca czas naprawy nawet dziesięciokrotnie, z godzin do minut.

Wyjaśnienie skrótów użytych na slajdzie:
OTel – OpenTelemetry – standard OpenTelemetry; Globalny standard standaryzujący formaty i biblioteki korelacji śladów, metryk i logów.
APM – Application Performance Monitoring – monitorowanie wydajności aplikacji; Platformy analityczne łączące profilowanie kodu z analizą zdarzeń w logach.
TraceID – Trace Identifier – identyfikator śladu; Unikalny klucz żądania umożliwiający błyskawiczne powiązanie wykresu latencji z odpowiadającymi mu logami.
SpanID – Span Identifier – identyfikator rozpiętości; Identyfikator konkretnego podzadania lub zapytania do bazy w ramach nadrzędnego śladu.
TSDB – Time Series Database – baza danych szeregów czasowych; Źródło metryk, z którego anomalie czasowe przekładają się na zapytania w bazie logów.

17/55 Struktura wpisu logu
Struktura wpisu logu: Poprawny log = severity (poziom) + request ID (W3C Trace Context) + czytelny message + structured context (key-value pairs dla maszyny). Format: JSON.

Dobry wpis to cztery składniki: poziom, ID żądania, ludzki opis i maszynowy kontekst w JSON.

  • Elementy rekordu – prawidłowy wpis w logu musi zawierać precyzyjny znacznik czasu, poziom logowania, nazwę serwisu oraz treść zdarzenia.
  • Dodatkowe atrybuty – wzbogacenie rekordu o identyfikator wątku, nazwę środowiska i adres IP klienta znacząco ułatwia późniejsze dochodzenie.
  • Zapis strukturalny – unikanie sklejania łańcuchów znaków na rzecz par klucz-wartość w JSON pozwala systemom na bezpośrednią analitykę.
  • Spójność typów danych – konsekwentne zapisywanie czasów trwania żądań w milisekundach jako liczb umożliwia ich łatwe filtrowanie.
  • Czystość danych – logi nie powinny zawierać niesformatowanych znaków nowej linii poza wydzielonymi polami zrzutów błędów stosu.
W3C Trace Context: Standard propagacji identyfikatorów żądań; poprawny wpis to severity plus request ID plus czytelny message plus kontekst strukturalny w JSON.
poprawny log

Poprawny wpis logu to punkt danych nadający się do działania, nie linia tekstu: poziom ważności (severity: DEBUG/INFO/WARN/ERROR/FATAL), identyfikator żądania (request ID / trace ID / correlation ID - W3C Trace Context), czytelny komunikat (message dla człowieka) i kontekst (pary klucz-wartość dla maszyny). Structured logging (JSON) daje parsowalność, przeszukiwalność i automatyzację - bez niego logi pozostają śmieciami tekstowymi.

Poziom ważności (severity): DEBUG (szczegóły debugowe: przepływ, zmienne - tylko dev/staging, próbkowanie w prod), INFO (zdarzenia operacyjne: start/end requestu, załadowanie configu, zakończenie zadania - domyślny prod), WARN (potencjalne problemy: retry, deprecated API, zbliżanie do limitu - wymaga analizy), ERROR (awarie: nieudany request, błąd DB - wymaga akcji/alertu), FATAL/CRITICAL (system down, utrata danych, naruszenie bezpieczeństwa - natychmiastowe paging). Spójne mapowanie = reguły alertowe. Severity = klucz routingu (DEBUG→tani storage, ERROR→alerting). Zasada: loguj na odpowiednim poziomie!

Identyfikator żądania: Request ID / Trace ID (W3C Trace Context: nagłówki traceparent, tracestate) - unikalny identyfikator przepływający przez CAŁY system (nagłówek HTTP X-Request-ID, traceparent). Logi z request_id = śledzenie end-to-end od load balancera przez API, serwisy, bazę, cache. Rozproszone śledzenie = kręgosłup korelacji logów. Bez request_id = niemożliwe śledzenie requestu w mikrousługach. Propagacja = middleware/interceptor w każdym serwisie.

Czytelny komunikat: Czytelny dla człowieka komunikat + strukturalny kontekst (klucz=wartość). Zły przykład: „Error occurred”, „Failed”, „Exception”. Dobry przykład: „Failed to connect to database” wraz z kontekstem strukturalnym: {host: "db-primary", port: 5432, error: "connection refused", retry_attempt: 3, max_retries: 3}. Czytelny komunikat jest przeznaczony dla operatora, natomiast kontekst strukturalny służy do automatycznego parsowania i agregacji przez systemy telemetryczne (np. grupowanie według typu błędu czy hosta).

Podsumowanie: Severity + RequestID (W3C) + Message (człowiek) + Context (maszyna) = wpis logu nadający się do działania. Structured logging (JSON) = inwestycja, a debugowanie = dywidenda. To nie koszt - to inwestycja z ROI przy pierwszej awarii.

Znając już narzędzia do wyszukiwania i korelacji logów, zastanówmy się nad fundamentalnym pytaniem: jak powinien wyglądać pojedynczy wpis logu, by w ogóle nadawał się do automatycznego przetwarzania? Nie wystarczy wypisać czegoś na konsolę - wpis musi zawierać minimalny zestaw pól, bez których żaden system agregacji nie zindeksuje go sensownie ani nie wykorzysta w procesie diagnostycznym.

Poprawny wpis składa się z czterech elementów: poziomu ważności, identyfikatora żądania zgodnego z W3C Trace Context, czytelnego komunikatu dla człowieka oraz kontekstu w postaci par klucz-wartość dla maszyny. Najlepszym formatem tego ostatniego elementu jest JSON, który zapewnia pełną parsowalność - strukturalne logi pozwalają wyciągać pola, filtrować po dowolnym atrybucie i budować reguły alertowe na konkretnych wartościach. To inwestycja, która zwraca się przy pierwszej poważnej awarii.

Wyjaśnienie skrótów użytych na slajdzie:
ISO – International Organization for Standardization – Międzynarodowa Organizacja Normalizacyjna; Wydawca standardu ISO 8601 gwarantującego jednoznaczność zapisu czasu w logach.
UTC – Coordinated Universal Time – uniwersalny czas koordynowany; Jednolity czas odniesienia eliminujący błędy wynikające z czasu letniego i zimowego.
PID – Process Identifier – identyfikator procesu; Liczbowy identyfikator instancji procesu w systemie operacyjnym emitującej dany komunikat.
TID – Thread Identifier – identyfikator wątku; Numer wątku w procesie wielowątkowym umożliwiający analizę zakleszczeń (deadlocks).
FQDN – Fully Qualified Domain Name – w pełni kwalifikowana nazwa domenowa; Precyzyjna nazwa węzła sieciowego umieszczana w nagłówku komunikatu.

18/55 Poziomy logowania (praktyka)
Poziomy logowania: Prawidłowe przypisywanie poziomów = alerty bez szumu. INFO (90%) - zdarzenia normalne, WARN (9%) - wymaga uwagi, ERROR (1%) - wymaga akcji, FATAL (<0.1%) - natychmiastowa interwencja.

Poziom decyduje, czy obudzisz dyżurnego, czy wpis poleży w archiwum. Trzymaj proporcje 90/9/1.

  • Poziom DEBUG – służy wyłącznie programistom podczas lokalnego testowania kodu i powinien być bezwzględnie wyłączony na produkcji.
  • Poziom INFO – dokumentuje prawidłowy przebieg procesów biznesowych, takich jak uruchomienie serwisu, realizacja płatności czy logowanie.
  • Poziom WARN – sygnalizuje nieoczekiwane sytuacje, które nie przerwały pracy systemu, lecz mogą wskazywać na zbliżające się zagrożenie.
  • Poziom ERROR – oznacza błąd wykonania konkretnego żądania użytkownika i wymaga rzetelnej analizy przez zespół programistyczny.
  • Poziom FATAL – informuje o katastrofalnej awarii uniemożliwiającej dalsze działanie procesu, prowadzącej do natychmiastowego zamknięcia.
Rozkład poziomów: INFO ok. 90% (norma), WARN ok. 9% (uwaga), ERROR ok. 1% (akcja), FATAL poniżej 0,1% (natychmiastowa interwencja); prawidłowe poziomy to alerty bez szumu.
skala poziomów

Poziomy logowania to balans między zmęczeniem alertami (za dużo szumu) a przegapionymi incydentami (za mało sygnału). Wartości to INFO (normalne zdarzenia operacyjne), WARN (ostrzeżenia wymagające uwagi), ERROR (błędy wymagające akcji) i FATAL/CRITICAL (krytyczne - natychmiastowa interwencja); poprawny dobór poziomów to precyzja alertowania, redukcja szumu i kontrola kosztów (log severity, log level, sampling).

INFO - normalne zdarzenia: Start/end requestu (metoda HTTP, ścieżka, status, latencja), załadowanie configu, start/stop usługi, zakończenie zadania cyklicznego, cache hit/miss. Wysoki wolumen (90%+ logów), niski sygnał. Próbkowanie/ograniczanie tempa (np. 10% INFO) = kontrola kosztów. Domyślny poziom dla production. Pola JSON: method, path, status_code, latency_ms, request_id.

WARN - ostrzeżenia: Próba retry (retry 2/3, backoff 500ms), użycie deprecated API (nagłówek warning), zbliżanie do limitu zasobów (dysk 80%, pulę połączeń 90%, pamięć 85%), wolne zapytanie (> próg), half-open circuit breaker. Do działania = wymaga analizy, NIE nagłego reagowania. Alert na trend (tempo wzrostu WARN > baza) nie na pojedyncze wystąpienie. Pola JSON: retry_count, resource_usage_percent, threshold.

ERROR - błędy operacyjne: Nieudany request (5xx, timeout, connection refused), błąd połączenia DB (wyczerpana pula, deadlock), sztorm cache miss (thundering herd), błąd uwierzytelniania (niepoprawny token, wygasły certyfikat), pełna kolejka (backpressure). Wymaga akcji (alert, page). Konsumpcja budżetu błędów. Stack trace + kontekst = można debugować. Pola JSON: error_type, error_message, stack_trace, affected_users.

FATAL/CRITICAL - krytyczne: Awaria procesu (OOM, segfault, panic), uszkodzenie danych (niezgodność sum kontrolnych), naruszenie bezpieczeństwa (nieautoryzowany dostęp, wstrzyknięcie), utrata danych (nieudany backup, krytyczne opóźnienie replikacji). Natychmiastowy page + zgłoszenie incydentu. Rzadkie (<0.1%), wysoki sygnał. Post-mortem obowiązkowy. Pola JSON: crash_reason, data_affected, blast_radius.

Podsumowanie: Poziom = siła sygnału. Poprawny rozkład: INFO 90%, WARN 9%, ERROR 1%, FATAL <0.1%. Złe poziomowanie = zmęczenie alertami LUB przegapione incydenty. Audyt poziomów co kwartał - czy ERRORy to prawdziwe błędy? czy INFO zawiera PII? Dyscyplina poziomów = dojrzałość operacyjna.

Skoro wiemy, jak powinien wyglądać pojedynczy wpis, kolejnym krokiem jest świadomy dobór poziomu ważności - bo to właśnie on determinuje, czy alert obudzi inżyniera o trzeciej w nocy, czy zostanie spokojnie zapisany w archiwum. Źle przypisane poziomy to jedna z najczęstszych przyczyn zmęczenia alertami albo, co gorsza, przegapionych incydentów. Poprawny rozkład przypomina więc dźwignię balansującą między szumem a ciszą.

Prawidłowy rozkład poziomów wygląda następująco: około dziewięćdziesięciu procent wpisów to INFO rejestrujące normalne zdarzenia, jak start i koniec żądania czy załadowanie konfiguracji; kolejne dziewięć procent to WARN sygnalizujący ponowną próbę połączenia albo zbliżanie się do limitu zasobów. Około procenta wpisów to ERROR, oznaczający błędy wymagające akcji, a poziom FATAL - utrata danych czy naruszenie bezpieczeństwa - powinien występować rzadziej niż raz na tysiąc wpisów. Dyscyplina w przypisywaniu poziomów to warunek alertów bez szumu.

Wyjaśnienie skrótów użytych na slajdzie:
RFC – Request for Comments – dokument standaryzacyjny RFC; Specyfikacje IETF definiujące m.in. 8 poziomów ważności w protokole Syslog (0-7).
DEBUG – Debug Logging Level – poziom debugowania; Szczegółowy poziom rejestrowania zdarzeń wyłączany na środowiskach produkcyjnych ze względów wydajnościowych.
INFO – Informational Logging Level – poziom informacyjny; Standardowy poziom potwierdzający poprawne wykonanie kluczowych operacji biznesowych.
WARN – Warning Logging Level – poziom ostrzegawczy; Sygnał o wystąpieniu nieoczekiwanego zdarzenia, które nie zatrzymało jeszcze działania usługi.
ERROR – Error Logging Level – poziom błędu; Zdarzenie awaryjne oznaczające niepowodzenie wykonania operacji, wymagające interwencji programisty.

19/55 Rotacja i retencja logów
Rotacja i retencja: Log rotation chroni dysk (size/time-based, logrotate). Tiered storage = hot (SSD, 7d) → warm (HDD, 90d) → cold (S3/Glacier, 1-7 lat). Compliance: SOX 7 lat, GDPR, HIPAA.

Logi rosną lawinowo: bez rotacji zapchają dysk, bez retencji zjedzą budżet. Trzy warstwy i automatyka.

  • Mechanizm rotacji – narzędzia systemowe dzielą pliki logów według rozmiaru lub harmonogramu, zapobiegając wyczerpaniu miejsca na dysku.
  • Kompresja archiwalna – pakowanie starszych plików za pomocą algorytmu gzip pozwala zaoszczędzić do dziewięćdziesięciu procent przestrzeni.
  • Polityka retencji – precyzyjnie określa czas przechowywania logów w zależności od wymogów prawnych, audytowych oraz kosztów magazynu.
  • Automatyczne usuwanie – skrypty cyklu życia bezpowrotnie kasują przeterminowane dane, chroniąc firmę przed niepotrzebnymi wydatkami.
  • Bezpieczeństwo rotacji – poprawne przeładowanie demonów po rotacji gwarantuje, że procesy nie będą pisać do skasowanych uchwytów plików.
Tiered storage: Warstwowe przechowywanie - hot (SSD, 7 dni), warm (HDD, 90 dni), cold (S3/Glacier, lata); logrotate chroni dysk, a compliance (SOX 7 lat, GDPR, HIPAA) wyznacza retencję.
logrotate

Niekontrolowany rozrost plików dziennika prowadzi do natychmiastowej awarii serwera w wyniku zapełnienia partycji. Do zarządzania cyklem życia plików służy narzędzie logrotate(8), konfigurujące rotację czasową lub rozmiarową, kompresję (gzip), atomowe tworzenie nowych plików z poprawnymi uprawnieniami (dyrektywa create) oraz wysyłanie sygnału SIGHUP do procesów roboczych.

Rotacja i retencja logów to kwestia kontroli kosztów, compliance i higieny operacyjnej: bez rotacji dyski się zapełniają (outage!), bez retencji płacisz za śmieci lub naruszasz prawo. Składają się na nie limity rozmiaru (rotacja oparta na rozmiarze, logrotate), okresy przechowywania (polityka retencji: poziomy hot/warm/cold) i archiwizacja (cold storage, compliance, przeszukiwalne archiwa); rotacja logów = ochrona dysku, retencja = balans kosztów i zgodności (compactor, ILM).

Limity rozmiaru: Rotacja oparta na rozmiarze (max rozmiar pliku: 100MB-1GB, max plików: 10-50) - logrotate (standard Linux) / Loki compactor (automatyczny). Rotacja oparta na czasie (dziennie/godzinowo) - dla aplikacji bez logrotate. Max użycie dysku = suma(max_size * max_files) per usługa. Alert na 80% użycia dysku = proaktywne (nie czekaj na 100%). Loki: limits_config: ingestion_rate_mb, per_stream_rate_limit = ochrona przed szalejącym logowaniem.

Okres przechowywania - storage wielopoziomowy: Hot (SSD/NVMe, ostatnie 1-7 dni, ścieżka dostarczania + zapytania w czasie rzeczywistym, drogie $/GB), Warm (HDD/object storage, 30-90 dni, zapytania ad-hoc, średnie), Cold (S3/GCS Glacier/Deep Archive, 1-7 lat, compliance/audyt, najtańsze $0.01-0.02/GB/mies). Storage wielopoziomowy = optymalizacja kosztów (automatyczne przechodzenie między poziomami). Loki: enkodowanie chunków + object storage = naturalny tiering (compactor przenosi chunki). Elasticsearch: ILM (Index Lifecycle Management) = tiering sterowany polityką.

Archiwizacja: Eksport do S3/GCS (Parquet/ORC - kolumnowe, predykcja pushdown / JSONL - linia po linii), ewolucja schematu (schema registry, dodawanie/usuwanie kolumn, poszerzanie typów) = przeszukiwalne archiwa. Przeszukiwalne: Athena (SQL na S3), BigQuery (SQL na GCS), Loki query frontend (remote read). Compliance: GDPR Art. 17 (prawo do bycia zapomnianym - selektywne usuwanie), SOX (7 lat finansowe), HIPAA (6 lat zdrowotne), PCI-DSS (1 rok płatnicze). Archiwum = niezmiennicze (WORM/Object Lock), szyfrowane (SSE-KMS), audytowane (CloudTrail). Automatyczny cykl życia = bez ręcznego sprzątania.

Podsumowanie: Rotacja = bezpieczeństwo dysku (alert na 80%). Retencja = balans kosztów i zgodności (storage wielopoziomowy). Archiwum = zgodność + przeszukiwalność (Parquet + Athena). Automatyzuj wszystko (logrotate, Loki compactor, ILM, S3 Lifecycle). FinOps = świadome kosztowo logowanie.

Mając poprawne wpisy i poziomy logowania, musimy zmierzyć się z problemem, który prędzej czy później dotknie każde środowisko produkcyjne - lawinowo rosnącą ilością danych. Logi gromadzone bez kontroli szybko zapełniają dyski, generują rosnące koszty przechowywania i stają się zagrożeniem dla stabilności samego systemu operacyjnego. Dlatego rotacja i retencja to nie wygoda, lecz konieczność, a ich odpowiednie zaprojektowanie przekłada się wprost na rachunki za infrastrukturę logową.

Rotację plików realizuje zwykle logrotate lub mechanizm kompaktora Loki, definiując rozmiar pliku i liczbę wersji. Ciekawsza jest retencja wielopoziomowa, w której dane automatycznie przechodzą przez trzy fazy: gorącą na dyskach SSD przez kilka dni, ciepłą w obiektowym magazynie przez kilka miesięcy oraz zimną w archiwum typu Glacier przez okres wymagany przepisami - na przykład siedem lat dla SOX. Index Lifecycle Management w Elasticsearch wykonuje te przejścia automatycznie.

Wyjaśnienie skrótów użytych na slajdzie:
FHS – Filesystem Hierarchy Standard – standard hierarchii systemu plików; Układ katalogów określający rotację plików w katalogach /var/log.
VFS – Virtual Filesystem Switch – wirtualny system plików; Warstwa jądra narażona na zablokowanie w przypadku braku wolnych i-węzłów przez miliony małych logów.
I/O – Input/Output – operacje wejścia/wyjścia; Operacje kompresji plików archiwalnych optymalizowane tak, aby nie obciążać bazy danych w godzinach szczytu.
Cron – Cron daemon – demon harmonogramu zadań; Usługa systemowa odpowiedzialna za cykliczne uruchamianie skryptów rotacji logów.
POSIX – Portable Operating System Interface – standard przenośnego systemu operacyjnego; Standard wywołań systemowych gwarantujący bezpieczne usuwanie i przemianowywanie plików.

20/55 Bezpieczeństwo logów
Bezpieczeństwo logów: Logi mogą zawierać PII (dane osobowe). Ochrona: maskowanie (hash/redact/drop), RBAC (role-based access), szyfrowanie (TLS 1.3 + encryption at rest). Zgodność z RODO/GDPR.

Logi to PII: maile, IP i tokeny. Chroń od projektu (RODO), nie doklejaj na końcu.

  • Ochrona prywatności – logi produkcyjne nie mogą zawierać poufnych danych osobowych, numerów kart płatniczych ani haseł klientów.
  • Maskowanie w locie – biblioteki programistyczne oraz potoki kolektorów powinny automatycznie zastępować wrażliwe pola gwiazdkami.
  • Kontrola dostępu RBAC – uprawnienia do przeszukiwania logów powinny być ściśle ograniczone wyłącznie do uprawnionych inżynierów i audytorów.
  • Szyfrowanie danych – przesyłanie logów przez sieć musi odbywać się przez bezpieczne kanały TLS, a magazyny dyskowe muszą być szyfrowane.
  • Zgodność z prawem – zachowanie standardów ochrony danych chroni przedsiębiorstwo przed surowymi karami nakładanymi przez organy nadzoru.
Maskowanie (redact): Technika ochrony PII w logach (hashowanie, usuwanie, odrzucanie) obok RBAC i szyfrowania (TLS 1.3, at rest); wymóg RODO/GDPR.
maskowanie logów

Rejestrowanie danych podlega restrykcyjnym wymogom rozporządzenia RODO oraz wytycznym Urzędu Ochrony Danych Osobowych. Bezwzględnie zabrania się utrwalania w logach haseł w otwartym tekście, kluczy sesyjnych, numerów kart płatniczych oraz danych osobowych podlegających szczególnej ochronie. Agent wysyłający musi realizować lokalne reguły maskowania (redaction) za pomocą wyrażeń regularnych przed przekazaniem strumienia do sieci.

Logi to potencjalna kopalnia PII (danych osobowych): user_id, email, IP, token, hasło, karta kredytowa, dane zdrowotne - bezpieczeństwo dotyczy prywatności (RODO/GDPR), compliance i pozycji bezpieczeństwa. Bezpieczeństwo od projektu to domyślnie bezpiecznie, nie "dodamy później": maskowanie wrażliwych pól (maskowanie/haszowanie/redakcja PII), ograniczony dostęp (RBAC, najmniejsze uprawnienia), szyfrowanie (TLS w transmisji, szyfrowanie w spoczynku) oraz kompetencja K02 (etyka, poufność); to minimalizacja danych.

Maskowanie wrażliwych pól: PII w logach (user_id, email, IP, session_id, token, credit_card, PESEL, dane zdrowotne) = ryzyko naruszenia GDPR/RODO (Art. 25 ochrona danych od projektu, Art. 32 bezpieczeństwo przetwarzania). Techniki: hash (SHA256 user_id - deterministyczny, pozwala korelację bez ujawniania), redakcja (regex replace: s/token=.*/token=***/, s/password=.*/password=***/), drop (usunięcie etykiety/pola user_id w pipeline). Promtail pipeline stages: replace, regex, hash, labeldrop. Loki: haszowanie wartości etykiet. Maskowanie danych = prywatność od projektu - instrumentacja bez danych osobowych (PII) od początku.

Ograniczony dostęp: RBAC (Grafana: Viewer/Editor/Admin per folder/datasource, uprawnienia datasource: tylko zapytania, bez API admina). SSO (SAML/OIDC/LDAP) = centralne zarządzanie tożsamością. Polityki sieciowe (Kubernetes NetworkPolicy, Security Groups, VPC) = segmentacja sieci. Najmniejsze uprawnienia = domyślnie odmowa. Logowanie audytowe: kto, co, kiedy zapytywał logi (Grafana audit log, Loki query log). Rozdzielenie obowiązków: on-call widzi logi, deweloper nie widzi logów produkcyjnych (albo widzi zmaskowane).

Szyfrowanie: TLS 1.3 w transmisji (Promtail→Loki, Loki→Grafana, klient→Grafana, Loki↔S3) - certyfikaty przez cert-manager/Let's Encrypt/Vault. Szyfrowanie w spoczynku (Loki: S3 SSE-S3/SSE-KMS, Elasticsearch: szyfrowanie w spoczynku, filesystem: LUKS). Zarządzanie kluczami: KMS (AWS KMS, GCP KMS, HashiCorp Vault), cert-manager dla TLS. Szyfrowanie = domyślne, nie opcjonalne. mTLS dla service-to-service = zero trust.

Compliance: GDPR Art. 25 (ochrona danych od projektu - instrumentacja bez danych osobowych (PII)), Art. 32 (bezpieczeństwo przetwarzania - TLS, RBAC, szyfrowanie), Art. 33/34 (zgłaszanie naruszeń - 72h). Logi = potencjalnie dane osobowe. Compliance = kultura, nie tylko config. Regularne audyty: co się loguje, kto ma dostęp, czy szyfrowanie działa.

Podsumowanie: Maskowanie PII (hash/redact/drop) = prywatność od projektu. RBAC + SSO + polityki sieciowe = najmniejsze uprawnienia. TLS 1.3 + szyfrowanie w spoczynku + KMS = szyfrowanie domyślnie. Compliance = kultura inżynierska. Bezpieczeństwo od projektu = domyślnie bezpiecznie.

Logi, które gromadzimy, często zawierają informacje wrażliwe - adresy poczty elektronicznej użytkowników, numery IP, tokeny sesji, a w branżach regulowanych nawet numery PESEL czy dane medyczne. Jeśli nie zadbamy o ich ochronę od początku projektowania pipeline'u, ryzykujemy nie tylko naruszenie przepisów o ochronie danych osobowych, lecz również udostępnienie atakującym cennych informacji o strukturze systemu i jego użytkownikach.

Maskowanie realizuje się w pipeline za pomocą haszowania, redakcji wyrażeniami regularnymi lub całkowitego usunięcia pola - Promtail potrafi na przykład zastąpić token sesji ciągiem gwiazdek, zanim log trafi do Loki. Kontrola dostępu opiera się na modelu RBAC z minimalnymi uprawnieniami, single sign-on i rejestrowaniem zapytań w celach audytowych. Szyfrowanie obejmuje transmisję protokołem TLS 1.3 oraz dane w spoczynku za pomocą kluczy KMS. Regulacyjnie chodzi o zgodność z RODO, które wymaga ochrony danych od fazy projektowania.

Wyjaśnienie skrótów użytych na slajdzie:
RODO – Rozporządzenie o Ochronie Danych Osobowych – unijne rozporządzenie o ochronie danych; Regulacja prawna nakazująca minimalizację i ochronę danych identyfikujących osoby w logach.
PII – Personally Identifiable Information – dane osobowe / dane identyfikujące; Informacje umożliwiające identyfikację osoby fizycznej, podlegające rygorystycznemu maskowaniu.
DLP – Data Loss Prevention – zapobieganie wyciekom danych; Systemy i reguły monitorujące strumienie logów pod kątem przypadkowego ujawnienia poufnych rekordów.
RBAC – Role-Based Access Control – kontrola dostępu oparta na rolach; Mechanizm separacji uprawnień gwarantujący, że do logów wrażliwych mają dostęp tylko audytorzy.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Protokół szyfrujący przesyłanie logów przez niezaufane segmenty sieci lokalnej i rozległej.

21/55 Agent zbierający logi (praktyka)
Promtail - praktyka: Konfiguracja scrape_configs: job_name, static_configs/file_sd/kubernetes_sd, __path__ (glob). Pipeline stages (regex, JSON, labelmap, timestamp) wzbogacają logi o etykiety przed wysłaniem do Loki.

Promtail konfigurujesz zadaniami: co czytać, jak wzbogacić i dokąd wysłać. Pamiętaj o higienie etykiet.

  • Działanie na brzegu – agent zbierający powinien zużywać minimalną ilość zasobów procesora i pamięci RAM, nie zakłócając pracy aplikacji.
  • Przetwarzanie lokalne – wstępne parsowanie i przypisywanie metadanych na hoście odciąża centralne węzły klastra przyjmujące strumienie.
  • Obsługa ciśnienia wstecznego – agent musi bezpiecznie wstrzymać pobieranie nowych danych w sytuacji, gdy centralna baza jest przeciążona.
  • Buforowanie dyskowe – zapisywanie nieprzesłanych pakietów w pamięci lokalnej chroni przed utratą logów w trakcie przerw w łączności sieciowej.
  • Monitorowanie agentów – zbieranie metryk o liczbie przetworzonych wierszy i błędów pozwala w porę wykryć awarię samego potoku logowania.
scrape_configs: Konfiguracja celów zbierania (job_name, static/file/kubernetes discovery, glob __path__); pipeline stages wzbogacają logi o etykiety przed wysyłką.
plik config Promtail

Wysokowydajnym kolektorem i routerem danych telemetrycznych nowej generacji jest narzędzie Vector.

Konfiguracja Promtail w praktyce to gotowa do produkcji konfiguracja od wykrywania usług po wzbogacanie etykiet: scrape_configs (job_name, static_configs, file_sd, kubernetes_sd), wybór plików (glob patterns, __path__, exclude) i etykiety (static_labels, pipeline stages: regex, json, labelmap, timestamp, labels, output, match, drop, sampling). To praktyczna wiedza niezbędna do wdrożenia w Kubernetes, VM i bare metal (scrape_config, pipeline stages, service discovery, positions.yaml).

scrape_configs: job_name (logika grupowania - np. "nginx", "app", "kubernetes-pods"), static_configs (targets: __address__, __path__ - dla VM/bare metal), file_sd (pliki JSON/YAML generowane przez CI/CD - dynamiczne targety), kubernetes_sd (role: pod/container, label selectors, wykrywanie namespace - konfiguracja zero-touch w K8s). Wykrywanie usług = konfiguracja zero-touch - nie edytujesz configu przy nowym podzie!

Wybór plików: __path__ (glob: /var/log/**/*.log, /var/log/nginx/*.log, /pods/*/*/*.log), exclude (access.log, debug.log, healthcheck.log - wysoki wolumen, niska wartość). Obsługa wildcard (**, *). Etykieta __path__ = ścieżka pliku źródłowego (debugowanie: skąd ten log?). Wykrywanie plików = dynamiczne - nowe pliki automatycznie śledzone.

Etykiety: static_labels (env=prod, cluster=eu-west-1, team=platform - stałe, niska kardynalność), pipeline stages (regex: ekstrakcja pól z treści, json: parsowanie logów JSON, labelmap: mapowanie wartości na etykiety, timestamp: ekstrakcja znacznika czasu z treści - KLUCZOWE!, labels: dodanie/nadpisanie etykiet na podstawie wyciągniętych pól, match: warunkowe stosowanie stadiów, drop: odrzucanie wpisów, sampling: próbkowanie). Wzbogacanie etykiet w agencie = odciążenie Loki, bogatszy kontekst przy dostarczaniu. Higiena etykiet = tylko ograniczona kardynalność! (status_code, method, handler - TAK; user_id, request_id, trace_id - NIE!).

Przykład konfiguracji: job_name: "nginx", static_configs: targets: ["localhost:9080"], pipeline_stages: [regex, labels]. Systemd: promtail.service, restart=always, User=promtail. Gotowość produkcyjna = monitorowany (promtail_build_info, promtail_config_last_reload_successful), wersjonowany (GitOps), testowany (najpierw staging). Logi Promtaila same w sobie → Loki (jedzenie własnego jedzenia).

Podsumowanie: scrape_configs (wykrywanie usług) + __path__ (glob) + pipeline stages (wzbogacanie etykiet) = gotowy do produkcji Promtail. Higiena etykiet = ograniczona kardynalność. Monitoruj sam Promtail. To nie "log shipper" - to procesor logów.

Przechodzimy teraz od teorii do praktyki wdrożenia - zastanowimy się, jak skonfigurować agenta zbierającego logi z poszczególnych węzłów i wysyłającego je do systemu agregacji. W ekosystemie Grafany rolę tę pełni Promtail, który nie jest prostym wysyłaczem plików, lecz pełnoprawnym procesorem potrafiącym wzbogacać logi o kontekstowe etykiety, zanim jeszcze trafią do Loki. Ta praktyczna wiedza przyda się zarówno przy Kubernetes, jak i przy maszynach wirtualnych.

Konfiguracja Promtail opiera się na sekcji scrape_configs: nazwa zadania, mechanizm wykrywania usług - od statycznych list, przez pliki CI/CD, po Kubernetesa - oraz wzorce glob czytanych plików. Najważniejszym elementem są etapy pipeline'u, w których operatory regex, parser JSON i mapowanie etykiet wyciągają z tekstu strukturalne pola i zamieniają je na etykiety. Pamiętajmy o higienie etykiet: nigdy nie tworzymy etykiet o nieograniczonej kardynalności, takich jak identyfikator użytkownika.

Wyjaśnienie skrótów użytych na slajdzie:
Vector – Vector data pipeline – potok danych telemetrycznych Vector; Nowoczesny, bezpieczny pamięciowo agent zbierający napisany w języku Rust.
Fluentd – Fluentd log collector – kolektor logów Fluentd; Otwarty agent logowania należący do fundacji CNCF, stosowany powszechnie w klastrach Kubernetes.
Rust – Rust programming language – język programowania Rust; Nowoczesny język systemowy gwarantujący brak wycieków pamięci i wyjątków typu null pointer w agencie Vector.
Go – Go programming language – język programowania Go; Język, w którym stworzono serwer Loki oraz agenta Promtail.
C – C programming language – język programowania C; Tradycyjny język uniksowy, w którym zaimplementowano klasyczne demony syslogd i rsyslog.

22/55 Logi w Grafana (panel Loki)
Panel Loki w Grafanie: LogQL query + Logs panel = tabela z Time, Labels, Line. Filtrowanie dwupoziomowe: label filtry (szybkie, indeksowane) → line filtry (precyzja). Live tailing = podgląd na żywo.

Panel Loki w Grafanie: etykiety tną szybko, linie precyzyjnie, a live tailing pokazuje na żywo.

  • Widok Explore – wbudowany w Grafanę interfejs eksploracji pozwala inżynierom na swobodne formułowanie zapytań bez budowy stałych paneli.
  • Wykres częstości wierszy – wizualny rozkład liczby wpisów w czasie pozwala błyskawicznie zidentyfikować momenty krytycznych incydentów.
  • Podział na strumienie – interfejs grupuje komunikaty według unikalnych etykiet, co ułatwia analizę zachowania poszczególnych instancji.
  • Interaktywne filtry – kliknięcie na wybraną wartość w logu automatycznie dodaje ją do zapytania, przyspieszając pracę analityczną.
  • Pulpity operacyjne – stałe panele logów mogą być łączone z metrykami biznesowymi, tworząc kompleksowe centra dowodzenia dla dyżurnych.
Filtrowanie dwupoziomowe: Najpierw szybkie filtry po indeksowanych etykietach, potem precyzyjne filtry linii; tabela Time-Labels-Line plus live tailing w panelu Logs.
logi w Grafana
Loki kontra ELK - jak podejmować decyzję: Wybór między Loki a ELK to klasyczny kompromis inżynierski: koszt i prostota kontra prędkość wyszukiwania ad-hoc. Jeśli szukasz rzadkiego numeru PESEL w miliardzie wierszy sprzed roku, Elasticsearch znajdzie go w 20 milisekund dzięki indeksowi. Jeśli jednak potrzebujesz logów głównie do diagnozowania bieżących incydentów w Kubernetes i zależy Ci na niskich kosztach infrastruktury, Loki jest bezkonkurencyjne.

Panel logów Loki w Grafanie to narzędzie do ad-hoc analizy logów i debugowania na żywo podczas incydentów - interfejs, którego inżynier on-call używa w stresie: szybki, intuicyjny, z kontekstem. Składają się na niego wizualizacja logów, zapytanie LogQL (filtry etykiet, filtry linii, parsowanie JSON, pipeline), podświetlanie pól (derived fields, podświetlanie etykiet, linki do trace) i live tailing (strumieniowanie logów w czasie rzeczywistym: monitorowanie canary, debugowanie incydentów); to zunifikowane rozwiązywanie problemów - metryki + logi + trace w jednym dashboardzie.

Panel logów - wizualizacja: Data source: Loki. Zapytanie LogQL: {job="nginx"} |= "error" | json | line_format "{{.message}}" → tabela: Time, Labels, Line. Kolumny: Time (timestamp), Labels (etykiety strumienia), Line (treść logu). Live tailing (auto-refresh 5-10s): nowe logi pojawiają się na górze w czasie rzeczywistym. Strumieniowanie w czasie rzeczywistym = monitorowanie wdrożenia canary (widzę nowe błędy od razu), debugowanie incydentów na żywo (widzę postęp naprawy). Zawijanie linii / rozwijanie = czytelność stack trace'ów.

Filtrowanie - dwupoziomowe (klucz do wydajności): Filtry etykiet (w zapytaniu, przed pobraniem danych): {job="nginx", env="prod"} - filtruje strumienie na poziomie indeksu etykiet Loki (szybkie, O(1), indeksowane). Filtry linii (po pobraniu, na liniach w pamięci): |= "error" (contains), != "health" (not contains), |~ "timeout.*" (regex match, RE2), !~ "debug" (regex not match). Pola pochodne: parsowanie JSON (| json), wyciąganie pól (| line_format "{{.request_id}}"), linki do trace (traceID → link do Tempo/Jaeger). Potężne filtrowanie = precyzyjne wyciąganie igły ze stogu siana. zawsze najpierw stosuj filtr etykiet!

Integracja metryk i logów - zunifikowane rozwiązywanie problemów: Ten sam dashboard → panel metryk (skok latencji p99, wskaźnik błędów) + panel logów (błędy w tym samym czasie) + wspólny zakres czasowy + zmienne ($instance filtruje OBA panele). Korelacja: widzisz skok latencji na wykresie metryk → patrzysz na panel logów w tym samym oknie czasowym → widzisz ERROR connection pool exhausted, WARN slow query > 5s → pierwotna przyczyna w 30 sekund. Zunifikowane rozwiązywanie problemów = metryki + logi + wspólny kontekst (zakres czasowy, zmienne). To "killer feature" Grafana+Loki+Prometheus.

Terminologia: log panel (panel logów), Explore (tryb eksploracji), LogQL (zapytania Loki), derived fields (pola pochodne), label filters (filtry etykiet - szybkie), line filters (filtry linii - precyzyjne), live tailing (podgląd na żywo), correlation (korelacja), metrics-logs correlation (korelacja metryk i logów), trace correlation (korelacja śladów).

Po skonfigurowaniu agenta zbierającego logi i wysłaniu ich do Loki pozostaje ich wizualizacja i przeszukiwanie w interfejsie, z którego inżynier on-call będzie korzystał w warunkach presji czasowej. Grafana udostępnia dedykowany panel logów zintegrowany z Loki, który łączy szybkość filtrowania po etykietach z precyzją przeszukiwania treści linii. To narzędzie łączy się też z metrykami Prometheus w jeden zunifikowany widok rozwiązywania problemów.

Podstawą zapytania jest selektor etykiet ograniczający zbiór do konkretnej aplikacji i środowiska - to szybkie, indeksowane filtrowanie, które wykonujemy zawsze najpierw. Dopiero na tak zawężonych strumieniach stosujemy operatory tekstowe, jak wyszukiwanie frazy czy wyrażenia regularne, aby znaleźć konkretne wzorce w treści. Zaawansowane opcje obejmują parsowanie pól JSON i tworzenie pól pochodnych generujących linki do śladów w Tempo lub Jaeger. Istotny jest też podgląd na żywo przy wdrożeniu kanarkowym.

Wyjaśnienie skrótów użytych na slajdzie:
GUI – Graphical User Interface – graficzny interfejs użytkownika; Konsola Grafany umożliwiająca interaktywne przeszukiwanie strumieni i podgląd szczegółów pól.
UX – User Experience – doświadczenie użytkownika; Ergonomia panelu logów umożliwiająca szybkie zwijanie i rozwijanie wielolinijkowych zrzutów błędów.
LogQL – Log Query Language – język zapytań LogQL; Składnia zapytań wprowadzana w edytorze panelu logów Grafany.
UI – User Interface – interfejs użytkownika; Kolorystyczne wyróżnienie poziomów logowania (czerwony dla error, żółty dla warn) w widoku tabeli.
API – Application Programming Interface – interfejs programistyczny; Kanał asynchronicznego pobierania kolejnych partii logów podczas przewijania panelu.

23/55 Analiza błędów aplikacji
Analiza błędów aplikacji: Workflow: log → stack trace → lokalizacja w kodzie → kontekst (request_id, version) → hipoteza → fix → canary deploy → monitor → verify. Blameless culture = focus na system.

Od linii logu do poprawki prowadzi łańcuch: kod, kontekst, hipoteza i pętla canary. Bez kultury blameless nie zadziała.

  • Wyjątki w kodzie – analiza zrzutów błędów w logach pozwala programistom prześledzić dokładną sekwencję wywołań funkcji przed wystąpieniem błędu.
  • Kody błędów HTTP – analiza częstości występowania odpowiedzi z rodziny 500 pozwala natychmiast odróżnić awarię serwera od pomyłek klientów.
  • Czas trwania zapytań – rejestrowanie opóźnień w logach aplikacyjnych pomaga zidentyfikować powolne zapytania SQL blokujące całą platformę.
  • Wyczerpanie zasobów – komunikaty o braku pamięci lub przepełnieniu puli połączeń sygnalizują konieczność pilnego skalowania środowiska.
  • Systematyka naprawy – zlokalizowanie powtarzających się wzorców błędów w logach pozwala na trwałe usunięcie wady w kolejnym wydaniu kodu.
Stack trace: Ślad stosu w logu prowadzący do lokalizacji błędu w kodzie; workflow log → kod → kontekst → hipoteza → fix → canary → weryfikacja w kulturze blameless.
ślad błędu

Analiza błędów aplikacji to kompletny workflow od logu do naprawy w production: log → trace → kod → fix → test → deploy → monitor → verify. Obejmuje lokalizację w kodzie (parsowanie stack trace, source maps), okoliczności występowania (ekstrakcja kontekstu: request, user, env, wersja), naprawę i wdrożenie (fix, test, canary deploy, monitor) oraz analizę studium przypadku; efektem jest analiza przyczyn źródłowych i bezpieczny powrót do poprzedniej wersji.

Lokalizacja w kodzie: Parsowanie stack trace (plik:linia:funkcja, zależne od frameworku: Java NullPointerException at com.example.Service.method:42, Go panic: runtime error: index out of range [3] with length 3, Python Traceback: File "app.py", line 42, in func). Source maps / symbole debug = precyzyjna lokalizacja (zminifikowany JS, skompilowany Go/Rust). Integracja z IDE (IntelliJ IDEA, VS Code, GoLand) = skok do linii z logu. Narzędzia do śledzenia błędów (Sentry, Rollbar, Datadog APM) = automatyczne grupowanie, alerting, kontekst.

Okoliczności występowania: Ekstrakcja kontekstu z logów: request_id (korelacja śladów), user_id (ocena wpływu), session_id, env (prod/staging/canary), wersja wdrożenia (git sha, tag), feature flags (on/off). Skorelowane dane = szybsze triage. "Kiedy, gdzie, kto, co, wersja" = pełny kontekst. LogQL: |= "ERROR" | json | line_format "{{.request_id}} {{.user_id}} {{.version}}" → eksport do CSV → analiza.

Naprawa i wdrożenie: Fix (zmiana kodu, poprawka konfiguracji, aktualizacja zależności, podniesienie limitu zasobów) → Test (jednostkowe, integracyjne, kontraktowe, testy obciążeniowe, chaos engineering) → Deploy (canary/blue-green, automatyczny rollback na naruszenie SLO wskaźnika błędów/latencji) → Monitor (wskaźnik błędów, latencja p99, metryki biznesowe, wolumen logów) → Verify (metryki wracają do bazy, brak nowych wzorców błędów). Plan powrotu = zabezpieczenie (git revert, helm rollback, przerwanie argo rollouts). Fix → Deploy → Verify = zamknięta pętla. Kultura bez winy = skupienie na systemie, nie na osobie.

Analiza studium przypadku - realny przykład: Deploy v2.3.1 → skok latencji p99 200ms→2s w OrderService → hipoteza: "Nowy endpoint /api/reports powoduje rywalizację o blokady DB" → Weryfikacja: logi DB pokazują lock wait na tabeli orders, explain plan = brakujący indeks → Fix: dodaj indeks + limit puli połączeń (20→50) → Canary deploy (5% ruchu, 10 min) → Monitor: wskaźnik błędów 0%, p99 180ms → wdrożenie 100%. Timeline: wykrycie 2 min, diagnoza 10 min, naprawa 30 min, weryfikacja 5 min. Łączny MTTR = 47 min. Wnioski: bramka code review (sprawdzenie indeksu), test integracyjny (test obciążeniowy), feature flag (wyłącznik awaryjny).

Podsumowanie: Log → Stack trace → Lokalizacja w kodzie → Kontekst (request_id, wersja, env) → Hipoteza → Fix → Canary → Monitor → Verify = systematyczne debugowanie. Przyczyna źródłowa = problem systemu, nie błąd człowieka. Utrwalić uczenie = aktualizacja runbooka.

Sam alert z dashboarda i wykres oparty na metrykach pokazują, że coś się dzieje, ale nie mówią, co dokładnie zawiodło - to logi dają odpowiedź dlaczego. Właśnie dlatego ta slajda zaczyna się od pytania, jak z surowego wpisu dojść do naprawy: analiza błędu to kompletny workflow, który startuje od pojedynczej linii logu, prowadzi przez lokalizację w kodzie i zrozumienie okoliczności, a kończy się wdrożeniem poprawki oraz weryfikacją, że problem wrócił do bazy. Zachowanie tej podróży jest celem dzisiejszych ćwiczeń.

Droga jest prosta: log, stack trace, lokalizacja w kodzie, kontekst i hipoteza, a potem zamknięta pętla naprawy - fix, test, canary deploy, monitor, verify. Stack trace podaje precyzyjne położenie w formacie plik, linia, funkcja, a narzędzia jak Sentry czy Datadog APM automatyzują grupowanie błędów; dla zminifikowanego JavaScriptu czy skompilowanego Go używa się source maps. Kontekst - request_id, wersja wdrożenia i feature flags - pozwala szybko ocenić wpływ, a kultura bez obwiniania kieruje uwagę na system, nie na osobę.

Wyjaśnienie skrótów użytych na slajdzie:
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji; Standard komunikacyjny generujący kody 4xx (błędy klienta) i 5xx (awarie serwera).
REST – Representational State Transfer – architektura usług sieciowych; Styl projektowania interfejsów, w którym każdy błąd biznesowy powinien zwracać ustrukturyzowany komunikat.
SQL – Structured Query Language – język zapytań bazodanowych; Język operacji na danych; logi aplikacji rejestrują błędy składniowe i przekroczenia limitów czasu zapytań (timeouts).
JVM – Java Virtual Machine – maszyna wirtualna Java; Środowisko generujące specyficzne wyjątki (np. NullPointerException, OutOfMemoryError) w logach.
StackTrace – Stack Traceback – zrzut stosu wywołań; Hierarchiczna lista wywołań funkcji w momencie wystąpienia błędu, kluczowa dla diagnostyki programistycznej.

24/55 Logi urządzeń sieciowych
Logi urządzeń sieciowych: Routery, switche, firewalle wysyłają logi via syslog (UDP 514, TCP 601, TLS 6514). Format: RFC 5424 (structured) vs RFC 3164 (legacy). Centralizacja eliminuje blind spot w obserwowalności.

Sieć nie ma agentów, więc sama wysyła logi syslogiem. Gdy pada sieć, pada wszystko - razem z monitoringiem.

  • Kolektory sieciowe – przełączniki, routery i zapory sieciowe przesyłają swoje komunikaty diagnostyczne za pomocą protokołu syslog.
  • Zdarzenia sprzętowe – logi sieciowe rejestrują zmiany stanu portów, przeliczenia tablic routingu oraz błędy transmisji na kablach.
  • Bezpieczeństwo obwodowe – rejestry zapór sieciowych dokumentują odrzucone pakiety, próby skanowania portów oraz podejrzany ruch z zewnątrz.
  • Wydzielone sieci zarządzające – ruch z logami urządzeń sieciowych powinien płynąć w izolowanym segmencie, chroniąc dane przed podsłuchem.
  • Korelacja z aplikacjami – jednoczesna analiza logów sieciowych i aplikacyjnych pozwala odróżnić usterkę serwera od fizycznej awarii łącza.
RFC 5424: Strukturalny format sysloga (wobec legacy RFC 3164); routery i firewalle wysyłają logi przez UDP 514, TCP 601 lub TLS 6514, a centralizacja usuwa ślepy punkt.
syslog z urządzeń

Logi urządzeń sieciowych są kluczowe dla widoczności infrastruktury, która często bywa martwym punktem w obserwowalności - sieć to fundament, jak sieć nie działa, nic nie działa. Wysyłka do centrali idzie przez serwer syslog (UDP 514, TCP 601, TLS 6514), format to RFC 5424 (structured syslog) lub RFC 3164 (legacy), a urządzenia sieciowe bywają jedynym źródłem logów (brak agentów i sidecarów): syslog, remote logging, PRI, facility, severity.

Wysyłka do centrali (serwer syslog): UDP 514 (szybki, lossy - akceptowalny dla wysokiego wolumenu/niskiej wartości), TCP 601 (niezawodny, uporządkowany, bez utrat), TLS 6514 (szyfrowany, uwierzytelniony - wymóg bezpieczeństwa). Centralny serwer syslog: rsyslog (standard Linux), syslog-ng (zaawansowany), odbiornik syslog Loki+Promtail (natywna dostawa do Loki). Niezawodność: TCP/TLS + kolejka dyskowa + retry = zero utrat. Segmentacja sieci: VLAN zarządzania, dedykowana karta sieciowa, reguły firewalla (zezwól UDP 514, TCP 601 i TLS 6514 tylko z urządzeń sieciowych).

Format standardowy: RFC 5424 (structured syslog: PRI, VERSION, TIMESTAMP, HOSTNAME, APP-NAME, PROCID, MSGID, STRUCTURED-DATA, MSG) vs RFC 3164 (legacy: PRI, TIMESTAMP, HOSTNAME, MSG). Parsowanie: RFC 5424 = pola strukturalne (SD-ELEMENTS), łatwiejsze parsowanie, rozszerzalny. RFC 3164 = legacy, parsowanie regex, ograniczone pola. Standaryzacja = parsowalność = przeszukiwalność. Cisco IOS/IOS-XE, Juniper JunOS, Arista EOS, MikroTik RouterOS - wszystkie wspierają RFC 5424.

Logi z urządzeń = eliminacja martwego punktu: Sieć często bywa martwym punktem (brak metryk, brak trace). Centralizacja syslog = widoczność: link flapping (interface up/down), ACL denies (bezpieczeństwo), skoki CPU/memory (pojemność), zmiany konfiguracji (audyt), zdarzenia bezpieczeństwa (odmowa ACL, błąd uwierzytelniania, BGP hijack). Sieć = część obserwowalności! Korelacja z metrykami (SNMP/telemetria) + logi = pełna obserwowalność sieci.

Podsumowanie: Syslog (UDP/TCP/TLS) → centralny serwer (rsyslog/Loki) → parsowanie (RFC 5424) → korelacja (metryki+logi). Sieć = eliminator martwych punktów. Standaryzacja formatu = parsowalność. Bezpieczeństwo: TLS + VLAN zarządzania.

Do tej pory mówiliśmy głównie o logach aplikacji i serwerów, ale w obserwowalności istnieje obszar, o którym łatwo zapomnieć: sieć. Routery, przełączniki i firewalle nie mają agentów ani sidecarów, dlatego wysyłają swoje zdarzenia do centralnej kolekcji samodzielnie. A gdy sieć nie działa, nie działa nic - znikają i metryki, i logi, często razem z systemem monitorującym. Syslog staje się więc podstawowym kanałem informacji o stanach łączy, politykach ACL czy zmianach w routingu.

Transport opiera się na syslogu: UDP 514 jest szybki, ale bywa zawodny, TCP 601 daje niezawodność, a TLS 6514 szyfrowanie. Format RFC 5424 wprowadza strukturę - oddzielne pola PRI, timestamp, hostname i sekcję STRUCTURED-DATA - podczas gdy legacyjny RFC 3164 ma pola ograniczone i wymaga parsowania wyrażeniami regularnymi. Centralnym serwerem może być rsyslog albo odbiornik syslog wbudowany w Promtail, przekazujący logi wprost do Lokiego; dzięki standaryzacji logi Cisco i MikroTika są równie parsowalne jak logi aplikacji.

Wyjaśnienie skrótów użytych na slajdzie:
SNMP – Simple Network Management Protocol – prosty protokół zarządzania siecią; Protokół odpytywania liczników urządzeń sieciowych, uzupełniany przez strumienie zdarzeń syslog.
CLI – Command Line Interface – interfejs wiersza poleceń; Konsola routera sieciowego, na której konfiguruje się parametry wysyłania zdarzeń do zdalnego serwera.
IOS – Internetwork Operating System – sieciowy system operacyjny Cisco; System operacyjny przełączników i routerów Cisco wysyłający komunikaty o stanie portów.
ROS – RouterOS – system operacyjny MikroTik RouterOS; Oprogramowanie routerów MikroTik z wbudowanym elastycznym modułem reguł logowania zdarzeń.
UDP – User Datagram Protocol – protokół datagramów użytkownika; Domyślny protokół transportowy komunikatów syslog w sieciach komputerowych.

25/55 Syslog w Cisco IOS (przykład)
Syslog w Cisco IOS: logging host - adres serwera syslog, logging trap - poziom (0=emerg..7=debug). Produkcja: informational (6). Weryfikacja: show logging. Źródło: logging source-interface.

W Cisco trzy komendy wystarczą: gdzie wysyłać, co wysyłać i skąd. Poziom 6 to złoty środek produkcji.

  • Konfiguracja Cisco IOS – polecenie logging pozwala na skierowanie komunikatów urządzenia na adres centralnego serwera syslog w sieci.
  • Poziomy ważności Cisco – system operacyjny stosuje ośmiostopniową skalę ważności zdarzeń, od sytuacji awaryjnych po komunikaty debugowania.
  • Precyzja znaczników czasu – włączenie komendy service timestamps gwarantuje dodawanie dokładnej daty w standardzie UTC do każdego wpisu.
  • Bufor lokalny – urządzenie utrzymuje w pamięci RAM podręczny rejestr ostatnich zdarzeń, dostępny z konsoli poleceniem show logging.
  • Dobre praktyki sieciowe – zaleca się rezerwowanie przesyłania przez sieć dla komunikatów o poziomie ostrzegawczym i wyższym.
logging trap: Poziom zdarzeń (0-7) opuszczających router do centrali; w produkcji informational (6), adres serwera wyznacza logging host, a weryfikację daje show logging.
konfiguracja IOS
CLI · Cisco IOS: konfiguracja syslog
Router(config)# logging host 192.168.10.10 Router(config)# logging trap informational Router(config)# end Router# show logging Syslog logging: enabled

Zgodnie ze specyfikacją IETF RFC 5424 urządzenia sieciowe Cisco przesyłają komunikaty Syslog z precyzyjnym priorytetem (Facility i Severity) oraz stemplem czasowym.

Konfiguracja syslog w Cisco IOS/IOS-XE to zweryfikowane polecenia z laboratorium, nie teoria: ustawienie poziomu logowania (logging trap), konfiguracja hosta docelowego (logging host), interfejs źródłowy i usługa znaczników czasu oraz weryfikacja (show logging). To praktyczna wiedza dla inżynierów sieci (syslog, Cisco IOS, trap, logging host, source-interface, timestamp).

Ustawienie poziomu: logging trap (0=emergencje, 1=alerts, 2=critical, 3=errors, 4=warnings, 5=notifications, 6=informational, 7=debugging). Produkcja: informational (6) lub notifications (5) - balans między widocznością a wolumenem. Debug (7) = szczegółowy, WYŁĄCZNIE do troubleshootingu (włącz na 15 min, potem wyłącz). Poziom trap = filtr tego, co idzie do serwera syslog (nie loguj DEBUG do centrali!). logging buffered = lokalny bufor w pamięci routera.

Konfiguracja hosta: logging host [transport udp/tcp] [port ]. UDP 514 domyślnie, TCP 601 dla niezawodności (logging host transport tcp port 601), TLS dla bezpieczeństwa - RFC 5425 na porcie 6514 (w IOS-XE: logging host transport tcp port 6514 + logging secure). Można wiele hostów (redundancja: logging host 192.168.10.10, logging host 192.168.10.11). Interfejs źródłowy (logging source-interface Loopback0) = spójny adres IP źródłowy (ważne dla reguł firewalla). logging facility = kod facility dla filtrowania po stronie serwera.

Weryfikacja: show logging (status, host, poziom trap, odrzucone komunikaty, buforowane logi), show logging | include . Test: logger test message (wysyła log testowy) → sprawdź na serwerze syslog. Rozwiązywanie problemów: firewall (ACL blokuje UDP 514), routing (brak trasy do serwera), certyfikat TLS (self-signed vs CA), straty kolejki (logging queue-limit).

Blok CLI: logging host 192.168.10.10 → logging trap informational → logging source-interface Loopback0 → service timestamps log datetime msec → end → show logging. Wynik: Syslog logging: enabled, host 192.168.10.10, trap level: informational, source interface: Loopback0. Zweryfikowane w laboratorium (Cisco ISR 4331, IOS-XE 17.6).

Podsumowanie: logging host + logging trap + logging source-interface + service timestamps = konfiguracja syslog gotowa do produkcji. Test: logger. Monitor: show logging (odrzucenia). Dalej: dostawa do ELK/Loki przez odbiornik syslog Promtaila.

Po kolejnych slajdach o teorii syslogu i formatach czas zobaczyć, jak ta konfiguracja wygląda na prawdziwym sprzęcie. Cisco IOS jest dobrym punktem wyjścia, bo jego polecenia to zweryfikowane praktyki z laboratorium, a nie abstrakcyjna teoria. Słowo kluczowe, które warto zapamiętać, to trap: określa ono nie tylko dokąd logi mają trafić, ale też który poziom zdarzeń w ogóle opuści router i pojedzie do centralnego serwera. Bez takiego filtra każde debuggowanie zalałoby centralę milionami wpisów.

Konfiguracja składa się z trzech poleceń: logging host wskazuje adres serwera syslog, domyślnie po UDP 514, logging trap ustawia poziom w skali od zera czyli emergencji do siódemki czyli debugowania, a produkcja wybiera najczęściej poziom 6 informational, łączący widoczność z umiarkowanym wolumenem. Warto dodać logging source-interface, by router używał spójnego adresu źródłowego, co ułatwia reguły firewalla, oraz service timestamps. Weryfikację daje show logging, a testowy wpis wyślemy poleceniem logger i odszukamy na serwerze syslog.

Wyjaśnienie skrótów użytych na slajdzie:
IOS – Internetwork Operating System – sieciowy system operacyjny Cisco; System Cisco, w którym polecenie logging host definiuje centralny serwer logów.
CLI – Command Line Interface – interfejs wiersza poleceń; Środowisko wprowadzania poleceń konfiguracyjnych w trybie uprzywilejowanym (enable).
SSH – Secure Shell – bezpieczna powłoka; Zaszyfrowany protokół dostępu zdalnego do konfiguracji urządzeń Cisco.
NTP – Network Time Protocol – protokół synchronizacji czasu; Kluczowa usługa na routerze Cisco zapewniająca, że znaczniki czasu w logach są zgodne z zegarem atomowym.
UDP – User Datagram Protocol – protokół transportu datagramów; Protokół bezpołączeniowy transportujący ramki syslog na standardowy port 514.

26/55 Syslog w RouterOS (przykład)
Syslog w RouterOS: MikroTik RouterOS wysyła logi przez /system logging action (target=remote). Topics = filtry (system, interface, firewall, routing). Format: BSD syslog (UDP 514).

RouterOS myśli parami akcja-temat: dokąd wysłać plus co wysłać. Weryfikacja jednym printem.

  • Elastyczność RouterOS – system operacyjny urządzeń MikroTik posiada rozbudowany moduł logowania oparty na regułach filtrowania tematów.
  • Cele logowania (actions) – komunikaty mogą być równolegle zapisywane w pamięci RAM, na dysku flash lub wysyłane do serwera syslog.
  • Prefiksy komunikatów – dodawanie unikalnych prefiksów do wpisów z poszczególnych routerów ułatwia ich późniejszą identyfikację w centrali.
  • Rejestracja reguł zapory – administrator może włączyć logowanie pakietów pasujących do konkretnych reguł ochronnych w celu analizy ataków.
  • Higiena pamięci flash – należy unikać zbyt intensywnego zapisywania logów na wbudowanej pamięci routera, aby zapobiec jej zużyciu.
Topics: Filtry tematów zdarzeń w RouterOS (system, interface, firewall, routing); akcja /system logging action z target=remote wysyła logi w formacie BSD syslog.
CLI RouterOS
CLI · RouterOS: wysyłka logów syslog
# tworzymy akcję wysyłającą logi do sysloga (UDP 514) [admin@MikroTik] > /system logging action add name=remote target=remote remote=192.168.10.10 remote-port=514 [admin@MikroTik] > /system logging add topics=system,interface action=remote [admin@MikroTik] > /system logging print Flags: * - DEFAULT Columns: TOPICS, ACTION # TOPICS ACTION 0 * info memory 4 system remote interface

Konfiguracja syslog w MikroTik RouterOS (v6/v7, CHR i sprzęt) opiera się na czterech elementach: target remote (definicja akcji wysyłającej logi), adres serwera syslog, topics (filtry co logować) i weryfikacja. MikroTik jest popularny w SMB i ISP, a jego logi są cenne dla obserwowalności (RouterOS, syslog, remote logging, action, target, topics, bsd-syslog).

Target remote - definicja akcji: /system logging action add name=remote target=remote remote= remote-port=514. Target=remote = syslog over UDP (tylko UDP w RouterOS v6, v7 dodaje TCP). Remote-port = 514 (domyślnie). Opcje: src-address (adres źródłowy - interfejs loopback), bsd-syslog=yes (format RFC 3164, domyślnie), syslog-facility (local0-local7). Dla HA: dwie akcje z różnymi adresami IP (name=remote1, name=remote2).

Adres serwera: remote= (np. 192.168.10.10). Obsługa nazw DNS (jeśli DNS działa - /ip dns set servers=...). Firewall: /ip firewall filter add chain=output protocol=udp dst-port=514 action=accept (wychodzący). Dla TLS: RouterOS v7 ma eksperymentalne wsparcie, v6 - nie. Obejście: stunnel lub przekaźnik rsyslog z TLS.

Topics - co logować: /system logging add topics=system,interface,firewall,routing action=remote. Topics: system (ogólne), interface (link up/down), firewall (odmowy ACL), routing (zmiany BGP/OSPF), wireless, dhcp, ppp, hotspot. Precyzja: topics=firewall,!firewall.info (wszystko firewall oprócz info). /system logging print = weryfikacja.

Przykład z konsoli RouterOS: /system logging action add name=remote target=remote remote=192.168.10.10 remote-port=514 → /system logging add topics=system,interface,firewall action=remote → /system logging print. Wynik: topics=system,interface,firewall action=remote. Zweryfikowane na CHR 7.12 / RB4011.

Scheduler dla automatyzacji: /system scheduler add name=log_check interval=1m on-event="/system script run check_logs". Monitorowanie logów = proaktywne. Dalej: eksport metryk do Prometheus (routeros_exporter) → alerting. Logi RouterOS = eliminator martwych punktów sieci.

MikroTik RouterOS to druga platforma z praktyki inżynierskiej, szczególnie powszechna w małych i średnich firmach oraz u operatorów ISP. Filozofia konfiguracji różni się od Cisco, bo opiera się na parach akcja i topic: najpierw definiujemy akcję, która opisuje, dokąd logi mają się udać, a potem mówimy systemowi, które tematy zdarzeń wysyłać. Taki podział przypomina znane już państwu zasady - najpierw jasno określamy cel, potem precyzyjny filtr, a na końcu weryfikujemy efekt.

W praktyce zaczynamy od /system logging action add, gdzie target równy remote i port 514 oznaczają wysyłkę po UDP; RouterOS w wersji 6 używa wyłącznie tego protokołu i formatu BSD syslog, a wersja 7 dodaje TCP. Topics to gotowe kategorie - system, interface, firewall, routing - które można precyzyjnie zawężać. Efekt sprawdzamy poleceniem /system logging print; całość zweryfikowano na CHR 7.12 i RB4011. Dla proaktywnego podejścia można dodać scheduler z cyklicznym przeglądem logów.

Wyjaśnienie skrótów użytych na slajdzie:
ROS – RouterOS – system operacyjny MikroTik RouterOS; System urządzeń MikroTik konfigurujący cele logowania w menu /system logging.
API – Application Programming Interface – interfejs programistyczny; Programowy interfejs RouterOS pozwalający na pobieranie bufora logów przez zewnętrzne skrypty.
CLI – Command Line Interface – interfejs tekstowy wiersza poleceń; Konsola MikroTik RouterOS służąca do inspekcji logów poleceniem /log print.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Protokół szyfrujący logi przesyłane z RouterOS do nowoczesnych kolektorów sieciowych.
UDP – User Datagram Protocol – protokół datagramowy; Standardowy kanał wysyłania komunikatów o zdarzeniach sieciowych do zewnętrznego demona syslog.

27/55 Zbieranie logów aplikacji z Pythona
Logowanie w Pythonie: Moduł logging (stdlib) z handlerami: StreamHandler (stdout/Docker), FileHandler (plik), LokiHandler (HTTP push). Format JSON = structured logging, queryable.

W Pythonie nie printuj - loguj modułem logging: handlery, formaty i poziomy zamiast chaosu na konsoli.

  • Moduł logging w Pythonie – wbudowana w standardową bibliotekę języka architektura dostarcza elastyczny system rejestracji zdarzeń w aplikacjach.
  • Klasy formatujące – pozwalają na automatyczne przekształcanie komunikatów w czytelne obiekty formatu JSON wzbogacone o metadane.
  • Niezależne procedury obsługi – programista może równolegle wysyłać logi na standardowe wyjście konsoli oraz do pliku rotacyjnego na dysku.
  • Kontekst wykonania – zastosowanie filtrów pozwala na automatyczne dołączanie identyfikatorów wątków i żądań do każdego wywołania logera.
  • Standardy kodowania – aplikacje w kontenerach powinny zawsze emitować logi na standardowe wyjście, powierzając ich zbiór orkiestratorowi.
Handlery logowania: StreamHandler (stdout/Docker), FileHandler (plik), LokiHandler (HTTP push); format JSON czyni logi strukturalnymi i przeszukiwalnymi.
kod Python logging
CLI · Python: logowanie do pliku
import logging logging.basicConfig( filename='app.log', level=logging.INFO, format='%(asctime)s %(levelname)s %(message)s' ) logging.info('Aplikacja uruchomiona')

W środowiskach produkcyjnych nie należy stosować instrukcji print() ani bezpośredniego zapisu do plików z blokowaniem wątków. Zgodnie z oficjalną dokumentacją modułu logging w Pythonie, aplikacja powinna emitować ustrukturyzowane rekordy JSON na standardowe wyjście (sys.stdout). Przechwytywaniem strumienia zajmuje się środowisko uruchomieniowe kontenera, co gwarantuje wysoką wydajność i brak utraty danych.

Zbieranie logów z aplikacji Python zaczyna się w module logging (elastyczny, rozszerzalny, standardowa biblioteka): konfiguracja handlerów (StreamHandler, FileHandler, RotatingFileHandler, LokiHandler), formatowanie wpisów (JSON formatter, structured logging, python-json-logger) i wysyłka do centrali (LokiHandler, HTTP push do /loki/api/v1/push). To praktyczna integracja - od print do produkcyjnego logowania.

Konfiguracja handlerów: StreamHandler (stdout - przyjazny dla Docker, logi kontenerów), FileHandler (plik, rotacja przez RotatingFileHandler: maxBytes, backupCount), LokiHandler (grafana/loki-python lub własny HTTP push). Najlepsza praktyka: wiele handlerów (stdout + Loki) - stdout dla kubectl logs / docker logs, Loki dla centralizacji. logging.basicConfig() = szybka konfiguracja, production = konfiguracja jawna (dictConfig lub config YAML). Poziomy handlerów: StreamHandler=INFO, LokiHandler=INFO, FileHandler=DEBUG.

Formatowanie wpisów: JSON formatter (python-json-logger) = structured logging. Format: %(asctime)s %(levelname)s %(name)s %(message)s %(request_id)s %(user_id)s %(trace_id)s. JSON = parsowalne, przeszukiwalne, bez regex. Klasa formattera = pola własne (trace_id, span_id, user_id, wersja wdrożenia). Structured logging = przeszukiwalność. Middleware (FastAPI/Flask/Django) = automatyczne wstrzykiwanie request_id, trace_id do wpisu logu.

Wysyłka do centrali: LokiHandler (grafana/loki-python) - batching (batch_size, batch_wait), etykiety (app, env, version, instance), kompresja (gzip), retry (exponential backoff). Alternatywa: HTTP push do Loki /loki/api/v1/push (requests/httpx, async, własne etykiety, pełna kontrola). HTTP push = elastyczność, własna logika batchowania. Async (httpx/aiohttp) = nieblokujący dla aplikacji o wysokiej przepustowości.

Terminologia: logging module, handler, formatter, LokiHandler, structured logging, JSON logging, Loki push API, middleware, contextvars (propagacja request_id). Python logging = potężny, ale wymaga dyscypliny (struktura, kontekst).

Przechodzimy teraz od urządzeń sieciowych do warstwy aplikacji, bo logi powstające w kodzie bywają najbardziej wartościowe dla diagnostyki. W Pythonie logowanie zaczyna się nie od drukowania na konsolę, lecz od modułu logging z biblioteki standardowej, składającego się z handlerów decydujących o tym, dokąd trafi wpis, formaterów określających jego wygląd oraz poziomów dzielących komunikaty na krytyczne i informacyjne. Ten porządek sprawia, że aplikacja zamiast prymitywnych print produkuje uporządkowane dane.

Wybór handlera to pierwsza poważna decyzja: StreamHandler pisze na standardowe wyjście, co w kontenerach oznacza logowanie do docker logs, FileHandler trafia do pliku, a RotatingFileHandler obsługuje rotację przez maxBytes i backupCount. Do zestawu dochodzi LokiHandler wysyłający wpisy bezpośrednio do Lokiego. Prawdziwą zmianą jakościową jest jednak format JSON - structured logging wzbogacony o pola takie jak request_id czy trace_id zamienia tekst, który kiedyś wymagał wyrażeń regularnych, w struktury parsowalne bez żadnego regexu.

Wyjaśnienie skrótów użytych na slajdzie:
PEP – Python Enhancement Proposal – propozycja ulepszenia języka Python; Standardy kodowania w Pythonie promujące stosowanie modułu logging zamiast funkcji print.
SDK – Software Development Kit – zestaw narzędzi programistycznych; Biblioteki języka Python udostępniające gotowe klasy formatujące i wysyłające logi.
JSON – JavaScript Object Notation – notacja obiektowa JavaScript; Format generowany przez bibliotekę python-json-logger ułatwiający automatyczną analizę.
stdout – Standard Output Stream – standardowy strumień wyjściowy; Domyślny strumień procesów, do którego aplikacja powinna emitować logi w architekturze kontenerowej.
stderr – Standard Error Stream – standardowy strumień błędów; Dedykowany strumień wyjściowy procesów zarezerwowany dla krytycznych komunikatów awaryjnych.

28/55 Przekazywanie logów do Loki (Python)
Logi Python → Loki: Wysyłka via HTTP push do /loki/api/v1/push (JSON payload). Etykiety: app, env, version, instance - bounded cardinality. Batchowanie + retry = niezawodność.

Aplikacja sama pcha logi do Lokiego przez HTTP. Trzy technikalia: czas w nanosekundach, chude etykiety i batche.

  • Biblioteka python-logging-loki – dedykowany moduł umożliwia bezpośrednie przesyłanie logów z aplikacji Python do API systemu Loki.
  • Asynchroniczna wysyłka – buforowanie wpisów w osobnym wątku roboczym gwarantuje, że opóźnienia sieciowe nie spowolnią działania samej aplikacji.
  • Dynamiczne etykiety – biblioteka pozwala na przypisywanie etykiet strumienia bezpośrednio z poziomu kodu źródłowego programu.
  • Kolejkowanie w pamięci – w razie chwilowej niedostępności serwera Loki biblioteka przechowuje pakiety w bezpiecznym buforze pamięci RAM.
  • Wybór architektury – bezpośrednia wysyłka sprawdza się w prostych usługach, natomiast w dużej skali zaleca się stosowanie lokalnego agenta.
Bounded cardinality: Ograniczona liczba wartości etykiet (app, env, version, instance); wysyłka HTTP push na /loki/api/v1/push z batchowaniem i retry dla niezawodności.
integracja

Przekazywanie logów z Pythona do Loki to integracja end-to-end od kodu do zapytania w Grafanie: kod → HTTP push → Loki → LogQL → Grafana Explore. Składa się na nią wysyłka wpisów (HTTP push do /loki/api/v1/push, JSON payload, batching), etykiety aplikacji (app, env, version, instance - ograniczona kardynalność!), przykładowy kod (requests/httpx, logika retry, async) i weryfikacja przekazu (zapytanie LogQL w Grafana Explore); potok to Loki push API, Python logging, Loki handler, labels.

Wysyłka wpisów - HTTP Push: POST /loki/api/v1/push (JSON payload: streams: [{stream: {etykiety}, values: [[timestamp_ns, linia]]]}). Timestamp w nanosekundach (time.time_ns()). Batchowanie (batch_size: 100-1000 linii, flush_interval: 1-5s) = przepustowość. Retry z exponential backoff + jitter = niezawodność. Async (httpx/aiohttp) = nieblokujący. Nagłówki: Content-Type: application/json, X-Scope-OrgID (multi-tenancy).

Etykiety aplikacji - Labels: {app="myapp", env="prod", version="1.2.3", instance="pod-123"}. Etykiety statyczne (stałe: app, env) + dynamiczne (runtime: version, instance). Higiena etykiet = ograniczona kardynalność! Etykieta = wymiar zapytań. Przeładowanie etykiet (user_id, request_id, trace_id) = eksplozja kardynalności = awaria Loki. Tylko niska kardynalność: app, env, version, handler, status_code, method.

Przykład kodu Pythona: requests.post(url, json=payload, headers={"Content-Type": "application/json"}) + logika retry (tenacity/urllib3 retry). Async: httpx.AsyncClient.post(). Weryfikacja: Grafana Explore → LogQL: {app="myapp"} → sprawdź logi z poprawnymi etykietami. Test end-to-end = pewność.

Weryfikacja przekazu: Grafana Explore → zapytanie LogQL → widzisz logi z poprawnymi etykietami (app, env, version). Test alertingu: wygeneruj log błędu → sprawdź alert w Alertmanagerze. Weryfikacja end-to-end = pewność produkcyjna. Logi same w sobie (access.log) też do Loki (Promtail) = pełny obraz.

Podsumowanie: HTTP push + ograniczone etykiety + batching + retry = niezawodne dostarczanie. Weryfikacja = zapytanie Grafana Explore. Higiena etykiet = krytyczna dla stabilności Loki.

Skoro aplikacja w Pythonie potrafi już pisać logi w formacie JSON, naturalne pytanie brzmi: jak doprowadzić te wpisy do Lokiego, żeby można je było przeszukiwać w Grafanie. Odpowiedzią jest HTTP push, czyli bezpośrednie wysyłanie danych przez aplikację do punktu /loki/api/v1/push. To podejście uzupełnia poznane wcześniej ścieżki - promtail czytający pliki i odbiornik syslog - a jego siłą jest pełna kontrola nad tym, co, kiedy i z jakimi metadanymi opuszcza proces. Aplikacja przestaje być bierna i sama staje się dostawcą danych.

Technikalia to trzy sprawy. Znacznik czasu wysyłamy w nanosekundach, posługując się time.time_ns, a ładunek ma strukturę streams z etykietami i wartościami. Etykiety muszą pozostać w ograniczonej kardynalności: app, env, version i instance są właściwe, ale user_id czy request_id, które eksplodowałyby liczbą wartości, do Lokiego nie trafią. Batchowanie paczek po 100 do 1000 linii z kompresją gzip i ponawianiem zapewnia niezawodność, jakiej nie da wysyłka pojedynczych wpisów, a potwierdzeniem jest zapytanie LogQL w Grafana Explore.

Wyjaśnienie skrótów użytych na slajdzie:
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji; Protokół sieciowy używany do wysyłania partii logów bezpośrednio do endpointu bazy Loki.
REST – Representational State Transfer – architektura usług REST; Styl interfejsu API bazy Loki obsługujący żądania rejestracji strumieni.
JSON – JavaScript Object Notation – format serializacji danych; Format danych przesyłanych w ciele żądania POST do serwera logów.
POST – HTTP POST Method – metoda żądania HTTP POST; Metoda protokołu HTTP wykorzystywana do przesyłania nowych danych do bazy docelowej.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Szyfrowanie połączenia HTTP chroniące logi aplikacyjne przed podsłuchem w sieci.

29/55 Alerting na podstawie logów (wstęp)
Log-based alerting: Reguły alertowe oparte na LogQL - count_over_time, rate, pattern matching. Integracja z Alertmanager (routing, grouping, inhibition). Burn rate alerting = SLO-based (fast burn = page, slow burn = ticket).

Logi też budzą w nocy: LogQL liczy, Alertmanager wozi. Reguła: tempo, nie pojedynczy błąd.

  • Alerting z logów – pozwala na natychmiastowe wykrywanie specyficznych wyjątków w kodzie, które nie są widoczne w standardowych metrykach.
  • Komponent Loki Ruler – moduł regularnie wykonuje zapytania LogQL i generuje sygnały alarmowe przekazywane do Alertmanagera.
  • Zapytania o częstość błędów – reguły powinny badać liczbę wystąpień danego błędu w określonym oknie czasowym, a nie pojedyncze zdarzenia.
  • Higiena powiadomień – powiadomienia generowane na podstawie logów muszą posiadać wysoki próg istotności, aby nie wywoływać zmęczenia alertami.
  • Dokumentacja procedury – każdy wyemitowany alert powinien zawierać odnośnik do runbooka wyjaśniającego kroki diagnostyczne dla inżyniera.
SLO-based alerting: Alerty z burn rate - szybkie spalanie budżetu woła (page), wolne zakłada ticket; reguły LogQL integrują się z Alertmanagerem (routing, grouping, inhibition).
od logu do alertu

Alerting oparty na logach to most między logami a akcją (incydent, page, ticket): reguły oparte na LogQL (count_over_time, rate, pattern matching, reguły nagrywające), integracja z Alertmanagerem (wykład 6: routing, grouping, inhibition, silencing) i inżynieria progów (statyczne vs dynamiczne, alerting na tempo spalania budżetu). To kluczowy element proaktywnego monitorowania (log-based alerting, recording rules, SLO-based alerting).

Reguły na logach - alerty LogQL: count_over_time({job="api"} |= "error" [5m]) > 10 → alert (próg liczby błędów). rate({app="api"} |= "timeout" [5m]) > 0.1 → alert (próg tempa błędów). Reguły nagrywające: pre-compute ciężkich LogQL (count_over_time, rate, sum by) → alert na regule nagrywającej = wydajność (ewaluacja na pre-computowanej metryce, nie na surowych logach). Etykiety: severity (critical/warning), team (platform/payments), runbook_url (link do runbooka). Grafana Alerting / Loki Ruler = silnik ewaluacji.

Alertmanager (wykład 6): Routing (group_by: [alertname, team], group_wait: 30s, group_interval: 5m, repeat_interval: 4h), Inhibicja (critical wycisza warning - np. down bazy wycisza błędy aplikacji), Wyciszanie (okna konserwacji, wdrożenia), Odbiorcy (Slack, Email, PagerDuty, Opsgenie, Webhook, Microsoft Teams). Alerty wieloźródłowe (metryki Prometheus + logi Loki) = zunifikowany routing. Wysoka dostępność: klaster Alertmanager (3+ węzły, gossip).

Inżynieria progów: Próg statyczny (liczba błędów > 10) - prosty, ale sztywny (wzrost ruchu = fałszywe pozytywy). Próg dynamiczny (tempo > baza * 2, baza = 7d ta sama godzina/dzień) - adaptacyjny. Alerting na tempo spalania (oparty na SLO): szybkie spalanie (2% budżetu błędów/1h) = page (critical), wolne spalanie (10% budżetu błędów/6h) = ticket (warning). Alerty SLO na logach = precyzja (alert na wpływ biznesowy, nie na szum). Budżet błędów = wspólny język dev/ops.

Terminologia: log-based alerting (alerting na logach), LogQL alerting, reguła nagrywająca, alertmanager, burn rate (tempo spalania budżetu błędów), severity (critical/warning), inhibicja, wyciszanie. Alerting = akcja, nie szum.

Do tej pory logi służyły nam głównie do retrospektywnego przeglądania - teraz odwracamy perspektywę i sprawiamy, że logi same nas budzą w nocy. Alerting oparty na logach łączy świat metryk z poprzedniego wykładu ze światem logów: funkcje LogQL zamieniają ciągłe strumienie wpisów w liczby, a na tych liczbach budujemy reguły alertów. Zasada jest jak przy Prometheusie - nie chodzi o ostrzeganie przy każdym pojedynczym błędzie, ale o to, żeby zmiana tempa czy licznika uruchamiała powiadomienie wtedy, gdy faktycznie sygnalizuje problem.

Podstawą są funkcje takie jak count_over_time i rate, które w oknie czasowym liczą linie z błędem albo tempo ich pojawiania się i porównują z progiem. Ciężkie zapytania warto wyliczać wcześniej przez recording rules, aby alert działał na przygotowanej metryce. Za dostarczenie odpowiada znany z wykładu o metrykach Alertmanager - z routingiem, grupowaniem, inhibicją i wyciszaniem. Alerting na tempo spalania budżetu błędów, gdzie szybkie spalanie wywołuje page, a wolne ticket, pozwala ostrzegać o wpływie na SLO zamiast o szumie.

Wyjaśnienie skrótów użytych na slajdzie:
AM – Alertmanager – menedżer alertów Prometheus; Podsystem powiadomień odbierający sygnały alarmowe wygenerowane na podstawie reguł LogQL.
LogQL – Log Query Language – język zapytań LogQL; Język definiujący warunki alertowe (np. częstość występowania słowa 'Fatal' > 0 w 1 minucie).
PromQL – Prometheus Query Language – język zapytań Prometheus; Baza koncepcyjna dla reguł alertowych budowanych na metrykach wyekstrahowanych z logów.
Pager – Pager / On-call notification system – system powiadamiania dyżurnego; Urządzenie lub aplikacja mobilna wybudzająca inżyniera SRE w przypadku krytycznego błędu w logu.
SMS – Short Message Service – krótka wiadomość tekstowa; Kanał powiadamiania awaryjnego wykorzystywany przy braku łączności internetowej ze stacją roboczą.

30/55 Diagnostyka: plan postępowania
Plan diagnostyki: Systematyczny workflow: zawęź zakres (binary search) → sprawdź metryki i logi (data-driven) → postaw hipotezę (testable) → zweryfikuj i napraw. Metoda naukowa w SRE.

Dobrego diagnostę robi plan, nie narzędzia: zawęź, sprawdź dane, postaw testowalną hipotezę i domknij pętlę.

  • Ustalenie ram czasowych – pierwszym krokiem dochodzenia jest zidentyfikowanie dokładnego momentu rozpoczęcia degradacji wskaźników.
  • Identyfikacja komponentu – zawężenie poszukiwań do konkretnego mikroserwisu lub bazy danych pozwala odrzucić nieistotny szum informacyjny.
  • Wyszukiwanie krytycznych błędów – analiza wierszy tekstu skupia się na identyfikacji pierwszego unikalnego błędu, który zapoczątkował awarię.
  • Weryfikacja zależności – inżynier bada, czy problem nie wynika z niedostępności zewnętrznych systemów płatności lub usług bazodanowych.
  • Mitygacja i wnioski – po opanowaniu sytuacji zebrane logi stanowią kluczowy materiał dowodowy podczas tworzenia raportu powypadkowego.
Binary search: Zawężanie zakresu poszukiwań o połowę na kroku; z danymi (metryki, logi) i testowalną hipotezą tworzy metodę naukową w SRE.
schemat diagnostyki
Dobre praktyki logowania w Kubernetes: W kontenerach obowiązuje żelazna zasada 12-Factor App: aplikacja nigdy nie powinna sama zarządzać plikami dziennika ani ich rotacją. Zamiast tego wypisuje wszystko na standardowe wyjście (stdout) i wyjście błędów (stderr). Środowisko kontenerowe automatycznie przechwytuje te strumienie do plików na węźle, a centralny agent (taki jak Promtail uruchomiony jako DaemonSet) odczytuje je i przesyła do centrali.

Plan diagnostyki to metoda naukowa zastosowana do inżynierii production - nie zgadywanie, lecz systematyczne, powtarzalne podejście: zawężenie zakresu (redukcja zakresu), sprawdzenie metryk i logów (oparte na danych), postawienie hipotezy (debugowanie oparte na hipotezach), weryfikacja i naprawa (weryfikacja i naprawa). To daje powtarzalne wyniki (troubleshoot, hypothesis testing, scientific method, RCA, binary search, falsifiability).

Zawężenie zakresu - redukcja zakresu: Podejście top-down. Globalny objaw (skok latencji p99 200ms→2s) → który serwis? (topk po wskaźniku błędów / latencji per serwis) → który endpoint? (topk po latencji per handler/URL) → która instancja? (metryki per instancja: CPU, pamięć, GC, połączenia). Redukcja zakresu = szybsza izolacja (wyszukiwanie binarne w architekturze). Wyszukiwanie binarne w logach: zawężanie zakresu czasowego (pół godziny → 10 min → 1 min). Grafana: zmienne ($service, $endpoint, $instance) = dynamiczne zawężanie.

Sprawdzenie metryk i logów - oparte na danych: Najpierw metryki (latencja p99, wskaźnik błędów, nasycenie: CPU, pamięć, dysk, sieć, połączenia) → potem logi (błędy, stack trace, ostrzeżenia, korelacja). Metryki = CO/GDZIE (skala, lokalizacja), Logi = DLACZEGO (przyczyna, kontekst). Wyrównanie zakresów czasowych = KRYTYCZNE (to samo okno czasowe na wszystkich panelach). Grafana Explore split view = metryki + logi obok siebie, wspólny zakres czasowy, zmienne. To workflow: Dashboard (metryki) → Explore (logi) → Trace (Tempo).

Postawienie hipotezy - debugowanie oparte na hipotezach: Hipoteza = świadome przypuszczenie oparte na dowodach (nie zgadywanie!). "Skok CPU → presja GC" (predykcja: pauzy GC w logach, piłokształtne użycie heap) vs "skok CPU → wyczerpanie puli wątków" (predykcja: RejectedExecutionException, maksymalny rozmiar kolejki). Hipoteza = testowalna predykcja (fałsyfikowalna!). Falsyfikowalność = metoda naukowa. Jeśli hipoteza fałszywa → nowa hipoteza (metoda iteracyjna).

Weryfikacja i naprawa - weryfikacja & naprawa: Test hipotezy (skala: HPA/replicas, restart: pod rollout, poprawka configu: zmienna środowiskowa/limit, poprawka kodu: PR) → obserwuj metryki (latencja, wskaźnik błędów, nasycenie) → potwierdź rozwiązanie (metryki wracają do bazy) → udokumentuj (aktualizacja runbooka, działania z post-mortem). Weryfikacja = metryki wracają do bazy + brak nowych wzorców błędów. Monitorowanie po naprawie (30-60 min) = pewność braku regresji. Runbook = skodyfikowana wiedza (następnym razem: 5 min, nie 50 min).

Terminologia: troubleshoot (diagnozowanie), hypothesis testing (testowanie hipotez), scientific method (metoda naukowa), RCA (analiza przyczyn źródłowych), binary search (wyszukiwanie binarne), falsifiability (fałsyfikowalność). Systematyczne diagnozowanie = powtarzalne wyniki. Opanuj to = opanuj SRE.

Poprzednie slajdy pokazały mnóstwo narzędzi i składni, ale samo ich poznanie nie czyni jeszcze dobrego diagnosty. To, co odróżnia doświadczonych inżynierów od osób przypadkowo operujących konsolą, to plan: systematyczne, powtarzalne postępowanie przy każdej awarii. Ta slajda proponuje metodę naukową przeniesioną do świata produkcji - zamiast zgadywać, zawężamy zakres, opieramy się na danych i testujemy hipotezy, które można obalić. Kto tę metodę opanuje, opanuje w istocie sedno SRE.

Kolejność kroków ma uzasadnienie. Najpierw zawężamy obszar poszukiwań przez wyszukiwanie binarne: który serwis, który endpoint, która instancja - zostaje jeden kandydat zamiast całej architektury. Potem sprawdzamy metryki, które odpowiadają na pytanie co i gdzie, oraz logi tłumaczące dlaczego, pamiętając o wyrównaniu zakresów czasowych. Hipoteza musi być testowalna i fałsyfikowalna, a weryfikacja zamyka pętlę monitorowaniem po naprawie przez 30-60 minut i aktualizacją runbooka, by następnym razem diagnoza trwała pięć minut, a nie pięćdziesiąt.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Kultura operacyjna promująca usystematyzowane procedury dochodzenia poawaryjnego.
Runbook – Operational Runbook – instrukcja operacyjna procedur; Dokument techniczny krok po kroku opisujący ścieżkę analizy logów w typowych awariach.
SOP – Standard Operating Procedure – standardowa procedura operacyjna; Formalny zestaw wytycznych określający kolejność działań diagnostycznych w organizacji.
RCA – Root Cause Analysis – analiza przyczyn źródłowych; Końcowy etap procedury dochodzeniowej zmierzający do trwałej eliminacji usterki.
Incident – Major Incident Management – zarządzanie poważnymi incydentami; Procedura kryzysowa uruchamiana w momencie załamania parametrów jakościowych usługi.

31/55 Najczęstsze przyczyny awarii (logi)
Najczęstsze awarie: Misconfiguration (config drift, missing secrets, resource limits) - cichy killer. Błędy aplikacji - unhandled exceptions, resource leaks, deadlocks. Problemy sieciowe - DNS failure, timeout, TLS errors.

Większość awarii to trzy wzorce: konfiguracja, kod albo sieć. Nazwij kategorię, a MTTR spada z godzin do sekund.

  • Błędy połączeń z bazą – wyczerpanie puli połączeń lub przeciążenie bazy danych jest jedną z najczęstszych przyczyn awarii aplikacji.
  • Niedostępność usług zależnych – awaria zewnętrznego API lub przekroczenie limitów czasu odpowiedzi paraliżuje działanie serwisów potomnych.
  • Błędy autoryzacji i certyfikatów – wygaśnięcie klucza TLS lub brak uprawnień procesowych objawia się nagłą lawiną błędów w logach.
  • Błędy nowo wdrożonego kodu – niesprawdzone wyjątki programistyczne ujawniają się bezpośrednio po publikacji nowego wydania oprogramowania.
  • Przepełnienie pamięci masowej – brak wolnego miejsca na dyskach uniemożliwia zapisywanie transakcji i prowadzi do zawieszenia procesów.
Misconfiguration: Błędna konfiguracja (dryft, brak sekretów, limity zasobów) - cichy zabójca; obok błędów aplikacji (wyjątki, wycieki, deadlocki) i sieci (DNS, timeouty, TLS).
katalog wzorców

Najczęstsze przyczyny awarii widoczne w logach to rozpoznawanie wzorców, klucz do szybkiego MTTR - doświadczony inżynier rozpoznaje wzorzec w sekundach, junior szuka godzinami. Trzy grupy to błędna konfiguracja (misconfiguration - cichy zabójca), błędy aplikacji (kod: bugi, wyjątki, wycieki zasobów) i problemy sieciowe (DNS, timeout, connection refused); wzorce typowych awarii i wzorce debugowania porządkują rozpoznawanie.

Błędna konfiguracja - misconfiguration (cichy zabójca): Dryf konfiguracji (zmienne środowiskowe, feature flags, config mapy różne w podach), brakujące sekrety (brakujący env var, zły klucz w Vault), niezgodność wersji (rozjazd wersji klient/serwer, łamiąca zmiana API), limity zasobów (limity CPU/memory za niskie, ulimits: nofile, nproc), feature flags (włączone w prod, wyłączone w staging). Konfiguracja = często cichy problem - działa do skali lub konkretnego wyzwalacza. GitOps = zapobieganie (config as code, przegląd, audyt).

Błędy aplikacji - kod: Nieobsłużone wyjątki (NullPointer, IndexOutOfBounds, KeyError, panic), wycieki zasobów (wyczerpanie puli połączeń - "pool exhausted", wyciek pamięci - OOM, wyciek deskryptorów plików - "too many open files"), nieskończone pętle (CPU 100%, spam logów), zakleszczenia (thread dump: BLOCKED, DB: deadlock detected), wyścigi (sporadyczne, trudne do odtworzenia). Jakość kodu = wsparcie obserwowalności (strukturalne błędy, kontekst, kody błędów). Przegląd kodu + testowanie (jednostkowe, integracyjne, chaos) = zapobieganie.

Problemy sieciowe: Błąd rozwiązywania DNS (NXDOMAIN - brak rekordu, SERVFAIL - błąd serwera, timeout), timeout połączenia (odrzucenie przez firewall, security group, network policy, czarna dziura MTU), connection refused (usługa wyłączona, niezgodność portu, błąd selektora), błędy TLS/SSL (wygaśnięcie certyfikatu, niezgodność hostname, niezgodność szyfrów, zaufanie CA). Sieć = często pomijana aż do awarii. Service mesh (Istio/Linkerd) = widoczność + odporność (retry, timeouty, circuit breaker).

Podsumowanie: Rozpoznawanie wzorców = szybszy MTTR (sekundy vs godziny). Runbook per wzorzec = standaryzowana odpowiedź (runbook: "Wyczerpana pula połączeń → sprawdź rozmiar puli, sprawdź wyciek, zwiększ limit"). Ciągłe uczenie = post-mortem → aktualizacja runbooka. Baza wiedzy = pamięć instytucjonalna (wiki, runbooki, automatyzacja runbooków).

Im więcej wzorców awarii rozpoznajemy od pierwszej sekundy, tym krótszy czas do naprawy - to rozpoznawanie wzorców decyduje, czy MTTR liczymy w godzinach, czy w sekundach. W praktyce większość awarii widocznych w logach grupuje się w trzech kategoriach: błędna konfiguracja, błędy aplikacji i problemy sieciowe. Warto je umieć nazwać, bo sama świadomość, że nasza sytuacja pasuje do jednej z nich, potrafi od razu skierować uwagę we właściwe miejsce zamiast pozwolić na bezproduktywne przeszukiwanie całego stosu.

Najbardziej podstępna jest misconfiguration, zwana cichym zabójcą: objaw pojawia się dopiero przy jakiejś skali albo konkretnym wyzwalaczu, a winowajcą bywa dryf konfiguracji, brakujący sekret, za niski limit zasobów czy feature flag włączony tylko w produkcji. Błędy kodu to między innymi nieobsłużone wyjątki, wyczerpana pula połączeń i deadlocki, a sieć to DNS zwracający NXDOMAIN, timeouty i wygasły certyfikat TLS. Na każdy wzorzec warto mieć gotowy runbook, a zgromadzona baza wiedzy staje się pamięcią instytucjonalną zespołu.

Wyjaśnienie skrótów użytych na slajdzie:
OOM – Out of Memory – wyczerpanie pamięci operacyjnej; Awaria jądra rejestrowana w dmesg jako zdarzenie ubicia procesu przez OOM Killer.
Deadlock – Resource Deadlock – zakleszczenie zasobów; Sytuacja w bazie danych lub aplikacji wielowątkowej, w której procesy wzajemnie blokują zasoby.
Timeout – Connection / Read Timeout – przekroczenie limitu czasu oczekiwania; Błąd sieciowy wskazujący na zawieszenie serwera zależnego lub nasycenie kolejki żądań.
DNS – Domain Name System – system nazw domenowych; Błąd rezolucji nazw (np. Name or service not known) uniemożliwiający nawiązanie połączenia.
ConnectionRefused – TCP Connection Refused – odrzucenie połączenia TCP; Komunikat warstwy transportowej świadczący o tym, że usługa na zdalnym porcie nie działa.

32/55 Wyszukiwanie tekstu w LogQL
Line filters w LogQL: Filtrowanie tekstu PO label selection. Operatory: |= contains, != not contains, |~ regex match (RE2), !~ regex not match. Chaining = AND logic. Label filter first = performance!

LogQL szuka w dwóch krokach: najpierw strumienie po etykietach (szybko), potem linie po treści (dokładnie).

  • Filtrowanie liniowe – operatory dopasowania tekstu |= oraz != pozwalają na natychmiastowe uwzględnienie lub odrzucenie określonych fraz.
  • Wyrażenia regularne – zaawansowany operator |~ umożliwia przeszukiwanie treści za pomocą złożonych wzorców składniowych w LogQL.
  • Ignorowanie wielkości liter – prefiks (?i) wewnątrz wyrażenia regularnego zapobiega pominięciu komunikatów pisanych wielkimi literami.
  • Łączenie potoków – inżynier może łączyć wiele kolejnych filtrów, stopniowo zawężając przeszukiwanie do precyzyjnego wzorca błędu.
  • Wydajność przeszukiwania – proste dopasowanie podciągu znaków jest znacznie szybsze niż skomplikowane wyrażenia regularne.
Operatory linii: |= (zawiera), != (nie zawiera), |~ (regex RE2), !~ (negacja regex); łączenie w łańcuch to logiczne AND, a filtr etykiet zawsze pierwszy dla wydajności.
przykłady filtrów

Wyszukiwanie tekstu w LogQL opiera się na filtrach linii - filtr wtórny po selekcji etykiet (najpierw filtr etykiet = wydajność, potem filtr linii = precyzja): |=, !=, |~, !~ z regexami w składni RE2 (czas liniowy, bez katastrofalnego backtrackingu). To kluczowa umiejętność precyzyjnej analizy logów (line filter, regex, RE2, pipe pipeline).

Filtry linii - podstawowe: |= "podciąg" (contains, rozróżnia wielkość liter), != "podciąg" (not contains), |~ "regex" (dopasowanie regex, RE2), !~ "regex" (negacja regex). Łańcuchowanie: {job="api"} |= "error" != "timeout" |~ "connection.*refused". Łańcuch = logika AND (kolejne filtry zawężają wyniki). Kolejność ma znaczenie: najpierw filtr etykiet (szybkie, indeksowane), potem filtr linii (wolniejsze, pełny skan). Filtruj wcześnie = mniej danych do przeskanowania = szybsze zapytanie.

Wyrażenia regularne - składnia RE2: Silnik RE2 Google (bez backtrackingu, czas liniowy, bezpieczny dla danych użytkownika). Wzorce: .* (dowolne), \d+ (cyfry), \w+ (znaki słowne), [a-zA-Z] (litery), ^/api/.* (prefiks), error|fail|timeout (alternacja). RE2 = bezpieczny, bez katastrofalnego backtrackingu (w przeciwieństwie do PCRE). Kotwice: ^ (początek), $ (koniec), \b (granica słowa). Grupy przechwytujące: (?Pwzorzec) - nazwane grupy do ekstrakcji etykiet.

Przykłady praktyczne: |= "error" (wszystkie błędy), |~ "timeout|refused|denied" (błędy sieciowe), !~ "health|ready|liveness" (wyklucz health checks), |= "trace_id=" | json | trace_id (ekstrakcja trace_id z JSON). Regex = potężne narzędzie, używaj rozsądnie (wydajność: regex na milionach linii = wolno). Najpierw filtr etykiet!

Terminologia: line filter (filtr linii), regex (wyrażenie regularne), RE2 (silnik RE2 Google), LogQL (język zapytań logów), pipe pipeline (potok filtrów). Opanuj wyszukiwanie tekstu = opanuj analizę logów.

Skoro logi zgromadziliśmy już w Lokim, czas nauczyć się z nich sprawnie korzystać, a to oznacza opanowanie LogQL, którego esencją jest wyszukiwanie tekstu w strumieniach logów. W przeciwieństwie do klasycznych narzędzi LogQL nie przeszukuje wszystkiego naraz: najpierw wybiera strumienie po etykietach, a dopiero potem filtruje zawartość linii. Ta dwustopniowa budowa to podstawa wydajności - szybka selekcja etykiet zostawia niewiele danych do przeskanowania, więc kolejność nie jest bez znaczenia.

Filtry linii to cztery operatory: |= oznacza zawieranie podciągu, != jego negację, a |~ i !~ odpowiadają za dopasowanie wyrażenia regularnego i jego odrzucenie. Filtry łączymy w potok, a kolejne warunki działają jak logika AND: najpierw selekcja po etykietach, potem szukamy error i wykluczamy timeout. Wyrażenia regularne działają w składni RE2, czyli silniku Googla bez backtrackingu, co gwarantuje czas liniowy i chroni przed katastrofalnym spowolnieniem nawet na milionach linii - istotna przewaga nad silnikami typu PCRE.

Wyjaśnienie skrótów użytych na slajdzie:
LogQL – Log Query Language – język zapytań LogQL; Narzędzie wyszukiwania tekstowego w strumieniach logów platformy Loki.
Regex – Regular Expression – wyrażenie regularne; Operator dopasowania wzorca w treści zdarzenia wykorzystujący składnię RE2.
POSIX – Portable Operating System Interface – standard przenośnego systemu operacyjnego; Standard zestawu znaków wspierany w klasach znakowych wyrażeń regularnych.
CaseSensitive – Case Sensitivity in Search – wrażliwość na wielkość liter; Cecha operatorów wyszukiwania (|~ vs nieistniejące filtry bez uwzględniania wielkości znaków).
ASCII – American Standard Code for Information Interchange – kod ASCII; Zestaw znaków alfanumerycznych stanowiący bazę przeszukiwanych wierszy tekstu.

33/55 Agregacje w LogQL
Agregacje LogQL: Zamiana logów na metryki: count_over_time (liczba linii), rate (linie/s), sum by (grupowanie), topk/bottomk (ranking). Recording rules = pre-compute for alerts.

Agregacje to most do metryk: logi w liczby, liczby na wykresy i pod progi alertów.

  • Funkcja zliczania częstości – funkcja rate() wylicza liczbę wierszy logów na sekundę spełniających zadane kryteria w oknie czasowym.
  • Dynamiczne metryki – LogQL pozwala na przekształcenie strumienia tekstowego w regularną serię czasową wartości liczbowych.
  • Sumowanie według etykiet – agregator sum by pozwala na grupowanie liczby błędów według poszczególnych mikroserwisów lub kodów HTTP.
  • Wyliczanie percentyli – funkcje kwantylowe potrafią wyznaczyć rozkład opóźnień na podstawie czasów trwania żądań wyodrębnionych z logów.
  • Wykrywanie anomalii – agregacje w LogQL stanowią doskonałą bazę do tworzenia paneli prezentujących trendy awaryjności w firmie.
count_over_time: Liczba linii w oknie (obok rate w liniach/s, sum by do grupowania, topk/bottomk do rankingu); recording rules wstępnie liczą agregacje dla alertów.
agregacje

Dynamiczne generowanie metryk w LogQL pozwala wyliczać zaawansowane agregacje i percentyle z logów bez modyfikacji kodu aplikacji.

Agregacje w LogQL zamieniają surowe logi na metryki (metryki z logów) - fundament alertowania, dashboardowania i analityki: count_over_time (liczba linii w oknie), rate (linie na sekundę), sum by / sum without (agregacja po etykietach), count_values (rozkład wartości pola) i topk/bottomk (top/bottom N). To przeszukiwalne metryki z logów (vector, by, without, share, group by).

count_over_time - podstawa: count_over_time({job="api"} |= "error" [5m]) - liczba linii w oknie 5 min. Rate: rate(... [5m]) = linie na sekundę (tempo na sekundę). To fundament alertów na logach (wskaźnik błędów, skok wolumenu). count_over_time = licznik z logów. Reguła nagrywająca: error_count:5m = count_over_time(...) → alert na error_count:5m > 10.

Grupowanie po etykietach - sum by / sum without: sum by (level) (count_over_time(...)) - rozkład po poziomie (error, warn, info). sum by (handler) - top endpointy po liczbie błędów. sum without (instance) - agregacja cross-instance (usunięcie instance z etykiet). Kontrola grupowania = analiza wymiarowa (krojenie i kostkowanie). by = zachowaj tylko te etykiety, without = usuń te etykiety.

count_values - rozkład wartości: count_values("level", {app="api"}) → liczba wystąpień każdego poziomu. Top błędów: topk(10, count_values("error_type", {app="api"} |= "error")) - top 10 typów błędów. Udział = count / sum (udział w całości). Analiza rozkładu = pomoc w debugowaniu (widzimy: 80% błędów to timeout, 15% connection refused).

topk / bottomk - ranking: topk(5, sum by (instance) (rate(...))) - top 5 instancji po tempie błędów. bottomk - bottom N (np. najbardziej wolne instancje). Ranking = skupienie na odchyleniach (Pareto: 20% instancji = 80% problemów). Praktyczne wzorce dla dashboardów/alertów: topk typów błędów, topk endpointów po latencji, topk hałaśliwych instancji.

Terminologia: count_over_time, sum, aggregation, vector, by, without, count_values, topk, bottomk, share, group by, metrics from logs. Opanuj agregacje = metryki z logów = alerty + dashboardy.

Logi są cenne dla analizy, ale przeszukiwanie surowych linii przy każdym zapytaniu bywa kosztowne, dlatego LogQL oferuje coś w rodzaju mostu w stronę świata metryk. Agregacje zamieniają logi w liczby, a liczby można już odkładać w czasie, rysować na wykresach i porównywać z progami alertów. To naturalne domknięcie poruszonego wcześniej tematu: dokładnie jak w PromQL, tak i tutaj budujemy agregacje, grupujemy po etykietach i wybieramy najbardziej problematyczne elementy, a wynik trafia między innymi do paneli Grafany, które państwo już znacie.

Warsztat otwierają count_over_time, licząca linie w oknie, i rate, przeliczająca je na tempo na sekundę - fundament alertów na logach. Dochodzi grupowanie przez sum by i sum without, rozkładające błędy na poziomy czy endpointy, count_values dające rozkład wartości pola oraz topk, czyli ranking najbardziej problematycznych instancji. Gdy zapytanie zaczyna być ciężkie, wyliczamy je raz przez recording rule i ostrzegamy na gotową metrykę zamiast skanować surowe logi przy każdej ewaluacji.

Wyjaśnienie skrótów użytych na slajdzie:
LogQL – Log Query Language – język zapytań LogQL; Język realizujący zaawansowane agregacje statystyczne nad przedziałami czasu w logach.
PromQL – Prometheus Query Language – język zapytań Prometheus; Wzorzec składniowy dla funkcji count_over_time(), rate() i bytes_rate() w LogQL.
RPS – Requests Per Second – liczba żądań na sekundę; Przepustowość usługi wyliczana ze strumienia logów serwera Nginx za pomocą funkcji rate().
QPS – Queries Per Second – liczba zapytań na sekundę; Częstotliwość zapytań bazodanowych agregowana na podstawie logów powolnych zapytań (slow query log).
TSDB – Time Series Database – baza danych szeregów czasowych; Docelowa struktura wynikowa zwracana przez zapytania metryczne LogQL do platformy Grafana.

34/55 Wizualizacja logów w Grafana
Wizualizacja w Grafanie: Panel Logs + panel Metrics w jednym dashboardzie. Shared time range + variables = unified troubleshooting. Live tailing, derived fields, trace correlation.

Jeden dashboard na metryki i logi: wspólny czas, wspólne zmienne i live tailing w kryzysie.

  • Wizualizacja szeregów czasowych – wykres liniowy częstości błędów w Grafanie pozwala natychmiast dostrzec gwałtowne skoki awaryjności.
  • Panel tabelaryczny – prezentuje wyodrębnione parametry logów w postaci czytelnej, sortowalnej tabeli z kolorowymi statusami zdarzeń.
  • Dedykowany panel logów – oferuje płynne przewijanie milionów wierszy z automatycznym podświetlaniem słów kluczowych i poziomów istotności.
  • Wykresy słupkowe – doskonale sprawdzają się do porównywania liczby żądań obsłużonych przez poszczególne instancje w klastrze.
  • Spójny styl graficzny – ujednolicenie kolorystyki wskaźników na wszystkich pulpitach ułatwia dyżurnym szybką interpretację sytuacji.
Derived fields: Pola pochodne łączące logi ze śladami; panel Logs z panelem Metrics we wspólnym czasie i zmiennych to zunifikowane rozwiązywanie problemów.
wizualizacja

Wizualizacja logów w Grafanie opiera się na panelu logów (Logs visualization), zapytaniu LogQL (filtry etykiet, filtry linii, parsowanie JSON, pipeline) i podświetlaniu pól (derived fields, podświetlanie etykiet, linki do trace). Live tailing to strumieniowanie logów w czasie rzeczywistym (monitorowanie wdrożeń canary, debugowanie incydentów na żywo); to zunifikowane rozwiązywanie problemów - metryki + logi + trace w jednym dashboardzie, w interfejsie, którego inżynier on-call używa w stresie.

Panel logów - wizualizacja: Data source: Loki. Zapytanie LogQL: {job="nginx"} |= "error" | json | line_format "{{.message}}" → tabela: Time, Labels, Line. Kolumny: Time (timestamp), Labels (etykiety strumienia), Line (treść logu). Live tailing (auto-refresh 5-10s): nowe logi pojawiają się na górze w czasie rzeczywistym. Strumieniowanie w czasie rzeczywistym = monitorowanie wdrożeń canary (widzę nowe błędy od razu), debugowanie incydentów na żywo (widzę postęp naprawy). Zawijanie linii / rozwijanie = czytelność stack trace'ów. Limit wierszy (domyślnie 1000) - wydajność.

Filtrowanie - dwupoziomowe (klucz do wydajności): Filtry etykiet (w zapytaniu, przed pobraniem danych): {job="nginx", env="prod"} - filtruje strumienie na poziomie indeksu etykiet Loki (szybkie, O(1), indeksowane). Filtry linii (po pobraniu, na liniach w pamięci): |= "error" (contains), != "health" (not contains), |~ "timeout.*" (regex match, RE2), !~ "debug" (regex not match). Pola pochodne: parsowanie JSON (| json), wyciąganie pól (| line_format "{{.request_id}}"), linki do trace (traceID → link do Tempo/Jaeger). Potężne filtrowanie = precyzyjne wyciąganie igły ze stogu siana. zawsze najpierw stosuj filtr etykiet!

Integracja metryk i logów - zunifikowane rozwiązywanie problemów: Ten sam dashboard → panel metryk (skok latencji p99, wskaźnik błędów) + panel logów (błędy w tym samym czasie) + wspólny zakres czasowy + zmienne ($instance filtruje OBA panele). Korelacja: widzisz skok latencji na wykresie metryk → patrzysz na panel logów w tym samym oknie czasowym → widzisz ERROR connection pool exhausted, WARN slow query > 5s → pierwotna przyczyna w 30 sekund. Zunifikowane rozwiązywanie problemów = metryki + logi + wspólny kontekst (zakres czasowy, zmienne). To "killer feature" Grafana+Loki+Prometheus.

Terminologia: log panel (panel logów), Explore (tryb eksploracji), LogQL (zapytania Loki), derived fields (pola pochodne), label filters (filtry etykiet - szybkie), line filters (filtry linii - precyzyjne), live tailing (podgląd na żywo), correlation (korelacja), metrics-logs correlation (korelacja metryk i logów), trace correlation (korelacja śladów).

Gdy podczas incydentu widzimy skok latencji na panelu metryk, naturalnym następnym krokiem jest sięgnięcie do logów - ale bez względu na to, czy szukamy wpisów z konkretnego serwisu, czy próbujemy połączyć ze sobą zdarzenia z kilku mikrousług, potrzebujemy jednego miejsca, w którym metryki i logi współdziałają ze sobą w obrębie tego samego zakresu czasowego i tych samych zmiennych. Właśnie taki kontekst oferuje Grafana, łącząc panel logów z panelem metryków w jednym dashboardzie i pozwalając inżynierowi na natychmiastowe przejście od obserwacji anomalii do jej źródła w logach - bez przełączania narzędzi.

W niniejszym slajdzie poznamy konstrukcję panelu Logs, zasady filtrowania za pomocą etykiet i fraz liniowych oraz mechanizm Live tailing, który pozwala obserwować napływające logi w czasie rzeczywistym. Omówimy również derived fields, czyli pola pochodne umożliwiające tworzenie łączności między wpisami logów a śladami rozproszonymi, a także pokażemy, jak zmienne i podział widoku składają się na zunifikowany workflow diagnostyczny w sytuacji presji czasowej.

Wyjaśnienie skrótów użytych na slajdzie:
GUI – Graphical User Interface – graficzny interfejs użytkownika; Konsola wizualizacji Grafany łącząca w jednym oknie panele metryk i panele logów.
UX – User Experience – doświadczenie użytkownika; Czytelność i ergonomia nawigacji po milionach zdarzeń tekstowych w sytuacjach kryzysowych.
TimeSeries – Time Series Panel – panel szeregów czasowych; Wykres słupkowy prezentujący wolumen logów w czasie z podziałem na poziomy ważności.
Heatmap – Heatmap visualization – mapa ciepła; Wizualizacja gęstości występowania anomalii i czasów odpowiedzi wyekstrahowanych z logów.
BarChart – Bar Chart Panel – panel wykresu słupkowego; Typ wykresu doskonale nadający się do prezentacji najczęstszych kodów błędów w zadanym oknie.

35/55 Analiza wpływu wdrożenia na logi
Deployment validation: Weryfikacja wpływu wdrożenia na logi: nowe wzorce błędów (regression), error budget consumption, canary analysis. Automated gates = risk threshold → auto-rollback.

Wdrożenie weryfikuj logami: nowe błędy po starcie to regresja. Decyzję podejmują dane i bramki, nie przeczucia.

  • Monitoring wdrożeń – inżynierowie powinni bacznie obserwować strumień logów w trakcie publikowania nowej wersji oprogramowania.
  • Pojawienie się nowych błędów – natychmiastowy wzrost liczby nieznanych dotąd wyjątków jest jasnym sygnałem do wycofania wdrożenia.
  • Sprawdzenie logów startowych – weryfikacja komunikatów inicjalizacyjnych pozwala upewnić się, że migracja bazy danych przebiegła pomyślnie.
  • Weryfikacja procesu wycofywania – logi pozwalają potwierdzić, że stare instancje zostały bezpiecznie wygaszone bez przerywania sesji klientów.
  • Wnioski wdrożeniowe – zestawienie logów sprzed i po publikacji kodu stanowi cenne źródło informacji o stabilności nowego wydania.
Automated gates: Bramki jakości porównujące logi nowej wersji z progiem ryzyka; przekroczenie progu wyzwala automatyczny rollback po wykryciu regresji.
logi przed/po

Analiza wpływu wdrożenia na logi to walidacja wdrożenia - weryfikacja, czy nowa wersja nie psuje systemu: nowe wzorce błędów (wykrywanie nowych wzorców błędów), ocena ryzyka (ocena ryzyka, budżet błędów) i walidacja wdrożenia (walidacja wdrożenia, analiza canary). To kluczowa praktyka CI/CD: deploy → validate → promote/rollback (analiza wpływu wydania, automatyczny powrót do poprzedniej wersji).

Nowe wzorce błędów: Post-deployment LogQL: count by (error_type) ({app="api"} |= "error" | json) → porównaj z bazą (pre-deploy, np. 1h przed). Nowe typy błędów (pojawione po wdrożeniu, nie było przed) = regresja. Delta tempa błędów (po vs przed) = metryka ryzyka. Automatyzacja: bramka CI/CD na wzorcach logów (GitHub Actions / GitLab CI / hak preSync ArgoCD: uruchom zapytanie LogQL, przerwij jeśli nowych typów błędów > 0).

Ocena ryzyka: Konsumpcja budżetu błędów (SLO), delta tempa błędów (po vs przed), wpływ na latencję (przesunięcie p99), liczba nowych typów błędów. Wynik ryzyka = suma ważona (np. error_rate_weight*0.5 + latency_weight*0.3 + new_errors_weight*0.2). Próg: ryzyko > próg → automatyczny rollback. Wdrożenie canary = stopniowe wystawienie na ryzyko (1% → 5% → 10% → 100% ruchu). Automatyczny rollback na osiągnięciu progu ryzyka (ArgoCD Rollouts, Flagger, Flux). Budżet błędów = wspólny język dev/ops.

Walidacja wdrożenia: Porównanie logów bazy (pre-deploy) vs canary (post-deploy). Metryki: wskaźnik błędów, latencja p99, nowe typy błędów, zmiana wolumenu. Automatyczne bramki: wskaźnik błędów < próg, zero nowych typów błędów, latencja < SLO. Narzędzia canary: ArgoCD Rollouts (analysisTemplate), Flagger (analiza canary), Flux (ImageAutomation + ImagePolicy). Walidacja wdrożenia = automatyczna bramka jakości (bez ręcznej akceptacji dla bezpiecznych wdrożeń).

Terminologia: release impact analysis (analiza wpływu wydania), deployment validation (walidacja wdrożenia), canary analysis (analiza kanarka), automated rollback (automatyczne cofnięcie), error budget (budżet błędów), SLO (cel poziomu usługi). Deploy → Validate → Promote/Rollback = dojrzałość CI/CD.

Każde wdrożenie nowej wersji oprogramowania niesie ze sobą ryzyko regresji, która nie zawsze daje się wykryć za pomocą tradycyjnych testów jednostkowych - dopiero analiza logów ujawnia, czy w produkcyjnym ruchu pojawiły się nowe wzorce błędów, czy zmienił się profil latency, czy też konsumpcja budżetu błędów przyspieszyła w nieoczekiwany sposób. Dlatego w dojrzałym procesie CI/CD walidacja wdrożenia nie kończy się na samym deployu, lecz obejmuje automatyczne porównanie stanu logów przed i po nim, co pozwala na podjęcie decyzji o promocji lub rollbacku w oparciu o twarde dane, a nie przeczucia.

Na tym slajdzie prześledzimy trzy filary analizy wpływu wdrożenia: wykrywanie nowych typów błędów za pomocą zapytań LogQL porównujących rozkłady z bazą, budowę wyniku ryzyka opartego na konsumpcji budżetu błędów, delta latencji i liczbie nowych wzorców, a także strategię wdrożenia canary z automatycznymi bramkami wycofującymi zmianę po przekroczeniu ustalonego progu. Na koniec pokażemy, jak tę logikę zaimplementować jako element pipeline'u CI/CD, czyniąc z walidacji logów pełnoprawny gate jakości.

Wyjaśnienie skrótów użytych na slajdzie:
CI/CD – Continuous Integration / Continuous Delivery – ciągła integracja i wdrażanie; Potok deweloperski, którego publikacje weryfikuje się na podstawie dynamiki nowych błędów w logach.
Canary – Canary Deployment – wdrożenie kanarkowe; Strategia wydań, w której logi z nowej wersji porównuje się z logami ze stabilnej wersji bazowej.
Git – Git version control system – system kontroli wersji Git; System kodu źródłowego, z którego identyfikator rewizji commitu trafia do etykiet logów.
PR – Pull Request – propozycja zmian w kodzie; Etap recenzji kodu, w którym należy weryfikować poprawność dodawanych komunikatów logowania.
Rollback – Automatic Rollback – automatyczne wycofanie zmian; Procedura awaryjnego przywrócenia poprzedniej wersji w przypadku lawinowego wzrostu błędów w logach.

36/55 Centralizacja w systemie rozproszonym
Spójność czasu: W systemach rozproszonych każdy node ma własny zegar. NTP (~1-10ms), PTP (~μs/ns). Bez synchronizacji korelacja logów niemożliwa. Chrony / systemd-timesyncd.

Rozproszone zegary kłamią: sekwencja wygląda na równoległą, a przyczyna ginie. NTP/PTP to fundament.

  • Architektura rozproszona – wymaga przesyłania logów z wielu niezależnych chmur i centrów danych do jednego centralnego repozytorium.
  • Zabezpieczenie łączy – transmisja logów przez publiczny Internet musi być bezwzględnie szyfrowana za pomocą certyfikatów mTLS.
  • Buforowanie brzegowe – lokalne kolejki komunikatów zabezpieczają dane przed utratą w przypadku problemów z łącznością międzykontynentalną.
  • Spójność konfiguracji – ujednolicenie formatów logowania we wszystkich oddziałach firmy ułatwia globalną korelację incydentów.
  • Centralny punkt audytu – jedno repozytorium zdarzeń umożliwia spełnienie wymogów bezpieczeństwa korporacyjnego i norm prawnych.
NTP i PTP: Protokoły synchronizacji zegarów (NTP: milisekundy, PTP: mikro/nanosekundy); bez nich korelacja logów w systemie rozproszonym jest niemożliwa.
wiele węzłów a centrala

Centralizacja logów w systemie rozproszonym stawia dwa krytyczne problemy, gdy logi pochodzą z setek kontenerów na dziesiątkach węzłów: spójność czasu (synchronizację) i sortowanie zdarzeń (kolejność). Rozwiązaniem są spójny czas (NTP, PTP, chrony, systemd-timesyncd) i sortowanie zdarzeń (precyzja timestamp, obsługa zdarzeń poza kolejnością); rozproszone logowanie wymaga synchronizacji czasu.

Spójny czas: W systemach rozproszonych każdy węzeł kontenera ma własny zegar. NTP (Network Time Protocol) - standard, dokładność ~1-10ms w LAN. PTP (Precision Time Protocol, IEEE 1588) - sprzętowe znaczniki czasu, dokładność ~μs/ns (wymaga wsparcia karty sieciowej/przełącznika). chrony (nowoczesny klient NTP) - lepiej radzi z przerywaną łącznością, kontenerami. systemd-timesyncd - prosty, dla VM/kontenerów. Kubernetes: synchronizacja czasu hosta + pody (hostPath /etc/localtime, demon ntp). Bez spójnego czasu: logi z różnych serwisów nie da się skorelować (request_id widzi: serwis A 10:00:00.123, serwis B 10:00:01.456 - ale to ten sam request!). Dryf zegara = korelacja niemożliwa.

Sortowanie zdarzeń: Precyzja timestamp: ns (nanosekundy) w Loki/Prometheus, ms w większości logów. Obsługa zdarzeń poza kolejnością: Loki toleruje pewien chaos (sortowanie chunków), ale duże rozbieżności = spadek wydajności. Potok logów: ekstrakcja timestamp przez agenta (Promtail: stage timestamp) vs timestamp dostarczenia (Loki: ingestion time). Najlepsza praktyka: timestamp z aplikacji (wyekstrahowany z logu) = źródło prawdy. Timestamp dostarczenia = fallback. Sortowanie w UI: Grafana sortuje po timestamp (kolumna Time). Korelacja: wspólny zakres czasowy = wyrównany widok.

Podsumowanie: Synchronizacja czasu = fundament rozproszonego logowania. NTP minimum, PTP dla wysokiej precyzji. Ekstrakcja timestamp w agencie (stage timestamp Promtaila) = źródło prawdy. Poza kolejnością = Loki obsłuży, ale kosztem wydajności. Czas = uniwersalny klucz łączenia dla korelacji.

W systemie rozproszonym, gdzie dziesiątki serwisów komunikują się ze sobą równolegle, a każdy z nich generuje tysiące wpisów logów dziennie, najmniejsza rozbieżność zegarów między węzłami może sprawić, że korelacja zdarzeń stanie się niemożliwa - request, który w rzeczywistości odbył się sekwencyjnie, zostanie w logach przedstawiony jako równoległy, a identyfikacja przyczyny źródłowej awarii zamieni się w zgadywankę. Dlatego synchronizacja czasu to ciągły wymóg operacyjny, a mechanizmy takie jak NTP czy PTP stanowią fundament, bez którego zaawansowana obserwowalność nie spełni swojej roli.

W dalszej części slajdu porównamy dokładność protokołów NTP i PTP, omówimy zalety demona chrony w kontenerowym środowisku Kubernetes oraz wyjaśnimy, dlaczego ekstrakcja timestampów bezpośrednio z aplikacji, a nie z momentu dostarczenia, stanowi jedyne wiarygodne źródło prawdy. Przeanalizujemy także, jak Loki toleruje zdarzenia przybywające poza kolejnością, jakie koszty niesie za sobą dryf zegara i jak prawidłowa polityka synchronizacji przekłada się na jakość korelacji między serwisami.

Wyjaśnienie skrótów użytych na slajdzie:
WAN – Wide Area Network – rozległa sieć komputerowa; Łącza telekomunikacyjne narażone na opóźnienia i zrywanie sesji podczas przesyłania logów do centrali.
LAN – Local Area Network – sieć lokalna; Szybka sieć wewnątrz centrum danych zapewniająca bezstratny transport logów do lokalnego kolektora.
VPN – Virtual Private Network – wirtualna sieć prywatna; Szyfrowany tunel sieciowy zabezpieczający ruch telemetryczny pomiędzy oddziałami a centralną bazą.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Standard kryptograficzny wymagany przy transmisji logów przez publiczne łącza internetowe.
MTU – Maximum Transmission Unit – maksymalna jednostka transmisji; Parametr pakietu sieciowego; nieoptymalne MTU w tunelach VPN może powodować fragmentację i straty logów.

37/55 Przechowywanie i koszty logów
Koszty logów: Tiered storage: Hot (SSD, drogie) → Warm (HDD, średnie) → Cold (S3/Glacier, $0.01/GB). Retencja: hot 7d, warm 90d, cold 1-7 lat. FinOps = cost-aware logging.

Logi to też rachunek: gigabajty rosną, przepisy każą trzymać latami. Mądrze warstwuj zamiast ciąć na oślep.

  • Ekonomia danych – ciągły wzrost wolumenu logów generuje poważne koszty, wymagając optymalizacji w ramach kultury inżynierskiej FinOps.
  • Efektywna kompresja – algorytmy pakowania bloków pozwalają kilkukrotnie zredukować wymagany rozmiar magazynu danych w chmurze.
  • Tani magazyn obiektowy – przeniesienie archiwalnych bloków danych do chmurowych magazynów S3 drastycznie obniża koszty operacyjne.
  • Odrzucanie szumu – wyciszenie nadmiarowych logów informacyjnych i debugowania na produkcji pozwala zaoszczędzić gigabajty transferu.
  • Wycena wartości danych – inżynierowie powinni regularnie oceniać, które kategorie logów realnie pomagają w diagnozowaniu awarii.
Cost-aware logging: Logowanie świadome kosztów - gorące dane na SSD, archiwa w S3/Glacier (~0,01 USD/GB); retencja hot 7d, warm 90d, cold do 7 lat.
retencja

Logi to dane, a dane kosztują - przechowywanie, dostarczanie, transfer, obliczenia; przechowywanie i koszty logów dotyczą planowania budżetu, compliance i FinOps (Financial Operations). Poziomy przechowywania (hot/warm/cold storage - storage wielopoziomowy), okresy retencji (polityka retencji - compliance vs biznes) i optymalizacja kosztów (kompresja, próbkowanie, dobór poziomu) to bilans; Loki używa enkodowania chunków + object storage = naturalny tiering (ILM).

Poziomy przechowywania - storage wielopoziomowy: Hot (SSD/NVMe, ostatnie 1-7 dni, ścieżka dostarczania + zapytania w czasie rzeczywistym, drogie $20-50/GB/mies), Warm (HDD/object storage, 30-90 dni, zapytania ad-hoc, średnie $5-10/GB/mies), Cold (S3/GCS Glacier/Deep Archive, 1-7 lat, compliance/audyt, najtańsze $0.01-0.04/GB/mies). Storage wielopoziomowy = automatyczny tiering (Loki compactor: kompaktowanie chunków, przenoszenie do tańszego storage; Elasticsearch ILM: Index Lifecycle Management - sterowany polityką). Hot = ścieżka dostarczania, Warm = przeszukiwalny, Cold = archiwum. Automatyczny = bez ręcznej interwencji.

Okresy retencji: Polityka retencji per poziom (Hot: 7d, Warm: 90d, Cold: 1-7 lat). Sterowana zgodnością: GDPR Art. 17 (prawo do bycia zapomnianym - selektywne usuwanie), SOX (7 lat rejestrów finansowych), HIPAA (6 lat danych zdrowotnych), PCI-DSS (1 rok logów płatniczych). Sterowana biznesem: debugowanie (7-30d), audyt (1-7 lat), trenowanie ML (zmienne). Polityka retencji = automatyzacja (Loki: limits_config: retention_period, retention_stream; Elasticsearch: polityka ILM). Automatyczna = bez ręcznego sprzątania = bez błędu ludzkiego.

Koszty i optymalizacja: Storage hot = drogi ($/GB/mies), cold = tani ($0.01-0.04/GB/mies). Optymalizacja kosztów = dobór poziomu (automatyczny tiering przez compactor/ILM), kompresja (gzip, domyślnie w Loki: typowo 5-10:1), próbkowanie (logi wysokiego wolumenu i niskiej wartości: próbkowanie DEBUG/INFO 1-10%, ERROR 100%), kontrola kardynalności etykiet (wysoka kardynalność = więcej strumieni = więcej narzutu). Koszt na GB na miesiąc = metryka FinOps. FinOps = kultura świadomego kosztowo logowania (tagowanie, budżety, alerty na anomalie kosztów).

Terminologia: hot/warm/cold storage (storage gorące/ciepłe/zimne), retention policy (polityka retencji), cost optimization (optymalizacja kosztów), tiered storage (storage wielopoziomowy), FinOps (finanse operacyjne), ILM (Index Lifecycle Management). Poziomowanie storage = optymalizacja kosztów. Compliance = wymóg prawny.

Logi to nie tylko dane diagnostyczne - to także koszt, który rośnie z każdym gigabajtem przechowywanych wpisów, a im dłużej je archiwizujemy, tym większy nacisk kładzie się na świadome zarządzanie cyklem życia danych od momentu ich wygenerowania po ostateczne usunięcie. Nie chodzi jednak o to, by logować mniej, lecz o to, by przechowywać je mądrze, dobierając poziom storage'u do wartości informacyjnej danego okresu i wymogów regulacyjnych, które nakazują przetrzymywanie wybranych typów logów przez określony czas.

Na tym slajdzie omówimy trójwarstwowy model przechowywania - hot, warm i cold - z przypisanymi im kosztami i okresami retencji, a także wymogi compliance wynikające z przepisów takich jak GDPR, SOX czy HIPAA. Przedstawimy również strategie optymalizacji kosztów, obejmujące kompresję, próbkowanie niskiej wartości wpisów oraz automatyczny tiering realizowany przez narzędzia takie jak Loki compactor czy Elasticsearch ILM, które przenoszą dane między poziomami bez ingerencji operatora.

Wyjaśnienie skrótów użytych na slajdzie:
CAPEX – Capital Expenditure – nakłady inwestycyjne; Koszty zakupu fizycznych macierzy dyskowych i serwerów na potrzeby centralizacji logów.
OPEX – Operational Expenditure – wydatki bieżące; Koszty opłat chmurowych za transfer i przestrzeń dyskową zajmowaną przez archiwa logów.
TCO – Total Cost of Ownership – całkowity koszt posiadania; Łączny koszt utrzymania systemu logowania optymalizowany przez dobór retencji i kompresji.
S3 – Simple Storage Service – obiektowa pamięć masowa; Najpopularniejszy standard taniej pamięci masowej w chmurze stosowany do przechowywania logów.
Glacier – Amazon S3 Glacier – archiwalny magazyn danych; Najtańsza klasa pamięci obiektowej przeznaczona do wieloletniej archiwizacji rzadko odpytywanych logów.

38/55 Redukcja szumu w logach
Redukcja szumu: Deduplication (hash-based, okno czasowe + licznik) + error-first routing (DEBUG→cold, ERROR→alert) + structured logging (JSON) = faster queries, lower costs, faster MTTR.

Większość logów to szum: healthchecki i debugi zasłaniają sygnał. Trzy techniki: deduplikacja, routing i JSON.

  • Zjawisko szumu w logach – generowanie tysięcy powtarzalnych, nic nieznaczących komunikatów utrudnia odnalezienie prawdziwych przyczyn awarii.
  • Filtrowanie u źródła – aplikacje powinny rejestrować zdarzenia selektywnie, unikając wypisywania logów wewnątrz intensywnych pętli obliczeniowych.
  • Dostrajanie poziomów – podniesienie progu logowania bibliotek zewnętrznych do poziomu WARN eliminuje niepotrzebny chaos informacyjny.
  • Próbkowanie zdarzeń – technika rejestrowania co dziesiątego lub setnego rutynowego żądania pozwala zachować statystyki bez zalewania bazy.
  • Dyscyplina programistyczna – dbałość o czystość i zwięzłość emitowanych komunikatów jest podstawowym obowiązkiem każdego programisty.
Deduplication: Usuwanie duplikatów po hashu w oknie czasowym z licznikiem; z routingiem error-first (DEBUG do cold, ERROR do alertu) daje szybsze zapytania i niższy MTTR.
redukcja szumu

Redukcja szumu w logach poprawia stosunek sygnału do szumu, kontrolę kosztów i szybkość debugowania - szum to logi bez wartości diagnostycznej (health checks, polling, zbyt szczegółowe DEBUG, powtarzające się INFO). Trzy praktyki to agregacja podobnych wpisów (deduplikacja, próbkowanie), skupienie na błędach (filtrowanie zorientowane na błędy) i struktura logów (structured logging); redukcja szumu = redukcja kosztów + szybsze debugowanie (zarządzanie wolumenem logów).

Agregacja podobnych wpisów - deduplikacja: Deduplikacja oparta na hashu wiadomości w oknie czasowym (hash + okno czasowe = 1 wpis z licznikiem) - realizowana własną logiką agenta lub aplikacji, bo Promtail nie ma gotowego stage'a dedupe; w backendzie Loki grupuje logi w strumienie (ten sam zestaw etykiet = ten sam strumień), a powtórki usuwa się agregacją w LogQL. Próbkowanie: próbkowanie probabilistyczne (np. 1% DEBUG/INFO, 100% ERROR/FATAL) - Promtail: stage sampling. Wskaźnik deduplikacji = metryka redukcji wolumenu (np. 10:1 = 90% redukcja wolumenu).

Skupienie na błędach - filtrowanie zorientowane na błędy: Routing poziomów logów: DEBUG/INFO → tani storage (próbkowanie, poziom cold), WARN/ERROR/FATAL → pełna wierność + alerting + poziom hot. Routing poziomów w agencie (Promtail: routing etykiet przez pipeline stages) = optymalizacja kosztów. Zorientowanie na błędy = zachowanie sygnału, eliminacja szumu. Wzorzec: rozdziel po etykiecie poziomu → różne tenanty/konfiguracje storage Loki.

Struktura logów = redukcja szumu: Structured logging (JSON) = parsowalne, przeszukiwalne, filtrowalne. Bez struktury = szum (grep/regex = wolno, błędotwórczo). Spójne pola (request_id, trace_id, user_id, wersja wdrożenia) = włączona korelacja. Wymuszenie schematu (schemat JSON, konwencje semantyczne OpenTelemetry) = jakość danych. Struktura = redukcja szumu z założenia (nie logujesz "User logged in" - logujesz {event: "user_login", user_id: "123", method: "oauth"}).

Podsumowanie: Redukcja szumu = deduplikacja + routing zorientowany na błędy + structured logging. Redukcja wolumenu = oszczędności + szybsze zapytania. Zachowanie sygnału = szybszy MTTR. Redukcja szumu = dyscyplina inżynierska (nie „loguj wszystko" - „loguj mądrze").

Terminologia: noise reduction (redukcja szumu), log filtering (filtrowanie logów), deduplication (deduplikacja), sampling (próbkowanie), log volume management (zarządzanie wolumenem logów).

W środowisku produkcyjnym, gdzie każdy serwis generuje tysiące linii logów dziennie, szybko okazuje się, że znaczna część z nich nie niesie wartości diagnostycznej - powtarzające się wpisy o zdrowiu serwisu, nadmiarowe informacje debugowania czy zduplikowane komunikaty zasłaniają sygnał i utrudniają identyfikację rzeczywistych problemów. Redukcja szumu to inżynierska dyscyplina, która pozwala zachować logi mające znaczenie, a jednocześnie obniżyć objętość i koszty przechowywania bez utraty widoczności.

W niniejszym slajdzie przedstawimy trzy komplementarne techniki: deduplikację opartą na hashu wiadomości, która redukuje objętość nawet dziesięciokrotnie, error-first routing kierujący wpisy o niskim priorytecie do tańszych warstw storage'u, a krytyczne - do alertów, oraz structured logging w formacie JSON, który zamienia nieprzeszukiwalny tekst w dane, które można filtrować, agregować i korelować. Na koniec podkreślimy, że redukcja szumu to nie „loguj mniej”, lecz „loguj mądrzej” - i że to podejście przekłada się na szybkość debugowania i wysokość rachunku za infrastrukturę.

Wyjaśnienie skrótów użytych na slajdzie:
Regex – Regular Expression – wyrażenie regularne; Wzorzec tekstowy wykorzystywany do filtrowania i odrzucania powtarzalnych komunikatów bezużytecznych.
Drop – Drop log filter stage – etap odrzucania logów; Reguła w agencie Promtail lub Vectorze natychmiast kasująca wiersze nieposiadające wartości inżynierskiej.
Sampling – Log Sampling – próbkowanie logów; Technika rejestrowania tylko co n-tego zdarzenia z powtarzalnego strumienia o bardzo wysokiej częstotliwości.
Level – Log Severity Level – poziom ważności logu; Mechanizm podnoszenia progu rejestracji na produkcji (np. z DEBUG na WARN) w celu redukcji szumu.
RateLimit – Rate Limiting of Logs – ograniczanie przepustowości logów; Mechanizm obronny zapobiegający zalaniu systemu logowania w trakcie pętli awaryjnej.

39/55 Podsumowanie analizy logów
Podsumowanie analizy logów: Zamykanie pętli: logi → pattern detection (anomalia, trend, korelacja) → actionable alerts → incydent/naprawa. Kompetencja U01: decyzje oparte na dowodach.

Logi bez akcji to drogi śmietnik. Łańcuch: wzorce → alert z runbookiem → naprawa → wniosek.

  • Rola logów w SRE – stanowią one niezastąpione źródło szczegółowej wiedzy o wewnętrznym stanie aplikacji w trakcie wystąpienia awarii.
  • Wybór odpowiedniego stosu – architektura Loki zapewnia oszczędność i prostotę, natomiast ELK oferuje bezkompromisowe wyszukiwanie.
  • Strukturyzacja i standardy – formatowanie JSON i ujednolicone schematy danych pozwalają na pełną automatyzację analizy zdarzeń w firmie.
  • Połączenie z metrykami – jednoczesna korelacja wykresów liczbowych z wpisami w logach drastycznie skraca czas diagnozy incydentów.
  • Ciągłe doskonalenie – regularny audyt reguł filtrowania i retencji pozwala utrzymać wysoką sprawność całego potoku obserwacyjnego.
Actionable alerts: Alerty nadające się do działania - z kontekstem i runbookiem; zamykają pętlę logi → wykrywanie wzorców → alert → naprawa w decyzjach opartych na dowodach.
korzyści

Analiza logów zamyka pętlę: logi (zbieranie) → analiza (zapytania, wykrywanie wzorców) → alerty (alerty nadające się do działania) → akcje (reagowanie na incydenty, naprawa). Najważniejsze wnioski to wykrywanie wzorców (anomalia, trend, korelacja) i podstawy alertów (reguły alertowe: oparte na logach, progach, tempie spalania budżetu); to operacje oparte na dowodach.

Wykrywanie wzorców: Wykrywanie anomalii (skok wolumenu: skok count_over_time, wzorzec błędów: nowe typy błędów, odchylenie od bazy: tempo > 2σ), analiza trendów (trend: rosnący wskaźnik błędów, sezonowość: nocny spadek, prognozowanie: predykcja pojemności), analiza korelacji (metryki-logi: skok latencji + błędy DB, cross-service: kaskadowa awaria A→B→C). Wzorzec = wnioski nadające się do działania (nie dane - wnioski). Biblioteka wzorców = wyzwalacze runbooków (jeśli widzisz wzorzec X → runbook Y).

Podstawy alertów - alerty nadające się do działania: Alerty oparte na logach (LogQL: count_over_time, rate, dopasowanie wzorców), progi (statyczne: >10 błędów/5m vs dynamiczne: > baza*2), alerting na tempie spalania budżetu (oparty na SLO: szybkie spalanie 2% budżetu/1h = page, wolne spalanie 10% budżetu/6h = ticket). Alert nadający się do działania = runbook + severity + właściciel (kto reaguje). Zapobieganie zmęczeniu alertami = tylko alerty nadające się do działania (jeśli alert nie wymaga akcji → usuń go). Dostrajanie alertów = ciągły proces (przegląd co sprint).

Związek z U01 (sylabus): Kompetencja analityczna (U01) = interpretacja danych, wnioskowanie, decyzyjność oparta na dowodach (evidence-based). Analiza logów = kluczowa umiejętność U01 (parsowanie, filtrowanie, agregacja, korelacja, wnioskowanie). Operacje oparte na dowodach = kultura inżynierska (nie "myślę, że" - "logi pokazują, że"). U01 = analityczne myślenie z danymi.

Terminologia: pattern detection (wykrywanie wzorców), alerting (alertowanie), actionable alerts (alerty nadające się do działania), burn rate alerting (alerting na tempo spalania), evidence-based operations (operacje oparte na dowodach). Logi → Analiza → Alerty → Akcje = zamknięta pętla.

Analiza logów zamyka się dopiero wtedy, gdy zebrane dane prowadzą do konkretnej akcji - alerty, naprawy lub zmiany konfiguracji - a sam fakt gromadzenia i przeszukiwania wpisów, bez powiązania ich z mechanizmem reagowania, nie przynosi wartości operacyjnej. Dlatego w modelu SRE logi traktujemy jako ogniwo łańcucha, który rozpoczyna się od wykrywania wzorców, prowadzi przez formułowanie alerty nadające się do działania, a kończy na zamkniętej pętli: od sygnału po naprawę i wniosek na przyszłość.

Na tym slajdzie podsumujemy kluczowe techniki wykrywania anomalii, trendów i korelacji między serwisami, a także omówimy zasady konstruowania alertów, które łączą runbook, poziom priorytetu i wskazanie odpowiedzialnego. Przedstawimy również związek tych kompetencji z modułem U01 sylabusu, podkreślając, że operacje oparte na dowodach - a nie na przeczuciach - stanowią rdzeń kultury inżynierskiej w zespole SRE.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina techniczna integrująca logi z kulturą ciągłego doskonalenia usług.
LogQL – Log Query Language – język zapytań LogQL; Nowoczesne narzędzie analityczne łączące logikę tekstową z matematyką szeregów czasowych.
Promtail – Promtail log shipper – agent przesyłania logów Promtail; Standardowy komponent środowiska Grafana odpowiedzialny za zasilanie bazy Loki.
Loki – Grafana Loki – system agregacji logów Loki; Nowoczesna, chmurowa baza logów optymalizująca koszty poprzez indeksowanie wyłącznie etykiet.
ELK – Elasticsearch, Logstash, Kibana – stos ELK; Klasyczne środowisko analityczne oferujące zaawansowane indeksowanie pełnotekstowe.

40/55 Praca własna: zadania (logi)
Praca własna: Hands-on lab: skonfiguruj Loki data source w Grafanie (URL http://loki:3100), zbuduj panele LogQL, znajdź błąd i zintegruj metryki z logami. Dashboard as code = GitOps.

LogQL wchodzi w ręce tylko przy klawiaturze: źródło, panele, debugowanie i dashboard jako kod.

  • Ćwiczenia praktyczne – samodzielne skonfigurowanie agenta Promtail i serwera Loki jest najlepszym sposobem na utrwalenie wiedzy.
  • Analiza logów z /var/log – przećwiczenie parsowania dzienników systemowych oraz serwerów WWW pozwala poznać realia pracy inżynierskiej.
  • Pisanie zapytań LogQL – konstruowanie filtrów potokowych i wyliczanie metryk częstości przygotowuje do rozwiązywania problemów produkcyjnych.
  • Testy mitygacji awarii – symulacja incydentu i namierzenie błędu za pomocą logów buduje pewność siebie przed dyżurami on-call.
  • Środowisko laboratoryjne – zachęcamy do eksperymentowania w bezpiecznej piaskownicy kontenerowej przed przystąpieniem do egzaminu.
Hands-on lab: Samodzielna konfiguracja źródła Loki (http://loki:3100), paneli LogQL i integracji metryk z logami; dashboard jako kod w duchu GitOps.
lista zadań

Zadania domowe (Hands-on Lab) uczą przez robienie, nie teorią: konfiguracja źródła logów (Promtail/source danych Loki w Grafanie), wykonanie zapytań LogQL (budowa paneli), znalezienie przykładowego błędu (ćwiczenie debugowania) i integracja z Grafaną (dashboard z korelacją metrics-logs). To droga od zera do analizy logów (LogQL, Loki, Grafana, Promtail, data source).

Skonfiguruj źródło logów: Data source → Loki → URL (http://loki:3100) → Save & Test. Weryfikacja połączenia = fundament (zielone "Data source is working"). Bez tego nic nie działa. Multi-tenancy: nagłówek X-Scope-OrgID jeśli włączone.

Zbuduj panele LogQL: Time series (wskaźnik błędów: count_over_time({job="api"} |= "error" [5m])), Stat (liczba błędów: sum(count_over_time({job="api"} |= "error" [1h]))), panel Logs ({job="api"} |= "error" | json | line_format "{{.message}}"). Ćwiczenie zapytań = pamięć mięśniowa (płynność LogQL = zapytanie w 30s, nie 30 min). Zmienne: $job = label_values(job) - dynamiczne filtry.

Znajdź błąd: LogQL {app="api"} |= "ERROR" | json | line_format "{{.message}}" → filtruj po timestamp, trace_id. Znajdź przyczynę źródłową w 5 min. Debugowanie praktyczne = trening rozpoznawania wzorców. Eksport do CSV → analiza w Excel/Notebooku.

Integracja z Grafana: Panel Logs + panel Metrics (wspólny zakres czasowy, zmienne). Korelacja metrics-logs = zunifikowane rozwiązywanie problemów (widzisz skok na metryce → patrzysz na logi w tym samym czasie → przyczyna źródłowa). Dashboard as code = wersjonowany (JSON w Git), z przeglądem (PR), powtarzalny. Provisioning: dashboards.yaml + datasources.yaml = GitOps.

Terminologia: LogQL, Loki data source, Grafana Explore, LogQL queries, dashboard, variables, annotations, correlation, dashboard as code, provisioning. Praktyka = jedyny sposób na naukę.

Teoria LogQL, koncepcja korelacji metryk i logów czy struktura panelu Logs w Grafanie stają się w pełni zrozumiałe dopiero wtedy, gdy samodzielnie skonfigurujemy źródło danych, zbudujemy pierwsze zapytanie i zobaczymy, jak surowe wpisy przekształcają się w informacje diagnostyczne - a do tego niezbędna jest praktyka przy konsoli, nie tylko lektura slajdów. Dlatego niniejszy slajd poświęcamy ćwiczeniom laboratorieskim, które stopniowo wprowadzają w realia pracy z Loki, Promtail i Grafaną.

W ramach pracy własnej wykonamy trzy zadania: skonfigurujemy data source Loki w Grafanie z weryfikacją połączenia, zbudujemy panele time series, stat i logs za pomocą LogQL, a na koniec przeprowadzimy ćwiczenie debugowania, identyfikując przyczynę błędu w przykładowych logach. Na koniec pokażemy, jak zintegrować metryki z logami w jednym dashboardzie i jak zapisać jego definicję jako kod w repozytorium Git, realizując zasadę dashboard as code i przygotowując się do pracy w środowisku GitOps.

Wyjaśnienie skrótów użytych na slajdzie:
VM – Virtual Machine – maszyna wirtualna; Środowisko wirtualne wykorzystywane przez studentów do uruchomienia demonstracyjnego stosu logów.
LXC – Linux Containers – kontenery systemowe Linux; Lekka platforma konteneryzacji stosowana w laboratoriach akademickich do ćwiczeń z rsyslog.
Docker – Docker container platform – platforma Docker; Narzędzie uruchamiające kontenery aplikacji, których logi studenci przekazują do bazy Loki.
systemd – systemd service manager – menedżer usług systemd; Podsystem linuksowy nadzorujący procesy i dostarczający logi do demona journald.
journalctl – journalctl query utility – narzędzie zapytań journald; Polecenie konsoli Linuksa służące do inspekcji binarnego dziennika systemowego.

41/55 Narzędzia wspierające diagnostykę
Narzędzia diagnostyczne: Gdy logi/metryki nie wystarczą: tcpdump/Wireshark (packet capture), ss/netstat (socket statistics), ping/traceroute/mtr (connectivity). Korelacja sieć + logi = full picture.

Gdy logi nie starczają, schodzisz niżej: pakiety, gniazda i trasa. Wynik korelujesz z logami.

  • Narzędzia konsolowe – programy takie jak jq, grep czy awk stanowią podstawowy warsztat inżyniera badającego logi bezpośrednio na serwerze.
  • Wizualne debuggery wyrażeń – ułatwiają szybkie weryfikowanie wzorców Grok i regex przed ich wdrożeniem do potoków produkcyjnych.
  • Generatory sztucznego ruchu – narzędzia testowe pozwalają zasymulować intensywny ruch użytkowników i przetestować wydajność kolektorów.
  • Wtyczki do przeglądarek – rozszerzenia deweloperskie ułatwiają podgląd nagłówków śladów oraz korelację zapytań sieciowych z logami.
  • Nowoczesne narzędzia CLI – znajomość poleceń wiersza linii przyspiesza wstępną diagnostykę na maszynach odciętych od centralnego UI.
Packet capture: Przechwytywanie pakietów (tcpdump/Wireshark) oraz statystyki gniazd (ss/netstat) i łączności (ping/traceroute/mtr); korelacja z logami daje pełny obraz.
narzędzia

Kiedy logi i metryki nie wystarczą (problemy sieciowe, problemy jądra, głębokie analizy wydajności), potrzebne są narzędzia obserwowalności sieci: tcpdump, wireshark, ss, netstat, ip, ping, traceroute i mtr, łączone z logami przez korelację sieć + logi. To kompletny zestaw narzędzi obserwowalności dla SRE (przechwytywanie pakietów, analiza sieci, korelacja, pcap).

Narzędzia sieciowe - przechwytywanie i analiza pakietów: tcpdump (CLI, filtry: host, port, proto, flagi TCP - tcpdump -i eth0 -w capture.pcap port 80), Wireshark (GUI, szczegółowa inspekcja pakietów, wykresy przepływu, expert info, składanie TCP), tshark (Wireshark z CLI - automatyzacja). Filtry: host, port, tcp.flags, http, dns, tls. Pliki przechwytów (pcap) = dowody (można przekazać do wsparcia producenta, przeanalizować offline). tcpdump = obowiązkowa umiejętność dla SRE.

Stan sieci i łączność: ss (statystyki gniazd: ss -tulpn - nasłuchujące porty, ss -s - podsumowanie, ss -i - informacje TCP), netstat (legacy, przestarzały), ip (ip addr, ip route, ip link, ip neigh - nowoczesny zamiennik), ping/traceroute/mtr (latencja, ścieżka, straty - mtr = traceroute + ping w jednym, w czasie rzeczywistym). ss > netstat (szybszy, więcej informacji, interfejs jądra). mtr = szwajcarski scyzoryk sieciowy.

Łączenie z logami - korelacja sieć-logi: Problem sieciowy (utrata pakietów, opóźnienie, retransmisje) → logi (connection refused, timeout, błąd DNS, nieudane uzgadnianie TLS). Skorelowany dashboard: metryki sieci (utrata pakietów, opóźnienie, retransmisje z node_exporter/blackbox) + logi (connection refused, timeout). Korelacja = debugowanie świadome sieci (czy to sieć czy aplikacja?). Narzędzia: Grafana (panele metryk + logi obok siebie), własne dashboardy, korelacja Loki + Prometheus.

Terminologia: packet capture (przechwytywanie pakietów), network analysis (analiza sieci), correlation (korelacja), packet capture (pcap), tcpdump, Wireshark, ss, netstat, mtr, correlation dashboard, network observability (obserwowalność sieci).

Choć logi i metryki stanowią fundament obserwowalności, istnieją sytuacje, w których same nie wystarczają - problemy z routingiem pakietów, przerywane połączenia TCP czy nieoczekiwane opóźnienia na poziomie sieci wymagają sięgnięcia po narzędzia, które operują niżej, na warstwie pakietów i gniazd, a ich wyniki łączą się z logami aplikacyjnymi w spójny obraz przyczynowo-skutkowy. Dlatego każdy inżynier SRE powinien mieć w arsenale narzędzia diagnostyczne sieci, gotowe do użycia, gdy tradycyjna analiza logów napotyka granice.

Na tym slajdzie omówimy praktyczne zastosowania tcpdump i Wireshark do przechwytywania i inspekcji pakietów, narzędzi ss i ip do analizy stanu gniazd sieciowych oraz połączonych ping, traceroute i mtr do badania łączności i latencji. Pokażemy też, jak korelować wyniki tych narzędzi z logami - gdy przechwytywanie wskazuje utratę lub opóźnienie pakietów, a w logach aplikacji pojawiają się komunikaty connection refused - oraz jak zbudować dashboard łączący metryki sieciowe z panelami logów, uzyskując pełny picture diagnostyczny.

Wyjaśnienie skrótów użytych na slajdzie:
grep – Global Regular Expression Print – narzędzie wyszukiwania grep; Fundamentalne uniksowe narzędzie konsolowe do szybkiego przeszukiwania plików tekstowych.
awk – Aho, Weinberger, Kernighan pattern scanning language – język przetwarzania tekstu awk; Klasyczny uniksowy język programowania przeznaczony do ekstrakcji i formatowania kolumn tekstu.
sed – Stream Editor – edytor strumieniowy sed; Narzędzie wiersza poleceń służące do transformacji i filtrowania tekstu w locie.
less – Terminal pager utility less – program stronicujący less; Interaktywny podgląd dużych plików logów bez konieczności wczytywania całego pliku do pamięci RAM.
journalctl – systemd journal query tool – narzędzie dziennika systemowego; Zaawansowane narzędzie filtrujące zdarzenia według jednostki systemd, priorytetu i czasu.

42/55 Podsumowanie wykładu 4 (cz. 1)
Podsumowanie cz. 1: Trzy filary: Loki vs ELK (cost vs features), LogQL mastery (stream selector, line filters, aggregation), workflow diagnostyki (metryka → logi → trace).

Trzy filary logowania w pigułce: narzędzia (Loki/ELK), język (LogQL) i droga od alertu do naprawy.

  • Kluczowe pojęcia wykładu – logowanie strukturalne, potoki zbierania, indeksowanie etykiet oraz język zapytań LogQL stanowią bazę wiedzy.
  • Architektura narzędzi – poznanie różnic pomiędzy podejściem firmy Grafana Labs a stosem ELK pozwala na świadome dobieranie technologii.
  • Zasady bezpieczeństwa – bezwzględna ochrona danych osobowych i szyfrowanie połączeń sieciowych są fundamentem profesjonalizmu SRE.
  • Optymalizacja potoków – kontrolowanie kardynalności etykiet oraz stosowanie rotacji chroni platformę przed awariami wydajnościowymi.
  • Dalsze kroki w kursie – zdobyta wiedza o logach stanowi bezpośredni wstęp do projektowania klastrów wysokiej dostępności i równoważenia ruchu.
LogQL mastery: Biegłość w selektorach strumieni, filtrach linii i agregacjach; z wyborem Loki/ELK (koszt vs funkcje) i workflow metryka → logi → trace.
podsumowanie

Porównanie Loki/ELK, płynność LogQL i workflow diagnostyki to trzy filary części 1 wykładu 4 - ściąga do powtórki przed egzaminem, rozmową i certyfikacją. Zbiera kluczowe informacje z pierwszych 30+ slajdów do szybkiego powtórzenia (spaced repetition).

Loki vs ELK - porównanie: Loki (indeksowanie oparte na etykietach, tani object storage, natywnie z Grafaną, design cloud-native, single binary) vs ELK (pełnotekstowy inverted index, bogaty w funkcje: ML/SIEM/APM, zasobożerny: JVM/heap/shardy, dojrzałość enterprise). Kompromisy: koszt vs funkcje (10-100× różnica kosztów), prostota vs potęga (Loki prostsze operacje), cloud-native vs samodzielny. Matryca decyzyjna = sterowana przypadkiem użycia (Loki: mikrousługi/K8s/wrażliwość na koszty; ELK: compliance/SIEM/legacy/full-text). Hybryda = Loki (hot) + Elasticsearch (cold/archive).

LogQL - opanowanie wzorców zapytań: Selektor strumienia ({label="value"} - indeks etykiet, O(1)), filtry linii (|= contains, != not contains, |~ regex, !~ not regex), potok (| json parsowanie, | regexp ekstrakcja, | line_format szablon), agregacje (count_over_time, rate, sum by/without, topk/bottomk, count_values). Płynność LogQL = zapytanie w 30 sekund, nie 30 minut. Reguły nagrywające = pre-compute ciężkich zapytań dla alertów/dashboardów.

Diagnostyka awarii - workflow diagnostyki: Filtrowanie po zakresie czasowym (względne + przesunięcie) + analiza błędów (stack trace, kody błędów, kontekst) + korelacja metryk (wspólny zakres czasowy, split view) = przyczyna źródłowa w minuty. Workflow: Alert → Dashboard (metryki) → Explore (logi) → Trace (Tempo) → Fix. Wizualne diagnozowanie = metryki + logi + trace w jednym UI (Grafana). Redukcja MTTR = 10×.

Podsumowanie: Trzy filary części 1: wybór narzędzi (Loki vs ELK), opanowanie zapytań (LogQL), opanowanie workflow (diagnostyka). Opanuj te = opanuj logowanie w SRE.

Pierwsza część wykładu o logowaniu koncentrowała się na trzech obszarach, które razem tworzą kompletny fundament pracy z logami w środowisku SRE: wyborze narzędzi, opanowaniu języka zapytań oraz zbudowaniu workflow diagnostycznego, prowadzącego od alertu przez analizę po naprawę. Zanim przejdziemy do zagadnień operacyjnych, warto podsumować i uporządkować te trzy filary, bo to one decydują o tym, czy logowanie będzie sprawnym narzędziem, czy jedynie dodatkowym źródłem szumu.

W ramach podsumowania porównamy Loki i ELK pod kątem kosztów, złożoności operacyjnej i przypadków użycia, przeanalizujemy wzorce zapytań LogQL od selektorów strumieni po agregacje i reguły nagrywające, a także przedstawimy workflow diagnostyczny: Alert → Dashboard → Explore → Trace → Fix, który redukuje MTTR nawet dziesięciokrotnie. Na koniec wskażemy, jak płynność LogQL przekłada się na prędkość reakcji i jak te same trzy umiejętności stanowią ściągawkę do powtórzenia przed egzaminem i rozmową kwalifikacyjną.

Wyjaśnienie skrótów użytych na slajdzie:
LogQL – Log Query Language – język zapytań LogQL; Kluczowa technologia analityczna platformy Grafana Loki podsumowana w pierwszej części wykładu.
Loki – Grafana Loki – system centralizacji logów; Skalowalna baza danych zoptymalizowana pod kątem niskich kosztów składowania.
Promtail – Promtail agent – agent logowania Promtail; Komponent zbierający logi z plików lokalnych i przekazujący je do serwera.
Syslog – Syslog protocol – protokół Syslog; Standard sieciowej wymiany komunikatów telemetrycznych w architekturze klient-serwer.
RFC – Request for Comments – dokument standaryzacyjny RFC; Zbiór oficjalnych specyfikacji protokołów sieciowych IETF.

43/55 Podsumowanie wykładu 4 (cz. 2)
Podsumowanie cz. 2: Instrumentacja: label hygiene (bounded cardinality), retencja/rotacja (hot→warm→cold + compliance), bezpieczeństwo (PII, RBAC, TLS), structured logging (JSON, schemat).

Druga połowa pigułki: etykiety, retencja, bezpieczeństwo i JSON zgodny ze standardami.

  • Diagnostyka w praktyce – korelacja metryk, logów i śladów pozwala na błyskawiczne przejście od objawu do bezpośredniej przyczyny usterki.
  • Wymiar biznesowy logowania – automatyzacja zbierania danych i transparentność operacyjna przekładają się na bezpośredni zysk przedsiębiorstwa.
  • Kultura dokumentacji – utrwalanie wniosków z analiz powypadkowych zapobiega ponownemu popełnianiu tych samych błędów w architekturze.
  • Równowaga kosztowa – inżynier musi stale bilansować koszty przechowywania telemetrii z korzyściami wynikającymi z szybkiego MTTR.
  • Kompleksowa obserwowalność – dopiero harmonijne współdziałanie metryk numerycznych i logów daje pełny wgląd w kondycję systemu.
Label hygiene: Higiena etykiet (ograniczona kardynalność) obok rotacji/retencji, bezpieczeństwa (PII, RBAC, TLS) i structured logging - filary dojrzałej instrumentacji.
słownik

Instrumentacja i operacje logów (slajdy 30-40) to warstwa części 2 wykładu 4: Etykiety/strumień logów (przeszukiwalność, kardynalność), Retencja/rotacja (koszt/zgodność), Bezpieczeństwo (PII, RBAC, szyfrowanie) i structured logging (JSON, normalizacja). To ściąga części 2 o tym, jak poprawnie zebrać, zabezpieczyć i przechowywać dane, a nie o teorii (higiena etykiet).

Etykiety i strumień logów - dyscyplina etykiet = przeszukiwalność: Nazewnictwo etykiet (snake_case, angielskie, opisowe: http_status_code, request_method, handler_path), wyłącznie ograniczone zbiory wartości (status_code, method, handler, job, instance, env, version). Higiena etykiet = tylko ograniczona kardynalność (odrzuć nieograniczone: user_id, trace_id, request_id, session_id, IP, email). Strumień logów = zestaw etykiet = wymiar zapytań. Dyscyplina etykiet = kontrola kosztów (eksplozja kardynalności = awaria Loki) = wydajność zapytań. Zasada: etykieta = wymiar o niskiej kardynalności, pola kontekstowe = ekstrakcja przez pipeline (json/regex) w czasie zapytania.

Retencja i rotacja - balans kosztów/zgodności: Polityka retencji (Hot 7d, Warm 90d, Cold 1-7 lat), rotacja (oparta na rozmiarze logrotate, na czasie, automatyczny Loki compactor). Storage wielopoziomowy = optymalizacja kosztów (hot→warm→cold automatycznie). Zgodność: GDPR Art. 17 (prawo do bycia zapomnianym - selektywne usuwanie), SOX (7 lat finansowe), HIPAA (6 lat zdrowotne), PCI-DSS (1 rok płatnicze). Retencja = automatyzacja (Loki: limits_config.retention_period, compactor; Elasticsearch: ILM). Rotacja = brak utraty danych (positions.yaml, WAL).

Bezpieczeństwo i structured logging: Maskowanie PII (hash/redact/drop w pipeline Promtaila), RBAC (uprawnienia folderów/data sources w Grafanie), TLS 1.3 + szyfrowanie w spoczynku (S3 SSE-KMS). Structured logging (JSON + konwencje semantyczne ECS/OTel) = parsowalne, przeszukiwalne, znormalizowane. Jakość instrumentacji = jakość zapytań.

Terminologia: labels (etykiety), log stream (strumień logów), retention policy (polityka retencji), rotation (rotacja), compactor (kompaktor), tiered storage (storage wielopoziomowy), compliance (zgodność), label hygiene (higiena etykiet), structured logging (logowanie strukturalne).

Opanowanie LogQL i wybór narzędzi to połowa sukcesu - drugą stanowią operacyjne praktyki, które decydują o tym, czy logowanie będzie wydajne, bezpieczne i zgodne z przepisami w długim okresie, a nie tylko podczas demonstracji na jednym serwisie. Dyscyplina etykiet, polityka retencji, zabezpieczenia dostępu i structured logging to cztery filary części 2 wykładu, które łączą się ze sobą i przekładają na realne koszty, ryzyko prawne oraz szybkość diagnozy w produkcji.

Na tym slajdzie omówimy higienę etykiet i konsekwencje eksplozji kardynalności dla wydajności Loki, strategię retencji balansującą wymogi compliance z kosztami przechowywania na trzech poziomach storage'u, a także zabezpieczenia dostępu obejmujące maskowanie danych osobowych, szyfrowanie i role RBAC. Przedstawimy również structured logging w formacie JSON zgodny z konwencjami ECS i OpenTelemetry, który zamienia nieuporządkowane wpisy w dane przeszukiwalne, normalizowane i gotowe do zaawansowanej analizy - a na koniec wskażemy, jak te praktyki przekładają się na jakość zapytań i stabilność operacyjną.

Wyjaśnienie skrótów użytych na slajdzie:
ELK – Elasticsearch, Logstash, Kibana – stos ELK; Klasyczne rozwiązanie logowania z pełnotekstowym indeksem podsumowane w drugiej części wykładu.
RODO – Rozporządzenie o Ochronie Danych Osobowych – unijne rozporządzenie o ochronie danych; Regulacje prawne wymuszające odpowiedzialne projektowanie systemów zbierania logów.
PII – Personally Identifiable Information – dane osobowe podlegające ochronie; Dane, których obecność w logach produkcyjnych stanowi poważne naruszenie bezpieczeństwa.
WORM – Write Once, Read Many – zapis jednokrotny, wielokrotny odczyt; Technologia ochrony archiwów przed modyfikacją gwarantująca niezmienność rejestrów audytowych.
Retention – Log Retention Policy – polityka retencji logów; Zbiór zasad określających czas przechowywania i automatycznego usuwania starych danych.

44/55 Bezpieczeństwo przy diagnostyce
Bezpieczeństwo przy diagnostyce: Dostęp do logów = dostęp do PII. Zasady: RBAC (least privilege, per folder/datasource), odpowiedzialność (no log surfing, chain of custody), kompetencja K02 - etyka i poufność.

Logi to dane wrażliwe: IP, sesje i tokeny. Dostęp tylko z powodem, zgodnie z RODO i etyką K02.

  • Ostrożność w kryzysie – inżynier analizujący logi podczas incydentu musi uważać, aby jego zapytania nie przeciążyły serwera produkcyjnego.
  • Ochrona tajemnic firmy – logi eksportowane do celów analizy powypadkowej nie mogą trafić do niepowołanych osób lub publicznych serwisów.
  • Izolacja środowisk – weryfikacja hipotez i testowanie poprawek powinno odbywać się w piaskownicy, a nie na żywej bazie danych klientów.
  • Ścieżki audytowe – wszelkie operacje przeszukiwania wrażliwych logów bezpieczeństwa są rejestrowane i podlegają kontroli wewnętrznej.
  • Odpowiedzialność etyczna – dyskrecja i profesjonalizm podczas pracy z danymi diagnostycznymi budują zaufanie do zespołu niezawodności.
Chain of custody: Łańcuch odpowiedzialności za dane; bez „buszowania” po logach (no log surfing), z najmniejszymi uprawnieniami - etyka i poufność (K02).
zasady

W analizie powłamaniowej i procedurach reagowania prowadzonych przez CERT Polska kluczowe znaczenie ma gwarancja integralności materiału dowodowego. Logi audytowe muszą być archiwizowane w technologii WORM (Write Once, Read Many / Object Lock), uniemożliwiającej modyfikację lub usunięcie rekordów nawet przez użytkownika z uprawnieniami administratora root przed upływem ustawowego okresu retencji.

Dostęp do logów to dostęp do potencjalnych danych osobowych (user_id, email, IP, token, dane biznesowe) - bezpieczeństwo przy diagnostyce dotyczy zgodności (GDPR, SOX, HIPAA), etyki i pozycji bezpieczeństwa. Bezpieczeństwo od projektu to domyślnie bezpiecznie, nie dodamy później: zakres dostępu (RBAC: viewer/editor/admin per folder/datasource), odpowiedzialność (etyka on-call, postępowanie z danymi, łańcuch dowodowy) i kompetencja K02 (etyka, poufność, odpowiedzialność); to stewardship danych.

Zakres dostępu - RBAC: Viewer (tylko podgląd dashboardów, zapytania w Explore), Editor (tworzenie/edycja dashboardów w folderach), Admin (zarządzanie użytkownikami, data sources, ustawieniami, provisioning) - według katalogu lub źródła danych (uprawnienia do folderów, uprawnienia data source = kontrola szczegółowa). SSO (SAML/OIDC/LDAP) = centralne zarządzanie tożsamością. Kontrola dostępu = najmniejsze uprawnienia (domyślnie odmowa). Logowanie audytowe: kto, co, kiedy zapytował (audit log Grafany). Rozdzielenie obowiązków: on-call widzi logi produkcyjne, deweloper widzi staging/zmaskowane.

Odpowiedzialność - etyka on-call: No log surfing (prywatność - nie przeglądasz logów użytkowników bez powodu), postępowanie z danymi incydentu (łańcuch dowodowy - logi jako dowód, nie modyfikuj), post-mortem w kulturze bez winy (skupienie na systemie, nie na osobie). Stewardship danych = obowiązek etyczny (SRE = strażnik danych). Retencja logów = wymóg prawny (nie usuwaj przed czasem, usuwaj PO czasie - prawo do bycia zapomnianym GDPR).

Nawiązanie do K02 - etyka, poufność, odpowiedzialność: K02 = kompetencje społeczne z sylabusu. Etyka (nie podsłuchujesz logów użytkowników, nie używasz danych do celów prywatnych), poufność (telemetria może zawierać PII - maskuj, szyfruj, ogranicz dostęp), odpowiedzialność (SRE = strażnik danych, decydujesz co logować i kto ma dostęp). GDPR: Art. 25 (ochrona danych od projektu - instrumentacja bez danych osobowych (PII)), Art. 32 (bezpieczeństwo przetwarzania - TLS, RBAC, szyfrowanie), Art. 33/34 (zgłaszanie naruszeń - 72h). Diagnostyka = dostęp do danych = odpowiedzialność.

Terminologia: RBAC (Role-Based Access Control), ethics (etyka), accountability (odpowiedzialność), data stewardship (zarządzanie danymi), GDPR compliance (zgodność z GDPR), chain of custody (łańcuch dowodowy), least privilege (najmniejsze uprawnienia). Bezpieczeństwo od projektu = domyślnie bezpiecznie.

Dostęp do logów to de facto dostęp do danych potencjalnie wrażliwych - adresy IP użytkowników, identyfikatory sesji, tokeny autoryzacyjne, a niekiedy nawet dane osobowe wprost pojawiają się w wpisach, co oznacza, że logowanie staje się kwestią nie tylko techniczną, lecz także prawną i etyczną, wymagającą przemyślanego projektowania od samego początku, a nie dodawania zabezpieczeń w fazie eksploatacji. Dlatego w kulturze SRE bezpieczeństwo przy diagnostyce traktujemy jako integralną część obserwowalności, a nie oddzielny temat do „załatwienia później”.

Na niniejszym slajdzie omówimy mechanizm RBAC w Grafanie z podziałem na role viewer, editor i admin oraz zasadę najmniejszych uprawnień, a także kwestię odpowiedzialności obejmującą zakaz przeglądania logów użytkowników bez uzasadnienia, łańcuch dowodowy i kulturę blameless post-mortem. Omówimy też kompetencję K02 - obejmującą etykę, poufność i odpowiedzialność za dane - oraz wymogi GDPR: art. 25 o ochronie danych od projektu, art. 32 o bezpieczeństwie przetwarzania oraz art. 33 i 34 o zgłaszaniu naruszeń w terminie 72 godzin.

Wyjaśnienie skrótów użytych na slajdzie:
LeastPrivilege – Principle of Least Privilege – zasada najmniejszych uprawnień; Fundamentalna reguła bezpieczeństwa ograniczająca dostęp do surowych logów tylko do niezbędnych ról.
RBAC – Role-Based Access Control – kontrola dostępu oparta na rolach; Mechanizm uniemożliwiający wgląd w poufne wpisy osobom spoza zespołu bezpieczeństwa.
Audit – Security Audit Trail – ścieżka audytu bezpieczeństwa; Rejestr logów operacji uprzywilejowanych dokumentujący każdą zmianę w konfiguracji systemu.
Vault – Secrets Management System – system zarządzania tajemnicami; Dedykowana platforma (np. HashiCorp Vault) chroniąca klucze szyfrujące archiwa logów.
SSH – Secure Shell – bezpieczna powłoka zdalna; Protokół dostępu do serwerów, którego logi logowania podlegają ciągłemu audytowi pod kątem ataków brute-force.

45/55 Diagnostyka: studium sukcesu
Studium sukcesu: Metoda naukowa w diagnostyce: hipoteza (educated guess) → predykcja → test → weryfikacja/fałsyfikacja. Lessons learned + preventive actions = institutionalized learning.

Debugowanie jak nauka: hipoteza, przewidywania, test i wniosek do runbooka. Studium: 47 minut od alertu do fix.

  • Studium przypadku awarii – analiza rzeczywistego incydentu pokazuje, jak metodyczne użycie logów pozwoliło uratować platformę przed paraliżem.
  • Błyskawiczne zawężenie – wykres błędów 500 w Grafanie naprowadził zespół na właściwy mikroserwis w ciągu zaledwie kilkunastu sekund.
  • Zlokalizowanie usterki – filtr LogQL ujawnił powtarzający się błąd wyczerpania puli połączeń do relacyjnej bazy danych pod dużym ruchem.
  • Skuteczna mitygacja – natychmiastowe zwiększenie limitu połączeń oraz restart serwerów przywróciły pełną sprawność usług dla klientów.
  • Trwała prewencja – raport powypadkowy doprowadził do wdrożenia mechanizmu asynchronicznego buforowania i optymalizacji indeksów SQL.
Preventive actions: Działania zapobiegawcze z lessons learned; zamieniają pojedynczą diagnozę w instytucjonalne uczenie się organizacji.
os czasu awarii

Studium sukcesu w diagnostyce uczy przez analizę realnych przypadków - nie tylko porażek: hipoteza i weryfikacja (debugowanie oparte na hipotezach), wniosek i zapobieganie (lessons learned, działania prewencyjne) oraz praktyczny przykład z osią czasu. To metoda case study prowadząca do redukcji MTTR (metoda naukowa).

Hipoteza i weryfikacja - naukowe debugowanie: Hipoteza (np. "skok CPU = presja GC") → predykcja (będzie pauza GC w logach, piłokształtny heap) → test (sprawdź logi GC, użycie heap, metryki GC) → weryfikacja/fałsyfikacja. Oparte na hipotezach = systematyczne, nie zgadywanie. Falsyfikowalność = metoda naukowa (Karl Popper). Jeśli hipoteza fałszywa → nowa hipoteza (metoda iteracyjna). Oparte na dowodach = logi/metryki/trace jako dowody.

Wniosek i zapobieganie - lessons learned: Przyczyna źródłowa → działania (naprawa kodu, konfiguracji, procesu) → środki zapobiegawcze (bramka przeglądu kodu: sprawdzenie indeksu, test integracyjny: test obciążeniowy, canary: automatyczny rollback, feature flag: wyłącznik awaryjny). Zapobieganie > leczenie: wzmocnienie systemu > reagowanie na incydenty. Utrwalenie uczenia (aktualizacja runbooka, baza wiedzy, retrospektywa zespołu). Runbook = skodyfikowana wiedza (następnym razem: 5 min, nie 50 min).

Praktyczny przykład - studium przypadku: Deploy v2.3 → skok latencji p99 200ms→2s → hipoteza: "Nowy endpoint /api/reports powoduje rywalizację o blokady DB" → weryfikacja: logi DB pokazują lock wait, explain plan = brakujący indeks → naprawa: dodaj indeks + limit puli połączeń (20→50) → canary deploy (5%, 10 min) → monitor: wskaźnik błędów 0%, p99 180ms → wdrożenie 100%. Oś czasu: wykrycie 2 min (alert), diagnoza 10 min (logi+metryki), naprawa 30 min (kod+wdrożenie), weryfikacja 5 min. Łączny MTTR = 47 min. Wnioski: bramka przeglądu kodu (indeks), test integracyjny (obciążenie), feature flag (wyłącznik awaryjny).

Terminologia: case study (studium przypadku), hypothesis-driven debugging (debugowanie oparte na hipotezach), lessons learned (wnioski), preventive actions (działania prewencyjne), MTTR (średni czas do naprawy), scientific method (metoda naukowa), falsifiability (fałsyfikowalność). Studium sukcesu = utrwalone uczenie.

Po analizie konkretnych przypadków diagnostycznych pora na refleksję nad samą metodą. Wiele awarii rozwiązuje się intuicyjnie, ale skuteczność zespołu SRE rośnie dopiero wtedy, gdy debugowanie staje się systematycznym procesem opartym na hipotezach i dowodach. To podejście, wywodzące się z nauk przyrodniczych, pozwala zamienić chaotyczne poszukiwania w powtarzalny workflow, który można doskonalić z każdym kolejnym incydentem.

W praktyce wygląda to tak: formułujemy hipotezę, na przykład przypuszczamy, że skok zużycia CPU wynika z presji garbage collectora, następnie przewidujemy konkretne symptomy w logach i metrykach, sprawdzamy je i albo potwierdzamy, albo odrzucamy. Po zakończeniu analizy nie wystarczy naprawić problem - trzeba wyciągnąć wnioski, zaktualizować runbooki i wprowadzić działania zapobiegawcze, takie jak canary deploy, feature flags czy automatyczny rollback. W ten sposób każdy incydent staje się źródłem trwałej poprawy systemu.

Wyjaśnienie skrótów użytych na slajdzie:
MTTR – Mean Time To Recover – średni czas usunięcia usterki; Główny parametr sukcesu zespołu operacyjnego osiągnięty dzięki efektywnemu wykorzystaniu logów.
RCA – Root Cause Analysis – analiza przyczyn źródłowych; Uwieńczone sukcesem dochodzenie techniczne zakończone identyfikacją błędu w oprogramowaniu.
Blameless – Blameless Culture – kultura bez obwiniania; Filozofia SRE kładąca nacisk na naprawę procedur i systemów zamiast szukania winnych awarii.
Post-mortem – Post-mortem incident report – raport poawaryjny; Ustrukturyzowany dokument zamykający incydent i definiujący działania naprawcze.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Praktyka inżynierska traktująca awarie jako naturalną okazję do usprawnienia infrastruktury.

46/55 Archiwizacja logów
Archiwizacja logów: Cold storage na AWS S3 Glacier/GCS Coldline ($1-4/TB/mies). Queryable archive: Athena/BigQuery (SQL na Parquet). WORM (immutable) + legal hold = compliance i evidence.

Archiwum to nie śmietnik: warstwy, przeszukiwalny format i prawna niezmienność plus prawo do usunięcia.

  • Długoterminowe archiwa – logi o znaczeniu audytowym i prawnym muszą być bezpiecznie przechowywane przez wiele miesięcy lub nawet lat.
  • Niezmienność nośników – archiwa danych powinny być chronione przed jakimkolwiek nadpisaniem lub modyfikacją za pomocą blokad WORM.
  • Sumy kontrolne – cyfrowe pieczętowanie plików z logami pozwala na późniejszą weryfikację ich integralności przed biegłymi sądowymi.
  • Magazyny archiwalne Glacier – wykorzystanie najtańszych klas pamięci chmurowej pozwala radykalnie obniżyć koszty wieloletniej retencji.
  • Procedury odtwarzania – zespół powinien cyklicznie testować możliwość sprawnego rozpakowania i przeszukania starych archiwów z logami.
WORM: Zapis jednokrotny, wielokrotny odczyt (niezmienny) z blokadą prawną; z archiwum SQL (Athena/BigQuery na Parquet) daje zgodność i materiał dowodowy.
archiwum

Zgodnie z procedurami CERT Polska ochrona logów przed modyfikacją (technologia WORM) stanowi warunek niepodważalności dowodów audytowych.

Archiwizacja logów to nie backup - to niezmiennicze, przeszukiwalne, zgodne archiwum dla compliance, audytu i blokady prawnej: archiwum w chmurze (S3, GCS, Azure Blob: poziomy Glacier, Archive), wyszukiwanie w archiwum (Athena, BigQuery, Loki query frontend), ewolucja schematu (Parquet/ORC) i blokada prawna. Archiwum = niezmiennicze, przeszukiwalne, zgodne (WORM, łańcuch dowodowy).

Archiwum w chmurze - storage zimny: S3 Glacier/Deep Archive ($1-4/TB/mies), GCS Coldline, Azure Archive Blob. Koszt: ~$1-4/TB/miesiąc vs Hot ~$20-50/TB/miesiąc (50× taniej!). Polityki cyklu życia (S3 Lifecycle, GCS Lifecycle, Azure Blob Lifecycle) = automatyczny tiering (Hot→Warm→Cold po X dniach). Niezmienniczość (Object Lock/WORM - Write Once Read Many) = zgodność (SOX, SEC 17a-4). Wersjonowanie = ochrona przed przypadkowym usunięciem.

Wyszukiwanie w archiwum - przeszukiwalne archiwum: Athena (SQL na S3/Parquet), BigQuery (SQL na GCS/Parquet), Loki query frontend (remote read - zapytania o zarchiwizowane chunki). Schemat: Parquet/ORC (kolumnowe, odsuwanie predykatów, przycinanie partycji = szybkie zapytania). Ewolucja schematu (dodawanie/usuwanie kolumn, poszerzanie typów, pola zagnieżdżone) = schema registry (AWS Glue, Confluent Schema Registry). Wydajność zapytań = przycinanie partycji (po dacie/tenancie) + odsuwanie predykatów (filtr przepychany do storage).

Zgodność i blokada prawna: Blokada prawna (niezmiennicza, bez usuwania - wstrzymanie z powodu sporu), blokada retencji (WORM - tryb compliance), ślad audytowy (kto zapytował co, kiedy - logi CloudTrail/GCS). Wsparcie eDiscovery (eksport, łańcuch dowodowy - dowód prawny). Archiwum = dowód prawny (dopuszczalny w sądzie). GDPR Art. 17 (prawo do bycia zapomnianym) - wymagana możliwość selektywnego usuwania (Parquet: przepisz plik, Loki: usuń chunk).

Terminologia: archiving (archiwizacja), cold storage (chłodne przechowywanie), compliance (zgodność), schema evolution (ewolucja schematu), queryable archive (przeszukiwane archiwum), legal hold (blokada prawna), WORM (Write Once Read Many), Object Lock, eDiscovery.

Dotychczas mówiliśmy o logach w kontekście bieżącego monitorowania i diagnostyki, ale równie ważna jest ich długoterminowa retencja. Regulacje prawne, takie jak SOX czy GDPR, nakazują przechowywanie danych przez lata, a potrzeby audytowe wymagają możliwości przeszukiwania archiwów. Jednocześnie koszt przechowywania rośnie z objętością, dlatego potrzebujemy strategii, która łączy dostępność danych z ekonomicznym podejściem do storage'u.

Rozwiązaniem jest archiwizacja warstwowa: logi automatycznie przechodzą z gorącej warstwy na zimną, na przykład do AWS S3 Glacier, gdzie koszt spada nawet pięćdziesiątokrotnie w porównaniu z dyskami SSD. Dane w formacie Parquet lub ORC pozostają przeszukiwalne za pomocą narzędzi takich jak Athena czy BigQuery, co oznacza, że nawet wieloletnie archiwum można przeszukiwać standardowym SQL. Mechanizmy WORM i legal hold zapewniają niezmienność danych, a możliwość selektywnego usuwania pozwala zachować zgodność z prawem do bycia zapomnianym.

Wyjaśnienie skrótów użytych na slajdzie:
WORM – Write Once, Read Many – pamięć niezmienna WORM; Technologiczna blokada zapobiegająca skasowaniu lub modyfikacji archiwalnych logów prawnych.
ObjectLock – Amazon S3 Object Lock – blokada obiektowa S3; Mechanizm chmurowy wymuszający zgodność z regulacjami finansowymi i prawnymi (np. SEC Rule 17a-4).
S3 – Simple Storage Service – obiektowy magazyn danych; Skalowalna przestrzeń chmurowa wykorzystywana do bezpiecznego składowania wieloletnich archiwów.
BCP – Business Continuity Plan – plan ciągłości działania; Strategia organizacji określająca procedury zachowania danych w sytuacjach katastrofalnych.
DRP – Disaster Recovery Plan – plan odzyskiwania poawaryjnego; Techniczne procedury odtworzenia centralnej bazy logów ze składowanych kopii zapasowych.

47/55 Monitorowanie logów systemowych
Logi systemowe (journalctl): systemd journal - indexowane, skompresowane. Filtrowanie: -u (usługa), -p (priorytet), --since (czas), -f (live). syslog = klasyczny system logowania.

Zanim Loki, poznaj journal: indeksowany dziennik systemd z filtrami po usłudze, priorytecie i czasie.

  • Dziennik systemd-journald – nowoczesny demon rejestruje wszystkie komunikaty procesów i jądra Linux w zoptymalizowanym formacie binarnym.
  • Narzędzie journalctl – wszechstronne polecenie konsoli pozwala na błyskawiczne filtrowanie zdarzeń według jednostek, czasu i priorytetów.
  • Przekazywanie do centrali – konfiguracja demona pozwala na automatyczne eksportowanie wpisów systemowych do agenta Promtail lub rsyslog.
  • Integralność binarnego rejestru – mechanizm pieczętowania kryptograficznego chroni dziennik jądra przed zatarciem śladów przez intruzów.
  • Trwałość dziennika – ustawienie parametru Storage=persistent gwarantuje zachowanie historii zdarzeń systemowych po restarcie maszyny.
systemd journal: Indeksowany, skompresowany dziennik systemu; filtry -u (usługa), -p (priorytet), --since (czas), -f (na żywo), obok klasycznego sysloga.
journalctl
CLI · Linux: przegląd logów (journalctl)
user@server:~$ sudo journalctl -u ssh --since "1 hour ago" Feb 12 10:15:11 server sshd[1234]: Accepted publickey for jnowak user@server:~$ sudo journalctl -p err -n 20 # ostatnie 20 błędów systemowych

Monitorowanie logów systemowych (syslog, journalctl) to fundament obserwowalności Linuksa: systemd journal to zunifikowane, strukturalne, indeksowane logowanie dla nowoczesnego Linuksa. Weryfikacja stanów usług (jednostki systemd), filtrowanie po priorytecie i czasie oraz gotowe polecenia (journalctl, filtr priorytetu, strukturalny wynik) stanowią podstawę codziennej pracy.

journalctl - zapytanie i filtr: journalctl -u (per usługa: sshd, nginx, docker, kubelet), -p err..crit (filtr priorytetu: 0=emerg..7=debug), --since "1 hour ago" / --until "2024-01-15 10:00" (zakres czasowy), -f (follow - live tail), -n 100 (ostatnie N linii), -o json (strukturalny wynik - parsowalne!), -o short-precise (timestamp z μs). journalctl = potężne narzędzie zapytań (indeksowane, skompresowane, forward-secure sealing).

Weryfikacja stanów: journalctl -u sshd (status sshd, logi uwierzytelniania), journalctl -u nginx (logi nginx), journalctl -k (logi jądra: OOM, błędy sprzętu), journalctl -b (logi bootu), journalctl -p 3 (błędy+). Wzorce grep: ERROR, FAILED, timeout, refused, killed, segfault. Status systemd = kontrola zdrowia (systemctl status = journalctl -u -n 20 + informacje o jednostce).

Przykładowe polecenia: journalctl -u ssh --since "1 hour ago" (ostatnia godzina SSH), journalctl -p err -n 20 (ostatnie 20 błędów systemowych), journalctl -u docker -f (live tail Dockera), journalctl -k -p 3 (błędy jądra). Przykłady CLI = gotowe do użycia. Trwały journal: /etc/systemd/journald.conf: Storage=persistent (przetrwa restart).

Terminologia: syslog, journalctl, systemd, journal, priority filter (filtr priorytetu), time range (zakres czasowy), structured output (wynik strukturalny), persistent journal (trwały journal), forward-secure sealing.

Zbieranie logów aplikacyjnych to jedno, ale nie wolno nam zapominać o logach systemowych, które opowiadają historię samego Linuksa. Init system, jądro, usługi systemowe i demony komunikują się za pośrednictwem mechanizmu journal lub klasycznego sysloga. Dla inżyniera SRE umiejętność poruszania się w tych źródłach jest równie istotna jak znajomość LogQL - bo wiele awarii zaczyna się od zdarzenia na poziomie systemu, nie aplikacji.

Narzędziem pierwszego wyboru jest journalctl - interfejs do indeksowanego, skompresowanego journala systemd, umożliwiający filtrowanie po jednostce usługi, priorytecie czy zakresie czasowym. Polecenie journalctl -u nginx --since "1 hour ago" daje natychmiastowy wgląd w logi usługi bez przeszukiwania plików. Wynik w formacie JSON otwiera drogę do integracji z centralnymi systemami agregacji, takimi jak Loki czy ELK. W starszych dystrybucjach wciąż spotykamy klasyczny syslog z portem UDP 514, ale journal to standard współczesnego Linuksa.

Wyjaśnienie skrótów użytych na slajdzie:
systemd – systemd system and service manager – menedżer systemu i usług systemd; Podstawa współczesnych dystrybucji Linuksa zarządzająca cyklem życia wszystkich usług.
journald – systemd-journald logging daemon – demon dziennika systemd; Usługa zbierająca zdarzenia z jądra, buforów initrd oraz strumieni procesów systemowych.
auditd – Linux Audit Daemon – demon audytu bezpieczeństwa Linuksa; Podsystem jądra rejestrujący wywołania systemowe, modyfikacje plików krytycznych i logowania.
auth.log – Authentication Log File – plik dziennika uwierzytelniania; Tradycyjny plik tekstowy rejestrujący próby logowania przez PAM, sudo i serwer SSH.
dmesg – Display Kernel Ring Buffer – bufor komunikatów jądra; Narzędzie odczytujące komunikaty jądra o wykrytym sprzęcie, sterownikach i błędach niskopoziomowych.

48/55 Logi aplikacji sieciowych
Logi aplikacji sieciowych: Nginx/Apache/HAProxy to choke point - widzą każdy request. Access log (request/response, status), error log (upstream errors 502/503/504). HTTP status 4xx/5xx = health indicator.

Proxy widzi każde żądanie, więc jego logi to pierwsze miejsce diagnozy: access mówi co, error mówi dlaczego.

  • Serwery pośredniczące – usługi brzegowe, takie jak Nginx czy HAProxy, stanowią kluczowy punkt sieciowy widzący każde żądanie klienta.
  • Dziennik dostępu access.log – rejestruje metodę HTTP, ścieżkę zasobu, status odpowiedzi, czas trwania oraz adres IP każdego klienta.
  • Dziennik błędów error.log – zawiera precyzyjne informacje o problemach serwerów aplikacyjnych, błędach TLS oraz przekroczeniu timeoutów.
  • Wskaźnik kodów odpowiedzi – nagły skok błędów z rodziny 500 na serwerze pośredniczącym jest niemal zawsze sygnałem awarii aplikacji w tle.
  • Formatowanie JSON na proxy – zapisywanie logów serwera WWW w formacie JSON ułatwia wyliczanie percentyli opóźnień bezpośrednio w LogQL.
Choke point: Wąskie gardło widząc każde żądanie (Nginx/Apache/HAProxy); access log (żądania, statusy) i error log (błędy upstream 502/503/504), a kody 4xx/5xx to wskaźnik zdrowia.
log Nginx

Load balancer / reverse proxy to punkt zwężenia widzący wszystkie requesty - logi aplikacji sieciowych (Nginx, Apache, HAProxy, Envoy) dają podstawową widoczność ruchu webowego i API. Access log (request/response), error log (błędy backendu), analiza statusów HTTP (4xx, 5xx, latencja) i własny format JSON; kombinacja standardowego formatu combined, formatu JSON i upstream to podstawa diagnostyki.

Access log - request/response: Standardowy format combined (IP, użytkownik, timestamp, request, status, rozmiar, referer, user-agent) - standard, czytelny dla człowieka. Własny format logu (JSON: $request_time, $upstream_response_time, $upstream_addr, $request_id, $trace_id) - strukturalny, parsowalny. Analiza logów: top URL (count by path), top IP (count by remote_addr), rozkład statusów (count by status), percentyle latencji (p50/p95/p99 $request_time). JSON + Loki = przeszukiwalne logi dostępu.

Error log - błędy backendu: Błędy upstream (502 bad gateway - upstream w dół, 503 unavailable - brak zdrowego upstream, 504 gateway timeout - przekroczony czas upstream), błędy SSL (nieudane uzgadnianie, weryfikacja certyfikatu), timeout upstream (proxy_read_timeout), connection refused (upstream nie nasłuchuje). Korelacja z metrykami (latencja upstream, wskaźnik błędów, aktywne połączenia). Error log = wczesne ostrzeżenie dla problemów backendu (widzimy 502 zanim użytkownik zgłosi).

Analiza statusów HTTP: 4xx (błędy klienta: 400 bad request - błędny format, 401 unauthorized - wymagane uwierzytelnienie, 403 forbidden - uwierzytelniony bez uprawnień, 404 not found - routing, 429 too many requests - limit tempa), 5xx (błędy serwera: 500 internal - bug aplikacji, 502 bad gateway - upstream, 503 unavailable - przeciążenie/konserwacja, 504 gateway timeout - wolny upstream). Rozkład statusów = wskaźnik zdrowia (nagły skok 5xx = incydent). Skok 4xx = problem klienta / atak / złe wdrożenie.

Terminologia: access log (log dostępu), error log (log błędów), HTTP status code (kod statusu HTTP), log format (format logu), combined log format, JSON log format, upstream (serwer backendowy), $request_time (łączny czas requestu), $upstream_response_time (czas przetwarzania upstream).

Aplikacje sieciowe takie jak Nginx, Apache czy HAProxy pełnią szczególną rolę w infrastrukturze - są punktem krytycznym, przez który przepływa każdy request do backendu. Z tego względu ich logi dostępu i logi błędów stanowią pierwsze źródło informacji o zdrowiu całej usługi. Spike kodów 5xx na poziomie load balancera może sygnalizować awarię serwisu backendowego, zanim ktokolwiek zgłosi problem.

W logach dostępu, szczególnie w formacie combined lub własnym formacie JSON, zapisywane są metody żądań, kody statusu HTTP, czas odpowiedzi i identyfikatory żądań. Logi błędów rejestrują problemy z serwerami upstream, takie jak 502 Bad Gateway, 503 Service Unavailable czy 504 Gateway Timeout. Analiza rozkładu kodów statusu pozwala odróżnić błędy klienta 4xx od problemów serwera 5xx, a połączenie tych danych z LogQL daje możliwość tworzenia zaawansowanych zapytań, na przykład identyfikacji najczęstszych ścieżek URL generujących błędy.

Wyjaśnienie skrótów użytych na slajdzie:
Nginx – Nginx web server and reverse proxy – serwer WWW i reverse proxy Nginx; Oprogramowanie serwera brzegowego rejestrujące czasy odpowiedzi i kody stanu HTTP.
Apache – Apache HTTP Server – serwer WWW Apache; Klasyczny serwer stron generujący logi access.log i error.log w ustandaryzowanych formatach.
HAProxy – High Availability Proxy – oprogramowanie równoważenia obciążenia HAProxy; Wysokowydajny load balancer rejestrujący szczegółowe czasy kolejek i nawiązywania sesji TCP.
Envoy – Envoy Cloud Native Edge Proxy – serwer proxy Envoy; Nowoczesne proxy sieciowe generujące bogate logi telemetryczne w architekturze Service Mesh.
AccessLog – HTTP Access Log – dziennik dostępu HTTP; Podstawowy plik logów serwera WWW rejestrujący każde przychodzące żądanie klienta.

49/55 Integracja Loki z metrykami
Loki + Prometheus: Unified observability - metrics (Prometheus), logi (Loki), trace (Tempo) w jednym UI. Shared time range + variables = jeden kontekst. Metrics = WHAT, logs = WHY, traces = WHERE.

Prawdziwa siła to trio: metryki, logi i ślady w jednym oknie, czasie i zmiennych. Klikasz spike, dostajesz przyczynę.

  • Koncepcja Unified Observability – łączy metryki, logi oraz rozproszone ślady w jeden spójny ekosystem wzajemnie uzupełniających się danych.
  • Uzupełnianie się sygnałów – metryki odpowiadają na pytanie, kiedy wystąpiła awaria, a logi dostarczają szczegółów wyjaśniających jej powód.
  • Nawigacja w interfejsie – kliknięcie na punkt na wykresie w platformie Grafana automatycznie otwiera logi zarejestrowane dokładnie w tym czasie.
  • Eliminacja chaosu – zunifikowany stos narzędzi zdejmuje z inżynierów konieczność ręcznego przełączania się pomiędzy wieloma programami.
  • Rozproszone śledzenie Tempo – powiązanie identyfikatora śladu pozwala natychmiast zlokalizować powolny mikroserwis w łańcuchu wywołań.
Metrics = WHAT, logs = WHY, traces = WHERE: Trójca obserwowalności - metryki (Prometheus), logi (Loki) i ślady (Tempo) w jednym UI ze wspólnym czasem.
pełny pulpit

Integracja Loki z metrykami (Prometheus) to zunifikowana obserwowalność - single pane of glass: metryki + logi + trace w jednym UI ze wspólnym kontekstem, zakresem czasowym i zmiennymi. To killer feature stacku Grafana, który przyspiesza diagnozę przez korelację metryk i logów - pełny obraz w jednym dashboardzie zamiast przełączania narzędzi (pełna obserwowalność, stack Grafana).

Wspólny pulpit w Grafanie: Data sources: Prometheus (metryki) + Loki (logi) + Tempo (trace). Jeden dashboard: panel metryk (CPU, latencja p99, wskaźnik błędów, nasycenie) + panel logów (błędy, stack trace, kontekst) + panel trace (spany, mapa usług). Wspólny zakres czasowy (time picker) + zmienne ($service, $instance, $env) = pojedynczy kontekst (jeden filtr filtruje WSZYSTKIE panele). Jeden dashboard = pełny obraz (CO + DLACZEGO + GDZIE).

Szybsza diagnoza - korelacja metryk i logów: Skok latencji (panel metryk) → klik na punkt na wykresie → panel logów w tym samym czasie (Grafana: "Show logs for this time range") → ERROR connection pool exhausted, WARN slow query. Metryki (CO: co się dzieje) → logi (DLACZEGO: dlaczego) → trace (GDZIE: w którym serwisie/span). Przejście = płynne (wspólny zakres czasowy, zmienne, link trace_id). Redukcja MTTR = 10× (z godzin na minuty). To workflow, nie magia.

Terminologia: full observability (pełna obserwowalność), metrics-logs correlation (korelacja metryk i logów), unified dashboard (zjednoczony pulpit), Grafana unified observability (zunifikowana obserwowalność), trace correlation (korelacja śladów), shared context (wspólny kontekst).

Do tej pory omawialiśmy metryki i logi jako osobne filary obserwowalności, ale prawdziwa siła pojawia się dopiero, gdy je połączymy. W systemach rozproszonych żaden pojedynczy typ danych nie wystarcza do pełnej diagnozy - metryki pokazują co się dzieje, logi wyjaśniają dlaczego, a śledzenie rozproszone wskazuje gdzie dokładnie narasta problem. Kluczem jest wspólny kontekst czasowy.

Grafana oferuje zunifikowany pulpit, w którym panele metryk Prometheusa, panel logów Loki i panel śladów Tempo współdzielą ten sam zakres czasowy i zmienne. Kliknięcie na spike na wykresie latencji prowadzi bezpośrednio do logów z tego samego okna czasowego, bez konieczności ręcznego przepisywania zakresów. Takie podejście skraca czas diagnozy nawet dziesięciokrotnie, zamieniając godziny poszukiwań w minuty. To podejście stanowi rdzeń nowoczesnej obserwowalności i jest jedną z kluczowych przewag ekosystemu Grafana Labs.

Wyjaśnienie skrótów użytych na slajdzie:
PromQL – Prometheus Query Language – język zapytań Prometheus; Język zapytań o metryki, z którego wykresy koreluje się bezpośrednio z logami w Loki.
LogQL – Log Query Language – język zapytań LogQL; Język zapytań bazy Loki umożliwiający wyliczanie szeregów czasowych z tekstu logów.
OTel – OpenTelemetry – standard OpenTelemetry; Standard zapewniający wspólne formaty danych dla śladów, logów i metryk w jednym ekosystemie.
Grafana – Grafana visualization platform – platforma analityczna Grafana; Środowisko unifikujące prezentację metryk i logów w ramach jednego pulpitu operacyjnego.
TSDB – Time Series Database – baza danych szeregów czasowych; Silnik persystencji danych telemetrycznych współpracujący z silnikiem logów.

50/55 Podsumowanie narzędzi logowania
Narzędzia logowania: ELK: Elasticsearch (search), Logstash (pipeline), Kibana (UI), Beats (shippers: Filebeat/Metricbeat). vs Loki: labels, tanie object storage, Grafana-native. Hybrid = best of both worlds.

ELK kontra Loki w pigułce: wyszukiwanie i analityka kontra etykiety i cena. Hybryda bierze oba.

  • Ekosystem narzędziowy – stos ELK dominuje w zaawansowanej analityce i bezpieczeństwie, podczas gdy Grafana Loki króluje w świecie SRE.
  • Lekkie kolektory – programy takie jak Filebeat, Promtail czy Vector gwarantują stabilny odbiór logów przy minimalnym narzucie na procesor.
  • Dobór do wymagań biznesowych – wybór architektury powinien zależeć od dostępnego budżetu, wolumenu danych oraz wymaganego czasu wyszukiwania.
  • Podejście wielowarstwowe – współczesne platformy z powodzeniem łączą tanie logi w Loki z analityką danych biznesowych w Elasticsearch.
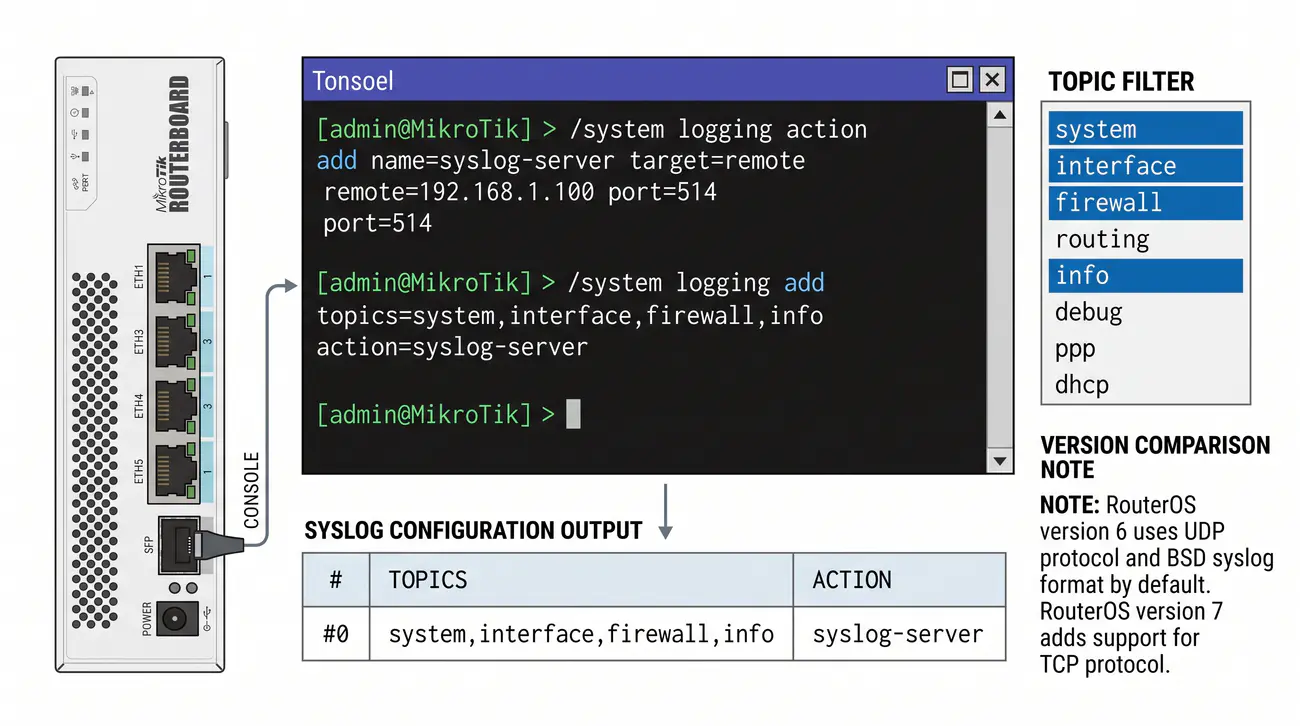
  • Ciągła ewolucja – rozwój otwartych standardów, takich jak OpenTelemetry, stopniowo zaciera bariery pomiędzy konkurencyjnymi narzędziami.
Podejście hybrydowe: ELK do pełnotekstowych poszukiwań i analityki obok Lokiego do tanich logów operacyjnych; best of both worlds zamiast wyboru albo-albo.
mapa narzędzi

Przegląd ekosystemu logowania to przewodnik wyboru narzędzi: Elasticsearch (wyszukiwanie/analityka), Kibana (wizualizacja), Logstash (potok), Beats (shippery) vs Loki (etykiety, tanio) - kiedy co wybrać, dlaczego i z jakimi kompromisami. Wybór zależy od potrzeb; logowanie hybrydowe łączy oba podejścia (wybór narzędzi).

Elasticsearch: Rozproszone wyszukiwanie/analityka (inverted index, sharding, repliki, tuning heap JVM). Kibana: Discover (ad-hoc), Visualize (wykresy), Dashboard (panele), Canvas (raporty), Lens (drag-drop), Alerting, Security (SIEM), APM, ML. Logstash: potok input/filter/output, grok (120+ wzorców), mutate, date, geoip. Beats: Filebeat (logi), Metricbeat (metryki), Packetbeat (sieć), Heartbeat (dostępność), Auditbeat (audyt), Functionbeat (serverless). Moduły = gotowe dashboardy/pipeline'y/szablony indeksów.

Loki vs ELK: Loki = indeksowanie oparte na etykietach, object storage, tanio ($0.50/GB/mies), natywnie z Grafaną, single binary, cloud-native. ELK = pełnotekstowy inverted index, bogata analityka (ML, SIEM, APM), cięższy (JVM, RAM, operacje), dojrzałość enterprise. Hybryda = Loki (hot/recent: 7-30d, tanio, szybko) + Elasticsearch (cold/archive: 1-7 lat, compliance, full-text) = najlepsze z obu światów. Wybór narzędzi = sterowany przypadkiem użycia (Loki: mikrousługi/K8s/cloud-native; ELK: compliance/SIEM/legacy/full-text; Hybryda: skala enterprise).

Terminologia: Elasticsearch (rozproszone wyszukiwanie), Kibana (wizualizacja), Logstash (potok), Beats (shippery), Loki (agregacja logów), hybrid logging (logowanie hybrydowe), tool selection (wybór narzędzi).

Przed nami podsumowanie ekosystemu narzędzi logowania, który poznawaliśmy przez cały wykład. Dwa główne podejścia - ELK Stack i Loki - reprezentują odmienne filozofie: jedno stawia na pełne przeszukiwanie tekstowe i bogatą analitykę, drugie na prostotę, niski koszt i integrację z Grafaną. Wybór między nimi nie jest oczywisty i zależy od wielu czynników, o których warto pamiętać podsumowując zdobytą wiedzę.

Elasticsearch oferuje odwrócony indeks i pełnotekstowe wyszukiwanie, Logstash dostarcza potok przetwarzania z setką wzorców Grok, Kibana zapewnia rozbudowane dashboardy i mechanizmy SIEM, a shippery Filebeat i Metricbeat dostarczają dane. Loki natomiast indeksuje wyłącznie etykiety, przechowuje dane w tanim object storage i jest sto razy tańszy w skali. Hybrydowe podejście, w którym Loki obsługuje dane gorące, a Elasticsearch archiwum, łączy zalety obu światów i sprawdza się tam, gdzie wymagania są zróżnicowane.

Wyjaśnienie skrótów użytych na slajdzie:
Loki – Grafana Loki – system logowania Grafana Loki; Zoptymalizowany pod kątem chmury system logów oparty na etykietach i magazynie obiektowym.
ELK – Elasticsearch, Logstash, Kibana – stos ELK; Wszechstronna platforma pełnotekstowa dedykowana do głębokiej analityki biznesowej.
OpenSearch – OpenSearch project – projekt OpenSearch; Otwarty fork projektów Elasticsearch i Kibana rozwijany pod auspicjami Linux Foundation.
Vector – Vector telemetry agent – agent telemetrii Vector; Wysokowydajny kolektor logów w języku Rust zastępujący tradycyjne, ciężkie narzędzia.
Fluentbit – Fluent Bit log processor – lekki procesor logów Fluent Bit; Superlekki agent w języku C zoptymalizowany pod kątem środowisk kontenerowych i systemów wbudowanych.
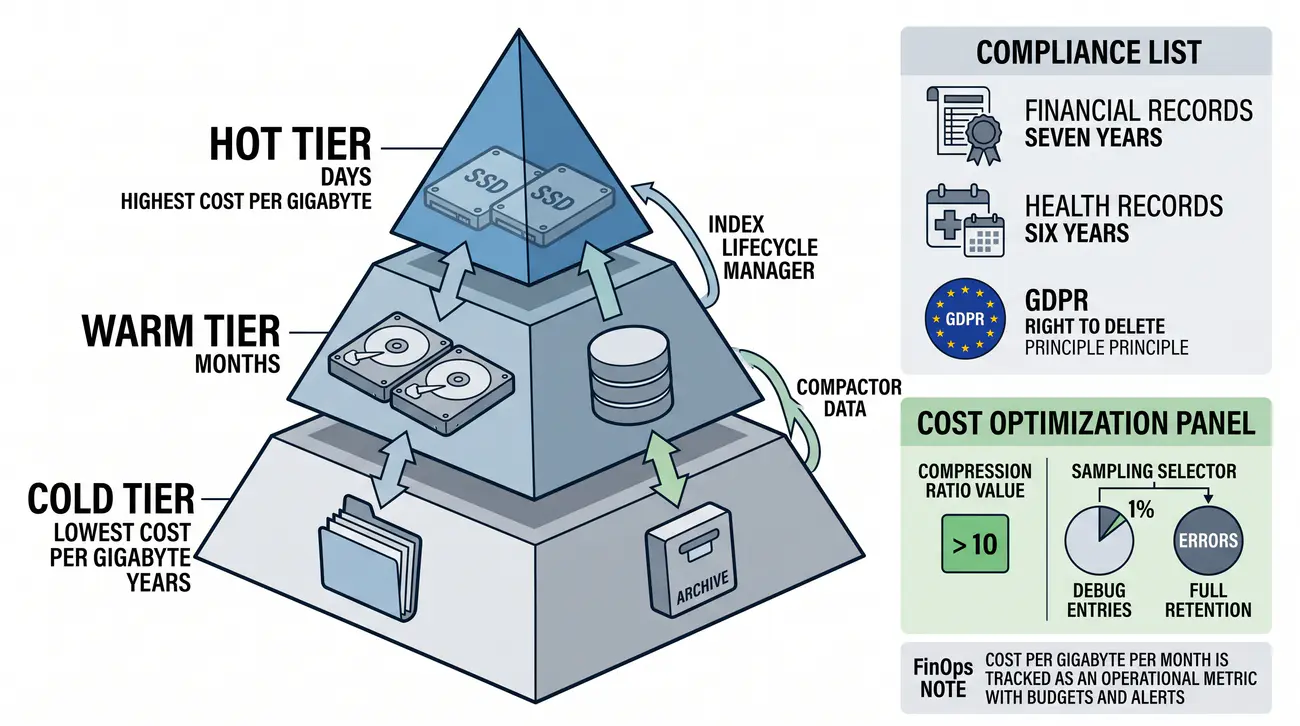
51/55 Pytania szkoleniowe (1)
Pytania szkoleniowe (1): Do przemyślenia przed egzaminem: nadmiar alertów zmienia się w szum, który podważa zaufanie zespołu; jakość alertu mierzy się kontekstem i runbookiem; integracja Prometheus-Loki-Grafana tworzy jeden stack, którego rolę warto rozważyć przed wdrożeniem, po wdrożeniu, podczas awarii i w analizie post-mortem.

Alerty mają być rzadkie i trafne: szum zabija zaufanie, a kontekst z runbookiem skraca naprawę.

  • Pytania egzaminacyjne – znajomość różnic pomiędzy indeksowaniem w Elasticsearch a etykietami w Loki jest podstawowym wymogiem wiedzy.
  • Rola dyscypliny etykiet – czy potrafisz wyjaśnić zjawisko eksplozji kardynalności i dlaczego user_id nie może być etykietą w systemie Loki?
  • Praktyka potoków LogQL – umiejętność sformułowania zapytania wyliczającego odsetek błędów HTTP 500 jest kluczową umiejętnością praktyczną.
  • Format logowania strukturalnego – dlaczego format JSON jest bardziej pożądany w nowoczesnych potokach telemetrycznych niż zwykły tekst?
  • Samodzielna powtórka – rzetelne przemyślenie tych pytań pozwala zweryfikować stan przygotowania przed przystąpieniem do sprawdzianu.
Jakość alertu: Mierzy się kontekstem i runbookiem, nie głośnością; nadmiar alertów to szum podważający zaufanie zespołu.
pytania

Pytania szkoleniowe do przemyślenia przed egzaminem - pytania otwarte, sprawdzające rozumienie (nie mechaniczną wiedzę): alerting (anomalie, rola alertów), integracja (Prometheus, Loki, Grafana) oraz wyzwania operacyjne i uzasadnienie biznesowe. Cel = sformułowanie odpowiedzi własnymi słowami.

Anomalie i alerty - pt.1 jak chcesz być budzony: Dlaczego wykrywanie anomalii = alerty do szumu? - alerty muszą być rzadkie (nadmierne alerty = szum; szum = mniejsze zaufanie; mniejsze zaufanie = ignorujemy alerty; ignorowanie = przegapione incydenty). Mniej = więcej (5 alertów/dzień > 500 alertów/dzień). Ruling out (odrzucanie hipotez) jest tak samo ważne jak confirm. Jak chcesz być budzony? = kwestia stylu (tylko awarie, Anomalie wczesne ostrzeżenie, Tylko poważne) i MTTR (przeciętna jakość alertu zależy od MTTR: kontekst: co się stało, metryki, logi, trace; runbook: krok po kroku; akcja: co naprawić).

Integracja Prometheus, Loki, Grafana - pt.2 rola stacku: Integracja Prometheus-Loki-Grafana = stack, którego rola: Metryki (Prometheus/Grafana): co się dzieje (latencja p99, wskaźnik błędów, nasycenie), Logi (Loki): dlaczego (ERROR, stack trace, kontekst), Trace (Tempo): gdzie (mapa usług, spany, zależności). To złoty trójkąt obserwowalności (metrics + logs + traces = pełna obserwowalność). Przed wdrożeniem na prod: testowanie, canary, suche dane (beta), weryfikacja wskaźników przed wdrożeniem. Po wdrożeniu: monitorowanie wskaźników (EC), porównanie z bazą, alerty.

Rola stacku podczas awarii: Awaria → alert → diagnoza (metryki: co, logi: dlaczego, trace: gdzie) → naprawa. Post-mortem: jeśli wpadliśmy w taką samą pułapkę po raz kolejny - czego nie rejestrowaliśmy wcześniej (prognozowanie)? Czy dane były wystarczające? Czy alert zadziałał wystarczająco wcześnie? Co możemy poprawić jeszcze przed kolejnym wdrożeniem (pre-production)?

Podsumowanie: Alerty = rzadkie, kontekstowe, akcje. Stack = jeden kontekst (metryki, logi, trace). Testowanie przed produkcją, monitorowanie po wdrożeniu, diagnoza w awarii, analiza po awarii. Pytania szkoleniowe = samodzielne myślenie.

Zanim przejdziemy do pytań szkoleniowych, warto zatrzymać się na chwilę i zastanowić, jak umiejętność alertowania i korzystania ze stacku obserwowalności przekłada się na codzienną pracę. Nie chodzi o mechaniczne zapamiętanie definicji, lecz o zrozumienie, dlaczego pewne decyzje operacyjne mają kluczowe znaczenie dla stabilności i niezawodności systemów.

Dlaczego alerty powinny być rzadkie? Nadmiar alertów prowadzi do szumu, szum zaś podważa zaufanie zespołu do systemu alertowego, a w konsekwencji prowadzi do ignorowania sygnałów i przegapienia prawdziwych incydentów. Jakość alertu mierzy się średnim czasem do naprawy - im lepszy kontekst, runbook i opis akcji, tym szybciej reagujemy. Złoty trójkąt obserwowalności, tworzony przez metryki, logi i ślady, stanowi fundament diagnostyki, a rozważenie roli stacku przed wdrożeniem, po wdrożeniu i podczas awarii porządkuje wiedzę przed egzaminem.

Wyjaśnienie skrótów użytych na slajdzie:
Syslog – Syslog protocol – protokół rejestrowania zdarzeń Syslog; Standard sieciowej telemetrii weryfikowany w pytaniach sprawdzających.
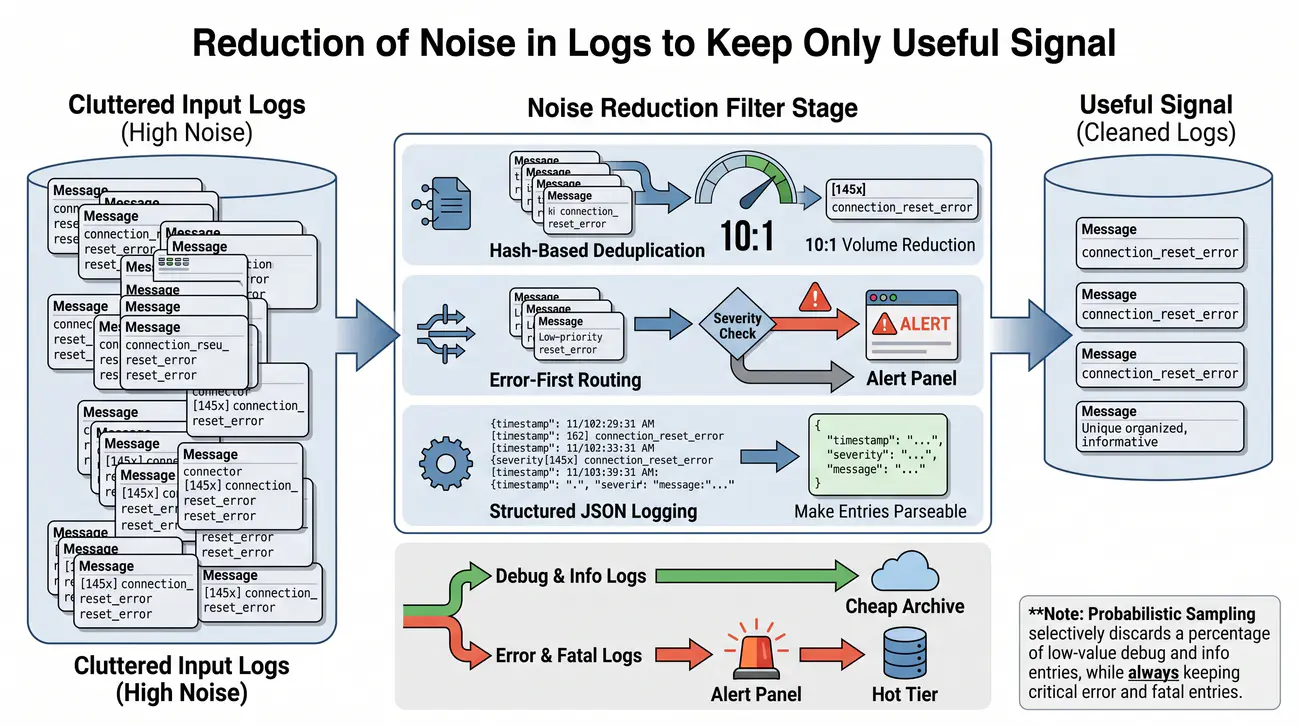
RFC – Request for Comments – dokument standaryzacji RFC; Zbiór oficjalnych specyfikacji protokołów sieciowych podlegających weryfikacji egzaminacyjnej.
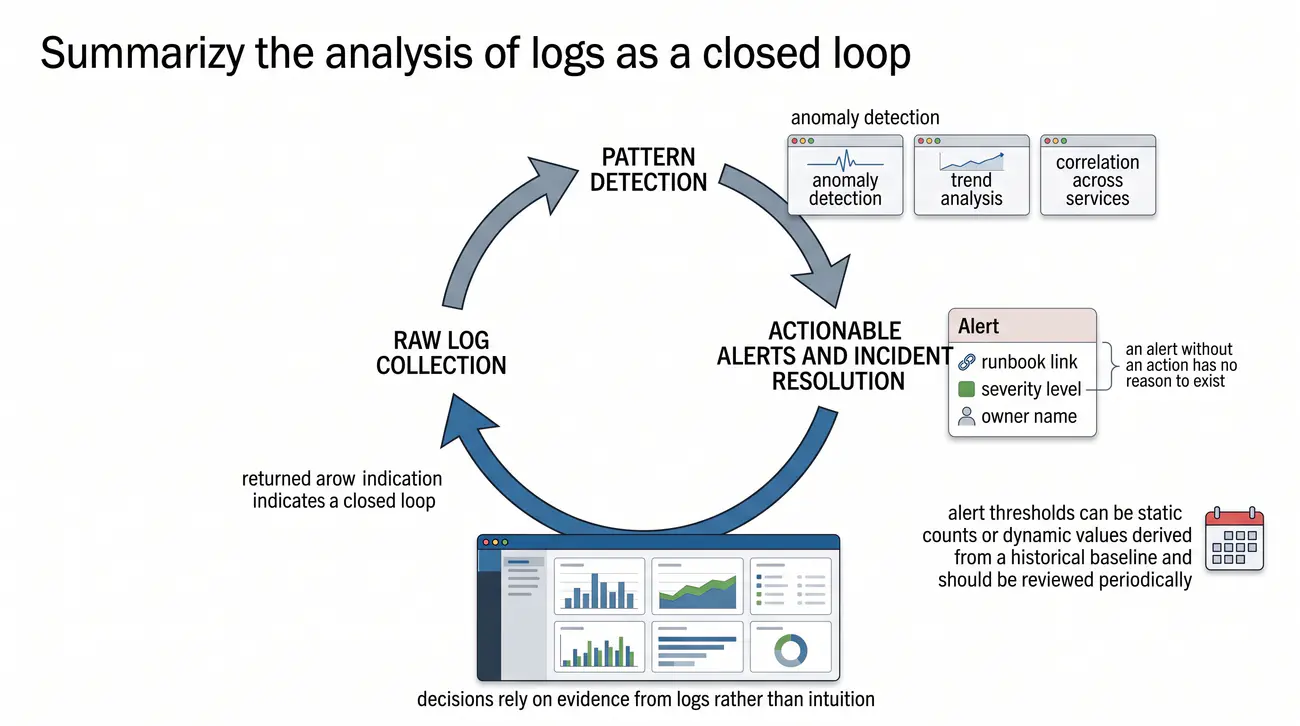
LogQL – Log Query Language – język zapytań LogQL; Praktyczna znajomość filtrów i agregacji języka LogQL testowana w zadaniach kontrolnych.
Promtail – Promtail log collector – agent logowania Promtail; Konfiguracja etapów potoku przetwarzania sprawdzana w testach wiedzy.
JSON – JavaScript Object Notation – format JSON; Format ustrukturyzowanego zapisu logów podlegający ocenie w pytaniach kontrolnych.

52/55 Pytania szkoleniowe (2)
Pytania szkoleniowe (2): Automatyzacja i finops: loging manualny vs automatyzacja, kompresja/różnica vs baza wiedzy. Odpowiedzi otwarte - nie ma jednej właściwej.

Technika plus ekonomia: ręczne jest kruche, telemetria kosztuje, a analiza przekonuje biznes.

  • Wymiar finansowy FinOps – umiejętność skalkulowania kosztów przechowywania logów i wykazania opłacalności inwestycji jest ceniona w biznesie.
  • Automatyzacja kontra ręczna praca – dlaczego ręczne przeglądanie logów na serwerach przez SSH jest zakazanym antywzorcem w metodyce SRE?
  • Kompresja i cykl życia – w jaki sposób wykorzystanie tanich magazynów obiektowych wpływa na długoterminowe budżety infrastruktury IT?
  • Argumentacja inżynierska – na egzaminie liczy się zdolność do logicznego uzasadnienia wyboru architektury w oparciu o twarde parametry techniczne.
  • Zwrot z inwestycji ROI – platforma centralnego logowania zwraca się z nawiązką już przy pierwszym sprawnie opanowanym incydencie.
FinOps w logach: Automatyzacja przeciw kruchym operacjom ręcznym; kompresja i retencja przeciw rosnącym kosztom przechowywania.
pytania

Pytania szkoleniowe (2) - druga grupa pytań otwartych: automatyzacja vs ręczne, koszty (FinOps) i uzasadnienie biznesowe logowania - sprawdza zrozumienie „dlaczego" logujemy i jak to ma się do kosztów i procesów. Odpowiedzi otwarte = analiza, nie magia (automatyzacja, FinOps).

Automatyzacja vs ręczne - pt.1 do czego dążyć: Logowanie ręczne (każdy błąd = ręczny grep po plikach, po omacku, bez kontekstu) vs automatyzacja (zapytania LogQL, panele, alerty - spójne, szybkie, powtarzalne). Rola agenta: czas na diagnostykę (automatyzacja skraca MTTR, agent nie przeklikuje GETów) + mniej błędów (ręczne = błędy). Pytanie badania: dlaczego ręczne operacje są kruche? (błędy ludzkie × czas naglący - awaria), dlaczego automatyzacja? (powtarzalność, didakość, audytowalność). Automatyzacja = spójność (ten sam runbook, te same zapytania, ta sama diagnoza) + szybkość (minuty, nie godziny) + mniej błędów.

FinOps - pt.2 uzasadnienie biznesowe: Koszt telemetrii (metria zasobów: CPU, RAM, storage, transfer) - ile zapłacisz za dane, które zbierasz. Koszt awarii (przychód stracony, reputacja, regułka) - ile kosztuje awaria. ROI logowania = (koszt unikniętych awarii − koszt logowania) / koszt logowania. Przykład: 1 awaria/mies × 2h × $5k/h = $120k/mies problemów; logowanie $2k/mies → ROI = 60×. Pytanie: jak skrócić MTTR, jak obniżyć koszt logowania (tiering, retention, streaming - invoices przez object storage).

Terminologia: automation (automatyzacja), FinOps, ROI (return on investment - zwrot z inwestycji), oracle logging (koszt logowania), MTTR (średni czas do naprawy). Odpowiedzi otwarte = analiza, nie ściąga.

Drugi zestaw pytań szkoleniowych dotyczy zagadnień, które łączą kwestie techniczne z ekonomicznymi i procesowymi. Automatyzacja, kontrola kosztów oraz uzasadnienie biznesowe to tematy, które w praktyce SRE pojawiają się tak samo często jak same narzędzia - a zrozumienie ich wpływu na operacje jest równie istotne jak znajomość LogQL czy konfiguracja Promtaila.

Dlaczego operacje ręczne są kruche? Ponieważ łączą błędy ludzkie z presją czasu typową dla awarii, a każdy manualny krok to potencjalne źródło pomyłki. Automatyzacja, czyli spójne zapytania, powtarzalne runbooki i scentralizowane alerty, eliminuje ten problem przez powtarzalność i audytowalność. Równie ważna jest perspektywa FinOps: koszt telemetrii należy porównywać z kosztem awarii, a wskaźnik zwrotu z inwestycji w logowanie pokazuje, że nawet niewielka inwestycja w stack obserwowalności zwraca się wielokrotnie przy pierwszej poważnej awarii.

Wyjaśnienie skrótów użytych na slajdzie:
RODO – Rozporządzenie o Ochronie Danych Osobowych – rozporządzenie RODO; Przepisy prawa o ochronie danych weryfikowane w kontekście logów audytowych.
Retention – Data Retention Policy – zasady retencji danych; Pojęcia okresów przechowywania i automatycznego czyszczenia logów na egzaminie.
ELK – Elasticsearch, Logstash, Kibana – architektura ELK; Zrozumienie wad i zalet pełnotekstowego indeksu odwróconego w pytaniach sprawdzających.
Loki – Grafana Loki – architektura Loki; Zasady optymalizacji kosztów i kompresji strumieni podlegające weryfikacji w teście wiedzy.
WORM – Write Once, Read Many – standard niezmienności WORM; Znajomość mechanizmów zabezpieczania logów przed usunięciem w pytaniach testowych.

53/55 Przygotowanie do egzaminu
Przygotowanie do egzaminu: Wykład 14 to obowiązkowa wiedza; lista zagadnień pogrupowana według etapów cyklu życia usługi (przed wdrożeniem, po wdrożeniu, podczas awarii, analiza post-mortem) stanowi mapę drogową do powtórki materiału przed egzaminem; 70% zaliczenia zależy od praktyki.

Egzamin to 70% praktyki: stack Loki od zera, Promtail, LogQL i korelacje. Powtórz laboratoria.

  • Obowiązkowy zakres materiału – przygotowanie do egzaminu wymaga opanowania całej ścieżki logów, od poleceń linuksowych po dashboardy.
  • Cztery złote sygnały – inżynier musi potrafić powiązać poziom opóźnień, ruch, błędy i nasycenie z konkretnymi zapytaniami analitycznymi.
  • Harmonogram powtórek – systematyczna praca z materiałami wykładowymi i wykonywanie zadań laboratoryjnych gwarantuje sukces na zaliczeniu.
  • Praktyka laboratoryjna – samodzielne skonfigurowanie agenta Promtail oraz napisanie reguł alertowych buduje bezcenne odruchy operacyjne.
  • Pewność wiedzy – opanowanie pojęć teoretycznych i warsztatu narzędziowego pozwala ze spokojem przystąpić do sesji egzaminacyjnej.
Plan powtórki materiału: Zagadnienia pogrupowane etapami cyklu życia usługi (przed i po wdrożeniu, awaria, post-mortem); 70% zaliczenia zależy od praktyki.
egzamin

Przygotowanie do egzaminu to ostatnia refaktoryzacja materiału: lista narzędzi (Logging: syslog, journalctl, Loki, Promtail, Grafana, LogQL - plus Elasticsearch, Logstash, Kibana, Beats, Szereg), monitoring (4 sygnały: latencja, ruch, błędy, nasycenie), alerting (SLO, error budget, burn rate, SLO → alert → runbook), automatyzacja i instrumentacja. Uczenie się = czas nauki = lista narzędzi do opanowania oraz plan ćwiczeń laboratoryjnych (CD, CV, PB, Login, kolejność wdrożeń).

Logging (logowanie) - narzędzia i koncepcje: syslog (klasyczny, kategoria/priorytet/urządzenie), journalctl (systemd, filtrowanie, strukturalny wynik), Loki (etykiety, object storage, single binary), Promtail (shipper, processing: regex/json), Grafana (Explore, dashboard, unified), LogQL (stream selector, line filters, aggregation), Elasticsearch/Kibana/Logstash/Beats (ELK: inverted index, Discover, grok). Praktyka (laby): uruchomienie Loki, promtail z /var/log, Python → Loki (logging_loki.LokiHandler), LogQL w Grafana, alert na błędach.

Monitoring i alerting: 4 złote sygnały (rzeczy, które najbardziej wpływają na UX: latencja, ruch, błędy, nasycenie - w dwóch warstwach: infrastruktura i aplikacja, mierzone metrykami). SLO (cel poziomu usług) - error budget (budżet błędów: 99.9% = 8.77h/rok, 43.8 min/mies), burn rate (tempo spalania: cepat = page, wolno = ticket), SLO → alert → runbook (zamknięta pętla). Synteza SLO/burn rate = świadomy alerting.

Przygotowanie do egzaminu w praktyce: 70% zaliczenia = znam laby na pamięć - praktyka. Zrób własny stack (Loki, Promtail, Grafana, Python), napisz zapytania LogQL (wszystkie typy), koreluj logi z metrykami (jedno źródło prawdy to 1 dashboard?), przygotuj odpowiedzi na pytania otwarte (Pytania szkoleniowe), dyskusja z egzaminatorem = podejście zrozumienia, nie pamięci. Uczenie się przed egzaminem = obowiązkowa wiedza + praktyka.

Terminologia: exam prep (przygotowanie do egzaminu), 4 golden signals (4 złote sygnały), SLO (service level objective), error budget (budżet błędów), burn rate (tempo spalania), runbook, dashboards, alerting, instrumentation (instrumentacja).

Zbliżamy się do końca wykładu o logowaniu, a to oznacza, że pora uporządkować wiedzę przed egzaminem. Przygotowanie powinno łączyć znajomość narzędzi, od sysloga i journalctl po LogQL i panel Loki w Grafanie, z rozumieniem koncepcji takich jak SLO, error budget czy burn rate. Kluczem nie jest pamięciowe odtwarzanie definicji, lecz umiejętność zastosowania wiedzy w praktyce.

Około siedemdziesięciu procent zaliczenia stanowi praktyczna umiejętność obsługi narzędzi, dlatego warto powtórzyć laboratoria i upewnić się, że potrafimy samodzielnie uruchomić stack Loki, skonfigurować Promtaila, napisać zapytania LogQL i skorelować logi z metrykami. Przydatna jest również lista zagadnień pogrupowanych według momentów cyklu życia usługi: przed wdrożeniem na produkcję, po wdrożeniu, podczas awarii i w analizie post-mortem. Takie podejście pomaga usystematyzować wiedzę i skutecznie przygotować się do pytań otwartych.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Podsumowanie kluczowych koncepcji przed egzaminem certyfikującym.
LogQL – Log Query Language – język zapytań LogQL; Powtórzenie zaawansowanych konstrukcji językowych przed sprawdzianem praktycznym.
PromQL – Prometheus Query Language – język zapytań Prometheus; Zestawienie funkcji języka metryk z funkcjami języka logów na egzaminie.
MTTR – Mean Time To Recover – średni czas naprawy; Definicje wskaźników operacyjnych sprawdzane w testach akademickich.
RCA – Root Cause Analysis – analiza przyczyn źródłowych; Metodologia systematycznego rozwiązywania problemów inżynierskich.

54/55 Bibliografia
Bibliografia: SRE Workbooks: Rozdział 6 Analiza informacji i wizualizacja, Rozdział 7 Używanie danych - prowadzimy analizę kosztów i korzyści oraz uzasadnienie ekonomiczne (U, O) dla danych nieużywanych.

Dalej czytaj u źródeł: Workbook Google i docsy Grafany. Decyzje architektoniczne też potrzebują cytatów.

  • Literatura podstawowa – rozdziały 6 i 7 podręcznika Google SRE Workbook szczegółowo opisują ekonomię danych oraz zasady budowy pulpitów.
  • Oficjalna dokumentacja – portale Grafana Labs oraz Elastic stanowią najbardziej wiarygodne źródła wiedzy technicznej i wzorców konfiguracji.
  • Unikanie przeładowanych widoków – literatura przestrzega przed tworzeniem nieczytelnych paneli, które zaciemniają obraz w trakcie awarii.
  • Śledzenie nowości – otwarte społeczności open-source na bieżąco publikują sprawdzone przewodniki wdrożeniowe i studia przypadków.
  • Ciągły rozwój – korzystanie z renomowanych źródeł wiedzy buduje solidne kompetencje i ułatwia dynamiczny rozwój kariery inżynierskiej.
SRE Workbook: Rozdziały o analizie informacji i używaniu danych; analiza kosztów i korzyści oraz uzasadnienie ekonomiczne dla danych nieużywanych.
książki

Bibliografia wykładu 4 to źródła do pogłębienia: SRE Workbook (Rozdziały 6 i 7) oraz dokumentacja Grafana Labs. SRE Workbook to oficjalna książka w stylu Google, poglądowe: dashboardy, integracja danych, programy alertów, zarządzanie incydentami, kultura. Rozdział 6 (analiza informacji i wizualizacji: dashboardy, wzorce) + Rozdział 7 (używanie danych: ad-hoc, analiza danych, nieużywane dane - uzasadnienie ekonomiczne).

Grafana Labs - oficjalna dokumentacja: docs.grafana.com (Docs: Grafana, Loki, Grafana Mimir, Tempo - przewodniki instalacji, Query language, najlepsze praktyki; GitHub: grafana/loki - źródła, przykłady, changelog, zgłaszanie problemów; Blog: Loki vs ELK - porównanie architektury i kosztów, New in Loki 2.x). Co czytać: przewodnik instalacji Loki (konfiguracja, storage), język zapytań LogQL (funkcje, pipeline), Konfiguracja Promtail (scrape_configs, pipeline stages), integracja z Grafaną (data source, Explore).

SRE Workbook w praktyce - dlaczego te rozdziały: Rozdz. 6 (Dashboardy jako mechanizm alertów, Wzorce: unikalne, czytelne; widoki: średni/duże; zmienne), Rozdz. 7 (Analiza danych, Używanie i nieużywanie danych - jak ocenić koszt vs korzyści; tutaj: monitoring danych = ryzyko). Te książki łączą teorię z praktyką i studiami przypadków z Google (case studies).

Terminologia: bibliography (bibliografia), SRE (Site Reliability Engineering), O'Reilly, dashboard (pulpit), data analysis (analiza danych), ad-hoc querying (zapytania tymczasowe). Pogłębione zrozumienie = wykład + literatura.

Zamykając wykład o logowaniu, warto wiedzieć, skąd czerpać dalszą wiedzę. Literatura przedmiotu obejmuje zarówno oficjalne źródła zespołu odpowiedzialnego za narzędzia, jak i rzetelne publikacje z zakresu inżynierii niezawodności. Znajomość tych źródeł przydaje się nie tylko do pogłębienia wiedzy, ale też do uzasadniania decyzji architektonicznych w zespołach.

Workbook zespołu SRE w firmie Google, szczególnie rozdziały poświęcone analizie informacji i wizualizacji oraz wykorzystaniu danych, dostarcza praktycznych wskazówek dotyczących tworzenia dashboardów, programowania alertów i zarządzania incydentami. Dokumentacja Grafana Labs na docs.grafana.com zawiera przewodniki instalacji, opis składni LogQL i najlepsze praktyki konfiguracji Promtaila. Warto śledzić również blog Grafana Labs, porównania architektury Loki i ELK oraz zmiany w kolejnych wersjach tych narzędzi.

Wyjaśnienie skrótów użytych na slajdzie:
IETF – Internet Engineering Task Force – Grupa Robocza Inżynierii Internetowej; Wydawca standardów RFC 5424 i RFC 5425 ujętych w bibliografii wykładu.
RFC – Request for Comments – dokumentacja standaryzacyjna RFC; Podstawowe źródła normatywne dla protokołów internetowych.
CNCF – Cloud Native Computing Foundation – Fundacja Oprogramowania Chmurowego; Organizacja standaryzująca projekty ekosystemu Cloud Native ujęte w literaturze.
ISO – International Organization for Standardization – Międzynarodowa Organizacja Normalizacyjna; Wydawca norm zarządzania bezpieczeństwem informacji ISO/IEC 27001.
PKN – Polski Komitet Normalizacyjny – krajowa jednostka normalizacyjna; Instytucja wprowadzająca europejskie standardy bezpieczeństwa do polskich norm PN-EN.

55/55 Pożegnanie
Dziękuję! Logowanie: syslog, journalctl, Promtail, Loki, LogQL, Grafana. Diagnostyka: metryki = CO, logi = DLACZEGO... Dziękuję za uwagę i zachęcam do pytań na forum.

Koniec wykładu, początek umiejętności: logi to świadomość, metryki to prędkość. Powodzenia na egzaminie.

  • Podsumowanie modułu – opanowanie narzędzi takich jak syslog, journalctl, Promtail, Loki i Grafana daje pełną kontrolę nad telemetrią.
  • Harmonia sygnałów – logi dostarczają szczegółowej wiedzy o przyczynach zdarzeń, podczas gdy metryki mierzą bieżącą kondycję platformy.
  • Wsparcie seminaryjne – zachęcamy do aktywnego zadawania pytań, rozwiązywania ćwiczeń oraz dyskusji na forum grupy studenckiej.
  • Praktyczne umiejętności – pamiętajmy, że inżynieria niezawodności to przede wszystkim praktyka, testowanie hipotez i ciągła automatyzacja.
  • Dziękujemy za uwagę – życzymy satysfakcji ze zdobywania nowej wiedzy i zapraszamy na kolejny wykład poświęcony wysokiej dostępności!
Świadomość systemu: Logi (syslog, journalctl, Promtail, Loki, LogQL) jako pamięć systemu wobec szybkości metryk; diagnostyka to metryki = CO, logi = DLACZEGO.
pożegnanie

Ostatni slajd wykładu 4 - pożegnanie i podsumowanie: zachęcenie do pracy z narzędziami i pytaniami szkoleniowymi, przypomnienie sukcesu (logi = świadomość), święta, życzenia i zaproszenie do dyskusji na forum.

Podsumowanie całego wykładu 4: Logowanie (systemowe: syslog, journalctl; narzędzie: Promtail → Loki → Grafana; zapytania: LogQL; integracja), Diagnostyka (korelacja metryk i logów, root cause, metodyka), Alerting (SLO, error budget, burn rate - świadomy alerting), Bezpieczeństwo (PII, RBAC, szyfrowanie), Koszty (storage, tiering, FinOps), Automatyzacja (skrócenie MTTR), Instrumentacja (labels, structured logging, retencja). Dziękuję za uwagę - zaproszenie do dyskusji.

Terminologia: thank you (dziękuję), summary (podsumowanie), Q&A (pytania i odpowiedzi), discussion (dyskusja), exam prep (przygotowanie do egzaminu). Powodzenia na egzaminie!

To już koniec wykładu o logowaniu i diagnostyce awarii. Przez ten czas poznaliśmy narzędzia i metody, które stanowią fundament obserwowalności w nowoczesnych systemach rozproszonych - od klasycznego sysloga, przez journalctl i Promtaila, po potężne możliwości LogQL i panel Loki w Grafanie. Teraz pora na krótkie podsumowanie i kilka słów na pożegnanie.

Logi to świadomość systemu, a metryki to jego szybkość i kondycja - bez jednych i drugich działamy po omacku, zwłaszcza gdy usługi pracują w dużej skali. Zachęcam do samodzielnej pracy z narzędziami, do dyskusji i pytań na forum oraz do systematycznego powtarzania materiału, zanim przystąpicie do egzaminu. Niech zdobytą wiedzę zamienicie w praktyczną umiejętność. Powodzenia i dziękuję za uwagę.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Nadrzędny kontekst inżynierski łączący zagadnienia logów z wysoką dostępnością.
HA – High Availability – wysoka dostępność; Temat przewodni kolejnego wykładu poświęconego odporności na awarie i eliminacji SPOF.
LoadBalancing – Load Balancing mechanisms – mechanizmy równoważenia obciążenia; Zagadnienie rozdziału ruchu sieciowego zapowiadane w wykładzie 5.
Keepalived – Keepalived routing and failover software – oprogramowanie przełączania awaryjnego Keepalived; Narzędzie wysokiej dostępności IP zapowiadane na kolejnych zajęciach.
VRRP – Virtual Router Redundancy Protocol – protokół redundancji routera wirtualnego; Protokół warstwy sieciowej (RFC 5798) stanowiący temat wprowadzający do wykładu 5.