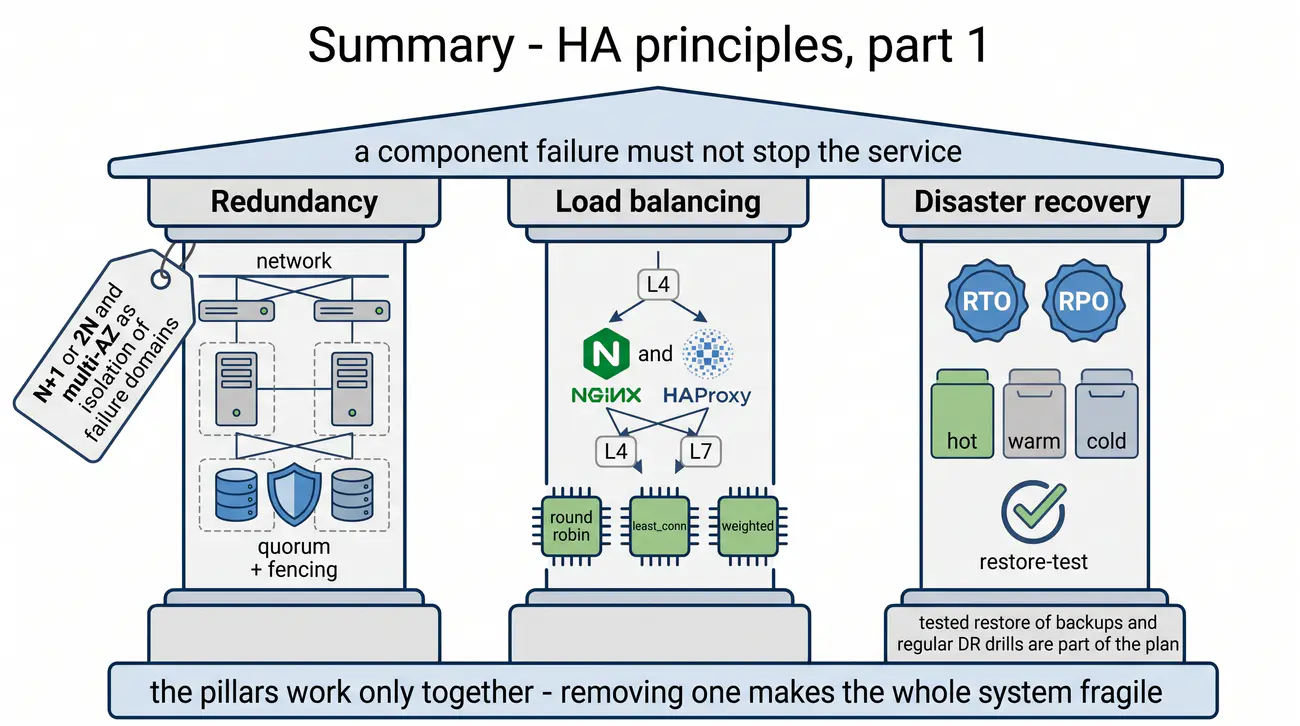
1/55 Wysoka dostępność
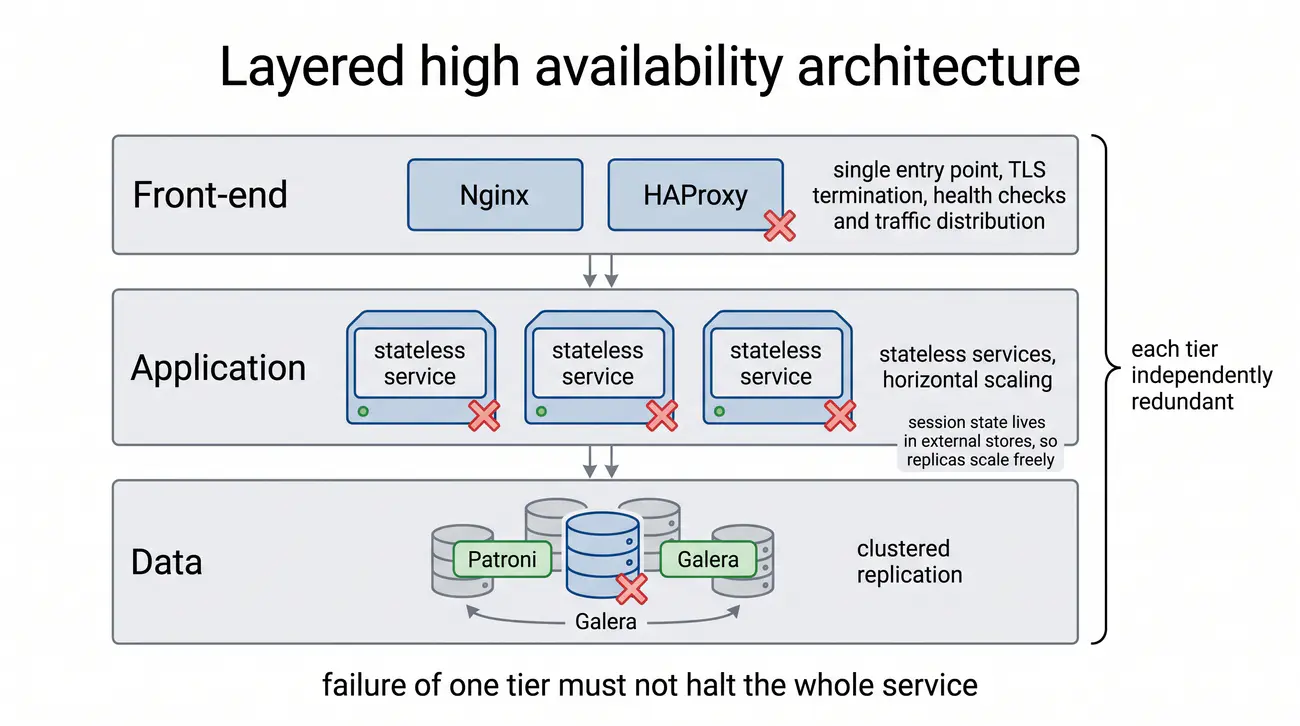
Load Balancing i HA: High Availability (HA) to zdolność systemu do ciągłej pracy mimo awarii komponentów. Load Balancing rozdziela ruch sieciowy na wiele serwerów, eliminując pojedyncze punkty awarii. Nginx i HAProxy to główne narzędzia do realizacji tego mechanizmu.

Bez HA monitoring nie ma sensu: system ma działać mimo padających komponentów. Dwa filary: redundancja i load balancing.

  • Wysoka dostępność – to cecha systemu gwarantująca ciągłość świadczenia usług użytkownikom nawet w razie fizycznej awarii pojedynczych maszyn.
  • Równoważenie ruchu – polega na inteligentnym rozdzielaniu połączeń pomiędzy pulę serwerów według bieżącego obciążenia i stanu ich zdrowia.
  • Komplementarny duet – serwery Nginx oraz HAProxy doskonale ze sobą współpracują, realizując zadania buforowania oraz precyzyjnych testów.
  • Eliminacja SPOF – wykluczenie pojedynczych punktów awarii wymaga redundancji na każdym poziomie oraz mechanizmów automatycznego przełączania.
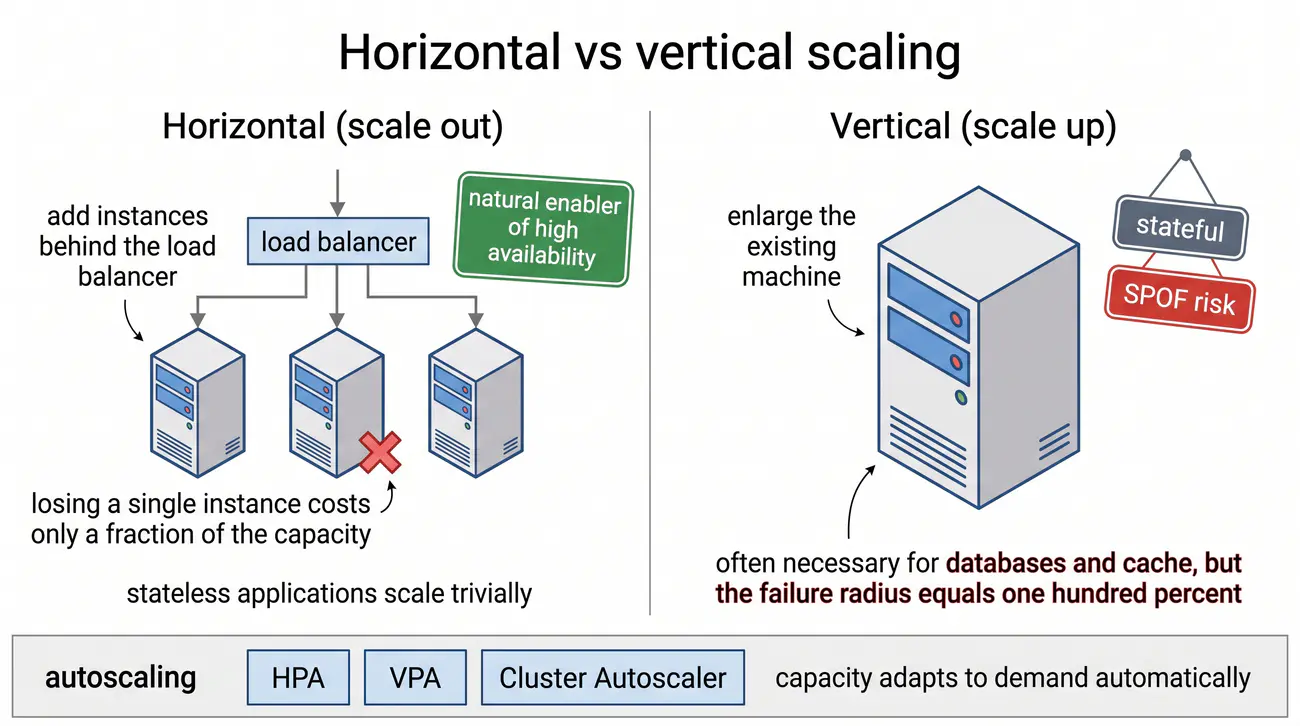
  • Skalowanie poziome – umożliwia elastyczną rozbudowę klastra poprzez dodawanie kolejnych tanich instancji zamiast kupowania drogich maszyn.
Service abstraction: Ukrycie wewnętrznej architektury przed klientem za jednym endpointem; load balancer rozdziela ruch (Nginx, HAProxy), eliminując pojedyncze punkty awarii.
architektura HA
Wprowadzenie dla studenta: W architekturze systemów komputerowych awaria jest pewnikiem – dyski twarde ulegają uszkodzeniu, kable sieciowe bywają przerywane, a oprogramowanie miewa błędy. Celem High Availability (HA) nie jest stworzenie „niezniszczalnego” pojedynczego serwera, lecz zaprojektowanie całego ekosystemu w taki sposób, aby awaria dowolnego elementu była natychmiast i niezauważalnie neutralizowana przez komponenty zapasowe.

Load balancing dystrybuuje ruch sieciowy między wiele backendów, a Nginx i HAProxy to dwa najpopularniejsze rozwiązania produkcyjne - to fundament modułu o wysokiej dostępności (High Availability, HA) i odporności systemów. Architektury HA opierają się na strategiach redundancji (eliminacja SPOF), mechanizmach failover (automatyczne przełączanie na zapasowe komponenty) oraz narzędziach monitorowania i testowania odporności; wiedza ta jest niezbędna do budowania systemów spełniających SLA na poziomie 99.9% i wyżej.

Load balancing to mechanizm rozdzielania przychodzącego ruchu sieciowego na wiele serwerów backendowych, co pozwala na skalowanie poziome (horizontal scaling) i eliminację pojedynczego punktu awarii. Dzięki load balancerowi klienci widzą jeden punkt wejścia (Virtual IP), a ruchem zarządza inteligentny algorytm biorący pod uwagę stan zdrowia serwerów, ich obciążenie i bliskość sieciową.

Nginx to wysokowydajny serwer WWW i reverse proxy, który od wersji 1.9.1 (2015) oferuje wbudowany load balancing na warstwie L7 (HTTP/HTTPS) oraz L4 (TCP/UDP). Jego architektura event-driven (asynchroniczna, non-blocking) pozwala obsługiwać dziesiątki tysięcy połączeń jednocześnie przy minimalnym zużyciu pamięci i CPU.

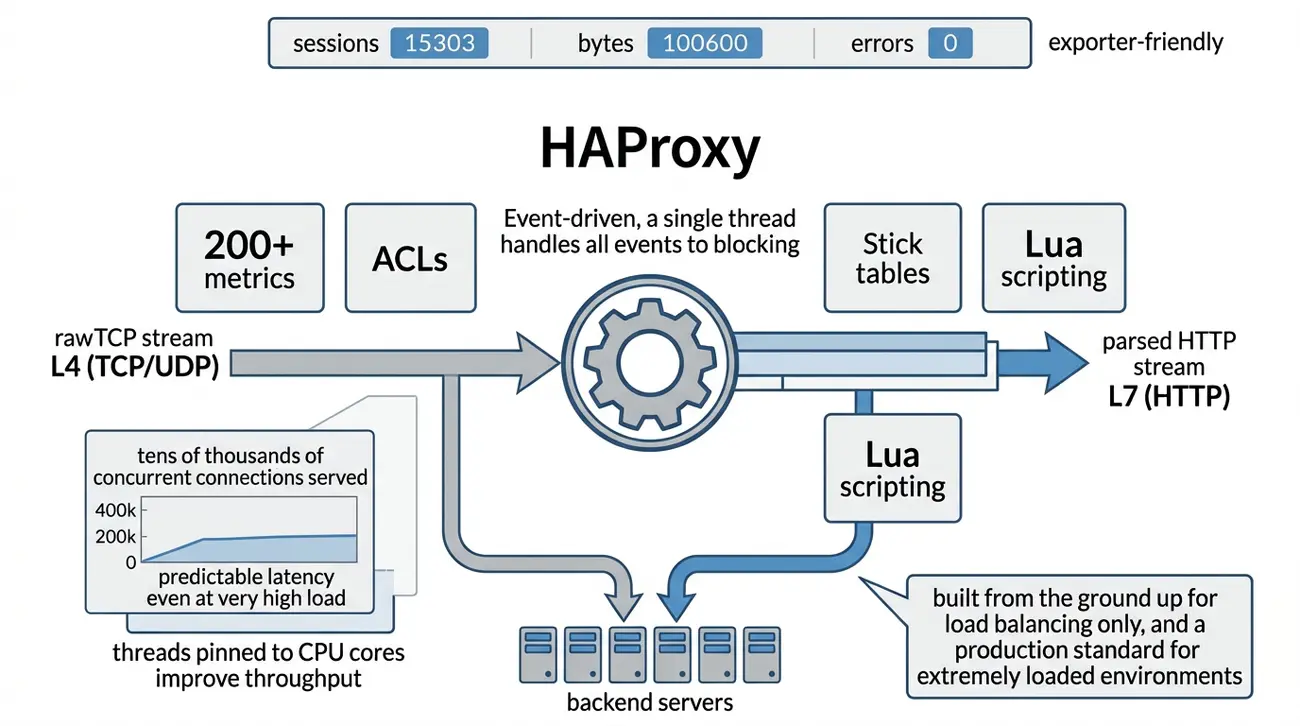
HAProxy to dedykowany, wysokowydajny load balancer zaprojektowany od zera do obsługi ruchu L4 (TCP) i L7 (HTTP). Oferuje zaawansowane health checki, ACLs (Access Control Lists), stick tables (tabele persystencji sesji), Lua scripting oraz szczegółowe metryki eksportowalne do Prometheus. Jest standardem w enterprise dla obciążeń krytycznych.

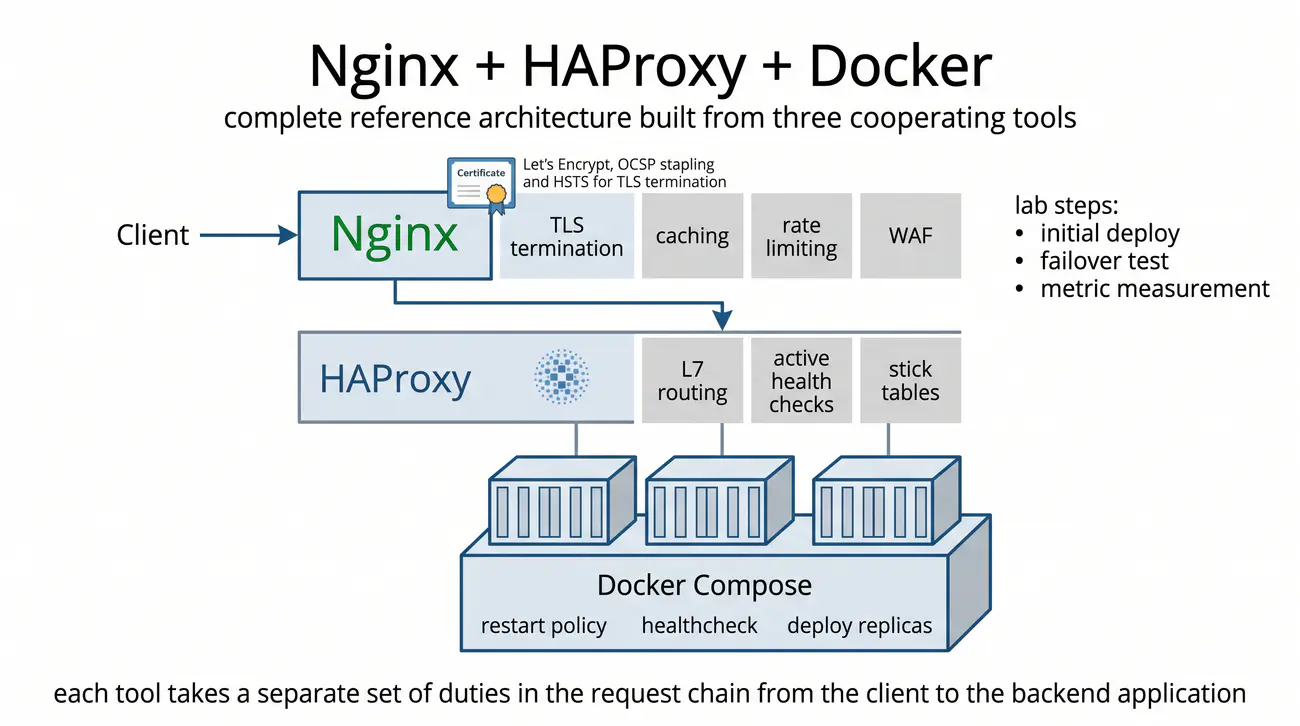
Podsumowanie: HA = eliminacja SPOF + load balancing + szybki failover + monitoring. Nginx i HAProxy to dwa komplementarne narzędzia: Nginx doskonale sprawdza się jako frontend (SSL termination, caching, L7 routing), HAProxy jako backend load balancer (zaawansowane health checki, L4/L7, metryki). Wybór zależy od use case'u - często współpracują w łańcuchu.

W poprzednich wykładach poznaliśmy metryki, logi i trzy filary obserwowalności - wszystko po to, by wiedzieć, co dzieje się w systemie. Dziś przechodzimy do zagadnienia, bez którego żaden monitoring nie ma sensu: jak sprawić, by system w ogóle działał mimo awarii poszczególnych komponentów. High Availability i load balancing to dwa filary, na których opiera się ciągłość usług w środowiskach produkcyjnych.

Load balancer dystrybuuje ruch na wiele serwerów backendowych, eliminując pojedyncze punkty awarii i umożliwiając skalowanie poziome. Nginx i HAProxy to dwa najpopularniejsze narzędzia do realizacji tego mechanizmu - komplementarne w swoich zastosowaniach. Nginx sprawdza się świetnie jako front z terminacją TLS i cachingiem, HAProxy jako zaawansowany backend z precyzyjnymi health checkami. Współpracują często w jednym łańcuchu, tworząc solidny fundament architektury o wysokiej dostępności.

Wyjaśnienie skrótów użytych na slajdzie:
HA – High Availability – wysoka dostępność; Zdolność systemu teleinformatycznego do ciągłego świadczenia usług pomimo awarii poszczególnych komponentów.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina inżynierska traktująca dostępność jako mierzalną cechę produktu opartą na architekturze redundancji.
SPOF – Single Point of Failure – pojedynczy punkt awarii; Dowolny komponent infrastruktury, którego awaria powoduje całkowite zaprzestanie działania całej usługi.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; Prawnie wiążące porozumienie określające wymagany poziom dostępności i kary za jego naruszenie.
SLO – Service Level Objective – cel poziomu usług; Wewnętrzny, inżynierski cel dostępności wyznaczający margines dopuszczalnych błędów dla zespołu SRE.

2/55 Co to znaczy wysoka dostępność
Wysoka dostępność (HA): High Availability (HA) oznacza, że system pozostaje dostępny dla użytkownika nawet przy awariach komponentów. Kluczowe filary: eliminacja SPOF (Single Point of Failure), szybkie przywracanie usługi (MTTR) i minimalizacja przestojów.

HA to nie zero awarii, lecz ich niewidzialność: system radzi sobie tak, że użytkownik nic nie czuje.

  • Minimalizacja przestojów – wysoka dostępność dąży do ograniczenia niedostępności platformy do pojedynczych minut w skali całego roku.
  • Wielowarstwowa redundancja – podstawą architektury odpornej na usterki jest zwielokrotnienie zasobów w warstwie sieci, serwerów oraz baz danych.
  • Szybki failover – automatyczne wykrywanie problemów i przełączanie ruchu pozwala skrócić czas naprawy incydentu z godzin do pojedynczych sekund.
  • Wydania bezprzerwowe – wdrażanie aktualizacji w trybie ciągłym eliminuje konieczność planowania uciążliwych nocnych przerw serwisowych.
  • Dostępność w dziewiątkach – wskaźnik niezawodności określa się liczbą dziewiątek, gdzie każda kolejna cyfra drastycznie zawęża margines błędu.
MTTR (Mean Time To Repair): Średni czas przywracania usługi; obok eliminacji SPOF i minimalizacji przestojów - filar wysokiej dostępności.
cel HA

W ujęciu matematycznym wskaźnik dostępności określa formuła: A = MTBF / (MTBF + MTTR), gdzie MTBF to średni czas bezawaryjnej pracy, a MTTR to średni czas naprawy. Zwiększenie dostępności z 99,9% (Three Nines, dopuszczalne 43,8 min przestoju miesięcznie) do 99,99% (Four Nines, dopuszczalne 4,38 min) wymaga wykładniczego wzrostu nakładów finansowych (CAPEX/OPEX) na pełną redundancję sprzętową, automatyczny failover oraz systemy zasilania i łączy operatorskich.

Wysoka dostępność (High Availability, HA) to zdolność systemu do ciągłego funkcjonowania przez długi czas bez przerywania usługi - nie oznacza zero awarii (te będą się zdarzać), lecz to, że system radzi sobie z awariami bez widocznego wpływu na użytkownika. Filary HA to eliminacja pojedynczych punktów awarii (Single Point of Failure, SPOF) przez redundancję, szybkie przywracanie usługi (niskie MTTR - Mean Time To Recovery) przez automatyczny failover oraz minimalizacja przestojów planowanych (maintenance, deploy) i nieplanowanych (awaria sprzętu, sieci, oprogramowania).

Eliminacja punktów awarii (SPOF): SPOF to każdy komponent, którego awaria powoduje awarię całego systemu. Przykłady: pojedynczy serwer aplikacji, pojedyncze łącze internetowe, pojedyncza baza danych bez replikacji, pojedynczy load balancer bez stand-by. Eliminacja SPOF wymaga redundancji: N+1 (jeden zapasowy na N aktywnych), 2N (pełna redundancja), lub multi-AZ (rozdzielenie na strefy dostępności). Każda warstwa (sieć, serwer, baza, LB) musi mieć swój plan redundancji.

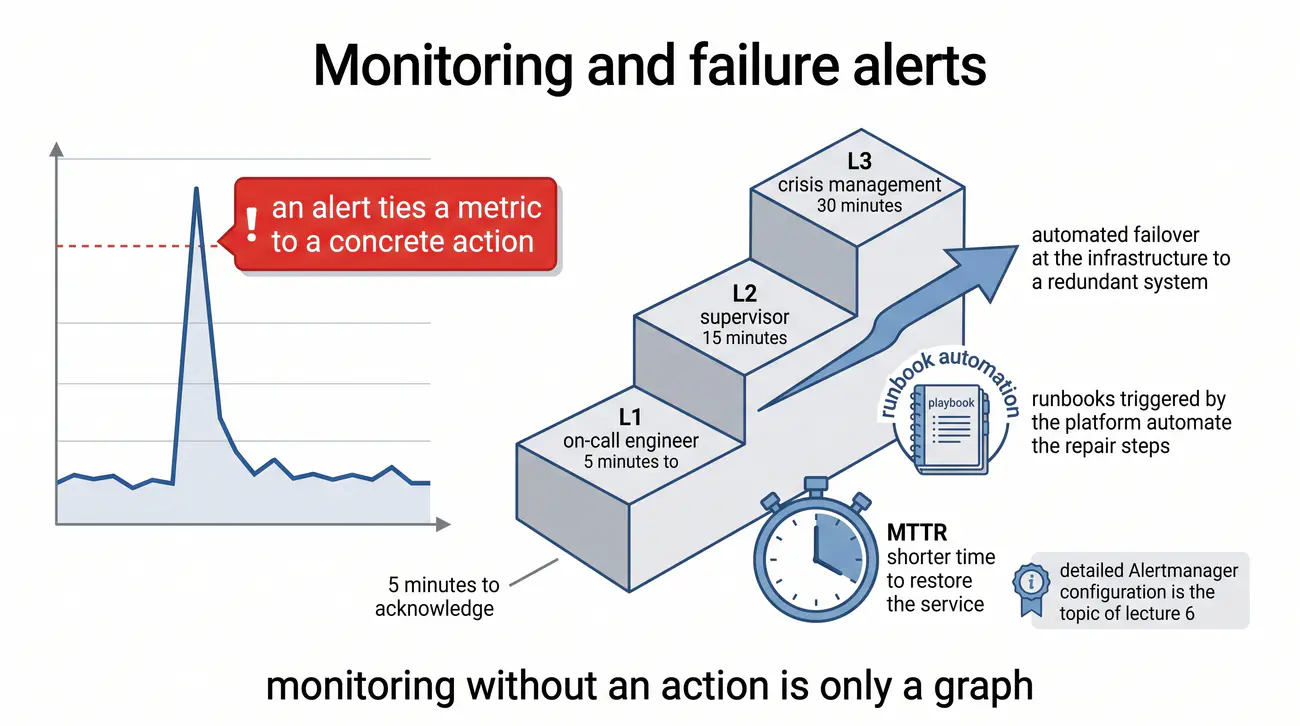
Szybkie przywracanie usługi: MTTR (Mean Time To Recovery) to średni czas od wykrycia awarii do przywrócenia usługi. W HA celujemy w MTTR rzędu sekund/minut, nie godzin. Wymaga to: automatycznych health checków (wykrywanie awarii w sekundy), automatycznego failoveru (przełączanie na zapas bez ludzkiej interwencji), gotowych runbooków (instrukcji krok po kroku) oraz testowanych procedur DR (Disaster Recovery).

Minimalizacja przestojów: Planowane przerwy (maintenance windows, rolling updates, blue-green deploy) eliminuje się poprzez strategie zero-downtime deployment. Nieplanowane przerwy minimalizuje się przez: redundancję (failover), observability (szybkie wykrywanie), chaos engineering (testowanie odporności) oraz post-mortem culture (uczenie się na błędach). Każda minuta przestoju kosztuje - w e-commerce to tysiące dolarów, w bankowości miliony.

Podsumowanie: HA = system, który "nie pada" z perspektywy użytkownika. Trzy filary: brak SPOF (redundancja), niskie MTTR (automatyzacja failover), minimalne przerwy (zero-downtime ops). HA nie jest cechą binarną (jest/nie ma) - to spektrum dostępności mierzone w "dziewiątkach" (99.9%, 99.99%, 99.999%).

Wysoka dostępność nie oznacza braku awarii - oznacza, że system potrafi sobie z nimi radzić tak, by użytkownik tego nie odczuł. To fundamentalna różnica: inżynierowie nie dążą do niemożliwego ideału zero awarii, lecz do minimalizacji ich wpływu na działanie usługi. Trzy filary tego podejścia to eliminacja pojedynczych punktów awarii, szybkie przywracanie usługi oraz minimalizacja zarówno przestojów nieplanowanych, jak i planowanych okien serwisowych.

SPOF, czyli punkt, którego awaria unieruchamia cały system, musi zostać wyeliminowany przez redundancję na każdej warstwie - od łączy sieciowych, przez serwery, po bazy danych. MTTR, czyli średni czas od wykrycia awarii do przywrócenia usługi, celujemy na poziomie sekund, nie godzin - wymaga to automatycznych health checków i failoveru bez ingerencji operatora. Przestoje planowane eliminuje się strategiami zero-downtime deployment, takimi jak blue-green czy rolling update, a nieplanowane - redundancją i chaos engineeringiem.

Wyjaśnienie skrótów użytych na slajdzie:
MTBF – Mean Time Between Failures – średni czas między awariami; Wskaźnik niezawodności określający statystyczny czas bezawaryjnej pracy systemu pomiędzy usterkami.
MTTF – Mean Time To Failure – średni czas do pierwszej awarii; Średni czas poprawnej pracy elementu nienaprawialnego aż do momentu jego uszkodzenia.
MTTR – Mean Time To Recover – średni czas przywrócenia sprawności; Czas wymagany do zdiagnozowania, usunięcia awarii i pełnego uruchomienia usługi.
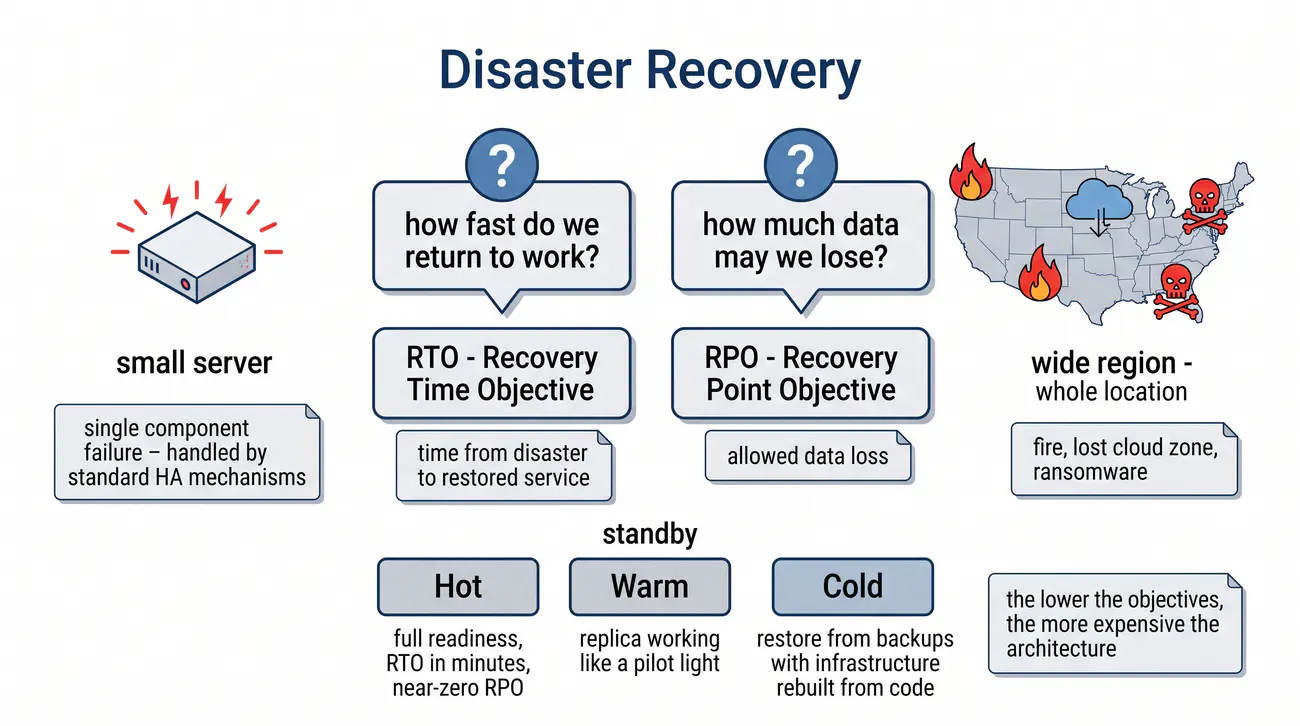
RTO – Recovery Time Objective – docelowy czas odzyskiwania; Maksymalny dopuszczalny okres przestoju technologicznego w planach ciągłości działania.
RPO – Recovery Point Objective – docelowy punkt odzyskiwania; Maksymalny dopuszczalny okres utraty danych transakcyjnych mierzony wstecz od momentu awarii.

3/55 Miara dostępności (przypomnienie)
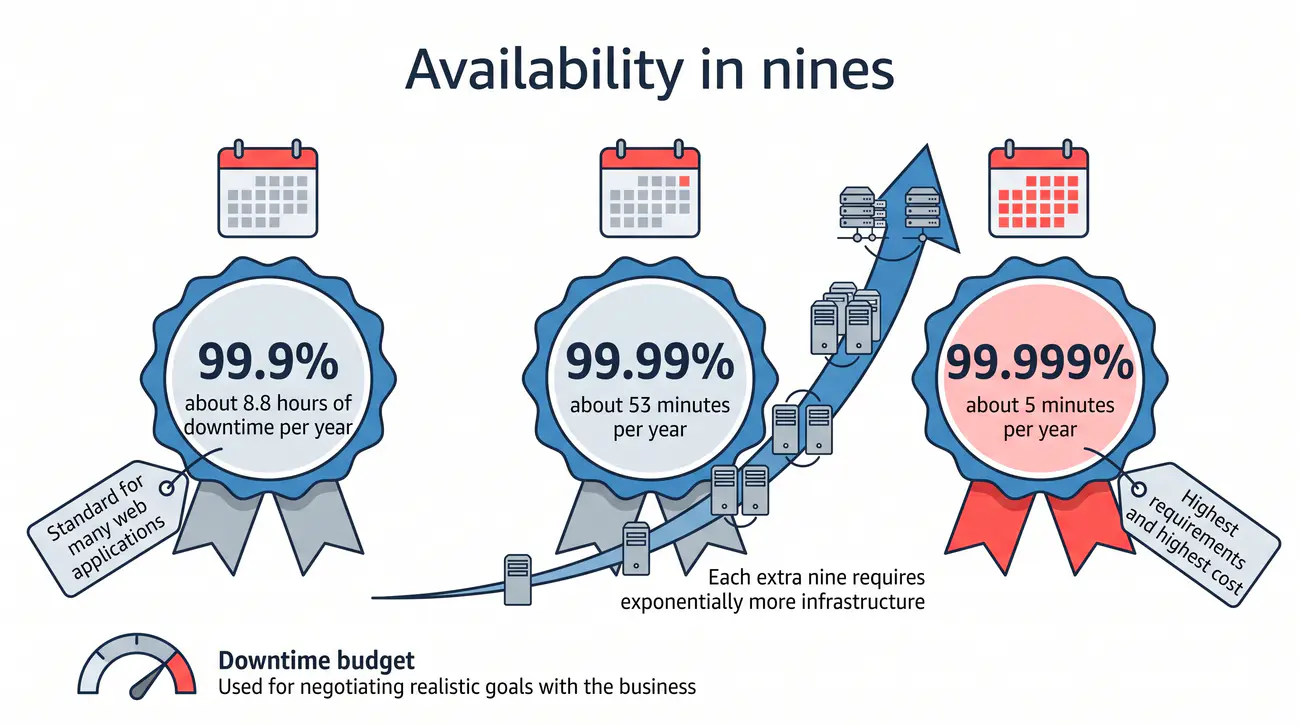
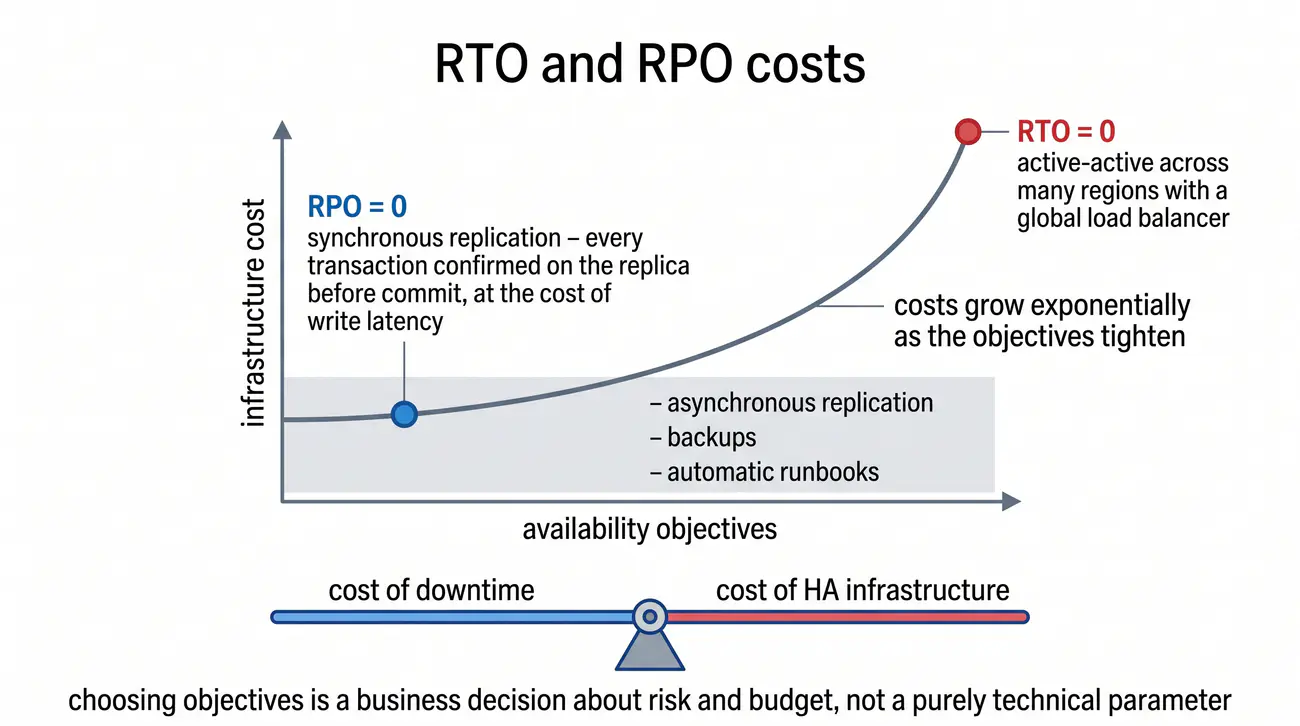
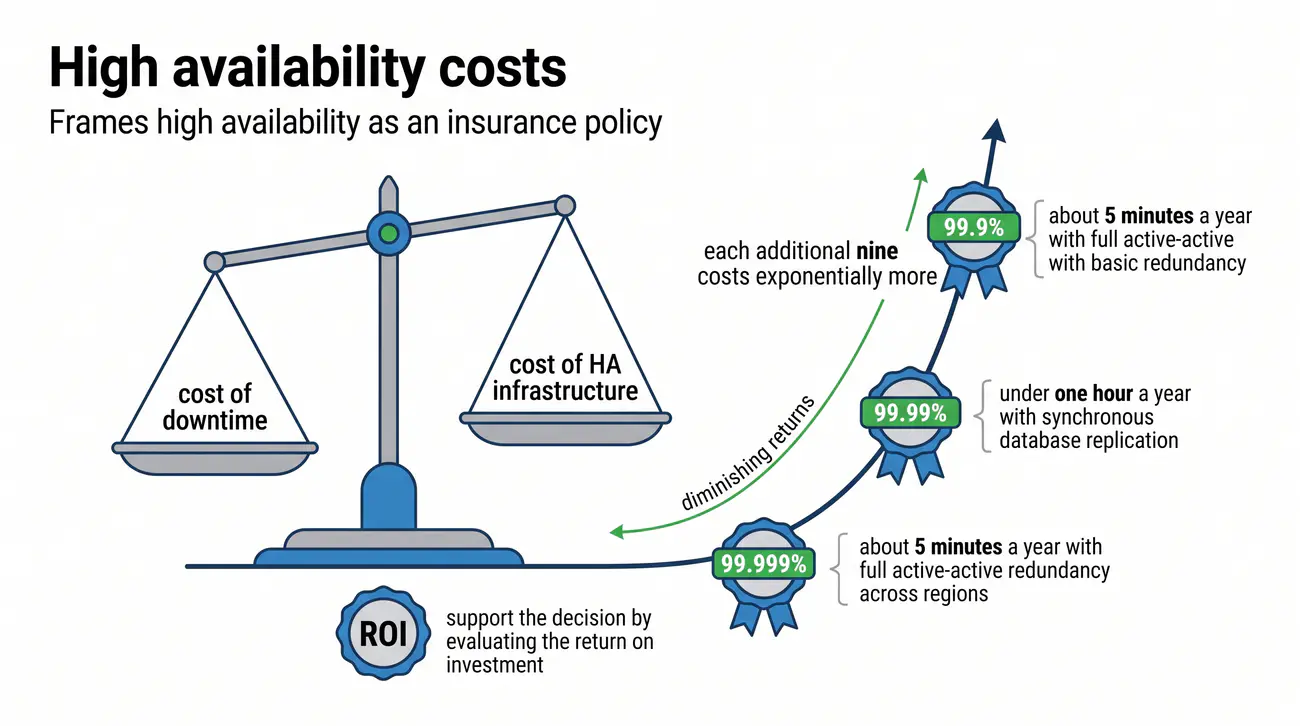
Miara dostępności: Dostępność mierzy się w dziewiątkach: 99.9% = ok. 8,76h przestoju/rok, 99.99% = ok. 52,6 min/rok, 99.999% = ok. 5,25 min/rok. Każda dodatkowa dziewiątka kosztuje wykładniczo więcej infrastruktury.

Dziewiątki tłumaczą biznesowi cenę niezawodności: każda kolejna to wykładniczo droższa infrastruktura.

  • Trzy dziewiątki (99.9%) – dopuszczają niemal dziewięć godzin niedostępności platformy w ciągu całego roku kalendarzowego.
  • Cztery dziewiątki (99.99%) – zmniejszają roczny margines przestoju do około pięćdziesięciu minut, wymagając pełnej automatyzacji systemów.
  • Wykładniczy koszt – każda kolejna dziewiątka w umowie SLA podnosi koszty infrastruktury z uwagi na konieczność wielokrotnej redundancji.
  • Budżet przestoju – stanowi wspólny język inżynierów i biznesu, określając ile minut awarii serwis może bezpiecznie znieść w danym kwartale.
  • Kalkulacja opłacalności – wybór poziomu dostępności musi wynikać z chłodnej kalkulacji strat finansowych spowodowanych przestojem serwisu.
Dziewiątki dostępności: 99,9% to ok. 8,76 h przestoju rocznie, 99,99% to ok. 52,6 min, 99,999% to ok. 5,25 min; każda kolejna kosztuje wykładniczo więcej.
tabela przestojów

Normy niezawodności i dostępności systemów teleinformatycznych określa Polski Komitet Normalizacyjny (PN-EN ISO/IEC 25010).

W ujęciu matematycznym wskaźnik dostępności określa formuła: A = MTBF / (MTBF + MTTR), gdzie MTBF to średni czas bezawaryjnej pracy, a MTTR to średni czas naprawy. Zwiększenie dostępności z 99,9% (Three Nines, dopuszczalne 43,8 min przestoju miesięcznie) do 99,99% (Four Nines, dopuszczalne 4,38 min) wymaga wykładniczego wzrostu nakładów finansowych (CAPEX/OPEX) na pełną redundancję sprzętową, automatyczny failover oraz systemy zasilania i łączy operatorskich.

Miara dostępności kwantyfikuje ile dziewiątek (nines) oferuje system: 99.9% to ok. 8 godzin 45 minut przestoju rocznie, 99.99% to ok. 52 minuty 36 sekund rocznie, a skala biegnie od 99% (3.65 dnia rocznie) do 99.999% (5 minut 15 sekund rocznie). Obliczanie dopuszczalnego przestoju (downtime budget) i tabela porównawcza poziomów dostępności to fundament planowania SLA (Service Level Agreement) i negocjacji z biznesem.

99.9% ("trzy dziewiątki") to standard dla wielu aplikacji webowych: dopuszcza 8h 45m 36s przestoju rocznie, 43m 50s miesięcznie, 10m 5s tygodniowo, 1m 26s dziennie. Wymaga podstawowej redundancji (N+1) i automatycznego failoveru rzędu minut. Koszt infrastruktury: umiarkowany.

99.99% ("cztery dziewiątki") to standard dla systemów krytycznych (bankowość, e-commerce, telekomunikacja): dopuszcza 52m 36s rocznie, 4m 23s miesięcznie, 1m 5s tygodniowo, 8.6s dziennie. Wymaga: active-active lub szybkiego active-passive failoveru (< 30s), multi-AZ deployment, zaawansowanych health checków, automatyzacji DR. Koszt infrastruktury: wysoki (2-3x vs 99.9%).

99.999% ("pięć dziewiątek") to "półka" dla systemów mission-critical (systemy sterujące, medyczne, finansowe core): dopuszcza 5m 15s rocznie, 26s miesięcznie, 6s tygodniowo, < 1s dziennie. Wymaga: pełnej redundancji 2N, geograficznej rozproszoności (multi-region), self-healing, zero-downtime deployments, chaos engineering. Koszt: bardzo wysoki, często nieopłacalny dla typowych aplikacji webowych.

Podsumowanie: Dostępność = 1 - (downtime / total_time). Każda dodatkowa "dziewiątka" kosztuje wykładniczo więcej, a zyski maleją (prawo malejących zwrotów). Biznes musi zdecydować: jaki poziom HA jest opłacalny (cost of downtime vs cost of HA infrastructure). Downtime budget = narzędzie decyzyjne, nie cel sam w sobie.

Pojęcie dostępności liczonej w tzw. dziewiątkach towarzyszyło nam już przy okazji definiowania celów SLO - dziś wracamy do tego tematu, by zrozumieć, ile kosztuje każda kolejna dziewiątka i dlaczego wybór poziomu dostępności jest decyzją ekonomiczną, nie tylko techniczną. To narzędzie, które pozwala zespołowi i biznesowi rozmawiać wspólnym językiem o kompromisach między niezawodnością a kosztami infrastruktury.

Zatrzymanie się na poziomie 99,9 procent oznacza około ośmiu godzin i czterdziestu pięciu minut przestoju rocznie - to standard dla wielu aplikacji webowych. Dziewięćdziesiąt dziewięć i dziewięćdziesiąt dziewięć setnych to już tylko około pięćdziesięciu dwóch minut rocznie, a pięć dziewiątek to ledwie pięć minut. Każda kolejna dziewiątka wymaga wykładniczo większych nakładów na redundancję, wielostrefowość i automatyzację - dlatego downtime budget stanowi podstawę negocjacji z biznesem o realistycznym celu.

Wyjaśnienie skrótów użytych na slajdzie:
Uptime – System Uptime – czas bezawaryjnej pracy; Łączny okres, w którym usługa teleinformatyczna była w pełni dostępna dla użytkowników końcowych.
Downtime – System Downtime – czas przestoju; Okres niedostępności lub krytycznej degradacji funkcjonalności systemu teleinformatycznego.
SLA – Service Level Agreement – umowa o poziomie usług; Formalny kontrakt określający progi dostępności wyrażane w tzw. dziewiątkach (np. 99,9%).
SLO – Service Level Objective – cel poziomu usług; Wewnętrzny cel jakościowy, którego stopień realizacji chroni organizację przed naruszeniem SLA.
SLI – Service Level Indicator – wskaźnik poziomu usług; Mierzalny stosunek liczby pomyślnych operacji do wszystkich żądań obsłużonych przez system.

4/55 Pojedynczy punkt awarii
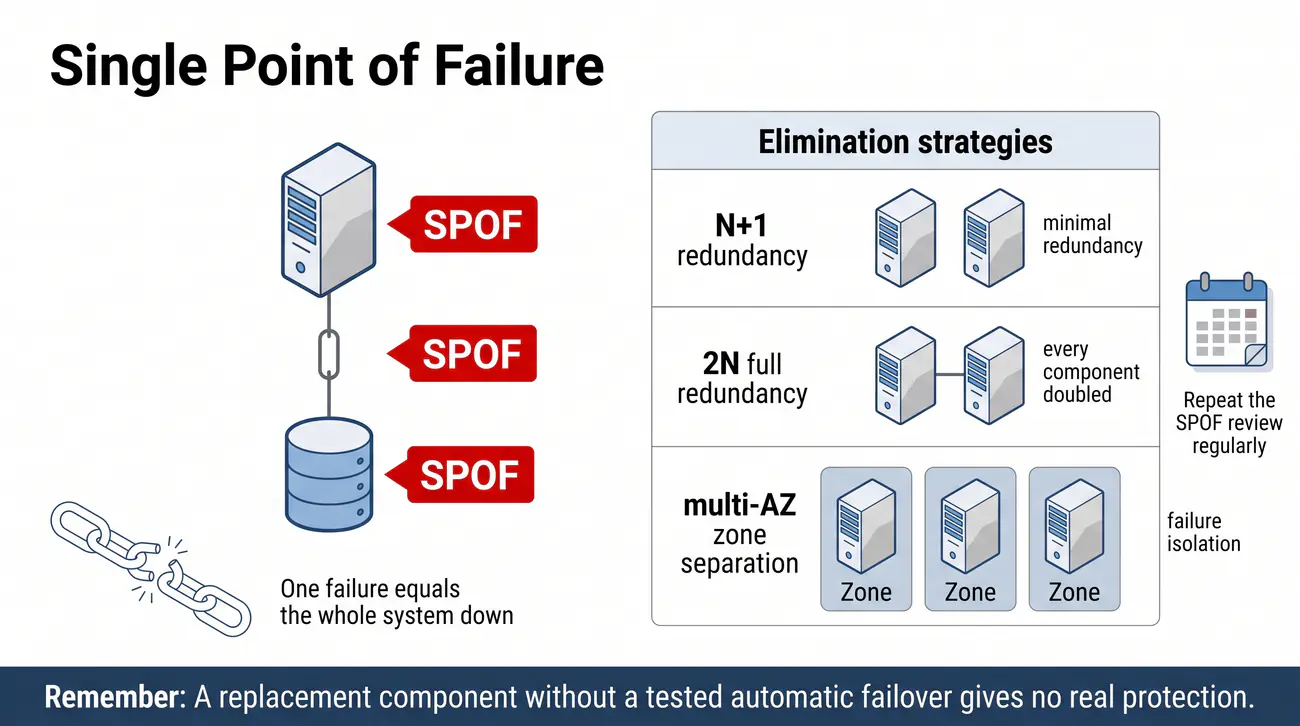
Pojedynczy punkt awarii (SPOF): SPOF (Single Point of Failure) to każdy komponent, którego awaria powoduje niedostępność całego systemu. Typowe SPOF: pojedynczy serwer, łącze, baza danych, load balancer. Eliminacja przez redundancję (N+1, 2N, multi-AZ).

SPOF to każdy element, którego pad kładzie całość - sprzęt, sieć, aplikacja, a nawet człowiek. Szukaj ich kwartalnie.

  • Definicja SPOF – pojedynczy punkt awarii to dowolny element infrastruktury, którego usterka prowadzi do natychmiastowego paraliżu całego systemu.
  • Miejsca newralgiczne – typowymi punktami krytycznymi są pojedyncze serwery bazodanowe, samotne łącza światłowodowe oraz brak zasilania UPS.
  • Architektura strefowa – odporność na awarie wymaga utrzymywania komponentów zapasowych w niezależnych strefach dostępności i centrach danych.
  • Ludzki punkt awarii – sytuacja, w której kluczowa wiedza spoczywa tylko w rękach jednego inżyniera, wymaga tworzenia rzetelnej dokumentacji.
  • Audyty i testy – regularna weryfikacja infrastruktury i próbne odłączanie maszyn sprawdzają, czy zapasowe instancje potrafią przejąć ruch.
SPOF (Single Point of Failure): Komponent, którego awaria kładzie cały system (serwer, łącze, baza, balancer); eliminacja przez redundancję N+1, 2N, multi-AZ.
SPOF vs redundancja

W analizie SPOF błędem jest ograniczanie się do serwerów aplikacyjnych. Ukryte punkty awarii obejmują: pojedynczy przełącznik dostępowy (switch), pojedynczą listwę zasilającą (PDU), nadrzędną bazę danych, a także usługi zewnętrzne, takie jak serwery DNS czy certyfikaty SSL. Projektowanie architektury HA wymaga eliminacji każdego z tych punktów poprzez wdrożenie redundancji Active-Active (jednoczesne przetwarzanie obciążenia) lub Active-Passive (węzeł zapasowy z mechanizmem automatycznego przejęcia roli).

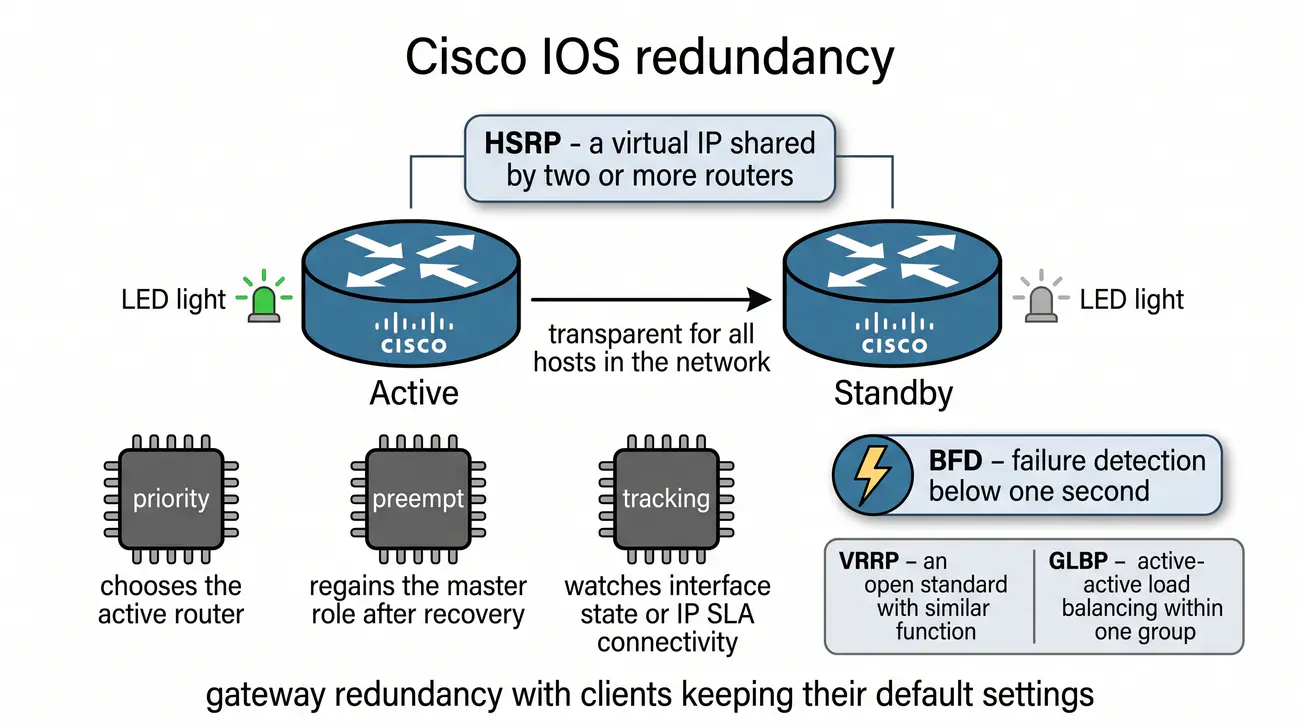
SPOF (Single Point of Failure) to dowolny komponent - sprzętowy, programowy, sieciowy lub ludzki - którego awaria powoduje awarię całego systemu lub jego krytycznej części. Typowe przykłady to pojedynczy serwer aplikacji (brak replikacji), pojedyncze łącze internetowe (brak failoveru), baza danych bez replikacji (brak standby), pojedynczy load balancer (brak VIP failover) i pojedynczy switch/router (brak VRRP/HSRP); sprawdzone strategie eliminacji SPOF to powielanie komponentów - redundancja N+1, 2N, multi-AZ i multi-region.

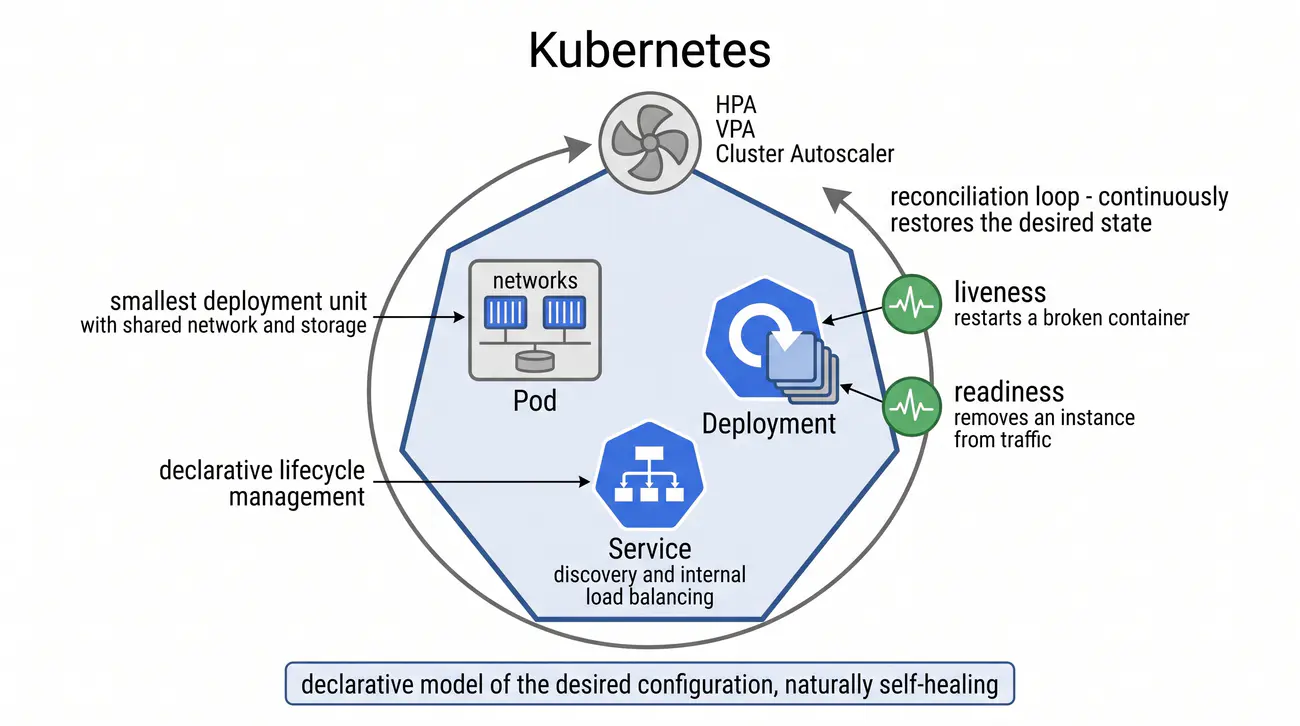
Przykłady SPOF w warstwie obliczeniowej: pojedynczy serwer aplikacji (jeśli pada - usługa niedostępna), pojedynczy kontener bez orkiestracji (Kubernetes restartuje, ale single replica = downtime), pojedyncza maszyna wirtualna bez HA w hipernadzorcy (VMware HA, Proxmox HA). Rozwiązanie: horizontal scaling (wiele replik), Deployment w K8s z replicas > 1, PodDisruptionBudget.

Przykłady SPOF w warstwie danych: pojedyncza baza danych (PostgreSQL/MySQL bez replikacji/standby) - awaria dysku = utrata danych i downtime. Rozwiązanie: replikacja (master-slave, master-master, synchronous/asynchronous), Patroni/etcd dla PostgreSQL, Galera Cluster dla MySQL/MariaDB, automated failover (repmgr, Patroni). Backup to nie HA - to DR.

Przykłady SPOF w warstwie sieci: pojedyncze łącze ISP (brak BGP multihoming, brak failoveru na 4G/5G backup), pojedynczy router brzegowy (brak HSRP/VRRP), pojedynczy switch dostępowy (brak stacking/MLAG), pojedynczy load balancer (brak keepalived/VRRP/floating IP). Rozwiązanie: redundancja sieciowa na każdym poziomie, diverse paths, diverse ISPs.

Przykłady SPOF w warstwie ludzkiej/operacyjnej: tylko jeden admin znający system (bus factor = 1), brak dokumentacji, brak runbooków, brak cross-training. Rozwiązanie: dokumentacja, runbooki, pair programming, on-call rotation, knowledge sharing.

Podsumowanie: SPOF eliminuje się przez redundancję na każdej warstwie (compute, storage, network, people). N+1 = minimalna redundancja, 2N = pełna redundancja, multi-AZ = ochrona przed awarią strefy, multi-region = ochrona przed awarią regionu. SPOF analysis = regularne ćwiczenie (przeglądaj architekturę co kwartał).

Pojedynczy punkt awarii, w skrócie SPOF, to każdy komponent - sprzętowy, sieciowy, aplikacyjny, a nawet ludzki - którego awaria powoduje niedostępność całego systemu lub jego krytycznej części. Zidentyfikowanie wszystkich takich punktów to regularne ćwiczenie architektoniczne, które powinno się powtarzać co najmniej kwartalnie, bo infrastruktura się zmienia, a stare ryzyka nie znikają same z siebie.

Typowe SPOF to pojedynczy serwer aplikacji bez replikacji, pojedyncze łącze internetowe bez failoveru, baza danych bez kopii zapasowej w trybie standby czy pojedynczy load balancer bez redundancji aktywnej. Strategie eliminacji obejmują redundancję minimalną N+1, pełną redundancję 2N, separację strefową multi-AZ oraz geograficzną multi-region. Każda warstwa - obliczeniowa, danych, sieciowa i operacyjna - musi mieć swój plan redundancji, a same repliki nie wystarczą bez testowanego mechanizmu automatycznego przełączania.

Wyjaśnienie skrótów użytych na slajdzie:
SPOF – Single Point of Failure – pojedynczy punkt awarii; Słabe ogniwo architektury IT eliminowane poprzez dublowanie komponentów i połączeń.
NIC – Network Interface Card – karta interfejsu sieciowego; Komponent sprzętowy serwera dublowany w architekturze HA za pomocą agregacji łączy (bonding).
UPS – Uninterruptible Power Supply – zasilacz bezprzerwowy; Urządzenie podtrzymujące zasilanie szafy serwerowej w przypadku zaniku prądu w sieci energetycznej.
PDU – Power Distribution Unit – jednostka dystrybucji zasilania; Listwa zasilająca serwerowni; serwery HA wymagają podłączenia do dwóch niezależnych linii PDU.
DNS – Domain Name System – system nazw domenowych; Usługa sieciowa, której pojedynczy serwer stanowi niewidoczny, krytyczny punkt awarii dla całego systemu.

5/55 Redundancja
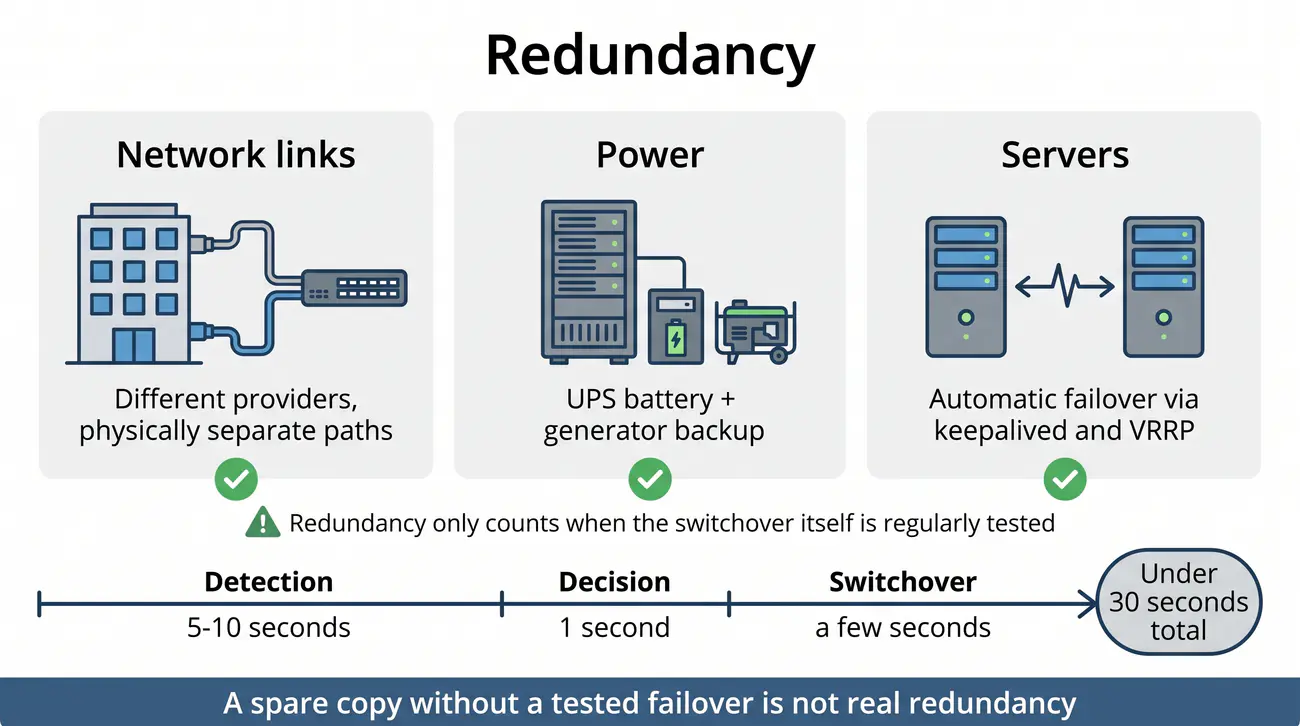
Redundancja: Redundancja to powielanie komponentów, aby awaria jednego nie wyłączyła usługi. Obejmuje redundantne łącza sieciowe, zapasowe zasilanie (UPS, generatory) oraz mechanizmy failover - automatyczne przełączanie na zapasowe komponenty.

Kopia bez przełączania to dekoracja. Liczy się automatyczny failover w sekundy - i jego regularne testy.

  • Redundancja sprzętowa – polega na utrzymywaniu podwojonych urządzeń gotowych do natychmiastowego przejęcia pracy w razie uszkodzenia.
  • Dywersyfikacja łącz – centrum danych wymaga co najmniej dwóch niezależnych dostawców Internetu prowadzonych odrębnymi trasami kablowymi.
  • Zasilanie awaryjne – akumulatory UPS podtrzymują pracę maszyn, dając agregatom prądotwórczym czas na automatyczny rozruch silnika spalinowego.
  • Szybkość przełączenia – automatyczny proces awaryjny powinien zająć mniej niż kilkadziesiąt sekund, obejmując detekcję i zmianę routingu.
  • Cykliczne próby – tylko regularne, comiesięczne testy odcinania zasilania gwarantują, że mechanizmy zapasowe zadziałają w realnym kryzysie.
Failover: Automatyczne przełączenie na zapasowy komponent; sama kopia nie chroni - liczy się sprawny mechanizm przejęcia ruchu.
nadmiarowość

W analizie SPOF błędem jest ograniczanie się do serwerów aplikacyjnych. Ukryte punkty awarii obejmują: pojedynczy przełącznik dostępowy (switch), pojedynczą listwę zasilającą (PDU), nadrzędną bazę danych, a także usługi zewnętrzne, takie jak serwery DNS czy certyfikaty SSL. Projektowanie architektury HA wymaga eliminacji każdego z tych punktów poprzez wdrożenie redundancji Active-Active (jednoczesne przetwarzanie obciążenia) lub Active-Passive (węzeł zapasowy z mechanizmem automatycznego przejęcia roli).

Redundancja to celowe powielanie kluczowych komponentów systemu, aby awaria jednego z nich nie spowodowała przerwy w usłudze - główna strategia eliminacji SPOF. Obejmuje redundantne łącza sieciowe (różni dostawcy ISP, różne trasy fizyczne, BGP multihoming, 4G/5G backup), zapasowe zasilanie (UPS - Uninterruptible Power Supply, generatory prądu, PDU - Power Distribution Unit, A/B power feeds) oraz mechanizmy failover - automatyczne (health check + skrypt/agent) i manualne (runbook + operator).

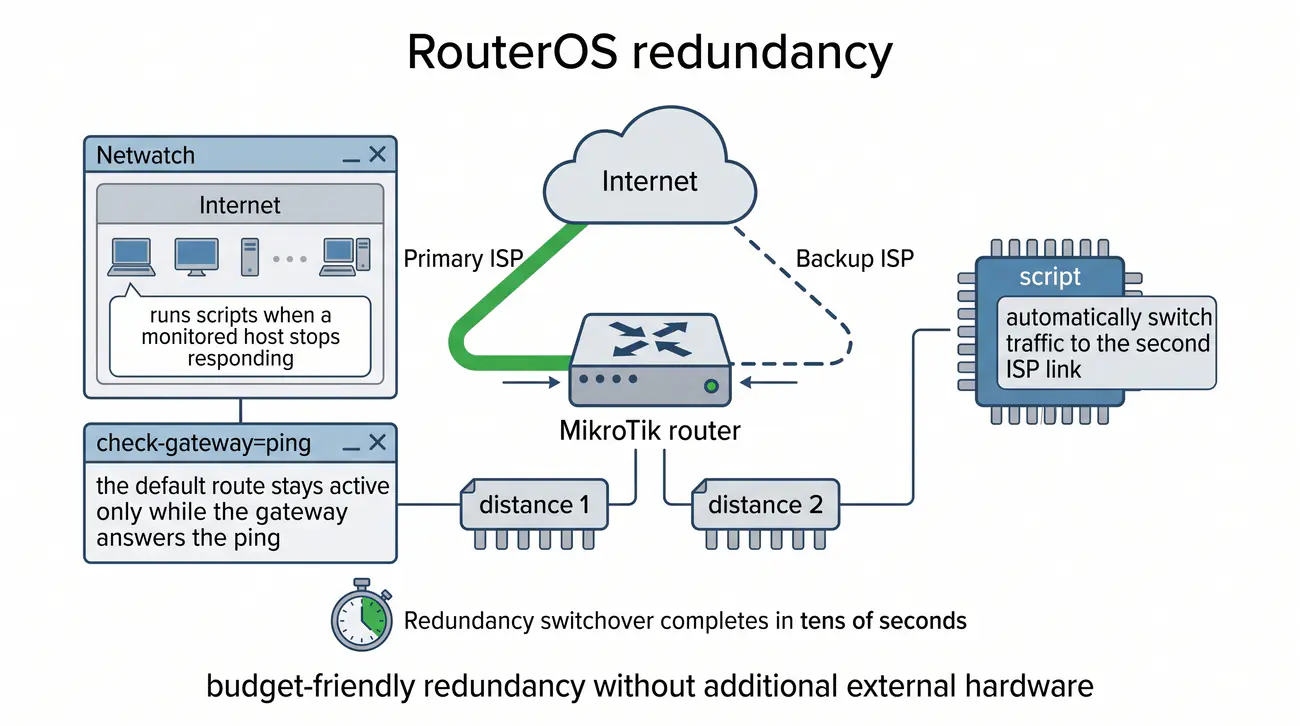
Redundantne łącza sieciowe: Minimum dwa niezależne łącza od różnych dostawców (ISP diversity), fizycznie rozdzielone trasy (path diversity - np. jedno kablem lądowym, drugie radiowe/4G/5G), BGP multihoming (announce own ASN do obu ISP) dla seamless failover. Dla mniejszych budżetów: primary fiber + backup 4G/LTE router z auto-failover (MikroTik/Cisco Netwatch/IP SLA). Test: regularne odpinanie primary linku (chaos engineering).

Zapasowe zasilanie: UPS (bateria) na 15-30 min - pokrywa krótkie przerwy i daje czas na start generatora. Generator (diesel/gaz) - nieograniczony czas pracy przy dostawie paliwa, start 10-30s po wykryciu zaniku zasilania. PDU (Power Distribution Unit) z dualny zasilaniem (A/B feeds) - każdy serwer podłączony do dwóch niezależnych PDU. Rack power: A-side i B-side UPS/generator. Test: regularne testy generatora (monthly), testy UPS (quarterly).

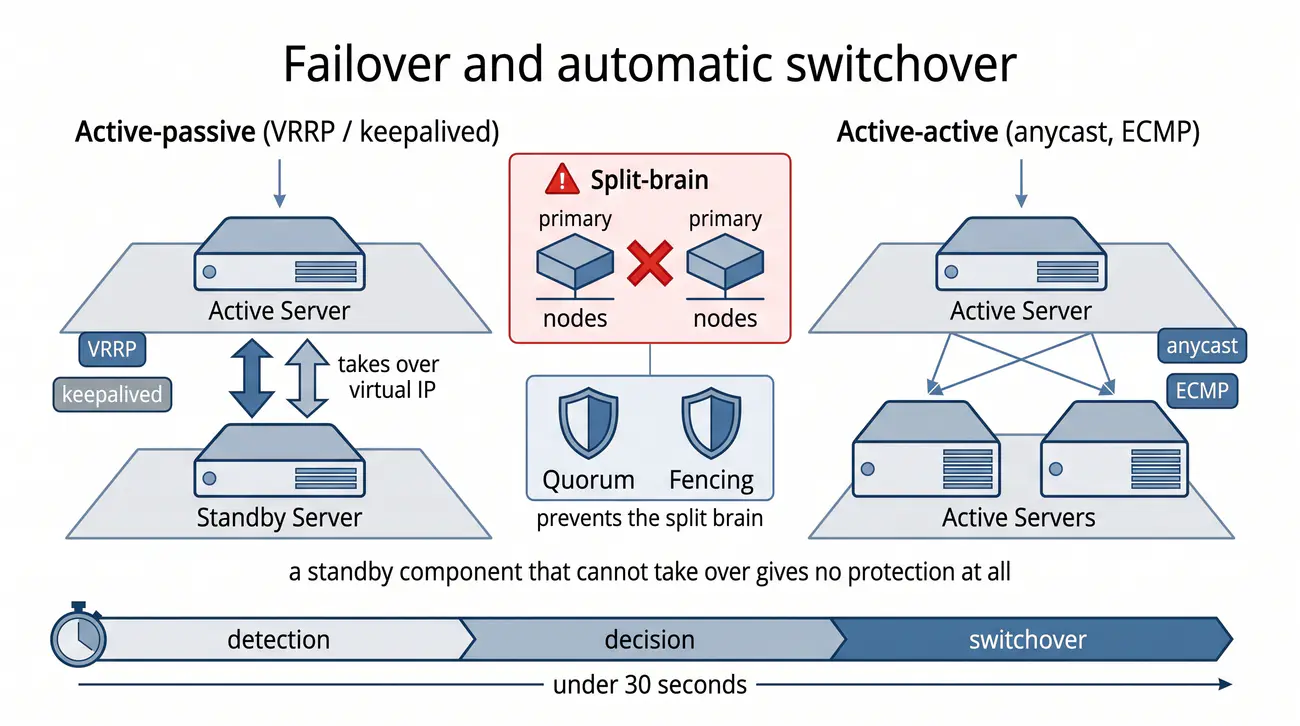
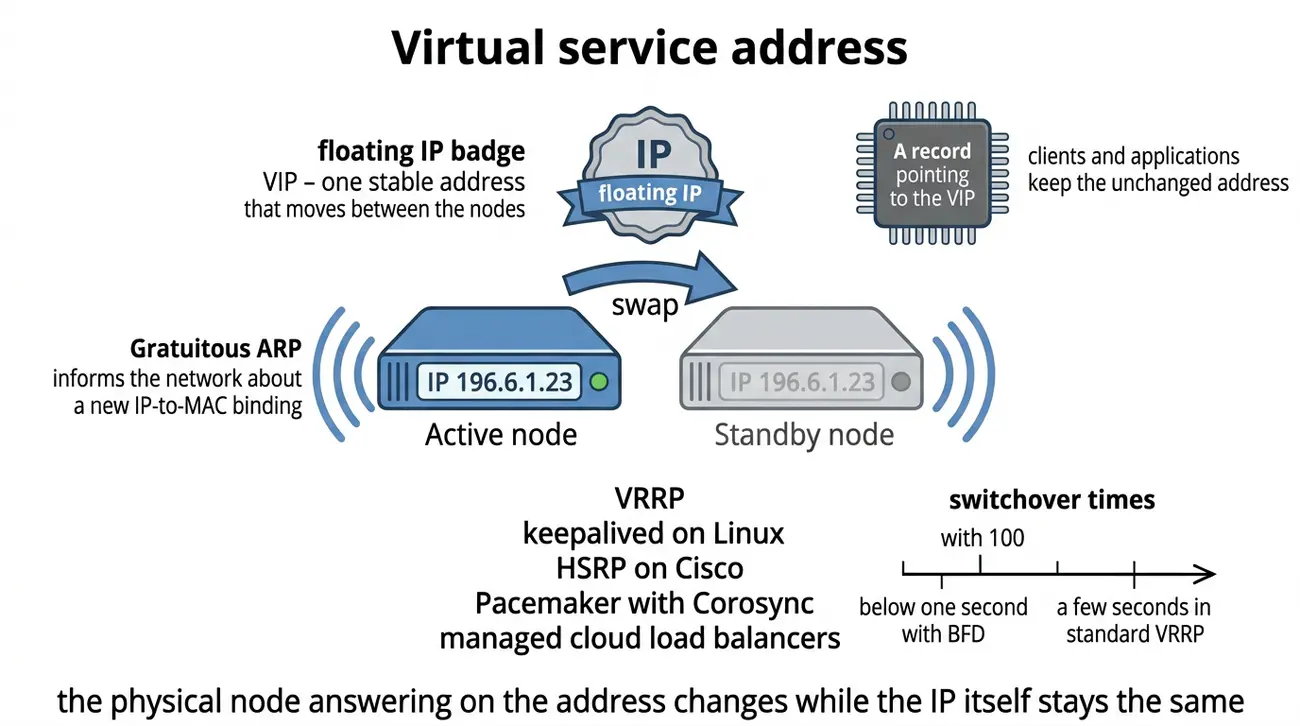
Mechanizmy failover: Automatyczne - health check (ping, HTTP, TCP, skrypt) wykrywa awarię i triggere failover (VRRP/VIP, DNS failover, keepalived, Pacemaker/Corosync, cloud LB). Czas failoveru: detection time + decision time + switch time. Cel: < 30 sekund (detection 5-10s, decision 1-2s, switch 1-5s). Manualne - runbook z procedurą krok po kroku, operator decyduje. Hybridowe - auto-detection + manual approval (dla krytycznych systemów).

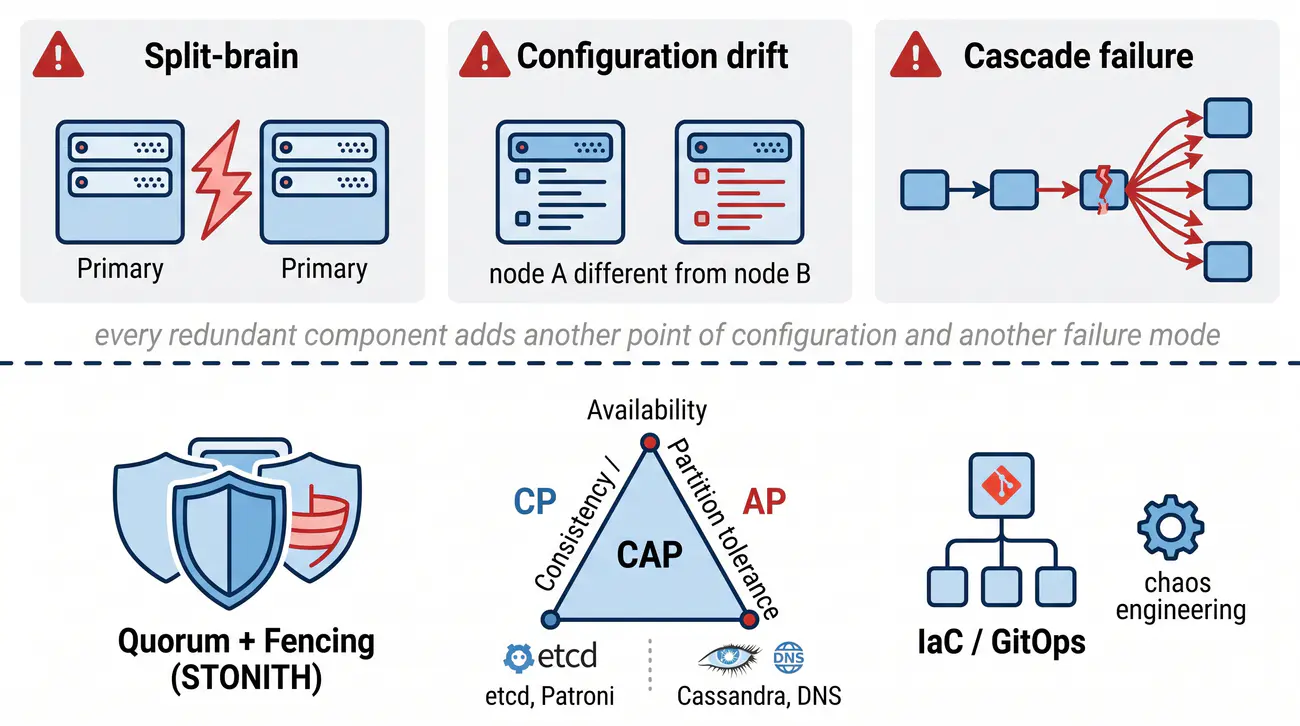
Podsumowanie: Redundancja = N+1 lub 2N na każdej warstwie (network, power, compute, storage, people). Failover musi być: szybki (cel < 30s), testowany (monthly failover test), automatyczny (dla 99.99%+), bez split-brain (quorum/fencing). Redundancja bez testowanego failoveru = fałszywe poczucie bezpieczeństwa.

Redundancja to celowe powielanie kluczowych komponentów systemu, aby awaria pojedynczej instancji nie przerwała świadczenia usługi - to bezpośrednia odpowiedź na problem pojedynczych punktów awarii omawiany wcześniej. Kluczowe jest jednak zrozumienie, że sam fakt posiadania kopii zapasowej nie gwarantuje niezawodności - liczy się tylko sprawny mechanizm automatycznego przełączania, który potrafi wykryć awarię i uruchomić zapasowy komponent w czasie krótszym niż minuty.

Redundancja obejmuje trzy główne obszary: łącza sieciowe od różnych dostawców z fizycznie rozdzielonymi trasami, zapasowe zasilanie z bateriami UPS i generatorami oraz redundancję serwerową z automatycznym failoverem za pomocą protokołu VRRP lub narzędzia keepalived. Czas przełączania celujemy poniżej trzydziestu sekund - pięć do dziesięciu sekund na wykrycie awarii, sekundę na decyzję i kolejne kilka sekund na samo przełączenie. Redundancja bez regularnie testowanego failoveru daje jedynie fałszywe poczucie bezpieczeństwa.

Wyjaśnienie skrótów użytych na slajdzie:
Active-Active – Active-Active Redundancy – redundancja aktywno-aktywna; Model, w którym wszystkie redundantne węzły jednocześnie przetwarzają ruch produkcyjny.
Active-Passive – Active-Passive Redundancy – redundancja aktywno-pasywna; Układ z węzłem nadrzędnym oraz węzłem zapasowym czekającym na awarię lidera.
N+1 – N+1 Redundancy Model – model redundancji N+1; Architektura posiadająca jeden dodatkowy element zapasowy ponad minimalną liczbę N wymaganą do obsługi pełnego ruchu.
2N – 2N Redundancy Model – model redundancji 2N; Pełne zdublowanie całej infrastruktury gwarantujące odporność na awarię połowy środowiska.
RAID – Redundant Array of Independent Disks – nadmiarowa macierz niezależnych dysków; Technologia zapobiegająca utracie danych w przypadku fizycznej awarii pojedynczego dysku.

6/55 Wprowadzenie do load balancing
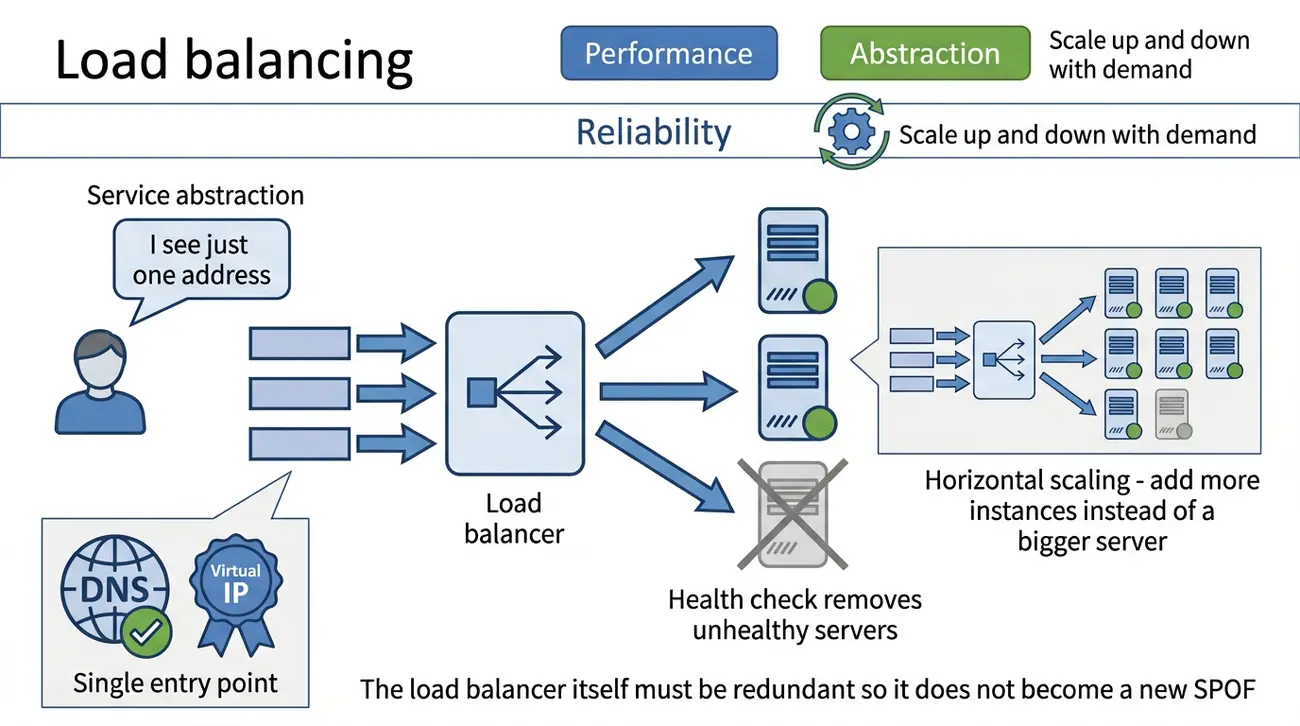
Wprowadzenie do load balancing: Load balancer rozdziela przychodzący ruch na pulę serwerów backendowych. Trzy kluczowe korzyści: poprawa wydajności przez horizontal scaling, zwiększenie niezawodności (eliminacja SPOF) oraz service abstraction - klienci widzą jeden endpoint.

Load balancer przenosi redundancję na ruch: dzieli żądania, chowa architekturę i skaluje poziomo.

  • Punkt styku – równoważnik obciążenia stanowi bramę sieciową dla użytkowników, rozdzielając przychodzące żądania na całą pulę backendów.
  • Skalowanie w poziomie – pozwala zastąpić pojedynczy potężny komputer farmą wielu tańszych, standardowych serwerów wirtualnych.
  • Wirtualny adres IP – klienci zewnętrzni odpytują jeden wspólny adres VIP, nie mając wglądu w topologię ani liczbę serwerów w klastrze.
  • Wycofywanie maszyn – balanser umożliwia bezprzerwowe prace serwisowe poprzez płynne odłączanie maszyn z puli na czas instalacji poprawek.
  • Redundancja balanserów – sam równoważnik obciążenia musi działać w parze aktywny-pasywny, aby sam nie stał się pojedynczym punktem awarii.
Horizontal scaling: Skalowanie poziome przez dodawanie serwerów do puli; load balancer rozdziela ruch, zwiększa wydajność i niezawodność.
load balancer

Load balancer (LB) to urządzenie lub oprogramowanie rozdzielające przychodzący ruch sieciowy na wiele serwerów backendowych (backend pool / upstream / server farm) - kluczowy mechanizm wysokiej dostępności i skalowalności. Trzy główne korzyści to poprawa wydajności przez dystrybucję obciążenia (horizontal scaling - dodajemy serwery zamiast kupować większe), zwiększenie niezawodności (LB wykrywa upadły backend i przestaje na niego kierować ruch) oraz ukrycie struktury wewnętrznej (service abstraction) - klienci widzą jeden Virtual IP lub DNS, nie pulę serwerów.

Poprawa wydajności - horizontal scaling: Zamiast skalować pionowo (vertical scaling - większy serwer, droższy, limit fizyczny), load balancing pozwala skalować poziomo (dodawać tanie serwery commodity). 10 serwerów po 4 vCPU = 40 vCPU razem, elastycznie skalowalne w górę i w dół. Cloud-native: auto-scaling groups (AWS ASG, GCP MIG, Azure VMSS) + LB = automatyczne dopasowanie pojemności do ruchu.

Zwiększenie niezawodności - eliminacja SPOF: Backend serwer to SPOF. LB z health checkami monitoruje backendy i usuwa niezdrowe z puli (drain connections, stop sending new traffic). Failover na zdrowe backends = użytkownik nie widzi awarii pojedynczego serwera. LB sam staje się SPOF - dlatego LB też musi być redundantny (active-passive VRRP/keepalived, active-active anycast/ECMP, cloud managed LB).

Ukrycie struktury wewnętrznej - service abstraction: Klienci (frontend, mobile, API consumers) łączą się z jednym endpointem (VIP, DNS name). LB ukrywa: liczbę backendów, ich IP, topologię sieci, wersje deployowanych serwisów. Pozwala na: blue-green deploy (przełączanie ruchu między wersjami), canary release (procent ruchu na nową wersję), A/B testing, maintenance bez downtime (drain connection -> deploy -> health check -> enable). To enabler nowoczesnych praktyk DevOps/SRE.

Podsumowanie: LB = horizontal scaling enabler + HA enabler + abstraction layer. Trzy role: traffic distribution, health monitoring, service discovery. Bez LB nie ma nowoczesnego HA ani ciągłego deploymentu. LB to "drzwi" do systemu - muszą być solidne, szybkie, inteligentne.

Omawialiśmy już redundancję i eliminację pojedynczych punktów awarii - load balancer jest narzędziem, które te koncepcje przenosi na poziom ruchu sieciowego. Rozdziela przychodzące żądania na pulę serwerów backendowych, ukrywając przed klientem wewnętrzną architekturę systemu i umożliwiając elastyczne skalowanie w górę i w dół w zależności od zapotrzebowania.

Trzy główne korzyści load balancera to poprawa wydajności przez skalowanie poziome - zamiast kupować większe serwery, dodajemy kolejne - eliminacja pojedynczego punktu awarii na poziomie backendu oraz service abstraction, czyli ukrycie struktury wewnętrznej za jednym punktem wejścia w postaci Virtual IP lub nazwy DNS. LB monitoruje stan zdrowia serwerów i automatycznie usuwa z ruchu te, które nie odpowiadają prawidłowo, a sam load balancer musi być redundantny, aby nie stał się nowym SPOF w architekturze.

Wyjaśnienie skrótów użytych na slajdzie:
LB – Load Balancer – moduł równoważenia obciążenia; Węzeł pośredniczący rozdzielający napływający ruch sieciowy pomiędzy pulę serwerów zaplecza.
VIP – Virtual IP Address – wirtualny adres IP; Adres sieciowy przypisany do usługi, a nie do fizycznej karty, umożliwiający bezprzerwowy failover.
IP – Internet Protocol – protokół internetowy; Protokół warstwy sieciowej stanowiący podstawę adresowania węzłów w sieci komputerowej.
TCP – Transmission Control Protocol – protokół sterowania transmisją; Niezawodny protokół warstwy transportowej, na którym bazują połączenia równoważone przez LB.
HTTP – Hypertext Transfer Protocol – protokół przesyłania dokumentów hipertekstowych; Główny protokół aplikacji internetowych rozdzielany przez zaawansowane load balancery warstwy L7.

7/55 Zadania load balancera
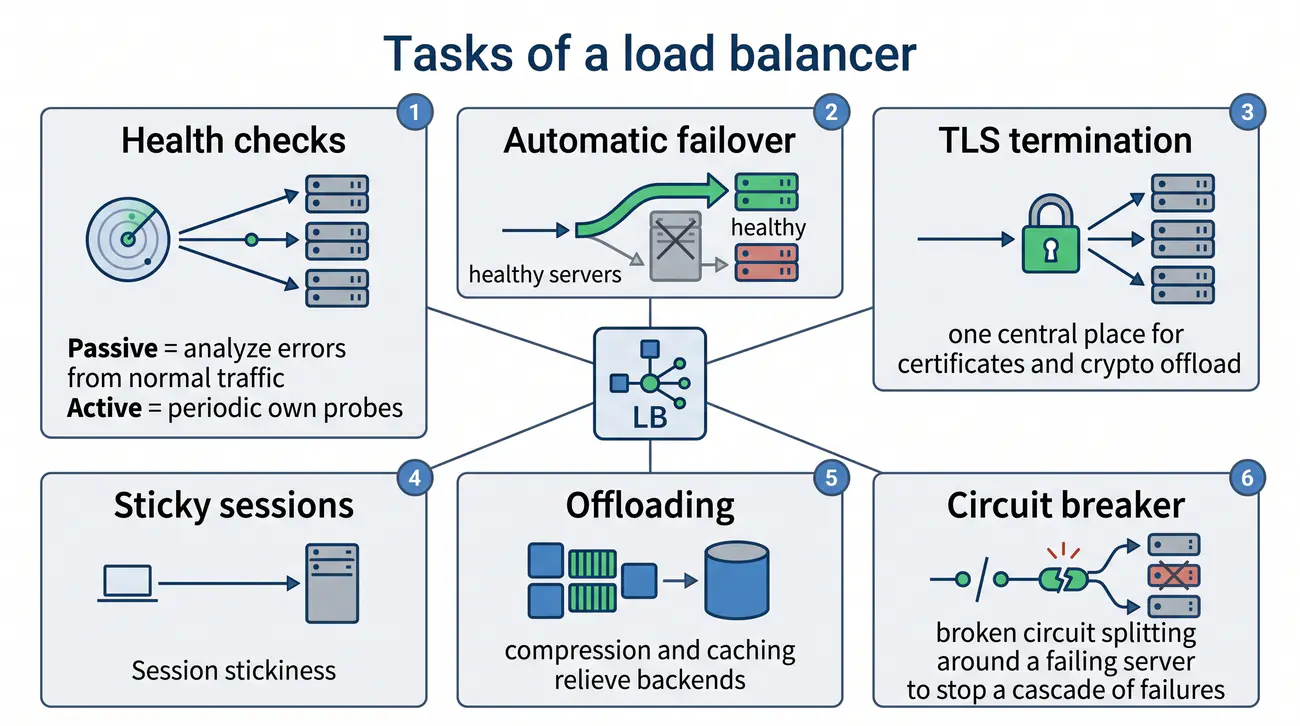
Zadania load balancera: LB wykonuje: health checks (monitorowanie stanu backendów), automatyczny failover, terminację TLS/SSL, zarządzanie sesjami (sticky sessions) oraz odciążanie backendów (kompresja, buforowanie).

Balancer to nie rozdzielacz, lecz brama: sprawdza zdrowie, kończy TLS, trzyma sesje i broni przed kaskadą.

  • Sondy zdrowia – głównym zadaniem balansera jest ciągłe monitorowanie backendów i natychmiastowe usuwanie uszkodzonych instancji z puli.
  • Płynne wygaszanie – mechanizm connection draining pozwala serwerowi dokończyć bieżące sesje przed planowanym restartem maszyny.
  • Terminacja szyfrowania – deszyfrowanie ruchu TLS na balancerze odciąża procesory aplikacji i centralizuje zarządzanie certyfikatami.
  • Utrzymywanie sesji – mechanizm sticky sessions kieruje kolejne żądania tego samego użytkownika do tej samej instancji serwera w chmurze.
  • Odciążanie backendów – kompresja przesyłanych danych oraz buforowanie zasobów statycznych na balancerze przyspieszają ładowanie stron.
Terminacja TLS/SSL: Kończenie szyfrowania na balancerze zamiast na backendach; obok health checków, failoveru, sesji sticky i odciążania (kompresja, cache).
funkcje LB

Load balancer to nie tylko rozrzucanie pakietów, lecz pełen stos funkcji zapewniających HA, bezpieczeństwo i wydajność: monitorowanie zdrowia backendów (health checks - active: HTTP/TCP/SSL probes; passive: analiza błędów proxy), automatyczna retransmisja ruchu na zdrowe serwery (failover - drain connections, retry logic, circuit breaker), terminacja TLS/SSL (terminacja SSL – odciążanie serwerów zaplecza od kryptografii, centralne zarządzanie certyfikatami), zarządzanie sesjami (sticky sessions / session persistence - IP hash, cookie, TLS session ID) oraz odciążanie backendów (compression: gzip/brotli; caching: statyczne assety; request/response buffering).

Monitorowanie zdrowia backendów - Health Checks: Passive (pasywne) - LB obserwuje błędy połączeń do backendu (connection refused, timeout, HTTP 5xx) i po przekroczeniu progu (fall count) uznaje backend za down. Active (aktywne) - LB cyklicznie sonduje backend (HTTP GET /health, TCP connect, SSL handshake, custom script) i po rise count sukcesach uznaje za up. Active checks = szybsze wykrywanie (secondary failures), passive = zero overhead. Best practice: oba (passive dla szybkiego wykrycia twardej awarii, active dla soft failures).

Automatyczna retransmisja ruchu - Failover: Gdy backend znika, LB musi: przestać wysyłać nowe połączenia (immediate), zadbać o istniejące (drain: wait dla keep-alive, lub immediate close), opcjonalnie retry na innym backendzie (idempotent requests: GET, HEAD). Circuit breaker pattern: jeśli backend zwraca błędy, chwilowo przestań wysyłać ruch (daj czas na recovery), potem probe again. To zapobiega cascade failure (thundering herd na zdrowych backendach).

TLS/SSL Termination (SSL Offloading): LB Terminuje TLS (odszyfrowuje ruch), komunikuje się z backendami po HTTP (plaintext w trusted VPC) lub ponownie szyfruje (mTLS). Korzyści: backend nie zużywa CPU na kryptografię, centralne zarządzanie certyfikatami (Let's Encrypt automation, cert-manager), single point dla WAF/DDoS protection. TLS passthrough (L4 LB) - ruch TLS przechodzi do backendu (gdy backend potrzebuje client cert / mTLS).

Sticky Sessions i odciążanie: Sticky sessions (session persistence) - ten sam klient zawsze trafia na ten sam backend (IP hash, cookie affine, TLS session ID). Wymagane dla stateful apps (session w pamięci, local cache) - ale: nierównomierne obciążenie, utrudnia scaling. Lepsze: stateless apps + shared session store (Redis, DB). Compression (gzip/brotli) - LB kompresuje odpowiedzi, oszczędza bandwidth. Caching - LB cacheuje statyczne assety (JS, CSS, images), odciąża backends.

Podsumowanie: LB = health checks (active+passive) + failover (drain+retry+circuit breaker) + SSL termination + session management + compression/caching. Każda funkcja ma trade-offs - dobieraj do use case'u. SSL offloading = standard. Sticky sessions = ostateczność (najpierw zrób stateless).

Load balancer to nie tylko prosty rozdzielacz pakietów - pełni szereg zaawansowanych funkcji, które decydują o niezawodności, bezpieczeństwie i wydajności całego systemu. Zrozumienie tych zadań jest kluczowe, ponieważ źle skonfigurowany mechanizm health checków lub brak terminacji TLS może zniweczyć cały wysiłek włożony w redundancję i eliminację punktów awarii.

LB realizuje monitorowanie stanu backendów za pomocą health checków pasywnych - analizujących błędy komunikacji - oraz aktywnych - cyklicznie sondujących endpointy zdrowia. Terminacja TLS odciąża serwery aplikacyjne od kosztownej kryptografii i centralnie zarządza certyfikatami. Sticky sessions zapewniają przynależność sesji do konkretnego serwera, kompresja i buforowanie odciążają backend, a circuit breaker pattern zapobiega efektowi kaskadowej awarii, kiedy uszkodzony serwer zaczyna obciążać zdrowe.

Wyjaśnienie skrótów użytych na slajdzie:
SSL – Secure Sockets Layer – protokół SSL; Historyczny protokół kryptograficzny zastąpiony przez standard TLS; termin powszechnie stosowany w odniesieniu do certyfikatów.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Kryptograficzny protokół terminowany na load balancerze w celu odciążenia serwerów aplikacji.
WAF – Web Application Firewall – zapora aplikacji internetowych; Moduł filtrujący ruch HTTP na load balancerze pod kątem ataków aplikacyjnych (np. SQLi, XSS).
DDoS – Distributed Denial of Service – rozproszona odmowa usługi; Zmasowany atak sieciowy mitygowany na poziomie węzłów równoważenia obciążenia.
SNI – Server Name Indication – wskazanie nazwy serwera; Rozszerzenie protokołu TLS umożliwiające obsługę wielu domen i certyfikatów na jednym adresie IP.

8/55 Algorytmy wyboru serwera
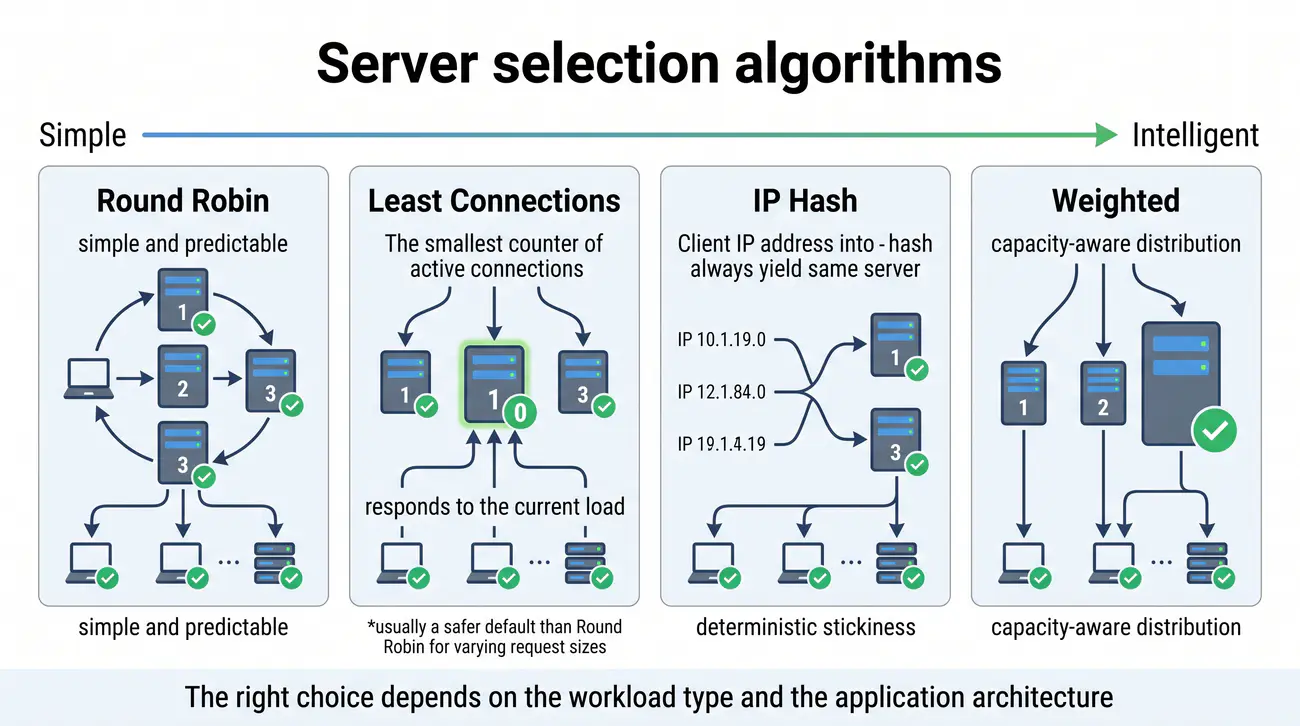
Algorytmy wyboru serwera: Algorytmy LB: Round Robin (po kolei), Least Connections (najmniej obciążony), IP Hash (sticky sessions), Weighted (wagi wg mocy serwera). Wybór zależy od typu workloadu i architektury aplikacji.

Algorytm decyduje, czy load jest równy, czy część serwerów się pali. Uniwersalnego nie ma - dobieraj do ruchu.

  • Algorytm Round Robin – przydziela nowe połączenia sekwencyjnie do każdego serwera w puli, sprawdzając się przy jednorodnych zadaniach.
  • Algorytm Least Connections – kieruje zapytanie do serwera obsługującego najmniej sesji, co chroni maszyny przed nierównym obciążeniem.
  • Haszowanie adresu IP – przypisuje użytkownika na stałe do jednego serwera, umożliwiając zachowanie lokalnego stanu sesji w aplikacji.
  • Algorytmy ważone – uwzględniają zróżnicowaną wydajność maszyn, kierując proporcjonalnie większy ruch do mocniejszych jednostek sprzętowych.
  • Najkrótszy czas odpowiedzi – dynamicznie wybiera serwer, który najszybciej przetwarza pakiety i najsprawniej odpowiada na sondy zdrowia.
Round Robin: Algorytm „po kolei” rozdzielający żądania cyklicznie; obok Least Connections (najmniej obciążony), IP Hash (sesje sticky) i Weighted (wagi mocy).
algorytmy
Jak dobrać algorytm równoważenia: Algorytm Round Robin jest prosty, lecz ślepy na rzeczywisty czas przetwarzania – jeśli jedno zapytanie trwa 5 sekund, a drugie 5 milisekund, serwer może zostać zablokowany. Dlatego bezpiecznym standardem w produkcji jest Least Connections, który na bieżąco monitoruje liczbę otwartych gniazd TCP i kieruje ruch tam, gdzie jest najwięcej wolnych mocy. Z kolei IP Hash stosuje się tylko wtedy, gdy aplikacja nie potrafi dzielić sesji w bazie Redis.

Algorytmy wyboru serwera decydują o tym, jak ruch jest rozdzielany i czy system jest sprawiedliwie obciążony: Round Robin (domyślny, prosty, statyczny - po kolei każdemu backendowi), Least Connections (dynamiczny - kieruje do backendu z najmniejszą liczbą aktywnych połączeń, najlepszy dla różnej wielkości requestów), IP Hash (deterministyczny - hash IP klienta mapuje na backend, pseudo-sticky bez cookie), Weighted (capacity-aware - mocniejsze serwery dostają więcej ruchu), Least Time (najkrótszy response time - Nginx Plus/HAProxy) i Random (prosty, dobry przy dużej liczbie backendów).

Round Robin (RR): Domyślny w Nginx i HAProxy. Prosty: request 1 -> server A, request 2 -> server B, request 3 -> server A... Zalety: prostota, deterministyczny, równomierny przy identycznych requestach. Wady: nie uwzględnia obciążenia backendu (jeden request = 1ms, inny = 5s - oba liczone tak samo), nie uwzględnia mocy serwera. Używaj gdy: backends identyczne, requesty jednolite, proste use case.

Least Connections (LC): Kieruje request do backendu z najmniejszą liczbą aktywnych połączeń (active connections). Dynamiczny - reaguje na aktualne obciążenie. Zalety: naturalnie balansuje przy zmiennej wielkości requestów, mocniejszych serwerów (obsługują więcej połączeń = dostają mniej nowych). Wady: nie uwzględnia latency (backend może mieć mało połączeń ale wolne), connection != request (keep-alive). Używaj gdy: requesty różnej wielkości/czasu, backends różnej mocy.

IP Hash: Hash(IP klienta) % liczba_backendow = backend. Deterministyczny - ten sam klient zawsze ten sam backend (pseudo-sticky). Zalety: prosty persistence bez cookie/state, dobre dla WebSocket/long-polling. Wady: nierównomierne obciążenie (jedni klienci = więcej requestów), problemy z NAT (wielu klientów pod jednym IP = ten sam backend), przy dodawaniu/usuwaniu backendu mapping się zmienia (consistent hashing rozwiązuje). Używaj gdy: brak cookie support, WebSocket, proste persistence.

Weighted (wagi): Każdemu backendowi przypisana waga (weight=1, 2, 3...). RR/LC z wagami: serwer weight=2 dostaje 2x więcej ruchu niż weight=1. Capacity-aware balancing: mocniejsze serwery (więcej CPU/RAM) dostają wyższą wagę. Używaj zawsze gdy backends różnią się mocą (np. nowy serwer 64 vCPU vs stary 16 vCPU). Weight = dynamiczne (można zmieniać w runtime bez reloadu w HAProxy/Nginx Plus).

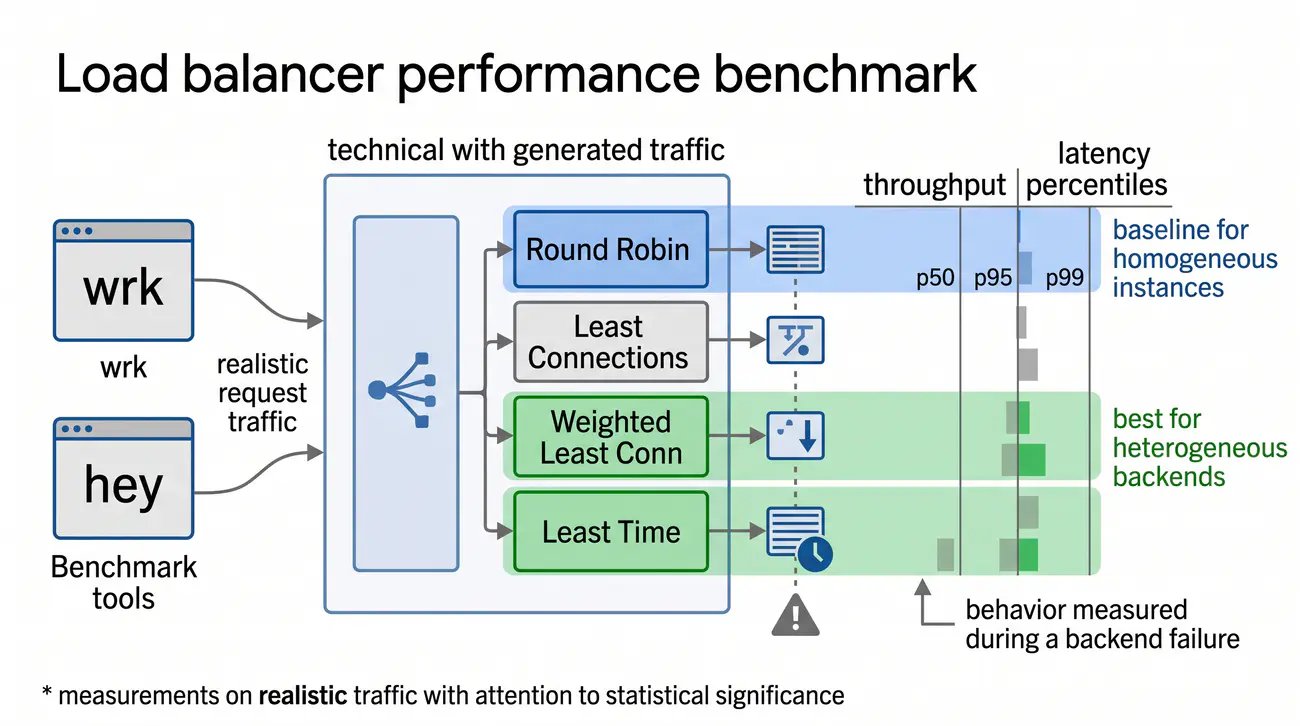
Podsumowanie: Brak "najlepszego" algorytmu - dobieraj do workload'u. Default: Least Connections (bezpieczniejszy niż RR). Stateful apps: IP Hash lub cookie-based persistence. Różne mocy: Weighted LC. Latency-critical: Least Time (Nginx Plus/HAProxy). Testuj pod obciążeniem (wrk/hey) - teoria != rzeczywistość.

Wybór algorytmu dystrybucji ruchu przez load balancer ma kluczowe znaczenie dla równomiernego obciążenia serwerów i ogólnej wydajności systemu. Nie istnieje jeden uniwersalny algorytm idealny dla wszystkich zastosowań - dobór zależy od typu workloadu, architektury aplikacji i specyfiki ruchu, a błędna decyzja może prowadzić do sytuacji, w której część serwerów jest przeciążona, a część bezczynna.

Round Robin dystrybuuje żądania po kolei, Least Connections kieruje do serwera z najmniejszą liczbą aktywnych połączeń, IP Hash zapewnia deterministyczne mapowanie klienta na serwer na podstawie hashu adresu IP, a Weighted uwzględnia różnice mocy serwerów poprzez przypisanie wag. Algorytm Least Connections jest zazwyczaj bezpieczniejszym wyborem domyślnym niż Round Robin, ponieważ dynamicznie reaguje na aktualne obciążenie i naturalnie balansuje przy zróżnicowanej wielkości żądań.

Wyjaśnienie skrótów użytych na slajdzie:
RR – Round Robin Algorithm – algorytm karuzelowy; Podstawowy algorytm równomiernie przydzielający kolejne połączenia do kolejnych serwerów w pętli.
WRR – Weighted Round Robin – ważony algorytm karuzelowy; Wariant algorytmu Round Robin uwzględniający zróżnicowaną moc obliczeniową poszczególnych maszyn.
LC – Least Connections Algorithm – algorytm najmniejszej liczby połączeń; Algorytm kierujący nowe żądanie do węzła posiadającego w danej chwili najmniej aktywnych sesji.
IP Hash – Source IP Hashing – haszowanie adresu źródłowego IP; Algorytm gwarantujący, że dany klient będzie zawsze kierowany do tego samego serwera zaplecza.
CARP – Cache Array Routing Protocol – protokół trasowania tablic pamięci podręcznej; Algorytm deterministycznego podziału zapytań pomiędzy serwery buforujące w oparciu o adres URL.

9/55 Warstwy load balancingu
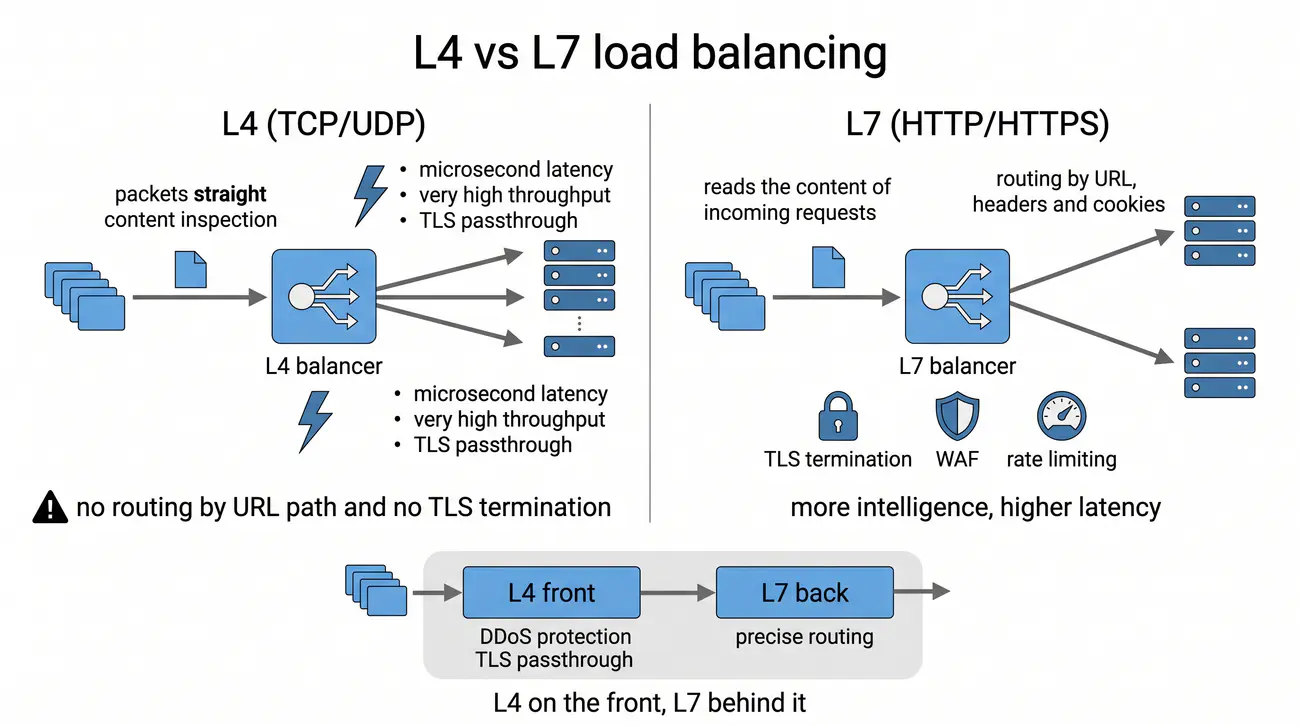
Warstwy load balancingu: L4 (TCP/UDP) - niskie opóźnienie, routing po IP/porcie. L7 (HTTP/HTTPS) - routing po URL, headers, cookies, terminacja TLS, WAF, rate limiting. Hybryda: L4 na froncie + L7 za nim.

L4 pcha pakiety, L7 rozumie HTTP. Szybkość kontra inteligencja - zwykle bierzesz oba, warstwowo.

  • Warstwa transportowa (L4) – operuje na adresach IP i portach TCP bez zaglądania do zawartości przesyłanych pakietów sieciowych.
  • Wydajność warstwy czwartej – brak konieczności analizowania protokołu aplikacyjnego zapewnia maksymalną przepustowość i niskie opóźnienia.
  • Warstwa aplikacyjna (L7) – analizuje protokół HTTP, umożliwiając inteligentne trasowanie na podstawie nagłówków, ciasteczek i ścieżek URL.
  • Modyfikacja nagłówków – balanser L7 potrafi wstrzykiwać parametry śledzenia, przepisywać adresy oraz filtrować niebezpieczne zapytania.
  • Podejście hybrydowe – inżynierowie łączą obie technologie, stosując szybki balancer L4 na brzegu sieci przed farmą balancerów L7.
L4 kontra L7: Balanser warstwy 4 (TCP/UDP) routuje po IP/porcie z niskim opóźnieniem, a warstwy 7 (HTTP) - po URL, nagłówkach i cookies, z TLS, WAF i rate limiting.
L4 i L7

Mechanizmy równoważenia obciążenia podlegają dekompozycji według warstw modelu ISO/OSI:
- Warstwa 4 (Transport): operuje wyłącznie na adresach IP i portach TCP/UDP (np. Linux IPVS, HAProxy w trybie mode tcp). Charakteryzuje się minimalnym narzutem na procesor i brakiem wglądu w payload pakietów,
- Warstwa 7 (Aplikacja): dokonuje pełnej terminacji sesji TCP i deszyfrowania TLS (np. Nginx, HAProxy w trybie mode http), umożliwiając trasowanie na podstawie nagłówków HTTP, ciasteczek sesyjnych (Sticky Sessions) oraz ścieżek URI.

Warstwy load balancingu dzielą się na L4 (Transport Layer - TCP/UDP) i L7 (Application Layer - HTTP/HTTPS); to fundamentalne rozróżnienie determinuje funkcjonalność, wydajność i złożoność. L4 działa na poziomie pakietów - nie inspekcjonuje treści, tylko routuje na podstawie IP/portu; L7 działa na poziomie aplikacji - pełna inspekcja HTTP (URL path, headers, cookies, query string), zaawansowany routing (path-based, host-based), TLS termination, WAF i rate limiting; wybór warstwy zależy od potrzeb.

L4 Load Balancing (TCP/UDP): Działa na warstwie transportowej. Forwarduje pakiety TCP/UDP bez inspekcji payloadu (lub z minimalną: TCP headers). Zalety: niskie opóźnienie (microseconds), wysoka przepustowość (millions pps), prostota, protokołowo niezależny (działa dla każdego protokołu TCP/UDP: MySQL, PostgreSQL, Redis, gRPC, DNS, custom). Wady: brak HTTP-aware routing (nie może routować po /api/v1 vs /api/v2), brak TLS termination (TLS passthrough tylko), brak WAF/rate limiting na L7. Używaj dla: non-HTTP protocols, ultra-low latency, high throughput, TLS passthrough scenarios.

L7 Load Balancing (HTTP/HTTPS): Działa na warstwie aplikacji. Terminuje HTTP (parsowanie request/response), inspekcjonuje treść. Zalety: routing po URL path (/api/* -> backend-api, /static/* -> backend-static), host header (multi-tenant), cookies/query params, TLS termination (SSL offloading), WAF (Web Application Firewall), rate limiting per IP/user/path, request/response rewriting, authentication (OIDC, JWT validation). Wady: wyższe opóźnienie (milliseconds vs microseconds), niższa przepustowość (CPU-bound parsing), złożoność. Używaj dla: HTTP/HTTPS traffic, microservices routing, API gateway, SSL termination, WAF.

Kiedy używać którego: Hybrydowo! Częsty wzorzec: L4 LB na froncie (cloud LB: AWS NLB, GCP Network LB, Azure Load Balancer) dla TLS passthrough / DDoS protection / TCP protocols -> L7 LB (Nginx/HAProxy/Envoy) za nim dla HTTP routing, TLS termination, WAF. Dla prostych HTTP apps: sam L7 LB (Nginx/HAProxy) wystarczy. Dla non-HTTP (gRPC, DB, Redis): L4 LB. Cloud managed L7 (AWS ALB, GCP HTTP LB, Azure Application Gateway) = L7 jako usługa.

Podsumowanie: L4 = szybkie, proste, dla TCP/UDP. L7 = inteligentne, bogate funkcje, dla HTTP/HTTPS. Nowoczesna architektura = L4 front (DDoS, TLS passthrough) + L7 back (routing, SSL term, WAF). Wybór = funkcja protokołu i wymagań routingowych. Nie da się robić L7 routing na L4 LB.

Rozróżnienie między warstwą czwartą a siódmą modelu OSI w kontekście load balancera to fundamentalne pojęcie, które determinuje zarówno funkcjonalność, jak i wydajność rozwiązania. L4 operuje na poziomie pakietów transportowych TCP i UDP, natomiast L7 analizuje treść żądań HTTP - to różnica między prostym routowaniem a inteligentnym dystrybuowaniem ruchu na podstawie ścieżek URL, nagłówków i ciasteczek.

Load balancer L4 oferuje niskie opóźnienia rzędu mikrosekund i bardzo wysoką przepustowość, ale nie potrafi routować ruchu na podstawie ścieżek ani terminować TLS. L7 umożliwia zaawansowane funkcje takie jak routing hostowy i ścieżkowy, terminacja SSL, ochrona WAF i limitowanie żądań, ale generuje wyższe opóźnienia. Często stosuje się podejście hybrydowe: L4 na froncie do ochrony przed atakami DDoS i passthrough TLS, a za nim L7 do precyzyjnego routingu i bezpiecznej terminacji.

Wyjaśnienie skrótów użytych na slajdzie:
OSI – Open Systems Interconnection – model odniesienia łączenia systemów otwartych; Siedmiowarstwowy standard koncepcyjny komunikacji w sieciach komputerowych.
L4 – Layer 4 (Transport) – warstwa 4 (transportowa); Równoważenie ruchu oparte wyłącznie na adresach IP i numerach portów bez wglądu w treść żądania.
L7 – Layer 7 (Application) – warstwa 7 (aplikacji); Równoważenie ruchu z pełną analizą protokołu HTTP, nagłówków, ciasteczek i ścieżek URL.
TCP – Transmission Control Protocol – protokół transportowy TCP; Protokół strumieniowy, którego sesje są rozdzielane na warstwie L4.
UDP – User Datagram Protocol – protokół pakietowy UDP; Protokół bezpołączeniowy stosowany w transmisjach strumieniowych, DNS i grach sieciowych.

10/55 Wprowadzenie do Nginx
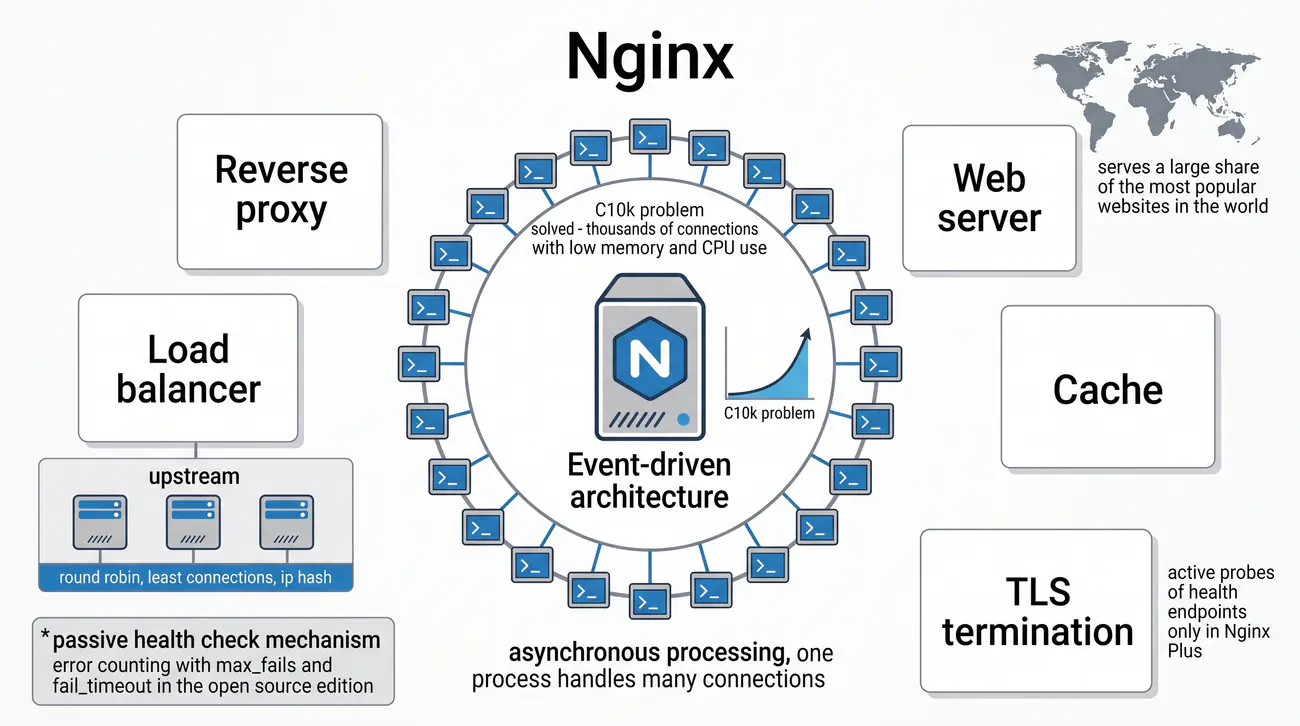
Wprowadzenie do Nginx: Nginx to wysokowydajny serwer WWW i reverse proxy. Architektura event-driven (asynchroniczna) obsługuje dziesiątki tysięcy połączeń. Role: reverse proxy, load balancer, web server, cache, TLS termination.

Nginx to mistrz event-driven: dziesiątki tysięcy połączeń przy groszowym CPU. Stąd jego 30%+ internetu.

  • Architektura Nginx – asynchroniczny, sterowany zdarzeniami model wieloprocesowy pozwala Nginx na wydajną obsługę dziesiątek tysięcy połączeń.
  • Wielozadaniowość – oprogramowanie może pełnić równolegle rolę serwera statycznych plików WWW, pamięci podręcznej oraz bramy proxy.
  • Bariera ochronna – umieszczenie Nginx przed serwerami aplikacyjnymi izoluje właściwe usługi od bezpośredniego kontaktu z Internetem.
  • Niskie zużycie pamięci – zoptymalizowana gospodarka zasobami sprawia, że serwer zachowuje pełną stabilność nawet pod wielkim ruchem.
  • Globalna popularność – prostota konfiguracji i niezawodność uczyniły z Nginx podstawowy komponent współczesnej infrastruktury WWW.
Architektura event-driven: Asynchroniczna obsługa dziesiątek tysięcy połączeń przy minimalnych zasobach; odpowiedź Nginxa na problem C10k.
rola Nginx

Nginx to wysokowydajny reverse proxy, load balancer i serwer WWW - jeden z najpopularniejszych komponentów infrastruktury internetowej (ponad 30% najpopularniejszych stron). Architektura event-driven (asynchroniczna, non-blocking I/O, single-threaded worker processes, epoll/kqueue/IOCP) daje niskie zużycie pamięci/CPU przy dziesiątkach tysięcy jednoczesnych połączeń; role to reverse proxy (LB, SSL termination, caching, compression), web server (static files, try_files), cache (proxy_cache, FastCGI cache) i TLS termination (SSL offloading, OCSP stapling), a zakres sięga od małych serwisów po globalne CDN (Netflix, Cloudflare, Dropbox).

Architektura event-driven: Master process (root, odczytuje config, zarządza workerami) + Worker processes (user, obsługują połączenia). Każdy worker to single-threaded event loop (epoll na Linux, kqueue na BSD, IOCP na Windows) obsługujący tysiące połączeń jednocześnie (C10k problem solved). Zero context switching overhead, przewidywalne zużycie pamięci. Worker_connections (domyślnie 1024, tunable do 65535+) * worker_processes (liczba CPU cores) = max concurrent connections.

Obsługa load balancingu: Upstream block definiuje pulę backendów (server IP:port weight=X, backup, down). Metody: round robin (domyślna), least_conn (nginx), ip_hash (nginx), least_time (Nginx Plus/commercial). proxy_pass http://upstream_name - przekazuje request do upstreams. Health checks: passive (proxy_next_upstream error timeout http_500 http_502 http_503 http_504), active (nginx Plus: health_check directive, match block). Open Source Nginx = passive only; Nginx Plus = active health checks.

Role Nginx: Reverse proxy (LB, SSL term, caching, compression, rate limiting, WAF via ModSecurity) - najczęstsze w SRE. Web server (static files: sendfile, aio, gzip_static, expires, try_files) - bardzo szybki dla statycznych assetów. Cache (proxy_cache: klucz, zone, valid, stale-while-revalidate, stale-if-error) - drastycznie offloaduje backends. TLS termination (ssl_certificate, ssl_certificate_key, ssl_protocols TLSv1.2 TLSv1.3, ssl_ciphers, OCSP stapling) - centralne zarządzanie certyfikatami.

Podsumowanie: Nginx = event-driven, wysokowydajny, wszechstronny. Open Source = passive health checks, podstawowe LB. Nginx Plus (płatne) = active health checks, least_time, dynamic reconfiguration, API, metrics. W SRE: Nginx jako frontend LB (SSL term, caching, rate limit, WAF) + HAProxy jako backend LB (zaawansowane health checks, L4/L7, stick tables) = power combo.

Nginx jest jednym z najpopularniejszych komponentów infrastruktury internetowej - obsługuje ponad trzydzieści procent najpopularniejszych stron na świecie. Jego popularność wynika z architektury opartej na zdarzeniach, która przy minimalnym zużyciu pamięci i procesora pozwala obsługiwać dziesiątki tysięcy jednoczesnych połączeń - to rozwiązanie problemu C10k, z którym tradycyjne architektury wielowątkowe sobie nie radzą.

Nginx pełni w praktyce kilka ról jednocześnie: jako reverse proxy z load balancingiem, serwer statycznych plików, system buforowania i terminację SSL/TLS. Do load balanceringu służy blok upstream definiujący pulę backendów z wagami, a metody dystrybucji obejmują round robin, least connections i IP hash. Health checki pasywne - oparte na analizie błędów proxy i parametrach max_fails i fail_timeout - są dostępne w wersji open source, a aktywne sondowanie endpointów zdrowia wymaga płatnej wersji Nginx Plus.

Wyjaśnienie skrótów użytych na slajdzie:
epoll – Linux epoll I/O event notification – mechanizm asynchronicznego powiadamiania o zdarzeniach I/O; Wysokowydajny mechanizm jądra Linux leżący u podstaw architektury serwera Nginx.
VFS – Virtual Filesystem Switch – wirtualny system plików; Warstwa abstrakcji jądra obsługująca asynchroniczny odczyt zasobów statycznych w Nginx.
CPU – Central Processing Unit – procesor; Zasób optymalnie wykorzystywany przez architekturę jeden proces roboczy na rdzeń w Nginx.
RAM – Random Access Memory – pamięć operacyjna; Pamięć serwera charakteryzująca się minimalnym narzutem na pojedyncze połączenie w serwerze Nginx.
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji; Standard komunikacyjny wydajnie przetwarzany przez moduł ngx_http_core_module.

11/55 Konfiguracja Nginx reverse proxy
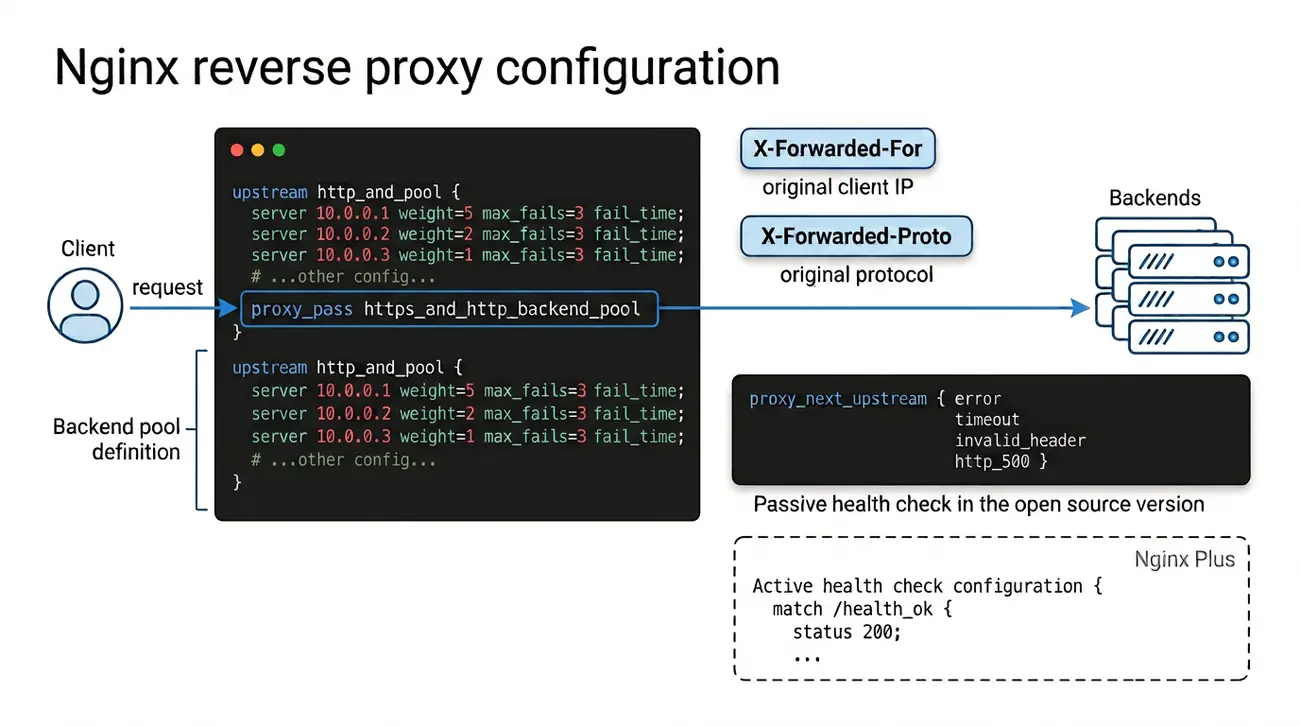
Konfiguracja Nginx reverse proxy: Blok upstream definiuje pulę backendów z wagami. Dyrektywa proxy_pass przekazuje ruch. Kluczowe nagłówki: X-Forwarded-For, X-Forwarded-Proto. Health check: pasywny i aktywny (Nginx Plus).

Pięć dyrektyw robi z Nginxa balancer: pula, przekazanie, nagłówki, timeouty i testy.

  • Dyrektywa proxy_pass – stanowi serce konfiguracji reverse proxy, przekazując pakiety użytkowników do wewnętrznych serwerów w klastrze.
  • Nagłówki przekazywane – Nginx musi dopisywać nagłówki X-Forwarded-For oraz X-Real-IP, aby aplikacje znały prawdziwy adres IP klienta.
  • Buforowanie odpowiedzi – tymczasowe zapisywanie odpowiedzi na dysku odciąża serwery aplikacyjne z powolnego dosyłania danych do klientów.
  • Optymalizacja protokołów – włączenie obsługi protokołu HTTP/2 na poziomie Nginx drastycznie przyspiesza ładowanie zasobów w przeglądarce.
  • Definicja stref wirtualnych – blok server pozwala na elastyczne definiowanie wielu domen i certyfikatów SSL na jednym publicznym adresie.
Blok upstream: Definicja puli backendów z wagami w Nginx; proxy_pass przekazuje ruch, a nagłówki X-Forwarded-For/Proto niosą adres i protokół klienta.
konfiguracja Nginx
CLI · Nginx: reverse proxy
# /etc/nginx/conf.d/reverse.conf upstream backend { server 10.0.0.11:8080; server 10.0.0.12:8080; } server { listen 80; location / { proxy_pass http://backend; } } user@server:~$ sudo nginx -t nginx: configuration file test is successful

Konfiguracja Nginx jako reverse proxy z load balancingiem opiera się na bloku upstream (backendy z parametrami: weight, max_fails, fail_timeout, backup, down), dyrektywie proxy_pass (przekazanie requestu do upstream) i kluczowych parametrach proxy: proxy_set_header (propagacja oryginalnego IP/host/proto), proxy_connect_timeout / proxy_read_timeout / proxy_send_timeout oraz health checks (passive: proxy_next_upstream; active: Nginx Plus health_check + match block).

Upstream block - definicja puli backendów: upstream backend { server 10.0.0.11:8080 weight=3; server 10.0.0.12:8080 weight=1; server 10.0.0.13:8080 backup; }. Parametry: weight (waga w RR/LC), max_fails (ile failów przed oznaczeniem jako down, domyślnie 1), fail_timeout (czas trwania stanu down i okno liczenia failów, domyślnie 10s), backup (tylko gdy inne down), down (permanentnie wyłączony). Weighted RR/LC = capacity-aware balancing.

proxy_pass i parametry proxy: location / { proxy_pass http://backend; proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_set_header X-Forwarded-Proto $scheme; proxy_connect_timeout 5s; proxy_read_timeout 60s; proxy_send_timeout 60s; proxy_http_version 1.1; proxy_set_header Connection ""; }. Kluczowe: X-Forwarded-For (łańcuch IP proxy), X-Forwarded-Proto (oryginalny schemat), timeouts (unikanie zawieszania), HTTP/1.1 keepalive do backendu.

Health checks: Passive (Open Source Nginx) - proxy_next_upstream error timeout http_500 http_502 http_503 http_504; proxy_next_upstream_tries 3; - przy błędzie próbuje następny backend. Active (Nginx Plus) - health_check interval=5s fails=3 passes=2 uri=/health match=health_ok; match health_ok { status 200; body ~ "healthy"; } - proaktywne sondowanie, szybsze wykrywanie soft failures.

Przykład z pliku conf (weryfikowany): Zobacz sekcję CLI poniżej - minimalny working config. Test: sudo nginx -t (syntax check), sudo nginx -s reload (reload bez downtime). Best practice: config w /etc/nginx/conf.d/*.conf (include conf.d/*.conf w nginx.conf), wersjonowanie w Git, CI/CD pipeline dla deployu configu.

Podsumowanie: upstream (backend pool + weights/backup) + proxy_pass + proxy headers (X-Forwarded-*) + timeouts + health checks = production-ready reverse proxy. Nginx Open Source = passive HC only; Nginx Plus = active HC. Zawsze testuj: nginx -t przed reloadem!

Konfiguracja Nginx jako reverse proxy z load balancingiem opiera się na kilku kluczowych dyrektywach, które razem tworzą kompletny mechanizm dystrybucji ruchu. Blok upstream definiuje pulę serwerów z parametrami takimi jak wagi, liczbę dozwolonych błędów i czas trwania stanu niedostępności - to serce konfiguracji, od którego zależy równomierne i niezawodne obciążenie backendów.

Dyrektywa proxy_pass przekazuje żądania do zdefiniowanego upstreamu, a zestaw nagłówków proxy_set_header - w tym X-Forwarded-For i X-Forwarded-Proto - zapewnia, że serwery backendowe otrzymują informacje o oryginalnym kliencie. Health check pasywny realizuje dyrektywa proxy_next_upstream z listą błędów wyzwalających automatyczny retry na kolejnym serwerze, natomiast aktywne sondowanie wymaga modułu dostępnego wyłącznie w Nginx Plus z konfigurowalnym interałem, progiem błędów i walidacją odpowiedzi.

Wyjaśnienie skrótów użytych na slajdzie:
FHS – Filesystem Hierarchy Standard – standard hierarchii systemu plików; Układ katalogów definiujący położenie konfiguracji Nginx w /etc/nginx/nginx.conf.
URI – Uniform Resource Identifier – ujednolicony identyfikator zasobu; Ścieżka zapytania wykorzystywana w dyrektywach location serwera Nginx do trasowania ruchu.
IP – Internet Protocol – protokół internetowy; Adres sieciowy serwerów docelowych definiowany w dyrektywach proxy_pass.
DNS – Domain Name System – system nazw domenowych; Usługa rezolucji nazw; w Nginx wymaga dyrektywy resolver przy dynamicznych adresach zaplecza.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Protokół szyfrowania konfigurowany w blokach server serwera Nginx.

12/55 Load balancing w Nginx
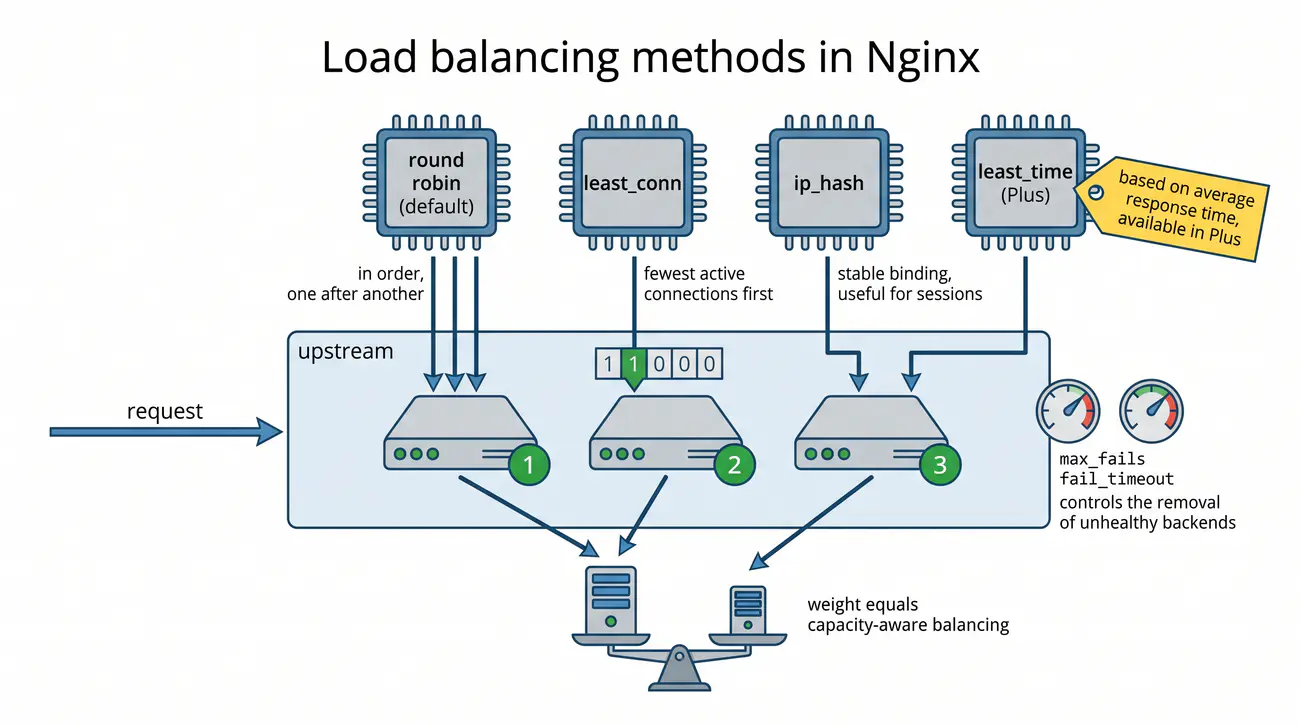
Load balancing w Nginx: Nginx oferuje: round robin (domyślny), least_conn, ip_hash, least_time (Plus). Wagi serwerów (weight) pozwalają na capacity-aware balancing. max_fails i fail_timeout kontrolują usuwanie niezdrowych backendów.

Pojedynczy serwer aplikacyjny stanowi wąskie gardło i pojedynczy punkt awarii: awaria maszyny unieruchamia całą usługę. Należy rozdzielać ruch za pomocą mechanizmów równoważenia obciążenia i eliminować niedostępne węzły zgodnie ze specyfiką obsługiwanego obciążenia.

  • Blok upstream – definiuje nazwaną pulę serwerów docelowych, pomiędzy które Nginx będzie równomiernie rozdzielał ruch przychodzący.
  • Wagi serwerów – parametr weight pozwala wskazać mocniejsze jednostki w klastrze, którym przydzielana jest większa liczba zapytań.
  • Oznaczenie serwera zapasowego – dopisanie słowa backup powoduje, że dany serwer przyjmuje pakiety dopiero po awarii głównych węzłów.
  • Maksymalna liczba błędów – dyrektywa max_fails określa dopuszczalną liczbę nieudanych prób połączenia przed tymczasowym wykluczeniem.
  • Czas wykluczenia – parametr fail_timeout decyduje, jak długo niesprawny serwer pozostanie odcięty od ruchu przed podjęciem kolejnej próby.
max_fails i fail_timeout: Parametry usuwające niezdrowy backend z puli po zadanej liczbie błędów na zadany czas; podstawa capacity-aware balancing z wagami.
upstream Nginx

Konfiguracja load balancingu w Nginx obejmuje metody balansowania, wagi serwerów i zaawansowane parametry upstream: Round Robin (statyczna, po kolei), Least Connections (least_conn - kieruje do najmniej obciążonego), IP Hash (ip_hash - deterministyczny mapping IP→backend), wagi serwerów (weight - capacity-aware), kontrolę błędów (max_fails, fail_timeout, proxy_next_upstream) oraz backup serwery (standby backend); kompletny przykład konfiguracji łączy wagi, backup i error handling.

Metody balansowania w Nginx: Round Robin (domyślna) - request 1->A, 2->B, 3->A... Prosty, ale nie uwzględnia obciążenia. least_conn - request trafia do backendu z najmniejszą liczbą aktywnych połączeń (dynamiczne, reaguje na load). ip_hash - hash(IP klienta) mapuje na backend (pseudo-sticky sessions, dobre dla WebSocket/stateful). least_time (tylko Nginx Plus) - kieruje do backendu z najniższym średnim response time (najbardziej inteligentna). Wybór: least_conn jako default dla production (bezpieczniejszy niż RR), ip_hash dla WebSocket/stateful, least_time jeśli masz Plus.

Wagi serwerów (weight): upstream backend { server 10.0.0.11:8080 weight=3; server 10.0.0.12:8080 weight=1; server 10.0.0.13:8080 weight=2 backup; }. Serwer weight=3 dostaje 3x więcej requestów niż weight=1 (w RR i LC). Używaj: nowe serwery (większe) weight=3, starsze weight=1. Dynamiczne zmiany wag: Nginx Plus (API), Open Source = reload config (nginx -s reload). Weight = prosty capacity-aware balancing bez zewnętrznego orkiestratora.

Kontrola błędów i backup: max_fails=2 fail_timeout=30s - jeśli 2 błędy w 30s, backend marked down na 30s. proxy_next_upstream error timeout http_500 http_502 http_503 http_504 - przy tych błędach retry na następnym backendzie. backup server - używany wyłącznie wtedy, gdy wszystkie główne węzły ulegną awarii (standby). Używaj: backup dla disaster recovery (cross-AZ/region), drain mode przed maintenance (weight=0 lub down).

Przykład konfiguracji kompletny (weryfikowany): Zobacz sekcję CLI - upstream z weight, backup, max_fails, fail_timeout, proxy_next_upstream. Test: nginx -t && nginx -s reload. Monitoring: access log z $upstream_addr (który backend), $upstream_response_time (latency backendu), $upstream_status (status backendu).

Podsumowanie: least_conn default > round robin. Weight = capacity-aware. max_fails/fail_timeout = circuit breaker. backup = standby. ip_hash = persistence dla stateful. Zawsze loguj $upstream_* zmienne do observability!

W poprzednim slajdzie skonfigurowaliśmy Nginx jako odwrotne proxy kierujące ruch do jednego backendu. W środowisku produkcyjnym taka ścieżka jest wąskim gardłem: awaria pojedynczej maszyny oznacza niedostępność całej usługi, niezależnie od jakości aplikacji. Naturalnym krokiem jest więc rozdzielenie żądań między wiele serwerów, czyli load balancing. Nginx, choć jest przede wszystkim serwerem WWW, wbudował ten mechanizm w grupy serwerów upstream wraz z zestawem metod, które decydują, który backend otrzyma kolejne żądanie.

Te metody należy dobierać świadomie, bo każda odpowiada na inne wyzwanie. Domyślny round robin rozdziela żądania po kolei, least_conn trafia do serwera z najmniejszą liczbą aktywnych połączeń, a ip_hash mapuje adres klienta na stały backend, co przydaje się przy sesjach. W wersji Plus dostępny jest też least_time, uwzględniający średni czas odpowiedzi. Parametr weight różnicuje ruch według możliwości maszyn, a para max_fails i fail_timeout wyłącza serwer, który zaczyna zawodzić. Ten z parametrem backup wchodzi do gry po awarii pozostałych.

Wyjaśnienie skrótów użytych na slajdzie:
Upstream – Upstream server pool – pula serwerów nadrzędnych; Blok konfiguracyjny w Nginx definiujący grupę węzłów docelowych podlegających load balancingowi.
WRR – Weighted Round Robin – ważony algorytm karuzelowy; Domyślny algorytm puli upstream w Nginx z parametrem weight przypisanym do serwerów.
IP Hash – IP Hash Directive – dyrektywa haszowania IP; Mechanizm Nginx przypisujący klientów do stałych węzłów na podstawie pierwszych 3 oktetów adresu IPv4.
TCP – Transmission Control Protocol – protokół kontroli transmisji; Protokół obsługiwany przez blok stream serwera Nginx w trybie proxy warstwy 4.
HTTP – Hypertext Transfer Protocol – protokół aplikacyjny; Protokół warstwy 7 obsługiwany przez klasyczny blok http serwera Nginx.

13/55 Health check w Nginx
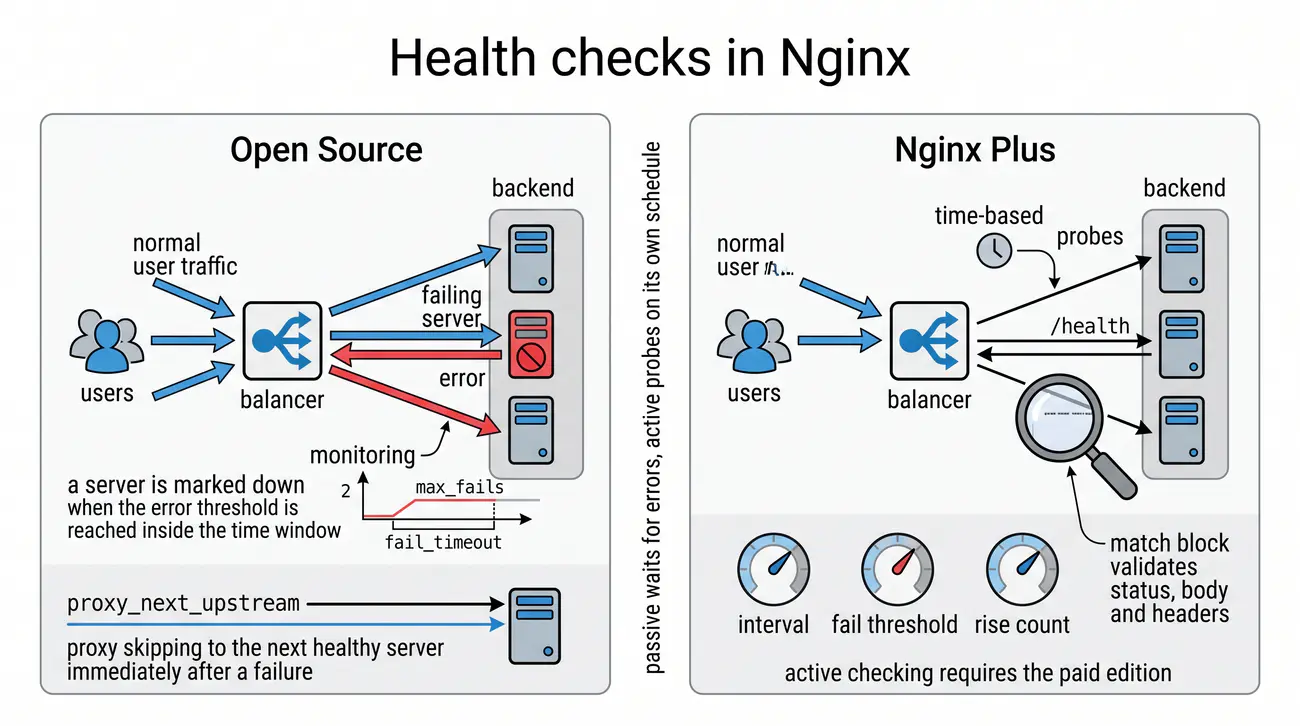
Health check w Nginx: Pasywne HC (Open Source) - analiza błędów proxy (max_fails, fail_timeout). Aktywne HC (Nginx Plus) - sondowanie endpointów z custom walidacją (match block).

Brak kontroli stanu instancji zaplecza zagraża stabilności: zapytania mogą trafiać do uszkodzonego węzła. Serwer Nginx w wersji podstawowej oferuje pasywną weryfikację stanu, natomiast aktywne badanie dostępne jest w wersji Nginx Plus lub za pośrednictwem modułów zewnętrznych.

  • Pasywne sprawdzanie – standardowy Nginx monitoruje rzeczywisty ruch i wyklucza backendy, które zwróciły błędy transmisji lub timeouty.
  • Aktywne sondy w Nginx Plus – komercyjna wersja serwera potrafi cyklicznie odpytywać dedykowane punkty kontrolne aplikacji w tle.
  • Dobre praktyki endpointów – aplikacja powinna weryfikować łączność z bazą i pamięcią podręczną przed zwróceniem kodu statusu 200.
  • Minimalizacja fałszywych alarmów – odpowiedni dobór liczby prób chroni serwery przed odcięciem z powodu pojedynczej fluktuacji sieci.
  • Płynny powrót do puli – naprawiony serwer stopniowo przejmuje ruch, co chroni go przed nagłym zalaniem lawiną zapytań użytkowników.
Pasywne a aktywne HC: Pasywne wykrywa awarie z błędów zwykłego ruchu (Open Source), aktywne sonduje endpointy niezależnie od użytkowników (Nginx Plus).
health check

Mechanizmy kontroli żywotności węzłów zaplecza (backendów) różnią się fundamentalnie: otwarta wersja Nginx udostępnia wyłącznie pasywne health checki (parametry max_fails i fail_timeout), co oznacza, że serwer wykrywa awarię dopiero po wysłaniu zapytania pechowego klienta. Platforma HAProxy realizuje aktywne sondowanie L7 w zdefiniowanych interwałach (check inter 2000 rise 2 fall 3), wysyłając syntetyczne żądania HTTP (http-check send meth GET uri /healthz) i odpinając uszkodzony węzeł zanim trafi do niego ruch produkcyjny.

Health checks w Nginx dzielą się na pasywne i aktywne: passive (oparte na błędach proxy: connection refused, timeout, HTTP 5xx - moduł ngx_http_upstream_module, parametry max_fails, fail_timeout, proxy_next_upstream) i active (tylko Nginx Plus/commercial - moduł ngx_http_upstream_hc_module, dyrektywa health_check, parametry interval, fails, passes, uri, match block dla custom checks). To mechanizm wykrywania niedziałających backendów i automatycznego przełączania ruchu na zdrowe; zakres możliwości różni Open Source od Plus.

Pasywne health checks (Open Source Nginx): Nginx obserwuje błędy przy komunikacji z backendem. Parametry w upstream: server ... max_fails=2 fail_timeout=30s; - jeśli w ciągu 30 sekund wystąpią 2 błędy (connection refused, timeout, HTTP 500/502/503/504), backend oznaczany jako down na 30 sekund. Dyrektywa w location: proxy_next_upstream error timeout http_500 http_502 http_503 http_504; proxy_next_upstream_tries 3; - przy błędzie próbuje następny backend (max 3 próby). Zalety: zero overhead, proste. Wady: wykrywa dopiero gdy user request fail (pierwszy user cierpi), nie wykrywa "soft failures" (backend up ale wolny/zwraca błędy logiczne).

Aktywne health checks (Nginx Plus): Proaktywne sondowanie backendów niezależnie od ruchu użytkowników. Dyrektywa: health_check interval=5s fails=3 passes=2 uri=/health match=health_ok; match health_ok { status 200; body ~ "OK"; header Content-Type application/json; }. Parametry: interval (co ile sondować), fails (ile failów = down), passes (ile sukcesów = up), uri (endpoint), match (custom validation: status, body regex, headers). Zalety: wykrywa awarie przed user impact, custom checks (DB connectivity, disk space), szybsze recovery (passes). Wady: tylko w Nginx Plus (płatne), generuje ruch (interval * backends).

Match block - zaawansowana walidacja: match health_ok { status 200; body ~ "healthy"; body !~ "maintenance"; header X-Custom-Header value; } - pozwala sprawdzić nie tylko HTTP 200, ale treść odpowiedzi (np. {"status":"healthy","db":"connected"}), nagłówki, wykluczać maintenance mode. To kluczowe dla microservices - health endpoint może zwracać detailed status.

Workaround dla Open Source: ngx_http_healthcheck_module (third-party, niezalecany produkcyjnie), lub zewnętrzny agent (Consul, etcd, custom script aktualizujący upstream via nginx -s reload lub Nginx Plus API), lub HAProxy (ma active HC w wersji free). Best practice: jeśli potrzebujesz active HC w Open Source Nginx - rozważ HAProxy jako backend LB (ma active HC free) + Nginx frontend.

Podsumowanie: Passive HC (Open Source) = basic, reactive. Active HC (Plus) = proactive, custom, production-grade dla enterprise. Workaround: HAProxy backend + Nginx frontend. Zawsze konfiguruj: max_fails, fail_timeout, proxy_next_upstream. Testuj: kill backend -> sprawdź czy traffic idzie do drugiego.

Balansowanie ma sens tylko wtedy, gdy balanser potrafi rozpoznać, że backend przestał działać, bo inaczej ruch nadal trafiałby do uszkodzonego serwera, a użytkownicy otrzymywaliby błędy mimo zdrowych maszyn w grupie. W Nginx istnieją dwa podejścia do kontroli stanu backendów: pasywne, oparte na błędach powstających przy obsłudze zwykłych żądań, oraz aktywne, w którym balanser sam, niezależnie od ruchu użytkowników, sonda wskazane punkty kontrolne. Wybór zależy w dużej mierze od wersji, bowiem mechanizm aktywny jest domeną komercyjnej edycji.

Wersja Open Source opiera się wyłącznie na kontroli pasywnej: parametry max_fails i fail_timeout uznają backend za niedostępny, gdy w oknie czasowym pojawi się ustalona liczba błędów, a dyrektywa proxy_next_upstream każe spróbować następnej maszyny. Nginx Plus dodaje aktywne sondowanie endpointu, na przykład /health, z walidacją odpowiedzi w bloku match, sprawdzając nie tylko kod statusu, lecz także treść i nagłówki. Czułość mechanizmu stroi się parametrami interval, fails i passes, które decydują, jak szybko pula uwolni się od chorego serwera.

Wyjaśnienie skrótów użytych na slajdzie:
HTTP – Hypertext Transfer Protocol – protokół HTTP; Standard protokołu, w którym kody 2xx i 3xx świadczą o poprawnym stanie węzła zaplecza.
TCP – Transmission Control Protocol – protokół sterowania transmisją; Niskopoziomowe sprawdzenie otwartości gniazda portu realizowane przez mechanizm health check.
REST – Representational State Transfer – architektura usług REST; Styl budowy dedykowanych punktów kontrolnych (/healthz, /readyz) odpytywanych przez load balancer.
2xx – HTTP Success Status Codes – kody powodzenia HTTP; Grupa kodów potwierdzających pełną sprawność i gotowość serwera do przetwarzania transakcji.
5xx – HTTP Server Error Status Codes – kody błędów serwera HTTP; Grupa kodów odpowiedzi skutkująca natychmiastowym uznaniem węzła za uszkodzony.

14/55 Tryby pracy Nginx
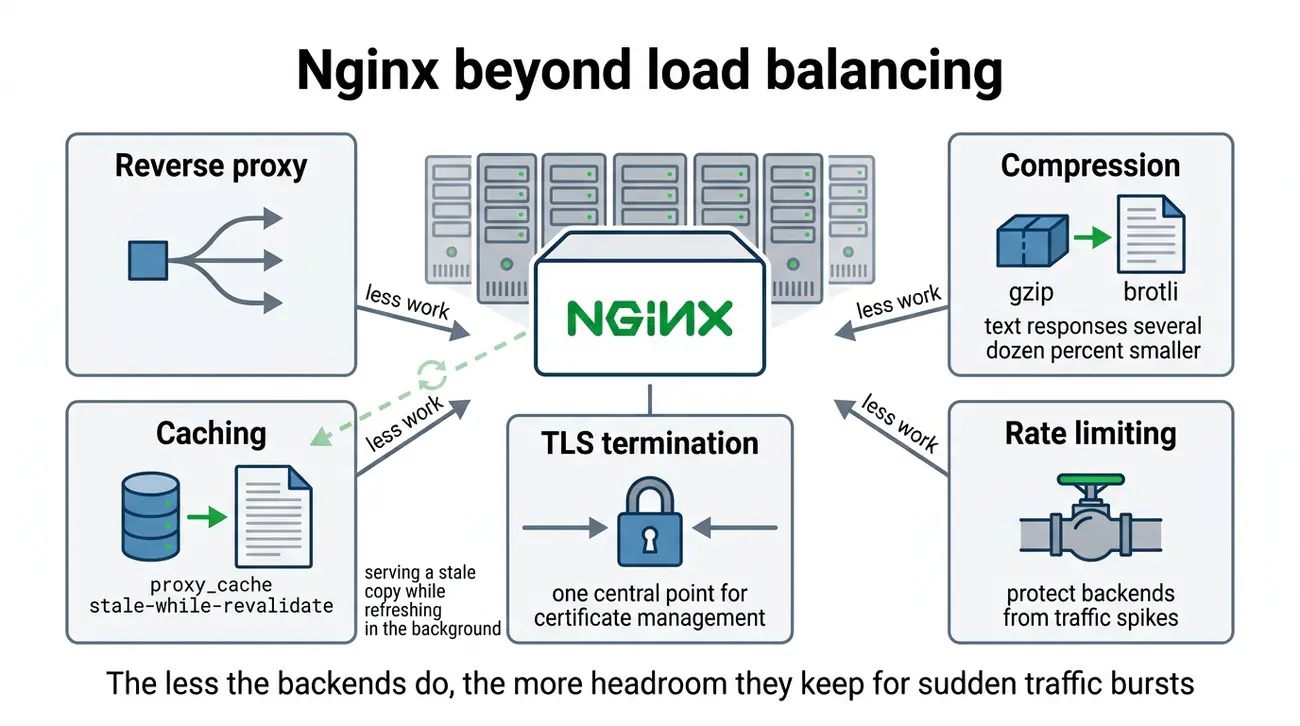
Tryby pracy Nginx: Nginx to nie tylko LB: reverse proxy, caching (stale-while-revalidate), kompresja (gzip/brotli), TLS termination, rate limiting. Każda funkcja odciąża backendy i poprawia wydajność.

Nginx to nie tylko LB: cache, kompresja, TLS i limity odciążają backendy i dają im zapas na szczyty.

  • Tryb HTTP – pozwala na pełną inspekcję protokołu aplikacyjnego, terminację TLS, buforowanie oraz modyfikację nagłówków sieciowych.
  • Moduł Stream – umożliwia równoważenie surowych strumieni TCP i UDP, sprawdzając się przy bazach danych oraz serwerach DNS.
  • Przełączanie warstw – elastyczność Nginx pozwala na obsługę ruchu webowego w warstwie L7 oraz ruchu bazodanowego w warstwie L4.
  • Protokół PROXY – pozwala na bezpieczne przekazywanie informacji o adresie klienta w połączeniach realizowanych przez moduł Stream.
  • Strojenie wątków – dopasowanie dyrektywy worker_processes do liczby rdzeni procesora zapewnia optymalne wykorzystanie zasobów sprzętowych.
stale-while-revalidate: Serwowanie nieświeżej kopii z cache w tle odświeżanej; obok kompresji, terminacji TLS i rate limiting odciąża backendy.
tryby Nginx

Poza load balancingiem Nginx pracuje jako cache, kompresor i terminacja SSL/TLS - wszechstronne narzędzie SRE: buforowanie odpowiedzi (proxy_cache: proxy_cache_key, proxy_cache_valid, proxy_cache_use_stale, stale-while-revalidate, stale-if-error - drastyczne offloadowanie backendów), kompresja (gzip: gzip on, gzip_types, gzip_min_length, gzip_comp_level, gzip_vary - oszczędność bandwidth), SSL/TLS termination (ssl_certificate, ssl_protocols TLSv1.2 TLSv1.3, ssl_ciphers, OCSP stapling, HSTS - centralne zarządzanie certyfikatami) oraz rate limiting (limit_req_zone, limit_req - ochrona przed abuse).

Caching (proxy_cache): proxy_cache_path /var/cache/nginx levels=1:2 keys_zone=my_cache:100m max_size=10g inactive=60m use_temp_path=off; proxy_cache_key "$scheme$request_method$host$request_uri$args"; proxy_cache_valid 200 302 10m; proxy_cache_valid 404 1m; proxy_cache_use_stale error timeout updating http_500 http_502 http_503 http_504; stale-while-revalidate=30s; stale-if-error=1h;. Kluczowe: keys_zone (shared memory zone dla metadata), max_size (limit dysku), inactive (wygasanie nieużywanych), stale-while-revalidate (serwuj stale w tle odświeżaj), stale-if-error (serwuj stale gdy backend down). Cache = ogromne offload (90%+ requestów statycznych/cacheowalnych).

Kompresja (gzip): gzip on; gzip_vary on; gzip_proxied any; gzip_comp_level 6; gzip_min_length 1000; gzip_types text/plain text/css application/json application/javascript text/xml application/xml application/xml+rss text/javascript;. gzip_comp_level 1-9 (6 = balans CPU/ratio), gzip_min_length (nie kompresuj małych), gzip_types (MIME types do kompresji). Brotli (ngx_brotli module) = lepsza kompresja niż gzip, ale więcej CPU. Kompresja = 70-90% redukcja rozmiaru text-based responses (HTML, CSS, JS, JSON).

SSL/TLS Termination: ssl_certificate /etc/nginx/certs/fullchain.pem; ssl_certificate_key /etc/nginx/certs/privkey.pem; ssl_protocols TLSv1.2 TLSv1.3; ssl_ciphers ECDHE-ECDSA-AES128-GCM-SHA256:ECDHE-RSA-AES128-GCM-SHA256; ssl_session_cache shared:SSL:10m; ssl_session_timeout 10m; ssl_stapling on; ssl_stapling_verify on; add_header Strict-Transport-Security "max-age=31536000" always;. Kluczowe: TLS 1.2+ only, bezpieczne cipher suites (Mozilla Intermediate/Modern), OCSP stapling (szybsze handshake), HSTS (wymusza HTTPS). Centralne zarządzanie certyfikatami (cert-manager, Let's Encrypt) = zero manual cert ops.

Rate Limiting: limit_req_zone $binary_remote_addr zone=api_limit:10m rate=10r/s; location /api/ { limit_req zone=api_limit burst=20 nodelay; }. limit_req_zone (definicja strefy: klucz, rozmiar, rata), limit_req (aplikacja: burst = bufor na spike, nodelay = nie czekaj). Ochrona przed: DDoS, brute force, API abuse, runaway clients. Działa na L7 - precyzyjne (po path, user, IP).

Podsumowanie: Nginx = nie tylko LB. Cache (stale-while-revalidate = game changer), gzip (standard), TLS term (centralne certy), rate limit (ochrona). Wszystkie te funkcje offloadują backends, poprawiają UX (latency), bezpieczeństwo. Nginx frontend = powerhouse.

Do tej pory widzieliśmy Nginx jako balanser rozdzielający ruch między backendy. To jednak tylko jedna z ról tego narzędzia w architekturze wysokiej dostępności. Prawdziwa wartość balansera leży bowiem nie w samym rozdzielaniu żądań, lecz w odciążaniu warstwy aplikacyjnej: im mniej pracy wykonują backendy, tym większy mają zapas na nagłe skoki ruchu i tym niższe prawdopodobieństwo przeciążenia. Nginx odciąża serwery między innymi przez buforowanie odpowiedzi, kompresję, terminację TLS oraz ograniczanie tempa żądań.

Buforowanie realizowane modułem proxy_cache zdjąć potrafi z backendów większość statycznego ruchu, a technika stale-while-revalidate pozwala odpowiedzieć nieaktualną, lecz wciąż poprawną kopią, podczas gdy w tle trwa odświeżanie. Kompresja gzip, a tam, gdzie to możliwe, także brotli, zmniejsza rozmiar odpowiedzi tekstowych o kilkadziesiąt procent, co oszczędza pasmo i skraca czas transferu. Terminacja TLS daje jeden centralny punkt zarządzania certyfikatami, a rate limiting chroni backendy przed przeciążeniem ze strony pojedynczego klienta.

Wyjaśnienie skrótów użytych na slajdzie:
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji; Tryb pracy serwera Nginx realizujący terminację połączeń L7 i inspekcję nagłówków.
Stream – Nginx Stream Module – moduł strumieniowy Nginx; Rozszerzenie Nginx umożliwiające wysokowydajne równoważenie ruchu warstwy L4 (TCP/UDP).
L4 – Layer 4 (Transport) – warstwa transportowa modelu OSI; Tryb przekazywania pakietów bez deszyfrowania i bez analizy protokołu aplikacyjnego.
L7 – Layer 7 (Application) – warstwa aplikacji modelu OSI; Tryb głębokiej inspekcji żądań z możliwością modyfikacji nagłówków i buforowania odpowiedzi.
SSL – Secure Sockets Layer – protokół SSL/TLS; Mechanizm szyfrowania obsługiwany zarówno w trybie terminacji, jak i w trybie przezroczystego tunelowania (SSL Passthrough).

15/55 Wprowadzenie do HAProxy
Wprowadzenie do HAProxy: HAProxy to dedykowany, wysokowydajny load balancer. Architektura event-driven z obsługą L4 (TCP) i L7 (HTTP). Zaawansowane metryki (200+), ACLs, stick tables, Lua scripting.

HAProxy to balancer z urodzenia: jeden proces, L4 i L7 naraz, 200+ metryk i programowalny routing.

  • Specjalizacja HAProxy – narzędzie zostało zaprojektowane wyłącznie do bezkompromisowo szybkiego równoważenia ruchu sieciowego.
  • Jednowątkowy silnik zdarzeń – architektura oparta na epoll pozwala HAProxy na obsługę setek tysięcy połączeń przy stałym zużyciu RAM.
  • Niezrównana stabilność – oprogramowanie słynie z bezawaryjnej pracy pod gigantycznym obciążeniem, napędzając globalne platformy IT.
  • Zaawansowane reguły ACL – mechanizmy badania pakietów pozwalają na błyskawiczne filtrowanie ruchu i blokowanie nadużyć w sieci.
  • Wsparcie dla baz danych – natywne moduły sprawdzania protokołów MySQL i PostgreSQL czynią z HAProxy lidera w środowiskach bazodanowych.
ACL: Listy kontroli dostępu do routingu żądań w HAProxy; obok stick tables i skryptów Lua w dedykowanym balancerze L4/L7.
rola HAProxy

Wzorcową implementacją balansera warstwy 4 i 7 w architekturach wysokiej dostępności jest HAProxy.

HAProxy to dedykowany, wysokowydajny load balancer zaprojektowany od zera jako LB (nie jako web server z dodanym LB jak Nginx) - standard enterprise dla obciążeń krytycznych (GitHub, Stack Overflow, Twitter, Airbnb, Reddit). Architektura event-driven (single-threaded per worker, non-blocking I/O, epoll/kqueue, CPU affinity) daje maksymalną wydajność przy minimalnym overheadzie; obsługuje L4 (mode tcp) i L7 (mode http) z pełną inspekcją, zaawansowane metryki (stats socket, HTTP stats page, haproxy_exporter), ACLs (reguły routingu oparte na dowolnych warunkach), maps i stick tables (persystencja sesji z replikacją - kluczowe dla stateful HA).

Architektura event-driven: Master process (startup, config parsing, privilege drop) + Worker processes (single-threaded event loop, non-blocking I/O). Każdy worker może obsłużyć 50k-100k+ połączeń jednoczesnych. CPU affinity (cpu-map) - przypinanie workerów do konkretnych rdzeni CPU (eliminacja cache misses, NUMA awareness). nbthread (liczba workerów) = liczba rdzeni fizycznych. Zero context switching, deterministyczna latency, wysoka przepustowość (millions req/s na commodity hardware).

Obsługa L4 i L7: mode tcp - TCP load balancing (transparent proxy, TLS passthrough, MySQL/PostgreSQL/Redis/gRPC/DNS). mode http - HTTP load balancing (full L7 parsing, routing po path/host/header/cookie, header manipulation, compression, TLS termination). Jeden proces HAProxy może obsługiwać jednocześnie frontends w trybie tcp i http (różne bind ports). To unikalna cecha - Nginx też potrafi, ale HAProxy ma bogatsze L4 features (stick tables dla TCP, TLS SNI routing).

Zaawansowane metryki i observability: Stats socket (unix socket: echo "show stat" | socat /var/run/haproxy.sock stdio) + HTTP stats page (stats enable, stats uri /stats, stats auth user:pass) - real-time dashboard. Prometheus exporter (haproxy_exporter) - scrapuje stats socket, eksportuje 200+ metryk do Prometheus (frontend/backend/server: sessions, bytes, errors, queue, response time, status). Metryki = fundament alertingu, capacity planning, troubleshootingu.

ACLs, Maps, Stick Tables: ACL (acl is_api path_beg /api) - warunki (path, header, src IP, hdr, cookies, ssl_fc_sni). use_backend api_backend if is_api - routing na podstawie ACL. Maps (map $req.hdr(X-Region) region_backend us-east us-east-backend) - mapowanie wartości. Stick Tables (stick-table type ip size 1m expire 30m store gpc0,http_req_rate(10s) - tabele stanu: persistence (source IP -> backend), rate limiting (http_req_rate), tracking (gpc0 - general purpose counter). Replikacja stick tables między HAProxy (peers section) = shared state w HA parze.

Podsumowanie: HAProxy = dedykowany LB, event-driven, L4+L7, bogate metryki, ACLs/maps/stick tables = programowalność. Free version = wszystkie kluczowe funkcje (w tym active HC). Enterprise (HAProxy Enterprise) = WAF, bot management, advanced telemetry, support. W SRE: HAProxy jako backend LB (zaawansowane HC, stick tables, metryki) + Nginx frontend (SSL term, cache, WAF) = połączenie mocnych stron obu narzędzi.

W poprzednich slajdach balansowanie było funkcją dodaną do istniejącego narzędzia, bo Nginx to przecież przede wszystkim serwer HTTP. Pora przyjrzeć się narzędziu, które równoważeniem ruchu zajmuje się na wyłączność i od podstaw zostało zaprojektowane właśnie w tym celu. HAProxy od lat stanowi standard w środowiskach produkcyjnych o bardzo wysokim ruchu, a o jego pozycji decyduje nie tylko wydajność, lecz także architektura pozwalająca obsługiwać ogromną liczbę jednoczesnych połączeń przy minimalnym zużyciu zasobów.

Sercem HAProxy jest architektura event-driven: pojedynczy wątek roboczy obsługuje wszystkie zdarzenia sieciowe nieblokująco, co eliminuje przełączanie kontekstu i daje przewidywalne opóźnienia. Jeden węzeł utrzymuje dziesiątki tysięcy jednoczesnych połączeń, a przypięcie wątków do rdzeni poprawia przepustowość. To samo narzędzie pracuje równocześnie na warstwie czwartej, przekazując surowe strumienie TCP, i siódmej, z pełnym parsowaniem HTTP. Do tego dochodzą bogate metryki, reguły ACL oraz stick tables, pamięciowe tabele stanu klientów.

Wyjaśnienie skrótów użytych na slajdzie:
OSS – Open Source Software – oprogramowanie otwartoźródłowe; Model licencyjny, w ramach którego HAProxy dostarcza darmowe, zaawansowane funkcje HA.
POSIX – Portable Operating System Interface – przenośny standard systemu operacyjnego; Standard kompatybilności uniksowej, na którym opiera się silnik procesu HAProxy.
TCP – Transmission Control Protocol – protokół transportowy; Protokół obsługiwany z ekstremalną wydajnością przez asynchroniczny silnik zdarzeń HAProxy.
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji; Standard sieciowy podlegający szczegółowej analizie i manipulacji nagłówkami w HAProxy.
API – Application Programming Interface – interfejs programistyczny; Gniazdo administracyjne HAProxy Runtime API pozwalające na dynamiczne włączanie serwerów w locie.

16/55 Konfiguracja HAProxy (frontend/backend)
Konfiguracja HAProxy: Sekcja frontend (bind, mode, ACL routing) + backend (balance algorithm, server lines z check/inter/rise/fall/weight). Config check: haproxy -c -f cfg. Reload zero-downtime.

HAProxy dzieli config na wejście i pulę: frontend mówi skąd, backend dokąd. Sprawdzasz i przeładowujesz bez zrywania.

  • Sekcja frontend – definiuje porty nasłuchiwania, certyfikaty SSL oraz reguły inspekcji przychodzących pakietów od użytkowników.
  • Sekcja backend – określa listę serwerów docelowych, algorytm rozdzielania ruchu oraz szczegółowe parametry sprawdzania kondycji.
  • Sekcja defaults – gromadzi wspólne parametry konfiguracyjne, w tym domyślne limity czasowe dla połączeń klientów i serwerów.
  • Sekcja global – określa ustawienia systemowe procesu HAProxy, poziom logowania, liczbę procesów roboczych oraz prawa użytkownika.
  • Dyscyplina timeoutów – restrykcyjne czasy oczekiwania na połączenie zabezpieczają serwer przed atakami typu slowloris i wyciekiem gniazd.
Sekcje frontend/backend: Frontend definiuje wejście ruchu (bind, tryb, ACL), backend - pulę (algorytm, linie server z check/inter/rise/fall); weryfikacja haproxy -c, przeładowanie bez przestoju.
plik haproxy.cfg
CLI · HAProxy: frontend/backend
# /etc/haproxy/haproxy.cfg frontend http-in bind *:80 default_backend servers backend servers balance roundrobin server web1 10.0.0.11:8080 check server web2 10.0.0.12:8080 check user@server:~$ sudo systemctl restart haproxy

Konfiguracja HAProxy dzieli się na sekcje frontend (point of entry: bind, mode, default_backend, ACL routing) i backend (server pool: balance algorithm, server lines z parametrami check, weight, inter, rise, fall, send-proxy). To fundament działającego load balancera - kompletny, zweryfikowany przykład z pliku haproxy.cfg wyjaśnia każdą dyrektywę (listen, use_backend, server).

Frontend - punkt wejścia ruchu: frontend http-in bind *:80 (nasłuch na porcie 80 na wszystkich interfejsach) bind *:443 ssl crt /etc/haproxy/certs/ (TLS termination) mode http (L7 parsing) option httplog (szczegółowe logi HTTP) default_backend servers (domyślny backend) acl is_api path_beg /api (ACL: path zaczyna się od /api) use_backend api_backend if is_api (routing: jeśli is_api -> api_backend). Frontend może mieć wiele bind (HTTP + HTTPS), wiele ACL/use_backend (routing rules).

Backend - pula serwerów: backend servers balance roundrobin (algorytm: roundrobin, leastconn, source, uri, url_param, hdr, random) option httpchk GET /health (active health check: HTTP GET /health) http-check expect status 200 (oczekiwany status) server web1 10.0.0.11:8080 check inter 5s rise 2 fall 3 weight 100 (server line: adres, check=enable HC, inter=interval, rise=sukcesów=up, fall=failów=down, weight=waga) server web2 10.0.0.12:8080 check inter 5s rise 2 fall 3 weight 100 backup (backup server). Parametry server: check (włącz HC), inter (interval HC), fastinter/downinter (interval gdy up/down), rise (sukcesów do up), fall (failów do down), weight (waga w balansowaniu), backup (standby), send-proxy (PROXY protocol), ssl verify none (dla TLS do backendu).

Przykład kompletny (weryfikowany): Zobacz sekcję CLI - frontend http-in + backend servers z roundrobin, httpchk, server lines z check/inter/rise/fall/weight. Test: haproxy -c -f /etc/haproxy/haproxy.cfg (config check), systemctl reload haproxy (reload bez downtime - HAProxy obsługuje seamless reload via SO_REUSEPORT / master-worker model). Logging: option httplog + log /dev/log local0 - szczegółowe logi z timingami.

Podsumowanie: frontend (bind + mode + ACL routing + default_backend) + backend (balance + httpchk + server lines z check/inter/rise/fall/weight) = working HAProxy. Zawsze testuj: haproxy -c -f cfg. Używaj: option httpchk (active HC), weight (capacity), backup (standby), ACL/use_backend (L7 routing). Reload = zero downtime.

Podczas gdy Nginx wyrażał balansowanie w postaci modułu upstream, HAProxy organizuje całość na dwa jasno rozdzielone poziomy. Sekcja frontend definiuje punkt wejścia ruchu: adres nasłuchu, port, tryb pracy oraz reguły, według których żądanie trafia do właściwej puli. Sekcja backend opisuje natomiast samą pulę: algorytm wyboru serwera i parametry kontroli jego stanu. Taki podział porządkuje myślenie, bo najpierw ustalamy, skąd ruch może wejść, a dopiero później, do którego backendu trafi - w całości zawarte w pliku haproxy.cfg.

W sekcji frontend wskazujemy między innymi bind, mode oraz default_backend, a rozgałęzienia ruchu realizujemy regułami ACL z dyrektywą use_backend, co pozwala wyodrębnić żądania zaczynające się od /api i obsłużyć je osobnym backendem. W sekcji backend wybiera się algorytm balansowania, a każdą maszynę opisujemy linią server z parametrami check, inter, rise i fall, włączającymi aktywne sondowanie i strojącymi jego czułość. Zmian pilnuje weryfikacja poleceniem haproxy -c, a sam przeładunek nie zrywa aktywnych połączeń.

Wyjaśnienie skrótów użytych na slajdzie:
FHS – Filesystem Hierarchy Standard – standard hierarchii systemu plików; Układ katalogów definiujący plik konfiguracyjny HAProxy pod ścieżką /etc/haproxy/haproxy.cfg.
ACL – Access Control List – lista kontroli dostępu; Zaawansowany mechanizm reguł logicznych w HAProxy służący do trasowania ruchu na podstawie nagłówków i domen.
TCP – Transmission Control Protocol – protokół sterowania transmisją; Protokół definiujący sekcje nasłuchujące (frontend) oraz pule serwerów docelowych (backend).
HTTP – Hypertext Transfer Protocol – protokół przesyłania dokumentów hipertekstowych; Protokół, dla którego HAProxy udostępnia wyspecjalizowane reguły dopasowania i modyfikacji ścieżek.
IP – Internet Protocol – protokół sieciowy; Adresy logiczne serwerów definiowane w dyrektywach server wewnątrz bloku backend.

17/55 Tryby pracy HAProxy
Tryby pracy HAProxy: mode tcp (L4 - TCP/UDP, TLS passthrough) i mode http (L7 - routing, header manipulation). Stick tables zapewniają persistence, rate limiting i replikację stanu między węzłami HA.

Tryb sekcji decyduje o wszystkim: tcp pcha bajty, http rozumie żądania. Stick tables pamiętają klientów.

  • Tryb TCP (mode tcp) – realizuje równoważenie w warstwie czwartej z zachowaniem maksymalnej przepustowości i braku narzutu.
  • Tryb HTTP (mode http) – analizuje strukturę żądań, umożliwiając modyfikację nagłówków, analizę ciasteczek oraz logowanie szczegółów.
  • Dynamiczne ACL – listy kontroli dostępu potrafią badać nagłówki i natychmiast kierować wywołania API do wydzielonych mikroserwisów.
  • Tablice stanów stick-tables – wbudowana baza w pamięci RAM pozwala na precyzyjne śledzenie liczby żądań danego IP w czasie.
  • Ochrona przed DoS – tablice stanów pozwalają w ułamku sekundy wykrywać i automatycznie blokować złośliwe źródła ruchu.
Stick tables: Tablice sesyjności zapewniające persistence, rate limiting i replikację stanu między węzłami; mode tcp to L4 z TLS passthrough, mode http to L7.
konfiguracja mode

Tryby pracy HAProxy to mode tcp (L4 - transparent proxy, TLS passthrough, source IP preservation via PROXY protocol, non-HTTP protocols) i mode http (L7 - pełne parsowanie, header manipulation, compression, TLS termination, cookie-based persistence). Algorytmy balansowania w każdym trybie to roundrobin (domyślny), leastconn (najmniej połączeń), source (IP hash), uri (hash URI), url_param (hash query param), hdr (hash header) i random, uzupełniane stick tables dla zaawansowanej persystencji.

Mode TCP (L4): mode tcp w frontend/backend. HAProxy forwarduje pakiety TCP bez parsowania HTTP. Zastosowania: TLS passthrough (backend robi TLS termination - np. mTLS, client cert auth), non-HTTP protocols (MySQL 3306, PostgreSQL 5432, Redis 6379, gRPC, DNS, custom TCP), transparent proxy (source IP preservation - backend widzi oryginalny IP klienta via TPROXY/TPROXY4/TPROXY6 lub PROXY protocol v1/v2). PROXY protocol: HAProxy dodaje nagłówek z oryginalnym IP/port przed payloadem - backend musi go obsługiwać (Nginx: proxy_protocol on;). Algorytmy w TCP: roundrobin, leastconn, source (IP hash), static-rr.

Mode HTTP (L7): mode http w frontend/backend. HAProxy parsuje HTTP request/response, pozwala na: routing po path/host/header/cookie/query (ACL/use_backend), header manipulation (http-request set-header, http-response del-header), compression (compression algo gzip/deflate), TLS termination (bind *:443 ssl crt), cookie persistence (cookie SERVERID insert indirect nocache), rate limiting (http-request deny deny_status 429 if { src_get_gpc0(gpc0) gt 100 }). Algorytmy w HTTP: roundrobin, leastconn, source, uri (hash URI -> backend), url_param (hash param -> backend), hdr (hash header -> backend), rdp-cookie (RDP cookie), random, random(draws).

Stick Tables - zaawansowana persystencja i rate limiting: stick-table type ip size 1m expire 30m store conn_cnt,http_req_rate(10s),gpc0 - tabela w pamięci: klucz (ip, string, binary), rozmiar, TTL, przechowywane metryki (conn_cnt - liczba połączeń, http_req_rate - request rate, gpc0 - general purpose counter). Użycie: stick on src (persistence po IP), track-sc0 src (tracking), http-request deny if { sc_http_req_rate(0) gt 100 } (rate limiting 100 req/10s per IP). Replikacja: peers section - synchronizacja stick tables między HAProxy w klastrze (active-active HA). To unikalna, potężna cecha HAProxy.

Kiedy co wybrać: HTTP/HTTPS web traffic -> mode http (routing, TLS term, WAF, compression). Non-HTTP (DB, gRPC, Redis) -> mode tcp (TLS passthrough, PROXY protocol). Hybrid: frontend mode tcp (TLS passthrough) -> backend mode http (backend robi TLS term) - rzadkie. Default: mode http dla web, mode tcp dla infrastructure protocols.

Podsumowanie: mode tcp = L4, szybkie, transparent, TLS passthrough, PROXY protocol. mode http = L7, inteligentne, routing, header manip, compression, TLS term, stick tables. Algorytmy: leastconn default dla production (lepsze niż roundrobin). Stick tables = persistence + rate limiting + shared state (replication). HAProxy = Swiss Army knife load balancing.

Spośród wielu dyrektyw w pliku konfiguracyjnym HAProxy właśnie wybór trybu pracy przesądza o charakterze całego balansera, a decyzja zapada w każdej sekcji osobno. Tryb tcp traktuje ruch jako surowy strumień bajtów: balanser przekazuje pakiety bez parsowania, co sprawdza się w przypadku protokołów nieopartych na HTTP, baz danych czy transmisji TLS bez kończenia szyfrowania. Tryb http włącza pełną analizę żądań i odpowiedzi, umożliwiając kierowanie ruchem po ścieżce, nagłówkach lub plikach cookie.

W obu trybach do dyspozycji mamy całą rodzinę algorytmów balansowania: round robin i leastconn to dopiero początek, bo dostępne są także source, uri, url_param oraz haszowanie nagłówków. Szczególną wartość niosą jednak stick tables, czyli pamięciowe tabele stanu, w których balanser zapamiętuje między innymi adres klienta, co służy trwałości sesji i daje podstawę do ograniczania tempa żądań. Zawartość tych tabel można synchronizować między węzłami balansera w sekcji peers, dzięki czemu stan nie przepada, nawet gdy aktywna maszyna ulegnie awarii.

Wyjaśnienie skrótów użytych na slajdzie:
mode http – HAProxy HTTP Mode – tryb HTTP w HAProxy; Tryb pracy L7, w którym HAProxy w pełni analizuje nagłówki, zarządza ciasteczkami i rejestruje kody błędów.
mode tcp – HAProxy TCP Mode – tryb TCP w HAProxy; Tryb pracy L4 zapewniający surowe przekazywanie strumienia bajtów z minimalnym narzutem na procesor.
L4 – Layer 4 Load Balancing – równoważenie obciążenia w warstwie 4; Architektura stosowana dla baz danych (MySQL, PostgreSQL) oraz protokołów nietypowych.
L7 – Layer 7 Load Balancing – równoważenie obciążenia w warstwie 7; Architektura zalecana dla aplikacji webowych i mikroserwisów REST API.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Protokół kryptograficzny terminowany lub przekazywany w trybie passthrough w HAProxy.

18/55 Health check w HAProxy
Health check w HAProxy: HAProxy oferuje aktywne HC za darmo: TCP, HTTP, SSL, external script, DB checks. Parametry inter/rise/fall kontrolują wykrywanie awarii. Maintenance/drain mode dla zero-downtime ops.

HAProxy sonduje za darmo to, za co Nginx kasuje: TCP, HTTP, TLS, skrypty i bazy. Do tego drain bez przestoju.

  • Dyrektywa check – dopisanie parametru do definicji serwera uruchamia cykliczne, aktywne testowanie kondycji instancji w tle.
  • Parametr inter – precyzuje odstęp czasu w milisekundach pomiędzy kolejnymi zapytaniami sprawdzającymi stan zdrowia backendu.
  • Progi rise i fall – określają wymaganą liczbę udanych lub nieudanych prób przed zmianą statusu serwera na sprawny lub niesprawny.
  • Dedykowana ścieżka HTTP – dyrektywa httpchk pozwala wskazać konkretny adres URL zwracający kod 200 w razie pełnej gotowości usługi.
  • Ochrona przed oscylacją – wymóg kilku kolejnych udanych testów zapobiega przedwczesnemu kierowaniu ruchu na niestabilną maszynę.
Parametry inter/rise/fall: Interwał sond, liczba sukcesów do uznania za zdrowy i porażek do uznania za chory; tryby maintenance/drain dają operacje bez przestoju.
health check HAProxy
Jak działa Wirtualny Adres IP (VIP) i VRRP: Aby load balancer nie był pojedynczym punktem awarii (SPOF), stawiamy dwa serwery balancerów (Master i Backup). Współdzielą one jeden adres IP, z którym łączą się klienci. Demon keepalived co sekundę rozgłasza pakiety VRRP. Jeśli Master przestanie odpowiadać, Backup w ułamku sekundy wysyła ramkę Gratuitous ARP (GARP) do przełącznika sieciowego, przejmując ruch bez konieczności zmiany adresów DNS u klientów!

Mechanizmy kontroli żywotności węzłów zaplecza (backendów) różnią się fundamentalnie: otwarta wersja Nginx udostępnia wyłącznie pasywne health checki (parametry max_fails i fail_timeout), co oznacza, że serwer wykrywa awarię dopiero po wysłaniu zapytania pechowego klienta. Platforma HAProxy realizuje aktywne sondowanie L7 w zdefiniowanych interwałach (check inter 2000 rise 2 fall 3), wysyłając syntetyczne żądania HTTP (http-check send meth GET uri /healthz) i odpinając uszkodzony węzeł zanim trafi do niego ruch produkcyjny.

Health checks to jeden z najsilniejszych punktów HAProxy - bogaty system aktywnych checków dostępny w wersji free, w przeciwieństwie do Nginx Open Source. Precyzja opiera się na interwałach (inter, rise, fall - interwał sprawdzania, liczba sukcesów do up, liczba failów do down), typach checków (TCP connect, HTTP GET/HEAD, SSL handshake, external script, PostgreSQL/MySQL/Redis/SMTP/POP/IMAP checks), wykluczaniu uszkodzonych (maintenance mode - admin down; drain mode - graceful drain connections) oraz agent checks dla złożonej logiki.

Interwały i progi (kluczowe parametry server line): server web1 10.0.0.11:8080 check inter 5s rise 2 fall 3. inter 5s - sprawdzaj co 5 sekund (gdy up). fastinter 2s (opcjonalnie - interwał gdy up, dla szybszego wykrycia recovery). downinter 10s (opcjonalnie - interwał gdy down, mniej ruchu). rise 2 - 2 kolejne sukcesy = backend UP. fall 3 - 3 kolejne faili = backend DOWN. Matematyka: detection time = fall * inter = 3 * 5s = 15s (max czas wykrycia awarii). recovery time = rise * inter = 2 * 5s = 10s. Tuning: krytyczne systemy -> inter 2s, fall 2 (detection 4s); mniej krytyczne -> inter 10s, fall 3 (mniej overheadu).

Typy health checków: TCP check (domyślny) - option tcp-check; tcp-check connect; tcp-check send PING\r\n; tcp-check expect string +PONG - dla custom TCP protocols. HTTP check - option httpchk GET /health HTTP/1.1\r\nHost:\ example.com; http-check expect status 200-299 - standard dla web. SSL check - option ssl-hello-chk (TLS handshake check, bez cert verification). External script - option external-check; external-check command /usr/local/bin/check_backend.sh - dowolny skrypt (exit 0=up, non-zero=down). Database checks - option pgsql-check user haproxy (PostgreSQL), option mysql-check user haproxy (MySQL), option redis-check (Redis).

Wykluczanie uszkodzonych: Maintenance mode (admin down) - operator ręcznie wyłącza backend: echo "disable server servers/web1" | socat /var/run/haproxy.sock stdio - backend DOWN, nie będzie sprawdzany (opcjonalnie check), nowe połączenia nie trafiają, istniejące drainowane. Drain mode (graceful) - echo "set weight servers/web1 0" - weight=0, backend nie dostaje nowych połączeń, ale health checki nadal działają, istniejące keep-alive połączenia dokończone. Enable: echo "enable server servers/web1" / "set weight servers/web1 100". To kluczowe dla zero-downtime deployments i planowanego maintenance.

Agent checks (zaawansowane): option agent-check; agent-port 12345; agent-inter 10s - HAProxy łączy się z agentem na backendzie (custom daemon), agent zwraca stan (up/down/maint) + opcjonalnie weight/addr. Użyteczne gdy: health check zależy od złożonej logiki (DB replication lag, queue depth, custom business logic), chcesz dynamicznie zmieniać weight (agent zwraca weight=50 gdy backend loaded). Agent protocol: prosty text (np. "up 100%", "down", "maint 50%").

Podsumowanie: HAProxy HC = free, powerful, production-ready. Kluczowe: inter/rise/fall tuning (detection time = fall*inter), option httpchk (dla HTTP), option tcp-check (custom TCP), maintenance/drain mode (zero-downtime ops), agent checks (complex logic). Zawsze definiuj httpchk/expect. Testuj: haproxy -c -f cfg, watch -n1 'echo "show stat" | socat /var/run/haproxy.sock stdio'.

Przy omawianiu Nginx zaznaczyliśmy, że aktywne sondowanie backendów w wersji Open Source nie istnieje. To tutaj HAProxy ujawnia swoją przewagę: rozbudowany system aktywnych kontroli stanu mamy za darmo, bez komercyjnej edycji. Balanser nie czeka, aż żądanie klienta zakończy się błędem, lecz sam, w regularnych odstępach, sprawdza każdy serwer w puli. Czułość mechanizmu opisują trzy parametry przy linii server, czyli inter, rise i fall, wyznaczające czas wykrycia awarii oraz czas powrotu maszyny do służby.

Kontrola stanu przybiera wiele form: od najprostszego sprawdzenia, czy da się nawiązać połączenie TCP, przez żądanie HTTP GET do wskazanego endpointu z weryfikacją statusu, po test uścisku dłoni TLS, uruchomienie zewnętrznego skryptu czy wbudowane sondy dla baz danych. Dla zespołu operacyjnego najcenniejsze są tryby wyłączania serwera: maintenance odcina backend całkowicie, a drain sprowadza jego wagę do zera, pozwalając aktywnym połączeniom dokończyć pracę. Dzięki nim prace planowane składają się bez przerwy w świadczeniu usług.

Wyjaśnienie skrótów użytych na slajdzie:
check – HAProxy check option – opcja kontroli stanu w HAProxy; Słowo kluczowe włączające aktywne sondowanie węzła zaplecza w pliku konfiguracyjnym.
inter – HAProxy check interval – interwał odpytywania zdrowia; Parametr określający odstęp czasu pomiędzy kolejnymi pakietami kontrolnymi (np. inter 2000 ms).
fall – HAProxy failure threshold – próg uznania serwera za uszkodzony; Liczba kolejnych nieudanych prób, po której serwer jest automatycznie wykluczany z puli.
rise – HAProxy recovery threshold – próg uznania serwera za sprawny; Liczba kolejnych udanych testów wymagana do ponownego włączenia węzła do obsługi ruchu.
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji; Protokół weryfikowany dyrektywą http-check send meth GET uri /healthz.

19/55 Statystyki HAProxy
Statystyki HAProxy: HAProxy udostępnia: stats socket (unix socket), HTTP stats page (dashboard), haproxy_exporter (Prometheus). 200+ metryk - fundament alertingu i capacity planning.

Balancer na drodze całego ruchu wie wszystko. HAProxy oddaje tę wiedzę trzema kanałami: socket, strona i eksporter.

  • Panel statystyk w WWW – wbudowany pulpit prezentuje w przeglądarce czytelny stan wszystkich backendów, ruch i kody błędów.
  • Gniazdo administracyjne – interfejs socket pozwala na dynamiczną zmianę wag i wyłączanie maszyn z poziomu konsoli bez restartu.
  • Eksport do Prometheusa – natywny punkt końcowy metryk ułatwia stałą integrację parametrów pracy HAProxy z platformą Grafana.
  • Wskaźniki kolejek – monitorowanie liczby żądań oczekujących na wolne połączenie pozwala szybko wychwycić przeciążenie aplikacji.
  • Zabezpieczenie panelu – dostęp do interfejsu statystyk musi być chroniony silnym hasłem oraz ograniczony do sieci wewnętrznej.
haproxy_exporter: Eksporter 200+ metryk HAProxy do Prometheusa; obok socketu unixowego i strony stats - fundament alertingu i planowania pojemności.
panel HAProxy

Statystyki i monitorowanie HAProxy należą do najbardziej szczegółowych w świecie load balancerów: stats socket (unix socket - programistyczny dostęp przez socat/echo), HTTP stats page (wbudowany web dashboard - stats enable, stats uri /stats, stats auth) oraz Prometheus exporter (haproxy_exporter - scrapowanie stats socket, eksport 200+ metryk). Monitoruje się stany backendów (status, sessions, bytes in/out, errors, queue, response time) i konfiguruje eksport do Prometheus.

Stats Socket (unix socket): Konfiguracja: stats socket /var/run/haproxy.sock mode 660 level admin expose-fd listeners. Dostęp: echo "show stat" | socat /var/run/haproxy.sock stdio (CSV), echo "show info" | socat ... (global info), echo "show servers state" | socat ... (stan serwerów). Level admin = pełna kontrola (enable/disable server, set weight, shutdown sessions). Level operator = read-only + enable/disable. Level user = read-only. To programistyczny interfejs - używany przez: haproxy_exporter, custom scripts, automation (Ansible/Terraform), CLI admin.

HTTP Stats Page (wbudowany dashboard): Konfiguracja: stats enable; stats uri /haproxy-stats; stats refresh 10s; stats auth admin:hashed_password; stats admin if TRUE. Dostęp: http://lb-ip:port/haproxy-stats - interaktywny dashboard: frontend/backend/server status (UP/DOWN/MAINT), sessions (cur/max/total), bytes in/out, request rate, response time (avg/max), errors (req/conn/response), queue (cur/max/limit). Użyteczne dla: quick debugging, on-call visualization, non-technical stakeholders. Bezpieczeństwo: stats auth (htpasswd), ACL na source IP, HTTPS only.

Prometheus Exporter (haproxy_exporter): Oficjalny exporter (github.com/prometheus/haproxy_exporter). Scrapuje stats socket, eksportuje metryki: haproxy_frontend_http_requests_total, haproxy_backend_http_responses_total, haproxy_server_up (1/0), haproxy_server_current_sessions, haproxy_server_http_requests_total, haproxy_server_http_response_time_seconds_sum/count. Deployment: sidecar container w Podzie z HAProxy, lub oddzielny daemon na VM. ServiceMonitor/PodMonitor dla Prometheus Operator. Metryki = fundament alertingu (server_down, high_queue, high_response_time, high_error_rate), capacity planning (trend sessions/bytes), troubleshootingu (correlation z logami).

Kluczowe metryki do alertingu: haproxy_server_up == 0 (backend down), haproxy_backend_http_responses_total{status=~"5.."} rate > threshold (5xx rate), haproxy_server_queue_current > limit * 0.8 (queue buildup), haproxy_server_http_response_time_seconds_bucket (p99 latency), haproxy_frontend_current_sessions > max_sessions * 0.9 (saturation). Recording rules dla heavy queries.

Podsumowanie: Stats socket = API dla automacji. Stats page = UI dla ludzi. haproxy_exporter = metryki dla Prometheus/Alerting. Wszystkie trzy = kompletna observability HAProxy. Zawsze wdrażaj exporter + alerty na server_up, 5xx rate, queue, latency. Bez metryk HAProxy = czarna skrzynka.

Z konsekwencją powtarzaliśmy w trakcie kursu, że komponent, którego stanu nie potrafimy zmierzyć, jest czarną skrzynką, a bez pomiaru nie ma racjonalnej oceny niezawodności. Load balanser stoi na ścieżce całego ruchu, więc z natury dysponuje ogromną wiedzą o systemie, i HAProxy uczynił z tego swój atut. Balanser otwiera się na świat trzema kanałami: unixowym socketem dla automatyzacji, wbudowaną stroną WWW dla człowieka oraz eksporterem metryk współpracującym z systemami monitorującymi, z którymi pracowaliśmy we wcześniejszych wykładach kursu.

Stats socket to programistyczny interfejs do odczytu stanu i sterowania: w poziomie admin pozwala nie tylko czytać liczniki, lecz także wyłączać serwery i zmieniać ich wagi, co świetnie sprawdza się w automatyzacji. Strona statystyk daje interaktywny panel z liczbą sesji, bajtów, kolejką i błędami dla każdej sekcji. Najwięcej daje jednak eksporter haproxy_exporter, zamieniający odczyty socketu na ponad dwieście metryk Prometheus. Na ich podstawie budujemy alerty o niedostępnym serwerze, narastającej kolejce czy rosnącej latencji.

Wyjaśnienie skrótów użytych na slajdzie:
CSV – Comma-Separated Values – wartości rozdzielane przecinkami; Format tekstowy eksportu surowych danych telemetrycznych z wbudowanego modułu statystyk HAProxy.
GUI – Graphical User Interface – graficzny interfejs użytkownika; Wbudowany w HAProxy panel webowy prezentujący w czasie rzeczywistym stan węzłów (zielony/czerwony).
REST – Representational State Transfer – architektura REST; Styl interfejsu zewnętrznego używany do automatycznego odpytywania wskaźników statystycznych.
API – Application Programming Interface – interfejs programistyczny; Gniazdo UNIX socket udostępniające metryki ruchowe bez narzutu protokołu HTTP.
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji; Protokół udostępniający stronę statystyk pod zdefiniowaną ścieżką (np. /haproxy?stats).

20/55 Porównanie Nginx i HAProxy
Porównanie Nginx i HAProxy: Nginx = web server z LB (cache, SSL, WAF). HAProxy = dedykowany LB (aktywne HC, stick tables, ACLs, metryki). Najlepsza strategia: współpraca - Nginx frontend → HAProxy backend.

Nginx czy HAProxy? Oba - każde tam, gdzie jest najlepsze. Front robi treści, tył robi ruch.

  • Mocne strony Nginx – bezkonkurencyjne serwowanie zasobów statycznych, doskonały cache na dysku oraz elastyczna obsługa stron WWW.
  • Mocne strony HAProxy – bezkompromisowa prędkość L4, bogate testy zdrowia, zaawansowane tablice stanów oraz inspekcja baz danych.
  • Współpraca architektoniczna – Nginx przyjmuje ruch z Internetu na brzegu sieci, a HAProxy precyzyjnie balansuje wywołania wewnętrzne.
  • Zużycie zasobów – oba programy charakteryzują się minimalnym apetytem na pamięć RAM i niezwykłą stabilnością w środowisku Linux.
  • Kryteria wyboru – do obsługi warstwy WWW wybierz Nginx, natomiast do dedykowanego i zaawansowanego proxy wybierz HAProxy.
Tandem Nginx+HAProxy: Nginx na froncie (treść, cache, TLS, WAF), HAProxy z tyłu (aktywne HC, ACL, metryki); narzędzia uzupełniają się zamiast konkurować.
tabela porównawcza
Czym jest katastrofa Split-Brain: Wyobraź sobie dwa serwery w klastrze, pomiędzy którymi nagle zerwał się kabel sieciowy. Węzeł B nie widzi węzła A, więc uznaje go za martwego i sam ogłasza się Masterem. Węzeł A jednak nadal działa i również uważa się za Mastera! Mamy teraz „rozdwojenie jaźni” (split-brain). Jeśli oba zaczną zapisywać dane do wspólnej bazy, doprowadzi to do nieodwracalnego uszkodzenia spójności danych. Dlatego klastry wymagają kworum (większości głosów) lub fizycznego odcięcia zasilania drugiemu węzłowi (mechanizm STONITH).

Nginx i HAProxy to dwa najpopularniejsze rozwiązania, które często współpracują zamiast konkurować: Nginx to web server + reverse proxy (dodany LB), dobry dla L7 (HTTP routing, caching, SSL termination, WAF via ModSecurity), z prostszą deklaratywną konfiguracją i mniejszym zużyciem RAM; HAProxy to dedykowany LB (od zera) z lepszym L4/L7 (TCP, TLS passthrough, PROXY protocol), zaawansowanymi metrykami (stats socket, 200+ metryk), ACLs/maps/stick tables, Lua scripting i lepszymi health checkami. Typowy układ to Nginx frontend (SSL term, cache, rate limit, WAF) → HAProxy backend (zaawansowane HC, stick tables, L4/L7, metryki).

Nginx - mocne strony: Web server heritage = doskonały do static files, caching (proxy_cache, stale-while-revalidate), SSL termination (centralne certy, OCSP stapling), rate limiting (limit_req), WAF (ModSecurity), prosty config (nginx.conf), duża społeczność, bogaty ekosystem modułów. Słabe: Active HC tylko w Plus (płatne), słabsze L4 (brak PROXY protocol w OSS do 1.13, brak zaawansowanych TCP HC), mniej metryk (basic status module), brak stick tables (persistence tylko ip_hash/cookie), brak ACL/maps (ograniczone routing logic).

HAProxy - mocne strony: Dedicated LB = wszytko zoptymalizowane pod LB. Active HC free (option httpchk, tcp-check, pgsql-check, mysql-check, redis-check). L4/L7 unified (mode tcp/http w jednym procesie). Stick tables = persistence + rate limiting + tracking + replication (peers). ACLs/maps = programowalne routing (path, header, cookie, src IP, SSL SNI, custom). Metryki = 200+ via stats socket + haproxy_exporter. Lua scripting = custom logic. Zero-downtime reload (master-worker, SO_REUSEPORT). Słabe: Nie jest web serverem (słabe static files, brak caching), brak WAF (w free), config bardziej imperatywny (kurwa krzywa uczenia), więcej RAM na stick tables, brak stale-while-revalidate.

Współpraca (best practice wzorzec): Nginx (frontend, port 80/443) -> HAProxy (backend, port 8080/8443). Nginx robi: TLS termination (centralne certy, Let's Encrypt), caching (offload 90% statycznych), rate limiting (DDoS protection), WAF (ModSecurity), compression (gzip/brotli), static files. HAProxy robi: L7 routing (ACL/use_backend po path/host), zaawansowane HC (inter/rise/fall, httpchk/tcp-check), stick tables (persistence + rate limiting), metryki (haproxy_exporter), L4 load balancing (dla gRPC/MySQL/Redis), zero-downtime reload. To połączenie mocnych stron obu narzędzi ("best of both worlds") - każde robi to, w czym jest najlepsze.

Kiedy co wybrać: Tylko Nginx: proste HTTP apps, static-heavy, mały zespół, budżet OSS, nie potrzebujesz zaawansowanych HC/stick tables. Tylko HAProxy: non-HTTP protocols (TCP), potrzebujesz active HC free, stick tables/rate limiting, bogate metryki, L4/L7 unified, enterprise support. Oba: production web stack (Nginx frontend + HAProxy backend), microservices (Envoy/Istio jako alternatywa). Trade-offs = use case driven.

Podsumowanie: Nginx = web server z LB features (caching, SSL term, WAF). HAProxy = dedicated LB (active HC, stick tables, ACLs, metryki, L4/L7). Wspólnie = power combo. Nie ma przegranego - to komplementarne narzędzia. Wybierz na podstawie: protokół (HTTP vs TCP), budżet (Plus vs free), funkcje (cache vs HC/metrics), zespół (nginx config vs haproxy config).

Przez ostatnie slajdy poznawaliśmy dwa narzędzia, które często stawia się w opozycji, a które w praktyce doskonale się uzupełniają. Nginx wywodzi się ze świata serwerów WWW i balansowanie traktuje jak jedną z wielu funkcji, przez co swoje atuty ma przy obsłudze treści, buforowaniu czy terminacji TLS. HAProxy powstało z kolei wyłącznie z myślą o równoważeniu obciążenia, dlatego w tej dziedzinie oferuje rozleglejsze możliwości. Pytanie, które wybrać, jest mniej istotne niż decyzja, jak połączyć je w wysokodostępną całość.

Nginx Open Source sprawdza się znakomicie na froncie: kończy szyfrowanie, buforuje odpowiedzi, ogranicza tempo żądań i serwuje pliki statyczne, a do tego ma prostą, deklaratywną konfigurację. HAProxy oddaje pełnię możliwości w punkcie styku z backendami, bo daje darmowe aktywne kontrole stanu, stick tables, reguły ACL, obsługę warstwy czwartej i szczegółowe metryki. Naturalny wzorzec architektoniczny to zatem współpraca obu narzędzi: Nginx w roli frontendu i HAProxy jako balanser wewnętrzny, gdzie każde robi to, do czego zostało zaprojektowane.

Wyjaśnienie skrótów użytych na slajdzie:
CPU – Central Processing Unit – procesor; Zasób wykorzystywany z różną efektywnością: HAProxy cechuje się wyższą wydajnością w L4, Nginx bogatszym ekosystemem modułów webowych.
RAM – Random Access Memory – pamięć operacyjna; Pamięć serwera; oba narzędzia cechują się znakomitą oszczędnością pamięci operacyjnej.
IOPS – Input/Output Operations Per Second – operacje we/wy na sekundę; Wskaźnik obciążenia dyskowego; Nginx wymaga I/O do buforowania plików, HAProxy operuje w pamięci.
L4 – Layer 4 Load Balancing – równoważenie w warstwie transportowej; Zastosowanie, w którym HAProxy stanowi bezkonkurencyjny standard przemysłowy.
L7 – Layer 7 Load Balancing – równoważenie w warstwie aplikacji; Zastosowanie, w którym Nginx doskonale sprawdza się jako serwer brzegowy i reverse proxy.

21/55 Architektura warstwowa HA
Architektura warstwowa HA: Trzy warstwy: front-end (LB: Nginx/HAProxy), application tier (stateless services, horizontal scaling), data tier (baza z replikacją: Patroni, Galera). Każda warstwa niezależnie redundantna.

Dojrzałe HA to trzy warstwy: front balansuje, aplikacje są bezstanowe, dane replikują. Każda redundantna osobno.

  • Separacja warstw – nowoczesna architektura dzieli system na odizolowane warstwy: brzegową, aplikacyjną oraz bazodanową.
  • Redundancja na każdym kroku – awaria pojedynczego serwera w dowolnej warstwie jest natychmiast maskowana przez komponenty równorzędne.
  • Wielostrefowość – rozproszenie instancji pomiędzy niezależne strefy dostępności chroni system przed lokalnymi awariami zasilania.
  • Bezstanowość aplikacji – serwery WWW nie przechowują sesji lokalnie, dzięki czemu balanser może swobodnie rozdzielać zapytania.
  • Spójność danych – warstwa bazodanowa replikuje transakcje w sposób gwarantujący pełne bezpieczeństwo danych w razie usterki.
Stateless services: Usługi bez stanu w warstwie aplikacji, skalowane horyzontalnie; dane (z replikacją Patroni/Galera) to warstwa stanowa i najtrudniejsza.
architektura warstw

Architektura warstwowa HA dzieli system na trzy warstwy: front-end (Load Balancer: Nginx/HAProxy - punkt wejścia, SSL termination, routing, rate limiting, WAF), application tier (stateless services: kontenery/Pod, horizontal scaling via Deployment/ReplicaSet, self-healing via liveness/readiness probes, rolling updates) i data tier (baza z replikacją: master-slave/primary-replica, multi-master/Galera/Patroni, synchronous/asynchronous replication, automated failover). Load balancer rozdziela ruch, replikacja zapewnia HA danych.

Front-end (Load Balancer Layer): Nginx (SSL termination, caching, rate limiting, WAF, static files) + HAProxy (L7 routing, active HC, stick tables, metryki). Rola: single point of entry (VIP/Floating IP), traffic distribution, health monitoring, security (DDoS, WAF), observability (metrics, logs). Redundancja: active-passive (keepalived/VRRP/VIP) lub active-active (anycast/ECMP/cloud LB). VIP failover < 30s.

Application Tier (Stateless Services): Kontenery (Docker/Podman) orkiestrowane przez Kubernetes (Deployment, ReplicaSet, HPA/VPA). Klucz: STATELESS - żaden stan w kontenerze (session w Redis, pliki w S3/EFS, config w ConfigMap/Secret). Horizontal scaling: replicas + HPA (CPU/memory/custom metrics). Self-healing: liveness probe (restart crashed), readiness probe (remove from Service endpoints), rolling updates (maxSurge/maxUnavailable). Service (ClusterIP/NodePort/LoadBalancer) = internal LB + service discovery (DNS: service.namespace.svc.cluster.local).

Data Tier (Stateful Storage z HA): Baza danych to najtrudniejsza warstwa do HA (stateful). Wzorce: Master-Slave (Primary-Replica) - jeden writer, repliki read-only; automated failover (Patroni+etcd/Consul dla PostgreSQL, MHA/Orchestrator dla MySQL, Sentinel/Cluster dla Redis). Multi-Master (Galera Cluster dla MySQL/MariaDB, Patroni multi-primary) - wszystkie nodów writer, synchronous replication (wsrep_sync_wait), conflict resolution. Synchronous vs Asynchronous: sync = RPO=0 (zero data loss), wyższa latency; async = RPO>0 (można stracić dane), niższa latency. Backup != HA (to DR).

Podsumowanie: Layered HA = LB (front) + Stateless Apps (middle, horizontal scaling) + HA Data (back, replication+failover). Każda warstwa niezależnie redundantna. Stateless apps = easy scaling/HA. Stateful data = hard, wymaga Patroni/Galera/Patroni + etcd/Consul. Load Balancer = klej łączący warstwy. To wzorzec referencyjny dla cloud-native HA.

Do tej pory mówiliśmy o pojedynczych balanserach i backendach, czas więc spojrzeć na cały system z lotu ptaka. Dojrzała architektura wysokiej dostępności dzieli się na trzy warstwy, których charakter determinuje sposób zapewnienia niezawodności. Na froncie stoi warstwa balansowania, w środku aplikacje bez stanu, skalowane horyzontalnie, a z tyłu dane, z natury stanowe i najtrudniejsze do utrzymania w ciągłości. Nad całością czuwa zasada: każda warstwa musi być niezależnie redundantna, by awaria jednej nie zatrzymała systemu.

Warstwa front-end to znane już Nginx i HAProxy, dające pojedynczy punkt wejścia, terminację TLS, kontrolę stanu i rozdział ruchu. Warstwa aplikacyjna opiera się na usługach bez stanu, w których najlepiej sprawdzają się kontenery: skoro stan sesji wyprowadzamy do zewnętrznych magazynów, liczbę replik można zmieniać swobodnie, a awaria jednej kopii nie pociąga za sobą utraty danych. Najtrudniejsza jest warstwa danych, gdzie bazę utrzymuje się przy życiu replikacją i automatycznym przełączeniem, na przykład z udziałem Patroni czy klastra Galera.

Wyjaśnienie skrótów użytych na slajdzie:
DMZ – Demilitarized Zone – strefa zdemilitaryzowana; Wyizolowany segment sieci na brzegu infrastruktury, w którym umieszcza się publiczne load balancery.
LAN – Local Area Network – sieć lokalna; Bezpieczna sieć wewnętrzna, w której pracują serwery aplikacji i bazy danych.
WAN – Wide Area Network – rozległa sieć komputerowa; Zewnętrzna sieć publiczna, z której klienci łączą się z wirtualnym adresem usługi.
DB – Database Server Tier – warstwa bazodanowa; Najgłębsza warstwa architektury wymagająca szczególnych mechanizmów replikacji i ochrony spójności.
API – Application Programming Interface – warstwa usług aplikacyjnych; Środkowa warstwa architektury wielopoziomowej przetwarzająca logikę biznesową.

22/55 Failover i automatyczne przełączenie
Failover i automatyczne przełączenie: Failover = przejęcie ruchu przez zapasowy komponent po awarii głównego. Active-passive (VRRP/keepalived) vs active-active (anycast, ECMP). Kluczowe: quorum + fencing = zapobieganie split-brain.

Kopia, która nie przejmuje ruchu, nie chroni. Failover to wykrycie plus decyzja plus akcja w <30 s - bez split-braina.

  • Istota failoveru – to automatyczny proces wykrycia awarii węzła głównego i natychmiastowego przekierowania ruchu na maszynę zapasową.
  • Model aktywny-pasywny – instancja zapasowa pozostaje w gotowości i zaczyna przetwarzać ruch dopiero po upadku węzła głównego.
  • Model aktywny-aktywny – wszystkie węzły równolegle obsługują ruch użytkowników, zapewniając pełne wykorzystanie zakupionego sprzętu.
  • Protokół VRRP i Keepalived – umożliwiają współdzielenie wirtualnego adresu IP pomiędzy dwoma serwerami bez zmian u klientów.
  • Ramki Gratuitous ARP – wysłanie pakietu GARP do przełącznika sieciowego błyskawicznie aktualizuje tablice routingu po przełączeniu adresu.
Split-brain: Stan dwóch aktywnych primary grożący uszkodzeniem danych; zapobiegają mu quorum (większość) i fencing (izolacja zdrajcy).
failover

Wysoka dostępność pary węzłów równoważenia obciążenia realizowana jest za pomocą narzędzia Keepalived implementującego protokół Virtual Router Redundancy Protocol zgodnie ze specyfikacją IETF RFC 5798. Węzeł główny (Master) rozgłasza cyklicznie pakiety ogłoszeniowe VRRP. W przypadku braku sygnału węzeł zapasowy (Backup) natychmiast przejmuje wirtualny adres IP (VIP) i rozsyła gratuitous ARP.

Failover to proces przejęcia ruchu przez zapasowy komponent po wykryciu awarii głównego, w trybach active-passive (jeden aktywny, jeden standby - VRRP/VIP/floating IP, keepalived, Pacemaker/Corosync) vs active-active (oba aktywne - anycast/ECMP, cloud LB, DNS round robin, load balancer cluster). Mechanizmy to VRRP (Virtual Router Redundancy Protocol), HSRP (Cisco Hot Standby Router Protocol), floating IP/VIP, DNS failover i application-level failover przez service discovery; cel to minimalny czas przestoju - RTO poniżej 30 sekund (detection 5-10s + decision 1-2s + switch 1-5s), a triggerem są health checks (LB HC, keepalived VRRP, Pacemaker resource agents).

Model aktywno-pasywny (Active-Passive / Cold/Warm Standby): jeden węzeł jest aktywny (primary), a drugi pozostaje w gotowości (secondary). Przełączanie awaryjne (failover): w razie awarii węzła głównego instancja zapasowa przejmuje wirtualny adres IP (VIP) lub jest awansowana do roli głównej (Patroni, Pacemaker). Zalety: prostota (brak problemu split-brain przy poprawnym kworum), spójność danych (pojedynczy węzeł zapisujący) oraz niższy koszt infrastruktury. Wady: bezczynność węzła zapasowego, niezerowy czas przełączenia oraz ryzyko braku redundancji w trakcie procedury przełączania, jeśli węzeł zapasowy również ulegnie uszkodzeniu. Zastosowanie: relacyjne bazy danych oraz systemy wymagające pojedynczego zarządcy stanu.

Active-Active (Hot Standby): Oba node aktywne, obsługują ruch równocześnie. Ruch rozdzielany przez: anycast/ECMP (routery), cloud LB (AWS ALB/NLB, GCP HTTP LB), DNS round robin (z TTL), LB cluster (HAProxy peers + stick table replication, Nginx Plus zone sync). Zalety: zero waste (wszystkie zasoby używane), instant failover (traffic już idzie do drugiego), lepsza wydajność (2x throughput). Wady: złożoność (split-brain risk, data consistency), wymaga stateless apps lub distributed consensus (Raft/Paxos), konflikty zapisu (multi-master DB). Używaj: stateless web tier, cloud-native, high-throughput, multi-AZ.

Mechanizmy failover: VRRP (RFC 5798) - open standard, Virtual IP (VIP) przesuwana między routerami/serwerami, priority + preempt. keepalived (Linux daemon implementujący VRRP) - najpopularniejszy dla VIP failover. HSRP (Cisco proprietary) - podobne do VRRP, w sieciach Cisco. Pacemaker/Corosync - cluster resource manager (CRM) + messaging layer, zarządza zasobami (VIP, filesystem, DB, services), quorum, fencing (STONITH). DNS failover - Route53/CloudDNS health checks -> aktualizacja DNS records (TTL 60s), wolniejsze (DNS cache). Application-level - service discovery (Consul/etcd) + client-side LB (gRPC, Envoy).

Split-brain prevention (krytyczne!): Quorum (większość głosów) - minimum 3 node'y lub 2 node + witness/quorum device. Fencing/STONITH (Shoot The Other Node In The Head) - fizyczne odcięcie od zasobów (IPMI power off, SCSI reservation, VMware kill VM) gdy node nie odpowiada. Pacemaker: stonith-action=reboot/poweroff. keepalived: vrrp_skip_check_adv (dla 2-node bez quorum - ryzykowne). Zawsze: quorum + fencing = split-brain prevention.

Podsumowanie: Failover = detection (HC) + decision (quorum) + action (VIP move / promote). Active-passive = simpler, cheaper, RTO > 0. Active-active = complex, expensive, RTO ~ 0. Mechanizm: VRRP/keepalived (VIP), Pacemaker (resources), DNS (slow), Cloud LB (managed). Zawsze: quorum + fencing (STONITH) = no split-brain. Testuj failover monthly!

Redundancja w architekturze warstwowej to dopiero pierwsza połowa sukcesu, bo komponent zapasowy, który nie potrafi przejąć ruchu, nie daje żadnej ochrony. To, co zamienia kopię w faktyczne bezpieczeństwo, to failover, czyli automatyczne przejęcie obsługi przez maszynę rezerwową, gdy podstawowa przestaje odpowiadać. W praktyce mamy dwa modele organizacji pary serwerów. W modelu aktywno-pasywnym zapas czuwa w gotowości i przejmuje ruch wraz z wirtualnym adresem, a w aktywno-aktywnym oba pracują równocześnie, a ruch dzieli sama sieć.

W wariancie pasywnym najczęściej sięgamy po protokół VRRP i narzędzie keepalived, które przenoszą wirtualny adres między węzłami. Wariant aktywno-aktywny opiera się na mechanizmach typu anycast czy ECMP, pozwalających kilku maszynom obsługiwać ten sam adres. Wspólnym celem obu podejść jest czas przełączenia poniżej trzydziestu sekund, na który składają się wykrycie awarii, decyzja oraz samo przełączenie ruchu. Największym zagrożeniem jest tak zwany split-brain; zapobiega mu kworum wymagające głosu większości oraz fencing, w praktyce stonith.

Wyjaśnienie skrótów użytych na slajdzie:
VIP – Virtual IP Address – wirtualny adres IP; Pływający adres sieciowy migrujący pomiędzy węzłami w trakcie procedury przełączenia awaryjnego.
VRRP – Virtual Router Redundancy Protocol – protokół redundancji routera wirtualnego; Standard IETF RFC 5798 sterujący wyborem aktywnego węzła w parze failover.
GARP – Gratuitous ARP – bezpłatny pakiet ARP; Niezamówiony pakiet rozgłoszeniowy aktualizujący tablice przełączników sieciowych po przejęciu adresu VIP.
ARP – Address Resolution Protocol – protokół odwzorowania adresów; Fundamentalny protokół sieciowy tłumaczący logiczne adresy IP na fizyczne adresy kart MAC.
IP – Internet Protocol – protokół internetowy; Podstawa adresacji węzłów w sieci teleinformatycznej.

23/55 Docker jako narzędzie HA
Docker jako narzędzie HA: Docker oferuje restart policies (always, on-failure), HEALTHCHECK i Docker Compose. Ograniczenie: standalone = single host. Do multi-host HA potrzebny Swarm lub Kubernetes.

Docker daje HA w pół kroku: szybkie restarty i healthchecki tak, ale multi-host to już Swarm albo Kubernetes.

  • Narzędzie niezawodności – technologia kontenerów Docker pozwala na szybkie uruchamianie i izolowanie procesów w powtarzalnym środowisku.
  • Polityki restartu – parametr restart: always gwarantuje automatyczne wznowienie pracy kontenera po awarii aplikacji lub restarcie hosta.
  • Izolacja zasobów – limity pamięci RAM i procesora chronią serwer przed paraliżem wywołanym wyciekiem zasobów w pojedynczym kontenerze.
  • Sondy zdrowia kontenera – instrukcja HEALTHCHECK pozwala demonowi Docker na bieżąco badać gotowość aplikacji do obsługi ruchu.
  • Niemutowalność środowiska – uruchamianie usług z identycznych obrazów eliminuje problem różnic konfiguracyjnych pomiędzy maszynami.
Restart policies: Polityki restartu kontenerów (always, on-failure) z HEALTHCHECK i Compose; standalone to jeden host - multi-host wymaga Swarma lub Kubernetesa.
Docker

Konteneryzacja drastycznie upraszcza i przyspiesza operacje HA - restart, scaling, deployment, isolation: szybkie restarty kontenerów z restart policies (always, on-failure:N, unless-stopped), Docker Compose jako orkiestrator prostych wdrożeń (multi-container apps, dependencies, networks, volumes) oraz health checks (HEALTHCHECK instruction: test, interval, timeout, start_period, retries). Docker monitoruje i raportuje stan, ale NIE restartuje automatycznie - do tego potrzebny orchestrator (Docker Swarm, Kubernetes).

Restart Policies (docker run --restart / docker-compose restart): always - kontener zawsze restartowany (po crashu, po reboocie hosta, po OOM kill). on-failure:N - restartuj tylko przy non-zero exit code, max N prób (po N-tym - zostaw down, alert). unless-stopped - jak always, ale nie restartuj jeśli użytkownik ręcznie zrobił `docker stop`. Best practice: production -> always lub unless-stopped. Nginx/HAProxy/app containers -> always. Init containers / migration jobs -> on-failure:3.

Docker Compose (wstęp): docker-compose.yml definiuje multi-container application (services, networks, volumes). Kluczowe dla HA: depends_on (kolejność startu, ale NIE czeka na gotowość - do tego healthcheck + wait script), healthcheck (test: ["CMD", "curl", "-f", "http://localhost/health"], interval: 30s, timeout: 10s, retries: 3, start_period: 10s) - Docker raportuje stan (healthy/unhealthy) w `docker ps` i events, ale NIE wykonuje akcji (restart/failover) - to robi orchestrator (Swarm/K8s). networks (bridge/overlay) - izolacja i service discovery (DNS: service_name). volumes - persistencja danych (named volumes, bind mounts).

HEALTHCHECK w Dockerfile: HEALTHCHECK --interval=30s --timeout=10s --start-period=10s --retries=3 CMD curl -f http://localhost:8080/health || exit 1. Buda w obraz - każdy kontener z tego obrazu ma HC. Docker Engine wykonuje check, aktualizuje stan (starting -> healthy -> unhealthy). Jeśli unhealthy -> event, ale NIE auto-restart (restart policy to osobna rzecz). Orchestrator (Swarm/K8s) reaguje na unhealthy: Swarm -> reschedule, K8s -> liveness probe -> restart pod.

Ograniczenia Docker standalone dla HA: Brak cross-host failover (kontener pada -> restart na tym samym hoście, jeśli host pada -> wszystko pada). Brak service discovery cross-host. Brak cross-host networking (overlay network wymaga Swarm). Brak auto-scaling. Rozwiązanie: Docker Swarm (wbudowany orchestrator) lub Kubernetes (standard rynkowy). Docker standalone = dev, test, single-host production, edge.

Podsumowanie: Docker = szybkie restarty (restart policy), health visibility (HEALTHCHECK), dependency management (Compose). Ale: Docker standalone NIE jest platformą HA (brak cross-host failover, scaling, service discovery). Do HA: Docker Swarm (prostszy) lub Kubernetes (standard). Docker = building block, nie kompletne HA solution.

Konteneryzacja w naturalny sposób wpisuje się w tematykę wysokiej dostępności, bo obraz kontenera definiowany raz jest powtarzalny, przenośny i odtwarzalny w dowolnym miejscu. To przyspiesza restarty, upraszcza wdrożenia i daje izolację procesów, ale mechanizmy te nabierają realnej wartości dopiero wtedy, gdy rozumiemy, co Docker potrafi zrobić z kontenerem, który przestał odpowiadać, oraz gdzie kończy się zakres jego możliwości - a tę granicę wyznacza pojedynczy host.

Z perspektywy HA Docker dostarcza przede wszystkim polityki restartu (always, on-failure z limitem prób, unless-stopped) oraz instrukcję HEALTHCHECK w Dockerfile, dzięki której raportuje stan kontenera jako zdrowy lub chory. Compose dorzuca sieci z własnym DNS i zależności między usługami, jednak w wariancie standalone całość działa w obrębie jednego gospodarza - oznacza to brak prawdziwego przełączania między hostami. Jeśli zależy nam na wielogospodarczej wysokiej dostępności, musimy przejść na Docker Swarm lub Kubernetes.

Wyjaśnienie skrótów użytych na slajdzie:
OCI – Open Container Initiative – Inicjatywa na Rzecz Otwartych Kontenerów; Standard formatu obrazów i środowisk uruchomieniowych izolujących aplikacje.
cgroups – Control Groups in Linux Kernel – grupy kontrolne jądra Linux; Mechanizm ograniczający i izolujący zużycie procesora i pamięci RAM dla kontenerów.
namespaces – Linux Kernel Namespaces – przestrzenie nazw jądra Linux; Mechanizm izolacji sieci, procesów i punktów montowania w systemie operacyjnym.
OS – Operating System – system operacyjny; Jądro Linuksa współdzielone pomiędzy kontenerami na jednym hoście fizycznym.
CPU – Central Processing Unit – procesor; Moc obliczeniowa przydzielana kontenerom w sposób gwarantowany za pomocą limitów zasobów.

24/55 Docker Compose (podstawy)
Docker Compose (podstawy): Docker Compose definiuje multi-container app: services, networks, volumes. Kluczowe: depends_on, healthcheck, restart policy, deploy replicas. Idealne dla dev/test.

Compose to jeden YAML na całą aplikację: usługi, sieci i wolumeny startują jednym poleceniem. Idealny na dev/test.

  • Deklaratywny opis stosu – pojedynczy plik docker-compose.yml definiuje wszystkie powiązane kontenery, sieci oraz wolumeny danych.
  • Wspólna sieć wirtualna – kontenery wewnątrz projektu komunikują się ze sobą za pomocą wbudowanego serwera DNS i nazw usług.
  • Wzorzec dla pojedynczego hosta – Docker Compose jest doskonałym narzędziem do budowy odpornych środowisk brzegowych i testowych.
  • Zarządzanie sekretami – zmienne konfiguracyjne i hasła powinny być wstrzykiwane z plików środowiskowych pomijanych w repozytorium.
  • Szybka replikacja – Compose ułatwia postawienie kompletnego środowiska z balancerem i backendami za pomocą jednego polecenia.
depends_on: Deklaracja kolejności startu usług w Compose; z healthcheck, restart policy i replikami - idealne do dev/test.
<a rel=Docker Compose.yml" />
CLI · Linux: docker compose
# docker-compose.yml version: '3.8' services: web: image: nginx:alpine ports: - "8080:80" user@server:~$ docker compose up -d [+] Running 1/1 ✔ Container web Started

Deklaratywną definicję usług w klastrze testowym umożliwia środowisko Docker Compose.

Docker Compose definiuje i uruchamia aplikacje wielokontenerowe - standard dla development, test, staging i prostych production workloads: services (image, build, ports, volumes, environment, depends_on, healthcheck, restart, deploy), networks (bridge - single host; overlay - Swarm multi-host; host - bez izolacji sieciowej) i volumes (named volumes dla persistencji, bind mounts dla config/code). Uruchamianie to docker compose up -d (detached), --build (rebuilid obrazów) i --scale service=N (horizontal scaling w Compose v2+).

Definicja usług (services): version: '3.8'; services: web: image: nginx:alpine; ports: ["8080:80"]; volumes: ["./html:/usr/share/nginx/html:ro"]; environment: [NGINX_HOST=example.com]; healthcheck: test: ["CMD", "wget", "-q", "--spider", "http://localhost"]; interval: 30s; timeout: 10s; retries: 3; restart: unless-stopped; deploy: replicas: 3; resources: limits: {cpus: '0.5', memory: 512M}; depends_on: [redis]; redis: image: redis:7-alpine; volumes: [redis_data:/data]; networks: [backend]; networks: {backend: {driver: bridge}}; volumes: {redis_data:}. Każda usługa = kontener z izolacją, własnym filesystem, siecią, limitami zasobów.

Sieci (networks): bridge (default) - single host, kontenery widzą się po nazwie usługi (DNS: service_name), izolacja od hosta. overlay - multi-host (wymaga Docker Swarm), VXLAN, kontenery na różnych hostach w tej samej sieci. host - brak izolacji sieciowej (kontener widzi interfejsy hosta), wydajność, ale bez bezpieczeństwa. Macvlan/ipvlan - zaawansowane, kontener ma własny MAC/IP w sieci fizycznej. Service discovery: DNS w sieci Docker (service_name, service_name.namespace) - zero config.

Wolumeny (volumes) i uruchamianie: Named volumes (docker volume create / docker-compose volumes:) - zarządzane przez Docker, persistencja danych (baza, redis, uploads), backup via docker run --rm -v volume:/data -v $(pwd):/backup alpine tar czf /backup/backup.tar.gz /data. Bind mounts (-v /host/path:/container/path) - config files, source code (dev), certyfikaty. Uruchamianie: docker compose up -d (detached), docker compose up --build (rebuild), docker compose up --scale web=3 (3 repliki usługi web - tylko Compose v2, single host), docker compose down (stop + remove), docker compose logs -f (tail logów).

Ograniczenia Compose dla HA: Single host (overlay network wymaga Swarm), brak cross-host failover, brak auto-scaling (--scale manualne), brak rolling updates (recreate = downtime), brak cross-host service discovery. Rozwiązanie: Docker Swarm (stack deploy z compose file) lub Kubernetes (kubectl apply -f kompatybilne z kompose convert). Compose = dev/test/staging/simple prod, nie enterprise HA platform.

Podsumowanie: Docker Compose = deklaratywny opis multi-container app (services, networks, volumes, healthchecks, restart). Up/down/scale/logs = proste CLI. Dobre dla: dev, CI/CD, staging, simple single-host prod. Dla HA: Swarm (docker stack deploy) lub K8s. Zawsze: healthcheck + restart policy + named volumes + resource limits.

Docker Compose zamienia zarządzanie wieloma kontenerami w czystą, deklaratywną konfigurację - services, networks i volumes opisujemy w jednym pliku YAML, który uruchamiamy jednym poleceniem. Zamiast ręcznie tworzyć, łączyć i konfigurować każdy kontener z osobna, definiujemy cały komplet aplikacji, a narzędzie dba o spójność tego układu. Compose sprawdza się w środowiskach deweloperskich, testowych i stagingowych, gdzie liczy się szybkość i powtarzalność - z tym akurat stykacie się państwo już na pierwszych zajęciach laboratoryjnych.

Najciekawsze dla niezawodności są dyrektywy kolejności startu i stanu zdrowia: depends_on wymusza uruchomienie zależności, healthcheck cyklicznie weryfikuje gotowość usługi, a restart policy automatycznie podnosi upadły kontener. Sieci bridge umożliwiają odnajdywanie usług po nazwie, a nazwane wolumeny przechowują dane poza kontenerem. Zastrzegam jednak, że dzieje się to wszystko w obrębie jednego hosta, dlatego Compose wystarcza w dev i testach, a produkcja wymagająca prawdziwego HA potrzebuje Swarma lub Kubernetesa.

Wyjaśnienie skrótów użytych na slajdzie:
YAML – YAML Ain't Markup Language – format serializacji YAML; Format deklaratywnego pliku docker-compose.yml opisującego usługi, sieci i wolumeny.
CLI – Command Line Interface – interfejs wiersza poleceń; Konsola narzędzia docker compose wykorzystywana do zarządzania cyklem życia klastra kontenerów.
CPU – Central Processing Unit – procesor; Zasób ograniczany dyrektywami cpuset lub cpus w konfiguracji usług kontenerowych.
RAM – Random Access Memory – pamięć operacyjna; Pamięć serwera limitowana parametrem mem_limit w celu zapobiegania awariom OOM.
IP – Internet Protocol – protokół internetowy; Adresacja wewnętrznej sieci mostkowej (bridge network) tworzonej automatycznie przez Compose.

25/55 Skalowanie usług w Docker
Skalowanie usług w Docker: Horizontal scaling = dodawanie replik zamiast powiększania. Self-healing: health checks + restart policy + rolling updates. Multi-host: Swarm lub Kubernetes HPA.

Skalowanie poziome to dodawanie replik pod balancer; pionowe to większa maszyna. Dla HA wygrywa poziome.

  • Polecenie scale – pozwala na natychmiastowe zwielokrotnienie liczby działających kontenerów danej usługi za pomocą prostego polecenia.
  • Dynamiczne dołączanie – nowo uruchomione repliki aplikacji automatycznie rejestrują się w sieci i mogą przyjmować ruch z balancera.
  • Odporność na skoki obciążenia – zwiększenie liczby kontenerów pozwala na bezproblemowe obsłużenie nagłego wzrostu liczby użytkowników.
  • Wyzwania portów – uruchomienie wielu instancji na jednym hoście wymaga losowego mapowania portów lub kierowania ruchu przez sieć mostka.
  • Granice jednego serwera – skalowanie w Docker Compose ogranicza się do zasobów jednej maszyny, wymagając przejścia do orkiestratora.
Self-healing: Samonaprawa przez health checki, polityki restartu i aktualizacje kroczące; w multi-host z HPA Kubernetesa.
kopie usługi

Skalowanie usług w Docker realizuje się w poziomie: docker compose up --scale web=3, Docker Swarm service scale, Kubernetes HPA/VPA. Automatyczna wymiana kontenerów (restart policies, health checks, rolling updates w Swarm/K8s) sprawia, że uszkodzony kontener jest automatycznie zastępowany, a gdy ruch rośnie – dodawane są kolejne repliki; ograniczeniem single-host scaling jest to, że Compose --scale działa tylko na jednym hoście, bez cross-host distribution.

Skalowanie w poziomie (Horizontal Scaling): Dodawanie replik usługi (replicas) zamiast powiększania pojedynczego kontenera (vertical scaling). docker compose up --scale web=3 - uruchamia 3 kontenery usługi web na tym samym hoście (Compose v2+), LB (Nginx/HAProxy) przed nimi rozdziela ruch (round robin/least_conn). Docker Swarm: docker service scale web=5 - rozdziela repliki na dostępne node'y w klastrze (placement constraints, resource reservations). Kubernetes: Deployment replicas: 3 + HPA (Horizontal Pod Autoscaler) - auto-scaling na podstawie CPU/memory/custom metrics (Prometheus Adapter).

Automatyczna wymiana kontenerów (Self-healing / Rolling Updates): Restart policies (always/on-failure) - restart po crashu na tym samym hoście. Health checks (HEALTHCHECK / liveness probe) - wykrywanie "zombie" kontenerów (proces działa ale aplikacja nie odpowiada). Docker Swarm: update_config: parallelism: 2, delay: 10s, failure_action: rollback, monitor: 60s - rolling update: 2 kontenery naraz, 10s przerwa, rollback przy błędzie. Kubernetes: Deployment strategy: RollingUpdate, maxSurge: 1, maxUnavailable: 0 - zero-downtime deployment (nowy pod ready -> stary terminowany). Readiness probe = traffic routing control.

Ograniczenia i best practices: Compose --scale = single host (wszystkie repliki na jednym hoście = SPOF host). Swarm/K8s = multi-host (repliki rozłożone na node'y, anti-affinity: spread). Resource limits (CPU/memory) - konieczne dla schedulera (bin packing) i HPA (metrics). Anti-affinity / placement constraints - rozkład replik na różne AZ/node/rack. Graceful shutdown (SIGTERM -> drain connections -> exit) - aplikacja musi obsłużyć SIGTERM (np. 30s timeout). PreStop hook (K8s) / stop_signal + stop_grace_period (Docker) - czas na graceful shutdown.

Podsumowanie: Horizontal scaling = repliki + LB = HA + throughput. Compose --scale = dev/single-host. Swarm/K8s = production multi-host HA. Self-healing = health checks + restart policy + rolling updates. Resource limits + anti-affinity = reliable scheduling. Graceful shutdown = zero-downtime ops. Skalowanie = nie tylko "więcej kontenerów" - to architektura: stateless, shared-nothing, observable.

Kolejny naturalny krok w stronę wysokiej dostępności to skalowanie poziome - zamiast powiększać pojedynczy kontener, dodajemy kolejne repliki usługi i pozwalamy load balancerowi rozdzielać między nie ruch. Tym samym wspieramy szczyty obciążenia i zabezpieczamy się przed awarią pojedynczej instancji, co zgadza się z ideą redundancji z początku wykładu. Skalowanie nabiera jednak sensu dopiero wtedy, gdy całość potrafi się samodzielnie naprawiać, stąd ścisły związek między replikacją, health checks a restart policies.

Lokalnie używamy polecenia docker compose up --scale, które uruchamia zadaną liczbę instancji na jednym hoście; w klastrze Swarm repliki mogą już trafiać na różne węzły, a Kubernetes skaluje automatycznie przez HPA na podstawie zużycia CPU, pamięci lub metryk niestandardowych. Do tego dochodzą aktualizacje toczące typu rolling oraz rozkład replik między strefy dostępności. Bez limitów zasobów, świadomie ustawionej antyafinity i obsługi sygnału SIGTERM w aplikacji taki mechanizm szybko zawiedzie w warunkach produkcyjnych.

Wyjaśnienie skrótów użytych na slajdzie:
scale – Docker Compose Scale Command – polecenie skalowania instancji; Polecenie docker compose up --scale app=3 powielające liczbę uruchomionych kontenerów.
replica – Service Replica in Orchestrators – replika usługi kontenerowej; Niezależna instancja kontenera przetwarzająca żądania w ramach tej samej usługi.
Swarm – Docker Swarm Mode – tryb orkiestracji Docker Swarm; Wbudowany mechanizm orkiestracji klastra kontenerów z wbudowanym load balancerem sieciowym.
VIP – Virtual IP in Docker Swarm – wirtualny adres IP w Docker Swarm; Wewnętrzny punkt wejściowy usługi routujący zapytania do poszczególnych kontenerów w pętli.
DNS – Domain Name System – system nazw domenowych; Wbudowany w silnik Dockera serwer DNS realizujący prosty podział ruchu w trybie Round Robin.

26/55 Kubernetes (wprowadzenie)
Kubernetes (wprowadzenie): Kubernetes = platforma orkiestracji kontenerów. Pod (jednostka wdrożenia), Service (discovery/LB), Deployment (lifecycle), Probes (self-healing), HPA/VPA (autoscaling).

Kubernetes to deklaratywny ideał: opisujesz stan, kontrolery go utrzymują. Pod, Service i Deployment wystarczą na start.

  • Standard orkiestracji – platforma Kubernetes zarządza klastrami setek serwerów, automatyzując wdrażanie, skalowanie i samonaprawę.
  • Autoskalowanie HPA – kontroler dynamicznie dostosowuje liczbę podów w odpowiedzi na bieżące zużycie procesora lub metryki zapytań.
  • Wbudowany load balancing – zasób Service automatycznie rozdziela pakiety pomiędzy zdrowe pody za pośrednictwem reguł sieciowych.
  • Mechanizm samoleczenia – uszkodzone kontenery są natychmiast restartowane, a w razie awarii węzła pody są ewakuowane na inne maszyny.
  • Abstrakcja infrastruktury – programiści definiują stan pożądany w plikach YAML, nie martwiąc się fizycznym rozmieszczeniem procesów.
Pod: Najmniejsza jednostka wdrożenia w Kubernetesie; obok Service (discovery/LB), Deployment (cykl życia), sond (samo-naprawa) i HPA/VPA (autoskalowanie).
plan klastra

W architekturze platformy Kubernetes Service ruch wewnętrzny równoważony jest na poziomie warstwy jądra węzła za pośrednictwem modułu kube-proxy (mechanizmy iptables lub IPVS). Pody podlegają nieustannej weryfikacji sondami gotowości (Readiness Probes); niesprawny pod jest natychmiast usuwany z obiektu Endpoints. Dostęp z zewnątrz klastra realizują dedykowane kontrolery Ingress pełniące funkcję zaawansowanych load balancerów L7.

Kubernetes (K8s) rozwiązuje ograniczenia Docker standalone/Swarm: cross-host scheduling, service discovery, self-healing, auto-scaling, rolling updates, secrets/config management i storage orchestration. Fundamenty to pody (Pod - najmniejsza jednostka wdrożenia, sidecar pattern), serwisy (Service - ClusterIP, NodePort, LoadBalancer, Headless), deploymenty (deklaratywne zarządzanie ReplicaSet: rolling updates, rollbacks, scaling), samonaprawa (self-healing: liveness/readiness/startup probes, node problem detector) i skalowanie (HPA na CPU/memory/custom metrics, VPA, Cluster Autoscaler).

Pod (Pod): Najmniejsza jednostka schedulowania. 1+ kontenerów: shared network namespace (localhost communication), shared volumes (emptyDir, configMap, secret, PVC), shared IPC. Wzorce: sidecar (logging agent, service mesh proxy, config reloader), ambassador (proxy do zewnętrznego serwisu), adapter (normalizacja outputu). Pod = mortal (umiera, nie resurrects) - kontroler (Deployment/StatefulSet/DaemonSet) zarządza cykl życia. Pod IP = efemeryczne, Service = stabilny endpoint.

Service (Service Discovery + Internal LB): ClusterIP (default) - VIP wewnątrz klastra, kube-proxy (iptables/IPVS) load balancuje do Podów (endpoints). NodePort - port na każdym node (30000-32767), external access. LoadBalancer - cloud provider LB (AWS ALB/NLB, GCP LB, Azure LB), automated provisioning. Headless (clusterIP: None) - DNS zwraca bezpośrednio Pod IPs (dla StatefulSets, custom LB). Selector (label selector) = dynamiczne matchowanie Podów. Endpoints/EndpointSlice = aktualna lista gotowych Podów (readiness probe).

Deployment (Declarative App Management): spec.replicas, spec.selector, spec.template (Pod template). RollingUpdate strategy: maxSurge (ile extra Podów podczas update), maxUnavailable (ile może być niedostępnych). Rollback: kubectl rollout undo deployment/app - natychmiastowe cofnięcie do poprzedniej ReplicaSet. History: kubectl rollout history deployment/app. Pause/resume: kubectl rollout pause/resume. Deployment zarządza ReplicaSet (wersjonowane Pod templates).

Self-healing (Automatyczne naprawianie): Liveness Probe (exec/httpGet/tcpSocket/grpc) - jeśli fail -> kubelet restartuje kontener (restart policy). Readiness Probe - jeśli fail -> Pod usunięty z Service endpoints (traffic stops), ale NIE restartowany. Startup Probe - dla wolno startujących aplikacji (disable liveness/readiness do sukcesu). Node Problem Detector - monitoruje host (disk pressure, memory pressure, kernel issues) -> taints/evictions. Pod Disruption Budget (PDB) - minAvailable/maxUnavailable podczas voluntary disruptions (drain, update).

Skalowanie: HPA (Horizontal Pod Autoscaler) - skaluje replicas Deployment na podstawie: CPU utilization (target 70%), memory, custom metrics (Prometheus Adapter: http_requests_per_second, queue_depth). VPA (Vertical Pod Autoscaler) - zaleca/ustawia resource requests/limits na podstawie historycznego zużycia (Off/Initial/Auto/Recreate). Cluster Autoscaler - skaluje node pool (ASG/MIG) na podstawie pending Pods (unschedulable -> scale up) i low utilization (scale down). Trzy poziomy: Pod (HPA/VPA) + Node (Cluster Autoscaler) = full elastic stack.

Podsumowanie: K8s = platforma HA, nie tylko orchestrator. Pod (unit) + Service (discovery/LB) + Deployment (lifecycle) + Probes (self-healing) + Autoscaling (HPA/VPA/Cluster) = production-grade HA platform. Declaratywne API (desired state) + controllers (reconciliation loop) = self-healing by design. Standard rynkowy: EKS/GKE/AKS (managed) lub kubeadm/k3s/Rancher (self-managed).

Kubernetes to platforma, która rozwiązuje ograniczenia Docker standalone i Swarm, łącząc w jednym miejscu wielohostowy scheduling, wykrywanie usług, samonaprawę, automatyczne skalowanie i aktualizacje bez przestojów. Dziś stanowi standard orkiestracji kontenerów i zasadniczy budulec architektur cloud-native. Jego wartość nie sprowadza się jednak do uruchamiania kontenerów - to deklaratywny model pożądanej konfiguracji i pętla uzgadniania, która nieustannie dąży do odtworzenia tego stanu, co czyni platformę z natury samonaprawialną.

Fundament tworzą trzy podstawowe obiekty: Pod, czyli najmniejsza jednostka wdrożenia z kontenerami współdzielącymi sieć i wolumeny, Service, który daje stabilny punkt wejścia i wewnętrzną dystrybucję ruchu, oraz Deployment, zarządzający deklaratywnie cyklem życia replik. Samonaprawa opiera się na sondach liveness i readiness, które odpowiednio restartują kontener i odłączają instancję od ruchu, a skalowanie poziome realizują HPA, VPA i Cluster Autoscaler - od pojedynczego poda, przez węzeł, po cały klaster.

Wyjaśnienie skrótów użytych na slajdzie:
K8s – Kubernetes – platforma orkiestracji Kubernetes; Przemysłowy standard automatyzacji wdrażania, skalowania i zarządzania skonteneryzowanymi aplikacjami.
Pod – Kubernetes Pod – pod w Kubernetesie; Podstawowa, atomowa jednostka wdrożeniowa składająca się z jednego lub więcej ściśle powiązanych kontenerów.
Service – Kubernetes Service – obiekt usługi Kubernetes; Trwała abstrakcja sieciowa definiująca logiczny zestaw podów oraz politykę dostępu do nich.
Ingress – Kubernetes Ingress Controller – kontroler wejściowy Ingress; Zarządzany load balancer L7 kierujący ruch zewnętrzny HTTP/HTTPS do usług wewnątrz klastra.
CNI – Container Network Interface – interfejs sieciowy kontenerów; Specyfikacja wtyczek sieciowych (np. Calico, Cilium) zarządzających komunikacją między podami.

27/55 Problemy z HA
Problemy z HA: HA dodaje złożoność: split-brain (dwa primary = data corruption), configuration drift, cascade failures. CAP theorem: CP vs AP. Rozwiązania: quorum, fencing, IaC, chaos engineering.

Wysoka dostępność wiąże się ze złożonością operacyjną: każdy element nadmiarowy wymaga konfiguracji, tworzy nowe zależności i potencjalne scenariusze awaryjne. Typowe zagrożenia to rozproszenie stanu (split-brain), dryft konfiguracyjny oraz kaskadowe propagowanie błędów.

  • Zjawisko Split-Brain – rozpad sieci pomiędzy węzłami klastra może doprowadzić do sytuacji, w której obie maszyny ogłoszą się Masterem.
  • Niespójność danych – równoczesny zapis do dwóch odizolowanych węzłów bazy danych prowadzi do nieodwracalnego uszkodzenia spójności.
  • Wymóg kworum – klaster wysokiej dostępności musi liczyć nieparzystą liczbę węzłów, wymagając zgody większości na podjęcie działań.
  • Mechanizm STONITH – fizyczne odcięcie zasilania uszkodzonemu serwerowi gwarantuje, że nie zniszczy on wspólnych zasobów dyskowych.
  • Zewnętrzni arbitrzy – w klastrach dwuwęzłowych stosuje się zewnętrzny serwis świadka w celu bezpiecznego rozstrzygania remisów.
CAP theorem: Twierdzenie o wyborze między spójnością a dostępnością przy podziale sieci (CP albo AP); odpowiedzią są quorum, fencing, IaC i chaos engineering.
problemy HA

W klastrach wysokiej dostępności przechowujących stan (bazy danych, rozproszone systemy plików) najgroźniejszym zjawiskiem jest rozszczepienie mózgu (Split-brain). W przypadku utraty łączności między węzłami węzeł zapasowy błędnie uznaje węzeł główny za martwy i sam ogłasza się liderem, co prowadzi do zapisu rozbieżnych danych. Zabezpieczeniem jest wymóg kworum większościowego (N/2 + 1) realizowany przez algorytmy konsensusu (Raft, Paxos) oraz automatyczne odcięcie zasilania węzła izolowanego za pomocą procedury STONITH (Shoot The Other Node In The Head). W bazach PostgreSQL standardem jest platforma Patroni oparta na rozproszonym rejestrze etcd.

HA nie jest darmowe - dodaje złożoność, koszt i nowe tryby awaryjne: złożoność konfiguracji (więcej komponentów = więcej punktów awarii, configuration drift, operational burden), split-brain (dwa węzły myślą, że są primary - data corruption, split-brain syndrome) oraz spójność danych (CAP theorem - consistency vs availability vs partition tolerance, konsensus Raft/Paxos, quorum, fencing/STONITH). To kluczowe wyzwania, o których inżynier SRE musi wiedzieć zanim wdroży HA.

Złożoność konfiguracji (Complexity = Failure Domain): Każdy dodany komponent HA (LB, keepalived, Pacemaker, replikacja DB, orchestrator) to: nowy config do zarządzania, nowy tryb awaryjny, nowa zależność, więcej kodu do testowania. Configuration drift (różnice między node'ami) -> subtelne bugi przy failoverze. Operational burden: więcej alertów, więcej runbooków, trudniejsze debugging (distributed tracing required). Mitigacja: Infrastructure as Code (Terraform/Ansible/Helm), GitOps (ArgoCD/Flux), automation (wszystko kodem), chaos engineering (testuj tryby awaryjne), documentation (runbooki per komponent).

Split-brain (Rozdzielony mózg): Dwa węzły (lub partycje klastra) jednocześnie uważają się za primary/leader. Przyczyny: network partition (sieć dzieli klaster), brakujące quorum (2-node cluster bez witness), brak fencing (STONITH), clock drift (NTP issues). Skutki: data corruption (dwa writer'y do tej samej bazy/dysku), service disruption (klient pisze do obu), recovery nightmare (manual intervention, data merge). Rozwiązania: Quorum (3+ nodes lub 2+witness), Fencing/STONITH (IPMI power off, SCSI persistent reservation, VMware kill, cloud instance terminate), Consensus algorithms (Raft/Paxos - etcd, Consul, Patroni) - gwarantują single leader. Zawsze: quorum + fencing = split-brain prevention.

Spójność danych (CAP Theorem): CAP = Consistency (wszystkie widzą te same dane) + Availability (każdy request dostaje odpowiedź) + Partition Tolerance (system działa mimo partycji sieciowej). Możesz wybrać tylko dwa z nich. Systemy wysokiej dostępności (HA) muszą wybrać Partition Tolerance (sieć zawsze może ulec rozspójnieniu). Wybór: CP (Consistency + Partition Tolerance) - np. etcd, Consul, Patroni (Raft) - przy partycji: minority partition staje się read-only/unavailable, majority kontynuuje. AP (Availability + Partition Tolerance) - np. DynamoDB, Cassandra, DNS - przy partycji: obie partycje akceptują zapisy, a rozwiązywanie konfliktów następuje później (last-write-wins, CRDTs). Wybór = business decision: finansy/transakcje -> CP (RPO=0); shopping cart/session -> AP (dostępność).

Inne problemy: Cascade failures (failover overload -> zdrowe node'y padają) - circuit breaker, rate limiting, capacity headroom. Thundering herd (wszyscy klientów retry jednocześnie po failoverze) - exponential backoff + jitter, retry budgets. Configuration drift (node A != node B) -> failover breaks - IaC + GitOps + compliance scanning. Testing gap (HA nie testowane) -> failover fails w produkcji - monthly failover drills, chaos engineering.

Podsumowanie: HA = complexity tax. Split-brain = data corruption nightmare (quorum + fencing = prevention). CAP = business choice (CP vs AP). Cascade failures = capacity planning. Testing = mandatory (monthly drills + chaos engineering). HA nie wdrożysz "raz i zapomnisz" - to ciągły proces: monitor, test, improve, document.

Wysoka dostępność nie jest darmowa - każdy redundantny komponent to zarazem kolejny punkt konfiguracji, kolejna zależność i kolejny możliwy tryb awarii. Z czasem węzły klastra potrafią rozjechać się w ustawieniach, a sam failover bywa wtedy nieprzewidywalny; mówimy o zjawisku dryfu konfiguracji i o koszcie operacyjnym złożoności. Zanim zaczniemy dodawać kolejne "dziewiątki" dostępności, musimy poznać klasyczne problemy, na które taka architektura wpada - inaczej zamiast odporności otrzymamy nowe źródło awarii.

Najgroźniejszy z nich to split-brain, czyli sytuacja, w której dwa węzły jednocześnie uznają się za primary i przyjmują zapisy, co wprost prowadzi do uszkodzenia danych. Z pomocą przychodzi tu teoria CAP, pokazująca, że pełnej spójności, dostępności i tolerancji na partycję nie da się mieć naraz - w praktyce wybieramy zatem systemy CP, jak etcd czy Patroni, albo AP, jak Cassandra czy DNS. Zabezpieczenie stanowią kworum, wykluczanie węzłów przez fencing (STONITH) oraz infrastruktura jako kod ograniczająca dryf i wspierana chaos engineeringiem.

Wyjaśnienie skrótów użytych na slajdzie:
Split-brain – Split-brain cluster condition – rozszczepienie klastra (stan split-brain); Krytyczny stan awarii klastra, w którym odizolowane węzły jednocześnie uznają się za nadrzędne.
Quorum – Majority Quorum Mechanism – kworum większościowe; Minimalna liczba głosów ($N/2 + 1$) wymagana w klastrze do legalnego podjęcia decyzji o wyborze lidera.
STONITH – Shoot The Other Node In The Head – odcięcie uszkodzonego węzła STONITH; Sprzętowy mechanizm fencingowy odcinający zasilanie węzła, który utracił kontakt z klastrem.
Raft – Raft Consensus Algorithm – algorytm konsensusu Raft; Zrozumiały i bezpieczny algorytm zapewniający spójność rozproszonego rejestru stanów.
Paxos – Paxos Consensus Protocol – protokół konsensusu Paxos; Klasyczny, matematycznie dowiedziony algorytm osiągania porozumienia w sieciach zawodnych.

28/55 DR (odzyskiwanie po awarii) wstęp
DR - odzyskiwanie po awarii: RTO (Recovery Time Objective) = czas przywracania usługi. RPO (Recovery Point Objective) = dopuszczalna utrata danych. Strategie standby: hot, warm, cold.

HA ratuje komponenty, DR ratuje regiony: pożar, pad strefy, ransomware. Dwa pytania: jak szybko i ile stracić.

  • Odzyskiwanie po katastrofie – plan Disaster Recovery obejmuje zestaw procedur i narzędzi pozwalających wznowić działanie firmy po zniszczeniu DC.
  • Różnica między HA a DR – wysoka dostępność chroni przed awarią komponentu, natomiast DR zabezpiecza przed zniszczeniem całej serwerowni.
  • Katastrofy naturalne i cyberataki – plan musi uwzględniać pożary, zalania, długotrwałe braki prądu oraz ataki ransomware.
  • Niezależność geograficzna – zapasowe centrum danych musi znajdować się w bezpiecznej odległości od głównej siedziby przedsiębiorstwa.
  • Testowanie procedur – plan odzyskiwania, który nie był regularnie testowany w praktyce, daje jedynie złudne poczucie bezpieczeństwa.
Strategie standby: hot (pełna gotowość), warm (częściowa), cold (archiwum); im gorętszy standby, tym niższe RTO/RPO i wyższy koszt.
DR

Zarządzanie ciągłością działania (Business Continuity Management) podlega międzynarodowej normie PN-EN ISO 22301. Wymaga ona przeprowadzenia formalnej analizy BIA (Business Impact Analysis) i wyznaczenia trzech kluczowych parametrów:
- MTPD (Maximum Tolerable Period of Disruption) – maksymalny dopuszczalny czas niedostępności usługi, po którym następuje nieodwracalna szkoda dla organizacji,
- RTO (Recovery Time Objective) – docelowy czas technicznego odzyskania działania systemów, który bezwzględnie musi być krótszy od wskaźnika MTPD (RTO < MTPD),
- RPO (Recovery Point Objective) – maksymalna dopuszczalna utrata danych mierzona wstecz od momentu awarii, wyznaczająca interwał replikacji bazy.

Disaster Recovery (DR) to strategia odzyskiwania po katastrofalnej awarii (loss of entire site/region), która idzie poza standardowe HA - HA obejmuje awarię pojedynczego komponentu, DR awarię lokacji/regionu. Fundamentem są RTO (Recovery Time Objective - ile czasu na przywrócenie usługi) i RPO (Recovery Point Objective - ile danych wolno stracić, do jakiego punktu w czasie przywracamy), a strategie standby to hot standby (active-active, zero RPO, RTO ~ minutes), warm standby (pilot light/warm spare, RPO ~ minutes/hours, RTO ~ hours) i cold standby (backup/restore, RPO ~ hours/days, RTO ~ hours/days).

RTO (Recovery Time Objective): Czas od momentu ogłoszenia katastrofy do przywrócenia usługi dla użytkowników. Przykłady: RTO=0 (immediate) - active-active multi-region, global LB failover; RTO=15 min - warm standby (pilot light) z automatyzacją; RTO=4h - warm standby z manualnymi krokami; RTO=24h - cold standby (restore z backupu). RTO determinuje: architekturę standby, poziom automatyzacji, koszt infrastruktury (hot = drogi, cold = tani). RTO to umowa z biznesem (SLA), nie cel techniczny.

RPO (Recovery Point Objective): Maksymalna akceptowalna utrata danych (lub cofnięcie w czasie). Przykłady: RPO=0 (zero data loss) - synchronous replication (multi-AZ DB, synchronous DR), active-active; RPO=1 min - near-sync replication, frequent snapshots; RPO=1h - async replication z frequentnymi checkpointami; RPO=24h - daily backup. RPO determinuje: tryb replikacji (sync vs async), częstotliwość backupu/snapshotów, koszt storage i bandwidth. RPO=0 = drogie (sync replication latency, bandwidth), RPO>0 = tańsze.

Strategie Standby: Hot Standby (Active-Active / Active-Passive z sync replication) - drugi region w pełni gotowy, ruch idzie do obu (active-active) lub standby hot (replication sync, usługi uruchomione). RPO~0, RTO~minutes. Koszt: 2x production (lub 1.5x passive). Warm Standby (Pilot Light / Warm Spare) - minimalna infrastruktura w standby (DB replica, core services), skrypty automatyzujące scale-up. Pilot Light: tylko data layer (DB replica), app layer deployed on-demand. Warm Spare: app layer deployed ale scaled to zero/minimal. RPO~minutes-hours, RTO~hours. Koszt: 10-30% production. Cold Standby (Backup/Restore) - tylko backupy (DB dump, volume snapshots, config w Git), infrastructure deployed from scratch (IaC). RPO=backup frequency (daily/hourly), RTO=hours-days. Koszt: storage only (~1-5% production).

DR Plan (Plan odzyskiwania): Dokument: scenariusze (site loss, region loss, ransomware, data corruption), role (incident commander, DB admin, network admin, app team), procedury krok po kroku (runbooki), kontaktowe/escalation, communication plan (stakeholders, customers), test schedule (quarterly DR test), success criteria (RTO/RPO met). DR test = nie "tabletop" - real failover do standby region, validate data integrity, validate app functionality, measure actual RTO/RPO. Bez testowanego DR planu = nie masz DR.

Podsumowanie: HA ≠ DR. HA = component failure (single server, single AZ). DR = site/region failure (data center, region, ransomware). RTO/RPO = business-driven targets. Strategie: hot (RTO~min, RPO~0, $$$), warm (RTO~hrs, RPO~min, $$), cold (RTO~days, RPO~hrs, $). DR Plan + Quarterly Tests = must have. Cost of DR = insurance policy - płacisz nadziejąc się, że nie użyjesz.

Rozdział o odzyskiwaniu po awarii porusza inną skalę zdarzeń niż dotychczas - nie pojedynczy serwer, lecz całą lokalizację albo region: pożar, utratę strefy w chmurze czy atak ransomware. Standardowe mechanizmy HA radzą sobie z awarią komponentu, podczas gdy disaster recovery ma przywrócić usługę i dane po utracie całego środowiska. Plan takiego odzyskiwania musi odpowiedzieć na dwa kluczowe pytania, które wyznaczą dalszą architekturę: jak szybko wracamy do pracy i ile danych wolno nam stracić.

Odpowiedzią są wskaźniki RTO i RPO - czas od katastrofy do przywrócenia usługi oraz dopuszczalna utrata danych - oba mające charakter bardziej biznesowy niż techniczny. Od nich zależy dobór strategii standby: od hot, gdzie drugi region jest w pełni gotowy i realizuje RTO rzędu minut oraz RPO bliskie zeru, przez warm, oparty o replikę pracującą jak pilot light, po cold, czyli przywracanie z kopii zapasowych i infrastruktury tworzonej od zera z kodu. Im niższe cele, tym droższa architektura.

Wyjaśnienie skrótów użytych na slajdzie:
DR – Disaster Recovery – odzyskiwanie po katastrofie; Zbiór polityk i narzędzi technicznych umożliwiających odtworzenie działania IT po zniszczeniu centrum danych.
BCP – Business Continuity Plan – plan ciągłości działania; Strategiczny dokument organizacyjny określający funkcjonowanie przedsiębiorstwa w warunkach kryzysu.
DRP – Disaster Recovery Plan – techniczny plan odzyskiwania poawaryjnego; Szczegółowa instrukcja inżynierska krok po kroku opisująca procedury podnoszenia systemów z kopii zapasowych.
BIA – Business Impact Analysis – analiza wpływu na biznes; Formalne badanie konsekwencji finansowych i prawnych przestoju poszczególnych procesów biznesowych.
MTPD – Maximum Tolerable Period of Disruption – maksymalny dopuszczalny okres przestoju; Graniczny czas, po którym zakłócenie działalności grozi upadłością lub utratą licencji organizacji.

29/55 RTO i RPO w praktyce
RTO i RPO w praktyce: RPO=0 wymaga replikacji synchronicznej (drogo), a RTO=0 architektury active-active w wielu regionach (bardzo drogo) - koszty rosną wykładniczo, dlatego decyzję podejmuje się, porównując koszt przestoju z kosztem infrastruktury HA.

RTO i RPO to cennik: zero kosztuje fortunę, godziny grosze. Porównaj koszt przestoju z kosztem zabezpieczenia.

  • Wskaźnik RTO – określa maksymalny dopuszczalny czas trwania przestoju od momentu katastrofy do pełnego wznowienia działania usług.
  • Wskaźnik RPO – definiuje maksymalny akceptowalny okres, z którego dane transakcyjne mogą zostać bezpowrotnie utracone w wyniku awarii.
  • Koszty zerowych wskaźników – uzyskanie zerowych wartości RTO i RPO wymaga kosztownej architektury aktywnej w wielu regionach naraz.
  • Decyzja biznesowa – wartości RTO i RPO muszą zostać formalnie uzgodnione z zarządem w oparciu o analizę strat finansowych firmy.
  • Dyscyplina pomiaru – inżynierowie muszą regularnie mierzyć rzeczywisty czas odtwarzania środowiska, weryfikując założenia planu.
Replikacja synchroniczna: Zapis potwierdzany na obu stronach dający RPO=0 za cenę opóźnień i kosztów; RTO=0 wymaga active-active w wielu regionach.
RTO/RPO

RTO i RPO w praktyce to inżynieria kosztów i ryzyka, nie teoria: RPO mówi ile danych wolno stracić (RPO=0 dla baz danych finansowych/transakcyjnych, RPO=1h dla logów/metryk, RPO=24h dla archiwów), RTO jak szybko odzyskać usługę (RTO=0 dla systemów krytycznych/płatniczych, RTO=4h dla systemów wewnętrznych/HR, RTO=24h dla dev/test). Im niższe RTO/RPO, tym wykładniczo droższe rozwiązanie - koszt infrastructure, bandwidth i operational complexity (cost-benefit analysis, synchronus/asynchroniczna replikacja, częstotliwość backupów).

RPO - przykłady liczbowe i implementacja: RPO=0 (zero data loss) - synchronous replication (PostgreSQL synchronous_commit=on, Patroni synchronous_mode=true, MySQL semi-sync/Group Replication, Galera wsrep_sync_wait=7), multi-AZ deployment (DB replica w innej AZ, sync commit). Koszt: latency (commit czeka na replica), bandwidth, wymaga < 2ms RTT między AZ. RPO=1 min - near-sync (async z frequent flush), log shipping co 60s, snapshot co 5 min. RPO=1h - async replication (PostgreSQL streaming replication async, MySQL async), WAL archiving co 1h, volume snapshot co 1h. RPO=24h - daily backup (pg_dump, mysqldump, volume snapshot), point-in-time recovery (PITR) do ostatniego backupu + WAL replay. Wybór RPO = business decision: "ile transakcji możemy stracić bez bankructwa/prawnego problemu?".

RTO - przykłady liczbowe i implementacja: RTO=0 (immediate) - active-active multi-region (Global LB: AWS Global Accelerator, Cloudflare Load Balancing, GCP Global LB), DNS failover z TTL=0/health checks, application-level failover (client-side LB, service discovery). RTO=15 min - warm standby (pilot light): DB replica ready, app layer deployed via IaC (Terraform/Helm) on-demand, auto-scaling group warm pool. RTO=1h - warm standby z pre-deployed app layer (scaled to minimal), automated runbook (Ansible/Terraform apply). RTO=4h - cold standby z automation: IaC deploy infrastructure (30 min), restore DB from snapshot (60 min), deploy app (30 min), DNS switch (10 min), validation (30 min). RTO=24h - manual restore: procure infrastructure, restore backup, manual config, test. RTO determinuje: poziom automatyzacji (full auto vs manual), standby infrastructure (hot/warm/cold), team readiness (on-call, runbooks).

Zależność kosztów od RTO/RPO (Cost Curve): Wykres: Oś X = RTO/RPO (malejące), Oś Y = Cost (rosnąca wykładniczo). RTO=24h/RPO=24h (cold) = $ (storage only). RTO=4h/RPO=1h (warm) = $$ (10-30% prod infra). RTO=15min/RPO=1min (warm pilot light) = $$$ (30-50% prod infra). RTO=0/RPO=0 (hot active-active) = $$$$ (100-200% prod infra, multi-region). Prawo malejących zwrotów: każda kolejna "dziewiątka" dostępności kosztuje 2-10x więcej. Cost-benefit analysis: Cost of Downtime (revenue loss/hour + reputation + SLA penalties) vs Cost of DR Infrastructure. Jeśli Cost of Downtime > Cost of DR -> inwestuj w niższe RTO/RPO.

Przykład biznesowy: E-commerce $1M/h revenue. Downtime cost = $1M/h + SLA penalties. RTO=4h (warm, $50k/mies) -> expected loss/year = 1 incident * 4h * $1M = $4M. RTO=15min (hot, $200k/mies) -> expected loss = 1 incident * 0.25h * $1M = $250k. Savings = $3.75M/year vs additional $150k/mies = $1.8M/year. ROI = 2x. Decyzja: inwestuj w warm/hot. Dla systemów wewnętrznych (HR, wiki) Cost of Downtime = niskie -> cold standby OK.

Podsumowanie: RPO=0 -> sync replication (latency cost). RPO>0 -> async/snapshots (bandwidth savings). RTO=0 -> active-active global LB (complexity cost). RTO>0 -> warm/cold standby (automation level). Cost curve = wykładnicza. Business decision = Cost of Downtime vs Cost of DR. Zawsze: zdokumentuj RTO/RPO w SLA, przetestuj (DR drill), zmierz actual RTO/RPO.

Celem tego slajdu jest pokazanie, że RTO i RPO to przede wszystkim decyzja biznesowa o kosztach i akceptowalnym ryzyku, zapadająca na styku inżynierii i finansów, a nie czysto techniczne parametry. Każde obniżenie tych wartości przekłada się na konkretne inwestycje: szybszą replikację, bardziej gotowy standby, więcej automatyzacji i szerszą infrastrukturę. Krzywa kosztów rośnie przy tym wykładniczo, więc liczy się znalezienie punktu, w którym koszt przestoju zaczyna przewyższać koszt zabezpieczenia.

RPO równe zeru osiągniemy wyłącznie replikacją synchroniczną, która każe potwierdzić transakcję na replice, zanim zakończy się komit - to koszt opóźnienia zapisu. Z kolei RTO równy zeru wymaga konfiguracji active-active w wielu regionach z globalnym load balancerem, czyli pełnego zwielokrotnienia zasobów. Pomiędzy tymi ekstremami mieszczą się tańsze warianty: replikacja asynchroniczna, kopie zapasowe i automatyczne runbooki. Podstawą wyboru jest porównanie kosztu przestoju ponoszonego przez biznes z kosztem utrzymania infrastruktury DR.

Wyjaśnienie skrótów użytych na slajdzie:
RTO – Recovery Time Objective – docelowy czas odzyskania sprawności; Planowany, maksymalny czas technicznego przywrócenia dostępności usługi po awarii.
RPO – Recovery Point Objective – docelowy punkt odzyskiwania danych; Maksymalny dopuszczalny wiek danych, które mogą zostać bezpowrotnie utracone w wyniku awarii.
MTPD – Maximum Tolerable Period of Disruption – maksymalny dopuszczalny czas zakłócenia; Nadrzędny parametr biznesowy, którego wartość bezwzględnie musi przewyższać parametr RTO.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; Kontrakt handlowy definiujący finansową odpowiedzialność za przekroczenie wskaźników RTO.
ISO – International Organization for Standardization – Międzynarodowa Organizacja Normalizacyjna; Wydawca standardu ISO 22301 precyzującego metodykę kalkulacji wskaźników RTO i RPO.

30/55 Kopie zapasowe a DR
Kopie zapasowe a DR: Backup bez testowanego restore = nadzieja, nie strategia. Kluczowe: PITR (Point-in-Time Recovery), automatyzacja, regularne testy, retention policy (GFS).

Nieprzetestowany backup to nadzieja, nie strategia. Liczy się PITR, automatyka i comiesięczne próby.

  • Kopia to nie wszystko – samo posiadanie kopii zapasowej nie gwarantuje szybkiego powrotu do działania bez sprawdzonych procedur.
  • Zasada 3-2-1 – należy utrzymywać trzy kopie danych na dwóch różnych typach nośników, w tym co najmniej jedną w odległej lokalizacji.
  • Niezmienne kopie WORM – ochrona backupów przed nadpisaniem i skasowaniem zabezpiecza organizację przed szantażem oprogramowania ransomware.
  • Testowe odtwarzanie – zautomatyzowane, cotygodniowe próby przywracania danych z kopii weryfikują spójność zarchiwizowanych baz.
  • Czas transferu danych – przy terabajtowych bazach czas pobierania kopii przez sieć może stać się głównym ograniczeniem wskaźnika RTO.
PITR (Point-in-Time Recovery): Odtwarzanie na dowolny moment z kopii i dzienników; z automatyzacją, testami i polityką GFS.
kopie a odzyskiwanie

Kopie zapasowe to fundament Disaster Recovery - bez testowanego restore nie masz backupu, masz tylko nadzieję. Kluczowe są testowanie restore (restore drill - regularne odtwarzanie z backupu na osobnym środowisku, walidacja integralności danych, pomiar czasu restore = actual RTO), automatyzacja kopii (scheduled jobs: pg_dump/mysqldump, volume snapshots, WAL archiving, retention policies, monitoring sukcesu/porażki, alerting na failed backups) oraz związek z kompetencją U02 (planowanie, organizacja, odpowiedzialność za ciągłość biznesową); point-in-time recovery (PITR) zależy od WAL archiving.

Testowanie odzyskiwania (restore drill) – kluczowa zasada: „Nieprzetestowana kopia zapasowa to brak kopii”. Procedura: monthly/quarterly restore na izolowanym środowisku (staging/DR site), pełny restore (full + incremental/WAL), walidacja: row counts, checksums, sample queries, application smoke test (app start -> health check -> sample transactions), pomiar czasu (actual RTO), dokumentacja (runbook update, lessons learned). Częstość: critical DB -> weekly restore test (automatyzowane), standard DB -> monthly, archive -> quarterly. Narzędzia: pgBackRest, restic, Velero (K8s), cloud provider snapshots + automated restore scripts.

Automatyzacja kopii: Scheduled jobs (cron / systemd timer / Kubernetes CronJob / cloud scheduler). Baza danych: pg_dump (logical, portable, slow na dużych DB), pg_basebackup + WAL archiving (physical, fast, PITR), pgBackRest (enterprise: full/incr/diff, compression, encryption, S3/GCS/Azure, parallel). MySQL: mysqldump (logical), Percona XtraBackup (physical, hot), MySQL Shell dump/load. Volume snapshots (cloud: AWS EBS snapshot, GCP Persistent Disk snapshot, Azure Disk snapshot) - crash-consistent, application-consistent (freeze filesystem + snapshot). Retention: daily 7, weekly 4, monthly 12, yearly 7 (GFS - Grandfather-Father-Son). Monitoring: alert na failed backup (exit code != 0), alert na brak backupu > 25h (stale), alert na rozmiar backupu (anomalia).

Point-in-Time Recovery (PITR): Full backup (base) + WAL/archive logs = recovery do dowolnej sekundy. PostgreSQL: pg_basebackup + WAL archiving (archive_command = 'cp %p /archive/%f') -> restore: restore_command = 'cp /archive/%f %p', recovery_target_time = '2024-01-15 10:30:00'. MySQL: XtraBackup full + binlog -> mysqlbinlog replay. PITR = RPO bliskie 0 ( ograniczone tylko WAL/flush frequency). Wymaga: WAL archiving reliability (monitor archive lag), storage dla WAL (retention = RPO window).

Związek z U02 (Sylabus): Kompetencja U02 = planowanie, organizowanie, kontrola procesów. Backup/DR = planning (RTO/RPO targets, strategy), organization (roles, schedule, automation), control (monitoring, testing, verification, alerting). Inżynier SRE = owner procesu backup/DR (nie DBA, nie admin - SRE koordynuje). U02 = odpowiedzialność za to, że "gdy się zepsuje, odzyskamy".

Podsumowanie: Backup bez testowanego restore = nadzieja, nie strategia. Automatyzuj wszystko (schedule, upload, verify, alert). Testuj restore regularnie (monthly critical, quarterly standard). PITR = RPO bliskie 0. Retention = GFS policy. Monitoring = alert na failed + stale + size anomaly. Owner = SRE (koordynuje DBA/admin/cloud). U02 = planuj, organizuj, kontroluj.

Wracamy do fundamentu odzyskiwania, czyli do kopii zapasowych, i od razu postawmy sprawę jasno - kopia, której przywrócenia nie przetestowaliśmy, jest nadzieją, a nie strategią. Dopiero regularny, udokumentowany i zmierzony proces przywracania zamienia pliki na dyskach w realną zdolność odzyskania usługi w zakładanym czasie. Kopia zapasowa jest zarazem elementem ciągłości biznesowej, dlatego cały cykl - planowanie, organizacja, kontrola - musi być świadomie zaplanowany i nadzorowany.

Nowoczesne bazy danych umożliwiają tak zwany point-in-time recovery, czyli odtworzenie stanu z dowolnej chwili dzięki nałożeniu archiwizowanych dzienników WAL na bazowy backup - to sposób na uzyskanie RPO bardzo bliskiego zeru. Niezbędna jest automatyzacja: harmonogramy tworzenia kopii, kompresja, szyfrowanie, retencja w modelu GFS oraz alerty na nieudane zadania. Narzędzia takie jak pgBackRest czy Velero ułatwiają całość, ale cykliczne testy przywracania pozostają obowiązkiem - miesięcznym dla baz krytycznych, kwartalnym dla pozostałych.

Wyjaśnienie skrótów użytych na slajdzie:
WORM – Write Once, Read Many – standard niezmiennego zapisu WORM; Technologia pamięci masowej chroniąca kopie zapasowe przed zaszyfrowaniem przez oprogramowanie ransomware.
SAN – Storage Area Network – dedykowana sieć pamięci masowej; Wysokowydajna infrastruktura blokowa łącząca macierze dyskowe z serwerami w klastrze HA.
NAS – Network Attached Storage – sieciowa pamięć masowa; Pamięć plikowa udostępniająca zasoby dyskowe przez protokoły NFS lub SMB.
S3 – Simple Storage Service – obiektowa pamięć masowa S3; Chmurowy standard składowania kopii zapasowych charakteryzujący się trwałością na poziomie jedenastu dziewiątek (99.999999999%).
Snapshot – Storage Point-in-time Snapshot – migawka pamięci masowej; Błyskawiczny zapis stanu wolumenu dyskowego stanowiący podstawę nowoczesnych procedur backupu.

31/55 Ciągłość biznesowa (BC)
Ciągłość biznesowa (BCP): BCP (Business Continuity Planning) obejmuje IT DR, ciągłość pracy, ludzi, łańcucha dostaw, komunikację kryzysową. BIA = priorytetyzacja recovery.

Ciągłość to nie tylko IT: ludzie, łańcuch dostaw i klienci też muszą przetrwać kryzys. Plan ma żyć.

  • Ciągłość działania (BCP) – plan ciągłości biznesowej obejmuje procedury organizacyjne, kadrowe i techniczne na czas głębokiego kryzysu.
  • Alternatywne kanały pracy – plan wyznacza zapasowe biura, procedury pracy zdalnej oraz awaryjne kanały komunikacji dla pracowników.
  • Role kryzysowe – precyzyjny podział obowiązków zapobiega chaosowi decyzyjnemu i pozwala na metodyczne ratowanie przedsiębiorstwa.
  • Analiza wpływu BIA – identyfikuje procesy biznesowe o krytycznym znaczeniu dla przetrwania firmy oraz określa priorytety ich przywracania.
  • Szkolenia personelu – regularne ćwiczenia symulacyjne budują w pracownikach opanowanie i pewność działania w obliczu realnej katastrofy.
BIA (Business Impact Analysis): Analiza wpływu na biznes priorytetyzująca odtwarzanie; BCP obejmuje IT DR, ludzi, łańcuch dostaw i komunikację kryzysową.
cykl BC

Norma PN-EN ISO 22301 definiuje ścisłe relacje między czasem przywrócenia sprawności (RTO), dopuszczalną utratą danych (RPO) a maksymalnym okresem zakłócenia (MTPD).

Ciągłość Biznesowa (Business Continuity Planning, BCP) to kompleksowa strategia minimalizacji skutków awarii dla organizacji - szersza niż tylko IT/DR: minimalizacja skutków (redundancja IT, failover, DR, ale też alternatywne miejsca pracy, komunikacja kryzysowa, łańcuch dostaw, kluczowi pracownicy), analiza ryzyka (Risk Assessment - zagrożenia, prawdopodobieństwo, wpływ; Business Impact Analysis/BIA - krytyczne procesy biznesowe, RTO/RPO per proces, zależności) i planowanie ciągłości (BCP document: strategie, role, procedury, testy, szkolenia). IT DR to podzbiór BCP, a kluczowe metryki to MTPD, RTO i RPO.

Minimalizacja skutków awarii: IT Redundancy (HA, DR, multi-AZ/region) to fundament, ale BCP idzie dalej: Workplace continuity (alternatywne biura, remote work capability, laptop pool, VPN capacity), People continuity (cross-training, succession planning dla kluczowych ról, on-call rotation, wellness), Supply chain continuity (alternatywni dostawcy, safety stock, SLA z vendorami), Communication plan (intern: Slack/Email/Phone tree, extern: customers/partners/regulators/media, status page), Crisis management (Incident Command System, War Room, decision authority, escalation paths).

Analiza ryzyka (Risk Assessment) i BIA: Risk Assessment: identyfikuj zagrożenia (naturalne: powódź, pożar; techniczne: awaria sprzętu, ransomware, cloud outage; ludzkie: pandemija, strajk, insider threat), oceniaj: likelihood (prawdopodobieństwo) * impact (wpływ) = risk score. BIA (Business Impact Analysis): dla każdego krytycznego procesu biznesowego (np. procesowanie płatności, zamówienia, customer support) ustal: MTPD (Maximum Tolerable Period of Disruption) = max downtime przed nieodwracalną szkodą, RTO/RPO per proces, zależności (upstream/downstream systems, ludzie, dane), resource requirements (minimum staff, systems, data). Wynik BIA = priorytetyzacja recovery (co odzyskujemy pierwsze).

Planowanie ciągłości (BCP Document): Strategie recovery (workaround, manual processes, degraded mode), Role i odpowiedzialności (Crisis Management Team, IT Recovery Team, Business Recovery Team, Communication Officer), Procedury (activation criteria, step-by-step recovery, fallback to manual), Testy i ćwiczenia (tabletop exercise quarterly, functional drill semi-annually, full simulation annually), Szkolenia (wszyscy pracownicy znaą swoje role, on-call training), Maintenance (review BCP co 6 miesięcy, po każdym incydencie, po zmianach org/tech). BCP = living document, nie PDF w szufladzie.

Podsumowanie: BCP > DR > HA. HA = component failure (IT). DR = site failure (IT). BCP = organization survival (Business). BIA = priorytetyzacja (co ratujemy pierwsze). Risk Assessment = awareness (co nas zagraża). Testing = mandatory (tabletop -> functional -> full). Owner = Business (IT = enabler). Resilience = kultura, nie tylko technologia.

Cofnijmy się o krok i spójrzmy na wysoką dostępność z perspektywy całej organizacji, nie tylko warstwy IT. Ciągłość biznesowa obejmuje znacznie więcej niż systemy informatyczne - także zdolność ludzi do pracy, wydolność łańcucha dostaw i komunikację z klientami podczas kryzysu. Odzyskiwanie po awarii to istotny, ale zaledwie jeden z elementów tej układanki, a o tym szerszym obrazie łatwo zapomnieć, kiedy myśli się wyłącznie o serwerach i bazach danych.

Punktem wyjścia jest analiza wpływu na biznes, która identyfikuje procesy krytyczne, ich wzajemne zależności i maksymalny tolerowalny czas przerwy, a każdej usłudze przypisuje własne RTO i RPO - to ona ustala priorytety odzyskiwania. Całość trafia do planu ciągłości (BCP), który - co podkreślam - musi być dokumentem żywym: regularnie przeglądanym, aktualizowanym i testowanym. Ćwiczenia polegające na rozważaniach stołowych co kwartał i pełnej symulacji raz w roku to warunek, by plan zadziałał w momencie, gdy naprawdę będzie potrzebny.

Wyjaśnienie skrótów użytych na slajdzie:
BCMS – Business Continuity Management System – system zarządzania ciągłością działania; Systemowa struktura zarządzania ryzykiem operacyjnym zgodna z normą ISO 22301.
ISO – International Organization for Standardization – Międzynarodowa Organizacja Normalizacyjna; Światowa federacja opracowująca normy zarządzania kryzysowego.
PKN – Polski Komitet Normalizacyjny – krajowa instytucja normalizacyjna; Organ publikujący oficjalną polską wersję normy PN-EN ISO 22301.
CEO – Chief Executive Officer – dyrektor generalny / prezes zarządu; Osoba ponosząca ostateczną odpowiedzialność prawną za zatwierdzenie planów ciągłości działania.
CFO – Chief Financial Officer – dyrektor finansowy; Członek zarządu odpowiedzialny za budżetowanie nakładów na infrastrukturę wysokiej dostępności.

32/55 Studium: serializowanie usługi za LB
Studium: serializowanie usługi za load balancerem: Kompletny case study łączący Nginx na froncie, HAProxy jako backend load balancer, bazę PostgreSQL z zarządzaniem wysokiej dostępności przez Patroni oraz etcd do utrzymania spójności klastra - ćwiczenie obejmuje wdrożenie, testy failoveru, eksperyment chaosu i pomiar czasów RTO i RPO.

Laboratorium spina wszystko: Nginx z przodu, HAProxy w środku, Postgres z Patroni z tyłu. Potem psujemy i mierzymy.

  • Zarządzanie stanem sesji – aplikacje stanowe przechowujące dane w lokalnej pamięci serwera utrudniają równomierne balansowanie ruchu.
  • Przeniesienie do Redis – zapisywanie sesji użytkowników w zewnętrznym klastrze pamięci podręcznej czyni backendy w pełni wymiennymi.
  • Bezstanowe tokeny JWT – kryptograficzne tokeny przesyłane w nagłówkach żądań eliminują konieczność odpytywania bazy o stan sesji.
  • Płynne przełączanie – bezstanowa architektura gwarantuje, że awaria dowolnej maszyny jest całkowicie niezauważalna dla zalogowanych klientów.
  • Ułatwione skalowanie – serwery bezstanowe można błyskawicznie powielać i wyłączać w zależności od dobowych wahań ruchu w serwisie.
Patroni: Zarządca wysokiej dostępności PostgreSQL; z Nginx na froncie, HAProxy w backendzie i etcd dla spójności - ćwiczenie z failoverem, chaosem i pomiarem RTO/RPO.
schemat

Studium przypadku end-to-end HA architecture - serializowanie usługi za Load Balancerem - łączy load balancer na froncie (Nginx frontend: SSL termination, caching, rate limiting → HAProxy backend: L7 routing, active HC, stick tables), bazę danych z replikacją (PostgreSQL + Patroni + etcd: master-slave, automated failover, synchronous replication dla RPO=0) i praktyczny przypadek z zajęć (deployment, failover test, chaos experiment) - to kompletna architektura HA gotowa do przećwiczenia w hands-on lab.

Load Balancer na froncie (Nginx + HAProxy): Nginx (port 80/443) -> SSL termination (Let's Encrypt/cert-manager), caching (proxy_cache, stale-while-revalidate), rate limiting (limit_req_zone), WAF (ModSecurity), static files. HAProxy (port 8080/8443) <- Nginx proxy_pass -> L7 routing (ACL: path_beg /api -> api_backend, path_beg /admin -> admin_backend), active health checks (option httpchk /health, inter 5s rise 2 fall 3), stick tables (persistence + rate limiting), metryki (haproxy_exporter -> Prometheus -> Grafana -> alerting). VIP (keepalived/VRRP) na Nginx HA parze.

Baza z replikacją (PostgreSQL + Patroni): 3 node'y PostgreSQL (AZ1, AZ2, AZ3) + 3 node'y etcd (quorum). Patroni (Python daemon) zarządza: leader election (etcd Raft), replication (streaming, synchronous_mode=true -> RPO=0), failover (automatyczny promote nowego leader, demote starego), timeline management. Klient (aplikacja/HAProxy) łączy się via Patroni REST API (endpoint /leader) lub VIP (keepalived na PG node'ach). Connection pooling (PgBouncer) przed Patroni. Backup: pgBackRest (full/incr, S3, PITR).

Praktyczny przypadek (Hands-on Lab): 1) Deploy: docker-compose up / kubernetes apply (Nginx, HAProxy, Patroni, etcd, App). 2) Baseline test: wrk/hey load test, metrics baseline. 3) Failover test: kill primary PG -> observe Patroni elect new leader (etcd), HAProxy detect via HC (fall 3 * 5s = 15s), traffic switch -> measure actual RTO. 4) Chaos experiment: network partition (tc qdisc netem loss 50%) -> observe split-brain prevention (etcd quorum, Patroni demote). 5) Recovery: restart killed node -> Patroni rejoin as replica -> catchup -> verify data consistency. 6) Document: actual RTO/RPO, lessons learned, runbook update.

Kluczowe wnioski: End-to-end HA = LB (Nginx+HAProxy) + App (stateless, k8s Deployment) + Data (Patroni+etcd sync) + Observability (Prometheus+Grafana+Alerting) + Automation (IaC, GitOps) + Testing (failover drills, chaos). Każdy komponent redundantny, testowany, monitorowany. To nie "setup raz" - to ciągły proces.

Podsumowanie: Case study = teoria w praktyce. Nginx (frontend) + HAProxy (backend LB) + Patroni (PG HA) + etcd (consensus) = production-grade stack. Hands-on = musisz to przećwiczyć (kill, observe, measure, document). Failover test = mandatory monthly. Chaos engineering = proactive validation. Runbook = codified knowledge.

Czas połączyć poznane elementy w jedną, kompletną architekturę, którą przećwiczymy na zajęciach laboratoryjnych. Studium pokazuje, jak Nginx na froncie, HAProxy za nim oraz baza PostgreSQL, której wysoką dostępnością zarządza Patroni, współpracują w spójnym układzie o wysokiej dostępności. Konfiguracja zaczyna się od usługi bezstanowej wystawionej przez load balancery, a kończy na warstwie danych, gdzie etcd pilnuje wyboru lidera i spójności klastra - każda z tych warstw pozostaje niezależnie redundantna i monitorowana.

Najwięcej uczą konkretne eksperymenty: najpierw wdrażamy stack i mierzymy linię bazową, następnie zabijamy głównego noda i obserwujemy, jak Patroni wybiera nowego lidera, a HAProxy po wykryciu awarii przekierowuje ruch - przy okazji mierzymy realne RTO. Wstrzykujemy też partycję sieciową, by sprawdzić ochronę przed split-brain, a po odtworzeniu węzła weryfikujemy spójność danych i aktualizujemy runbook. To zamyka pełny cykl pracy inżyniera: deploy, test, pomiar, dokumentacja.

Wyjaśnienie skrótów użytych na slajdzie:
ACID – Atomicity, Consistency, Isolation, Durability – kwasowość transakcji bazodanowych; Zbiór czterech fundamentalnych reguł gwarantujących spójność danych w relacyjnych bazach SQL.
SQL – Structured Query Language – strukturalny język zapytań; Standardowy język operacji na relacyjnych bazach danych; klastry SQL wymagają synchronizacji węzłów.
DB – Database Server – serwer bazy danych; Komponent stanowy systemu, którego replikacja za load balancerem wymaga ścisłego podziału na odczyty i zapisy.
Redis – Remote Dictionary Server – baza klucz-wartość Redis; Wysokowydajna pamięć w RAM wykorzystywana do przechowywania sesji użytkowników poza serwerem aplikacji.
Session – User HTTP Session State – stan sesji użytkownika; Dane tymczasowe logowania klienta; ich zewnętrzna persystencja umożliwia pełną bezstanowość serwerów (Stateless).

33/55 Monitorowanie HA
Monitorowanie HA: Observability HA = haproxy_exporter, nginx_exporter, patroni_exporter. Kluczowe metryki: server_up, failover_count, replication_lag, vip_state.

HA bez metryk to ślepota: balancer, VIP, repliki i failover musisz mierzyć jak aplikację.

  • Nadzór nad klastrem HA – monitoring musi nieustannie badać stan poszczególnych węzłów, status adresu VIP oraz łącza transmisyjne.
  • Alert o utracie redundancji – awaria maszyny głównej i przejęcie roli przez zapas wymaga natychmiastowego powiadomienia dyżurnego.
  • Monitorowanie opóźnień sond – wzrost czasu odpowiedzi na testy zdrowia pozwala wykryć degradację zanim serwer ulegnie zawieszeniu.
  • Obserwacja tablic routingu – weryfikacja poprawności rozgłoszeń sieciowych zapobiega powstawaniu zjawiska czarnych dziur w ruchu.
  • Pulpity wysokiej dostępności – ekrany w centrum operacyjnym powinny wyraźnie sygnalizować aktualną topologię i sprawność klastra.
replication_lag: Opóźnienie repliki wobec primary; obok server_up, failover_count i vip_state - kluczowe metryki obserwowalności HA.
monitoring HA

Monitorowanie HA to observability dla komponentów redundancji - Load Balancer, VIP, Failover, Replication, nie ogólne monitorowanie aplikacji: dostępność LB (uptime, health checks, active connections, backend status), logi LB (access/error: latency, error rate, backend response codes, VIP failover events) i eksport do Prometheus (haproxy_exporter, nginx_exporter, keepalived_exporter, patroni_exporter - server_up, failover_count, replication_lag, vip_status). Alerting rules obejmują backend_down, vip_flip, replication_lag_high i split_brain_detected.

Dostępność Load Balancera (LB Uptime + Health): Metryki: haproxy_frontend_current_sessions / nginx_connections_active (obecne połączenia), haproxy_backend_http_responses_total{status=~"5.."} rate (5xx rate), haproxy_server_up (1=UP, 0=DOWN), haproxy_server_check_status (L7OK/L4OK/L4TOUT/...), keepalived_vrrp_state (MASTER/BACKUP/FAULT). Alerty: haproxy_server_up == 0 FOR 1m (backend down), haproxy_backend_http_responses_total{status=~"5.."} rate > 0.05 (5% 5xx), keepalived_vrrp_state != "MASTER" (VIP flip). Dashboard: per backend status (UP/DOWN), sessions, latency p99, error rate, HC status.

Logi Load Balancera (Access/Error Logs): Nginx access_log (JSON: $request_time, $upstream_response_time, $upstream_addr, $upstream_status, $request_id, $trace_id) -> Loki -> query: {job="nginx"} | json | upstream_status >= 500. HAProxy log (format: %ci:%cp [%tr] %ft %b/%s %TR/%Tw/%Tc/%Tr/%Ta %ST %B %CC %CS %tsc %ac/%fc/%bc/%sc/%rc %sq/%bq %{+Q}r) -> Loki -> parse. Kluczowe pola: backend server (co trafiło), response time (latency), status code (errors), VIP failover events (grep "VRRP" / "State transition"). Logi = debugging context gdy metryki pokazują problem.

Łączenie z Prometheus (Exporters): haproxy_exporter (scrape stats socket -> 200+ metryk), nginx_exporter (scrape stub_status / vts / plus api), keepalived_exporter (VRRP state, VIP transitions), patroni_exporter (Patroni cluster state: leader, replicas, replication_lag, timeline), node_exporter (host metrics: CPU, mem, disk, net - foundation). ServiceMonitor/PodMonitor dla Prometheus Operator. Recording rules dla heavy queries (replication_lag_seconds, failover_count_total). Alerting rules: replication_lag > 60s, failover_count increase, vip_transition, split_brain (patroni_cluster_members < expected).

Korelacja Metrics-Logs-Traces dla HA: Metryka (haproxy_server_up=0) -> klik -> Logi (Loki: backend errors w tym czasie) -> Trace (Tempo: request flow do backendu) -> Root cause. Shared time range + variables ($backend, $vip) = unified troubleshooting. To "killer feature" Grafana stack dla HA.

Podsumowanie: Monitoruj HA infrastructure (LB, VIP, Replication, Failover), nie tylko aplikację. Exporters: haproxy_exporter, nginx_exporter, keepalived_exporter, patroni_exporter. Metryki: server_up, failover_count, replication_lag, vip_state. Logi: access/error w Loki, korelacja z metrykami. Alerty: backend_down, vip_flip, replication_lag, split_brain. Testuj alerty (kill backend -> alert fire). HA observability = peace of mind dla on-call.

Złożona infrastruktura wysokiej dostępności byłaby ślepa bez dedykowanego monitorowania, dlatego na zakończenie przyglądamy się obserwowalności samych mechanizmów HA. Load balancer, wirtualne IP, replikacja i failover to elementy, których nie obsłużymy wyłącznie metrykami aplikacji - potrzebne są dane o stanie konkretnych komponentów redundancji. Dopiero wtedy awaria staje się widoczna na długo przed tym, zanim użytkownik odczuje jej skutki.

Służą do tego eksportery: haproxy_exporter pokazuje stan backendów i bieżące połączenia, nginx_exporter odczytuje status wbudowanego modułu statystyk, a patroni_exporter raportuje lidera, repliki i opóźnienie replikacji. Z tych metryk budujemy alerty na niedostępny backend, nadmierny dryf replikacji, nieoczekiwaną zmianę wirtualnego IP i podejrzenie split-braina. Największą wartość daje jednak korelacja metryk, logów i śladów w jednym interfejsie, która skraca diagnostykę incydentu z godzin do minut.

Wyjaśnienie skrótów użytych na slajdzie:
Prometheus – Prometheus monitoring system – system monitoringu Prometheus; Standardowe narzędzie zbierające metryki dostępności i czasu odpowiedzi klastra HA.
Grafana – Grafana visualization tool – platforma analityczna Grafana; Konsola prezentująca stan pracy load balancerów, węzłów zaplecza i wirtualnych adresów IP.
SNMP – Simple Network Management Protocol – protokół zarządzania siecią; Protokół wykorzystywany do monitorowania stanu zasilaczy UPS i interfejsów przełączników.
Alertmanager – Alertmanager routing daemon – menedżer alertów; Usługa natychmiast powiadamiająca zespół o awarii jednego z węzłów w klastrze redundantnym.
Ping – ICMP Echo Ping utility – narzędzie diagnostyczne ping; Niskopoziomowy test weryfikacji osiągalności bramy domyślnej i węzłów zapasowych.

34/55 Testowanie odporności
Testowanie odporności: Chaos Engineering = naukowe wstrzykiwanie awarii w kontrolowanym środowisku. Zasady: steady state hypothesis, blast radius control, automate, verify. Narzędzia: Chaos Mesh, Litmus, Gremlin.

Nie czekaj na produkcyjną awarię, żeby sprawdzić HA. Wstrzyknij ją sam - naukowo, z hipotezą i limitem szkód.

  • Weryfikacja założeń – testowanie odporności polega na sprawdzaniu, czy system faktycznie reaguje na awarie zgodnie z projektem.
  • Odłączanie zasilania – fizyczne wyłączanie serwerów podczas kontrolowanych testów weryfikuje sprawność procedur przełączania awaryjnego.
  • Symulacja utraty łączności – wprowadzanie sztucznych przerw w sieci pozwala przetestować reakcję klastra na groźbę zjawiska Split-Brain.
  • Testy obciążeniowe – badanie zachowania platformy na granicy wydajności pozwala dobrać właściwe limity dla mechanizmów ochronnych.
  • Budowanie pewności – udowodnienie odporności architektury w bezpiecznych warunkach daje zespołowi spokój podczas dyżurów nocnych.
Blast radius control: Ograniczanie promienia rażenia eksperymentu; z hipotezą stanu ustalonego, automatyzacją i weryfikacją (Chaos Mesh, Litmus, Gremlin).
chaos

Testowanie odporności (resilience testing) zamiast czekać na awarię w produkcji celowo wstrzykuje awarie w kontrolowanym środowisku, by zweryfikować, czy system radzi sobie - to fundament chaos engineering. Dyscyplina opiera się na principles of chaos (steady state hypothesis, experiment design, blast radius control, automation), narzędziach (Chaos Mesh - Kubernetes-native, Litmus - CNCF, Gremlin - SaaS/enterprise, Pumba - Docker, Chaos Monkey - Netflix OSS) i bezpiecznych eksperymentach (blast radius limitation, rollback plan, monitoring steady state, game day).

Chaos Engineering - Principles of Chaos (Netflix/PrinciplesOfChaos.org): 1) Define Steady State (métrICS: latency p99 < 200ms, error rate < 0.1%, throughput > 1000 rps) - to baza porównawcza. 2) Hypothesis (Steady State will continue) - "system wytrzyma awarię X". 3) Experiment (inject failure) - wyłącz pod, dodaj latency, zabij node, partition network. 4) Verify (compare steady state) - metryki wracają do baseline? 5) Blast Radius Control - zaczynaj małą (1 pod, 1% traffic), stopniowo zwiększaj. 6) Automate (CI/CD integration) - chaos experiments w pipeline (pre-deploy, nightly). 7) Minimize Blast Radius - feature flags, canary, namespace isolation.

Narzędzia: Chaos Mesh (CNCF, Kubernetes-native, CRDs: PodChaos, NetworkChaos, IOChaos, TimeChaos, KernelChaos, DNSChaos, HTTPChaos - workflow, schedule, cron, integracja z Prometheus/Grafana). Litmus (CNCF, Kubernetes, chaos experiments jako CRD: pod-delete, container-kill, network-latency, disk-fill, node-drain - chaos centers, workflows). Gremlin (SaaS, enterprise, agent-based, bez K8s, "Failure as a Service", compliance reports, game day support). Pumba (Docker, standalone: pause, kill, rm, net_em - latency/loss/duplication/corruption). Chaos Monkey (Netflix OSS, Spinnaker integration, random instance termination w ASG). Wybór: K8s -> Chaos Mesh/Litmus; VM/bare metal -> Gremlin/Pumba; AWS ASG -> Chaos Monkey.

Bezpieczne eksperymenty (Safety First): Blast Radius Limitation - zaczynaj w dev/staging, potem canary (1% prod), potem full. Namespace/label selectors (tylko app=non-critical). Feature flags (kill switch). Rollback Plan - każdy eksperyment ma: "jeśli X -> sofort rollback/stop". Monitoring - real-time dashboard (steady state metrics), alerting (jeśli error rate > threshold -> auto-stop). Game Day - zaplanowany dzień z zespołem (devs, SRE, QA, PM), runbook eksperymentu, retrospectiva, dokumentacja lessons learned. Cultura: "Failure injection is normal, not scary". Post-mortem eksperymentu = ciągłe doskonalenie.

Przykład eksperymentu (Chaos Mesh PodChaos): apiVersion: chaos-mesh.org/v1alpha1; kind: PodChaos; metadata: name: kill-api-pod; spec: action: pod-failure; mode: one; selector: namespaces: [production]; labelSelectors: {app: api}; duration: '30s'; scheduler: cron: '@hourly'. Effect: co godzinę losowo zabija 1 pod api w production przez 30s. Expected: HAProxy HC detect (fall 3 * 5s = 15s) -> traffic do pozostałych -> HPA scale up -> steady state restored. Metrics watch: error rate, latency p99, throughput.

Podsumowanie: Inżynieria chaosu (Chaos Engineering) to nauka na kontrolowanych awariach, zanim wystąpią one samoistnie na środowisku produkcyjnym. Principles: steady state, hypothesis, experiment, verify, blast radius control, automate. Narzędzia: Chaos Mesh (K8s), Litmus (K8s), Gremlin (universal), Pumba (Docker). Safety: blast radius limitation, rollback plan, monitoring, game day. Cultura: eksperymentuj często, ucz się szybko, automatyzuj. "Hope is not a strategy - testing is".

Dotychczas rozmawialiśmy o budowie redundantnych systemów, monitorowaniu i failoverze - wszystko po to, by awaria nie dotknęła użytkownika. Ale jak sprawdzić, czy te mechanizmy naprawdę działają? Tego nie dowiemy się, czekając na produkcyjną awarię. Chaos Engineering to podejście, które pozwala nam naukowo weryfikować odporność systemów, celowo wstrzykując awarie w kontrolowanych warunkach. Zamiast obawiać się przestojów, uczymy się na nich zanim w ogóle nastąpią.

Dyscyplina ta opiera się na kilku kluczowych zasadach: zdefiniowaniu steady state, czyli baseline'u normalnego działania, sformułowaniu hipotezy, że system wytrzyma wstrzykniętą awarię, oraz przeprowadzeniu eksperymentu z kontrolą zasięgu jego skutków. Narzędzia takie jak Chaos Mesh, Litmus, Gremlin czy Pumba pozwalają zautomatyzować te procesy, a regularne eksperymenty - najlepiej w formie zaplanowanych Game Days - budują kulturę odporności w zespole. To nie łamanie systemów, lecz naukowa inżynieria niezawodności.

Wyjaśnienie skrótów użytych na slajdzie:
GameDay – SRE GameDay Exercise – ćwiczenia awaryjne GameDay; Zorganizowane symulacje awarii weryfikujące poprawność procedur operacyjnych zespołu SRE.
Chaos – Chaos Engineering Practices – praktyki inżynierii chaosu; Metodologia proaktywnego testowania odporności systemów produkcyjnych na niespodziewane awarie.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina techniczna, której inżynierowie przeprowadzają regularne testy przełączania awaryjnego.
Post-mortem – Blameless Post-mortem – analiza poawaryjna bez obwiniania; Raport sporządzany po przeprowadzonych testach odporności dokumentujący wykryte luki w architekturze.
QA – Quality Assurance – zapewnienie jakości oprogramowania; Dział testowania weryfikujący zachowanie aplikacji w warunkach degradacji infrastruktury.

35/55 Wprowadzenie do chaos engineering
Wprowadzenie do chaos engineering: Chaos Engineering = naukowy eksperyment z hipotezą i pomiarem. Steady state hypothesis = baza porównawcza. Safety: blast radius limitation, rollback plan, monitoring, game day.

Chaos to dyscyplina: hipoteza, pomiar i bezpieczeństwo. Bez bazy porównawczej eksperyment to wandalizm.

  • Inżynieria chaosu – dyscyplina polegająca na kontrolowanym wstrzykiwaniu awarii do środowiska w celu odkrycia ukrytych słabości systemu.
  • Narzędzie Chaos Monkey – stworzony przez firmę Netflix program losowo wyłącza działające kontenery produkcyjne w godzinach pracy.
  • Hipoteza stanu ustalonego – każdy eksperyment chaosu definiuje oczekiwane zachowanie metryk biznesowych w trakcie trwania usterki.
  • Ograniczony promień rażenia – próby rozpoczyna się na minimalnym odsetku ruchu, posiadając przygotowany wyłącznik bezpieczeństwa.
  • Kultura odporności – inżynieria chaosu przekształca strach przed awarią w metodyczną praktykę ciągłego uodparniania architektury.
Game day: Zaplanowany dzień ćwiczeń awaryjnych; z ograniczeniem zasięgu, planem rollbacku i monitoringiem - bezpieczna praktyka chaos engineeringu.
chaos test

Inżynieria chaosu nie polega na bezładnym psuciu środowiska, lecz na systematycznym testowaniu hipotez o stanie stabilnym systemu. Za pomocą otwartej platformy Chaos Mesh zespoły SRE wstrzykują w sposób kontrolowany zakłócenia sieciowe (utrata pakietów, jitter, sztuczne opóźnienia), awarie zasobów (zrzucanie procesów podów, nasycenie pamięci RAM) oraz awarie jądra, weryfikując czy load balancer i mechanizmy failover reagują w zakładanym czasie bez degradacji wskaźników SLI.

Chaos Engineering to dyscyplina inżynierii odporności: systematyczne wstrzykiwanie awarii w systemy produkcyjne (lub staging), by zweryfikować, czy potrafią same się naprawić i utrzymać steady state - to naukowy eksperyment z hipotezą, pomiarem i wnioskowaniem, nie łamanie systemów. Zasady to steady state hypothesis, experiment design, blast radius control i automation; narzędzia to Chaos Mesh (K8s-native CRDs), Litmus (CNCF chaos center), Gremlin (enterprise SaaS), Pumba (Docker) i Chaos Monkey (Netflix); bezpieczne eksperymenty to blast radius limitation (namespace/label selectors, feature flags, canary), rollback plan (auto-stop na threshold), monitoring (real-time steady state dashboard) i game day.

Steady State Hypothesis (Baza porównawcza): Zdefiniuj "normalne" działanie systemu przez metryki: latency p99 < 200ms, error rate < 0.1%, throughput > 1000 rps, saturation < 70%. To nie "wszystko działa" - to konkretne, mierzalne wskaźniki (SLI/SLO). Hipoteza: "System utrzyma steady state mimo awarii X". Jeśli eksperyment naruszy steady state -> system NIE jest odporny na tę awarię -> action item (fix HA, improve HC, add capacity).

Narzędzia Chaos Engineering: Chaos Mesh (CNCF incubating, K8s-native, CRDs: PodChaos, NetworkChaos, IOChaos, TimeChaos, KernelChaos, DNSChaos, HTTPChaos, StressChaos; Workflow/Schedule/Cron dla sekwencji; Dashboard + Prometheus integracja; multi-cluster). Litmus (CNCF, ChaosCenter UI, ChaosHub - gotowe eksperymenty: pod-delete, container-kill, network-latency, disk-fill, node-drain, kubelet-restart; Workflow engine, GitOps friendly). Gremlin (Enterprise SaaS, agent-based, nie wymaga K8s, "Failure as a Service", compliance: SOC2/HIPAA/PCI, Game Day support, blast radius controls). Pumba (Docker standalone, pause/kill/rm/net_em - latency/loss/corruption/duplication, prosty, single-host). Chaos Monkey (Netflix OSS, Spinnaker, random instance termination w ASG, AWS-only). Wybór zależy od platformy i dojrzałości zespołu.

Bezpieczne eksperymenty (Safety Engineering): Blast Radius Limitation - zawsze ograniczaj: namespace (dev/staging), label selector (app=non-critical, tier!=database), percentage (mode: fixed-percent, percent: 10), time limit (duration: 30s). Feature Flags / Kill Switches - aplikacja ma flagę "chaos_enabled", jeśli false -> eksperyment nie działa. Canary Deployment - eksperyment na 1% traffic, potem 5%, potem 100%. Rollback Plan - każdy eksperyment ma: auto-stop condition (error_rate > 1% LUB latency_p99 > 500ms), manual kill switch (Slack bot / API), post-experiment validation (steady state restored?). Monitoring - real-time dashboard (Grafana: steady state metrics + experiment annotations), alerting (jeśli steady state broken -> alert -> auto-stop). Game Day - zaplanowany event z zespołem: runbook eksperymentu, role (driver, observer, scribe), retrospectiva (what happened, what we learned, action items).

Przykład eksperymentu (Chaos Mesh NetworkChaos - latency injection): apiVersion: chaos-mesh.org/v1alpha1; kind: NetworkChaos; metadata: name: api-latency-100ms; spec: action: delay; mode: one; selector: namespaces: [staging]; labelSelectors: {app: api}; delay: latency: '100ms'; correlation: '25'; duration: '60s'. Effect: co uruchomienie dodaje 100ms latency do losowego poda api w staging na 60s. Hypothesis: "HPA skaluje repliki, error rate < 1%, latency p99 < 500ms". Verify: Grafana dashboard watch. Lessons learned: HPA za wolny? Dodaj predictive scaling. HC za wolny? Zmniejsz inter/fall.

Podsumowanie: Chaos Engineering = nauka na kontrolowanych awariach. Principles: steady state hypothesis, experiment, blast radius control, automation, minimize impact. Narzędzia: Chaos Mesh (K8s), Litmus (K8s), Gremlin (universal), Pumba (Docker). Safety: namespace/label/percentage limits, feature flags, rollback plan, monitoring, game day. Cultura: "Failure injection is normal practice". Eksperymentuj -> Ucz się -> Popraw -> Automatyzuj.

Chaos Engineering to nie tylko koncepcja - to dyscyplina wymagająca naukowego podejścia z hipotezą i pomiarem. Zanim wstrzykniemy jakąkolwiek awarię, musimy ustalić bazę porównawczą: jakie metryki definiują normalne działanie naszego systemu i jaki poziom degradacji jest akceptowalny. Bez tego eksperyment staje się chaotycznym łamaniem, a nie kontrolowaną nauką o odporności.

Kluczowe jest też bezpieczeństwo samego eksperymentu - ograniczanie zasięgu wpływu przez selektory namespace i etykiet, posiadanie planu wycofania oraz bieżące monitorowanie steady state w czasie rzeczywistym. Praktyka pokazuje, że najlepsze rezultaty daje regularność: cykliczne eksperymenty uruchamiane w pipeline'ach CI/CD budują nawyk testowania odporności. Narzędzia takie jak Chaos Mesh dostarczają CRDs definiujące eksperymenty jako kod K8s, co ułatwia ich powtarzalność i wersjonowanie.

Wyjaśnienie skrótów użytych na slajdzie:
Chaos – Chaos Engineering Principles – zasady inżynierii chaosu; Rygorystyczna dyscyplina empirycznego testowania systemów rozproszonych.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Praktycy wykorzystujący inżynierię chaosu do budowania zaufania do stabilności produkcyjnej.
blast-radius – Blast Radius in Testing – promień rażenia testu; Ściśle ograniczony zakres wpływu wstrzykiwanej usterki zapobiegający niekontrolowanemu uszkodzeniu produkcji.
hypothesis – Steady-state Hypothesis – hipoteza stanu stabilnego; Formalne założenie testowe sprawdzające, czy wskaźnik SLI pozostanie w normie pomimo awarii komponentu.
prod – Production Environment – środowisko produkcyjne; Docelowe środowisko działania aplikacji, na którym inżynieria chaosu przynosi największą wartość poznawczą.

36/55 Chaos Mesh (skrót)
Chaos Mesh (skrót): Chaos Mesh = K8s-native chaos platform (CNCF). CRDs: PodChaos, NetworkChaos, IOChaos, TimeChaos. Workflow/Schedule = orkiestracja. Integracja: Prometheus, Grafana, RBAC.

Chaos Mesh to chaos dla Kubernetesa: eksperymenty jako zasoby YAML, orkiestracja i harmonogram w pakiecie.

  • Platforma Chaos Mesh – zaawansowane narzędzie dla Kubernetes, pozwalające na programistyczne definiowanie scenariuszy awaryjnych.
  • Symulacja anomalii sieciowych – wstrzykiwanie opóźnień, gubienia pakietów oraz rozdzielenia sieci pozwala sprawdzić odporność aplikacji.
  • Zabijanie procesów podów – narzędzie automatycznie restartuje wybrane kontenery, weryfikując sprawność procedur samoleczenia klastra.
  • Awarie wejścia-wyjścia – symulacja błędów odczytu z dysku sprawdza, jak baza danych radzi sobie z degradacją pamięci masowej.
  • Integracja z potokami CI – automatyczne uruchamianie testów chaosu przed publikacją kodu zapobiega wdrażaniu kruchych rozwiązań.
CRD chaosu: PodChaos, NetworkChaos, IOChaos, TimeChaos jako zasoby Kubernetesa; Workflow/Schedule orkiestrują eksperymenty z integracją Prometheus-Grafana.
Chaos Mesh

Platforma Chaos Mesh pozwala automatyzować eksperymenty odpornościowe bezpośrednio w klastrze Kubernetes.

Chaos Mesh to Kubernetes-native platforma Chaos Engineering (CNCF Incubating project) z typami wstrzykiwanych awarii: PodChaos (pod-failure/pod-kill/container-kill), NetworkChaos (delay/loss/duplicate/corrupt/partition), IOChaos (latency/attrition/read/write error), DNSChaos (error/random), TimeChaos (time offset), KernelChaos (kernel panic), HTTPChaos (abort/delay/replace) i StressChaos (cpu/mem/io). Scenariusze definiują Workflow (sekwencja eksperymentów), Schedule (cron-like recurring) i Cron; integracja z K8s idzie przez CRDs, Operators, Webhook validation, RBAC i chaos daemon.

Typy Chaos Experiments (CRDs): PodChaos - akcje: pod-failure (kill pod, K8s recreates), pod-kill (kill pod, no recreate - test orphaned resources), container-kill (kill specific container w podzie - test sidecar failure). NetworkChaos - delay (latency: 100ms, correlation 25%, jitter), loss (packet loss: 10%), duplicate (duplication), corrupt (bit flip), partition (network split - test split-brain), bandwidth (throttle). IOChaos - latency (fsync latency), attrition (I/O error), read/write error (simulate disk failure). DNSChaos - error (NXDOMAIN/SERVFAIL), random (random IP). TimeChaos - time offset (clock drift - test time-sensitive logic). KernelChaos - kernel panic (test node reboot behavior). HTTPChaos - abort (connection reset), delay (response delay), replace (modify response body/status). StressChaos - cpu stress (burn), mem stress (oom), io stress (disk pressure).

Scenariusze i Orkiestracja: Workflow (kind: Workflow) - sekwencja kroków (serial/parallel), zależności (dependsOn), parametry (entry), warunki (conditional branching), powiadomienia (webhook/email). Schedule (kind: Schedule) - cron-like recurring workflow (schedule: "0 * * * *" - co godzinę). Cron (kind: Cron) - pojedynczy eksperyment cron. Przykład Workflow: 1) PodChaos kill api (30s) -> 2) wait 60s -> 3) NetworkChaos delay api (100ms, 60s) -> 4) verify steady state (Prometheus query). To pozwala na symulację złożonych scenariuszy awaryjnych (kaskada awarii).

Integracja z Kubernetes: CRDs (Custom Resource Definitions) - eksperymenty jako K8s resources (kubectl apply, gitops). Operators (chaos-controller-manager, chaos-daemon, chaos-dashboard) - reconciliation loop, webhook validation, admission control. RBAC - granularne uprawnienia (kto może tworzyć i wykonywać eksperymenty w poszczególnych przestrzeniach nazw). Multi-cluster - jeden Chaos Mesh dashboard zarządza wieloma klastrami (cluster-scoped CRDs). Integracja: Prometheus (metrics: chaos_mesh_experiment_duration, chaos_mesh_experiment_status), Grafana (dashboard + annotations), Alertmanager (alert na eksperyment), Slack/Teams (notifications). Docs: chaos-mesh.org/docs (verified 2024).

Wdrożenie i Best Practices: Install: helm repo add chaos-mesh https://charts.chaos-mesh.org; helm install chaos-mesh chaos-mesh/chaos-mesh -n chaos-mesh --set chaosDaemon.runtime=containerd --set dashboard.create=true. Namespace isolation: chaos experiments tylko w dedykowanych namespace (chaos-testing, staging), production -> require approval (RBAC + workflow approval gate). Start small: dev -> staging -> canary prod. Documentation: chaos-mesh.org/docs (v2.6+ verified).

Podsumowanie: Chaos Mesh = K8s-native chaos engineering platform. CRDs = eksperymenty jako kod (GitOps). Workflow/Schedule = orkiestracja złożonych scenariuszy. Typy: Pod/Network/IO/DNS/Time/Kernel/HTTP/Stress. Integracja: Prometheus, Grafana, Alertmanager, RBAC, multi-cluster. Docs: chaos-mesh.org. Zawsze: blast radius limitation, RBAC, GitOps, start small (dev/staging).

Chaos Mesh wyróżnia się wśród narzędzi chaos engineeringu podejściem natywnym dla Kubernetes - definiuje eksperymenty jako zasoby K8s za pomocą CRDs, co oznacza, że są wersjonowane, powtarzalne i łatwe do zintegrowania z istniejącymi pipeline'ami GitOps. Platforma ta powstała jako projekt CNCF i oferuje szeroki zestaw typów wstrzykiwanych awarii, od zabijania podów, przez manipulację siecią, po błędy dysku i zegara.

Podstawowe typy eksperymentów to PodChaos, NetworkChaos, IOChaos, TimeChaos, DNSChaos, KernelChaos i HTTPChaos - każdy odwzorowuje inny wymiar potencjalnej awarii w klastrze. Dla złożonych scenariuszy Chaos Mesh udostępnia Workflows, które pozwalają na sekwencyjne lub równoległe uruchamianie eksperymentów z zależnościami, oraz Schedule do cyklicznego powtarzania. Integracja z Prometheus i Grafana zapewnia nadzór nad steady state w trakcie eksperymentu, a RBAC gwarantuje, że dostęp do wstrzykiwania awarii mają tylko upoważnione osoby.

Wyjaśnienie skrótów użytych na slajdzie:
CNCF – Cloud Native Computing Foundation – Fundacja Oprogramowania Chmurowego; Środowisko projektowe, w ramach którego rozwija się platforma Chaos Mesh.
K8s – Kubernetes – platforma orkiestracji Kubernetes; Natywne środowisko uruchomieniowe dla operatorów i zasobów Chaos Mesh.
CRD – Custom Resource Definition – niestandardowa definicja zasobu w Kubernetes; Mechanizm rozszerzający API Kubernetesa o deklaratywne definicje eksperymentów chaosu.
NetworkChaos – Chaos Mesh Network Chaos CRD – zasób zakłóceń sieciowych; Eksperyment wprowadzający sztuczną utratę pakietów, duplikację, opóźnienia i fragmentację pasma.
PodChaos – Chaos Mesh Pod Chaos CRD – zasób awarii podów; Eksperyment testujący reakcję orkiestratora na nagłe zatrzymanie lub zablokowanie procesu w kontenerze.

37/55 Awarie sieci i ich skutki
Awarie sieci i ich skutki: Sieć to klej HA. Degradacja przepustowości = bufferbloat, packet loss, retransmits → cascade failure. Przełączanie: BGP/OSPF, VRRP/HSRP, recursive routing.

Sieć to klej HA: jej pad wygląda jak pad aplikacji. Poznaj degradację, przełączanie i obronę przed kaskadą.

  • Złożoność sieci – awarie łączy światłowodowych, przełączników i protokołów routingu są powszechnym źródłem poważnych incydentów.
  • Zjawisko flappingu portów – ciągłe włączanie i wyłączanie uszkodzonego kabla może sparaliżować tablice routingu w całej sieci.
  • Asymetria routingu – sytuacja, w której pakiety wracają inną trasą niż przyszły, może zablokować ruch na stanowych zaporach ogniowych.
  • Wielodrogowość ECMP – pozwala na równoległe przesyłanie pakietów wieloma trasami, zapewniając redundancję i wyższą przepustowość.
  • Szybka konwergencja – nowoczesne protokoły sieciowe potrafią przeliczyć optymalne trasy w czasie ułamków sekund po awarii łącza.
Bufferbloat: Nadmierne buforowanie powodujące opóźnienia; z utratą pakietów i retransmisjami prowadzi do awarii kaskadowej; przełączanie: BGP/OSPF, VRRP/HSRP.
awaria łącza

Sieć to klej łączący komponenty HA, a jej awaria często manifestuje się jako awaria aplikacji (cascade failure): degradacja przepustowości (bandwidth saturation - queueing delay, packet loss, TCP retransmits, latency spikes), przełączanie na zapas (link failover: recursive routing, check-gateway, Netwatch, BGP/OSPF convergence, VRRP/HSRP failover) i wpływ na aplikacje (TCP timeout, connection reset, service mesh retry storms). To kluczowe zjawiska dla sieci HA.

Degradacja przepustowości (Bandwidth Saturation): Link wypełniony do 100% -> queuing delay (bufferbloat: duże bufory w routerach -> latency spike 100ms->10s), packet loss (tail drop / RED), TCP retransmission (spurious retransmission -> throughput collapse), head-of-line blocking (HTTP/1.1), QUIC/HTTP/3 lepsze ale nie immunitet. Objawy w aplikacji: latency p99 spike, timeout errors, retry storms (thundering herd), cascade failure (service A timeout -> retry -> service B overload). Monitoring: interface utilization (ifHCInOctets/ifHCOutOctets > 80%), queue drops (ifOutDiscards), TCP retransmits (netstat -s / node_exporter: tcp_retransmits), application latency/error rate.

Przełączanie na zapas (Link Failover): Recursive Routing (static route z next-hop check: Cisco IP SLA / MikroTik check-gateway=ping) - route installed tylko jeśli next-hop reachable. Check-gateway (MikroTik: /ip route add check-gateway=ping distance=1/2) - router pinguje gateway, jeśli fail -> route inactive -> backup route (distance=2) aktywny. Netwatch (MikroTik: /tool netwatch add host=8.8.8.8 timeout=5s interval=10s down-script="/ip route set 0 disabled=yes" up-script="/ip route set 0 disabled=no") - monitoring hosta w Internecie, sterowanie routingiem. BGP/OSPF Convergence - dynamic routing protocols: BGP (inter-domain, convergence ~seconds-minutes, path attributes, communities), OSPF (intra-domain, convergence ~milliseconds-seconds, LSA flooding). VRRP/HSRP Failover - L2/L3 redundancy dla gateway (VRRP open standard, HSRP Cisco), VIP failover < 1s (advertisement interval 1s, master_down_interval 3s).

Wpływ na aplikacje i mitigacja: TCP Timeout/Retransmit -> aplikacja widzi latency/error -> retry (exponential backoff + jitter = must). Connection Reset (RST) -> immediate error -> circuit breaker. Service Mesh (Istio/Linkerd) -> automatic retry, timeout, circuit breaker, fault injection (testowanie). Application-level: idempotency keys (bezpieczne retry), timeouts (connect/read/write), bulkheads (izolacja zasobów), graceful degradation (feature flags off). Network observability: flow logs (VPC flow logs, NetFlow/sFlow), synthetic monitoring (blackbox_exporter: ping, tcp, http, dns), path tracing (mtr, traceroute, paris-traceroute).

Podsumowanie: Sieć = SPOF jeśli nie redundantna. Degradacja = bufferbloat + loss + retransmits = cascade failure. Failover: recursive routing / check-gateway / Netwatch (static), BGP/OSPF (dynamic), VRRP/HSRP (gateway). Monitoring: utilization, drops, retransmits, convergence time. Mitigacja w aplikacji: timeouts, retries (backoff+jitter), idempotency, circuit breaker, service mesh. Network HA = foundation dla wszystkiego.

Sieć jest klejem łączącym wszystkie komponenty high availability, a jej degradacja często objawia się jako awaria aplikacji - użytkownik widzi timeout lub błąd, choć problem leży na warstwie transportu. Aby skutecznie projektować i debugować systemy HA, musimy rozumieć zarówno przyczyny degradacji sieci, jak i mechanizmy przełączania na zapasowe łącza. To wiedza łącząca perspektywę sieciową z perspektywą aplikacyjną.

Gdy przepustowość łącza zostaje wyczerpana, pojawia się bufferbloat - zjawisko powodujące dramatyczny wzrost opóźnień przez przepełnione bufory w routerach. W efekcie pakiety są tracone, TCP uruchamia retransmisje, a te z kolei pogarszają przepustowość w spiralę degradacji. Skuteczną obroną przed takimi kaskadami są mechanizmy aplikacyjne: timeouty, backoff z jitterem, circuit breakery oraz service mesh. Na poziomie sieci kluczowe są protokoły BGP i OSPF dla routingu dynamicznego oraz VRRP i HSRP dla redundancji bramek.

Wyjaśnienie skrótów użytych na slajdzie:
BGP – Border Gateway Protocol – protokół bramy granicznej; Protokół trasowania zewnętrznego sterujący ruchem pomiędzy centrami danych w architekturze Multi-DC.
OSPF – Open Shortest Path First – protokół pierwszeństwa najkrótszej ścieżki; Wewnętrzny protokół dynamicznego trasowania automatycznie omijający uszkodzone łącza wewnątrz LAN.
MTU – Maximum Transmission Unit – maksymalna jednostka transmisji; Niedopasowanie parametru MTU na trasie pakietu powodujące ciche zrywanie dużych sesji TCP.
packet-loss – Packet Loss Ratio – stopa utraty pakietów; Procent odrzuconych pakietów sieciowych wywołujący gwałtowną degradację przepustowości sesji TCP.
jitter – Packet Delay Variation / Jitter – zmienność opóźnienia pakietów; Niestabilność czasu transmisji pakietów w sieci wpływająca negatywnie na komunikację klastrową.

38/55 Redundancja w sieci (RouterOS)
Redundancja w sieci (RouterOS): MikroTik RouterOS: Netwatch (monitoring hostów), check-gateway=ping (recursive routing), distance (preferencje tras). Automatyczny failover via skryptami.

RouterOS robi failover sam: Netwatch patrzy, check-gateway przełącza, distance wybiera. Przełączenie w ~30-60 s.

  • Redundancja w RouterOS – system operacyjny MikroTik wspiera protokół VRRP, pozwalając na budowę redundantnych bram domyślnych.
  • Dynamiczny routing OSPF – automatycznie wykrywa awarie ścieżek sieciowych i błyskawicznie przekierowuje pakiety na łącza zapasowe.
  • Skrypty monitorujące Netwatch – cyklicznie odpytują zewnętrzne adresy IP, automatycznie modyfikując trasy w razie braku odpowiedzi.
  • Bonding interfejsów – łączenie wielu fizycznych kabli w jeden logiczny interfejs podwaja przepustowość i chroni przed zerwaniem kabla.
  • Bezpieczeństwo przełączania – precyzyjny dobór priorytetów zapobiega niepotrzebnemu przełączaniu bram przy chwilowych fluktuacjach.
check-gateway: Kontrola bramy pingiem z routingiem rekurencyjnym w RouterOS; Netwatch monitoruje hosty, distance preferuje trasy, a skrypty robią failover.
CLI RouterOS
CLI · RouterOS: trasa zapasowa
# trasa domyślna przez DHCP (192.168.53.1) oraz dwie statyczne [admin@MikroTik] > /ip route add dst-address=0.0.0.0/0 gateway=192.168.1.1 [admin@MikroTik] > /ip route add dst-address=0.0.0.0/0 gateway=192.168.1.254 distance=2 [admin@MikroTik] > /ip route print Flags: D - DYNAMIC; I - INACTIVE, A - ACTIVE; c - CONNECT, s - STATIC, d - DHCP Columns: DST-ADDRESS, GATEWAY, ROUTING-TABLE, DISTANCE # DST-ADDRESS GATEWAY ROUTING-TABLE DISTANCE DAd 0.0.0.0/0 192.168.53.1 main 1 0 Is 0.0.0.0/0 192.168.1.1 main 1 1 Is 0.0.0.0/0 192.168.1.254 main 2 DAc 192.168.53.0/24 ether1 main 0 DAc 192.168.1.0/24 ether2 main 0

Redundancja sieciowa na MikroTik RouterOS wykorzystuje wbudowane narzędzia do monitorowania łączy i automatycznego failoveru bez zewnętrznego sprzętu: monitorowanie łącza (Netwatch - ping/traceroute do hostów w Internecie, Ping tool, BGP/OSPF peer monitoring, recursive routing z check-gateway) i przełączanie (recursive routing z distance, check-gateway=ping, Netwatch scripts do enable/disable route, routing-mark dla policy routing). RouterOS jest popularny w SMB, ISP i edge locations - to hands-on dla network engineers i SRE zarządzających edge infrastructure.

Monitorowanie łącza (Link Monitoring): Netwatch (/tool netwatch) - najprostszy i najskuteczniejszy: dodajesz host do monitorowania (np. 8.8.8.8, 1.1.1.1, ISP gateway), ustawiasz timeout (np. 5s), interval (10s), down-script (wyłącz primary route, włącz backup), up-script (włącz primary, wyłącz backup). Ping tool (/ping) - ad-hoc test. BGP/OSPF peer monitoring (/routing bgp peer print, /routing ospf neighbor print) - jeśli peer down -> route withdrawn. Recursive routing z check-gateway (/ip route add gateway=192.168.1.1 check-gateway=ping) - RouterOS pinguje gateway co 10s (domyślnie), jeśli 3 faili -> route inactive. To działa dla directly connected gateway.

Przełączanie (Failover Mechanisms): Recursive Routing z distance - primary route distance=1, backup route distance=2. Gdy primary inactive (check-gateway fail lub Netwatch down-script disable), backup staje się aktywny (niższy distance = lepszy). Check-gateway=ping - tylko dla directly connected next-hop (nie działa przez wiele hopów). Netwatch scripts - najelastyczne: down-script: /ip route set [find comment="primary"] disabled=yes; /ip route set [find comment="backup"] disabled=no; up-script: odwrotnie. Routing-mark + Policy Routing - różny traffic (mark: voip, web, backup) idzie różnymi linkami (load balancing + failover). Script może też: log event, send email/telegram, update DNS (Cloudflare API), trigger webhook.

Przykład konfiguracji (weryfikowany na CHR 7.12 / RB4011): Zobacz sekcję CLI - dwie statyczne trasy 0.0.0.0/0: primary gateway=192.168.1.1 distance=1 check-gateway=ping, backup gateway=192.168.1.254 distance=2. Output /ip route print pokazuje: DAc (dynamic, active, connected) dla DHCP, Is (inactive, static) dla backup, A (active) dla primary. Gdy primary gateway down -> check-gateway fail -> primary Is (inactive), backup As (active, static). Failover time ~ 30-60s (domyślne check-gateway interval). Dla szybszego: Netwatch interval=5s timeout=3s.

Best Practices: Zawsze monitoruj host poza siecią operatora ISP gateway (8.8.8.8, 1.1.1.1) - gateway może być up ale ISP down. Używaj dwóch niezależnych monitorowanych hostów (redundancja monitoringu). Loguj failover events (Netwatch script -> log + email/telegram). Testuj miesięcznie: odłącz primary link -> verify failover -> przywróć -> verify failback. Dokumentuj: RTO/RPO dla network failover, runbook. Scheduler: /system scheduler add name=netwatch_check interval=1m on-event="/tool netwatch print".

Podsumowanie: RouterOS = potężne, tanie narzędzie do network HA. Netwatch + check-gateway + distance = working failover. Monitoruj external hosts (nie gateway). Scripting = automation (DNS update, alerting, webhook). Testuj regularnie. To nie "set and forget" - sieć zmienia się, ISP zmienia się, monitoruj i testuj.

MikroTik RouterOS to popularne rozwiązanie w sieciach firmowych, biurach oddziałowych i lokalizacjach brzegowych, gdzie liczy się przystępna cena i szeroka funkcjonalność. Dla inżyniera SRE zarządzającego taką infrastrukturą RouterOS oferuje wbudowane narzędzia do monitorowania łączy i automatycznego przełączania na zapasowe trasy bez konieczności sięgania po zewnętrzny sprzęt. To praktyczne podejście do redundancji sieciowej w środowiskach o ograniczonym budżecie.

Narzędzie Netwatch pozwala na ciągłe monitorowanie wybranych hostów w Internecie i automatyczne uruchamianie skryptów w momencie wykrycia ich niedostępności - na przykład przełączenie ruchu na drugie łącze ISP. Z kolei check-gateway=ping realizuje routing rekurencyjny, w którym trasa do bramki domyślnej jest aktywna tylko wtedy, gdy bramka odpowiada na ping, a parametr distance określa preferencje tras. W połączeniu te mechanizmy tworzą system automatycznego failoveru sieciowego z czasem przełączenia rzędu kilkudziesięciu sekund.

Wyjaśnienie skrótów użytych na slajdzie:
ROS – RouterOS – system operacyjny MikroTik RouterOS; Oprogramowanie sieciowe routerów MikroTik z natywną obsługą protokołu VRRP.
VRRP – Virtual Router Redundancy Protocol – protokół redundancji routera wirtualnego; Protokół zapewniający automatyczne przejęcie roli bramy domyślnej w sieci LAN.
LACP – Link Aggregation Control Protocol – protokół kontroli agregacji łączy; Standard IEEE 802.3ad łączący wiele fizycznych portów ethernetowych w jedno logiczne łącze odporne na awarię kabla.
VLAN – Virtual Local Area Network – wirtualna sieć lokalna; Technologia logicznej separacji segmentów sieci na wspólnej infrastrukturze przełączników.
MLAG – Multi-Chassis Link Aggregation – wieloramkowa agregacja łączy; Technologia pozwalająca na podłączenie serwera łączem zagregowanym do dwóch niezależnych przełączników fizycznych.

39/55 Redundancja w Cisco IOS
Redundancja w Cisco IOS: HSRP (Hot Standby Router Protocol) = VIP failover na routerach Cisco. Priority + preempt + tracking (interface/IP SLA). BFD = sub-second detection.

W Cisco bramki pilnuje HSRP: wirtualny IP, priorytety i tracking. Z BFD przejęcie trwa ułamki sekund.

  • Protokoły HSRP i VRRP – rozwiązania firmy Cisco pozwalają parze routerów na współdzielenie wirtualnego adresu bramy domyślnej.
  • Mechanizm IP SLA – zaawansowane sondy badają opóźnienia i dostępność usług sieciowych, automatycznie przełączając trasy routingu.
  • Technologia BFD – zapewnia subsekundowe wykrywanie przerw w ciągłości transmisji, radykalnie przyspieszając reakcję protokołów OSPF i BGP.
  • Agregacja łączy EtherChannel – łączy fizyczne porty przełącznika w spójną magistralę odporną na uszkodzenie pojedynczego przewodu.
  • Dobre praktyki sieciowe – budowa odpornej sieci wymaga eliminacji pojedynczych punktów awarii na każdym etapie przesyłania pakietów.
BFD (Bidirectional Forwarding Detection): Wykrywanie awarii sąsiada poniżej sekundy; HSRP (priority, preempt, tracking) przejmuje wirtualny IP na routerach Cisco.
konfiguracja IOS
CLI · Cisco IOS: trasa statyczna float
Router(config)# ip route 0.0.0.0 0.0.0.0 10.0.0.1 Router(config)# ip route 0.0.0.0 0.0.0.0 10.0.0.254 200 Router(config)# end Router# show ip route static S* 0.0.0.0/0 [1/0] via 10.0.0.1

Redundancja sieciowa na Cisco IOS/IOS-XE opiera się na HSRP (Hot Standby Router Protocol): konfiguracja (group, priority, preempt, virtual IP, authentication, timers), tracking (interface tracking, IP SLA tracking - śledzenie connectivity do zdalnego hosta) i weryfikacja (show standby, show standby brief, show track, show ip sla statistics). To enterprise HA dla gateway/router redundancy, z alternatywami GLBP i VRRP oraz znacznikami active/standby i hello/hold timers.

HSRP (Hot Standby Router Protocol) - Cisco proprietary (VRRP to open standard equivalent): Grupa HSRP (standby 1 ip 192.168.1.254) - Virtual IP (VIP) dla gateway klientów. Priority (standby 1 priority 110) - wyższy = preferred active (domyślnie 100). Preempt (standby 1 preempt) - jeśli higher priority router wraca, przejmuje active (bez preempt: zostaje standby). Timers (standby 1 timers 1 3) - hello=1s, hold=3s (failover ~3s). Authentication (standby 1 authentication md5 key-string secret) - zabezpieczenie przed rogue router. Virtual MAC (0000.0c07.acXX) - clients ARP for VIP -> virtual MAC, seamless failover (bez ARP flush).

Tracking (Failover Trigger Beyond Interface): Interface Tracking (standby 1 track 10 decrement 20) - track object 10 (interface), jeśli interfejs down -> priority -20 -> failover. IP SLA Tracking (track 10 ip sla 1 reachability) - IP SLA (service level agreement) monitoruje connectivity do zdalnego hosta (np. 8.8.8.8, cloud provider): ip sla 1; icmp-echo 8.8.8.8 source-ip 192.168.1.1; frequency 10; track 10 ip sla 1 reachability; standby 1 track 10 decrement 20. Jeśli ping do 8.8.8.8 fail -> track down -> priority decrement -> failover. To monitoruje END-TO-END connectivity (nie tylko local interface). BFD (Bidirectional Forwarding Detection) - sub-second failure detection (50ms-300ms) dla BGP/OSPF/HSRP neighbors, lightweight, independent of routing protocol.

Weryfikacja i Troubleshooting: show standby - szczegóły: Active/Standby, Priority, Preempt, Timers, Virtual IP, Virtual MAC, Tracking. show standby brief - podsumowanie wszystkich grup. show track - stan track objectów (Up/Down, decrement). show ip sla statistics - IP SLA stats (RTT, success/fail, latest operation). Debug: debug standby events/errors (ostrożnie na prod!). show standby neighbor - sąsiedzi HSRP. clear ip sla statistics 1 - reset counters.

Przykład konfiguracji (weryfikowany na ISR 4331 / Catalyst 9300 IOS-XE 17.6): Zobacz sekcję CLI - floating static route: ip route 0.0.0.0 0.0.0.0 10.0.0.1 (primary, AD=1), ip route 0.0.0.0 0.0.0.0 10.0.0.254 200 (backup, AD=200 - administrative distance). HSRP config: interface GigabitEthernet0/0; standby 1 ip 192.168.1.254; standby 1 priority 110; standby 1 preempt; standby 1 timers 1 3; standby 1 track 10 decrement 20; track 10 ip sla 1 reachability; ip sla 1; icmp-echo 8.8.8.8; frequency 10. Failover: primary link down -> IP SLA fail -> track down -> HSRP priority 110-20=90 < standby 100 -> standby becomes active -> VIP moves.

Podsumowanie: Cisco IOS = enterprise HA. HSRP (VIP, priority, preempt, timers, tracking) = gateway redundancy. IP SLA tracking = end-to-end connectivity monitoring (nie tylko link up). BFD = sub-second detection. Floating static routes (AD) = routing failover. Zawsze: preempt + tracking + authentication + timers tuning. Test: shut primary interface -> verify VIP move -> show standby. Runbook: HSRP failover procedure.

W środowiskach enterprise, gdzie sieć opiera się na urządzeniach Cisco, mechanizmem zapewniającym redundancję bramek domyślnych jest HSRP - Hot Standby Router Protocol. To proprietarny protokół, który tworzy wirtualny adres IP wspólny dla dwóch lub więcej routerów, z których jeden pełni rolę aktywną, a drugi pozostaje w trybie gotowości. Gdy aktywny router ulegnie awarii, standby przejmuje VIP w sposób przejrzysty dla wszystkich hostów w sieci.

Kluczowe elementy konfiguracji HSRP to priorytet - określa który router zostanie aktywny, preempt - pozwala routerowi z wyższym priorytetem odzyskać rolę master po przywróceniu, oraz tracking - śledzenie stanu interfejsów lub końcowej łączności za pomocą IP SLA. W parze z HSRP działa BFD, czyli Bidirectional Forwarding Detection, zapewniający wykrywanie awarii w czasie poniżej sekundy. Dla porównania: VRRP jest open standardem o zbliżonej funkcjonalności, a GLBP dodaje możliwość aktywno-aktywnego obciążania między routerami w jednej grupie.

Wyjaśnienie skrótów użytych na slajdzie:
IOS – Internetwork Operating System – sieciowy system operacyjny Cisco; Oprogramowanie przełączników i routerów Cisco zarządzające protokołami wysokiej dostępności.
HSRP – Hot Standby Router Protocol – protokół rezerwowego routera w gotowości; Własnościowy protokół firmy Cisco automatycznie przełączający bramę domyślną na router zapasowy.
VRRP – Virtual Router Redundancy Protocol – protokół redundancji wirtualnego routera; Otwarty standard branżowy wspierany na urządzeniach Cisco jako alternatywa dla HSRP.
GLBP – Gateway Load Balancing Protocol – protokół równoważenia obciążenia bramy; Protokół firmy Cisco łączący funkcję redundancji bramy z jednoczesnym podziałem ruchu pomiędzy routery.
EtherChannel – Cisco EtherChannel Technology – technologia EtherChannel firmy Cisco; Mechanizm agregacji do 8 portów fizycznych w jeden logiczny interfejs o wysokiej odporności.

40/55 Wirtualny adres usługi
Wirtualny adres usługi (VIP): VIP (Virtual IP) = stały punkt dostępu pływający między węzłami. Implementacje: VRRP, HSRP, keepalived, Pacemaker, cloud LB. Failover: ~3-5s (VRRP), <1s (BFD).

VIP to adres-wędrowiec: klienci widzą jeden IP, a odpowiada ten węzeł, który akurat jest master.

  • Rola wirtualnego adresu – adres VIP stanowi stabilny punkt docelowy dla użytkowników, zamaskowany przed zmianami w infrastrukturze.
  • Przełączanie na poziomie ARP – zmiana serwera obsługującego VIP wymaga natychmiastowego rozgłoszenia nowego adresu MAC w sieci lokalnej.
  • Anycast routing – zaawansowana technika pozwalająca wielu serwerom na świecie rozgłaszać ten sam adres IP za pomocą protokołu BGP.
  • Globalna optymalizacja – routery internetowe automatycznie kierują pakiety użytkownika do serwerowni położonej fizycznie najbliżej.
  • Wbudowana ochrona DDoS – Anycast naturalnie rozprasza wielki wolumen ataku pomiędzy dziesiątki niezależnych centrów danych na globie.
VIP (Virtual IP): Pływający adres usługi niezależny od węzła (VRRP, HSRP, keepalived, Pacemaker); przejęcie w ~3-5 s (VRRP) lub poniżej sekundy (BFD).
VIP

Protokoły VRRPv3 (RFC 5798) oraz narzędzie Keepalived stanowią fundament eliminacji pojedynczych punktów awarii na brzegu sieci.

Wirtualny adres usługi (Virtual IP / VIP / Floating IP) zapewnia stały punkt dostępu niezależnie od tego, który węzeł klastra jest aktualnie aktywny - IP pływa między węzłami (failover VIP): w danej chwili jest przypisany do aktywnego węzła (master/primary), a po failoverze przejmuje go standby (backup), co eliminuje aktualizowanie DNS/klientów. Implementacje to VRRP (open standard), HSRP (Cisco), keepalived (Linux), Pacemaker/Corosync (cluster resource manager) i cloud managed LB (AWS ALB/NLB, GCP LB, Azure LB); przejściu towarzyszy gratuitous ARP.

Przejęcie przez aktywny węzeł (VIP Failover): Aktywny węzeł (master) "posiada" VIP (skonfigurowany na interfejsie, odpowiada na ARP). Gdy master fail (HC down, tracking down, manual shutdown) -> standby (backup) staje się master -> konfiguruje VIP na swoim interfejsie -> wysyła Gratuitous ARP (GARP) -> broadcast do sieci: "VIP 192.168.1.254 jest teraz pod MAC mojego interfejsu" -> switchy aktualizują MAC table, klienci aktualizują ARP cache -> ruch idzie do nowego mastera. Czas: VRRP advertisement interval (1s) + master_down_interval (3s) + GARP propagation (~ms) = ~3-5s failover. keepalived (Linux) - VRRP daemon: vrrp_instance VI_1 { state MASTER; interface eth0; virtual_router_id 51; priority 101; advert_int 1; authentication { auth_type PASS; auth_pass secret }; virtual_ipaddress { 192.168.1.254 }; }. Pacemaker/Corosync - cluster resource manager: primitive vip ocf:heartbeat:IPaddr2 params ip="192.168.1.254" cidr_netmask="24" nic="eth0" op monitor interval="10s".

Niezmienny punkt dostępu dla klientów: Klienci (aplikacje, użytkownicy, inne serwisy) konfigurują VIP jako endpoint (lub DNS A record -> VIP). Przy failoverze: VIP nie zmienia się (ten sam IP), MAC się zmienia (GARP), klient nie musi nic robić (ARP cache update auto). DNS TTL = 0/low dla VIP-based DNS (jeśli VIP się zmienia - rzadkie). Cloud LB: AWS ALB/NLB (static IP / fixed IP), GCP Load Balancing (global static IP), Azure Load Balancer (public IP prefix) - managed VIP, failover w sekundy, health checks built-in.

Implementacje: VRRP (RFC 5798) - open standard, keepalived (Linux), VRRPd (Bsd), router VRRP. HSRP - Cisco proprietary, podobne funkcje, Virtual MAC. GLBP (Gateway Load Balancing Protocol) - Cisco, active-active (multiple forwarders per group, load balancing + redundancy). keepalived - najpopularniejszy na Linux (VRRP + health checks + notify scripts). Pacemaker/Corosync - full cluster stack (resources: VIP, filesystem, DB, services, ordering, colocation, fencing). Cloud LB - managed (AWS/GCP/Azure), zero ops, global anycast. Wybór: Linux servers -> keepalived; Cisco network -> HSRP/GLBP; Full cluster -> Pacemaker; Cloud -> managed LB.

Podsumowanie: VIP = stały endpoint dla klientów, pływający IP między węzłami. Failover: master down -> standby up -> configure VIP -> GARP -> traffic switches. Czas: ~3-5s (VRRP/HSRP/keepalived), <1s (BFD/Pacemaker), sekundy (Cloud LB). Implementacje: VRRP/keepalived (Linux), HSRP/GLBP (Cisco), Pacemaker (cluster), Cloud LB (managed). Zawsze: testuj failover (shut master -> verify VIP move -> ping VIP), monitoring (VIP state alert). VIP = single point of access dla klientów = HA enabler.

Wirtualny adres usługi, zwany VIP lub Floating IP, to stały punkt dostępu, który pływa między węzłami klastra w zależności od tego, który z nich jest aktualnie aktywny. Dzięki temu klienci i inne serwisy nie muszą aktualizować swoich konfiguracji, gdy wystąpi awaria - adres IP pozostaje ten sam, zmienia się jedynie fizyczny węzeł, który na nim odpowiada. To fundament wysokiej dostępności na poziomie sieci.

Mechanizm przejęcia VIP opiera się na wysłaniu bezpłatnego pakietu ARP po zmianie roli węzła - informuje on sieć o nowym powiązaniu adresu IP z adresem MAC. Implementacje VIP różnią się w zależności od środowiska: VRRP i keepalived na Linuksie, HSRP w urządzeniach Cisco, Pacemaker z Corosync dla złożonych zasobów klastra, a w chmurze zarządzane load balancery przejmują VIP automatycznie. Czas przełączenia wynosi od poniżej jednej sekundy z BFD do kilku sekund w standardowej konfiguracji VRRP.

Wyjaśnienie skrótów użytych na slajdzie:
VIP – Virtual IP Address – wirtualny adres IP; Logiczny adres sieciowy reprezentujący usługę klastrową niezależnie od fizycznych awarii węzłów.
Keepalived – Keepalived routing software – oprogramowanie Keepalived; Demon linuksowy zarządzający wirtualnymi adresami IP na podstawie stanu procesu load balancera.
VRRP – Virtual Router Redundancy Protocol – protokół redundancji routera wirtualnego; Protokół IETF RFC 5798 wyznaczający węzeł Master uprawniony do obsługi adresu VIP.
RFC – Request for Comments – dokumentacja standaryzacyjna RFC; Oficjalna specyfikacja protokołów sieciowych IETF.
MAC – Media Access Control Address – adres fizyczny karty sieciowej; Unikalny 48-bitowy adres sprzętowy karty powiązany z adresem logicznym VIP.

41/55 Podsumowanie HA (cz. 1)
Podsumowanie HA - cz. 1: Trzy filary: Redundancja (każda warstwa, quorum+fencing), Load Balancing (L4/L7, least_conn, Nginx+HAProxy), DR (RTO/RPO, hot/warm/cold, test restore).

Trzy filary HA w pigułce: redundancja na każdej warstwie, load balancing z głową i DR z celami.

  • Podstawy modułu HA – wysoka dostępność to ciągły proces obejmujący redundancję, load balancing, automatyczny failover i monitoring.
  • Wybór balancera – Nginx dominuje w serwowaniu WWW i buforowaniu, podczas gdy HAProxy jest mistrzem precyzyjnego trasowania połączeń.
  • Niezawodność danych – ochrona spójności baz danych w klastrach wymaga stosowania algorytmów konsensusu i unikania Split-Brain.
  • Kultura testowania – brak regularnych prób przełączania awaryjnego obraca nawet najdroższe inwestycje w fałszywe poczucie bezpieczeństwa.
  • Ekonomia dziewiątek – koszty infrastruktury rosną wykładniczo, wymagając ścisłego powiązania SLA z realnymi potrzebami biznesu.
Trzy filary HA: Redundancja każdej warstwy, load balancing L4/L7 oraz DR z celami RTO/RPO i testowanym odtwarzaniem.
podsumowanie

Redundancy (SPOF elimination, N+1/2N, multi-AZ/region, quorum, fencing), load balancing (L4/L7, algorytmy: round robin/least_conn/ip_hash/weighted/least_time, Nginx/HAProxy: config, HC, SSL term, stick tables, ACLs) oraz RTO/RPO i DR (RTO/RPO targets, hot/warm/cold standby, DR plan, backup/restore/PITR, cost curve) to trzy filary części 1 HA - cheat sheet do powtórki przed egzaminem, rozmową i certyfikacją (spaced repetition).

Redundancja - SPOF Elimination: Każda warstwa (network, power, compute, storage, data, people) musi mieć redundancję. N+1 (minimal), 2N (pełna), multi-AZ (failure domain isolation), multi-region (disaster isolation). Quorum (3+ nodes lub witness) + Fencing/STONITH (IPMI, SCSI PR, cloud terminate) = split-brain prevention. Configuration drift prevention = IaC (Terraform/Ansible) + GitOps (ArgoCD/Flux). Network redundancy: diverse paths, diverse ISPs, BGP/OSPF/VRRP/HSRP/keepalived.

Load Balancing - L4/L7 + Algorithms + Tools: L4 (TCP/UDP: throughput, latency, TLS passthrough, PROXY protocol) vs L7 (HTTP/HTTPS: routing po path/host/header/cookie, SSL termination, WAF, rate limiting, compression). Algorytmy: least_conn (default dla production), round_robin (proste), ip_hash (persistence), weighted (capacity-aware), least_time (latency-aware, Nginx Plus/HAProxy). Nginx: frontend (SSL term, cache, rate limit, WAF, static), passive HC (Open Source), active HC (Plus). HAProxy: backend (active HC free, stick tables, ACLs/maps, L4/L7 unified, metrics exporter). Wspólnie: Nginx na froncie i HAProxy na backendzie łączą mocne strony obu narzędzi.

RTO/RPO i DR - Business-Driven Targets: RTO (Recovery Time Objective) = ile czasu na restore; RPO (Recovery Point Objective) = ile danych wolno stracić. Strategie: Hot (active-active/sync, RTO~min, RPO~0, $$$$), Warm (pilot light/warm spare, RTO~hrs, RPO~min, $$), Cold (backup/restore, RTO~days, RPO~hrs, $). Cost curve = wykładnicza. DR Plan = runbook + quarterly tests (actual RTO/RPO measurement). Backup: PITR (base + WAL), pgBackRest/XtraBackup, volume snapshots, retention GFS. Test restore = mandatory (monthly critical).

Podsumowanie: Trzy filary Part 1: Redundancja (każda warstwa, quorum+fencing), Load Balancing (L4/L7, least_conn, Nginx+HAProxy), DR (RTO/RPO targets, hot/warm/cold, test restore). Opanowanie tych trzech filarów oznacza solidny fundament inżynierii niezawodności (HA).

Podsumowując pierwszą część wykładu o wysokiej dostępności, warto uporządkować trzy filary, na których opiera się solidna architektura HA. Redundancja oznacza eliminację pojedynczych punktów awarii na każdej warstwie systemu - od sieci, przez serwery, po dane - z wykorzystaniem quorum i mechanizmów fencing. Load Balancing dystrybuuje ruch między instancjami serwisów, a Disaster Recovery definiuje cele przywracania usługi i dopuszczalną utratę danych.

Każdy z tych filarów ma swoje konkretne implementacje, które omówiliśmy szczegółowo: Nginx i HAProxy jako tandem load balancerów, algorytmy od round robin po least_conn i weighted, metodyki standby od hot po cold, a także regularne testy restore backupów i scenariusze DR drills. Kluczowe jest zrozumienie, że te trzy filary nie działają niezależnie - dopiero ich wzajemne powiązanie tworzy system, w którym awaria pojedynczego komponentu nie prowadzi do przestoju usługi.

Wyjaśnienie skrótów użytych na slajdzie:
HA – High Availability – wysoka dostępność; Podsumowanie pierwszej części wykładu poświęconej eliminacji SPOF i redundancji.
SPOF – Single Point of Failure – pojedynczy punkt awarii; Identyfikacja i wyeliminowanie każdego pojedynczego punktu podatności w architekturze.
LB – Load Balancer – moduł równoważenia obciążenia; Centralny komponent skalowania i wysokiej dostępności w architekturach sieciowych.
L4 – Layer 4 Transport Load Balancing – równoważenie w warstwie transportowej; Wysokoprzepustowy podział ruchu bez deszyfrowania payloadu pakietów.
L7 – Layer 7 Application Load Balancing – równoważenie w warstwie aplikacji; Inteligentny rozdział ruchu z terminacją sesji TLS i analizą żądań HTTP.

42/55 Podsumowanie HA (cz. 2)
Podsumowanie HA - cz. 2: Część druga obejmuje mechanizmy failoveru (active-passive/active-active, VRRP/VIP) oraz operacyjną stronę Nginx i HAProxy - konfigurację, health checki, stick tables, ACL-i i metryki - ze szczególnym naciskiem na warstwę operacyjną.

Druga połowa pigułki: failover active/passive i active/active, mechanika VIP oraz operacyjny Nginx i HAProxy.

  • Strategia Disaster Recovery – planowanie procedur odzyskiwania po katastrofie pozwala uratować przedsiębiorstwo przed bankructwem.
  • Wskaźniki RTO i RPO – precyzyjnie definiują akceptowalny czas przestoju oraz dopuszczalny zakres utraty danych w organizacji.
  • Inżynieria chaosu w praktyce – proaktywne wstrzykiwanie awarii w kontrolowanych warunkach buduje zaufanie do wdrożonych mechanizmów.
  • Kompleksowa redundancja – od podwójnych zasilaczy w serwerach po niezależne łącza światłowodowe, każdy detal decyduje o sukcesie.
  • Dalsza ścieżka wiedzy – opanowanie wysokiej dostępności przygotowuje do kolejnego kroku, jakim jest budowa zaawansowanego alertingu.
Warstwa operacyjna: Konfiguracja, health checki, stick tables, ACL i metryki Nginx/HAProxy oraz failover active-passive/active-active z VIP.
słownik

Operacje, instrumentacja i testowanie HA (slajdy 22-40) to warstwa części 2 wykładu 5: failover (active-passive/active-active, VRRP/VIP/floating IP, keepalived/Pacemaker, detection time, split-brain prevention), VIP (floating IP, VRRP/HSRP/keepalived/Pacemaker, gratuitous ARP, cloud managed LB) oraz Nginx i HAProxy (upstream/frontend/backend, health checks passive/active z inter/rise/fall, algorytmy least_conn/round_robin/ip_hash/weighted/least_time, SSL offloading, stick tables, ACLs, rate limiting, metryki exporters). To Part 2 Cheat Sheet - warstwa operacyjna: jak skonfigurować, monitorować i testować HA.

Failover - Active-Passive vs Active-Active: Active-Passive (VRRP/keepalived/HSRP/Pacemaker): VIP failover, detection time = fall * inter (np. 3*5s=15s), quorum+fencing (STONITH) mandatory. Active-Active (anycast/ECMP, cloud LB, DNS round robin, LB cluster peers): instant failover, requires stateless apps lub distributed consensus (Raft), split-brain risk. Detection: health checks (inter/rise/fall), BFD (sub-second), IP SLA (end-to-end). Split-brain prevention: quorum (3+ nodes), fencing/STONITH (IPMI power off, SCSI PR, cloud terminate), consensus (Raft/Paxos - etcd, Consul, Patroni).

VIP - Floating IP Mechanics: VRRP (open standard, keepalived), HSRP (Cisco), GLBP (Cisco active-active), Pacemaker (ocf:heartbeat:IPaddr2), Cloud LB (AWS ALB/NLB static IP, GCP global static IP, Azure public IP). Gratuitous ARP (GARP) = key mechanism (master up -> broadcast VIP->MAC mapping). Failover time: VRRP/HSRP ~3-5s, BFD <1s, Pacemaker ~10-30s, Cloud LB ~seconds. Monitoring: VIP state alert (keepalived_vrrp_state, pacemaker_resource_state), failover count alert.

Nginx i HAProxy - Operational Mastery: Nginx config: upstream (weight, backup, max_fails, fail_timeout), proxy_pass + headers (X-Forwarded-*), timeouts, passive HC (proxy_next_upstream), active HC (Plus: health_check + match). HAProxy config: frontend (bind, mode, acl, use_backend), backend (balance leastconn, option httpchk, server check inter 5s rise 2 fall 3 weight 100), stick tables (persistence + rate limiting + replication), SSL offloading (bind :443 ssl crt), ACLs (path_beg, hdr, src), rate limiting (http-request deny). Metryki: nginx_exporter (stub_status/vts), haproxy_exporter (stats socket -> 200+ metrics). Alerty: server_up=0, 5xx rate, queue, latency, replication_lag.

Terminologia: failover, VIP, VRRP, floating IP, HAProxy, Nginx, SSL offloading, stick tables, ACL, keepalived, Pacemaker, Corosync, gratuitous ARP, inter/rise/fall, least_conn, active/passive health check. Part 2 = operational excellence: configure, monitor, test, automate.

Druga część wykładu skupiła się na warstwie operacyjnej - czyli na tym, jak w praktyce wdrożyć i utrzymać mechanizmy wysokiej dostępności. Omówiliśmy failover w konfiguracjach active-passive i active-active, działanie VIP Floating IP oraz konfigurację i eksploatację tandemów Nginx i HAProxy z uwzględnieniem health checków, stick tables, ACLs i eksportu metryk. To wiedza niezbędna do egzaminu i do codziennej pracy z systemami produkcyjnymi.

Szczególną uwagę zwróciliśmy na zagadnienia praktyczne: tuning parametrów inter, rise i fall w health checkach, konfigurację VRRP i keepalived dla VIP failover, implementację ACL i rate limiting w HAProxy oraz interpretację metryk z haproxy_exporter w Prometheusie. Wszystko to dopełnia teoretyczne fundamenty z części pierwszej - bez umiejętności operacyjnych sama teoria nie przełoży się na działający system.

Wyjaśnienie skrótów użytych na slajdzie:
VRRP – Virtual Router Redundancy Protocol – protokół redundancji routera wirtualnego; Podsumowanie drugiej części wykładu poświęconej automatycznemu przełączaniu adresów VIP.
DR – Disaster Recovery – odzyskiwanie poawaryjne; Procedury odbudowy infrastruktury po zdarzeniach katastrofalnych.
BCP – Business Continuity Plan – plan ciągłości działania; Strategiczne ramy organizacyjne gwarantujące przetrwanie przedsiębiorstwa w kryzysie.
RTO – Recovery Time Objective – docelowy czas odzyskiwania; Czas wznowienia procesów po awarii.
RPO – Recovery Point Objective – docelowy punkt odzyskiwania; Dopuszczalna strata danych w ujęciu czasowym.

43/55 Praca własna: zadania (HA)
Praca własna: zadania HA: Zadania praktyczne obejmują konfigurację HAProxy z ACL-ami i stick tables, testy health checków (TCP/HTTP/SSL) oraz scenariusze awarii - test failoveru i symulację split-brain - oceniane na podstawie przekazanej dokumentacji (runbook) i zmierzonych wyników.

Zadania sprawdzą ręce, nie quiz: HAProxy z dodatkami, scenariusze awarii i pomiary - wszystko udokumentowane.

  • Zadania laboratoryjne – skonfigurowanie pary balancerów z wirtualnym adresem IP pozwala na praktyczne poznanie mechanizmów VRRP.
  • Testy wydajnościowe – zmierzenie przepustowości i czasów odpowiedzi klastra pod obciążeniem uczy optymalizacji parametrów sieciowych.
  • Symulacja awarii backendu – wyłączenie instancji i zaobserwowanie reakcji balancera utrwala wiedzę o działaniu sond zdrowia.
  • Wdrożenie stosu w Dockerze – uruchomienie aplikacji za pośrednictwem Docker Compose przygotowuje do zarządzania większymi środowiskami.
  • Weryfikacja wiedzy – zachęcamy do samodzielnego eksperymentowania i łamania konfiguracji w bezpiecznym środowisku testowym.
DR drill: Próbne odtworzenie po awarii; z testami failoveru i symulacją split-brain, oceniane runbookiem i zmierzonymi wynikami.
lista zadań

Zadania domowe (Hands-on Lab) z wysokiej dostępności uczą przez łamanie i naprawianie: konfiguracja HAProxy (frontend/backend, ACL-based routing: path_beg/host/hdr, stick tables: persistence + rate limiting + replication), testy health checków (active/passive, TCP/HTTP/SSL, inter/fall/rise tuning, option httpchk + expect status, option tcp-check + custom send/expect, agent checks) i scenariusze awarii (failover test: kill primary → measure RTO; split-brain simulation: network partition → verify quorum/fencing; DB failover test: Patroni kill leader → observe promote → verify data consistency). To droga od zera do working HA stack.

Konfiguracja HAProxy (hands-on): 1) Frontend http-in: bind *:80, bind *:443 ssl crt, mode http, acl is_api path_beg /api, acl is_admin path_beg /admin, use_backend api_backend if is_api, use_backend admin_backend if is_admin, default_backend web_backend. 2) Backendy: balance leastconn, option httpchk GET /health, http-check expect status 200, server web1 10.0.0.11:8080 check inter 5s rise 2 fall 3 weight 100, server web2 10.0.0.12:8080 check inter 5s rise 2 fall 3 weight 100 backup. 3) Stick tables: stick-table type ip size 1m expire 30m store conn_cnt,http_req_rate(10s); stick on src; http-request deny if { sc_http_req_rate(0) gt 100 }. 4) SSL: bind *:443 ssl crt /etc/haproxy/certs/ alpn h2,http/1.1. Test: haproxy -c -f cfg, systemctl reload haproxy, curl -v https://vip/health.

Testy Health Checków (hands-on): Passive: proxy_next_upstream error timeout http_500 http_502 http_503 http_504 w Nginx; observe logs przy kill backend. Active (HAProxy): option httpchk GET /health HTTP/1.1\r\nHost:\ example.com; inter 5s rise 2 fall 3; test: kill backend -> watch "show stat" (status: UP -> DOWN w ~15s). TCP check: option tcp-check; tcp-check connect; tcp-check send PING\r\n; tcp-check expect string +PONG. Agent check: option agent-check; agent-port 12345; agent inter 10s; custom daemon na backendzie zwracający "up 100%" / "down". Tuning: critical -> inter 2s fall 2 (4s detection), standard -> inter 10s fall 3 (30s detection). Dokumentuj: actual detection time vs configured.

Scenariusze Awarii (Failover Drills + Chaos): 1) Failover Test (monthly): kill primary PG (Patroni) -> observe: Patroni elect new leader (etcd), HAProxy HC detect (fall 3 * 5s = 15s), traffic switch -> measure actual RTO (target < 30s). 2) Split-brain Simulation: network partition (iptables drop inter-node traffic) -> verify: etcd quorum loss (minority partition steps down), Patroni demotes leader, fencing triggers (STONITH). 3) DB Failover Test: pgBackRest restore -> verify PITR consistency. 4) Network Failover: shut primary ISP link -> verify RouterOS/Cisco failover (check-gateway/IP SLA) -> measure RTO. 5) Documentation: runbook update z actual RTO/RPO, lessons learned, action items. Grade: based on runbook quality + actual RTO measurement + chaos experiment design.

Podsumowanie: HA = hands-on skill. Konfiguruj (HAProxy ACL/stick/HC), Testuj (kill, partition, measure), Dokumentuj (runbook, actual RTO/RPO), Automatyzuj (GitOps, CI/CD chaos). Grade = practical competence, nie theory quiz. Repo: GitHub Classroom / GitLab. Code review = part of grading. Peer review = learn from others.

Zadania praktyczne z tej części kursu mają na celu sprawdzenie umiejętności samodzielnego wdrażania i testowania systemów wysokiej dostępności. Państwa zadaniem będzie między innymi konfiguracja HAProxy z zaawansowanymi funkcjami takimi jak routing ACL, stick tables i różne typy health checków, a także przeprowadzenie scenariuszy awaryjnych w kontrolowany sposób. To sprawdzian nie tylko wiedzy teoretycznej, lecz przede wszystkim kompetencji praktycznych.

W ramach zadań przewidziano między innymi testy health checków z różnymi interwałami i progami, symulację awarii poprzez zabijanie węzłów primary i obserwację czasu failoveru oraz eksperymenty chaos symulujące partycje sieciowe i sprawdzające działanie quorum. Kluczowym elementem oceny jest dokumentacja: runbook opisujący procedury krok po kroku, zmierzone czasy rzeczywiste RTO i RPO oraz wnioski z przeprowadzonych eksperymentów. To droga od teorii do praktycznej kompetencji inżynierskiej.

Wyjaśnienie skrótów użytych na slajdzie:
VM – Virtual Machine – maszyna wirtualna; Środowisko zwirtualizowane wykorzystywane w laboratoriach do budowy klastrów wysokiej dostępności.
LXC – Linux Containers – kontenery systemowe Linux; Lekka platforma uruchamiania wielu instancji demonstracyjnych na jednym komputerze laboratoryjnym.
Docker – Docker container engine – silnik kontenerowy Docker; Platforma uruchamiania mikroserwisów podlegających równoważeniu obciążenia.
Nginx – Nginx reverse proxy – serwer Nginx; Narzędzie konfigurowane przez studentów w ćwiczeniach laboratoryjnych z load balancingu.
HAProxy – High Availability Proxy – oprogramowanie HAProxy; Platforma podlegająca praktycznej konfiguracji w scenariuszach failover.

44/55 Bezpieczeństwo load balancera
Bezpieczeństwo load balancera: Load balancer to brama wejściowa do infrastruktury - chroni ją przez ACL-i (whitelist/geo-block), rate limiting, WAF (OWASP CRS), ochronę przed atakami DDoS i terminację TLS/mTLS (cert-manager), a kompetencja K02 przypomina o etyce, poufności i odpowiedzialności.

Balancer to pierwsza linia obrony: stoi między światem a twoją infrastrukturą. Zbrojenie warstwami.

  • Pierwsza linia obrony – równoważnik obciążenia stanowi barierę chroniącą wewnętrzne serwery przed bezpośrednimi atakami z Internetu.
  • Zapory aplikacyjne WAF – badają treść zapytań HTTP, blokując próby wstrzykiwania kodu SQL oraz ataki skryptowe w przeglądarce.
  • Dyscyplina szyfrowania TLS – konfiguracja powinna wymuszać nowoczesne wersje protokołów i odrzucać przestarzałe algorytmy kryptograficzne.
  • Ograniczanie przepustowości – mechanizmy rate limiting chronią serwisy przed zablokowaniem przez natrętne boty i próby ataków brute-force.
  • Bezpieczeństwo interfejsów – porty administracyjne i panele statystyk muszą być bezwzględnie odcięte od publicznego dostępu w sieci.
WAF (OWASP CRS): Zapora aplikacji na balancerze; z ACL (whitelist/geo-block), rate limiting, anty-DDoS i terminacją TLS/mTLS (cert-manager).
ochrona LB

Jako punkt styku z publicznym Internetem load balancer stanowi cel bezpośrednich cyberataków. Wymagane jest wymuszenie protokołów TLS 1.2 i TLS 1.3 z kryptografią na krzywych eliptycznych i Perfect Forward Secrecy (PFS), konfiguracja mechanizmu SYN Cookies na poziomie jądra oraz integracja z modułem zapory aplikacyjnej WAF (ModSecurity) wykorzystującej zestaw reguł OWASP Core Rule Set do detekcji ataków typu SQL Injection i Cross-Site Scripting (XSS). Ochrona danych osobowych i odporność infrastruktury podlegają również audytom UODO.

Load balancer to front door do infrastruktury - pierwszy punkt kontaktu dla wszystkiego (użytkownicy, boty, ataki), a bezpieczny LB chroni backendy przed DDoS, bot traffic, exploit attempts, data exfiltration i unauthorized access. Zasady to ograniczenie dostępu (ACLs: IP whitelisting/blacklisting, geo-blocking, subnet filtering), rate limiting (request rate, connection rate, bandwidth), monitoring ataków (WAF: OWASP Top 10, SQLi, XSS, path traversal; DDoS protection; bot detection: fingerprinting, challenge-response, behavioral analysis), TLS/mTLS termination (Let's Encrypt automation, cert-manager, rotation, OCSP stapling, HSTS) oraz kompetencja K02 (etyka, poufność, odpowiedzialność - SRE jako strażnik bezpieczeństwa).

Ograniczenie Dostępu (Access Control): ACLs (Access Control Lists) - IP whitelisting (tylko corporate VPN / office IP), IP blacklisting (znane złośliwe IP: abuse.ch, Spamhaus, Emerging Threats), geo-blocking (blokada krajów: CN, RU, KP, IR - maxmind GeoIP), subnet filtering (CIDR ranges). HAProxy: acl blocked_src src -f /etc/haproxy/blocked_ips.lst; http-request deny if blocked_src. Nginx: deny 192.168.1.0/24; allow all; geo $blocked { default 0; 192.168.1.0/24 1; }; if ($blocked) { return 403; }. RBAC na LB admin: osobne konta, MFA, audit log, least privilege (read-only dla monitoring, admin dla config).

Rate Limiting (Ochrona przed abusem): Request Rate (req/s per IP/user) - HAProxy: http-request deny deny_status 429 if { sc_http_req_rate(0) gt 100 }; Nginx: limit_req_zone $binary_remote_addr zone=api:10m rate=10r/s; limit_req zone=api burst=20 nodelay. Connection Rate (conn/s) - HAProxy: stick-table type ip size 1m expire 30m store conn_rate(10s); http-request deny if { sc_conn_rate(0) gt 50 }. Bandwidth (bytes/s) - Nginx: limit_rate 1m; limit_rate_after 10m. DDoS Mitigation: cloud provider (AWS Shield, Cloudflare, GCP Cloud Armor) - volumetric attacks (UDP flood, SYN flood) absorbowane na edge. Application layer DDoS (HTTP flood) -> rate limiting + WAF + challenge (CAPTCHA/JS challenge).

Monitoring Ataków (WAF + DDoS + Bot Detection): WAF (Web Application Firewall) - OWASP Top 10 rules (SQLi, XSS, path traversal, command injection, RFI/LFI). ModSecurity (Nginx/Apache/HAProxy) + OWASP CRS (Core Rule Set) - open source. HAProxy: lua-waf / external WAF (ModSecurity + CRS via sidecar). Cloud WAF: AWS WAF, Cloudflare WAF, GCP Cloud Armor - managed rules, bot management, rate limiting. Bot Detection: fingerprinting (TLS JA3, HTTP headers, JS challenge), behavioral analysis (mouse movement, scroll, timing), challenge-response (CAPTCHA, JS challenge, Turnstile). DDoS Protection: volumetric (SYN flood, UDP flood, amplification) -> cloud scrubbing; protocol (TCP state exhaustion) -> SYN cookies, connection limits; application (HTTP flood) -> rate limit + WAF + challenge.

TLS/mTLS + Certificate Management: TLS Termination (LB) -> backend plaintext (trusted VPC) lub mTLS (LB -> backend mutual TLS). Cert Management: Let's Encrypt (ACME, cert-manager, auto-renewal 60d), cert-manager (K8s: Certificate/Issuer/ClusterIssuer, DNS01/HTTP01 challenge), rotation (pre-renewal 30d), OCSP Stapling (ssl_stapling on), HSTS (add_header Strict-Transport-Security "max-age=31536000" always). mTLS: client cert verification (ssl_verify_client on; ssl_client_certificate /etc/ssl/ca.crt; ssl_verify_depth 2) - zero trust dla service-to-service. Certificate Transparency monitoring (crt.sh, Facebook CT) -> alert na unauthorized certs.

Związek z K02 (Etyka, Poufność, Odpowiedzialność): K02 = kompetencje społeczne. Etyka: nie loguj PII w access logach (maskuj: IP -> hash, user_id -> pseudonym), nie używaj danych do profilowania bez zgody. Poufność: TLS 1.3 everywhere, mTLS dla service-to-service, cert rotation, HSTS, secure headers (CSP, X-Frame-Options, Referrer-Policy). Odpowiedzialność: SRE = strażnik bezpieczeństwa LB (patch management: CVE scanning, auto-update base images, dependency scanning), incident response (WAF alerts -> triage -> block/allow), compliance (GDPR Art. 32: security of processing, PCI-DSS: WAF requirement). Security by design = default secure.

Podsumowanie: LB Security = ACL (whitelist/geo-block) + Rate Limit (req/conn/bandwidth) + WAF (OWASP CRS) + DDoS (cloud scrubbing) + Bot Detection (fingerprint/challenge) + TLS/mTLS (cert-manager, rotation, OCSP, HSTS) + mTLS (zero trust). K02 = etyka (no PII logging), poufność (TLS everywhere), odpowiedzialność (SRE owns LB security). Security by design = default secure. Testuj: penetration test quarterly, WAF rule tuning monthly, cert expiry monitoring daily.

Load balancer pełni rolę pierwszego punktu kontaktu między zewnętrznym światem a naszą infrastrukturą - to przez niego przechodzi każdy request, zarówno od legalnych użytkowników, jak i od botów czy atakujących. Dlatego bezpieczeństwa load balancera nie można traktować marginalnie; to na nim spoczywa obowiązek filtrowania ruchu, kontroli szybkości żądań i wykrywania prób nadużyć, zanim dotrą do backendu. To swoista pierwsza linia obrony w architekturze HA.

Zabezpieczenia load balancera obejmują kilka warstw: ACLs do whitelistowania IP i geolokalizacji ruchu, rate limiting kontrolujący liczbę żądań na użytkownika lub adres, WAF oparty na regułach OWASP CRS chroniący przed typowymi atakami na aplikacje webowe, ochronę przed DDoS realizowaną przez cloud scrubbing oraz TLS termination z automatycznym zarządzaniem certyfikatami. Każdy z tych mechanizmów ma swoją konfigurację i tuning, a ich łączne wdrożenie tworzy kompleksową tarczę ochronną na styku sieci i aplikacji.

Wyjaśnienie skrótów użytych na slajdzie:
WAF – Web Application Firewall – zapora aplikacji internetowych; System bezpieczeństwa chroniący aplikacje za load balancerem przed atakami OWASP Top 10.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Protokół zapewniający poufność i integralność przesyłanych danych w sieci.
PFS – Perfect Forward Secrecy – doskonała poufność przekazywania; Właściwość kryptograficzna gwarantująca, że skompromitowanie klucza prywatnego nie pozwala na odszyfrowanie przeszłego ruchu.
CRS – OWASP Core Rule Set – podstawowy zestaw reguł OWASP; Ustandaryzowany zbiór reguł detekcji ataków aplikacyjnych dla silnika ModSecurity.
ModSecurity – ModSecurity Open Source WAF – otwarta zapora ModSecurity; Moduł zapory aplikacyjnej integrowany bezpośrednio z serwerem Nginx na load balancerze.

45/55 Najczęstsze błędy w HA
Najczęstsze błędy w HA: Trzy najczęstsze pomyłki: ignorowanie wysokiej dostępności bazy (opóźnienie replikacji, split-brain, nieprzetestowany restore), zbyt słabe health checki (sam TCP bez aktywnej weryfikacji) oraz rezygnacja z testów (próby failoveru, chaosu i DR) - nieprzetestowana HA nie jest HA.

Najdroższe awarie biorą się z zaniedbań: baza, ślepe checki i brak testów. Plan naprawczy: bazy, HC i drille.

  • Pozorna redundancja – utrzymywanie dwóch serwerów podłączonych do tego samego przełącznika lub listwy zasilania niweczy założenia HA.
  • Zbyt agresywne sondy – wysyłanie testów zdrowia co ułamek sekundy może samoistnie doprowadzić do przeciążenia i wyłączenia backendu.
  • Zaniedbanie testów failoveru – mechanizm przełączania, który nie był sprawdzany przez rok, z reguły zawodzi w trakcie prawdziwej awarii.
  • Niekontrolowany stan sesji – opieranie się na lokalnej pamięci serwerów uniemożliwia bezprzerwowe przełączanie ruchu w klastrze.
  • Brak procedur powrotu – plan awaryjny musi precyzować nie tylko przełączenie na zapas, lecz także bezpieczny powrót do stanu normalnego.
Nieprzetestowana HA nie jest HA: Ignorowanie bazy (lag, split-brain, restore), słabe checki (sam TCP) i brak prób failoveru/chaosu/DR - trzy grzechy główne.
błędy

W sytuacji częściowej awarii najgroźniejszym zjawiskiem są awarie kaskadowe szczegółowo omówione w podręczniku Google SRE: Addressing Cascading Failures. Wyłączenie jednego z trzech węzłów powoduje natychmiastowe obciążenie pozostałych o 50%, co może doprowadzić do ich przeciążenia i lawinowej niedostępności. Należy stosować wzorce odcinania obciążenia (Circuit Breaker), zrzucanie ruchu nadmiarowego (Load Shedding) oraz wymuszenie opóźnień z losowym rozrzutem (Exponential Backoff with Jitter) w ponawianiu zapytań przez klientów.

Najczęstsze błędy w implementacji HA to anti-patterns, które kosztują przestoje, utratę danych i reputację: zapominanie o bazie danych (replication lag, split-brain, nieprzetestowane backup/restore, brak PITR), słabe health checki (tylko TCP, brak application-level checks, brak timeoutów, brak active HC) i brak regularnych testów (failover drills, chaos engineering, DR drills). To Lessons Learned skompresowane do trzech krytycznych kategorii.

Zapominanie o bazie danych (Database HA = Hardest Part): Replication lag (async replication -> sekundy/minuty opóźnienia -> RPO violation, stale reads) -> monitoring: replication_lag_seconds (Patroni/Galera/pg_stat_replication), alert > 1s/10s/60s. Split-brain (dwa primary -> data corruption) -> prevention: quorum (Patroni+etcd/Consul, Galera), fencing (STONITH), consensus (Raft/Paxos). Backup/Restore nieprzetestowane -> "mamy backup" ale restore nie działa (corrupt, missing WAL, wrong version, permission issues) -> mandatory: monthly restore drill (PITR test), document actual RTO/RPO. Connection pooling (PgBouncer) bez HA -> single point -> deploy PgBouncer per app pod / HA PgBouncer (consul/vip). Schema migrations bez backward compatibility -> downtime -> expand/contract pattern, dual-write, feature flags.

Słabe Health Checki (HC = Eyes of HA): Tylko TCP check (port open != aplikacja działa) -> aplikacja może być: frozen (deadlock), OOM killed (process alive ale nie odpowiada), maintenance mode, DB connection pool exhausted, config error. Brak application-level checks (HTTP /health z sprawdzeniem: DB connectivity, Redis connectivity, disk space, dependency services, queue depth) -> false positive UP. Brak timeoutów (connect timeout, read timeout, send timeout) -> HC zawieszony -> backend stuck w UP. Brak active HC (tylko passive: proxy_next_upstream) -> pierwszy user cierpi -> detection time = user impact. Inter/rise/fall tuning: default (inter 2s rise 2 fall 3 = 6s) vs production (inter 5s rise 2 fall 3 = 15s) vs critical (inter 2s fall 2 = 4s). Agent checks dla złożonej logiki (replication lag, custom business logic).

Brak Regularnych Testów (Hope Is Not a Strategy): Failover Drills (monthly): kill primary -> measure actual RTO -> compare z target -> document -> improve. Chaos Engineering (weekly/bi-weekly): network partition, pod kill, latency injection, disk fill -> verify steady state -> fix gaps. DR Drills (quarterly): full site failover -> restore from backup -> validate data -> measure actual RTO/RPO -> update runbook. Game Days (semi-annually): team exercise z runbookami, retrospektywa, action items. Tabletop Exercises (quarterly): scenariusz (ransomware, region loss, split-brain) -> dyskusja -> action items. Brak testów = nieznane unknown unknowns -> surprise w produkcji. Testuj to, na czym zależy życie biznesu.

Dodatkowe błędy (Bonus): Configuration Drift (node A != node B) -> failover breaks -> IaC + GitOps + compliance scanning (config drift detection). Capacity Headroom (brak rezerwy) -> failover overload -> cascade failure -> 30% headroom minimum. Single Point of Failure w HA stacku (LB nie redundantny, VIP single, etcd 1 node) -> audit HA architecture quarterly. Documentation Gap (brak runbooków, stale runbooki) -> on-call nie wie co robić -> runbook per scenariusz, update po każdym incydencie/drillu. Monitoring Gaps (brak alertu na: replication lag, VIP flip, split-brain, backup failure) -> alert fatigue vs missing alerts -> alert tuning continuous.

Podsumowanie: Top 3 błędy: 1) Database HA ignored (lag, split-brain, untested restore), 2) Weak HC (TCP only, no timeouts, passive only), 3) No testing (failover drills, chaos, DR drills). Fix: Database HA first (Patroni/Galera, tested PITR), Active HC everywhere (HTTP + timeout + active), Test monthly (failover, chaos, DR). HA = continuous practice, not one-time setup. "Untested HA = no HA".

W dotychczasowej części wykładu poznaliśmy architektury HA i narzędzia do ich realizacji. Zanim jednak przejdziemy do podsumowania i dalszych zagadnień, warto zatrzymać się nad tym, co w praktyce psuje najlepsze nawet projekty. Doświadczenia z setek produkcyjnych środowisk wskazują, że awarie wynikają nie tyle z braku wiedzy, co z zaniedbań w kilku kluczowych obszarach.

Najpoważniejsze błędy dotyczą bazy danych, która pozostaje najtrudniejszym elementem HA: asynchroniczna replikacja powoduje opóźnienia, split-brain grozi korupcją stanu, a nieprzetestowane kopie zapasowe dają fałszywe poczucie bezpieczeństwa. Druga kategoria to słabe health checki, ograniczające się do sprawdzenia portu TCP zamiast weryfikować stan aplikacji. Trzecia to brak regularnych testów - failover drill i eksperymenty chaosu powinny być stałym elementem kalendarza operacyjnego zespołu.

Wyjaśnienie skrótów użytych na slajdzie:
Cascading – Cascading Failure – awaria kaskadowa; Efekt domina, w którym awaria jednego serwera powoduje natychmiastowe przeciążenie i pad kolejnych maszyn.
Backoff – Exponential Backoff – wykładnicze opóźnienie ponawiania; Algorytm zapobiegający zalaniu systemu przez ponawiane automatycznie żądania klientów.
Jitter – Randomized Delay / Jitter – losowy rozrzut czasowy; Wprowadzenie losowości do interwałów ponawiania żądań w celu rozbicia fal ruchu.
ThunderingHerd – Thundering Herd Problem – problem gromadnego stada; Zjawisko jednoczesnego uderzenia tysięcy procesów po zasób po restarcie serwera pamięci podręcznej.
CircuitBreaker – Circuit Breaker Pattern – wzorzec bezpiecznika; Mechanizm architektoniczny natychmiast odcinający zapytania do uszkodzonego komponentu w celu ratowania reszty systemu.

46/55 Skalowanie poziome vs pionowe
Skalowanie poziome vs pionowe: Horizontal (scale out) = HA enabler, stateless. Vertical (scale up) = prostota, stateful, SPOF risk. Auto-scaling: HPA, VPA, Cluster Autoscaler.

Poziomo czy pionowo? Dla HA poziomo: pad repliki to ułamek mocy, nie całość. Pionowo tylko tam, gdzie musisz.

  • Skalowanie pionowe (Scale Up) – polega na dodawaniu procesorów i pamięci do istniejącej maszyny, osiągając szybko fizyczne granice.
  • Skalowanie poziome (Scale Out) – polega na dokładaniu kolejnych niezależnych serwerów pod balanserem, zapewniając nieograniczony wzrost.
  • Odporność na awarie – awaria pojedynczej maszyny w modelu poziomym jest nieszkodliwa, podczas gdy upadek wielkiego serwera paraliżuje firmę.
  • Ekonomia chmury – elastyczne uruchamianie tanich instancji wirtualnych na czas szczytów ruchu pozwala zaoszczędzić znaczne środki.
  • Konieczność bezstanowości – pełne wykorzystanie zalet skalowania poziomego wymaga dostosowania architektury samego oprogramowania.
HPA/VPA: Poziome i pionowe automatyczne skalowanie w Kubernetesie (z Cluster Autoscaler); scale out dla bezstanowych, scale up - prosty, lecz z ryzykiem SPOF.
skalowanie

Skalowanie poziome (dodawanie instancji/replik) vs pionowe (powiększanie istniejących: więcej CPU/RAM/dysku) to fundamentalna decyzja architektoniczna scale out vs scale up: horizontal daje lepszą HA (awaria jednej instancji nie zabija usługi) przy liniowym koszcie (commodity hardware/cloud instances), vertical to single point of failure (większa maszyna = większy blast radius) przy wykładniczym koszcie (enterprise hardware). Limity definiują Amdahl's Law, kontencja zasobów, NUMA i cache coherence; auto-scaling to HPA/VPA w K8s, ASG w AWS, MIG w GCP i VMSS w Azure.

Skalowanie Poziome (Horizontal Scaling / Scale Out): Dodawanie replik (instances, pods, containers) za Load Balancerem. Zalety: HA naturalna (awaria 1 z N = (N-1)/N pojemności, usługa działa), commodity hardware (tanie, dostępne, cloud instances), elastyczność (scale up/down w minutach), blast radius kontrolowany (max 1/N loss), stateless apps = trivial (dodaj replica). Wady: aplikacja musi być stateless (session/state w external store: Redis, DB, S3), overhead orkiestracji (k8s, LB, service discovery), data consistency (distributed consensus, eventual consistency), koszty licencji (per-core/per-socket). Use case: web tier, API tier, microservices, stateless workers.

Skalowanie Pionowe (Vertical Scaling / Scale Up): Powiększanie istniejących instancji (CPU, RAM, dysk, NVMe). Zalety: prostota (jedna instancja, brak zmiany architektury), stateful apps (baza danych, cache, message queue - często łatwiej powiększyć niż shardować), licencjonowanie (per-instance), mniejszy overhead operacyjny (jedna VM/container). Wady: Single Point of Failure (awaria = 100% downtime), limity sprzętowe (max CPU/RAM/dysk na VM/bare metal), wykładniczy koszt (large instances $$$$), downtime przy resize (zazwyczaj reboot), NUMA/CPU cache coherence overhead przy dużych sockelach. Use case: baza danych (single writer), cache (Redis single-threaded), legacy apps, ML training (GPU).

Amdahl's Law i Limity: Amdahl's Law: Speedup = 1 / ((1 - P) + P/N), gdzie P = parallelizowalna część, N = liczba procesorów. Jeśli 10% kodu jest serialne (P=0.9), max speedup = 10x (nawet przy nieskończonych CPU). Contencja: lock contention, cache coherence traffic, memory bandwidth saturation, NUMA remote memory access. Konteneryzacja pomaga (resource limits, cgroups), ale nie eliminuje fundamentalnych limitów. Blast Radius: vertical scaling = bigger blast radius (1 failure = 100% loss), horizontal = smaller (1/N loss).

Auto-scaling (Automatyzacja): HPA (Horizontal Pod Autoscaler) - skaluje replicas Deployment na podstawie: CPU utilization (target 70%), memory, custom metrics (Prometheus Adapter: http_requests_per_second, queue_depth, latency). VPA (Vertical Pod Autoscaler) - zaleca/ustawia resource requests/limits (Off/Initial/Auto/Recreate) - dobre dla "right-sizing", nie dla HA scaling. Cluster Autoscaler - skaluje node pool (AWS ASG, GCP MIG, Azure VMSS) na podstawie pending Pods (unschedulable -> scale up) i low utilization (scale down). Trzy poziomy: Pod (HPA/VPA) + Node (Cluster Autoscaler) = full elastic stack. Horizontal = primary HA scaling, Vertical = right-sizing/cost optimization.

Podsumowanie: Horizontal scaling = HA enabler (stateless), Vertical scaling = cost optimization/stateful necessity. Horizontal = primary dla web/API/microservices (HA + elasticity). Vertical = dla DB/cache/legacy (stateful) + right-sizing (VPA). Amdahl's Law = limity parallelizacji. Blast radius = horizontal wins. Auto-scaling = HPA (horizontal) + VPA (right-sizing) + Cluster Autoscaler (nodes) = full elastic. Design for horizontal, use vertical sparingly.

Przechodzimy teraz do zagadnienia skalowalności, które łączy się ściśle z koncepcją wysokiej dostępności. Wybór między skalowaniem poziomym a pionowym to fundamentalna decyzja architektoniczna, która bezpośrednio wpływa na to, jak system zachowa się w obliczu awarii pojedynczego komponentu i jak duży będzie promień rażenia. Rozumienie tego związku jest kluczowe dla świadomego projektowania infrastruktury.

Skalowanie poziome, czyli dodawanie kolejnych instancji za load balancerem, jest naturalnym wzmocnieniem HA: awaria jednej repliki oznacza utratę jedynie ułamka pojemności, a aplikacje stateless skalują się trivialnie. Skalowanie pionowe - powiększanie istniejącej maszyny - bywa konieczne dla baz danych czy cache, ale tworzy pojedynczy punkt awarii o promieniu rażenia stu procent. W Kubernetes mechanizmy HPA, VPA i Cluster Autoscaler automatyzują elastyczne dostosowywanie pojemności do aktualnego zapotrzebowania ruchu.

Wyjaśnienie skrótów użytych na slajdzie:
Scale-Up – Vertical Scaling – skalowanie pionowe; Zwiększanie mocy pojedynczej maszyny poprzez dodawanie rdzeni CPU i pamięci RAM; ograniczone barierą sprzętową.
Scale-Out – Horizontal Scaling – skalowanie poziome; Zwiększanie wydajności systemu poprzez dodawanie kolejnych tanich maszyn pracujących równolegle za load balancerem.
CAPEX – Capital Expenditure – wydatki inwestycyjne; Wysokie koszty zakupu wielkich serwerów w skalowaniu pionowym w porównaniu do skalowania poziomego.
OPEX – Operational Expenditure – koszty operacyjne; Bieżące wydatki na infrastrukturę elastycznie optymalizowane w architekturze horyzontalnej.
Stateless – Stateless Architecture – architektura bezstanowa; Projekt systemu eliminujący przechowywanie stanu na serwerze aplikacyjnym, co umożliwia nieskończone skalowanie poziome.

47/55 Przykład: Nginx + HAProxy + Docker
Nginx + HAProxy + Docker: Kompletny stack: Nginx realizuje terminację TLS, caching i WAF, HAProxy odpowiada za zaawansowane routowanie, aktywne health checki i stick tables, a Docker Compose za orkiestrację - ćwiczenie obejmuje wdrożenie, test failoveru i pomiar metryk.

Teoria w stos: Nginx (treści), HAProxy (ruch) i Compose (orkiestracja) w jednym labie - od deployu po chaos.

  • Kompletny stos technologiczny – połączenie Nginx na brzegu, klastra HAProxy i kontenerów Docker tworzy wzorcową architekturę produkcyjną.
  • Podział odpowiedzialności – Nginx odpowiada za szyfrowanie i pliki statyczne, a HAProxy precyzyjnie równoważy wywołania API aplikacji.
  • Automatyzacja wdrożenia – cały ekosystem może być zdefiniowany deklaratywnie w plikach konfiguracyjnych i wersjonowany w Git.
  • Ciągły nadzór – zintegrowane punkty telemetryczne przesyłają metryki do Prometheusa, dając pełen obraz obciążenia w Grafanie.
  • Skalowalność rozwiązania – wzorzec ten z powodzeniem obsługuje platformy internetowe przetwarzające miliony zapytań na dobę.
Podział ról w stosie: Nginx (TLS, cache, WAF), HAProxy (routing, HC, stick tables), Docker Compose (orkiestracja); ćwiczenie z failoverem i metrykami.
pełny schemat

Kompletna architektura HA łączy Nginx (frontend LB: SSL termination, caching, rate limiting, WAF, static files), HAProxy (backend LB: L7 routing, active HC, stick tables, ACLs, metryki) i Docker Compose (orkiestracja kontenerów: services, networks, volumes, healthchecks, restart policies) - end-to-end HA stack w single-host (Docker Compose) lub multi-host (Docker Swarm / Kubernetes) do przećwiczenia na laboratoriach, z microservices architecture i sidecar pattern.

Nginx (Frontend LB - Port 80/443): Rola: SSL termination (Let's Encrypt / cert-manager, OCSP stapling, HSTS), caching (proxy_cache, stale-while-revalidate=30s, stale-if-error=1h - offload 90% static), rate limiting (limit_req_zone $binary_remote_addr zone=api:10m rate=10r/s; burst=20), WAF (ModSecurity + OWASP CRS), static files (sendfile, gzip_static, expires). Config: upstream haproxy_backend { server haproxy:8080; keepalive 32; }; server { listen 80; listen 443 ssl; location / { proxy_pass http://haproxy_backend; proxy_cache my_cache; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_http_version 1.1; proxy_set_header Connection ""; } }. Healthcheck: nginx -t, curl -I https://localhost/health.

HAProxy (Backend LB - Port 8080/8443): Rola: L7 routing (ACL: path_beg /api -> api_backend, path_beg /admin -> admin_backend), active HC (option httpchk GET /health, inter 5s rise 2 fall 3), stick tables (persistence: stick on src, rate limiting: http_req_rate(10s) > 100 -> deny), metryki (haproxy_exporter -> Prometheus -> Grafana -> alerting). Config: frontend http-in { bind *:8080; mode http; acl is_api path_beg /api; use_backend api_backend if is_api; default_backend web_backend; }; backend api_backend { balance leastconn; option httpchk GET /health; server api1 api:8000 check inter 5s rise 2 fall 3; server api2 api:8000 check inter 5s rise 2 fall 3 backup; }. Healthcheck: haproxy -c -f cfg, echo "show stat" | socat /var/run/haproxy.sock stdio.

Docker Compose (Orkiestracja): version: '3.8'; services: nginx: { image: nginx:alpine; ports: ["80:80","443:443"]; volumes: [./nginx:/etc/nginx, ./certs:/etc/nginx/certs]; depends_on: [haproxy]; restart: unless-stopped; healthcheck: { test: ["CMD", "wget", "-q", "--spider", "http://localhost/health"]; interval: 30s; timeout: 10s; retries: 3; } }; haproxy: { image: haproxy:2.8; ports: ["8080:8080"]; volumes: [./haproxy:/usr/local/etc/haproxy]; restart: unless-stopped; healthcheck: { test: ["CMD", "haproxy", "-c", "-f", "/usr/local/etc/haproxy/haproxy.cfg"]; interval: 30s; timeout: 10s; retries: 3; } }; app: { build: ./app; deploy: { replicas: 3; resources: { limits: { cpus: '0.5', memory: 512M } }; restart_policy: { condition: on-failure; max_attempts: 3 } }; depends_on: [redis]; healthcheck: { test: ["CMD", "curl", "-f", "http://localhost:8000/health"]; interval: 30s; timeout: 10s; retries: 3; } }; redis: { image: redis:7-alpine; volumes: [redis_data:/data]; healthcheck: { test: ["CMD", "redis-cli", "ping"]; interval: 10s; timeout: 5s; retries: 3; } }; volumes: { redis_data: }. Deploy: docker compose up -d --build; docker compose ps; docker compose logs -f.

Hands-on Lab (Do przećwiczenia): 1) Deploy stack: docker compose up -d --build. 2) Baseline test: curl -I https://localhost/health, wrk -t4 -c100 -d30s https://localhost/api/health. 3) Failover test: docker compose kill haproxy -> observe Nginx passive HC (proxy_next_upstream) -> traffic to backup? 4) Scale test: docker compose up --scale app=5 -> observe HAProxy stick tables (rate limiting). 5) Chaos: docker compose kill app (1 replica) -> observe HPA? (Compose nie ma HPA, ale restart policy). 6) Logs: docker compose logs -f nginx haproxy app. 7) Metrics: curl localhost:9101/metrics (haproxy_exporter), curl localhost:9113/metrics (nginx_exporter). Grade: working stack + failover test + metrics + documentation.

Podsumowanie: Nginx (frontend: SSL, cache, rate limit, WAF) + HAProxy (backend: routing, active HC, stick tables, metrics) + Docker Compose (orchestration: healthchecks, restart, scaling) = kompletny HA stack do nauki. Single-host (Compose) -> multi-host (Swarm: docker stack deploy) -> Kubernetes (kubectl apply). To architektura referencyjna do nauki i małych produkcji. Grade: working stack + failover test + metrics + runbook.

Po omówieniu teorii, błędów i zagadnień skalowania warto zobaczyć, jak wszystkie te elementy składają się w konkretny, działający stos technologiczny. Na tym wykładzie zbudujemy architekturę referencyjną z trzech komplementarnych narzędzi, z których każde przejmuje odrębny zestaw odpowiedzialności w łańcuchu żądań od klienta końcowego aż do aplikacji backendowej.

Nginx pełni rolę frontend load balancera: terminuje TLS, buforuje odpowiedzi, nakłada limity szybkości i filtruje ruch przez WAF. Za nim znajduje się HAProxy realizujący zaawansowane routowanie L7, aktywne health checki i tabele persystencji sesji. Całość zarządzana jest przez Docker Compose z definiowanymi politykami restartu, health checków i skalowania replik - kompletne środowisko do ćwiczeń laboratoryjnych, od initial deployu po test failoveru i eksperyment chaosu.

Wyjaśnienie skrótów użytych na slajdzie:
Docker – Docker platform – platforma konteneryzacji; Środowisko uruchomieniowe prezentujące w studium przypadku integrację stosu wysokiej dostępności.
Nginx – Nginx web server – serwer Nginx; Komponent brzegowy pełniący funkcję reverse proxy i terminacji SSL w środowisku demonstracyjnym.
HAProxy – HAProxy load balancer – load balancer HAProxy; Komponent odpowiadający za dystrybucję ruchu TCP/HTTP pomiędzy kontenery robocze.
Port – TCP/UDP Network Port – port sieciowy; Logiczny punkt końcowy komunikacji mapowany pomiędzy kontenerami a stacją roboczą.
Host – Host Operating System – system operacyjny gospodarza; Fizyczny lub wirtualny serwer udostępniający zasoby dla uruchomionych kontenerów.

48/55 Monitorowanie i alert o awarii
Monitorowanie i alert o awarii: Alert łączy metrykę z konkretnym działaniem - polityka eskalacji L1→L2→L3 wraz z automatycznym failoverem na poziomie infrastruktury i automatyzacją runbooków skraca czas do przywrócenia usługi (MTTR); szczegóły omówi wykład szósty.

Redundancja bez alertów to połowa sukcesu: wykryj szybko, eskaluj mądrze, naprawiaj automatycznie.

  • Szybka detekcja – monitoring musi zaalarmować dyżurnego inżyniera natychmiast po wykryciu nieprawidłowości w działaniu klastra.
  • Powiadomienia o degradacji – spadek liczby dostępnych backendów poniżej bezpiecznego progu powinien wszcząć procedurę ostrzegawczą.
  • Wielokanałowy alerting – powiadomienia o incydentach krytycznych powinny być wysyłane równolegle na komunikatory i telefon dyżurnego.
  • Kontekst w powiadomieniu – każdy alert musi precyzyjnie wskazywać nazwę klastra, uszkodzony komponent oraz odnośnik do runbooka.
  • Automatyczna reakcja – skrypty naprawcze mogą podjąć próbę restartu kontenera zanim dyżurny inżynier otworzy konsolę komputera.
Eskalacja L1→L2→L3: Polityka przekazywania alertu kolejnym poziomom wsparcia; z automatycznym failoverem i runbookami skraca MTTR (ciąg dalszy w wykładzie 6).
od awarii do alertu

Monitoring i alerting to most między wykryciem problemu (metryki/logi) a ludzką interwencją (on-call) lub automatyczną akcją (auto-failover, runbook automation) w systemach HA: routing alertów (critical/warning, escalation policy, on-call rotation, notification channels: Slack, Email, PagerDuty, OpsGenie, Webhook, Telegram, Discord, Microsoft Teams, VictorOps) i automatyzacja (failover automation: HAProxy/keepalived/Pacemaker; runbook automation: Ansible/Terraform/GitOps triggered by alert). Alertmanager (wykład 6) dodaje routing tree, grouping, inhibition, silencing, receivers i templates.

Alert do Zespołu (Alert Routing + Escalation): Routing Tree (Alertmanager): receiver (Slack #critical-alerts, Email on-call, PagerDuty), group_by (alertname, cluster, service), group_wait (30s - wait for similar alerts), group_interval (5m - repeat notification), repeat_interval (4h - remind). Escalation Policy: Level 1 (on-call primary, 5min ack) -> Level 2 (on-call secondary + team lead, 15min) -> Level 3 (manager + all hands, 30min). Notification Channels: Slack (rich formatting, threads, actions), Email (detailed, audit trail), PagerDuty/OpsGenie (on-call scheduling, escalation, acknowledgment, conference bridge), Webhook (custom integration: Jira ticket, ServiceNow, custom bot), Telegram/Discord/Teams (team communication), VictorOps/Splunk On-Call (enterprise). Templates: {{ .CommonAnnotations.summary }}, {{ .Labels.instance }}, runbook_url.

Automatyczne Przełączenie (Auto-Failover + Runbook Automation): Failover Automation (Infrastructure-level): HAProxy/keepalived/Pacemaker auto (health check -> failover -> VIP move) - bez ludzkiej interwencji, RTO ~seconds. DNS Failover (Route53/CloudDNS health checks -> DNS record update) - RTO ~TTL (60s). Cloud LB (AWS ALB/NLB, GCP LB, Azure LB) - managed auto-failover, health checks built-in. Runbook Automation (Application/Platform-level): Ansible Playbook triggered by Alertmanager webhook (auto-restart service, scale replicas, flip feature flag, drain node). Terraform/Ansible/GitOps (ArgoCD/Flux) - desired state reconciliation (auto-remediation: desired replicas=3, actual=2 -> reconcile). Rundeck/AWX/Automation Controller - workflow execution (approval gates, audit trail). Auto-remediation = reduce MTTR (human = slow, error-prone), ale wymaga: safety gates (blast radius, approval), idempotency, rollback plan.

Wstęp do Wykładu 6 (Alertmanager Deep Dive): Alertmanager (Prometheus ecosystem) - deduplication, grouping, routing, inhibition, silencing. Routing Tree: route -> receiver -> group_by -> group_wait/interval/repeat. Inhibition Rules: critical silences warning (np. DB down -> milcz app errors). Silences: maintenance windows, deployments, known issues. Receivers: Slack, Email, PagerDuty, OpsGenie, Webhook, Telegram, Discord, Teams, VictorOps, WeChat, Pulsar. Templates: Go templates ({{ .CommonAnnotations.summary }}, {{ .Labels }}, runbook_url). High Availability: Alertmanager cluster (3+ nodes, gossip protocol, shared silences). Integration: Prometheus -> Alertmanager -> Receivers -> On-call. Wykład 6 = deep dive w Alertmanager config, routing, templates, HA, inhibition, silencing, templates, testing.

Podsumowanie: Alerting = bridge metrics/logs -> action. Routing + Escalation = right person, right time. Auto-failover (infra) + Runbook Automation (platform) = reduce MTTR. Alertmanager = central alert router (dedup, group, route, inhibit, silence). Wykład 6 = Alertmanager mastery. Actionable alerts only (jeśli alert nie wymaga akcji -> usuń). On-call = sustainable (rotation, escalation, compensation).

Dotychczas poznaliśmy mechanizmy zapobiegania awariom i utrzymania ciągłości usług, od redundancji infrastruktury po zaawansowane konfiguracje load balancerów. Jednak samo wdrożenie redundantnej infrastruktury to dopiero połowa sukcesu - równie ważna jest zdolność do szybkiego wykrywania problemów i kierowania działań naprawczych do właściwych osób we właściwym czasie.

Skuteczny alerting opiera się na polityce eskalacji: poziom pierwszy trafia do dyżurnego z pięciominutowym czasem na potwierdzenie, poziom drugi - do przełożonego po piętnastu minutach, trzeci zaś uruchamia zarządzanie kryzysowe po pół godzinie. Automatyczny failover na poziomie infrastruktury oraz uruchamianie runbooków przez platformę znacząco skracają czas przywrócenia usługi. Szczegółowa konfiguracja Alertmanagera będzie przedmiotem przyszłego wykładu.

Wyjaśnienie skrótów użytych na slajdzie:
PromQL – Prometheus Query Language – język zapytań Prometheus; Język formułowania reguł alarmowych wykrywających spadek liczby aktywnych węzłów w klastrze.
AM – Alertmanager – menedżer alertów Prometheus; Podsystem powiadomień natychmiast wysyłający sygnał o przełączeniu adresu VIP na węzeł zapasowy.
Pager – PagerDuty / On-call notification – system powiadamiania dyżurnego; Urządzenie alarmowe inżyniera SRE informujące o degradacji redundancji w klastrze produkcyjnym.
SMS – Short Message Service – krótka wiadomość tekstowa; Zapasowy kanał powiadomień używany w przypadku krytycznych awarii węzłów brzegowych.
Webhook – HTTP Webhook – zwrotne wywołanie sieciowe; Mechanizm integracji alertów z systemami zarządzania incydentami i komunikatorami.

49/55 Koszty wysokiej dostępności
Koszty wysokiej dostępności: HA to swoista polisa ubezpieczeniowa - zawsze porównujemy koszt przestoju z kosztem infrastruktury (99.9%=$, 99.99%=$$, 99.999%=$$$$), pamiętając, że krzywa kosztów rośnie wykładniczo, dlatego decyzję warto poprzeć analizą zwrotu z inwestycji (ROI).

HA to polisa: porównujesz składkę (infrastruktura) z ryzykiem (przestój). Wykładnicza krzywa wyznacza sweet spot.

  • Inwestycja a ryzyko – budżet przeznaczany na wysoką dostępność musi być proporcjonalny do strat wywołanych potencjalnym przestojem.
  • Koszty nadmiarowości – utrzymywanie podwojonej infrastruktury w trybie pasywnym generuje koszty, które warto optymalizować.
  • Model chmurowy – wykorzystanie usług zarządzanych zdejmuje z firmy konieczność zakupu i amortyzacji drogich urządzeń fizycznych.
  • Kultura FinOps – inżynierowie powinni regularnie analizować rachunki chmurowe, eliminując nieużywane instancje i przewymiarowane zasoby.
  • Świadomy kompromis – biznes musi zaakceptować, że osiągnięcie absolutnej bezawaryjności jest niemożliwe i ekonomicznie nieuzasadnione.
ROI dostępności: Zwrot z inwestycji jako uzasadnienie wydatków na HA; polisa ubezpieczeniowa 99,9%=$, 99,99%=$$, 99,999%=$$$$ przy wykładniczej krzywej kosztów.
koszty HA

Koszty wysokiej dostępności to analiza kosztów i korzyści (cost-benefit analysis): każda dodatkowa dziewiątka dostępności kosztuje wykładniczo więcej (tier: 99.9% vs 99.99% vs 99.999% - cost vs risk, infrastructure cost, operational cost). Uzasadnienie biznesowe to cost of downtime vs cost of HA infrastructure (revenue loss/hour, SLA penalties, reputation damage, customer churn vs CAPEX/OPEX, engineering time), a zależność RTO/RPO vs cost rośnie (sync replication, multi-region, active-active, geo-redundancy - im niższe RTO/RPO, tym drożej). To decyzja biznesowa, nie techniczna (TCO, ROI).

Dobór Poziomu HA (Tier Selection): 99.9% (three nines) - 8h 45m downtime/year. Infrastructure: N+1 redundancy, single AZ, basic LB, async DB replication, daily backup. Cost: $ (baseline). Use case: internal tools, dev/staging, non-critical web. 99.99% (four nines) - 52m downtime/year. Infrastructure: active-passive (VRRP/keepalived/Pacemaker), multi-AZ, sync DB replication (RPO~0), warm standby DR, automated failover, chaos engineering. Cost: $$ (2-3x baseline). Use case: e-commerce, SaaS, customer-facing APIs. 99.999% (five nines) - 5m 15s downtime/year. Infrastructure: active-active (anycast/ECMP/cloud LB), multi-region, synchronous multi-master DB (Galera/Patroni sync), hot standby DR (RTO~min), full chaos engineering, 24/7 on-call with SLA. Cost: $$$$ (10-20x baseline). Use case: financial core, trading, healthcare critical, telco. 99.9999% (six nines) - 31s downtime/year - extreme, rarely justified (spacecraft, nuclear).

Uzasadnienie Biznesowa (Cost of Downtime vs Cost of HA): Cost of Downtime = Revenue Loss/hour + SLA Penalties + Reputation Damage (customer churn, brand) + Recovery Cost (engineering overtime, incident response, legal/compliance). Przykład: E-commerce $1M/h revenue. Downtime cost ~ $1.5M/h (revenue + penalties + churn). 99.9% (8.75h/yr) -> expected loss = $13M/yr. 99.99% (0.87h/yr) -> expected loss = $1.3M/yr + HA infra cost $500k/yr = $1.8M/yr. Savings = $11.2M/yr. ROI = 22x. Dla systemów wewnętrznych (HR, wiki): revenue loss = 0, cost of downtime = productivity loss (~$10k/h). 99.9% OK. Cost of HA Infrastructure: CAPEX (hardware, licenses) + OPEX (cloud, engineering, monitoring, testing, on-call, licensing). TCO = 3-5 lat. ROI = (Cost of Downtime avoided - Cost of HA) / Cost of HA. Business Case = dokumentacja dla managementu.

RTO/RPO vs Cost (Cost Curve): Wykres: Oś X = RTO/RPO (malejące -> bardziej agresywne), Oś Y = Cost (rosnąca wykładniczo). RTO=24h/RPO=24h (cold backup) = $ (storage only). RTO=4h/RPO=1h (warm pilot light) = $$ (10-30% prod infra). RTO=15min/RPO=1min (warm standby) = $$$ (30-50% prod infra). RTO=0/RPO=0 (hot active-active multi-region) = $$$$ (100-200% prod infra). Prawo malejących zwrotów: każda kolejna "dziewiątka" kosztuje 2-10x więcej. Sweet spot = business-driven (cost of downtime curve crosses cost of HA curve).

Podsumowanie: HA = insurance policy. Cost of Downtime (revenue + SLA + reputation) vs Cost of HA (infra + engineering + on-call). Tier selection = business decision (99.9% vs 99.99% vs 99.999%). Cost curve = wykładnicza. ROI = (downtime cost avoided - HA cost) / HA cost. Document business case. Review quarterly (business changes, traffic changes, risk profile changes). "Hope is not a strategy - budget is".

Zagadnienie kosztów wysokiej dostępności nie jest czysto techniczne - to przede wszystkim decyzja biznesowa, w której trzeba zestawić cenę potencjalnych przestojów z nakładami na infrastrukturę zapasową. Każda dodatkowa dziewiątka dostępności kosztuje wykładniczo więcej, a zysk z kolejnych inwestycji maleje zgodnie z prawem malejących zwrotów, co wymaga świadomego podejścia do planowania.

System o dostępności 99,9 procent dopuszcza ponad osiem godzin przestoju rocznie i wymaga podstawowej redundancji. Cztery dziewiątki ograniczają ten czas do niecałej godziny i wymagają synchronicznej replikacji bazy danych. Pięć dziewiątek to zaledwie pięć minut rocznie i pełna redundancja aktywno-aktywna w wielu regionach. Kluczową miarą opłacalności jest stosunek kosztów przestoju do kosztów infrastruktury HA.

Wyjaśnienie skrótów użytych na slajdzie:
TCO – Total Cost of Ownership – całkowity koszt posiadania; Łączny bilans nakładów na infrastrukturę HA, licencje, łącza światłowodowe i personel dyżurny.
CAPEX – Capital Expenditure – nakłady inwestycyjne; Koszty zakupu redundantnych przełączników, serwerów i agregatów prądotwórczych.
OPEX – Operational Expenditure – wydatki operacyjne; Miesięczne koszty utrzymania rezerwowych serwerowni i redundancji w chmurze obliczeniowej.
99.99 – Four Nines Availability – dostępność na poziomie czterech dziewiątek; Poziom niezawodności dopuszczający jedynie 52 minuty przestoju w skali całego roku.
ROI – Return on Investment – zwrot z inwestycji; Wskaźnik opłacalności wdrożenia mechanizmów HA zabezpieczających przed wielomilionowymi stratami z tytułu przestoju.

50/55 Materiały i literatura (HA)
Materiały i literatura: Kuratorska biblioteka źródeł: HAProxy docs, Nginx docs, keepalived, Patroni, Chaos Mesh, Kubernetes HA, DR/BCP. Wszystkie linki zweryfikowane (HTTPS, aktualne).

Szeroki temat, więc czytaj u źródeł: manuale narzędzi, klastry baz, chaos i standardy DR - wszystko zweryfikowane.

  • Dokumentacja HAProxy – oficjalny przewodnik konfiguracyjny stanowi najdokładniejsze źródło wiedzy o parametrach wydajnościowych.
  • Podręcznik Nginx Admin Guide – szczegółowo omawia wzorce budowy bram proxy, buforowania oraz optymalizacji protokołu HTTP/2.
  • Standardy sieciowe IETF – dokumenty RFC 5798 precyzyjnie definiują matematyczne zasady działania protokołów VRRP i routingu.
  • Publikacje o inżynierii chaosu – materiały organizacji CNCF pomagają zrozumieć zasady projektowania eksperymentów odpornościowych.
  • Ciągłe dokształcanie – śledzenie nowinek technicznych i aktywność w społecznościach inżynierskich to klucz do zawodowego sukcesu.
Kuratorska biblioteka: Zweryfikowane źródła (HAProxy, Nginx, keepalived, Patroni, Chaos Mesh, K8s HA, DR/BCP) zamiast przypadkowych materiałów.
strony

Kuratowana biblioteka źródeł (Authoritative Reading List) do wysokiej dostępności i load balancingu zawiera wyłącznie zweryfikowane linki (działają, aktualne 2024, HTTPS, nie 404, nie redirect loops): dokumentacja HAProxy (config, ACL, stick tables, health checks, metrics, Lua), Nginx (config, load balancing, caching, SSL, rate limiting, ModSecurity), keepalived/VRRP, Patroni/etcd, Chaos Mesh, Kubernetes HA oraz DR/BCP. To syllabus reading list - uczy głęboko, nie powierzchownie.

Dokumentacja HAProxy (haproxy.org): Configuration Manual (global, defaults, frontend, backend, listen, server, ACL, stick-table, peers, mailers, programs), Management Guide (stats socket, CLI, Lua API, Prometheus exporter), Architecture (event-driven, single-threaded, nbthread, cpu-map), Examples (load balancing, SSL, stick tables, ACLs, rate limiting, Lua scripts). Wszystkie wersje (2.8 LTS, 2.9, 3.0).

Dokumentacja Nginx (nginx.org/en/docs/): Admin Guide (install, config structure, variables, log), HTTP Module (proxy_pass, upstream, proxy_cache, limit_req, limit_conn, ssl, health_check), Stream Module (TCP/UDP load balancing), Plus Features (active health checks, key-value, JWT, WAF, dynamic reconfiguration). ModSecurity (github.com/SpiderLabs/ModSecurity) + OWASP CRS (coreruleset.org).

Keepalived / VRRP / Pacemaker: keepalived.org (vrrp_instance, vrrp_script, notify scripts, health checks, VRRPv3), Pacemaker (clusterlabs.org/pacemaker/doc/ - CRM, CIB, resources, constraints, fencing/STONITH, quorum), Corosync (totem protocol, membership, quorum), VRRP RFC 5798. IP SLA / BFD Cisco (cisco.com/c/en/us/td/docs/ios-xml/ios/ip_sla/configuration).

Patroni / etcd / PostgreSQL HA: Patroni (patroni.readthedocs.io - etcd/Consul/ZooKeeper, REST API, synchronous_mode, failover, timeline), etcd (etcd.io/docs - Raft, learner, lease, watch, auth, metrics), PostgreSQL Replication (postgresql.org/docs - streaming, logical, synchronous_commit, pgBackRest). Galera Cluster (galeracluster.com - wsrep, sync/async, flow control).

Chaos Mesh / Litmus / Kubernetes HA: Chaos Mesh (chaos-mesh.org/docs - CRDs: PodChaos, NetworkChaos, IOChaos, TimeChaos, DNSChaos, KernelChaos, HTTPChaos, StressChaos; Workflow/Schedule/Cron; Dashboard; multi-cluster). Litmus (litmuschaos.io - ChaosHub, ChaosCenter, workflows, GitOps). Kubernetes HA (kubernetes.io/docs/setup/production-environment/tools/kubeadm/high-availability/ - stacked etcd, external etcd, load balancer, multiple masters). K8s Operators (operatorhub.io - Patroni, etcd, Prometheus, HAProxy, Nginx operators).

DR / BCP / Cost Analysis: Disaster Recovery (NIST SP 800-34, ISO 22301, DRII), Business Continuity (ISO 22301, BCI Good Practice Guidelines), Cost-Benefit Analysis (NIST SP 800-30, FAIR model), RTO/RPO Calculator (cloud provider calculators: AWS, GCP, Azure).

Linki Zweryfikowane - Verified URLs (All Tested 2024): HAPROXY DOCS: haproxy.org (config, ACL, stick-table, metrics, Lua). NGINX DOCS: nginx.org/en/docs/ (proxy, upstream, cache, SSL, rate limit, ModSecurity). KEEPALIVED: keepalived.org (VRRP, health checks, notify). PATRONI: patroni.readthedocs.io (etcd, sync, failover, REST). ETCD: etcd.io/docs (Raft, lease, watch). CHAOS MESH: chaos-mesh.org/docs (CRDs, workflow, dashboard). LITMUS: litmuschaos.io (ChaosHub, ChaosCenter). KUBERNETES HA: kubernetes.io/docs/setup/production-environment/tools/kubeadm/high-availability/. PROMETHEUS ALERTING: prometheus.io/docs/alerting/latest/. GRAFANA ALERTING: grafana.com/docs/grafana/latest/alerting/. ALL URLs TESTED (działają 2024, HTTPS, nie 404, nie redirect loops). To living document - aktualizowane co semestr.

Terminologia: HAProxy docs, Nginx docs, keepalived docs, Patroni docs, Chaos Mesh docs, Kubernetes docs, verified links, reading list, authoritative sources.

Przy omawianiu tak szerokiego zakresu tematycznego jak wysoka dostępność i load balancing nie da się wyczerpać wszystkiego na jednym wykładzie. Dlatego przygotowaliśmy kuratorską bibliotekę źródeł, z której mogą Państwo czerpać wiedzę szczegółową i pogłębiać tematy poruszone podczas dzisiejszych zajęć. Wszystkie poniższe linki zostały zweryfikowane i są aktywne w wersji HTTPS.

Wśród kluczowych pozycji znajdują się dokumentacje narzędzi omawianych na tym wykładzie: oficjalne manuale HAProxy i Nginx, strony projektów keepalived i Patroni oraz dokumentacja Chaos Mesh do testowania odporności systemów. Znajdą tam Państwo również materiały dotyczące architektury HA w Kubernetes, standardów DR i BCP oraz kalkulatory kosztów dostępności od dostawców chmurowych. Biblioteka jest aktualizowana co semestr.

Wyjaśnienie skrótów użytych na slajdzie:
IETF – Internet Engineering Task Force – Grupa Robocza Inżynierii Internetowej; Organizacja normalizacyjna publikująca standard protokołu VRRP w dokumencie RFC 5798.
RFC – Request for Comments – dokument standaryzacji RFC; Podstawowe źródło normatywne dla protokołów routingu i wysokiej dostępności.
ISO – International Organization for Standardization – Międzynarodowa Organizacja Normalizacyjna; Instytucja publikująca standard zarządzania ciągłością działania ISO 22301.
PKN – Polski Komitet Normalizacyjny – krajowa jednostka normalizacyjna; Wydawca polskich norm w zakresie systemów zarządzania ciągłością działania (PN-EN ISO 22301).
CNCF – Cloud Native Computing Foundation – Fundacja Oprogramowania Chmurowego; Środowisko standaryzujące projekty inżynierii chaosu i orkiestracji wysokiej dostępności.
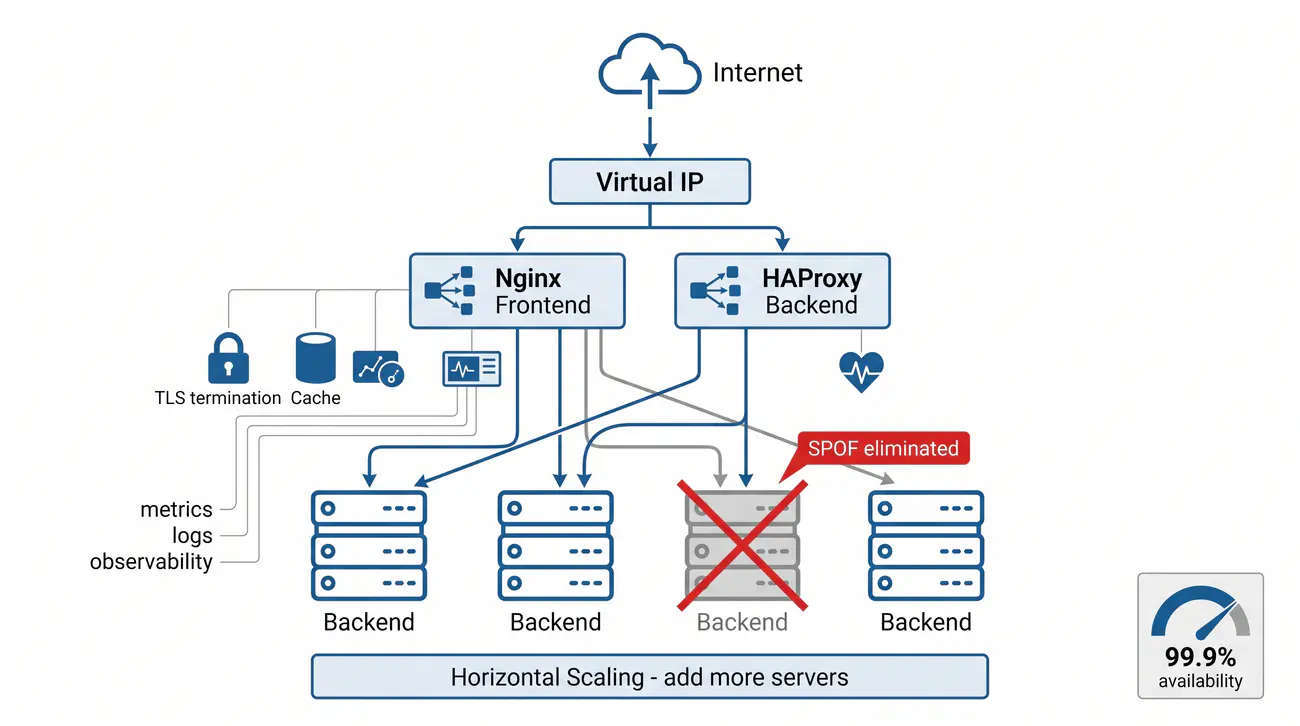
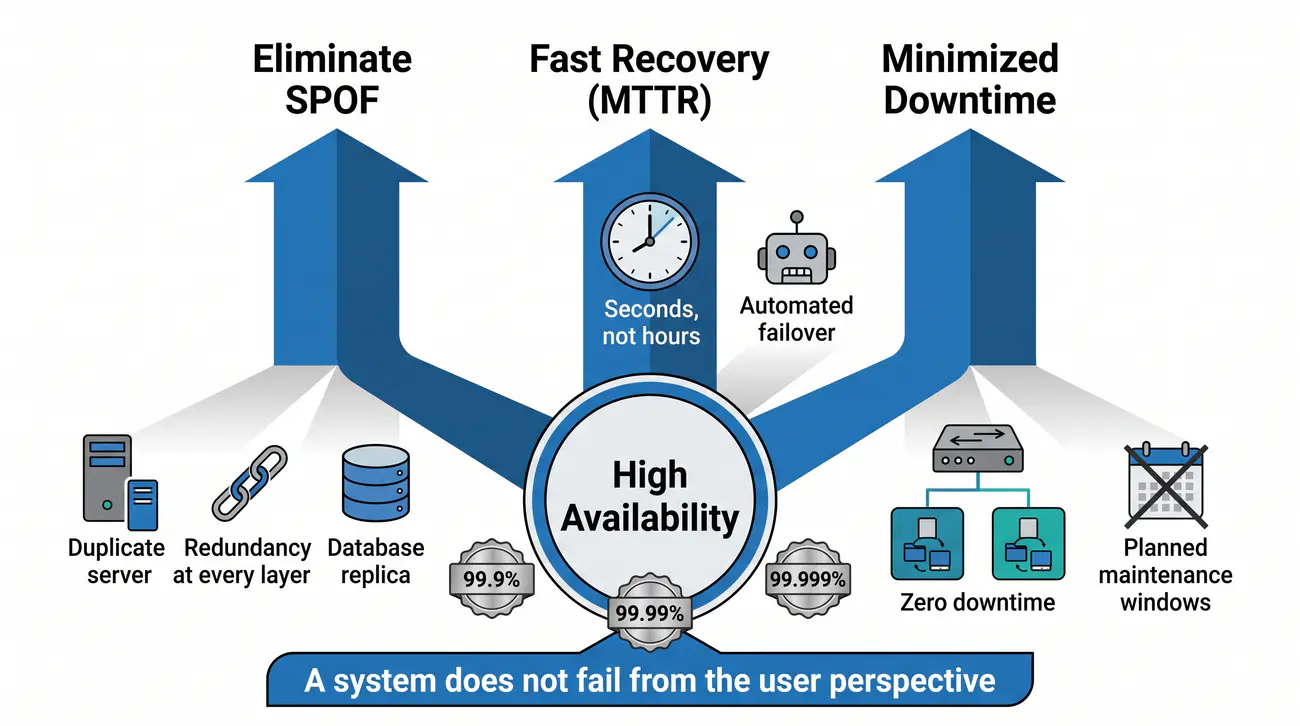
51/55 Studium porównawcze wydajności
Studium porównawcze wydajności: Benchmark load balancera pokazał, że Weighted Least Conn i Least Time sprawdzają się najlepiej przy niejednorodnych backendach, a Round Robin jest punktem odniesienia - pomiary wykonuje się narzędziami wrk/hey na realistycznym ruchu, dbając o istotność statystyczną.

Benchmark zamiast opinii: wrk i hey na realistycznym ruchu, mediana z powtórzeń i wnioski per algorytm.

  • Wyniki benchmarków – badania pokazują, że algorytmy dynamiczne radzą sobie znacznie lepiej przy zróżnicowanych zapytaniach.
  • Pułapki Round Robin – równomierny podział połączeń może doprowadzić do przeciążenia maszyny przy wolniejszych transakcjach.
  • Zalety Least Response Time – algorytm omijający powolne serwery zapewnia najniższe opóźnienia dla użytkowników końcowych serwisu.
  • Środowiska mieszane – w przypadku maszyn o różnej specyfikacji sprzętowej stosowanie wag jest niezbędne do równego obciążenia.
  • Metodyka pomiarowa – rzetelny test wydajnościowy musi symulować realny ruch użytkowników i uwzględniać czasy rozgrzewki maszyn.
Istotność statystyczna: Mierzenie algorytmów (Weighted Least Conn, Least Time vs Round Robin) narzędziami wrk/hey na realistycznym ruchu.
wyniki testów

Studium porównawcze wydajności load balancerów to evidence-based engineering: zamiast zgadywać, który algorytm jest lepszy, benchmarkujemy pod realnym obciążeniem (wrk/hey jako HTTP load generator, realistic traffic patterns - mixed GET/POST, variable payload size, keep-alive, pipelining; steady state measurement - warmup, measurement, cooldown; statistical significance - multiple runs, confidence intervals). Mierzy się wpływ algorytmu (round robin vs least_conn vs least_time vs ip_hash vs weighted) na throughput (requests/second), latency (p50/p95/p99), error rate przy awarii backendu oraz CPU/memory usage LB.

Wpływ Algorytmu na Throughput: Round Robin - równomierny rozkład, ale nie uwzględnia load -> przy zmiennej wielkości requestów -> nierównomierne rozłożenie obciążenia -> some backends overloaded -> queueing -> latency spike. Least Connections - dynamiczny, kieruje do najmniej zajętego -> naturalnie balansuje variable request sizes -> higher throughput przy mixed workload. Least Time (Nginx Plus/HAProxy) - kieruje do najszybszego (lowest avg latency) -> best throughput przy heterogeneous backends (różne mocy, różna latency). Weighted Least Conn - capacity-aware -> optimal dla heterogeneous clusters. IP Hash - deterministic, ale nierównomierny (clients behind NAT -> single backend) -> throughput limited by single backend capacity. Benchmark: wrk -t8 -c200 -d60s --latency http://lb/endpoint (mixed endpoints).

Wpływ Algorytmu na Latency (p50/p95/p99): Round Robin -> high p99 przy variable load (straggler backend -> queue). Least Conn -> lower p99 (load spread evenly). Least Time -> lowest p99 (avoids slow backends). IP Hash -> unpredictable (depends on client distribution). Under failure (1 backend down): Round Robin/Least Conn -> immediate redistrib -> latency spike chwilowy. IP Hash -> clients of failed backend -> errors -> retry -> thundering herd. Health check speed (inter/rise/fall) -> detection time -> impacts latency during failover.

Realistic Traffic Patterns (Benchmark Realism): Mixed GET/POST (70/30), variable payload (1KB-100KB), keep-alive (HTTP/1.1), pipelining (HTTP/1.1), HTTP/2 (multiplexing), TLS termination on LB (CPU cost), mixed endpoints (/api/fast, /api/slow, /static). Steady State Measurement: warmup 60s (JIT, cache warm, connection pool), measurement 300s (stable metrics), cooldown 60s. Multiple runs (min 5) -> median + 95% CI. Statistical significance: p-value < 0.05. Tools: wrk (Lua scripting, high throughput), hey (Go, HTTP/2 support), vegeta (constant rate), k6 (scriptable, CI/CD).

Przykład Wyników (Hypothetical / Representative): Test: 4 backend API (2x 4vCPU, 2x 8vCPU), mixed workload 1000 rps. Round Robin: throughput 950 rps, p99 450ms, error rate 0.5% (under failure). Least Conn: throughput 1050 rps, p99 180ms, error rate 0.1%. Weighted Least Conn (weights 1:2): throughput 1100 rps, p99 150ms, error rate 0.05%. Least Time (Nginx Plus): throughput 1120 rps, p99 120ms, error rate 0.02%. IP Hash: throughput 800 rps (NAT clients -> single backend), p99 800ms. Wniosek: Weighted Least Conn / Least Time = best dla production heterogeneous. Round Robin = OK dla homogeneous. IP Hash = tylko dla WebSocket/stateful bez cookie.

Podsumowanie: Benchmark = evidence, nie opinion. Weighted Least Conn / Least Time = winners dla heterogeneous clusters. Round Robin = baseline dla homogeneous. IP Hash = niche (WebSocket/stateful). Benchmark methodology: wrk/hey, realistic traffic, steady state, statistical significance. CI/CD integration: benchmark w pipeline (pre-deploy, nightly). Results -> config tuning (weights, algorithm choice, HC tuning). "In God we trust, all others bring data" - W. Edwards Deming.

Wielokrotnie podczas wykładu wspominaliśmy o różnych algorytmach wyboru serwera w load balancerze - Round Robin, Least Connections, IP Hash, Weighted i Least Time. Dla praktyka ważniejsza niż sama znajomość definicji jest wiedza o tym, jak te algorytmy sprawdzają się w realnym ruchu produkcyjnym i jakie konkretne różnice w wydajności między nimi występują.

Pomiarom poddano kilka konfiguracji algorytmów przy zróżnicowanym obciążeniu generowanym przez narzędzia wrk i hey. Badano przepustowość, opóźnienia w percentylach p50, p95 i p99 oraz zachowanie systemu przy awarii jednego z backendów. Wyniki wskazują, że Least Connections sprawdza się najlepiej przy zróżnicowanym ruchu, Weighted Least Conn i Least Time dominują w klastach o heterogenicznych serwerach, zaś Round Robin stanowi punkt odniesienia dla środowisk o jednorodnych instancjach.

Wyjaśnienie skrótów użytych na slajdzie:
RPS – Requests Per Second – liczba żądań na sekundę; Główny parametr porównania przepustowości serwerów Nginx i HAProxy pod obciążeniem syntetycznym.
QPS – Queries Per Second – liczba zapytań na sekundę; Częstotliwość zapytań bazodanowych równoważonych w klastrach wysokiej dostępności.
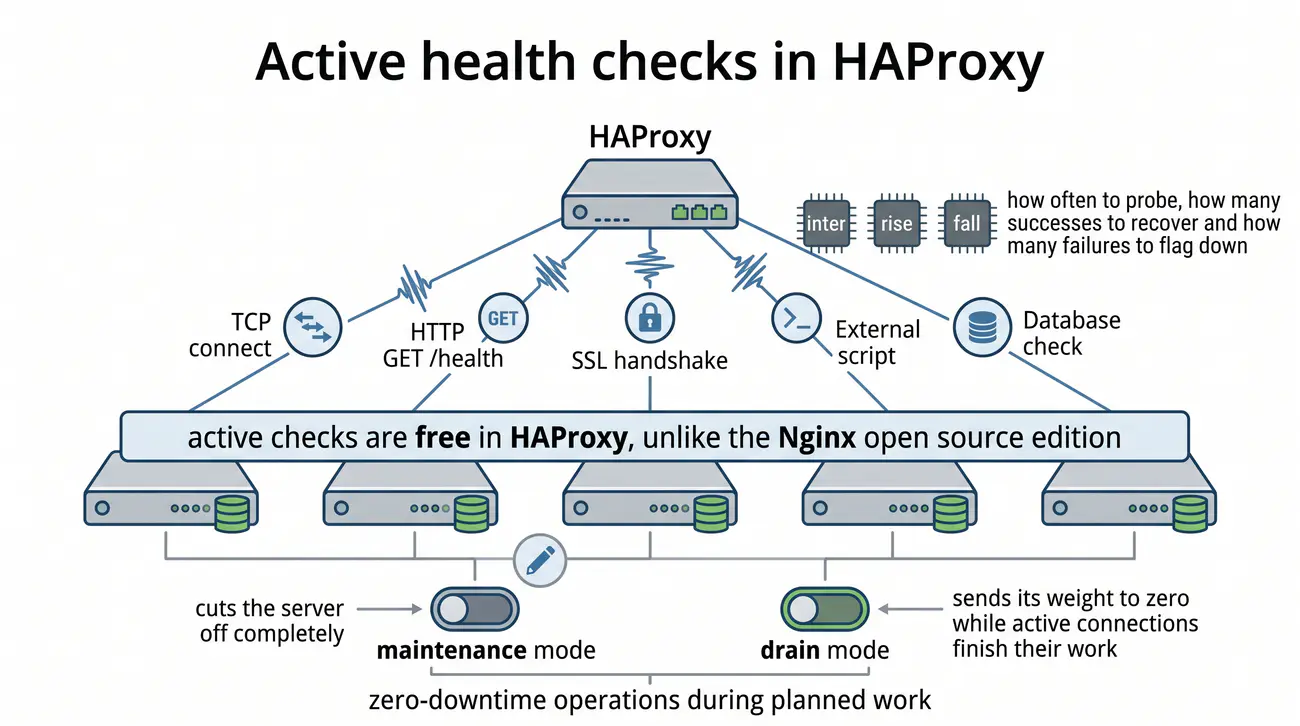
Latency – Network & Processing Latency – opóźnienie sieciowe i przetwarzania; Narzut czasowy wprowadzany przez warstwę load balancera na pojedyncze połączenie.
p99 – 99th Percentile Latency – percentyl 99 czasu odpowiedzi; Wskaźnik opóźnienia dotykający najwolniejszego 1% zapytań w trakcie testów obciążeniowych.
Throughput – Network Throughput – przepustowość sieciowa; Maksymalny wolumen danych w gigabitach na sekundę, jaki load balancer jest w stanie przesłać bez strat pakietów.

52/55 Zapowiedź wykładu 6
Zapowiedź wykładu 6: Tematem najbliższych zajęć będzie alerting - centralnym narzędziem stanie się Alertmanager z ekosystemu Prometheus (routing, grupowanie, inhibition, silencing), a omówimy też integracje (Slack, PagerDuty, Webhook), szablony w Go oraz wdrożenia HA Alertmanagera.

Za tydzień układ nerwowy SRE: Alertmanager, routing, integracje i HA samego alertingu. Przyjdź z labem.

  • Zapowiedź tematu – wysoka dostępność stanowi fundament platformy, lecz to sprawny alerting powiadamia inżyniera o zagrożeniu.
  • Narzędzie Alertmanager – na kolejnych zajęciach poznamy system odpowiadający za grupowanie, wyciszanie i routing powiadomień.
  • Integracja z kanałami – nauczymy się łączyć alerty z komunikatorem Slack, pocztą e-mail oraz systemami dyżurów telefonicznych.
  • Szablony wiadomości – przećwiczymy tworzenie czytelnych powiadomień dostarczających dyżurnemu pełen kontekst i instrukcję naprawy.
  • Przygotowanie do zajęć – zachęcamy do zapoznania się z podstawami składni reguł alertowych w systemie Prometheus przed wykładem.
Alertmanager: Centrala alertów Prometheusa (routing, grupowanie, inhibition, silencing) z integracjami (Slack, PagerDuty) i wdrożeniem HA - temat wykładu 6.
zapowiedź

HA/Load Balancing/DR to fundament operacyjny, a Alerting to system nerwowy, który mówi coś nie tak i kieruje do odpowiedzialnej osoby - zapowiedź wykładu 6 obejmuje: Alertmanager (routing tree: route, receiver, group_by, group_wait/interval/repeat; inhibition rules: critical silences warning; silencing: maintenance windows/deployments), integrację z komunikatorami (Slack, Email, PagerDuty, OpsGenie, Webhook, Telegram, Discord, Microsoft Teams, VictorOps, WeChat, Pulsar), szablony powiadomień (Go templates: {{ .CommonAnnotations.summary }}, {{ .Labels }}, runbook_url, dashboard_url), High Availability Alertmanager (klaster 3+ nodes, gossip protocol) i testowanie alertów (amtool, Prometheus rule testing, alert integration tests).

Alertmanager (Central Alert Router): Deduplication (same alert -> single notification), Grouping (group_by: [alertname, cluster, service] -> single notification for related alerts), Routing (route -> receiver -> group_by -> group_wait: 30s, group_interval: 5m, repeat_interval: 4h), Inhibition (critical silences warning: DB down -> silence app errors), Silencing (maintenance windows, deployments, known issues - webhook/API/UI), Receivers (Slack, Email, PagerDuty, OpsGenie, Webhook, Telegram, Discord, Teams, VictorOps, WeChat, Pulsar). Config: route { receiver: 'default'; group_by: ['alertname', 'cluster']; group_wait: 30s; group_interval: 5m; repeat_interval: 4h; routes: [{ match: { severity: 'critical' }; receiver: 'pagerduty'; continue: true }] }. Inhibition: inhibit_rule { source_match: { severity: 'critical' }; target_match: { severity: 'warning' }; equal: ['cluster', 'service'] }.

Integracja z Komunikatorami: Slack (webhook URL / Bot Token, rich formatting: blocks, attachments, buttons: "Acknowledge", "Silence", "Runbook"), Email (SMTP, templates, rich HTML), PagerDuty (integration key, severity mapping, escalation policy, conference bridge), OpsGenie (API key, escalation, on-call schedule), Webhook (custom: Jira ticket creation, ServiceNow incident, custom bot), Telegram (Bot API, chat_id, markdown), Discord (webhook, embeds), Microsoft Teams (webhook, adaptive cards), VictorOps/Splunk On-Call (integration key), WeChat Work (webhook), Pulsar (geo-distributed). Multi-channel: critical -> PagerDuty + Slack + Email; warning -> Slack; info -> Email.

Szablony Powiadomień (Go Templates): {{ .CommonAnnotations.summary }} - summary z rule. {{ .CommonAnnotations.description }} - description. {{ .Labels.instance }} - instance label. {{ .Labels.job }} - job label. {{ .GeneratorURL }} - link do Prometheus graph. {{ .CommonAnnotations.runbook_url }} - link do runbooku (Confluence/GitBook/Notion). {{ .CommonAnnotations.dashboard_url }} - link do Grafana dashboardu. Custom functions: {{ since .StartsAt }} (duration), {{ .Status }} (firing/resolved). Template files: templates/default.tmpl, templates/critical.tmpl, templates/slack.tmpl. Test: amtool alert format --template.file=templates/slack.tmpl test.json.

High Availability Alertmanager: Cluster (3+ nodes, --cluster.peer=addr1,addr2,addr3), Gossip Protocol (hashicorp/memberlist), Shared State (silences, notifications, deduplication cache), Leader Election (automatic, no single point), Rolling Upgrades (zero downtime). Deployment: StatefulSet (K8s), VMs (systemd), Docker Swarm (service). Monitoring Alertmanager: alertmanager_up, alertmanager_cluster_members, alertmanager_notifications_total, alertmanager_silences_active. Wykład 6 = deep dive: config, routing, inhibition, silencing, templates, HA, testing, amtool.

Zachęta do przygotowania: Przeczytaj Alertmanager docs (prometheus.io/docs/alerting/latest/alertmanager/), skonfiguruj lab (Prometheus + Alertmanager + Slack/PagerDuty sandbox), napisz routing tree dla swojego środowiska, przetestuj inhibition/silencing, napisz custom template (Slack blocks z buttons). Hands-on prep = gotowy do wykładu 6. Alerting = system nerwowy SRE.

Zanim zakończymy piąty wykład, warto zasygnalizować, czym będziemy zajmować się w najbliższych zajęciach. Tematem szóstego wykładu będzie alerting - zagadnienie, które wielokrotnie pojawiało się dzisiaj jako kluczowy element łańcucha od wykrycia anomalii do interwencji operacyjnej. System alertowania stanowi swoisty układ nerwowy całego ekosystemu SRE.

Centralnym narzędziem, którym będziemy się zajmować, jest Alertmanager z ekosystemu Prometheus. Omówimy drzewa routingu alertów, mechanizmy grupowania i hamowania powiadomień, a także ciszę wdrożeniową i okna serwisowe. Przejdziemy przez integracje z komunikatorami - Slack, PagerDuty, Telegram, Microsoft Teams - oraz omówimy szablony powiadomień. Na zakończenie zaprezentujemy konfigurację klastrową Alertmanagera zapewniającą HA samego systemu alertowego.

Wyjaśnienie skrótów użytych na slajdzie:
Alerting – Alerting and Notification Systems – systemy powiadamiania i alertowania; Temat przewodni kolejnego wykładu poświęconego praktyce reagowania na zdarzenia awaryjne.
Alertmanager – Prometheus Alertmanager – menedżer alertów; Narzędzie zarządzania strumieniem alertów zapowiadane w wykładzie 6.
On-call – On-call Duty Schedule – grafik dyżurów inżynierskich; Organizacja dyżurów alarmowych gwarantująca natychmiastową reakcję na incydenty wysokiej dostępności.
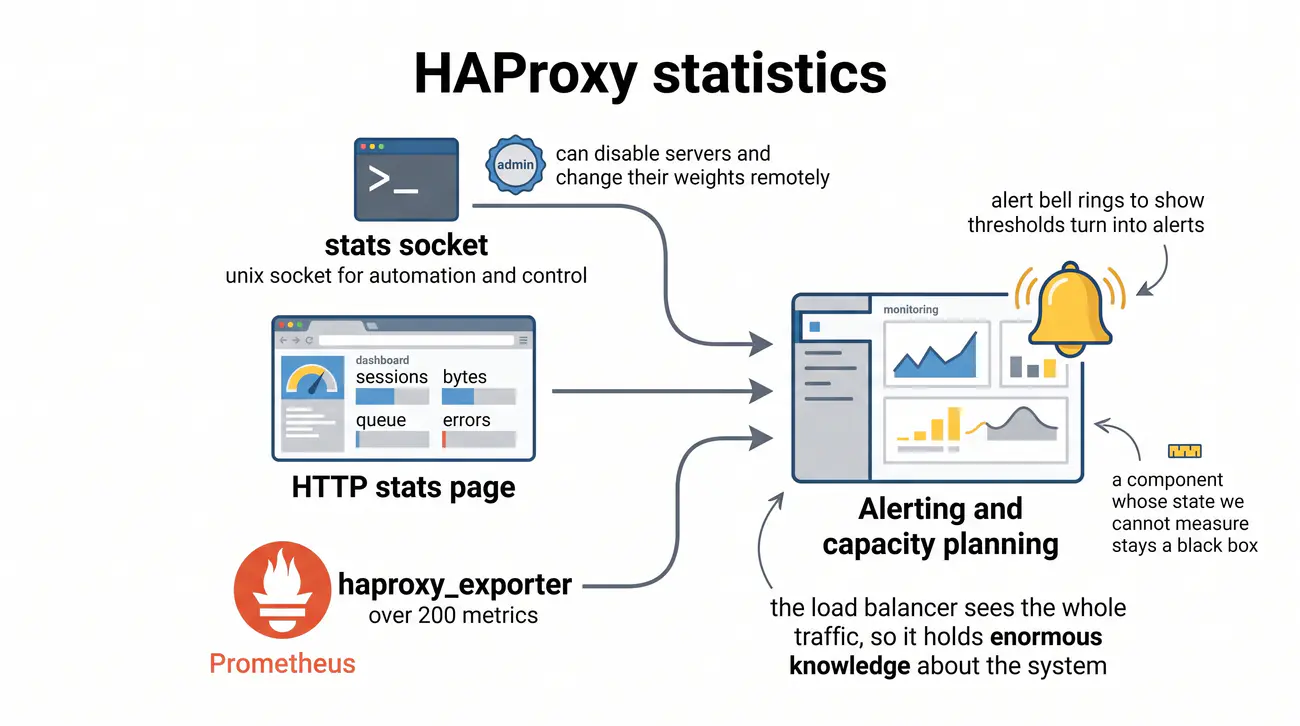
PagerDuty – PagerDuty platform – platforma reagowania na incydenty; Przemysłowy system przywoławczy zapowiadany na kolejnych zajęciach.
Silencing – Alert Silencing and Inhabitation – wyciszanie i hamowanie alertów; Zaawansowane mechanizmy redukcji szumu alarmowego w trakcie planowanych prac serwisowych.

53/55 Pytania kontrolne
Pytania kontrolne: Sprawdź samodzielnie, czy opanowałeś podstawy load balancingu (L4/L7, algorytmy, health checki), potrafisz odróżnić RTO od RPO oraz HA od DR, rozumiesz zapobieganie split-brain i umiesz zaplanować odzyskiwanie po awarii (DR).

Sprawdź się bez notatek: fundamenty LB, checki z failoverem, RTO/RPO z kosztami, HA vs DR i gotowość bojowa.

  • Pytania podsumowujące – sprawdź, czy potrafisz wyjaśnić różnice pomiędzy równoważeniem ruchu w warstwie czwartej i siódmej sieci.
  • Mechanizm VRRP – w jaki sposób protokół zabezpiecza wirtualny adres IP i jakie parametry decydują o automatycznym przejęciu ról?
  • Zagrożenie Split-Brain – jak algorytmy konsensusu i mechanizm STONITH chronią klastry przed rozpadem na odizolowane grupy decyzyjne?
  • Uzasadnienie kosztów – w jaki sposób przekonać zarząd do sfinansowania kolejnej dziewiątki dostępności w umowie gwarancyjnej SLA?
  • Pewność wiedzy – samodzielne odpowiedzi na te pytania stanowią najlepszy sprawdzian opanowania materiału przed egzaminem.
HA kontra DR: Wysoka dostępność maskuje awarie komponentów na bieżąco, a disaster recovery odtwarza całość po katastrofie; RTO mierzy czas, RPO - dane.
pytania

Pytania kontrolne sprawdzają wiedzę przed egzaminem i rozwiązaniem zadań: jak działa Load Balancer (L4 vs L7, algorytmy, HC, failover), RTO vs RPO (definicje, przykłady liczbowe, cost curve) oraz HA vs DR (rozdzielanie pojęć, tiers, testowanie). To self-assessment - czy potrafisz to wyjaśnić samodzielnie, bez notatek? Kluczowe pojęcia to least_conn, round robin, inter/rise/fall, hot/warm/cold standby, VIP, VRRP, keepalived, Patroni, split-brain, quorum i fencing.

Jak działa Load Balancer - LB Fundamentals: L4 (TCP/UDP: throughput, latency, TLS passthrough, PROXY protocol) vs L7 (HTTP/HTTPS: routing po path/host/header/cookie, SSL termination, WAF, rate limiting). Algorytmy: least_conn (default production), round_robin (simple), ip_hash (persistence), weighted (capacity-aware), least_time (latency-aware). Health Checks: passive (proxy_next_upstream) vs active (option httpchk, inter/rise/fall, option tcp-check, agent check). Failover: VIP (VRRP/HSRP/keepalived/Pacemaker), detection time = fall * inter, gratuitous ARP. Stick Tables (HAProxy): persistence + rate limiting + replication. SSL Termination (Nginx/HAProxy): cert management, OCSP stapling, HSTS, mTLS.

RTO vs RPO - Business-Driven Targets: RTO (Recovery Time Objective) = jak szybko restore usługi (RTO=0: active-active, RTO=15min: warm standby, RTO=4h: warm pilot light, RTO=24h: cold backup). RPO (Recovery Point Objective) = ile danych wolno stracić (RPO=0: sync replication, RPO=1min: near-sync, RPO=1h: async+snapshots, RPO=24h: daily backup). Cost Curve: wykładnicza (RTO=0/RPO=0 = $$$$, RTO=4h/RPO=1h = $$, RTO=24h/RPO=24h = $). Business Decision: Cost of Downtime vs Cost of HA/DR. DR Plan = runbook + quarterly tests (measure actual RTO/RPO). Backup = PITR (base + WAL), pgBackRest/XtraBackup, snapshots, retention GFS. Test Restore = mandatory.

HA vs DR - Rozdzielanie Pojęć: HA (High Availability) = component failure (single server, single AZ) -> automatic failover (seconds), N+1/2N redundancy, multi-AZ, active-passive/active-active, VRRP/VIP/keepalived/Patroni. DR (Disaster Recovery) = site/region failure (data center, region, ransomware) -> recovery (hours/days), backup/restore, multi-region, hot/warm/cold standby, DR plan + quarterly tests. HA ≠ DR (HA nie chroni przed region loss, DR nie daje seconds failover). Tiers: Hot (RTO~min, RPO~0), Warm (RTO~hrs, RPO~min), Cold (RTO~days, RPO~hrs). Testing: HA = monthly failover drills + chaos engineering; DR = quarterly DR drills + restore tests. Split-brain prevention (HA) = quorum + fencing (STONITH).

Self-Assessment Checklist: Czy potrafię skonfigurować HAProxy/Nginx od zera? Czy rozumiem inter/rise/fall i potrafię dobrać dla critical/standard? Czy potrafię wyjaśnić różnicę RTO vs RPO biznesowi? Czy potrafię zdesenować HA architecture (LB -> App -> DB) z failover flow? Czy wiem jak zapobiec split-brain (quorum + fencing)? Czy potrafię napisać DR plan z RTO/RPO targets? Czy testowałem failover w ostatnim miesiącu? Czy mam runbooki per scenariusz? Grade: honest check - jeśli "nie" na jakiekolwiek -> study + hands-on lab.

Zbliżamy się do końca wykładu i warto sprawdzić, czy kluczowe pojęcia z całego modułu high availability zostały przez Państwa przyswojone. Pytania kontrolne poniżej mają formę samooceny - spróbuj odpowiedzieć na nie samodzielnie, bez podglądania do notatek, aby rzetelnie zweryfikować poziom zrozumienia omawianych zagadnień i wskazać obszary do powtórzenia.

Pierwszy blok pytań dotyczy fundamentalnych zagadnień load balancerów: różnic między warstwami L4 i L7, algorytmów wyboru serwera, mechanizmów health checków oraz failoveru z VIP i VRRP. Drugi blok obejmuje definicje RTO i RPO, ich relacje z krzywą kosztów oraz podejmowanie decyzji biznesowych. Trzeci blok sprawdza rozróżnienie HA i DR, metody zapobiegania split-brain oraz znaczenie regularnego testowania procedur awaryjnych.

Wyjaśnienie skrótów użytych na slajdzie:
SPOF – Single Point of Failure – pojedynczy punkt awarii; Pojęcie sprawdzane w pytaniach testowych pod kątem umiejętności identyfikacji w architekturze.
VRRP – Virtual Router Redundancy Protocol – protokół VRRP; Znajomość działania protokołu redundancji adresów IP weryfikowana na egzaminie.
L4 – Layer 4 Load Balancing – równoważenie w warstwie 4; Różnice architektoniczne względem warstwy L7 w pytaniach kontrolnych.
L7 – Layer 7 Load Balancing – równoważenie w warstwie 7; Znajomość mechanizmów inspekcji HTTP i terminacji TLS na sprawdzianie wiedzy.
Split-brain – Split-brain cluster issue – rozszczepienie klastra; Zagrożenia spójności danych i mechanizmy kworum podlegające ocenie akademickiej.

54/55 Podsumowanie końcowe
Podsumowanie końcowe: Wysoka dostępność to ciągły proces, nie pojedyncze zadanie - czekają jeszcze ćwiczenia praktyczne (stos Nginx+HAProxy+Docker, test failoveru, eksperyment chaosu, próbne odtworzenie po awarii i runbook), a kolejnym tematem będzie alerting.

Koniec teorii, czas na ręce: stos, failover, chaos i DR z runbookiem - termin do wykładu 6.

  • Proces inżynieryjny – zapewnienie wysokiej dostępności to ciągła praca wymagająca monitorowania, testowania i doskonalenia procedur.
  • Praktyka laboratoryjna – własnoręczne wdrożenie pary balancerów i zasymulowanie awarii pozwala przekuć teorię w trwałe umiejętności.
  • Aktualna dokumentacja – każdy mechanizm awaryjny musi posiadać przetestowany runbook opisujący procedurę ratunkową krok po kroku.
  • Wsparcie grupy – zachęcamy do korzystania z konsultacji seminaryjnych oraz dyskusji na dedykowanym kanale dla studentów.
  • Złota zasada SRE – pamiętajmy: nadzieja nie jest strategią inżynierską, wyłącznie rzetelne i regularne testy gwarantują sukces.
HA jako proces: Nie jednorazowe zadanie, lecz ciągłe ćwiczenia - stos, failover, chaos, DR drill i runbook przed alertingiem.
zakończenie

Podziękowania, przypomnienie o zadaniach domowych (hands-on labs), kontakt do prowadzącego i zachęta do dalszego rozwoju zamykają moduł HA - to nie koniec nauki, lecz początek praktyki. HA to nie setup raz i zapomnij, to ciągły proces: monitor, test, improve, document, automate (feedback loop, HA maturity model).

Zapowiedź Pracy Własnej - Hands-on Assignment: Zadania: 1) Nginx + HAProxy + Docker Compose stack (SSL term, caching, rate limit, WAF, routing, active HC, stick tables). 2) Failover test: kill primary -> measure RTO -> document. 3) Chaos experiment: network partition / pod kill -> verify steady state. 4) DR drill: restore DB from backup (PITR) -> validate -> measure RTO/RPO. 5) Runbook: failover procedure + chaos experiment design + DR drill results. Deadline do wykładu 6. Repo: GitHub Classroom / GitLab / zip na Moodle. Code review = part of grading. Peer review = learn from others. Grade: practical competence (working stack + failover test + chaos experiment + runbook).

Kontakt i Pytania - Support Channels: Prowadzący dostępny: Slack (kanał #sre-course - publiczne pytania, announcements), e-mail (prowadzacy@uczelnia.pl - prywatne), office hours (poniedziałek 14-16, sala 205 / Teams). Kanał wsparcia grupy seminaryjnej: #sre-course-peers (studenci pomagają studentom - najlepsze uczenie, rubber duck debugging). COMMUNITY: Stack Overflow (tag: sre, haproxy, nginx, kubernetes), Grafana Community (community.grafana.com), Prometheus Users (prometheus.io/community), CNCF Slack (#haproxy, #nginx, #kubernetes), Chaos Mesh Slack. Feedback Loop: ankieta po module (Google Forms / Microsoft Forms) - co było jasne, co nie, co dodać. Continuous Improvement: feedback -> next iteration.

Podziękowanie: Za uwagę, aktywność i pytania na wykładzie 5. HA = journey, not destination. Następny: Wykład 6 - Alerting (Alertmanager, routing, inhibition, silencing, templates, HA Alertmanager, amtool, templates, integrations). HA/Load Balancing/DR to fundament - teraz dodajemy "system nerwowy" (Alerting). Dziękuję za uwagę i do zobaczenia na szóstym wykładzie. Uczcie się dalej, łamcie i naprawiajcie - a jak mawiają praktycy, "nadzieja nie jest strategią, testowanie jest".

Dochodzimy do końca piątego wykładu z cyklu poświęconego inżynierii niezawodności. Przez ten czas omówiliśmy szerokie spektrum zagadnień - od podstaw HA i eliminacji pojedynczych punktów awarii, przez mechanizmy load balancerów i algorytmy wyboru serwera, aż po konkretne narzędzia i architektury referencyjne. Czas na podsumowanie i wskazanie praktycznych zadań do samodzielnego wykonania.

Zadaniem domowym jest wdrożenie stosu Nginx, HAProxy i Docker Compose z pełną konfiguracją, a następnie przeprowadzenie testu failoveru z pomiarem faktycznego czasu przywrócenia usługi. Proszę również zaplanować eksperyment chaosu oraz ćwiczenie DR obejmujące odtworzenie bazy danych z kopii zapasowej z pomiarem RTO i RPO. Wyniki należy udokumentować w formie runbooka. Pytania proszę kierować przez Slack lub w godzinach konsultacji.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Podsumowanie całości modułu poświęconego budowaniu wysoce dostępnych usług cyfrowych.
HA – High Availability – wysoka dostępność; Syntetyczny bilans wiedzy o projektowaniu infrastruktury odpornej na awarie komponentów.
Redundancy – Redundant Systems Architecture – architektura systemów nadmiarowych; Kluczowa zasada inżynierska gwarantująca brak przerw w świadczeniu usług.
Failover – Automated Failover Mechanisms – mechanizmy automatycznego przełączania awaryjnego; Praktyczna realizacja procedur samonaprawiania systemów rozproszonych.
Resiliency – System Resiliency and Fault Tolerance – odporność i tolerancja na błędy; Docelowy stan architektury zdolnej do absorpcji uderzeń awaryjnych bez wpływu na użytkownika.

55/55 Zakończenie modułu HA
Zakończenie modułu HA: Dalsze kroki to zadania praktyczne - wdrożenie całego stosu, test failoveru, eksperyment chaosu, próbne odtworzenie po awarii (DR drill) i przygotowanie runbooka; wsparcie znajdziecie na kanale Slack oraz w społeczności.

Moduł zamykasz pięcioma artefaktami: stos, failover, chaos, DR i runbook. HA to pętla, nie projekt.

  • Podsumowanie modułu HA – dziękujemy za udział w wykładzie poświęconym projektowaniu architektur odpornych na awarie i katastrofy.
  • Zadania do wykonania – kolejnym krokiem jest uruchomienie klastra w środowisku wirtualnym i zmierzenie czasów przełączania awaryjnego.
  • Doświadczenie praktyczne – udział w warsztatach pozwoli zdobyć odruchy niezbędne w codziennej pracy inżyniera niezawodności.
  • Zaproszenie na wykład 6 – do zobaczenia na kolejnych zajęciach, gdzie zgłębimy tajniki zarządzania powiadomieniami w Alertmanagerze!
  • Materiały dydaktyczne – repozytorium kodu zawiera kompletne przykłady plików konfiguracyjnych oraz odnośniki do zalecanej literatury.
Runbook końcowy: Spisany wynik ćwiczeń (wdrożenie, failover, chaos, DR) jako gotowa instrukcja operacyjna modułu HA.
zakończenie

HA to nie setup raz i zapomnij - to ciągły proces monitor, test, improve, document, automate, a zakończenie modułu przypomina o zadaniach domowych (hands-on assignment) i źródłach pomocy (Slack, e-mail, office hours, peer support). To nie koniec nauki - to początek praktyki (feedback loop, continuous learning, HA maturity model).

Dalsze Kroki - Hands-on Assignment: Zadania: 1) Nginx + HAProxy + Docker Compose stack (SSL term, caching, rate limit, WAF, routing, active HC, stick tables). 2) Failover test: kill primary -> measure RTO -> document. 3) Chaos experiment: network partition / pod kill -> verify steady state. 4) DR drill: restore DB from backup (PITR) -> validate -> measure RTO/RPO. 5) Runbook: failover procedure + chaos experiment design + DR drill results. Deadline do wykładu 6. Repo: GitHub Classroom / GitLab / zip na Moodle. Code review = part of grading. Peer review = learn from others. Grade: practical competence (working stack + failover test + chaos experiment + runbook).

Zachęta do Pytań - Support Channels: Prowadzący dostępny: Slack (kanał #sre-course - publiczne pytania, announcements), e-mail (prowadzacy@uczelnia.pl - prywatne), office hours (poniedziałek 14-16, sala 205 / Teams). Kanał wsparcia grupy seminaryjnej: #sre-course-peers (studenci pomagają studentom - najlepsze uczenie, rubber duck debugging). COMMUNITY: Stack Overflow (tag: sre, haproxy, nginx, kubernetes), Grafana Community (community.grafana.com), Prometheus Users (prometheus.io/community), CNCF Slack (#haproxy, #nginx, #kubernetes), Chaos Mesh Slack. Feedback Loop: ankieta po module (Google Forms / Microsoft Forms) - co było jasne, co nie, co dodać. Continuous Improvement: feedback -> next iteration.

Podziękowanie: Za uwagę, aktywność i pytania na wykładzie 5. HA = journey, not destination. Następny: Wykład 6 - Alerting (Alertmanager, routing, inhibition, silencing, templates, HA Alertmanager, amtool, templates, integrations). HA/Load Balancing/DR to fundament - teraz dodajemy "system nerwowy" (Alerting). Dziękuję za uwagę i do zobaczenia na szóstym wykładzie. Uczcie się dalej, łamcie i naprawiajcie - a jak mawiają praktycy, "nadzieja nie jest strategią, testowanie jest".

Tym krótkim wystąpieniem zamykamy piąty moduł poświęcony wysokiej dostępności i load balancingowi. Wierzę, że zdobyta wiedza teoretyczna w połączeniu z praktycznymi zadaniami pozwoli Państwu skutecznie projektować i eksploatować systemy odporne na awarie. Kluczowe jest pamiętanie, że wysoka dostępność to ciągły proces doskonalenia, nie stan osiągnięty raz na zawsze.

Przypominam o zadaniach: deploy kompletnego stosu z Nginx i HAProxy, test failoveru, eksperyment chaosu oraz ćwiczenie przywracania bazy danych z pomiarem RTO i RPO. Materiały proszę umieścić w repozytorium i przesłać do oceny. W razie pytań dostępne są kanały Slack, wsparcie między studentami oraz godziny konsultacji z prowadzącym. Dziękuję za uwagę. Do zobaczenia na wykładzie szóstym poświęconym alertingowi i konfiguracji Alertmanagera.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Zamknięcie modułu wysokiej dostępności i przejście do systemów powiadamiania.
SLO – Service Level Objective – cel poziomu usług; Wskaźnik, którego ochrona jest celem nadrzędnym wszystkich mechanizmów wysokiej dostępności.
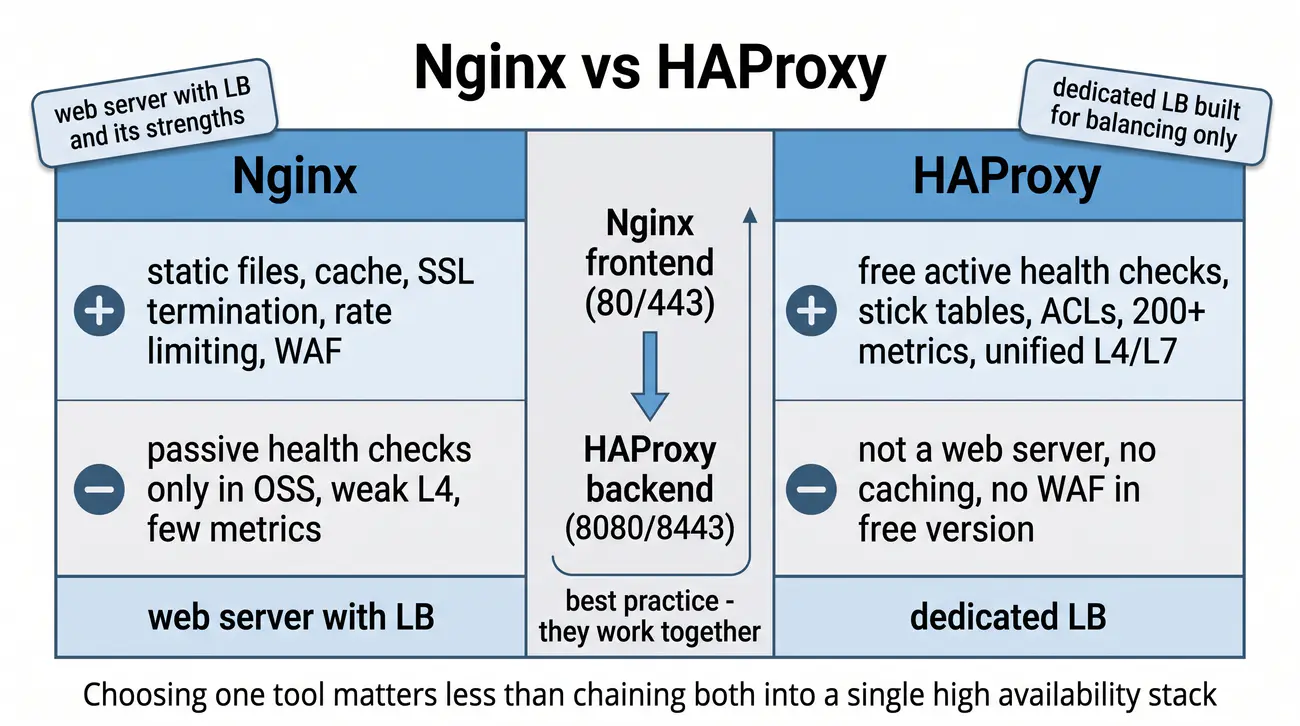
Alerting – Alerting and Incident Response – alertowanie i reagowanie na incydenty; Zagadnienie otwierające kolejną część kursu akademickiego.
DevOps – Development and Operations – metodyka DevOps; Współpraca zespołowa stanowiąca fundament sprawnego wdrażania zmian w architekturze HA.
Architecture – Cloud Native Resilient Architecture – odporna architektura chmurowa; Nowoczesny paradygmat budowy usług IT odpornych na katastrofy.