1/55 Wprowadzenie do cyklu
SRE (Site Reliability Engineering) - inżynieria niezawodności systemów; dyscyplina łącząca wiedzę operacyjną z programowaniem, aby utrzymywać usługi na wysokim poziomie niezawodności.

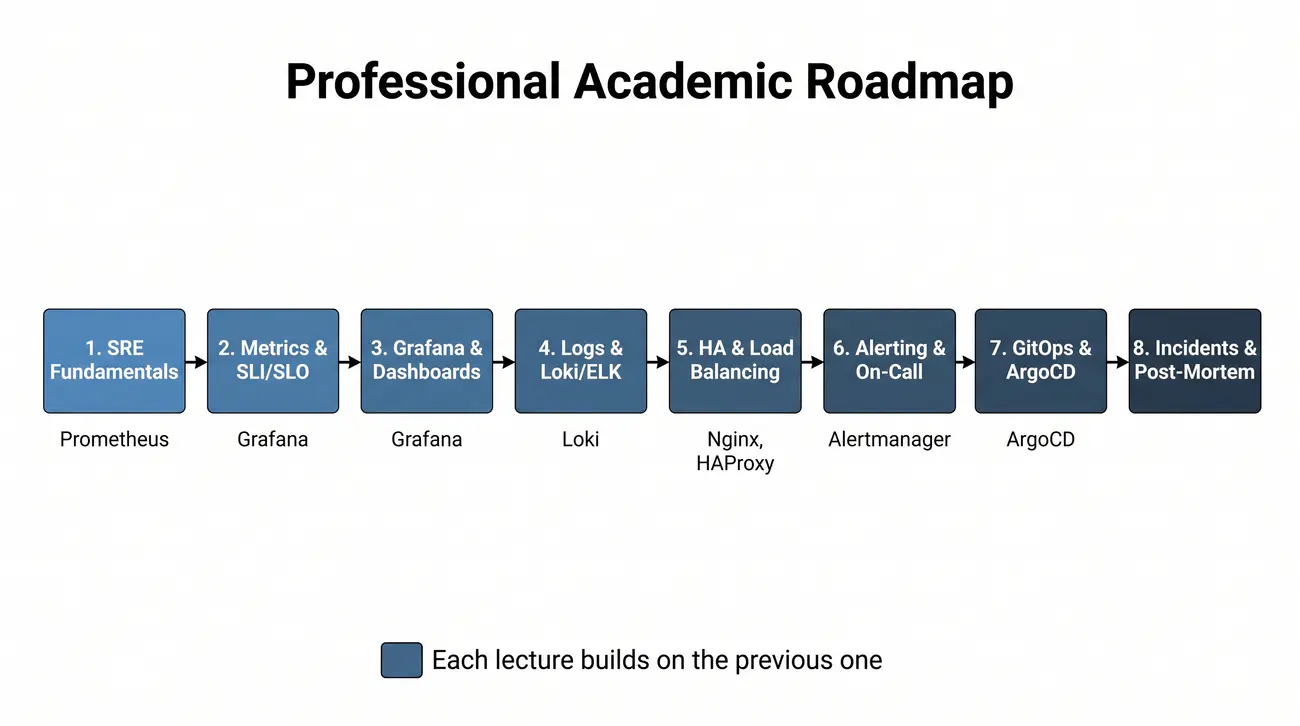
Przed nami osiem wykładów ułożonych w jedną drogę: od definicji SRE, przez monitoring i automatyzację, aż po incydenty. Każdy kolejny temat buduje na poprzednim.

  • Struktura programu – cykl ośmiu wykładów prowadzi od podstaw inżynierii niezawodności i monitoringu po zaawansowane wdrożenia GitOps i analizę awarii.
  • Warsztat inżynierski – konfiguracje systemów Linux, RouterOS i Cisco oraz skrypty w Bashu i Pythonie pochodzą ze sprawdzonych środowisk produkcyjnych.
  • Środowisko izolowane – wszelkie nowe polecenia i skrypty należy testować w piaskownicy (sandbox), eliminując ryzyko uszkodzenia działających usług.
  • Wiedza rozszerzona – sekcje dodatkowe pod slajdami zawierają wyczerpujące wyjaśnienia akademickie, szczegóły konfiguracji oraz wykaz skrótów branżowych.
  • Wymagania początkowe – zrozumienie materiału opiera się na znajomości protokołów sieciowych TCP/IP, DNS, HTTP oraz podstawowej obsługi zdalnej powłoki SSH.
Cykl wykładów SRE: Osiem powiązanych wykładów od definicji SRE po zarządzanie incydentami, ułożonych tak, że każdy kolejny temat buduje na poprzednim.
obraz tytułowy kursu

Kompendium wiedzy oraz oficjalny portal inżynierii niezawodności Google znajduje się pod adresem Site Reliability Engineering (sre.google).

Wskazówka dydaktyczna dla studenta: Inżynieria niezawodności systemów (SRE) łączy wiedzę programistyczną z administracyjną. Aby w pełni skorzystać z kursu, każde omawiane polecenie należy uruchamiać we własnym środowisku testowym (piaskownicy – sandbox), takim jak lokalna maszyna wirtualna VirtualBox lub kontener Docker. Praca w odizolowanym laboratorium pozwala na bezpieczne popełnianie błędów i badanie reakcji systemu na awarie bez ryzyka uszkodzenia rzeczywistych usług.

Kurs poświęcony jest nowoczesnemu utrzymaniu systemów informatycznych - zestawowi działań gwarantujących ciągłą i poprawną pracę usług sieciowych; w branży dyscyplina ta nosi nazwę Site Reliability Engineering (SRE), czyli inżynierii niezawodności systemów.

W trakcie ośmiu wykładów pokryjemy pełny zakres tematyczny: od definicji utrzymania i roli inżyniera SRE, przez monitorowanie (Prometheus, Grafana), wizualizację danych i analizę trendów, centralizację i analizę logów (Loki, ELK), wysoką dostępność i load balancing (Nginx, HAProxy), systemy alertingu i powiadamianie, model GitOps z ArgoCD, aż po zarządzanie incydentami i raporty post-mortem.

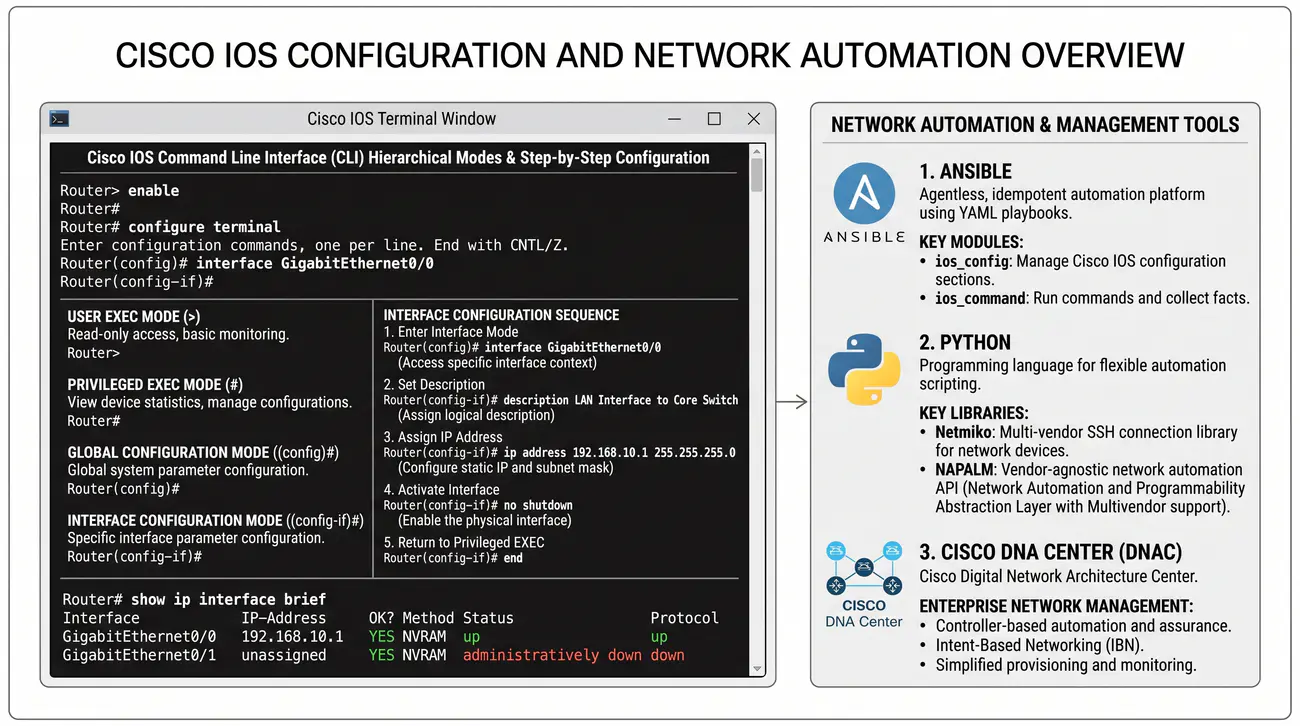
Nowoczesne utrzymanie opiera się na kontrolowanym projektowaniu i automatyzacji zamiast ręcznego naprawiania, dlatego w całym cyklu pracujemy na konsoli Linux, urządzeniach sieciowych (Cisco IOS, MikroTik RouterOS) oraz w językach Bash i Python.

Cel przedmiotu zgodnie z sylabusem to przygotowanie do samodzielnego utrzymywania usług w modelu stosowanym w firmach technologicznych; zakładamy znajomość podstaw sieci LAN i usług sieciowych (DNS, HTTP, SSH), co pozwala skupić się na praktyce.

Każdy przykład na slajdach jest weryfikowany na serwerze testowym - realne wyniki, poprawna kolejność poleceń, nawyk weryfikacji w bezpiecznym środowisku (sandbox), gdzie błędy nie niszczą produkcji.

Zanim przejdziemy do konkretów, powiem kilka słów o tym, czym jest ten kurs i czego możecie się po nim spodziewać. Mamy przed sobą osiem wykładów, z których każdy składa się z 55 slajdów. To sporo materiału, ale całość jest ułożona tak, żeby wiedza narastała stopniowo i żeby każdy kolejny temat budował na poprzednim. Zaczniemy od definicji SRE i podstaw utrzymania, potem przejdziemy do monitoringu z Prometheusem, wizualizacji danych w Grafaną, analizy logów w Loki i ELK, wysokiej dostępności i load balancingu, alertingu, GitOpsa z ArgoCD, a na końcu porozmawiamy o zarządzaniu incydentami i raportach post-mortem. Na slajdach znajdziecie przykłady konsolowe - z Linuxa, RouterOS i Cisco IOS - oraz fragmenty kodu w Bashu i Pythonie. Wszystkie zostały przetestowane na serwerze testowym, więc możecie je bezpiecznie kopiować i uruchamiać u siebie. Jedna uwaga: zakładamy, że znacie już podstawy sieci LAN i podstawowych usług sieciowych - TCP/IP, DNS, HTTP, SSH. Jeśli te terminy brzmią obco, warto nadrobić tę wiedzę zanim przejdziemy do kolejnych tematów.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; dyscyplina łącząca praktyki inżynierii oprogramowania z operacjami IT w celu tworzenia wysoce skalowalnych i niezawodnych usług teleinformatycznych.
LAN – Local Area Network – lokalna sieć komputerowa; sieć o ograniczonym zasięgu geograficznym stanowiąca podstawowe środowisko komunikacyjne dla infrastruktury serwerowej i stacji roboczych.
TCP/IP – Transmission Control Protocol / Internet Protocol – protokół sterowania transmisją / protokół internetowy; fundamentalny stos protokołów komunikacyjnych stanowiący podstawę działania sieci Internet.
DNS – Domain Name System – system nazw domenowych; rozproszona baza danych realizująca translację czytelnych dla człowieka nazw domenowych na adresy IP.
HTTP – Hypertext Transfer Protocol – protokół przesyłania dokumentów hipertekstowych; bezstanowy protokół warstwy aplikacji leżący u podstaw komunikacji w sieci WWW.
SSH – Secure Shell – bezpieczna powłoka; kryptograficzny protokół sieciowy służący do bezpiecznego, szyfrowanego zdalnego logowania i wykonywania poleceń na serwerach.

2/55 Czym jest utrzymanie systemów
Maintenance (utrzymanie) - faza operacyjna usługi po go-live; 60-80% TCO (Total Cost of Ownership).

IT to głównie utrzymywanie tego, co już działa - na to idzie 60-80% kosztów systemu. Dopiero po starcie (go-live) zaczyna się prawdziwa praca.

  • Koszty cyklu życia (TCO) – etap programowania kończy się wdrożeniem, natomiast późniejsze utrzymanie pochłania od 60% do 80% całkowitego budżetu usługi.
  • Rola zespołu operacyjnego – inżynierowie dbają o ciągłość działania usług produkcyjnych, nadzorując wdrożenia, monitoring, kopie zapasowe i bezpieczeństwo.
  • Zadania bieżące – codzienna praca obejmuje instalację poprawek, testowe przywracanie kopii, obsługę powiadomień o anomaliach oraz porządkowanie logów.
  • Inwestycja w stabilność – budżet operacyjny musi uwzględniać nie tylko serwery i łącza, lecz także profesjonalne narzędzia telemetryczne i kompetencje zespołu.
  • Fazy życia oprogramowania – każda usługa przechodzi od analizy i wdrożenia do wieloletniej eksploatacji, która stanowi najdłuższy i najbardziej wymagający etap.
Utrzymanie (maintenance): Faza operacyjna usługi po uruchomieniu (go-live), obejmująca monitoring, awarie, aktualizacje i kopie zapasowe; pochłania 60-80% całkowitego kosztu posiadania systemu (TCO).
schemat cyklu życia usługi

Dlaczego utrzymanie kosztuje więcej niż budowa: W branży IT powszechnym błędem początkujących jest przekonanie, że najtrudniejszą częścią projektu jest napisanie kodu. W rzeczywistości wdrożenie (go-live) to dopiero początek życia systemu. Wieloletnia eksploatacja wymaga nieustannej instalacji poprawek bezpieczeństwa, migracji baz danych, monitorowania wydajności i reagowania na awarie sprzętowe. Wskaźnik całkowitego kosztu posiadania (TCO – Total Cost of Ownership) pokazuje, że koszty fazy utrzymania stanowią od 60% do 80% wszystkich wydatków poniesionych na aplikację.

Utrzymanie (maintenance) to wszystkie procesy po wdrożeniu usługi, które gwarantują jej ciągłą poprawną pracę do momentu wycofania - w przeciwieństwie do budowy, która kończy się na uruchomieniu (go-live).

Pełny przebieg od projektu przez wdrożenie do wycofania (retirement) to service lifecycle (cykl życia usługi); zrozumienie tego rozróżnienia to fundament nowoczesnego utrzymania.

Codzienne zadania zespołu ops to instalowanie aktualizacji, tworzenie i weryfikacja backupów, reagowanie na awarie, rotacja logów, czyszczenie dysków - praca powtarzalna i kluczowa dla stabilności.

Standardy i ramy cyklu życia systemów teleinformatycznych promuje m.in. Ministerstwo Cyfryzacji.

Utrzymanie generuje koszty stałe (infrastruktura, ludzie, narzędzia), które muszą być w budżecie; dojrzałe organizacje planują je świadomie, a nie traktują usługi jako projektu jednorazowego.

Zespół operacyjny (ops) odpowiada za parametry działania zgodne z oczekiwaniami i stały nadzór nad produkcją; sukces zależy od dobrej dokumentacji i testowania zmian przed wdrożeniem.

Zanim przejdziemy do samego SRE, zatrzymajmy się na chwilę nad pojęciem utrzymania systemów. Wiele osób kojarzy IT z tworzeniem nowych rzeczy - pisaniem kodu, projektowaniem architektury, wdrażaniem nowych funkcji. Tymczasem okazuje się, że większość pieniędzy i czasu w branży IT pochłania nie budowanie, lecz utrzymywanie tego, co już zostało stworzone. Według powszechnie cytowanych szacunków (m.in. raportów Gartnera) od 60 do 80 procent całkowitego kosztu posiadania systemu (TCO) przypada właśnie na utrzymanie - a więc na wszystko to, co dzieje się po uruchomieniu usługi. Kiedy projekt dociera do tak zwanego go-live, czyli momentu udostępnienia użytkownikom, dopiero wtedy zaczyna się najważniejsza praca. Zespół operacyjny zajmuje się monitorowaniem, reagowaniem na awarie, instalowaniem aktualizacji, tworzeniem kopii zapasowych i setkami innych powtarzalnych czynności. To właśnie w tym momencie rodzi się potrzeba nowoczesnego podejścia do utrzymania - podejścia, jakim jest SRE.

Wyjaśnienie skrótów użytych na slajdzie:
TCO – Total Cost of Ownership – całkowity koszt posiadania; łączna suma wszystkich kosztów zakupu, wdrożenia, eksploatacji, wsparcia technicznego i wycofania systemu IT.
CAPEX – Capital Expenditure – wydatki inwestycyjne; nakłady ponoszone przez przedsiębiorstwo na zakup trwałych aktywów technologicznych, takich jak fizyczne serwery, macierze czy licencje wieczyste.
OPEX – Operational Expenditure – wydatki operacyjne; bieżące koszty ponoszone na codzienne funkcjonowanie infrastruktury, w tym opłaty chmurowe, energię i wynagrodzenia zespołu.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; prawnie wiążące porozumienie między usługodawcą a klientem definiujące parametry jakościowe i sankcje finansowe.
IT – Information Technology – technologie informacyjne; dziedzina obejmująca całokształt sprzętu, oprogramowania i procedur związanych z przetwarzaniem informacji.

3/55 Od administratora do inżyniera niezawodności
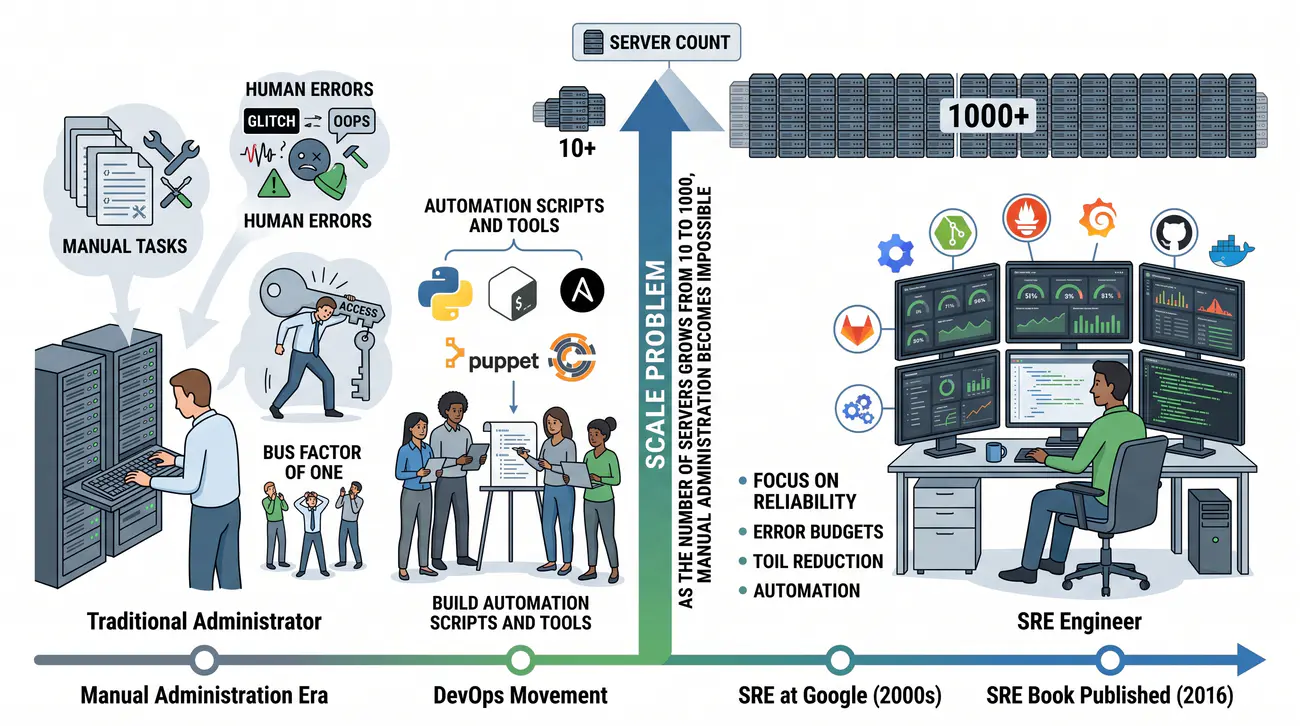
SRE powstało jako odpowiedź na ograniczenia klasycznej administracji; ręczne czynności nie skalują się przy dużej liczbie systemów.

Ręczne klikanie nie skaluje się do setek serwerów. SRE powstało, by zamiast naprawiać ręcznie, budować systemy samoutrzymujące się.

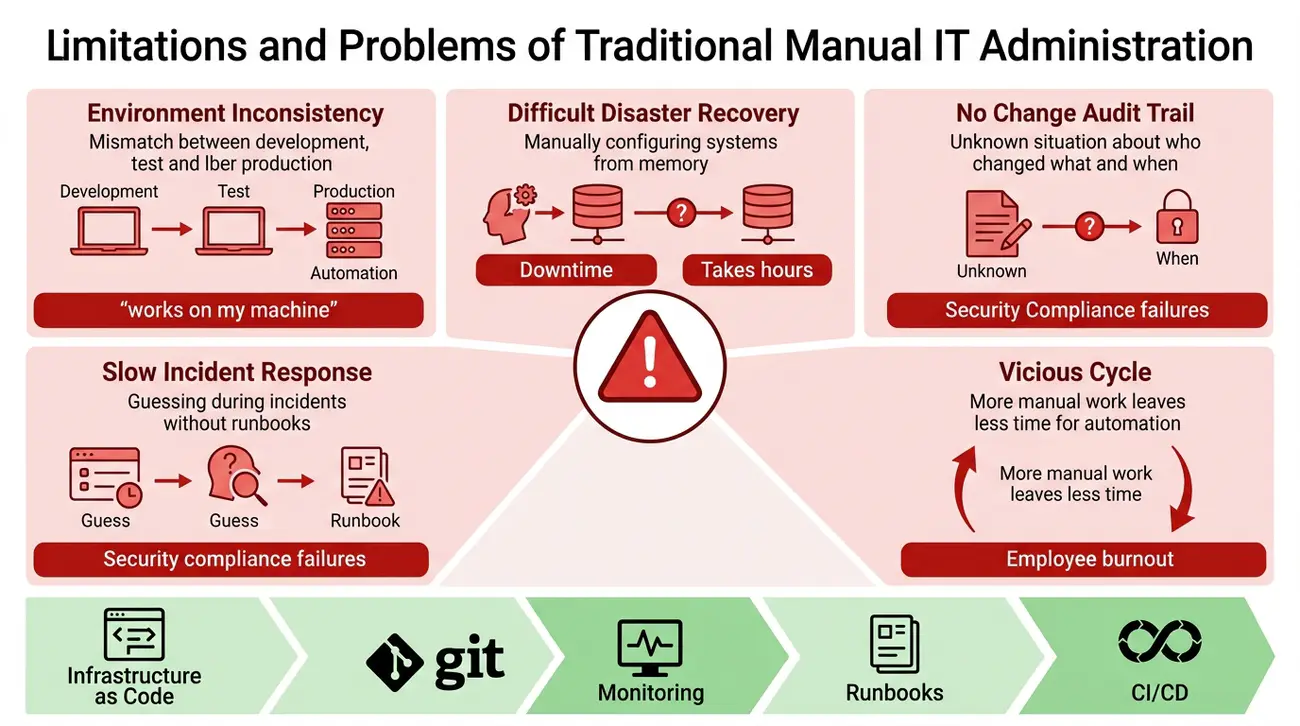
  • Ryzyko pracy manualnej – ręczne wykonywanie powtarzalnych czynności zwiększa ryzyko błędów ludzkich i uzależnia stabilność firmy od wiedzy pojedynczych osób.
  • Podejście inżynierskie – zamiast wielokrotnego konfigurowania maszyn z klawiatury tworzy się oprogramowanie i procedury, które samoczynnie zarządzają infrastrukturą.
  • Stos technologiczny SRE – inżynier niezawodności posługuje się językami skryptowymi, systemami metryk oraz narzędziami automatyzacji i konteneryzacji.
  • Geneza w firmie Google – metodyka SRE powstała w odpowiedzi na globalną skalę ruchu sieciowego, gdzie tradycyjne metody administrowania przestały wystarczać.
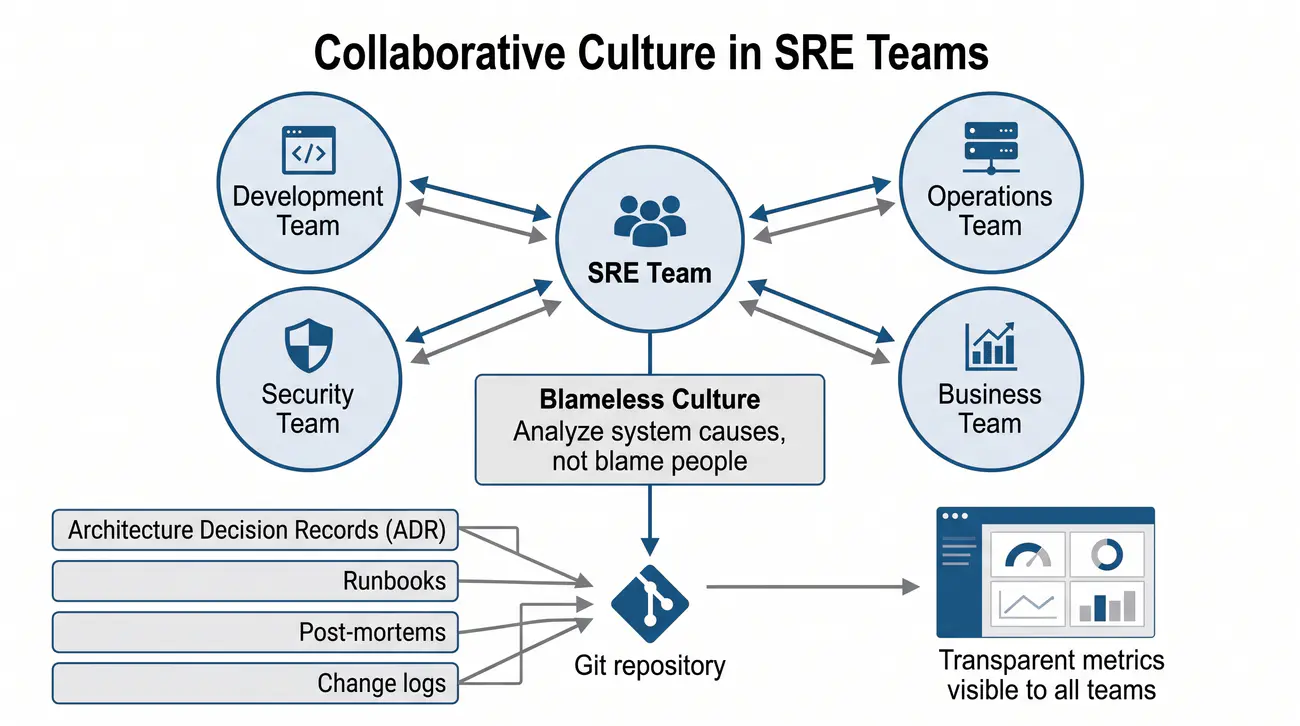
  • Kultura bezpieczeństwa – zespół opiera się na partnerskiej współpracy, zespołowej weryfikacji zmian oraz analizie awarii skupionej na usprawnieniu procedur.
Bus factor: Miara ryzyka związana z koncentracją wiedzy o systemie w głowie jednej osoby; jej odejście zostawia zespół bez tej wiedzy, czemu SRE zapobiega automatyzacją i dokumentacją.
oś czasu ewolucji ról IT

Zrozumieć pojęcie Bus Factor i kulturę Blameless: Wskaźnik bus factor (współczynnik ryzyka osobowego) określa liczbę kluczowych członków zespołu, których nagłe zniknięcie (np. choroba lub zmiana pracy) doprowadziłoby do paraliżu projektu. Jeśli tylko jedna osoba potrafi skonfigurować serwer produkcyjny, bus factor wynosi 1 – co stanowi krytyczne zagrożenie biznesowe. Odpowiedzią SRE jest automatyzacja, dokumentacja w kodzie oraz kultura blameless (bez obwiniania), w której awarie traktuje się jako okazję do naprawy wadliwych procedur, a nie szukania kozła ofiarnego.

Tradycyjny administrator ręcznie konfigurował urządzenia i reagował na awarie - to podejście nie skaluje się: zadania są powtarzalne, podatne na błędy ludzkie, niewydokumentowane, a wiedza zostaje w głowach jednostek.

Przy dużej skali ręczne utrzymanie staje się niewykonalne - zespół nie nadąża, a każda zmiana niesie ryzyko pomyłki; limitem jest ludzka przepustowość pracy ręcznej.

Rozwiązaniem jest przejście do ról automatyzowanych: inżynier niezawodności łączy wiedzę operacyjną z programowaniem, pisze skrypty, buduje monitoring, eliminuje rutynę (toil), co pozwala obsłużyć więcej systemów bez zwiększania zespołu.

Rola SRE dojrzała w Google na początku lat 2000 jako odpowiedź na problemy skali; praktyka została nazwana, udokumentowana w książce "Site Reliability Engineering" (2016) i rozpropagowana jako odrębna specjalizacja inżynierska.

Dziś stanowiska SRE istnieją w setkach firm; umiejętności skryptowania, automatyzacji i monitoringu stały się standardem w każdej poważnej roli operacyjnej - student musi je opanować.

Przez lata utrzymaniem systemów zajmowali się administratorzy - osoby, które ręcznie konfigurowały serwery, reagowały na awarie i rozwiązywały problemy na bieżąco. To podejście sprawdzało się przy małej liczbie maszyn, ale gdy firma rosła i przybywało systemów, pojawiał się problem: jeden administrator nie jest w stanie zarządzać setkami serwerów. Do tego dochodziły błędy ludzkie, brak dokumentacji i tak zwany bus factor równy jeden - jeśli jedyna osoba znająca daną konfigurację odchodzi z pracy, cały zespół zostaje bez tej wiedzy. SRE powstało właśnie jako odpowiedź na te ograniczenia. Zamiast ręcznie wykonywać te same czynności po raz setny, inżynier niezawodności pisze skrypty i narzędzia, które robią to automatycznie. To zmiana paradygmatu: z ręcznego naprawiania na budowanie systemów, które same się utrzymują. I to jest sedno tej dyscypliny.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; nowoczesny model operacyjny zastępujący manualne zarządzanie zautomatyzowanymi procesami inżynierii oprogramowania.
Sysadmin – System Administrator – administrator systemów; tradycyjna rola operacyjna skupiona na manualnej konfiguracji, instalacji i bieżącym usuwaniu nagłych awarii produkcyjnych.
VM – Virtual Machine – maszyna wirtualna; wyizolowane środowisko programowe emulujące fizyczny komputer, uruchamiane pod nadzorem hiperwizora.
CI/CD – Continuous Integration / Continuous Delivery – ciągła integracja i ciągłe dostarczanie; zautomatyzowany potok budowania, testowania i publikowania oprogramowania.
PR – Pull Request – prośba o dołączenie zmian; mechanizm weryfikacji i dyskusji nad zmianami w kodzie przed ich włączeniem do głównej gałęzi repozytorium.

4/55 Definicja SRE
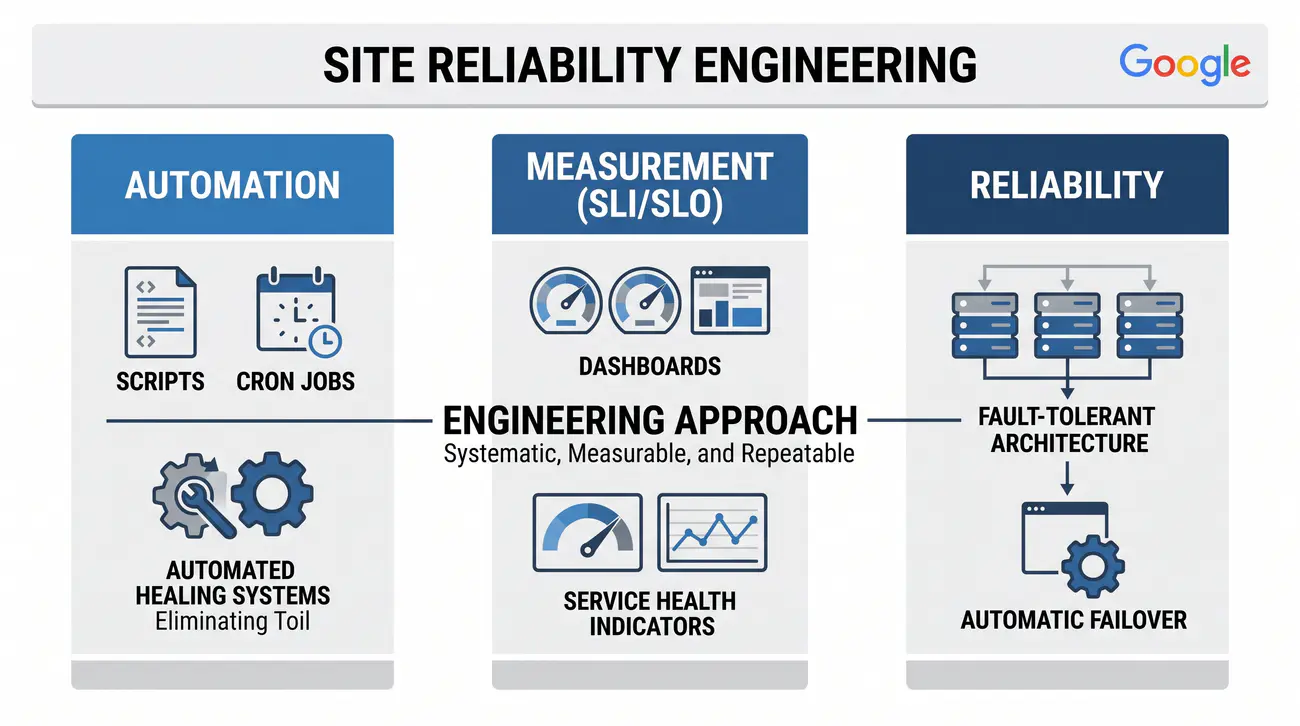
SRE = inżynieria niezawodności systemów; filary: automatyzacja, pomiar (SLI/SLO), niezawodność. Powstało w Google na początku lat 2000.

SRE to stosowanie inżynierii oprogramowania do problemów operacyjnych: zamiast restartować ręcznie, piszemy program, który robi to sam.

  • Główny cel SRE – budowa systemów zachowujących ciągłość działania pomimo awarii pojedynczych podzespołów oraz zdolnych do automatycznego skalowania.
  • Trzy filary niezawodności – fundamenty dyscypliny obejmują zastępowanie pracy żmudnej kodem, matematyczny pomiar jakości usług oraz projektowanie redundancji.
  • Porozumienie z programistami – budżet błędów stanowi obiektywną granicę dopuszczalnego ryzyka, godząc potrzebę częstych wydań z wymogiem stabilności.
  • Rygor inżynierski – zarządzanie infrastrukturą opiera się na sprawdzonych wzorcach projektowych, powtarzalnych testach i ścisłej weryfikacji empirycznej.
  • Traktowanie platformy jako produktu – infrastruktura posiada własne wymagania jakościowe i mierzalne wskaźniki, a decyzje operacyjne wynikają z faktów i metryk.
SRE (Site Reliability Engineering): Podejście do utrzymania systemów stosujące zasady inżynierii oprogramowania do problemów operacyjnych; trzy filary to automatyzacja, pomiar (SLI/SLO) i niezawodność.
logo koncepcji SRE

Odporność na awarie (Fault Tolerance) w praktyce: W systemach rozproszonych awaria sprzętu nie jest wyjątkiem, lecz statystyczną pewnością. Zamiast budować jeden „niezniszczalny” serwer, inżynieria SRE projektuje systemy w taki sposób, aby nagła utrata pojedynczej maszyny, dysku lub łącza była niewidoczna dla użytkownika końcowego. Realizuje się to za pomocą redundancji (wielu działających kopii), automatycznych mechanizmów przełączania ruchu (failover) oraz ciągłego badania stanu zdrowia usług.

SRE (Site Reliability Engineering) to dyscyplina stosująca zasady inżynierii oprogramowania do problemów operacyjnych - zamiast ręcznego restartu usługi, uzupełniania konfiguracji czy analizy logów, pisze się programy i skrypty wykonujące to automatycznie.

Trzy filary SRE to: automatyzacja powtarzalnych działań (eliminacja toil), ciągły pomiar jakości usługi (SLI, SLO, error budget) i świadoma dbałość o niezawodność (projektowanie odpornych systemów, chaos engineering).

Cel SRE: tworzenie systemów skalowalnych i niezawodnych, w których awarie pojedynczych elementów nie przerywają pracy całości; inżynier SRE traktuje system jak produkt z jasnymi wymaganiami.

Inżynier niezawodności łączy zespoły programistyczne (chcące szybkich wydań) z operacyjnymi (dbającymi o stabilność), tłumacząc ich potrzeby na język metryk i automatyzacji - to most między dev a ops.

Kanon wiedzy i doświadczeń inżynierii niezawodności udostępniono bezpłatnie w serii publikacji w serwisie Google SRE Books.

SRE to nie "nowa administracja", ale inne podejście: operacje stają się problemem inżynierskim, a nie zbiorem czynności; kluczowe terminy: reliability, operations, engineering.

Teraz zdefiniujemy to pojęcie precyzyjnie. SRE, czyli Site Reliability Engineering, to podejście do utrzymania systemów, w którym stosuje się zasady inżynierii oprogramowania do problemów operacyjnych. Zamiast ręcznie restartować usługę czy uzupełniać konfigurację, pisze się programy i skrypty, które robią to automatycznie. Stąd słowo „Engineering" w nazwie - to nie jest administracja, to jest inżynieria, czyli podejście systematyczne, mierzalne i powtarzalne. SRE opiera się na trzech filarach: automatyzacja powtarzalnych czynności, czyli eliminacja tak zwanego toil, ciągły pomiar jakości usługi za pomocą wskaźników SLI i SLO oraz świadoma dbałość o niezawodność. Cel jest prosty: tworzyć systemy, które są odporne na awarie, potrafią się automatycznie skalować i łatwo poddają się odzyskiwaniu po awarii. Inżynier SRE traktuje system jak produkt - z jasno zdefiniowanymi wymaganiami, metrykami i cyklem życia.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; sformułowany w Google paradygmat traktowania problemów operacyjnych jak zadań z zakresu inżynierii oprogramowania.
SLI – Service Level Indicator – wskaźnik poziomu usług; konkretna, mierzalna metryka liczbowa odzwierciedlająca jakość i dostępność usługi w danym momencie.
SLO – Service Level Objective – cel poziomu usług; wewnętrzny, docelowy poziom niezawodności ustalony przez zespół na podstawie wskaźnika SLI.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; kontrakt biznesowy z klientem zewnętrznym określający warunki brzegowe i kary za przestoje.
MTTR – Mean Time to Recovery – średni czas przywrócenia sprawności; kluczowa miara inżynierska określająca tempo usunięcia skutków awarii i przywrócenia usługi do działania.

5/55 Skąd pochodzi SRE
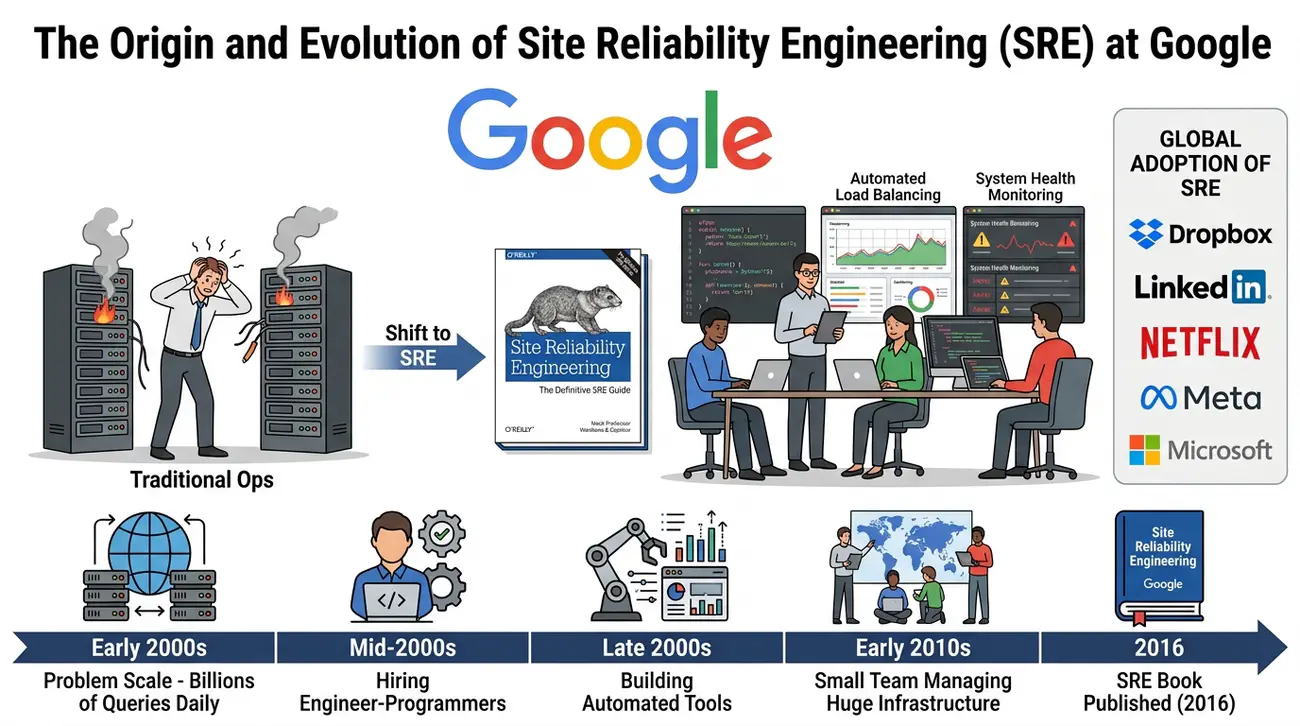
Geneza SRE - Google, początek lat 2000: miliardy zapytań dziennie, klasyczna administracja nie nadążała; książka „Site Reliability Engineering" (2016) udokumentowała tę filozofię.

Google na początku lat 2000 nie nadążało ręcznie obsługiwać miliardów zapytań. Zatrudniło programistów do budowania narzędzi - tak narodziło się SRE.

  • Wyzwanie hiper-skali – obsługa miliardów zapytań dziennie uniemożliwiła ręczne naprawianie awarii, wymuszając automatyczną detekcję i samonaprawę.
  • Programistyczne podejście do operacji – zadania utrzymaniowe powierzono inżynierom oprogramowania, którzy zastąpili rutynowe procedury algorytmami.
  • Wysoka efektywność zespołów – dzięki automatyzacji nieliczny zespół inżynierów jest w stanie stabilnie zarządzać flotą dziesiątek tysięcy serwerów.
  • Standard przemysłowy – zasady inżynierii niezawodności zostały powszechnie zaadoptowane przez globalne firmy technologiczne oraz sektor bankowy i e-commerce.
  • Kanon literatury – zasady zdefiniowane przez zespół Bena Treynora Slossa opisano w fundamentalnej monografii wydanej przez O'Reilly oraz w kanonie Google SRE.
Geneza SRE: Dyscyplina narodzona w Google na początku lat 2000 jako odpowiedź na skalę miliardów zapytań dziennie; udokumentowana w książce „Site Reliability Engineering” (2016).
historia powstawania SRE

Początki w Google: termin Site Reliability Engineering sformułował Benjamin Treynor Sloss w Google w 2003 roku, tworząc pierwszy zespół inżynierów oprogramowania dedykowany do zarządzania dostępnością systemów produkcyjnych. Monografia podsumowująca te doświadczenia ukazała się nakładem wydawnictwa O'Reilly w 2016 roku. Oficjalne materiały i publikacje dostępne są w serwisie Google SRE.

Geneza SRE sięga początku lat 2000, gdy Google musiało utrzymać systemy obsługujące miliony użytkowników - klasyczna administracja nie nadążała z ręczną obsługą skali i szybkością reakcji na awarie.

Rozwiązaniem było zatrudnienie inżynierów-programistów do budowania oprogramowania wspomagającego system: automatycznych restartów, load balancerów, narzędzi diagnostycznych - czyli oprogramowania do operacji (software for operations).

Efektem nie tylko rozwiązano problem skali, ale stworzono całą filozofię utrzymania, udokumentowaną w książce "Site Reliability Engineering" (O'Reilly, 2016), która stała się kanonem dziedziny.

Opisane metody (error budget, SLI/SLO, runbooks, blameless post-mortem) są dziś stosowane globalnie - Dropbox, LinkedIn, Netflix i wiele innych firm zaadaptowało ten wzorzec, dowodząc jego uniwersalności.

Otwarte udostępnienie wiedzy operacyjnej pozwala każdemu zespołowi uczyć się z gotowych wzorców zamiast eksperymentować latami - to kluczowa wartość społeczności SRE.

Skoro wiemy już, czym jest SRE, warto poznać jego historię. Dyscyplina ta powstała na początku lat dwutysięcznych w Google, gdzie inżynierowie musieli utrzymywać systemy obsługujące miliardy zapytań dziennie. Klasyczna administracja nie nadążała z reakcją na awarie i obsługą takiej skali. Rozwiązaniem było zatrudnienie inżynierów-programistów, którzy zamiast ręcznie naprawiać systemy, budowali narzędzia robiące to za nich - skrypty automatycznych restartów, load balancery, systemy monitoringu. Efekt przeszedł oczekiwania: niewielki zespół mógł obsługiwać ogromną infrastrukturę. W 2016 roku wydawnictwo O'Reilly Media opublikowało napisaną przez inżynierów Google książkę „Site Reliability Engineering", która udokumentowała tę filozofię i udostępniła ją światu. Od tamtej pory wzorzec ten przejęły setki firm - Dropbox, LinkedIn, Netflix i wiele innych - co dowodzi jego uniwersalności. Dziś SRE to nie tylko filozofia Google, lecz odrębna specjalizacja inżynierska, znana i stosowana na całym świecie.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; dyscyplina zainicjowana w Google w 2003 roku pod kierownictwem Benjamina Treynora Slossa.
API – Application Programming Interface – interfejs programistyczny aplikacji; sformalizowany zbiór reguł umożliwiający integrację i wymianę danych pomiędzy heterogenicznymi systemami.
OS – Operating System – system operacyjny; oprogramowanie bazowe zarządzające zasobami sprzętowymi i koordynujące wykonywanie procesów.
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji, którego masowa obsługa w wielkich centrach danych dała impuls do narodzin praktyk SRE.

6/55 SRE a DevOps
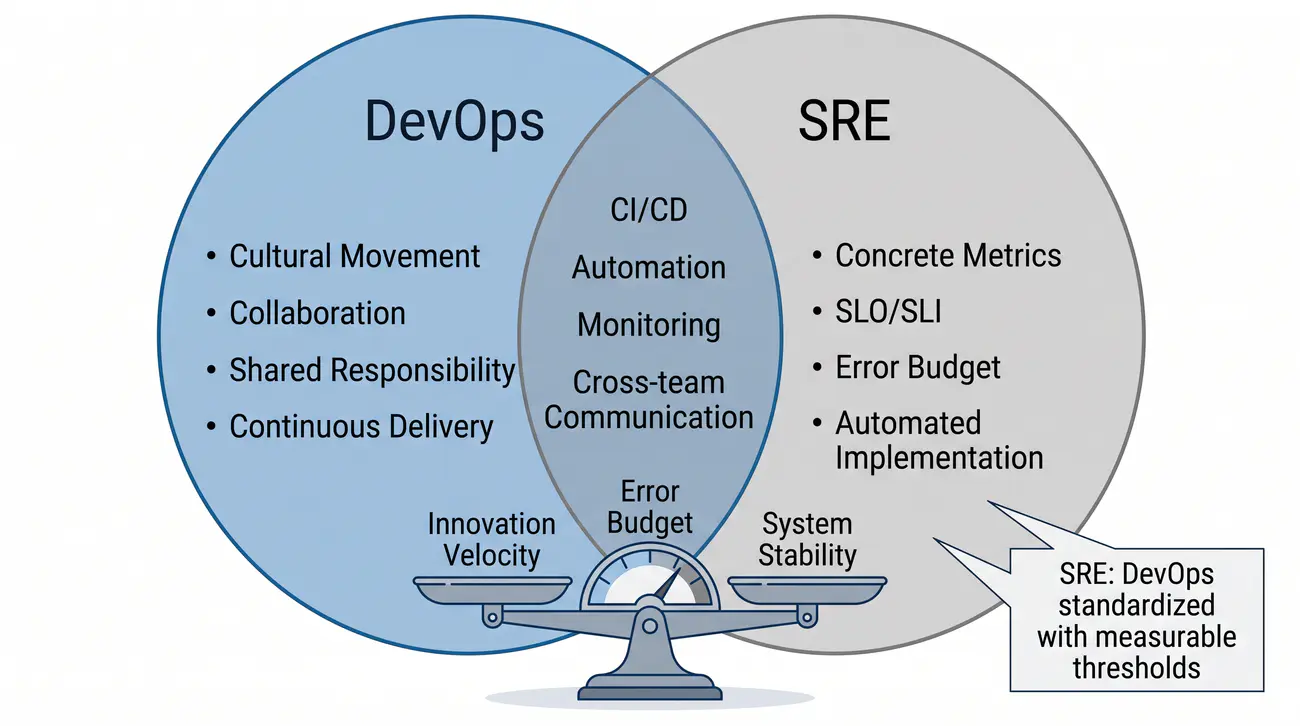
DevOps to ruch kulturowy; SRE to jego implementacja techniczna z konkretnymi metrykami (SLO, error budget). SRE = „DevOps ustandaryzowany".

DevOps i SRE to nie to samo: DevOps to kultura współpracy, SRE to jej techniczna implementacja z konkretnymi liczbami.

  • Praktyczna realizacja DevOps – metodyka SRE przekłada ogólne idee współpracy na precyzyjne reguły inżynierskie, wskaźniki SLI oraz cele SLO.
  • Wspólny mianownik – oba podejścia kładą nacisk na automatyzację potoków wdrożeniowych, traktowanie konfiguracji jak kodu oraz ciągły pomiar jakości.
  • Precyzja celów – podczas gdy DevOps definiuje filozofię dostarczania zmian, SRE precyzuje dopuszczalny próg błędów i mechanizmy ochrony stabilności.
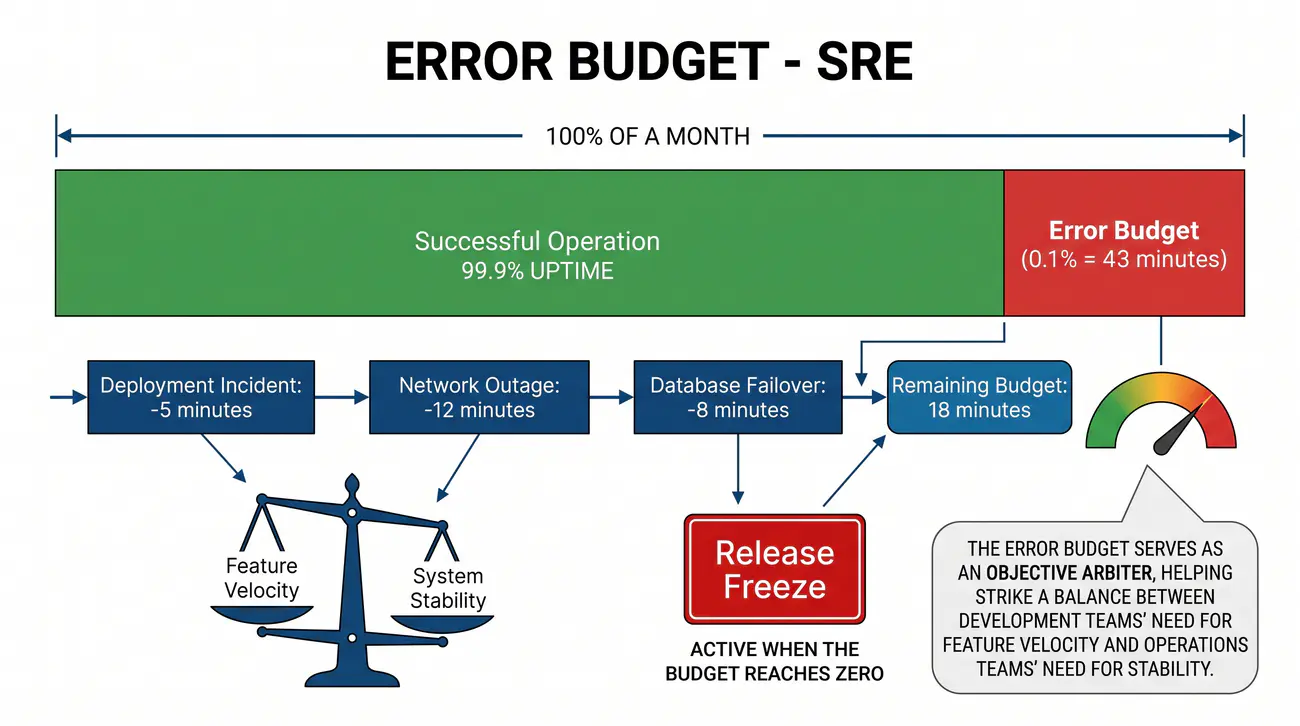
  • Obiektywny arbitraż – budżet błędów eliminuje spory kompetencyjne, wyznaczając jasną granicę: nowe funkcje wdraża się tylko przy zachowaniu stabilności.
  • Wstrzymanie wydań (freeze) – wyczerpanie dopuszczalnego marginesu awarii w danym okresie automatycznie przekierowuje siły programistów na poprawę niezawodności.
DevOps a SRE: DevOps to ruch kulturowy łączący zespoły deweloperskie i operacyjne, natomiast SRE to jego konkretna implementacja techniczna z mierzalnymi progami jakości (SLO, error budget).
mapa DevOps i SRE

Jak działa wstrzymanie wdrożeń (Release Freeze): Tradycyjny konflikt między programistami (którzy chcą jak najszybciej publikować nowe funkcje) a administratorami (którzy cenią nienaruszony spokój produkcji) rozwiązuje budżet błędów. Jeśli w danym miesiącu system działa stabilnie i budżet nie został wyczerpany, programiści mogą swobodnie wdrażać nowości. Gdy jednak seria awarii wyczerpie limit (budżet spada do zera), uruchamiana jest reguła release freeze: publikacja nowości zostaje bezdyskusyjnie zablokowana, a cały zespół skupia się na optymalizacji i naprawie stabilności.

Kluczowe wskaźniki efektywności operacyjnej zespołów inżynieryjnych bada instytut badawczy DORA (DevOps Research and Assessment).

DevOps to ruch kulturowo-techniczny łączący development i operations - współpraca, automatyzacja, ciągłe dostarczanie, shared responsibility ("you build it, you run it"); to zbiór zasad i postaw.

SRE to konkretna implementacja techniczna idei DevOps: dostarcza precyzyjne narzędzia i metryki (SLO, SLI, error budget) i wskazuje, jak je stosować w praktyce codziennej.

Wspólne cechy: automatyzacja (CI/CD, IaC), współpraca zespołów, mierzenie efektów (lead time, deployment frequency, MTTR), kultura uczenia się z błędów (blameless culture).

Kluczowa różnica: DevOps nie definiuje progów akceptacji ryzyka; SRE wprowadza SLO (np. 99.9% dostępności) i error budget - gdy budżet się wyczerpie, następuje release freeze (wstrzymanie wydań).

Error budget to mierzalny kontrakt między zespołami: decyzja o wstrzymaniu wdrożeń nie jest kwestią opinii ani polityki, lecz twardych liczb; to obiektywna granica równoważąca tempo innowacji ze stabilnością.

Często słyszymy terminy DevOps i SRE używane zamiennie, ale choć są ze sobą ściśle powiązane, nie oznaczają tego samego. DevOps to przede wszystkim ruch kulturowy - zbiór zasad i postaw, które łączą zespoły programistów i operacyjnych. Chodzi o współpracę, wspólną odpowiedzialność za kod i infrastrukturę oraz ciągłe dostarczanie wartości użytkownikom. SRE jest natomiast konkretną implementacją techniczną idei DevOps. Tam, gdzie DevOps mówi „współpracujcie i automatyzujcie", SRE dodaje: „zmierzcie to, ustawcie konkretne progi jakości i podejmujcie decyzje na podstawie liczb". Kluczowym narzędziem arbitrażu między zespołami jest tak zwany error budget, czyli budżet błędów, który mówi, ile niedostępności jest jeszcze akceptowalne. Gdy budżet się wyczerpie, wstrzymujemy wdrożenia i skupiamy się na stabilizacji. To nie jest kwestia polityki czy opinii, tylko twardych danych. Dlatego mówi się, że SRE to „DevOps ustandaryzowany" - dodaje konkretne miary i progi do ogólnych zasad kulturowych.

Wyjaśnienie skrótów użytych na slajdzie:
DevOps – Development and Operations – ruch łączący rozwój i utrzymanie oprogramowania; metodyka dążąca do integracji silosów organizacyjnych poprzez kulturę współodpowiedzialności i automatyzację.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; konkretna techniczna implementacja założeń DevOps oparta na mierzalnych wskaźnikach i inżynierii oprogramowania.
CALMS – Culture, Automation, Lean, Measurement, Sharing – ramy koncepcyjne opisujące filary dojrzałości kultury DevOps w organizacji.
DORA – DevOps Research and Assessment – zespół badawczy definiujący cztery kluczowe metryki efektywności wytwarzania i dostarczania oprogramowania.
CI – Continuous Integration – ciągła integracja; automatyzacja procesu kompilacji i weryfikacji testowej kodu po każdym zatwierdzeniu w repozytorium.

7/55 Role i odpowiedzialności SRE
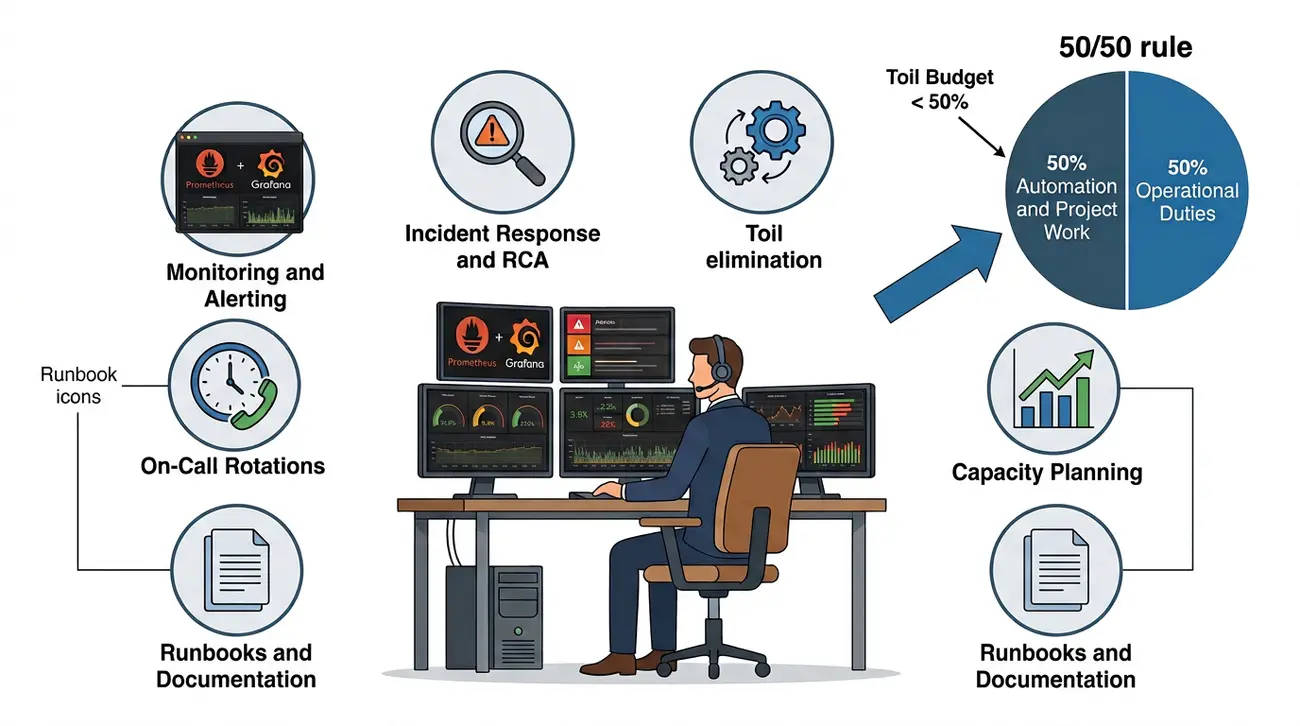
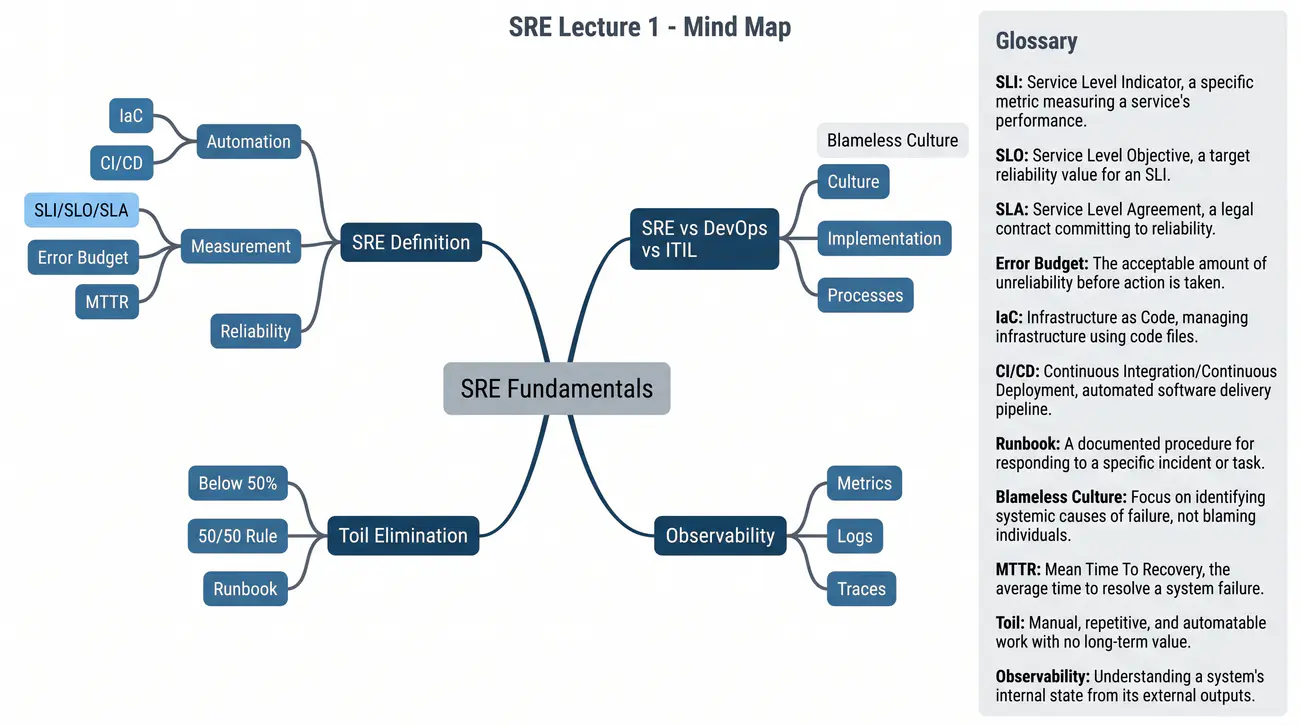
Toil - żmudna, powtarzalna praca ręczna bez trwałej wartości; cel: toil < 50% czasu zespołu (standard Google). Zasada 50/50: połowa czasu na automatyzację, połowa na operacje.

Inżynier SRE dba o stabilność produkcji systematycznie: mierzy zawczasu, reaguje na awarie bez obwiniania i usuwa ręczną rutynę.

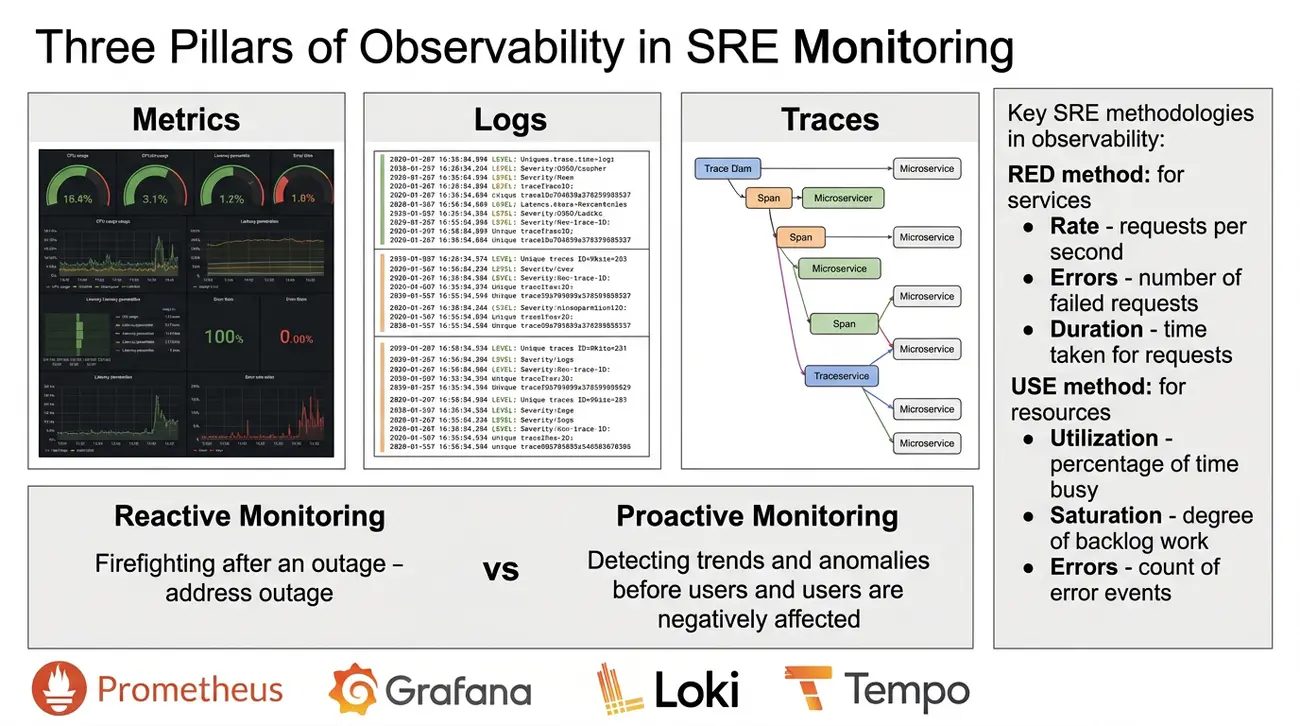
  • Obserwowalność i alarmowanie – narzędzia Prometheus, Grafana i Alertmanager wykrywają odchylenia metryk, zanim wpłyną one na użytkowników.
  • Analiza poawaryjna – po rozwiązaniu incydentu zespół sporządza dokumentację przebiegu zdarzenia i przyczyn źródłowych, nie szukając winnych wśród ludzi.
  • Redukcja pracy powtarzalnej – przekroczenie połowy czasu pracy na powtarzalne operacje jest bezwzględnym sygnałem do wdrożenia automatyzacji.
  • Organizowanie dyżurów – inżynierowie pełnią rotacyjne dyżury gotowości technicznej, posługując się precyzyjnymi instrukcjami awaryjnymi (runbookami).
  • Równowaga zadań (50/50) – co najmniej połowa czasu pracy inżyniera musi być przeznaczona na projektowanie systemów, chroniąc zespół przed przeciążeniem.
Zasada 50/50: Reguła wypracowana w Google, zgodnie z którą inżynier SRE poświęca około połowy czasu na automatyzację i rozwój, a połowę na bieżące operacje.
codzienne zadania SRE

Zasada 50% czasu pracy w Google SRE: Aby uchronić inżynierów przed utonięciem w bieżących zgłoszeniach awaryjnych (tzw. ops overload), wprowadzono twardą regułę organizacyjną: dyżury (on-call) i ręczna obsługa incydentów mogą zajmować maksymalnie 50% czasu pracy. Pozostałe 50% czasu inżynier musi poświęcić na pisanie oprogramowania, automatyzację i tworzenie instrukcji ratunkowych (runbooks), co systematycznie zmniejsza liczbę przyszłych awarii.

Inżynier SRE odpowiada za wdrażanie monitoringu i alertingu (Prometheus, Alertmanager) tak, by anomalie były wykrywane przed wpływem na użytkowników; to fundament proaktywnego utrzymania.

Po awarii prowadzi analizę przyczyn (RCA) i pisze blameless post-mortem: timeline, root cause, action items - uczciwa dokumentacja bez szukania winnych, by zespół uczył się na przyszłość.

Ciągła eliminacja toil (żmudnej pracy ręcznej, powtarzalnej, niewnoszącej wartości) przez automatyzację to cel nadrzędny; toil > 50% czasu to sygnał do inwestycji w automatyzację.

On-call (dyżury) to dostępność poza godzinami pracy z rotacją i eskalacją (L1→L2→L3); runbooki wspierają decyzje, a czas wolny kompensuje obciążenie.

Zasada 50/50 (Google): około 50% czasu na automatyzację i rozwój (projekty długofalowe), około 50% na operacje (incydenty, code review) - zapobiega uwięzieniu zespołu w trybie wyłącznie awaryjnym.

Kluczowe terminy: toil, on-call, incident response, runbook, blameless culture, error budget, SLO/SLI.

Co właściwie robi inżynier SRE na co dzień? Jego głównym zadaniem jest zapewnienie stabilności produkcji, ale robi to w sposób systematyczny. Najpierw buduje monitoring i alerting tak, żeby anomalie były wykrywane zanim zdążą dotknąć użytkowników. Potem, gdy dojdzie już do awarii, przeprowadza analizę przyczyn (RCA) i pisze raport post-mortem - dokument opisujący przebieg zdarzenia, jego przyczyny i wnioski na przyszłość. Co ważne, raport pisany jest w tak zwanej kulturze blameless, czyli bez szukania winnych: celem jest zrozumienie, co zawiodło w systemie, a nie obwinianie konkretnych osób. Obok reagowania na awarie, inżynier SRE ciągle eliminuje toil, czyli żmudną, powtarzalną pracę ręczną, która nie wnosi trwałej wartości. Cel jest taki, żeby toil stanowił mniej niż 50 procent czasu zespołu - reszta powinna iść na automatyzację i rozwój. Google stosuje tak zwaną zasadę 50/50: połowa czasu na projekty długofalowe, połowa na bieżące operacje. Do tego dochodzą dyżury (on-call) z rotacją i systemem eskalacji, wspierane runbookami, czyli instrukcjami krok po kroku na najczęstsze sytuacje kryzysowe.

Wyjaśnienie skrótów użytych na slajdzie:
Toil – Żmudna praca operacyjna; manualne, powtarzalne czynności pozbawione trwałej wartości, które wg wytycznych Google nie powinny przekraczać 50% czasu inżyniera.
RCA – Root Cause Analysis – analiza przyczyn źródłowych; metodyka badania incydentów ukierunkowana na eliminację systemowych słabości architektury.
MTTA – Mean Time to Acknowledge – średni czas potwierdzenia incydentu; okres od wygenerowania alertu przez system do podjęcia reakcji przez inżyniera dyżurnego.
MTTR – Mean Time to Repair – średni czas naprawy; wskaźnik sprawności operacyjnej zespołu w przywracaniu poprawnego działania usług produkcyjnych.
L1/L2/L3 – Poziomy wsparcia technicznego (Level 1, 2, 3); warstwowa struktura obsługi awarii, w której wyższe szczeble odpowiadają za zaawansowane problemy inżynierskie.

8/55 Czym jest toil (żmudna praca)
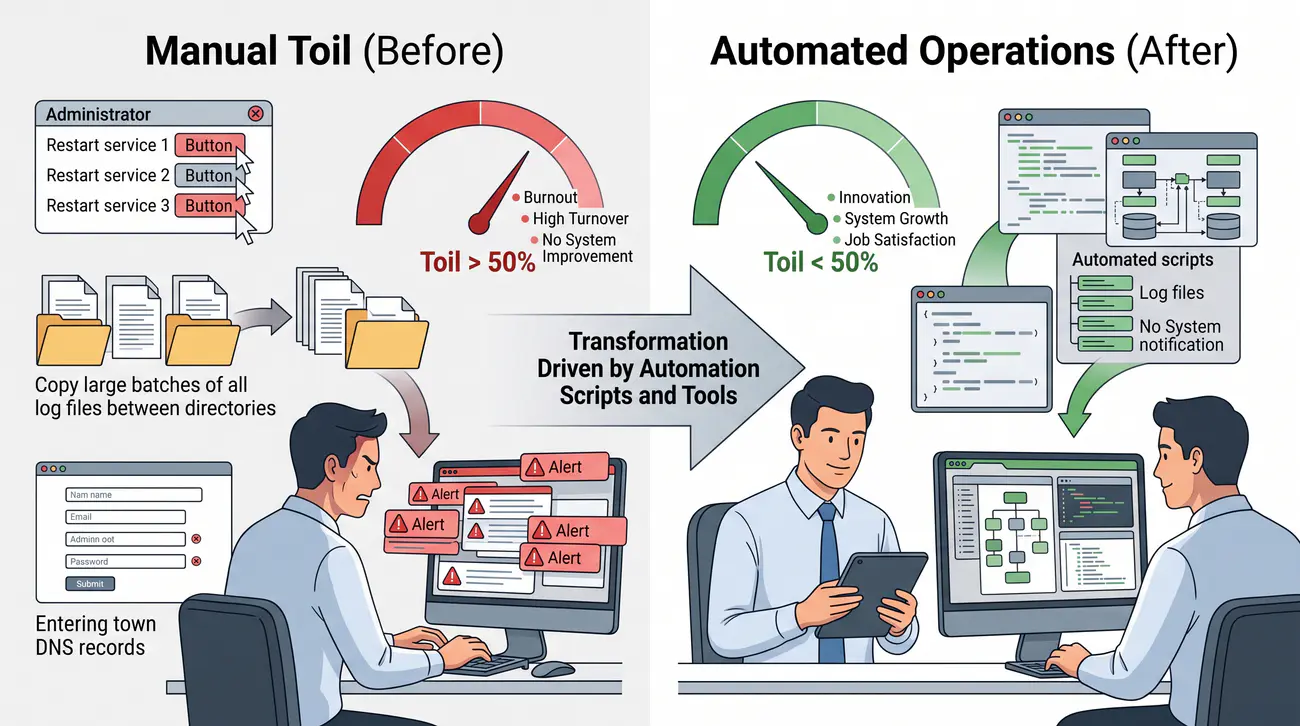
Toil - praca ręczna, powtarzalna, skalująca liniowo, niewnosząca trwałej wartości. Przykłady: ręczne restarty, wpisy DNS, kopiowanie logów.

Toil to ręczna, powtarzalna praca bez trwałej wartości - rośnie liniowo z liczbą maszyn i wypala zespół. SRE z nim walczy.

  • Przykłady pracy żmudnej (toil) – ręczne restartowanie usług, wpisywanie rekordów DNS czy kopiowanie logów to zadania, które powinny wykonywać skrypty.
  • Liniowy wzrost obciążenia – przy pracy manualnej podwojenie liczby serwerów wymaga podwojenia liczby administratorów, co prowadzi do impasu organizacyjnego.
  • Negatywne konsekwencje – monotonna i powtarzalna praca hamuje rozwój technologiczny systemów oraz prowadzi do szybkiego wypalenia zawodowego inżynierów.
  • Standard redukcji toilu – zgodnie z regułą Google SRE zadania manualne nie mogą przekraczać 50% czasu pracy, a każda rutyna musi zostać zautomatyzowana.
  • Warunek skalowalności – automatyzacja nie jest opcjonalnym udogodnieniem, lecz fundamentalnym warunkiem stabilnego wzrostu przedsiębiorstwa.
Toil: Żmudna, powtarzalna praca ręczna niewnosząca trwałej wartości i skalująca się liniowo z liczbą systemów; jej nadmiar prowadzi do wypalenia, a cel SRE to utrzymanie jej poniżej 50% czasu zespołu.
porównanie pracy ręcznej i zautomatyzowanej

Pięć cech toilu (pracy żmudnej): Zgodnie z oficjalną definicją Google SRE, czynność jest uznawana za toil, jeśli spełnia następujące kryteria: jest wykonywana manualnie, powtarza się cyklicznie, można ją zautomatyzować za pomocą programu, ma charakter taktyczny (doraźny, skupiony na powierzchownych skutkach zamiast eliminować przyczyny źródłowe) oraz nie wnosi trwałej wartości inżynierskiej do systemu. Co gorsza, nakład toilu rośnie liniowo wraz ze wzrostem liczby użytkowników, jeśli nie zostanie zatrzymany przez automatyzację.

Zgodnie ze standardem inżynierii SRE, praca żmudna (toil) charakteryzuje się sześcioma kryteriami:
1. Manualność – wykonywanie czynności ręcznie na konsoli zamiast przez oprogramowanie,
2. Powtarzalność – wielokrotne rozwiązywanie tego samego zagadnienia operacyjnego,
3. Automatyzowalność – zadanie, które może zostać zrealizowane przez program lub skrypt,
4. Brak trwałej wartości – po wykonaniu zadania stan systemu wraca do normy bez trwałego ulepszenia,
5. Charakter taktyczny – reaktywne gaszenie problemu zamiast proaktywnego projektowania,
6. Skalowanie liniowe – zapotrzebowanie na nakład pracy rośnie wprost proporcjonalnie do skali ruchu lub liczby węzłów.
Cel zespołu to ograniczenie udziału toil poniżej 50% całkowitego czasu pracy, z przeznaczeniem pozostałej części na inżynierię oprogramowania i automatyzację.

Negatywny wpływ: zespół zajęty operacjami nie rozwija systemu, jakość utrzymania spada, monotonna praca prowadzi do wypalenia (burnout), wysokiej rotacji i kosztów rekrutacji - krąg zamknięty.

Cel SRE: eliminacja toil przez automatyzację - każde powtarzalne działanie ma swój skrypt lub narzędzie; sukces mierzony jako toil < 50% czasu zespołu (standard Google).

Granica 50%: jeśli toil przekracza połowę czasu zespołu, to sygnał do przeznaczenia zasobów na automatyzację; to metryka zdrowia zespołu i procesu.

Wypalenie zawodowe przy nadmiarze toil to realne zagrożenie: ucieczka wiedzy, dalsze pogorszenie operacji - automatyzacja to nie "nice to have", lecz konieczność.

Toil to termin, który w SRE odgrywa kluczową rolę, a który na co dzień bywa ignorowany. Oznacza żmudną, powtarzalną pracę ręczną, która nie wnosi trwałej wartości i skaluje się liniowo z liczbą systemów - im więcej maszyn, tym więcej pracy, bez żadnego postępu. Wyobraźcie sobie administratora, który codziennie ręcznie restartuje tę samą usługę, wpisuje rekordy DNS albo kopiuje logi do analizy. Za każdym razem wykonuje dokładnie tę samą czynność, niezależnie od tego, ile razy to zrobił - ani nie przyspiesza, ani nie tworzy niczego, co mogłoby zostać wykorzystane ponownie. To jest właśnie toil. Problem polega na tym, że jeśli zespół spędza więcej niż 50 procent czasu na tego rodzaju pracy, nie rozwija systemu, nie buduje automatyzacji i nie poprawia jakości usług. Monotonna praca prowadzi do wypalenia zawodowego, rotacji pracowników i spadku jakości utrzymania - koło się zamyka. Dlatego eliminacja toil jest jednym z głównych celów SRE: każde powtarzalne działanie powinno mieć swój skrypt lub narzędzie.

Wyjaśnienie skrótów użytych na slajdzie:
Toil – Praca żmudna; powtarzalne czynności manualne bez wartości dodanej, które skalują się liniowo z rozmiarem infrastruktury i prowadzą do wypalenia zawodowego.
DNS – Domain Name System – system nazw domenowych; ręczna edycja stref DNS stanowi podręcznikowy przykład toil, podlegający automatyzacji przez API.
OPEX – Operational Expenditure – wydatki operacyjne; nadmiar pracy żmudnej powoduje nieefektywny wzrost kosztów osobowych w budżecie IT.
CLI – Command Line Interface – interfejs wiersza poleceń; środowisko tekstowe wykorzystywane do manualnego lub zautomatyzowanego wydawania dyspozycji systemowych.

9/55 Niezawodność jako produkt
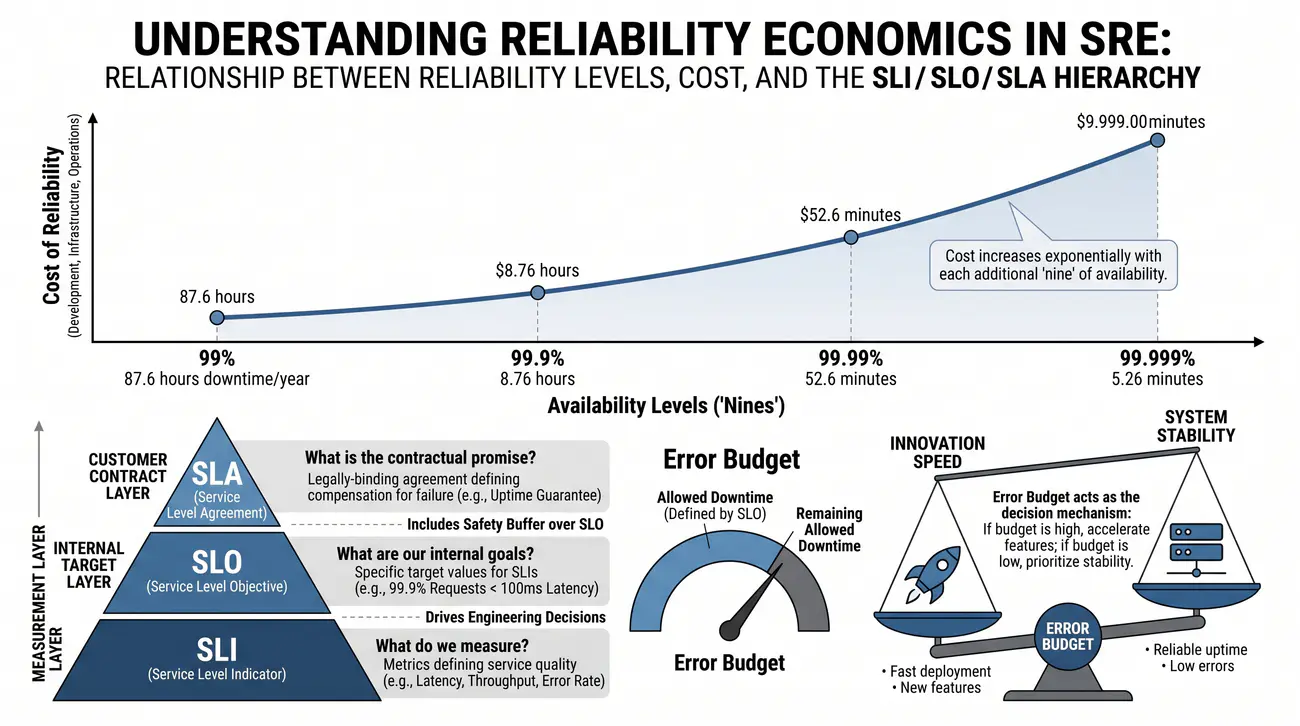
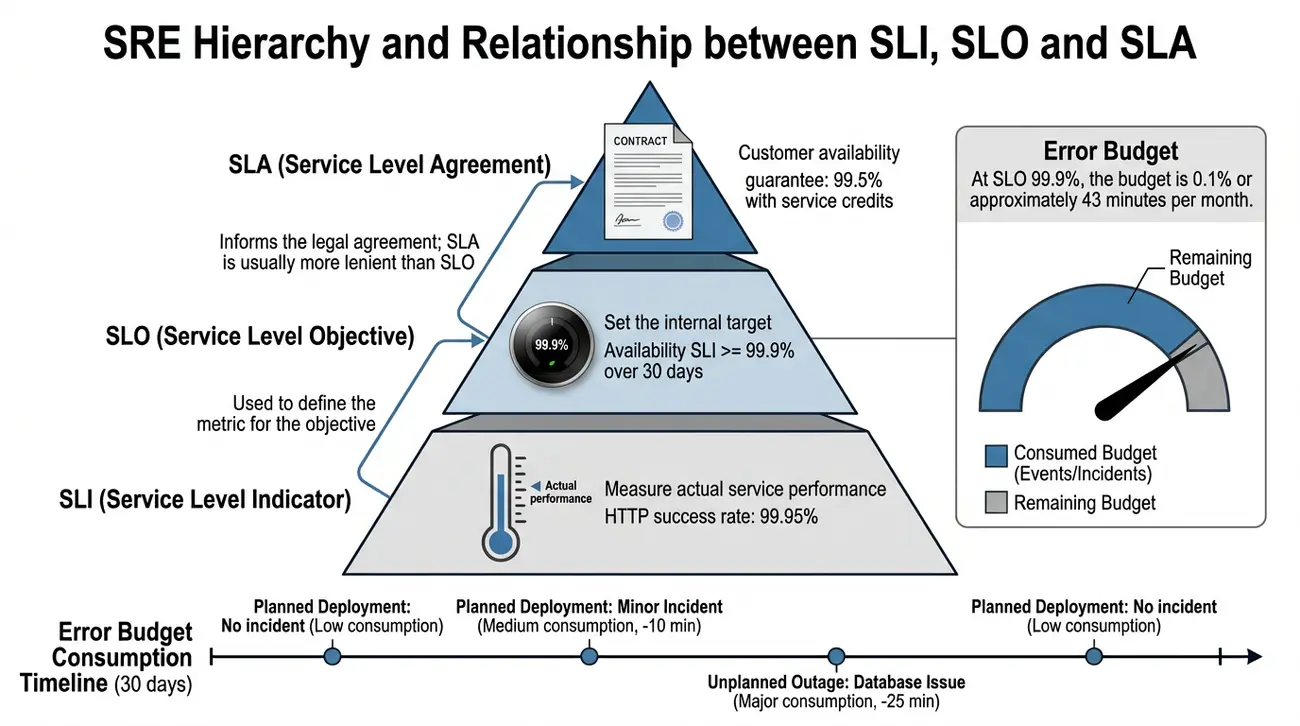
SLI (Service Level Indicator) - mierzalna metryka stanu usługi. SLO (Service Level Objective) - cel jakościowy. SLA - umowa z klientem. Koszt niezawodności rośnie wykładniczo z każdym dodatkowym „9".

Niezawodność w SRE to produkt: planujesz ją (SLO), mierzysz (SLI) i sprzedajesz klientowi (SLA). Każde kolejne „9” kosztuje wykładniczo.

  • Wskaźnik jakości (SLI) – empiryczny pomiar bieżącej pracy usługi, np. odsetek zapytań obsłużonych bez błędu lub czas odpowiedzi dla 99% użytkowników.
  • Znaczenie czasu odpowiedzi – spadek wydajności i wysoka latencja są dla odbiorcy równie uciążliwe jak całkowita niedostępność usługi teleinformatycznej.
  • Wykładniczy koszt niezawodności – podniesienie dostępności z 99,9% do 99,99% drastycznie ogranicza dopuszczalny przestój i wymaga kosztownej redundancji.
  • Budżet błędów jako bufor innowacji – zapas dopuszczalnej niedostępności pozwala bezpiecznie wdrażać nowe wersje aplikacji i eksperymentować.
  • Hierarchia pojęć jakościowych – wskaźnik SLI mierzy rzeczywistość, cel SLO określa wymóg zespołu, a umowa SLA definiuje zobowiązania prawne wobec klientów.
Hierarchia SLI → SLO → SLA: SLI to mierzalna metryka stanu usługi, SLO to wewnętrzny cel jakościowy wyznaczony na jej podstawie, a SLA to umowa z klientem, zwykle luźniejsza i z buforem bezpieczeństwa.
wykres zależności niezawodności od kosztów

Dlaczego powolne działanie to też awaria: Dla studenta kluczowe jest zrozumienie, że wysoka latencja (długi czas oczekiwania na odpowiedź) jest przez użytkownika odbierana niemal tak samo jak błąd serwera. Jeśli witryna ładuje się kilkanaście sekund, zniecierpliwiony klient opuszcza aplikację. Z tego względu cele jakościowe SLO definiują nie tylko procent odpowiedzi bez kodu błędu HTTP 500, lecz także precyzyjny próg czasowy (np. 99% zapytań obsłużonych w czasie poniżej 200 ms).

Wskaźniki SLI muszą precyzyjnie oddawać percepcję użytkownika:
- Latencja musi być mierzona percentylami (p50, p95, p99), ponieważ średnia arytmetyczna maskuje drastyczne opóźnienia dotykające mniejszości zapytań (tzw. problem długiego ogona),
- Budżet błędów stanowi różnicę: EB = 100% - SLO (np. przy SLO na poziomie 99,9% margines niedostępności wynosi 0,1%, co odpowiada około 43 minutom przestoju w skali 30 dni),
- Wskaźnik spalania budżetu (Burn Rate) określa tempo zużywania marginesu błędów; wartość Burn Rate równa 1 oznacza równomierne wykorzystanie budżetu w przyjętym oknie pomiarowym, natomiast wartość powyżej 1 sygnalizuje konieczność wdrożenia procedury stabilizacyjnej (Release Freeze).

Niezawodność w SRE to mierzalny produkt: da się zaplanować (SLO), zmierzyć (SLI), dostarczyć (dashboards, raporty) i negocjować z biznesem lub klientem - to nie hasło, lecz liczba.

Wskaźniki jakości (SLI): dostępność (uptime %), latencja (p50/p95/p99), error rate, throughput, poprawność danych - wybór zależny od charakteru usługi (user-facing vs batch).

Związek z UX: użytkownik czuje "wolno" - metryki pokazują wzrost p95 z 100 ms na 500 ms; nawet rzadkie błędy degradują odbieraną jakość; subiektywne odczucie < obiektywne liczby.

Koszt wysokiej niezawodności rośnie wykładniczo: każde dodatkowe "9" (99.9%→99.99%→99.999%) oznacza więcej nadmiarowości, testów, ekspertów i złożoności; to wybór ekonomiczny, nie techniczny.

Równowaga features vs stabilność: error budget jako waluta - budżet wolny = deploy, budżet wyczerpany = freeze; SRE arbitruje konflikt interesów dev (velocity) vs ops (stability).

Wstęp do SLI/SLO/SLA (szczegóły w wykładzie 2): SLI=miara, SLO=cel, SLA=umowa z klientem (zazwyczaj luźniejsza, z buforem bezpieczeństwa).

W SRE niezawodność nie jest abstrakcyjnym pojęciem - jest produktem, który da się zaplanować, zmierzyć i dostarczyć. Mówimy tu o trzech poziomach: SLI, SLO i SLA. SLI, czyli Service Level Indicator, to konkretna mierzalna metryka stanu usługi - na przykład procent czasu, gdy serwer odpowiada poprawnie, albo wartość percentyla czasu odpowiedzi. Na podstawie SLI definiuje się SLO, czyli Service Level Objective, który jest wewnętrznym celem jakościowym - na przykład „dostępność usługi musi wynosić co najmniej 99,9% w oknie 30 dni". Na końcu mamy SLA, czyli umowę z klientem, która zazwyczaj jest luźniejsza niż SLO i zawiera bufor bezpieczeństwa. Istotne jest to, że koszt niezawodności rośnie wykładniczo z każdym dodatkowym „9". Przejście z 99,9% na 99,99% dostępności oznacza budowę redundancji, dodatkowe testy i ekspertów - a wszystko to kosztuje coraz więcej. Dlatego wybór poziomu niezawodności to w dużej mierze decyzja ekonomiczna, a nie wyłącznie techniczna. Kluczem jest pojęcie error budget - budżet błędów, który mówi, ile niedostępności mamy jeszcze do dyspozycji. Jeśli budżet jest wolny, możemy wdrażać nowe funkcje; jeśli się wyczerpie, wstrzymujemy zmiany i stabilizujemy system.

Wyjaśnienie skrótów użytych na slajdzie:
SLI – Service Level Indicator – wskaźnik poziomu usług; metryka telemetryczna pozwalająca na empiryczną ocenę stopnia spełnienia wymagań jakościowych przez usługę.
SLO – Service Level Objective – cel poziomu usług; punkt odniesienia dla stabilności systemu, decydujący o tempie wdrażania nowych funkcjonalności.
SLA – Service Level Agreement – umowa o poziomie usług; kontrakt z odbiorcą zewnętrznym, którego złamanie skutkuje konsekwencjami prawno-finansowymi.
UX – User Experience – doświadczenie użytkownika; całościowy odbiór jakości usługi przez klienta, na który bezpośrednio wpływają opóźnienia i niedostępność.

10/55 Cykl życia usługi sieciowej
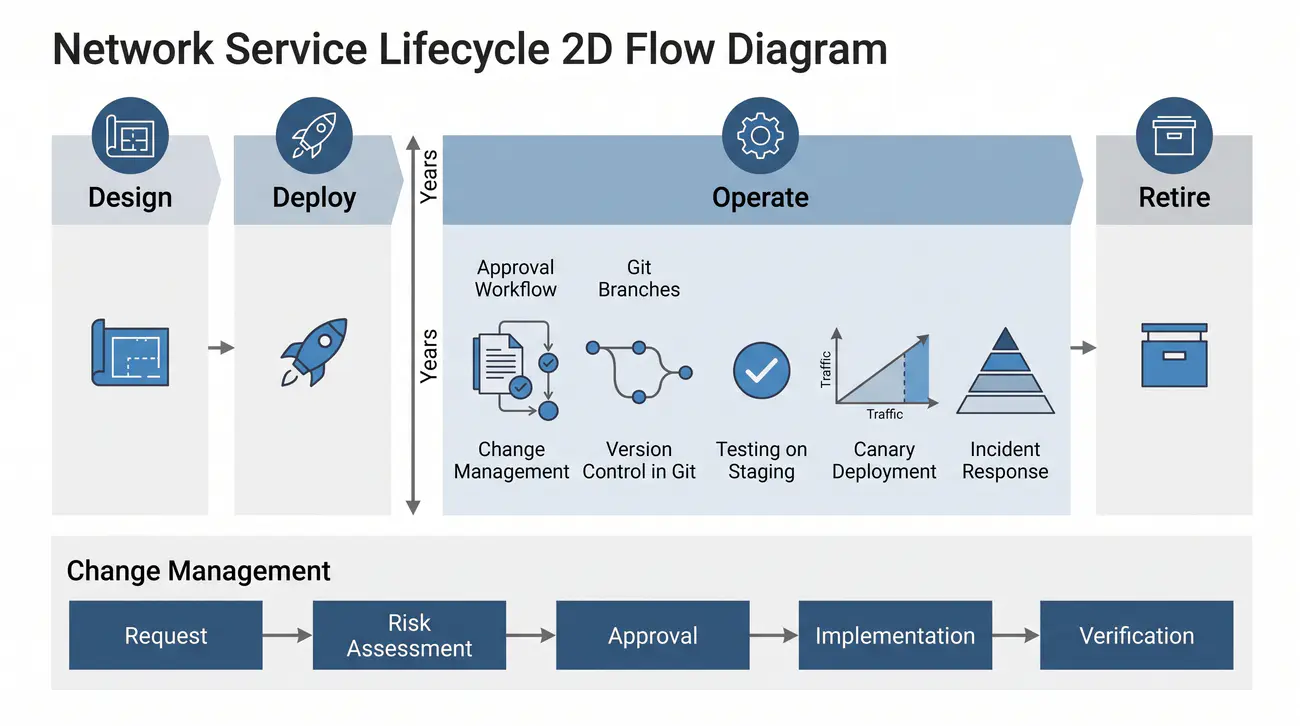
Service lifecycle - cykl życia usługi: projekt → wdrożenie → operacje → wycofanie. Zarządzanie zmianami (change management) minimalizuje ryzyko awarii.

Usługa żyje długo po wdrożeniu: projekt, start, lata operacji i wycofanie. Zmiany w działającym systemie muszą iść formalną ścieżką.

  • Zarządzanie zmianą – ustrukturyzowany proces oceny i akceptacji modyfikacji infrastruktury chroni środowisko produkcyjne przed niesprawdzonymi zmianami.
  • Kontrola wersji konfiguracji – przechowywanie manifestów w systemie Git zapewnia pełną historię, zespołową weryfikację oraz możliwość natychmiastowego wycofania błędu.
  • Stopniowe wdrażanie zmian – techniki canary i blue-green pozwalają udostępnić nową wersję wąskiej grupie użytkowników, minimalizując ryzyko awarii masowej.
  • Przygotowanie procedur ratunkowych – zdefiniowane wcześniej ścieżki eskalacji, instrukcje runbook oraz wskaźniki MTTA i MTTR pozwalają opanować kryzys bez chaosu.
  • Synergia ITIL i SRE – biblioteka dobrych praktyk ITIL zapewnia ład organizacyjny i procesowy, podczas gdy inżynieria SRE wnosi automatyzację i pomiar telemetryczny.
Change management: Kontrolowane wprowadzanie zmian do działającego systemu według formalnej ścieżki od zgłoszenia przez ocenę i akceptację po wdrożenie i weryfikację, minimalizujące ryzyko awarii.
diagram cyklu życia usługi

Techniki bezpiecznych wdrożeń – Canary i Blue-Green: Aby uniknąć sytuacji, w której błąd w nowej wersji programu natychmiast dotyka wszystkich klientów, stosuje się stopniowanie wdrożeń. W strategii kanarkowej (canary) nowy kod udostępnia się najpierw zaledwie 1-2% użytkowników; jeśli telemetria nie wykaże wzrostu błędów, ruch jest stopniowo zwiększany. W strategii blue-green utrzymuje się dwa równoległe środowiska produkcyjne – nowe wydanie testuje się na nieaktywnej infrastrukturze, po czym jednym przełączeniem routera kieruje się na nią cały ruch.

Standardy zarządzania cyklem życia usług teleinformatycznych opierają się na normach PKN (PN-EN ISO/IEC 20000) oraz metodyce ITIL.

Cykl życia usługi nie kończy się na wdrożeniu (go-live) - po uruchomieniu następuje faza operacyjna: używanie, obserwowanie, utrzymywanie, doskonalenie, aż do wycofania lub zastąpienia nową wersją.

Change Management (zarządzanie zmianami) to kontrolowane wprowadzanie poprawek i funkcji: request → assess → approve → implement → verify → close; minimalizacja ryzyka produkcji przez procedury.

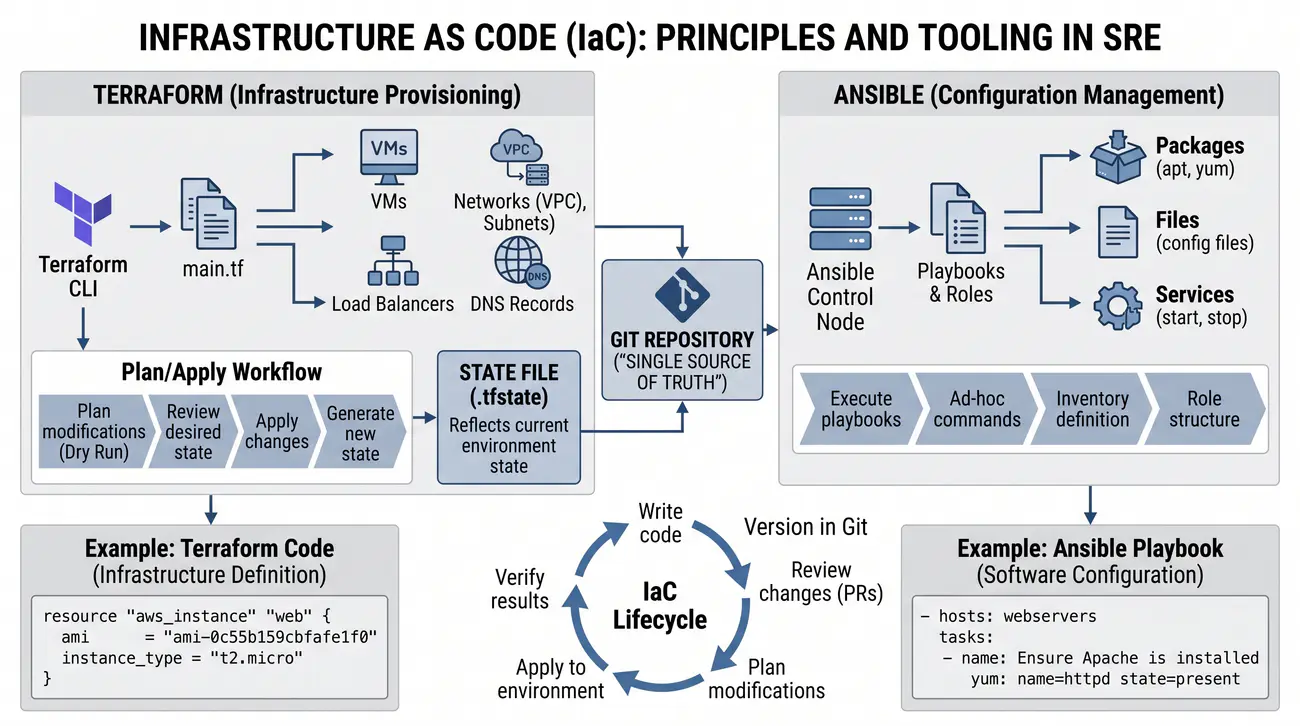
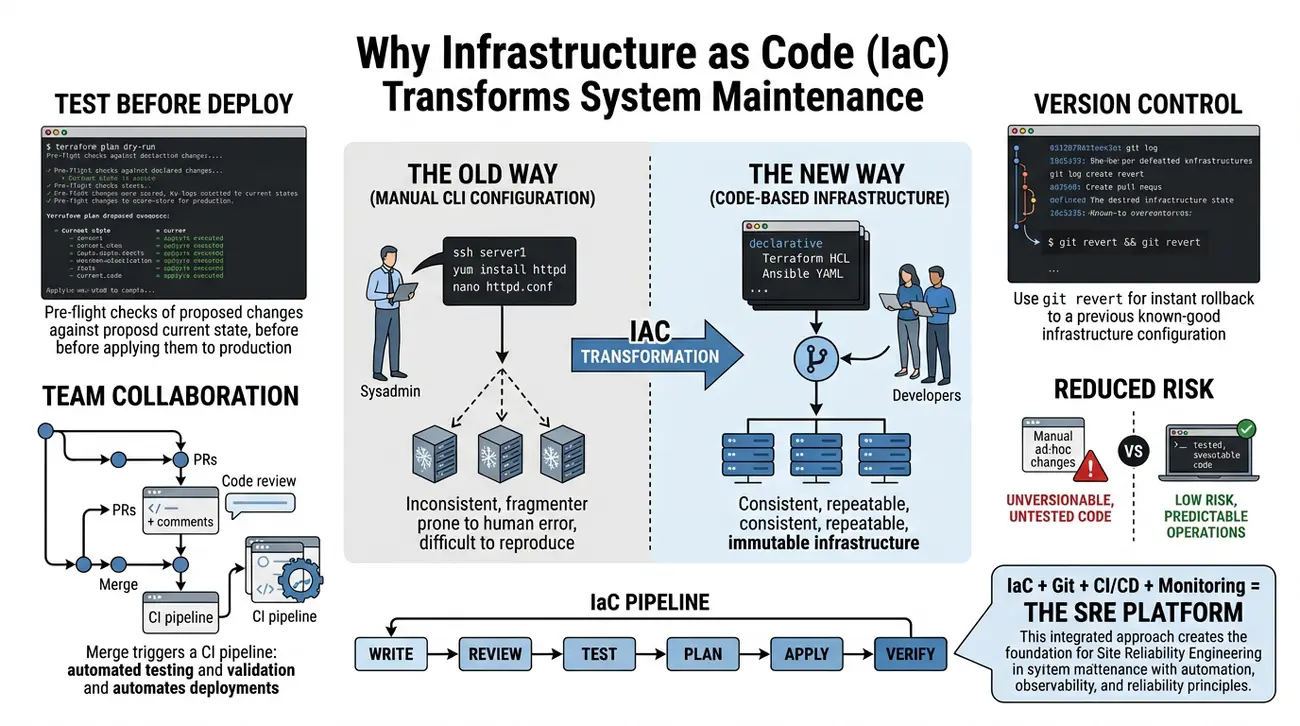
Version Control konfiguracji (Git/IaC): historia zmian, audit, rollback, code review, CI gates - każda modyfikacja widoczna i odwracalna.

Testowanie przed wdrożeniem: unit/integration/contract testy, staging env, canary deployments, automated rollback na metrykach - "testuj przed deployem".

Reakcja na incydenty: procedury eskalacji, runbooks, war room, post-mortem - przygotowanie przed awarią, nie w trakcie; MTTA/MTTR jako miary sprawności.

Wstęp do ITIL: ITIL formalizuje te procesy (change, incident, problem management) - SRE dodaje automatyzację i metryki do ram procesowych.

Każda usługa sieciowa przechodzi przez cykl życia, który nie kończy się w momencie uruchomienia. Zaczyna się od projektu, potem jest wdrożenie, a następnie - i to jest najdłuższa faza - operacje, czyli bieżące utrzymanie. Dopiero po latach, gdy usługa staje się przestarzała lub zostaje zastąpiona nowszą wersją, następuje wycofanie. Kluczowym elementem fazy operacyjnej jest zarządzanie zmianami (change management), czyli kontrolowane wprowadzanie modyfikacji do działającego systemu. Każda zmiana - czy to poprawka bezpieczeństwa, nowa funkcja, czy aktualizacja konfiguracji - powinna przejść przez formalną ścieżkę: od zgłoszenia, przez ocenę ryzyka, aż po wdrożenie i weryfikację. W tym kontekście niezwykle ważna jest wersjonacja konfiguracji w systemie Git, który umożliwia śledzenie historii zmian, przeprowadzanie przeglądów kodu i szybki powrót do poprzedniej wersji w razie problemów. Przed wdrożeniem na produkcję przeprowadza się testy na środowisku stagingowym, a same wdrożenia realizowane są metodami takimi jak canary deployment czy blue-green deployment, które minimalizują ryzyko awarii. Całość uzupełniają procedury reakcji na incydenty - eskalacja, war room, runbooki i post-mortem, o których szerzej w późniejszych wykładach.

Wyjaśnienie skrótów użytych na slajdzie:
ITIL – Information Technology Infrastructure Library – biblioteka infrastruktury technologii informacyjnych; zestaw powszechnie uznanych praktyk zarządzania usługami IT.
CAB – Change Advisory Board – komitet doradczy ds. zmian; organ powoływany do formalnej oceny i autoryzacji zmian w infrastrukturze produkcyjnej.
MTTA – Mean Time to Acknowledge – średni czas od wystąpienia awarii do potwierdzenia podjęcia działań naprawczych.
MTTR – Mean Time to Recovery – średni czas od momentu awarii do pełnego wznowienia świadczenia usługi.
CI/CD – Continuous Integration / Continuous Delivery – zautomatyzowany potok wdrażania zmian technologicznych minimalizujący ryzyko błędów wdrożeniowych.

11/55 Wprowadzenie do ITIL
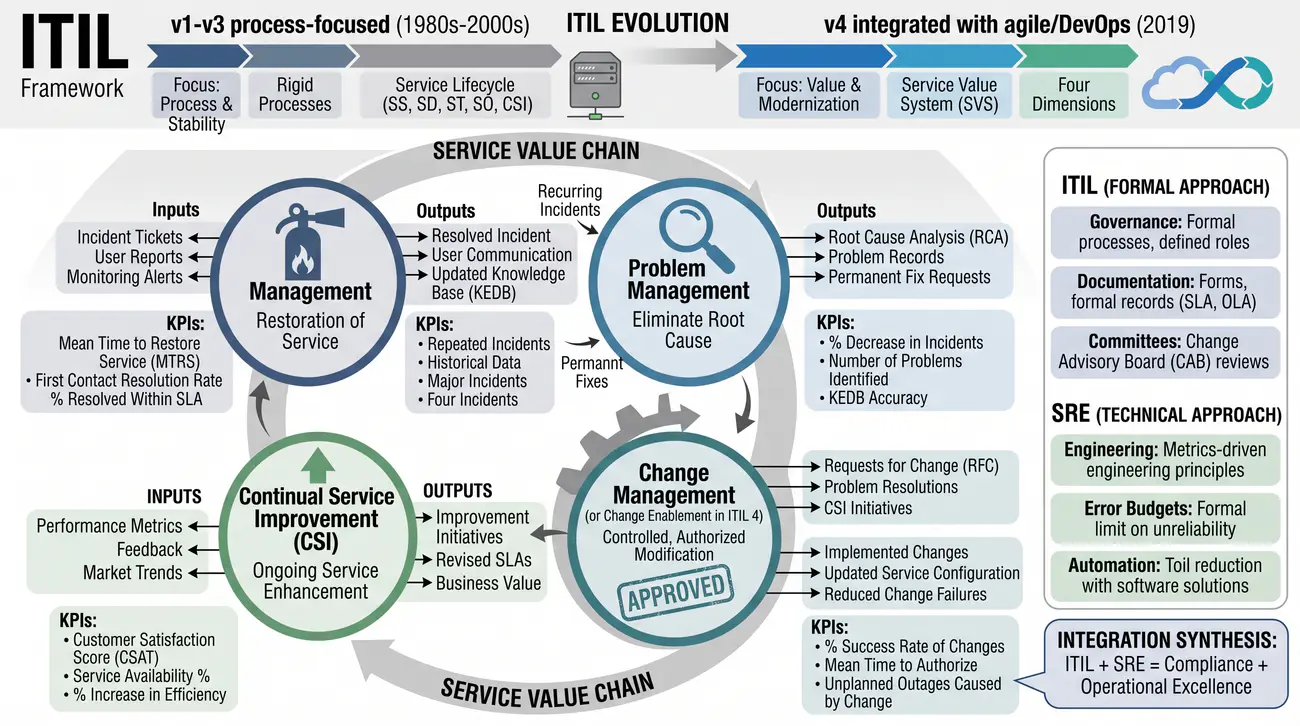
ITIL (Information Technology Infrastructure Library) - zbiór najlepszych praktyk ITSM; v4 (2019) integruje z agile/DevOps. Kluczowe procesy: Incident, Problem i Change Management.

ITIL to zbiór sprawdzonych praktyk zarządzania usługami IT - od lat 80., dziś w wersji v4 zintegrowanej z agile i DevOps.

  • Geneza i ewolucja ITIL – metodyka powstała w Wielkiej Brytanii, a jej najnowsza wersja ITIL 4 integruje podejście procesowe ze zwinnością i DevOps.
  • Kluczowe procesy operacyjne – biblioteka definiuje obsługę incydentów (przywrócenie sprawności), zarządzanie problemami (badanie przyczyn) oraz zarządzanie zmianą.
  • Struktura i odpowiedzialność – każdy proces ITIL posiada wyznaczonego właściciela, zdefiniowane wejścia i wyjścia oraz mierniki efektywności (KPI).
  • Komplementarność z SRE – ITIL tworzy ramy ładu organizacyjnego i zgodności audytowej, podczas gdy SRE dostarcza narzędzia techniczne i automatyzację.
  • Różnice w realizacji – ITIL formalizuje komunikację i komitety akceptacji (CAB), natomiast SRE kładzie nacisk na samoczynne wdrożenia sterowane budżetem błędów.
ITIL: Zbiór najlepszych praktyk zarządzania usługami informatycznymi (ITSM); wersja v4 z 2019 roku integruje procesy z podejściami agile i DevOps.
obszary ITIL

Współczesne ramy zarządzania usługami teleinformatycznymi opierają się na normie PN-EN ISO/IEC 20000-1 oraz metodyce ITIL 4 (Service Value System). ITIL definiuje ład korporacyjny, odpowiedzialność i procesy, natomiast SRE stanowi ich techniczną realizację. W nowoczesnym modelu komitet ds. zmian (CAB) nie opiniuje ręcznie rutynowych modyfikacji; zmiany spełniające rygor testów i posiadające bezpieczny budżet błędów klasyfikowane są jako zmiany standardowe (Standard Changes) i wdrażane automatycznie przez potoki CI/CD.

ITIL (Information Technology Infrastructure Library) to zbiór najlepszych praktyk ITSM (IT Service Management); historia sięga lat 80. (UK CCTA), v1-v3 procesowe, v4 (2019) zintegrowany z agile/DevOps i value streams.

Kluczowe procesy: Incident Management (szybkie przywrócenie usługi, SLA-driven), Problem Management (RCA powtarzających się przyczyn, known errors, workarounds), Change Management/Enablement (bezpieczne wdrażanie: standard/normal/emergency changes, CAB).

Podejście procesowe: każdy proces ma wyznaczonych właścicieli, zdefiniowane dane wejściowe i wyjściowe, wskaźniki KPI i ciągłe doskonalenie (CSI - Continual Service Improvement); dyscyplina i dokumentacja dają porządek i powtarzalność.

ITIL jako uzupełnienie SRE: ITIL = ramy organizacyjne, governance, procesy; SRE = implementacja techniczna, automatyzacja, metryki, error budget; razem = compliance + operational excellence.

Różnice ITIL vs SRE (szczegóły dalej): ITIL = formularze, komisje, jakościowa ocena ryzyka; SRE = metryki, error budget, canary, automated rollback, deploy frequency.

Terminy: ITSM, service desk, change enablement, CMDB, KPI, CSI, process vs practice.

ITIL to termin, który wielu z was już słyszało, choć może nie do końca wie, co oznacza. Jest to zbiór najlepszych praktyk zarządzania usługami informatycznymi (ITSM - IT Service Management), który powstał w latach 80. w Wielkiej Brytanii. Przez lata ewoluował - od pierwszej wersji procesowej, aż po ITIL v4 z 2019 roku, który zintegrował się z podejściami agile i DevOps. Kluczowe procesy w ITIL to zarządzanie incydentami (szybkie przywrócenie usługi po awarii), zarządzanie problemami (analiza przyczyn powtarzających się awarii) oraz zarządzanie zmianami (bezpieczne wdrażanie modyfikacji). Podejście ITIL kładzie nacisk na formalne procesy: każdy proces ma swojego właściciela, określone wejścia i wyjścia, wskaźniki KPI oraz mechanizm ciągłego doskonalenia (CSI - Continual Service Improvement). ITIL i SRE nie wykluczają się nawzajem - raczej się uzupełniają. ITIL dostarcza ramy organizacyjne i zgodność (compliance), natomiast SRE wnosi automatyzację i metryki. Razem tworzą kompletny obraz nowoczesnego utrzymania.

Wyjaśnienie skrótów użytych na slajdzie:
ITIL – Information Technology Infrastructure Library – usystematyzowany zbiór najlepszych praktyk zarządzania usługami IT, w wersji ITIL 4 zintegrowany z podejściem zwinnym.
ITSM – IT Service Management – zarządzanie usługami informatycznymi; procesowe podejście do projektowania, dostarczania i ciągłego doskonalenia usług IT.
SVS – Service Value System – system wartości usług; centralny model w metodyce ITIL 4 opisujący sposób transformacji zapotrzebowania w realną wartość biznesową.
KPI – Key Performance Indicator – kluczowy wskaźnik efektywności; parametr liczbowy służący do monitorowania postępów w realizacji celów operacyjnych.
CSI – Continual Service Improvement – ciągłe doskonalenie usług; metodyka permanentnej optymalizacji procesów i jakości infrastruktury IT.

12/55 ITIL a SRE: porównanie
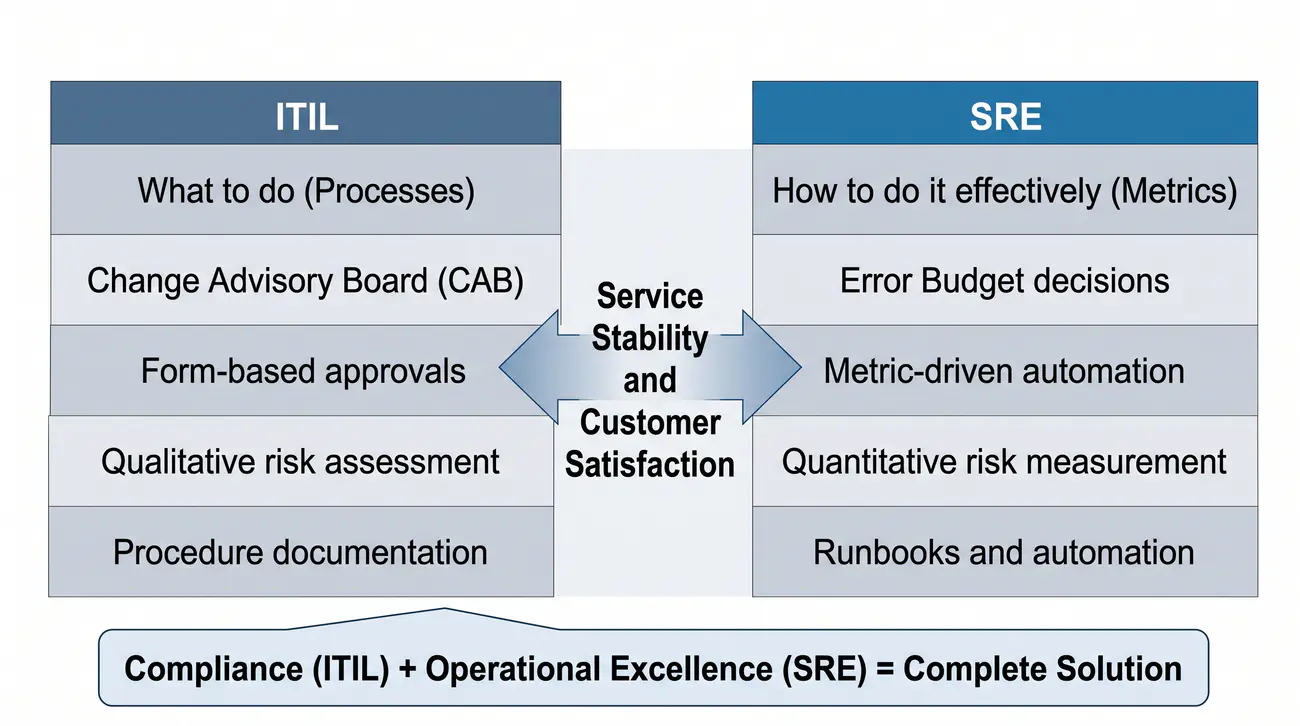
ITIL definiuje „co robić" (procesy, formularze), SRE „jak zrobić skutecznie" (automatyzacja, metryki). Razem = compliance + operational excellence.

ITIL mówi, co robić, SRE - jak robić to skutecznie. Cel jest wspólny: stabilne usługi. Dojrzałe firmy łączą oba podejścia.

  • Podział perspektyw – ITIL skupia się na strukturze organizacyjnej i formalnych regułach, podczas gdy SRE odpowiada za inżynierskie wdrożenie i automatyzację.
  • Autoryzacja zmian – w ITIL zmiany opiniuje komitet doradczy (CAB), natomiast w SRE decyzję o wdrożeniu podejmuje się w oparciu o wolny budżet błędów.
  • Reagowanie na awarie – ITIL definiuje kategoryzację zgłoszeń i eskalację, z kolei SRE stawia na automatyczną telemetrię, runbooki i analizę post-mortem bez obwiniania.
  • Zbieżność celów biznesowych – obie metodyki dążą do maksymalizacji zadowolenia użytkownika i ciągłości działania, różniąc się doborem instrumentów.
  • Model hybrydowy – dojrzałe organizacje łączą ład procesowy ITIL w relacjach z biznesem ze zwinnym podejściem inżynierskim SRE w zarządzaniu systemami.
CAB (Change Advisory Board): Zespół doradczy ds. zmian w metodyce ITIL, zatwierdzający modyfikacje systemu; w SRE jego rolę przejmują metryki i error budget umożliwiające automatyczne wdrożenia.
tabela porównawcza ITIL vs SRE

Zgodnie z normą PN-EN ISO/IEC 20000-1 rutynowe zmiany o niskim ryzyku (Standard Changes) są w modelach SRE i CI/CD zatwierdzane i wdrażane w sposób w pełni zautomatyzowany, bez konieczności oczekiwania na posiedzenia komitetu CAB.

Filozofia: ITIL = "co robić" (procesy, dokumenty, zgody, CAB); SRE = "jak zrobić skutecznie" (automatyzacja, metryki, narzędzia, error budget) - process vs practice.

Change Management: ITIL = formularze, komisje, harmonogramy, jakościowa ocena ryzyka; SRE = metryki, error budget, canary deployment, automated rollback, wysoka deploy frequency.

Incident Management: ITIL = procedury eskalacji, kategoryzacja, priorytetyzacja, SLA; SRE = monitoring-driven detection, runbooks, blameless post-mortem, MTTA/MTTR, war room.

Wspólny cel: stabilność usług, ciągłość biznesowa, zadowolenie klienta - oba podejścia dążą do tego, ale innymi metodami.

Współistnienie: dojrzałe organizacje używają ITIL dla compliance i governance oraz SRE dla realizacji technicznej; "process vs practice" nie wyklucza się.

Terminy: change advisory board vs error budget, runbook vs procedure, qualitative vs quantitative risk assessment.

Porównanie ITIL i SRE warto zacząć od fundamentalnej różnicy w podejściu. ITIL mówi „co robić" - definiuje procesy, formularze, komisje zatwierdzające zmiany i hierarchię eskalacji. SRE mówi „jak to zrobić skutecznie" - dostarcza narzędzia automatyzacji, metryki i konkretne progi decyzyjne. W przypadku zmian w systemie ITIL wymaga wypełnienia formularza, zwołania zespołu doradczego ds. zmian (CAB) i uzyskania zatwierdzenia. SRE zamiast tego polega na metrykach: jeśli error budget jest wolny, wdrożenie następuje automatycznie z canary deploymentem i automatycznym rollbackiem w razie problemów. Podobnie jest z incydentami: ITIL definiuje procedury eskalacji, kategoryzację i priorytetyzację, podczas gdy SRE bazuje na monitoringu, runbookach i blameless post-mortem. Mimo tych różnic oba podejścia mają ten sam cel - stabilność usług i zadowolenie klientów - i w praktyce doskonale ze sobą współistnieją. Dojrzałe organizacje stosują ITIL dla zgodności i zarządzania (governance), a SRE dla realizacji technicznej. To nie jest wybór jednego zamiast drugiego, lecz komplementarne podejście.

Wyjaśnienie skrótów użytych na slajdzie:
ITIL – Information Technology Infrastructure Library – podejście koncentrujące się na procedurach, ładzie korporacyjnym i zgodności z normami.
SRE – Site Reliability Engineering – podejście inżynierskie stawiające na automatyzację, programowe bramki jakościowe i rygorystyczne pomiary telemetryczne.
CAB – Change Advisory Board – komitet ds. zmian; w środowisku SRE jego zadania są weryfikowane przez zautomatyzowane testy i stan budżetu błędów.
RFC – Request for Change – formalny wniosek o wprowadzenie modyfikacji w środowisku produkcyjnym w terminologii ITIL.

13/55 Automatyzacja: po co
Idempotentność - własność, przy której wielokrotne wykonanie operacji daje ten sam wynik. Kluczowa cecha skryptów i narzędzi automatyzacji.

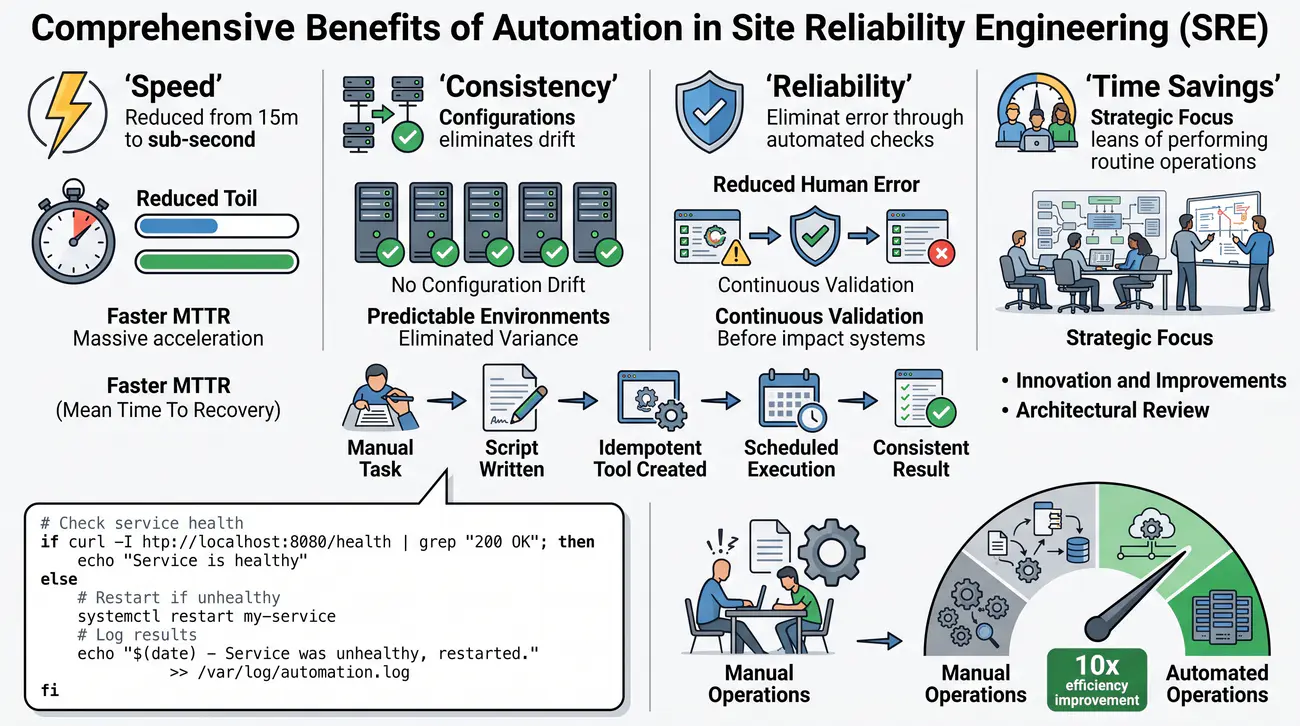
Automatyzacja to serce SRE: jest szybciej, powtarzalnie i bez błędów z pośpiechu. Kluczem jest idempotentność skryptów.

  • Szybkość realizacji – skrypt wykonuje złożone procedury administracyjne w ułamku sekundy, eliminując wielominutowe wprowadzanie komend z klawiatury.
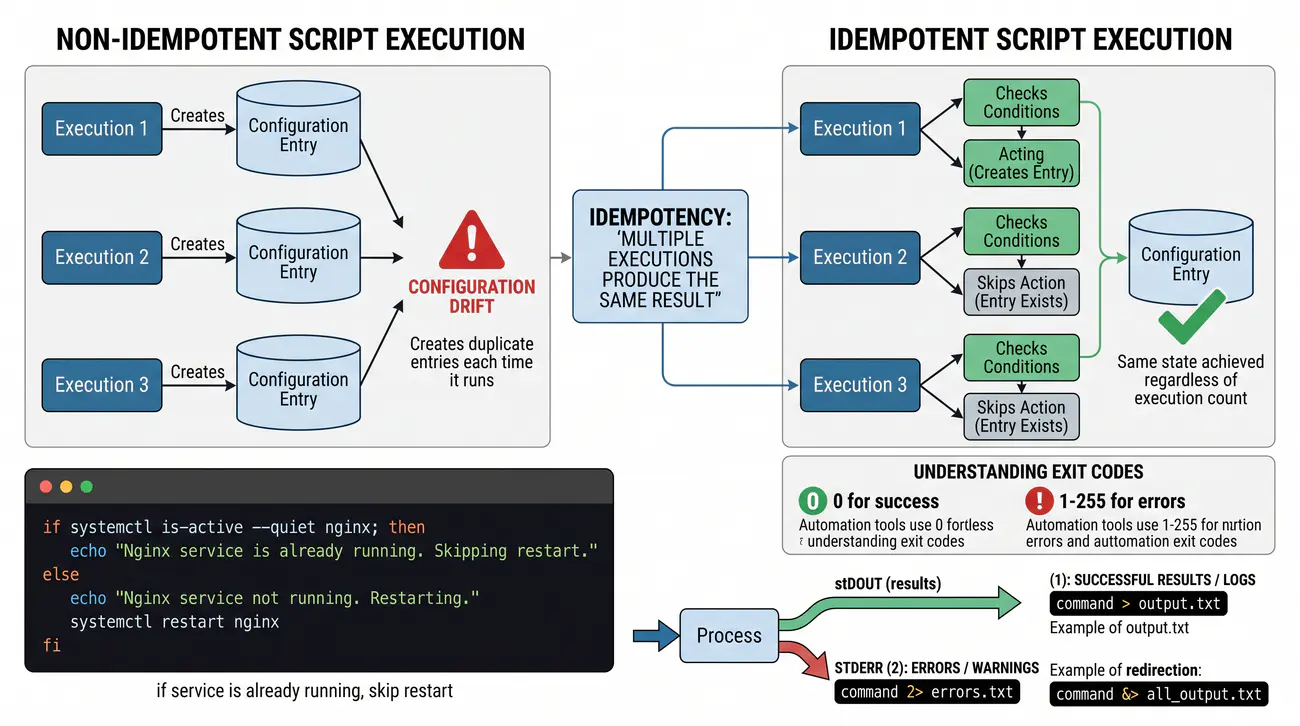
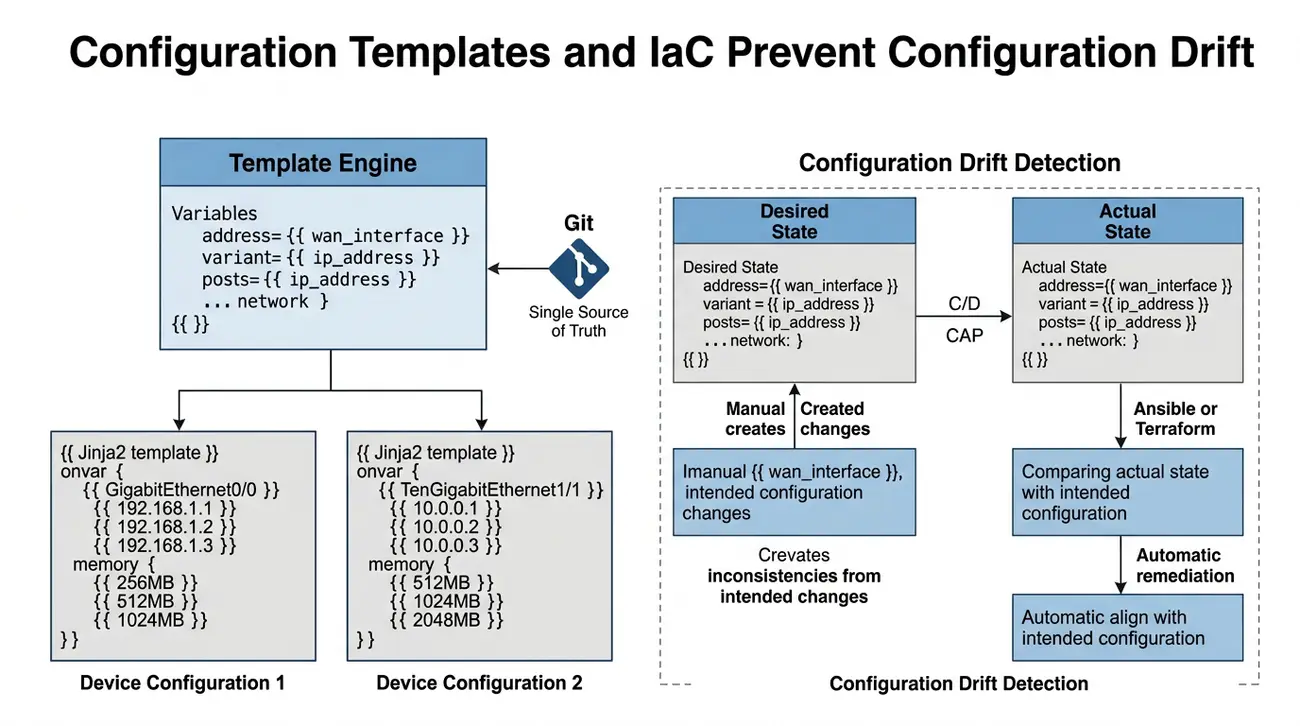
  • Powtarzalność operacji – zautomatyzowane zadanie zawsze prowadzi do identycznego stanu docelowego, skutecznie zapobiegając dryftowi konfiguracyjnemu.
  • Minimalizacja błędów ludzkich – automatyzacja wyklucza pomyłki w składni poleceń, literówki i pominięcie kroków, które są główną przyczyną awarii.
  • Przestrzeń na inżynierię – wyeliminowanie rutynowych zadań zwalnia czas zespołu na projektowanie bezpiecznej i skalowalnej architektury systemów.
  • Gwarancja idempotentności – bezpieczna automatyzacja gwarantuje, że wielokrotne uruchomienie skryptu nie wywoła niepożądanych skutków ubocznych.
Idempotentność: Własność operacji polegająca na tym, że jej wielokrotne wykonanie daje ten sam wynik co pojedyncze; kluczowa cecha skryptów i narzędzi automatyzacji.
korzyści z automatyzacji

Automatyzacja to serce nowoczesnego utrzymania: przekształca powtarzalne czynności w operacje wykonywane w ułamku sekundy, zawsze identycznie - eliminuje 15-minutowe zadania ręczne na rzecz skryptów.

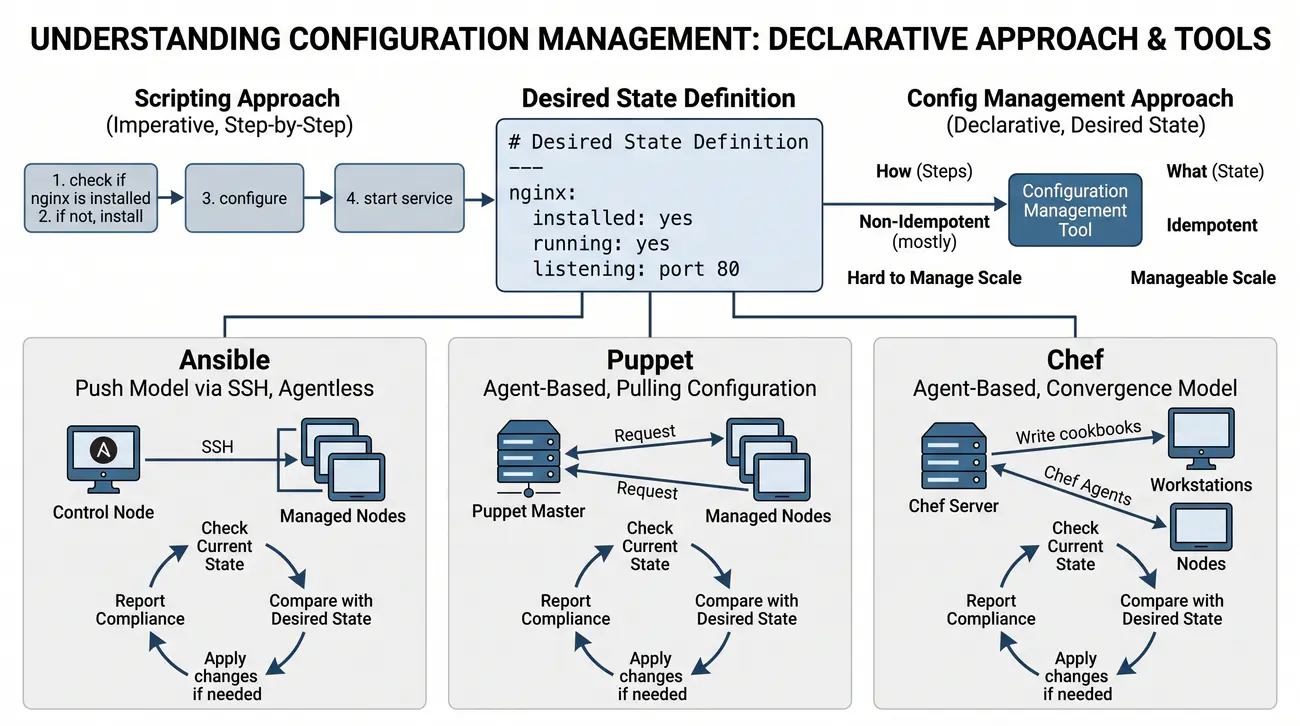
Powtarzalność i spójność (idempotentność): ten sam skrypt wielokrotnie = ten sam stan systemu; bez "configuration drift", bez ryzyka pomyłki przy konfiguracji setek serwerów.

Zwolnienie czasu: zespół inwestuje w architekturę, analizę incydentów i nowe funkcje zamiast w rutynę; to przejście z roli "keeper" na "builder".

Niezawodność: eliminacja błędów ludzkich (literówki, pominięte kroki, zła kolejność) - główna przyczyna awarii produkcyjnych; automatyzacja = bezpieczeństwo.

Przykład: skrypt Bash sprawdzający dysk, restartujący usługę i logujący wynik - gotowy wzorzec do rozszerzenia; idempotentność jako cecha kluczowa.

Terminy: automation, scripted tasks, idempotency, configuration drift, desired state, toil reduction.

Automatyzacja to serce nowoczesnego utrzymania i zarazem kluczowa umiejętność inżyniera SRE. Ale dlaczego właściwie powinniśmy automatyzować? Powodów jest kilka. Po pierwsze, szybkość: czynność, która ręcznie zajmuje kilkanaście minut, po zautomatyzowaniu trwa ułamek sekundy. Im większa skala, tym większa przewaga - przy setkach serwerów różnica jest kolosalna. Po drugie, powtarzalność: ten sam skrypt uruchomiony wielokrotnie zawsze doprowadza system do tego samego stanu. Eliminuje to tak zwany configuration drift, czyli niechciane odchylenia konfiguracji, które pojawiają się przy ręcznych zmianach. Po trzecie, niezawodność: automatyzacja eliminuje błędy ludzkie - literówki, pominięte kroki, złą kolejność poleceń - które są główną przyczyną awarii produkcyjnych. I wreszcie, zwolnienie czasu: zespół zamiast wykonywać rutynowe czynności, może pracować nad architekturą, analizą incydentów i nowymi funkcjami. Kluczową cechą dobrze zaprojektowanego narzędzia automatyzacji jest idempotentność - możliwość wielokrotnego uruchomienia bez obawy o negatywne skutki. Skrypt powinien sprawdzić, czy dana operacja została już wykonana, i pominąć ją, jeśli tak było. To pozwala na bezpieczne ponawianie, uruchamianie przez cron i wdrażanie w CI/CD.

Wyjaśnienie skrótów użytych na slajdzie:
IaC – Infrastructure as Code – infrastruktura jako kod; zarządzanie zasobami sieciowymi i serwerowymi przy użyciu wersjonowanych plików definicji.
CLI – Command Line Interface – tekstowy interfejs konsoli umożliwiający wywoływanie poleceń i uruchamianie skryptów automatyzacji.
API – Application Programming Interface – programistyczny interfejs umożliwiający bezobsługowe sterowanie infrastrukturą i aplikacjami.
TCO – Total Cost of Ownership – całkowity koszt posiadania; automatyzacja obniża TCO poprzez radykalną redukcję czasu poświęcanego na powtarzalne czynności.

14/55 Co można automatyzować
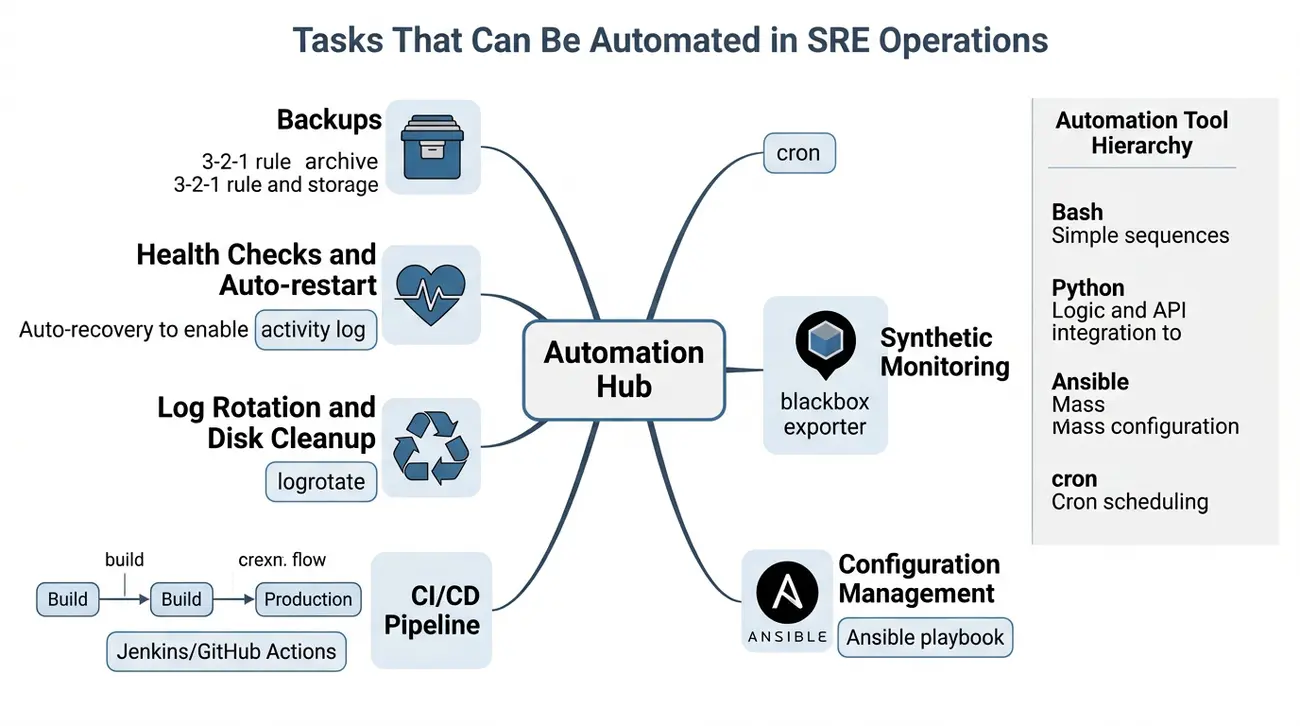
Automatyzacja - zamiana czynności ręcznych na procesy wykonywane automatycznie; narzędzia: Bash (proste sekwencje), Python (logika/API), Ansible (masowa konfiguracja), cron (harmonogramowanie).

Automatyzować da się prawie wszystko, co robisz regularnie: backupy, kontrole zdrowia, logi i wdrożenia. Narzędzie dobierz do zadania.

  • Kopie zapasowe i retencja – automatyzacja obejmuje cykliczny zrzut danych, ich szyfrowanie, transfer poza ośrodek oraz próbne odtworzenie.
  • Sondy zdrowia (health checks) – cykliczne sprawdzanie odpowiedzi protokołów HTTP, DNS i TCP pozwala na natychmiastowy restart niesprawnej usługi.
  • Zarządzanie zasobami dyskowymi – automatyczna rotacja logów oraz usuwanie plików tymczasowych chronią system przed wyczerpaniem miejsca na dysku.
  • Potoki wdrożeniowe (CI/CD) – skompilowanie, przetestowanie i stopniowe udostępnienie nowej wersji kodu na produkcji odbywa się bez udziału człowieka.
  • Dobór narzędzi operacyjnych – proste zadania realizuje powłoka Bash, logikę biznesową język Python, a spójną konfigurację wielu węzłów system Ansible.
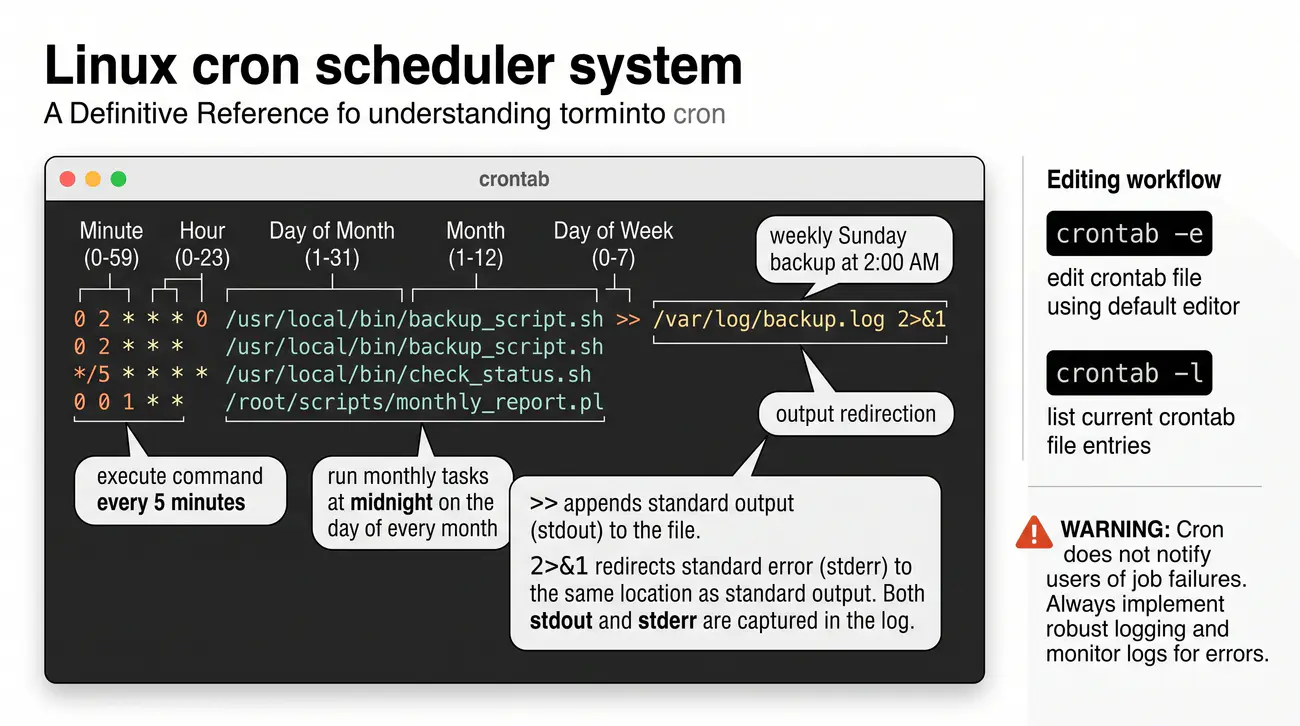
Automatyzacja: Zamiana ręcznych, powtarzalnych czynności (kopie zapasowe, health checki) na procesy wykonywane automatycznie za pomocą narzędzi takich jak Bash, Python, Ansible i cron.
lista zadań do automatyzacji

Standardy protokołów komunikacyjnych i formatów wymiany danych publikuje organizacja normalizacyjna IETF.

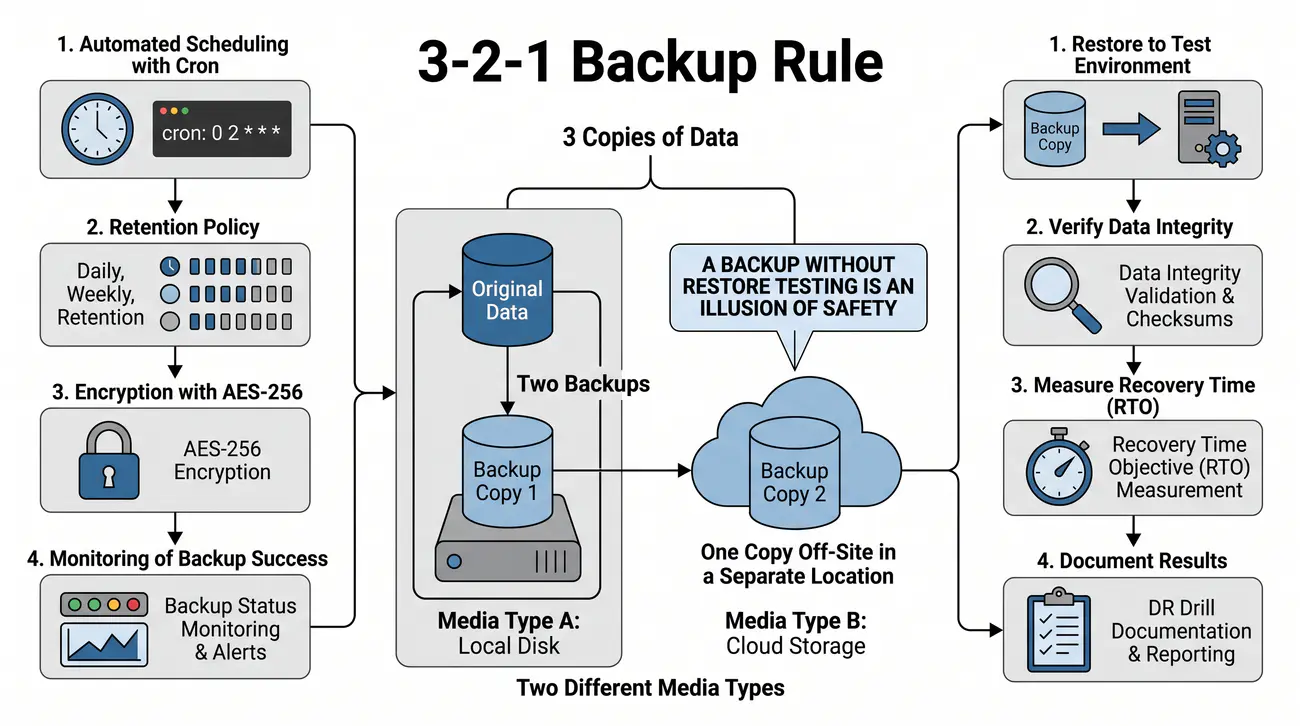
Backupy + weryfikacja (test restore!): automatyczne tworzenie, kopia offsite, polityka retencji - kopia bez testu odczytu to iluzja bezpieczeństwa.

Health checks + auto-restart: systemctl is-active / HTTP probe → restart, jeśli usługa nie odpowiada; circuit breaker zapobiega kaskadowym awariom.

Rotacja logów + czyszczenie dysków: logrotate, usuwanie plików tymczasowych, monitoring zajętości - zapobiega przepełnieniu i awariom "no space left".

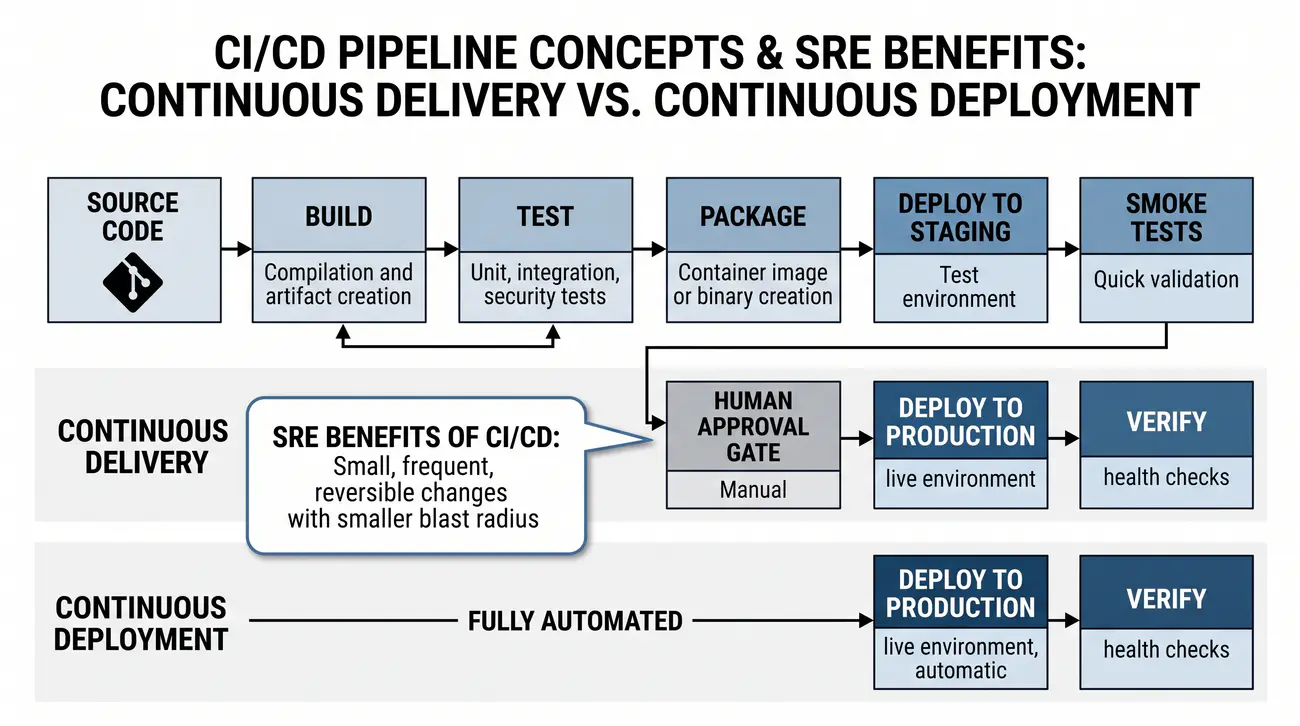
Deployments (CI/CD): build, test, package, deploy (canary/blue-green), smoke tests, automated rollback - każda zmiana idzie tą samą, sprawdzoną ścieżką.

Sprawdzanie dostępności: syntetyczne testy (blackbox exporter) - HTTP, DNS, TCP, ICMP z wielu lokalizacji; perspektywa prawdziwego użytkownika.

Narzędzia: Bash (proste sekwencje), Python (logika, API, parsowanie), Ansible (masowa konfiguracja setek hostów), cron (cykliczność) - dobór narzędzia do zadania.

Skoro wiemy, dlaczego automatyzacja jest ważna, zastanówmy się, co właściwie można automatyzować. Odpowiedź brzmi: prawie wszystko, co wykonujecie regularnie na serwerze. Zacznijmy od kopii zapasowych - ich tworzenie powinno odbywać się automatycznie, z harmonogramem, retencją, szyfrowaniem i, co kluczowe, regularnym testowaniem przywracania. Kopia bez testu odczytu to iluzja bezpieczeństwa. Kolejnym kandydatem są health checki, czyli sprawdzanie, czy usługa działa poprawnie - na przykład, czy serwer HTTP zwraca kod 200. Jeśli nie zwraca, skrypt może automatycznie zrestartować usługę i powiadomić o tym zespół. Automatyzacji podlega również rotacja logów i czyszczenie dysków - zapobiega to przepełnieniu i awariom „no space left on device". Cały proces wdrażania nowych wersji oprogramowania (CI/CD) to kolejny obszar: build, testy, pakowanie, wdrożenie na staging, smoke testy, wdrożenie na produkcję i ewentualny automatyczny rollback. Do tego dochodzą syntetyczne testy dostępności, na przykład za pomocą blackbox exportera, który sprawdza HTTP, DNS, TCP i ICMP z wielu lokalizacji. Narzędzia do automatyzacji to Bash dla prostych sekwencji, Python dla logiki i integracji z API, Ansible dla masowej konfiguracji oraz cron dla harmonogramowania zadań.

Wyjaśnienie skrótów użytych na slajdzie:
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji, którego kody odpowiedzi stanowią podstawę automatycznych testów żywotności usług (Health Checks).
DNS – Domain Name System – system nazw domenowych, w którym automatyczna modyfikacja rekordów pozwala na natychmiastowe przekierowanie ruchu w razie awarii.
TCP – Transmission Control Protocol – połączeniowy protokół transportowy; badanie portów TCP pozwala weryfikować gotowość usług sieciowych do przyjmowania połączeń.
ICMP – Internet Control Message Protocol – protokół diagnostyczny warstwy sieciowej wykorzystywany m.in. przez narzędzie ping do weryfikacji osiągalności hostów.
CI/CD – Continuous Integration / Continuous Deployment – pełna automatyzacja procesu testowania, budowy i publikacji oprogramowania na produkcji.

15/55 Bash jako fundament automatyzacji
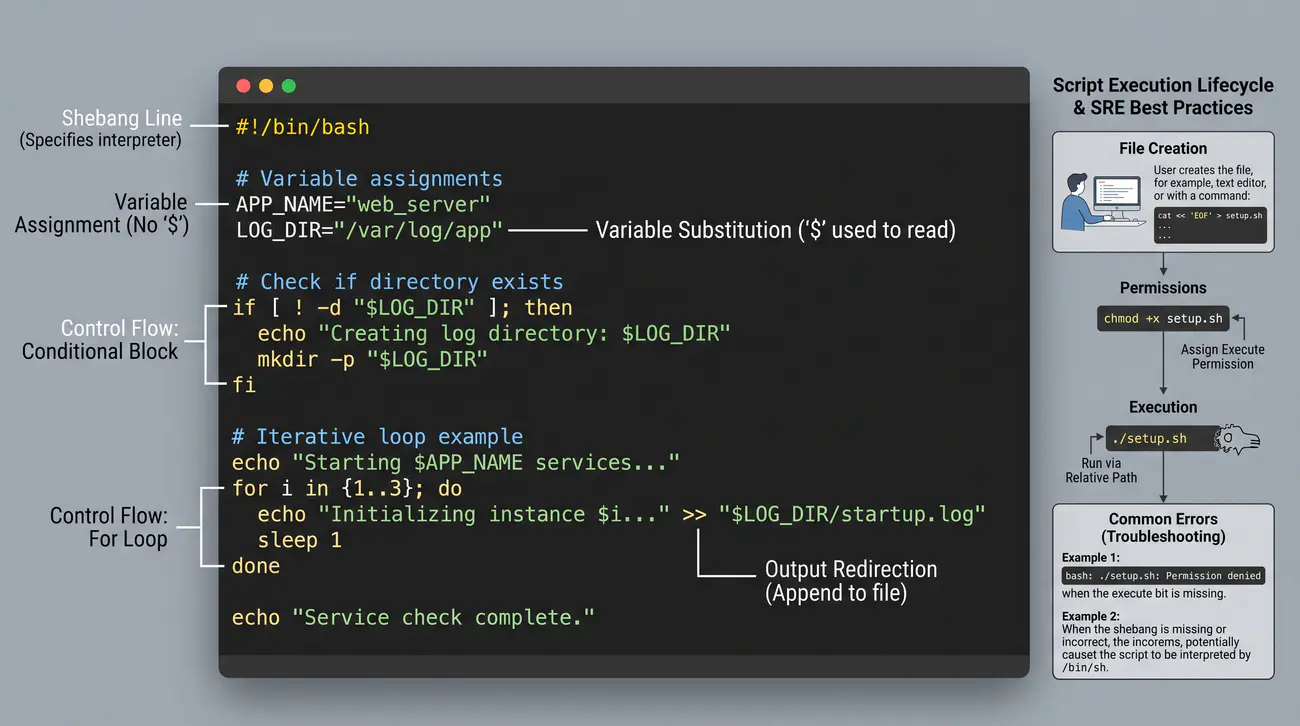
Bash - domyślna powłoka Linux; shebang #!/bin/bash wskazuje interpreter, chmod +x nadaje prawa wykonywania.

Bash to domyślna powłoka Linuxa i twój pierwszy automat: te same polecenia co z klawiatury, ale zapisane w skrypcie.

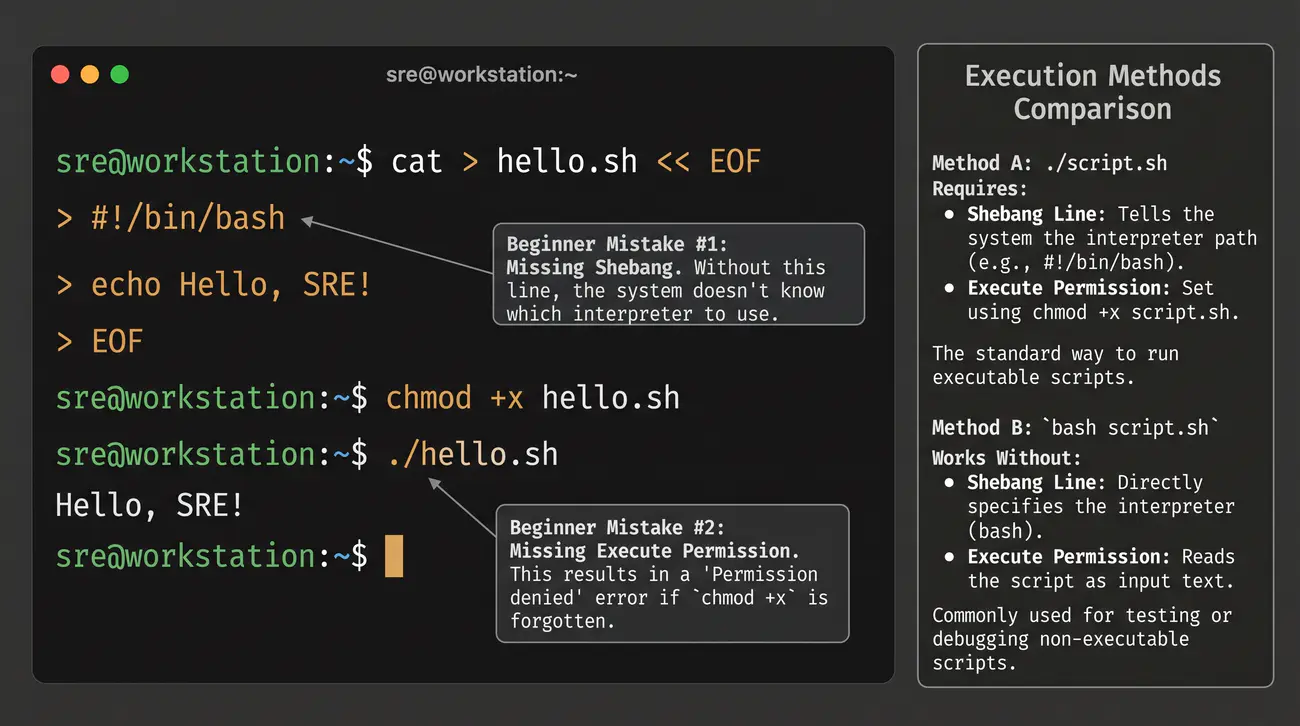
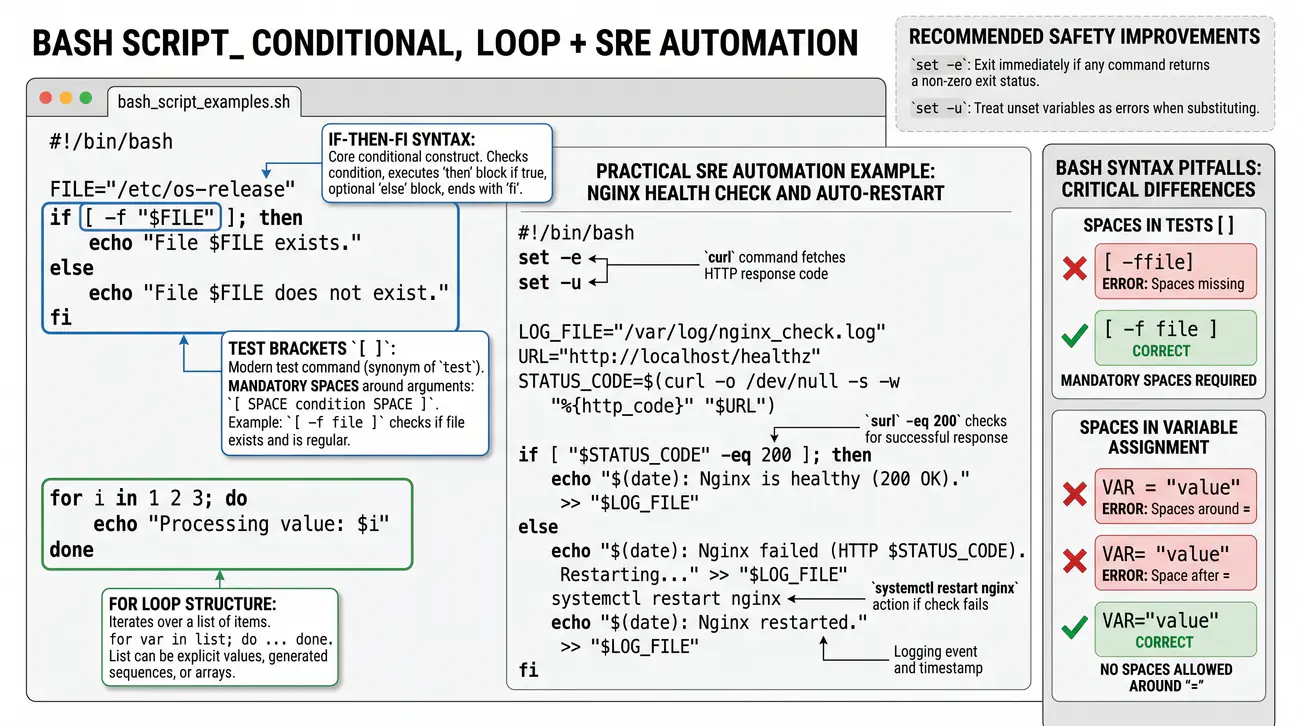
  • Nagłówek shebang i uprawnienia – deklaracja #!/bin/bash wskazuje interpreter, a nadanie praw wykonywania (chmod +x) umożliwia start skryptu.
  • Praca ze zmiennymi – przypisanie wartości zmiennej nie wymaga znaku dolara (VAR=wartość), natomiast odczyt i podstawienie nakazuje użycie $VAR.
  • Sterowanie przepływem – instrukcje warunkowe if oraz pętle for i while pozwalają skryptom podejmować decyzje na podstawie stanu systemu.
  • Integracja poleceń systemowych – powłoka Bash łączy programy takie jak grep, awk czy sed w wydajne potoki przetwarzające strumienie tekstu i logów.
  • Weryfikacja w środowisku testowym – wszystkie przykłady poleceń należy testować w piaskownicy, analizując kody wyjścia i komunikaty błędów.
Shebang: Pierwsza linia skryptu (np. #!/bin/bash) wskazująca systemowi interpreter, którym należy go uruchomić; wraz z prawem wykonywania (chmod +x) warunkuje działanie skryptu.
struktura skryptu Bash
CLI · Bash: prosty skrypt
# skrypt.sh - prosty skrypt Bash #!/bin/bash echo "Katalog: $HOME" df -h / echo "Zapisano: $(date)"

Bash (GNU Bash, powłoka dostępna domyślnie w Linux) to naturalny punkt startu: wykonuje te same polecenia co ręcznie, ale w postaci zapisanego, wersjonowanego skryptu.

Struktura: shebang `#!/bin/bash` (wskazuje interpreter), `chmod +x` (prawo wykonywania), uruchamianie `./skrypt.sh`; bez shebanga lub bitu execute wywołanie przez `./skrypt.sh` nie zadziała.

Zmienne: zapis bez `$` (np. `VAR=wartosc`), odczyt z `$` (`$VAR`); to częsty błąd początkujących; `$HOME`, `$USER` - zmienne środowiskowe.

Kontrola przepływu: `if [ -f plik ]; then ... fi`, `for i in {1..10}; do ... done`, `while`, `case` - konstrukcje decyzyjne i pętlowe.

Zastosowania: przetwarzanie logów (grep/awk/sed), warunkowe restarty usług, generowanie raportów, opakowanie CLI - "klej" systemowy.

Wstęp do przykładów konsolowych: cały kurs używa zweryfikowanych bloków CLI - kopiowanie, wklejanie, identyczny wynik; nawyk weryfikacji.

Bash to język, który będzie wam towarzyszył przez cały ten kurs i - co ważniejsze - przez całą karierę w IT. Jest domyślną powłoką w większości dystrybucji Linuxa i stanowi naturalny punkt wyjścia do automatyzacji. Dlaczego? Ponieważ wykonuje te same polecenia, które wpisujecie ręcznie, ale w postaci zapisanego, wersjonowanego skryptu. Struktura skryptu jest prosta: pierwsza linia to tak zwany shebang (#!/bin/bash), który mówi systemowi, jakiego interpretera użyć. Potem nadajemy plikowi prawa wykonywania za pomocą chmod +x i uruchamiamy go poleceniem ./skrypt.sh. Bez shebanga lub bitu execute uruchomienie przez ./skrypt.sh nie zadziała (wywołanie bash skrypt.sh zadziała nawet bez bitu execute) - to najczęstszy błąd początkujących. Bash oferuje zmienne (zapis bez dolara, odczyt z dolarem), warunki (if), pętle (for, while) i wiele narzędzi do przetwarzania tekstu, takich jak grep, awk czy sed. W praktyce Bash pełni rolę „kleju systemowego" - łączy różne narzędzia w spójne sekwencje, restartuje usługi, generuje raporty i automatyzuje rutynowe zadania. Na slajdach znajdziecie zweryfikowane przykłady poleceń, które warto kopiować na środowisko testowe i uruchamiać samodzielnie.

Wyjaśnienie skrótów użytych na slajdzie:
BASH – Bourne-Again Shell – powłoka systemowa i język skryptowy stanowiący standardowe środowisko automatyzacji w systemach operacyjnych Linux.
POSIX – Portable Operating System Interface – międzynarodowa rodzina standardów IEEE zapewniająca przenośność skryptów i oprogramowania między systemami zgodnymi z Uniksem.
CLI – Command Line Interface – interfejs tekstowy wiersza poleceń umożliwiający bezpośrednie sterowanie procesami jądra systemu.
SH – Bourne Shell – historyczna powłoka uniksowa, której rygorystyczny podzbiór składniowy stanowi punkt odniesienia dla standardu POSIX.

16/55 Przygotowanie środowiska do ćwiczeń
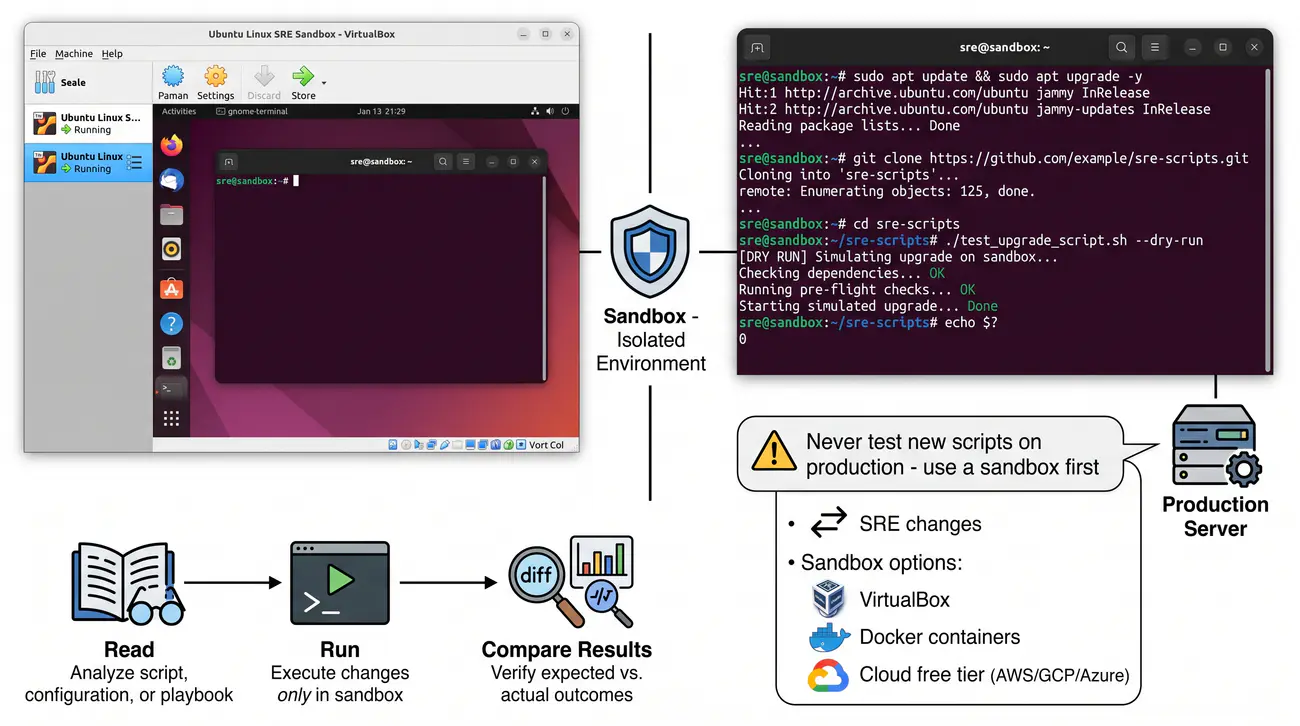
Sandbox - odizolowane środowisko testowe (VM, Docker), gdzie błąd nie niszczy produkcji. Zasada: 100% weryfikacji przed wdrożeniem.

Nigdy nie testuj na produkcji. Ćwicz w sandboxie - maszynie wirtualnej, Dockerze albo serwerze testowym.

  • Realistyczne dane wyjściowe – prezentowane w blokach kody odzwierciedlają autentyczne odpowiedzi powłoki serwera, ułatwiając samodzielną weryfikację.
  • Bezpieczeństwo ćwiczeń – polecenia zostały przetestowane w środowisku laboratoryjnym, co pozwala na bezpieczne kopiowanie ich do własnej piaskownicy.
  • Zrozumienie przed wykonaniem – przed uruchomieniem komendy należy zrozumieć jej działanie, składnię i flagi, zamiast bezrefleksyjnego wklejania tekstu.
  • Komentarze objaśniające – linie rozpoczynające się od znaku # są ignorowane przez powłokę i służą wyłącznie jako wskazówki dydaktyczne dla studenta.
  • Wybór platformy testowej – ćwiczenia można realizować w maszynie wirtualnej, kontenerze Docker lub odizolowanej instancji chmurowej.
Sandbox: Odizolowane środowisko testowe (maszyna wirtualna, kontener Docker), w którym błędy nie niszczą produkcji; obowiązuje zasada pełnej weryfikacji przed wdrożeniem.
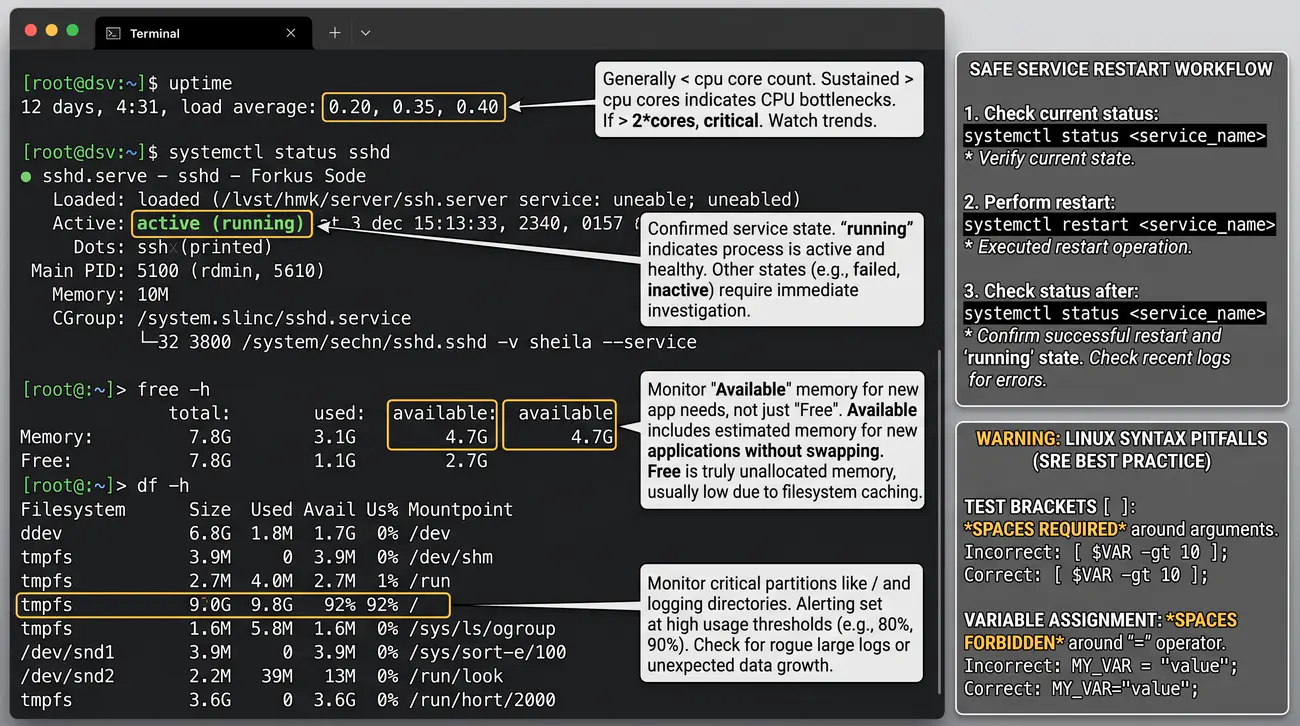
zrzut ekranu konsoli Linux

Sandbox / Practice Environment: wirtualna maszyna / kontener / oddzielny serwer testowy - odizolowane miejsce do bezpiecznych eksperymentów; błąd nie niszczy produkcji.

Zasada 100% weryfikacji: każdy przykład na slajdzie sprawdzony na serwerze testowym przed publikacją - pewność, że polecenie zadziała; budowanie zaufania do automatyzacji.

Praktyka zamiast teorii: kurs = teoria + uruchamianie realnych poleceń krok po kroku; nawyk weryfikacji efektów (nie ślepe kopiowanie).

Narzędzia: VirtualBox/VMware (VM), Docker (kontenery), chroot, odizolowane VLAN-y, cloud sandbox (AWS/GCP/Azure free tier) - dobór do środowiska studenta.

Etyka inżyniera: nie kopiuj ślepo - zrozum, zweryfikuj, porównaj wynik; to buduje kompetencję i odpowiedzialność operacyjną.

Zanim zaczniecie ćwiczyć na żywym systemie, musicie zrozumieć jedną zasadę: nigdy nie testujcie nowych skryptów ani konfiguracji na produkcji. Potrzebujecie bezpiecznego środowiska testowego, zwanego sandboxem, w którym możecie spokojnie eksperymentować, popełniać błędy i uczyć się na nich, nie ryzykując awarii prawdziwego systemu. Sandbox może być wirtualną maszyną (VirtualBox, VMware), kontenerem (Docker) albo oddzielnym serwerem testowym. Na slajdach pokazujemy bloki CLI z realnymi outputami - to nie jest teoria, lecz wyniki uzyskane na serwerze testowym. Każdy przykład został sprawdzony, więc możecie go bezpiecznie skopiować i uruchomić u siebie. Komentarze w zielonym kolorze to wyjaśnienia - nie są wykonywane przez powłokę. Ważne jest, żebyście nie kopiowali ślepo, lecz rozumieli, co robi dane polecenie. Praktyka polega na sekwencji: przeczytaj → uruchom → porównaj wynik. To buduje nawyk weryfikacji, który jest kluczowy w pracy inżyniera SRE.

Wyjaśnienie skrótów użytych na slajdzie:
VM – Virtual Machine – maszyna wirtualna; odizolowane środowisko systemowe zarządzane przez hiperwizor, stanowiące bezpieczny poligon doświadczalny (Sandbox).
LXC – Linux Containers – kontenery linuksowe; technologia wirtualizacji na poziomie jądra oferująca niemal natywną wydajność przy zachowaniu izolacji procesów.
CPU – Central Processing Unit – centralna jednostka obliczeniowa; w środowiskach wirtualnych jej zasoby są przydzielane i limitowane za pomocą mechanizmów jądra.
RAM – Random Access Memory – operacyjna pamięć ulotna; wyczerpanie pamięci na maszynie testowej uruchamia mechanizm OOM Killer.

17/55 Pierwsze polecenia narzędziowe
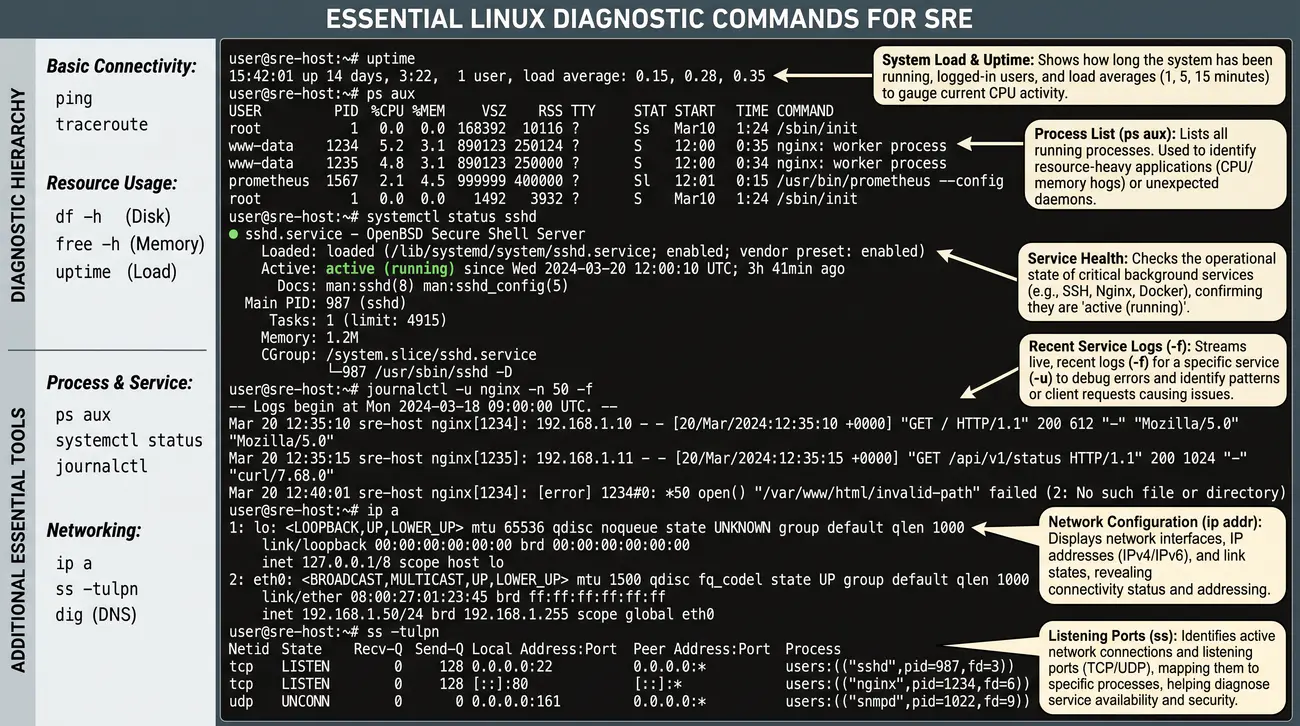
systemctl - narzędzie do zarządzania usługami systemd. journalctl - przeglądanie logów systemowych. ss - wyświetlanie aktywnych połączeń i portów.

Pięć grup poleceń to twój warsztat: procesy, usługi, logi i sieć. Opanuj je do automatyzmu - wrócą w każdym wykładzie.

  • Nadzór nad procesami – polecenie ps aux generuje pełną listę procesów, a programy top i htop umożliwiają dynamiczne monitorowanie CPU i RAM.
  • Zarządzanie usługami systemowymi – narzędzie systemctl służy do uruchamiania, zatrzymywania, sprawdzania statusu oraz włączania autostartu serwisów.
  • Przeglądanie dziennika zdarzeń – polecenie journalctl pozwala filtrować logi systemowe według nazwy usługi, poziomu błędów oraz przedziału czasowego.
  • Diagnostyka połączeń sieciowych – komendy ip, ping oraz ss -tulpn służą do weryfikacji konfiguracji interfejsów, routingu i nasłuchujących portów TCP/UDP.
  • Praktyczny fundament inżyniera – podstawowe polecenia powłoki stanowią codzienny warsztat diagnostyczny wykorzystywany we wszystkich kolejnych modułach.
systemd: System inicjalizacji i zarządca usług w Linux, obsługiwany poleceniem systemctl (status, start, stop, restart, enable), z logami dostępnymi przez journalctl.
konsola z wynikami poleceń

Procesy: `ps aux` (zrzut), `top`/`htop` (ciągły podgląd CPU/RAM, sortowanie, kill z UI) - orientacja, co obciąża system.

Usługi (systemd): `systemctl status|start|stop|restart|enable|disable nazwa` - zarządzanie jednostkami, drzewo zależności, integracja z journalctl.

Logi systemowe: `journalctl -u usługa -n 50 -f` (podążanie), `--since "1 hour ago"`, `-p err` (tylko błędy) - scentralizowany dziennik zdarzeń.

Sieć: `ping` (osiągalność ICMP), `ip a|route|link` (interfejsy, trasy, linki), `ss -tulpn` (nasłuchujące porty TCP/UDP z PID i procesem) - diagnostyka łączności.

Używane przez cały kurs: to "szpachelka i młotek" codziennej diagnostyki - inżynier musi posługiwać się nimi automatycznie; bez nich dalsza praca operacyjna jest niemożliwa.

Weryfikacja: wszystkie przykłady sprawdzone na serwerze testowym - realne outputy, nie teoretyczne; porównujcie wyniki z materiałem.

Zanim przejdziemy do pisania skryptów, musimy opanować podstawowe polecenia diagnostyczne, bez których żaden inżynier nie jest w stanie pracować. To odpowiednik młotka i klucza w warsztacie - bez nich nie zrobicie nic. Zacznijmy od procesów: polecenie ps aux robi zrzut wszystkich uruchomionych procesów, a top lub htop pokazuje je na żywo, z możliwością sortowania i kończenia. Zarządzanie usługami odbywa się za pomocą systemctl - polecenia status, start, stop, restart, enable i disable pozwalają kontrolować dowolną usługę systemową. Logi systemowe przeglądamy za pomocą journalctl, na przykład journalctl -u nazwa_uslugi -n 50 -f, co wyświetla ostatnich 50 wpisów i podąża za nowymi. Diagnostyka sieci zaczyna się od pinga, potem ip a do sprawdzenia interfejsów, a ss -tulpn pokazuje, które porty nasłuchują i jakie procesy je obsługują. Te polecenia będą wam towarzyszyć przez cały kurs, dlatego warto przećwiczyć je do momentu, w którym wykonujecie je bez zastanowienia.

Wyjaśnienie skrótów użytych na slajdzie:
PID – Process Identifier – unikalny numer identyfikacyjny przypisywany każdemu procesowi w tablicy procesów jądra Linux.
TCP – Transmission Control Protocol – niezawodny protokół transportowy zorientowany połączeniowo, którego stan gniazd bada się poleceniem ss.
UDP – User Datagram Protocol – bezpołączeniowy protokół warstwy transportowej charakteryzujący się niskim narzutem transmisyjnym.
RSS – Resident Set Size – rzeczywista ilość pamięci fizycznej RAM zaalokowana przez proces i znajdująca się w pamięci operacyjnej.
VSZ – Virtual Memory Size – całkowity rozmiar pamięci wirtualnej zadeklarowany i dostępny dla danego procesu.

18/55 Python w automatyzacji (wprowadzenie)
Python w SRE: przetwarzanie danych, integracja z API, automatyzacja złożonych zadań. Bash = proste sekwencje, Python = logika biznesowa.

Bash łączy polecenia, Python łączy systemy: pobierze metryki z API, przeanalizuje je i wyśle alert. Tu zaczyna się prawdziwa automatyzacja.

  • Biblioteka standardowa i moduły zewnętrzne – Python udostępnia wbudowaną obsługę plików i JSON, a menedżer pip pozwala doinstalować biblioteki sieciowe.
  • Integracja odmiennych systemów – skrypty w Pythonie łączą ze sobą bazy metryk, systemy zgłoszeniowe i komunikatory, przetwarzając ustrukturyzowane dane API.
  • Porównanie z powłoką Bash – Bash służy do sekwencyjnego łączenia programów, natomiast Python oferuje zaawansowane struktury danych i obsługę wyjątków.
  • Rola w kolejnych modułach – znajomość podstaw języka Python jest niezbędna przy zaawansowanej telemetrii, analizie logów oraz obsłudze webhooków alertowych.
  • Kluczowe pojęcia programistyczne – student poznaje definicje skryptu, biblioteki standardowej oraz klienta API komunikującego się z zewnętrznymi serwisami.
Podział ról Bash-Python: Bash służy do prostych sekwencji poleceń, natomiast Python do zadań wymagających logiki, przetwarzania danych i integracji z API.
krótki fragment kodu Python

Python vs Bash: Bash = sekwencja poleceń, "klej" systemu; Python = logika biznesowa, struktury danych (listy, słowniki, JSON/YAML), wyjątki (try/except), moduły, biblioteki (stdlib + PyPI).

Zastosowania: pliki (read/write/parse), sieć, API (REST, GraphQL, gRPC), bazy danych - integracje zewnętrzne; requests, paramiko i cloud SDK (AWS/GCP/Azure) to pakiety zewnętrzne z pip, natomiast json, os i socket są w bibliotece standardowej.

Automatyzacja i integracja: skrypty łączące systemy - np. pobierz metryki z Prometheus, przeanalizuj, wyślij alert na Slack i utwórz ticket w Jira; to "scripted API client".

Przewaga: łatwiejsze zarządzanie dużymi danymi, obsługa wyjątków, struktury wielokrotnego użytku, type hints, dataclasses - kod produkcyjny, nie "hack".

Przygotowanie: narzędzia monitoringu i alertingu w kolejnych wykładach będą w Pythonie; warto opanować podstawy już teraz.

Choć Bash jest świetny do prostych sekwencji poleceń, przy bardziej złożonych zadaniach potrzebujemy czegoś potężniejszego. I tutaj wkracza Python. W kontekście SRE Python służy głównie do przetwarzania danych, integracji z API i budowania narzędzi, które łączą różne systemy ze sobą. Wyobraźcie sobie taki scenariusz: musicie pobrać metryki z Prometheusa, przeanalizować je, a potem wysłać alert na Slacka i utworzyć ticket w Jira. W Bashu byłoby to niezwykle kłopotliwe, w Pythonie - naturalne. Python oferuje bogatą bibliotekę standardową (funkcję open() do obsługi plików, moduły json i os), a do tego popularne biblioteki zewnętrzne doinstalowywane przez pip: requests do komunikacji z API REST, yaml do parsowania danych oraz paramiko do zdalnego sterowania przez SSH. Różnica między Bash a Python jest zasadnicza: Bash to sekwencja poleceń, natomiast Python to w pełni rozwinięty język programowania ze strukturami danych (listy, słowniki, JSON), obsługą wyjątków (try/except) i modułami. W kolejnych wykładach będziemy intensywnie używać Pythona, szczególnie przy monitoringu, logach i alertingu, dlatego warto już teraz poznać podstawy tego języka.

Wyjaśnienie skrótów użytych na slajdzie:
API – Application Programming Interface – interfejsy programistyczne, z którymi skrypty Pythona integrują się w celu pobierania metryk lub wysyłania alertów.
JSON – JavaScript Object Notation – tekstowy, ustrukturyzowany format zapisu danych, stanowiący standard w komunikacji REST API.
YAML – YAML Ain't Markup Language – czytelny dla człowieka format serializacji danych, powszechnie stosowany w plikach konfiguracyjnych Ansible i Kubernetes.
PEP – Python Enhancement Proposal – oficjalne dokumenty projektowe ekosystemu Python; PEP 8 definiuje kanoniczne zasady formatowania i czytelności kodu.

19/55 Idempotentność skryptów
Idempotentność - skrypt po wielokrotnym uruchomieniu doprowadza system do tego samego stanu. Exit code: 0 = sukces, 1-255 = błąd. stderr - strumień błędów, oddzielny od stdout.

Dobry skrypt znosi wielokrotne uruchomienie bez szkód. Dają to trzy rzeczy: sprawdzanie warunków, kody wyjścia i rozdzielone strumienie.

  • Weryfikacja stanu przed akcją – bezpieczny skrypt sprawdza obecność pliku lub aktywność usługi przed podjęciem działań, modyfikując system tylko gdy to konieczne.
  • Interpretacja kodów wyjścia – wartość 0 oznacza poprawne zakończenie zadania, a kody z zakresu 1–255 sygnalizują błędy interpretowane przez automaty i planery.
  • Rozdzielenie wyjścia i błędów – standardowe wyniki kieruje się do strumienia stdout, natomiast komunikaty awarii do stderr, co umożliwia czytelną rejestrację logów.
  • Testowanie scenariuszy negatywnych – skrypty należy testować nie tylko w warunkach idealnych, lecz również przy braku uprawnień, plików czy awarii sieci.
  • Fundament infrastruktury jako kodu – zasada idempotentności gwarantuje, że ponowne uruchomienie procedury na skonfigurowanej maszynie nie zmieni jej stanu.
Kod wyjścia (exit code): Liczba zwracana przez program po zakończeniu (0 oznacza sukces, 1-255 błąd), umożliwiająca skryptom wykrywanie niepowodzeń i bezpieczne ponawianie operacji.
przykład bezpiecznego skryptu

Intuicyjna definicja idempotentności: Operacja jest idempotentna, jeśli jej jednokrotne wykonanie przynosi dokładnie taki sam skutek, jak wykonanie jej dziesięć razy z rzędu. Dobrym przykładem z życia codziennego jest wciśnięcie przycisku przywołania windy: ponowne naciśnięcie nie powoduje przyjechania drugiej windy ani nie zmienia piętra docelowego. W automatyzacji SRE idempotentny skrypt sprawdza np. czy użytkownik lub pakiet już istnieje – jeśli tak, nie podejmuje żadnych działań, gwarantując bezpieczne ponawianie zadania w razie awarii sieci.

Weryfikację stanu połączeń i gniazd sieciowych w skryptach wykonuje się za pomocą narzędzia ss(8).

Idempotentność: skrypt po wielokrotnym uruchomieniu pozostawia system w tym samym stanie - bezpieczny do ponawiania, cron, CI/CD; fundament IaC (Terraform, Ansible).

Sprawdzanie warunków przed zmianą: `if [ ! -f /etc/nginx/nginx.conf ]; then cp ...; fi` (nie nadpisuj, jeśli istnieje), `systemctl is-active nginx || systemctl start nginx` - działaj tylko, gdy konieczne.

Exit codes: 0 = sukces, 1-255 = błąd (konwencja Unix); `set -e` (zakończ przy błędzie), `trap 'cleanup' EXIT` - narzędzia nadrzędne oceniają wynik.

Stderr vs stdout: błędy na stderr (`>&2`), wyniki na stdout - umożliwia to przetwarzanie potokowe i logowanie (`2>>error.log`); separacja strumieni.

Testowanie w sandboxie: najpierw środowisko testowe, potem staging, potem produkcja - nigdy "na żywo" bez weryfikacji; bezpieczeństwo deploymentu.

Obsługa błędów na szeroko: od sprawdzania argumentów po reakcję na brak plików i uprawnień; przewidywalność w każdej sytuacji.

Przechodzimy do niezwykle ważnej cechy dobrych skryptów - idempotentności. Oznacza ona, że wielokrotne uruchomienie tego samego skryptu doprowadza system do identycznego stanu, niezależnie od tego, czy uruchamiamy go po raz pierwszy, czy piąty. To fundamentalna właściwość, która pozwala na bezpieczne ponawianie skryptów, uruchamianie ich przez cron i wdrażanie w pipeline'ach CI/CD. Jak osiągnąć idempotentność? Przede wszystkim przez sprawdzanie warunków przed wykonaniem operacji - na przykład: czy plik już istnieje? Czy usługa jest już uruchomiona? Jeśli tak, nie rób nic. Kolejnym ważnym aspektem jest obsługa kodów wyjścia (exit codes) w Bashu: zero oznacza sukces, a wartości od 1 do 255 oznaczają błąd. Narzędzia nadrzędne - na przykład Ansible albo cron - oceniają wynik na podstawie tego kodu. Istotne jest również rozróżnienie między strumieniami stdout i stderr: wyniki trafiają na stdout, błędy na stderr (za pomocą >&2). Dzięki temu logowanie i przetwarzanie potokowe działają poprawnie. Na koniec pamiętajcie o testowaniu w sandboxie - nigdy nie uruchamiajcie nowego skryptu bezpośrednio na produkcji.

Wyjaśnienie skrótów użytych na slajdzie:
POSIX – Portable Operating System Interface – standard określający konwencję kodów wyjścia: 0 oznacza sukces, a wartości 1–255 sygnalizują błędy operacyjne.
I/O – Input/Output – wejście/wyjście; w powłoce Linux standardowe wyjście (stdout) i wyjście błędów (stderr) posiadają odrębne deskryptory (1 i 2).
OS – Operating System – system operacyjny; środowisko gospodarza udostępniające zasoby i zmienne środowiskowe dla wykonywanego skryptu.

20/55 Planowanie zadań utrzymaniowych
Cron - demon planujący zadania w Linux; składnia: 5 pól czasowych + polecenie. Cron nie powiadamia o błędach - konieczne logowanie wyników.

Cron to systemowy harmonogram zadań w Linuksie: uruchamia skrypty o wyznaczonym czasie. Należy jednak pamiętać, że sam nie powiadomi administratora o błędzie, dlatego wyniki należy rejestrować w plikach dziennika.

  • Format harmonogramu cron – konfiguracja składa się z pięciu pól czasowych określających minutę, godzinę, dzień miesiąca, miesiąc i dzień tygodnia oraz polecenia.
  • Konstrukcja wpisu okresowego – zapis 0 2 * * 0 uruchamia zadanie w każdą niedzielę o godzinie 2:00, a pomocnicze aliasy upraszczają typowe harmonogramy.
  • Rejestracja strumieni wyjściowych – przekierowanie >> log 2>&1 zapisuje zarówno komunikaty sukcesu, jak i błędy do pliku dziennika na potrzeby audytu.
  • Nadzór nad wykonywaniem zadań – samo zaplanowanie skryptu wymaga weryfikacji w logach lub eksportu metryk, gdyż awaria zadania w cronie nie generuje alarmu.
  • Zarządzanie tabelą zadań – edycję harmonogramu wykonuje się za pomocą polecenia crontab -e, a aktualną listę weryfikuje opcją crontab -l.
Cron: Demon systemowy planujący automatyczne wykonywanie zadań według pięciu pól czasu (minuta, godzina, dzień miesiąca, miesiąc, dzień tygodnia); nie powiadamia o błędach, więc wyniki trzeba logować.
przykład wpisu crontab

W zadaniach produkcyjnych należy zabezpieczyć proces przed jednoczesnym uruchomieniem kolejnej instancji skryptu w przypadku przedłużania się poprzedniego wykonania. W środowisku Linux zaleca się stosowanie blokady plikowej za pomocą narzędzia flock:

0 2 * * 0 /usr/bin/flock -n /var/lock/backup.lock /opt/scripts/backup.sh >> /var/log/backup.log 2>&1

Flaga -n (non-blocking) gwarantuje, że jeśli poprzednie zadanie jeszcze trwa, nowe wywołanie zakończy się natychmiast bez blokowania zasobów systemowych.

Cron - mechanizm planowania zadań w Linux: wpis = 5 pól (minuta 0-59, godzina 0-23, dzień miesiąca 1-31, miesiąc 1-12, dzień tygodnia 0-7) + polecenie.

Przykłady: `0 3 * * * /scripts/backup.sh` (codziennie 3:00), `*/5 * * * * /scripts/check.sh` (co 5 min), `0 0 * * 0 /scripts/weekly.sh` (w niedziele o 0:00).

Logowanie: `>> /var/log/backup.log 2>&1` (stdout+stderr do pliku); rotacja logów crona; cron nie powiadamia o błędach - kontrola musi być samodzielna.

Monitorowanie wykonania: logi, metryki, alerty, jeśli brak wpisu - cron nie ma wbudowanego alertingu; node_exporter nie ma wbudowanego kolektora cron, więc takie metryki dodaje się samodzielnie przez textfile collector.

Zaawansowane: zakresy (`1-5`), listy (`1,3,5`), kroki (`*/10`), `@reboot`, `@daily`, `@hourly`; `crontab -e` (user), `/etc/cron.d/` (system-wide).

Cron to narzędzie, które pozwala zaplanować automatyczne wykonywanie zadań w określonych odstępach czasu. Jest odpowiednikiem alarmu w telefonie, tyle że zamiast budzić was, uruchamia skrypty. Składnia crona składa się z pięciu pól czasowych (minuta, godzina, dzień miesiąca, miesiąc, dzień tygodnia) oraz polecenia, które ma zostać wykonane. Na przykład wpis 0 2 * * 0 /opt/scripts/backup.sh oznacza „uruchom skrypt backupowy w niedzielę o 2:00". Jest kilka rzeczy, o których musicie pamiętać. Po pierwsze, cron nie powiadamia o błędach - jeśli skrypt się nie powiedzie, nikt się o tym nie dowie, chyba że zalogujecie wynik do pliku. Dlatego dodajcie na końcu zapisu >> log 2>&1, co przekieruje zarówno stdout, jak i stderr do pliku z logami. Po drugie, regularnie przeglądajcie logi, aby upewnić się, że zadania się wykonują i kończą pomyślnie. Cron ma też zaawansowane opcje: zakresy (1-5), listy (1,3,5), kroki (*/10) oraz skróty (@reboot, @daily, @hourly). Edycja crontab odbywa się poleceniem crontab -e, a podgląd aktualnych wpisów - poleceniem crontab -l.

Wyjaśnienie skrótów użytych na slajdzie:
UTC – Coordinated Universal Time – uniwersalny czas koordynowany; zalecany wzorzec czasu dla serwerów produkcyjnych zapobiegający anomaliom harmonogramu cron.
PAM – Pluggable Authentication Modules – modułowy system uwierzytelniania w systemie Linux weryfikujący dostęp użytkownika do tabeli zadań cron.
CLI – Command Line Interface – interfejs tekstowy wykorzystywany do edycji i zarządzania wpisami w tabeli crontab.

21/55 Monitoring jako podstawa SRE
Observability (obserwowalność) - 3 filary: metryki (co się dzieje), logi (dlaczego), tracing (gdzie jest problem). Monitoring proaktywny wykrywa trendy przed awarią.

Monitoring to kluczowy zmysł SRE: bez niego inżynier reaguje na awarie dopiero po zgłoszeniach od użytkowników. Nowocześnie mówimy: obserwowalność.

  • Trzy filary obserwowalności – metryki agregują stan liczbowy usługi, logi rejestrują szczegółowe zdarzenia, a ślady (traces) obrazują przepływ żądania w sieci.
  • Proaktywne wykrywanie anomalii – zamiast reagowania po wystąpieniu awarii, inżynierowie analizują trendy wzrostu latencji i zużycia zasobów.
  • Sygnały wczesnego ostrzegania – rosnąca saturacja kolejek oraz skoki błędów pozwalają podjąć interwencję, zanim użytkownicy odczują spadek jakości.
  • Metodyki pomiarowe (RED i USE) – metodyka RED mierzy parametry żądań aplikacji (częstość, błędy, czas), a USE bada nasycenie zasobów sprzętowych.
  • Zintegrowany stos telemetryczny – platforma łączy systemy Prometheus i Loki do zbierania danych oraz Grafanę do ich czytelnej wizualizacji na dashboardach.
Observability (obserwowalność): Podejście do monitoringu oparte na trzech filarach - metrykach (co się dzieje), logach (dlaczego) i tracingu (gdzie jest problem); monitoring proaktywny wykrywa trendy przed awarią.
trzy filary obserwowalności

Observability - 3 filary: Metrics (liczby: CPU%, latency p99, req/s - dashboards, alerting, trends), Logs (zdarzenia tekstowe: error, trace, audit - root cause, debugging), Traces (ścieżka żądania przez mikroserwisy: span, trace ID - latency breakdown, dependency map; OpenTelemetry, Jaeger, Tempo).

Komplementarność: metryka mówi "co" (latency↑), logi "dlaczego" (DB timeout), tracing "gdzie" (span w usłudze B) - razem dają pełny obraz; te elementy się nie zastępują, lecz uzupełniają.

Reaktywny vs Proaktywny: reaktywny = alert, gdy już upadło; proaktywny = wykrywanie trendów (wzrost p95, dysk 80%), sezonowość, capacity planning - leading indicators.

RED method (usługi): Rate (req/s), Errors (error rate), Duration (latency) - Golden Signals; USE (zasoby): Utilization, Saturation, Errors - dla infrastruktury.

Wykrywanie przed użytkownikiem: alerty na leading indicators (saturation, errors, latency) - nie na trailing (downtime); RED method (Rate, Errors, Duration) dla każdej usługi.

Narzędzia (wykład 2): Prometheus (metrics), Loki (logs), Tempo/Jaeger (traces) - ekosystem Grafana Labs; unified observability stack.

Terminy: observability, metrics, logs, traces, leading/lagging indicators, SLI, SLO, RED method, USE method.

Monitoring to absolutny fundament pracy SRE - bez niego działacie po ciemku, reagując na problemy dopiero, gdy użytkownicy zaczną dzwonić. Dzisiejsze podejście do monitoringu nosi nazwę observability, czyli obserwowalności, i opiera się na trzech filarach. Pierwszy filar to metryki - liczby, które mówią, co się dzieje: zużycie CPU, opóźnienia odpowiedzi, liczba błędów. Drugi filar to logi - tekstowe zapisy zdarzeń, które pomagają zrozumieć, dlaczego coś poszło nie tak. Trzeci filar to tracing - ścieżka żądania przez system, która pokazuje, gdzie występuje problem. Kluczowa różnica między podejściem reaktywnym a proaktywnym polega na tym, kiedy reagujecie. Podejście reaktywne oznacza doraźne reagowanie na kryzysy – oczekiwanie na awarię i naprawianie szkód po fakcie. Podejście proaktywne polega na wykrywaniu trendów: widzicie, że latencja rośnie albo dysk się zapełnia, i reagujecie zanim problem dotknie użytkowników. Do mierzenia tych trendów służą metody RED (Rate, Errors, Duration) i USE (Utilization, Saturation, Errors). Narzędzia, których będziemy używać, to Prometheus do metryk, Grafana do wizualizacji, Loki do logów i Tempo do tracingu - wszystkie z ekosystemu Grafana Labs.

Wyjaśnienie skrótów użytych na slajdzie:
APM – Application Performance Monitoring – zaawansowane narzędzia do profilowania i monitorowania wydajności kodu aplikacji w czasie rzeczywistym.
RED – Rate, Errors, Duration – metodyka monitorowania usług sieciowych skoncentrowana na liczbie zapytań, odsetku błędów i czasie ich trwania.
USE – Utilization, Saturation, Errors – metodyka monitorowania zasobów sprzętowych autorstwa Brendana Gregga (wykorzystanie, nasycenie, błędy).
TSDB – Time Series Database – baza danych szeregów czasowych przechowująca próbki metryk powiązane z precyzyjnymi stemplami czasu.
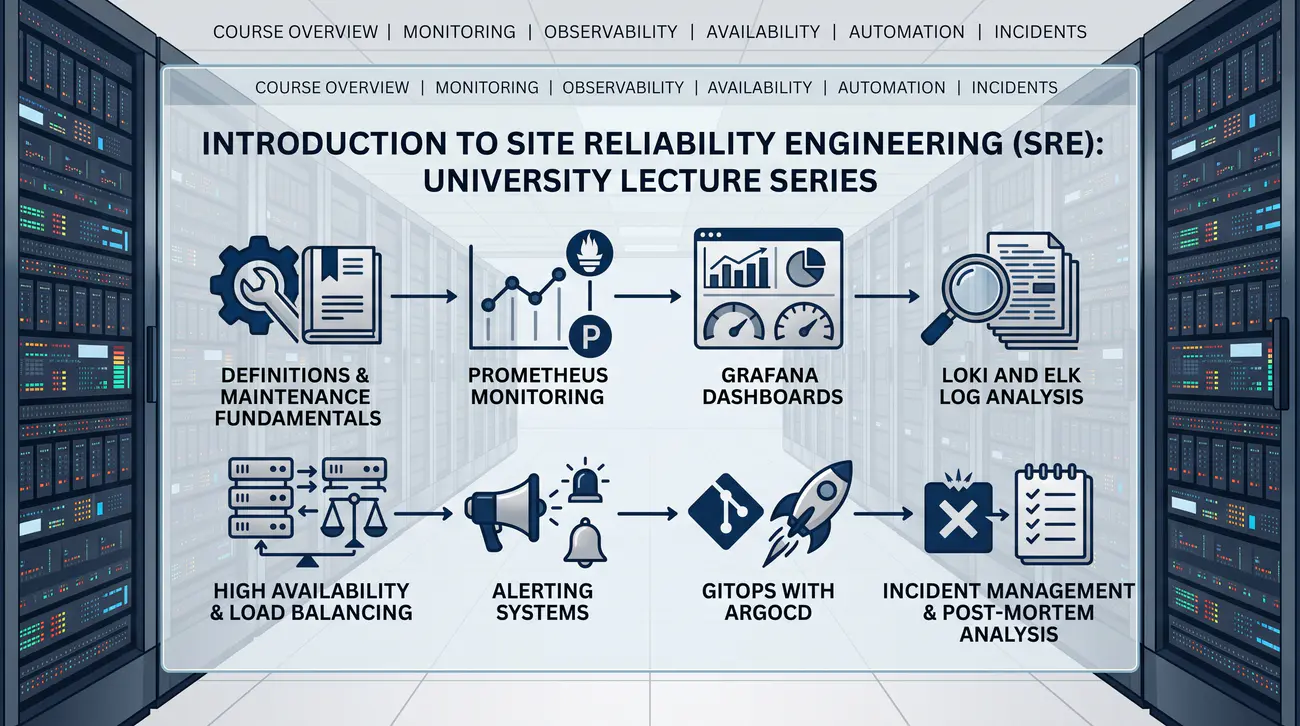
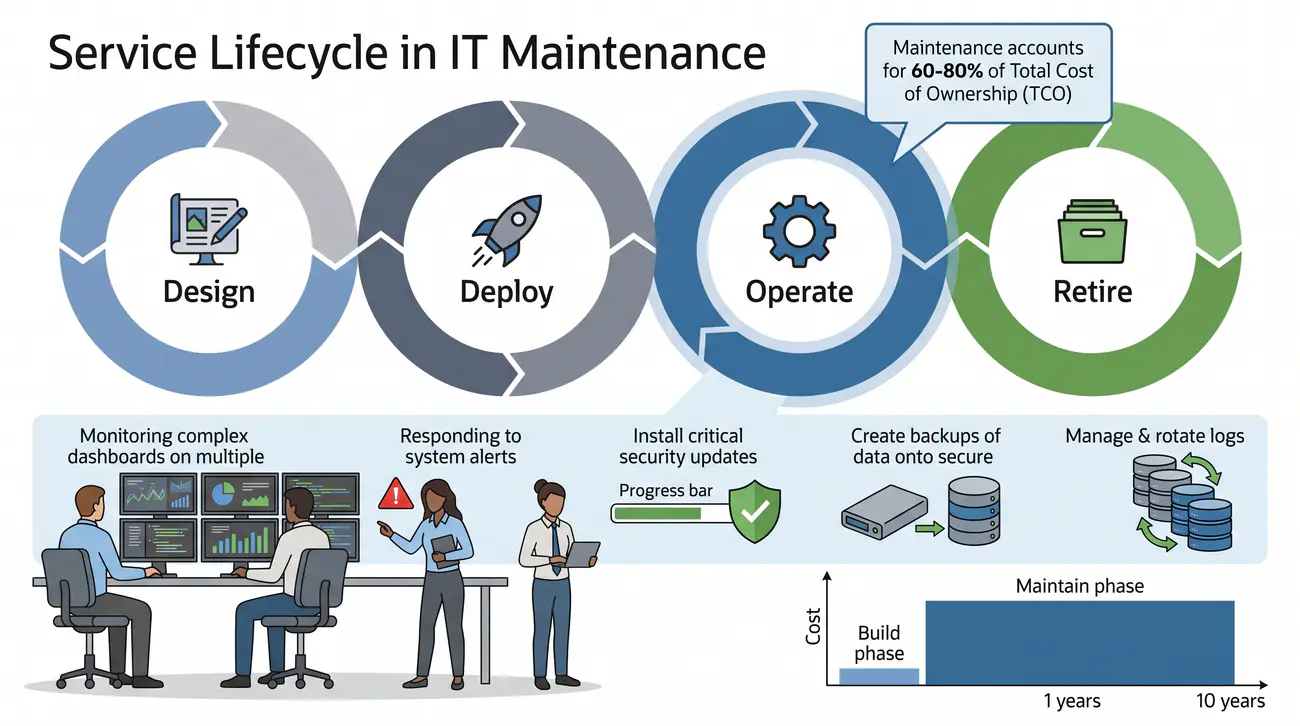
22/55 SLA, SLO, SLI (wstęp)
SLI → SLO → SLA: hierarchia miar. SLI = miara, SLO = cel wewnętrzny (np. 99.9%), SLA = umowa z klientem (luźna, z buforem).

Trzy skróty na cały kurs: SLI to termometr (miara), SLO to termostat (cel), a SLA to umowa z serwisantem.

  • Wewnętrzny cel jakościowy (SLO) – cel poziomu usług określa pożądany próg niezawodności (np. 99,9% bezbłędnych odpowiedzi), motywując zespół do działania.
  • Wskaźnik empiryczny (SLI) – wskaźnik poziomu usług mierzy rzeczywistą jakość w czasie rzeczywistym, stanowiąc obiektywne odzwierciedlenie stanu systemu.
  • Koncepcja budżetu błędów – margines niedozwolonej zawodności (100% minus SLO) wyznacza dopuszczalną pulę przestoju przeznaczoną na ryzyko innowacji.
  • Wykładniczy koszt niezawodności – podniesienie dostępności z 99,9% (~43 min przestoju/miesiąc) do 99,99% (~4,3 min) wymaga wielokrotnie droższej architektury.
  • Przejście do analizy matematycznej – precyzyjne formułowanie zapytań PromQL i obliczanie budżetu błędów stanowi główny temat kolejnego wykładu.
SLI (Service Level Indicator): Konkretna, mierzalna metryka stanu usługi (np. procent udanych żądań, percentyl czasu odpowiedzi), pełniąca rolę termometru kondycji systemu.
zależność SLA-SLO-SLI

Wskaźniki SLI muszą precyzyjnie oddawać percepcję użytkownika: latencja percentylowa (p95, p99), budżet błędów EB = 100% - SLO, oraz wskaźnik spalania budżetu (Burn Rate), który powyżej 1 oznacza konieczność uruchomienia procedury stabilizacyjnej (Release Freeze).

SLI (Service Level Indicator): konkretna mierzalna metryka stanu usługi - np. `http_requests_total{status=~"2.."} / http_requests_total` = SLI dostępności; wartość 0.0-1.0.

SLO (Service Level Objective): cel jakościowy ustawiany przez zespół - np. "availability SLI ≥ 99.9% w oknie 30 dni rolling"; wewnętrzny, inżynierski, napędza decyzje.

SLA (Service Level Agreement): umowa z klientem z konsekwencjami prawnymi i finansowymi (penalties, service credits); zwykle luźniejsze od SLO (bufor bezpieczeństwa - safety margin).

Rola SLO w SRE: error budget = 1 - SLO; budżet zużywany na wdrożenia (ryzyko) i awarie; gdy 0 → freeze deployments; SLO = operacyjna waluta.

Hierarchia: SLI (miara) → SLO (cel na SLI) → SLA (umowa oparta na SLO, z buforem); nie mylić SLO (cel inżynierski) z SLA (kontrakt biznesowy).

Szczegóły w wykładzie 2: pełne omówienie z przykładami PromQL, obliczeniami i burn rate alerting.

Te trzy skróty - SLI, SLO i SLA - będą wam towarzyszyć przez cały kurs, dlatego warto je dobrze zrozumieć już teraz. Zacznijmy od SLI, czyli Service Level Indicator. To konkretna, mierzalna metryka stanu usługi, na przykład procent udanych żądań HTTP albo mediana czasu odpowiedzi. SLI jest jak termometr - pokazuje, jak usługa sobie radzi w danej chwili. Na podstawie SLI definiujemy SLO, czyli Service Level Objective, czyli wewnętrzny cel jakościowy ustawiany przez zespół inżynierski. Na przykład: „dostępność SLI musi wynosić co najmniej 99,9% w oknie 30 dni". SLO jest jak termostat - określa, do jakiego poziomu chcemy utrzymać temperaturę. Na końcu mamy SLA, czyli Service Level Agreement, czyli umowę z klientem, która zazwyczaj jest luźniejsza niż SLO i zawiera bufor bezpieczeństwa. SLA jest jak umowa z serwisantem - jeśli temperatura spadnie poniżej pewnego poziomu, serwisant musi przyjechać. Istotny jest związek z error budget: przy SLO 99,9% mamy 0,1% budżetu błędów, co odpowiada około 43 minutom niedostępności miesięcznie. Gdy budżet się wyczerpie, wstrzymujemy wdrożenia i stabilizujemy system. Szczegóły omówimy w wykładzie 2.

Wyjaśnienie skrótów użytych na slajdzie:
SLI – Service Level Indicator – wskaźnik poziomu usług; konkretna wielkość liczbowa mierząca jakość usługi (np. udział żądań z kodem 200).
SLO – Service Level Objective – cel poziomu usług; wewnętrznie uzgodniony z biznesem próg niezawodności, do którego dąży zespół inżynierów.
SLA – Service Level Agreement – umowa o poziomie usług; formalny kontrakt z klientem obwarowany sankcjami prawno-finansowymi za niedostępność.
HTTP – Hypertext Transfer Protocol – protokół WWW, którego kody odpowiedzi (2xx, 3xx, 4xx, 5xx) stanowią fundament kalkulacji wskaźników SLI.

23/55 Budżet błędów (Error Budget)
Error budget = 100% - SLO: przy 99.9% mamy 0.1% (~43 min/miesiąc). Gdy budżet się wyczerpie → release freeze.

Wyobraź sobie pulę minut niedostępności na miesiąc. Każda awaria ją uszczupla, a gdy się skończy - zamrażamy wydania.

  • Matematyczny wymiar budżetu – przy celu SLO 99,9% dopuszczalny margines błędów wynosi 0,1%, co odpowiada około 43 minutom przestoju w skali miesiąca.
  • Konsumpcja budżetu – pulę dopuszczalnego ryzyka zużywają nieprzewidziane awarie produkcyjne oraz nieudane wdrożenia nowych funkcjonalności oprogramowania.
  • Zasada wstrzymania wydań (freeze) – całkowite wyczerpanie budżetu nakłada obowiązek wstrzymania nowości biznesowych na rzecz stabilizacji infrastruktury.
  • Obiektywny arbitraż zespołowy – budżet błędów zastępuje subiektywne spory programistów i administratorów przejrzystą, matematyczną regułą decyzyjną.
  • Wskaźnik tempa spalania (Burn Rate) – metryka ta mierzy prędkość zużywania budżetu błędów, alarmując o zagrożeniu niedotrzymania rocznych celów SLO.
Error budget (budżet błędów): Dozwolony margines niedostępności równy 100% minus SLO (np. ok. 43 min miesięcznie przy 99,9%); jego wyczerpanie oznacza wstrzymanie wdrożeń (release freeze).
wizualizacja budżetu błędów

Czym jest wskaźnik Burn Rate: Metryka burn rate (tempo spalania) określa, jak szybko usługa zużywa swój budżet błędów w stosunku do dopuszczalnego tempa. Tempo 1x oznacza, że przy obecnej liczbie usterek budżet wyczerpie się dokładnie na koniec planowanego okresu (np. 30 dni). Jeśli jednak burn rate wynosi 14x, oznacza to gwałtowną awarię, która pochłonie cały miesięczny limit w niespełna dwa dni – co wymaga natychmiastowej mobilizacji dyżurnego inżyniera SRE.

Wskaźniki SLI muszą precyzyjnie oddawać percepcję użytkownika: latencja percentylowa (p95, p99), budżet błędów EB = 100% - SLO, oraz wskaźnik spalania budżetu (Burn Rate), który powyżej 1 oznacza konieczność uruchomienia procedury stabilizacyjnej (Release Freeze).

Error budget = 100% - SLO (w % czasu): SLO 99.9% → budżet 0.1% (43 min/miesiąc); SLO 99.99% → 4.3 min; SLO 99.999% → 26 sekund - ilość dopuszczalnego "złego".

Zużycie: każda awaria zużywa budżet; każde wdrożenie ryzykuje budżetem (canary = małe ryzyko, big bang = duże); error budget jako "waluta" operacyjna.

Burn rate: szybkość spływania - np. 1% error rate przez 1 h = 1 h budżetu zużyte; multi-window burn rate alerting (Google SRE workbook) - fast/slow burn.

Wyczerpanie → Release Freeze: budżet ≈ 0 → wstrzymanie zmian niekrytycznych, fokus na stabilizację, redukcję długu technicznego; to nie decyzja uznaniowa, lecz konsekwencja liczb.

Równowaga tempo vs stabilność: dev "kupuje" szybkość wydawania, SRE "strzeże" stabilności; obiektywny arbitraż konfliktu interesów; budżet ujemny → post-mortem i działania naprawcze.

Terminy: error budget, release freeze, burn rate, SLO target, consequence-driven operations.

Error budget to jedno z najciekawszych i najbardziej praktycznych pojęć w SRE. Wyobraźcie sobie, że macie budżet na błędy - dosłownie pulę dozwolonego czasu niedostępności. Jeśli wasze SLO wynosi 99,9%, to macie 0,1% budżetu, co odpowiada około 43 minutom miesięcznie. Każda awaria, każde ryzykowne wdrożenie zużywa ten budżet. Gdy budżet się wyczerpie - wstrzymujecie wdrożenia nowych funkcji i skupiacie się na stabilizacji systemu. To nie jest kwestia polityki czy widzimisię kierownika, tylko twardych danych: albo budżet jest, albo go nie ma. Error budget pełni rolę obiektywnego arbitrażu w konflikcie między zespołami deweloperskimi (chcącymi szybko wdrażać) a operacyjnymi (dbającymi o stabilność). Istnieje też pojęcie burn rate, czyli szybkości spływania budżetu - jeśli jest zbyt wysoka, oznacza to, że coś jest nie tak i trzeba interweniować. Szczegóły techniczne, w tym alertowanie na burn rate z kilku okien czasowych, omówimy w wykładzie 6.

Wyjaśnienie skrótów użytych na slajdzie:
SLO – Service Level Objective – docelowy poziom niezawodności wyznaczający dopuszczalną pulę błędów równą 100% minus SLO.
SLA – Service Level Agreement – zewnętrzny kontrakt biznesowy; wyczerpanie budżetu SLO następuje przed naruszeniem SLA.
MTTR – Mean Time to Recovery – średni czas przywrócenia sprawności; szybkość naprawy bezpośrednio decyduje o ilości zaoszczędzonego budżetu błędów.
BR – Burn Rate – wskaźnik tempa spalania budżetu błędów; relacja rzeczywistej stopy awarii do stopy dopuszczalnej w oknie czasowym.

24/55 Kultura współpracy i komunikacji
Blameless culture - analiza awarii bez szukania winnych; skupienie na przyczynach systemowych. ADR (Architecture Decision Records) - dokumentowanie decyzji w repozytorium.

SRE to kultura, nie tylko technologia: współpraca zespołów, wiedza w repozytorium i nauka na błędach bez obwiniania.

  • Wspólna odpowiedzialność za produkt – programiści odpowiadają za jakość kodu i telemetrię, a inżynierowie SRE dostarczają niezawodną platformę wdrożeniową.
  • Dokumentacja w repozytorium (Docs-as-Code) – instrukcje operacyjne, decyzje architektoniczne i raporty poawaryjne podlegają takiej samej kontroli wersji jak kod.
  • Transparentność operacyjna – publiczne dashboardy oraz strony statusowe zapewniają wszystkim działom firmy jednakowy wgląd w kondycję usług.
  • Kultura analizy bez obwiniania (Blameless) – po wystąpieniu awarii zespół bada podatności systemowe i procedury, traktując błąd człowieka jako objaw, a nie przyczynę.
  • Zintegrowana świadomość sytuacyjna – wspólny dostęp do metryk integruje programistów, administratorów, zespoły bezpieczeństwa i decydentów biznesowych.
Blameless culture: Kultura analizy awarii bez szukania winnych, skupiona na przyczynach systemowych i usprawnianiu procesów zamiast obwiniania ludzi.
schemat współpracy zespołów

Praktyki pracy z gałęziami i wersjonowaniem kodu opisano w podręczniku Pro Git.

SRE × Developers: wspólna odpowiedzialność - dev pisze kod, testy i metryki; SRE buduje platformę, narzędzia i runbooki; wspólny code review; "you build it, you run it" w praktyce.

Dokumentowanie decyzji: Architecture Decision Records (ADR), runbooki, post-mortemy, change logi - wiedza w repozytorium kodu, nie w pamięci pracowników; precyzyjnie przypisana odpowiedzialność za usługi.

Przejrzystość metryk: dashboards widoczne dla wszystkich (Grafana), publiczne status pages, regularne raportowanie zgodności ze SLO - wspólna świadomość sytuacyjna.

Blameless Culture: analiza awarii = przyczyny systemowe (proces, narzędzia, architektura), nie ludzie; psychologiczne bezpieczeństwo = zgłaszanie błędów bez strachu; uczenie się z błędów.

Terminy: blameless culture, cross-team communication, ADR, runbook, transparency, psychological safety, shared responsibility.

SRE to nie tylko technologia - to przede wszystkim kultura pracy. Współczesne zespoły operacyjne nie działają w próżni: ściśle współpracują z deweloperami, zespołami bezpieczeństwa i biznesem. Kluczowym elementem tej współpracy jest tak zwana blameless culture, czyli kultura bez obwiniania. Kiedy zdarza się awaria, zamiast szukać winnych, analizuje się przyczyny systemowe: dlaczego proces pozwolił na taką sytuację, jakie narzędzia zawiodły, jakie procedury były niejasne. To podejście buduje psychologiczne bezpieczeństwo - ludzie zgłaszają błędy i bliskie incydenty bez strachu, co pozwala uczyć się z nich zamiast je maskować. Równie ważna jest dokumentacja. Decyzje architektoniczne warto zapisywać w tak zwanych ADR (Architecture Decision Records) - krótkich dokumentach w repozytorium Git, które wyjaśniają, dlaczego podjęto daną decyzję. Runbooki, post-mortemy i change logi powinny być trzymane w tym samym repozytorium co kod, zgodnie z zasadą docs-as-code. Przejrzystość jest kluczowa: pulpity w systemie Grafana powinny być widoczne dla wszystkich, a raportowanie SLO powinno odbywać się regularnie. To buduje wspólną świadomość sytuacyjną w zespole.

Wyjaśnienie skrótów użytych na slajdzie:
ADR – Architecture Decision Record – rejestr decyzji architektonicznych; zwięzły dokument tekstowy w repozytorium opisujący kontekst i skutki wyborów technicznych.
RCA – Root Cause Analysis – analiza przyczyn pierwotnych incydentu, prowadzona bez obwiniania ludzi w celu usprawnienia procesów i architektury.
DevOps – Development and Operations – kultura organizacyjna znosząca silosy kompetencyjne na rzecz wspólnej odpowiedzialności za produkt na produkcji.

25/55 Przykład poleceń utrzymaniowych na konsoli
Nawyki SRE: weryfikuj po każdej zmianie (systemctl status), sprawdzaj zasoby (df -h, free -h), loguj wyniki; pracuj na środowisku testowym (sandbox).

Pięć poleceń, które musisz znać na pamięć: sprawdzają dysk, pamięć, obciążenie i usługi. Zbuduj z nich nawyki.

  • Weryfikacja obciążenia i pamięci – polecenia df -h, free -h oraz uptime pozwalają ocenić dostępną pamięć RAM oraz nasycenie rdzeni procesora.
  • Bezpieczna sekwencja restartu – przed zrestartowaniem usługi należy zweryfikować jej stan, a po wykonaniu operacji upewnić się o wznowieniu nasłuchu.
  • Komentarze instruktażowe – znaki # rozpoczynają linie objaśniające, które pomagają studentowi zrozumieć cel i kontekst wykonywanych operacji.
  • Rygor składniowy powłoki – deklaracje zmiennych w Bashu zabraniają spacji przy znaku równości, natomiast testy warunkowe wymagają odstępów w nawiasach.
  • Metodyka samodzielnych ćwiczeń – student powinien analizować polecenia w pętli: zrozumienie składni, wykonanie w piaskownicy i analiza wyniku serwera.
Load average: Średnie obciążenie systemu z 1, 5 i 15 minut pokazywane przez uptime; wartość wyższa od liczby rdzeni CPU sygnalizuje problem z wydajnością.
zrzut z konsoli
CLI · Linux: polecenia utrzymaniowe
user@server:~$ uptime 10:23:11 up 12 days, 4:31, 1 user, load average: 0.20, 0.35, 0.40 user@server:~$ sudo systemctl status sshd ● ssh.service - OpenBSD Secure Shell server Active: active (running) user@server:~$ free -h total used free Mem: 7.8G 3.1G 4.7G

`uptime`: czas działania systemu, liczba użytkowników, load average (1/5/15 min) - szybki health check; czy serwer "zdaje egzamin".

`systemctl status sshd`: stan usługi (active/running/failed), PID, pamięć, ostatnie logi - weryfikacja usługi krytycznej (SSH = dostęp zdalny).

`free -h`: RAM - total/used/free/shared/buff/cache/available (available = realnie dostępna dla nowych procesów); czytelna forma (-h = human readable).

`df -h`: zajętość dysków - filesystem, size, used, avail, use%, mounted on; krytyczne: `/`, `/var`, `/home`; monitoring dysku = priorytet.

Komentarze (zielony kolor): `# komentarz` - nie wykonywane; wyjaśnienia w przykładach; budowanie czytelności skryptów i dokumentacji.

Weryfikacja na serwerze testowym: wszystkie outputy realne - porównujcie wyniki z materiałem; budowanie pewności i nawyków.

Teraz zobaczmy to w praktyce. Oto kilka poleceń, które inżynier SRE wykonuje codziennie i które wy powinniście opanować do automatyzmu. Polecenie uptime pokazuje czas działania systemu, liczbę zalogowanych użytkowników i średnie obciążenie (load average) z ostatnich 1, 5 i 15 minut. To szybki test: jeśli load average jest wyższy niż liczba rdzeni CPU, coś jest nie tak. Polecenie systemctl status sshd pokazuje stan usługi SSH - czy działa, jaki ma PID, ile zużywa pamięci i jakie są ostatnie wpisy w logach. SSH to usługa krytyczna: jeśli nie działa, tracicie zdalny dostęp do serwera. Polecenie free -h wyświetla zużycie pamięci RAM w formacie czytelnym dla człowieka - kolumny to total, used, free, shared, buff/cache i available. Ważna jest kolumna available, czyli pamięć realnie dostępna dla nowych procesów, a nie tylko free. Polecenie df -h pokazuje zajętość dysków - filesystem, rozmiar, zużycie, dostępność i punkt montowania. Monitoring dysku to priorytet: pełny dysk oznacza awarię. Wszystkie te polecenia warto łączyć w skrypty automatyzujące diagnostykę.

Wyjaśnienie skrótów użytych na slajdzie:
OOM – Out Of Memory – stan krytycznego wyczerpania pamięci RAM, w którym mechanizm jądra (OOM Killer) zamyka najbardziej obciążające procesy.
VFS – Virtual File System – warstwa wirtualnego systemu plików w jądrze Linux unifikująca operacje dyskowe dla polecenia df.
I/O – Input/Output – operacje wejścia/wyjścia na pamięciach masowych; opóźnienia I/O wpływają bezpośrednio na wskaźnik Load Average.

26/55 RouterOS: wstęp do automatyzacji sieci
RouterOS - system operacyjny MikroTik; hierarchiczne menu CLI, skrypty i scheduler (jak cron) do automatyzacji zadań sieciowych.

Automatyzujemy też sieć: RouterOS od MikroTika ma skrypty i terminarz jak cron - sam przełączy cię na łącze zapasowe.

  • Hierarchiczna struktura konsoli – interfejs RouterOS dzieli konfigurację na gałęzie funkcyjne, a klawisz Tab automatycznie uzupełnia polecenia i parametry.
  • Skrypty wbudowane w system – menu /system script pozwala tworzyć programy wykorzystujące zmienne i pętle do automatyzacji zadań sieciowych.
  • Wbudowany harmonogram zadań – moduł /system scheduler umożliwia okresowe uruchamianie skryptów, pełniąc rolę systemowego demona cron w routerze.
  • Automatyczne przełączanie łączy – skrypt wykrywający brak odpowiedzi na łączu głównym potrafi natychmiast przekierować ruch na trasę zapasową.
  • Spójność podejścia serwerowego i sieciowego – nowoczesne sieci teleinformatyczne podlegają takim samym rygorom programowalności jak serwery aplikacji.
RouterOS: System operacyjny urządzeń MikroTik o hierarchicznym CLI, oferujący wbudowane skrypty i scheduler do automatyzacji zadań sieciowych.
CLI RouterOS ze skryptem
CLI · RouterOS: sprawdzenie interfejsu
[admin@MikroTik] > /interface print Flags: R - RUNNING Columns: NAME, TYPE, ACTUAL-MTU, MAC-ADDRESS # NAME TYPE ACTUAL-MTU MAC-ADDRESS ;;; WAN 0 R ether1 ether 1500 08:00:27:58:57:BA ;;; LAN 1 R ether2 ether 1500 08:00:27:91:D1:73 [admin@MikroTik] > /ip address print Flags: D - DYNAMIC Columns: ADDRESS, NETWORK, INTERFACE # ADDRESS NETWORK INTERFACE 0 192.168.1.1/24 192.168.1.0 ether2 1 D 192.168.53.103/24 192.168.53.0 ether1

Podczas zdalnej automatyzacji i rekonfiguracji routerów w systemie MikroTik RouterOS kluczowe znaczenie ma funkcja trybu bezpiecznego (Safe Mode). Aktywowana skrótem klawiszowym lub parametrem sesji chroni przed odcięciem zdalnego zarządzania: w przypadku utraty sesji TCP z administratorem system automatycznie cofa wszelkie niezatwierdzone zmiany konfiguracyjne. Szczegółowe zasady opisuje dokumentacja RouterOS.

RouterOS CLI: hierarchiczne menu (na przykład `/interface`, `/ip`, `/system`), dopełnianie Tab i historia - to własna powłoka (nie Bash), ale o podobnej filozofii do routerów klasy operatorskiej.

Scripting: `/system script` - sekwencje poleceń, zmienne, pętle, warunki; uruchamianie ręczne lub przez scheduler; skrypty przechowywane w konfiguracji.

Scheduler: `/system scheduler` - cykliczne uruchamianie (interval, start-time, on-event); np. co minutę health check linku WAN; automatyzacja bez crona.

Przykład: skrypt sprawdzający `/interface ethernet monitor ether1 once` → jeśli `link-ok` nie ma → przełącz na backup (`/ip route` distance) lub wyślij alert e-mailem/Slackiem.

Terminy: RouterOS CLI, scheduler, script, netwatch, interface monitoring, failover script, automation patterns.

Automatyzacja nie dotyczy tylko serwerów - urządzenia sieciowe również można i należy automatyzować. RouterOS od MikroTika to doskonały przykład systemu, który oferuje wbudowane narzędzia do tworzenia skryptów i planowania zadań. CLI RouterOS ma strukturę hierarchiczną - polecenia są pogrupowane w drzewie, na przykład /interface do zarządzania interfejsami, /ip do adresacji i routingu, /system do ustawień systemowych. Skrypty w RouterOS pozwalają tworzyć sekwencje poleceń ze zmiennymi, pętlami i warunkami - podobnie jak w Bashu, ale w składni dostosowanej do tego systemu. Planner zadań (scheduler) działa jak cron: możecie zaplanować uruchamianie skryptów w określonych odstępach czasu. Przydatne zastosowanie to na przykład monitorowanie stanu interfejsu WAN i automatyczne przełączenie na łącze zapasowe, gdy główne ulegnie awarii. Tego typu mechanizmy - automatyczny failover - są standardem w środowiskach produkcyjnych, a RouterOS daje wam możliwość nauczenia się ich od podstaw.
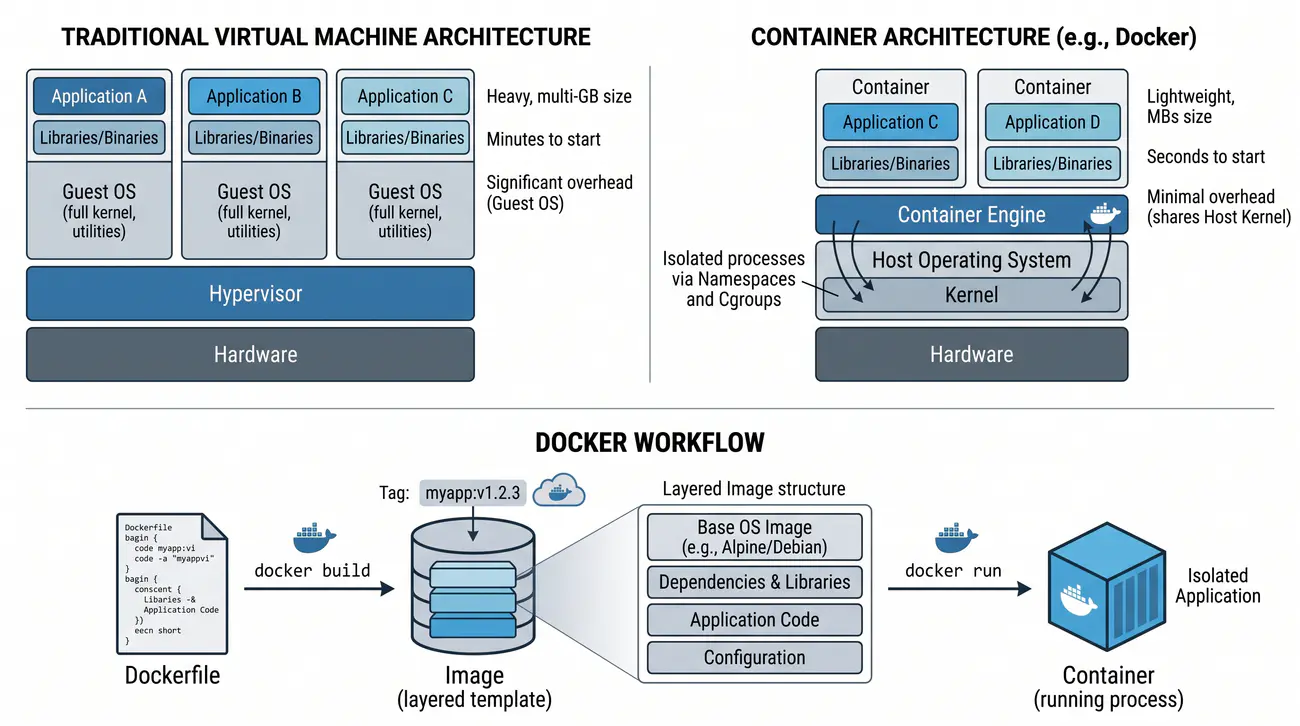
Wyjaśnienie skrótów użytych na slajdzie:
ROS – RouterOS – wyspecjalizowany system operacyjny oparty na jądrze Linux, rozwijany przez firmę MikroTik dla urządzeń sieciowych.
CLI – Command Line Interface – zhierarchizowany interfejs wiersza poleceń umożliwiający konfigurację i uruchamianie wewnętrznych skryptów RouterOS.
WAN – Wide Area Network – rozległa sieć komputerowa; automatyzacja routera często obejmuje monitorowanie bramy WAN i przełączanie na łącze zapasowe.
LAN – Local Area Network – sieć lokalna obsługiwana przez interfejsy fizyczne i mosty sieciowe w systemie RouterOS.

27/55 Cisco IOS: konfiguracja i automatyzacja
Cisco IOS - tryby: User EXEC → Privileged EXEC → Global Config → Interface Config. Ansible i Netmiko automatyzują konfigurację setek urządzeń.

Cisco IOS to hierarchia trybów: im głębiej wchodzisz, tym więcej ci wolno. Setki urządzeń konfigurujesz zdalnie, z jednego miejsca.

  • Hierarchia trybów dostępu – system dzieli uprawnienia na podgląd (User/Privileged EXEC) oraz wprowadzanie zmian, co chroni przed przypadkowym błędem.
  • Konfigurowanie interfejsów sieciowych – nadanie adresu IP i aktywacja portu poleceniem no shutdown wymaga natychmiastowej weryfikacji tabeli stanu.
  • Programowalne zarządzanie siecią – moduły Ansible oraz biblioteki Python Netmiko i NAPALM pozwalają wdrażać jednolitą konfigurację na setkach przełączników.
  • Kontrola spójności konfiguracji – inżynier weryfikuje różnice między konfiguracją bieżącą w RAM a zapisaną w pamięci trwałej NVRAM.
  • Diagnostyka po wprowadzeniu zmian – polecenia show running-config oraz show version potwierdzają poprawność wdrożonych modyfikacji sieciowych.
Tryby Cisco IOS: Hierarchia poziomów pracy (User EXEC, Privileged EXEC, Global Config, Interface Config), wymuszająca przejście do odpowiedniego trybu przed zmianą konfiguracji.
konfiguracja IOS w konsoli
CLI · Cisco IOS: konfiguracja interfejsu
Router(config)# interface GigabitEthernet0/1 Router(config-if)# description LAN Router(config-if)# ip address 192.168.10.1 255.255.255.0 Router(config-if)# no shutdown Router(config-if)# end Router# show ip interface brief Interface IP-Address OK? Method Status Protocol Gig0/1 192.168.10.1 YES manual up up

Automatyzacja urządzeń Cisco ewoluowała od parsowania wyjścia tekstowego CLI za pomocą bibliotek Netmiko i NAPALM do standardów modelowania danych YANG obsługiwanych przez interfejsy NETCONF (IETF RFC 6241) oraz RESTCONF (IETF RFC 8040). Rozwiązania te umożliwiają atomowe i weryfikowalne wdrażanie konfiguracji przez protokół RPC w formatach XML i JSON.

Cisco IOS: tryby pracy - User EXEC (`>`) → Privileged EXEC (`#`) → Global Config (`config)#`) → Interface Config (`config-if)#`) - hierarchia uprawnień, inna niż w Uniksie.

Konfiguracja interfejsu: `interface Gi0/1` → `description LAN` → `ip address 192.168.10.1 255.255.255.0` → `no shutdown` → `end`; aktywacja portu z pełną adresacją.

Weryfikacja (show commands): `show ip interface brief` (tabela stanów), `show running-config`, `show interfaces` (liczniki błędów, bandwidth, CRC, collisions) - diagnostyka.

Automatyzacja nowoczesna: Ansible (ios_config, ios_command), Python (Netmiko, NAPALM), Cisco DNA Center - eliminacja ręcznego CLI, standaryzacja setek urządzeń.

Rola w produkcji: sprawdzanie zgodności, wykrywanie dryftu, zero-touch provisioning; konfiguracja jako dane (generowanie, weryfikacja, automatyczne odtwarzanie).

Terminy: IOS CLI, config mode, show command, running-config vs startup-config, Ansible network modules, Netmiko, NAPALM.

Cisco IOS to system operacyjny routerów i switchy Cisco, z którym spotkacie się w prawie każdej sieci firmowej. Jego struktura opiera się na hierarchii trybów pracy: od User EXEC (podstawowy dostęp), przez Privileged EXEC (pełne polecenia show), aż po Global Config i Interface Config, gdzie dokonuje się właściwej konfiguracji. Każda zmiana wymaga przejścia do odpowiedniego trybu - to mechanizm bezpieczeństwa, który zapobiega przypadkowym modyfikacjom. Konfiguracja interfejsu wygląda na przykład tak: wchodzimy w tryb konfiguracji, wybieramy interfejs, nadajemy mu opis, przypisujemy adres IP i aktywujemy go poleceniem no shutdown. Weryfikacja odbywa się za pomocą poleceń show - show ip interface brief wyświetla podsumowanie stanów wszystkich interfejsów. Tradycyjnie konfigurację przeprowadza się ręcznie z klawiatury, ale w nowoczesnych środowiskach coraz częściej stosuje się automatyzację za pomocą Ansible (moduły ios_config, ios_command), Pythona z biblioteką Netmiko lub NAPALM oraz Cisco DNA Center. Te narzędzia pozwalają na zdalną, masową konfigurację setek urządzeń z jednego miejsca, z wersjonowaniem i audytem zmian.

Wyjaśnienie skrótów użytych na slajdzie:
IOS – Internetwork Operating System – oprogramowanie układowe urządzeń sieciowych Cisco definiujące zhierarchizowane tryby pracy konsoli.
CLI – Command Line Interface – tekstowy interfejs poleceń wykorzystywany tradycyjnie do konfiguracji przełączników i routerów.
NVRAM – Non-Volatile Random Access Memory – pamięć nieulotna przechowująca plik konfiguracyjny startup-config.
SSH – Secure Shell – szyfrowany protokół komunikacyjny wykorzystywany przez narzędzia automatyzacji do łączenia się z urządzeniami Cisco.
SCP – Secure Copy Protocol – bezpieczny protokół kopiowania plików używany do automatycznego backupu konfiguracji urządzeń sieciowych.

28/55 Standaryzacja konfiguracji
Configuration drift - niechciane odchylenia konfiguracji od stanu pożądanego. IaC (Infrastructure as Code) i szablony eliminują ten problem.

Ręczne klikanie na wielu urządzeniach kończy się dryftem: niby identyczne, a każde inne. Lekarstwo to szablony i IaC.

  • Szablony parametryzowane – silniki szablonów (np. Jinja2) oddzielają stałą strukturę plików od zmiennych środowiskowych, takich jak adresy IP czy nazwy hostów.
  • Podział parametrów na globalne i lokalne – parametry wspólne (DNS, NTP) definiuje się centralnie, a specyficzne atrybuty przypisuje konkretnym węzłom.
  • Wykrywanie i naprawa dryftu – narzędzia automatyzacji porównują stan serwerów z repozytorium i samoczynnie przywracają zgodność z wzorcem.
  • Repozytorium jako jedyne źródło prawdy – wszelkie modyfikacje produkcyjne muszą pochodzić z zatwierdzonego kodu, uniemożliwiając powstawanie zmian ręcznych.
  • Eliminacja rozbieżności w środowiskach – jednorazowa modyfikacja szablonu umożliwia bezbłędne wdrożenie konfiguracji w całej infrastrukturze.
Configuration drift: Niechciane odchylenia bieżącej konfiguracji od stanu pożądanego, powstające przez ręczne zmiany; eliminują je szablony i infrastruktura jako kod.
szablon konfiguracji

Templates (szablony): plik ze strukturą konfiguracji + zmienne (Jinja2 w Ansible, Go templates) - np. `interface {{ wan_if }}` → `ip address {{ wan_ip }}`; separacja logiki od danych specyficznych dla hosta.

Zmienne w szablonach: specyficzne dla hosta (IP, hostname, ASN) vs globalne (DNS, NTP, SNMP community) - jeden szablon, wiele instancji; wdrożenie nowego serwera = wstawienie wartości.

Drift Detection: narzędzia (Ansible, Terraform, własne skrypty) porównują stan rzeczywisty ze stanem pożądanym zapisanym w repozytorium kodu - raportują i naprawiają odchylenia; configuration drift = cichy zabójca.

Przykład: ręczna zmiana na routerze → wykrycie dryftu → automatyczna naprawa lub alert → przywrócenie ze szablonu; egzekwowanie stanu pożądanego.

Terminy: configuration template, drift, desired state, idempotency, compliance, source of truth, Jinja2, Ansible variables.

W środowisku z wieloma urządzeniami pojawia się problem, o którym rzadko się mówi, a który potrafi zniszczyć produkcję - configuration drift, czyli dryft konfiguracji. To niechciane odchylenia bieżącej konfiguracji od stanu pożądanego. Ktoś zmienił coś ręcznie na jednym routerze, ktoś inny na drugim i po kilku miesiącach te urządzenia, które miały być identyczne, zachowują się zupełnie inaczej. Rozwiązaniem są szablony konfiguracji i infrastruktura jako kod (IaC). Zamiast ręcznie wpisywać setki poleceń, definiujecie konfigurację jako plik z szablonem (na przykład w Jinja2 lub Go templates) i zmiennymi. Jedno urządzenie ma własne zmienne (adres IP, nazwa hosta, VLAN), a wspólne ustawienia (DNS, NTP) są globalne. Nowy serwer to po prostu wstawienie nowych wartości do szablonu. Narzędzia takie jak Ansible czy Terraform porównują stan rzeczywisty ze stanem pożądanym - wykrywają dryft i mogą go automatycznie naprawić. Kod w repozytorium Git staje się wtedy jedynym źródłem prawdy (single source of truth), a ręczne zmiany są wykrywane jako odchylenia.

Wyjaśnienie skrótów użytych na slajdzie:
IaC – Infrastructure as Code – paradygmat opisywania konfiguracji urządzeń w postaci deklaratywnych szablonów zarządzanych przez system kontroli wersji.
NTP – Network Time Protocol – protokół synchronizacji czasu; ujednolicenie konfiguracji NTP jest niezbędne do rzetelnej analizy logów i zdarzeń.
DNS – Domain Name System – system nazw domenowych; standaryzacja serwerów DNS zapobiega problemom z translacją nazw w infrastrukturze.

29/55 Problemy klasycznej administracji
IaC (Infrastructure as Code) - zarządzanie infrastrukturą jak oprogramowaniem: Git, wersjonowanie, code review, audit trail. Rozwiązuje problemy klasycznej administracji.

Klasyczna administracja ma pięć grzechów - to one urodziły SRE i IaC. Poznaj je, żeby ich nie powtarzać.

  • Niespójność środowisk wykonawczych – ręczne konfigurowanie serwerów prowadzi do rozbieżności między środowiskiem deweloperskim a produkcyjnym.
  • Długotrwałe odzyskiwanie sprawności – odtwarzanie serwerów z pamięci administratora wydłuża czas usunięcia awarii i stwarza ryzyko utraty danych.
  • Brak śladu audytowego – przy ręcznych modyfikacjach z poziomu konsoli niemożliwe jest ustalenie autora, celu i dokładnego czasu wprowadzenia zmian.
  • Uzależnienie od wiedzy jednostek – brak sformalizowanych procedur zmusza zespół do zgadywania właściwych parametrów podczas kryzysu produkcyjnego.
  • Przejście do infrastruktury jako kodu – rozwiązaniem problemów manualnego zarządzania jest wersjonowanie manifestów w Git oraz automatyzacja potoków CI/CD.
Niespójność środowisk: Różnice między środowiskiem deweloperskim, testowym i produkcyjnym prowadzące do sytuacji „u mnie działa, na produkcji nie”; usuwa je wersjonowana infrastruktura jako kod.
skutki ręcznej konfiguracji

Niespójność środowisk: Dev ≠ Test ≠ Prod - drobne różnice (wersje pakietów, limity, tuning) → "u mnie działa, na prod nie"; configuration drift jako cisza przed burzą.

Trudność odtworzenia (disaster recovery): brak dokumentacji, konfiguracja "z pamięci" → czas odzyskania (RTO) liczony w godzinach lub dniach zamiast minut; backup konfiguracji = klucz do przetrwania.

Brak audytu zmian: kto, co, kiedy i dlaczego zmienił? Bez historii niemożliwa jest analiza przyczyny awarii i spełnienie wymogów zgodności; "kto to zrobił?" = stracony czas.

Długi czas reakcji: diagnostyka = zgadywanie, brak runbooków, eskalacja do "eksperta" → wysoki MTTR; tryb awaryjny zamiast budowania rozwiązań.

Wniosek: potrzeba automatyzacji (IaC, config management), wersjonowania (Git), monitoringu i runbooków - to jest nowoczesne utrzymanie; przejście od ręki do kodu.

Zastanówmy się, jakie konkretnie problemy ma klasyczna administracja, bo to one wymusiły narodziny SRE i infrastruktury jako kodu. Po pierwsze, niespójność środowisk: środowisko deweloperskie, testowe i produkcyjne różnią się między sobą drobnymi szczegółami - wersjami pakietów, limitami, tuningiem. To prowadzi do słynnego „u mnie działa, na produkcji nie". Po drugie, trudność odtworzenia środowiska po awarii: bez dokumentacji, z konfiguracją „z pamięci", odzyskanie systemu trwa godziny albo dni zamiast minut. Po trzecie, brak audytu zmian: jeśli nie wiemy, kto, co i kiedy zmienił, nie jesteśmy w stanie przeanalizować przyczyny awarii ani spełnić wymogów zgodności. Po czwarte, długi czas reakcji: diagnostyka to zgadywanie, brak runbooków, uciekanie się do „eksperta", który zna system. I wreszcie po piąte - zamknięte koło: brak automatyzacji powoduje więcej pracy ręcznej, a więcej pracy ręcznej zostawia mniej czasu na automatyzację. Wniosek jest prosty: potrzebujemy infrastruktury jako kodu (IaC), wersjonowania w Git, monitoringu i runbooków - tego właśnie uczy ten kurs.

Wyjaśnienie skrótów użytych na slajdzie:
DR – Disaster Recovery – plan odzyskiwania sprawności infrastruktury teleinformatycznej po wystąpieniu poważnej awarii lub katastrofy.
VCS – Version Control System – system kontroli wersji (np. Git) eliminujący chaos wynikający z braku historii zmian i ścieżki audytu w konfiguracjach.
IT – Information Technology – sektor technologii informacyjnych, w którym tradycyjne zarządzanie generowało silosy wiedzy i wysoki wskaźnik Bus Factor.

30/55 Zarządzanie konfiguracją (Config Management)
Config Management - deklaratywne opisywanie pożądanego stanu systemu; narzędzie (Ansible, Puppet) automatycznie doprowadza i utrzymuje ten stan.

Zamiast rozkazów krok po kroku opisujesz stan docelowy - narzędzie samo do niego doprowadza i potem go pilnuje.

  • Podejście deklaratywne – inżynier definiuje pożądany stan końcowy systemu (np. aktywna usługa na danym porcie), a narzędzie samo doprowadza do tego stanu.
  • Automatyczne utrzymanie zgodności – cykliczne sesje synchronizacji wykrywają nieautoryzowane odstępstwa od wzorca i samoczynnie przywracają pożądany stan.
  • Bezpieczna idempotentność operacji – narzędzie przed wykonaniem zmiany sprawdza stan bieżący, zapobiegając niepotrzebnym restartom i uszkodzeniom usług.
  • Masowa skala wdrażania – pojedynczy manifest pozwala skonfigurować setki serwerów równolegle, generując szczegółowy raport zgodności.
  • Architektura agentowa i bezagentowa – systemy takie jak Ansible wykorzystują bezpieczny protokół SSH, eliminując wymóg instalacji dodatkowego oprogramowania na węzłach.
Podejście deklaratywne: Opisywanie pożądanego stanu systemu („nginx ma być uruchomiony na porcie 80”) zamiast sekwencji kroków; narzędzie samo doprowadza i utrzymuje ten stan.
porównanie narzędzi

Szczegółowe informacje o modułach i składni playbooków zawiera oficjalna dokumentacja Ansible.

Config Management = desired state: deklaratywny opis - "pakiet nginx zainstalowany, usługa uruchomiona, port 80 otwarty"; narzędzie samo dąży do stanu (convergence).

Automatyczne doprowadzenie: agent na maszynie (Ansible push / Salt minion / Puppet agent) sprawdza i egzekwuje stan co interwał (np. 30 min); idempotentne, bezpieczne przy ponownym uruchomieniu, korekta dryftu.

Różnica od skryptów: skrypt = podejście imperatywne (zrób X, potem Y); config management = deklaratywne (stan ma być X) - nie wykonuje niczego, jeśli stan już osiągnięty; idempotentność na poziomie systemu.

Skala: setki i tysiące maszyn - jeden opis, jednoczesne wdrożenie, raportowanie zgodności; bez config management jest to niewykonalne; praktyczny przykład: Ansible.

Terminy: desired state, configuration management tool, convergence, idempotency, drift, compliance, declarative vs imperative.

Zarządzanie konfiguracją (configuration management) to koncepcja, która zmienia sposób myślenia o utrzymaniu serwerów. Zamiast pisać skrypty krok po kroku („zrób X, potem Y"), opisujecie deklaratywnie pożądany stan systemu: „nginx ma być zainstalowany, uruchomiony, nasłuchiwać na porcie 80". Narzędzie - na przykład Ansible, Puppet czy Chef - samo doprowadza system do tego stanu i utrzymuje go w nim. To ogromna różnica w porównaniu ze skryptami, które wykonują polecenia „na ślepo". Narzędzie do zarządzania konfiguracją najpierw sprawdza, czy stan już został osiągnięty, i jeśli tak, nic nie robi - to jest właśnie idempotentność na poziomie całego systemu. Narzędzie sprawdza stan co pewien interwał (na przykład co 30 minut) i automatycznie naprawia odchylenia - u Puppet i Chef robi to agent zainstalowany na maszynie, a u Ansible cykliczny push po SSH bez agenta (agentless). Ta sama konfiguracja może być wdrożona na setki lub tysiące maszyn jednocześnie, z raportowaniem zgodności. Dzięki temu jeden opis konfiguracji zastępuje setki godzin pracy ręcznej.

Wyjaśnienie skrótów użytych na slajdzie:
CM – Configuration Management – zarządzanie konfiguracją; proces automatycznego doprowadzania systemów do pożądanego stanu przez Ansible, Puppet lub Chef.
SSH – Secure Shell – bezpieczny protokół sieciowy wykorzystywany przez system Ansible do bezagentowego wdrażania konfiguracji na serwerach docelowych.
SSL/TLS – Secure Sockets Layer / Transport Layer Security – protokoły kryptograficzne zabezpieczające komunikację agentów z serwerem nadrzędnym.

31/55 Infrastruktura jako kod (IaC)
Terraform - buduje infrastrukturę (VM, sieci, LB). Ansible - konfiguruje oprogramowanie na istniejących maszynach. Oba w Git = pełna historia zmian.

IaC to infrastruktura jak kod: pliki tekstowe w Git zamiast klikania w konsoli. Terraform buduje, Ansible konfiguruje.

  • Wersjonowanie środowiska – pliki definicji infrastruktury (Terraform, YAML) przechowuje się w systemie Git, gwarantując pełną historię i audytowalność.
  • Odtwarzalność środowisk – polecenie wdrożeniowe potrafi w kilka minut stworzyć kompletne, w pełni działające i identyczne środowisko w dowolnej chmurze.
  • Aprowizacja zasobów sprzętowych – narzędzie Terraform zarządza tworzeniem maszyn, sieci, reguł zapór ogniowych oraz domen, utrzymując stan w pliku stanu.
  • Zarządzanie konfiguracją systemu – oprogramowanie Ansible instaluje pakiety, konfiguruje usługi oraz dostarcza szablony plików na utworzonych maszynach.
  • Pojedyncze źródło prawdy – historia zatwierdzeń w systemie Git pozwala natychmiast zlokalizować przyczynę usterki lub wycofać błędną zmianę.
Terraform i Ansible: Terraform buduje samą infrastrukturę (maszyny, sieci, load balancery), Ansible konfiguruje oprogramowanie na istniejących maszynach; oba trzymane w Git dają pełną historię zmian.
koncepcja IaC

W architekturze IaC narzędzia aprowizacyjne (np. OpenTofu / Terraform) odpowiadają za tworzenie zasobów bazowych (maszyn wirtualnych, sieci wirtualnych, reguł zapór ogniowych i load balancerów) w oparciu o deklaratywne pliki stanu (.tfstate) z obsługą blokowania stanu (State Locking). Narzędzia zarządzania konfiguracją, takie jak Ansible, odpowiadają za instalację pakietów, parametryzację usług i zarządzanie plikami konfiguracyjnymi na uruchomionych węzłach w modelu bezagentowym (Agentless) poprzez protokół SSH.

IaC = konfiguracja jako kod wersjonowany: pliki `.tf` (Terraform), `.yml` (Ansible), `Dockerfile`, `docker-compose.yml` w Git - historia, diff, blame, pull request; infrastruktura staje się oprogramowaniem.

Wielokrotne odtwarzanie: `terraform apply` → identyczne środowisko w dowolnej chmurze lub regionie; `ansible-playbook` → identyczna konfiguracja na nowych hostach; powtarzalność buduje pewność (confidence).

Narzędzia: Terraform (provisioning infrastruktury: VM, VPC, LB, DB, DNS - state file, plan/apply, providers) versus Ansible (konfiguracja systemu i aplikacji na istniejących maszynach - playbooks, roles, modules).

Powiązanie z Git (wykład 7): GitOps - Git jako single source of truth, ArgoCD/Flux synchronizuje klaster z repozytorium; IaC + Git = fundament platformy SRE.

Terminy: infrastructure as code, provisioning, state file, plan, apply, provider, module, registry, GitOps, single source of truth.

Infrastruktura jako kod (ang. infrastructure as code, IaC) sprowadza się do jednej prostej myśli: infrastrukturę traktujemy tak samo jak oprogramowanie - opisujemy ją plikami tekstowymi i wersjonujemy. Mówiąc wprost: zamiast ręcznie klikania w konsoli chmury albo wpisywania poleceń z pamięci, piszesz opis, który można przeczytać, zmienić, sprawdzić i uruchomić ponownie. Tu pojawiają się dwa narzędzia o różnych rolach. Terraform buduje samą infrastrukturę - maszyny wirtualne, sieci, load balancery, bazy danych - deklaratywnie, a gdy uruchomimy komendę terraform apply, odtworzy identyczne środowisko w dowolnym regionie czy chmurze. Ansible natomiast nie tworzy maszyn, tylko konfiguruje oprogramowanie na istniejących hostach - instaluje pakiety, kopiuje pliki, uruchamia usługi. Oba zestawy plików lądują w Gicie, więc każda zmiana ma autora, datę i opis, a do każdej wersji można wrócić jednym poleceniem. W ten sposób Git staje się pojedynczym źródłem prawdy (single source of truth) - jedynym miejscem, które opisuje, jak wygląda twoja produkcja.

Wyjaśnienie skrótów użytych na slajdzie:
IaC – Infrastructure as Code – definiowanie zasobów infrastruktury fizycznej i chmurowej za pomocą czytelnego dla maszyn kodu źródłowego.
HCL – HashiCorp Configuration Language – deklaratywny język opisu infrastruktury stworzony dla narzędzia Terraform.
DSL – Domain-Specific Language – wyspecjalizowany język dedykowany do rozwiązywania problemów w konkretnej dziedzinie technicznej.
API – Application Programming Interface – interfejs programistyczny, za pośrednictwem którego narzędzia IaC tworzą maszyny, sieci i reguły zapór ogniowych.

32/55 Dlaczego IaC zmienia utrzymanie
IaC + Git + CI/CD + monitoring = platforma SRE. Testowanie infrastruktury tak samo jak oprogramowania: plan → test → apply → verify.

Kod infrastruktury testujesz jak aplikację: podgląd, staging i review. Operacje to uruchamianie sprawdzonego kodu.

  • Weryfikacja zmian przed wykonaniem – polecenia typu plan lub tryb testowy pozwalają bezpiecznie podejrzeć planowane modyfikacje przed dotknięciem produkcji.
  • Błyskawiczne wycofywanie zmian – w razie wykrycia awarii operacja cofnięcia zatwierdzenia w repozytorium przywraca sprawny stan w kilkadziesiąt sekund.
  • Zespołowy przegląd konfiguracji – każda modyfikacja infrastruktury przechodzi przez procedurę Pull Request i testy automatyczne przed wdrożeniem na serwery.
  • Minimalizacja ryzyka operacyjnego – inżynier uruchamia przetestowany kod z repozytorium, eliminując potrzebę wprowadzania poleceń z pamięci na konsoli serwera.
  • Fundament nowoczesnego SRE – połączenie kodu infrastruktury, automatycznych potoków i ciągłego monitoringu tworzy odporną platformę cyfrową.
Testowanie infrastruktury: Traktowanie infrastruktury jak oprogramowania - podgląd zmian (terraform plan), sprawdzanie bez modyfikacji (ansible --check) i testy na stagingu przed produkcją.
środowisko z IaC

Zarządzanie stanem (.tfstate) w OpenTofu i Terraformie wymaga bezpiecznego backendu zdalnego z blokowaniem (np. S3 z tabelą DynamoDB lub etcd), co zapobiega współbieżnemu nanoszeniu zmian i uszkodzeniu infrastruktury.

Testowanie przed wdrożeniem: `terraform plan` (dry-run), `ansible --check`, testy na środowisku stagingowym przed produkcją - wykrywanie błędów wcześnie; hasło „test infrastructure like code".

Wersjonowanie i historia: `git log` - kto, co i kiedy zmienił; `git revert` = natychmiastowy rollback konfiguracji; audyt wbudowany w proces (built-in audit trail).

Współpraca zespołu: model branchy (GitFlow/GitHub Flow), pull request + CI (lint, test, plan), code review - brak konfliktów, wspólna wiedza (shared knowledge), szybszy rozwój zespołu.

Mniejsze ryzyko błędu ludzkiego: operacje = uruchomienie przetestowanego kodu, nie wpisywanie z pamięci; nowy członek zespołu jest bezpieczny dzięki czytelnemu kodowi.

Wniosek: IaC + Git + CI/CD + monitoring = platforma SRE; każdy element wzmacnia pozostałe; fundament nowoczesnego utrzymania systemów.

Jeśli infrastruktura jest opisana kodem, możemy ją traktować z takim samym rygor jak aplikację - i to jest właśnie moment, w którym utrzymanie systemów zmienia się z rzemiosła w inżynierię. Zamiast przewidywać wszystko w pamięci, testujemy infrastrukturę przed wdrożeniem: terraform plan pokazuje z wyprzedzeniem, co dokładnie zostanie zmienione, a ansible --check tylko sprawdza, bez wprowadzania zmian. Pełny test wykonujemy na środowisku stagingowym, zanim cokolwiek dotknie produkcji. Wersjonowanie daje natychmiastowy rollback - błędna zmiana jest cofana komendą git revert, a historia pokazuje, kto, co i kiedy zmienił; audyt jest wbudowany w proces, a nie doklejany później. Zespół współpracuje przez feature branch, pull request i code review - zmiany są czytane przez innych, sprawdzane przez CI (lint, testy, terraform plan), a dopiero po akceptacji idą dalej. Najważniejsze: operacje przestają być wpisywaniem poleceń „z głowy", a stają się uruchamianiem przetestowanego kodu. Mniejsze ryzyko błędu ludzkiego, szybszy rozwój i przewidywalność - to jest esencja platformy SRE, w której IaC, Git, CI/CD i monitoring wzajemnie się wzmacniają.

Wyjaśnienie skrótów użytych na slajdzie:
PR – Pull Request – sformalizowana prośba o włączenie zmian w kodzie infrastruktury poddawana zespołowej weryfikacji (Peer Review).
CI/CD – Continuous Integration / Continuous Delivery – potoki automatyzujące walidację składniową i bezpieczeństwo kodu infrastruktury przed wdrożeniem.
IaC – Infrastructure as Code – fundament niezmiennej infrastruktury, eliminujący bezpośrednie, ręczne interwencje administratorskie na produkcji.

33/55 Pojęcie kontenerów (wprowadzenie)
Kontener vs VM: kontener współdzieli kernel hosta (lekki, MB, sekundy startu); VM ma własny OS (ciężki, GB, minuty). Docker = narzędzie nr 1 do konteneryzacji.

Kontener to lekka izolacja procesów na wspólnym kernelu: megabajty zamiast gigabajtów, sekundy zamiast minut.

  • Maszyna wirtualna a kontener – maszyna wirtualna emuluje cały system operacyjny, podczas gdy kontener izoluje pojedynczą aplikację, dzieląc jądro z systemem gospodarza.
  • Efektywność wykorzystania zasobów – kontenery zużywają ułamek pamięci RAM wymaganej przez systemy wirtualne i uruchamiają się w ciągu ułamków sekund.
  • Praktyka konteneryzacji – narzędzie Docker buduje niezmienny obraz aplikacji na podstawie pliku Dockerfile, a następnie uruchamia go jako izolowany proces.
  • Warstwowa struktura obrazu – obraz składa się z warstw bibliotek i kodu, które można wersjonować etykietami i bezpiecznie pobierać ze wspólnego rejestru.
  • Spójność między środowiskami – ten sam skonteneryzowany obraz działa identycznie na komputerze programisty, w potoku testowym i na klastrze produkcyjnym.
Kontener: Lekka jednostka izolująca procesy przy współdzieleniu kernela hosta (megabajty, start w sekundy); maszyna wirtualna zawiera pełny system operacyjny (gigabajty, start w minuty).
schemat kontenera

Mechanizm działania kontenerów w systemie Linux: W przeciwieństwie do maszyny wirtualnej, która uruchamia własne, oddzielne jądro systemu na emulowanym sprzęcie, kontener jest po prostu standardowym procesem Linuksa uruchomionym w izolacji. Izolację tę zapewniają dwa mechanizmy jądra: namespaces (przestrzenie nazw), które dają procesowi złudzenie posiadania własnego stosu sieciowego, dysku i drzewa procesów, oraz cgroups (grupy kontrolne), które sztywno limitują przydział pamięci RAM i rdzeni CPU.

Praktyczne tworzenie i uruchamianie kontenerów aplikacyjnych dokumentuje oficjalny podręcznik platformy Docker.

Środowiska kontenerowe podlegają specyfikacjom fundacji Open Container Initiative (OCI) definiującym format obrazu oraz środowisko uruchomieniowe (np. runc, containerd). Izolacja opiera się na linuksowych przestrzeniach nazw (namespaces) oraz grupach kontrolnych (cgroups).

Kontener vs VM: maszyna wirtualna = hypervisor + pełny system gościa (GB RAM, minuty startu); kontener = kernel hosta + namespace + cgroups (MB, sekundy); współdzielony kernel = lekkość (lightweight).

Docker: narzędzie nr 1 - `docker build` (z Dockerfile) → image → `docker run` → kontener; warstwowy system plików (overlayfs), copy-on-write; przenośne i powtarzalne buildy.

Obraz (image): niezmienny szablon zbudowany z warstw - base OS + zależności + aplikacja + konfiguracja; wersjonowany tagami (`nginx:1.25`, `myapp:v1.2.3`); rejestry: Docker Hub, GHCR, ECR, Harbor.

Spójność środowiska: ten sam obraz na laptopie developera, w CI, na stagingu i na produkcji - eliminacja „works on my machine"; obraz = „przepis", kontener = działający proces.

Szczegóły w wykładzie 5 i 7: Docker Compose (lokalnie/prosto), Kubernetes (produkcja, skala), GitOps (ArgoCD + Kubernetes); terminy: container, image, Docker, Dockerfile, layer, registry, namespace, cgroup, OCI.

Kontenery są odpowiedzią na odwieczny problem „u mnie działa" (works on my machine). Porównajmy je najpierw z maszynami wirtualnymi. Maszyna wirtualna zawiera pełny system operacyjny działający na hypervisorze - jest więc ciężka, zajmuje gigabajty i potrzebuje minut na start. Kontener natomiast współdzieli kernel hosta, a izoluje tylko procesy dzięki mechanizmom jądra, takim jak namespace i cgroups. Dlatego jest lekki - to z reguły dziesiątki megabajtów - i startuje w sekundy. W praktyce kontenery obsługujemy narzędziem Docker: na podstawie pliku Dockerfile wykonujemy docker build, który tworzy obraz (image) - niezmienny, warstwowy szablon zawierający system bazowy, zależności, aplikację i konfigurację. Obraz jest wersjonowany tagami (na przykład myapp:v1.2.3) i przechowywany w rejestrze, takim jak Docker Hub. Z obrazu uruchamiamy kontener - działający proces. Kluczowa korzyść to spójność: ten sam obraz uruchomiony na laptopie programisty, w CI, na stagingu i na produkcji daje identyczne środowisko. To eliminuje całą kategorię awarii wynikających z różnic między środowiskami. Szczegóły rozwijamy w wykładach 5 i 7: Docker Compose dla prostych stosów, Kubernetes dla produkcji i ArgoCD dla GitOps.

Wyjaśnienie skrótów użytych na slajdzie:
OCI – Open Container Initiative – otwarta inicjatywa standaryzująca formaty obrazów kontenerów oraz interfejsy środowisk uruchomieniowych.
VM – Virtual Machine – maszyna wirtualna; technologia wirtualizacji sprzętowej wymagająca pełnego systemu operacyjnego dla każdego systemu gościa.
OS – Operating System – system operacyjny; konteneryzacja umożliwia współdzielenie jądra systemu gospodarza przy zachowaniu izolacji procesów.
cgroups – Control Groups – mechanizm jądra Linux odpowiedzialny za precyzyjne limitowanie i rozliczanie zasobów procesora, pamięci i operacji we/wy dla kontenerów.

34/55 Orkiestracja (wprowadzenie)
Orkiestracja - automatyczne zarządzanie kontenerami: scheduling, skalowanie (HPA), self-healing, rolling updates. Kubernetes (K8s) = platforma #1.

Setkami kontenerów nikt nie zarządza ręcznie. Orkiestrator rozmieszcza je, skaluje, leczy i aktualizuje sam.

  • Rola platformy orkiestracji – system Kubernetes automatycznie rozmieszcza kontenery na węzłach, restartuje uszkodzone procesy i równoważy ruch sieciowy.
  • Lokalne środowiska wielokontenerowe – narzędzie Docker Compose umożliwia deklaratywne uruchomienie połączonych usług na pojedynczej maszynie deweloperskiej.
  • Automatyczne skalowanie (HPA) – liczba instancji aplikacji rośnie samoczynnie w odpowiedzi na wzrost zużycia procesora, chroniąc system przed przeciążeniem.
  • Wysoka dostępność z definicji – deklaracja pożądanej liczby replik gwarantuje, że awaria pojedynczego węzła wywoła natychmiastowe uruchomienie kontenera w innym miejscu.
  • Podstawowe pojęcia orkiestracji – student poznaje koncepcje węzła, pętli sterowania, podu, serwisu sieciowego oraz bezprzestojowej aktualizacji (Rolling Update).
Orkiestracja: Automatyczne zarządzanie zbiorem kontenerów - planowanie (scheduling), skalowanie, samonaprawa i aktualizacje bez przestojów; wiodącą platformą jest Kubernetes.
klaster kontenerów

Pętla sterowania (Reconciliation Loop) w Kubernetes: Sednem działania platformy orkiestracji jest koncepcja deklaratywna. Inżynier nie wydaje poleceń typu „uruchom kontener na serwerze X”. Zamiast tego zapisuje w pliku YAML deklarację: „stanem pożądanym są 3 działające instancje aplikacji”. Kontroler w klastrze w nieustannej pętli bada stan rzeczywisty – jeśli jeden z serwerów ulegnie fizycznej awarii i liczba działających instancji spadnie do 2, system samoczynnie uruchamia brakujący kontener na innym zdrowym węźle.

W warstwie orkiestracji platforma Kubernetes realizuje ciągłą pętlę uzgadniania stanu (Reconciliation Loop), stale dążąc do zrównania stanu obserwowanego klastra ze stanem pożądanym zadeklarowanym w manifestach.

Orkiestracja = automatyczne zarządzanie zbiorem kontenerów; gdy liczba rośnie, ręczne uruchamianie przestaje wystarczać - Kubernetes (K8s) jest platformą numer jeden.

Architektura K8s: warstwa kontrolna (control plane: api-server, scheduler, controller-manager, etcd) + węzły robocze (kubelet, kube-proxy, container runtime); deklaratywny opis pożądanego stanu.

Docker Compose dla prostszych przypadków: `docker-compose.yml` (services, networks, volumes); komenda `docker compose up -d` uruchamia cały stos; środowisko deweloperskie i mała skala.

Zadania orkiestracji: automatyczne skalowanie (HPA/VPA), samonaprawa (restart awaryjnych podów, przydzielenie na nowy węzeł), rolling updates, wykrywanie usług (service discovery przez DNS), secrets i configmaps; wysoka dostępność wbudowana.

Związek z HA: orkiestrator gwarantuje `replicas: 3` - pod lub węzeł umiera, nowy pod powstaje na innym węźle; Service (load balancer) rozdziela ruch; terminy: orchestration, cluster, scaling, self-healing, rolling update, pod, service, deployment.

Pojedynczy kontener możesz uruchomić ręcznie, ale co, gdy jest ich kilkadziesiąt albo kilkaset, a do tego każdy ma być zawsze dostępny, skalowany i aktualizowany bez przestojów? Tutaj wkracza orkiestracja (ang. orchestration) - automatyczne zarządzanie całym zbiorem kontenerów. Kiedy uruchomisz pięć usług na jednej maszynie obok siebie, następnego dnia klikasz 150 razy w tej samej konsoli w szóstym środowisku - o ile pamiętasz, co robiłeś - to już nie jest obsługa, tylko chaos. Dlatego powstała platforma numer jeden - Kubernetes, nazywany krótko K8s. Kontroluje on rozmieszczanie kontenerów (scheduling), automatycznie skaluje liczbę replik na podstawie metryk, na przykład zużycia CPU, dzięki mechanizmowi HPA (Horizontal Pod Autoscaler), samoczynnie restartuje kontenery, które uległy awarii (mechanizm samonaprawy – self-healing), i wdraża nowe wersje metodą rolling updates - bez zrywania dostępności. Dla prostszych przypadków istnieje Docker Compose: w pliku docker-compose.yml opisujesz usługi, sieci i wolumeny, a jedna komenda docker compose up -d uruchamia cały stos - to świetne rozwiązanie na etapie rozwoju i testów. Orkiestracja to też wysoka dostępność: deklaracja replicas: 3 oznacza, że system stale utrzymuje trzy działające instancje, a warstwa Service rozdziela między nie ruch jak load balancer. Jeśli pod umrze, orkiestrator uruchomi nowy na innym węźle - sieci obejmują cały klaster.

Wyjaśnienie skrótów użytych na slajdzie:
K8s – Kubernetes – otwarta platforma orkiestracji kontenerów realizująca automatyczne harmonogramowanie, samonaprawę i skalowanie aplikacji.
CNCF – Cloud Native Computing Foundation – organizacja open-source zrzeszająca wiodące projekty infrastruktury chmurowej, w tym Kubernetes i Prometheus.
HPA – Horizontal Pod Autoscaler – mechanizm horyzontalnego skalowania liczby instancji podów w zależności od obciążenia procesora lub metryk niestandardowych.
HA – High Availability – wysoka dostępność; cecha architektury gwarantująca nieprzerwane świadczenie usług pomimo awarii pojedynczych węzłów klastra.

35/55 Ciągłe wdrażanie (CI/CD, wstęp)
CI (Continuous Integration) - automatyczny build + testy przy każdym push. CD (Continuous Delivery/Deployment) - automatyczne dostarczanie na produkcję.

CI testuje każdą zmianę, CD dowozi ją na produkcję. Efekt: małe, częste i odwracalne wydania zamiast wielkich bangów.

  • Ciągła integracja (CI) – każda zmiana w kodzie automatycznie uruchamia proces budowania i zestaw testów jednostkowych, wykrywając usterki na wczesnym etapie.
  • Dostarczanie a wdrażanie (CD) – ciągłe dostarczanie przygotowuje przetestowany artefakt do ręcznej decyzji, natomiast ciągłe wdrażanie publikuje go samoczynnie.
  • Etapy potoku wdrożeniowego – proces prowadzi przez pobranie kodu, kompilację, testy bezpieczeństwa, wdrożenie próbne oraz testy dymne na produkcji.
  • Zmniejszanie promienia rażenia – częste publikowanie drobnych poprawek ogranicza skalę potencjalnych problemów i drastycznie upraszcza analizę awarii.
  • Zaawansowane techniki wydań – metody canary (kanarkowe) oraz blue-green pozwalają na bezpieczne testowanie nowej wersji na ułamku rzeczywistego ruchu.
CI/CD: Ciągła integracja (automatyczny build i testy przy każdym pushu) oraz ciągłe dostarczanie (automatyczne wdrażanie na produkcję), wykrywające błędy wcześnie, gdy są tanie w naprawie.
etapy pipeline CI/CD

Koncepcja promienia rażenia (Blast Radius): Pojęcie blast radius określa maksymalny zasięg zniszczeń, jaki może wywołać pojedyncza awaria lub błąd we wdrożeniu. W tradycyjnym modelu publikowano ogromne pakiety zmian raz na kilka miesięcy – awaria takiego wydania paraliżowała całą firmę. W podejściu CI/CD publikuje się mikroskopijne zmiany wielokrotnie w ciągu dnia; w razie usterki promień rażenia obejmuje zaledwie drobny wycinek systemu, a przyczynę błędu można natychmiast zlokalizować i naprawić.

CI (Continuous Integration): integracja zmian wielokrotnie dziennie - automatyczny build + testy (unit, integration, lint, scan bezpieczeństwa) przy każdym push/PR; wczesne wykrywanie błędów integracji.

CD (Continuous Delivery/Deployment): Delivery = artefakt gotowy do wdrożenia, wdrożenie ręczne (przycisk); Deployment = w pełni automatyczne wdrożenie na produkcję po testach; małe partie zmian = bezpieczniej.

Pipeline: etapy - checkout → build → test → package (artifact) → deploy (staging) → smoke test → deploy (prod) → weryfikacja; artefakt = gotowy pakiet z metadanymi.

Związek z SRE: szybsze i bezpieczniejsze wdrożenia - mniejsze partie zmian, szybszy feedback, łatwiejszy rollback, mniejszy blast radius; ryzyko przenosi się z samego uruchamiania na projektowanie automatyzacji.

Terminy: CI/CD, pipeline, artifact, stage, job, runner, trigger, canary, blue-green, feature flag, blast radius.

CI/CD to skróty, które określają dwa uzupełniające się mechanizmy. CI, czyli ciągła integracja (Continuous Integration), polega na tym, że za każdym razem, gdy programista wypycha zmiany do repozytorium - przy każdym wypchnięciu zmian (push) czy wniosku pull request - automatycznie uruchamia się build i cały zestaw testów: jednostkowych, integracyjnych, a często też sprawdzeń bezpieczeństwa. Dzięki temu błędy są wykrywane wcześnie, gdy są tanie w naprawie, a nie po kilku tygodniach, gdy zapomniano już, co zostało zmienione. CD oznacza ciągłe dostarczanie lub ciągłe wdrażanie (Continuous Delivery/Deployment). Delivery zakłada, że artefakt - gotowy, spakowany produkt - jest zawsze przygotowany, ale samo wdrożenie na produkcję robi człowiek jednym przyciskiem. Deployment idzie dalej: wdrożenie na produkcję jest w pełni automatyczne, pod warunkiem że wszystkie testy przeszły. Całość przebiega w tak zwanym pipeline - potoku etapów: pobranie kodu, build, testy, spakowanie artefaktu, wdrożenie na staging, testy dymne (smoke tests), a na końcu wdrożenie na produkcję i weryfikacja. Dla SRE najważniejszy efekt jest prosty: zmiany są małe, częste i odwracalne. Każda pula zmian ma mniejszy „promień rażenia" (blast radius), feedback przychodzi szybko, a w razie problemu łatwiej cofnąć wersję. Zaawansowane techniki, takie jak canary czy blue-green, omówimy w dalszych wykładach.

Wyjaśnienie skrótów użytych na slajdzie:
CI – Continuous Integration – ciągła integracja; automatyczne scalanie i testowanie zmian w oprogramowaniu przy każdym zatwierdzeniu kodu.
CD – Continuous Delivery / Deployment – ciągłe dostarczanie (gotowość do wydania) lub ciągłe wdrażanie (automatyczna publikacja na produkcji).
VCS – Version Control System – system kontroli wersji rejestrujący historię modyfikacji kodu źródłowego i wyzwalający potoki CI/CD.

36/55 Bezpieczeństwo w utrzymaniu usług
Least privilege - minimalne uprawnienia dla procesów/usług. Secrets management - bezpieczne przechowywanie haseł i kluczy (Vault, Sealed Secrets).

Bezpieczeństwa nie doklejasz na końcu - projektujesz je od pierwszej linijki: uprawnienia, sekrety, audyt i RODO.

  • Zasada minimalnych uprawnień – procesy i usługi sieciowe uruchamia się na dedykowanych kontach bez praw roota, ograniczając dostęp regułami RBAC.
  • Zarządzanie tajemnicami i kluczami – hasła, certyfikaty i tokeny API przechowuje się w dedykowanych skarbcach (Vault), nigdy w jawnym tekście w repozytorium.
  • Ślad audytowy i rozliczalność – operacje administracyjne z uprawnieniami uprzywilejowanymi podlegają centralnemu logowaniu w celu wykrywania nadużyć.
  • Ochrona danych osobowych (RODO) – adresy IP, identyfikatory użytkowników i poufne dane podlegają obowiązkowemu maskowaniu w strumieniach logów.
  • Kultura odpowiedzialności zawodowej – bezpieczeństwo systemów opiera się na ciągłej weryfikacji podatności, higienie konfiguracji i etyce inżynierskiej.
Least privilege: Zasada przyznawania usługom i procesom wyłącznie minimalnych, absolutnie niezbędnych uprawnień; uzupełnia ją bezpieczne przechowywanie sekretów poza kodem.
warstwy bezpieczeństwa

Utrzymanie środowisk teleinformatycznych podlega przepisom ustawy z dnia 10 maja 2018 r. o ochronie danych osobowych, rozporządzenia RODO oraz ustawy o krajowym systemie cyberbezpieczeństwa. Wszelkie identyfikatory sieciowe (adresy IP, logi dostępowe) podlegają rygorom ochrony i minimalizacji określonym przez Urząd Ochrony Danych Osobowych. Hasła, tokeny API i klucze prywatne nie mogą znajdować się w kodzie źródłowym ani obrazach kontenerów; muszą być zarządzane przez dedykowane systemy skarbcowe (np. HashiCorp Vault) z wymuszoną rotacją i audytem dostępu zgodnie ze standardami Center for Internet Security (CIS).

Least privilege: proces lub usługa ma tylko uprawnienia niezbędne - użytkownik `nginx`, nie root; capabilities zamiast `--privileged`; RBAC w Kubernetesie; zasada zero trust.

Secrets management: hasła, klucze, tokeny nigdy w kodzie, konfiguracji ani obrazach - Vault, AWS Secrets Manager, Sealed Secrets, Doppler, 1Password CLI; rotacja i audyt dostępu.

Audyt operacji: wszystkie czynności administratora (sudo, kubectl, ansible) logowane - kto, co, kiedy; systemy SIEM/korelacja; zgodność i forensics.

Ochrona danych w logach: dane osobowe (PII: IP, e-mail, tokeny) maskowane i anonimizowane przed zapisem - RODO, compliance; filtrowanie logów w Promtail lub Fluent Bit.

Sylabus - K02: etyka, poufność, odpowiedzialność - kompetencje społeczne weryfikowane na egzaminie; security as code, nie doklejane na końcu.

Bezpieczeństwo w SRE nie jest osobnym obszarem, który ktoś dokleja na końcu - to sposób, w jaki projektujesz systemy od pierwszej linijki. Podstawową zasadą jest least privilege, czyli przyznawanie każdej usłudze i każdemu procesowi tylko tych uprawnień, które są mu absolutnie niezbędne. Serwer nginx pracuje na użytkowniku nginx, a nie na root; w Kubernetesie reguły RBAC ograniczają, co każdy pod może zrobić. Równie ważne jest zarządzanie sekretami - hasłami, kluczami, tokenami, które absolutnie nie mogą trafiać do kodu, konfiguracji ani obrazów. Do ich przechowywania służą dedykowane narzędzia, na przykład HashiCorp Vault czy Sealed Secrets, wraz z rotacją i audytem dostępu. Każda czynność administracyjna - sudo, kubectl, ansible - powinna być logowana: kto, co, kiedy wykonał. Takie dzienniki pozwalają na analizę incydentów (forensics), raporty zgodności (compliance) i wykrywanie anomalii w typowych systemach SIEM, które korelują logi z różnych źródeł. Wreszcie sama analiza danych: logi mogą zawierać dane osobowe, takie jak adresy IP czy e-maile, dlatego zgodnie z RODO należy je maskować i anonimizować przed zapisem. Podsumowując: bezpieczeństwo to postawa i systematyczność, a nie pojedyncze narzędzie.

Wyjaśnienie skrótów użytych na slajdzie:
RBAC – Role-Based Access Control – kontrola dostępu oparta na rolach; model autoryzacji przyznający uprawnienia do określonych funkcji systemowych.
SIEM – Security Information and Event Management – zintegrowany system centralnego gromadzenia i korelacji logów pod kątem wykrywania incydentów bezpieczeństwa.
RODO – Rozporządzenie o Ochronie Danych Osobowych – unijny akt prawny nakładający obowiązek technicznej ochrony i minimalizacji danych osobowych w systemach IT.
GDPR – General Data Protection Regulation – oficjalna angielska nazwa ogólnego rozporządzenia o ochronie danych osobowych.

37/55 Etyka pracy SRE
Blameless culture - szczere dokumentowanie błędów i awarii; psychologiczne bezpieczeństwo pozwala uczyć się zamiast maskować problemy.

Masz dane milionów użytkowników i systemy, które nie śpią. To zobowiązuje: poufność, rzetelność i jawność błędów.

  • Ochrona prywatności i danych – inżynier ma dostęp do krytycznych baz danych, co nakłada bezwzględny obowiązek poszanowania tajemnicy i minimalizacji wglądu.
  • Rzetelność dokumentacji technicznej – raporty poawaryjne i instrukcje muszą odzwierciedlać stan faktyczny, bez zatajania niewygodnych usterek i zaniedbań.
  • Jawność raportowania zdarzeń – organizacja premiuje zgłaszanie drobnych incydentów i sytuacji bliskich awarii, traktując je jako szansę na utwardzenie systemów.
  • Transparentność wobec klientów – publiczne komunikaty na stronach statusowych budują zaufanie użytkowników poprzez rzeczowe informowanie o postępach naprawy.
  • Standardy etyczne w programie studiów – odpowiedzialność zawodowa inżyniera stanowi integralny element kształcenia akademickiego na kierunkach technicznych.
Need-to-know: Zasada dostępu do danych (np. logów z danymi osobowymi) tylko dla osób, które go potrzebują, i tylko w niezbędnym zakresie; fundament etyki pracy inżyniera SRE.
zasady etyczne w IT

Standardy zgłaszania podatności i reakcji na incydenty bezpieczeństwa koordynuje zespół CERT Polska.

Poufność danych: logi, metryki i bazy mogą zawierać dane użytkowników - dostęp tylko na zasadzie need-to-know, szyfrowanie, polityka retencji; zasada minimalizacji danych.

Rzetelność dokumentacji: post-mortemy, runbooki, change logi - prawdziwe, kompletne, nawet gdy wnioski są niewygodne; brak „ładnych" raportów ukrywających problemy; szczerość = zaufanie.

Nieukrywanie błędów: zgłaszanie incydentów, near-misses, własnych pomyłek - psychologiczne bezpieczeństwo (psychological safety) pozwala uczyć się zamiast maskować; blameless culture w praktyce.

Przejrzystość wobec klienta: status pages (publiczne), komunikacja podczas awarii (ETA, wpływ, obejście), uczciwe raportowanie SLA - buduje długofalowe zaufanie; przejrzystość = przewaga konkurencyjna.

Sylabus - K01, K02, K03: odpowiedzialność (K01), etyka/poufność (K02), kreatywne rozwiązywanie problemów (K03) - kompetencje społeczne weryfikowane; postawa osoby wpływającej na wielu innych.

Inżynier niezawodności pracuje z danymi milionów użytkowników i z systemami, które nie śpią nawet wtedy, gdy on sam śpi. To nakłada na niego konkretne obowiązki etyczne. Po pierwsze: poufność. Logi, metryki i bazy danych bywają pełne danych osobowych, dlatego dostęp do nich podlega zasadzie need-to-know - tylko ci, którzy muszą, w zakresie, w jakim muszą - a dane są szyfrowane i podlegają polityce retencji. Po drugie: rzetelność. Post-mortemy po awariach, runbooki i logi zmian mają być prawdziwe i kompletne, nawet jeśli wnioski są niewygodne - bo to na nich opiera się zaufanie w zespole. Po trzecie: brak ukrywania błędów. Zgłaszasz incydent, bliski wypadek (near-miss), przyznajesz się do własnej pomyłki. Tak działa kultura bez obwiniania (blameless culture): psychologiczne bezpieczeństwo sprawia, że ludzie mówią o problemach, zamiast je maskować. Po czwarte: przejrzystość wobec klientów - status pages z informacją o awarii, uczciwe raportowanie SLA i spokojna komunikacja, zamiast cichego trzymania problemu w tajemnicy. To wszystko są kompetencje społeczne, które sylabus zapisuje jako K01 (odpowiedzialność), K02 (etyka i poufność) i K03 (kreatywne rozwiązywanie problemów).

Wyjaśnienie skrótów użytych na slajdzie:
NDA – Non-Disclosure Agreement – umowa o zachowaniu poufności; formalne zobowiązanie inżyniera do ochrony danych wrażliwych i tajemnic przedsiębiorstwa.
SLA – Service Level Agreement – formalna umowa określająca standardy jakościowe; rzetelność inżyniera wymaga jawnego i uczciwego raportowania awarii.
BCP – Business Continuity Plan – plan ciągłości działania instytucji na wypadek kryzysu, wymagający szczerości w raportach powypadkowych.

38/55 Dokumentacja operacyjna
Runbook - instrukcja krok po kroku na konkretną sytuację kryzysową. Docs-as-code - dokumentacja w repozytorium Git, poddana review jak kod.

Dokumentacja to pamięć zespołu: bez niej wiedza wyparowuje razem z ludźmi, a nowi wdrażają się tygodniami.

  • Zakres dokumentacji platformy – kompletna dokumentacja łączy diagramy architektury systemowej (diagramy C4), kod infrastruktury oraz procedury awaryjne.
  • Struktura instrukcji runbook – procedury ratunkowe opisują precyzyjne kroki diagnostyczne i naprawcze dla zdefiniowanych scenariuszy awaryjnych.
  • Dokumentacja jako kod (Docs-as-Code) – dokumenty techniczne podlegają wersjonowaniu w systemie Git, przeglądom zespołowym oraz automatycznej kontroli spójności.
  • Repozytorium znanych błędów – baza zidentyfikowanych problemów z udokumentowanymi obejściami skraca czas przywracania sprawności podczas nocnych dyżurów.
  • Wdrażanie nowych inżynierów – przejrzyste checklisty, scenariusze laboratoryjne oraz asystowanie starszym inżynierom przyspieszają bezpieczne wejście do zespołu.
Runbook: Instrukcja krok po kroku na konkretną, zwykle kryzysową sytuację (np. przywrócenie usługi po awarii bazy); część pamięci operacyjnej zespołu.
struktura dokumentacji

Dokumentacja operacyjna = pamięć zespołu: architektura (diagramy C4), konfiguracja (repozytorium IaC), procedury - wszystko, co pozwala zrozumieć, jak powstał system i jak go utrzymać; single source of truth.

Runbooki = specyficzna forma: instrukcje krok po kroku na konkretne sytuacje (np. przywrócenie usługi po awarii); wykonalne, krytyczne czasowo; z przypisanym właścicielem.

Aktualność = kluczowe wyzwanie: nieaktualny dokument szkodzi (wprowadza w błąd, opóźnia reakcję); docs-as-code - dokumentacja w tej samych repozytorium co kod, CI sprawdza linki, review w PR; jasny właściciel.

Baza błędów i rozwiązań (wiki/Notion/Confluence): known errors, workaroundy, runbooki per usługa; indeksowanie i tagowanie; skraca czas diagnozy dzięki gotowym rozwiązaniom.

Szkolenie nowych: checklista onboardingowa - dostępne dokumenty, przejście przez runbooki, shadowing on-call, dostęp do środowiska testowego; time-to-productivity; dokumentacja działa niezależnie od rotacji ludzi.

Dokumentacja operacyjna to pamięć zespołu - bez niej niewielka wiedza rozproszona w głowach ludzi wycieka, a czas dojścia nowego inżyniera do pełnej produktywności liczony jest w tygodniach zamiast w dniach. W skład tej dokumentacji wchodzi architektura systemu, na przykład zapisana w diagramach C4, konfiguracja utrzymywana jako kod w IaC oraz procedury. Najbardziej specyficzną formą są runbooki - instrukcje krok po kroku na konkretną, zwykle kryzysową sytuację, na przykład „przywróć usługę po awarii bazy". Runbook ma być konkretny, wykonalny i przypisany do właściciela. Drugi kluczowy pomysł to docs-as-code, czyli dokumentacja traktowana jak kod: znajduje się w tym samym repozytorium, jest poddawana recenzji kodu we wniosku pull request, a CI sprawdza chociażby linki. Dlaczego to ważne? Bo nieaktualna dokumentacja jest gorsza niż jej brak - prowadzi w ślepy zaułek w najgorszym możliwym momencie. Do tego warto zbierać bazę błędów: znane problemy (known errors) z obejściami (workarounds), co dramatycznie skraca czas diagnozy. Wreszcie onboarding: checklisty, przejście z nowym pracownikiem przez runbooki, shadowing dyżurów i dostęp do środowiska testowego pozwalają go wdrożyć szybko i bezpiecznie.

Wyjaśnienie skrótów użytych na slajdzie:
ADR – Architecture Decision Record – sformalizowany dokument opisujący motywację, alternatywy i skutki podjętych decyzji architektonicznych.
SOP – Standard Operating Procedure – standardowa procedura operacyjna precyzująca krok po kroku powtarzalne czynności techniczne.
CI/CD – Continuous Integration / Continuous Delivery – potok stosowany w koncepcji docs-as-code do automatycznego testowania i publikacji dokumentacji.

39/55 Narzędzia komunikacji zespołu
Incident channel - dedykowany kanał komunikacji podczas awarii. Integracja monitoringu z komunikatorami (Slack, Discord) przez webhooki.

Awaria testuje komunikację, nie tylko system. Miej kanały, zgłoszenia i kanał war room gotowe, zanim wystąpi awaria.

  • Dedykowane kanały komunikacji – komunikatory zespołowe porządkują dyskusję według projektów i komponentów, tworząc przeszukiwalną bazę wiedzy inżynierskiej.
  • Powiadomienia o incydentach – automatyczne powiadomienia z systemów monitoringu trafiają do dedykowanych kanałów awaryjnych, usprawniając mobilizację.
  • Systemy rejestracji zgłoszeń – platformy zarządzania zadaniami (Jira, ServiceNow) ewidencjonują historię prac, właścicieli zadań oraz zgodność z celami SLA.
  • Zasady komunikacji kryzysowej – w trakcie poważnych incydentów zespół powołuje wirtualny pokój operacyjny (war room) z jednoosobowym dowodzeniem.
  • Zapowiedź modułu alarmowania – mechanizmy grupowania powiadomień, wyciszania alarmów i harmonogramów dyżurów zostaną szczegółowo omówione w wykładzie 6.
Webhook: Mechanizm automatycznego przekazywania zdarzeń między systemami (np. alert z Alertmanagera na kanał Slack), integrujący monitoring z komunikacją zespołu.
okno komunikatora zespołu

Komunikatory (Slack/Discord/Mattermost): centralne miejsce dla rozmów, danych i zgłoszeń; kanały per zespół/projekt/incydent; przeszukiwalna historia = baza wiedzy.

Integracja z monitoringiem: alert → automatyczny wpis na kanał (Alertmanager/webhook) → od razu widać co, gdzie i kto reaguje; eliminacja szumu mailowego; incident channel per awaria.

Ticketing (Jira/ServiceNow/GitHub Issues): numer sprawy, właściciel, priorytet, SLA, historia (audit trail); system rejestracji dla incydentów i wniosków o zmianę.

Zasady zgłaszania: kto powiadamia, w jakim trybie, w jakim czasie; war room / incident channel = komunikacja awaryjna w jednym miejscu bez szumu; regularne aktualizacje (update cadence).

Szczegóły w wykładzie 6 (alerting): contact points, notification policies, silencing, integracja on-call; komunikacja = kluczowa, niedoceniana umiejętność SRE.

Awaria to test nie tylko systemu, ale przede wszystkim komunikacji. Dlatego zespół SRE ma wypracowane narzędzia i zasady, które działają jeszcze zanim coś się zepsuje. Centrum rozmów są komunikatory - Slack, Discord albo Mattermost - z kanałami per zespół, projekt i temat; ich historia jest jednocześnie przeszukiwalną bazą wiedzy. Monitoring można z nimi zintegrować: gdy Prometheus lub Alertmanager wygeneruje alert, przez webhook trafia on automatycznie na odpowiedni kanał, więc od razu widać, co się stało, gdzie i kto reaguje. Na czas każdej większej awarii tworzy się osobny incident channel - wydzielony kanał awaryjny, żeby nie mieszać dyskusji ratunkowej z codziennym szumem. Obok komunikatorów funkcjonuje system ticketowy, na przykład Jira czy ServiceNow: każdy incydent ma numer, właściciela, priorytet, powiązane SLA i pełną historię - to system rejestracji (system of record). Zasady zgłaszania ustalamy z wyprzedzeniem: kto powiadamia, w jakim trybie, w jakim czasie, jak często aktualizuje komunikat. W czasie poważnej awarii działa tak zwany war room - wirtualny lub fizyczny pokój dowodzenia, w którym cała komunikacja kryzysowa toczy się w jednym miejscu.

Wyjaśnienie skrótów użytych na slajdzie:
ITSM – IT Service Management – platformy obsługi zgłoszeń i zarządzania incydentami (np. Jira, ServiceNow) stanowiące formalny rejestr zdarzeń operacyjnych.
API – Application Programming Interface – interfejs programistyczny umożliwiający systemom monitoringu przesyłanie powiadomień przez webhooki do komunikatorów.
ChatOps – Podejście operacyjne łączące narzędzia zarządzania infrastrukturą z komunikatorami zespołu, pozwalające na sterowanie usługami bezpośrednio z czatu.

40/55 Podsumowanie narzędzi SRE
Stack SRE - współpracujący zestaw narzędzi: Prometheus (metryki), Grafana (wizualizacja), Loki (logi), ArgoCD (GitOps).

Narzędzia poznajemy jako współpracujący stack, nie osobno: logi, automatyzacja, kontenery i GitOps się uzupełniają.

  • Zarządzanie logami systemowymi – system Loki indeksuje metadane wpisów, zapewniając szybkie wyszukiwanie przyczyn awarii bez narzutu na pamięć RAM.
  • Automatyzacja powtarzalnych zadań – skrypty powłoki Bash oraz języka Python realizują zadania lokalne, a system Ansible deklaratywnie konfiguruje całą flotę maszyn.
  • Konteneryzacja i orkiestracja – narzędzie Docker tworzy jednolite środowiska uruchomieniowe, a platforma Kubernetes zarządza ich skalowaniem i wysoką dostępnością.
  • Deklaratywny model GitOps – repozytorium kodu stanowi jedyne źródło prawdy o konfiguracji, a kontrolery synchronizacji samoczynnie niwelują wszelki dryft.
  • Spójny ekosystem niezawodności – poznane narzędzia współpracują ze sobą w ramach jednej architektury, którą student będzie rozwijał w kolejnych wykładach.
Stack SRE: Współpracujący zestaw narzędzi kursu: Prometheus do metryk, Grafana do wizualizacji, Loki do logów i ArgoCD do GitOps.
mapa narzędzi

Do tworzenia dashboardów i zaawansowanej wizualizacji metryk służy platforma analityczna Grafana.

Zespół SRE używa zestawu narzędzi pogrupowanego funkcją: Logi - Loki/ELK (centralizacja, zapytania, korelacja); Automatyzacja - Bash/Python (skrypty, klej), Ansible (config management, deklaratywne); Kontenery - Docker (build/run), K8s (orkiestracja, HA, skalowanie); GitOps - Git (źródło prawdy), ArgoCD (synchronizacja, drift detection, self-healing).

Każde narzędzie rozwijane w kolejnych wykładach: Loki/ELK (wykład 4), Grafana/PromQL (wykład 3), Nginx/HAProxy/Docker/K8s (wykład 5), Alertmanager/on-call (wykład 6), ArgoCD/GitOps (wykład 7), Post-mortem/RCA (wykład 8); to nie jednorazowy pokaz, lecz stopniowe pogłębianie.

Termin stack = dobrany zespół współpracujących narzędzi; wybór nie jest celem samym w sobie - ma służyć zadaniom operacyjnym; dobre narzędzie uzupełnia pozostałe i ułatwia pracę, zamiast komplikować ją kolejną konfiguracją.

Następne zajęcia: składamy elementy w spójny system utrzymania; świadomość celu podróży ułatwia naukę i łączy szczegóły w całość; mapowanie kompetencji.

Zanim przejdziemy dalej, warto zrobić mapę narzędzi, z których będziemy korzystać przez cały kurs - bo uczymy się ich nie pojedynczo, ale jako współpracującego zestawu, czyli tak zwanego stacku. Do logów mamy Lokiego, lekkie rozwiązanie z językiem zapytań LogQL, albo cięższe, ale pełnotekstowe ELK. Do automatyzacji: Bash jako „klej" do sekwencji poleceń, Python tam, gdzie potrzeba logiki i integracji z API, oraz Ansible do masowej konfiguracji setek maszyn. Kontenery obsługujemy Dockerem do budowania i uruchamiania oraz Kubernetesem do orkiestracji, wysokiej dostępności i skalowania. Nad tym wszystkim stoi filozofia GitOps: Git jako jedyne źródło prawdy, a ArgoCD jako mechanizm synchronizujący klaster z repozytorium, wykrywający dryft i samonaprawiający odchylenia. Zauważcie, jak te elementy się uzupełniają: metryki bez dashboardów są ślepe, logi bez centralizacji giną, a wdrożenia bez GitOps są nieweryfikowalne. Wybór narzędzi nie jest celem samym w sobie - ma służyć konkretnym zadaniom operacyjnym. Każde z nich rozwijamy stopniowo w wykładach od drugiego do ósmego, więc teraz wystarczy, że zrozumiecie mapę.

Wyjaśnienie skrótów użytych na slajdzie:
CNCF – Cloud Native Computing Foundation – fundacja koordynująca rozwój kluczowych technologii chmurowych ekosystemu SRE.
GitOps – Model operacyjny, w którym repozytorium Git stanowi jedyne źródło prawdy dla stanu infrastruktury, automatycznie synchronizowanego przez dedykowany kontroler.
ELK – Elasticsearch, Logstash, Kibana – popularny stos oprogramowania służący do centralizacji, wyszukiwania pełnotekstowego i wizualizacji logów systemowych.
TSDB – Time Series Database – wyspecjalizowana baza danych zoptymalizowana pod kątem agregacji i analizy danych telemetrycznych w czasie.

41/55 Związek treści z planem wykładów
Mapa wykładów: każdy kolejny buduje na poprzednim - metryki (2) → dashboards (3) → logi (4) → HA/alerting (5,6) → GitOps (7) → incydenty (8).

Osiem wykładów to jedna droga: każdy następny staje na poprzednim. Oto mapa, dokąd idziemy.

  • Moduł 1 i 2: Fundamenty i metryki – poznanie zasad SRE i redukcji toilu prowadzi bezpośrednio do zbierania metryk w systemie Prometheus.
  • Moduł 3 i 4: Wizualizacja i logi – budowa dashboardów w Grafanie oraz agregacja i korelacja logów w systemie Loki z wykorzystaniem LogQL.
  • Moduł 5: Wysoka dostępność – eliminacja pojedynczych punktów awarii (SPOF) poprzez klastrowanie, balansery Nginx/HAProxy oraz mechanizmy HA.
  • Moduł 6: Systemy powiadomień – konfiguracja reguł alarmowych w Alertmanagerze, zarządzanie dyżurami technicznymi i ochrona przed zmęczeniem alertami.
  • Moduł 7 i 8: GitOps i incydenty – wdrożenia deklaratywne za pomocą ArgoCD oraz opanowanie procedur ratunkowych i raportów post-mortem.
Kolejność kursu: Metryki (w.2) dają dane do dashboardów (w.3), logi (w.4) wyjaśniają ich przyczyny, a HA, alerting, GitOps i incydenty (w.5-8) budują na tych fundamentach.
mapa 8 tematów

Plan 8 wykładów: 1) Fundamenty SRE (ten), 2) Monitoring + SLI/SLO/Prometheus, 3) Grafana + PromQL + projektowanie dashboardów, 4) Loki/ELK + analiza logów + RCA, 5) HA + Load Balancing (Nginx/HAProxy) + Docker/K8s + RTO/RPO, 6) Alertmanager + reguły alertowe + dyżury + MTTA/MTTR, 7) GitOps + ArgoCD + workflow Git + sekrety, 8) Zarządzanie incydentami + blameless post-mortem + RCA (5 Why, FTA).

Każdy wykład buduje na poprzednim: metryki (2) → dashboardy (3) → logi (4) → monitorowana i alertowana HA (5,6) → GitOps wdraża wszystko (7) → incydenty spinają całość (8); opanowanie fundamentów = klucz do sukcesu.
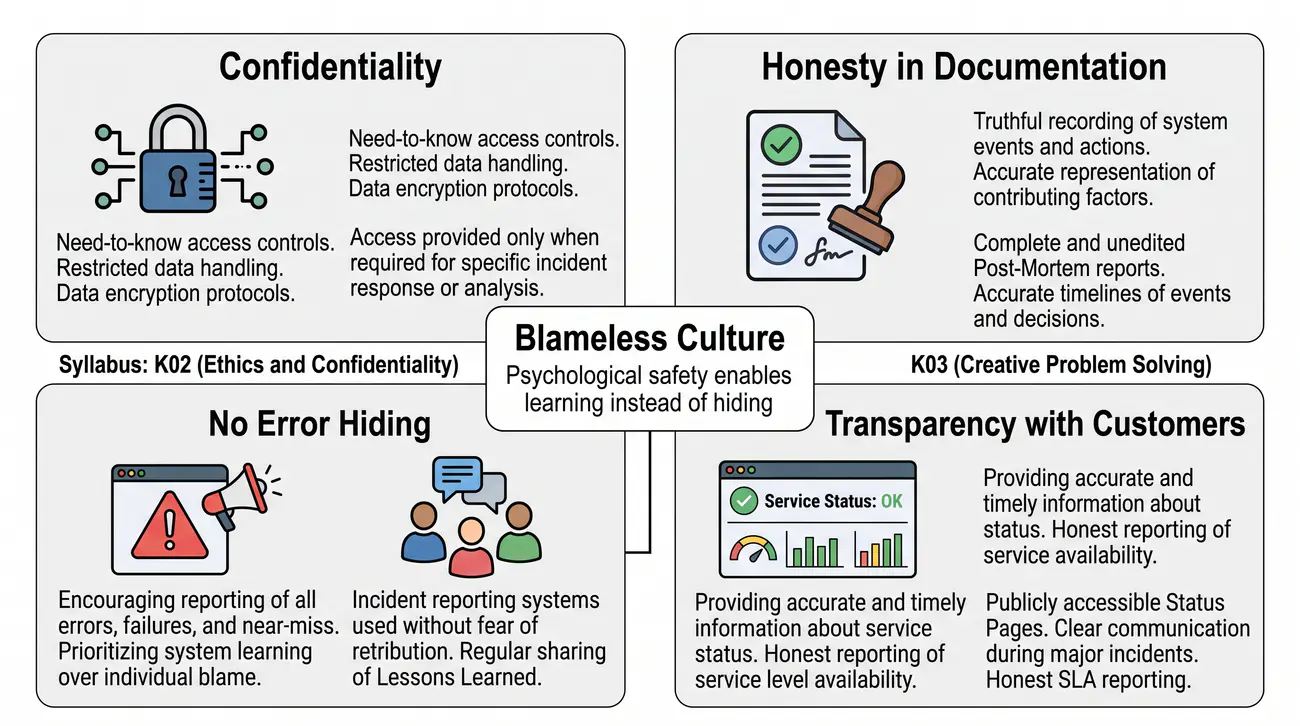
Świadomość mapy = lista celów, do których wracamy; ułatwia naukę, pozwala łączyć szczegóły w spójną całość; traktujcie ją jak mapę drogową rozwoju kompetencji.

Żeby nauka miała sens, warto od początku widzieć, dokąd zmierzamy. Cały kurs to osiem wykładów, w których każdy następny buduje na poprzednim. Wykład drugi to metryki i SLI/SLO oraz instalacja Prometheusa. Trzeci to Grafana i język zapytań PromQL - czyli projektowanie dashboardów i Golden Signals, metody RED i USE. Czwarty zbiera logi w Lokim i ELK, uczy LogQL i korelacji logów z metrykami, a także analizy przyczyn (RCA). Piąty zajmuje się wysoką dostępnością i load balancingiem - eliminacją pojedynczych punktów awarii, Nginxem i HAProxy, kontenerami oraz celami RTO/RPO. Szósty poświęcony jest alertingowi: Alertmanagerowi, regułom w PromQL, spalaniu budżetu błędów (burn rate), dyżurom i eskalacji. Siódmy to GitOps - Git, ArgoCD, Kustomize, Helm i Sealed Secrets, czyli automatyczna synchronizacja klastra z repozytorium. Ósmy scala wszystko przez zarządzanie incydentami: etapy awarii, blameless RCA, oś czasu, analiza przyczyn źródłowych i lista działań naprawczych. Zwróćcie uwagę, jak temat pierwszego wykładu - fundamenty niezawodności, toil, narzędzia - pojawia się tu jako wspólny język, na którym staniecie w każdym kolejnym temacie.

Wyjaśnienie skrótów użytych na slajdzie:
HA – High Availability – wysoka dostępność; projektowanie systemów o podwyższonej odporności na awarie sprzętowe i programowe.
SPOF – Single Point of Failure – pojedynczy punkt awarii; newralgiczny komponent, którego uszkodzenie paraliżuje działanie całego systemu.
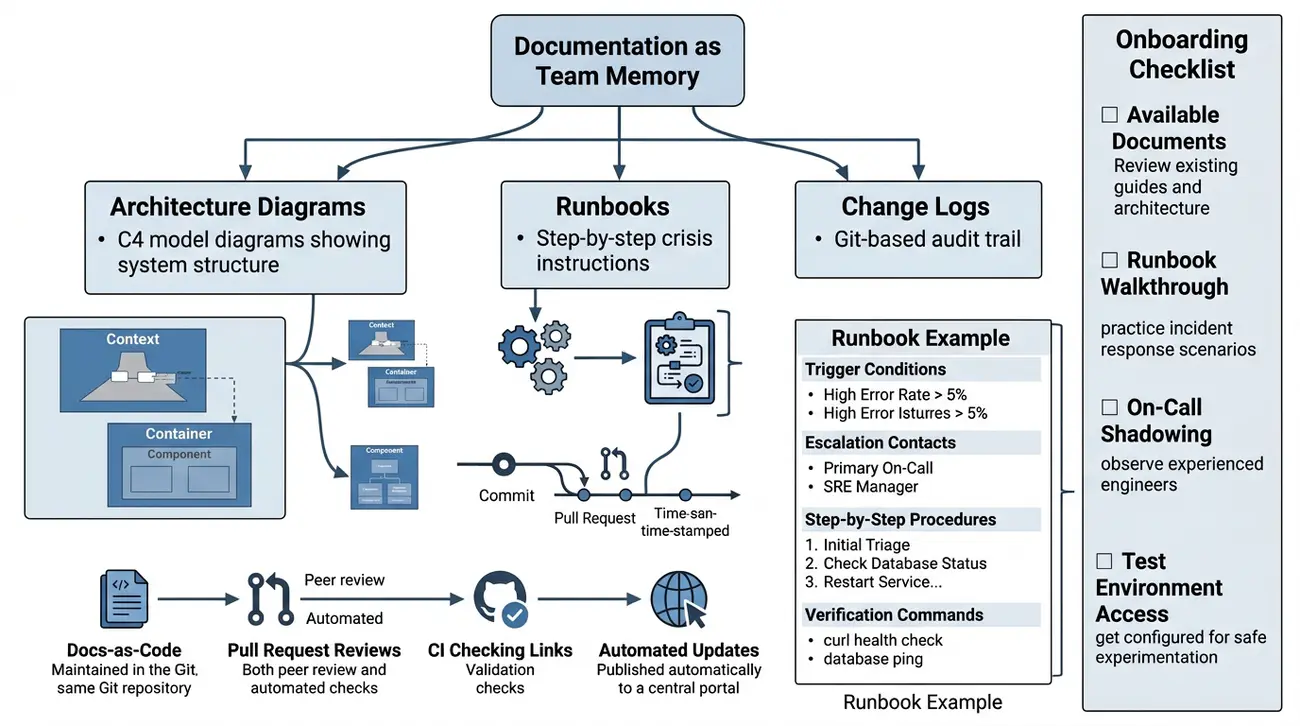
GitOps – Metodyka deklaratywnego wdrażania i synchronizacji aplikacji z repozytorium kodu Git.
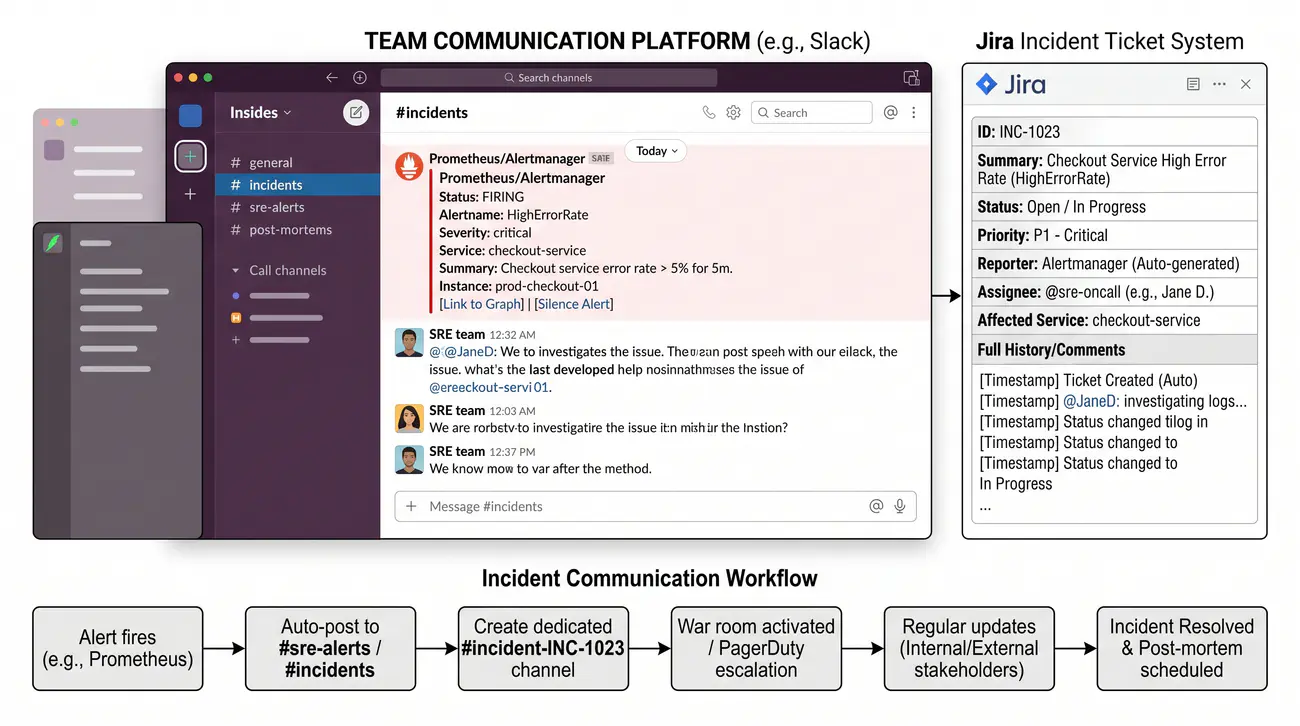
RCA – Root Cause Analysis – ustrukturyzowana metoda dochodzenia do pierwotnych przyczyn awarii wykorzystywana w raportach post-mortem.

42/55 Przygotowanie prostej automatyzacji w Bash (cz. 1)
Shebang #!/bin/bash - wskazuje interpreter skryptu. chmod +x - nadaje prawa wykonywania. Bez tych kroków skrypt nie zadziała.

Piszemy pierwszy skrypt. Dwa klasyczne potknięcia - brak shebanga i brak prawa wykonywania - naprawiamy oba.

  • Deklaracja interpretera (shebang) – linia #!/bin/bash na samym początku pliku precyzuje powłokę, która ma wykonać instrukcje skryptu.
  • Nadanie praw wykonywalności – polecenie chmod +x skrypt.sh nadaje atrybut wykonywania, umożliwiając bezpośrednie uruchomienie pliku.
  • Definiowanie i odczyt zmiennych – przypisanie wartości nie może zawierać spacji (nazwa=wartosc), a jej odczyt wymaga poprzedzenia symbolem dolara.
  • Sposoby uruchamiania programu – wywołanie ./skrypt.sh respektuje nagłówek shebang, podczas gdy bash skrypt.sh wymusza uruchomienie przez wskazany interpreter.
  • Weryfikacja w środowisku uczącym – student powinien samodzielnie uruchamiać przygotowane skrypty i weryfikować poprawność zwracanych komunikatów.
Prawo wykonywania: Flaga pliku nadawana poleceniem chmod +x, bez której uruchomienie skryptu poleceniem ./skrypt.sh kończy się odmową.
pierwszy skrypt
CLI · Bash: tworzenie pierwszego skryptu
# utworzenie pliku skryptu user@server:~$ cat > hello.sh << 'EOF' #!/bin/bash echo "Hello, SRE!" EOF user@server:~$ chmod +x hello.sh user@server:~$ ./hello.sh Hello, SRE!

Pierwszy skrypt Bash: shebang `#!/bin/bash` (wskazuje interpreter), `chmod +x` (bit wykonania), `./hello.sh` (uruchomienie z ./); bez shebanga lub uprawnień skrypt nie zadziała - najczęstsze błędy początkujących.

Zmienne i `echo`: `VAR=wartosc` (bez $ przy zapisie), `echo $VAR` (z $ przy odczycie); proste konstrukcje jako fundament; demo CLI: `cat > hello.sh << 'EOF'` (heredoc) tworzy plik bez edytora.

Weryfikacja na serwerze: wszystkie komendy sprawdzone - identyczny output (`Hello, SRE!`); budowanie pewności i nawyków; przy błędach sprawdź najpierw shebang i uprawnienia.

Najprostszy obieg pracy: utwórz → nadaj prawa → uruchom → zweryfikuj; w kolejnych slajdach rozbudowa o warunki (`if`), pętle (`for`) i argumenty (`$1`, `$2`).

Przejdźmy teraz do praktyki - napiszemy pierwszy skrypt w Bashu. Na początek dwa najczęstsze błędy początkujących, które sprawiają, że skrypt „wcale nie działa", mimo że powinien. Pierwszy: brak pierwszej linii, tak zwanego shebangu - zapisu #!/bin/bash lub przenośniejszego #!/usr/bin/env bash - który informuje system, jakim interpreterem uruchomić skrypt. Drugi: brak prawa do wykonywania, które nadajemy komendą chmod +x; bez tej flagi wpisanie ./skrypt.sh zakończy się odmową. Utworzymy plik hello.sh za pomocą heredoc - zapisu cat > plik << 'EOF', który pozwala tworzyć pliki bez edytora, wpisując zawartość między znacznikami. Potem nadamy prawa, uruchomimy skrypt i zobaczymy wypisany komunikat. Do tego dochodzą zmienne: zapisujesz nazwa=wartosc bez spacji i bez dolara, a odczytujesz przez echo $nazwa już z dolarem. Pamiętajcie też, że choć przykłady w tym wykładzie zostały zweryfikowane na serwerze testowym, różne środowiska mogą dać nieco inne wyniki - sprawdzanie zawsze warto zrobić samodzielnie.

Wyjaśnienie skrótów użytych na slajdzie:
CLI – Command Line Interface – środowisko wiersza poleceń służące do interaktywnego i wsadowego wywoływania skryptów powłoki.
POSIX – Portable Operating System Interface – standard kompatybilności uniksowej determinujący m.in. interpretację praw dostępu rwx.
UID – User Identifier – unikalny identyfikator numeryczny przypisany do konta użytkownika w systemie Linux.
GID – Group Identifier – numeryczny identyfikator grupy użytkowników decydujący o uprawnieniach zespołowych do plików i katalogów.

43/55 Przygotowanie prostej automatyzacji w Bash (cz. 2)
Testy plików: -f (plik istnieje), -d (katalog). Argumenty: $1, $2 - parametry z linii poleceń; $? - kod wyjścia ostatniego polecenia.

Statyczna lista komend to za mało: dodajemy warunki, pętle i argumenty, a skrypt staje się prawdziwym narzędziem.

  • Konstrukcje testujące stan – operatory w nawiasach kwadratowych (np. [ -f plik ]) sprawdzają istnienie zasobów, wymagając zachowania spacji.
  • Pętle przetwarzające kolekcje – składnia for i in ...; do ... done pozwala na seryjne wykonanie tych samych operacji na wielu plikach lub serwerach.
  • Obsługa argumentów i zmiennych specjalnych – zmienne $1 i $2 przekazują parametry wejściowe, a zmienna $? przechowuje kod wyjścia ostatniego polecenia.
  • Automatyczna detekcja awarii – komenda curl weryfikuje kod HTTP 200, a w razie jego braku skrypt restartuje serwer WWW i rejestruje zdarzenie w logu.
  • Wymuszenie rygoru wykonania – dyrektywy set -e oraz set -u natychmiast przerywają skrypt po wystąpieniu błędu lub użyciu niezdefiniowanej zmiennej.
Testy warunkowe Basha: Wyrażenia w nawiasach kwadratowych (np. [ -f plik ]) sprawdzające własności plików; spacje wewnątrz nawiasów są obowiązkowe.
fragment skryptu z pętlą
CLI · Bash: warunki i pętle
#!/bin/bash if [ -f /etc/os-release ]; then echo "System: $(head -1 /etc/os-release)" fi for i in 1 2 3; do echo "Iteracja $i" done

Warunki (`if`): `if [ -f /etc/os-release ]; then echo "System: $(head -1 /etc/os-release)"; fi` - wykonaj tylko, gdy test jest prawdziwy; operator `-f` = plik istnieje; decyzje dynamiczne.

Pętle (`for`): `for i in 1 2 3; do echo "Iteracja $i"; done` - to samo dla każdego elementu listy; baza przetwarzania wielu plików i serwerów; automatyzacja na skalę.

Argumenty: `$1`, `$2`... = parametry z linii poleceń; `$?` = kod wyjścia ostatniego polecenia; skrypty parametryzowane i wielokrotnego użytku.

Komentarze (kolor zielony): `# komentarz` - nie są wykonywane, wyjaśniają intencję; dobra praktyka = czytelność i łatwość utrzymania.

Przykład: skrypt sprawdzający dostępność usługi i raportujący restart; administratorzy używają go do kontroli wielu maszyn; fundament bezpiecznych, idempotentnych rozwiązań.

Rozbudujemy nasz skrypt o logikę decyzyjną, bo automatyzacja bez warunków i pętli to tylko statyczna lista poleceń. Warunek zapisujemy konstrukcją if ... then ... fi, a sam test umieszczamy w nawiasach kwadratowych - na przykład [ -f /etc/os-release ] sprawdzi, czy plik istnieje, a [ -d /katalog ], czy istnieje katalog. Uważajcie na składnię: spacje w nawiasach są w Bashu obowiązkowe, a przy przypisaniu zmiennej - wręcz zakazane. Pętla for i in 1 2 3; do ... done wykonuje to samo dla każdego elementu listy - to baza obróbki wielu plików lub wielu serwerów naraz. Z linii poleceń skrypt odbiera argumenty: $1, $2 i kolejne to parametry, $0 to nazwa skryptu, $# liczba parametrów, a $? kod wyjścia ostatniego polecenia - zero oznacza sukces. Taki parametryzowany skrypt staje się narzędziem wielokrotnego użytku: potrafi sprawdzić dostępność usługi przez curl i - gdy odpowiedź nie jest 200 - automatycznie zrestartować nginx i zapisać zdarzenie do logu. Do tego dochodzą flaga set -e (zakończ przy błędzie) i set -u (reaguj na niezdefiniowane zmienne), które czynią skrypty znacznie bezpieczniejszymi.

Wyjaśnienie skrótów użytych na slajdzie:
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji, którego kody stanu bada narzędzie curl w skryptach sprawdzających kondycję usług.
IPC – Inter-Process Communication – mechanizmy komunikacji międzyprocesowej, w tym potoki i przekazywanie kodów wyjścia.
CLI – Command Line Interface – tekstowe środowisko wykonawcze skryptów powłoki systemowej.

44/55 Harmonogramowanie skryptów (cron)
Cron - demon planujący zadania; crontab -e edytuje, crontab -l wyświetla. >> log 2>&1 - dopisuje stdout i stderr do pliku logów.

Ręczne uruchamianie to dopiero wstęp do automatyzacji. Demon cron wykonuje zadania o wyznaczonym czasie – wyniki należy jednak samodzielnie rejestrować w plikach dziennika.

  • Zarządzanie harmonogramem zadań – polecenie crontab -e otwiera edycję zadań użytkownika, a crontab -l wyświetla bieżącą listę zaplanowanych procesów.
  • Przykładowa definicja zadania – wpis 0 3 * * * skrypt.sh uruchamia skrypt codziennie o godzinie 3:00 w nocy, gdzie gwiazdka oznacza dowolną wartość pola.
  • Obowiązkowe rejestrowanie wyników – przekierowanie >> log 2>&1 zapisuje standardowe wyjście i komunikaty błędów, uniemożliwiając ciche awarie.
  • Kontrola wykonania i telemetria – cykliczne zadania wymagają weryfikacji w plikach dziennika oraz eksportu metryk do centralnego systemu monitoringu.
  • Elastyczne reguły czasowe – demon cron wspiera zakresy liczb, listy wartości, interwały krokowe oraz wygodne aliasy, takie jak @daily czy @reboot.
Przekierowanie strumieni: Zapis >> log 2>&1 dopisujący standardowe wyjście i błędy do pliku; podstawa logowania wyników zadań cron, który sam nie powiadamia o błędach.
przykładowy crontab
CLI · Linux: harmonogram cron
user@server:~$ crontab -e # codziennie o 3:00 kopia zapasowa 0 3 * * * /opt/scripts/backup.sh >> /var/log/backup.log 2>&1 user@server:~$ crontab -l 0 3 * * * /opt/scripts/backup.sh >> /var/log/backup.log 2>&1

W środowisku Linux zaleca się stosowanie blokady plikowej za pomocą narzędzia flock:

0 2 * * 0 /usr/bin/flock -n /var/lock/backup.lock /opt/scripts/backup.sh >> /var/log/backup.log 2>&1

Flaga -n (non-blocking) zapobiega nakładaniu się procesów długotrwałych.

Cron = mechanizm planowania zadań (demon cron): `crontab -e` edytuje, wpis = 5 pól czasu + polecenie; `0 3 * * * /opt/scripts/backup.sh >> /var/log/backup.log 2>&1` - codziennie 3:00, logowanie stdout+stderr do jednego pliku.

`>>` = dopisanie do pliku, `2>&1` = stderr do stdout (wszystko w jednym logu); `crontab -l` = podgląd bez edycji; cron nie ma wbudowanego alertingu - samodzielna kontrola wykonania (logi, metryki, alerty).

Weryfikacja: okresowo sprawdzaj logi, czy zadania się uruchamiają i kończą poprawnie; w dużych środowiskach dodatkowe narzędzia monitorujące (node_exporter + własne metryki generowane przez textfile collector, bo wbudowanego kolektora cron nie ma).

Zaawansowane: zakresy (`1-5`), listy (`1,3,5`), kroki (`*/10`), `@reboot`, `@daily`, `@hourly`; `crontab -e` (użytkownik), `/etc/cron.d/` (system); harmonogramowanie = fundament systematycznej pracy.

Skrypt uruchamiany ręcznie to dopiero połowa drogi - celem nowoczesnego utrzymania systemów jest zapewnienie, aby krytyczne operacje wykonywały się samoczynnie, według zaplanowanego harmonogramu. Tu wchodzi cron, mechanizm planowania zadań obecny w praktycznie każdym Linuksie. Edycję własnego harmonogramu otwieramy komendą crontab -e, a podgląd bez edycji daje crontab -l. Każdy wpis składa się z pięciu pól czasu - minuta, godzina, dzień miesiąca, miesiąc, dzień tygodnia - oraz polecenia do wykonania. Wpis 0 3 * * * /opt/scripts/backup.sh oznacza: codziennie o 3:00 wykonaj kopię zapasową. Gwiazdki oznaczają każdą wartość, a składnię można wzbogacać o zakresy (1-5), listy (1,3,5), kroki (*/10) oraz skróty typu @reboot czy @daily. Zwróćcie uwagę na końcówkę wpisu: >> /var/log/backup.log 2>&1 - podwójny znak większości dopisuje standardowe wyjście do pliku zamiast nadpisywać, a 2>&1 przekierowuje także strumień błędów do tego samego logu. To ważne, bo cron sam nie powiadamia o błędach - brak logowania oznacza, że cicho zepsute zadanie przejdzie niezauważone. Dlatego wykonanie zadań weryfikujemy: przeglądamy logi, a w większych środowiskach sięgamy po metryki (np. dodane własnoręcznie przez textfile collector, bo node_exporter nie ma wbudowanego kolektora cron) i alerty. Harmonogramowanie to fundament systematycznej pracy.

Wyjaśnienie skrótów użytych na slajdzie:
FQDN – Fully Qualified Domain Name – pełna nazwa domenowa jednoznacznie identyfikująca hosta w globalnym systemie DNS.
UTC – Coordinated Universal Time – uniwersalny czas koordynowany stanowiący zalecany standard konfiguracji demonów systemowych na serwerach.
CLI – Command Line Interface – interfejs wiersza poleceń umożliwiający podgląd i edycję zadań crontab.

45/55 Podstawy Pythona do operacji (cz. 1)
Python w operacjach: moduły os, platform do informacji o systemie; open() do plików; print() do outputu. Dynamic typing = szybkie tworzenie narzędzi.

Gdy Bash to za mało na dane i API, wchodzi Python: „zaawansowany skrypt” z typami, plikami i wyjątkami.

  • Moduły systemowe biblioteki – wbudowane moduły os i platform dostarczają informacji o systemie operacyjnym, procesorze oraz strukturze katalogów.
  • Bezpieczna praca z plikami – menedżer kontekstu with open() gwarantuje poprawne zamknięcie uchwytu pliku nawet w przypadku wystąpienia wyjątku.
  • Formatowanie komunikatów – f-stringi (np. f"Status: {x}") umożliwiają czytelne łączenie tekstu ze zmiennymi i kierowanie błędów do strumienia stderr.
  • Dynamiczne typowanie struktur – wbudowane listy, słowniki i zbiory pozwalają na szybkie przetwarzanie odpowiedzi API bez żmudnych deklaracji typów.
  • Rola kodu integrującego – język Python łączy ze sobą odmienne systemy monitoringu, powiadomień i baz danych, których nie da się spiąć powłoką Bash.
Dynamiczne typowanie: Cecha Pythona polegająca na deklarowaniu zmiennych bez podawania typu, przyspieszająca tworzenie narzędzi operacyjnych.
prosty skrypt Python

Zasady czytelnego formatowania skryptów operacyjnych definiuje oficjalny przewodnik stylu PEP 8.

Python jako „zaawansowany skrypt": moduły `os`, `platform` - informacje o systemie (nazwa, architektura) → decyzje zależne od środowiska; `open()`, `read()`, `write()` - proste, spójne API plików (konfiguracja, logi).

`print()` = output; zmienne i listy bez deklaracji typu → szybkie tworzenie narzędzi; Python czyta się od góry, dynamiczne typowanie daje elastyczność; nawet krótki program: wczytaj plik → przetwórz → zapisz wynik czytelnie.

Zastosowanie w wykładzie 4 (logi: parsowanie, wysyłka do Loki) i 6 (alerting: webhook do Slacka, e-mail przez smtplib); Python = glue code między systemami.

Podstawowa znajomość otwiera drogę do złożonych narzędzi niemożliwych w Bashu; inwestycja czasu zwraca się w kolejnych wykładach; terminy: scripting, standard library, API client, virtualenv, pip.

Bash świetnie łączy polecenia, ale gdy trzeba przetworzyć dane, połączyć się z API albo napisać coś bardziej złożonego, naturalnym wyborem jest Python - można o nim myśleć jak o „zaawansowanym skrypcie". Cechuje go dynamiczne typowanie: deklarujesz zmienne bez podawania typu, a listy, słowniki, liczby i napisy po prostu działają. Od razu przydadzą ci się moduły ze standardowej biblioteki: os daje dostęp do zmiennych środowiskowych i operacji na katalogach, platform poda nazwę systemu i architekturę procesora - dzięki temu skrypt potrafi podejmować decyzje zależne od środowiska. Pliki otwiera się funkcją open() z trybem zapisu, odczytu lub dopisania, a praktyczna konstrukcja with open() gwarantuje samo zamknięcie pliku nawet przy błędzie. Do wypisywania wyników służy print(), a w nowszych wersjach Pythona - tak zwane f-stringi, czyli napisy z wbudowanym formatowaniem, np. f"... {zmienna}". Błędy obsługujemy konstrukcją try/except, która przechwytuje wyjątek zamiast dopuścić do awaryjnego zatrzymania programu. To nie jest teoria: Python przyda się wam już w wykładzie czwartym przy analizie logów i w szóstym przy webhookach alertingowych - to typowy „glue code", czyli kod spajający różne systemy.

Wyjaśnienie skrótów użytych na slajdzie:
OS – Operating System – system operacyjny; moduł os w bibliotece standardowej Pythona zapewnia bezpieczny dostęp do zasobów i zmiennych środowiskowych jądra.
CPU – Central Processing Unit – procesor komputera; parametry architektury sprzętowej są odpytywane przez moduł platform.
RAM – Random Access Memory – pamięć operacyjna; kontrola jej zużycia zapobiega awariom aplikacji wskutek wyczerpania zasobów.
API – Application Programming Interface – zestaw interfejsów bibliotecznych Pythona umożliwiających operacje na plikach i strumieniach systemowych.

46/55 Podstawy Pythona do operacji (cz. 2)
subprocess.run() - uruchamianie poleceń systemowych z poziomu Pythona. try/except - obsługa błędów bez crashu; fundament niezawodnych narzędzi.

Skrypt operacyjny woła inne programy i znosi ich humory: łapie błędy i zamienia surowy tekst w dane.

  • Wykonywanie poleceń powłoki – funkcja subprocess.run() pozwala uruchamiać narzędzia systemowe z poziomu Pythona i przechwytywać ich tekstowy wynik.
  • Strukturyzacja danych wyjściowych – surowy strumień tekstowy przetwarza się na listy i słowniki, co ułatwia filtrowanie procesów czy analizę rozmiaru logów.
  • Elegancka obsługa wyjątków – blok try/except przechwytuje błędy brakujących plików lub błędnych komend, chroniąc program przed nagłym przerwaniem.
  • Testowanie w odizolowanym środowisku – skrypty operacyjne należy weryfikować w piaskownicy laboratoryjnej pod kątem nietypowych sytuacji brzegowych.
  • Profesjonalny kod produkcyjny – połączenie czytelnej logiki z obsługą błędów przekształca doraźny skrypt w niezawodne narzędzie inżynierskie.
subprocess.run(): Funkcja Pythona uruchamiająca polecenia systemowe i (z capture_output=True, text=True) zwracająca ich wynik jako tekst do dalszej analizy.
kod z obsługą błędów

W skryptach automatyzacji wykorzystujących funkcję subprocess.run() należy unikać parametru shell=True, który powoduje przekazanie łańcucha znaków bezpośrednio do powłoki systemowej i otwiera podatność na wstrzykiwanie poleceń (Command Injection). Bezpieczna implementacja wymaga przekazywania argumentów w postaci listy przy domyślnej wartości shell=False:

import subprocess

# Bezpieczne wywołanie polecenia z jawną listą argumentów
wynik = subprocess.run(["systemctl", "is-active", "nginx"], capture_output=True, text=True, check=False)
if wynik.returncode == 0:
    print("Usługa Nginx działa poprawnie")
else:
    print("Awaria usługi Nginx:", wynik.stderr.strip())

Do komunikacji HTTP z interfejsami API zaleca się stosowanie biblioteki Requests.

Przetwarzanie wyników poleceń: `subprocess.run()` / `subprocess.check_output()` → stdout jako string → parsowanie, struktura danych (listy, słowniki) → dalsza analiza; stdout systemu = surowy tekst, Python = dane uporządkowane.

Proste analizy: filtrowanie, agregacja, statystyki na zebranych danych - odpowiedzi na pytania, na które system odpowiada tylko surowym tekstem; decyzje oparte na danych.

Obsługa wyjątków (`try`-`except`): przechwytuje błędy (FileNotFound, PermissionError, CalledProcessError) → kontynuuj lub zakończ elegancko z logiem; nie crash z tracebackiem; wzorzec niezawodności.

Testowanie w środowisku przed wdrożeniem = standard; chroni przed niespodziankami w produkcji; obsługa wyjątków kluczowa przy poleceniach zewnętrznych (mogą nie istnieć albo zwrócić błąd).

Fundament budowania odpornych narzędzi; rozwijane w wykładach 4 i 6 przy integracji z monitoringiem i alertingiem; przetwarzanie danych + obsługa błędów = kod gotowy do produkcji.

Skrypty operacyjne rzadko żyją w izolacji - zazwyczaj mają uruchamiać polecenia systemowe, wziąć z nich dane i coś z nimi zrobić. Do tego służy moduł subprocess, a konkretnie funkcja subprocess.run(): wykonuje zewnętrzne polecenie, a z parametrami capture_output=True i text=True zwraca standardowe wyjście jako zwykły tekst gotowy do analizy. Surowy output systemu zamieniamy wtedy na strukturę danych Pythona - listy i słowniki - i możemy filtrować, agregować czy sortować. To kluczowa umiejętność: system odpowiada ci surowym tekstem, a Python przekształca go w odpowiedź na konkretne pytanie, na przykład: ile procesów jest uruchomionych albo które pliki logów przekroczyły rozmiar. Równie ważne jest spokojne radzenie sobie z błędami. Konstrukcja try/except przechwytuje wyjątki - na przykład FileNotFoundError, gdy plik nie istnieje, albo CalledProcessError, gdy zewnętrzne polecenie kończy się niezerowym kodem - i zamiast crashu z długim tracebackiem, logujemy problem i elegancko kończymy lub kontynuujemy. To właśnie odróżnia narzędzie produkcyjne od zabawki. Zanim wdrożysz skrypt, przetestuj go w sandboxie i na środowisku stagingowym - i to nie tylko ścieżkę szczęśliwą, ale też przypadki brzegowe. Te wzorce wykorzystamy później w wykładach 2, 4 i 6.

Wyjaśnienie skrótów użytych na slajdzie:
CLI – Command Line Interface – tekstowe środowisko systemowe, którego programy są bezpiecznie wywoływane przez funkcję subprocess.run().
JSON – JavaScript Object Notation – ustrukturyzowany format wymiany danych ułatwiający automatyczne parsowanie wyników poleceń systemowych.
STDOUT – Standard Output – standardowy strumień wyjściowy procesu przechwytywany i przetwarzany w skryptach operacyjnych.
STDERR – Standard Error – standardowy strumień diagnostyczny informujący o błędach w wykonaniu podprocesów.

47/55 Praca zdalna z serwerami (SSH)
SSH (Secure Shell) - bezpieczny zdalny dostęp; klucz ed25519 bezpieczniejszy od hasła. authorized_keys - plik z kluczami publicznymi na serwerze.

Serwery nie mają ekranów - łączysz się przez SSH. Klucze zamiast haseł, pojedyncze komendy do automatyzacji.

  • Uwierzytelnianie kluczami kryptograficznymi – wygenerowanie pary kluczy ed25519 i przesłanie klucza publicznego eliminuje podatne na ataki hasła.
  • Zdalne wykonywanie poleceń – komenda ssh user@host 'polecenie' wykonuje instrukcję na zdalnym węźle bez konieczności otwierania interaktywnej sesji.
  • Skalowalna automatyzacja floty – pętle skryptowe oraz narzędzia typu Ansible wykorzystują protokół SSH do równoległego zarządzania setkami serwerów.
  • Zasady higieny bezpieczeństwa – wyłączenie logowania hasłem, blokada dostępu dla konta root oraz audyt połączeń w logach chronią dostęp do serwerów.
  • Architektura hosta pośredniczącego (bastion) – pojedynczy, zabezpieczony punkt wejścia minimalizuje powierzchnię ataku na wewnętrzną sieć serwerową.
SSH (Secure Shell): Protokół bezpiecznego zdalnego dostępu do serwerów; uwierzytelnianie kluczem (np. ed25519) z plikiem authorized_keys jest bezpieczniejsze od hasła.
sesja SSH
CLI · Linux: sesja SSH
user@server:~$ ssh jnowak@192.168.53.97 jnowak@192.168.53.97 password: jnowak@ub:~$ hostname ub jnowak@ub:~$ logout

Protokół SSHv2, zdefiniowany w dokumencie IETF RFC 4251, stanowi podstawowy kanał administracji serwerami. Standardem inżynierskim jest rezygnacja ze starszych kluczy RSA na rzecz algorytmu podpisu cyfrowego na krzywych Edwardsa Ed25519 (IETF RFC 8709), oferującego wysoki poziom bezpieczeństwa przy 256-bitowym kluczu. W konfiguracji demona (sshd_config) należy bezwzględnie zablokować logowanie na konto roota (PermitRootLogin no) oraz logowanie hasłem (PasswordAuthentication no). Do programowej obsługi SSH w Pythonie służy biblioteka Paramiko.

SSH = standard bezpiecznego zdalnego dostępu: `ssh user@host` → sesja jak przy lokalnej konsoli; hasło lub klucz; `logout`/`exit` zamyka; pojedyncze polecenie: `ssh host 'cmd'` - bez sesji interaktywnej, baza automatyzacji.

Uwierzytelnianie kluczem: para kluczy (prywatny u właściciela, publiczny na serwerze w `~/.ssh/authorized_keys`); bezpieczniejsze od haseł (nie do zgadnięcia ani przechwycenia); `ssh-keygen -t ed25519`; najlepsza praktyka.

Automatyzacja multi-host: skrypt z pętlą po serwerach → `ssh` do każdego → zbiór danych; Ansible robi to wbudowanie (wtyczka połączenia ssh); wykonywanie równoległe.

Bezpieczeństwo sesji: minimalne uprawnienia (least privilege), audyt kto/kiedy/skąd (`/var/log/auth.log`), weryfikacja klucza hosta (known_hosts), bastion/jump host dla produkcji; dyscyplina pracy zdalnej.

Terminy: SSH key, remote access, public/private key, authorized_keys, ssh-agent, bastion host, least privilege.

Serwery produkcyjne prawie nigdy nie mają ekranu - pracujemy z nimi zdalnie, przez protokół SSH (Secure Shell), czyli bezpieczną powłokę. Komenda ssh user@host otwiera sesję, która działa jak lokalna konsola: wpisujesz polecenia, oglądasz wynik, kończysz przez logout albo exit. Poza sesjami interaktywnymi SSH pozwala wykonać pojedyncze polecenie na odległość - ssh user@host 'polecenie' - a to jest fundament automatyzacji: pętla po wielu serwerach wysyła to samo polecenie każdemu z nich. Uwierzytelnianie najlepiej oprzeć na parach kluczy zamiast haseł - hasła można zgadnąć lub przechwycić, a klucz jest praktycznie niezgadnialny. Parę generujesz komendą ssh-keygen -t ed25519 (algorytm ed25519 uznajemy za bezpieczniejszy), a klucz publiczny wgrywasz na serwer przez ssh-copy-id; trafia on do pliku ~/.ssh/authorized_keys i odtąd logowanie jest bezhasłowe. Z bezpieczeństwem wiążą się też dwa wymagania: wyłączenie logowania hasłem na serwerach produkcyjnych oraz audyt - plik /var/log/auth.log notuje, kto, kiedy i skąd się logował. W dużych sieciach dostęp do wewnętrznych maszyn prowadzi się przez tak zwany bastion host, czyli dedykowany punkt wejścia. We wszystkich tych operacjach pamiętaj o zasadzie najmniejszego uprzywilejowania.

Wyjaśnienie skrótów użytych na slajdzie:
SSH – Secure Shell – kryptograficzny protokół sieciowy gwarantujący poufność, integralność i uwierzytelnianie podczas zdalnej administracji.
RSA – Rivest-Shamir-Adleman – asymetryczny algorytm kryptograficzny oparty na trudności faktoryzacji liczb pierwszych, obecnie zastępowany przez nowocześniejsze rozwiązania.
EdDSA – Edwards-curve Digital Signature Algorithm – zaawansowany schemat podpisu cyfrowego na krzywych Edwardsa; implementacja Ed25519 zapewnia najwyższy poziom bezpieczeństwa.
RFC – Request for Comments – dokumentacja techniczna IETF standaryzująca protokoły internetowe, w tym specyfikację architektury SSH (RFC 4251).

48/55 Kopie zapasowe i odzyskiwanie
Zasada 3-2-1: 3 kopie danych, 2 różne nośniki, 1 poza siedzibą. Kopia bez testu przywracania (restore) to iluzja bezpieczeństwa.

Kopia zapasowa chroni przed awarią dysku, atakiem ransomware i błędem ludzkim – pod warunkiem jednak, że procedura odzyskiwania została zweryfikowana w praktyce.

  • Strategia ochrony danych 3-2-1 – zasada nakazuje posiadanie trzech kopii danych na dwóch różnych nośnikach fizycznych, z czego jedna poza główną serwerownią.
  • Testowe przywracanie kopii – samo wykonanie kopii nie daje gwarancji bezpieczeństwa; jedynym dowodem poprawności jest regularne, próbne odtworzenie danych.
  • Polityka automatyzacji i retencji – proces tworzenia kopii musi być zautomatyzowany harmonogramem, zaszyfrowany (AES-256) i objęty okresem przechowywania.
  • Ciągłość biznesowa a odzyskiwanie – procedury Disaster Recovery stanowią techniczne ramię planu ciągłości działania, precyzując kroki odtworzenia po katastrofie.
  • Praktyczna reguła inżynierska – kopia zapasowa, która nie została pomyślnie odzyskana w środowisku testowym, nie istnieje z punktu widzenia bezpieczeństwa.
Zasada 3-2-1: Trzy kopie danych na dwóch różnych nośnikach, w tym jedna poza siedzibą; kopia bez testu przywracania to iluzja bezpieczeństwa.
schemat kopii 3-2-1

System zarządzania ciągłością działania (BCMS) definiuje międzynarodowa norma PN-EN ISO 22301. Wymaga ona przeprowadzenia formalnej analizy wpływu na biznes (BIA) i wyznaczenia trzech powiązanych parametrów:
- MTPD (Maximum Tolerable Period of Disruption) – maksymalny dopuszczalny czas trwania zakłócenia, po przekroczeniu którego następuje nieodwracalna szkoda dla organizacji,
- RTO (Recovery Time Objective) – planowany techniczny czas przywrócenia dostępności usługi, który musi być ściśle krótszy niż wskaźnik MTPD (RTO < MTPD),
- RPO (Recovery Point Objective) – maksymalny dopuszczalny okres utraty danych mierzony wstecz od momentu awarii, wyznaczający wymaganą częstotliwość replikacji i tworzenia kopii zapasowych.
W celu ochrony przed atakami ransomware kopie zapasowe muszą być przechowywane w technologii niezmiennej (WORM / Immutable Storage).

Backup = zabezpieczenie przed utratą danych (awaria dysku, ransomware, błąd ludzki); zasada 3-2-1: 3 kopie, 2 nośniki (np. lokalny + chmura), 1 off-site (inna lokalizacja/region) - realna ochrona przed pożarem, kradzieżą, awarią budynku.

Test restore = równie ważny: kopia nieprzetestowana = iluzja bezpieczeństwa; regularne próby odzyskiwania (disaster recovery drills) - RTO/RPO w praktyce; „backup is not restore until tested".

Automatyzacja: harmonogram (cron/systemd timer), polityka retencji, szyfrowanie (AES-256), kontrola dostępu; planowanie: kiedy, gdzie, ile trwa odzyskanie; dane wrażliwe = kopie szyfrowane.

Związek z BC (Business Continuity): szczegóły w wykładzie 5 (HA/DR) i 8 (post-mortem/incident response); dobre zespoły regularnie robią próby odzyskiwania; odporność operacyjna.

Backupy chronią cię przed trzema rodzajami zagrożeń: awarią dysku, atakami ransomware i zwykłym ludzkim błędem. Złotym standardem jest tak zwana zasada 3-2-1: trzymaj trzy kopie danych (oryginał plus dwa zapisy), na dwóch różnych nośnikach (na przykład dysk lokalny i chmura) oraz jedną - poza siedzibą, w innej lokalizacji lub regionie, żeby przetrwała pożar biura albo awarię całego budynku. Samo wykonanie kopii to jednak dopiero połowa sukcesu. Kopia, której nie przetestowałeś, to iluzja bezpieczeństwa - dopóki nie przywrócisz z niej danych i nie zweryfikujesz, że działają, nie wiesz, czy zapis w ogóle zadziałał. Dlatego regularnie wykonuje się tak zwane próby odzyskiwania (disaster recovery drills): na środowisku testowym uruchamia się proces odzyskiwania danych z rzeczywistej kopii i mierzy jego czas. Backupy trzeba też automatyzować - harmonogram w cronie lub systemd timer, jasna polityka retencji (ile wersji trzymamy i jak długo), szyfrowanie wrażliwych danych, na przykład AES-256, oraz monitoring, który poinformuje, gdy kopia się nie powiedzie. Operacyjnie zagadnienie wiąże się z dwoma szerszymi pojęciami: Business Continuity, czyli ciągłością działania usług, i Disaster Recovery - techniczną stroną przywracania. Szczegóły, w tym cele RTO i RPO, omówimy w wykładzie 5, a na post-mortemy wróci temat w wykładzie 8.

Wyjaśnienie skrótów użytych na slajdzie:
RPO – Recovery Point Objective – cel punktu odzyskiwania; dopuszczalny okres utraty danych mierzony wstecz od momentu awarii, determinujący częstotliwość backupu.
RTO – Recovery Time Objective – cel czasu odzyskiwania; maksymalny dopuszczalny czas trwania procedury przywracania środowiska do pełnej sprawności.
DRP – Disaster Recovery Plan – techniczny plan awaryjny określający procedury odzyskiwania infrastruktury teleinformatycznej po katastrofie.
WORM – Write Once, Read Many – technologia pamięci masowej uniemożliwiająca modyfikację lub usunięcie zapisanych danych, kluczowa w ochronie przed ransomware.

49/55 Business Continuity (wprowadzenie)
RTO (Recovery Time Objective) - czas przywrócenia systemu. RPO (Recovery Point Objective) - dopuszczalna utrata danych. Im krótsze → droższa infrastruktura.

Co w sytuacji, gdy awarii ulegnie nie pojedynczy serwer, lecz całe centrum danych? Odpowiedź stanowi plan ciągłości działania (BCP) ze zdefiniowanymi celami RTO i RPO.

  • Plan ciągłości działania (BCP) – kompleksowa strategia organizacyjna definiująca priorytety usług, role i procedury na wypadek poważnej katastrofy infrastrukturalnej.
  • Techniczny plan odtworzenia (DRP) – zbiór instrukcji inżynierskich opisujących procedury przełączenia ruchu na ośrodki zapasowe (hot, warm lub cold standby).
  • Wskaźniki RTO i RPO – cel czasu odtworzenia (RTO) określa dopuszczalną długość przestoju, a cel punktu odtworzenia (RPO) maksymalną utratę danych w czasie.
  • Ekonomiczny bilans niezawodności – dążenie do zerowych wartości RTO i RPO wymaga kosztownej redundancji wielochmurowej, co wymaga akceptacji biznesu.
  • Rola inżyniera SRE w biznesie – inżynier przekłada wymagania zarządcze na architekturę systemową, replikację baz danych oraz automatyczne procedury failover.
RTO i RPO: Recovery Time Objective (czas przywrócenia systemu) oraz Recovery Point Objective (dopuszczalna utrata danych); im krótsze, tym droższa infrastruktura.
cykl zarządzania ciągłością

W przypadku incydentów o zasięgu krajowym lub naruszeń w sektorze infrastruktury krytycznej zgłoszenia kierowane są do właściwego zespołu CSIRT poziomu krajowego, w tym do CSIRT GOV.

Business Continuity (BC) = zdolność do utrzymania kluczowych usług w warunkach zakłóceń (awarie infrastruktury, katastrofy, ataki); BCP (Business Continuity Plan) = formalny plan: kto, co, w jakiej kolejności; zarządzanie kryzysowe.

Disaster Recovery (DR) = techniczna część BCP: konkretne procedury przywracania systemów i danych; RTO (Recovery Time Objective) = jak szybko system ma wrócić; RPO (Recovery Point Objective) = ile danych może zostać utraconych (od którego momentu kopia).

RTO/RPO wyznacza biznes (koszt przestoju versus koszt infrastruktury): im krótsze RTO/RPO → droższa i bardziej złożona infrastruktura (HA, multi-AZ, replikacja); kompromis ekonomiczny.

Dla SRE = praktyczny język rozmowy o akceptowalnych stratach i czasie przestoju; świadome projektowanie backupów i środowisk standby; szczegóły w wykładach 5 (HA/DR) i 8 (incident response).

Business Continuity, czyli ciągłość działania, odpowiada na odwieczne pytanie: jak zareagujemy w sytuacji rozległej awarii – nie pojedynczej maszyny, lecz całego centrum danych albo fragment sieci? Formalnym dokumentem jest tak zwany BCP (Business Continuity Plan): plan zawiera listę kluczowych usług, priorytety ich odtwarzania, role i scenariusze awarii. Techniczną częścią tego planu jest Disaster Recovery - konkretne procedury przywracania systemów i danych, środowiska standby, testy. By plan był mierzalny, biznes definiuje dwa cele. RTO, czyli Recovery Time Objective, to czas, w jakim system ma wrócić do działania po awarii - jak szybko. RPO, czyli Recovery Point Objective, określa, ile danych może zostać utraconych - od jakiego momentu wstecz kopia jest akceptowalna. Przykładowo RPO równe cztery godziny oznacza, że całodzienne dane sprzed czterech godzin mogą przepaść, ale nic więcej. Kluczowa jest świadomość kompromisu: im krótsze RTO i RPO, tym droższa infrastruktura - więcej replikacji, szybsze zapasy, dodatkowe regiony. To rachunek ekonomiczny: biznes godzi koszt przestoju z kosztem jej zapobiegania. SRE jest tłumaczem między tymi światami - zamienia cele biznesowe na konkretną technikę: backupy, replikację, środowiska standby i testy, a kierownictwo informuje poprawnie o kosztach. Szczegóły powrócą w wykładzie 5 o wysokiej dostępności i w wykładzie 8 o incydentach.

Wyjaśnienie skrótów użytych na slajdzie:
BCP – Business Continuity Plan – całościowy plan ciągłości działania organizacji na wypadek zakłóceń kryzysowych.
BIA – Business Impact Analysis – formalna analiza wpływu biznesowego określająca krytyczność poszczególnych procesów i systemów w przedsiębiorstwie.
MTPD – Maximum Tolerable Period of Disruption – maksymalny dopuszczalny czas trwania zakłócenia, którego przekroczenie zagraża istnieniu organizacji.
RTO – Recovery Time Objective – planowany czas przywrócenia sprawności technicznej, który musi być ściśle krótszy niż wskaźnik MTPD.
RPO – Recovery Point Objective – maksymalna dopuszczalna utrata danych wyznaczająca architekturę systemów replikacji i kopii zapasowych.

50/55 Podsumowanie wykładu 1 (cz. 1)
Powtórzenie: SRE = automatyzacja + pomiar (SLI/SLO) + niezawodność; DevOps = kultura, SRE = implementacja z metrykami; ITIL = procesy formalne.

Lot ptaka po wykładzie: trzy słowa SRE, zmiana ról, toil oraz słownik, który odróżnia cię od laika.

  • Ewolucja ról operacyjnych – przejście od manualnego administrowania do SRE polega na programowaniu infrastruktury i traktowaniu niezawodności jako cechy oprogramowania.
  • Fundamenty dyscypliny SRE – podejście stworzone w Google opiera się na automatyzacji eliminującej toil, rygorystycznym pomiarze wskaźników oraz redundancji.
  • Współpraca metodyk branżowych – kultura DevOps, inżynierskie wskaźniki SRE oraz ład procesowy ITIL uzupełniają się wzajemnie w nowoczesnej organizacji.
  • Ograniczenie pracy powtarzalnej – utrzymywanie toilu poniżej połowy czasu pracy chroni zespół przed stagnacją i umożliwia ciągły rozwój platformy.
  • Aparatura pojęciowa inżyniera – student przyswaja kluczowe pojęcia: wskaźniki SLI/SLO, budżet błędów, obserwowalność, IaC oraz kulturę bez obwiniania.
Trzy słowa SRE: Automatyzacja, pomiar i niezawodność - filary odróżniające inżynierię niezawodności od klasycznej administracji.
mapa pojęć wykładu 1

Ewolucja: administrator (ręczne czynności) → SRE (automatyzacja, kod, metryki, współpraca z dev); definicja i geneza SRE (Google, 2000s, książka 2016); filary: automatyzacja, pomiar, niezawodność.

SRE vs DevOps vs ITIL: DevOps = kultura, SRE = implementacja z metrykami (SLO, error budget), ITIL = procesy (change/incident/problem management); współistnienie możliwe i pożądane; proces versus praktyka.

Automatyzacja i toil: toil = żmudna praca ręczna, eliminowana przez skrypty i narzędzia; cel poniżej 50% czasu; zasada 50/50 (Google); monitoring jako fundament (3 filary obserwowalności).

Terminy powtórzone: SLI/SLO/SLA, error budget, toil, observability, blameless culture, IaC, CI/CD, runbook; solidne fundamenty = wspólny język dla kolejnych wykładów.

Zanim pójdziemy dalej, spójrzmy na cały wykład z lotu ptaka - to dobra okazja, żeby utrwalić pojęcia, które będą wracać na każdych zajęciach. Zapamiętajcie trzy słowa opisujące SRE: automatyzacja, pomiar i niezawodność. SRE narodziło się w Google w latach dwutysięcznych jako odpowiedź na problem, że czysto operacyjne administrowanie nie skaluje się do setek milionów użytkowników. Zobaczcie, jak rozmieszczone są role: DevOps to kultura współpracy, SRE to jej konkretna implementacja z metrykami - SLI, SLO, budżet błędów - a ITIL dostarcza sformalizowanych procesów, takich jak zarządzanie zmianami i incydentami. Po drodze pojawił się toil, czyli żmudna ręczna praca, którą automatyczujemy - Google jako cel wskazuje nawet mniej niż 50 procent czasu na pracę operacyjną. Fundamentem wszystkiego jest monitoring i obserwowalność: bez pomiaru nie ma zarządzania. Zapamiętajcie też słowniczek, który już dziś odróżnia was od laika: SLI, SLO, SLA, error budget, observability, IaC, CI/CD, runbook, blameless culture, MTTR. Te pojęcia będą wracać niemal na każdym slajdzie do końca kursu.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; połączenie wiedzy programistycznej i operacyjnej dla osiągnięcia wysokiej dostępności usług.
DevOps – Metodyka współpracy i kultura współodpowiedzialności pomiędzy zespołami wytwórczymi a operacyjnymi.
ITIL – Ramy procesowe zarządzania usługami informatycznymi (ITSM) kładące nacisk na ład organizacyjny i strukturę procedur.
SLI – Service Level Indicator – empiryczna metryka liczbowa mierząca bieżącą jakość usługi.
SLO – Service Level Objective – wewnętrzny próg jakościowy wyznaczający granicę akceptowalnej stabilności systemu.
SLA – Service Level Agreement – zewnętrzny kontrakt biznesowy z klientem obwarowany sankcjami finansowymi.
Toil – Rutynowe czynności manualne pozbawione wartości inżynierskiej, redukowane w SRE za pomocą automatyzacji poniżej 50% czasu pracy.

51/55 Podsumowanie wykładu 1 (cz. 2)
Kluczowe pojęcia: error budget (1-SLO), IaC (Infrastruktura jako Kod), CI/CD (ciągłe wdrażanie), runbook (instrukcja kryzysowa), blameless culture (kultura bez obwiniania).

Pięć pojęć definiujących inżyniera niezawodności - od budżetu błędów po etykę. Reszta to już literatura.

  • Matematyka budżetu błędów – margines błędu stanowi mierzalny kontrakt techniczny, decydujący o tempie publikowania innowacji i zamrażaniu wydań.
  • Nowoczesny stos technologiczny – narzędzia Terraform i Ansible wraz z kontenerami Docker i Kubernetes tworzą środowisko w pełni powtarzalne i odporne na awarie.
  • Stabilność potoków dostarczania – automatyczne testy w procesach CI/CD oraz procedury runbook zapewniają przewidywalność działania systemów produkcyjnych.
  • Etyka i bezpieczeństwo operacyjne – kultura organizacyjna zakłada poszanowanie prywatności danych, ochronę tajemnic oraz traktowanie błędów jako lekcji projektowych.
  • Źródła wiedzy inżynierskiej – student korzysta z oficjalnych publikacji Google SRE oraz kanonu GitOps opartego na narzędziu ArgoCD do ciągłej synchronizacji konfiguracji.
Release freeze: Wstrzymanie wdrożeń nowych funkcji po wyczerpaniu budżetu błędów; zespół skupia się wtedy wyłącznie na stabilizacji systemu.
słownik pojęć

Error budget = dozwolony margines niedostępności (1-SLO) → podstawa decyzji o wydaniach; IaC + kontenery = uproszczone odtwarzanie środowisk (Terraform, Ansible, Docker); CI/CD = automatyzacja dostarczania (pipeline, artifact, rollback).

Dokumentacja operacyjna + bezpieczeństwo + etyka: runbooki, baza wiedzy, least privilege, secrets management, blameless culture, psychological safety; komunikacja w zespole (Slack, ticketing, war room).

Literatura do samodzielnej pracy: „Site Reliability Engineering" (O'Reilly Media, 2016), „SRE Workbook" (2018), sre.google, prometheus.io/docs; zadania domowe weryfikują znajomość mechanizmów.

Weryfikuj notatki: uzupełniaj braki, solidne fundamenty = łatwiejsze przyswajanie zaawansowanych tematów; kolejne wykłady budują na tej bazie; inwestycja w podstawy = zwrot w czasie.

Druga część podsumowania to zestaw pięciu pojęć, które naprawdę definiują pracę inżyniera niezawodności. Error budget, czyli budżet błędów, to dozwolony margines niedostępności równy 1 minus SLO: przy SLA na poziomie 99,9 procent zostaje nam 0,1 procent, czyli nieco ponad 43 minuty przestoju miesięcznie. Dopóki budżet się nie wyczerpie - wdrażamy; gdy osiągnie zero - wprowadzamy tak zwany freeze i bardzo ostrożnie planujemy kolejne zmiany. Infrastruktura jako kod (IaC) z Terraformem i Ansiblem oraz kontenery z Dockerem i Kubernetesem sprawiają, że środowiska można odtwarzać powtarzalnie z repozytorium zamiast z pamięci. CI/CD automatyzuje dostarczanie przez pipeline: build, test, deploy i weryfikację. Runbooki i ADR-y stanowią pamięć zespołu - instrukcje na wypadek kryzysu i zapis ważnych decyzji architektonicznych. Wreszcie bezpieczeństwo i etyka: najmniejsze uprzywilejowanie, zarządzanie sekretami i kultura bez obwiniania, która sprawia, że awarie stają się lekcjami, a nie tematami tabu. Jeśli macie ochotę pogłębić temat, podstawy literatury to „Site Reliability Engineering" z 2016 roku (napisane przez inżynierów Google, wydane przez O'Reilly Media), „The SRE Workbook" z 2018, portal sre.google i dokumentacja prometheus.io - wszystko dostępne bezpłatnie w sieci.

Wyjaśnienie skrótów użytych na slajdzie:
IaC – Infrastructure as Code – deklaratywne zarządzanie infrastrukturą serwerową i sieciową za pomocą kodu w systemie kontroli wersji.
CI/CD – Automatyczne potoki ciągłej integracji i ciągłego dostarczania oprogramowania eliminujące ryzyko błędów ludzkich.
K8s – Kubernetes – standard orkiestracji środowisk kontenerowych zapewniający automatyczne skalowanie i samonaprawę aplikacji.
ADR – Architecture Decision Record – sformalizowana dokumentacja decyzji architektonicznych przechowywana w repozytorium kodu.
RBAC – Role-Based Access Control – model autoryzacji oparty na rolach, stanowiący fundament zasady najmniejszych uprawnień.

52/55 Najczęstsze błędy początkujących
Antywzorce: deploy bez monitoringu, brak dokumentacji (bus factor = 1), brak testów restore, automatyzacja bez testów. Dokumentuj, testuj, monitoruj od dnia 1.

Jak nie wolno: cztery antywzorce początkujących. Nazwane wprost, żebyś rozpoznał je u siebie.

  • Wdrażanie kodu bez obserwacji – publikowanie zmian bez natychmiastowej analizy wykresów telemetrii uniemożliwia szybkie wychwycenie degradacji usługi.
  • Brak dokumentacji i izolacja wiedzy – uzależnienie stabilności firmy od pamięci pojedynczego inżyniera stwarza krytyczne ryzyko w przypadku jego nieobecności.
  • Zaniechanie prób odtwarzania kopii – tworzenie backupów bez regularnych testów ich przywracania w środowisku testowym daje fałszywe poczucie bezpieczeństwa.
  • Automatyzacja pomijająca testy – wdrażanie skryptów bezpośrednio na produkcji bez fazy piaskownicy i środowiska staging potęguje skalę potencjalnej awarii.
  • Budowanie właściwych nawyków – dokumentowanie procedur w kodzie, testowanie zmian przed publikacją i ciągły monitoring stanowią fundament profesjonalizmu.
Deploy and pray: Antywzorzec wdrażania zmian na produkcję bez obserwowania metryk i logów; o problemie zespół dowiaduje się dopiero po szkodach.
lista antywzorców

Pułapka „Deploy and Pray” i kluczowe błędy początkujących: Praktyka określana żargonowo jako deploy and pray (wdrożyć i modlić się) to częsty grzech niedoświadczonych administratorów: po wgraniu nowego kodu na serwer nie obserwują oni wykresów telemetrii, zakładając, że brak skarg od razu oznacza sukces. Profesjonalny inżynier SRE po każdym wdrożeniu przez co najmniej kilkanaście minut bacznie analizuje wykresy latencji i logi błędów, gotowy do natychmiastowego wycofania zmiany (rollback) przy najmniejszej anomalii.

Błąd 1: wdrożenie bez monitorowania skutków - nigdy się nie dowiesz, czy konfiguracja działa; „deploy and pray" = antywzorzec; zawsze obserwuj metryki po wdrożeniu.

Błąd 2: pomijanie dokumentacji → „wiedza tajemna" pojedynczych osób; bus factor = 1; docs-as-code + review w PR = wspólna wiedza.

Błąd 3: brak testów restore (backup nieprzetestowany = bezużyteczny); próby odzyskiwania (disaster recovery drills) = obowiązek; weryfikacja RTO/RPO.

Błąd 4: automatyzacja bez testów → przenosi błędy ręczne do szybkich procesów automatycznych; test w sandboxie → staging → canary → produkcja.

Wspólne źródło: pośpiech i przekonanie „na oko"; rady na start: dokumentuj, testuj, monitoruj od pierwszego dnia; dobre nawyki na etapie nauki = łatwiejsza przyszłość; świadomość antywzorców to pierwszy krok.

Wiemy już, jak robić dobrze; przyjrzyjmy się, jak nie wolno - bo antywzorce (anti-patterns) pojawiają się u początkujących tak często, że warto je nazwać wprost. Pierwszy: wdrożenie oparte na wierze, tak zwany deploy and pray - wypychacie zmianę na produkcję, nie patrzycie na metryki, a potem dowiadujecie się o problemie po szkodach. Zawsze po wdrożeniu sprawdzajcie metryki i logi. Drugi błąd: wiedza silosowa – cała wiedza operacyjna skupia się w pamięci jednej osoby, podczas gdy dokumentacja nie istnieje, a zespół ma tak zwany bus factor równy jeden: jeśli ta osoba zniknie, projekt utknie. Podejście docs-as-code z recenzją we wniosku pull request eliminuje ten problem. Trzeci: brak testów przywracania - kopia, której nigdy nie próbowano odtworzyć, jest bezużyteczna, więc próby odzyskiwania (DR drills) to obowiązek, a nie opcja. Czwarty: automatyzacja bez testów - przenosicie błędy ręczne do procesów, które od tej pory powtarzają je szybko i bezlitośnie; stąd zasada: testuj w sandboxie, potem na stagingu, na końcu canary i produkcja. Wspólne źródło tych błędów to pośpiech i przekonanie, że „na oko będzie dobrze”. Dlatego prosta rada na start brzmi: dokumentuj od pierwszego dnia, testuj przed wdrożeniem, monitoruj skutki zmian. Dobre nawyki wpojone na etapie nauki zwrócą się z nawiązką w pracy zawodowej.

Wyjaśnienie skrótów użytych na slajdzie:
MTBF – Mean Time Between Failures – średni czas między awariami; wskaźnik niezawodności mierzący średni czas bezawaryjnej pracy systemu.
MTTR – Mean Time to Recovery – średni czas naprawy; brak testów procedur odzyskiwania drastycznie wydłuża ten parametr podczas rzeczywistej awarii.
DR – Disaster Recovery – plan i procedury odtwarzania środowiska produkcyjnego po katastrofie; brak ćwiczeń (DR Drills) to kardynalny antywzorzec.
IaC – Infrastructure as Code – wdrażanie automatyzacji bez testów i właściwości idempotentności prowadzi do powielania błędów w skali całej infrastruktury.

53/55 Praca własna: zadania do wykonania
Zadania domowe: dodaj wpis do cron, sprawdź stan systemu (uptime/free/df), utwórz dokument z poleceniami, zapoznaj się z sre.google.

Teoria wyparowuje w tydzień - przetrenuj wykład rękami. Cztery zadania, od najprostszego.

  • Praktyka harmonogramowania zadań – skonfigurowanie własnego zadania w cronie wraz z przekierowaniem strumieni i weryfikacją w logach systemowych.
  • Samodzielna diagnostyka konsolowa – regularne ćwiczenie poleceń uptime, free -h, df -h oraz journalctl -f w celu interpretacji zachowania serwera.
  • Tworzenie osobistego repozytorium wiedzy – prowadzenie notatek technicznych z działającymi poleceniami i konfiguracjami jako zalążek własnych instrukcji runbook.
  • Studiowanie kanonu Google SRE – samodzielna lektura oficjalnych rozdziałów monografii Google SRE pogłębiająca zrozumienie kultury niezawodności.
  • Przygotowanie do kolejnego modułu – utrwalenie podstaw warsztatowych stanowi niezbędny fundament do opanowania metryk i języka zapytań PromQL.
Zadania utrwalające: Własny wpis w cron, sprawdzenie stanu systemu (uptime, free, df) i lektura sre.google - praktyka, bez której teoria wyparowuje w tydzień.
lista zadań

Zadanie 1: dodaj własne zadanie do cron (np. skrypt backupu) + weryfikacja wykonywania (logi, metryki); praktyka systematycznej pracy.

Zadanie 2: podstawowe narzędzia monitoringu - odczytaj bieżący stan systemu (CPU, RAM, dysk, usługi); przygotowanie do wykładu 2 (Prometheus, SLI/SLO).

Zadanie 3: utwórz własny dokument z poleceniami (runbook/notatki) - rośnie przez cały kurs; osobista baza wiedzy.

Zadanie 4: zapoznaj się z sre.google - oficjalna strona Google SRE (case studies, best practices, workbook); materiały od twórców.

Cel: po wykonaniu student płynnie zaczyna wykład 2; nauka samodzielności, weryfikacji i bezpiecznego środowiska (sandbox); podejście inżynierskie.

Żeby wykład przyniósł realny efekt, musicie go przetrenować własnymi rękami - teoria bez praktyki wyparowuje w tydzień. Rozpocznijcie od najpraktyczniejszego zadania: dodajcie do cron własne zadanie, na przykład skrypt tworzący kopię zapasową, a następnie zweryfikujcie w logach i metrykach, że regularnie się wykonuje. Drugie zadanie to oswojenie się z podstawowymi narzędziami monitoringu na własnym komputerze: uptime pokaże czas pracy systemu i obciążenie, free -h dostępną pamięć, df -h zajętość dysków, journalctl -f strumień logów systemowych na żywo, a ps aux - uruchomione procesy. Odczytaj te wartości i naucz się je interpretować, bo to naturalny wstęp do metryk w kolejnym wykładzie. Trzecie zadanie: zacznijcie własną bazę wiedzy - wiki, Notion albo zwykły plik Markdown - i wpisujcie do niego każde nowe polecenie z prawdziwym outputem. Ten dokument urośnie w trakcie całego kursu w wasz osobisty runbook. Czwarte: odwiedźcie sre.google - oficjalną stronę SRE od Google z darmowymi książkami oraz case studies najlepszych praktyk. Zadania przygotowują grunt pod wykład drugi i - co ważniejsze - ćwiczą samodzielność i weryfikację, które towarzyszą inżynierowi przez całą karierę.

Wyjaśnienie skrótów użytych na slajdzie:
CLI – Command Line Interface – tekstowe środowisko konsoli stanowiące podstawowe narzędzie pracy studenta podczas realizacji ćwiczeń laboratoryjnych.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów, której praktyczne nawyki kształtowane są przez bezpośrednią pracę na serwerze.
OS – Operating System – system operacyjny; diagnozowanie obciążenia zasobów i procesów w środowisku Linux.
CPU – Central Processing Unit – jednostka obliczeniowa procesora, której stan obciążenia weryfikuje się poleceniem uptime.
RAM – Random Access Memory – pamięć operacyjna serwera badana pod kątem dostępnych zasobów za pomocą polecenia free -h.

54/55 Materiały i literatura do wykładu 1
Źródła: prometheus.io/docs (monitoring), sre.google (SRE Book + Workbook, darmowe), docs.ansible.com, man bash (die.net), python.org/tutorial.

Sprawdzone źródła zamiast losowych blogów: dokumentacje twórców technologii. Małe porcje biją maraton.

  • Dokumentacja podsystemów jądra – jądro Linux: oficjalna dokumentacja mechanizmów zarządzania pamięcią operacyjną, procesami i wirtualnymi systemami plików.
  • Współpraca i wersjonowanie w chmurze – GitHub Docs: przewodniki po procedurach Pull Request, przeglądach kodu oraz potokach ciągłej integracji GitHub Actions.
  • Podręczniki automatyzacji i skryptów – oficjalne źródła dokumentacji narzędzia Ansible oraz języka Python wprowadzające w tworzenie niezawodnych skryptów.
  • Zasada weryfikacji źródeł – inżynier opiera swoją wiedzę wyłącznie na oficjalnych specyfikacjach i zweryfikowanej dokumentacji technicznej producentów.
  • Metodyka przyswajania wiedzy – systematyczna praca z podręcznikami i realizacja małych ćwiczeń laboratoryjnych zapewnia trwałe opanowanie rzemiosła SRE.
Kanon SRE: Darmowe książki SRE Book i Workbook (sre.google) oraz dokumentacja Prometheusa (prometheus.io/docs) jako podstawowe źródła wiedzy o niezawodności i monitoringu.
okładki materiałów

Dokumentacja Prometheus (prometheus.io/docs) - wprowadzenie do pojęć monitoringu (metryki, SLI, alerting), choć samo narzędzie omawiamy w wykładzie 2; opisy, przykłady, odnośniki; fundament teoretyczny.

Bash/Python: podręcznik man bash (linux.die.net/man/1/bash) i samouczek python.org/tutorial - samodzielne ćwiczenie konstrukcji z wykładu; nauka przez praktykę.

Ansible: docs.ansible.com + forum - narzędzie config management (wykład 7); warto znać adresy już teraz; wsparcie społeczności.

Wszystkie linki sprawdzone pod kątem osiągalności - nie kierujemy na nieistniejące zasoby; złamany link = utracone zaufanie.

Systematyczne przeglądanie > wkuwanie przed zajęciami; małe porcje = lepsze zapamiętywanie; focus na rozdziałach wprowadzających przy wątpliwościach; inwestycja zwraca się w kolejnych wykładach.

Na koniec trochę literatury - sprawdzone źródła, do których warto sięgać systematycznie, a nie tuż przed zajęciami. Monitoring to domena dokumentacji Prometheusa dostępnej pod prometheus.io/docs: wytłumaczone są tam pojęcia metryk, SLI, alertowania i exporterów, więc to naturalny fundament przed wykładem drugim. Język Bash ćwiczymy z podręcznikiem man bash (linux.die.net/man/1/bash), a Pythona w oficjalnym samouczku python.org/tutorial - samodzielnie uruchamiajcie i testujcie konstrukcje z dzisiejszego wykładu. Konfiguracją maszyn na szeroką skalę zajmie się w wykładzie siódmym Ansible; jego dokumentacja czeka na docs.ansible.com, a wsparcie społeczności znajdziecie na forach i w serwisie Stack Overflow. Jedno ważne spostrzeżenie: wszystkie podane linki zostały sprawdzone pod kątem osiągalności, bo kierowanie studenta na nieistniejący zasób to stracona wiarygodność - dokładnie to samo, co złamany link w produkcji. Jeśli chodzi o sam tryb nauki: systematyczne przeglądanie w małych porcjach wygrywa z masowym powtarzaniem materiału w przeddzień egzaminu, bo małe dawki pozostają w pamięci (retention) znacznie dłużej. Skupcie się na rozdziałach wprowadzających, a przy wątpliwościach wracajcie do tych slajdów.

Wyjaśnienie skrótów użytych na slajdzie:
CNCF – Cloud Native Computing Foundation – fundacja open-source rozwijająca kluczowe technologie chmurowe ekosystemu SRE.
O'Reilly – Wiodące wydawnictwo techniczne, nakładem którego ukazały się kanoniczne podręczniki inżynierii niezawodności systemów.
RFC – Request for Comments – publicznie dostępne dokumenty techniczne IETF definiujące oficjalne standardy protokołów internetowych.
GNU – Projekt wolnego oprogramowania powołany przez Richarda Stallmana, twórca kluczowych narzędzi systemowych powłoki Linux.

55/55 Zapowiedź wykładu 2
Wykład 2: SLI/SLO/SLA w praktyce, instalacja Prometheus, zbieranie metryk (node_exporter), powtórka observability (3 filary: metryki, logi, tracing).

Następnym razem konkrety: SLI/SLO w konfiguracji, własny Prometheus i metryki systemowe. Przygotuj środowisko.

  • Praktyka wskaźników jakościowych – w kolejnym wykładzie student nauczy się wyliczać wskaźniki SLI i zarządzać budżetem błędów na realnych danych liczbowych.
  • Architektura systemu Prometheus – omówienie struktury pliku konfiguracyjnego prometheus.yml, definicji celów zbierania oraz mechanizmu pobierania metryk.
  • Instrumentacja systemu za pomocą Node Exporter – uruchomienie eksportera metryk sprzętowych jako fundamentu pod tworzenie pierwszych dashboardów.
  • Praktyczne wdrożenie metodyk RED i USE – dekompozycja obserwowalności na wskaźniki nasycenia zasobów oraz parametry jakościowe ruchu sieciowego.
  • Checklista gotowości laboratoryjnej – przygotowanie maszyny wirtualnej z systemem Linux, powłoką Bash, środowiskiem Python 3 oraz demonem cron.
node_exporter: Narzędzie zbierające metryki systemowe (procesor, pamięć, dyski) i wystawiające je dla Prometheusa; praktyczny temat wykładu drugiego.
zapowiedź tematu

Przygotowanie do wykładu 2: SLI/SLO/SLA w praktyce (definicje, obliczenia, error budget); instalacja i konfiguracja Prometheus (prometheus.yml, scrape_configs, targets); zbieranie metryk systemowych (node_exporter); powtórzenie obserwowalności (3 filary).

Potrzebne umiejętności z wykładu 1: Bash (`uptime`, `free`, `df -h`, `systemctl`, `journalctl`), Python 3 (skrypty), cron (crontab), wstęp do RouterOS/Cisco IOS (automatyzacja konfiguracji) - wszystko zweryfikowane na serwerze testowym.

Środowisko testowe: warto mieć gotowe (VM/LXC/Docker), by od razu ćwiczyć; sre.google + prometheus.io (wstęp) jako lista lektur; wszystkie polecenia CLI zweryfikowane = bezpieczne do powtórzenia.

Kontakt/pytania: prowadzący dostępny (Slack/e-mail/office hours); kanał wsparcia dla studentów; następne: praktyczne warsztaty z Prometheus + SLI/SLO.

Na następnych zajęciach przechodzimy od fundamentów do konkretów. Wykład drugi skupi się na trzech rzeczach. Po pierwsze na upraktycznieniu SLI, SLO i SLA - zobaczycie, jak wyglądają w realnej konfiguracji, jak się je oblicza i jak prowadzić budżet błędów. Po drugie zainstalujemy i skonfigurujemy Prometheusa: plik prometheus.yml, konfigurację scrape_configs, czyli skąd serwer ma zbierać metryki, oraz listę celów (targets). Do zbierania metryk systemowych wykorzystamy node_exportera, który wystawia dane o procesorze, pamięci, dyskach i sieci - właśnie te metryki posłużą nam w wykładzie trzecim do zbudowania pierwszych dashboardów w Grafanie. Po trzecie wrócimy do obserwowalności i jej trzech filarów - metryk, logów i tracingu - oraz metodologii RED i USE, które pomagają wybrać właściwe dane do obserwacji. Do zajęć przyda się gotowe środowisko testowe - maszyna wirtualna, kontener LXC albo Docker - oraz umiejętności z dzisiejszego wykładu: Bash (uptime, free, df -h, systemctl, journalctl), Python 3 do prostych skryptów i obsługa crona. Wstępnie zerkniemy też na RouterOS i Cisco IOS. Wszystkie polecenia pokazywane na zajęciach są wcześniej sprawdzane na serwerze testowym, więc możecie je bezpiecznie powtarzać we własnym środowisku.

Wyjaśnienie skrótów użytych na slajdzie:
TSDB – Time Series Database – baza danych szeregów czasowych stanowiąca rdzeń silnika bazy Prometheus.
PromQL – Prometheus Query Language – wyspecjalizowany, funkcjonalny język zapytań służący do filtrowania i agregacji próbek metryk telemetrycznych.
HTTP – Hypertext Transfer Protocol – protokół wykorzystywany przez mechanizm pull Prometheusa do okresowego odpytywania endpointów eksporterów.
CPU – Central Processing Unit – procesor serwera, którego parametry obciążenia są zbierane i wystawiane przez node_exporter.
RAM – Random Access Memory – pamięć operacyjna monitorowana w czasie rzeczywistym pod kątem saturacji i wycieków pamięci.