1/55 GitOps
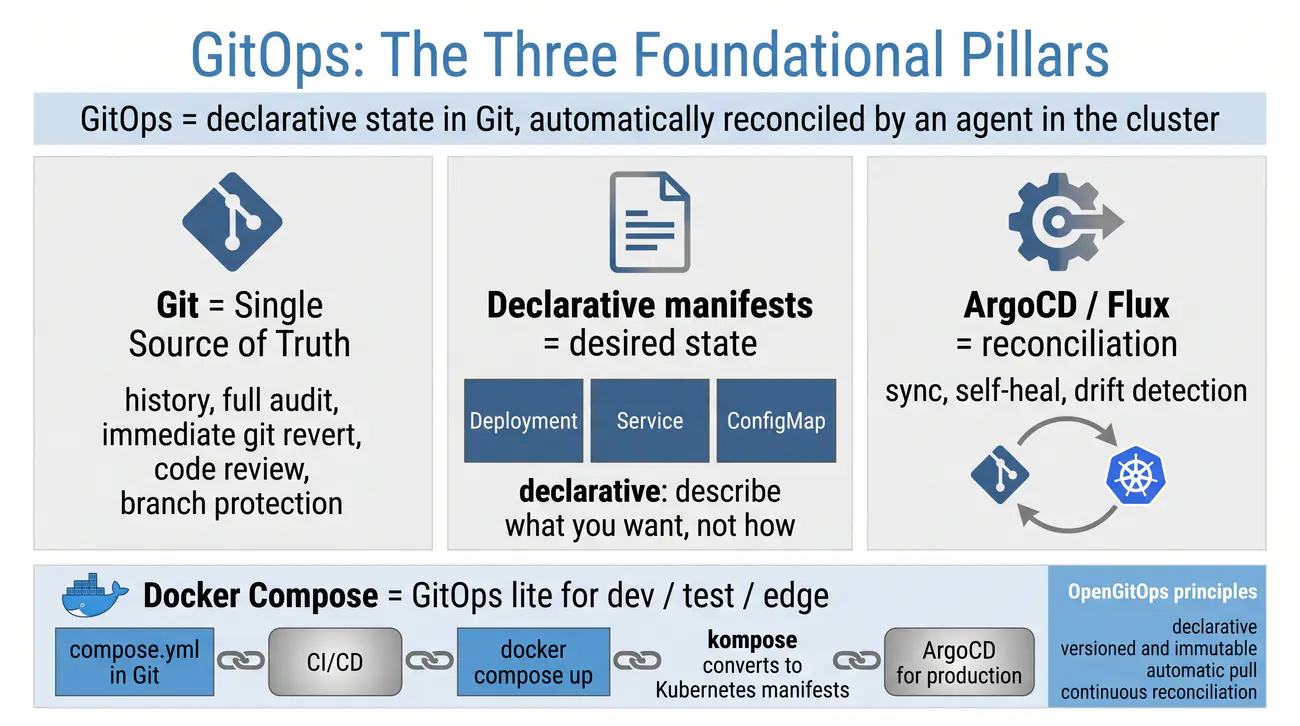
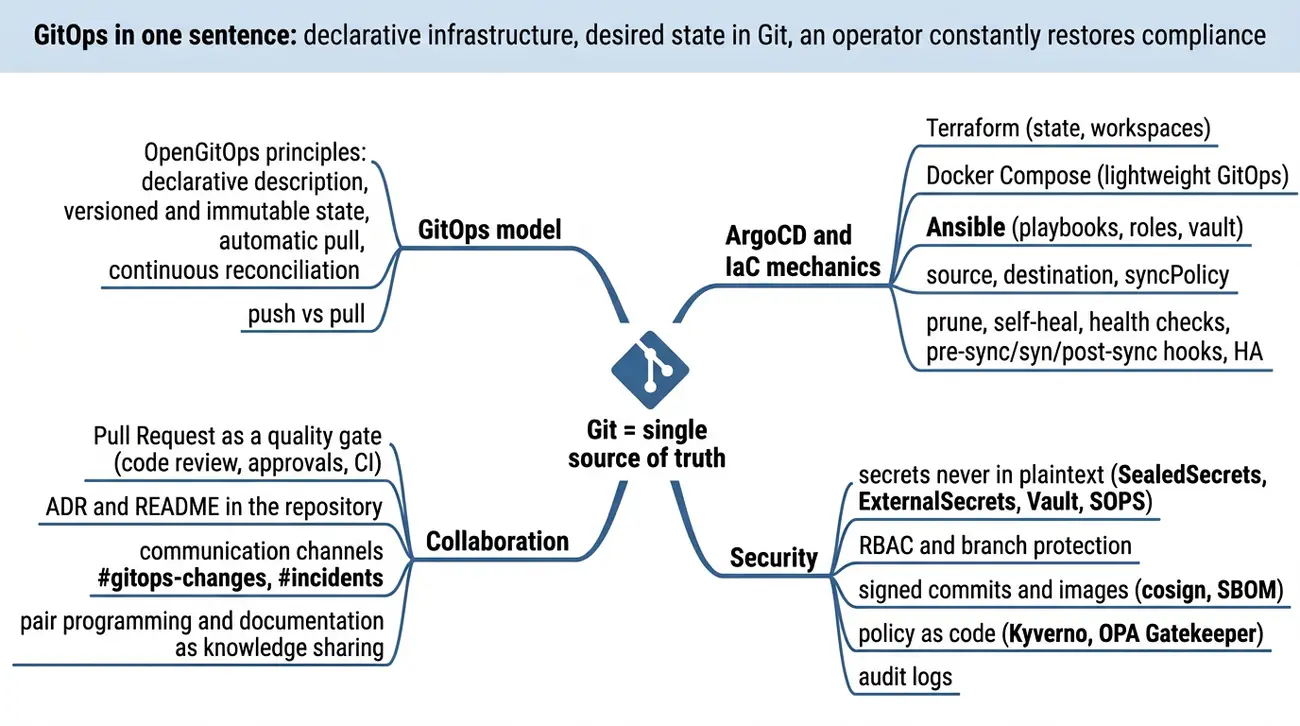
GitOps: paradygmat zarządzania infrastrukturą i aplikacjami, w którym repozytorium Git jest jedynym źródłem prawdy (ang. Single Source of Truth, w skrócie SSoT). Łączy deklaratywne manifesty, opisujące pożądany stan systemu, z automatyczną synchronizacją tego stanu przez agenta działającego w klastrze, np. ArgoCD lub Flux.

GitOps w zdaniu: Git mówi jak ma być, agent dopilnowuje, żeby tak było. Cztery elementy: Git, manifesty, ArgoCD i Compose.

  • Repozytorium jako prawda – w metodyce GitOps repozytorium kodu Git stanowi jedyne oficjalne i wiążące źródło wiedzy o całym systemie.
  • Deklaratywne manifesty – definicje serwerów i aplikacji opisuje się w plikach YAML określających pożądany rezultat końcowy w klastrze.
  • Rola kontrolera ArgoCD – wyspecjalizowany agent stale porównuje stan w repozytorium z żywym klastrem i eliminuje wszelkie rozbieżności.
  • Zastosowanie Docker Compose – narzędzie pozwala stosować zasady deklaratywnego opisu środowisk na pojedynczych maszynach deweloperskich.
  • Bezpieczny kręgosłup CD – połączenie ścisłej kontroli wersji z automatyczną synchronizacją tworzy w pełni audytowalny potok wdrożeniowy.
Single Source of Truth (SSoT): Repozytorium Git jako jedyne źródło prawdy; deklaratywne manifesty plus agent (ArgoCD/Flux) synchronizujący klaster.
GitOps
Czym właściwie jest GitOps: Tradycyjne wdrożenia polegały na tym, że inżynier wpisywał polecenia w konsoli (np. kubectl apply) albo skrypt CI logował się na serwer przez SSH. To rodziło chaos – nikt nie wiedział, kto i co dokładnie zmienił. GitOps odwraca tę relację: Git staje się jedynym źródłem prawdy. Chcesz zmienić konfigurację? Tworzysz Pull Request. Po jego zaakceptowaniu specjalny agent (np. ArgoCD) sam pobiera deklarację i doprowadza klaster do wymaganego stanu. Jeśli ktoś ręcznie coś zmieni na klastrze, agent to natychmiast wykryje i nadpisze!

GitOps to metodologia zarządzania infrastrukturą i aplikacjami, będąca naturalną kontynuacją praktyk DevOps. Zamiast wdrażać aplikacje serią ręcznych komend i ad-hoc skryptów, całą definicję środowiska - od konfiguracji sieci, przez schematy baz danych, po parametry wdrożenia - trzymamy w repozytorium Git. To repozytorium staje się jedynym źródłem prawdy (ang. Single Source of Truth): wszystko, co istnieje w środowisku produkcyjnym, jest odwzorowaniem tego, co zostało zapisane w Git. Znika dzięki temu chaos wynikający z ręcznych zmian robionych przez SSH, w konsoli chmury czy jednorazowymi skryptami.

Jak to wygląda w praktyce? Załóżmy, że klaster Kubernetes ma zawsze znajdować się w stanie opisanym w manifestach. Nad tym czuwa agent - najczęściej ArgoCD lub Flux - który na bieżąco porównuje stan zapisany w Git ze stanem rzeczywistym klastra, a w razie rozbieżności przywraca stan zdefiniowany w repozytorium. Proces, który kiedyś wymagał wielu godzin pracy administratora i groził błędem ludzkim, dzisiaj jest powtarzalny, audytowalny i można go niemal natychmiast cofnąć. Historia commitów w Git staje się zarazem pełnym zapisem zdarzeń: kto, co, kiedy i dlaczego zmienił.

Docker Compose wpisuje się w ten model jako jego lekka wersja dla pojedynczego hosta - plik docker-compose.yml zapisany w Git w pełni opisuje pożądany stan usług na danej maszynie. Zrozumienie, w jaki sposób Git, deklaratywne manifesty i automatyczna synchronizacja współpracują ze sobą, jest fundamentem, na którym zbudujemy cały dzisiejszy wykład.

Wyjaśnienie skrótów użytych na slajdzie:
GitOps – Git Operations – operacje oparte na systemie Git; Paradygmat operacyjny traktujący repozytorium kodu jako pojedyncze źródło prawdy dla konfiguracji infrastruktury.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina techniczna wykorzystująca model GitOps do eliminacji pracy manualnej i redukcji błędów wdrożeniowych.
CNCF – Cloud Native Computing Foundation – Fundacja Oprogramowania Chmurowego; Organizacja open-source standaryzująca narzędzia ekosystemu chmurowego, w tym projekty GitOps.
IaC – Infrastructure as Code – infrastruktura jako kod; Praktyka zarządzania zasobami teleinformatycznymi za pomocą deklaratywnych plików konfiguracyjnych.
K8s – Kubernetes – platforma Kubernetes; Wiodący system orkiestracji kontenerów stanowiący naturalne środowisko wykonawcze dla operatorów GitOps.

2/55 Co to jest Git
Git - rozproszony system kontroli wersji (DVCS): narzędzie przechowujące pełną historię zmian jako graf commitów (DAG). Każdy commit to migawka (ang. snapshot) całego repozytorium. Kluczowe pojęcia: version control, repository, commit, branch, merge.

Git to rozproszona historia: każdy ma całość lokalnie, zmiany to migawki, a współpraca idzie przez gałęzie i PR-y.

  • Rozproszona kontrola wersji – w systemie Git każdy inżynier posiada kompletną kopię całej historii projektu bezpośrednio na swoim dysku.
  • Graf acykliczny DAG – historia rewizji zapisywana jest w postaci skierowanego grafu, gdzie każdy węzeł reprezentuje migawkę stanu plików.
  • Standardowy cykl pracy – obejmuje utworzenie gałęzi funkcyjnej, zatwierdzenie zmian, recenzję kodu oraz bezpieczne scalenie z gałęzią główną.
  • Równoległy rozwój kodu – praca na odgałęzieniach pozwala zespołom równolegle rozwijać nowe funkcje oraz błyskawicznie łatać błędy produkcyjne.
  • Sumy kontrolne SHA – kryptograficzne hasze każdego zatwierdzenia uniemożliwiają potajemną zmianę historii bez wiedzy współpracowników.
DAG commitów: Historia jako graf skierowany bez cykli; każdy commit to migawka całego repozytorium, a rozproszenie daje pełną kopię każdemu.
Git

Git to rozproszony system kontroli wersji (ang. Distributed Version Control System, DVCS) - de facto standard w inżynierii oprogramowania i DevOps. Najważniejsza różnica w stosunku do starszych narzędzi, takich jak SVN czy CVS, polega na tym, że Git przechowuje historię zmian w postaci grafu commitów (DAG), gdzie każdy commit jest kompletną migawką (ang. snapshot) całego repozytorium w danym momencie, a nie samą różnicą między wersjami. Każdy deweloper ma przy tym pełną kopię historii lokalnie, więc może pracować bez dostępu do sieci. Gałęzie (ang. branches) to poruszające się wskaźniki na commity, dzięki którym wiele osób może równolegle rozwijać różne funkcjonalności, nie blokując się wzajemnie.

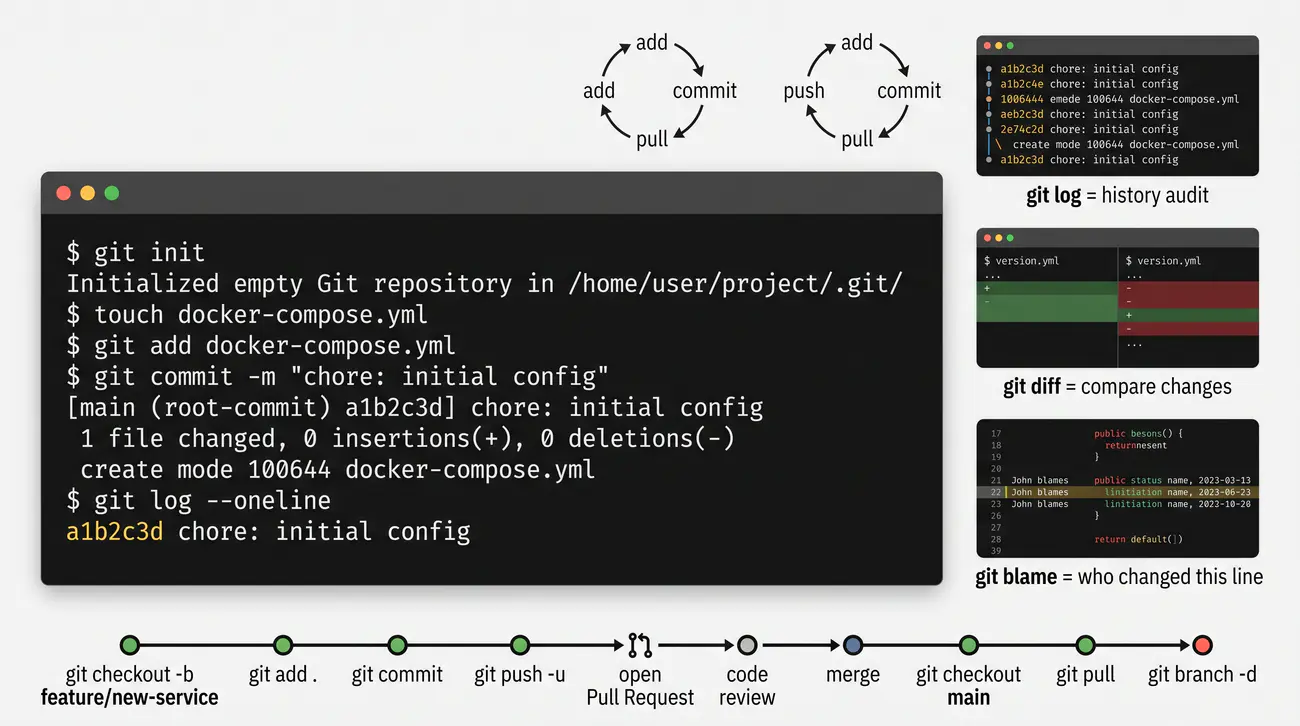
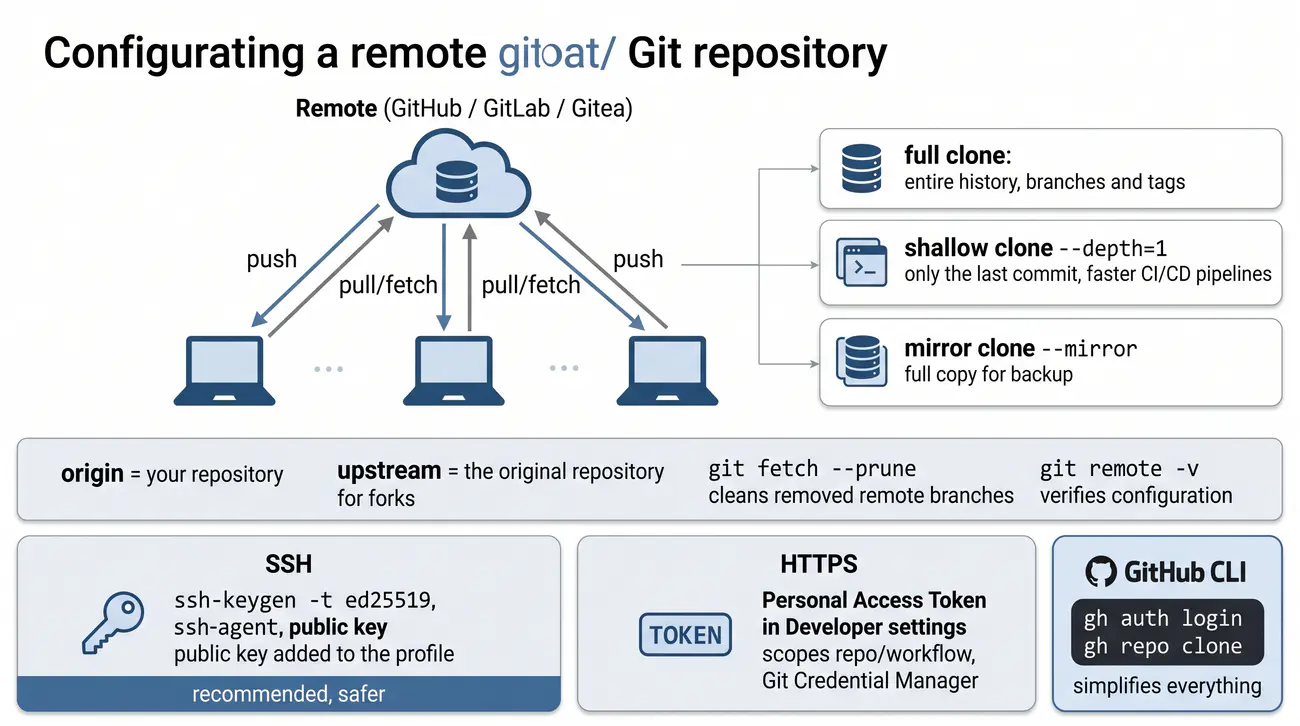
Model współpracy w zespole opiera się na zdalnym repozytorium (ang. remote, np. GitHub, GitLab, Bitbucket lub Gitea). Typowy przebieg pracy wygląda tak: klonujemy repozytorium, na podstawie gałęzi głównej tworzymy gałąź funkcyjną (feature branch), na niej wprowadzamy zmiany i zapisujemy je w commitach, a następnie wypychamy gałąź do repozytorium i otwieramy Pull Request. Zmiany przechodzą przez code review, czyli przegląd wykonany przez innych członków zespołu, a po akceptacji są łączone z gałęzią główną (merge). Ten proces jest absolutnym fundamentem GitOps - bez niego nie ma mowy o zarządzaniu środowiskami produkcyjnymi przez Git.

Warto pamiętać, że historia w Git jest niezmienna (immutable): nie da się jej przepisać bez przebudowania wszystkich następnych commitów. To cecha bardzo pożądana, ponieważ daje gwarancję integralności danych i pozwala wykrywać próby manipulacji historią. Stąd właśnie biorą się wszystkie korzyści audytowe, o których będzie mowa w dalszej części wykładu.

Wyjaśnienie skrótów użytych na slajdzie:
VCS – Version Control System – system kontroli wersji; Oprogramowanie śledzące historię zmian w plikach i umożliwiające współpracę wielu inżynierów.
DVCS – Distributed Version Control System – rozproszony system kontroli wersji; Architektura systemu kontroli wersji, w której każdy programista posiada pełną lokalną kopię historii repozytorium.
SHA – Secure Hash Algorithm – bezpieczny algorytm haszujący; Kryptograficzna funkcja skrótu (SHA-1/SHA-256) jednoznacznie identyfikująca commity i stany plików w Git.
Commit – Git Commit Object – zatwierdzenie w Git; Niezmienna migawka stanu projektu powiązana z autorem, datą i kryptograficznym identyfikatorem.
Branch – Git Branch Reference – gałąź w systemie Git; Ruchomy wskaźnik na konkretny commit w historii, umożliwiający równoległe prowadzenie prac deweloperskich.

3/55 Git jako źródło prawdy
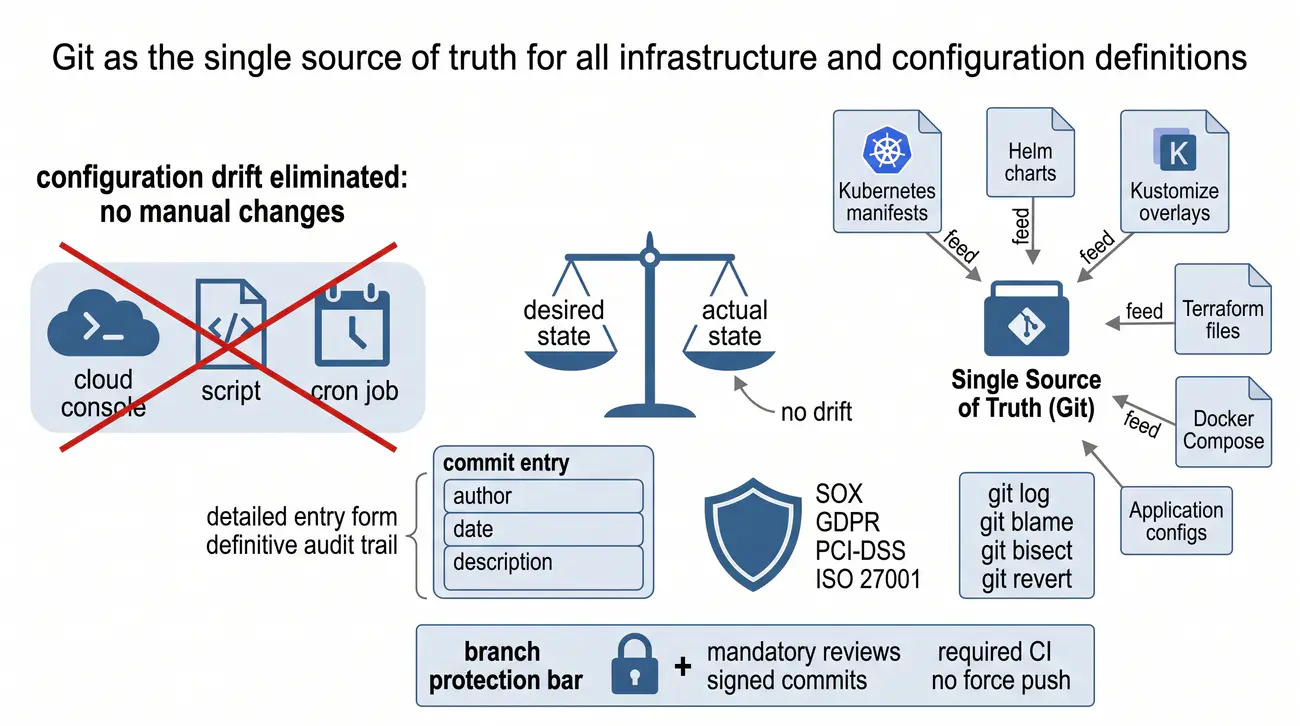
Single Source of Truth (jedno źródło prawdy): wszystkie definicje infrastruktury i konfiguracji są przechowywane wyłącznie w Git. To eliminuje configuration drift, czyli rozbieżność między stanem pożądanym a stanem rzeczywistym. Każda zmiana to commit z nazwiskiem autora, datą i kontekstem.

Jedno źródło prawdy: wszystko w Git, nic obok. Koniec z dryftem i pytaniami „kto to zmienił?”.

  • Jedno źródło prawdy – zasada Single Source of Truth nakazuje wersjonowanie wszystkich konfiguracji i manifestów wyłącznie w systemie Git.
  • Koniec z ręcznymi zmianami – wszelkie bezpośrednie modyfikowanie konfiguracji serwerów produkcyjnych przez SSH jest kategorycznie zakazane.
  • Pełna audytowalność – każdy wpis w repozytorium precyzyjnie dokumentuje nazwisko autora, dokładny czas wykonania oraz uzasadnienie zmiany.
  • Wymogi compliance – centralny rejestr konfiguracji znacząco ułatwia spełnienie rygorystycznych wymogów audytów prawnych i bezpieczeństwa.
  • Ochrona gałęzi głównej – polityki blokowania bezpośrednich commitów gwarantują, że na produkcję trafia wyłącznie przejrzany i przetestowany kod.
Configuration drift: Rozbieżność stanu rzeczywistego od pożądanego z Git; każdy commit z autorem, datą i kontekstem eliminuje dryft.
repozytorium

Koncepcja "Git jako jedyne źródło prawdy" to serce filozofii GitOps. W tradycyjnym podejściu definicja infrastruktury jest rozproszona: część siedzi w konsoli chmury, część w skryptach Terraform rozrzuconych po dyskach inżynierów, część w zadaniach cron, a część to ręczne zmiany robione przez SSH czy komendą kubectl edit. Każde z tych miejsc może się od siebie różnić, a im więcej takich miejsc, tym trudniej ustalić, jaki jest naprawdę stan systemu. W efekcie pojawia się configuration drift - rozbieżność między stanem, jaki zamierzamy utrzymywać, a tym, co faktycznie działa - która utrudnia diagnozowanie, audyt i odtwarzanie środowisk.

Git jako jedyne źródło prawdy oznacza, że wszystkie definicje infrastruktury (manifesty Kubernetes, wykresy Helm, overlaye Kustomize, pliki Terraform, Docker Compose) oraz konfiguracje aplikacji (ConfigMap, sekrety, przełączniki funkcji) są przechowywane wyłącznie w repozytorium. Żadna ręczna zmiana w środowisku produkcyjnym nie jest dozwolona - każda modyfikacja przechodzi przez Git: pull request, code review, a dopiero potem merge. Dzięki temu każda zmiana ma autora, datę i opis, a historia commitów tworzy pełny, niepodważalny dziennik zdarzeń, nazywany śladem audytowym.

Taki porządek przynosi konkretne korzyści. Możemy wrócić do dowolnego punktu w historii (git checkout <hash>), sprawdzić, kto zmienił konkretną linię (git blame), automatycznie znaleźć commit, który wprowadził błąd (git bisect), a przede wszystkim błyskawicznie cofnąć szkodliwą zmianę (git revert). Wersjonujemy przy tym nie tylko kod aplikacji, ale także stan Terraform, wartości Helm, overlaye Kustomize, a nawet - w postaci zaszyfrowanej - sekrety. To wszystko razem spełnia wymogi audytu stawiane przez regulacje takie jak SOX, GDPR, PCI-DSS czy ISO 27001: każda zmiana ma autora (najlepiej podpisany commit GPG), przeszła code review i kontrole CI.

Wyjaśnienie skrótów użytych na slajdzie:
SSOT – Single Source of Truth – pojedyncze źródło prawdy; Fundamentalna zasada inżynierii oprogramowania nakazująca przechowywanie definicji stanu w jednym, zaufanym miejscu.
Audit – Compliance and Security Audit – audyt zgodności i bezpieczeństwa; Procedura weryfikacji historii operacji uprzywilejowanych w oparciu o nienaruszalny dziennik commitów Git.
Git – Git version control system – system kontroli wersji Git; Narzędzie stanowiące autorytatywną bazę danych stanu pożądanego w modelu GitOps.
IaC – Infrastructure as Code – infrastruktura jako kod; Definicje serwerów, sieci i aplikacji zapisane w postaci plików tekstowych w repozytorium.
PR – Pull Request – propozycja włączenia zmian; Mechanizm zgłoszenia i recenzji zmian w konfiguracji infrastruktury przed wdrożeniem na produkcję.

4/55 Wprowadzenie do GitOps
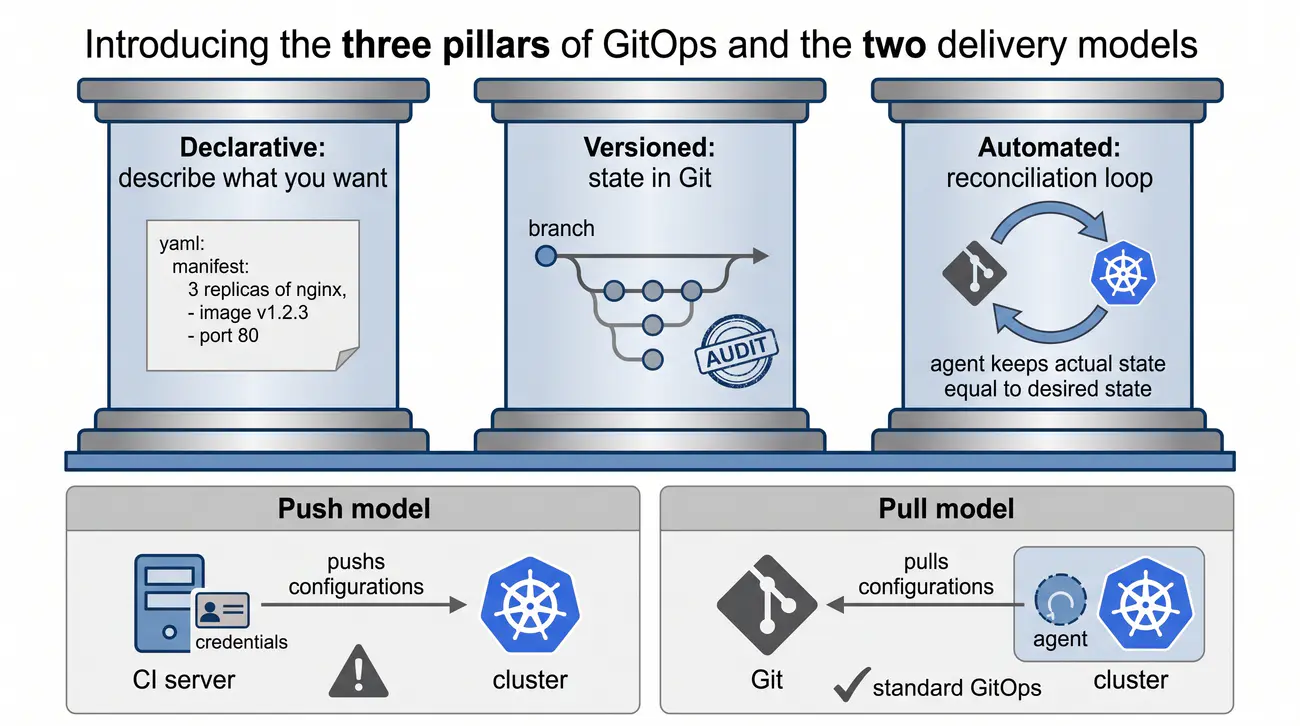
Trzy filary GitOps: 1) deklaratywność - opisujemy, czego chcemy, a nie, jak to zrobić; 2) wersjonowanie i niezmienność - stan jest zapisany w Git; 3) automatyzacja - agent nieustannie przywraca stan rzeczywisty do stanu pożądanego (pętla rekonsyliacji, ang. reconciliation loop).

GitOps w pigułce: opisujesz cel, wersjonujesz go i pozwalasz agentowi go pilnować. Pull, nie push.

  • Deklaratywny stan systemu – inżynier zamiast pisać ciągi instrukcji proceduralnych deklaruje stan docelowy, na przykład liczbę replik poda.
  • Pętla rekonsyliacji – agent wdrożeniowy stale porównuje pliki w repozytorium ze stanem obiektów w klastrze, usuwając rozbieżności.
  • Wdrożenia w modelu pull – kontroler wewnątrz klastra sam pobiera zmiany z Git, eliminując potrzebę otwierania portów dla zewnętrznych narzędzi.
  • Separacja etapów CI i CD – rozdzielenie procesu kompilacji kodu od jego wdrożenia na klastrze drastycznie podnosi bezpieczeństwo platformy.
  • Odporność operacyjna – deklaratywny opis środowiska pozwala na bezbłędne odtworzenie całego ekosystemu po dowolnej awarii sprzętowej.
Reconciliation loop: Pętla rekonsyliacji - agent nieustannie przywraca stan rzeczywisty do pożądanego z Git.
GitOps pipeline

Standard operacyjny opracowany przez komitet OpenGitOps CNCF definiuje cztery fundamentalne zasady:
1. Deklaratywność: cały stan pożądany systemu musi być opisany w postaci deklaratywnych manifestów,
2. Wersjonowalność i niezmienność: stan jest przechowywany w systemie Git, zapewniając pełną historię i audytowalność,
3. Automatyczne pobieranie: dedykowane oprogramowanie agentowe w klastrze automatycznie pobiera deklaracje stanu z repozytorium,
4. Ciągła pętla uzgadniania (Reconciliation Loop): agent nieustannie monitoruje stan rzeczywisty i samoczynnie niweluje wszelkie odchylenia (Configuration Drift).

GitOps to metodologia zarządzania infrastrukturą i aplikacjami, która przenosi DevOps na wyższy poziom: zamiast wyłącznie automatyzować ręczne czynności, wprowadza Git jako centrum sterowania i wymaga, aby system był opisany deklaratywnie. W skrócie: to "wszystko jako kod" (Everything as Code) plus Git jako jedyne źródło prawdy plus automatyczna synchronizacja. Nie jest to konkretne narzędzie, lecz paradygmat operacyjny - a o tym, czy system naprawdę realizuje GitOps, decyduje spełnienie trzech filarów.

Pierwszy filar to deklaratywność. W podejściu imperatywnym piszemy instrukcje: "zrób X, potem Y, potem Z" - jak w skryptach czy playbookach Ansible. Taki kod trudno debugować i bywa nieidempotentny, czyli powtórne uruchomienie może dać inny wynik. GitOps wymaga podejścia deklaratywnego: podajemy stan docelowy, np. "chcę trzy repliki nginx z obrazem v1.2.3 na porcie 80", a system sam decyduje, jak go osiągnąć. Dzięki temu zastosowanie tego samego manifestu wielokrotnie daje zawsze ten sam rezultat, a porównanie stanu pożądanego z rzeczywistym jest proste i jednoznaczne.

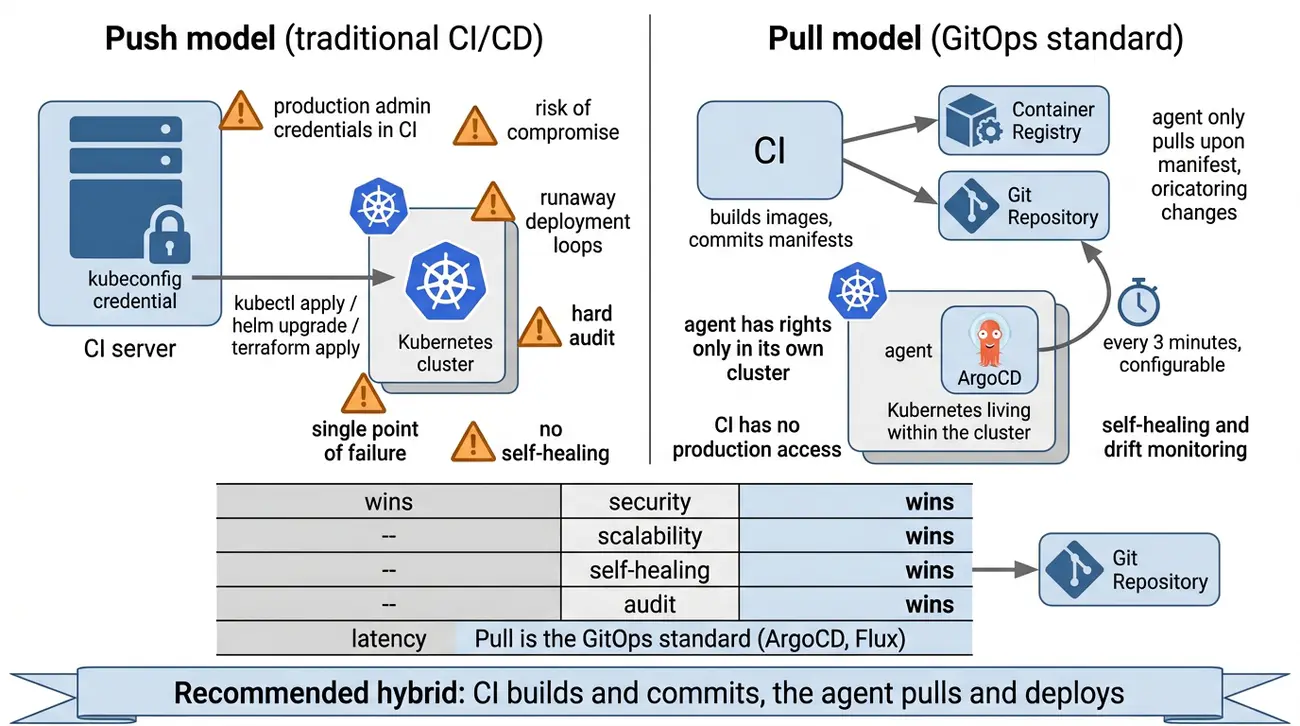
Drugi filar to wersjonowanie i niezmienność - pożądany stan jest przechowywany w Git, a historia zmian jest stała i audytowalna. Trzeci filar to automatyzacja: agent, taki jak ArgoCD czy Flux, nieustannie porównuje stan zapisany w Git ze stanem klastra i przywraca zgodność, gdy wykryje rozbieżność. W kontekście tych trzech filarów warto też rozróżnić dwa modele dystrybucji zmian: model Push, w którym CI wypycha zmiany do klastra (wymaga uprawnień w CI, trudniej go skalować), oraz model Pull, w którym agent działający w klastrze sam pobiera zmiany z Git. Model Pull jest bezpieczniejszy i skalowalniejszy, dlatego stanowi standard GitOps.

Wyjaśnienie skrótów użytych na slajdzie:
Pull – Pull-based Deployment Model – model wdrożeniowy oparty na pobieraniu; Wzorzec architektoniczny, w którym agent wewnątrz klastra sam cyklicznie pobiera konfigurację z repozytorium.
Push – Push-based Deployment Model – model wdrożeniowy oparty na wypychaniu; Tradycyjny model CI/CD, w którym zewnętrzny serwer łączy się do klastra i wymusza zmiany.
Reconciliation – Continuous Reconciliation Loop – ciągła pętla uzgadniania stanu; Niewygasający proces porównujący stan obserwowany z zadeklarowanym i korygujący rozbieżności.
Operator – Kubernetes Operator Pattern – wzorzec operatora w Kubernetesie; Metoda rozszerzania funkcjonalności klastra o automatyczne zarządzanie aplikacjami za pomocą kontrolerów CRD.
Drift – Configuration Drift – dryft konfiguracyjny; Zjawisko powstawania nieudokumentowanych różnic pomiędzy stanem produkcyjnym a plikami w repozytorium.

5/55 Zasady GitOps
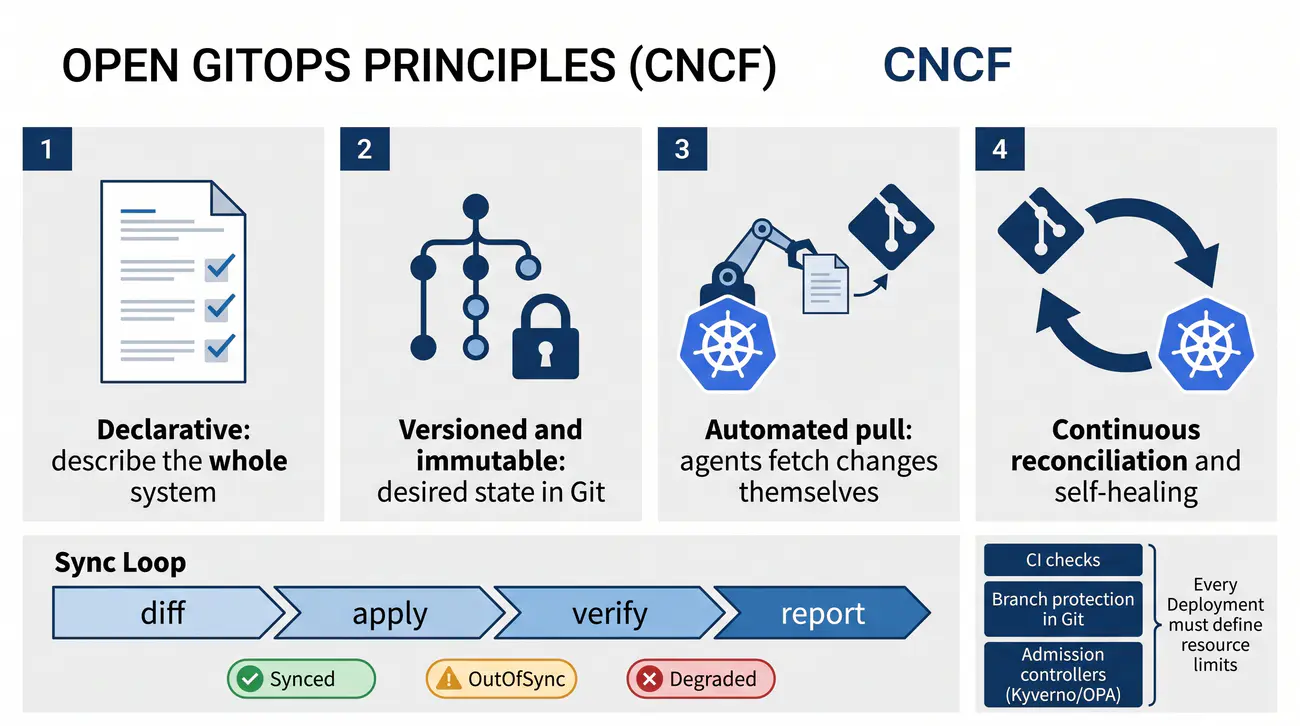
Cztery zasady OpenGitOps (CNCF): 1) deklaratywność - cały system jest opisany deklaratywnie; 2) wersjonowanie i niezmienność - pożądany stan jest w Git; 3) automatyczny pull - agent sam pobiera zmiany; 4) ciągła rekonsyliacja - nieustanna pętla doprowadzania stanu do zgodności wraz z samonaprawą.

Cztery zasady OpenGitOps (CNCF): deklaratywność, wersje, pull i ciągła rekonsyliacja z samonaprawą.

  • Standard OpenGitOps – międzynarodowa norma definiuje cztery filary: deklaratywność, wersjonowanie, automatyzację oraz samonaprawę.
  • Pełna automatyzacja – agent wdrożeniowy pobiera i aplikuje zadeklarowany stan bez konieczności ręcznego zatwierdzania przez administratora.
  • Mechanizm samonaprawiania – kontroler natychmiast wykrywa i cofa wszelkie nieautoryzowane zmiany wprowadzone bezpośrednio na klastrze.
  • Cykliczna weryfikacja spójności – stan środowiska produkcyjnego jest nieustannie uzgadniany z najnowszym zatwierdzonym commitem w repozytorium.
  • Wielowarstwowa kontrola – obejmuje walidację składni manifestów, automatyczne testy jednostkowe oraz reguły polityk bezpieczeństwa.
Automatyczny pull: Agent sam pobiera zmiany z Git (bez push z CI); z ciągłą rekonsyliacją i samonaprawą - zasady CNCF OpenGitOps.
zasady

Zgodnie z zasadami OpenGitOps kontroler w klastrze realizuje ciągłą pętlę sterowania (Reconciliation Loop), stale dążąc do zrównania stanu obserwowanego ze stanem zadeklarowanym w Git.

Cztery zasady OpenGitOps, wypracowane pod patronatem CNCF, nie są sugestiami, lecz warunkami koniecznymi. Definiują one, czy dany system naprawdę implementuje GitOps, czy tylko udaje: (1) deklaratywność - cały system jest opisany w sposób deklaratywny; (2) wersjonowanie i niezmienność - pożądany stan trafia do Git i nie można go zmienić "po cichu"; (3) automatyczny pull - agenty same pobierają i stosują zmiany; (4) ciągła rekonsyliacja - pętla, która nieustannie porównuje stan rzeczywisty z pożądanym, wykrywa dryft i naprawia go (samonaprawa). Jeśli którykolwiek warunek nie jest spełniony, system nie jest w pełni GitOps.

Z zasady pierwszej wynika bardzo konkretna konsekwencja: jedynym dozwolonym sposobem zmiany środowiska produkcyjnego jest Git. Niedozwolone są kubectl edit, kubectl scale, helm upgrade z konsoli, terraform apply z laptopa ani ssh na serwer. Dozwolony przepływ wygląda tak: inżynier → commit/push → Pull Request → code review → merge → agent (ArgoCD/Flux) → klaster. Dzięki temu znikają problemy typu "na mojej maszynie działa" albo "kto to zmienił?", a każda zmiana ma udokumentowany kontekst. Wymaga to ochrony gałęzi głównej (branch protection) i podpisywania commitów, a tam, gdzie to możliwe - polityk blokujących ręczne zmiany w klastrze.

Automatyczna synchronizacja działa w pętli: agent pobiera z Git stan pożądany, odczytuje z API Kubernetes stan aktualny, porównuje je, w razie różnic stosuje zmiany (apply, patch albo delete) i raportuje status (Synced, OutOfSync, Degraded). Domyślnie ArgoCD wykonuje tę kontrolę co trzy minuty, ale odstęp jest konfigurowalny. Zanim jakakolwiek zmiana dotrze do klastra, przechodzi walidację na kilku poziomach: w CI (składnia, lint, testy, skanowanie bezpieczeństwa), w Git (obowiązkowe recenzje i kontrole) oraz w samym klastrze przez mechanizm admission controllers, które egzekwują narzucone zasady - np. że każdy Deployment musi mieć zdefiniowane limity zasobów.

Wyjaśnienie skrótów użytych na slajdzie:
Declarative – Declarative System Description – deklaratywny opis systemu; Podejście definiujące stan końcowy (co ma działać) zamiast sekwencji kroków proceduralnych (jak to zrobić).
Versioned – Versioned and Immutable State – stan wersjonowany i niezmienny; Wymóg przechowywania całej konfiguracji w postaci migawek w systemie kontroli wersji.
Pulled – Automatically Pulled Declarations – automatycznie pobierane deklaracje; Zasada autonomicznego działania oprogramowania wdrażającego bez udziału człowieka.
Reconciled – Continuously Reconciled State – stan ciągle uzgadniany; Gwarancja samonaprawiania się klastra w przypadku wystąpienia nieautoryzowanych zmian manualnych.
OpenGitOps – OpenGitOps Standard – standard OpenGitOps; Oficjalna specyfikacja reguł GitOps rozwijana pod auspicjami fundacji CNCF.

6/55 Git a infrastruktura
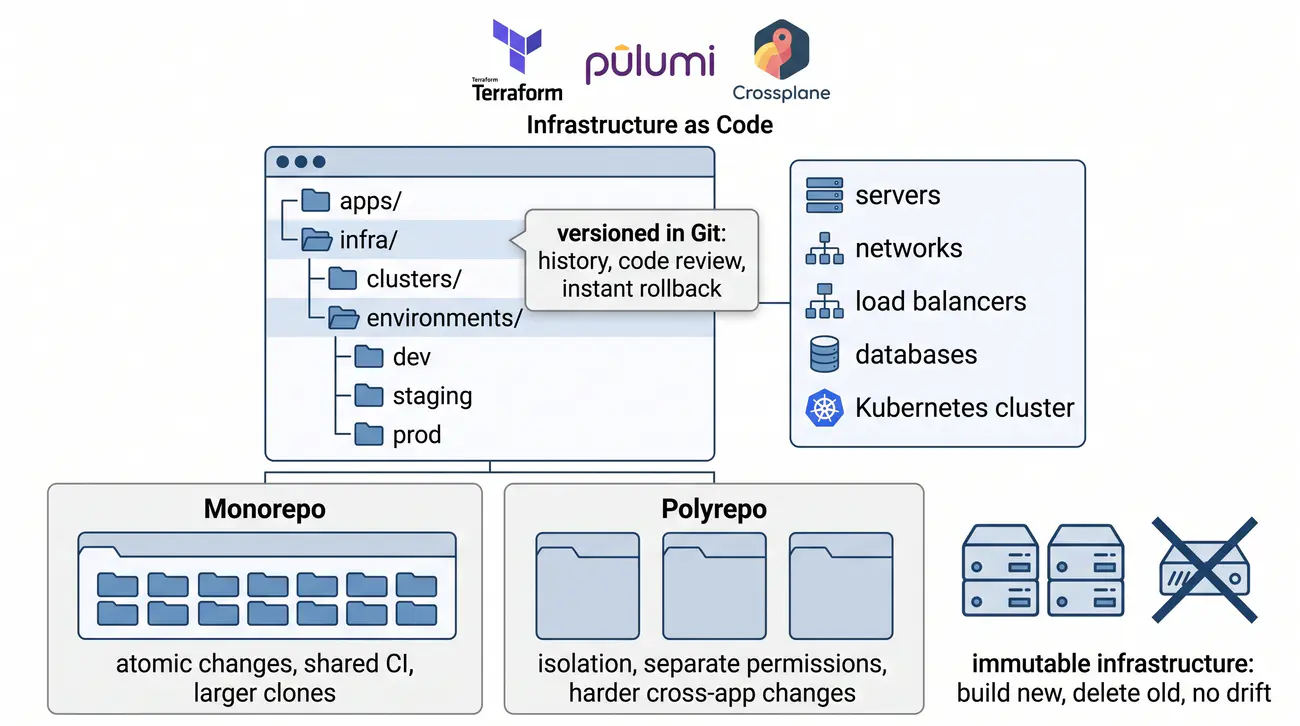
Infrastructure as Code (IaC): infrastruktura jest definiowana i zarządzana za pomocą kodu (Terraform, Pulumi, Crossplane), wersjonowanego w Git. Pliki .tf/.yaml opisujące środowiska (dev/staging/prod) stają się audytowalną i odwracalną definicją infrastruktury.

IaC to koniec klikania: infrastrukturę piszesz jak kod - Terraform, Pulumi czy Crossplane - i trzymasz w Git.

  • Infrastruktura jako kod IaC – traktuje definicje maszyn, sieci i magazynów danych dokładnie tak samo jak kod źródłowy aplikacji.
  • Eliminacja błędów ludzkich – zastąpienie ręcznej konfiguracji powtarzalnymi skryptami pozwala na błyskawiczne odtworzenie platformy od zera.
  • Separacja środowisk – środowiska deweloperskie, testowe i produkcyjne są definiowane w osobnych katalogach w tym samym repozytorium.
  • Niemutowalna infrastruktura – zamiast modyfikować działające maszyny tworzy się nowe instancje o zaktualizowanej konfiguracji bazowej.
  • Bezpieczne testowanie – wersjonowanie kodu infrastruktury umożliwia weryfikację zmian w izolowanych środowiskach przed ich wdrożeniem.
Pliki .tf/.yaml: Audytowalna, odwracalna definicja środowisk (dev/staging/prod) w Terraform, Pulumi czy Crossplane, wersjonowana w Git.
IaC

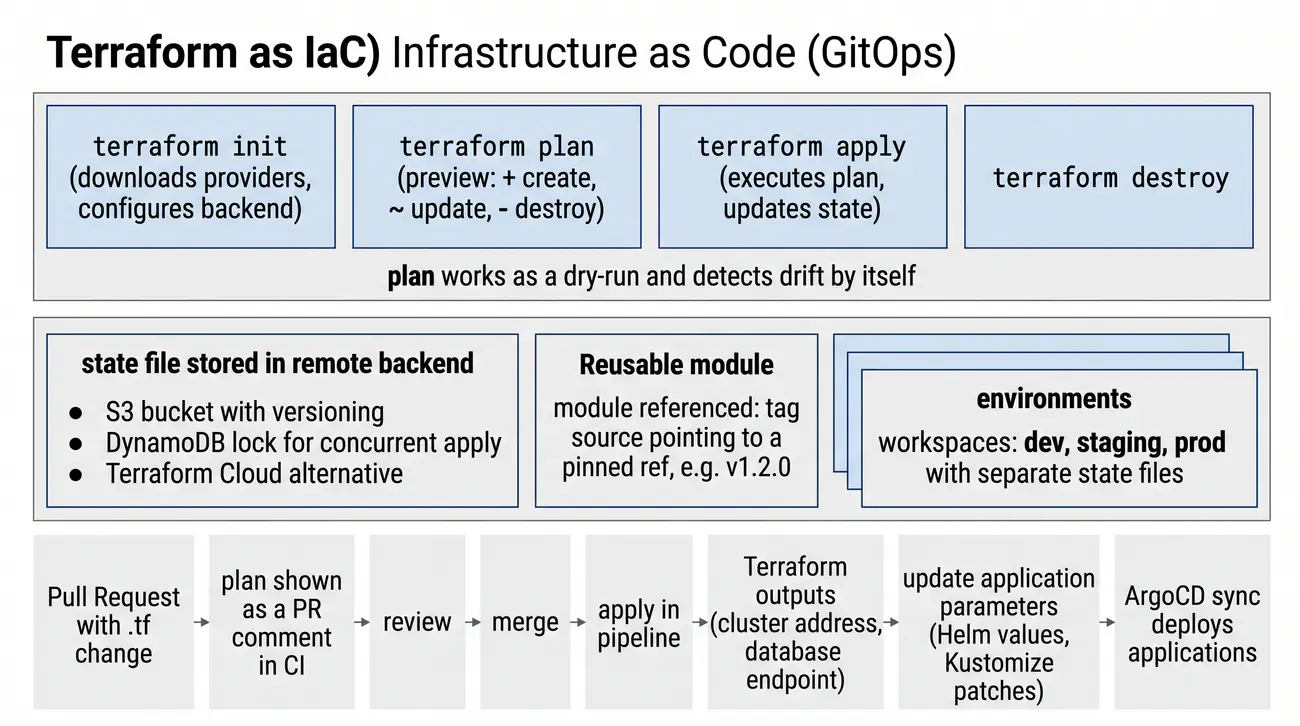
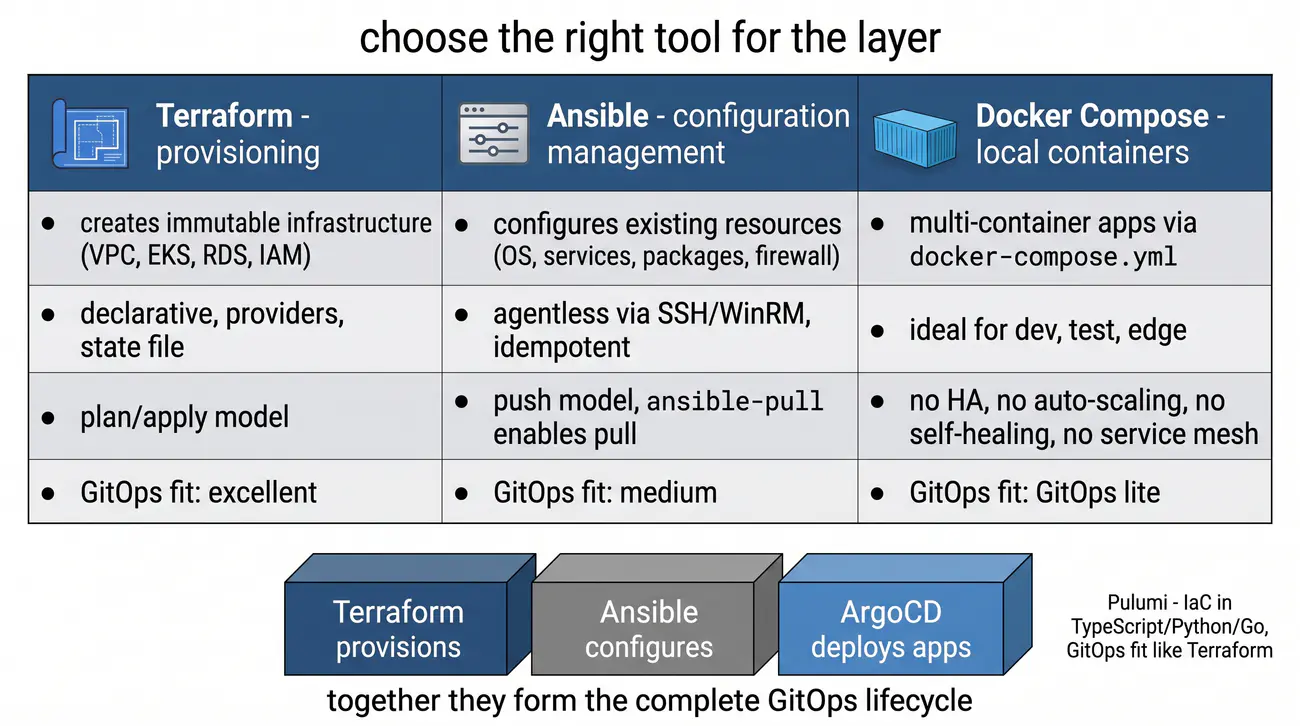
Infrastructure as Code (IaC) to fundament nowoczesnego zarządzania infrastrukturą. Serwery, sieci, load balancery, bazy danych czy całe klastry Kubernetes przestają być konfigurowane ręcznie - zamiast tego opisujemy je w kodzie (pliki konfiguracyjne), a Git staje się repozytorium tego kodu. Do najpopularniejszych narzędzi należą Terraform (język HCL, chmury AWS/GCP/Azure), Pulumi (TypeScript, Python, Go), Crossplane (narzędzie IaC natywne dla Kubernetes), a także Ansible (konfiguracja systemów), Packer (budowanie obrazów) czy CloudFormation (rozwiązanie vendorowe od AWS). Wersjonowanie tych plików w Git daje historię zmian, możliwość code review, rollback przez git revert, audyt i testowanie w CI/CD.

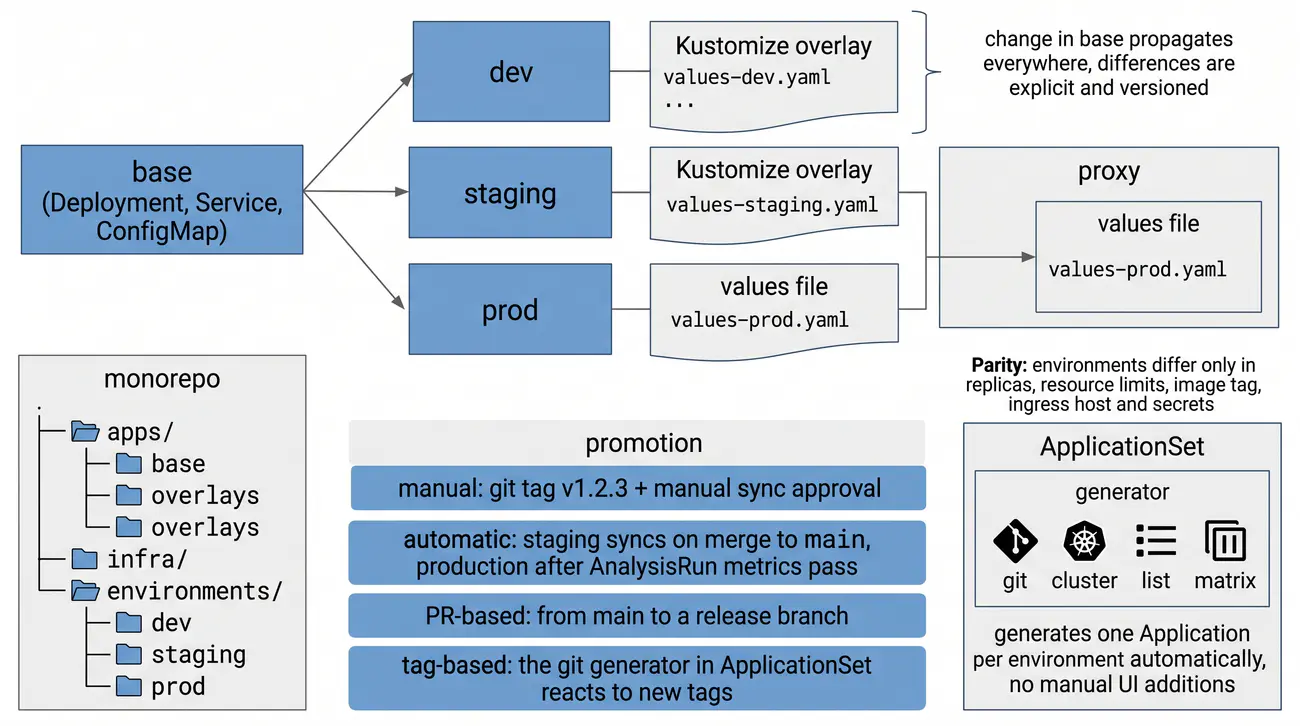
W modelu GitOps każde środowisko - dev, staging, prod - ma w Git swoją jednoznaczną definicję. Typowa struktura repozytorium obejmuje katalogi apps/ (aplikacje: wykresy Helm, overlaye Kustomize), infra/ (moduły Terraform, kompozycje Crossplane), clusters/ (zasoby o zasięgu klastra: CRD, ClusterRole, namespace) oraz environments/ (dev/, staging/, prod/ z plikami values.yaml i overlayami). Dzięki temu różnice między środowiskami są jawne w Git - wystarczy porównać pliki - a promocja zmian między środowiskami też idzie przez Git: pull request, merge, a następnie automatyczna synchronizacja w docelowym środowisku.

Wersjonowanie infrastruktury ma jeszcze jedną ważną konsekwencję: infrastruktura staje się niezmienna (ang. immutable). Zamiast "podrasowywać" działający serwer, budujemy nowy na podstawie zdefiniowanego obrazu, a stary usuwamy. To podejście radykalnie zmniejsza dryf konfiguracji i sprawia, że środowiska są w pełni powtarzalne. W kontekście wykładu 1: Git oraz IaC razem realizują postulat "infrastruktura jako kod", a dodatkowo kategoria "cattle, not pets" - zasoby są wymienne, wersjonowane i można je odtwarzać z kodu, zamiast traktować jak ręcznie hodowane "zwierzaki", których nikt nie odważy się dotknąć.

Wyjaśnienie skrótów użytych na slajdzie:
IaC – Infrastructure as Code – infrastruktura jako kod; Podstawa automatyzacji umożliwiająca zarządzanie zasobami sprzętowymi i chmurowymi jak oprogramowaniem.
Terraform – HashiCorp Terraform – platforma Terraform; Narzędzie deklaratywnej aprowizacji zasobów chmurowych operujące na plikach stanu .tfstate.
OpenTofu – OpenTofu Open Source IaC – projekt OpenTofu; Otwarty, wspierany przez Linux Foundation fork narzędzia Terraform o pełnej kompatybilności składniowej.
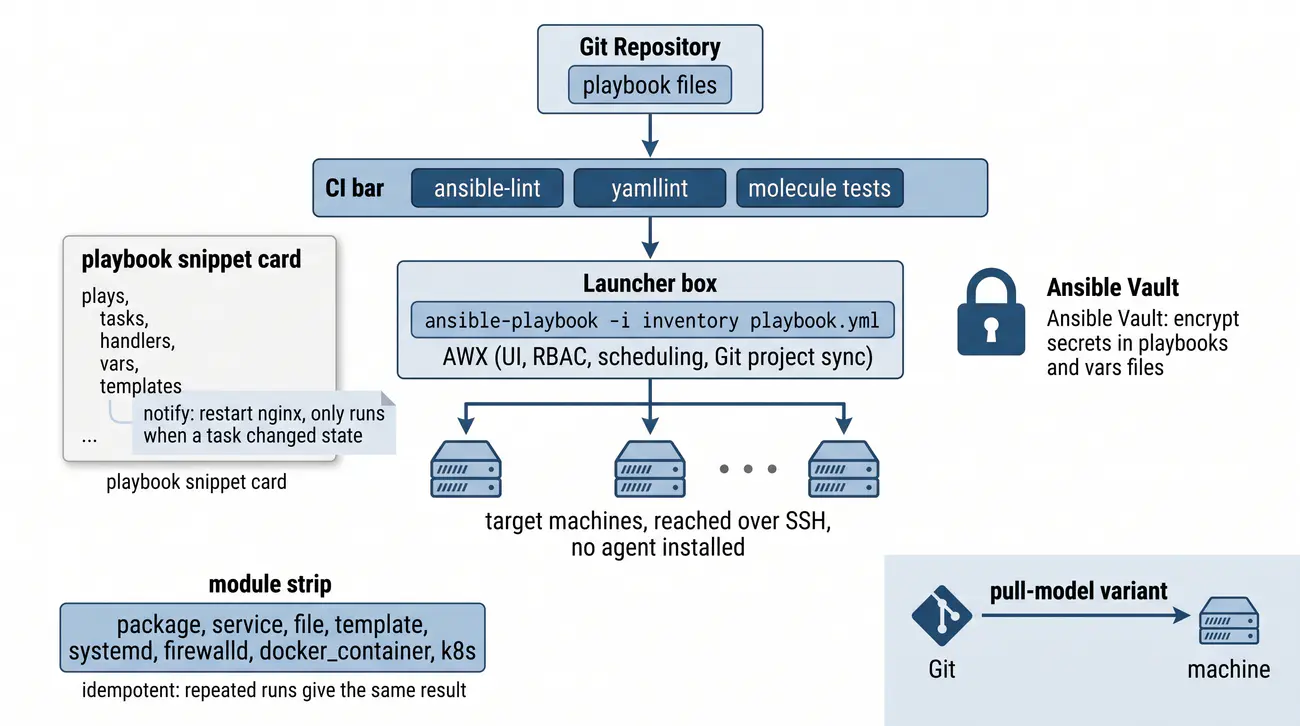
Ansible – Red Hat Ansible – system automatyzacji Ansible; Bezagentowe narzędzie konfiguracji serwerów przez protokół SSH oparte na deklaratywnych playbookach YAML.
Manifest – Kubernetes Resource Manifest – manifest zasobu w Kubernetes; Plik YAML opisujący pożądany stan obiektu (Deployment, Service, ConfigMap) w klastrze.

7/55 Bazy i gałęzie w Git
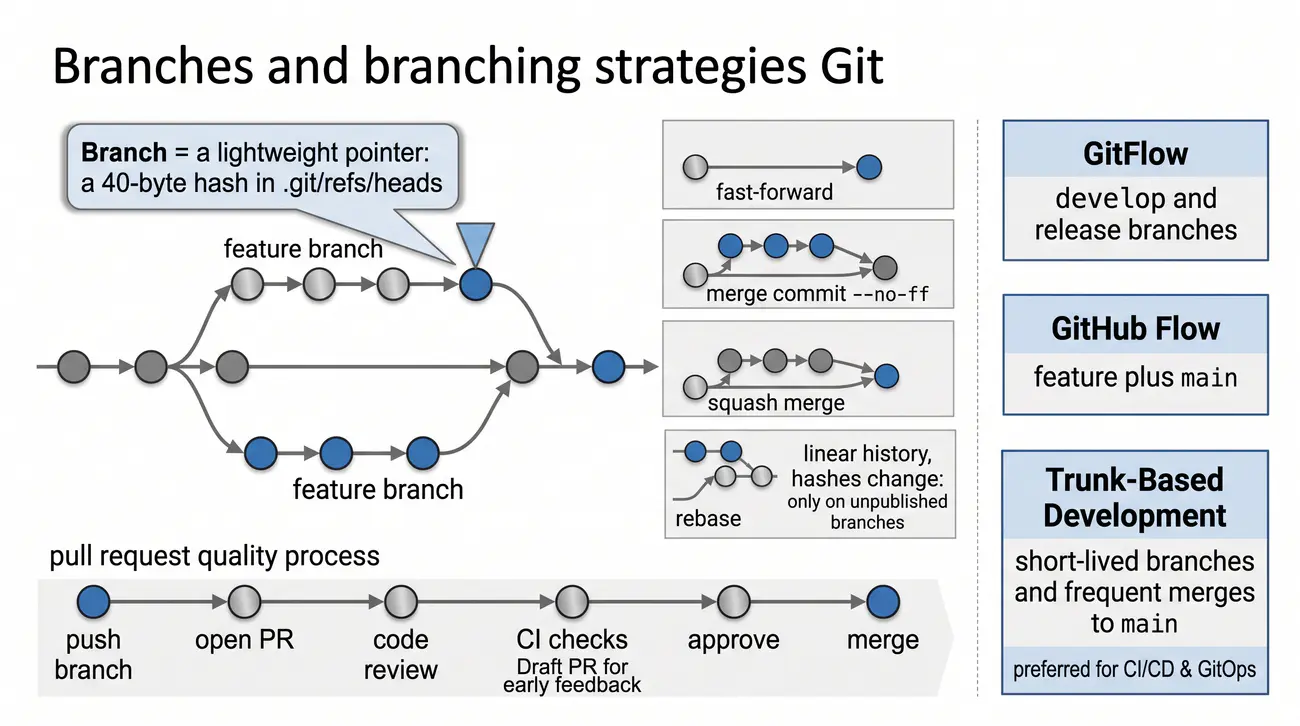
Gałęzie i strategie gałęziowe: gałąź (ang. branch) to lekki wskaźnik (ok. 40 bajtów) na commit. Strategie: GitFlow (feature/develop/release/hotfix), GitHub Flow (feature + main), Trunk-Based (krótkowieczne gałęzie, częste scalanie do main). Wybór zależy od wielkości zespołu i częstotliwości wydań.

Gałąź to wskaźnik za 40 bajtów: tworzysz w mgnieniu oka. Strategie dobierasz do zespołu i tempa wydań.

  • Lekkie gałęzie funkcyjne – gałąź w Git to wskaźnik na konkretny commit, co umożliwia jej błyskawiczne powołanie bez narzutu dyskowego.
  • Strategie scalania zmian – integracja kodu może odbywać się przez przesunięcie Fast-Forward, dedykowany commit scalający lub spłaszczenie.
  • Wnioski pull request – stanowią oficjalne miejsce dyskusji nad proponowanymi zmianami, wynikami testów automatycznych i uwagami recenzentów.
  • Modele pracy GitFlow i Trunk – dobór strategii gałęziowej zależy od częstotliwości wydań oraz wielkości zespołu inżynierów w organizacji.
  • Etyka czystej historii – dbałość o zrozumiałe opisy commitów i usuwanie niepotrzebnych gałęzi ułatwia późniejsze diagnozowanie problemów.
Trunk-Based: Krótkowieczne gałęzie z częstym scalaniem do main; obok GitFlow (feature/develop/release/hotfix) i GitHub Flow (feature + main).
komendy Git

Model gałęzi to w Git kluczowa umiejętność organizacyjna - zarówno dla pracy zespołowej, jak i dla CI/CD. Gałęzie są niezwykle tanie: to w praktyce plik w katalogu .git/refs/heads/ zawierający 40-znakowy hash commita. Tworzy się je komendą git branch, git checkout -b albo nowszą i bezpieczniejszą git switch -c, przełącza git checkout lub git switch, a usuwa git branch -d (bezpieczne, jeśli zmiany zostały scalone) albo git branch -D (wymuszone). Wybór strategii gałęziowej zależy od kontekstu: GitFlow wprowadza dodatkowe gałęzie develop i release (sprawdza się przy rygorystycznym procesie wydawniczym), GitHub Flow ogranicza się do gałęzi feature i main (prosty, dobry dla szybkich zespołów), a Trunk-Based Development zakłada bardzo krótkowieczne gałęzie i częste integracje z gałęzią główną - to preferowany wariant w środowiskach CI/CD i GitOps.

Scalanie (ang. merge) łączy historie dwóch gałęzi i może przebiegać na trzy sposoby. Fast-forward po prostu przesuwa wskaźnik, gdy gałąź bazowa nie zmieniła się od czasu rozwidlenia. Merge commit (git merge --no-ff) tworzy nowy commit scalenia i zachowuje pełną historię gałęzi - dobrze widać ją w git log --graph. Squash merge spłaszcza wszystkie zmiany gałęzi do jednego commita na gałęzi głównej - historia jest czysta, ale traci się szczegółowość. Rebase przepisuje zmiany na wierzch gałęzi bazowej, dając liniową historię, ale zmienia hashe commitów, dlatego stosuje się go wyłącznie na własnych, niewypchniętych gałęziach.

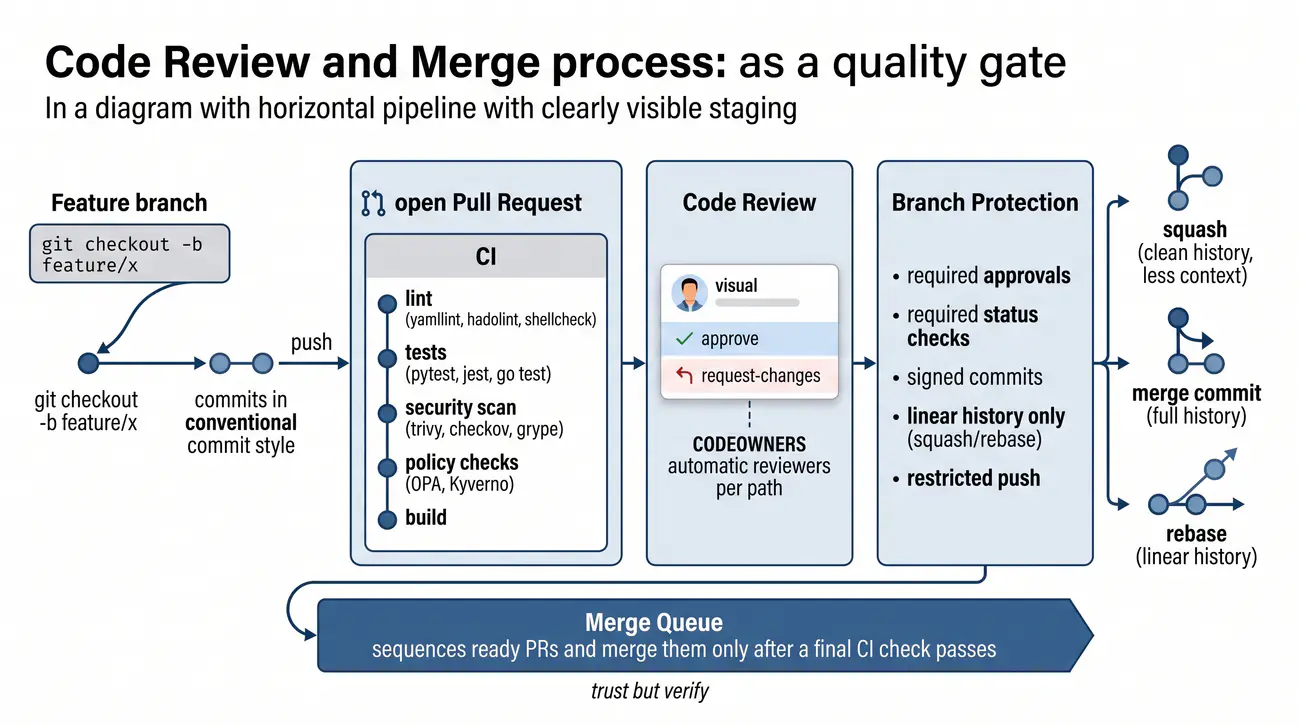
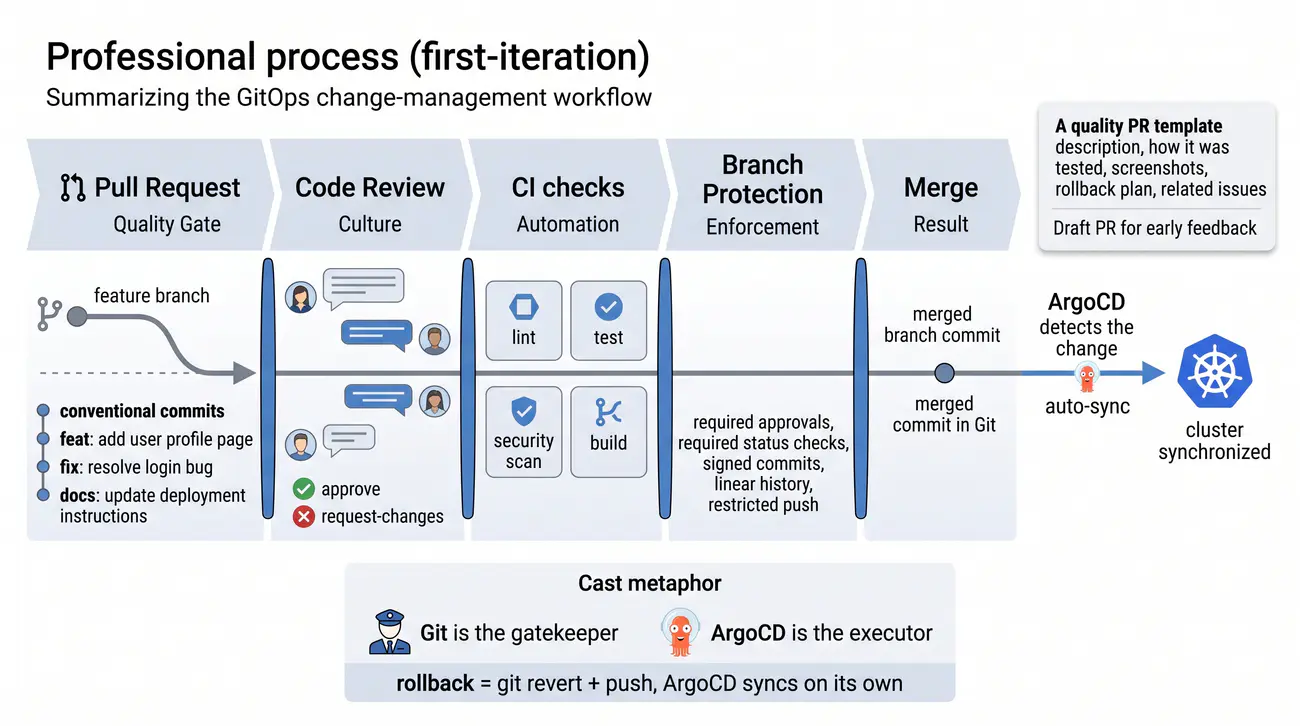
Pull Request (w GitLab: Merge Request) to nie samo scalanie, lecz cały proces jakościowy: po wypchnięciu gałęzi otwieramy PR, inni inżynierowie sprawdzają kod (code review) i proponują poprawki, CI wykonuje testy, lint i skanowanie bezpieczeństwa, a całość kończy się zatwierdzeniem i scaleniem. Draft PR pozwala poprosić o wczesny feedback jeszcze przed uznaniem zmian za gotowe. W czystej praktyce GitOps to właśnie Pull Request, a nie komenda git merge, jest bramką, przez którą przechodzi każda zmiana infrastruktury.

Wyjaśnienie skrótów użytych na slajdzie:
TrunkBased – Trunk-Based Development – rozwój oparty na pniu głównym; Metodyka pracy w Git zakładająca częste scalanie małych zmian bezpośrednio do gałęzi głównej.
GitFlow – GitFlow Branching Model – model gałęziowy GitFlow; Tradycyjna, rozbudowana strategia zarządzania wieloma długożyjącymi gałęziami (develop, release, master).
FeatureBranch – Feature Branch Workflow – praca na gałęziach funkcjonalnych; Tworzenie krótkotrwałych gałęzi roboczych w celu izolacji prac nad pojedynczą zmianą.
Rebase – Git Rebase Operation – przebazowanie w systemie Git; Operacja liniowego przenoszenia zatwierdzeń na koniec innej gałęzi zapewniająca czystą historię zmian.
Merge – Git Merge Operation – scalanie gałęzi w Git; Połączenie historii dwóch odrębnych linii rozwojowych za pomocą dedykowanego zatwierdzenia scalającego.

8/55 Git w pracy zespołu
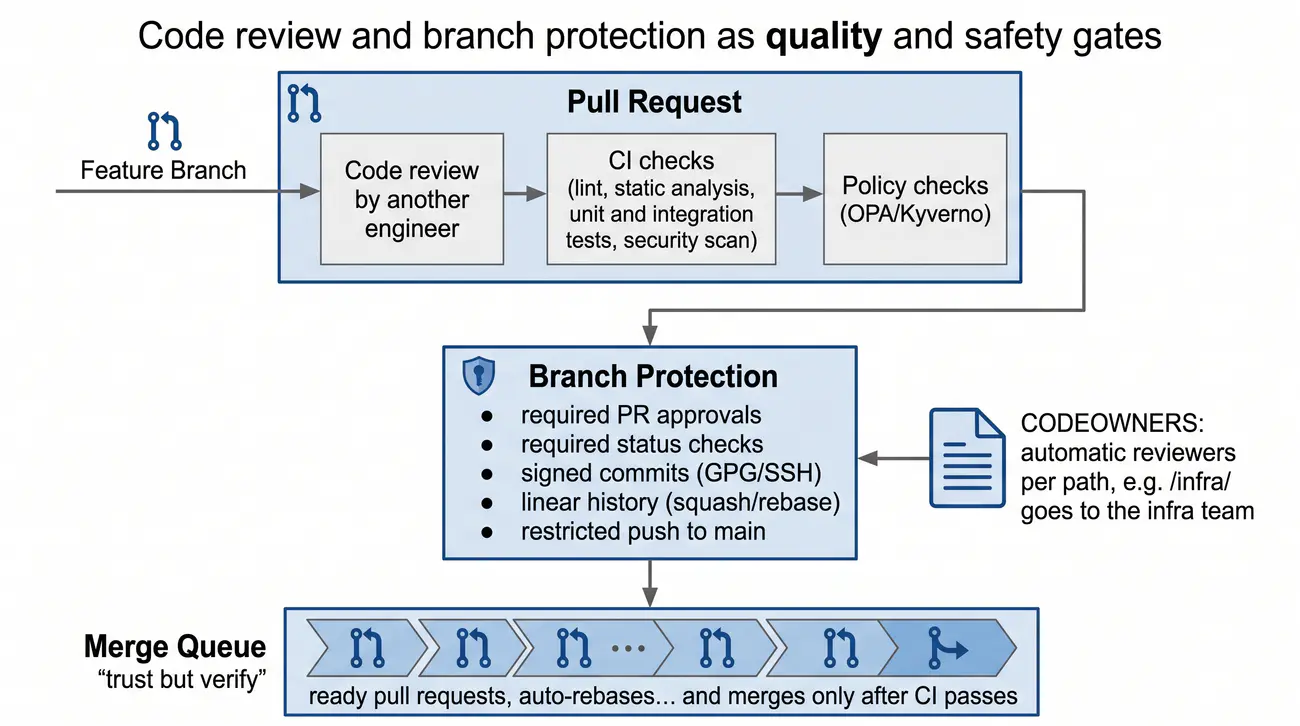
Code Review i ochrona gałęzi: Code Review to bramka jakości - każda zmiana musi być sprawdzona przed scaleniem. Ochrona gałęzi (Branch Protection) wymusza: obowiązkowe recenzje PR, wymagane kontrole CI, podpisywane commity i liniową historię. Razem wzmacniają jakość i bezpieczeństwo kodu.

Zmiana wchodzi przez bramki: review ludzi, kontrole maszyn i ochrona gałęzi. Jakość zamiast „ufam Ci”.

  • Granularna recenzja zmian – inspekcja diffa przed commitem pozwala wykryć omyłkowo dodane hasła, pliki tymczasowe oraz błędy składniowe.
  • Czytelność historii zmian – regularne przeglądanie różnic ułatwia zrozumienie ewolucji architektury systemu i zamysłu innych autorów.
  • Testy zmian konfiguracyjnych – automatyczne narzędzia analizują diffy manifestów w poszukiwaniu naruszeń reguł bezpieczeństwa IT.
  • Ograniczanie rozmiaru wdrożeń – tworzenie mniejszych, czytelnych wniosków pull request przyspiesza recenzję i redukuje ryzyko pomyłek.
  • Wzajemna edukacja zespołu – dyskusja nad różnicami w kodzie podczas recenzji buduje wspólne standardy inżynierskie i podnosi jakość.
Branch Protection: Ochrona gałęzi wymuszająca recenzje PR, kontrole CI, podpisane commity i liniową historię; bramka jakości kodu.
PR

Praca zespołowa w modelu Git opiera się na trzech filarach: code review, Continuous Integration uruchamianej na Pull Requestach oraz ochronie gałęzi (Branch Protection). Kod nie trafia do produkcji bez przeglądu - to nie biurokracja, lecz inżynieria jakości. Recenzujący sprawdza poprawność, bezpieczeństwo, wydajność, utrzymywalność, kompletność testów i dokumentacji, a zespół dzieli się przy okazji wiedzą o systemie. Proces Pull Request wygląda standardowo: utworzenie gałęzi, commity, push, otwarcie PR, kontrole CI, recenzja, zatwierdzenie i scalenie.

Continuous Integration na Pull Request oznacza, że automatyczny potok sprawdza każdą proponowaną zmianę: lint i analiza statyczna (np. yamllint, hadolint, shellcheck), testy jednostkowe i integracyjne, skanowanie bezpieczeństwa (Trivy, Grype) oraz kontrole zasad (policies). Te kroki muszą zakończyć się sukcesem, zanim scalenie będzie dozwolone - GitHub wymusza to mechanizmem wymaganych kontroli (required status checks). Takie podejście "fail fast" pozwala wyłapać błędy na najwcześniejszym etapie, zamiast wykrywać je w produkcji.

Ochrona gałęzi (Branch Protection) to zasady egzekwowane na gałęzi produkcyjnej: co najmniej jedna czy dwie akceptacje recenzentów, obowiązkowe kontrole CI, podpisywane commity (GPG/SSH), liniowa historia (tylko squash/rebase), ograniczenie praw do wypychania oraz plik CODEOWNERS, który automatycznie przydziela recenzentów na podstawie ścieżek - np. zmiany w /infra/ trafiają do zespołu infra. Współczesne platformy oferują też kolejkę scalania (Merge Queue), która sekwencjonuje gotowe PR-y, automatycznie aktualizuje je do najnowszego main i scala dopiero po przejściu CI. Eliminuje to "wyścigi", w których dwa PR-y nawzajem się unieważniają. Całość tworzy zasadę "trust but verify": ufamy ludziom, ale system weryfikuje każdą zmianę.

Wyjaśnienie skrótów użytych na slajdzie:
PR – Pull Request – propozycja włączenia zmian; Platformowy mechanizm (GitHub, Bitbucket) inicjujący formalną procedurę recenzji i testów kodu.
MR – Merge Request – żądanie scalenia kodu; Odpowiednik Pull Requesta stosowany w platformie GitLab do kontroli zmian w repozytorium.
CodeReview – Peer Code Review – wzajemna recenzja kodu; Praktyka inżynierska polegająca na weryfikacji manifestów przez co najmniej jednego niezależnego inżyniera.
CI – Continuous Integration – ciągła integracja; Automatyczne uruchamianie testów składniowych (linterów) i skanerów bezpieczeństwa dla każdego PR.
Approval – Formal Change Approval – formalna akceptacja zmiany; Wymóg uzyskania zgody od uprawnionego właściciela kodu (CODEOWNERS) przed scaleniem.

9/55 Wprowadzenie do ArgoCD
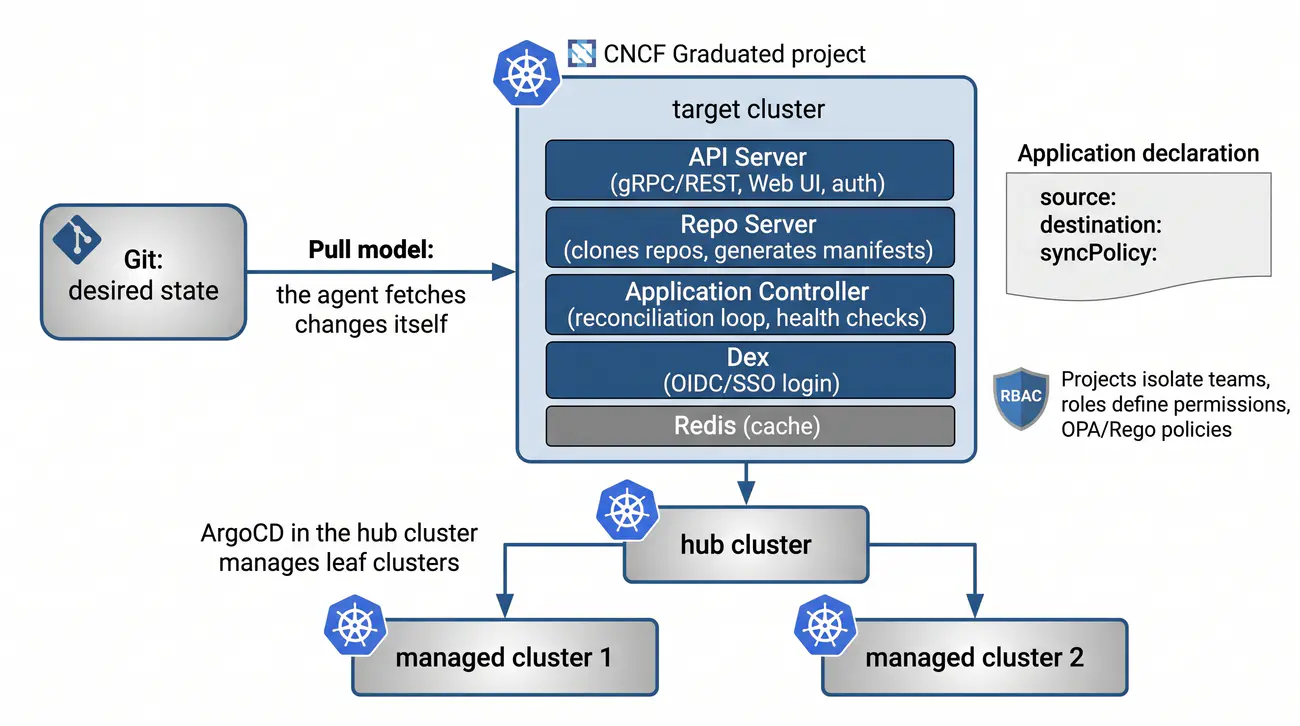
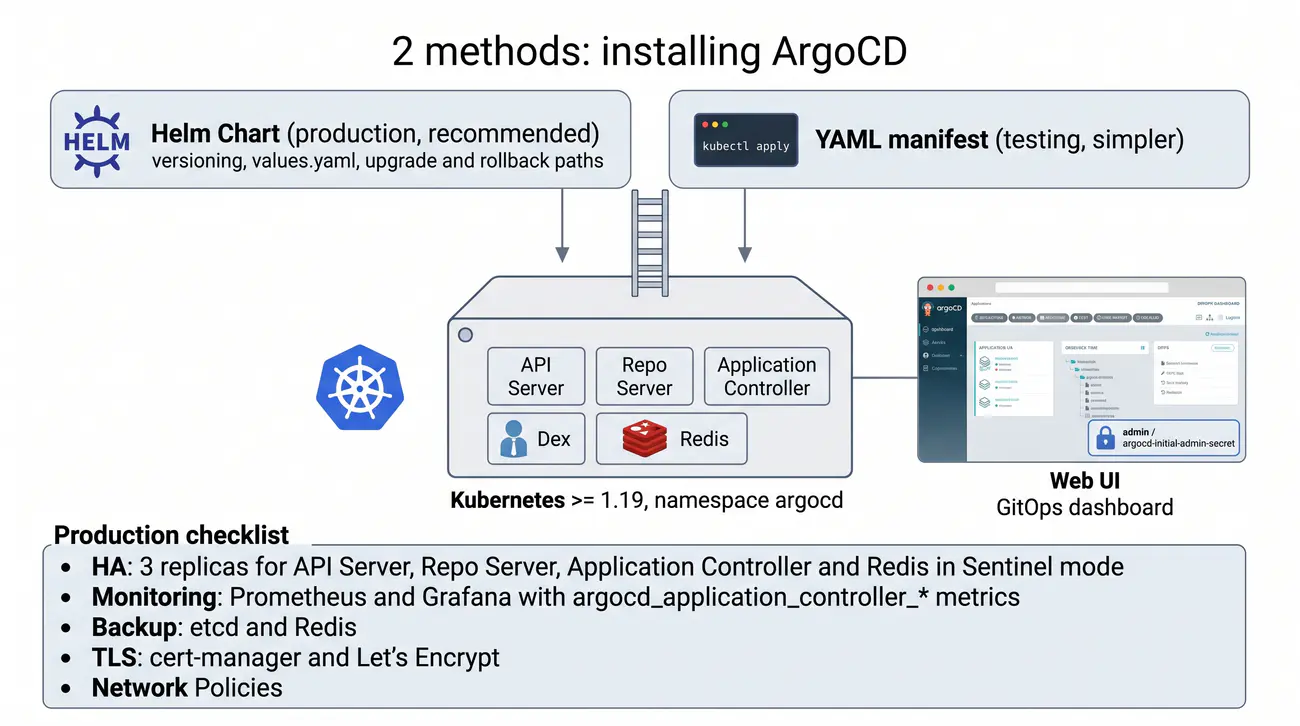
ArgoCD - silnik GitOps: najpopularniejsze narzędzie Continuous Delivery w modelu GitOps dla Kubernetes (projekt CNCF Graduated). Działa w modelu Pull: agent działający w klastrze sam pobiera zmiany z Git. W jego skład wchodzą: API Server, Repo Server, Application Controller, Dex (OIDC) oraz Redis.

ArgoCD to kontroler w klastrze: patrzy w Git, porównuje z żywym stanem i doprowadza do zgodności.

  • Zarządzanie przez ArgoCD – to wiodący kontroler GitOps dla platformy Kubernetes, działający jako natywny operator wewnątrz klastra.
  • Pobieranie manifestów – narzędzie cyklicznie odpytuje repozytorium Git i interpretuje pliki w formatach czystego YAML, Kustomize lub Helm.
  • Wizualny pulpit nawigacyjny – interfejs graficzny w przeglądarce prezentuje w czasie rzeczywistym pełne drzewo zależności obiektów klastra.
  • Automatyczna rekonsyliacja – po wykryciu różnic ArgoCD potrafi natychmiast zaktualizować aplikację lub powiadomić dyżurnego o dryfie.
  • Bezpieczne delegowanie ról – dzięki systemowi uprawnień RBAC programiści mogą wdrażać własne usługi bez konieczności praw roota na klastrze.
Model Pull: Agent w klastrze pobiera zmiany z Git; komponenty ArgoCD: API Server, Repo Server, Application Controller, Dex (OIDC), Redis.
ArgoCD
Model Pull vs Push w GitOps: Dlaczego w GitOps tak mocno promuje się model Pull (reprezentowany przez ArgoCD)? W tradycyjnym modelu Push potok CI (np. GitHub Actions) musiał posiadać uprawnienia roota do klastra Kubernetes i wysyłać tam polecenia. Gdyby serwer CI został skompromitowany, napastnik przejąłby całą produkcję! W modelu Pull to ArgoCD (działający wewnątrz bezpiecznego klastra) odpytuje repozytorium Git przez zwykłe HTTPS. Klaster nie wystawia żadnych portów do Internetu, a potok CI nie zna poświadczeń klastra.

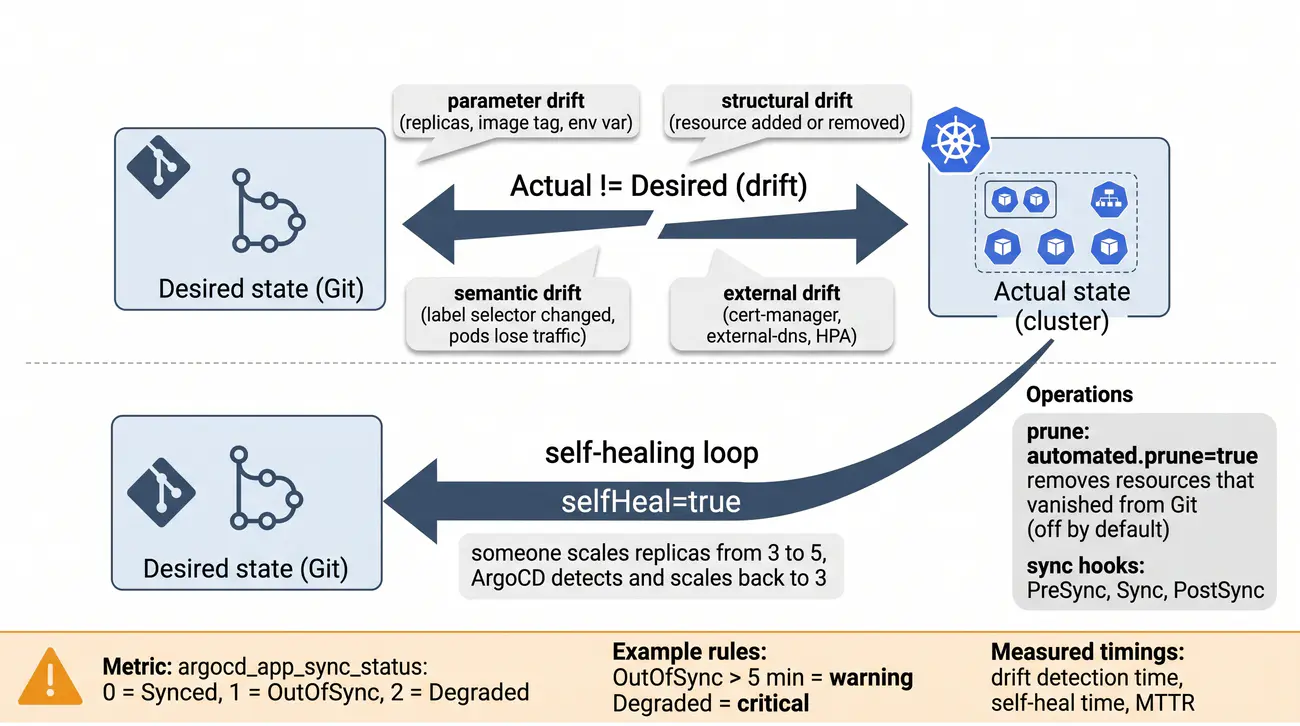
Kontroler ArgoCD implementuje pętlę sterowania w klastrze Kubernetes. Cyklicznie porównuje stan pożądany zapisany w gałęzi Git ze stanem rzeczywistym pobranym z API serwera. W przypadku wykrycia ręcznych modyfikacji w klastrze (stan OutOfSync) mechanizm automatycznej synchronizacji (Self-Healing) natychmiast przywraca stan zadeklarowany w repozytorium, uniemożliwiając powstawanie nieudokumentowanych zmian na produkcji.

ArgoCD to najpopularniejsze narzędzie ciągłego dostarczania (Continuous Delivery) w modelu GitOps dla Kubernetes. Jest projektem o statusie Graduated w fundacji CNCF, co potwierdza jego dojrzałość. Z technicznego punktu widzenia ArgoCD to kontroler Kubernetes, który realizuje wzorzec GitOps: monitoruje repozytorium Git, porównuje stan pożądany (manifesty w Git) ze stanem aktualnym (odpowiedzi API Kubernetes) i automatycznie doprowadza klaster do zgodności. Pracuje w modelu Pull - agent w klastrze sam pobiera zmiany z Git, dzięki czemu CI nie musi przechowywać uprawnień do środowiska produkcyjnego, a dodanie kolejnego klastra sprowadza się do uruchomienia kolejnego agenta.

Fundamentalnym pojęciem jest Application - deklaracja opisująca, skąd pochodzą manifesty (source: repozytorium, ścieżka, wersja), dokąd trafiają (destination: klaster i namespace) i w jaki sposób są wdrażane (sync policy). W architekturze ArgoCD pracuje kilka komponentów: API Server (interfejs gRPC/REST, UI, uwierzytelnianie), Repo Server (klonowanie repozytoriów i generowanie manifestów), Application Controller (pętla rekonsyliacji, synchronizacja i kontrole stanu zdrowia), Dex (integracja logowania OIDC/SSO) oraz Redis (cache). Zarządzanie odbywa się przez Web UI, CLI oraz - co szczególnie ważne w GitOps - deklaratywnie, czyli manifestami Application.

W środowisku z wieloma klastrami ArgoCD uruchamiany w klastrze centralnym (hub) zarządza klastrami podległymi (managed). To upraszcza nadzór, ale wymaga przemyślanej kontroli dostępu: projekty izolują zespoły, role definiują uprawnienia, a polityki OPA/Rego potrafią wymusić dodatkowe zasady. W połączeniu z obsługą Helm, Kustomize i Jsonnet ArgoCD daje praktycznie wszystkie mechanizmy, o których będziemy mówić w dalszej części wykładu: synchronizację, samo-naprawę, wykrywanie dryftu i rollback.

Wyjaśnienie skrótów użytych na slajdzie:
ArgoCD – Argo CD GitOps Controller – kontroler GitOps ArgoCD; Wiodące, otwarte narzędzie deklaratywnego wdrażania aplikacji dla platformy Kubernetes.
CNCF – Cloud Native Computing Foundation – Fundacja Oprogramowania Chmurowego; Środowisko, w którym projekt ArgoCD posiada status dojrzałego projektu (Graduated).
CRD – Custom Resource Definition – niestandardowa definicja zasobu; Mechanizm rozszerzający API Kubernetesa o obiekty specyficzne dla ArgoCD (Application, AppProject).
K8s – Kubernetes – platforma orkiestracji Kubernetes; Docelowy system, w którym kontroler ArgoCD zarządza stanem aplikacji.
UI – User Interface – graficzny interfejs użytkownika; Konsola webowa ArgoCD wizualizująca drzewo zależności zasobów i stan synchronizacji w czasie rzeczywistym.

10/55 Koncepcja synchronizacji ArgoCD
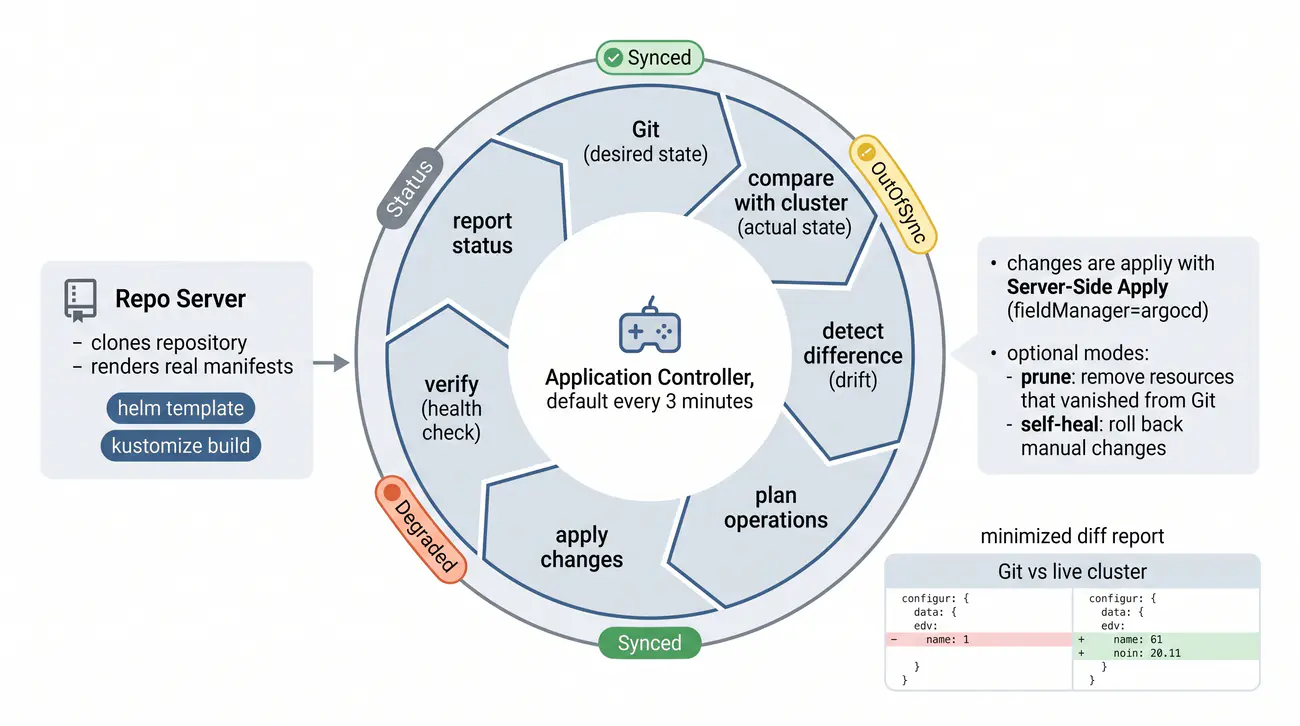
Pętla rekonsyliacji (Reconciliation Loop): ciągły cykl: Git (stan pożądany) → porównanie z klastrem (stan aktualny) → wykrycie rozbieżności (dryft) → zaplanowanie operacji → zastosowanie zmian → weryfikacja (health check) → raportowanie statusu (Synced/OutOfSync/Degraded).

Synchronizacja to pętla, nie akcja: Git → porównanie → plan → apply → weryfikacja → raport. Co 3 minuty.

  • Serwer API ArgoCD – odpowiada za uwierzytelnianie użytkowników, egzekwowanie ról RBAC oraz obsługę interfejsu WWW i narzędzia CLI.
  • Serwer repozytoriów – klonuje kod z systemu Git i renderuje ostateczne manifesty Kubernetes za pomocą silników Kustomize lub Helm.
  • Główny kontroler aplikacji – nieustannie porównuje wygenerowany stan docelowy ze stanem obiektów pobranym z API platformy Kubernetes.
  • Moduł powiadomień – potrafi wysyłać natychmiastowe komunikaty na kanały Slack lub Discord w przypadku sukcesu lub błędu wdrożenia.
  • Skalowalność architektury – wszystkie komponenty ArgoCD można skalować horyzontalnie w celu obsługi tysięcy aplikacji produkcyjnych.
Stany Synced/OutOfSync/Degraded: Statusy synchronizacji aplikacji - zgodny, rozjechany (dryft) lub zdegradowany po health checku.
sync

Mechanizm detekcji dryftu w ArgoCD natychmiast alarmuje o rozbieżnościach między definicją w Git a środowiskiem produkcyjnym.

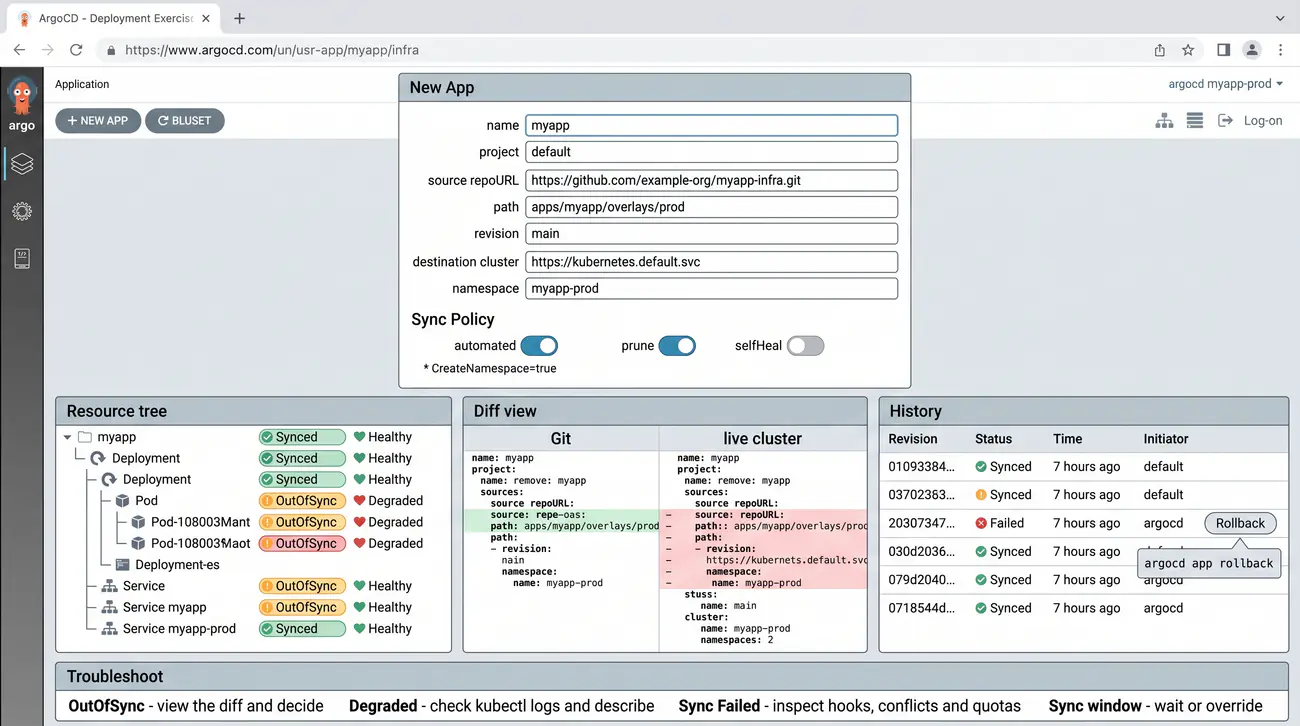
Synchronizacja w ArgoCD nie jest jednorazowym zdarzeniem, lecz ciągłą pętlą, która doprowadza stan klastra (stan aktualny) do stanu zdefiniowanego w Git (stan pożądany). To dokładnie ten sam wzorzec pętli rekonsyliacji, na którym oparty jest cały Kubernetes. Application Controller, domyślnie co trzy minuty, wykonuje pełny cykl: pobiera z repozytorium manifesty, odczytuje stan klastra, wylicza różnicę, układa plan operacji (utwórz, zaktualizuj, usuń, połataj), stosuje go w odpowiedniej kolejności, a na końcu weryfikuje stan zdrowia zasobów i raportuje wynik.

Jak wygląda ten proces krok po kroku? Najpierw Repo Server klonuje i aktualizuje repozytorium, a następnie generuje rzeczywiste manifesty (uruchamia helm template, kustomize build itd.). Potem Application Controller porównuje te manifesty z tym, co faktycznie istnieje w klastrze, i przygotowuje plan zmian. Zmiany są stosowane mechanizmem Server-Side Apply, który precyzyjnie rozlicza, kto jest właścicielem poszczególnych pól (fieldManager=argocd). Opcjonalnie działa prune - usuwanie zasobów, które zniknęły z Git, oraz self-heal - automatyczne cofanie ręcznych zmian wykrytych w klastrze. Po zastosowaniu zmian ArgoCD sprawdza stan zdrowia (health check), np. czy Deployment osiągnął żądaną liczbę replik.

Wynik każdej iteracji jest raportowany w interfejsie i w metrykach: status synchronizacji (Synced - zgodny, OutOfSync - wykryto rozbieżności, Degraded - błędy zdrowia), stan zdrowia (Healthy/Degraded), historia synchronizacji oraz szczegółowy raport różnic między Git a klastrem. To daje operatorowi pełną, nieustannie aktualizowaną odpowiedź na pytanie: czy klaster jest zgodny z tym, co mamy zapisane w Git? Dzięki temu GitOps realizuje obietnicę "samonaprawiającej się infrastruktury": stan rzeczywisty wraca do pożądanego, nawet jeśli ktoś ręcznie coś zmieni.

Wyjaśnienie skrótów użytych na slajdzie:
Sync – ArgoCD Synchronization Phase – faza synchronizacji ArgoCD; Proces aplikowania zmian z repozytorium Git do klastra za pomocą operacji kubectl apply.
Drift – Configuration Drift Condition – stan dryftu konfiguracyjnego; Wykrycie rozbieżności pomiędzy wartością parametru w Git a wartością w klastrze.
OutOfSync – OutOfSync Application Status – status braku synchronizacji; Stan w ArgoCD oznaczający, że stan rzeczywisty w klastrze różni się od stanu zadeklarowanego w repozytorium.
Synced – Synced Application Status – status pełnej synchronizacji; Pożądany stan informujący, że obiekty w klastrze są w 100% zgodne z commitami w repozytorium.
Health – Resource Health Assessment – ocena zdrowia zasobu; Weryfikacja czy wdrożone pody poprawnie przeszły testy gotowości i realizują ruch produkcyjny.

11/55 Zainstalowanie ArgoCD (wstęp)
Instalacja ArgoCD: Dwa główne sposoby: Helm Chart (zalecane w produkcji - wersjonowanie, aktualizacje i rollback) oraz manifest YAML (prostsze, do testów). W produkcji wymagane: wysoką dostępność (HA, 3 repliki), Monitoring (Prometheus), Backup oraz TLS (cert-manager).

Instalacja na produkcję to Helm, na testy wystarczy YAML. Potem HA, monitoring, backup i TLS.

  • Obiekt Application CRD – podstawowy zasób konfiguracyjny łączący konkretne repozytorium kodu z docelową przestrzenią nazw na klastrze.
  • Parametry źródła kodu – w definicji wskazuje się adres repozytorium Git, ścieżkę do katalogu z manifestami oraz docelowy branch lub tag.
  • Wskazanie celu wdrożenia – sekcja docelowa określa adres API klastra Kubernetes oraz nazwę przestrzeni nazw dla uruchamianych podów.
  • Polityka synchronizacji – decyduje o tym, czy wdrożenie ma następować automatycznie po wykryciu commita, czy wymaga ręcznego kliknięcia.
  • Wersjonowanie wdrożeń – sam manifest Application jest przechowywany w Git, co pozwala zarządzać wdrożeniami tak samo jak aplikacjami.
Helm Chart: Zalecany sposób instalacji ArgoCD na produkcję (wersjonowanie, aktualizacje, rollback); z HA (3 repliki), monitoringiem, backupem i TLS.
instalacja

Instalację ArgoCD można przeprowadzić na kilka sposobów. Najprostszy, nadający się do środowisk testowych, to nałożenie oficjalnego manifestu YAML poleceniem kubectl apply. Dla produkcji standardem jest Helm Chart (argo/argo-cd), który daje wersjonowanie, kontrolę parametrów w values.yaml oraz ścieżki aktualizacji i rollbacku. Bardziej zaawansowani użytkownicy sięgają po Kustomize (overlay na bazowym manifeście, często po to, by ArgoCD zarządzał samym sobą - patrz wzorzec "ArgoCD manages ArgoCD"), a na OpenShift instalacja może przejść przez Operator Lifecycle Manager. Niezależnie od metody potrzebujemy klastra Kubernetes 1.19+ oraz przestrzeni nazw argocd, w której znajdą się API Server, Repo Server, Application Controller, Dex i Redis.

Po instalacji dostęp do ArgoCD idzie przez Web UI (usługa argocd-server, port 80/443) lub CLI. Przed udostępnieniem przez Ingress można użyć port-forward: kubectl port-forward svc/argocd-server -n argocd 8080:443. Domyślne logowanie to admin z hasłem odczytanym z sekretu argocd-initial-admin-secret. Web UI to operacyjny pulpit GitOps: widzimy listę aplikacji z aktualnym statusem, drzewo zasobów, różnice między Git a klastrem, historię synchronizacji i opcje rollbacku. W ustawieniach konfigurujemy repozytoria, klastry, projekty i certyfikaty, a dostęp kontrolujemy przez RBAC (projekty, role, polityki OPA/Rego) oraz integrację SSO przez Dex (OIDC, SAML, LDAP, GitHub).

Środowisko produkcyjne wymaga więcej niż domyślnej instalacji. Po pierwsze wysokiej dostępności: trzy repliki API Server, Repo Server i Application Controller oraz Redis w trybie Sentinel lub Cluster. Dochodzą limity zasobów, wolumeny trwałe dla Redis, Ingress z TLS (cert-manager + Let's Encrypt), izolacja sieciowa (Network Policies) i zabezpieczenia typu PodDisruptionBudget oraz anti-affinity rozpraszające pody po węzłach. Monitoring opiera się na metrykach Prometheus (argocd_application_controller_*, argocd_repo_server_*) i gotowych dashboardach Grafana. Backup obejmuje stan przechowywany w Secrets/ConfigMaps oraz Redis, a procedura Disaster Recovery sprowadza się do przywrócenia danych i ponownej synchronizacji z Git. Wreszcie w dużych organizacjach ArgoCD samo bywa instalowane i zarządzane w modelu GitOps - jako aplikacja zdefiniowana... w samym ArgoCD.

Wyjaśnienie skrótów użytych na slajdzie:
Helm – Helm Package Manager – menedżer pakietów Helm; Popularne narzędzie wykorzystywane do instalacji serwera ArgoCD w klastrze Kubernetes.
Kustomize – Kustomize Manifest Engine – silnik manifestów Kustomize; Alternatywny mechanizm bezszablonowego wdrażania stosu ArgoCD na węzłach.
CLI – Command Line Interface – interfejs wiersza poleceń; Narzędzie argocd CLI służące do zarządzania aplikacjami, klastrami i repozytoriami z poziomu terminala.
RBAC – Role-Based Access Control – kontrola dostępu oparta na rolach; System uprawnień gwarantujący separację dostępu inżynierów do poszczególnych projektów w ArgoCD.
Namespace – Kubernetes Logical Namespace – przestrzeń nazw w Kubernetes; Wyizolowany logicznie obszar klastra (zwykle argocd), w którym instalowane są komponenty kontrolera.

12/55 Tworzenie aplikacji w ArgoCD
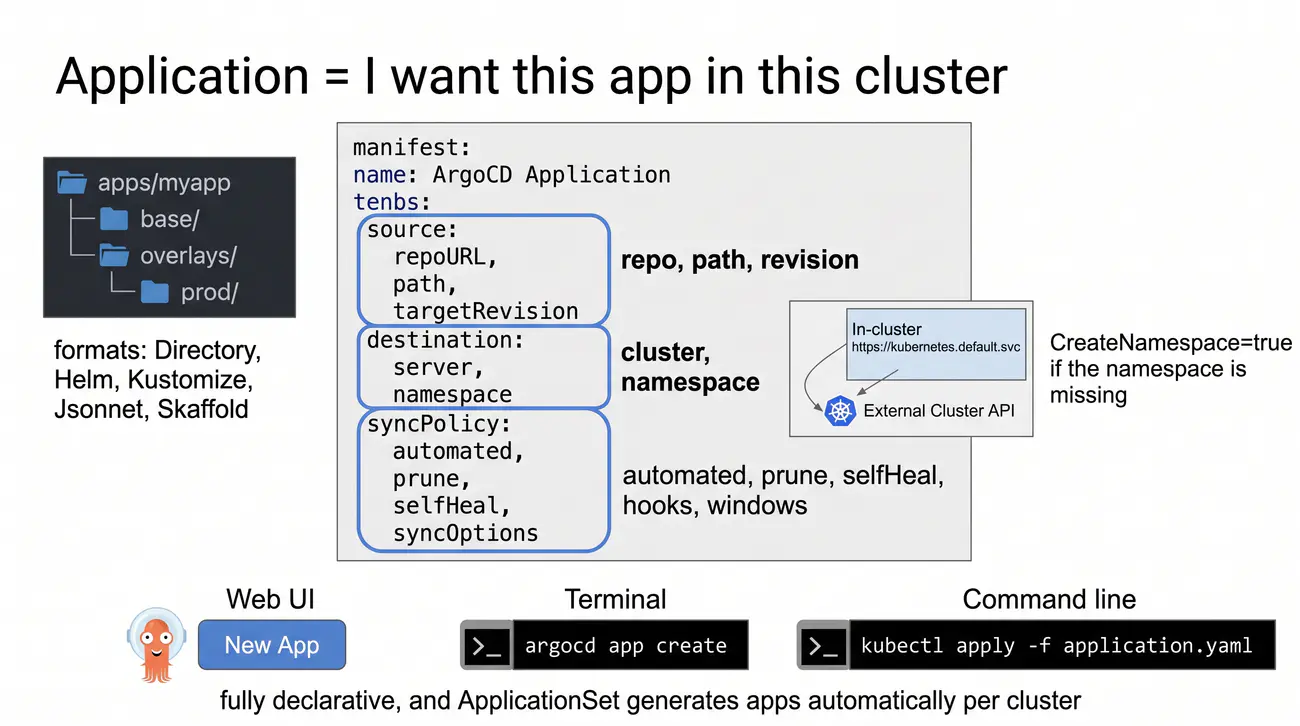
Application CRD: Podstawowa jednostka zarządzania w ArgoCD. Definiuje: source (repo Git, ścieżka, revision), destination (klaster, namespace), syncPolicy (automated, prune, selfHeal, hooks, windows). Application to deklaracja "chcę tę aplikację w tym klastrze".

Application to jedno zdanie: „chcę tę aplikację w tym klastrze”. Source, destination i syncPolicy wystarczą.

  • Generatory ApplicationSet – rozszerzają ArgoCD, umożliwiając automatyczne generowanie dziesiątek aplikacji na bazie wspólnego szablonu.
  • Zarządzanie wieloma środowiskami – generator list pozwala powołać aplikacje dla środowisk dev, stage i prod z jednego wspólnego szablonu.
  • Automatyzacja dołączania klastrów – generator klastrów instaluje wymagany zestaw narzędzi pomocniczych na każdym nowo dodanym klastrze.
  • Eliminacja duplikacji kodu – zastosowanie generatorów usuwa konieczność ręcznego powielania setek niemal identycznych plików manifestów.
  • Wsparcie platform inżynieryjnych – podejście to jest fundamentem nowoczesnych platform chmurowych zarządzanych przez zespoły platformowe.
syncPolicy: Polityka synchronizacji (automated, prune, selfHeal, hooks, windows); Application to deklaracja „chcę tę aplikację w tym klastrze”.
kreator aplikacji

Application to w ArgoCD fundamentalna jednostka zarządzania - zasób Kubernetes (Application CRD), który opisuje trzy rzeczy: co wdrażamy (source: repozytorium Git, ścieżka, wersja docelowa), gdzie wdrażamy (destination: klaster i przestrzeń nazw) oraz jak wdrażamy (syncPolicy: synchronizacja automatyczna, prune, self-heal, okna czasowe, hooki, kontrole stanu zdrowia). To forma deklaracji "chcę tę aplikację w tym klastrze w tym stanie", a Application Controller nieustannie monitoruje te deklaracje i doprowadza klaster do zadeklarowanego stanu. Aplikację tworzymy przez UI (New App), przez CLI (argocd app create) albo w pełni deklaratywnie: kubectl apply -f application.yaml - wówczas tworzymy ją jak każdy inny zasób Kubernetes, co otwiera drogę do zarządzania samym ArgoCD w modelu GitOps.

Ścieżka źródła to katalog w repozytorium z manifestami aplikacji. ArgoCD obsługuje kilka formatów: katalog czysty (plain YAML), Helm (Chart.yaml z values.yaml), Kustomize (kustomization.yaml z overlayami), Jsonnet i Skaffold. Typowa struktura to apps/myapp/ z katalogami base/ (wspólne manifesty) i overlays/prod/ (przykładowo patch na liczbę replik lub tag obrazu). Celem jest klaster i przestrzeń nazw: dla klastra, w którym działa ArgoCD, używamy https://kubernetes.default.svc (in-cluster), dla pozostałych - URL ich API Server; namespace musi istnieć albo włączamy opcję CreateNamespace=true. Przy wielu klastrach ArgoCD w klastrze centralnym zarządza klastrami podległymi, a generator ApplicationSet potrafi automatycznie tworzyć aplikacje per klaster.

Poniższy przykład pokazuje kompletną, produkcyjną definicję Application: repozytorium z manifestami, gałąź main, ścieżka do Koustomize overlay dla produkcji, synchronizacja automatyczna z prune i self-heal, utworzenie przestrzeni nazw, ponowne próby z backoffem oraz ignorowanie różnic w polu liczb replik (to pole zmienia np. HPA, więc nie powinno być traktowane jako dryft). Całość pokazuje filozofię GitOps w praktyce: zapisujemy deklarację, a ArgoCD zajmuje się resztą.

Wyjaśnienie skrótów użytych na slajdzie:
Application – ArgoCD Application CRD – zasób niestandardowy Application; Podstawowy obiekt w ArgoCD łączący źródłowe repozytorium Git z docelowym klastrem i przestrzenią nazw.
AppProject – ArgoCD AppProject CRD – zasób logiczny projektu; Mechanizm izolacji określający dozwolone repozytoria, klastry i rodzaje zasobów dla grupy aplikacji.
Destination – Target Cluster Destination – docelowy klaster i przestrzeń nazw; Parametr obiektu Application wskazujący adres URL serwera API klastra docelowego.
Source – Git Source Repository – źródłowe repozytorium Git; Wskazanie adresu URL repozytorium, ścieżki do katalogu z manifestami oraz śledzonej gałęzi (targetRevision).
SyncPolicy – Automated Sync Policy – polityka automatycznej synchronizacji; Dyrektywa włączająca automatyczne wdrażanie zmian (automated), samonaprawę (selfHeal) i usuwanie starych zasobów (prune).

13/55 Manifesty (podstawy)
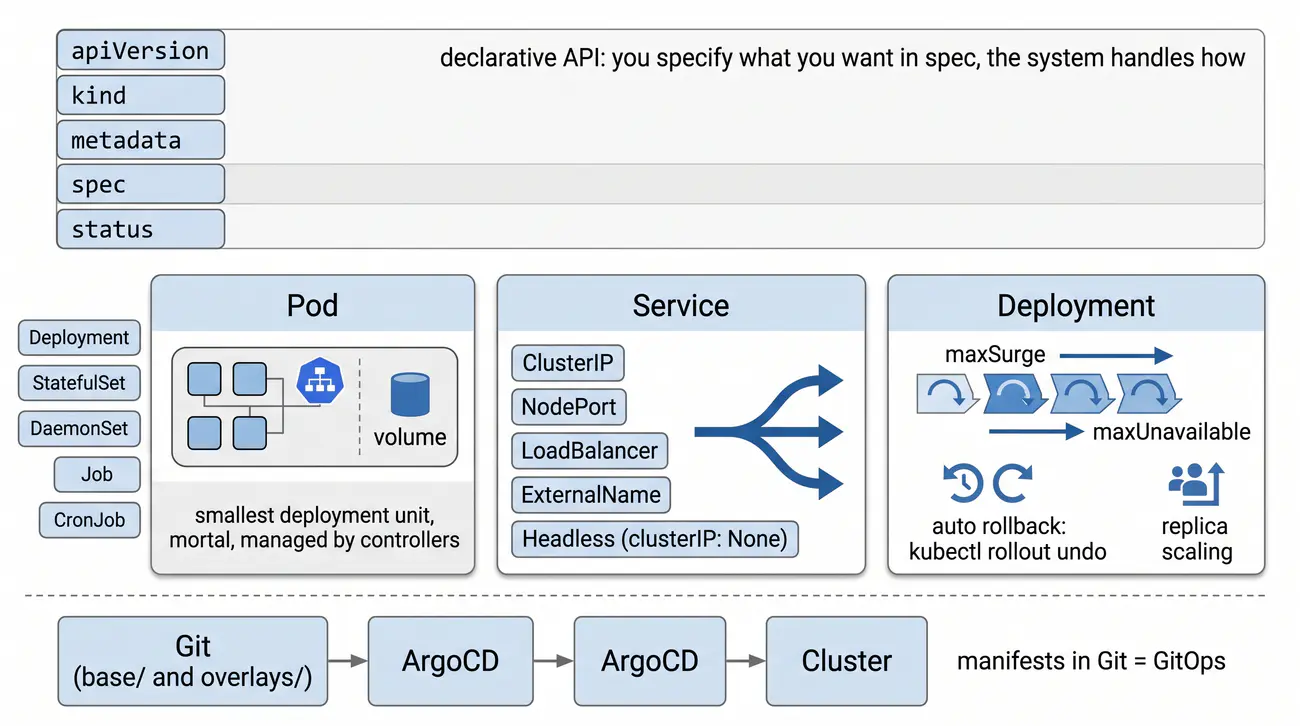
Manifesty Kubernetes: Pliki YAML definiujące pożądany stan zasobów. Kluczowe typy: Pod (jednostka wdrożenia), Service (dostęp i load balancing), Deployment (zarządzanie Podami, rolling update, rollback). Manifesty w Git = GitOps.

Manifest to pożądany stan w YAML: apiVersion, kind, metadata, spec. Pod, Service i Deployment to baza.

  • Statusy synchronizacji i zdrowia – ArgoCD przypisuje każdej aplikacji dwa niezależne stany: zgodność z repozytorium oraz kondycję podów.
  • Stan zsynchronizowany Synced – oznacza, że obiekty uruchomione w klastrze są w pełni tożsame z deklaracją zapisaną w repozytorium Git.
  • Stan braku zgodności OutOfSync – sygnalizuje pojawienie się nowego commita w repozytorium lub ręczną modyfikację obiektów w klastrze.
  • Kondycja zdrowia Healthy – bada rzeczywistą sprawność procesów, weryfikując czy kontenery poprawnie przeszły testy gotowości readiness.
  • Precyzyjna diagnostyka – rozdzielenie pojęć synchronizacji i zdrowia pozwala błyskawicznie ustalić źródło ewentualnej awarii na produkcji.
Deployment: Zasób zarządzający Podami z rolling update i rollbackiem; obok Pod (jednostka) i Service (dostęp/LB) - manifesty w Git to GitOps.
manifest

W zarządzaniu wieloma środowiskami standardem jest bezszablonowe narzędzie Kustomize wbudowane w kubectl. Zamiast kopiowania całych manifestów definiuje się katalog bazowy (base/) zawierający wspólne definicje obiektów oraz katalogi nakładek (overlays/dev, overlays/prod). W nakładkach deklaruje się wyłącznie specyficzne dla danego środowiska modyfikacje (liczbę replik, limity pamięci RAM, domeny Ingress), eliminując duplikację kodu i ryzyko błędów konfiguracyjnych.

Manifest Kubernetes to plik YAML (lub JSON) opisujący pożądany stan zasobu - to właśnie na nim opiera się GitOps, bo ArgoCD czy Flux wdrażają dokładnie to, co jest w nich zdefiniowane. Interfejs API Kubernetes'a jest deklaratywny: w sekcji spec podajemy, czego chcemy, a sam system dba o to, jak to osiągnąć (status). Do najważniejszych typów zasobów należą Pod, Service, Deployment, ConfigMap, Secret, Ingress, PersistentVolumeClaim, ServiceAccount oraz elementy RBAC (Role/RoleBinding). Każdy manifest ma stałą strukturę: apiVersion, kind, metadata, spec, status. Manifest czy interesujący zasób można podejrzeć poleceniem kubectl explain albo wygenerować szkielet przez kubectl create --dry-run=client -o yaml, a do parametryzacji służą natywnie obsługiwane przez ArgoCD narzędzia - Kustomize i Helm. Walidację warto wspomóc kubeconform lub kubeval.

Pod to najmniejsza jednostka wdrożenia - grupa jednego lub więcej kontenerów współdzielących sieć (wspólny adres IP), wolumeny, przestrzeń IPC i grupy cgroups. Pod jest z natury efemeryczny: w przypadku awarii węzła Pod ulega zniszczeniu i nie wznawia się samoczynnie – jego cyklem życia zarządzają kontrolery: Deployment, StatefulSet, DaemonSet, Job czy CronJob. W definicji kontenera najważniejsze pola to obraz, porty, zmienne środowiskowe, progi zasobów (requests/limits) oraz trzy sondy: livenessProbe (czy proces żyje), readinessProbe (czy przyjmuje ruch) i startupProbe (dla wolno startujących procesów). Przed kontenerami głównymi mogą działać kontenery init (migracje bazy, pobieranie konfiguracji), a kontener pomocniczy w tym samym Podzie, czyli sidecar, obsługuje np. zbieranie logów, proxy service mesh czy przeładowywanie konfiguracji.

Service to stabilna abstrakcja dostępu do zbioru Podów, która dodaje load balancing i Service Discovery. Typy: ClusterIP (wewnętrzny adres), NodePort (port na każdym węźle), LoadBalancer (balanser od chmury), ExternalName (alias DNS) i Headless (clusterIP: None - bezpośredni DNS do konkretnych Podów, wykorzystywany z StatefulSet). Service wybiera Pody przez etykiety (selektor), a aplikacje odwołują się do siebie za pomocą nazw DNS w domenie service.namespace.svc.cluster.local - dawna metoda przekazywania adresów i portów przez zmienne środowiskowe odchodzi do lamusa.

Deployment to kontroler zarządzający ReplicaSetami, które z kolei zarządzają Podami, i zapewnia aktualizacje bez przerw (RollingUpdate, sterowany parametrami maxSurge i maxUnavailable), automatyczny rollback do poprzedniej rewizji (kubectl rollout undo), skalowanie liczby replik oraz pauzowanie i wznawianie zmian. Jeśli chodzi o przechowywanie w repozytorium - Git staje się tu pojedynczym źródłem prawdy (Single Source of Truth): manifesty trafiają do base/ (wspólne Deployment, Service, ConfigMap) i overlays/ (różnice środowiskowe), a Kustomize czy Helm dodają parametryzację i patche. Z Git manifesty płyną do ArgoCD, a stamtąd do klastra - to fundament, na którym stoi cały pozostały materiał wykładu.

Wyjaśnienie skrótów użytych na slajdzie:
YAML – YAML Ain't Markup Language – format serializacji YAML; Podstawowy język deklaratywnego zapisu manifestów zasobów platformy Kubernetes.
Deployment – Kubernetes Deployment Controller – kontroler wdrożenia Deployment; Nadrzędny obiekt zarządzający bezstanowymi replikami podów z obsługą aktualizacji kroczących.
Service – Kubernetes Service Abstraction – usługa sieciowa Service; Trwały punkt dostępowy z wewnętrznym adresem IP kierujący ruch do dynamicznie zmieniających się podów.
ConfigMap – Kubernetes ConfigMap Object – obiekt konfiguracji ConfigMap; Zasób przechowujący niemające charakteru poufnego pary klucz-wartość wstrzykiwane do kontenerów.
Secret – Kubernetes Secret Object – obiekt tajemnic Secret; Zasób przechowujący zakodowane w Base64 poufne parametry uwierzytelniające (hasła, klucze).

14/55 Docker Compose w GitOps
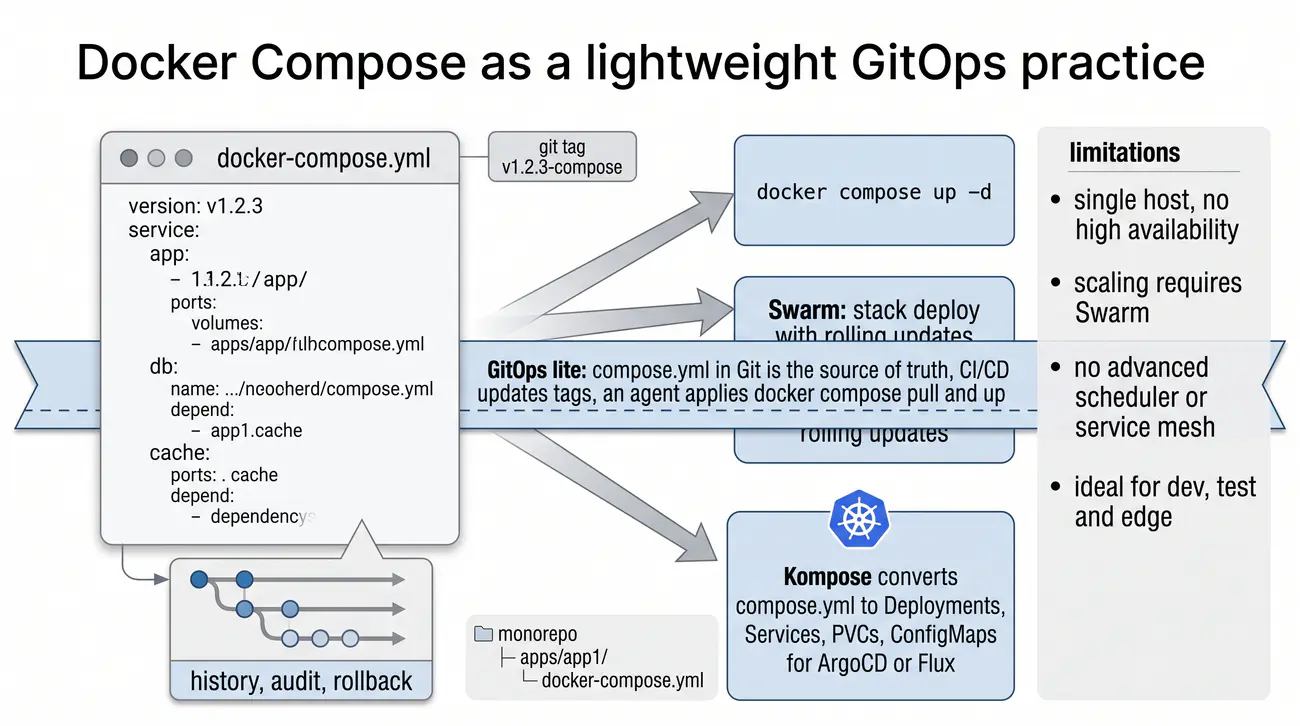
Docker Compose w GitOps: Plik docker-compose.yml wersjonowany w Git daje historię, audyt i rollback - te same korzyści co GitOps w Kubernetes, ale dla środowisk lokalnych. Narzędzie Kompose konwertuje compose.yml na manifesty K8s. Używaj do: dev, test, edge.

Compose w Git to GitOps dla jednego hosta: historia, audyt i rollback jak w K8s, ale lokalnie.

  • Automatyczna synchronizacja – sprawia, że każda zmiana zatwierdzona w repozytorium Git jest natychmiast wdrażana na środowisku klastra.
  • Samoczynna naprawa Self-Heal – natychmiast nadpisuje i cofa wszelkie nieautoryzowane zmiany wprowadzone w klastrze przez polecenia konsoli.
  • Usuwanie zasobów Prune – dba o automatyczne usuwanie z klastra tych obiektów, których manifesty zostały wykasowane z repozytorium kodu.
  • Kontrolowane okna wdrożeń – na produkcji zaleca się stosowanie limitów czasowych w celu ograniczenia ryzyka nagłych awarii poza dyżurem.
  • Tryb manualny w awariach – możliwość tymczasowego wyłączenia automatycznej synchronizacji jest pomocna podczas trudnych akcji naprawczych.
Kompose: Konwerter compose.yml na manifesty K8s; plik Compose w Git daje historię, audyt i rollback dla środowisk lokalnych (dev/test/edge).
compose w Git
CLI · Docker Compose: plik usług
# docker-compose.yml w Git version: '3.8' services: app: build: . ports: - "5000:5000" user@server:~$ git status On branch main

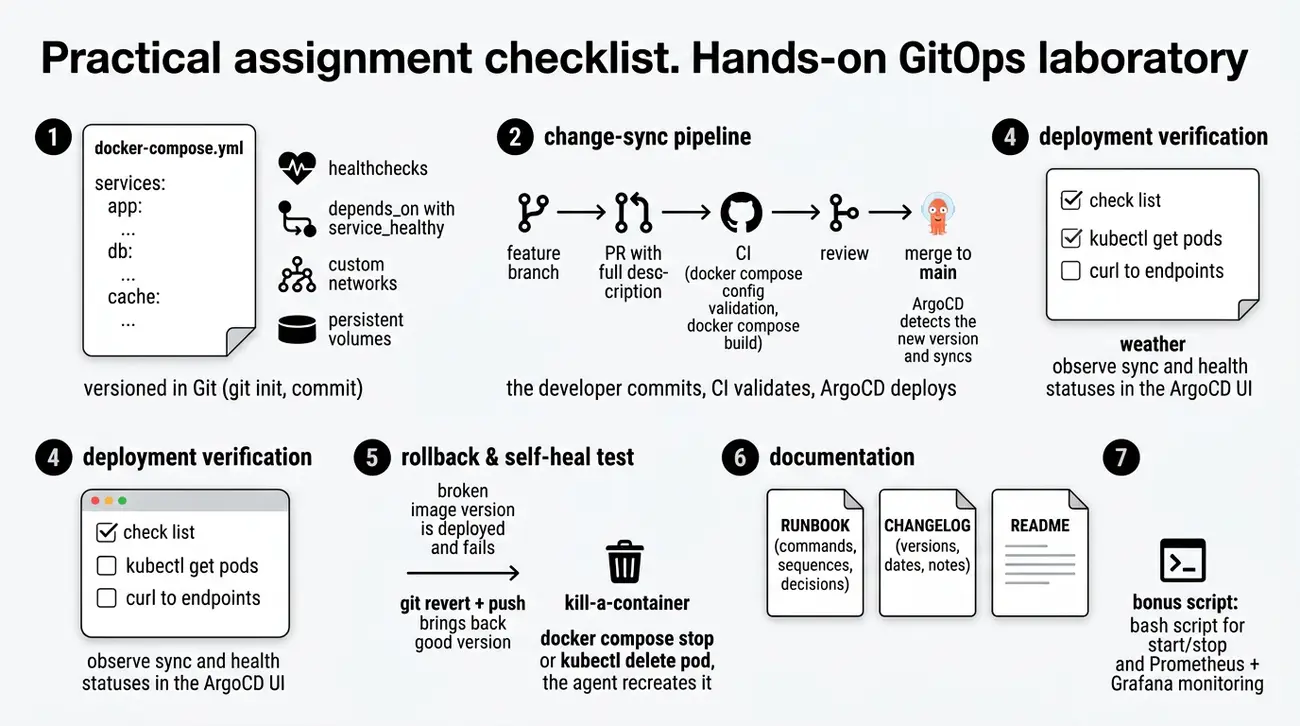
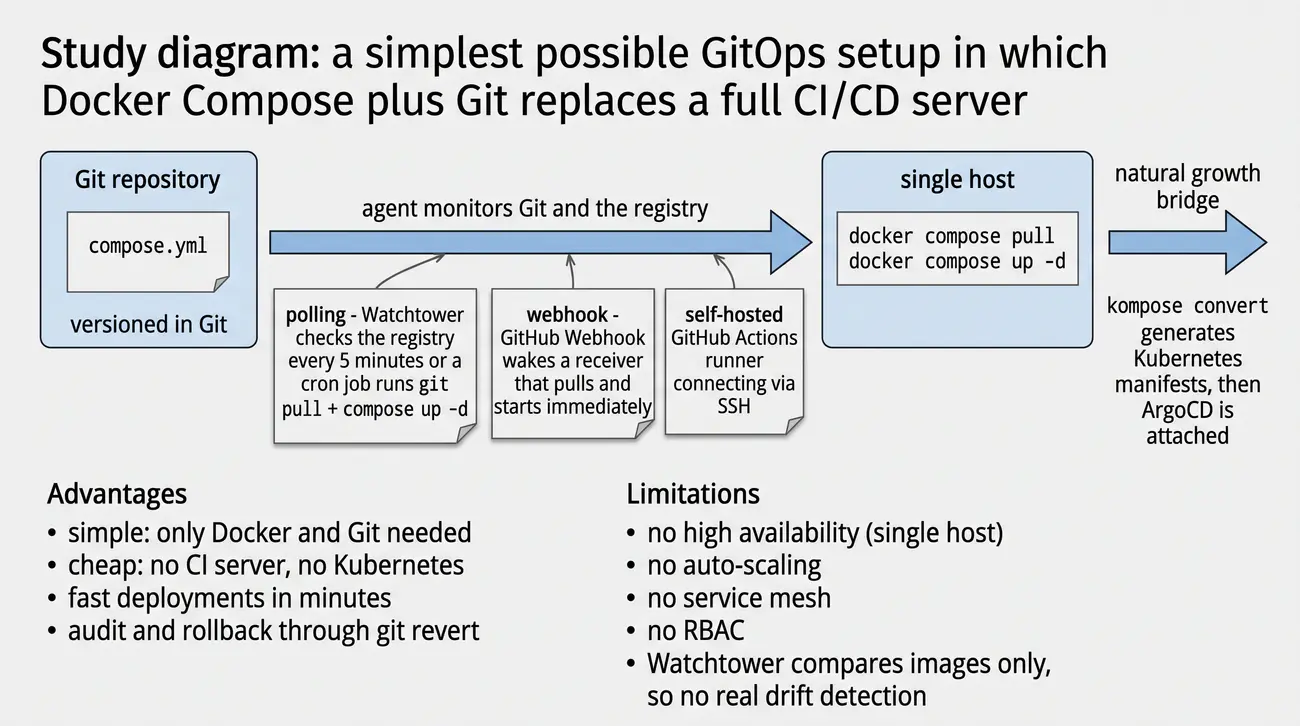
Docker Compose pozwala w prosty sposób definiować i uruchamiać wielokontenerowe aplikacje - i to właśnie dlatego tak dobrze sprawdza się w środowiskach deweloperskich, testowych i prostych produkcyjnych. W pliku docker-compose.yml opisujemy usługi (jakie obrazy, z jakimi portami, wolumenami i zależnościami), sieci, wolumeny oraz ewentualne konfiguracje i sekrety. Wersjonowanie tego pliku w Git daje nam dokładnie te same korzyści co GitOps w Kubernetes: historię zmian, możliwość przejrzenia kodu (code review), natychmiastowy rollback przez git revert oraz pełny audyt, kto i co zmienił. Niezależnie od tego, czy mówimy o pojedynczym hoście z docker compose up -d, o klastrze Swarm ze stack deploy, czy o konwersji pliku Compose na manifesty Kubernetes narzędziem Kompose - zasada pozostaje ta sama: definicja aplikacji jest trzymana w Git jako pojedyncze źródło prawdy.

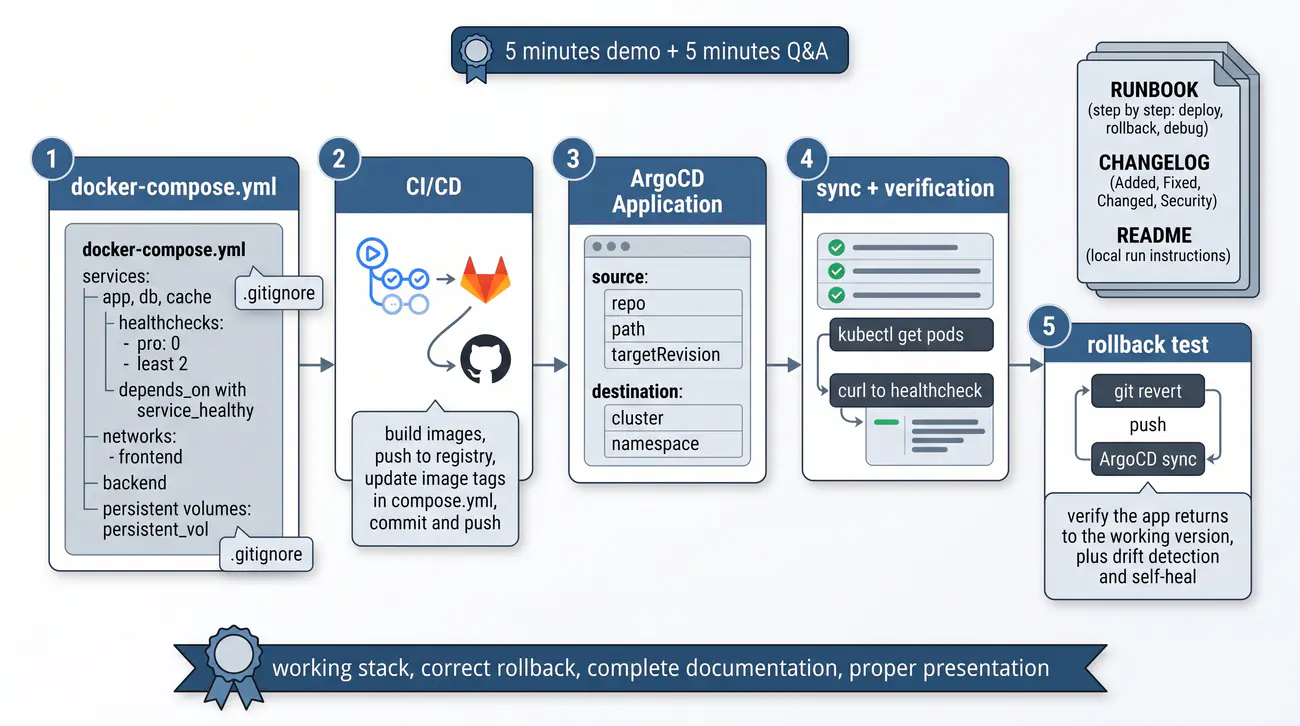
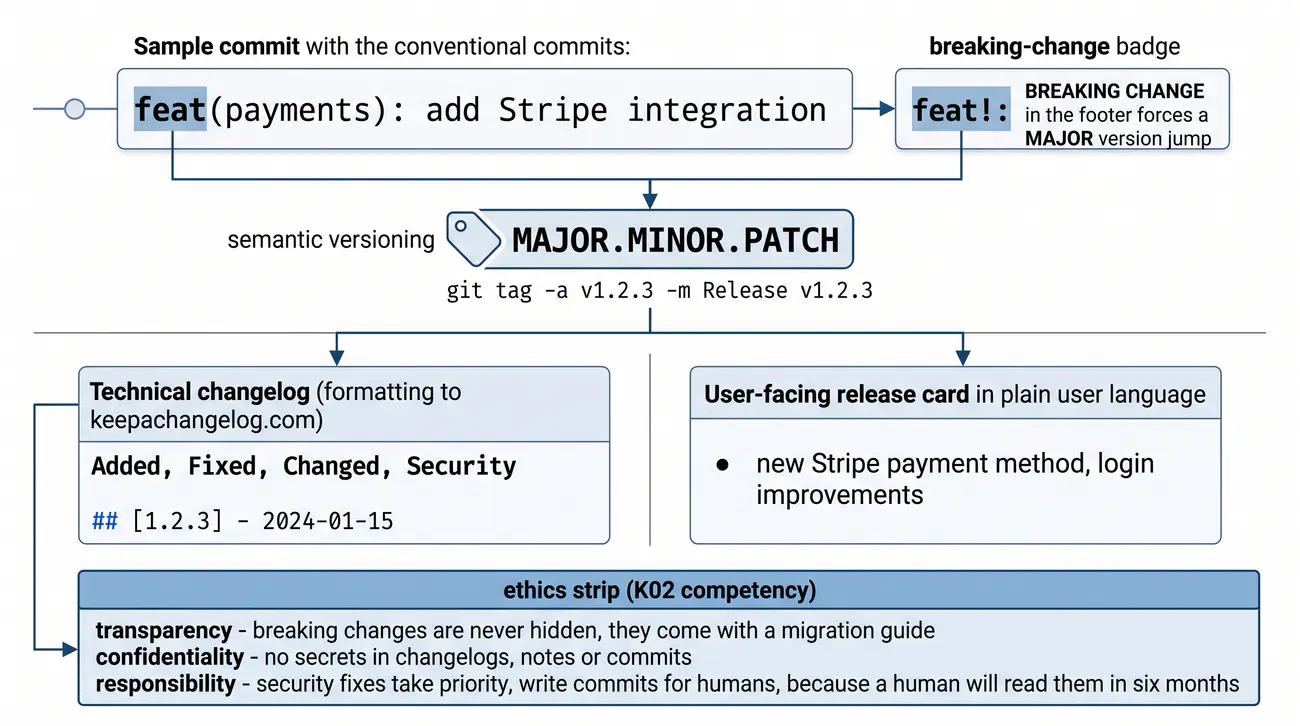
Wersjonowanie oznacza, że każda zmiana - dodanie serwisu, podmiana obrazu, zmiana portu czy montowanie nowego wolumenu - przechodzi przez commit i Pull Request. W Git można też tagować wersje stacku (git tag v1.2.3-compose), używać gałęzi feature i hotfix oraz trzymać wiele plików Compose w tzw. monorepo (apps/app1/docker-compose.yml, apps/app2/docker-compose.yml). Ciekawostką są profile: jeden plik może definiować warstwę frontendu i backendu, a włączamy ją poleceniem docker compose --profile frontend up. CI/CD w takim ustawieniu to pipeline, który buduje obrazy, aktualizuje tagi w compose.yml i wypycha zmiany do Git; dalej działa już mechanizm znany z GitOps - agent na hoście wykonuje docker compose pull i up.

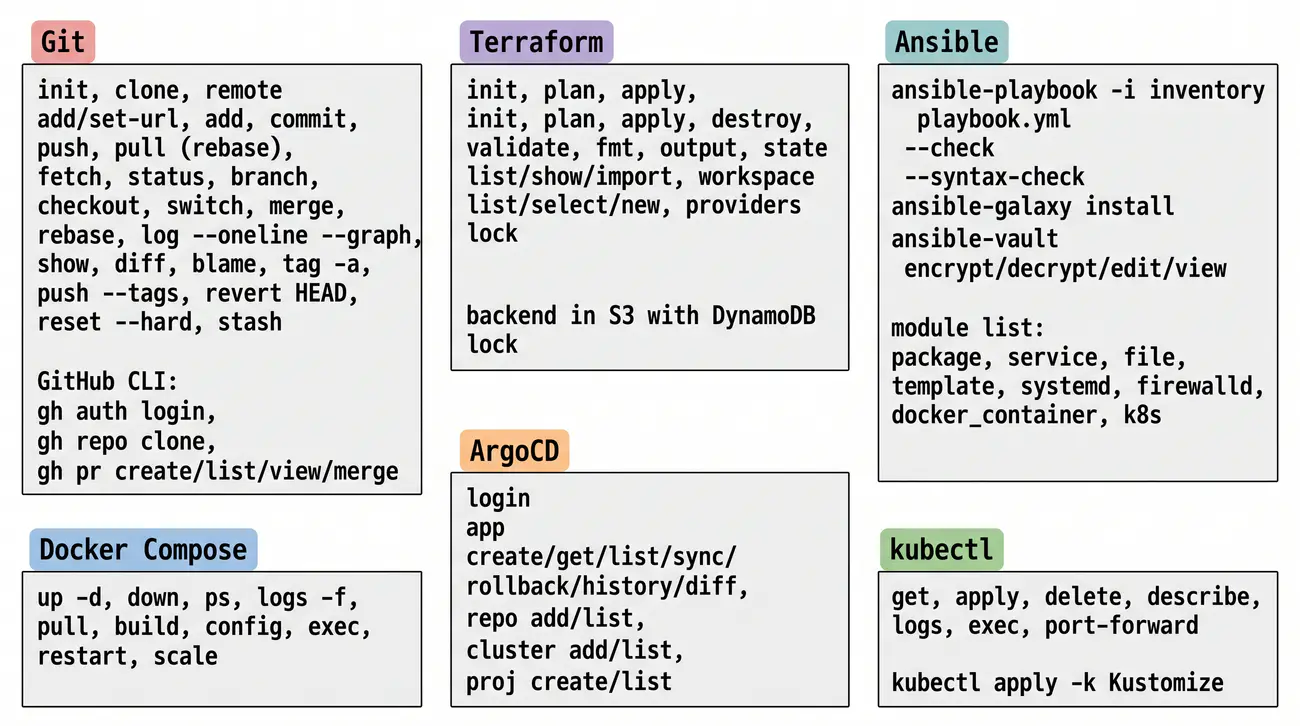
Wdrożenie zależy od wybranego środowiska. Docker Compose CLI v2 dostarcza komendy docker compose up -d (uruchomienie w tle), down (zatrzymanie i usunięcie), ps (stan usług), logs -f (logi), pull, build oraz config, który waliduje i renderuje cały plik. Docker Swarm w trybie stack deploy dodaje planowanie zadań, aktualizacje rolling, sekrety i routing mesh, natomiast kompose convert zamienia compose.yml na Deploymenty, Servisy, PVC, ConfigMap i Sekrety, które trafiają potem do ArgoCD lub Flux. Do najprostszych instalacji przydają się też narzędzia pokroju Watchtower (agent automatycznie pobierający nowe obrazy i restartujący usługi) czy Portainer (interfejs do zarządzania Compose, Swarm i Kubernetes).

Tak budowane rozwiązanie to często "GitOps dla pojedynczego hosta" lub "GitOps lite": plik Compose w Git staje się źródłem prawdy, CI/CD aktualizuje tagi i commituje, a agent na hoście (Watchtower lub własny skrypt) stosuje zmiany. Alternatywnie Compose stanowi jedynie pomost - konwertujemy go do manifestów Kubernetes i przechodzimy na pełne GitOps z ArgoCD. Należy pamiętać o ograniczeniach tej drogi: pojedynczy host nie daje wysokiej dostępności, skalowanie wymaga Swarm, a brakuje tu też zaawansowanego schedulera czy service mesh. Dla małych zespołów, aplikacji edge i prostego hostingu to jednak w pełni wystarczające, a przy tym nad wyraz eleganckie rozwiązanie.

Wyjaśnienie skrótów użytych na slajdzie:
Compose – Docker Compose Specification – specyfikacja Docker Compose; Deklaratywny format definiowania wielokontenerowych aplikacji uruchamianych na pojedynczym hoście.
YAML – YAML Data Format – format danych YAML; Struktura pliku docker-compose.yml podlegająca wersjonowaniu w repozytorium Git.
Docker – Docker Container Engine – silnik kontenerowy Docker; Środowisko wykonawcze uruchamiające usługi opisane w deklaratywnym pliku Compose.
Volume – Persistent Storage Volume – trwały wolumen pamięci masowej; Zasób dyskowy montowany w kontenerze gwarantujący zachowanie danych po restarcie usługi.
Network – Isolated Container Network – izolowana sieć kontenerowa; Wirtualny przełącznik programowy zapewniający bezpieczną komunikację pomiędzy serwisami aplikacji.

15/55 Compose i automatyzacja
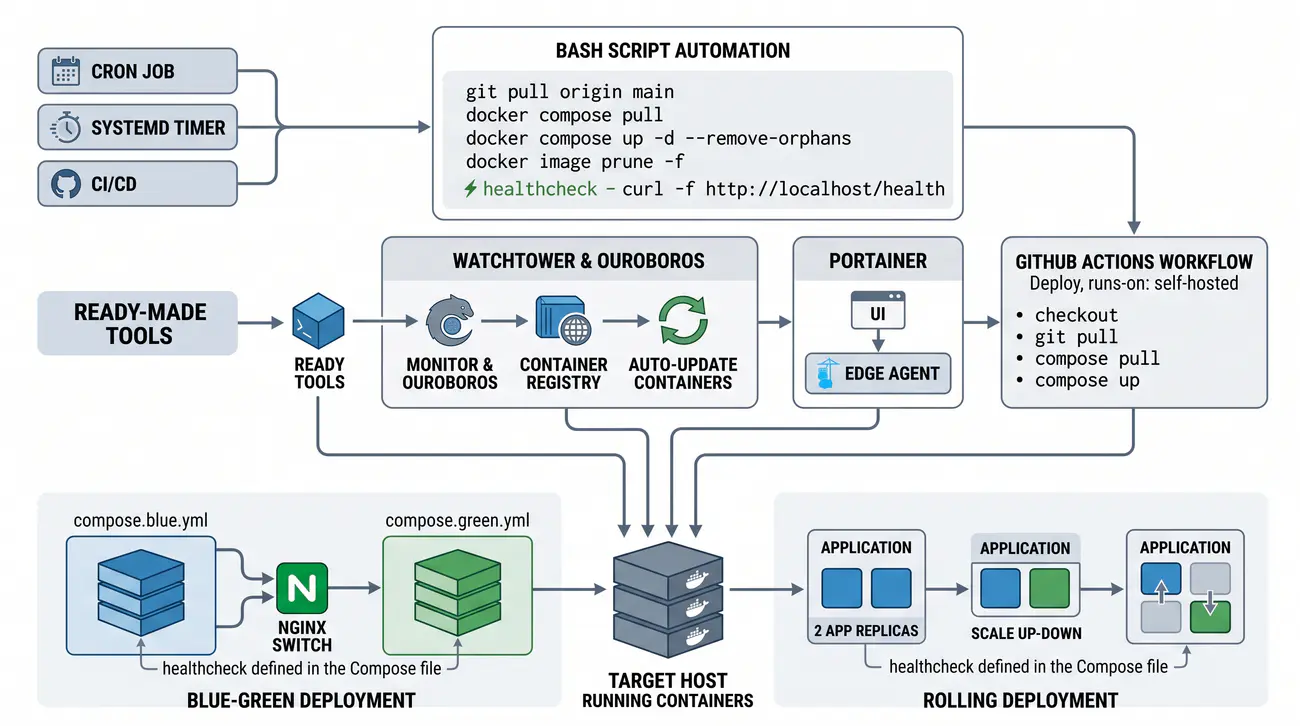
Automatyzacja Compose: Automatyzacja wdrożeń Compose: Watchtower (auto-update obrazów), skrypty bash (git pull → compose up), Portainer (UI + auto-update), CI/CD pipeline (GitHub Actions). Zero-downtime: Blue-Green lub Rolling update z healthcheck.

Wdrożenia Compose automatyzujesz czterema drogami: skrypt, Watchtower, Portainer albo CI/CD. Zawsze z zero-downtime.

  • Fale synchronizacji Sync Waves – pozwalają na precyzyjne sterowanie kolejnością uruchamiania komponentów wielowarstwowej aplikacji.
  • Adnotacje kolejnościowe – inżynier przypisuje obiektom numery fal, gwarantując start bazy danych przed uruchomieniem serwerów WWW.
  • Zależność od stanu zdrowia – kontroler przechodzi do kolejnej fali dopiero po osiągnięciu pełnej gotowości przez obiekty z fali poprzedniej.
  • Eliminacja błędów startowych – stopniowe uruchamianie zapobiega awariom aplikacji wywołanym brakiem połączenia z wymaganą bazą danych.
  • Wdrażanie struktur danych – fale doskonale sprawdzają się przy instalacji baz wymagających uprzedniego przygotowania dysków i wolumenów.
Watchtower: Automatyczna aktualizacja obrazów kontenerów; obok skryptów bash (pull → up), Portainera i CI/CD - zero-downtime przez Blue-Green lub rolling.
przepływ

Automatyzacja wdrożeń z Docker Compose i skryptami to praktyczny sposób na "GitOps bez Kubernetes" dla mniejszych zespołów i prostszych aplikacji. Sam plik docker-compose.yml jest tylko definicją - potrzebujemy jeszcze narzędzi, które obserwują Git lub rejestr obrazów, pobierają zmiany i stosują je. Do dyspozycji mamy kilka podejść: własne skrypty bash czy Python (wyzwalane przez cron, timer systemd lub CI/CD), gotowe narzędzia takie jak Watchtower, Portainer czy Ouroboros, pipeline'y CI/CD (GitHub Actions, GitLab CI), skrypty do backupu i przywracania wolumenów, a także techniki Blue-Green i Rolling update, które dają aktualizacje bez przerywania pracy. Wybór konkretnego rozwiązania zależy od skali wdrożenia i kompetencji zespołu.

Najprostszym i najbardziej elastycznym podejściem jest własny skrypt, który pobiera najnowszy stan z Git i uruchamia usługi: #!/bin/bash # deploy.sh - prosty deploy z Git set -euo pipefail cd /opt/myapp git pull origin main docker compose pull docker compose up -d --remove-orphans docker image prune -f # healthcheck sleep 10 curl -f http://localhost/health || exit 1 echo "Deploy successful" Skrypt wyzwalamy przez cron (0 3 * * * /opt/myapp/deploy.sh), timer systemd lub zdalnie z CI/CD - puszczamy go na samhostowanym runnerze po każdym wdrożeniu w gałęzi main. Alternatywą są gotowce: Watchtower sam monitoruje rejestr obrazów (Docker Hub, GHCR, ECR) i po pojawieniu się nowego tagu wykonuje docker compose up -d; jego zachowanie konfigurujemy zmiennymi, np. WATCHTOWER_POLL_INTERVAL=300 czy WATCHTOWER_CLEANUP=true. Ouroboros to odpowiednik napisany w Pythonie, a Portainer dodaje interfejs do zarządzania kontenerami i automatycznych aktualizacji (Edge Agent). Warto też spiąć backup wolumenów, np. archiwizując je do pliku tar: docker run --rm -v volume:/data -v $(pwd):/backup alpine tar czf /backup/backup-$(date +%F).tar.gz /data, i tak samo odtwarzać dane w razie awarii.

Automatyzację można przenieść w pełni do CI/CD. Fragment workflow GitHub Actions poniżej uruchamia się po wypchnięciu zmian do gałęzi main, a na self-hosted runnerze wykonuje dokładnie ten sam ciąg poleceń, który pokazaliśmy w skrypcie: name: Deploy on: push: branches: [main] jobs: deploy: runs-on: self-hosted steps: - uses: actions/checkout@v4 - name: Deploy run: | cd /opt/myapp git pull docker compose pull docker compose up -d --remove-orphans docker image prune -f aktualizacje bez przerw robimy natomiast dwiema technikami. Blue-Green utrzymuje dwa zestawy stacków (compose.blue.yml i compose.green.yml) i przełącza ruch na nginx'ie, Rolling update najpierw podbija liczbę replik (docker compose up -d --scale app=2), czeka na zdrowie usługi i dopiero zmniejsza skalę do jednej. Kluczowa jest tu definicja sondy zdrowia w pliku Compose (healthcheck: test: ["CMD", "curl", "-f", "http://localhost/health"], interval: 30s, timeout: 10s, retries: 3, start_period: 10s) - docker compose up czeka wtedy, aż usługa będzie gotowa. Skrypty dają pełną kontrolę, ale wymagają utrzymania; gotowe narzędzia są prostsze, ale mniejsze możliwości modyfikacji. Wybór pozostaje kwestią skali i kompetencji zespołu.

Warto w tym miejscu podsumować dostępne ścieżki. Skrypty to pełna kontrola kosztem utrzymania własnego kodu, Watchtower to prostota automatycznego podbijania obrazów, Portainer dodaje interfejs i aktualizacje, a CI/CD daje pełną ścieżkę: testy, budowanie i wdrożenie. Dowolną z nich warto uzupełnić o wdrożenia Blue-Green lub Rolling z sondą zdrowia - to w praktyce jedyny rozsądny sposób na zero-downtime w świecie Compose. Takie podejście to jednak "GitOps lite": gdy zespół wyrośnie z pojedynczego hosta, naturalnym krokiem jest przejście do Kubernetes - najlepiej właśnie przez GitOps.

Wyjaśnienie skrótów użytych na slajdzie:
Webhook – Git Repository Webhook – zwrotne wywołanie sieciowe webhook; Mechanizm powiadamiania serwera o nowym zatwierdzeniu w celu automatycznego wyzwolenia pulla.
Systemd – Systemd System Manager – menedżer usług systemd; Podsystem nadrzędny Linuksa nadzorujący działanie skryptów synchronizacji na serwerze z Docker Compose.
Daemon – Background Daemon Process – demon systemowy; Proces pracujący w tle, odpowiedzialny za cykliczne sprawdzanie zmian w gałęzi Git.
CLI – Command Line Interface – interfejs wiersza poleceń; Konsola tekstowa wykorzystywana do testowania automatyzacji wdrażania kontenerów.
Bash – GNU Bourne Again Shell – powłoka GNU Bash; Język skryptowy wykorzystywany do automatyzacji operacji git pull i docker compose up na maszynie brzegowej.

16/55 CI/CD w GitOps
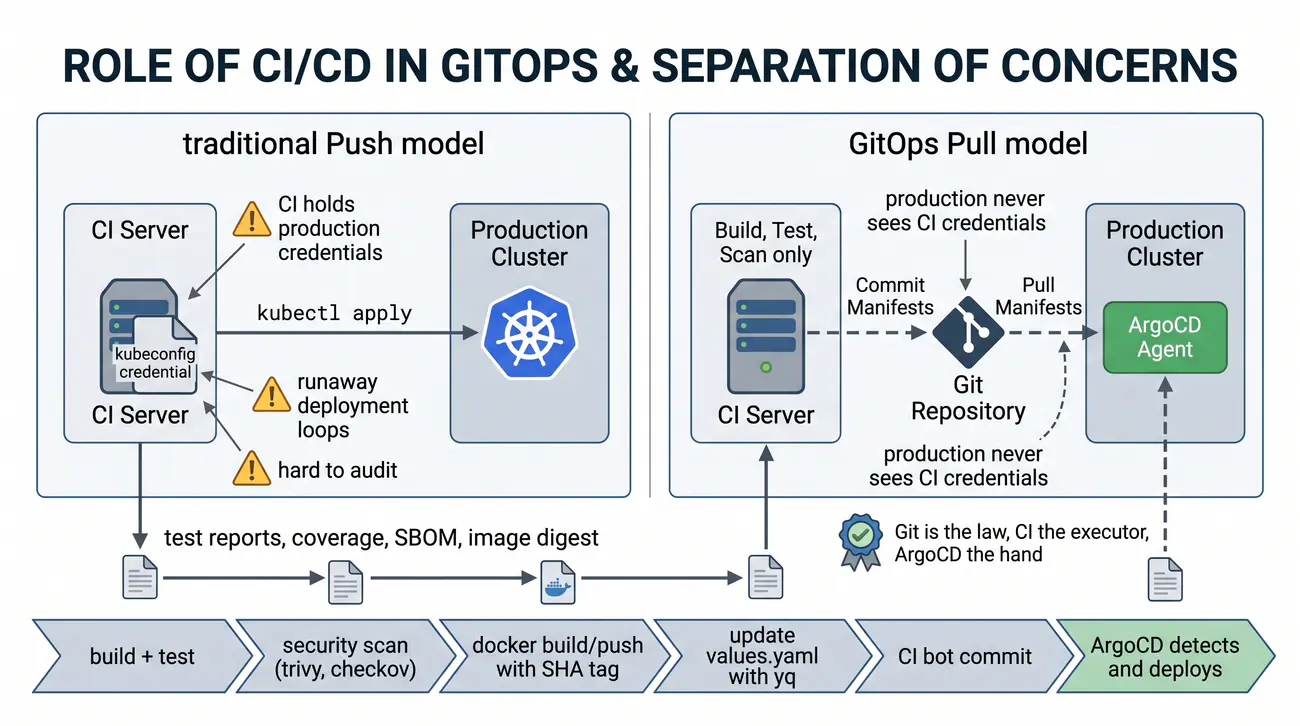
CI/CD w GitOps: CI (Continuous Integration) = build, test, scan. CD (Continuous Delivery) = deploy. W GitOps: CI commituje manifesty do Git, a ArgoCD (CD) synchronizuje je z klastrem. CI nie ma dostępu do produkcji - Separation of Concerns.

W GitOps CI buduje, a CD wdraża - i nigdy odwrotnie. CI nie dotyka produkcji; to sedno bezpieczeństwa.

  • Procedury haków Resource Hooks – umożliwiają uruchamianie dedykowanych zadań Job przed, w trakcie lub po zakończeniu procesu wdrożenia.
  • Zadania wstępne PreSync – stanowią idealne miejsce do wykonania migracji schematu bazy danych zanim wystartuje nowa wersja kontenera.
  • Zadania końcowe PostSync – pozwalają na automatyczne wywołanie testów dymnych lub wysłanie powiadomienia o sukcesie na firmowy komunikator.
  • Reakcja na błąd SyncFail – hak uruchamiany po awarii wdrożenia pozwala zaalarmować zespół lub wyczyścić tymczasowe zasoby w klastrze.
  • Polityka usuwania zadań – określa, czy zakończone pomyślnie zadania mają zostać natychmiast skasowane z klastra w celu zwolnienia zasobów.
Separation of Concerns: Rozdział odpowiedzialności - CI buduje i commituje manifesty do Git, a CD (ArgoCD) synchronizuje klaster bez dostępu CI do produkcji.
pipeline

Zanim przejdziemy do roli CI/CD w GitOps, warto ustalić, co dokładnie oznaczają te skróty. CI (Continuous Integration) to automatyczne budowanie, testowanie i walidacja kodu przy każdym wypchnięciu zmian do Git. CD (Continuous Delivery lub Continuous Deployment) to automatyczne dostarczanie gotowych artefaktów do środowisk - a GitOps jest właśnie specyficznym podejściem do CD, w którym Git pełni rolę pojedynczego źródła prawdy, a wdrożenie realizuje agent działający w klastrze (model Pull). Podział ról jest prosty: CI buduje obrazy, wykonuje testy i skany, a następnie commituje zaktualizowane manifesty do Git; ArgoCD lub Flux obserwuje repozytorium, wykrywa zmianę, synchronizuje ją i doprowadza klaster do zgodności. CI nigdy nie dotyka środowiska produkcyjnego - to kluczowy element rozdzielenia odpowiedzialności (separation of concerns).

W tradycyjnym modelu CD (model Push) serwer CI/CD - Jenkins, GitLab CI czy GitHub Actions - ma poświadczenia do klastra i sam wykonuje kubectl apply, helm upgrade lub terraform apply. Niesie to ze sobą poważne ryzyka: serwer CI dysponuje uprawnieniami administracyjnymi do produkcji, możliwa jest "pętla wdrożeniowa" (runaway deployment), trudno ustalić, kto faktycznie wdrożył zmianę, a każdy nowy klaster wymaga kolejnych poświadczeń w systemie CI. W modelu GitOps (model Pull) serwer CI robi tylko to: buduje obraz, testuje i skanuje go, generuje zaktualizowane manifesty i wypycha je do Git. Wdrożenia dokonuje już ArgoCD w klastrze - czyta Git i zapisuje do API Kubernetes. Dzięki temu produkcja nigdy nie "widzi" poświadczeń CI, a całość zyskuje na bezpieczeństwie, audytowalności i skalowalności.

Git pełni w tym układzie rolę kontrolera ruchu lotniczego. Przyjmuje się zasady: żadna zmiana nie ma prawa zaistnieć bez commita w Git; żaden commit nie trafia do produkcji bez Pull Requestu i code review; żaden Pull Request nie zostaje scalony bez pozytywnych wyników CI; ArgoCD synchronizuje wyłącznie z gałęzi main (lub z tagów); a rollback to po prostu git revert. Taki sam łańcuch wymuszeń daje pełny audyt - dziennik Git mówi, kto, co, kiedy i dlaczego zmienił - oraz natychmiastowy i w pełni odtwarzalny sposób przywracania stanu. Git staje się "prawem" w GitOps, CI jego "wykonawcą", a ArgoCD ręką, która zmiany wprowadza w życie.

Cały cykl najprościej zobrazować przykładowym pipelinem GitHub Actions. Po wypchnięciu zmian do gałęzi main pierwsze zadanie buduje i testuje aplikację, skanuje kod i obraz pod kątem bezpieczeństwa (trivy, checkov), a następnie wypycha obraz do rejestru z tagiem będącym hashem commitów. Drugie zadanie aktualizuje plik values.yaml aplikacji, ustawiając w nim nowy tag obrazu (yq), i commituje go do Git w imieniu bota CI: name: CI on: push: branches: [main] jobs: build-test: runs-on: ubuntu-latest steps: - uses: actions/checkout@v4 - name: Build & Test run: make build test - name: Security Scan run: trivy fs . && checkov -d . - name: Build Image run: docker build -t ghcr.io/org/app:$GITHUB_SHA . - name: Push Image run: docker push ghcr.io/org/app:$GITHUB_SHA update-manifests: needs: build-test runs-on: ubuntu-latest steps: - uses: actions/checkout@v4 with: token: ${{ secrets.GIT_TOKEN }} - name: Update values.yaml run: | yq -i '.image.tag = "${{ github.sha }}"' apps/myapp/values.yaml git config user.name "ci-bot" git config user.email "ci@org.com" git commit -am "chore: update image to ${{ github.sha }}" git push Tutaj do gry wchodzi ArgoCD: wykrywa nowy commit, synchronizuje zmianę i wdraża nowy obraz do klastra. To domyka pełną pętlę GitOps - od push kodu po wdrożenie w produkcji.

Wyjaśnienie skrótów użytych na slajdzie:
CI – Continuous Integration – ciągła integracja; Etap automatycznego budowania obrazów kontenerowych, uruchamiania testów jednostkowych i analizy podatności.
CD – Continuous Delivery / Continuous Deployment – ciągłe dostarczanie / automatyczne wdrażanie; Etap automatycznej publikacji zmian w środowiskach wykonawczych realizowany przez kontroler GitOps.
Pipeline – Automated CI/CD Pipeline – zautomatyzowany potok wdrożeniowy; Sekwencja kroków wykonywana przez platformy takie jak GitHub Actions, GitLab CI czy Tekton.
Runner – CI Pipeline Runner Agent – agent wykonawczy potoku CI; Węzeł obliczeniowy wykonujący instrukcje budowy kodu i testów w odizolowanym środowisku.
Artifact – Build Output Artifact – artefakt procesu budowy; Skompilowany pakiet lub obraz kontenera o unikalnym tagu wypychany do rejestru OCI.

17/55 Związek GitOps z SRE
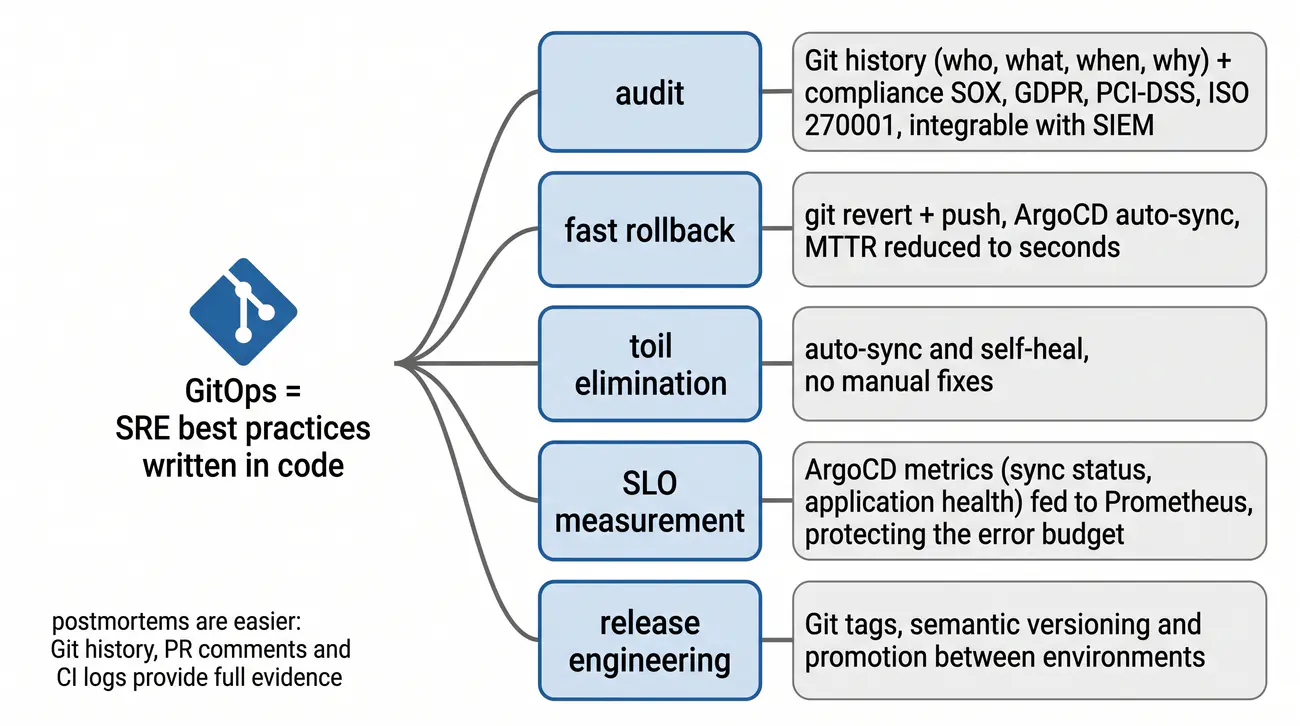
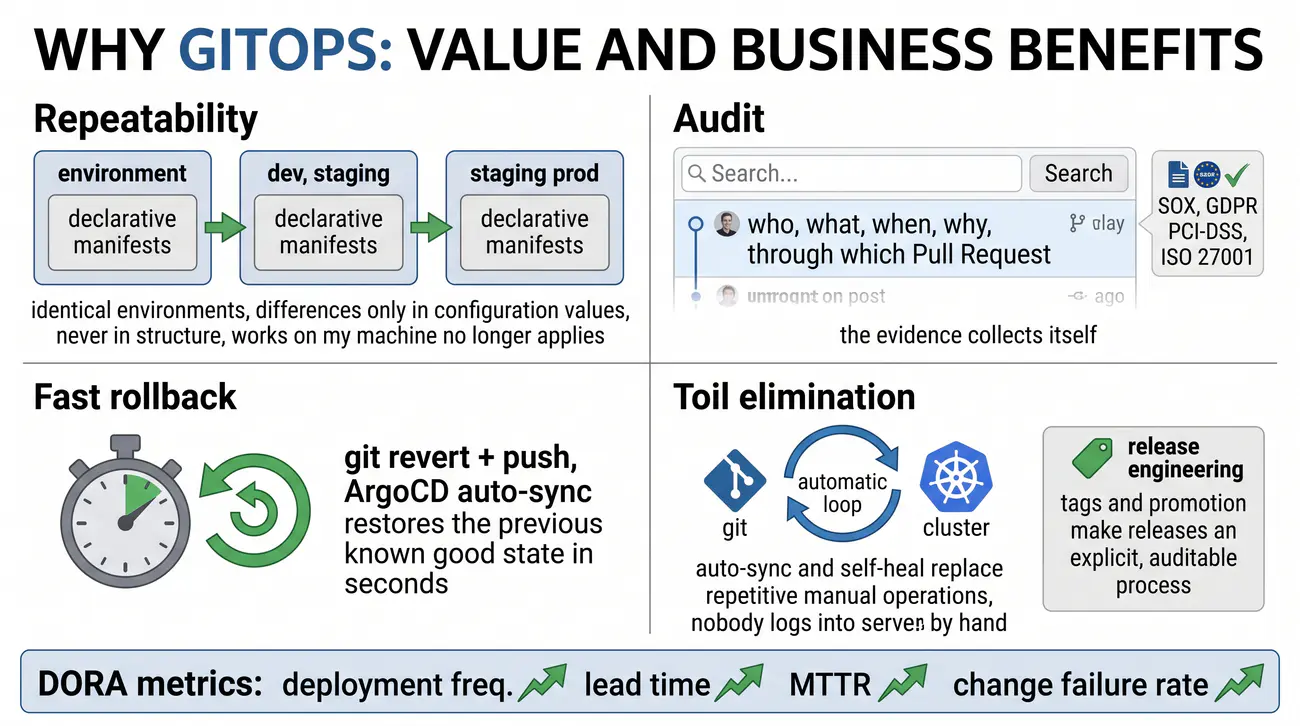
GitOps a SRE: GitOps realizuje kluczowe zasady SRE: audyt (historia Git), szybki rollback (git revert), eliminację toil (auto-sync, self-heal) i release engineering (tagi w Git, promocja). GitOps = dobre praktyki SRE zapisane w kodzie.

GitOps to SRE zapisane w kodzie: audyt, szybki rollback, koniec toil i porządne wydania.

  • Kontrola uprawnień RBAC – moduł dostępu w ArgoCD pozwala na granularne definiowanie praw zespołów w oparciu o pełnione role zawodowe.
  • Zasada najmniejszych przywilejów – dobra praktyka ogranicza prawa programistów do synchronizacji wyłącznie ich własnych przestrzeni nazw.
  • Projekty logiczne AppProject – umożliwiają grupowanie aplikacji oraz blokowanie możliwości wdrażania niebezpiecznych zasobów klastra.
  • Integracja Single Sign-On – połączenie z korporacyjnymi dostawcami tożsamości przez OAuth2 ułatwia centralne zarządzanie kontami pracowników.
  • Rejestr audytowy zdarzeń – wszelkie operacje zlecane w interfejsie graficznym lub konsoli są trwale logowane na potrzeby inspekcji bezpieczeństwa.
Release engineering: Inżynieria wydań (tagi w Git, promocja); GitOps realizuje audyt, szybki rollback i eliminację toil - dobre praktyki SRE w kodzie.
korzyści

Związek GitOps z SRE to nie przypadek - to naturalne dopasowanie. Książka SRE Google opisuje filary tej dyscypliny: SLO i Error Budgets, eliminację toil, automatyzację, monitoring, reagowanie na incydenty, postmortemy i release engineering. Każdy z tych filarów zyskuje w modelu GitOps konkretny, technologiczny odpowiednik: audyt zmian płynie z historii Git, szybkie cofnięcie z pola git revert, eliminacja toil z automatycznej synchronizacji i self-heal, obserwowalność z metryk ArgoCD, a discipline związane z wydaniami z tagów i mechanizmów promocji środowisk. Mówiąc wprost - GitOps to dobre praktyki SRE zapisane w kodzie.

Audyt zmian opiera się na tym, że historia Git jest kompletnym dziennikiem: kto (autor, najlepiej dodatkowo podpis GPG), co (różnica, diff), kiedy (znacznik czasu) i dlaczego (treść commita, link do Pull Requestu i zgłoszenia). Tak prowadzona dokumentacja zmian spełnia wymagania regulacyjne - SOX (sektor finansowy), GDPR (dane osobowe), PCI-DSS (dane kart), ISO 27001 (zarządzanie zmianami) - i daje się łatwo zintegrować z systemami SIEM przez API audytowe GitHub czy GitLab. Dobrą praktyką jest też zasada czterech oczu (dwie akceptacje), oddzielenie ról (developer nie scala do main), niezmienność historii (zablokowany force push). Każda zmiana to udokumentowany proces: PR, recenzja, merge, synchronizacja.

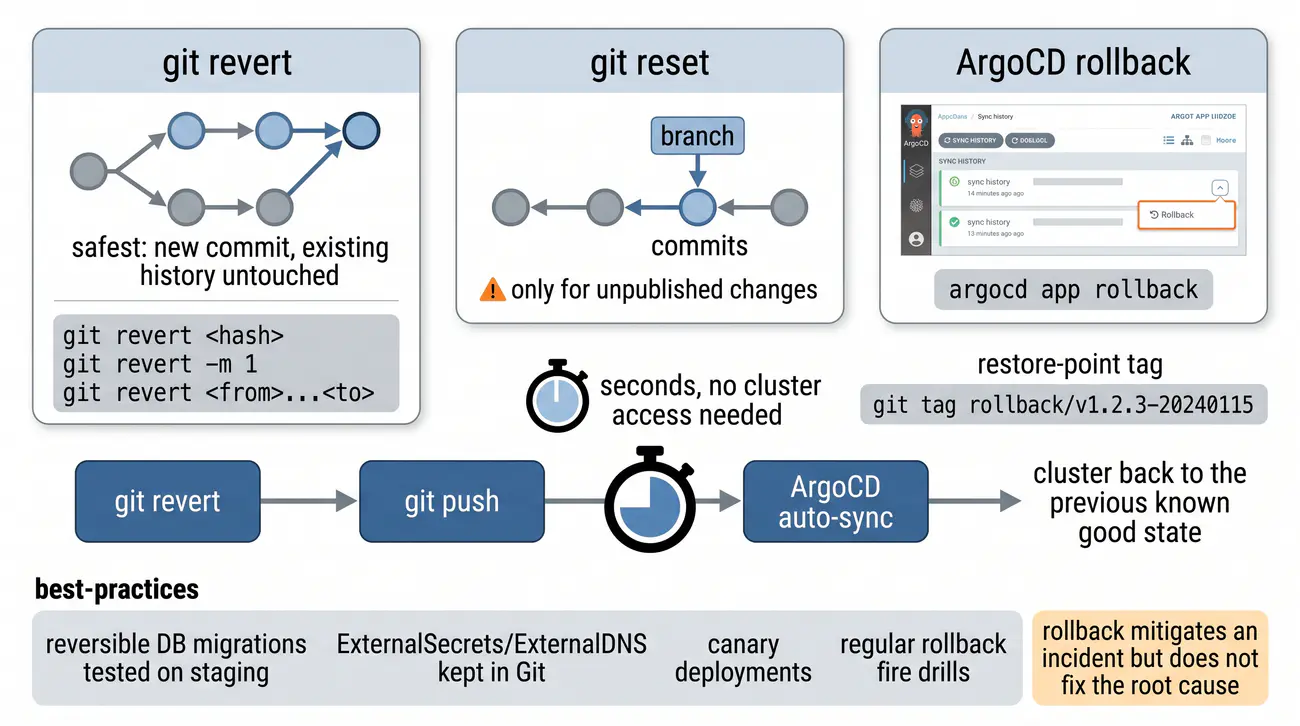
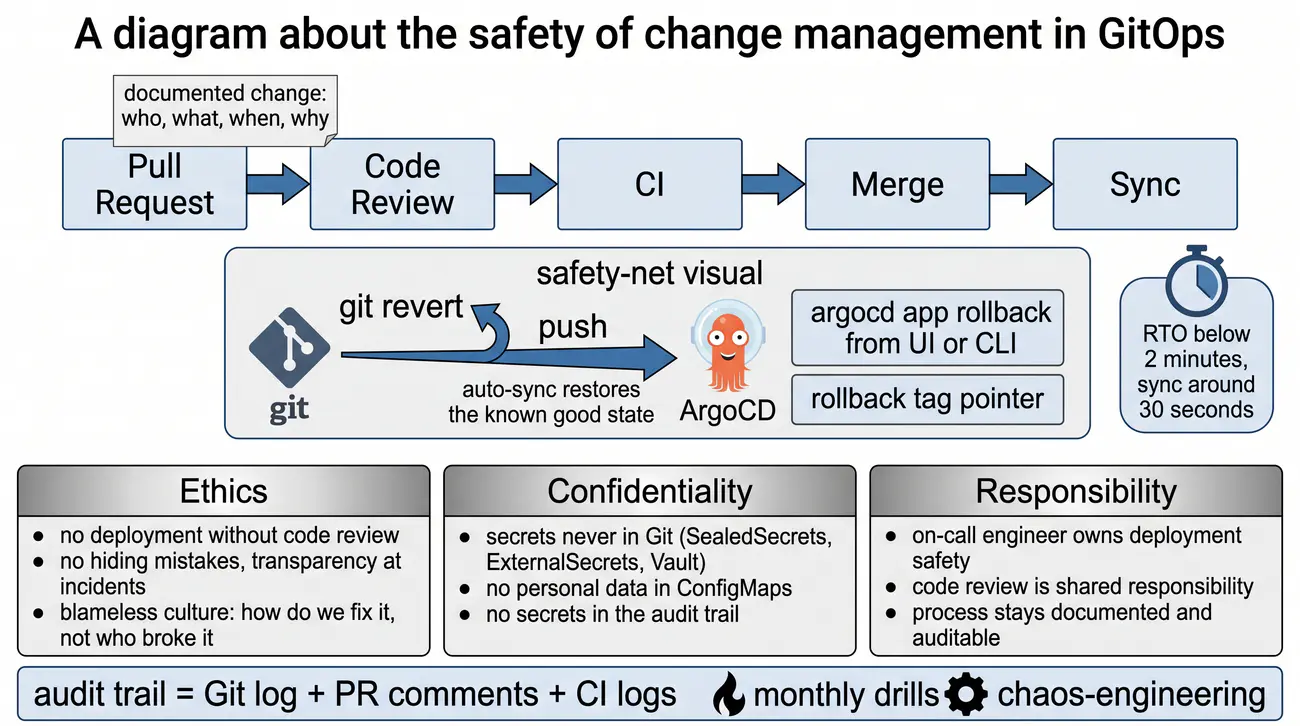
Szybkie cofnięcie zmian to jedna z największych przewag GitOps nad klasycznym CD. W tradycyjnym podejściu rollback oznacza kubectl rollout undo, helm rollback czy ponowne apply starego terraforma - operacje liczone w minutach lub godzinach, wymagające dostępu do klastra i obarczone ryzykiem błędu. W GitOps rollback to git revert i git push: ArgoCD wykrywa zmianę i automatycznie przywraca klaster do stanu sprzed commita. Czas reagowania spada do sekund, dostęp do klastra nie jest potrzebny, a historia pozostaje nienaruszona - git revert tworzy bowiem nowy commit, który odwraca skutki poprzedniego, zamiast przepisywać historię. To bezpośrednio przekłada się na redukcję MTTR i ochronę budżetu błędów.

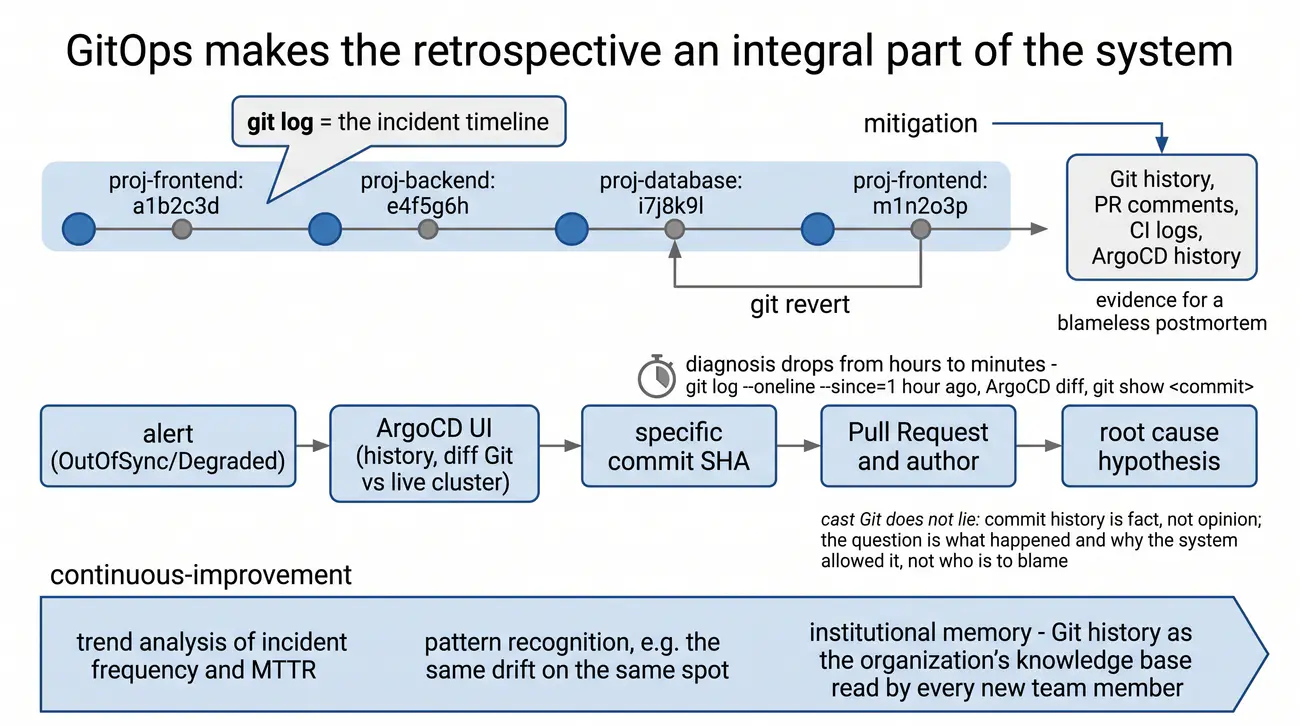
Na koniec spójrzmy na pozostałe filary. SLO i SLI liczymy między innymi z metryk ArgoCD trafiających do Prometheusa (status synchronizacji, zdrowie aplikacji). Monitoring tych metryk, szybkie cofnięcie zmian i automatyczna naprawa dryfu to praktyczna ochrona bufora błędów. Postmortemy pisze się łatwiej, bo w historii Git i komentarzach PR mamy pełne dowody. Release engineering wspiera się tagami, semantycznym wersjonowaniem i promocją między środowiskami. Warto pamiętać, że GitOps to nie kolejne narzędzie - to kultura operacyjna, która realizuje zasady SRE w praktyce.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Kultura łącząca automatyzację GitOps z ciągłą kontrolą budżetu błędów i wskaźników niezawodności.
SLO – Service Level Objective – cel poziomu usług; Wskaźnik jakościowy chroniony przed degradacją dzięki natychmiastowym rollbackom w GitOps.
ErrorBudget – Error Budget Mechanism – budżet błędów; Dopuszczalna pula zawodności; jej wyczerpanie blokuje automatyczne synchronizacje nowych funkcji w GitOps.
Blameless – Blameless Culture – kultura bez obwiniania; Filozofia organizacyjna traktująca historię commitów jako naukę inżynierską, a nie narzędzie szukania winnych.
Rollback – Fast Automated Rollback – szybkie wycofanie zmian; Procedura odtworzenia poprzedniego stanu klastra realizowana za pomocą prostego cofnięcia zatwierdzenia w Git.

18/55 Rollback w GitOps
Rollback w GitOps: git revert tworzy nowy commit odwracający zmiany (historia zachowana). Rollback w GitOps = git revert + push → auto-sync ArgoCD → sekundy. Znacznie szybsze niż tradycyjne (kubectl rollout undo, helm rollback). Testuj regularnie (fire drills).

Cofanie ma trzy smaki: revert (bezpieczny), reset (lokalny) i rollback ArgoCD. Pamiętaj: łagodzi, nie leczy.

  • Zarządzanie wieloma klastrami – centralna instancja ArgoCD potrafi zarządzać wdrażaniem oprogramowania na dziesiątkach odległych klastrów.
  • Architektura Hub and Spoke – główny klaster zarządczy komunikuje się z klastrami roboczymi za pośrednictwem bezpiecznych certyfikatów mTLS.
  • Globalny punkt widzenia – zapewnia jeden centralny widok na stan wszystkich środowisk w firmie, ułatwiając koordynację globalnych wydań.
  • Izolacja środowiskowa – w razie rygorystycznych wymogów sieciowych można wdrożyć niezależne instancje kontrolera lokalnie na klastrach.
  • Optymalizacja kosztów operacyjnych – centralizacja sterowania wdrożeniami obniża nakład pracy inżynierów i usprawnia zarządzanie wersjami.
git revert: Bezpieczne cofnięcie przez nowy commit odwracający (historia zachowana); revert + push + auto-sync to rollback w sekundy (ćwiczony w fire drills).
rollback

W architekturze GitOps zabrania się ręcznego cofania wdrożeń za pomocą poleceń kubectl rollout undo, gdyż powoduje to natychmiastowe rozbieżności z repozytorium. Prawidłowa procedura Rollback polega na wykonaniu operacji git revert <commit-hash> na gałęzi produkcyjnej i zatwierdzeniu zmian przez Pull Request. Kontroler GitOps natychmiast wykrywa zmianę sumy kontrolnej w Git i w sposób atomowy przywraca stabilną konfigurację w klastrze, zachowując nienaruszony ślad audytowy.

Rollback w modelu GitOps nie jest osobną procedurą awaryjną, lecz naturalną konsekwencją tego, że Git jest źródłem prawdy: każdy commit to punkt przywracania, a powrót do wcześniejszego stanu to zwykła operacja na historii. Do wyboru mamy trzy główne mechanizmy. git revert tworzy nowy commit odwracający zmiany konkretnego commita lub ich zakresu - najbezpieczniejsza opcja, bo nie dotyka istniejącej historii. git reset cofa wskaźnik gałęzi lokalnie, a użycie go z force push ma sens tylko w wyjątkowych przypadkach, gdy zmiany nie zostały jeszcze opublikowane. ArgoCD ma też własny rollback: w UI wybieramy wersję z historii synchronizacji, a CLI robi to poleceniem argocd app rollback. Dopełnieniem zdolności obronnych są regularne testy rollbacku (fire drills) i dobrze zaplanowana komunikacja w czasie incydentu - odróżnia to dojrzałe organizacje od tych, które "liczą na szczęście".

Odzyskanie poprzedniego stanu oznacza w praktyce przywrócenie znanego dobrego stanu (known good state) bez utraty historii. git revert to nie "cofnięcie" w sensie git reset --hard, lecz "przeciwdziałanie": tworzymy nowy commit, który odwraca skutki poprzedniego, a cała historia pozostaje nienaruszona i przejrzysta. Warianty: git revert <hash> odwraca pojedynczy commit, git revert -m 1 <hash-merge> odwraca cały merge z zachowaniem historii obu gałęzi, a git revert <od>..<do> zakres commitów. ArgoCD w UI wykonuje odpowiednik tej operacji automatycznie - wybiera w rewizji historii i sam obsługuje cały proces. Możemy też oznaczyć punkt przywracania tagiem, np. git tag rollback/v1.2.3-20240115, by wrócić do niego jednym poleceniem. To praktycznie "przycisk cofania" dla infrastruktury.

Dlaczego rollback w GitOps jest bezpieczny i niskiego ryzyka? Po pierwsze wymaga tylko wypchnięcia do Git - nie potrzebujemy dostępu do klastra, więc powierzchnia ataku jest mniejsza. Po drugie ArgoCD zastosuje zmianę w sposób deterministyczny, bez ręcznych kroków. Po trzecie historia Git to gotowy audyt: wiemy, kto, kiedy i w jakim celu wykonał rollback. Po czwarte całą procedurę można wcześniej sprawdzić na staging - wystarczy przywrócić zmianę na gałęzi i zsynchronizować środowisko testowe. Pamiętajmy też, że rollback łagodzi skutki incydentu, ale nie naprawia przyczyny - diagnozę i poprawkę wykonujemy osobno. Ograniczenia są oczywiste: migracji schematu bazy nie cofniemy przez revert plików (potrzebna migracja w dół), zasoby zewnętrzne, jak DNS czy certyfikaty, nie są w Git i wymagają odrębnej procedury, a częściowy powrót tylko wybranych zmian trzeba złożyć ręcznie. Najlepszą praktyką jest zawsze odwracalna migracja testowana na staging, trzymanie zasobów zewnętrznych w Git (ExternalSecrets, SealedSecrets, ExternalDNS), a w razie potrzeby wdrożenia canary, które ograniczają promień wybuchu błędu.

Wyjaśnienie skrótów użytych na slajdzie:
GitRevert – Git Revert Command – polecenie git revert; Atomowa operacja w Git tworząca nowy commit odwracający skutki błędnej zmiany bez niszczenia historii repozytorium.
Rollback – Operational State Rollback – wycofanie stanu operacyjnego; Powrót do poprzedniej, w pełni stabilnej wersji konfiguracji w klastrze produkcyjnym.
FastForward – Fast-Forward Merge Policy – scalanie bez tworzenia commita scalającego; Strategia aktualizacji wskaźnika gałęzi gwarantująca w pełni liniową historię zatwierdzeń.
History – Immutable Commit History – niezmienna historia commitów; Podstawa audytu operacyjnego wykazująca kto, kiedy i z jakiego powodu dokonał rekonfiguracji systemów.
SHA – Commit Hash Identifier – identyfikator skrótu zatwierdzenia; Kryptograficzny identyfikator gwarantujący integralność i jednoznaczność punktu przywracania.

19/55 Recenzja i akceptacja zmian
Code Review i scalanie: Pull Request to bramka jakości. Proces: gałąź feature → PR → kontrole CI (lint, test, security) → code review → akceptacja → scalenie (squash/merge-commit/rebase). Ochrona gałęzi wymusza: obowiązkowe recenzje, wymagane kontrole, podpisywane commity.

PR to bramka: feature → commity → push → CI → review → merge. Bez niej nie ma wejścia do main.

  • Rozszerzenie Argo Rollouts – wzbogaca platformę Kubernetes o zaawansowane strategie wydań, takie jak wdrożenia kanarkowe i Blue-Green.
  • Wdrożenie kanarkowe Canary – polega na skierowaniu małego procenta ruchu do nowej wersji w celu weryfikacji jej stabilności na żywych danych.
  • Zautomatyzowana analityka – kontroler wdrożenia cyklicznie odpytuje system Prometheus, weryfikując wskaźniki błędów na każdym kroku.
  • Automatyczny powrót Rollback – w przypadku zaobserwowania wzrostu błędów kontroler natychmiast i bezobsługowo wycofuje ruch do stabilnej wersji.
  • Spokojne publikacje zmian – zaawansowane wdrożenia kanarkowe minimalizują ryzyko przestojów i pozwalają na bezpieczne wydania w dzień.
Squash/merge/rebase: Strategie scalania PR (spłaszczenie, commit scalający, przełożenie); po kontrolach CI i recenzji z ochroną gałęzi.
proces review

Recenzja kodu i akceptacja zmian to najważniejsza bramka jakości w GitOps: każda zmiana infrastruktury lub aplikacji musi przejść przez Pull Request (w GitLab: Merge Request). To nie formalność - to inżynieria jakości i bezpieczeństwa. Proces wygląda zawsze podobnie: utworzenie gałęzi feature, commity, wypchnięcie do Git, otwarcie PR, automatyczne walidacje CI, recenzja, akceptacja i scalenie. Pull Request daje jednak znacznie więcej: przegląd kodu przez drugą osobę (catching błędów, aspekty bezpieczeństwa, wydajność, utrzymywalność, kompletność testów), wymianę wiedzy w zespole i pełną, zapisaną historię decyzyjną każdej zmiany.

Kontrolę jakości na Pull Requestach bierze na siebie CI. Pipeline uruchamiany dla każdego PR sprawdza kolejno: pobranie kodu, instalację zależności, analizę statyczną (yamllint, hadolint, shellcheck, checkov, trivy fs), testy jednostkowe i integracyjne (pytest, jest, go test, mvn test), skanowanie bezpieczeństwa obrazy (Trivy, Grype, Syft) i - jeśli to wrażliwy fragment - kontrole polityk narzędziami typu OPA Gatekeeper czy Kyverno. Dopiero gdy wszystkie wymagane kontrole uzyskają status sukcesu (required status checks), scalenie jest dozwolone. Speed i efektywność dają cache zależności i równoległa realizacja zadań, a same artefakty - raporty testów, pokrycie kodu, SBOM i digest obrazu - trafiają do artefaktów pipelineu.

Scalenie do gałęzi chroni tzw. Branch Protection (ochrona gałęzi) - zestaw reguł egzekwowanych na main. Najczęściej: obowiązkowe recenzje Pull Request (jedna lub dwie akceptacje, automatyczne odrzucanie przestarzałych akceptacji po nowych commitach), wymagane kontrole CI, podpisywane commity, liniowa historia (tylko squash lub rebase) i ograniczenie, kto może w ogóle wypychać do gałęzi. Plik CODEOWNERS automatycznie przypisuje recenzentów na podstawie ścieżek - zmiany w /infra/ trafiają do zespołu infra, zmiany w /apps/payments/ do zespołu płatności, co gwarantuje obecność właściwej wiedzy domenowej. Do tego dochodzi wybór strategii scalenia: squash spłaszcza całą gałąź do jednego commita (czysta historia, mniej kontekstu), merge commit zachowuje pełną historię, rebase daje historię liniową. Współczesne platformy dodają też kolejkę scalania: gotowe PR-y są sekwencjonowane, automatycznie przestawiane na najnowszy main i scalane dopiero po przejściu CI - to eliminuje wyścigi, w których dwa PR-y unieważniają się nawzajem. Całość realizuje zasadę "ufamy, ale sprawdzamy" - a razem z synchronizacją z Git stanowi fundament całego modelu GitOps.

Wyjaśnienie skrótów użytych na slajdzie:
BranchProtection – Branch Protection Rules – zasady ochrony gałęzi; Mechanizm w Git blokujący bezpośrednie wypychanie zmian do gałęzi głównej bez procedury Code Review.
CODEOWNERS – Repository Code Owners Configuration – konfiguracja właścicieli kodu; Plik wymuszający obowiązkową recenzję zmian w krytycznych plikach przez wyznaczonych architektów.
PeerReview – Peer Engineering Review – koleżeńska recenzja inżynierska; Weryfikacja założeń architektonicznych i bezpieczeństwa manifestu przed wyrażeniem zgody na wdrożenie.
CI – Continuous Integration Quality Gate – bramka jakości ciągłej integracji; Wymóg zaliczenia wszystkich zautomatyzowanych testów przed odblokowaniem przycisku scalenia w PR.
Gate – Production Deployment Gate – bramka wdrożenia produkcyjnego; Formalny warunek bezpieczeństwa zapobiegający przypadkowemu wprowadzeniu błędów konfiguracji.

20/55 Bezpieczeństwo w GitOps
Bezpieczeństwo w GitOps: Podejście wielowarstwowe: szyfrowanie (TLS 1.3, szyfrowanie w spoczynku), RBAC (zasada najmniejszych uprawnień), polityki jako kod (OPA Gatekeeper/Kyverno), zarządzanie sekretami (ExternalSecrets, Vault, SOPS), bezpieczeństwo łańcucha dostaw (SLSA, cosign, SBOM).

Bezpieczeństwo warstwami: szyfrowanie, sekrety, RBAC, polityki, łańcuch dostaw i Falco na straży runtime.

  • Zarządzanie przez Kustomize – umożliwia parametryzację manifestów Kubernetes bez konieczności stosowania silników szablonów tekstowych.
  • Koncepcja bazy i nakładek – bazowe manifesty przechowuje się w osobnym folderze, a specyficzne różnice dla dev i prod opisuje w nakładkach.
  • Modyfikacja atrybutów – nakładki środowiskowe zmieniają liczbę replik podów, wstrzykują zmienne środowiskowe oraz dopasowują limity RAM.
  • Poprawne manifesty YAML – pliki bazowe pozostają w pełni poprawnymi manifestami, które można w dowolnej chwili zweryfikować narzędziami.
  • Natywna integracja narzędzi – Kustomize jest fabrycznie wbudowany w narzędzie kubectl oraz kontroler ArgoCD, stanowiąc rynkowy standard.
SLSA i SBOM: Standardy łańcucha dostaw (poziomy SLSA, podpisy cosign, wykaz SBOM); z szyfrowaniem, RBAC, politykami i sekretami - warstwy GitOps.
bezpieczeństwo

Bezpieczeństwo w modelu GitOps to interesujące połączenie: GitOps samo z siebie podnosi bezpieczeństwo - Git pełni rolę strażnika, historia stanowi dziennik audytu, a każda zmiana przechodzi przez recenzję - ale jednocześnie wymaga dopełnienia kolejnymi warstwami ochrony. W praktyce mówimy o kilku: szyfrowaniu danych w spoczynku i w transmicie, zarządzaniu sekretami, kontroli dostępu (RBAC z zasadą najmniejszych uprawnień), politykach egzekwowanych jako kod, bezpieczeństwie łańcucha dostaw (SLSA, podpisywanie obrazów cosign, SBOM) oraz bezpieczeństwie w czasie działania (Falco, monitoring runtime). To klasyczny model warstwowy - jak cebula: im głębiej, tym trudniej przebić.

Szyfrowanie obejmuje oba kierunki. W transmisji: TLS 1.3 wszędzie - Git przez HTTPS czy SSH, gRPC w ArgoCD, API Kubernetes, mTLS między usługami przez Istio, Linkerd lub Cilium; certyfikaty automatyzuje cert-manager. W spoczynku: szyfrowanie etcd przez providerów Kubernetesa (AES lub KMS), szyfrowanie Redis, a dla dysków trwałych - szyfrowane PVC na poziomie sterowników CSI z integracją z chmurowymi KMS. Większe wdrożenia stosują tak zwane szyfrowanie kopertowe: każdy zasób szyfruje się kluczem danych DEK, a ten jest chroniony kluczem nadrzędnym KEK przechowywanym w KMS. Istotna jest też rotacja kluczy - automatyczna w KMS lub przez odnawianie certyfikatów w cert-manager. I najważniejsze: sekrety nigdy nie mają prawa trafić do Git w formie jawnej - do tego służą SealedSecrets, ExternalSecrets Operator, SOPS czy Vault, o czym za chwilę.

Kontrola dostępu realizowana jest na wielu poziomach. W Kubernetes przez RBAC: Role i RoleBinding budowane według zasady najmniejszych uprawnień; w ArgoCD przez Projekty (logiczna izolacja zespołów), Role i polityki OPA/Rego; w Git przez ochronę gałęzi, podpisywanie commitów i CODEOWNERS. W modelu GitOps kluczowe jest też, by CI/CD nie miało dostępu do klastra - dostęp ma tylko ArgoCD. Organizacje dbające o bezpieczeństwo idą dalej: dostęp na żądanie (Just-in-Time) przez Teleport czy HashiCorp Boundary, kontrolowane konto awaryjne (break-glass) z audytem i alertami oraz filozofia Zero Trust ("nikomu nie ufaj, zawsze weryfikuj") z mTLS i tożsamościami SPIFFE/SPIRE.

Polityki jako kod (policy as code) to sposób, w jaki bezpieczeństwo i wymogi organizacyjne wchodzą do klastra razem z samym kodem. OPA Gatekeeper i Kyverno to kontrolery admission, które weryfikują każdy zasób przy tworzeniu i aktualizacji - np. "wszystkie Deploymenty muszą mieć limity zasobów", "obrazy nie mogą używać tagu latest", "obowiązkowe etykiety owner/team/environment", "zakaz kontenerów z uprawnieniami hostPath czy privileged", "każdy namespace musi mieć NetworkPolicy". Kyverno jest natywnie zintegrowany z Kubernetesem i umie walidować, mutować i generować zasoby; Gatekeeper opiera się na OPA/Rego. Ponieważ polityki trzymamy w Git, podlegają dokładnie takiemu samemu procesowi jak reszta infrastruktury: recenzji, testom w CI i wersjonowaniu.

Wyjaśnienie skrótów użytych na slajdzie:
RBAC – Role-Based Access Control – kontrola dostępu oparta na rolach; Precyzyjne uprawnienia w systemie Git i klastrze ograniczające możliwość zatwierdzania zmian produkcyjnych.
LeastPrivilege – Principle of Least Privilege – zasada najmniejszych uprawnień; Reguła bezpieczeństwa przyznająca inżynierom wyłącznie prawa do odczytu w klastrach produkcyjnych.
mTLS – Mutual Transport Layer Security – wzajemne uwierzytelnianie TLS; Kryptograficzny protokół zabezpieczający komunikację pomiędzy kontrolerem ArgoCD a klastrami zdalnymi.
AuditLog – Comprehensive Audit Logging – kompleksowy dziennik audytowy; Nieusuwalny zapis wszystkich zatwierdzeń, scalenia PR i zdarzeń synchronizacji w systemie GitOps.
SOC2 – System and Organization Controls 2 – standard audytu bezpieczeństwa SOC 2; Certyfikacja potwierdzająca zgodność procesów zarządzania zmianą z wymogami bezpieczeństwa danych.

21/55 Sekrety i konfiguracja
Zarządzanie sekretami: Złota reguła: nigdy nie trzymaj haseł, tokenów ani kluczy API w formie jawnej w Git. Alternatywy: SealedSecrets (natywne dla GitOps), ExternalSecrets Operator (Vault, dostawcy chmurowi), SOPS (szyfrowanie plików narzędziami age/GPG/KMS).

Złota reguła sekretów: nic jawnego w Git. ConfigMap to nie Secret, a historia nie zapomina.

  • Menedżer pakietów Helm – pozwala na pakowanie aplikacji w wersjonowane archiwa wyposażone w szablony i domyślne zbiory parametrów.
  • Dyscyplina wartości w Git – pliki konfiguracyjne values.yaml przechowuje się w repozytorium, a kontroler renderuje szablony w locie przed wdrożeniem.
  • Gotowe pakiety społeczności – inżynierowie mogą łatwo wdrażać gotowe, sprawdzone narzędzia open-source bez kopiowania setek linii manifestów.
  • Wersjonowanie oprogramowania – zmiana wersji aplikacji polega na prostej modyfikacji numeru wydania pakietu w manifeście w repozytorium.
  • Harmonia szablonów z GitOps – połączenie elastyczności szablonów Helm z dyscypliną Git zapewnia powtarzalność i łatwość zarządzania.
SealedSecrets: Szyfrowane sekrety natywne dla GitOps; obok ExternalSecrets (Vault/chmura) i SOPS (age/GPG/KMS) - złota reguła: nic jawnego w Git.
sekrety

Przechowywanie haseł i kluczy prywatnych w otwartym tekście w systemie Git jest rażącym błędem bezpieczeństwa. W modelu GitOps stosuje się dwa komplementarne wzorce:
- Szyfrowanie w repozytorium: narzędzie Mozilla SOPS lub Bitnami Sealed Secrets szyfrują wartości parametrów w plikach YAML kluczem publicznym; deszyfrowanie następuje wyłącznie wewnątrz klastra za pomocą klucza prywatnego,
- Synchronizacja ze skarbcem: kontroler External Secrets Operator pobiera tajemnice z zewnętrznego systemu (HashiCorp Vault, AWS Secrets Manager) i automatycznie wstrzykuje je jako obiekty Secret w Kubernetesie.

Zarządzanie sekretami w modelu GitOps to jeden z najważniejszych i zarazem najtrudniejszych aspektów bezpieczeństwa. Złota reguła brzmi: nigdy nie umieszczaj haseł, tokenów, kluczy API, certyfikatów ani ciągów połączeń w postaci jawnej w Git - repozytorium bywa publiczne albo przynajmniej szeroko dostępne, a każda zapisana wartość zostaje w historii na zawsze. Zamiast tego sekrety czyta się z wyspecjalizowanych rozwiązań: SealedSecrets, ExternalSecrets Operator, HashiCorp Vault, SOPS, menedżery sekretów od dostawców chmurowych (AWS, GCP, Azure) czy 1Password Connect. Warto też pamiętać o rozróżnieniu między ConfigMaps a Sekretami: konfiguracja nieczuła trafia do pierwszych, dane wrażliwe - do drugich, zawsze w formie zaszyfrowanej.

Dlaczego sekretów nie wolno trzymać w Git? Historia Git jest niemutowalna: nawet git revert nie usuwa zapisanej treści, a git filter-branch czy BFG repo-cleaner przepisują historię - operacja ryzykowna i zmieniająca hashe wszystkich commitów. Konsekwencje przecieku są dotkliwe: hasła widzą wszyscy autorzy gałęzi, logi CI/CD mogą je wydrukować, fork repozytorium zwielokrotnia wyciek, a przeszukanie historii (git log -p) to trywialne zadanie. Te same wymogi nakładają też regulacje: GDPR (dane osobowe), PCI-DSS (dane kart), SOX (finanse), HIPAA (zdrowie) - każda wymaga szyfrowania sekretów. Reakcja na wyciek zawsze wymaga rotacji, ale stary commit nadal zawiera sekret, więc najlepiej w ogóle nie dopuścić do sytuacji: pre-commit hooks (git-secrets, detect-secrets, trivy), skany w CI (trivy fs, gitleaks) i ochrona wypychania na GitHub czy wykrywanie sekretów w GitLab zatrzymują problem, zanim trafi do Git.

Rozwiązaniem natywnym dla GitOps są SealedSecrets od Bitnami. Narzędzie kubeseal szyfruje zwykły Sekret Kubernetes kluczem publicznym kontrolera i zamienia go na zasób SealedSecret (CRD), który bezpiecznie commitujemy do Git. W klastrze kontroler, dysponujący kluczem prywatnym, odszyfrowuje go i odtwarza zwykły Sekret Kubernetes. Klucz publiczny można trzymać w repozytorium, a klucz prywatny - w samym klastrze; każdy klaster ma zresztą własną parę. Rotacja oznacza ponowne zaszyfrowanie wszystkich SealedSecrets nowym kluczem. Organizacje, które chcą więcej centralizacji, wybierają ExternalSecrets Operator (ESO): operator synchronizuje sekrety z zewnętrznych dostawców - HashiCorp Vault, AWS Secrets Manager, GCP Secret Manager, Azure Key Vault, ale też 1Password czy Bitwarden - do Sekretów Kubernetes. Definiujemy ClusterSecretStore (konfiguracja dostawcy) i ExternalSecret (mapowanie zdalnej referencji na klucz Sekretu), a pętla rekonsyliacji z zadanym interwałem odświeża dane. Sekrety nie trafiają wtedy do Git w ogóle, a rotacja po stronie dostawcy jest automatycznie propagowana do klastra.

Ostatni z głównych wariantów to SOPS (Secrets OPerationS) Mozilli - narzędzie CLI szyfrujące pliki YAML, JSON czy ENV. Szyfruje wartości, zachowując strukturę dokumentu, a jako backendy obsługuje age (nowoczesny i prosty), GPG oraz KMS-u różnych dostawców i Vault w trybie Transit. Praca wygląda tak: sops -e -i values.yaml szyfruje plik w miejscu, sops -d values.yaml odszyfrowuje go do wyjścia standardowego; do Git trafia wyłącznie wersja zaszyfrowana, a w CI odszyfrowany plik można skarmić helm template. Wybór narzędzia zależy od skali i infrastruktury: ESO z Vaultem to wariant dla dużych organizacji, SealedSecrets najlepiej pasują do mniejszych zespołów trzymających się GitOps, a SOPS świetnie radzi sobie z plikowymi wartościami w helmie. Jedno pozostaje niezmienne: nigdy nie commitujemy sekretów jawnie.

Wyjaśnienie skrótów użytych na slajdzie:
SOPS – Secrets OPerationS by Mozilla – narzędzie Mozilla SOPS; Przemysłowy standard szyfrowania wartości w plikach YAML/JSON za pomocą kluczy KMS, age lub GPG.
SealedSecrets – Bitnami Sealed Secrets – zapieczętowane sekrety Bitnami; Operator klastrowy deszyfrujący asymetrycznie zaszyfrowane manifesty w locie wewnątrz Kubernetesa.
ExternalSecrets – External Secrets Operator – operator zewnętrznych tajemnic; Kontroler pobierający poświadczenia z bezpiecznych skarbców chmurowych bezpośrednio do klastra.
KMS – Key Management Service – usługa zarządzania kluczami kryptograficznymi; Chmurowy moduł HSM (AWS KMS, GCP Cloud KMS, Azure Key Vault) zarządzający kluczami głównymi.
Vault – HashiCorp Vault – menedżer tajemnic HashiCorp Vault; Wiodąca platforma centralnego składowania, rotacji i audytu dostępu do haseł, tokenów i certyfikatów.

22/55 Git w praktyce: pierwsze kroki
Git w praktyce - pierwsze kroki: Podstawowe operacje: init/clone → add → commit → push/pull. git log = audyt historii, git diff = porównanie zmian, git blame = autor danej linii. Workflow: gałąź feature → commit → push → PR → recenzja → scalenie.

Codzienny Git w pięciu ruchach: init/clone, add, commit, push i pull. Do tego log, diff i blame.

  • Zakaz jawnych haseł w Git – fundamentalną regułą bezpieczeństwa w GitOps jest kategoryczny zakaz umieszczania otwartych sekretów w repozytoriach.
  • Zagrożenie wyciekiem danych – nawet prywatne repozytoria firmowe mogą paść ofiarą nieautoryzowanego dostępu lub pomyłkowego upublicznienia.
  • Kryptograficzna ochrona danych – sekrety muszą być szyfrowane przed zatwierdzeniem w Git lub dynamicznie pobierane z zewnętrznych skarbców.
  • Brak tajemnic w commitach – raz zatwierdzone hasło w historii rewizji pozostaje w niej na zawsze, wymagając natychmiastowej unieważniającej rotacji.
  • Separacja konfiguracji od sekretów – bezpieczna architektura ściśle rozdziela parametry działania usługi od wrażliwych kluczy kryptograficznych.
git blame: Wskazanie autora każdej linii; z git log (audyt) i git diff (porównanie) - podstawy w workflow feature → PR → recenzja → scalenie.
konsola Git
CLI · Git: pierwsze polecenia
user@server:~$ git init Initialized empty Git repository in /home/user/sre/.git/ user@server:~$ git add docker-compose.yml user@server:~$ git commit -m "Konfiguracja podstawowa" [master (root-commit)] 1a2b3c4 Konfiguracja podstawowa user@server:~$ git log --oneline 1a2b3c4 Konfiguracja podstawowa
Tajemnice i hasła w GitOps: Złota zasada GitOps brzmi: Wszystko musi być w Git. Druga zasada brzmi: Nigdy nie commituj haseł otwartym tekstem! Jak pogodzić te sprzeczności? Rozwiązaniem jest asymetryczne szyfrowanie danych (narzędzia takie jak Sealed Secrets lub SOPS) albo referencje do zewnętrznych sejfów (External Secrets Operator). W repozytorium ląduje wyłącznie bezpieczny szyfrogram lub wskaźnik do klucza w AWS KMS/Vault, a deszyfrowanie odbywa się dopiero w pamięci klastra.

Praktyczne pierwsze kroki z Git są fundamentem pracy w modelu GitOps, bo to właśnie Git staje się centrum sterowania infrastrukturą. Zaczynamy od inicjalizacji repozytorium (git init) lub pobrania istniejącego (git clone), potem przechodzimy normalny cykl: zmieniamy pliki, dodajemy je do tymczasowego obszaru (git add), zapisujemy w commitach, wysyłamy do zdalnego repozytorium (git push) i pobieramy zmiany innych (git pull). Wokół tego kręcą się pozostałe operacje: przeglądanie historii (git log, git show), porównywanie zmian (git diff), cofanie błędów (git restore, git reset, git revert), praca na gałęziach (branch, checkout, switch, merge) i zarządzanie zdalnymi repozytoriami (remote, fetch, prune). Bezpieczne posługiwanie się każdą z nich to codzienna rutyna każdego inżyniera SRE.

Przyjrzyjmy się bliżej dwóm najczęstszym operacjom. git push wysyła lokalne commity do zdalnego repozytorium; pierwszy raz robimy to z flagą -u, by ustawić tzw. śledzenie gałęzi (git push -u origin main), a kolejne wypchnięcia odbywają się już zwykłym git push. Wymuszone wypchnięcie nazywamy siłą rzeczy niebezpiecznym - dlatego właściwa forma to git push --force-with-lease, która sprawdza, czy zdalna gałąź nie zmieniła się po naszym ostatnim pobraniu, i chroni przed nadpisaniem czyichś zmian. git pull natomiast to skrót: najpierw pobiera zmiany (fetch), a potem scala je z lokalną gałęzią (merge) lub przestawia na ich wierzch (rebase). Liniową historię utrzymamy ustawieniem git config --global pull.rebase true. Jeśli przy scalaniu pojawi się konflikt, rozwiązujemy go ręcznie, dodajemy pliki i finalizujemy commitem scalenia.

Historia commitów to z kolei główne narzędzie audytu i debugowania. Podstawowe wywołania to git log (wszystkie commity), git log --oneline (krótkie hashe z opisami), git log --graph --oneline --all (wizualizacja gałęzi), a w węższych scenariuszach: git log --since="2 weeks ago", git log --author="Jan" czy git log --grep="bug". Pełną treść zmian daje git log -p, statystyki - git log --stat, a historię pliku nawet po zmianie nazwy - git log --follow <plik>. Format dostosowujemy wygodnym git log --format="%h %an %ad %s", a ulubione komendy można skrócić aliasem, np. git config --global alias.lg "log --graph --oneline --all --decorate".

Zestaw przykładowych poleceń podsumowuje cały codzienny cykl: # Inicjalizacja i pierwszy commit git init git add docker-compose.yml git commit -m "chore: initial compose config" git branch -M main git remote add origin git@github.com:org/repo.git git push -u origin main # Codzienna praca git checkout -b feature/new-service # ... edycja plików ... git add . git commit -m "feat: add new service config" git push -u origin feature/new-service # Otwórz PR na GitHub/GitLab # Po code review i scaleniu git checkout main git pull git branch -d feature/new-service git fetch --prune # Historia i debugowanie git log --oneline --graph --all git log --oneline --since="1 week ago" git show <commit-hash> git diff <commit1> <commit2> git blame <plik> W tym workflow wszystko, co istotne, trafia w jednym strumieniu: zmiany idą w izolowanej gałęzi, przechodzą recenzję w Pull Requescie, a po scaleniu działają dalej w procesie GitOps.

Wyjaśnienie skrótów użytych na slajdzie:
git-init – git init command – polecenie inicjalizacji repozytorium; Utworzenie nowej bazy kontroli wersji w lokalnym katalogu projektowym.
git-add – git add command – polecenie indeksowania zmian; Przeniesienie zmodyfikowanych manifestów infrastruktury do poczekalni (staging area).
git-commit – git commit command – polecenie zatwierdzenia zmian; Trwałe utrwalenie zindeksowanych modyfikacji w lokalnej bazie historii pod unikalnym skrótem SHA.
git-status – git status command – polecenie weryfikacji stanu; Wyświetlenie listy zmodyfikowanych, zindeksowanych i nieśledzonych plików w drzewie roboczym.
git-log – git log command – polecenie przeglądu historii; Inspekcja chronologicznej listy zatwierdzeń wraz z informacją o autorach i komunikatach zmian.

23/55 Konfiguracja zdalnego repo
Konfiguracja zdalnego repo: Remote to centralne repozytorium (GitHub/GitLab/Gitea). Clone = pobranie pełnej kopii. Uwierzytelnienie: SSH (zalecane, klucz ed25519) lub HTTPS + PAT (Personal Access Token). GitHub CLI (gh) ułatwia zarządzanie.

Bez remote nie ma zespołu: centralne repo spina push i pull. Clone, klucze i CLI w pigułce.

  • Szyfrowane sekrety Sealed Secrets – mechanizm pozwala na bezpieczne wersjonowanie haseł w Git dzięki asymetrycznemu szyfrowaniu kluczem publicznym.
  • Szyfrowanie po stronie klienta – programista szyfruje wrażliwą wartość za pomocą narzędzia konsolowego kubeseal i klucza publicznego klastra.
  • Bezpieczne wersjonowanie – zaszyfrowany obiekt SealedSecret może być bezpiecznie zatwierdzony w publicznym repozytorium kodu.
  • Deszyfrowanie przez operatora – kontroler w klastrze posiada klucz prywatny i automatycznie przekształca zasób w standardowy obiekt Secret.
  • Ochrona klucza prywatnego – klucz prywatny nigdy nie opuszcza pamięci klastra, co gwarantuje pełne bezpieczeństwo danych w repozytorium.
PAT (Personal Access Token): Token do uwierzytelniania HTTPS; obok SSH z kluczem ed25519 i GitHub CLI (gh) do zarządzania zdalnym repo.
zdalne repo
CLI · Git: repozytorium zdalne
user@server:~$ git remote add origin git@github.com:user/sre.git user@server:~$ git push -u origin main To github.com:user/sre.git * [new branch] main -> main user@server:~$ git clone git@github.com:user/sre.git Cloning into 'sre'...

Konfiguracja zdalnego repozytorium to kluczowy krok w pracy z Git w modelu GitOps. Remote to centralne miejsce przechowywania kodu i manifestów, do którego członkowie zespołu wysyłają swoje zmiany (push) i skąd pobierają cudze (pull/fetch). W praktyce używamy kilku poleceń: dodanie zdalnego repo (git remote add), klonowanie istniejącego (git clone), uwierzytelnienie (klucze SSH, tokeny HTTPS, GitHub CLI), zarządzanie wieloma zdalnymi repozytoriami (origin i upstream przy forkach), synchronizacja (fetch, pull, push), ustawianie śledzenia gałęzi i czyszczenie (git remote prune). Bez nich nie ma współpracy zespołowej - a ta jest istotą GitOps.

git clone pobiera pełną kopię repozytorium - całą historię, gałęzie i tagi - do lokalnego katalogu. Dostępne są trzy protokoły. HTTPS (git clone https://github.com/org/repo.git) jest prosty: przy wypychaniu podajemy token lub hasło; dla SSH (git clone git@github.com:org/repo.git) potrzebujemy pary kluczy (ssh-keygen -t ed25519, ssh-agent). W środowiskach CI/CD wykorzystujemy też warianty klonowania: shallow clone (git clone --depth=1) pobiera tylko ostatni commit, co przyspiesza pipeline, a mirror clone (git clone --mirror) tworzy pełną kopię do celów backupu. GitHub CLI (gh repo clone) to wygodna alternatywa.

Uwierzytelnienie to zwykle wybór między SSH a HTTPS. SSH jest uznawane za bezpieczniejsze: klucz prywatny (id_ed25519) trzymamy lokalnie, klucz publiczny dodajemy na GitHubie czy GitLabie, a ssh-agent przechowuje odblokowany klucz w pamięci. HTTPS używa Personal Access Token (PAT) - w GitHubie konfigurujemy go w Developer settings z odpowiednimi zakresami (scopes: repo, workflow), a Git Credential Manager potrafi zapamiętywać token w systemowej magazynie haseł. GitHub CLI upraszcza sprawę do jednego polecenia gh auth login, które samodzielnie przygotowuje konfigurację SSH lub HTTPS. Krótko mówiąc: SSH wygrywa bezpieczeństwem, HTTPS + PAT wygodą na początek.

Rzeczowy przykład zestawu poleceń wygląda tak: # Dodanie remote git remote add origin git@github.com:org/repo.git git remote -v (weryfikacja) # Klonowanie git clone git@github.com:org/repo.git git clone --depth=1 https://github.com/org/repo.git (shallow) # Uwierzytelnienie SSH ssh-keygen -t ed25519 -C "user@company.com" ssh-add ~/.ssh/id_ed25519 cat ~/.ssh/id_ed25519.pub (dodaj na GitHub/GitLab) # Remote management git remote add upstream git@github.com:org/upstream-repo.git git fetch upstream git remote prune origin (czyszczenie usuniętych remote branches) # GitHub CLI gh auth login gh repo clone org/repo W modelu forków typowe jest posiadanie dwóch zdalnych repozytoriów: origin wskazuje nasz fork, a upstream oryginalne repozytorium organizacji, z którego pobieramy cudze zmiany. W czystym GitOps każde repozytorium to z reguły pojedyncze źródło prawdy dla konkretnej aplikacji lub zespołu infrastruktury - a zarządzanie nim powyższymi komendami to codzienna rutyna.

Wyjaśnienie skrótów użytych na slajdzie:
git-remote – git remote command – polecenie zarządzania zdalnymi repozytoriami; Definiowanie adresów URL centralnych serwerów Git (np. origin) powiązanych z lokalnym projektem.
git-push – git push command – polecenie wysyłania zmian; Przesłanie lokalnych zatwierdzeń na serwer zdalny w celu uruchomienia potoków lub synchronizacji GitOps.
git-pull – git pull command – polecenie pobierania i scalania zmian; Pobranie nowych zatwierdzeń z centralnego repozytorium i scalenie ich z lokalną gałęzią roboczą.
SSH – Secure Shell Protocol – bezpieczna powłoka sieciowa; Kryptograficzny protokół autoryzacji operacji w Git za pomocą asymetrycznych kluczy Ed25519.
DeployKey – Read-Only Git Deploy Key – klucz wdrożeniowy tylko do odczytu; Dedykowany klucz publiczny SSH instalowany w klastrze, uprawniający operatora wyłącznie do pobierania kodu.

24/55 Wprowadzenie do Terraform (akcent GitOps)
Terraform - Infrastructure as Code: Narzędzie do tworzenia infrastruktury (VPC, EKS, RDS). Workflow: init → plan (podgląd zmian) → apply (wykonanie). Zarządzanie stanem: zdalny backend (S3 + blokada DynamoDB). W GitOps: .tf w Git → CI → plan/apply → sync ArgoCD.

Terraform pisze infrastrukturę w HCL: init, plan, apply. Stan zdalny, moduły z tagami, GitOps na końcu.

  • Narzędzie Mozilla SOPS – zaawansowany edytor plików konfiguracyjnych szyfrujący wyłącznie wartości pól, z zachowaniem jawnej struktury kluczy.
  • Obsługa formatów YAML i JSON – program doskonale współpracuje z plikami konfiguracyjnymi, szyfrując poufne parametry baz danych i tokeny.
  • Integracja z usługami chmurowymi – SOPS wspiera klucze KMS z platform AWS, GCP, Azure oraz tradycyjne klucze PGP i nowoczesny format age.
  • Czytelność rewizji w Git – dzięki widocznym nazwom pól inżynierowie mogą łatwo recenzować zmiany konfiguracji podczas procedury pull request.
  • Deszyfrowanie w pamięci – wtyczki do ArgoCD odszyfrowują pliki chronione przez SOPS bezpośrednio przed ich zaaplikowaniem na środowisko.
terraform plan: Podgląd zmian przed apply; workflow init → plan → apply ze zdalnym stanem (S3 + DynamoDB), a w GitOps: .tf w Git → CI → sync ArgoCD.
Terraform
CLI · Terraform: plan i apply
# terraform (plan/apply) user@server:~$ terraform plan Plan: 1 to add, 0 to change, 0 to destroy. user@server:~$ terraform apply -auto-approve Apply complete! Resources: 1 added.

W dojrzałej architekturze IaC narzędzia aprowizacyjne, takie jak OpenTofu / Terraform, odpowiadają za tworzenie zasobów bazowych (maszyn wirtualnych, sieci VPC, klastrów zarządzanych). Po uruchomieniu klastra kontrolę przejmuje operator GitOps.

Terraform to sztandarowe narzędzie Infrastructure as Code (IaC), idealnie wpisujące się w filozofię GitOps. Używa deklaratywnego języka HCL (HashiCorp Configuration Language) do opisywania infrastruktury u setek dostawców - AWS, Azure, GCP, Kubernetes - i to właśnie definiuje jego rolę: Terraform tworzy infrastrukturę, a ArgoCD wdraża na niej aplikacje. W modelu GitOps pliki .tf wersjonujemy w Git, poddajemy je recenzji, a w CI/CD uruchamiamy plan i apply. Ciekawostką jest też zarządzanie stanem: Terraform trzyma tzw. plik stanu opisujący aktualną infrastrukturę, dlatego w zespołach trzeba używać zdalnego backendu (np. S3 z blokadą DynamoDB albo Terraform Cloud) - inaczej nie ma mowy o bezpiecznej współpracy.

Podstawowy cykl pracy to cztery polecenia: terraform init (inicjalizacja - pobiera providery i konfiguruje backend), terraform plan (planowanie - porównuje aktualny stan z kodem i pokazuje plan zmian: + create, ~ update, - destroy), terraform apply (zastosowanie - wykonuje plan i aktualizuje plik stanu) oraz terraform destroy (usunięcie wszystkiego). Plan pełni też rolę "suchego przebiegu" (dry-run), a w CI zapisujemy go do pliku i po recenzji wykonujemy apply na podstawie tego samego pliku (terraform plan -out=tfplan, potem terraform apply tfplan), a w pipeline w pełni automatycznie z flagą -auto-approve. Warto podkreślić, że samo uruchomienie plan - bez apply - to skuteczna metoda wykrywania dryftu (zmian w infrastrukturze dokonanych poza Terraformem).

Wersjonowanie i utrzymywalność kodu Terraform zaczyna się od Git - historia zmian, code review i możliwość rollbacku to standard. Dalej idą moduły: wielokrotnego użytku, wersjonowane (źródło wskazuje konkretny tag, np. source = "git::https://github.com/org/terraform-module.git?ref=v1.2.0"), publikowane także w Terraform Registry. Wersje silnika i providerów ograniczamy wymaganiami (required_version = ">= 1.5.0", aws = "~> 5.0"), a środowiska rozdzielamy workspace'ami (dev, staging, prod), każdy z osobnym plikiem stanu. Wersjonowanie dotyczy też samego stanu: backend S3 z włączonym versioning i blokada przed równoczesnym apply to podstawa zespołowej pracy, a Terraform Cloud dodaje historię uruchomień i egzekwowanie polityk.

Integracja Terraforma z GitOps wygląda na prostą, ale jest bardzo istotna. Workflow: Pull Request ze zmianą .tf → plan w CI (komentarz na PR z podglądem) → review → merge → apply w pipeline → Terraform outputs (np. adres klastra czy bazy danych) → aktualizacja parametrów aplikacji (wartości Helm, patche Kustomize) → sync ArgoCD wdraża aplikacje na nowej infrastrukturze. W ten sposób Terraform tworzy infrastrukturę, a ArgoCD dostarcza oprogramowanie - razem budują pełny, zamknięty cykl GitOps, w którym każda warstwa jest wersjonowana i audytowalna.

Wyjaśnienie skrótów użytych na slajdzie:
HCL – HashiCorp Configuration Language – język konfiguracji HashiCorp; Czytelny, deklaratywny język strukturalny wykorzystywany do definicji zasobów w Terraformie.
State – Terraform State Mechanism – mechanizm stanu w Terraformie; Plik odwzorowujący deklaracje w kodzie na rzeczywiste identyfikatory zasobów utworzonych w chmurze.
tfstate – Terraform State File – plik stanu .tfstate; Wrażliwy plik przechowujący metadane infrastruktury, podlegający obowiązkowemu blokowaniu (State Locking).
Plan – Terraform Plan Execution – generowanie planu wykonania; Analiza sucha wykazująca jakie zasoby zostaną utworzone, zmodyfikowane lub skasowane przed wdrożeniem.
Apply – Terraform Apply Execution – zatwierdzenie wykonania zmian; Rzeczywista aprowizacja infrastruktury w chmurze na podstawie zatwierdzonego planu.

25/55 Ansible (akcent)
Ansible - Configuration Management: Narzędzie bez agenta (SSH), idempotentne, do konfiguracji istniejących zasobów. Playbooki (YAML) definiują pożądany stan: pakiety, usługi, pliki, firewall. W GitOps: playbooki w Git → CI → ansible-playbook/AWX → maszyny docelowe. Ansible = konfiguracja tego, co już istnieje.

Ansible konfiguruje to, co już stoi: bez agenta, przez SSH, idempotentnie. Playbooki w YAML, sekrety w Vault.

  • External Secrets Operator ESO – operator klastra, który pobiera hasła z zewnętrznych systemów i synchronizuje je do obiektów Secret.
  • Wsparcie zewnętrznych skarbców – integruje się z takimi rozwiązaniami jak AWS Secrets Manager, HashiCorp Vault czy Google Secret Manager.
  • Referencje zamiast wartości – w repozytorium Git umieszcza się wyłącznie bezpieczne referencje wskazujące na właściwe klucze w zewnętrznym sejfie.
  • Automatyczna rotacja haseł – kontroler cyklicznie odświeża wartości sekretów, gwarantując szybką propagację zmienionych haseł w klastrze.
  • Separacja odpowiedzialności – doskonale rozdziela zadania inżynierów bezpieczeństwa nadzorujących sejf od deweloperów piszących kod.
Playbooki: Pliki YAML pożadanego stanu (pakiety, usługi, pliki, firewall); bezagentowe przez SSH, idempotentne - konfiguracja tego, co istnieje.
Ansible
CLI · Ansible: uruchamianie playbooka
# ansible (playbook) user@server:~$ ansible-playbook -i hosts playbook.yml PLAY [webservers] ********** TASK [install nginx] ********** ok: [web1] ok: [web2]

Ansible to narzędzie do zarządzania konfiguracją (Configuration Management), które w modelu GitOps odgrywa rolę uzupełniającą wobec Terraforma: tam gdzie Terraform tworzy infrastrukturę, Ansible konfiguruje to, co już istnieje - systemy operacyjne, usługi i aplikacje na gotowych maszynach. Jest agentless, bo porozumiewa się przez SSH (a na Windows przez WinRM), i idempotentne: jeśli stan już odpowiada pożądanemu, Ansible nic nie zmienia, a ponowne uruchomienie daje ten sam wynik. Playbooki są deklaratywne i zapisane w YAML, a zarządzanie nimi przebiega dokładnie jak całą resztą w GitOps: wersjonowanie w Git, lint (ansible-lint, yamllint), testy (molecule), a potem wykonanie ansible-playbook na maszynach docelowych lub przez platformę AWX.

Podejście Ansible opiera się na pożądanym stanie. Definiujemy cel, np. "nginx ma być zainstalowany, usługa uruchomiona, port 80 otwarty", a Ansible decyduje, jak go osiągnąć: jeśli stan już istnieje, raportuje ok i nic nie robi; jeśli nie - instaluje, uruchamia i włącza usługę. Logika kryje się w modułach: package (instalacja pakietów), service (usługi systemd), file i template (pliki konfiguracyjne), systemd, firewalld, docker_container czy nawet k8s. Do tego dochodzą handlery - zadania "odroczone", uruchamiane na końcu playa tylko wtedy, gdy wcześniejszy task faktycznie zmienił stan (typowe: notify: restart nginx). Dzięki temu kolejne uruchomienia playbooka są bezpieczne i przewidywalne.

Integracja z GitOps to naturalny krok. Playbooki wersjonujemy w Git, w CI wykonujemy linting i testy (molecule), a następnie uruchamiamy je na maszynach docelowych - albo bezpośrednio, albo przez AWX (open source) czy Ansible Tower, które dodają interfejs, RBAC, planowanie zadań, zarządzanie poświadczeniami oraz synchronizację projektów z Git. Dla pełnego modelu Pull istnieje ansible-pull: agent na maszynie docelowej sam pobiera playbook z Git i wykonuje go lokalnie - dokładnie ta sama filozofia co ArgoCD. Jeśli Ansible zarządza zasobami Kubernetes, wyniki trafiają dalej do ArgoCD czy Flux; razem budują łańcuch: Terraform tworzy infrastrukturę, Ansible konfiguruje systemy, a ArgoCD wdraża aplikacje.

Wyjaśnienie skrótów użytych na slajdzie:
Playbook – Ansible Playbook Document – scenariusz automatyzacji Ansible; Plik YAML opisujący stan pożądany usług i plików na węzłach docelowych.
Agentless – Agentless Architecture – architektura bezagentowa; Zaleta Ansible polegająca na braku konieczności instalacji dodatkowego oprogramowania na serwerach docelowych.
SSH – Secure Shell Remote Access – bezpieczna komunikacja SSH; Protokół transportowy, przez który kontroler Ansible łączy się z zarządzanymi maszynami.
Idempotency – Idempotent Execution Principle – zasada idempotentności wykonania; Właściwość gwarantująca, że wielokrotne uruchomienie tego samego scenariusza nie zmieni stanu poprawnego systemu.
YAML – YAML Format in Ansible – format konfiguracji YAML; Format zapisu zadań i ról w ekosystemie automatyzacji Ansible.

26/55 Porównanie podejść IaC
Porównanie podejść IaC: Dobieramy narzędzie do zadania: Terraform = tworzenie infrastruktury, Ansible = konfiguracja istniejących zasobów, Compose = lokalne kontenery. Najlepsza praktyka: Terraform + Ansible + ArgoCD = pełny cykl życia GitOps.

Narzędzie do warstwy: Terraform tworzy, Ansible konfiguruje, Compose uruchamia lokalnie. Razem pełny cykl.

  • Centralny skarbiec HashiCorp Vault – kompleksowy system zarządzania tożsamością, certyfikatami oraz dynamicznymi sekretami w IT.
  • Dynamiczne dane dostępowe – Vault potrafi w ułamku sekundy wygenerować tymczasowe, unikalne konto bazodanowe dla nowo startującego poda.
  • Pobieranie wprost do pamięci – aplikacje mogą pobierać sekrety przez bezpieczne API, co eliminuje konieczność tworzenia plików z hasłami.
  • Ścisły rejestr audytowy – system szczegółowo loguje każde zapytanie o klucz lub hasło, uniemożliwiając niezauważoną kradzież danych w firmie.
  • Szczyt bezpieczeństwa platformy – połączenie skarbca Vault z dyscypliną GitOps stanowi uznany wzorzec najwyższego bezpieczeństwa w chmurze.
Pełny cykl GitOps: Terraform (tworzy) + Ansible (konfiguruje) + ArgoCD (wdraża); narzędzie dobrane do warstwy zamiast jednego do wszystkiego.
porównanie

Nowoczesnym pomostem łączącym zarządzanie infrastrukturą i aplikacjami jest platforma Crossplane, pozwalająca zarządzać zasobami chmurowymi za pomocą deklaratywnych manifestów CRD bezpośrednio z GitOps.

Podejść do Infrastructure as Code (IaC) i zarządzania konfiguracją jest kilka i w kontekście GitOps kluczem jest dobór narzędzia do zadania. Terraform tworzy infrastrukturę (VPC, EKS, RDS, IAM) - tzw. provisioning. Ansible konfiguruje systemy operacyjne, aplikacje i usługi na istniejących zasobach. Docker Compose uruchamia kontenery lokalnie lub na prostym hoście. Do tego Packer buduje gotowe obrazy (AMI, obrazy Docker), a Pulumi czy Crossplane umożliwiają pisanie infrastruktury w językach ogólnego przeznaczenia (TypeScript, Python, Go). Z pomocą tych narzędzi definiujemy też kluczowe rozróżnienia architektoniczne: provisioning vs configuration management, infrastrukturę mutowalną vs niezmienną (immutable), obecność lub brak agentów oraz podejście deklaratywne vs imperatywne - to one decydują, jak dane narzędzie współgra z filozofią GitOps.

Ansible reprezentuje zarządzanie konfiguracją. Jego zadaniem jest skonfigurowanie istniejącej maszyny albo kontenera: instalacja pakietów, konfiguracja usług, pliki konfiguracyjne, użytkownicy, uprawnienia, firewall, agenci monitorujące. Jest agentless (działa przez SSH lub WinRM), idempotentne i deklaratywne. Sięga się po niego, gdy infrastruktura już istnieje (maszyny wirtualne, bare metal, działający klaster), gdy nie można lub nie chce się instalować agentów i gdy potrzeba szybkich zadań ad-hoc. W GitOps znaczy to: playbooki w Git, przy czym Ansible działa raczej w modelu wypychania - choć ansible-pull pozwala też na model Pull. Krótko: Ansible konfiguruje to, co istnieje.

Compose to z kolei narzędzie do definiowania i uruchamiania wielokontenerowych aplikacji na pojedynczym hoście lub w klastrze Swarm; plik docker-compose.yml opisuje usługi, sieci, wolumeny, konfiguracje i sekrety. Idealnie sprawdza się w lokalnym development, testach integracyjnych w CI/CD, prostych wdrożeniach na jednej maszynie czy edge computing. W GitOps wersjonujemy compose.yml w Git i uruchamiamy go docker compose czy stack deploy, a kompose konwertuje definicję na manifesty Kubernetes. Trzeba jednak pamiętać o ograniczeniach: brak wysokiej dostępności, auto-skalowania, samo-naprawy, service mesh i RBAC - dlatego w produkcji Compose nie zastępuje Kubernetesa.

Zestawienie wygląda następująco. Terraform to provisioning infrastruktury niezmiennej, z plikiem stanu, deklaratywny, oparty na providerach, z modelem plan/apply - i bardzo dobrze wpisuje się w GitOps. Ansible to konfiguracja istniejących zasobów, mutowalna, bez agentów, idempotentna, mix deklaratywny i proceduralny, działająca w modelu push/pull - dopasowanie do GitOps średnie, bo wymaga dostarczania przez CI. Compose to lokalne lub proste kontenery z YAML i up/down - to "GitOps lite" o niskim dopasowaniu. Pulumi to IaC w językach programowania, deklaratywne z plikiem stanu, dopasowane do GitOps tak jak Terraform. Praktyczna rekomendacja jest jedna: Terraform do tworzenia infra, Ansible do konfiguracji systemów, ArgoCD do wdrażania aplikacji - razem dają kompletny cykl życia, a Compose zostaje dla dev/test/edge.

Wyjaśnienie skrótów użytych na slajdzie:
Declarative – Declarative IaC Approach – podejście deklaratywne w IaC; Deklarowanie stanu docelowego (np. 'ma istnieć 3 serwery'); silnik sam ustala sekwencję działań (Terraform, K8s).
Imperative – Imperative Configuration Approach – podejście imperatywne; Wykonywanie sekwencji poleceń krok po kroku (np. skrypty Bash); podatne na błędy przy ponownym uruchomieniu.
Terraform – HashiCorp Terraform Tool – narzędzie Terraform; Deklaratywny lider aprowizacji warstwy sprzętowej i sieciowej.
Ansible – Red Hat Ansible Platform – platforma Ansible; Narzędzie hybrydowe zorientowane na konfigurację systemów operacyjnych i instalację pakietów.
Pulumi – Pulumi Code-first IaC – platforma Pulumi; Nowoczesne narzędzie IaC umożliwiające definiowanie infrastruktury w językach programowania ogólnego przeznaczenia (TypeScript, Python, Go).

27/55 Pull vs Push w GitOps
Model Pull vs Push: Push (tradycyjny CI/CD): CI ma poświadczenia do klastra → ryzyko. Pull (GitOps): agent w klastrze pobiera z Git → bezpieczniej, skalowalnie, z samo-naprawą. Model Pull = standard GitOps (ArgoCD, Flux).

Pull czy Push? Kto trzyma klucze do produkcji, ten ryzykuję. Pull wygrywa bezpieczeństwem i samonaprawą.

  • Deklaratywny Docker Compose – narzędzie stanowi świetne wprowadzenie do idei GitOps, oferując deklaratywny opis środowiska na pojedynczym hoście.
  • Struktura pliku konfiguracyjnego – pojedynczy plik definiuje powiązane kontenery, sieci wirtualne oraz wolumeny trwałej pamięci dyskowej.
  • Pełna powtarzalność stosu – wersjonowanie pliku docker-compose.yml w Git pozwala na bezproblemowe uruchomienie całego stosu jednym poleceniem.
  • Automatyzacja na małą skalę – proste skrypty mogą monitorować repozytorium i restartować kontenery po wykryciu nowych wersji obrazów.
  • Idealne narzędzie lokalne – Compose doskonale sprawdza się na stacjach roboczych inżynierów oraz dedykowanych maszynach brzegowych.
Ryzyko poświadczeń: W modelu Push CI trzyma dostęp do klastra; w Pull agent ciągnie z Git - bezpieczniej, skalowalniej, z samonaprawą (ArgoCD, Flux).
pull/push

Wybór między modelem Push a Pull to jedna z kluczowych decyzji architektonicznych w GitOps - wpływa na bezpieczeństwo, skalowalność i niezawodność całego systemu. W modelu Push (tradycyjny CI/CD) serwer CI/CD - Jenkins, GitLab CI czy GitHub Actions - przechowuje poświadczenia do klastra i aktywnie "wpycha" zmiany: wykonuje kubectl apply, helm upgrade czy terraform apply. W modelu Pull (natywny dla GitOps) agent żyjący w klastrze - ArgoCD czy Flux - cyklicznie "ciągnie" zmiany z Git i sam je stosuje. Poniżej porównamy oba podejścia pod kątem architektury, bezpieczeństwa, skalowalności, niezawodności, audytu, wykrywania dryftu i samo-naprawy.

W modelu Push serwer CI/CD trzyma kubeconfig bądź token konta usługi i sam wdraża. Zalety? Prosty, dobrze znany wzorzec, pełna kontrola z poziomu CI i natychmiastowe wdrożenie. Wady są jednak poważne: system CI dysponuje uprawnieniami administratorskimi do produkcji, więc jego kompromitacja oznacza kompromitację całego środowiska; możliwe są "ucieczkowe" pętle wdrożeniowe; trudno ustalić, kto faktycznie co wdrożył; każdy nowy klaster wymaga kolejnych poświadczeń w CI; a po samym wdrożeniu nikt nie pilnuje, czy klaster nie odchylił się od stanu - brak samo-naprawy. Do tego serwer CI stanowi pojedynczy punkt awarii: awaria systemu ciągłej integracji całkowicie uniemożliwia realizację wdrożeń produkcyjnych.

W modelu Pull agent w klastrze (Application Controller ArgoCD czy kontrolery Flux) co trzy minuty - to domyślny interwał, konfigurowalny - porównuje Git z klastrem i stosuje zmiany. Agent ma uprawnienia RBAC tylko do swojego klastra i nic poza nim; CI/CD nie ma żadnego dostępu do klastra. Możliwa rola CI to budowa obrazy, testy i wypchnięcie zaktualizowanych manifestów do Git - i to wszystko. Zyskujemy potem pełny pakiet korzyści: CI nie może skompromitować produkcji, agent jest naturalną izolacją, stale pilnuje dryftu i sam go naprawia (self-healing), a kolejne klastry to po prostu kolejni agenci pobierający z Git. Całość jest w pełni audytowalna, bo historię zmian czyta się wprost z Git. Jedyną realną wadą jest opóźnienie równe interwałowi odpytywań.

Porównanie punkt po punkcie: bezpieczeństwo - wygrywa Pull (CI bez dostępu do produkcji); skalowalność - Pull (agent na klaster zamiast poświadczeń w CI); samo-naprawa - Pull (agent monitoruje dryft), Push nie ma; audyt - Pull ma w Git, Push ma w logach CI; opóźnienie - Push natychmiastowe, Pull do 3 minut; złożoność - Push prostszy na start, Pull wymaga agenta. Z tego powodu standardem GitOps jest model Pull (ArgoCD, Flux), a najlepszym rozwiązaniem hybrydowe łączenie: CI buduje i commituje manifesty, agent pobiera i wdraża - to połączenie najlepszych stron obu światów.

Wyjaśnienie skrótów użytych na slajdzie:
PullModel – Pull-based GitOps Architecture – architektura modelu Pull; Wzorzec, w którym agent wewnątrz klastra cyklicznie odpytuje repozytorium przez wychodzące łącze HTTPS.
PushModel – Push-based CI/CD Architecture – architektura modelu Push; Wzorzec, w którym zewnętrzny serwer budujący wypycha zmiany do klastra przez publiczny port API.
ClusterAPI – Kubernetes API Server Endpoint – punkt końcowy API Kubernetesa; Krytyczny interfejs kontrolny klastra, którego porty nie powinny być wystawiane do publicznego Internetu.
Firewall – Network Boundary Firewall – zapora sieciowa; Bariera ochronna uniemożliwiająca bezpośrednie nawiązywanie połączeń z zewnątrz do węzłów klastra produkcyjnego.
BlastRadius – Security Blast Radius – promień rażenia kompromitacji; Zakres zniszczeń w infrastrukturze; model Pull drastycznie ogranicza promień rażenia przy przełamaniu zabezpieczeń serwera CI.

28/55 Dryft i samonaprawa
Dryft i samo-naprawa: Dryft (dryf konfiguracji) = rozbieżność między Git (stan pożądany) a klastrem (stan aktualny). Powody: ręczne zmiany, HPA, zewnętrzne kontrolery. Samo-naprawa = automatyczne naprawianie dryftu przez agenta GitOps (ArgoCD selfHeal=true).

Dryft to rozjazd Git-klaster: ręczne grzebanie, HPA i obce kontrolery. Self-heal wraca do Git bez pytania.

  • Polityki restartu w produkcji – stosowanie Docker Compose na serwerach wymaga zdefiniowania reguły restart: always dla kluczowych kontenerów.
  • Przydziały pamięci i procesora – należy określić maksymalne limity zasobów dla usług, zabezpieczając system przed wyczerpaniem pamięci operacyjnej.
  • Bezpieczne wstrzykiwanie zmiennych – hasła i parametry środowiskowe powinny być przekazywane przez odrębne, zabezpieczone pliki .env na maszynie.
  • Badanie kondycji healthcheck – wbudowane testy stanu zdrowia w pliku Compose pozwalają wykryć zawieszoną aplikację i wywołać restart procesu.
  • Stabilność prostych usług – właściwie skonfigurowane środowisko Docker Compose potrafi stabilnie i bezobsługowo utrzymywać mniejsze serwisy.
selfHeal=true: Automatyczne naprawianie dryftu przez agenta; przyczyny rozjazdu: ręczne zmiany, HPA, zewnętrzne kontrolery.
samonaprawa

Dryft i samo-naprawa to mechanizmy, które sprawiają, że stan klastra zawsze zgadza się ze stanem zdefiniowanym w Git. Dryft (dryf konfiguracji) to rozbieżność między stanem pożądanym (desired state w Git) a stanem aktualnym (actual state w klastrze). Źródła dryftu bywają różne: ręczne zmiany (kubectl edit, scale, delete), automatyczne skalowanie przez HPA czy VPA, działanie zewnętrznych kontrolerów (cert-manager, external-dns), awarie węzłów czy odnowienia certyfikatów. Przeciwnym mechanizmem jest samo-naprawa (self-healing): agent GitOps - ArgoCD lub Flux - sam wykrywa rozbieżność i automatycznie przywraca stan z Git. Do tego dochodzi konfiguracja prune, alertowanie i metryki opisujące czas wykrycia i naprawy.

Dryft definiujemy najprościej jako nierówność: stan klastra (Actual) ≠ stan w Git (Desired). ArgoCD i Flux wykrywają go w pętli rekonsyliacji - domyślnie co trzy minuty. Można wyróżnić kilka rodzajów dryftu. Dryft parametrów: zmiana wartości parametru (liczba replik, tag obrazu, zmienna środowiskowa, limity zasobów). Dryft strukturalny: dodanie lub usunięcie całego zasobu (nowy Sekret, usunięty Service). Dryft semantyczny: subtelna zmiana znaczenia - na przykład zmiana selektora etykiet w Service, przez co Pod przestaje otrzymywać ruch. Wreszcie dryft zewnętrzny: modyfikacje przez systemy pokroju cert-managera, external-dns czy HPA. Każdy z tych przypadków przekłada się w ArgoCD na status OutOfSync.

Samo-naprawa to automatyczne remedium. Gdy w konfiguracji Application ustawimy automated.selfHeal=true, Application Controller sam przywraca stan z Git przy każdym wykryciu dryftu - na przykład, jeśli ktoś zmieni repliki Deploymentu z 3 na 5, ArgoCD wykryje różnicę i przeskaluje z powrotem na 3. Flux robi to samo przez swoją pętlę rekonsyliacji z kontrolerami kustomize i helm. Opcjonalny prune (automated.prune=true) usuwa zasoby, które zniknęły z Git - ta opcja domyślnie wyłączona, bo jest niebezpieczna. Proces można kontrolować hookami: PreSync (np. wyłączenie bazy danych przed wdrożeniem), Sync i PostSync (np. przywrócenie bazy i test zadymienia). Własne kontrole zdrowia, definiowane w Lua, potrafią oznaczyć aplikację jako Degraded, co uruchamia alert i - w razie potrzeby - samo-naprawę.

Alertowanie na dryft opiera się na metrykach ArgoCD (status synchronizacji argocd_app_sync_status: 0 = Synced, 1 = OutOfSync, 2 = Degraded oraz zdrowie argocd_app_health_status) lub odpowiednikach Fluxa (flux_source_ready, flux_kustomization_ready). Typowe reguły: OutOfSync trwający ponad 5 minut - ostrzeżenie; Degraded - alert krytyczny; oba trafiają do Slacka czy PagerDuty, a Dashboards Grafana pokazują panele dryftu. Runbook przy takim alercie: sprawdź UI ArgoCD, obejrzyj diff, podejmij decyzję - pozwól samo-naprawie działać albo interweniuj ręcznie. Mierzymy czas wykrycia dryftu (czas od dryftu do wykrycia, zależny od interwału odpytywań), czas samo-naprawy (od wykrycia do przywrócenia) oraz MTTR i częstotliwość dryftu - i nie zapominajmy regularnie testować chaos engineeringiem: zabij Pod, zmień repliki i sprawdź, czy samo-naprawa zadziałała.

Wyjaśnienie skrótów użytych na slajdzie:
ConfigurationDrift – Configuration Drift Phenomenon – zjawisko dryftu konfiguracyjnego; Stopniowa, niekontrolowana rozbieżność konfiguracji wywołana doraźnymi, ręcznymi naprawami na serwerach.
SelfHealing – Automated Self-Healing Loop – automatyczna pętla samonaprawiania; Właściwość operatora GitOps natychmiast przywracająca stan zadeklarowany po wykryciu manualnej modyfikacji.
AutoSync – Automated Synchronization Mode – automatyczny tryb synchronizacji; Funkcja ArgoCD aplikująca zatwierdzone zmiany z Git do klastra bez konieczności klikania przez człowieka.
Reconciliation – Continuous Reconciliation Cycle – cykl ciągłego uzgadniania; Pętla sterowania, której zadaniem jest nieustanne dążenie do zrównania stanu rzeczywistego ze stanem pożądanym.
K8s – Kubernetes Native Control Loop – natywna pętla sterowania w Kubernetes; Fundament architektoniczny platformy, na którym bazują operatory synchronizacji GitOps.

29/55 GitOps dla wielu środowisk
GitOps dla wielu środowisk: Jedna definicja (base) + różnice per środowisko (overlays/values) + strategia promocji. Overlaye w Kustomize lub pliki values Helm per środowisko. ApplicationSet automatycznie generuje Aplikacje per środowisko.

Środowiska bez kopiuj-wklej: jedna baza plus jawne różnice. Zmiana w bazie leci wszędzie sama.

  • Infrastruktura w Terraformie – narzędzie służy do deklaratywnego tworzenia fundamentów infrastruktury, takich jak sieci, maszyny i bazy danych.
  • Integracja przez Atlantis – integruje proces planowania i wdrażania zmian w Terraformie bezpośrednio z komentarzami wewnątrz pull requestów.
  • Weryfikacja planu zmian – inżynierowie mogą przeanalizować wygenerowany plan modyfikacji w komentarzu przed ostatecznym zatwierdzeniem kodu.
  • Zdalny stan z blokadami – stan platformy przechowywany jest w zabezpieczonym magazynie, co zapobiega równoczesnemu nadpisywaniu zasobów.
  • Spójność świata chmurowego – połączenie Terraforma z metodyką GitOps zapewnia pełną kontrolę i powtarzalność środowisk chmurowych.
ApplicationSet: Generator Aplikacji ArgoCD per środowisko; jedna baza (base) plus overlaye Kustomize lub values Helma plus promocja.
środowiska

W zarządzaniu wieloma środowiskami standardem jest bezszablonowe narzędzie Kustomize wbudowane w kubectl. Zamiast kopiowania całych manifestów definiuje się katalog bazowy (base/) zawierający wspólne definicje obiektów oraz katalogi nakładek (overlays/dev, overlays/prod). W nakładkach deklaruje się wyłącznie specyficzne dla danego środowiska modyfikacje (liczbę replik, limity pamięci RAM, domeny Ingress), eliminując duplikację kodu i ryzyko błędów konfiguracyjnych.

Praca z wieloma środowiskami to jeden z codziennych problemów zespołów SRE: dwa środowiska różniące się drobiazgami potrafią zepsuć wdrożenie w sposób, którego nie da się odtworzyć lokalnie. GitOps rozwiązuje to przez zasadę „jedna definicja aplikacji + różnice per środowisko". Bazowa definicja (base) - Deployment, Service, ConfigMap - jest wspólna, a poszczególne środowiska rozbijają się na tzw. overlaye w Kustomize albo osobne pliki values w Helmie. Dzięki temu zmiana w bazie trafia automatycznie wszędzie, a różnice między środowiskami są jawne i wersjonowane, a nie rozsiane po konfiguracji serwerów. Do tego dochodzi strategia promocji zmian między środowiskami oraz narzędzie ApplicationSet, które potrafi generować osobne aplikacje ArgoCD dla każdego środowiska.

Najczęściej spotykaną strukturą jest monorepo: katalog apps/ zawiera definicje aplikacji (bazę i overlaye), infra/ konfigurację infrastruktury (np. Terraform), a environments/ środowiska dev, staging i prod. Osobne środowiska realizujemy albo overlayami Kustomize - na przykład overlays/dev z jedną repliką i obrazem deweloperskim, overlays/prod z większą liczbą replik i limitami zasobów - albo wartościami Helm: values.yaml jako baza plus values-dev.yaml, values-staging.yaml i values-prod.yaml. Alternatywą jest model polyrepo, w którym każda aplikacja lub środowisko ma własne repozytorium; daje większą izolację i mniejsze klony, ale utrudnia zmiany obejmujące wiele aplikacji i traci atomowość commitów. Wybór zależy głównie od rozmiaru organizacji i liczby zespołów - w praktyce monorepo sprawdza się dobrze, gdy zmiany często dotykają wielu aplikacji naraz.

Kolejnym elementem jest promocja zmian między środowiskami, czyli sposób, w jaki wersja przemieszcza się z dev przez staging do produkcji. Promocja ręczna polega na tagowaniu Gita (git tag v1.2.3) i zatwierdzeniu synchronizacji w interfejsie ArgoCD; to najprostszy model, w którym decyzja należy do człowieka. Promocja automatyczna synchronizuje staging po scaleniu do main, a do produkcji przechodzi dopiero po upływie czasu lub po zdaniu testów - tu ArgoCD może posłużyć się AnalysisRun z metrykami. Promocja oparta na pull requestach, z main do gałęzi release, scala się po akceptacji i automatycznie wdraża do produkcji. Z kolei promocja tagiem korzysta z generatora git w ApplicationSet: utworzenie tagu v1.2.3-prod sprawia, że środowisko produkcyjne zostaje skonfigurowane do tej wersji. I tu właśnie pojawia się ApplicationSet z generatorami (matrix łączący klastry i środowiska, list czy cluster), które automatycznie tworzą i utrzymują osobne Applications per środowisko - bez ręcznego dodawania ich w UI.

Ostatni element to parzystość środowisk (environment parity) i kontrola dryftu między nimi. Dążymy do tego, by środowiska różniły się tylko w uprawnionych miejscach: liczbie replik, limitach zasobów, tagu obrazu, hoście ingressa i sekretach. Kiedy różnice wykraczają poza te punkty, pojawia się ryzyko klasycznego „działa na stagingu, pada na produkcji". Do wykrywania takich rozjazdów przydają się helm diff i kustomize build porównujące wartości lub overlaye środowisk, a samo ArgoCD pokazuje przez ApplicationSet status synchronizacji każdego środowiska z osobna. Warto też zadawać sobie pytanie o testy: smoke testy po każdej synchronizacji, testy integracyjne na stagingu, a na produkcji canary. Mierzona w ten sposób dojrzałość promocji - poprawna weryfikacja na każdym środowisku przed kolejnym krokiem - to w praktyce najtańsze ubezpieczenie przed awariami produkcyjnymi.

Wyjaśnienie skrótów użytych na slajdzie:
Kustomize – Kustomize Overlay Engine – narzędzie Kustomize; Bezszablonowy silnik kompozycji manifestów eliminujący powielanie kodu pomiędzy środowiskami.
Overlays – Kustomize Environment Overlays – nakładki środowiskowe Kustomize; Katalogi różnicowe definiujące unikalne parametry dla poszczególnych etapów cyklu życia aplikacji.
Dev – Development Environment – środowisko deweloperskie; Przestrzeń uruchomieniowa dla programistów o zminimalizowanych limitach zasobów i pojedynczych replikach.
Staging – Staging / Pre-production Environment – środowisko przedprodukcyjne; Wierna kopia architektury produkcyjnej służąca do ostatecznych testów akceptacyjnych i wydajnościowych.
Prod – Production Environment – środowisko produkcyjne; Rzeczywiste środowisko obsługujące klientów zewnętrznych, podlegające najsurowszym rygorom dostępności.

30/55 Podsumowanie GitOps (cz. 1)
Podsumowanie GitOps (cz. 1): Trzy filary: 1) Git = Single Source of Truth, 2) Declarative manifests = desired state, 3) ArgoCD/Flux = reconciliation (sync, self-heal, drift detection). Docker Compose = GitOps lite dla dev/test/edge.

GitOps w zdaniu: deklaratywny stan w Git, realizowany przez agenta. Trzy składniki: Git, manifesty i rekonsyliacja.

  • Automatyzacja przez Ansible – umożliwia konfigurację systemów operacyjnych i serwerów za pomocą przejrzystych scenariuszy playbook w YAML.
  • Idempotencja operacji – kluczową cechą zadań w playbookach jest gwarancja osiągnięcia identycznego stanu niezależnie od liczby ich wywołań.
  • Skuteczne wdrażanie poprawek – wersjonowanie scenariuszy w Git pozwala na zautomatyzowane aplikowanie łatek bezpieczeństwa na setkach maszyn naraz.
  • Potoki orkiestracji systemowej – w modelu GitOps zmiany w konfiguracji hostów są automatycznie wdrażane przez potoki zaraz po zatwierdzeniu zmian.
  • Uzupełnienie dla kontenerów – Ansible świetnie współpracuje z platformami kontenerowymi, dbając o właściwe przygotowanie samych węzłów klastra.
GitOps lite: Docker Compose jako lekki GitOps dla dev/test/edge; pełny model to Git (SSoT) + manifesty (desired state) + rekonsyliacja.
podsumowanie

To podsumowanie pierwszej części wykładu - swoista "ściągawka" do powtórki kluczowych koncepcji przed egzaminem lub rozmową kwalifikacyjną. Przez ostatnie trzydzieści minut przeszliśmy od podstaw Gita aż do pełnej architektury GitOps z ArgoCD. Jeśli ktoś miałby zatrzymać się w połowie i podsumować jednym zdaniem, brzmiałoby tak: GitOps to deklaratywny stan zapisany w Git, automatycznie realizowany przez agenta w klastrze. Kluczowa terminologia to GitOps, desired state, reconciliation, drift, self-heal i cztery zasady OpenGitOps.

Zacznijmy od fundamentu: Git jako jedyne źródło prawdy (Single Source of Truth). GitOps w najprostszej definicji to połączenie trzech elementów: Git (SSoT), deklaratywne manifesty (desired state) oraz automatyczna rekonsyliacja (pull model). Git daje nam historię zmian, pełny audyt, możliwość natychmiastowego cofnięcia błędu poleceniem git revert, code review przed wdrożeniem i egzekwowanie zasad przez Branch Protection. Deklaratywność oznacza, że opisujemy "co chcemy mieć" (manifesty YAML: Deployment, Service, ConfigMap), a nie "jak to zrobić" - różnica między deklaratywnym a imperatywnym podejściem jest fundamentalna i wraca w każdym aspekcie GitOps. Pętla rekonsyliacji (reconciliation loop) w ArgoCD lub Flux ciągle porównuje stan pożądany z aktualnym i samodzielnie naprawia wszelkie odchylenia - to eliminuje configuration drift, ręczną administrację i problem "działa na mojej maszynie". Cztery zasady OpenGitOps to: deklaratywność, wersjonowanie i niezmienność (Git), automatyczne pobieranie (pull) oraz ciągła rekonsyliacja.

Przechodząc do ArgoCD i Compose: ArgoCD to pełnoprawny silnik GitOps dla Kubernetes - składa się z Application Controller (porównuje stan pożądany z rzeczywistym), Repo Server (pobiera manifesty z Git), API Server, Dex (uwierzytelnianie) i Redis (cache). Application CRD definiuje aplikację: source (repo, ścieżka, rewizja), destination (klaster, namespace) i syncPolicy (automatyczny sync, prune, self-heal). Synchronizacja to pętla: diff (porównanie), plan (co zostanie zmienione), apply (aplikacja zmian) i verify (weryfikacja stanu). Self-heal to automatyczna naprawa dryftu, prune to usuwanie zasobów, które zniknęły z Git. Web UI daje przegląd drzewa zasobów, historii, diff i możliwość rollbaku. Klient CLI pozwala na tworzenie, synchronizację i zarządzanie aplikacjami z linii poleceń. Docker Compose, z kolei, to "GitOps lite" dla środowisk developerskich, testowych i edge: compose.yml w Git, potem CI/CD, a na końcu docker compose up, Docker Swarm lub kompose do Kubernetes. Całość łączy się w spójny ciąg: Compose (dev) → konwersja przez kompose → manifesty K8s → ArgoCD (produkcja).

Podsumowując pierwszą część: Git daje źródło prawdy, deklaratywność opisuje pożądany stan, a rekonsyliacja przez ArgoCD lub Flux automatycznie realizuje i pilnuje ten stan. To rdzeń GitOps. ArgoCD jest silnikiem dla Kubernetes - auto-sync, self-heal, wykrywanie dryftu, rollback. Docker Compose uzupełnia jako narzędzie dla dev/test/edge. Cztery zasady - deklaratywność, wersjonowanie, automatyzacja i rekonsyliacja - to fundament, na którym zbudujemy dalsze części wykładu.

Wyjaśnienie skrótów użytych na slajdzie:
GitOps – Git Operations Paradigm – paradygmat GitOps; Podsumowanie pierwszej części wykładu poświęconej deklaratywnemu zarządzaniu klastrami.
ArgoCD – Argo CD Controller – kontroler ArgoCD; Wiodące narzędzie synchronizacji wizualizujące stan klastra w modelu GitOps.
Flux – Flux GitOps Suite – pakiet narzędziowy Flux; Modularny zestaw kontrolerów Kubernetes realizujący zasady GitOps.
Declarative – Declarative Infrastructure State – deklaratywny stan infrastruktury; Opis pożądanego kształtu systemów wersjonowany w repozytorium kodu.
SSOT – Single Source of Truth – pojedyncze źródło prawdy; Naczelna zasada inżynierska gwarantująca pełną audytowalność zmian w infrastrukturze.

31/55 Podsumowanie GitOps (cz. 2)
Podsumowanie GitOps (cz. 2): Proces zmian: Pull Request (quality gate) → Code Review (kultura) → CI checks (automatyzacja) → Branch Protection (egzekwowanie) → Merge → ArgoCD sync. Git = gatekeeper, ArgoCD = executor. Rollback = git revert.

Zmiana wchodzi bramkami: PR (jakość), review (kultura), CI (automaty) i ochrona (egzekucja). Git bramkarzem, ArgoCD wykonawcą.

  • Koniec potoku ciągłej integracji CI – nowoczesny etap CI kończy się zbudowaniem, przetestowaniem oraz opublikowaniem niemutowalnego obrazu.
  • Zatwierdzenie nowego tagu – potok wdrożeniowy CD nie wymusza zmian w klastrze, lecz zatwierdza nowy numer wersji obrazu w repozytorium Git.
  • Brak uprawnień roota w CI – rozdzielenie etapów sprawia, że serwer budujący nie musi posiadać niebezpiecznych uprawnień do klastra na produkcji.
  • Autonomiczne pobranie przez agenta – kontroler GitOps samoczynnie wykrywa nowy commit i wdraża aktualizację zgodnie z regułami bezpieczeństwa.
  • Redukcja wektorów ataku – odcięcie bezpośredniego dostępu z systemów CI do serwerów produkcyjnych drastycznie podnosi bezpieczeństwo platformy.
Git jako gatekeeper: Git pilnuje jakości (PR, review, CI, ochrona), ArgoCD wykonuje (sync); rollback to git revert.
słownik

Druga część podsumowania koncentruje się na procesie wprowadzania zmian - tym, jak bezpiecznie i skutecznie przeprowadzać modyfikacje w środowisku GitOps. To praktyczna "ściągawka": Pull Request jako brama jakości, Code Review jako element kultury organizacji, CI działający na PR jako automatyczna walidacja, Branch Protection jako egzekwowanie reguł oraz cały GitOps workflow od pusha przez merge aż do synchronizacji przez ArgoCD.

Pull Request to brama jakości (quality gate): żadna zmiana nie trafia do głównej gałęzi bez przejścia przez ten proces. Programista tworzy gałąź dedykowaną danej funkcji (git checkout -b feature/x), zapisuje commity zgodnie z konwencją Conventional Commits (feat:, fix:, chore:), wypycha gałąź do repozytorium i otwiera żądanie wciągnięcia zmian (Pull Request). Następnie odbywa się przegląd kodu (code review) oraz automatyczne testy CI (lintery, testy jednostkowe, skanowanie podatności). Dopiero po uzyskaniu akceptacji zespołu i pomyślnym wykonaniu potoku testowego następuje scalenie kodu (merge) i usunięcie gałęzi roboczej. Szablon PR określa opis zmiany, plan testów i procedurę wycofania, natomiast wersja robocza (Draft PR) umożliwia wczesną dyskusję bez ryzyka przedwczesnego scalenia kodu.

Code Review to nie tylko brama jakości, ale także doskonałe narzędzie dzielenia się wiedzą i audyt bezpieczeństwa. Czego szukamy podczas przeglądu? Poprawności logicznej (błędy, przypadki graniczne), bezpieczeństwa (wstrzykiwanie, sekrety, uprawnienia), wydajności (problemy N+1, wycieki pamięci), utrzymywalności (nazewnictwo, struktura, DRY, SOLID), testów (jednostkowych, integracyjnych, pokrycia) i dokumentacji (komentarze, README, CHANGELOG). Zatwierdzenie to LGTM (Looks Good To Me), a żądanie zmian blokuje merge. Plik CODEOWNERS automatycznie przypisuje recenzentów odpowiedzialnych za dane ścieżki, a lista kontrolna do przeglądu zapewnia spójność. Pary programistyczne to z kolei review w czasie rzeczywistym.

Branch Protection i CI to egzekwowanie zasad - techniczne wymuszenie tego, co organizacja ustaliła w kulturze. Reguły ochrony gałęzi (main) mogą wymagać: przynajmniej dwóch recenzji (z odrzuceniem przestarzałych i respektowaniem CODEOWNERS), wymaganych status checks (lint, testy, build, bezpieczeństwo, polityki), podpisanych commitów (GPG/SSH), liniowej historii (tylko squash/rebase), ograniczenia bezpośredniego pushu (tylko bot CI), rozwiązania wszystkich wątków dyskusji, zablokowania gałęzi oraz pomyślnego wdrożenia. Merge Queue automatycznie szereguje PR-y: rebase na bieżący main, CI, merge. Cały workflow GitOps od końca do końca: push gałęzi, CI (build, test, scan), PR, code review, zielony CI, merge (squash), commit w Git, ArgoCD wykrywa zmianę, auto-sync, klaster zsynchronizowany. Rollback to git revert i push - ArgoCD sam się zsynchronizuje. Git jest bramkarzem, ArgoCD wykonawcą.

Podsumowując: na proces GitOps składają się PR (brama jakości), code review (kultura), CI na PR (automatyzacja), Branch Protection (egzekwowanie) i Merge Queue (kolejkowanie). Opanowanie tego procesu to opanowanie zarządzania zmianami w GitOps.

Wyjaśnienie skrótów użytych na slajdzie:
Kustomize – Kustomize Configuration Tool – narzędzie Kustomize; Podsumowanie drugiej części wykładu poświęconej kompozycji manifestów i nakładkom.
Helm – Helm Package Manager – menedżer pakietów Helm; Narzędzie dystrybucji i wersjonowania aplikacji chmurowych.
SOPS – Mozilla SOPS Secrets Manager – narzędzie Mozilla SOPS; Standard bezpiecznego szyfrowania danych poufnych w plikach konfiguracyjnych.
SealedSecrets – Bitnami Sealed Secrets Controller – kontroler Sealed Secrets; Klastrowy mechanizm asymetrycznego deszyfrowania sekretów.
Drift – Configuration Drift Remediation – eliminacja dryftu konfiguracyjnego; Automatyczne korygowanie nieautoryzowanych modyfikacji w środowiskach produkcyjnych.

32/55 Praca własna: zadania (GitOps)
Praca własna: zadania GitOps: Praktyczne ćwiczenie: stwórz docker-compose.yml → wersjonuj w Git → skonfiguruj CI/CD → wdróż przez ArgoCD → przetestuj rollback i self-heal → zadokumentuj (RUNBOOK, CHANGELOG). Nauka przez robienie.

Praca własna: compose w Git, CI, ArgoCD, rollback z self-healem i dokumentacja. Nauka przez robienie.

  • Podpisywanie obrazów cosign – bezpieczeństwo łańcucha dostaw oprogramowania wymaga kryptograficznego podpisywania tworzonych kontenerów.
  • Blokowanie niepodpisanych obrazów – mechanizmy admission control w klastrze automatycznie uniemożliwiają uruchomienie niezweryfikowanych obrazów.
  • Cyfrowy spis komponentów SBOM – generowanie rejestru bibliotek pozwala na błyskawiczne sprawdzenie, czy oprogramowanie nie zawiera znanych luk.
  • Bramki jakościowe w potokach – skanery podatności wstrzymują proces wydania w przypadku wykrycia krytycznych błędów w dołączonych bibliotekach.
  • Integralność łańcucha wytwórczego – rygorystyczna kontrola dostawców chroni firmę przed wstrzyknięciem złośliwego kodu przez przejęte pakiety.
Nauka przez robienie: compose.yml (3 serwisy) → Git → CI/CD → ArgoCD → rollback i self-heal → RUNBOOK i CHANGELOG.
lista zadań

To zadanie domowe - praktyczny "hands-on lab", którego celem jest nauka przez robienie. Ćwiczenie prowadzi od zera do działającej infrastruktury GitOps: najpierw plik docker-compose.yml z co najmniej trzema serwisami, wersjonowany w Git; potem pełny proces synchronizacji zmian (feature branch, PR, CI, review, merge, sync przez ArgoCD); na koniec symulacja wdrożenia - weryfikacja, rollback i samo-naprawa. Wykonanie każdego z tych kroków wymaga uruchomienia konkretnych komend, więc kilka wskazówek ułatwi start.

Plik docker-compose.yml powinien zawierać co najmniej trzy serwisy - na przykład aplikację (app), bazę danych (db) i cache (Redis), choć można też dodać kolejkę czy worker. Każdy serwis zaopatrujemy w healthcheck (test GET do endpointu lub komenda trafiająca do bazy), depends_on z warunkiem service_healthy (żeby app startowała dopiero po gotowej bazie), własną sieć Docker i woluminy dla danych trwałych. Konfigurację wersjonujemy w Git - to fundament podejścia GitOps. Środowisko budujemy na przykład tak: git init w katalogu lab, plik compose.yml w katalogu aplikacji, prosta app (FastAPI + PostgreSQL + Redis), komenda docker compose build i docker compose up -d do weryfikacji lokalnej.

Synchronizacja zmian przebiega przez pełny proces GitOps: zakładamy gałąź funkcji (git checkout -b feature/cache), wprowadzamy zmiany (np. dodajemy Cache), stawiamy PR z pełnym opisem (zmiany, testowanie, plan wycofania), konfigurujemy CI, które sprawdza poprawność (docker compose config) i buduje serwisy (docker compose build), po review i zielonym CI mergujemy do main, a ArgoCD wykrywa nową wersję w Git i synchronizuje klaster. W ten sposób realizujemy pełną pętlę: deweloper committuje, CI waliduje, ArgoCD wdraża.

Na końcu symulujemy wdrożenie i testujemy GitOps w akcji. Po udanym sync sprawdzamy stan: kubectl get pods i przejście stron zależne od cache, curl do endpointów. Test rollbacku: zmieniamy wersję obrazu na zawierającą błąd, wdrażamy ją i obserwujemy awarię, następnie git revert + push - ArgoCD auto-sync przywraca poprzednią dobrą wersję. Test self-heal (opcjonalnie): ręcznie zabijamy kontener (docker compose stop lub kubectl delete pod), a agent GitOps odtwarza go automatycznie. Wszystko dokumentujemy w RUNBOOK (komendy, sekwencje, decyzje) i CHANGELOG (wersje, daty, notatki), a jako bonus można dodać skrypt bash automatyzujący start i stop środowiska. Taki lab można rozbudowywać kolejnymi komponentami - monitoring (Prometheus + Grafana), bezpieczeństwo, konfiguracja przez zmienne środowiskowe - i traktować jako studium przypadku dla realnych wdrożeń.

Wyjaśnienie skrótów użytych na slajdzie:
Minikube – Minikube Local Kubernetes – lokalny klaster Minikube; Lekkie środowisko uruchamiania jedno-węzłowego klastra Kubernetes na stacji roboczej studenta.
Kind – Kubernetes in Docker – klaster Kubernetes w kontenerach Docker; Wysokowydajne narzędzie tworzenia lokalnych klastrów wielowęzłowych do ćwiczeń z GitOps.
ArgoCD – Argo CD Deployment in Lab – wdrożenie ArgoCD w laboratorium; Instalacja kontrolera synchronizacji przeprowadzana samodzielnie przez studentów.
Git – Git Local and Remote Repositories – lokalne i zdalne repozytoria Git; Środowisko tworzenia commitów, gałęzi i propozycji zmian w manifestach ćwiczeniowych.
GitHub – GitHub Cloud Platform – platforma chmurowa GitHub; Publiczny serwis hostowania repozytoriów zintegrowany z laboratoriami akademickimi.

33/55 Najczęstsze błędy w GitOps
Najczęstsze błędy (anti-patterns): Top 3: 1) Brak recenzji (zero quality gate), 2) Dryft ignorowany (OutOfSync bez reakcji), 3) Brak testów (no rollback drills). Fix: Branch Protection + Code Review + CI + Self-heal + Alerting + Monthly drills.

Trzy grzechy GitOps: brak recenzji, ignorowany dryft i zero testów. Lekarstwa: ochrona, self-heal i drille.

  • Statyczna analiza kodu linters – narzędzia badają poprawność składniową i zgodność manifestów ze standardami przed zatwierdzeniem commita.
  • Walidacja struktury yamllint – program weryfikuje formatowanie i wcięcia w plikach, zapobiegając trudnym do wykrycia błędom struktury danych.
  • Audyt dobrych praktyk kube-score – narzędzie analizuje obiekty pod kątem definicji limitów zasobów procesora oraz sond sprawdzających gotowość.
  • Wymuszone testy w potokach – uruchamianie testów walidacyjnych w bramkach PR gwarantuje, że do repozytorium trafiają wyłącznie czyste manifesty.
  • Oszczędność czasu inżynierów – automatyczna inspekcja plików odciąża recenzentów i zapobiega paraliżowaniu klastra błędnymi manifestami.
OutOfSync bez reakcji: Ignorowany dryft jako grzech główny; obok braku recenzji i testów - naprawa przez ochronę, CI, self-heal i miesięczne ćwiczenia.
błędy

Katalog antywzorców (anti-patterns) w GitOps powstał na podstawie realnych incydentów i lekcji wyniesionych z produkcji. To swego rodzaju czarna lista: trzy główne grzechy, które sprawiają, że GitOps przestaje być skuteczny, a zaczyna być wręcz szkodliwy. Brak recenzji (zero bramy jakości), ignorowany dryft (stan klastra odjeżdża od Git bez reakcji) oraz brak testów (żadnych prób rollbacku czy chaos engineeringu). Każdy z tych punktów omówimy jako konkretny incydent, a na końcu podsumujemy, jak go rozwiązać.

Pierwszy grzech to brak recenzji - a więc zero jakiejkolwiek bramy jakości. Kiedy commit trafia bezpośrednio do głównej gałęzi (pomijając Pull Request, czasem nawet force pushem), tracimy wszystko, na czym zbudowaliśmy GitOps: zero audytu, zero code review, zero kontroli CI. Commit o treści "fix" bez kontekstu nie pozostawia żadnego śladu, kto, co i dlaczego zmienił. Brak pliku CODEOWNERS oznacza, że nikt formalnie nie odpowiada za obszar kodu, a brak wymaganych zatwierdzeń pozwala na merge bez jakiejkolwiek akceptacji. Konsekwencje są znane: błąd w produkcji, podatność bezpieczeństwa, naruszenie zgodności, a rollback utrudniony, bo brak kontekstu. Rozwiązanie to jesteśmy w stanie wymusić technicznie - Branch Protection z wymaganymi recenzjami i kontrolami, CODEOWNERS, wymagany szablon Pull Requestu, konwencjonalne commity i egzekwowanie wszystkiego w CI. Prosta reguła do zapamiętania: bez Pull Requestu nie ma merge.

Drugi grzech to ignorowany dryft. Dryf konfiguracji to rozjazd między stanem klastra a stanem w Git. Źródła mogą być rożne: ręczny kubectl edit/scale/delete, automatyczne skalowanie HPA/VPA, zewnętrzne kontrolery (cert-manager, external-dns), awarie węzłów. Skutki to status OutOfSync w ArgoCD, Degraded po nieudanych kontrolach zdrowia, luki bezpieczeństwa po zmianie polityki sieciowej czy naruszenie zgodności po zmianie limitów zasobów. Wykrywamy dryft przez status OutOfSync (ArgoCD) lub OutOfSync na Kustomization/HelmRelease (Flux) oraz alerty. Naprawiamy przez self-heal (auto-remediation) i manualny sync. Najlepsza prewencja to przede wszystkim kultura - żadnych ręcznych zmian w produkcji, wszystko tylko przez Git - oraz alerty (OutOfSync ponad 5 minut → alert). Zasada: dryft się zdarza, self-heal naprawia, a alertowanie ostrzega.

Porady praktyczne w kilku punktach. Po pierwsze, wdrażaj iteracyjnie: zacznij od minimalnego rozwiązania (3-5 paneli), potem rozwijaj o kolejne elementy na podstawie informacji zwrotnych, a wszystko wersjonuj w Git. Po drugie, Branch Protection to pozycja obowiązkowa - wymagane recenzje, kontrole, podpisane commity, liniowa historia. Po trzecie, code review to przymus (przynajmniej jedna akceptacja, CODEOWNERS). Po czwarte, CI na Pull Request to przymus (lint, testy, bezpieczeństwo, polityki). Po piąte, włącz self-heal i alerting na dryft. Po szóste, co miesiąc ćwicz rollback (git revert) i samo-naprawę (chaos engineering), dokumentuj runbooki i poddawaj całość miesięcznemu przeglądowi GitOps. Te trzy grzechy - brak recenzji, ignorowany dryft i brak testów - naprawiamy kombinacją: Branch Protection + Code Review + CI + self-heal + alerting + cykliczne próby awaryjne. Pamiętaj, że GitOps to kultura, a nie narzędzie.

Wyjaśnienie skrótów użytych na slajdzie:
PlaintextSecrets – Plaintext Secrets Anti-pattern – antywzorzec sekretów w jawnym tekście; Krytyczny błąd bezpieczeństwa polegający na umieszczeniu haseł i kluczy prywatnych w repozytorium Git.
ManualEdits – Manual kubectl edit Anti-pattern – antywzorzec ręcznych modyfikacji; Błąd niszczący spójność architektury poprzez doraźne zmienianie konfiguracji w działającym klastrze.
MissingOverlays – Duplicated Manifests Anti-pattern – antywzorzec kopiowania manifestów; Błąd utrzymaniowy polegający na powielaniu całych plików zamiast stosowania nakładek Kustomize.
MonolithicRepo – Unpartitioned Monorepo Anti-pattern – antywzorzec niepodzielonego repozytorium; Trzymanie setek niezależnych projektów w jednym katalogu bez separacji uprawnień i potoków.
NoCI – Missing Linting and Testing Gate – brak bramek testowych w CI; Zezwalanie na scalanie zmian do repozytorium bez uprzedniej weryfikacji składniowej i logicznej w potoku CI.

34/55 Wdrożenie przez ArgoCD (ćwiczenie)
Wdrożenie przez ArgoCD (ćwiczenie): Praktyczne ćwiczenie: stwórz Application (UI/CLI) → skonfiguruj sync policy (auto-sync, prune, selfHeal) → wykonaj sync → weryfikuj (resources tree, diff, history) → przetestuj rollback (git revert lub argocd app rollback).

Application zakładasz w UI, CLI albo YAML. Sync Policy, weryfikacja i rollback - potem troubleshooting.

  • Polityki jako kod Policy as Code – mechanizm umożliwia programistyczne egzekwowanie reguł bezpieczeństwa wewnątrz platformy Kubernetes.
  • Kontrolery Kyverno i Gatekeeper – silniki analizują każdy zgłaszany manifest i kategorycznie odrzucają obiekty naruszające polityki firmy.
  • Egzekwowanie dobrych praktyk – reguły zabraniają pracy na prawach administratora roota, wymuszają etykiety oraz blokują obce rejestry obrazów.
  • Blokada wadliwych commitów – nawet jeśli błędny manifest zostanie zatwierdzony w Git, kontroler klastra odmówi utworzenia niebezpiecznego poda.
  • Wygodne wersjonowanie reguł – definicje polityk bezpieczeństwa są wersjonowane w Git i automatycznie dystrybuowane na wszystkie klastry.
Resources tree: Drzewo zasobów do weryfikacji sync (z diff i historią); tworzenie Application przez UI/CLI z polityką auto-sync, prune, selfHeal.
ArgoCD UI

To kolejne praktyczne ćwiczenie, tym razem w całości wokół ArgoCD - od stworzenia zasobu Application, przez konfigurację polityki synchronizacji, wykonanie sync, weryfikację stanu i rollback. Przejdziemy ścieżką typowego dnia pracy operatora: tworzenie aplikacji w UI oraz przez CLI, automatyczna synchronizacja z opcjami prune i self-heal, weryfikacja na drzewie zasobów (resources tree), porównanie diff z Git, przegląd historii i na koniec rollback oraz rozwiązywanie problemów ze stanami OutOfSync, Degraded czy Sync Failed. To nauka przez robienie - najlepszy sposób na oswojenie się z ArgoCD.

Tworzenie Application zaczynamy od ArgoCD UI: New App, a następnie podajemy nazwę (myapp), projekt (default), źródło - repoURL (np. https://github.com/org/repo.git), ścieżkę w repozytorium (np. apps/myapp/overlays/prod) i rewizję docelową (main). Destination opisuje klaster (https://kubernetes.default.svc) i namespace (myapp-prod). Sync Policy ustawiamy na automated z prune: true i selfHeal: true, a opcje synchronizacji (syncOptions) mogą obejmować CreateNamespace=true czy PruneLast=true. Do dyspozycji mamy też Sync Windows (ograniczenie synchronizacji do godzin roboczych) oraz hooki - PreSync (np. skalowanie bazy w dół przed wdrożeniem) i PostSync (np. test zadymienia). Po utworzeniu ArgoCD tworzy zasób Application i - przy automatycznej polityce - sam się synchronizuje. Wersję CLI tworzymy komendą argocd app create z tymi samymi parametrami, a sam plik YAML definiujący Application może być wersjonowany w Git - spójnie z filozofią GitOps.

Sync i weryfikacja: synchronizacja manualna przebiega przez UI (Application → Sync, z opcjami Prune i Dry Run) albo komendą argocd app sync myapp. Przy auto-sync ArgoCD sam reaguje na zmiany w Git. Weryfikację prowadzimy na kilku poziomach. Resources Tree pokazuje każdy zasób ze statusem Synced/OutOfSync/Modified oraz Healthy/Degraded. Diff wyświetla różnice bok przy boku - Git versus żywy klaster. History pokazuje listę synchronizacji z rewizją, statusem, czasem i inicjatorem. Events to zdarzenia Kubernetes. Wykrywamy przy tym cztery statusy: Synced (zgodny), OutOfSync (rozbieżności), Degraded (nieudana kontrola zdrowia) i Suspended (wstrzymany). W CLI te same informacje uzyskamy przez argocd app get, diff i history - w jednym miejscu mamy pełną kontrolę nad aplikacją.

Rollback i troubleshooting: cofnięcie wdrożenia wykonujemy najprościej przez UI (History → wybierz rewizję → Rollback) lub poleceniem argocd app rollback myapp z numerem rewizji. Preferowanym podejściem jest jednak git revert: wycofujemy w Git właściwą zmianę, wypychamy, a ArgoCD auto-sync robi resztę - przywraca stan, który jest też prawdą w repozytorium. W sytuacjach awaryjnych szybszy jest argocd app rollback, ale nie aktualizuje Git. Rozwiązywanie problemów krok po kroku: OutOfSync → spójrz na diff i zdecyduj, czy zsynchronizować, naprawić ręcznie, czy zignorować; Degraded → sprawdź logi (kubectl logs), zdarzenia (kubectl describe) i skrypt kontroli zdrowia; Sync Failed → zajrzyj w zdarzenia, hooki (PreSync/Sync/PostSync - timeouty, błędy), konflikty zasobów (pola niezmienialne), przekroczenie przydziałów; Hook Failed → sprawdź skrypt PreSync przy timeout czy test zadymienia PostSync; Sync window - poczekaj lub chwilowo nadpisz. Pamiętaj: synchronizacja ArgoCD to pętla rekonsyliacji w akcji, a do dyspozycji masz i UI, i CLI. Zepsuj i napraw - najlepsza praktyka, nie teoria.

Wyjaśnienie skrótów użytych na slajdzie:
GitRepo – Git Application Repository – repozytorium aplikacji Git; Repozytorium zawierające manifesty podlegające synchronizacji w zadaniu laboratoryjnym.
AppSync – Manual and Automated Application Sync – synchronizacja aplikacji w ArgoCD; Praktyczne wykonanie operacji zrównania stanu klastra z gałęzią główną.
HealthCheck – Resource Health Check Verification – weryfikacja zdrowia zasobów; Sprawdzenie statusu uruchomienia podów w interfejsie konsoli webowej ArgoCD.
PodStatus – Pod Lifecycle and Phase Status – status cyklu życia podów; Analiza stanów Running, CrashLoopBackOff i ImagePullBackOff na ekranie studenta.
UI – ArgoCD Graphical Interface – graficzny interfejs ArgoCD; Panel analityczny wykorzystywany do inspekcji relacji pomiędzy obiektami K8s.

35/55 Studium: Compose + Git zamiast CI
Lightweight GitOps: Docker Compose + Git jako lekka alternatywa dla pełnego CI/CD. docker-compose.yml wersjonowany w Git, agent (Watchtower/custom script/cron) monitoruje Git i stosuje zmiany (compose pull + up). Dobry dla małych zespołów, edge, staging.

Lekki GitOps: Compose + Git + prosty agent zamiast pełnego CI/CD. Małym zespołom i edge w zupełności wystarcza.

  • Minimalne przywileje w Git – zarządzanie uprawnieniami w repozytorium GitOps musi realizować zasadę przydzielania niezbędnego minimum praw.
  • Zakaz bezpośrednich commitów – bezpośrednie zatwierdzanie zmian w gałęziach produkcyjnych powinno być zablokowane dla wszystkich pracowników.
  • Wymóg wniosków pull request – wprowadzanie zmian na produkcji musi odbywać się wyłącznie za pośrednictwem zrecenzowanych zgłoszeń zmian.
  • Restrykcyjne konta maszynowe – tokeny wykorzystywane przez automatyzację powinny posiadać wyłącznie wąskie uprawnienia do zapisu w wybranych plikach.
  • Cykliczny przegląd dostępów – regularna weryfikacja uprawnień użytkowników w repozytorium zapobiega pozostawaniu kont byłych pracowników firmy.
Polling Watchtowera: Okresowe sprawdzanie rejestru (np. co 5 minut) z compose pull + up; lekkie GitOps dla małych zespołów, edge i stagingu.
prosty przepływ

To studium przypadku pokazuje najprostszy możliwy model "GitOps bez serwera CI": Docker Compose w połączeniu z Git jako lekka, tania alternatywa dla pełnego CI/CD. Pomysł sprowadza się do tego, że plik compose.yml jest wersjonowany w Git, a na hoście działa prosty agent (Watchtower, własny skrypt, cronjob), który odświeża kontenery. W zależności od mechanizmu agent albo okresowo sprawdza rejestr obrazów, albo reaguje na webhook i - po wykryciu zmiany - wykonuje docker compose pull i docker compose up -d. Takie rozwiązanie świetnie sprawdza się w małych zespołach, w środowiskach testowych i stagazingowych oraz w edge computing, gdzie pełny Kubernetes byłby przerostem formy nad treścią.

Okresowa synchronizacja może działać na jeden z kilku sposobów. Pierwszy - polling: Watchtower domyślnie co 5 minut sprawdza rejestr obrazów, a po pojawieniu się nowego taga wykonuje docker compose pull i docker compose up -d; podobnie działa cronjob, np. crontab: */5 * * * * /opt/deploy.sh, czyli za każdym razem git pull i docker compose up -d. Drugi - webhook: GitHub Webhook budzi specjalnego odbiorcę, który natychmiast wykonuje git pull i docker compose up -d - to rozwiązanie natychmiastowe, ale wymaga publicznego endpointu. Trzeci - self-hosted runner GitHub Actions, który po pushu łączy się przez SSH i uruchamia skrypt wdrożeniowy. Polling jest prostszy, ale wprowadza opóźnienie; webhook jest natychmiastowy, ale wymaga dostępności sieciowej; cron to zwykłe polling. Wybór zależy od tego, jak szybko potrzebujemy reakcji.

Zalety są oczywiste: prostota - potrzebujemy tylko Dockera i Gita; niski koszt - brak serwera CI i Kubernetes; szybkie wdrożenia liczone w minutach; wersjonowanie w Git daje audyt i proste rollback przez git revert; całość jest czytelna nawet dla małego zespołu, bo nie wymaga rozbudowanej infrastruktury DevOps. Ograniczenia również trzeba znać: brak wysokiej dostępności (pojedynczy host), brak automatycznego skalowania (skala ręczna), brak service mesh typu Istio czy Linkerd, brak RBAC, a service discovery ograniczone do DNS Dockera. Co ważne, Watchtower nie rozumie Gita jako stanu pożądanego - porównuje tylko obrazy, więc nie ma prawdziwego wykrywania dryftu. Użycia: małe zespoły (1-5 osób), modernizacja aplikacji legacy (lift & shift do kontenerów), pojedyncze węzły edge, proste środowiska stagingowe i CI/CD. A kiedy projekt urośnie, jest naturalny most do pełnego GitOps: kompose convert generuje manifesty Kubernetes, a dalej podłącza się ArgoCD.

Podsumowując: Compose + Git to "GitOps lite". Doskonale nadaje się dla małych zespołów, prostych aplikacji, środowisk dev/test/staging, edge i modernizacji legacy. Nie nadaje się zaś do produkcji wymagającej wysokiej dostępności, auto-scalingu, service mesh czy pełnej zgodności. Drogę do pełnego GitOps wyznacza kompose → manifesty Kubernetes → ArgoCD. Wybór zawsze zależy od skali, zaplecza i wymagań - zasada zdroworozsądkowa: zaczynaj prosto, a migruj, gdy zajdzie potrzeba.

Wyjaśnienie skrótów użytych na slajdzie:
GitHook – Git Server-side Post-receive Hook – skrypt wyzwalany po odebraniu danych w Git; Skrypt powłoki uruchamiany na serwerze po wykonaniu pusha, wyzwalający automatyczną aktualizację.
ComposePull – docker compose pull and up command – polecenie pobrania i restartu kontenerów; Procedura odświeżenia obrazów i wdrożenia nowej wersji aplikacji w środowiskach bez orkiestratora.
SystemdTimer – Systemd Monotonic Timer – zegar systemd; Nowoczesny mechanizm Linuksa zastępujący demona cron w cyklicznym sprawdzaniu zmian w repozytorium.
Bash – Bash Automation Script – skrypt automatyzacji powłoki Bash; Prosty i niezawodny skrypt synchronizujący stan maszyn wirtualnych z repozytorium kodu.
Cron – Cron Scheduled Job – zadanie harmonogramu cron; Tradycyjne narzędzie okresowego wywoływania procedur sprawdzania nowości w gałęzi Git.

36/55 Narzędzia towarzyszące
Narzędzia towarzyszące GitOps: Tekton = CI/CD as Kubernetes-native pipelines. Argo Rollouts = progressive delivery (Blue-Green, Canary). Flagger = automated progressive delivery z metric analysis. Razem: Tekton (CI) → ArgoCD (sync) → Rollouts/Flagger (delivery).

Wokół ArgoCD/Fluxa cały ekosystem: Tekton buduje, Rollouts/Flagger wydają ostrożnie, reszta pilnuje sekretów i polityk.

  • Błyskawiczne wycofanie w Git – powrót do stabilnej wersji polega na wykonaniu prostego i bezpiecznego polecenia odwrócenia zatwierdzenia git revert.
  • Zachowanie pełnej historii – utworzenie nowego zatwierdzenia odwracającego wadliwe zmiany nie niszczy integralności osi czasu w repozytorium.
  • Automatyczna rekonsyliacja po cofnięciu – agent ArgoCD natychmiast wykrywa cofnięcie definicji i przywraca stabilną wersję na klastrze.
  • Przewidywalność procedury awaryjnej – proces wycofania jest w pełni audytowalny i nie wymaga nerwowego modyfikowania obiektów pod presją czasu.
  • Kluczowy atut metodyki GitOps – możliwość bezbłędnego przywrócenia stabilności platformy w kilkanaście sekund stanowi ogromną zaletę podejścia.
Progressive delivery: Progresywne dostarczanie (Blue-Green, Canary) przez Argo Rollouts/Flagger z analizą metryk; łańcuch Tekton (CI) → ArgoCD → Rollouts.
narzędzia

Obok platformy ArgoCD kluczowym silnikiem w ekosystemie jest Flux CD, zaprojektowany jako zestaw modułowych kontrolerów Kubernetes. Do pakietowania i parametryzowania złożonych aplikacji wykorzystuje się menedżer pakietów Helm, a do tworzenia chmurowych potoków CI/CD służy silnik Tekton CD.

Wokół ArgoCD i Fluxa powstał cały ekosystem narzędzi, które uzupełniają cykl życia GitOps. W tej części przyjrzymy się trzem najważniejszym: Tekton jako kubernetes-natywnemu CI/CD (definicje pipeline'ów jako zasoby Kubernetes), Argo Rollouts jako kontrolerowi do zaawansowanych strategii wdrożeń (Blue-Green, Canary, progressive delivery) oraz Flaggerowi, który automatyzuje progressive delivery na bazie analizy metryk. Po drodze wspomnimy też o towarzyszach zarządzania manifestami (Kustomize i Helm), sekretami (SealedSecrets, ExternalSecrets), infrastrukturą (Crossplane), politykami (Kyverno, OPA Gatekeeper) czy portalach dla deweloperów (Backstage). Wszystko razem składa się na platform engineering - budowanie zespołowego "internal developer platform".

Tekton to framework CI/CD osadzony natywnie w Kubernetesie - pipeline as code, czyli definicje potoków jako zasoby klastra. Podstawowe pojęcia: Task (krok z obrazem, skryptem, parametrami i wynikami), TaskRun (jednorazowe wykonanie Tasku), Pipeline (ciąg zadań połączonych wynikami), PipelineRun (wykonanie całego Pipeline'u), Workspace (współdzielone miejsce na dane) i PipelineResource (referencje do gita, obrazów, klastrów). Tekton opiera się na CRD-ach, więc działa tam, gdzie działa Kubernetes; jest serverlessowy (skaluje się do zera), przenośny i natywnie kompatybilny z GitOps - PipelineRun potrafi być wywoływany zdarzeniami z Gita. Właśnie za to odpowiada Triggers: EventListener, TriggerBinding i TriggerTemplate zamieniają webhook z GitHub na wykonanie PipelineRun. Tekton Hub to katalog gotowych Tasków, a Tekton Chains dodaje bezpieczeństwo łańcucha dostaw (SLSA, provenance, SBOM). Na koniec: Pipeline jako kod ma przewagę nad konfiguracją w narzędziu - jest wersjonowany, recenzowany i audytowalny razem z resztą projektu.

Argo Rollouts rozszerza klasyczny Deployment o strategie progressive delivery - Canary, Blue-Green i Eksperyment. W core leży nowy zasób Rollout, będący rozszerzeniem Deploymentu: stosuje te same PodTemplate i ReplicaSet, ale dodaje kontrolę nad sposobem wydawania wersji. Blue-Green: dwa zbiory replik (active/preview), a przełączenie ruchu następuje natychmiast po pełnym wdrożeniu nowej wersji. Canary: procentowe przesuwanie ruchu - na przykład 10%, 25%, 50%, 100% - z analizą metryk, pauzami i automatycznym przerwaniem w razie problemów. Eksperyment pozwala na równoległe testy A/B z podziałem ruchu. Analiza przebiega przez AnalysisTemplate i AnalysisRun, które odwołują się do metryk z Prometheusa, Datadoga, Wavefront czy Kayenta i zwracają wynik success/fail/inconclusive - a na tej podstawie Rollouts promuje, przerwie lub wycofuje. Ruch kierowany jest przez Service Mesh (Istio, Linkerd, Cilium), ALB, NGINX lub SMI. Przy awarii mamy natychmiastowy rollback (przerwanie canary - powrót do 100% stabilnej wersji; Blue-Green - przełączenie selektora Service'u). Obsługę zapewnia plugin do ArgoCD lub CLI kubectl argo rollouts.

Flagger to operator progressive delivery, który współpracuje z Fluxem, ArgoCD i Kubernetesem, automatyzując wdrożenia Canary i Blue-Green na podstawie analizy metryk z Prometheusa, Datadoga czy niestandardowych zapytań. Flagger sam steruje ruchem, mierzy jego skutki i podejmuje decyzję: promocja, pauza albo automatyczny rollback, gdy metryki przekroczą progi (np. spadek współczynnika sukcesu żądań, wzrost opóźnienia p99, wzrost liczby błędów). Integruje się z NGINX, Istio, Linkerd i App Mesh, a o zdarzeniach powiadamia Slacka, MS Teams, Discord czy PagerDuty. Całość układa się w kompletny potok GitOps: Tekton buduje i testuje, ArgoCD synchronizuje, a Rollouts albo Flagger dbają o płynne i bezpieczne wydanie zmian.

Wyjaśnienie skrótów użytych na slajdzie:
FluxCD – Flux GitOps Toolkit – zestaw narzędzi Flux CD; Alternatywny wobec ArgoCD modularny silnik GitOps wspierany przez fundację CNCF.
Tekton – Tekton Cloud Native Pipelines – chmurowe potoki Tekton; Standard deklaratywnego budowania potoków CI/CD bezpośrednio jako zasobów w Kubernetesie.
Helm – Helm Package Manager for K8s – menedżer pakietów Helm dla K8s; Narzędzie ułatwiające pakietowanie, wersjonowanie i parametryzację złożonych aplikacji.
Kustomize – Kustomize Template-free Engine – bezszablonowy silnik Kustomize; Narzędzie modyfikacji obiektów bez konieczności wprowadzania skomplikowanych instrukcji warunkowych.
Crossplane – Crossplane Cloud Control Plane – płaszczyzna sterowania chmurą Crossplane; Narzędzie rozszerzające API Kubernetesa o zarządzanie infrastrukturą AWS, GCP i Azure w modelu GitOps.

37/55 Wersjonowanie wersji aplikacji
Semantic Versioning (SemVer): Standard wersjonowania: MAJOR.MINOR.PATCH (np. 1.2.3). MAJOR = breaking, MINOR = nowe funkcje, PATCH = bugfixy. Git tags = punkty przywracania. CI/CD auto-tagging. ArgoCD targetRevision = co wdrażamy (tag/branch/SHA).

Wersje to MAJOR.MINOR.PATCH: łamiesz, dodajesz albo naprawiasz. Tagi to punkty powrotu, CI taguje samo.

  • Zjawisko dryfu konfiguracji – pojawia się w momencie, gdy rzeczywisty stan obiektów na klastrze zaczyna odbiegać od deklaracji w repozytorium Git.
  • Przyczyny rozbieżności stanu – dryf powstaje najczęściej w wyniku ręcznych interwencji inżynierów w konsoli lub działania zewnętrznych skryptów.
  • Ciągłe wykrywanie rozbieżności – kontroler GitOps bada stan środowiska i natychmiast sygnalizuje pojawienie się nieautoryzowanych modyfikacji.
  • Automatyczne tłumienie dryfu – włączenie funkcji samonaprawiania natychmiast nadpisuje niepożądane modyfikacje pierwotnym stanem z repozytorium.
  • Gwarancja spójności środowiska – aktywna eliminacja dryfu chroni zespół przed problemami z reprodukowalnością środowisk produkcyjnych.
targetRevision: Wskaźnik wdrażanej wersji w ArgoCD (tag/gałąź/SHA); SemVer MAJOR.MINOR.PATCH z tagami jako punktami przywracania i auto-taggingiem CI/CD.
wersje

Wersjonowanie aplikacji to fundament śledzenia zmian, automatycznego wdrażania, szybkiego rollbacku i audytu. Standardem w tej dziedzinie jest Semantic Versioning (SemVer) - notacja MAJOR.MINOR.PATCH, na przykład 1.2.3, z jasną semantyką każdego składnika. Do pełnego obrazu dochodzą pre-release'y (1.0.0-alpha.1, 1.0.0-beta.2, 1.0.0-rc.1) i metadane buildu (1.0.0+build.123 czy 1.0.0+git.sha.abc123). W praktyce wersjonowanie obejmuje tagi w Git, automatyczne tagowanie w CI/CD, wersje obrazów Docker, wersje chartów Helm (version i appVersion), pole targetRevision w ArgoCD oraz promocję wersji między środowiskami dev → staging → prod.

Zaczynając od SemVer 2.0.0: MAJOR używamy przy zmianach znaczących - usunięcie elementu API, zmiana schematu bazy czy formatu konfiguracji - takich, które wymagają migracji. MINOR dodaje nowe funkcje zgodne wstecz (nowy endpoint, nowa funkcjonalność, opcjonalny parametr), a PATCH to zgodny wstecz bugfix - naprawa błędu, poprawa wydajności, łatka bezpieczeństwa. Pre-release sygnalizuje wersję przedwydaniową: -alpha to wczesna, niestabilna; -beta to zakończona funkcjonalnie, w fazie testów; -rc (release candidate) to kandydat do wydania. Metadane buildu (+build.123, +git.sha.abc123) nie wpływają na porównywanie wersji. Warto zapamiętać kolejność: 1.0.0 < 1.0.1 < 1.1.0 < 2.0.0, a wersje pre-release są niższe od stabilnych: 2.0.0-alpha < 2.0.0-beta < 2.0.0-rc.1 < 2.0.0.

W Git i CI/CD wersjonowanie sprowadza się do tagów i automatyzacji. Tagi tworzymy komendami git tag v1.2.3 (zwykły) albo git tag -a v1.2.3 -m "Release v1.2.3" (annotated, z metadanymi - zalecany w produkcji) i wypychamy przez git push origin v1.2.3. W CI/CD tagowanie bywa automatyczne: GitHub Actions czy GitLab CI mogą tworzyć tagi, a narzędzie semantic-release na podstawie conventional commits samo decyduje: feat → MINOR, fix → PATCH, BREAKING CHANGE → MAJOR. Dla obrazów Docker używamy tagów (docker tag myapp:v1.2.3); uwaga na tag latest - to "rolling", przesuwający się, i w produkcji bywa pułapką. W helm używa się dwóch pól: version (wersja chartu) i appVersion (wersja aplikacji). Podstawowe pytanie - "co wdrażamy w ArgoCD?" - rozstrzyga targetRevision: może wskazywać tag v1.2.3, gałąź main albo konkretny commit SHA. Na tym budujemy promocję między środowiskami: dev trzyma gałąź main, staging dostaje tag v1.2.3-rc.1, a produkcja wersję v1.2.3. Krótka zasada: wersjonuj wszystko, taguj wydania, a tagowanie automatyzuj.

Wyjaśnienie skrótów użytych na slajdzie:
SemVer – Semantic Versioning Specification – specyfikacja wersjonowania semantycznego; Ustandaryzowany format oznaczania wydań oprogramowania w postaci MAJOR.MINOR.PATCH.
ImageTag – Container Image Tag – znacznik obrazu kontenera; Identyfikator wersji obrazu w rejestrze; unika się tagu 'latest' na rzecz niezmiennych numerów wydań.
SHA256 – Cryptographic Hash Algorithm SHA-256 – algorytm skrótu kryptograficznego SHA-256; Funkcja haszująca generująca unikalny skrót zawartości binarnej obrazu kontenera.
Digest – Immutable Container Image Digest – niezmienny skrót obrazu kontenera; Unikalny identyfikator 'sha256:...' gwarantujący, że do klastra trafia dokładnie ten sam, zweryfikowany obraz.
Immutable – Immutable Artifact Principle – zasada niezmienności artefaktów; Wymóg inżynierski stanowiący, że raz zbudowany i przetestowany artefakt nigdy nie może być nadpisany.

38/55 Bezpieczeństwo podczas zmian
Bezpieczeństwo podczas zmian: Change management: PR → review → CI → merge → sync. Rollback (git revert) = safety net w sekundy. K01 (etyka): code review = wspólna odpowiedzialność, transparentność, blameless culture. Audit trail = Git log + PR + CI logs.

Bezpieczna zmiana to pięć warstw i siatka w postaci rollbacku. Etyka (K01) spina całość: review, jawność i brak winnych.

  • Narzędzie kube-diff – pozwala na precyzyjne porównanie manifestów zapisanych w repozytorium z obiektami aktualnie działającymi na klastrze.
  • Inspekcja przed synchronizacją – inżynier może dokładnie sprawdzić, które pola zostaną zmodyfikowane przed zatwierdzeniem operacji na produkcji.
  • Wykrywanie zmian wewnętrznych – narzędzie filtruje dynamiczne pola dopisywane przez platformę Kubernetes, takie jak status czy generacja.
  • Weryfikacja w potokach CI – uruchomienie porównania w potoku weryfikacyjnym chroni zespół przed niespodziewanym zniszczeniem zasobów.
  • Poczucie kontroli nad wdrożeniem – możliwość dokładnego podejrzenia planowanych zmian buduje spokój i bezpieczeństwo pracy operatora.
Safety net: Siatka bezpieczeństwa - rollback (git revert) w sekundy; change management PR → review → CI → merge → sync ze śladem audytu i K01.
bezpieczne zmiany

W architekturze GitOps wdraża się silniki Admission Control, takie jak Kyverno lub OPA Gatekeeper. Weryfikują one w locie każdy synchronizowany manifest i automatycznie odrzucają obiekty naruszające reguły bezpieczeństwa (np. brak zdefiniowanych limitów CPU/RAM, próba uruchomienia kontenera w trybie uprzywilejowanym privileged: true).

Bezpieczeństwo podczas zmian w modelu GitOps to pięć wzajemnie uzupełniających się warstw: kontrola dostępu (kto może co zmienić), walidacja (czy zmiana jest poprawna), audyt (kto, co, kiedy i dlaczego), zdolność do natychmiastowego cofnięcia zmian (rollback capability) oraz zgodność z zasadami K01 - etyką, poufnością i odpowiedzialnością. Cały proces change management (PR → review → CI → merge → sync) przechodzi przez bramy zatwierdzeń (wymagane recenzje, CODEOWNERS), automatyczną walidację (kontroli CI, kontrole polityk), gotowość rollbacku (git revert, ArgoCD rollback), ślad audytowy (Git log + PR + logi CI), procedury awaryjne (break-glass) i mapowanie na wymagania zgodności (K01, SOX, GDPR, PCI-DSS).

Rollback to najlepsza siatka bezpieczeństwa, jaką daje GitOps. Zamiast "naprawiać do przodu" (fix forward) cofamy do znanego, dobrego stanu (known good state) - to szybsze, bezpieczniejsze i w pełni deterministyczne. Podstawowa strategia to git revert: cofamy commit w Git, wypychamy, a ArgoCD auto-sync przywraca stan. Alternatywy to argocd app rollback (z UI lub CLI, przenosi na wybraną rewizję) oraz git tag rollback - wskaźnik rollback/v1.2.3 popychamy do Git, aby ArgoCD nadał nową rewizję docelową. Szybkości: git revert i push liczą sekundy, sync ArgoCD jest rzędu 30 sekund, a całkowity RTO zamkniemy w dwóch minutach. To należy ćwiczyć: comiesięczne "próby pożarowe" (fire drills) i chaos engineering - zabij Pod, zmień liczbę replik, sprawdź, jak zadziałał self-heal, i wytrenuj rollback. Dobrze jest mieć gotowy playbook rollbacku krok po kroku: kto, co, kiedy, jak i jak weryfikujemy.

K01 z sylabusu to trzy kompetencje społeczne, które pięknie łączą się z GitOps. Etyka: nie wdrażamy zmian bez code review, nie ukrywamy błędów, jesteśmy transparentni przy incydentach. Poufność: sekrety nigdy nie trafiają do Git - używamy SealedSecrets, ExternalSecrets lub Vaulta; dane osobowe nie mieszkają w ConfigMapach; ślad audytowy nie zawiera sekretów. Odpowiedzialność: osoba pełniąca dyżur odpowiada za bezpieczeństwo wdrożenia, code review to wspólna odpowiedzialność, a decyzje o rollbacku podejmujemy razem - nie "kto to zepsuł", ale "jak to naprawiamy". Blameless culture to skupienie na systemie, a nie na wskazywaniu winnych, a proces zmiany pozostaje udokumentowany, audytowalny i możliwy do prześledzenia. Podsumowując: bezpieczeństwo zmian to suma code review, walidacji CI, Branch Protection, Gita jako siatki bezpieczeństwa, śladu audytowego i zgodności z K01. Krótko: kultura plus narzędzia plus proces.

Wyjaśnienie skrótów użytych na slajdzie:
Kyverno – Kyverno Kubernetes Native Policy Management – zarządzanie politykami w Kyverno; Silnik reguł bezpieczeństwa analizujący manifesty i wymuszający zgodność ze standardami CIS Benchmarks.
OPA – Open Policy Agent – otwarty agent polityk OPA; Uniwersalny silnik reguł bezpieczeństwa wykorzystujący deklaratywny język zapytań Rego.
Gatekeeper – OPA Gatekeeper Controller – kontroler OPA Gatekeeper dla K8s; Komponent integracyjny egzekwujący polityki OPA jako kontroler dopuszczeń w Kubernetesie.
AdmissionWebhook – Kubernetes Validating Admission Webhook – walidujący webhook dopuszczeń; Mechanizm API serwera odrzucający manifesty naruszające zdefiniowane reguły przed ich zapisem w bazie etcd.
Cosign – Sigstore Cosign Container Signing – narzędzie podpisywania obrazów Cosign; Narzędzie weryfikujące podpisy cyfrowe obrazów kontenerowych przed ich uruchomieniem w klastrze.

39/55 GitOps a monitoring
GitOps a Monitoring: GitOps naturalnie integruje się z observability. ArgoCD metrics (sync status, health) = SLI. Korelacja: Git commit → deploy → metrics change → alert. Grafana annotations jako adnotacje na wykresach. Closed loop: Git → metrics → alert → fix → Git.

GitOps bez monitoringu leci na ślepo. Metryki ArgoCD to SLI, commit to adnotacja, a pętla zamyka się alertem.

  • Strategia Monorepo – przechowywanie manifestów wszystkich usług w jednym repozytorium ułatwia spójne wersjonowanie i globalne audyty.
  • Strategia Polyrepo – model wielu odrębnych repozytoriów gwarantuje pełną izolację uprawnień, lecz utrudnia koordynację globalnych wydań.
  • Dopasowanie do organizacji – wybór właściwej architektury repozytoriów zależy od struktury zespołów, wielkości firmy i złożoności usług.
  • Ujednolicone standardy nazewnictwa – niezależnie od liczby repozytoriów konieczne jest utrzymanie spójnych wzorców struktur katalogów w projektach.
  • Automatyzacja synchronizacji – przejrzysty podział kodu ułatwia agentom wdrożeniowym szybkie i bezbłędne śledzenie zmian w strukturze.
Closed loop: Zamknięta pętla Git → metryki → alert → fix → Git; metryki ArgoCD (sync, health) jako SLI i adnotacje Grafany na wykresach.
powiązanie

GitOps i obserwowalność (observability) to dwa aspekty jednego układu: GitOps bez monitoringu to lot na ślepo, a sam monitoring bez GitOps nie daje kontekstu, co dokładnie zmieniło się w systemie. W tej części zobaczymy, jak metryki eksportowane przez ArgoCD i Flux (przez Prometheus exporters) pełnią rolę SLI, jak synchronizować zdarzenia w Git z metrykami (commit → deploy → zmiana metryk), jak alertować na dryft, self-heal i awarie oraz jak łączyć to z logami (Loki) i tracingiem (Tempo). Ten wątek naturalnie koresponduje z wykładem o metrykach, SLI/SLO oraz alertowaniu.

Metryki ArgoCD i Fluxa to gotowe SLI dla pipeline'u GitOps. ArgoCD eksportuje między innymi: argocd_app_sync_status (0 = Synced, 1 = OutOfSync, 2 = Degraded), argocd_app_health_status, argocd_app_sync_duration_seconds, argocd_app_last_sync_timestamp, argocd_application_controller_reconcile_duration oraz argocd_repo_server_repo_fetched_total. Flux udostępnia flux_source_ready, flux_kustomization_ready, flux_helmrelease_ready czy flux_notification_controller_sent_total. Na ich podstawie budujemy praktyczne SLO: sync latency (opóźnienie od commita do synchronizacji - histogram), drift detection time (czas od powstania dryftu do wykrycia OutOfSync) oraz self-heal success rate (odsetek dryftów naprawionych automatycznie).

Największa wartość bierze się z korelacji zdarzeń w Git z metrykami. Układamy pełny przepływ: commit → webhook do ArgoCD → sync → zmiana metryk (skok CPU, pamięci, opóźnień), a my łączymy konkretny SHA commita z konkretną synchronizacją i widoczną zmianą metryk. W praktyce używamy do tego adnotacji Grafany (Git commit jako adnotacja na wykresie), korelacji logów w Loki (commit → logi) i śladów w Tempo (deploy trace). Całość układa się w domkniętą pętlę: zmiana w Git → metryki → alert → incydent → postmortem → poprawka w Git → commit → cykliczna synchronizacja. GitOps tworzy ciągłą pętlę sterowaną obserwowalnością systemu.

Alertowanie opieramy na statusach synchronizacji i zdrowia. Typowe reguły: argocd_app_sync_status == 1 (OutOfSync) utrzymujący się ponad 5 minut → warning; argocd_app_health_status != Healthy → alert krytyczny; argocd_app_sync_status == 2 (Degraded) → alert krytyczny. Dla Fluxa: flux_kustomization_ready == 0 → warning. Szczególną uwagę warto zwrócić na "flapping" self-healu: jeśli status przeskakuje między OutOfSync a Synced krócej niż w 5 minut - to znak, że self-heal zadziałał i można potraktować to jako zdarzenie informacyjne, a nie awarię. Dobrze skonfigurowane alerty oznaczają wczesne wykrywanie problemów z całym pipeline'em.

Wyjaśnienie skrótów użytych na slajdzie:
Prometheus – Prometheus Monitoring Server – serwer monitoringu Prometheus; Podsystem telemetryczny zbierający metryki wydajnościowe z kontrolerów GitOps.
Grafana – Grafana Visualization Dashboard – pulpit wizualizacyjny Grafana; Konsola prezentująca dynamikę synchronizacji aplikacji, liczbę błędów i czasy przetwarzania pętli sterowania.
Alertmanager – Prometheus Alertmanager Component – menedżer alertów; Moduł powiadamiający inżynierów o zablokowaniu pętli synchronizacji lub permanentnym stanie OutOfSync.
ArgoCDMetrics – Argo CD Prometheus Metrics Endpoint – punkt końcowy metryk ArgoCD; Metryki wewnętrzne (np. argocd_app_sync_total, argocd_app_health_status) eksportowane do bazy TSDB.
SLI – Service Level Indicator – wskaźnik poziomu usług; Miara sprawności procesu wdrażania, dla której GitOps minimalizuje wskaźnik Change Failure Rate.

40/55 Retrospekcja GitOps w SRE
Retrospektywa GitOps w SRE: GitOps = retrospektywa wbudowana: git log = timeline incydentu, git revert = mitigation, Git history = evidence do blameless post-mortem. Continuous improvement: trend analysis, pattern recognition, institutional memory.

Retrospektywa w GitOps jest wbudowana: log to oś czasu, revert to mitigacja, historia to dowód do postmortem.

  • Telemetria serwera ArgoCD – komponenty kontrolera udostępniają bogaty zestaw metryk Prometheus umożliwiających bieżący nadzór nad potokami.
  • Monitorowanie stanu synchronizacji – metryki mierzą czas trwania operacji wdrożeniowych, liczbę błędów oraz stopień obciążenia serwera API.
  • Wydajność operacji Git – badanie opóźnień pobierania danych z repozytorium pozwala wcześnie wykryć problemy sieciowe lub przeciążenie serwerów.
  • Pulpity kontrolne w Grafanie – dedykowane panele telemetryczne prezentują globalny stan zdrowia i aktywności wszystkich wdrożeń w organizacji.
  • Kluczowa rola obserwowalności – stały nadzór nad platformą GitOps jest niezbędny, gdyż jej awaria paraliżuje proces dostarczania zmian na produkcję.
Institutional memory: Pamięć instytucjonalna z trendów i wzorców; git log jako oś czasu, revert jako mitigacja, historia jako dowód do postmortem.
korzyści

Wdrożenie modelu GitOps stanowi techniczną realizację postulatów inżynierii SRE w zakresie eliminacji pracy żmudnej (Toil). Zgodnie z badaniami instytutu DORA (DevOps Research and Assessment) zespoły stosujące deklaratywne repozytoria i automatyczną synchronizację osiągają radykalną poprawę czterech kluczowych wskaźników operacyjnych: skrócenie czasu wprowadzenia zmiany (Lead Time for Changes), obniżenie wskaźnika awaryjności wydań (Change Failure Rate) oraz drastyczną redukcję średniego czasu naprawy (MTTR) dzięki natychmiastowym rollbackom.

GitOps ma tę szczególną właściwość, że retrospektywa jest w nim po prostu wbudowana w system. Ponieważ cała infrastruktura jest wersjonowana w Git, każda zmiana ma historię: git log to gotowa oś czasu incydentu, git revert to natychmiastowa łagodzenie skutków (mitigation), a historia Gita wraz z Pull Requestami i logami CI stanowi dowód do blameless post-mortem. Dzięki temu diagnoza przebiega w minuty zamiast godzin, uczenie się z błędów jest oparte na faktach, a wiedza organizacji nie wyparowuje wraz z odejściem częściowców.

Szybka diagnoza zaczyna się od alertu (OutOfSync/Degraded), przechodzi przez UI ArgoCD - historia, diff między Git a żywym klastrem - do konkretnego SHA commita, potem do Pull Requestu, autora i kontekstu, aż po hipotezę przyczyny źródłowej i jej weryfikację. Git history to oś czasu incydentu: kto, co, kiedy i dlaczego (commit message + PR). Bez GitOps pada seria pytań bez odpowiedzi: "kto to zmienił?", "kiedy?", "dlaczego?", "jak cofnąć?". Z GitOps wystarczy git log --oneline --since="1 hour ago", a ArgoCD diff pokazuje, co dokładnie się zmieniło; git show <commit> daje szczegółowe porównanie z kontekstem. Czas samej diagnozy zmienia się z godzin na minuty - to wielka przewaga operacyjna.

Rollback jako mitigation to druga przewaga. Po incydencie nie musimy naprawiać przyczynowo - wystarczy git revert HEAD, push, a ArgoCD auto-sync przywraca stan. Rollback to łagodzenie skutków, nie naprawa, ale daje czas na spokojną analizę przyczyn źródłowych bez presji czasu. Zasada jest taka: nie cofajmy przez fix forward (żadnych pokus amenda na produkcji), tylko przez czysty revert - to bezpieczniejsze, szybsze i deterministyczne. Czas rollbacku staje się nawet metryką SLA. Po spokojnej naprawie przyczyny wracamy z re-revertem, czyli ponowieniem wycofanej zmiany w poprawionej postaci.

Kultura blameless i historia Gita idą w parze, bo Git nie kłamie - historia commitów to fakty, a nie opinie. Postmortem budujemy na dowodach: historia Gita, komentarze z PR, logi CI, historia ArgoCD. Same w sobie dowody kierują naszą uwagę na pytanie, co się stało i dlaczego system na to pozwolił, a nie na to, kto zawinił. Dobry szablon postmortem to oś czasu (git log), przyczyna źródłowa (diff + kontekst), wpływ (metryki) i działania naprawcze (naprawa kodu i poprawa procesu). Wreszcie ciągłe doskonalenie: analiza trendów z historii Gita (częstotliwość incydentów, typowe przyczyny, MTTR), rozpoznawanie powtarzających się wzorców ("od dwóch tygodni ten sam dryft na tym samym miejscu" → naprawa procesu) i pamięć instytucjonalna - historia Gita jako baza wiedzy organizacyjnej, którą czytają wszyscy, także nowi członkowie zespołu. GitOps po prostu czyni z organizacji uczącą się organizację.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Podsumowanie wdrożenia GitOps jako technicznej realizacji kultury niezawodności.
MTTR – Mean Time To Recover – średni czas przywrócenia sprawności; Metryka operacyjna ulegająca drastycznemu skróceniu dzięki natychmiastowym operacjom git revert.
ChangeFailureRate – Change Failure Rate Metric – wskaźnik awaryjności zmian; Odsetek wdrożeń produkcyjnych skutkujących degradacją usługi; GitOps minimalizuje ten wskaźnik przez procedurę PR.
DORA – DevOps Research and Assessment – zespół badawczy DORA; Jednostka badawcza Google wykazująca korelację pomiędzy automatyzacją GitOps a wysoką wydajnością operacyjną.
Toil – Operational Toil Elimination – eliminacja pracy żmudnej; Odzyskanie czasu inżynierów dzięki zastąpieniu ręcznych wdrożeń powtarzalną automatyzacją.

41/55 Podsumowanie narzędzi GitOps
Podsumowanie narzędzi GitOps: ArgoCD/Flux = CD (sync, reconciliation). Tekton = CI (pipeline as code). Argo Rollouts/Flagger = progressive delivery. Vault/ExternalSecrets = secrets management. Grafana/Prometheus = observability. Razem = full GitOps platform.

Platforma GitOps warstwami: CD synchronizuje, CI buduje, delivery wydaje ostrożnie, sekrety i monitoring domykają.

  • Natychmiastowe alarmy o błędach – system powiadamiania powinien bezwzględnie alarmować dyżurnych w razie niepowodzenia operacji wdrożeniowej.
  • Szczegółowy kontekst w powiadomieniu – wiadomość na komunikatorze powinna zawierać przyczynę usterki, nazwisko autora oraz link do konsoli ArgoCD.
  • Wykrywanie długotrwałego dryfu – alert o utrzymującym się stanie braku synchronizacji pozwala szybko wykryć próby ręcznych modyfikacji klastra.
  • Integracja z Alertmanagerem – reguły alarmowe potoku wdrożeniowego powinny być połączone z centralnym systemem obsługi incydentów w firmie.
  • Wczesna reakcja operacyjna – sprawne powiadamianie pozwala inżynierom usunąć usterki wydania zanim zaczną one rzutować na klientów platformy.
Full GitOps platform: ArgoCD/Flux (CD) + Tekton (CI) + Rollouts/Flagger (delivery) + Vault/ESO (sekrety) + Grafana/Prometheus (observability).
mapa

Na zakończenie przeglądu narzędzi warto zrobić porządek w całym ekosystemie GitOps - to swego rodzaju mapa, na której każdy element pełni jasno określoną funkcję. Rozdzielamy w niej warstwy: ciągłą integrację, ciągłe wdrażanie, progressive delivery, sekrety oraz obserwowalność. Żadne z tych narzędzi nie działa w próżni - dopiero ich spójne połączenie daje pełnoprawną platformę GitOps, o jakiej mówiliśmy w całej tej części wykładu.

Centralną rolę ciągłego wdrażania pełnią ArgoCD i Flux - to one odpowiadają za synchronizację i rekonsyliację stanu, wykrywanie dryftu i samo-naprawę. ArgoCD jest projektem CNCF Graduated, czyli dojrzałym i sprawdzonym w szerokiej produkcji; Flux, budowany na module GitOps Toolkit, przechodzi proces inkubacji w CNCF. W warstwie ciągłej integracji najczęściej pojawia się Tekton - definicje pipeline'ów jako zasoby Kubernetes (pipeline as code): serverless, przenośne i natywnie zintegrowane z GitOps dzięki Triggers, które wywołują wykonania pipeline'ów zdarzeniami z Gita. Alternatywy pokroju GitHub Actions, GitLab CI czy Jenkinsa też się zdarzają, ale to Tekton jest najbardziej "kubernetesowy".

Trzej pozostali uczestnicy domykają platformę. Argo Rollouts i Flagger wprowadzają progressive delivery - stopniowe, mierzone metrykami wydawanie zmian (Canary, Blue-Green, Eksperymenty) z automatyczną analizą i możliwością natychmiastowego wycofania. Vault i ExternalSecrets zajmują się sekretami - przechowywaniem, odnawianiem i wstrzykiwaniem bez umieszczania ich w Git. Grafana z Prometheusem zamykają całość jako warstwa obserwowalności - metryki, logi, alerty. Całość układa się w jeden spójny łańcuch: Tekton (CI) → ArgoCD (sync) → Argo Rollouts lub Flagger (progressive delivery) → Grafana (obserwowalność) → Vault (sekrety). To właśnie ta kompozycja, a nie pojedyncze narzędzie, tworzy pełną platformę GitOps.

Wyjaśnienie skrótów użytych na slajdzie:
ArgoCD – Argo CD GitOps Controller – kontroler ArgoCD; Zestawienie podstawowych narzędzi deklaratywnego utrzymania aplikacji.
Flux – Flux CD GitOps Engine – silnik Flux CD; Modułowe rozwiązanie automatyzacji oparte na natywnych kontrolerach Kubernetes.
Helm – Helm Package Manager – menedżer pakietów Helm; Narzędzie parametryzacji i wdrażania gotowych stosów oprogramowania.
Kustomize – Kustomize Overlay Tool – narzędzie Kustomize; Bezszablonowy system nakładek konfiguracyjnych dla wielu środowisk.
SOPS – Mozilla SOPS Secret Encryption – narzędzie Mozilla SOPS; Standard kryptograficznego zabezpieczania danych wrażliwych w plikach repozytorium.

42/55 Materiały i literatura (GitOps)
Materiały i literatura: Kuratowana biblioteka źródeł: ArgoCD docs (argoproj.github.io), Flux docs (fluxcd.io), Tekton (tekton.dev), Helm (helm.sh), Kustomize (kustomize.io), Vault (vaultproject.io), Crossplane (crossplane.io), Kyverno (kyverno.io). Wszystkie linki zweryfikowane.

Czytaj u źródeł: ArgoCD, Flux, Tekton, IaC i sekrety - wszystko zweryfikowane, po HTTPS, bez 404.

  • Błyskawiczne odtworzenie po awarii – kompletna konfiguracja klastra spoczywa w bezpiecznym Git, co diametralnie upraszcza procedury Disaster Recovery.
  • Odbudowa od zera – w razie zniszczenia centrum danych wystarczy postawić pusty klaster i podłączyć do niego agenta wdrożeniowego ArgoCD.
  • Automatyczna rekonstrukcja usług – kontroler samoczynnie pobierze deklaracje z Git i zrekonstruuje całe środowisko w kilkanaście minut.
  • Minimalizacja wskaźnika RTO – automatyzacja procesu odtwarzania skraca czas powrotu do sprawności niemal do zera bez żmudnych operacji na kopiach.
  • Ochrona stanu bazy danych – jedynym komponentem wymagającym tradycyjnego backupu pozostają bazy danych przechowujące stan transakcyjny.
Biblioteka GitOps: Dokumentacje ArgoCD, Flux, Tekton, Helm, Kustomize, Vault, Crossplane, Kyverno - zweryfikowane, aktualne, po HTTPS.
strony

Na zakończenie został nam jeszcze jeden, bardzo praktyczny fragment - kuratorowana lista źródeł, z której warto (a w zasadzie trzeba) korzystać, ucząc się GitOps głęboko, a nie powierzchownie. Wszystkie linki zostały zweryfikowane: działają, są aktualne, HTTPS, nie prowadzą do błędów 404 ani pętli przekierowań. Lista obejmuje dokumentację ArgoCD, Fluxa, Tektona, Argo Rollouts, Flaggera, Kustomize, Helma, narzędzi do sekretów (SOPS, ExternalSecrets, Vault), Crossplane'a (IaC), polityk (Kyverno, OPA Gatekeeper) oraz portalu deweloperskiego Backstage. To żywy dokument, aktualizowany co semestr; na bieżąco aktualne adresy znajdziecie w literaturze.

Dokumentacja ArgoCD (argoproj.github.io/argo-cd) zawiera komplet materiałów: getting started, operator manual - zdecydowane "must-read" dla administratorów, user guide dla użytkowników (applications, projects, repositories, ustawienia), developer guide, FAQ, troubleshooting, opis HA, RBAC, powiadomień, webhooków oraz pełną referencję CLI. Flux (fluxcd.io/docs) prowadzi przez instalację i bootstrap oraz przez komponenty GitOps Toolkit: source-controller, kustomize-controller, helm-controller, notification-controller, image-automation i image-reflector, a także przez przewodniki (multi-tenancy, multi-cluster, środowiska odcięte od sieci, migracja z Flux v1). Tekton (tekton.dev/docs) ma w dokumentacji pipelines, tasks, triggers, chains, hub, operator, results i workspaces - czyli wszystko, co składa się na CI/CD as code, sterowanie zdarzeniami i bezpieczeństwo łańcucha dostaw.

Argo Rollouts (argoproj.github.io/argo-rollouts) dokumentuje instalację, koncepcje zasobu Rollout, strategie blue-green, canary i experiment, analizę, sterowanie ruchem, rollback, wtyczkę do UI oraz plugin kubectl. Flagger (docs.flagger.app) opisuje instalację, canary, blue-green, analizę metryk, webhooki i gotowe dashboards Grafana. Kolejna grupa to narzędzia pomocnicze: kubectl kustomize i kustomize.io opisują bazy, overlaye, patche, generatory i transformatory; helm.sh/docs - pliki chartów, szablony, values, hooki, zależności i charty biblioteczne; SOPS (github.com/getsops/sops) - szyfrowanie kluczami age, GPG, KMS i konfigurację .sops.yaml; ExternalSecrets (external-secrets.io) - dostawców (Vault, AWS, GCP, Azure, Kubernetes, Doppler, 1Password, Bitwarden i inne); Vault (vaultproject.io) - enginy sekretów, transit, PKI i sekrety dynamiczne.

Na koniec: Crossplane (crossplane.io) opisuje kompozycje, XRD-y i zarządzane zasoby dla dostawców AWS, Azure, GCP oraz Kubernetes; Kyverno (kyverno.io) - polityki validate, mutate i generate z użyciem JMESPath i CEL; OPA Gatekeeper (openpolicyagent.org/gatekeeper) - constraints i templates z audytem; Backstage (backstage.io) - katalog oprogramowania, scaffolder, tech docs i plugin-y. Do kompletu zostają narzędzia dostępne przez własną dokumentację: GitHub Actions (docs.github.com/actions), GitLab CI (docs.gitlab.com/ee/ci), Prometheus, Grafana, Loki, Tempo oraz narzędzia chaos engineeringu - Chaos Mesh (chaos-mesh.org/docs) i Litmus (litmuschaos.io). Osobom, które chcą zacząć od jednego źródła, polecam dokumentację ArgoCD, a osobom szukającym wytłumaczenia koncepcji - specyfikację OpenGitOps.

Wyjaśnienie skrótów użytych na slajdzie:
OpenGitOps – OpenGitOps Standards Documents – standardy komitetu OpenGitOps; Oficjalne zasady i definicje ujęte w bibliografii akademickiej wykładu.
CNCF – Cloud Native Computing Foundation – Fundacja Oprogramowania Chmurowego; Główny wydawca specyfikacji technicznych i monografii dla technologii chmurowych.
KubernetesDocs – Kubernetes Official Documentation – oficjalna dokumentacja Kubernetes; Podstawowe źródło wiedzy o architekturze obiektów i kontrolerów API.
OReilly – O'Reilly Media Technical Books – wydawnictwo techniczne O'Reilly; Wydawca kluczowych monografii poświęconych inżynierii SRE, GitOps i architekturze rozproszonej.
RFC – Request for Comments – dokumenty standaryzacji RFC; Standardy kryptograficzne i sieciowe leżące u podstaw bezpiecznej komunikacji w GitOps.

43/55 Zapowiedź wykładu 8
Zapowiedź wykładu 8: Następny temat: Incydenty i Post-mortem. Lifecycle: detection → response → mitigation → resolution → post-mortem. Kluczowe: blameless culture, timeline reconstruction, root cause analysis (5 Whys), action items (SMART).

Za tydzień incydenty: lifecycle, role, blameless post-mortem i SMART. Przygotuj StatusPage i szablony.

  • Tryb testowy Dry-Run – weryfikacja manifestów w trybie próbnym pozwala upewnić się, że serwer API zaakceptuje definicje przed ich aplikacją.
  • Tymczasowe środowiska testowe – zautomatyzowane potoki uruchamiają odizolowane środowiska w celu przetestowania całego procesu wdrożenia.
  • Symulacja aktualizacji usług – narzędzia testowe weryfikują, czy planowana migracja wersji nie spowoduje niepożądanych przerw w działaniu platformy.
  • Blokowanie destrukcyjnych zmian – automatyczne odrzucanie wadliwych konfiguracji na etapie testów skutecznie chroni środowiska produkcyjne.
  • Pewność operacyjna zespołu – regularne testowanie procesu wdrożeń buduje zaufanie i pozwala na częste oraz bezpieczne publikowanie nowego kodu.
Action items (SMART): Konkretne, mierzalne zadania po incydencie; z blameless culture, osią czasu i 5 Whys - zapowiedź wykładu o post-mortem.
zapowiedź

Następny wykład o incydentach i post-mortem będzie bezpośrednio budował na tym, co już zna się z GitOps. Git jako wersjonowana historia, ArgoCD i Flux jako fundament obserwowalności przygotowują nas do momentu, w którym - nieuchronnie - coś w systemie się psuje. Tam, gdzie GitOps już zrobił swoje (szybka diagnoza przez git log, natychmiastowe łagodzenie przez git revert), wkracza dojrzałość operacyjna: zarządzanie incydentem, analiza przyczyn źródłowych i kultury blameless. Cykl incydentu to pięć etapów: wykrycie → odpowiedź → łagodzenie → rozwiązanie → post-mortem, a walka o skrócenie czasu dysponowania i naprawy (MTTK/MTTR) to serce SRE.

Incydent Lifecycle w praktyce wygląda tak. Wykrycie (detection) - alert z Prometheusa, ArgoCD, Grafany czy StatusPage. Odpowiedź (response) - potwierdzenie, triaż, komunikacja. Łagodzenie (mitigation) - rollback, skalowanie, przełączenie na inną strefę, zmiana konfiguracji. Rozwiązanie (resolution) - naprawa przyczyny źródłowej i weryfikacja. Post-mortem - oś czasu, przyczyna, działania, follow-up. Kluczowa jest organizacja ról: Incident Commander koordynuje całość i podejmuje decyzje o eskalacji, rollbacku i komunikacji; Scribe dokumentuje oś czasu na bieżąco; Communicator utrzymuje status page i kontakt z zainteresowanymi stronami; SME prowadzi część techniczną. Komunikacja opiera się o dedykowany kanał Slack (#incident-xyz), status page i "war room", a wszystkie szablony komunikacyjne przygotowujemy wcześniej, nie w trakcie awarii.

Blameless Post-Mortem to sedno kultury bezpieczeństwa. "Blameless" oznacza skupienie na systemie, nie na osobie - a Git jest idealnym narzędziem, bo historia commitów to fakty, nie opinie. Oś czasu rekonstruujemy z historii Gita, historii ArgoCD, komentarzy z PR i logów CI. Analizę przyczyn źródłowych prowadzimy techniką 5 Whys (pytamy "dlaczego?" pięć razy), diagramem ryby (fishbone) z kategoriami ludzie/proces/technologia/środowisko albo analizą Pareto (20% przyczyn odpowiada za 80% problemów). Wszystkie działania naprawcze (action items) opisujemy w formacie SMART i przydzielamy właściciela, termin i priorytet, a śledzenie realizacji prowadzimy w Jirze czy GitHub Projects. Blameless to także psychologiczne bezpieczeństwo - gdy ludzie nie boją się zgłaszać błędów, incydentów jest mniej.

Przygotowanie do wykładu 8 warto zacząć wcześniej: przeczytajcie w Google SRE Book rozdziały o postmortem culture, reagowaniu na incydenty i zarządzaniu incydentami. Przed zajęciami skonfigurujcie podstawy praktyczne: StatusPage (StatusPage.io, Atlassian Statuspage albo samodzielny Cachet), webhook Slacka dla alertów, Jira lub GitHub Projects dla śledzenia działań oraz szablony post-mortem w Confluence albo GitHub Wiki. Gotowy szablon post-mortem składa się z pięciu sekcji: Timeline, Root Cause, Impact, Action Items i Lessons Learned. Ten wykład zamyka część GitOps, a otwiera drogę do operacyjnej dojrzałości - to nie koniec nauki, tylko jej kolejny próg.

Wyjaśnienie skrótów użytych na slajdzie:
IncidentManagement – Major Incident Management – zarządzanie poważnymi incydentami; Zapowiedź tematyki wykładu 8 poświęconego reakcji na awarie produkcyjne.
PostMortem – Blameless Post-mortem Methodology – metodologia analizy poawaryjnej bez obwiniania; Procedura dochodzenia przyczyn źródłowych awarii omawiana na kolejnych zajęciach.
RCA – Root Cause Analysis – analiza przyczyn źródłowych; Systematyczny proces poszukiwania pierwotnych defektów w architekturze i procedurach.
Blameless – Blameless Engineering Culture – inżynierska kultura bez obwiniania; Filozofia organizacyjna traktująca awarie jako okazję do wzmocnienia odporności systemów.
Sev1 – Severity 1 Critical Outage – awaria krytyczna stopnia 1; Incydent o najwyższym priorytecie biznesowym stanowiący studium przypadku w wykładzie 8.

44/55 Pytania kontrolne
Pytania kontrolne: Samodzielna weryfikacja wiedzy: architektura ArgoCD, tworzenie Application YAML, sync policy, Push vs Pull, rollback (git revert), self-healing, sekrety (SealedSecrets/ExternalSecrets), wielu środowisk (ApplicationSet), integracja CI/CD.

Sprawdź się bez notatek: ArgoCD, YAML, polityki, Pull/Push, revert i sekrety. „Nie” znaczy: wróć i poćwicz.

  • Kontroler Flux CD – stanowi nowoczesną alternatywę dla ArgoCD, opierając się na zestawie niezależnych mikro-operatorów platformy Kubernetes.
  • Natywna architektura Kubernetes – projekt stawia na ścisłą integrację z mechanizmami orkiestratora i deklaratywne zasoby definicji CRD.
  • Podejście bez rozbudowanego UI – domyślnie koncentruje się na operacjach z poziomu konsoli i kodu YAML, zapewniając surowy minimalizm.
  • Modularna budowa kontrolera – architektura pozwala na instalację wyłącznie tych modułów, które są faktycznie niezbędne w danym środowisku.
  • Popularność w rozwiązaniach brzegowych – Flux cieszy się dużym uznaniem w środowiskach stawiających na lekkość i minimalny narzut zasobów.
Samodzielna weryfikacja: Architektura ArgoCD, Application YAML, sync policy, Push/Pull, revert, self-heal, sekrety, ApplicationSet, CI/CD - bez notatek.
pytania

Ta partia pytań kontrolnych służy samodzielnej weryfikacji wiedzy przed egzaminem i przed rozwiązywaniem zadań praktycznych. Jeśli potraficie odpowiedzieć na te pytania bez otwierania notatek - jesteście na dobrej drodze. Pytania obejmują architekturę ArgoCD, tworzenie definicji Application w YAML, politykę synchronizacji, różnicę między modelem Push a Pull, rollback przez git revert, samo-naprawę, zarządzanie sekretami (SealedSecrets, ExternalSecrets, SOPS, Vault), wiele środowisk przez ApplicationSet oraz integrację z CI/CD (GitHub Actions, GitLab CI działające na zasadzie commit → Git → ArgoCD sync).

Jak działa ArgoCD? W architekturze wyróżniamy: API Server (gRPC/REST, interfejs webowy, uwierzytelnianie), Repo Server (klonuje repozytorium i generuje manifesty przez Helm, Kustomize lub Jsonnet), Application Controller (pętla rekonsyliacji, sync, kontrole zdrowia), Dex (OIDC/SSO) i Redis (cache, wsparcie HA). Zasób Application CRD ma trzy kluczowe pola: source (repoURL, path, targetRevision), destination (server, namespace) i syncPolicy (automated, prune, selfHeal, syncWindows, hooki). Synchronizacja przebiega czterema krokami: diff → plan → apply → verify. Self-heal włączamy przez automated.selfHeal=true, rollback wykonujemy z historii albo komendą argocd app rollback, a do generowania wielu aplikacji służy ApplicationSet z generatorami (matrix, git, cluster).

Dlaczego Git jest źródłem prawdy? Bo dostarcza wszystkiego, czego potrzebuje audytowalna infrastruktura: historii (kto, co, kiedy, dlaczego - czemu wystarczy git log i git blame), błyskawicznego rollbacku (git revert liczony w sekundach), code review jako bramy jakości oraz zgodności z wymaganiami (SOX, GDPR, PCI-DSS). Change management zamknięty w schemacie PR → Review → CI → Merge pozostawia udokumentowaną zmianę, a Git występuje w roli bramkarza - system of record. Warto pamiętać, że ArgoCD tylko czyta z Git i nigdy do niego nie pisze - to fundamentalna zasada GitOps.

Na koniec szczera samoocena. Czy potraficie: wyjaśnić architekturę ArgoCD; stworzyć Application YAML od zera; skonfigurować auto-sync z self-heal i prune; wskazać różnice między modelem Push a Pull; wykonać rollback przez git revert i argocd app rollback; skonfigurować ApplicationSet dla wielu środowisk; zintegrować CI/CD z ArgoCD; wyjaśnić, dlaczego Git jest jedynym źródłem prawdy. Jeśli na któreś z tych pytań pada "nie" - wróćcie do odpowiedniego slajdu i wykonajcie ćwiczenie hands-on. Ten wykład ma być nie tylko przeczytany, ale i przerobiony.

Wyjaśnienie skrótów użytych na slajdzie:
GitOps – GitOps Framework Principles – zasady paradygmatu GitOps; Weryfikacja zrozumienia deklaratywności i pojedynczego źródła prawdy w pytaniach kontrolnych.
Reconciliation – Continuous Reconciliation Mechanism – mechanizm ciągłego uzgadniania; Zrozumienie działania pętli sterowania podlegające ocenie na egzaminie.
PullVsPush – Pull versus Push Architecture – architektura Pull kontra Push; Znajomość różnic w bezpieczeństwie i przepływie danych weryfikowana w teście wiedzy.
SOPS – Mozilla SOPS Encryption Tool – narzędzie szyfrowania SOPS; Praktyczna znajomość zarządzania sekretami w repozytorium kodu na sprawdzianie wiedzy.
Drift – Configuration Drift Resolution – rozwiązywanie problemów dryftu; Umiejętność analizy przyczyn powstawania rozbieżności pomiędzy Git a klastrem.

45/55 Ćwiczenie grupowe
Ćwiczenie grupowe: Praktyczne ćwiczenie w zespołach: end-to-end GitOps workflow. Role: Incident Commander, Developer, Reviewer, Scribe. Zadania: feature branch → PR → CI → ArgoCD sync → weryfikacja → rollback test → retrospektywa. Timebox: 60 min.

Warsztat w zespołach: end-to-end GitOps w 60 minut - od planu po retrospektywę, w rolach jak w firmie.

  • Zalety platformy ArgoCD – oferuje doskonały graficzny panel użytkownika i zaawansowane zarządzanie wieloma klastrami w wielkich firmach.
  • Atuty rozwiązania Flux CD – wyróżnia się wyjątkową lekkością oraz głębszą integracją z ekosystemem narzędzi chmurowych na brzegu sieci.
  • Dojrzałość ekosystemu CNCF – oba rozwiązania posiadają najwyższy status dojrzałości w ramach fundacji Cloud Native Computing Foundation.
  • Dopasowanie do potrzeb firmy – decyzja o wyborze narzędzia zależy od preferencji inżynierów, modelu uprawnień i zapotrzebowania na interfejs WWW.
  • Wspólne zasady działania – niezależnie od wybranej platformy oba narzędzia w pełni realizują fundamentalne zasady paradygmatu GitOps.
Timebox 60 min: Ograniczone ramy czasowe ćwiczenia end-to-end (feature → PR → CI → sync → rollback → retrospektywa) w rolach (Commander, Dev, Reviewer, Scribe).
zadanie

Ćwiczenie grupowe to okazja, żeby całą wiedzę z tego wykładu zastosować w praktyce - i to od razu w zespołach, tak jak dzieje się to w prawdziwej organizacji. Warsztat prowadzi przez kompletny proces GitOps end-to-end: od planowania i implementacji, przez Pull Request i recenzję, po wdrożenie, weryfikację i test rollbacku. Każda grupa pracuje według scenariusza, z przydzielonymi rolami, ograniczeniem czasowym i jasnym efektem do zdobycia: działające wdrożenie, udany rollback i retrospektywa. To nauka przez robienie, a przy okazji sprawdzian współpracy.

Scenariusz brzmi na przykład tak: wasz zespół odpowiada za wdrożenie wersji 2.0 aplikacji payment-service na produkcję przez GitOps. Zmiany obejmują nowy endpoint /api/v2/payments, nową zmienną środowiskową PAYMENT_GATEWAY_URL oraz nowy Secret PAYMENT_API_KEY. Do tego wymagania: wdrożenie bez przestoju (zero-downtime), gotowy plan rollbacku, monitoring i alerting. Zadania układają się w naturalną sekwencję: utworzenie gałęzi funkcyjnej i aktualizacja manifestów (nowy znacznik obrazu, zmienne środowiskowe, Sekret); commit, Pull Request, code review, CI, merge; sync ArgoCD i weryfikacja na staging; promocja do produkcji za pomocą tagu v2.0.0; test rollbacku (git revert + sync ArgoCD); wreszcie retrospektywa. Całość zamkniemy w 45 minut implementacji plus 15 minut podsumowania.

Role w zespole wyznaczają odpowiedzialności: Incident Commander koordynuje pracę, podejmuje decyzje i dba o komunikację; Developer implementuje zmiany i otwiera Pull Requesty; Reviewer prowadzi code review i zatwierdza lub żąda zmian; Scribe dokumentuje oś czasu, decyzje i działania naprawcze. Warto rotować rolami między ćwiczeniami, żeby każdy doświadczył każdej funkcji. Komunikację prowadzimy na dedykowanym kanale Slack (#gitops-exercise) i we wspólnym dokumencie z notatkami. Retrospektywa w formacie Start/Stop/Continue zbiera odpowiedzi na trzy pytania - co zaczynamy robić, co przestajemy, co kontynuujemy - a wszystkie działania naprawcze dostają właściciela i termin.

Podsumowując: to ćwiczenie łączy praktykę GitOps z pracą zespołową - jasne role, timebox dający skupienie, retrospektywa jako ciągłe doskonalenie. Code review, współdzielona odpowiedzialność, dobra komunikacja - to one decydują o sukcesie w GitOps. Ćwiczymy dokładnie tak, jak potem „gramy" w produkcji. Ocena obejmuje działające wdrożenie, udany rollback, retrospektywę i realne działania naprawcze.

Wyjaśnienie skrótów użytych na slajdzie:
TeamReview – Collaborative Team Review – zespołowa recenzja konfiguracji; Zadanie grupowe polegające na wieloosobowej weryfikacji architektury manifestów w ramach PR.
PRReview – Pull Request Inspection and Comments – inspekcja propozycji zmian w Git; Wskazywanie błędów konfiguracji i luk bezpieczeństwa w kodzie kolegów z grupy laboratoryjnej.
ConflictResolution – Git Merge Conflict Resolution – rozwiązywanie konfliktów scalania w Git; Praktyczne radzenie sobie z rozbieżnościami historii w trakcie równoległej pracy nad manifestami.
DeploymentSimulation – Staged Deployment Simulation – symulacja etapowego wdrożenia; Przejście pełnej ścieżki awansu zmian od środowiska deweloperskiego do produkcyjnego.
K8s – Kubernetes Hands-on Practice – praktyka laboratoryjna na klastrze Kubernetes; Weryfikacja zachowania obiektów aplikacyjnych po zatwierdzeniu zmian przez operatora GitOps.

46/55 Współpraca przy GitOps
Współpraca przy GitOps: Kultura współpracy: role (Developer, Reviewer, Maintainer, Release Manager), PR workflow (Draft → Ready → Review → Approved → Merged), komunikacja (Slack channels: #gitops-changes, #incidents, #deployments), dokumentacja (README, RUNBOOK, CHANGELOG, ADR).

Współpraca to droga, role, kanały i dokumenty. Każdy wie, którędy idzie zmiana i gdzie ją widać.

  • Kulturowy wymiar GitOps – wprowadzenie metodyki to nie tylko nowe oprogramowanie, lecz przede wszystkim głęboka transformacja kultury pracy IT.
  • Transparentność procedur PR – przeniesienie dyskusji technicznych do publicznych wniosków pull request buduje zaufanie i otwartość w zespole.
  • Przełamywanie silosów DevOps – współodpowiedzialność za definicje infrastruktury łączy programistów i inżynierów operacyjnych we wspólnej pracy.
  • Swoboda bezpiecznych eksperymentów – łatwość wycofywania zmian w Git zachęca zespoły do ciągłego ulepszania architektury bez paraliżującego lęku.
  • Szybka wartość dla biznesu – dojrzała kultura GitOps pozwala firmie skrócić czas dostarczania funkcji na rynek przy zachowaniu stabilności.
ADR: Architecture Decision Records - zapisane decyzje architektoniczne; z rolami, workflow PR, kanałami Slack i dokumentacją (README, RUNBOOK, CHANGELOG).
role

Współpraca przy GitOps to przede wszystkim kultura, a dopiero potem narzędzia. Każda zmiana przechodzi tą samą, jasno określoną drogą: Git, Pull Request, code review, CI i synchronizacja ArgoCD. Dobrą współpracę buduje się z kilku elementów: przypisane role i odpowiedzialności (Developer, Reviewer, Maintainer, Release Manager, On-call Engineer), przejrzysty proces Pull Requestu (Draft → Ready → Approved → Merged → Synced), komunikacja na dedykowanych kanałach (#gitops-changes, #incidents, #deployments), dokumentacja trzymana w samym repozytorium (README, RUNBOOK, CHANGELOG, ADR) oraz dzielenie się wiedzą - tech talki, wspólne postmortemy, programowanie parami czy mob programming. Całość łączy się w model oparty o zaufanie i jawność.

Role i odpowiedzialności warto ustalić od początku. Developer pisze kod i manifesty, zakłada Pull Requesty i odpowiada na uwagi w recenzji. Reviewer prowadzi code review - patrzy na poprawność, bezpieczeństwo, styl i testy. Maintainer zatwierdza i merguje, opiekuje się repozytorium i chroni gałęzie. Release Manager koordynuje wydania - tagowanie, changelog, noty wydawnicze, promocję między środowiskami. On-call Engineer odpowiada za incydenty, rollback, monitoring i alerty w czasie dyżuru. Do rozjaśnienia odpowiedzialności służy macierz RACI (Responsible, Accountable, Consulted, Informed) - dzięki niej każda zmiana ma swojego właściciela, a każda decyzja człowieka odpowiedzialnego za nią.

Proces Pull Requestu przebiega w sposób powtarzalny. Rozpoczyna się od wersji roboczej (Draft PR) umożliwiającej wczesną wymianę informacji, po czym przechodzi w stan gotowości do weryfikacji. Właściwy przegląd obejmuje merytoryczne komentarze, sugestie oraz formalne zatwierdzenie. Po akceptacji następuje scalenie zmian (merge), a następnie automatyczna synchronizacja w narzędziu ArgoCD. Po scaleniu kodu warto zweryfikować spójność wdrożenia, zaktualizować dziennik zmian CHANGELOG i utworzyć tag wydania. Zasady ochrony gałęzi (Branch Protection) egzekwują wymagane zatwierdzenia i pomyślny wynik testów CI.

Komunikacja opiera się na kilku prostych zasadach: zmianach poświęcamy kanał #gitops-changes, incydentom #incidents, wdrożeniom #deployments, a prośbom o recenzje #reviews; dyskusje przy Pull Requestach prowadzimy w wątkach; e-mail zostaje tylko dla alertów krytycznych, a StatusPage dla komunikacji z klientami. Dokumentacja ma swoje miejsce w repozytorium: RUNBOOKi (procedury krok po kroku) w docs/runbooks/, CHANGELOG dla użytkowników oraz ADR - Architecture Decision Records, zapisujące powody decyzji architektonicznych ("dlaczego wybraliśmy to narzędzie, dlaczego taką architekturę"). Tak zorganizowana współpraca pozwala też skalować zespół: onboarding opiera się na tej dokumentacji i środowisku testowym. Zasada przewodnia: budujemy, utrzymujemy i odpowiadamy za to, co wydajemy - a Git jest jedynym źródłem prawdy.

Wyjaśnienie skrótów użytych na slajdzie:
DevOpsCulture – DevOps Collaborative Culture – kultura współpracy DevOps; Współdzielenie odpowiedzialności za jakość i stabilność środowisk pomiędzy programistami a operacjami.
Communication – Clear Technical Communication – precyzyjna komunikacja techniczna; Jasne formułowanie uzasadnień biznesowych i technicznych w opisach zatwierdzeń i zgłoszeń PR.
GitWorkflow – Standardized Git Workflow – ustandaryzowany przepływ pracy w Git; Przestrzeganie konwencji nazw gałęzi, formatu komunikatów i zasad ochrony gałęzi głównej.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Rola inżyniera SRE jako facylitatora bezpiecznych i automatycznych wdrożeń w organizacji.
PairReview – Pair Engineering Review – recenzja w parach inżynierskich; Praktyka wspólnej analizy skomplikowanych zmian infrastrukturalnych w celu eliminacji błędów ludzkich.

47/55 Podsumowanie wykładu 7 (cz. 1)
Podsumowanie wykładu 7 (cz. 1): Cheat sheet komend: Git (init, clone, add, commit, push, pull, branch, merge, log, tag, revert). Terraform (init, plan, apply, workspace). Ansible (playbook, vault). Docker Compose (up, down, ps, logs). ArgoCD CLI (app create/sync/rollback).

Ściąga na lodówkę: Git, Terraform, Ansible, Compose, ArgoCD i kubectl - komendy, które wchodzą w krew.

  • Ręczne modyfikacje konsolowe – zmienianie parametrów w klastrze z pominięciem repozytorium kodu to najgroźniejszy antywzorzec niszczący GitOps.
  • Otwarte sekrety w repozytorium – umieszczanie jawnych haseł w plikach konfiguracyjnych tworzy śmiertelne ryzyko dla bezpieczeństwa infrastruktury.
  • Przeładowane commity zmian – tworzenie olbrzymich rewizji z setkami zmian uniemożliwia rzetelną recenzję i utrudnia późniejsze wycofywanie błędów.
  • Brak automatycznych testów – brak weryfikacji manifestów w potokach wdrożeniowych prowadzi do paraliżowania klastrów błędnymi plikami.
  • Świadoma higiena wdrożeń – konsekwentne unikanie typowych antywzorców jest warunkiem koniecznym do osiągnięcia stabilności środowiska chmurowego.
Cheat sheet: Ściąga komend Git, Terraform, Ansible, Compose, ArgoCD CLI i kubectl do codziennych powtórek aż wejdą w krew.
podsumowanie

Pierwsza część podsumowania wykładu to praktyczna "ściąga" komend - przydatna przed egzaminem, rozmową kwalifikacyjną i codzienną pracą. Zebrane dalej komendy pogrupowano tematycznie: Git jako fundament, Terraform dla infrastruktury jako kodu, Ansible dla konfiguracji, Docker Compose dla środowisk lokalnych, ArgoCD jako silnik GitOps oraz kubectl jako "scyzoryk" Kubernetes. Warto powtarzać je codziennie, aż wejdą w krew.

Git - centrum wszystkiego. Inicjalizacja i praca zdalna: git init, git clone, git remote -v, git remote add origin, git remote set-url origin. Codzienna praca: git add, git commit -m "msg", git push, git pull, git fetch, git status. Gałęzie: git branch, git checkout, git switch, git merge, git rebase. Przeglądanie: git log --oneline --graph, git show, git diff, git blame. Tagi: git tag -a v1.0.0 -m "msg" i git push --tags. Bezpieczeństwo i porządki: git revert HEAD, git reset --hard, git stash. GitHub CLI przyda się do obsługi Pull Requestów z konsoli: gh auth login, gh repo clone, gh pr create, gh pr list, gh pr view, gh pr merge.

Terraform - infrastruktura jako kod: terraform init (zainicjowanie modułów i backendu), terraform plan (podgląd zmian), terraform apply (zastosowanie), terraform destroy (usunięcie), terraform validate i terraform fmt (walidacja i formatowanie), terraform output (wartości wyjściowe), a także zarządzanie stanem - terraform state list, terraform state show, terraform import. Workspaces (dev, staging, prod) obsługujemy przez terraform workspace list/select/new, a lockowanie dostawców przez terraform providers lock. W praktyce backend najczęściej mieszka w S3 z blokadą na DynamoDB, a moduły ładujemy przez source i version. Ansible: ansible-playbook -i inventory playbook.yml, próba sucha --check i walidacja składni --syntax-check, instalacja ról przez ansible-galaxy install oraz szyfrowanie sekretów ansible-vault encrypt/decrypt/edit/view. Inventory bywa statyczny (hosts.ini) lub dynamiczny (aws_ec2, gcp_compute), a moduły - package, service, file, template, copy, systemd, docker_container, k8s.

Docker Compose - środowisko lokalne: docker compose up -d, down, ps, logs -f, pull, build, config (walidacja), exec, restart, scale, run. Healthcheck definiujemy przez test, interval, timeout, retries i start_period. ArgoCD - silnik GitOps: argocd login, argocd app create/get/list/sync/rollback/history/diff/manifests/watch, zarządzanie repozytoriami (argocd repo add/list), klastrami (argocd cluster add/list) i projektami (argocd proj create/list) oraz zmiana hasła (argocd account update-password). Na koniec kubectl: get, apply, delete, describe, logs, exec, port-forward oraz praca z Kustomize - kubectl apply -k i kubectl kustomize. Całość to szybka ścieżka powtórzenia przed oceną.

Wyjaśnienie skrótów użytych na slajdzie:
Git – Git Version Control System – system kontroli wersji Git; Podsumowanie roli repozytorium jako fundamentu audytu i pojedynczego źródła prawdy.
Declarative – Declarative Configuration Pattern – deklaratywny wzorzec konfiguracji; Przewaga opisu stanu pożądanego nad tradycyjnymi skryptami imperatywnymi.
Reconciliation – Automated Reconciliation Loop – automatyczna pętla uzgadniania; Samoczynne utrzymywanie zgodności klastra z definicjami w repozytorium kodu.
ArgoCD – Argo CD GitOps Platform – platforma GitOps ArgoCD; Podstawowe narzędzie orkiestracji wdrożeń w architekturze chmurowej.
Flux – Flux CD Toolkit – narzędzia Flux CD; Modułowy ekosystem kontrolerów Kubernetes dedykowany do automatyzacji GitOps.

48/55 Podsumowanie wykładu 7 (cz. 2)
Korzyści GitOps: Wdrożenie GitOps przynosi: powtarzalność (identyczne środowiska), audyt (Git history = pełny dziennik zmian), szybki rollback (git revert w sekundy). Eliminuje manual ops, daje compliance (SOX, GDPR, PCI-DSS).

Po co GitOps? Powtarzalność, audyt, szybki rollback i koniec toil. Biznesowo: taniej, szybciej i zgodniej.

  • Logiczna ewolucja DevOps – koncepcja GitOps stanowi dojrzałe rozwinięcie automatyzacji dostarczania oprogramowania w nowoczesnym świecie IT.
  • Samodzielność zespołów produktowych – udostępnienie programistom gotowych szablonów wdrożeniowych skraca czas dostarczania nowych usług.
  • Rola inżynierów platformowych – zespół platformowy buduje stabilne fundamenty i narzędzia, uwalniając deweloperów od zadań operacyjnych.
  • Standaryzacja w całej korporacji – ujednolicenie procesów wdrażania kodu eliminuje chaos technologiczny i gwarantuje spójność architektury.
  • Fundament inżynierii SRE – współczesna inżynieria niezawodności traktuje GitOps jako standardowy sposób zarządzania środowiskami chmurowymi.
Manual ops: Ręczne operacje eliminowane przez GitOps; powtarzalność, audyt i szybki rollback dają compliance (SOX, GDPR, PCI-DSS).
wnioski

Druga część podsumowania wykładu przenosi uwagę z samych narzędzi na ich wartość biznesową - dlaczego organizacje w ogóle decydują się na wdrożenie GitOps, co realnie zyskują i jakie koszty i ryzyka udaje się im zredukować. Gdyby ktoś zapytał "po co nam GitOps?", ten blok jest najlepszą odpowiedzią. Kluczowe korzyści to powtarzalność środowisk, pełna audytowalność, błyskawiczny rollback i systematyczna eliminacja zbędnej pracy ręcznej - a to razem przekłada się na niższy koszt eksploatacji, krótszy czas usuwania awarii i łatwiejsze spełnianie wymogów compliance.

Powtarzalność (repeatability) oznacza, że środowiska dev, staging i produkcja są za każdym razem identyczne, bo ich stan zapisany jest w deklaratywnych manifestach, a nie w głowach ludzi ani w przyciskach w panelu. W praktyce środowiska różnią się jedynie wartościami konfiguracji (ApplicationSet + overlaye), nigdy strukturą. Stare "works on my machine" przestaje obowiązywać, bo środowisko tworzy się z kodu. Efekt? Mniejsze prawdopodobieństwo "przypadkowo innego środowiska", szybsze odtwarzanie po awarii (disaster recovery) i przewidywalne zachowanie w produkcji. Związana koncepcja to immutable infrastructure - nie patchujemy działającego serwera, tylko budujemy nowy z gotowego obrazu; w skrajnej formie nowa wersja otwiera „nowy klaster testowy" zamiast aktualizacji na żywo. Wszystko to redukuje dryft środowiskowy (environment drift) i czyni odtwarzalne builds standardem.

Audytowalność to siła GitOps w starciu z audytorem, inspektorem i każdym, kto pyta "kto, co i kiedy zmienił?". W tym modelu każda zmiana - kto, co, kiedy, dlaczego, przez który Pull Request - trafia trwale do historii Git. To nie jest log do którego nikt nie zagląda, ale przeszukiwalna baza odpowiedzi na pytania kontrolne. Wystarczy przywołać zgodność z kilkoma standardami: SOX wymaga ścieżek zatwierdzeń i audytu zmian; GDPR - kontroli przetwarzania danych; PCI-DSS - kontroli zmian i monitoringu w środowiskach kartowych; ISO 27001 - kontroli zarządzania zmianami. Dla inspektora GitOps daje niezaprzeczalny ślad: wersjonowana konfiguracja plus historie wdrożeń z ArgoCD. To nie jest "zbieranie dowodów" - dowody zbierają się same.

Szybki rollback to kolejna przewaga, bo gdy wdrożenie okaże się złym pomysłem, cofamy je w sekundach: git revert plus push, a ArgoCD auto-sync przywraca poprzedni, znany i sprawdzony stan. To diametralna różnica w porównaniu z klasycznymi wdrożeniami, gdzie rollback oznacza ręczne wgrywanie starej wersji i nerwowe oczekiwanie. Auto-sync i self-heal eliminują toil - powtarzalną, mechaniczną pracę ręczną; nikt nie loguje się do serwera, by "ręcznie naprawić" stan, bo robi to kontroler oczekiwany. MTTR maleje, liczba manualnych operacji spada, a zespół inżynierski może zająć się wykrywaniem przyczyn źródłowych, a nie jedynie doraźnym usuwaniem skutków awarii – na tym polega filozofia SRE: eliminacja pracy powtarzalnej (toil) i efektywne gospodarowanie budżetem błędów. Release engineering oparty o tagi Git i promocję między środowiskami zamienia wydanie w jawny, audytowalny proces. Na koniec: koszty wdrożenia (narzędzia, szkolenia, zmiana kultury) zwracają się przez niższy MTTR, mniej incydentów, mniej nadgodzin i lepsze wyniki w metrykach DORA (deployment frequency, lead time, MTTR, change failure rate).

Wyjaśnienie skrótów użytych na slajdzie:
SecretsManagement – Secure Secrets Management in GitOps – bezpieczne zarządzanie sekretami w GitOps; Podsumowanie wzorców kryptograficznych chroniących dane poufne w repozytoriach.
SOPS – Mozilla SOPS Framework – framework Mozilla SOPS; Standard szyfrowania hybrydowego zintegrowany z dostawcami kluczy chmurowych.
RBAC – Role-Based Access Control in GitOps – kontrola dostępu oparta na rolach w GitOps; Separacja uprawnień i zasada najmniejszych przywilejów w zarządzaniu klastrami.
PolicyAsCode – Policy-as-Code Enforcement – wymuszanie polityk jako kodu; Bramki bezpieczeństwa uniemożliwiające synchronizację niezgodnych z prawem konfiguracji.
Audit – Complete Historical Auditability – pełna audytowalność historyczna; Gwarancja nienaruszalności śladu operacyjnego dla celów certyfikacji i kontroli prawnej.

49/55 Omówienie pracy własnej
Omówienie pracy własnej: Zadania domowe: stwórz docker-compose.yml (min. 3 serwisy) → GitHub Actions/GitLab CI → ArgoCD Application → sync + weryfikacja → rollback test → RUNBOOK + CHANGELOG + README. Prezentacja: 5 min demo + 5 min Q&A.

Praca własna: compose, CI, ArgoCD, rollback i dokumentacja. Demo 5+5 na zajęciach.

  • Standard Conventional Commits – wprowadza jednolity format opisu zmian, ułatwiając ludziom i maszynom analizę historii repozytorium.
  • Automatyczne wyliczanie wersji – prefiksy takie jak feat czy fix pozwalają narzędziom na samoczynne ustalanie numeru kolejnego wydania.
  • Semantyczne wersjonowanie SemVer – informuje użytkowników o pojawieniu się nowych funkcjonalności lub zmianach łamiących kompatybilność.
  • Generowanie dzienników wydań – automatyczne tworzenie czytelnych list zmian Changelog na podstawie commitów oszczędza cenny czas inżynierów.
  • Dyscyplina opisu zatwierdzeń – dbałość o precyzyjne opisy commitów jest wizytówką każdego profesjonalnego inżyniera oprogramowania i SRE.
Demo 5+5: Prezentacja pracy - 5 minut demo plus 5 minut pytań; z repo na Classroom/GitLabie i code review jako częścią oceny.
zadania

Praca własna to etap, w którym przenosicie teorię w praktykę - budujecie, wdrażacie, testujecie i dokumentujecie kompletny system GitOps samodzielnie. Zadanie obejmuje pięć kroków i zamyka się przed ósmym wykładem; repozytorium hostujecie na GitHub Classroom, GitLabu lub jako zip na Moodle. Code review jest integralną częścią oceny - nie tylko oceniamy działanie stacku, ale też jakość Pull Requestu, czytelność kodu i kompletność dokumentacji.

Zaczynamy od pliku docker-compose.yml dla aplikacji wielokontenerowej z co najmniej trzema serwisami: aplikacja (app), baza danych (db) i cache. Dbamy o healthchecki, depends_on z warunkiem service_healthy, sieci (frontend i backend) oraz woluminy dla danych trwałych. Do tego dochodzi .gitignore (node_modules, .env, logi), workflow CI/CD w GitHub Actions lub GitLab CI (budowanie obrazów, push do rejestru, aktualizacja tagów w compose.yml, commit i push), oraz sam compose.yml - wersjonowany w Git. Po ukończeniu本地 testu (docker compose up -d) tworzycie tag git tag v1.0.0 i wypychacie go (git push --tags).

Następnie przechodzicie do integracji z ArgoCD: tworzycie Application (source: repo, path: compose/overlays/prod, targetRevision: main; destination: klaster i namespace), synchronizujecie (auto lub ręcznie) i weryfikujecie stan (kubectl get pods, curl do healthchecka). Potem przychodzi test rollbacku: git revert, push i ArgoCD sync - sprawdzacie, czy aplikacja wraca do poprzedniej, działającej wersji. Na koniec dokumentacja: RUNBOOK (opis krok po kroku jak wdrażać, robić rollback i debugować), CHANGELOG (zmiany w wersji - Added, Fixed, Changed, Security) oraz README (instrukcja uruchomienia lokalnego). Na zajęciach odbędzie się prezentacja: 5 minut demo plus 5 minut pytań. Ocena obejmuje cztery elementy: działający stack, poprawny rollback, kompletna dokumentacja i sama prezentacja. To nie jest teoria - to symulacja prawdziwego workflowu GitOps. Budujesz, uruchamiasz, dokumentujesz.

Wyjaśnienie skrótów użytych na slajdzie:
LabReview – Laboratory Exercise Review – przegląd ćwiczeń laboratoryjnych; Ocena poprawności wykonanych przez studentów potoków synchronizacji i manifestów.
GitVerification – Git Repository State Verification – weryfikacja stanu repozytorium Git; Sprawdzenie czystości historii commitów, podpisów kryptograficznych i braku haseł w plikach.
K8sTroubleshooting – Kubernetes Diagnostic Troubleshooting – diagnostyka problemów w Kubernetesie; Wspólne analizowanie przyczyn stanów OutOfSync, błędów kompozycji i pętli restartów.
BestPractices – Engineering Best Practices – najlepsze praktyki inżynierskie; Utrwalenie standardów nazewnictwa, modularności i separacji środowisk w nakładkach Kustomize.
QandA – Questions and Answers Session – sesja pytań i odpowiedzi; Wyjaśnienie wątpliwości technicznych związanych z implementacją modelu GitOps w firmach.

50/55 Etyka wersjonowania
Etyka wersjonowania: Odpowiedzialna komunikacja zmian: conventional commits (feat:, fix:, chore:), semantic versioning (MAJOR.MINOR.PATCH), changelog (keepachangelog.com), release notes. Związek z K02: transparentność, nie ukrywanie breaking changes.

Wersjonujesz dla ludzi: commity, tagi i changelogi tak, żeby kolega (i ty za pół roku) zrozumiał. K02 w praktyce.

  • Małe i atomowe zatwierdzenia – tworzenie commitów skupionych na jednej zmianie drastycznie upraszcza recenzję kodu i diagnozowanie usterek.
  • Regularna synchronizacja gałęzi – częste pobieranie najnowszych zmian z repozytorium zapobiega skomplikowanym konfliktom podczas scalania kodu.
  • Weryfikacja różnic przed commitem – sprawdzanie wygenerowanego diffa chroni projekt przed omyłkowym dołączeniem zbędnych plików tymczasowych.
  • Kryptograficzny podpis commitów – podpisywanie zatwierdzeń kluczami GPG potwierdza tożsamość autora i zabezpiecza projekt przed fałszerstwem.
  • Solidne fundamenty GitOps – dobre nawyki wypracowane podczas codziennej pracy z repozytorium są fundamentem bezproblemowych wdrożeń w chmurze.
Conventional commits: Konwencja feat:/fix:/chore: w opisach zmian; z semver, changelogiem i release notes - transparentność zamiast ukrywania breaking changes (K02).
etyka

Śledzenie zmian i audytowalność wydań podlegają regulacjom ochrony danych nadzorowanym przez UODO oraz normie PN-EN ISO/IEC 27001 w zakresie bezpieczeństwa informacji i kontroli dostępu.

Etyka wersjonowania to odpowiedzialność inżyniera za to, jak opisuje zmiany, komu je zakomunikuje i jak dbają o to, by nikt nie został zaskoczony. Wersjonowanie to nie tylko formalność - to komunikacja z zespołem, użytkownikami i przyszłym sobą. Jasny opis w commicie, w tagu i w notach wydawniczych to empatia wobec kolegów, którzy muszą zrozumieć, co się zmieniło, dlaczego i jak ta zmiana wpływa na ich pracę. W praktyce oznacza to stosowanie conventional commits (feat:, fix:, chore:, docs:, refactor:, perf:, test:), semantic versioning (MAJOR.MINOR.PATCH), prowadzenie changelogu (według standardu keepachangelog.com), release notes (oddzielnie dla użytkowników i deweloperów) i staranne tagowanie - np. git tag -a v1.2.3 z opisem, co się zmieniło. Wszystko to ma związek z kompetencją K02: inżynier odpowiada za jakość komunikacji, transparentność i zaufanie w zespole.

Conventional Commits to ustalona konwencja nadawania nazw commitom. Każdy commit zaczyna się od typu: feat (nowa funkcja), fix (naprawa błędu), chore (konserwacja, aktualizacja zależności), docs (dokumentacja), refactor (zmiana struktury bez zmiany zachowania), perf (poprawa wydajności), test (dodanie testów), ci (zmiany w CI/CD), build (zmiany w systemie budowania), revert (cofanie poprzedniego commita). Format to typ, w nawiasie opcjonalny zakres i opis: feat(payments): add Stripe integration. Zmiana niekompatybilna wstecz sygnalizowana jest dopiskiem BREAKING CHANGE w stopce lub wykrzyknikiem po typie (feat!: ...), co automatycznie wymusza skok MAJOR wersji. To pozwala na automatyczne generowanie changelogów i buduje przejrzystość zmian.

Changelog i Release Notes to dwa komunikaty kierowane do różnych odbiorców. Changelog - w formacie keepachangelog.com - jest techniczny i precyzyjny: Added, Fixed, Changed, Security. Przykład: ## [1.2.3] - 2024-01-15, ### Added: feat(payments): Stripe integration, ### Fixed: fix(auth): token expiration handling. Z kolei Release Notes to komunikat dla użytkowników końcowych - bez technicznego żargonu ("Nowa metoda płatności Stripe, poprawa logowania") - oraz dla deweloperów, z detalem technicznym. Tag tworzymy jako annotated (git tag -a v1.2.3 -m "Release v1.2.3: ..."), a GitHub Release generujemy z tagu i fragmentu changelogu. Wszystko to buduje zaufanie: użytkownik wie, co dostaje, deweloper wie, co się zmieniło, a audytor ma ślad.

Związek z K02 (etyka, poufność, odpowiedzialność) sprowadza się do kilku zasad. Etyka: uczciwa komunikacja zmian, nie ukrywanie niekompatybilności wstecz (breaking changes) bez ostrzeżenia i przewodnika migracji. Poufność: żadnych sekretów w changelogu, notach ani commitach. Odpowiedzialność: inżynier odpowiada za jakość komunikacji - breaking changes dostają wyraźne ostrzeżenie i przewodnik, a poprawki bezpieczeństwa mają priorytet. Transparentność buduje zaufanie w zespole i z użytkownikami. Warto zapamiętać jedną zasadę: pisz commity dla ludzi, nie dla maszyn - bo to człowiek będzie je czytał za pół roku.

Wyjaśnienie skrótów użytych na slajdzie:
Traceability – Complete Operational Traceability – pełna identyfikowalność operacyjna; Możliwość precyzyjnego powiązania każdego działającego poda z zatwierdzeniem i autorem w Git.
Responsibility – Shared Engineering Responsibility – współdzielona odpowiedzialność inżynierska; Poczucie odpowiedzialności za skutki produkcyjne scalanych do repozytorium zmian.
GitAttribution – Cryptographic Git Attribution – kryptograficzne przypisanie autorstwa w Git; Wymóg podpisywania commitów eliminujący możliwość podszycia się pod innego inżyniera.
GPGSigning – GPG Commit Signing – podpisywanie zatwierdzeń kluczem GPG; Standard weryfikacji integralności i autentyczności commitów na poziomie repozytorium centralnego.
NonRepudiation – Legal Non-Repudiation Principle – zasada niezaprzeczalności prawnej; Właściwość kryptograficzna gwarantująca, że autor nie może wyprzeć się wprowadzonej modyfikacji.

51/55 Najlepsze praktyki Git
Najlepsze praktyki Git: Atomic commits (jeden = jedna zmiana), conventional commits, regularne pull/rebase, małe PR (max 400 linii), konstruktywny code review, branch protection, semver tagging, git hygiene (prune, gc), security (signed commits, no secrets).

Git działa dla ciebie, gdy masz nawyki: małe commity, krótkie gałęzie, małe PR-y i czyste repo.

  • Czystość historii repozytorium – osiąga się ją poprzez usuwanie scalonych gałęzi funkcyjnych oraz spłaszczanie roboczych zatwierdzeń.
  • Dobre praktyki pull requestów – zgłoszenia powinny zawierać zwięzłe uzasadnienie zmian, instrukcję testowania oraz ewentualne zrzuty ekranu.
  • Priorytetowa recenzja kodu – inżynierowie powinni sprawnie oceniać propozycje zmian kolegów, zapobiegając blokowaniu pracy innych zespołów.
  • Zakaz siłowego wypychania push – modyfikowanie historii we współdzielonych gałęziach za pomocą siłowego pusha niszczy pracę innych współpracowników.
  • Przewidywalność i spokój – przestrzeganie zespołowych reguł higieny kodu sprawia, że praca w modelu GitOps staje się płynna i wolna od stresu.
Atomic commits: Atomowe commity (jeden = jedna zmiana); z małymi PR (max 400 linii), higieną (prune, gc) i bezpieczeństwem (podpisy, brak sekretów).
praktyki

To zbiór praktyk, które w codziennej pracy sprawiają, że Git działa na naszą korzyść - doświadczenie skondensowane w konkretne nawyki. Komendy to tylko narzędzie; to nawyki czynią je potężnym. Zasady obejmują commity (małe, atomowe, w konwencji conventional commits), gałęzie (krótkotrwałe, funkcyjne, z konwencją nazewniczą), Pull Requesty (małe, z opisem i kontekstem, samodzielnie przeglądane przed wysłaniem), code review (konstruktywne i konkretne), CI/CD (wymagane kontrole, szybkie porażki, cache), Branch Protection, strategie merge, tagowanie semver, higienę repozytorium i bezpieczeństwo (podpisane commity, brak sekretów).

Zasada atomowych commitów to jedna logiczna zmiana na jeden commit. Dzięki temu wszystko jest prostsze: code review (mały diff nie przytłacza recenzenta), git bisect (znajdujemy bug bez szukania w ogromnej zmianie), git revert (cofamy jedną zmianę bez ubocznych skutków) i cherry-pick (przenosimy pojedynczą zmianę do innej gałęzi). Zbyt duże commity typu "fix stuff", "update files" czy "wip" są wrogiem historii; zamiast nich piszemy feat(auth): add JWT token refresh. Jeśli commita nie da się podzielić na mniejsze logiczne jednostki - jest atomowy.

Regularny git pull --rebase (albo --ff-only) trzyma Twoją pracę na bieżąco z gałęzią główną i zapobiega trzem problemom: dużym konfliktom merge przy późnym pull, pracy na nieaktualnym kodzie oraz wymuszonemu force pushowi przy rozbieżnej historii. Pull wykonujemy przed rozpoczęciem pracy, przed pushem i po code review (przed merge). Wygodnie ustawić git config --global pull.rebase true, a w razie potrzeby robić to ręcznie: git fetch origin && git rebase origin/main. To drobny nawyk o wielkiej wartości.

Pozostałe praktyki dopisujemy do codziennego rytuału. Nazewnictwo gałęzi: feature/JIRA-123, bugfix/JIRA-456, hotfix/JIRA-789, release/v1.2.0. Pull Requesty trzymamy małe - co najwyżej 400 linii diff - z opisem, testem i zrzutami ekranów, przed wysłaniem robimy samodzielny przegląd. Code review jest konstruktywne, konkretne i wykonywalne - zamiast "looks good" piszemy "linia 42: rozważ const zamiast let dla niemutowalności". W CI wymagane kontrole (lint, testy, build, bezpieczeństwo) i szybkie porażki; Branch Protection z dwiema wymaganymi recenzjami, kontrolami, podpisanymi commitami i liniową historią. Tagi semver z podpisem (annotated). Higiena: git fetch --prune, git gc, usuwanie połączonych gałęzi (git branch --merged | grep -v main | xargs git branch -d). Bezpieczeństwo: podpisane commity (GPG/SSH) i narzędzia wykrywające sekrety - git-secrets, trivy, gitleaks - wpięte w CI. Dobre nawyki oznaczają mniej błędów, szybsze recenzje i łatwiejsze debugowanie.

Wyjaśnienie skrótów użytych na slajdzie:
AtomicCommits – Atomic Git Commits Principle – zasada atomowych zatwierdzeń; Tworzenie commitów obejmujących pojedynczą, logicznie zamkniętą i spójną modyfikację infrastruktury.
ClearMessages – Informative Commit Messages – czytelne komunikaty zatwierdzeń; Konwencja opisywania przyczyn wprowadzenia zmiany zgodnie ze standardem Conventional Commits.
SmallPRs – Small and Focused Pull Requests – małe i ukierunkowane propozycje zmian; Zmniejszanie ryzyka i przyspieszanie recenzji poprzez ograniczanie rozmiaru pojedynczego PR.
LinearHistory – Clean Linear Git History – czysta liniowa historia w Git; Unikanie chaotycznych commitów scalających na rzecz przebazowania i polityki rebase/fast-forward.
Rebase – Git Rebase Workflow – przepływ pracy oparty na rebase; Utrzymywanie prostego, czytelnego drzewa zmian ułatwiającego analizę historyczną i rollbacki.

52/55 Wdrażanie GitOps w organizacji
Wdrażanie GitOps w organizacji: Adoption path: pilot (1 app, 1 team, ArgoCD) → scale (dodaj recenzje, klastry, policy) → standardize (naming, structure, CI/CD) → govern (policy as code, compliance). Mierzy DORA metrics. Platform Engineering = IDP na GitOps.

Adopcja to droga: pilot, skala, standard i nadzór - mierzona DORA i układana w platformę (IDP).

  • Etap pilotażowy wdrożenia – wprowadzanie zasad GitOps w firmie należy zacząć od małego projektu prowadzonego przez doświadczony zespół.
  • Skalowanie sprawdzonych wzorców – sukces pilotażu pozwala wypracować gotowe szablony, które można stopniowo rozszerzać na resztę organizacji.
  • Standaryzacja procesów platformy – kluczem do sukcesu jest ujednolicenie struktur katalogów, nazewnictwa oraz procedur zarządzania sekretami.
  • Programistyczne polityki ładu – wdrożenie automatycznych reguł bezpieczeństwa gwarantuje zgodność z normami prawnymi i ułatwia audyty.
  • Śledzenie metryk DORA – pomiar częstotliwości wdrożeń i wskaźnika awaryjności pozwala obiektywnie wykazać korzyści biznesowe z GitOps.
DORA metrics: Metryki DevOps mierzące adopcję (częstotliwość wdrożeń, lead time, MTTR, change fail rate); ścieżka pilot → scale → standardize → govern.
plan wdrożenia

Wdrażanie GitOps w organizacji to proces iteracyjny, a nie jednorazowe "przełączenie przełącznika" - to zmiana kultury, procesów i narzędzi, przemyślane przejście od pilotażu do pełnej skali działania. Ścieżka adopcji wygląda zwykle tak: najpierw ocena stanu bieżącego (manual operations, dotychczasowe CI/CD i narzędzia), potem pilotaż na jednej aplikacji i jednym zespole z ArgoCD i Gitem, następnie skalowanie (recenzje, kolejne klastry, polityki), standaryzacja (nazewnictwo, struktura repozytoriów, szablony CI/CD) i wreszcie zarządzanie (policy as code, compliance, audyt). Całość mierzymy metrykami DORA i układamy w platform engineering - budowanie wewnętrznej platformy deweloperskiej (IDP) osadzonej na GitOps.

Pilot to najważniejsza pierwsza próba. Wybieramy jedną aplikację - niekrytyczną, ale reprezentatywną - oraz jeden zespół doświadczony i otwarty na zmiany. Stack powinniśmy uprościć: Kubernetes, ArgoCD i Git. Cel to działająca pętla GitOps (commit → PR → CI → sync ArgoCD) połączona z pomiarami: częstotliwość wdrożeń, czas realizacji zmian, MTTR i odsetek nieudanych zmian (DORA metrics). Po pilocie robimy retrospektywę, spisujemy wnioski i dokumentację oraz podejmujemy świadomą decyzję: skalujemy, przerywamy albo dostosowujemy.

W fazie skalowania najpierw obowiązkowo dodajemy recenzje: co najmniej jedną akceptację (dwie przy zmianach krytycznych i infrastrukturalnych), CODEOWNERS automatycznie przypisujący recenzentów, wymagane kontrole statusu w CI (lint, testy, bezpieczeństwo, polityki), podpisane commity i liniową historię. Kultura code review jest konstruktywna, konkretna i terminowa - warto mieć listę kontrolną (bezpieczeństwo, wydajność, utrzymywalność, testy, dokumentacja). Następnie rozszerzamy wdrożenie na kolejne klastry. Multi-cluster GitOps zwykle oznacza centralny "hub" ArgoCD zarządzający wieloma podpiętymi klastrami (ApplicationSet z Cluster Generator tworzy aplikacje automatycznie per klaster); alternatywą jest oddzielny ArgoCD na każdy klaster - większa izolacja, ale więcej narzędzi do utrzymania. Promocja działa tu zwykłym schematem dev → staging → prod, a disaster recovery wspiera przeniesienie synchronizacji na klaster zapasowy.

Na końcu standaryzujemy i zarządzamy. Standaryzacja to ustalone konwencje nazewnicze (zasoby, etykiety, adnotacje), struktura repozytoriów (monorepo kontra polyrepo), reusable szablony CI/CD i manifesty oparte o base plus overlaye. Governance to policy as code (Kyverno, OPA Gatekeeper wymuszające standardy), compliance (SOX, GDPR, PCI-DSS), audyt (logi ArgoCD i Git), FinOps (przypisanie kosztów do aplikacji, środowisk i zespołów) oraz bezpieczeństwo łańcucha dostaw (SBOM, cosign, skanowanie obrazów, zabezpieczenia środowiska wykonawczego). Wdrażanie GitOps to podróż, nie cel - kluczem są poparcie kierownictwa, zaangażowanie zespołów, iteracyjne podejście, pomiary i dokumentacja.

Wyjaśnienie skrótów użytych na slajdzie:
CulturalChange – Organizational Cultural Transformation – organizacyjna transformacja kulturowa; Przejście od manualnego administrowania do programistycznej dyscypliny wersji w całym dziale IT.
Training – Continuous Engineering Training – ciągłe szkolenie inżynierów; Inwestycja w podnoszenie kompetencji zespołu w zakresie zaawansowanych funkcji Gita i Kubernetesa.
PilotProject – GitOps Pilot Implementation – projekt pilotażowy GitOps; Rozpoczęcie wdrażania metodyki od wyizolowanej, niekrytycznej usługi w celu zebrania doświadczeń.
Tooling – Standardized Tooling Selection – dobór ustandaryzowanych narzędzi; Wybór jednolitego stosu (np. ArgoCD + Kustomize + SOPS) obowiązującego we wszystkich zespołach.
MaturityModel – GitOps Maturity Model Assessment – ocena modelu dojrzałości GitOps; Cykliczne badanie stopnia automatyzacji i bezpieczeństwa procesów wdrożeniowych w firmie.

53/55 Podsumowanie końcowe
Podsumowanie końcowe: Kluczowe tematy wykładu 7: GitOps (Git + declarative + reconciliation), ArgoCD (sync, self-heal, drift detection), IaC (Terraform, Ansible, Compose), bezpieczeństwo (secrets, RBAC, policy), współpraca (PR, review, CI/CD).

Mapa, nie katalog: model, mechanika, bezpieczeństwo i współpraca. Sedno w jednym zdaniu o ArgoCD.

  • Rewolucja w dostarczaniu usług – metodyka GitOps łączy kontrolę wersji z deklaratywnością, automatyzacją i ciągłą samonaprawą środowisk.
  • Niezawodna rekonsyliacja ArgoCD – operator pilnuje, aby stan obiektów w klastrze był w każdej sekundzie wiernym odbiciem deklaracji z Git.
  • Pełna ochrona tajemnic – narzędzia Kustomize, SOPS i External Secrets Operator gwarantują elastyczność i najwyższy poziom ochrony haseł.
  • Transparentny dialog inżynierów – przeniesienie procesu wydań do wniosków pull request tworzy bezpieczną i audytowalną kulturę współpracy.
  • Fundament nowoczesnego IT – opanowanie narzędzi GitOps pozwala budować wysoce odporne, skalowalne i zautomatyzowane platformy chmurowe.
Mapa powiązań: Cztery warstwy wykładu - model GitOps, mechanika (ArgoCD/IaC), bezpieczeństwo i współpraca; sedno: ArgoCD ciągnie klaster do stanu z Git.
zakończenie

To zakończenie domyka cały materiał wykładu 7. Porządkujemy go w cztery warstwy: GitOps jako model operacyjny, ArgoCD i narzędzia IaC jako mechanika, bezpieczeństwo oraz współpraca. To nie jest szczegółowy katalog, lecz mapa powiązań - jeśli po tym podsumowaniu potraficie jednym zdaniem opisać rolę ArgoCD (ciągnie stan klastra do stanu zdefiniowanego w Git), macie sedno wykładu. Reszta to rozwijanie tego zrozumienia.

Warstwa pierwsza - GitOps jako model. Cztery fundamenty wg OpenGitOps (CNCF): deklaratywny opis systemu (desired state w Git), kontrola wersji i niezmienność (historia równa się audyt, nic nie zmienia się poza wyznaczoną ścieżką), automatyczne pobieranie (wdrożenia oparte na pull), ciągła rekonsyliacja (operator stale porównuje stan rzeczywisty z pożądanym i przywraca zgodność). Na tym tle rozróżnienie push (CI wypycha zmiany) versus pull (operator sam pobiera z Git - Twoja pasywność, Git jest aktywny) wyznacza architekturę całego systemu.

Warstwa druga - ArgoCD jako mechanika i narzędzia IaC. ArgoCD to silnik rekonsyliacji dla Kubernetes: zasób Application (source = repo + ścieżka + rewizja, destination = klaster + namespace), sync policy (manual/auto), opcje sync (prune, self-heal), kontrole zdrowia, hooki (pre-sync/sync/post-sync), a w produkcji odpowiednia konfiguracja HA (co najmniej dwie repliki, load balancer, bootstrapping). Wokół niego narzędzia IaC: Terraform (deklaratywna infrastruktura ze stanem i workspaces - dla "ciężkiej" infrastruktury), Ansible (configuration management przez playbooki, role i vault - dla serwerów), Docker Compose (lokalne środowiska wielokontenerowe - lekki GitOps bez Kubernetes). Dobór narzędzia zależy od zarządzanej warstwy, ale Git pozostaje jedynym źródłem prawdy dla wszystkich.

Warstwa trzecia - bezpieczeństwo (sekrety, RBAC, polityki) i czwarta - współpraca (PR, review, CI/CD). Bezpieczeństwo GitOps jest wielowarstwowe: sekrety nigdy w plaintext (SealedSecrets, ExternalSecrets, Vault, SOPS), RBAC i Branch Protection (reguły określające, kto ma uprawnienia do scalania kodu), podpisane commity i podpisywanie obrazów (cosign, SBOM), policy as code (Kyverno, OPA Gatekeeper egzekwujące reguły przy wdrożeniu) oraz logi audytowe. Współpraca to jakość procesu: PR jako brama jakości (code review, zatwierdzenia, CI jako gate), ADR i README w repozytorium, komunikacja na kanałach (#gitops-changes, #incidents), programowanie parami i dokumentacja jako kanały dzielenia wiedzy, onboarding przez checklistę i środowisko testowe. GitOps mówi jednym zdaniem: deklaratywna infrastruktura, oczekiwany stan w Git, operator ciągle przywracający zgodność. Kolejne kroki: dokończ pracę własną (compose + CI + ArgoCD + rollback test + dokumentacja), dokumentuj procesy wdrożeniowe (runbook) i czerp z listy materiałów na następnym slajdzie. Wykład 8 o incydentach i post-mortem pokaże, jak GitOps wspiera diagnozę i naukę po awariach.

Wyjaśnienie skrótów użytych na slajdzie:
GitOpsMaturity – GitOps Maturity Level – poziom dojrzałości GitOps; Osiągnięcie pełnej automatyzacji, gdzie 100% zmian produkcyjnych przechodzi przez repozytorium kodu.
DeclarativeEverything – Declarative Everything Paradigm – paradygmat deklaratywności wszystkiego; Docelowy stan, w którym klastry, sieci, uprawnienia i aplikacje są opisane w Git.
SingleSourceOfTruth – Absolute Single Source of Truth – bezwzględne pojedyncze źródło prawdy; Całkowita eliminacja lokalnych konfiguracji i ręcznych skryptów na serwerach.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Osiągnięcie stabilności i przewidywalności usług dzięki eliminacji czynnika błędów ludzkich.
Agility – Operational Agility and Speed – zwinność i szybkość operacyjna; Możliwość bezpiecznego i częstego publikowania nowych funkcji z zachowaniem wysokiej niezawodności.

54/55 Materiały dodatkowe
Materiały dodatkowe: Rozszerzona lista źródeł: Pro Git Book, GitHub Skills, ArgoCD/Flux/Tekton docs, Terraform/Ansible/K8s docs, Kyverno/OPA/Falco (security), Chaos Mesh/Litmus (chaos engineering). Wszystkie linki zweryfikowane (HTTPS, działają).

Czytaj u źródeł: ArgoCD, Flux, Tekton, IaC i sekrety - wszystko zweryfikowane, po HTTPS, bez 404.

  • Oficjalna dokumentacja narzędzi – portale projektów ArgoCD, Flux CD oraz Kustomize stanowią najbardziej aktualne źródło wiedzy inżynierskiej.
  • Literatura wzorców chmurowych – publikacje poświęcone systemowi Git oraz wzorcom dla platformy Kubernetes pomagają zrozumieć architekturę.
  • Referencyjne repozytoria kodu – analiza publicznych projektów open-source pozwala poznać sprawdzone w boju układy katalogów i manifestów.
  • Zasoby fundacji CNCF – śledzenie nowości i białych ksiąg publikowanych przez stowarzyszenie pozwala być zawsze na bieżąco z trendami branży.
  • Uniwersalne kompetencje inżyniera – zdobycie solidnej wiedzy z zakresu otwartych standardów GitOps gwarantuje wysoką pozycję na rynku pracy.
GitHub Skills: Interaktywne kursy Gita; obok Pro Git Book, docsów ArgoCD/Flux/Tekton/IaC oraz Kyverno/OPA/Falco i Chaos Mesh/Litmus.
materiały

Slajd z materiałami dodatkowymi to rozszerzona lista źródeł, z której warto korzystać, gdy zechcecie pogłębić wiedzę poza ramy wykładu. Wszystkie linki zostały zweryfikowane - działają, są aktualne, autorytatywne, prowadzą po HTTPS-ie i nie zwracają błędów 404 ani pętli przekierowań. Lista obejmuje cztery grupy: literatura o Gicie i GitOps, dokumentacja ArgoCD, Fluxa i Tektona, materiały o Terraformie, Ansible, Docker Compose i Kubernetesie oraz sekcję bezpieczeństwa, polityk, obserwowalności i chaos engineeringu. Na końcu znajdziecie też skrótowy słownik terminów i zweryfikowane adresy - wszystko w jednym miejscu, aktualizowane co semestr.

Grupa Git i GitOps: Pro Git Book (książka referencyjna o samym Gicie), GitHub Skills (interaktywne kursy), dokumentacja GitLab, tutoriale Atlassiana oraz specyfikacja OpenGitOps (opengitops.io) - tam znajdziecie kanoniczne definicje czterech zasad GitOps. Grupa ArgoCD/Flux/Tekton to przede wszystkim oficjalne dokumentacje: ArgoCD (instalacja, konfiguracja, aplikacje, projekty, RBAC, powiadomienia, HA, troubleshooting), Flux (bootstrap, komponenty, kustomize, helm, źródła, odbiorcy), Tekton (pipelines, tasks, triggers, chains, hub, operator), a obok nich Argo Rollouts (strategie, analiza, sterowanie ruchem, rollback) i Flagger (canary, blue-green, analiza metryk).

Grupa narzędziowa: Terraform (terraform.io/docs - providerzy, moduły, stan, workspaces, testowanie), Ansible (docs.ansible.com - playbooki, role, moduły, collections, vault, AWX), Docker Compose (docs.docker.com/compose - plik compose, sieci, woluminy, configs, secrets, deploy) oraz Kubernetes (kubernetes.io/docs - koncepcje, zadania, samouczki, tablica, ściąga kubectl). Do kompletu Helm (charts, szablony, values, hooki, zależności, rejestr OCI) i Kustomize (kubectl kustomize, kustomize.io).

Sekcja bezpieczeństwa i chaosu: Kyverno (polityki validate/mutate/generate, CEL, JMESPath), OPA Gatekeeper (constraints, templates, audit), Falco (bezpieczeństwo wykonania, reguły), SOPS (szyfrowanie age, GPG, KMS), ExternalSecrets, SLSA (poziomy łańcucha dostaw) oraz Cosign z Sigstore (podpisywanie bez kluczy, SBOM). Do eksperymentów chaosowych Chaos Mesh i Litmus. Na zakończenie słownik terminów (SLI/SLO/SLA, error budget, burn rate, metryki Prometheusa - gauge, counter, histogram, quantile, a z GitOps: reconciliation loop, desired/actual state, drift, self-heal, prune, sync window, hooki, generatory ApplicationSet - matrix, git, cluster, list, merge) i lista zweryfikowanych adresów. To żywy dokument, który będzie aktualizowany co semestr - zapraszam do regularnego zaglądania.

Wyjaśnienie skrótów użytych na slajdzie:
CNCFCloudNative – CNCF Cloud Native Interactive Landscape – mapa projektów chmurowych CNCF; Interaktywny katalog otwartego oprogramowania wspierającego architekturę chmurową.
OpenGitOpsDocs – OpenGitOps Official Documentation – oficjalna dokumentacja OpenGitOps; Podręczniki i białe księgi definiujące międzynarodowe standardy wdrożeń deklaratywnych.
KubernetesGuides – Production Kubernetes Best Practices Guides – przewodniki dobrych praktyk Kubernetesa; Materiały referencyjne dotyczące utwardzania klastrów i optymalizacji zasobów.
SecurityPapers – Supply Chain Security Whitepapers – publikacje bezpieczeństwa łańcucha dostaw; Wytyczne agencji cyberbezpieczeństwa (NIST, ENISA) w zakresie ochrony potoków GitOps.
Blogs – Engineering Blogs and Technical Case Studies – inżynierskie studia przypadków; Praktyczne artykuły architektoniczne opisujące wdrożenia GitOps w globalnych firmach technologicznych.
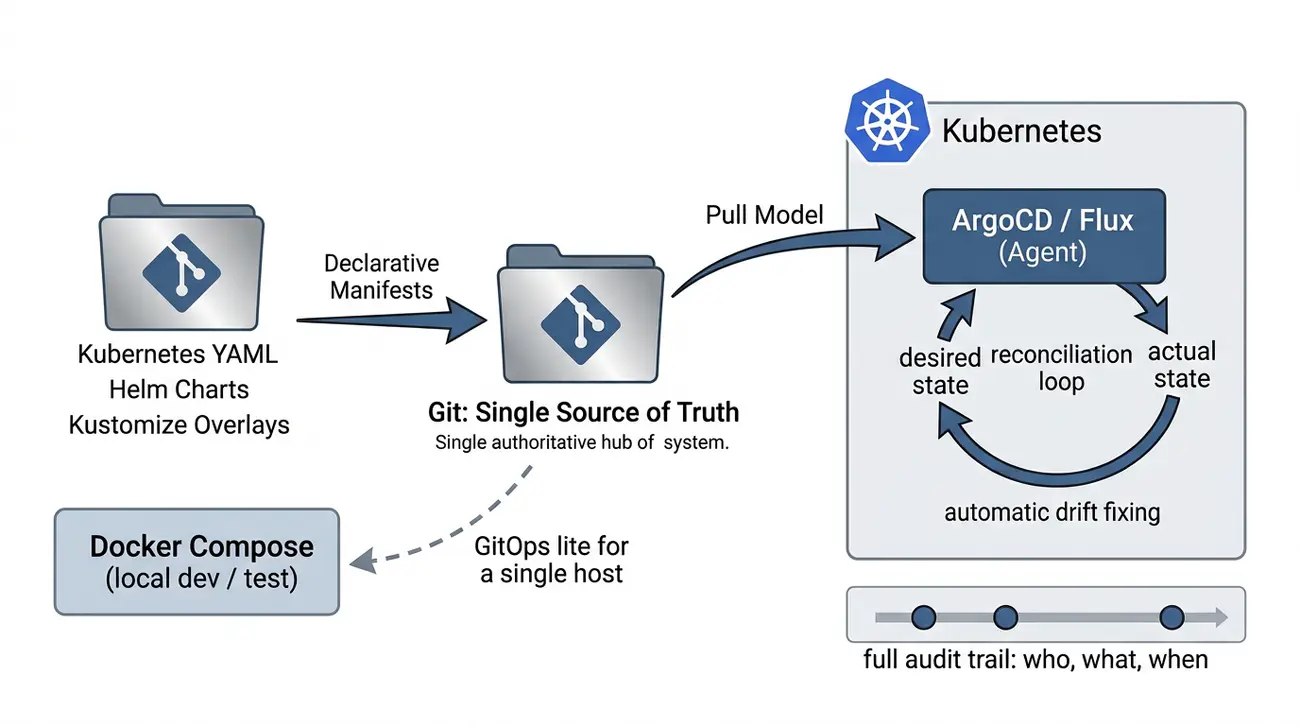
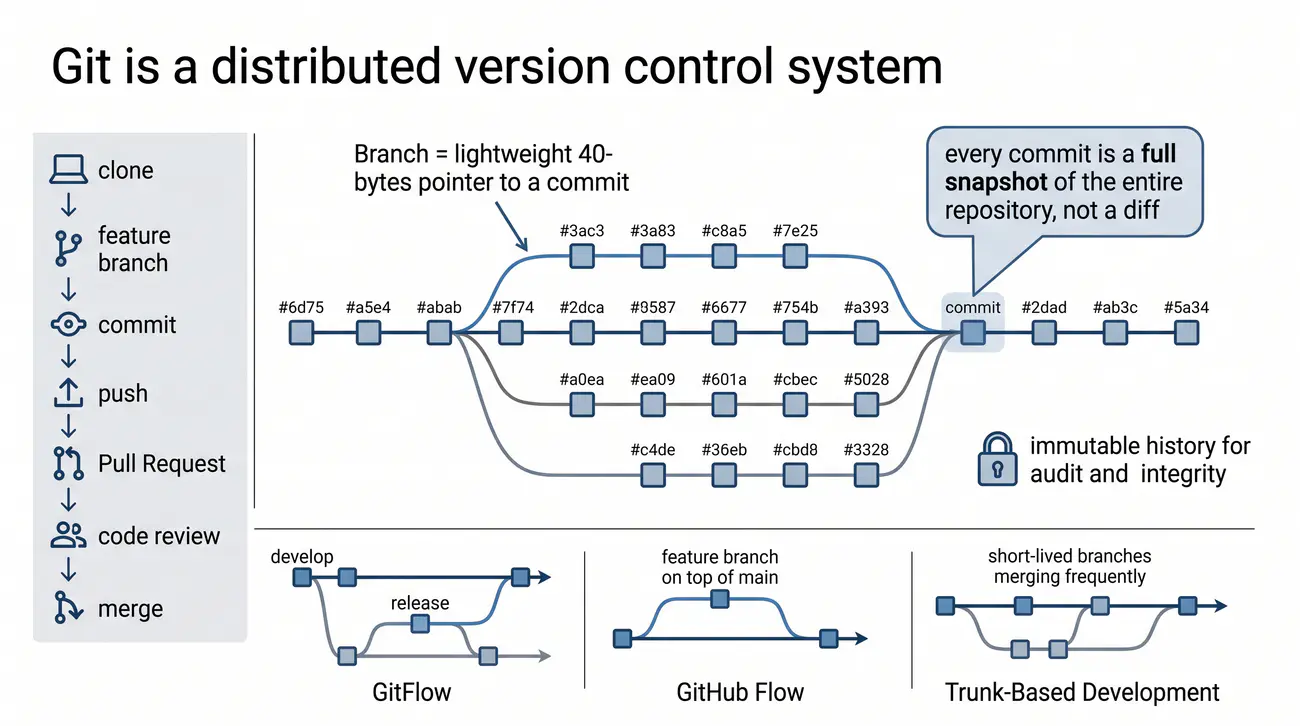
55/55 Zakończenie
Zakończenie wykładu 7: Dziękuję za uwagę. Kolejny wykład: 8: Incydenty, Post-mortem. Zapraszam do samodzielnej pracy i ćwiczeń praktycznych z GitOps. Powodzenia!

GitOps spina kurs: od pomiaru po dostarczanie. Za tydzień incydenty - ostatni moduł i pełny cykl SRE.

  • Podziękowanie za uczestnictwo – dziękujemy za uwagę i aktywny udział w wykładzie poświęconym paradygmatowi GitOps i automatyzacji wdrożeń.
  • Zapowiedź modułu incydentów – na kolejnych zajęciach przejdziemy do zagadnień reagowania na awarie, koordynacji prac i analiz post-mortem.
  • Warsztat laboratoryjny – zachęcamy do uruchomienia własnego klastra z operatorem ArgoCD i przetestowania automatycznej synchronizacji w praktyce.
  • Wsparcie i dyskusja seminaryjna – w razie pytań zapraszamy do zadawania pytań na forum grupy studenckiej oraz podczas konsultacji dydaktycznych.
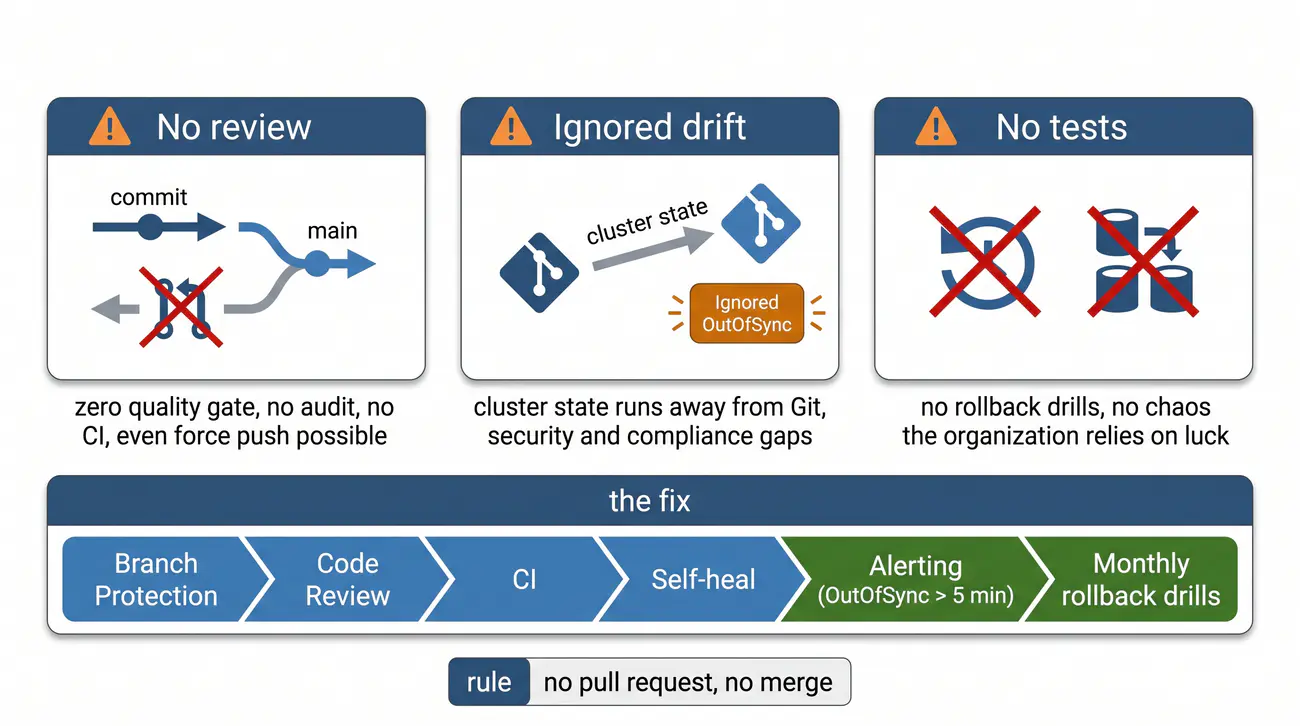
  • Praktyka czyni mistrza – pamiętajmy, że najlepszą drogą do opanowania technologii jest eksperymentowanie: twórzcie kod i automatyzujcie świat!
Domknięcie całości: GitOps spina moduły kursu (pomiar → obserwowalność → dostarczanie); dalej wykład 8: Incydenty i Post-mortem.
zakończenie

To właściwie zamknięcie łuku całego kursu, nie tylko wykładu 7 - bo GitOps, o którym dziś mówiliśmy, spina wcześniejsze moduły w jedną całość. Zanim przejdziecie do wykładu 8, warto wykonać kilka rzeczy: powtórzyć kluczowe pojęcia z tego wykładu (listę znajdziecie wcześniej), skończyć pracę własną, o ile nie została ukończona podczas zajęć, i zajrzeć do materiałów dodatkowych, o ile któreś hasło zostało niejasne. Nic z tego nie jest obowiązkowe w sensie „muszę", ale każde z tych działań realnie skraca drogę do swobodnego posługiwania się GitOps w praktyce.

Wykład wyrósł z praktyki SRE, a nie z samej literatury - dlatego bardzo zachęcam do kontaktu: pytajcie o to, co niejasne, zarówno na wykładzie, jak i w kanałach kursu. Jeśli coś było dla Was niezrozumiałe, to sygnał, że akurat o tym trzeba mówić więcej - takie uwagi traktuję jako cenny materiał do poprawy kolejnych edycji. Mile widziane są też własne przykłady z praktyki: case studies pokazane przez studentów wzbogacają wszystkich. Kontakt i szczegóły znajdziecie na stronie kursu oraz na platformie, na której oddawane są prace domowe.

Szybkie przypomnienie mapy całego cyklu: (1) wprowadzenie do SRE i utrzymania - toil, automatyzacja, etyka; (2) monitoring i metryki - SLI/SLO/SLA, Prometheus, PromQL; (3) wizualizacja i analiza trendów - Grafana; (4) logi i diagnostyka - Loki, korelacja zdarzeń; (5) wysoka dostępność - HA, failover, skalowanie; (6) alerting i powiadamianie - Alertmanager, dyżury, alerting oparty o SLO; (7) GitOps, czyli ten wykład - wdrożenia „jak z Git". Każdy moduł to osobna cegła; dopiero wszystkie razem tworzą coś, co można nazwać systemem nerwowym nowoczesnego SRE - od pomiaru, przez obserwowalność, po bezpieczne i powtarzalne dostarczanie zmian.

Wykład 8 zatytułowany „Incydenty, Post-mortem” domyka cały cykl i jest poświęcony metodyce postępowania w trakcie awarii. Poruszymy zarządzanie incydentem od strony praktycznej: rolę koordynatora incydentu (Incident Commander), komunikację operacyjną oraz prowadzenie stron statusowych. Omówimy kulturę analizy post-mortem bez obwiniania (blameless post-mortem), analizę przyczyn źródłowych (RCA) oraz formułowanie działań naprawczych. Dowiecie się, jak metodycznie zarządzać przebiegiem awarii, wyciągać wnioski systemowe zamiast doraźnego reagowania na usterki oraz jak łączyć historię zmian w repozytorium Git z logami i metrykami w spójną oś czasu incydentu. Jako lekturę wprowadzającą polecamy rozdziały „Incident Response” oraz „Postmortem Culture” z oficjalnego podręcznika Google SRE.
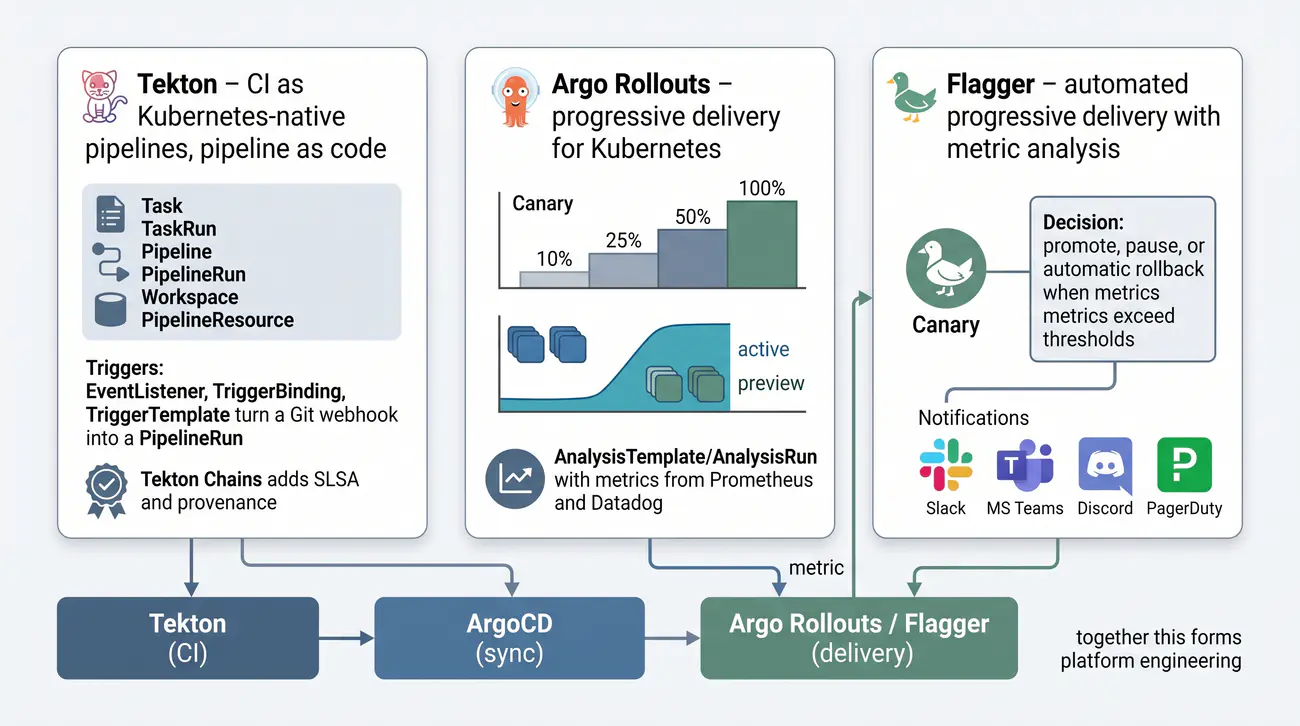
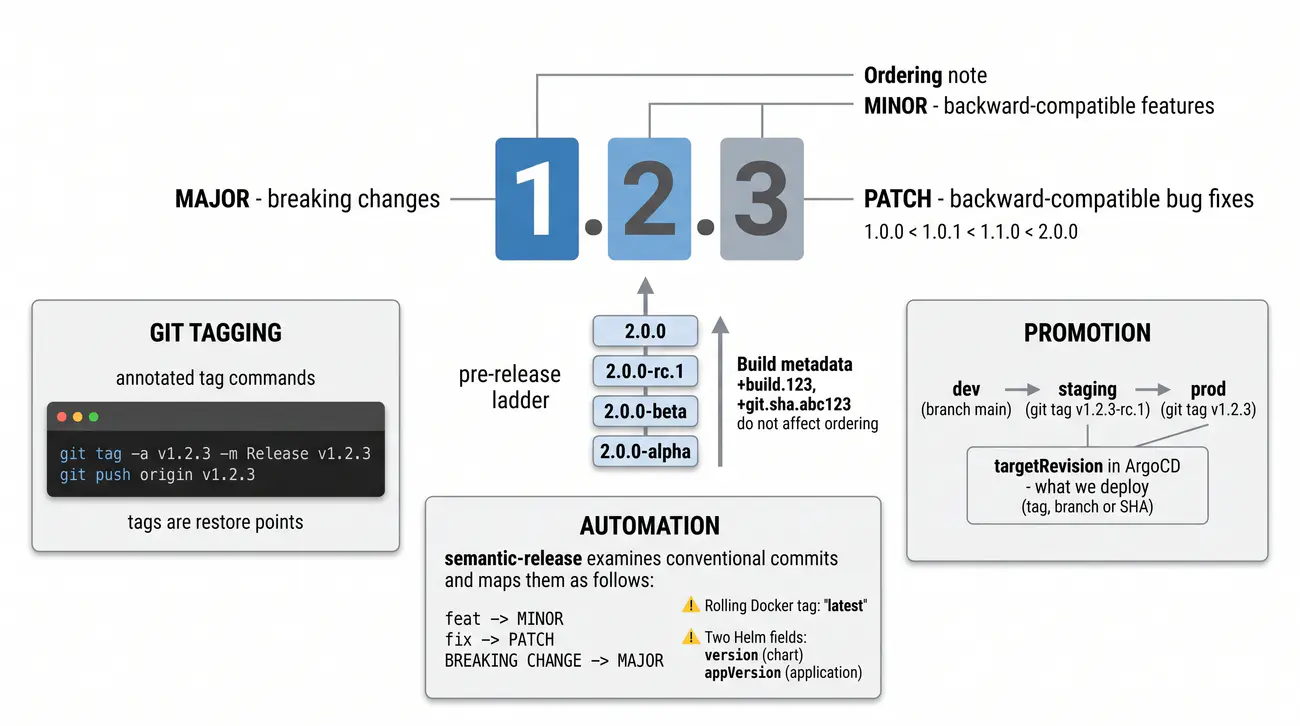
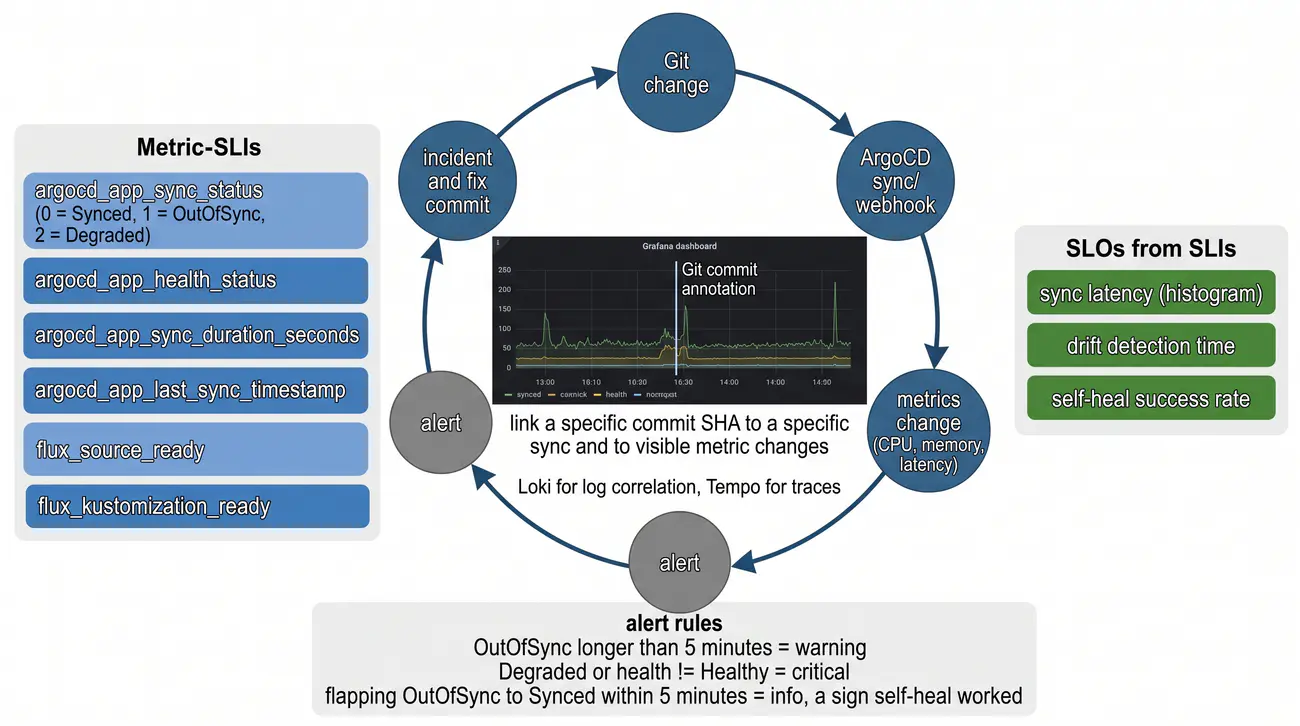
Na koniec jedna zachęta: GitOps to nie teoria do zapamiętania, ale umiejętność budowana przez wielokrotne powtórzenie. Załóż własne repozytorium, zautomatyzuj wdrożenie, celowo coś zepsuń i wykonaj rollback - właśnie tak te rzeczy osiadają na dobre. Nie zrażajcie się pierwszymi trudnościami z ochroną gałęzi, sekretami czy politykami synchronizacji - błędy to informacja, a każdy błąd na własnym labie to jedna lekcja mniej do odrobienia w produkcji. Po wykładzie 8 zamkniecie pełny cykl i będziecie mieć komplet metodologii SRE przydatnej w pracy zawodowej. Życzę owocnej nauki i do zobaczenia na wykładzie 8!

Wyjaśnienie skrótów użytych na slajdzie:
SRECourse – Site Reliability Engineering Academic Curriculum – program akademicki SRE; Zakończenie modułu siódmego i podsumowanie drogi ku pełnej automatyzacji infrastruktury.
IncidentResponse – Incident Response Next Module – moduł reagowania na incydenty; Zapowiedź finałowego wykładu poświęconego procedurom kryzysowym i kulturze organizacyjnej.
PostMortemNext – Post-mortem Analysis Preview – zapowiedź analizy poawaryjnej; Praktyka wyciągania konstruktywnych wniosków z incydentów produkcyjnych w wykładzie 8.
ContinuousLearning – Continuous Learning Culture – kultura ciągłego uczenia się; Zasada nieustannego doskonalenia rzemiosła inżynierskiego w dynamicznym świecie technologii IT.
GitOpsMastery – GitOps Operational Mastery – mistrzostwo operacyjne w modelu GitOps; Praktyczna umiejętność budowania stabilnych, skalowalnych i bezpiecznych usług cyfrowych.