1/55 Monitorowanie zdrowia usług
Pomiar - fundament SRE: „nie poprawisz tego, czego nie mierzysz". Prometheus = standardowy system monitoringu (pull model, PromQL, TSDB).

Monitorowanie to fundament SRE: bez pomiaru nie zarządzisz jakością. Zaczynamy od metryk i Prometheusa.

  • Fundament obserwowalności – metryki telemetryczne, logi zdarzeń oraz ślady wykonania stanowią podstawę wyliczania wskaźników jakości i celów SLO.
  • Metodyki analityczne (USE i RED) – metodyka USE bada wysycenie zasobów sprzętowych, natomiast RED analizuje parametry ruchu aplikacji.
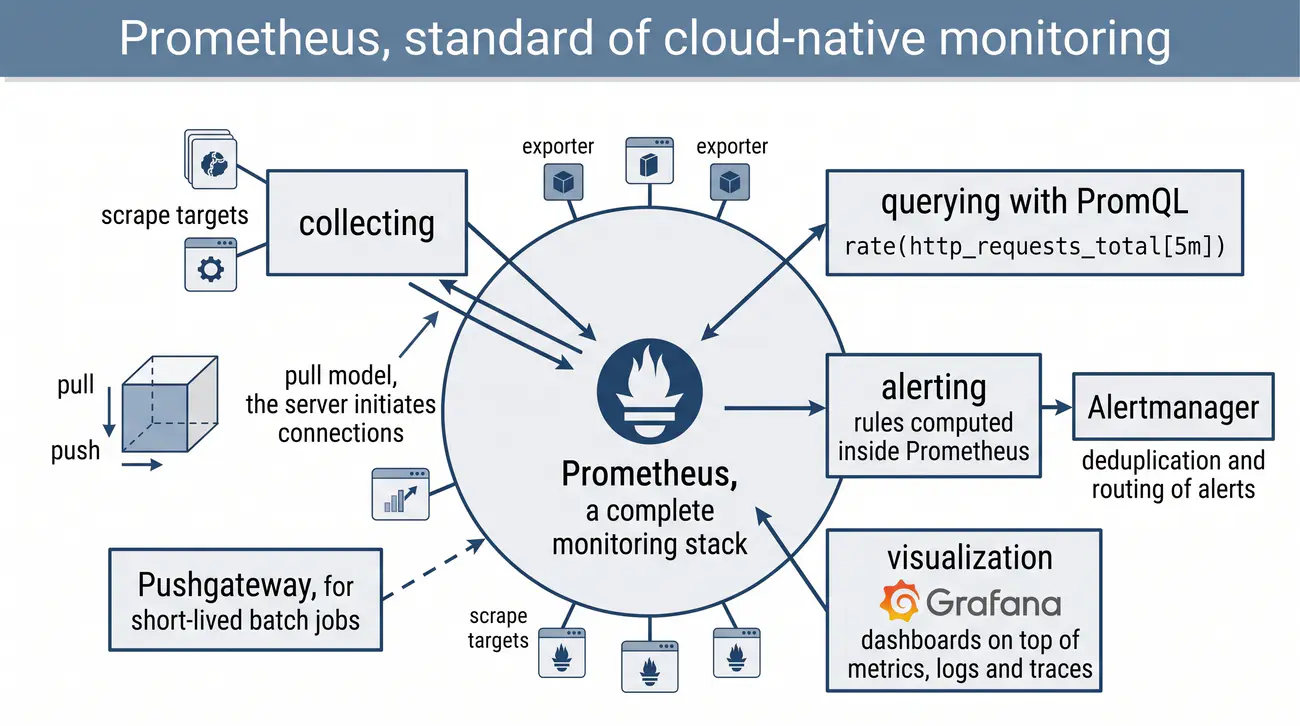
  • Ekosystem Prometheus – standard monitoringu chmurowego oparty na modelu odpytywania (pull), własnym języku PromQL oraz bazie szeregów TSDB.
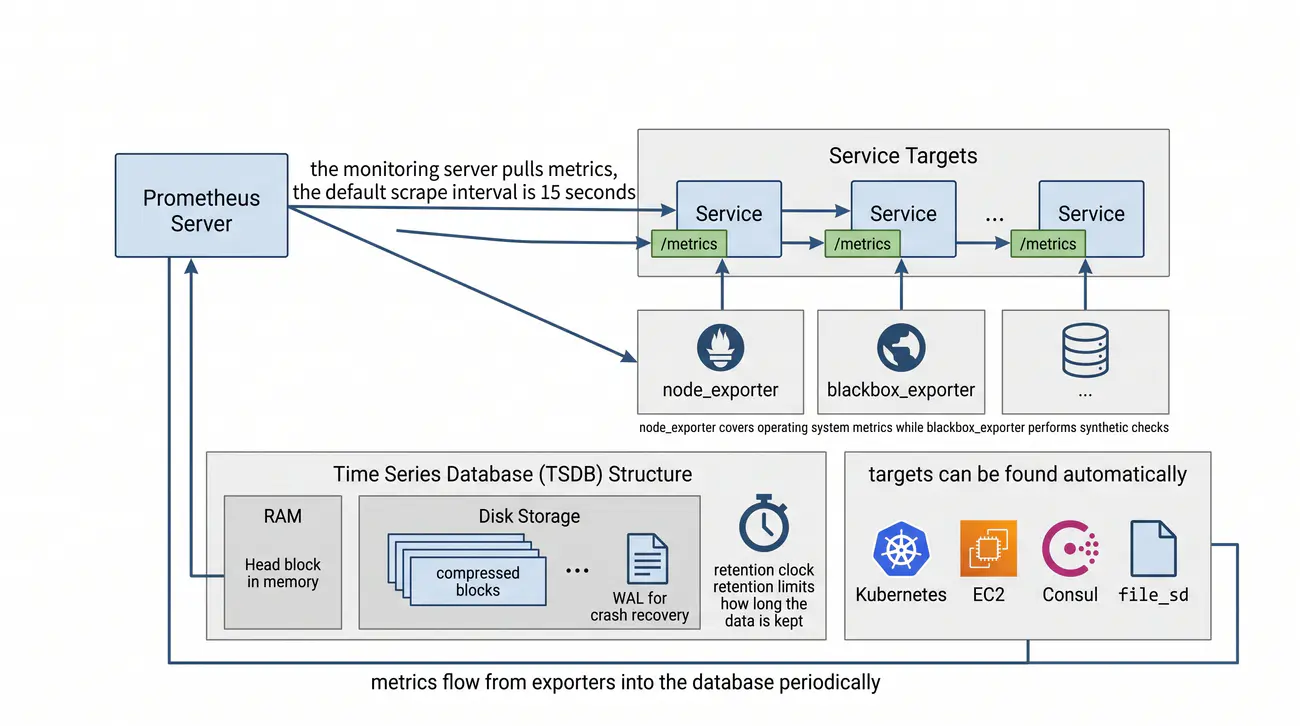
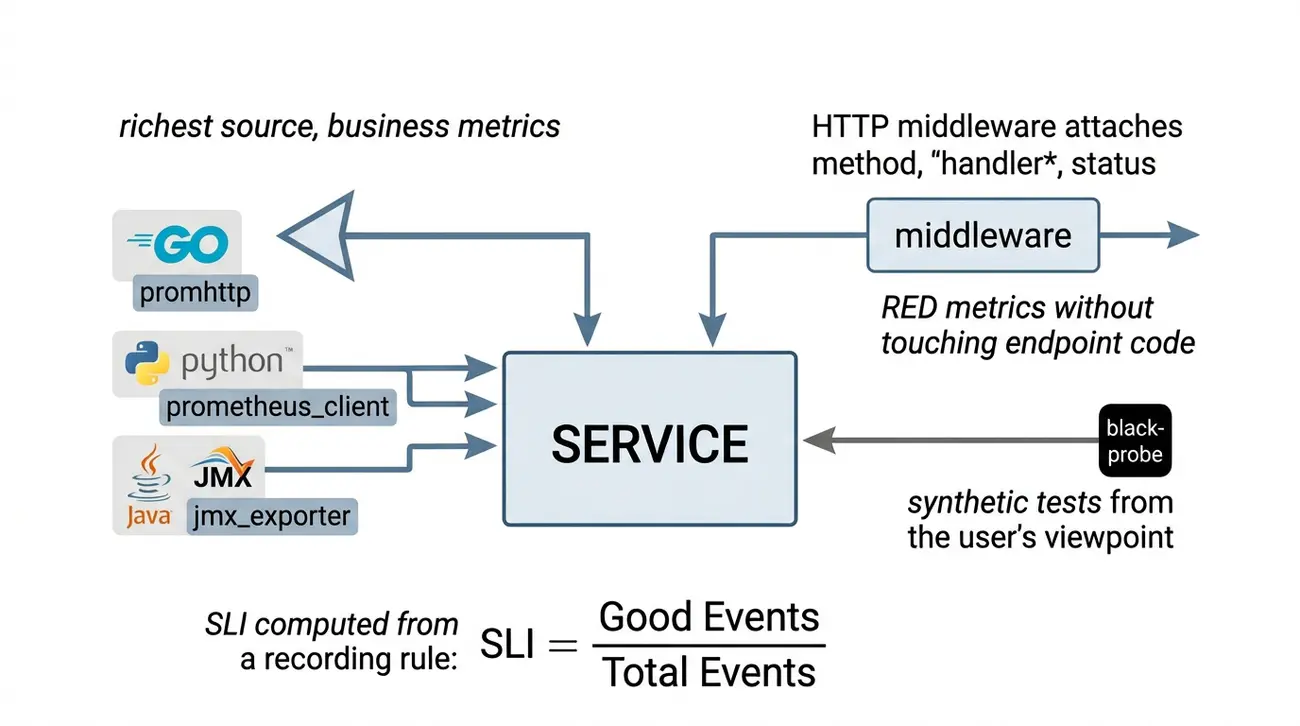
  • Architektura bezagentowa – usługi wystawiają metryki tekstowe pod adresem /metrics, skąd serwer monitoringu pobiera je w regularnych interwałach.
  • Rola w inżynierii SRE – bez precyzyjnych pomiarów liczbowych niemożliwe jest obiektywne zarządzanie ryzykiem i budżetem błędów na produkcji.
Prometheus: Standardowy system monitoringu działający w modelu pull (sam pyta targety o metryki), z językiem zapytań PromQL i własną bazą szeregów czasowych (TSDB).
ekran monitorowania

Podstawowym silnikiem zbierania metryk telemetrycznych w modelu SRE jest Prometheus.

Monitorowanie to fundament inżynierii niezawodności: bez systematycznego pomiaru (observability, SLI, SLO, error budget z wykładu 1) nie da się zarządzać jakością usługi, a dwie kluczowe metodyki doboru metryk to USE dla zasobów infrastruktury i RED dla usług aplikacyjnych. Prometheus jest standardowym systemem zbierania i przechowywania metryk w ekosystemie Cloud Native, a bez mierzenia nie ma inżynierii - tylko zgadywanie.

Związek z wykładem 1 (observability): Observability to zdolność do zrozumienia stanu wewnętrznego systemu na podstawie jego wyjść zewnętrznych. Trzy filary - metryki, logi, tracing - tworzą kompletny obraz. Metryki są "oczami" systemu: bez nich nie da się zdefiniować SLI (Service Level Indicator), ustalić SLO (Service Level Objective) ani obliczyć error budget. Wykład 1 dał ramy kulturowe i procesowe; ten wykład dostarcza narzędzi i metod, by te ramy wypełnić danymi.

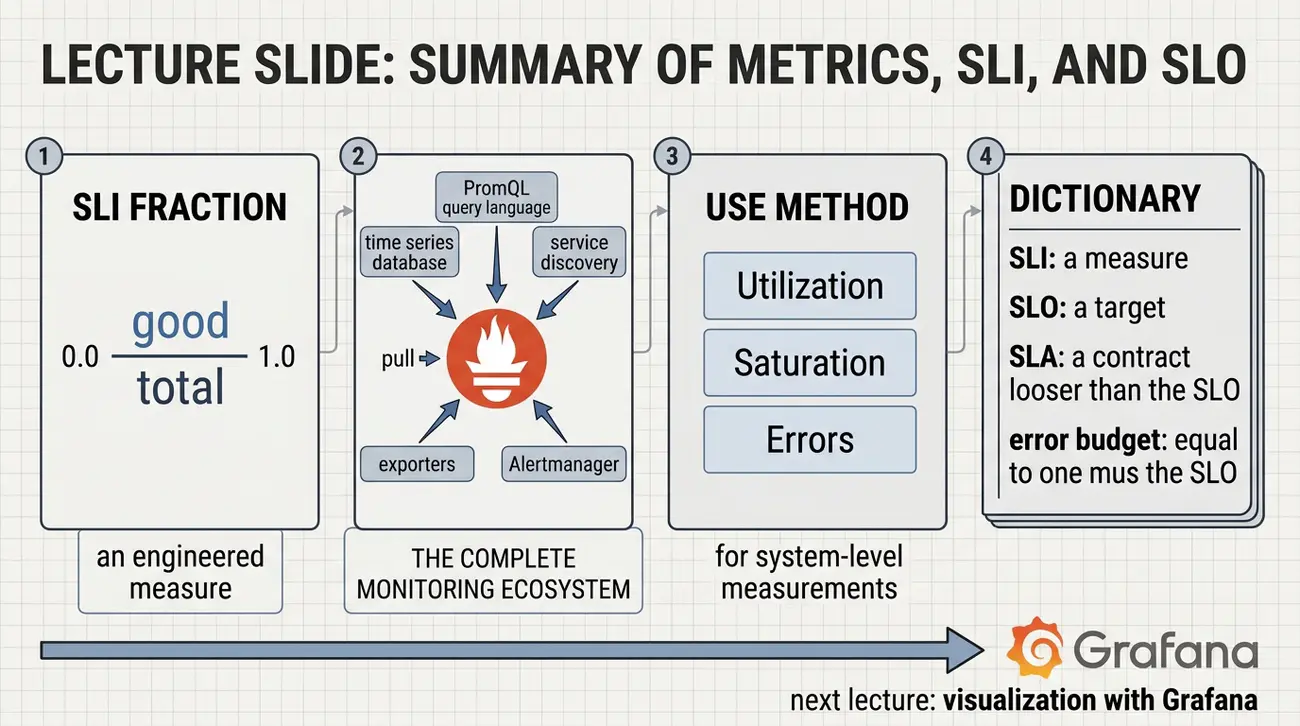
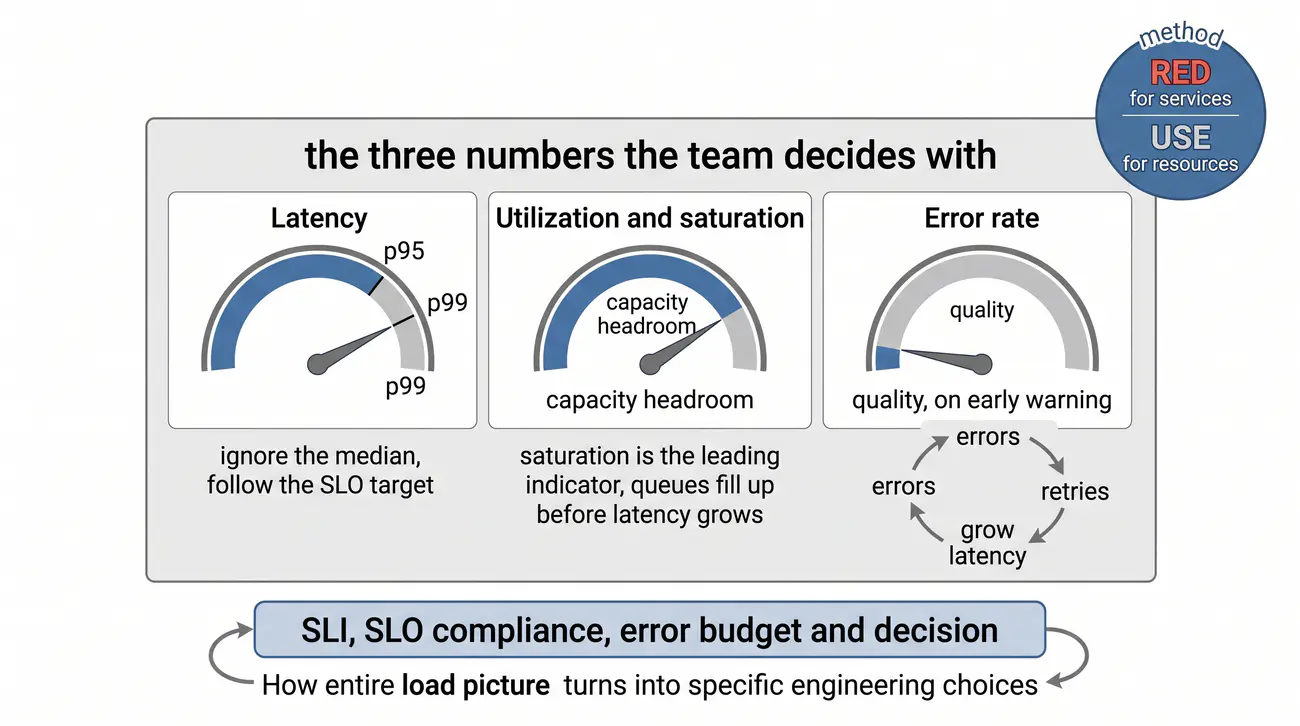
Zdefiniowanie metryk zdrowia systemu: Dobór metryk nie jest dowolny. USE method (Brendan Gregg) kieruje nas przy zasobach: Utilization (jak mocno zasób jest używany), Saturation (jak blisko limitu), Errors (liczba błędów). RED method (Tom Wilkie) dotyczy usług: Rate (przepływ żądań), Errors (wskaźnik błędów), Duration (latencja). SLI (Service Level Indicator) to agregat - pojedyncza liczba 0.0-1.0, która syntetyzuje zdrowie usługi z wielu surowych metryk.

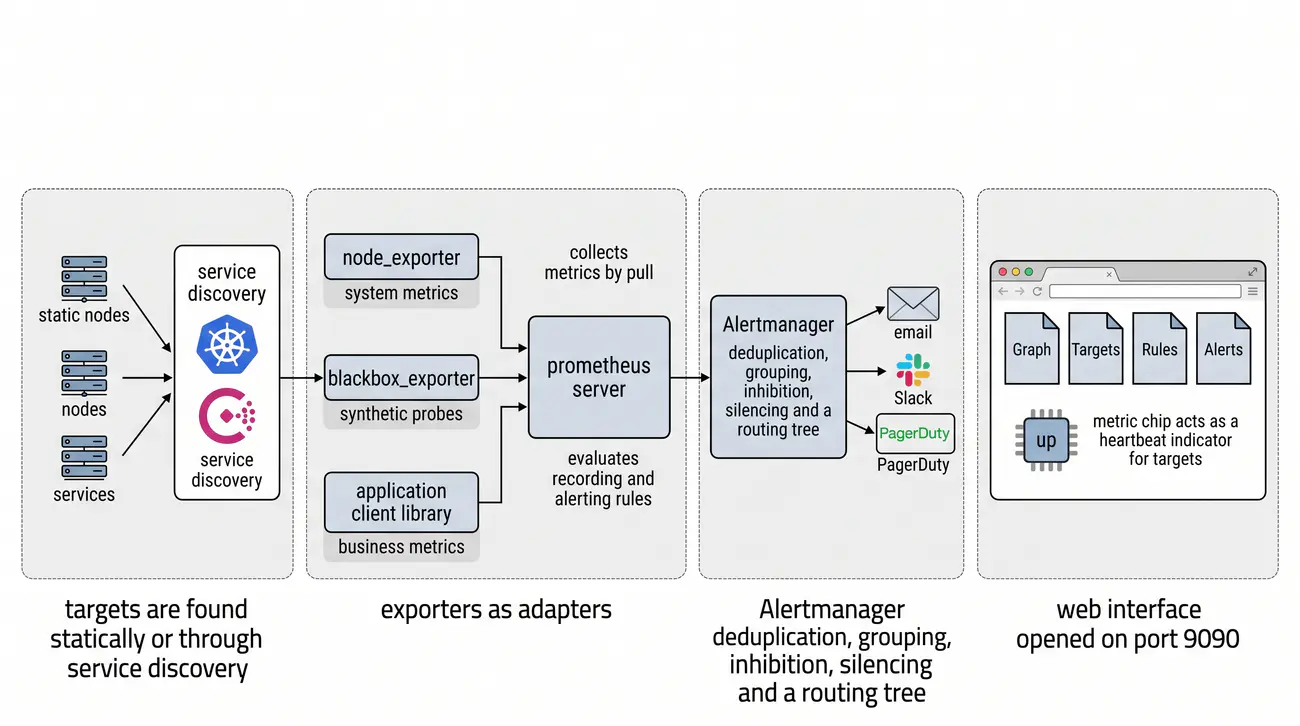
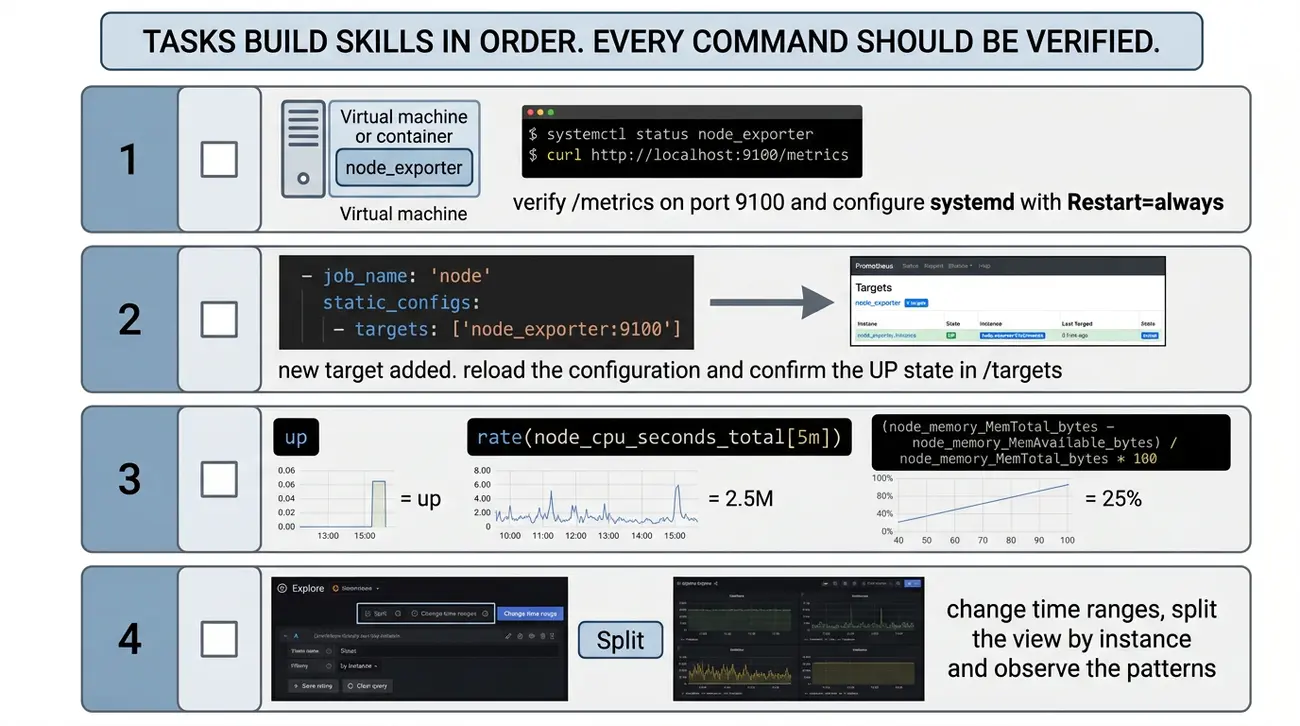
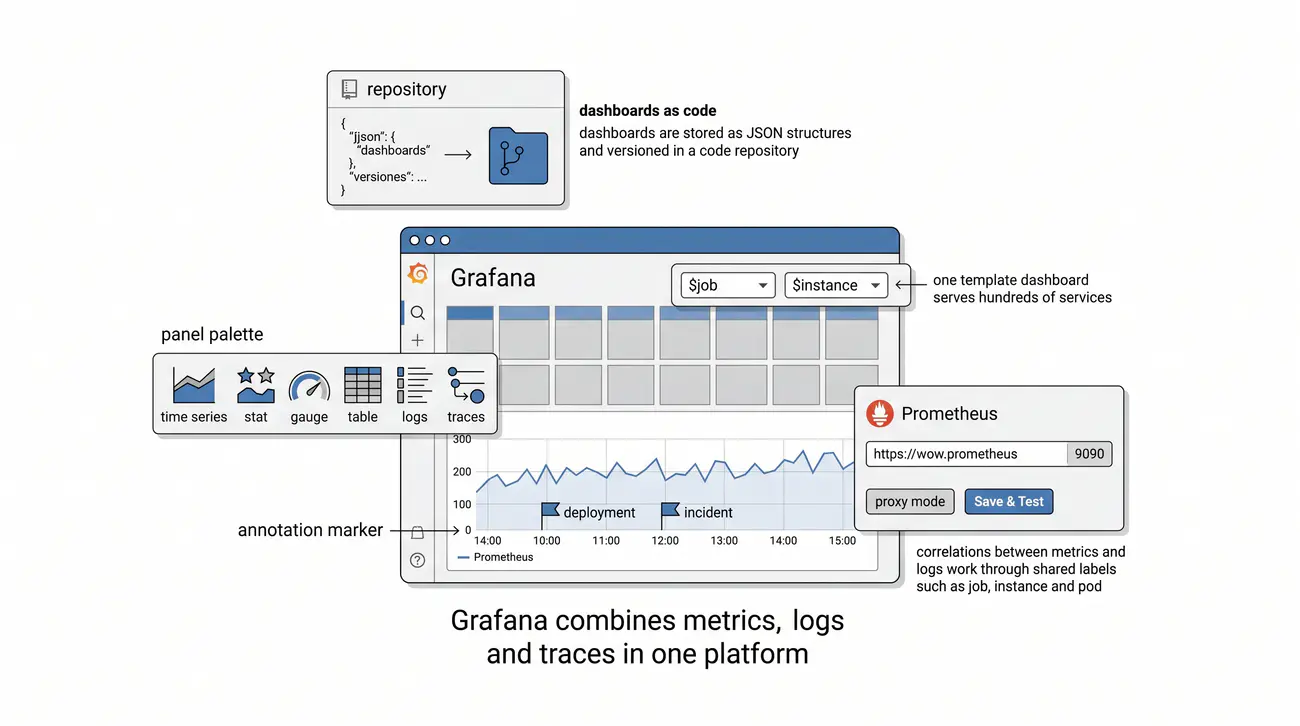
Wprowadzenie do Prometheus: Prometheus to system monitorowania i alertowania open-source, projekt CNCF, standard de facto w ekosystemie Kubernetes. Kluczowe cechy: pull model (serwer sam pyta targety o metryki), wielowymiarowy model danych z etykietami (labels), język zapytań PromQL, wbudowana baza szeregów czasowych (TSDB), service discovery (automatyczne wykrywanie targetów), ekosystem eksportów (node_exporter, blackbox_exporter, itd.). Integracja z Grafana (wizualizacja) i Alertmanager (alertowanie) tworzy kompletny stack.

Rola pomiaru w SRE: Przysłowie "You can't improve what you don't measure" (Nie możesz poprawić czego nie mierisz) to esencja SRE. Metryki napędzają decyzje: automatyczne skalowanie (HPA/VPA), alertowanie (proaktywne wykrywanie problemów), capacity planning (planowanie pojemności na podstawie trendów), weryfikacja wdrożeń (canary analysis - czy nowa wersja psuje metryki?). Bez metryk zespół operacyjny działa w oparciu o intuicję i zgadywanie, co przy skali prowadzi do awarii i wypalenia. Mierzenie zmienia operacje z reaktywnego gaśnienia pożarów w proaktywną inżynierię.

Zaczynamy od tematu, który stoi u podstaw całej inżynierii niezawodności - monitorowania. Bez systematycznego pomiaru nie da się zarządzać jakością usługi: nie sprawdzisz, czy usługa spełnia obiecane cele, czy zbliża się do granic swojej pojemności i czy opublikowana przed chwilą wersja nie pogorszyła czegoś użytkownikom. Pomiar to fundament, na którym opierają się takie pojęcia jak SLI, SLO i budżet błędów, więc zanim sięgniemy po narzędzia, ustalimy najpierw, co tak właściwie chcielibyśmy zmierzyć.

Na tym wykładzie zajmiemy się metrykami, czyli liczbowym obrazem tego, co dzieje się w systemie, a naszym głównym narzędziem będzie Prometheus - powszechnie przyjęty standard monitoringu w środowiskach Cloud Native. Przeanalizujemy, jak buduje się wskaźniki dostępności, jak ujmuje się je w cele SLO i wreszcie jak zbierać je i przechowywać w praktyce. Wszystkie te elementy złożą się w kompletny obraz tego, czym tak naprawdę jest monitorowanie zdrowia usług.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina inżynierska stosująca podejście programistyczne do zarządzania infrastrukturą i operacjami.
SLI – Service Level Indicator – wskaźnik poziomu usług; Bezpośrednia, mierzalna wartość liczbowa określająca bieżącą jakość usługi w czasie rzeczywistym.
SLO – Service Level Objective – cel poziomu usług; Wewnętrzny, docelowy próg jakościowy wskaźnika SLI uzgodniony z zespołem produktowym.
TSDB – Time Series Database – baza danych szeregów czasowych; Zoptymalizowany system bazodanowy przeznaczony do składowania i szybkiej agregacji danych indeksowanych czasem.
RED – Rate, Errors, Duration – metoda RED (częstotliwość, błędy, czas); Metodyka doboru metryk telemetrycznych dedykowana do monitorowania usług aplikacyjnych i architektur mikroserwisowych.
USE – Utilization, Saturation, Errors – metoda USE (utylizacja, nasycenie, błędy); Metodyka analizy wydajności opracowana przez Brendana Gregga, zorientowana na zasoby sprzętowe i systemowe.

2/55 Co to znaczy zdrowie usługi
Zdrowie usługi - nie stan binarny (up/down), ale spektrum jakościowe: latencja, błędy, ruch, nasycenie. Metody: USE (zasoby), RED (usługi).

Kod 200 nie znaczy, że usługa zdrowa. Zdrowie to spektrum: latencja, błędy, ruch i nasycenie.

  • Pozorna poprawność kodu HTTP 200 – kod sukcesu nie gwarantuje sprawności usługi, gdyż może maskować błędy logiczne i zablokowane zapytania do bazy.
  • Wielowymiarowa ocena zdrowia – pełny obraz systemu wymaga równoległego badania czasu odpowiedzi, odsetka błędów, natężenia ruchu oraz zasobów.
  • Obiektywizacja dyskusji o awarii – precyzyjny pomiar percentyli eliminuje subiektywne spory, dostarczając twardych dowodów na degradację usługi.
  • Wskaźniki wczesnego ostrzegania – gwałtowny wzrost zużycia pamięci lub kolejki wątków pozwala na interwencję, zanim system ulegnie paraliżowi.
  • Zależności między komponentami – usterka w warstwie bazy danych objawia się wzrostem czasu oczekiwania w warstwie aplikacji internetowej.
Metody USE i RED: USE opisuje zasoby (wykorzystanie, nasycenie, błędy), a RED opisuje usługi (tempo żądań, błędy, czas odpowiedzi); zdrowie usługi to spektrum jakościowe, nie stan binarny.
parametry zdrowia usługi

Dlaczego HTTP 200 nie gwarantuje sprawności usługi: Kod odpowiedzi HTTP 200 informuje jedynie, że serwer WWW zdołał odebrać żądanie i odesłać poprawnie sformatowany dokument. Nie oznacza to jednak, że aplikacja wykonała zadanie poprawnie. Przykładowo, serwer może zwrócić kod 200 z komunikatem „Błąd połączenia z bazą danych” lub z pustą stroną. Ponadto, jeśli wygenerowanie odpowiedzi trwało 15 sekund z powodu wyczerpania puli połączeń, dla zniecierpliwionego użytkownika usługa pozostaje bezużyteczna. W inżynierii SRE badanie samego kodu HTTP musi być zawsze powiązane z pomiarem czasu odpowiedzi (latencji) oraz weryfikacją poprawności biznesowej.

Kod odpowiedzi HTTP 200 nie stanowi wyłącznego dowodu sprawności usługi, gdyż może maskować błędy logiczne, wyczerpanie puli połączeń do bazy oraz drastyczny wzrost czasu odpowiedzi. Pełną ocenę kondycji systemu zapewnia korelacja kodów stanu protokołu aplikacyjnego z parametrami nasycenia zasobów i opóźnień.

"Zdrowa usługa" to nie stan binarny (up/down), lecz spektrum jakościowe mierzalne parametrami: opóźnieniem, błędem, obciążeniem i nasyceniem. Proste sprawdzenie "czy działa" (HTTP 200) bywa groźnie mylące, bo nie oddaje różnicy między subiektywnym odczuciem użytkownika a obiektywnymi danymi telemetrycznymi; bez obiektywnych wskaźników (SLI) nie da się zarządzać niezawodnością inżynieryjnie.

Brak symptomów awarii to za mało: Usługa może zwracać kod HTTP 200 (OK), ale działać z poważną degradacją - np. percentyl 99 (p99) latencji wynosi 10 sekund, zdarzają się błędy logiczne (złe dane w odpowiedzi), pula połączeń do bazy jest wyczerpana (resource exhaustion). Taką usługę nazywa się "zombie service" - pozornie żyje, ale nie realizuje swojej funkcji biznesowej. Taki stan jest widoczny tylko przez metryki (latencja, error rate, saturation), a nie proste health checki binarne.

Parametry zdrowia usługi: Cztery kluczowe wymiary. Latency (opóźnienie) - percentyle p50 (mediana, typowy użytkownik), p95 (95% żądań szybszych), p99 (tail latency, najgorsze 1%); to bezpośrednio przekłada się na user experience. Errors (błędy) - wskaźnik HTTP 5xx, exception rate w kodzie aplikacji, business error rate (np. płatność odrzucona przez bramkę). Traffic (ruch) - RPS (requests per second), liczba połączeń współbieżnych; pokazuje obciążenie i pozwala planować skalowanie. Saturation (nasycenie) - zużycie CPU, RAM, dysku, sieci, puli połączeń w procentach; wskazuje, jak blisko jesteśmy limitu pojemności.

Subiektywne odczucie użytkownika a liczby: Użytkownik raportuje "wolno" lub "nie działa" - to subiektywne, trudne do zweryfikowania i porównania między zespołami. Metryki dają twarde dane: p95 wzrosło z 100 ms na 500 ms w ostatniej godzinie; error rate skoczył z 0.1% na 2%. Liczby eliminują dyskusje "u mnie działa" w sporach cross-team (dev vs ops vs product) i pozwalają na obiektywną triage incydenta. To podstawa evidence-based operations.

Potrzeba obiektywnych wskaźników (SLI): Powyższe parametry są surowymi metrykami. SLI (Service Level Indicator) to ich agregacja do jednej liczby z zakresu 0.0-1.0, np. availability SLI = udane żądania / wszystkie żądania; latency SLI = żądania szybsze niż 200 ms / wszystkie żądania. Pojedynczy KPI (Key Performance Indicator) ułatwia: definicję celów (SLO), budżet błędów (error budget), alertowanie (burn rate), raportowanie biznesowi. Bez SLI nie ma SLO, bez SLO nie ma error budget - cała piramida SRE upada.

Terminologia: service health (zdrowie usługi), health check (sprawdzanie zdrowia), SLI (Service Level Indicator), SLO (Service Level Objective), RED method (Rate, Errors, Duration), USE method (Utilization, Saturation, Errors), leading indicators (wskaźniki wiodące, np. saturation) vs lagging indicators (wskaźniki opóźnione, np. downtime).

Wiele osób myśli o usłudze w kategoriach „działa albo nie działa". Prawda jest jednak bardziej złożona: usługa może zwracać poprawny kod odpowiedzi HTTP i mimo to znajdować się w poważnym kryzysie - odpowiadać wolno, generować błędy logiczne albo dyskretnie wyczerpywać swoje zasoby. Z punktu widzenia użytkownika takie pozornie działające usługi bywają praktycznie bezużyteczne. Dlatego zdrowia usługi nie traktujemy jako stanu binarnego, lecz jako spektrum jakościowe, które trzeba zmierzyć w kilku wymiarach: latencji, błędach, ruchu i nasyceniu zasobów.

Te cztery wymiary to punkt wyjścia dla doboru właściwych metryk. Robimy to metodami USE i RED - pierwsza skupia się na zasobach infrastruktury, druga na doświadczeniu usługi aplikacyjnej. Surowe metryki, które dzięki nim zbierzemy, będą później agregowane do wskaźników SLI, stanowiących podstawę celów SLO i budżetu błędów.

Wyjaśnienie skrótów użytych na slajdzie:
HTTP – Hypertext Transfer Protocol – protokół przesyłania dokumentów hipertekstowych; Podstawowy protokół komunikacyjny warstwy aplikacji w architekturach sieciowych i internetowych.
API – Application Programming Interface – interfejs programowania aplikacji; Zestaw reguł i specyfikacji umożliwiający bezpośrednią komunikację i wymianę danych między modułami oprogramowania.
CPU – Central Processing Unit – główna jednostka obliczeniowa; Procesor komputera odpowiadający za wykonywanie instrukcji programowych i logiki systemowej.
RAM – Random Access Memory – pamięć o dostępie swobodnym; Podstawowa pamięć operacyjna służąca do przechowywania bieżących danych i kodu uruchomionych procesów.
I/O – Input/Output – wejście/wyjście; Operacje wymiany danych pomiędzy procesorem a urządzeniami peryferyjnymi, pamięcią masową lub siecią.

3/55 Dlaczego mierzymy
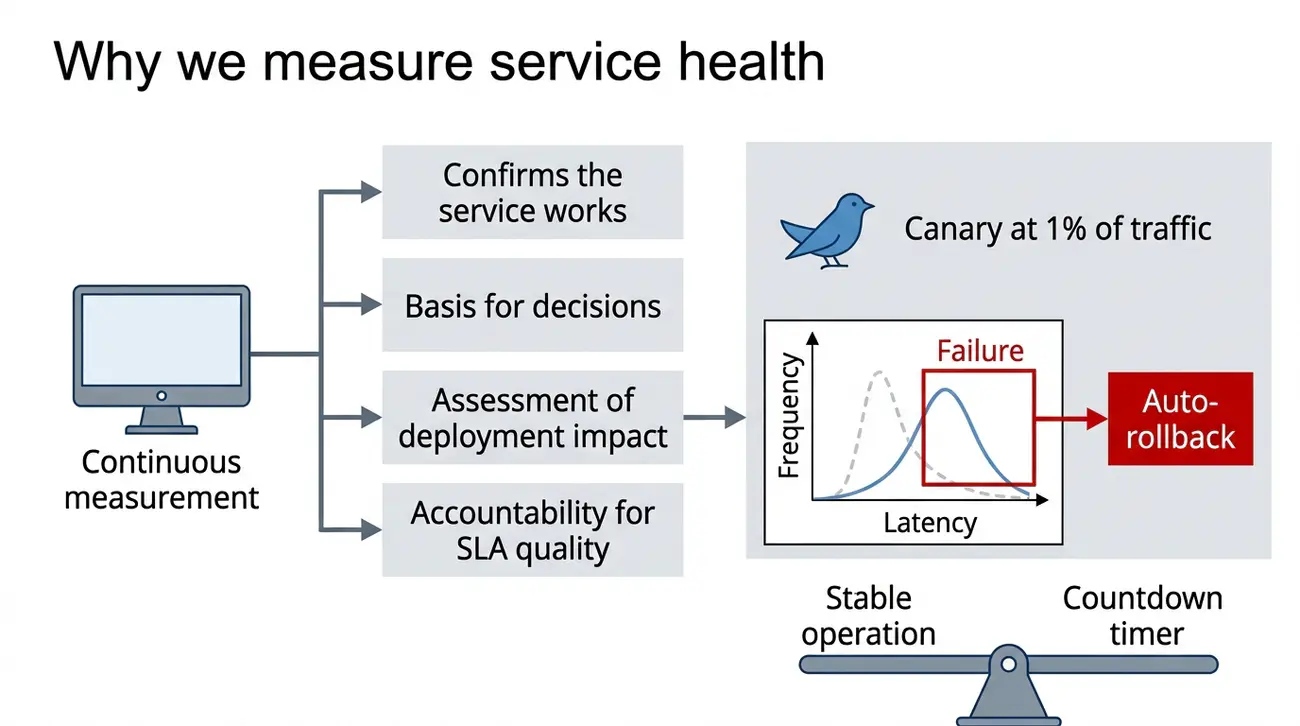
Dlaczego mierzymy: potwierdzenie działania, podstawa decyzji, ocena wdrożeń (canary analysis), rozliczanie jakości (SLA).

Mierzymy nie dla samego mierzenia, lecz dla decyzji: czy działa, czy zmiana pomogła i czy klient dostaje jakość.

  • Pomiary jakościowe a binarne – samo stwierdzenie, że serwer działa, nie wystarcza; kluczowa jest jakość i czas dostarczenia odpowiedzi użytkownikowi.
  • Weryfikacja wdrożeń produkcyjnych – porównanie metryk przed publikacją nowej wersji kodu i po niej pozwala natychmiast wykryć wprowadzone regresje.
  • Punkt odniesienia (baseline) – wyznaczenie typowego profilu obciążenia pozwala automatycznym algorytmom odróżnić cykliczny szczyt od usterki.
  • Bezpieczne wdrożenia stopniowe – skierowanie części ruchu na nową wersję umożliwia zbadanie metryk przy minimalnym ryzyku dla ogółu klientów.
  • Optymalizacja wydatków na infrastrukturę – analiza trendów zużycia procesorów i pamięci pozwala racjonalnie planować zakupy sprzętu i chmury.
Canary analysis: Ocena wdrożenia przez porównanie metryk nowej wersji wypuszczonej na małą część ruchu z wersją stabilną, zanim zmiana obejmie wszystkich użytkowników.
korzyści z monitoringu

Praktyczną dekompozycję metryk zasobowych definiuje metodyka USE Brendana Gregga (Utilization, Saturation, Errors).

Pomiar nie jest celem sam w sobie, lecz narzędziem do podejmowania decyzji, zarządzania ryzykiem i budowania zaufania - dlatego w SRE mierzymy wszystko, co da się zmierzyć. Cztery filary wartości pomiaru to potwierdzenie działania usługi, baza decyzyjna przy zmianach, ocena wpływu wdrożeń i rozliczanie jakości wobec klienta/biznesu; każdy tłumaczy inny aspekt codziennej pracy inżyniera SRE.

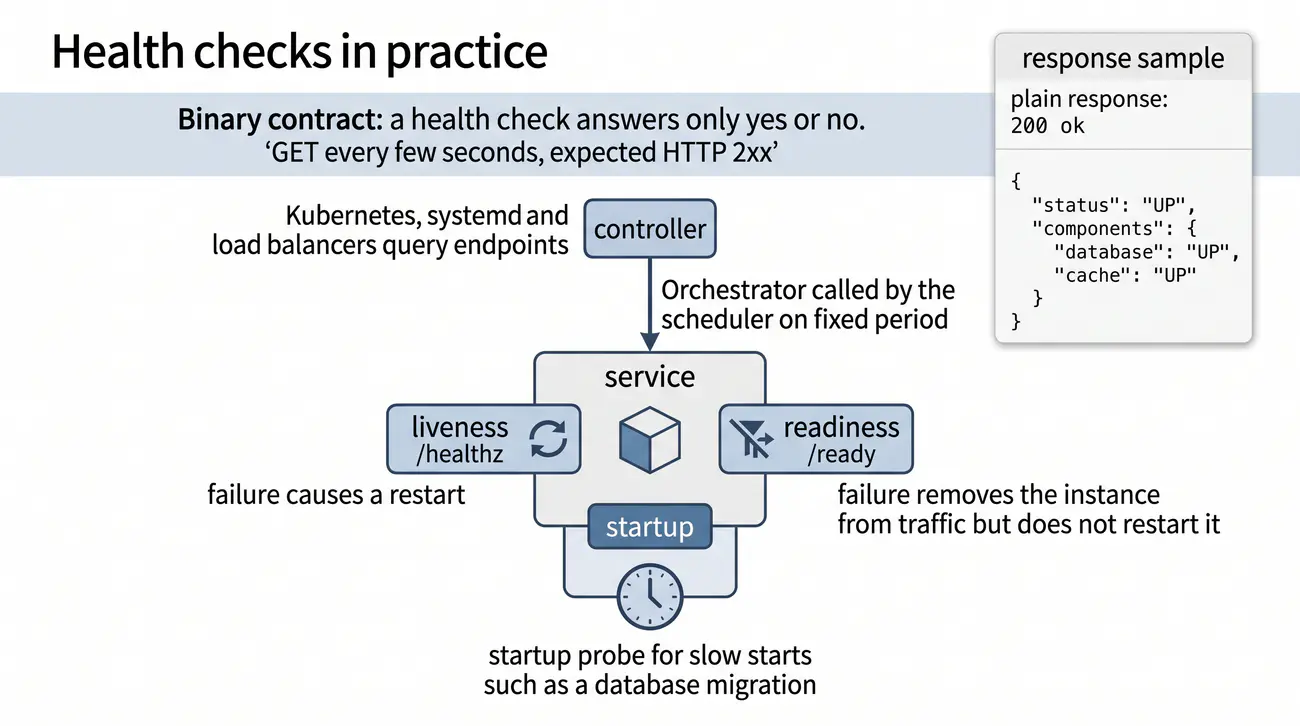
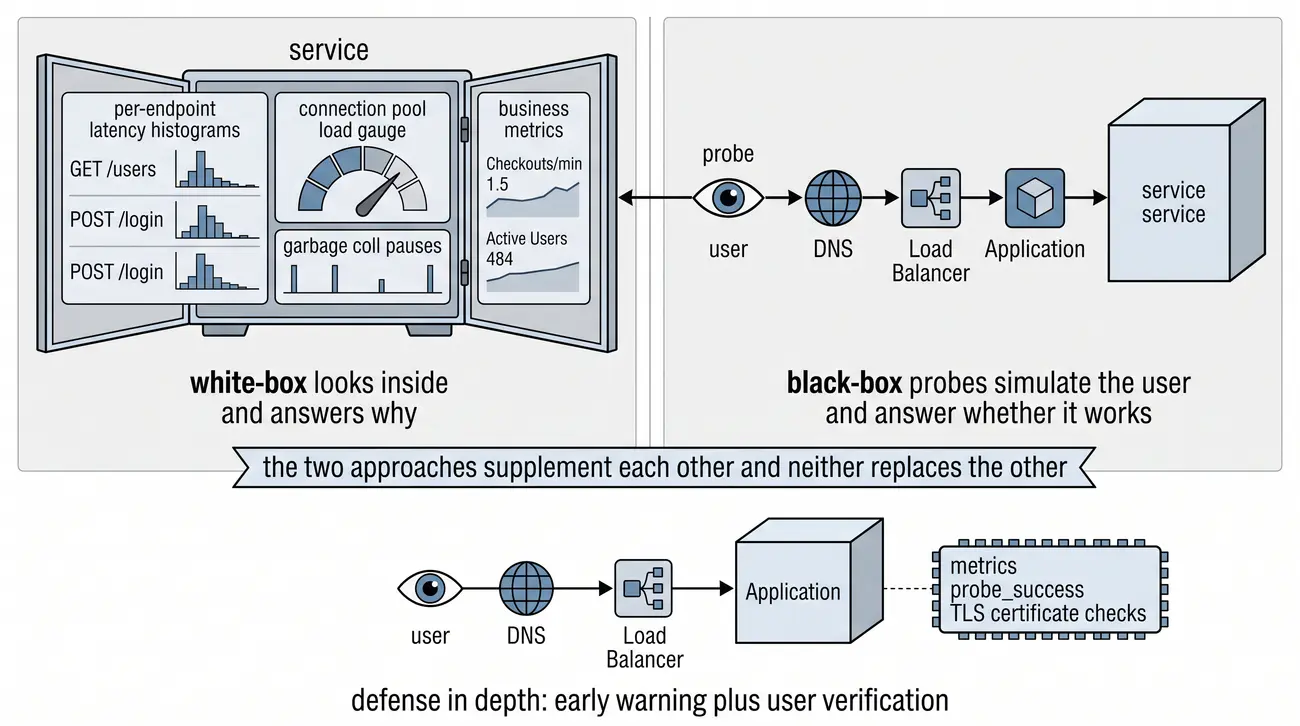
Potwierdzenie, że usługa działa: Pytanie "Czy usługa działa?" ma dwa wymiary. Binary up/down (blackbox monitoring) - syntetyczny test z zewnątrz: czy endpoint odpowiada 200 OK? To perspektywa użytkownika. Quality SLI (whitebox monitoring) - metryki wewnętrzne: jaka jest latencja, jaki error rate, czy zasoby nie są nasycone? To perspektywa inżyniera. Bez obu wymiarów nie wiemy, czy usługa faktycznie działa - mamy tylko zgadywanie. Monitoring jest warunkiem koniecznym możliwości praktyki SRE.

Podstawa decyzji o zmianach: Każda zmiana (deploy, konfiguracja, schema DB) niesie ryzyko. Metryki pozwalają podejmować data-driven decisions zamiast polegać na "czuciu" lub nadziei. Wzorzec: wdrożenie (canary/blue-green) → porównanie metryk przed i po → jeśli error rate rośnie lub latencja skacze → automatyczny rollback. To zamienia ryzyko w kontrolowaną decyzję opartą na dowodach.

Ocena wpływu wdrożeń: Baseline (linia bazowa) to "normalny" przebieg metryk przed zmianą. Nowa wersja porównujemy do baseline automatycznie (np. ArgoCD + Prometheus metrics w pipeline GitOps). Blast radius control - ograniczamy zasięg potencjalnej awarii (np. 1% ruchu na canary) i mamy gotowy plan cofnięcia. Metryki pozwalają wykryć regresję w minutach, nie godzinach.

Rozliczanie jakości (SLA): Biznes i klienci oczekują raportów: uptime report (dostępność w %), SLO compliance (czy cel został spełniony), error budget remaining (ile budżetu błędu zostało). To kontrakty oparte na liczbach, nie na obietnicach. Regularne raportowanie buduje zaufanie i umożliwia negocjacje o priorytety (nowe funkcje vs stabilność) w języku biznesu.

Terminologia: observability (obserwowalność), early warning (wczesne ostrzeżenie), baseline (linia bazowa/referencyjna), canary analysis (analiza kanarka - porównanie metryk nowej wersji z bazą), automated rollback (automatyczne cofnięcie), SLA reporting (raportowanie SLA), blast radius (promień wybuchu - zasięg awarii).

Zastanówmy się chwilę, po co właściwie mierzymy. Monitoring nie jest celem samym w sobie - jego sens tkwi w decyzjach, które dzięki niemu podejmujemy. Mierzymy po to, by potwierdzić, że usługa działa, by podejmować decyzje o zmianach w oparciu o fakty zamiast przeczuć, by ocenić wpływ każdego wdrożenia i wreszcie by rozliczać jakość wobec klienta i biznesu. Każdy z tych powodów przekłada się na konkretne mechanizmy - od porównania metryk przed i po wdrożeniu po analizę kanarkową, czyli wypuszczenie nowej wersji na niewielki procent ruchu.

Skoro mierzenie ma dostarczać argumentów do decyzji, musi też być wspólnym językiem. Kiedy zespół mówi „usługa jest wolna", to opinia; kiedy mówi „p95 wzrosło z 100 do 500 milisekund", to fakt, który można porównać z linią bazową i sprawdzić, czy regresję widać też na innych metrykach. W ten sposób pomiar zamienia operacje z doraźnego usuwania awarii w systematyczną, opartą na dowodach praktykę.

Wyjaśnienie skrótów użytych na slajdzie:
RPS – Requests Per Second – liczba żądań na sekundę; Jednostka miary przepustowości systemu określająca wolumen zapytań obsługiwanych w jednostce czasu.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; Prawnie wiążące porozumienie między usługodawcą a klientem definiujące sankcje za niedotrzymanie parametrów jakościowych.
MTTR – Mean Time To Recover – średni czas naprawy; Kluczowa metryka niezawodności określająca średni czas upływający od wykrycia awarii do pełnego przywrócenia sprawności usługi.
MTTD – Mean Time To Detect – średni czas wykrycia; Średni czas liczony od momentu zaistnienia usterki w systemie do jej zarejestrowania przez system monitoringu.
RTO – Recovery Time Objective – docelowy czas odzyskiwania; Dopuszczalny czas niedostępności systemu po awarii określony w planach ciągłości działania.

4/55 Trzy filary obserwowalności
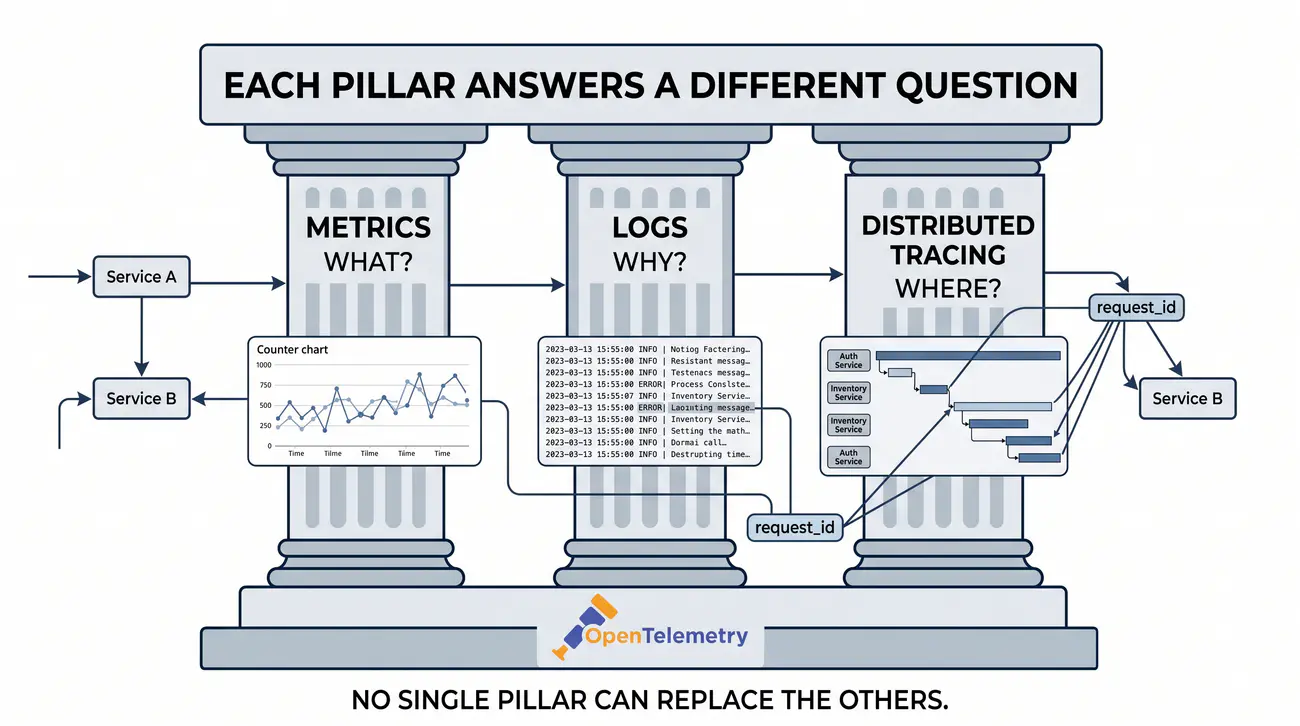
Observability - 3 filary: metryki (co się dzieje), logi (dlaczego), tracing (gdzie jest problem). Standard instrumentacji: OpenTelemetry.

Trzy filary obserwowalności odpowiadają na trzy pytania: metryki - co, logi - dlaczego, tracing - gdzie.

  • Metryki jako sygnał numeryczny – liczbowe szeregi czasowe o niskim narzucie informują, kiedy i w którym komponencie wystąpiła anomalia.
  • Logi jako rejestr zdarzeń – szczegółowe komunikaty tekstowe z identyfikatorem żądania wyjaśniają, dlaczego dana operacja zakończyła się błędem.
  • Śledzenie rozproszone (tracing) – wizualizacja przepływu zapytania przez mikroserwisy precyzyjnie lokalizuje wąskie gardła i źródła opóźnień.
  • Korelacja trzech filarów – wspólny identyfikator żądania (TraceID) łączy metryki, logi i ślady w spójną historię pojedynczego wywołania.
  • Dojrzałość obserwowalności – zintegrowany system monitoringu pozwala inżynierom przejść od wykrycia problemu do naprawy w kilka minut.
OpenTelemetry: Otwarty standard instrumentacji aplikacji, dostarczający metryki, logi i trace’e w ujednolicony sposób dla systemów obserwowalności.
diagram trzech filarów

Korelacja trzech filarów obserwowalności za pomocą TraceID: Największym wyzwaniem w monitorowaniu architektur mikroserwisowych jest powiązanie pojedynczej anomalii na wykresie metryk z konkretnym błędem w kodzie. Rozwiązaniem jest unikalny identyfikator śladu (TraceID), generowany w momencie wejścia żądania do systemu i przekazywany w nagłówkach HTTP (np. W3C Trace Context) do wszystkich podsystemów. Identyfikator ten jest automatycznie dopisywany do każdego wpisu w logach oraz powiązany z pomiarem latencji. Dzięki temu inżynier widzący na wykresie skok opóźnień może jednym kliknięciem wyświetlić pełną ścieżkę zapytania i zlokalizować przeciążony serwis.

Architektura obserwowalności opiera się na korelacji trzech komplementarnych strumieni danych telemetrycznych:
- Metryki stanowią zagregowane dane liczbowe w czasie o niskim koszcie składowania, służące do ciągłej detekcji anomalii i wyzwalania alertów,
- Logi rejestrują dyskretne zdarzenia ze szczegółowym kontekstem wykonania (identyfikator żądania, zrzut stosu błędów), niezbędne w diagnozie przyczyn awarii,
- Ślady rozproszone (tracing) mapują przepływ pojedynczego żądania przez łańcuch mikroserwisów zgodnie ze standardem OpenTelemetry.

Obserwowalność (observability) opiera się na trzech filarach: metrykach, logach i tracingu. Każdy filar odpowiada na inne pytanie diagnostyczne i ma inną kosztowość, granularność i zastosowanie - filary się nie zastępują, a razem dają pełny obraz systemu; korelację umożliwia np. request ID.

Metrics (metryki): Liczby agregowane w czasie - counters (monotoniczne liczniki, np. http_requests_total), gauges (wartości zmienne, np. memory usage), histograms (rozkłady, np. latency buckets). Są tanie w gromadzeniu i przechowywaniu, szybkie w zapytaniu, idealne do alertingu, trendowania i dashboardów. Narzędzie standardowe: Prometheus. Metryki mówią "CO się dzieje" (latency wzrosła, error rate skoczył).

Logs (logi): Szczegółowe zdarzenia tekstowe z bogatym kontekstem - request ID, stack trace, parametry wywołania, business context (user ID, order ID). Są drogie (storage, ingest), trudniejsze do agregowania, ale niezbędne do debugowania (root cause analysis), audytu i compliance. Narzędzia: Loki (Grafana), ELK/EFK Stack. Logi mówią "DLACZEGO się dzieje" (np. timeout przy zapytaniu do bazy, błąd walidacji).

Traces (śledzenie): Ścieżka requesta przez rozproszony system mikroserwisów - trace ID (wspólny identyfikator), spany (pojedyncze operacje: HTTP call, DB query, cache lookup), latencja na każdym skoku (hop). Standard: OpenTelemetry (OTel), backendy: Jaeger, Tempo. Traces mówią "GDZIE się dzieje" (w którym serwisie, na jakim skoku opóźnienie rośnie). Kluczowe przy debugowaniu rozproszonym.

Komplementarność trzech źródeł: Żaden filar nie zastępuje innych. Metryka sygnalizuje: "latency p99 wzrosła z 100ms na 2s" (CO). Logi w serwisie B pokazują: "DB query timeout po 5s, connection pool exhausted" (DLACZEGO). Trace wskazuje: "span w serwisie B, wywołanie bazy danych, 95% czasu requesta" (GDZIE). Razem = pełny obraz incydenta w sekundy, nie godziny. Korelacja przez request ID / trace ID to standard w nowoczesnych stackach (np. Grafana: metrics → logs → traces w jednym UI).

Terminologia: metrics (metryki), logs (logi), traces (śledzenie/tracing), observability pillars (filary obserwowalności), OpenTelemetry (OTel - standard instrumentacji), correlation (korelacja danych telemetrycznych), distributed tracing (rozproszone śledzenie).

Zanim przejdziemy do liczb, warto ustalić, skąd właściwie czerpiemy informacje o systemie. W inżynierii niezawodności mówimy o trzech filarach obserwowalności: metrykach, logach i tracingu. Każdy z nich odpowiada na inne pytanie - metryki mówią, co się dzieje, logi - dlaczego, a tracing - gdzie dokładnie narasta opóźnienie. Żaden z tych filarów nie zastępuje pozostałych; dopiero ich połączenie daje pełny obraz zdarzenia.

Ta komplementarność będzie przewijać się przez cały kurs. Dziś skupimy się na metrykach, ale zerkniemy też na logi i tracing, bo korelacja wszystkich trzech źródeł - na przykład po wspólnym identyfikatorze żądania - to właśnie dojrzałe podejście do obserwowalności, w którym incydent można zrozumieć w sekundy, a nie godziny.

Wyjaśnienie skrótów użytych na slajdzie:
APM – Application Performance Monitoring – monitorowanie wydajności aplikacji; Zestaw narzędzi telemetrycznych umożliwiający głęboki wgląd w czas wykonania poszczególnych funkcji kodu i zapytań bazodanowych.
ELK – Elasticsearch, Logstash, Kibana – stos technologiczny ELK; Popularny zestaw oprogramowania do centralnego gromadzenia, indeksowania i wizualizacji logów systemowych.
OTel – OpenTelemetry – standard OpenTelemetry; Projekt CNCF standaryzujący API i SDK do generowania i eksportu metryk, logów oraz śladów rozproszonych.
JSON – JavaScript Object Notation – notacja obiektowa JavaScript; Lekki, czytelny dla człowieka format wymiany danych powszechnie stosowany w logach ustrukturyzowanych.
SDK – Software Development Kit – pakiet programistyczny; Zestaw narzędzi, bibliotek i dokumentacji ułatwiający tworzenie oprogramowania integrującego się z daną platformą.

5/55 Metryki w praktyce
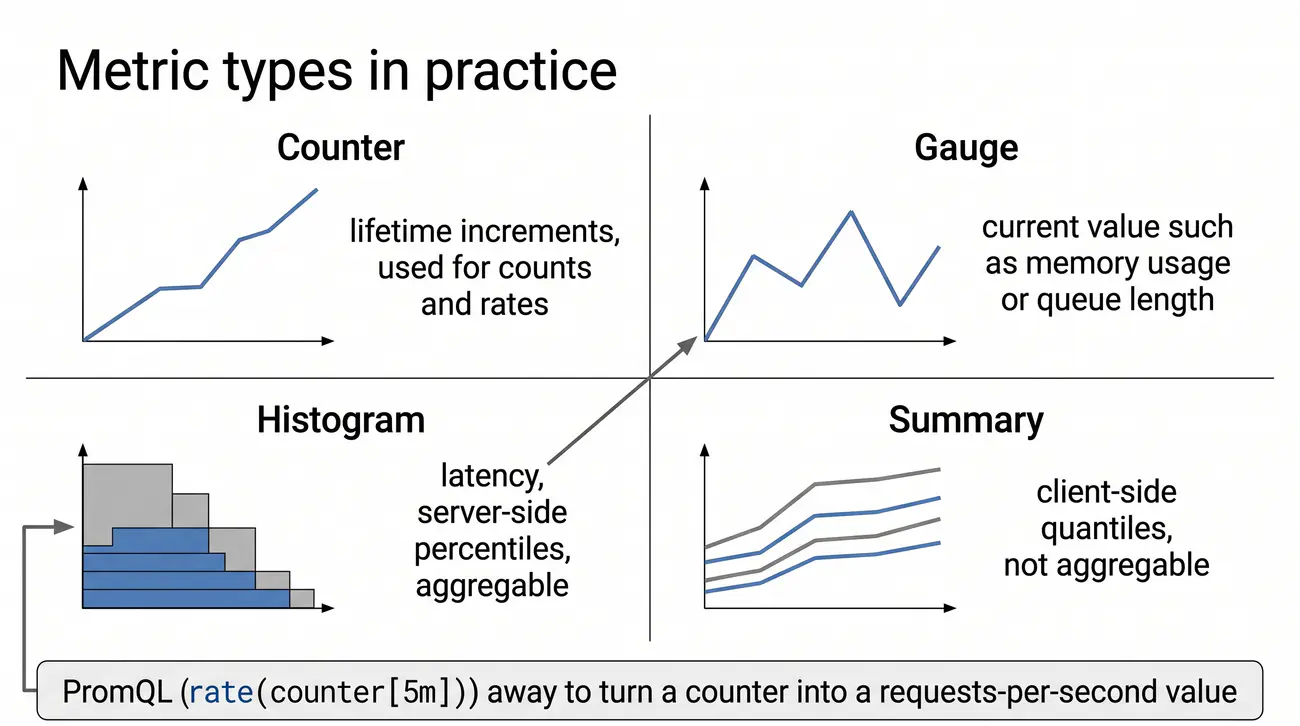
Typy metryk Prometheus: counter (monotoniczny licznik), gauge (wartość góra/dół), histogram (rozkład w bucketach), summary (kwantyle po stronie klienta).

Prometheus ma cztery typy metryk. Zły typ to złe zapytania i zepsute alerty - dobieraj świadomie.

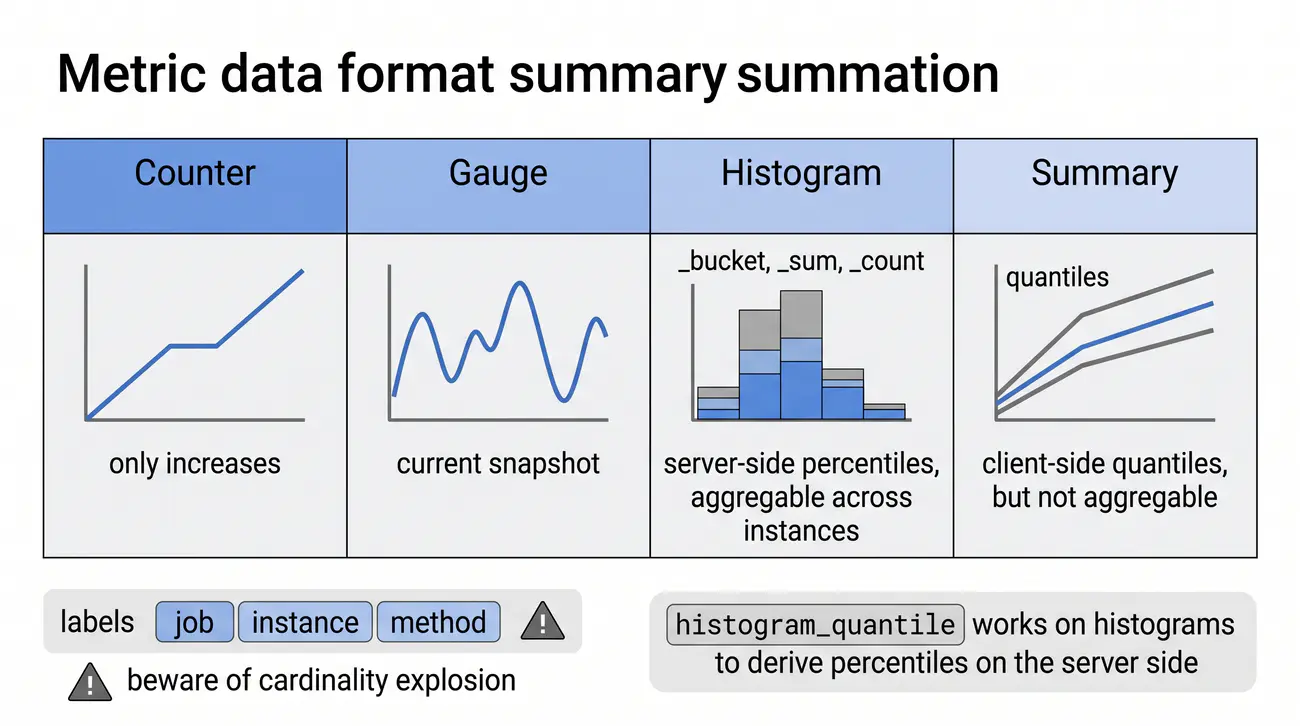
  • Licznik monotoniczny (Counter) – metryka sumaryczna, która może wyłącznie rosnąć lub ulegać resetowi; analizuje się ją funkcją rate().
  • Wskaźnik chwilowy (Gauge) – pomiar odzwierciedlający bieżący stan (np. zapełnienie dysku lub pamięci RAM), który może swobodnie rosnąć i maleć.
  • Histogram rozkładu wartości – zlicza zdarzenia w zdefiniowanych przedziałach, umożliwiając wyliczanie percentyli po stronie serwera.
  • Podsumowanie statystyczne (Summary) – oblicza kwantyle bezpośrednio w aplikacji; rozwiązanie prostsze, lecz uniemożliwiające agregację w klastrze.
  • Zasady doboru typu metryki – do zliczania błędów stosuje się Counter, do badania poziomu zasobów Gauge, a do pomiaru latencji Histogram.
Counter: Monotonicznie rosnący licznik, który nigdy nie maleje; tempo zmian liczy się funkcją rate(), a błędny typ metryki uniemożliwia poprawne zapytania.
typy metryk

Różnica między Counter i Gauge w matematyce PromQL: Podstawowy błąd początkujących polega na stosowaniu funkcji rate() do metryk typu Gauge. Licznik (Counter) z natury wyłącznie rośnie (np. sumaryczna liczba odwiedzin od restartu); funkcja rate() wylicza jego pochodną po czasie, a w razie restartu serwera samoczynnie niweluje spadek do zera. Z kolei Gauge odzwierciedla stan chwilowy (np. wolną pamięć RAM lub temperaturę dysku), który naturalnie rośnie i maleje. Zastosowanie rate() do Gauge prowadziłoby do absurdalnych wyników, gdyż algorytm uznałby każdy spadek pamięci za restart serwera. Do analizy zmian wskaźników Gauge stosuje się funkcję deriv() lub operacje uśredniające.

Prometheus oferuje cztery fundamentalne typy metryk, a ich wybór determinuje, jakie zapytania (PromQL) będzie można wykonać, czy metrykę da się agregować między instancjami i jak precyzyjne będą wyniki. Są to Counter, Gauge, Histogram i Summary - każdy z inną semantyką, dozwolonymi operacjami PromQL i typowymi zastosowaniami.

Counter (licznik): Monotonicznie rosnąca wartość - nigdy nie maleje (chyba że reset przy restarcie procesu). Przykłady: http_requests_total, node_cpu_seconds_total. Używamy `rate(counter[5m])` by uzyskać wartość na sekundę (np. RPS). Prometheus automatycznie obsługuje resety (np. po restarcie aplikacji). Stosowane wyłącznie dla liczników – wywołanie `rate(gauge)` nie zadziała. Typowe zastosowanie: liczenie żądań, błędów, bajtów przesłanych.

Gauge (miernik): Wartość, która może rosnąć i spaść - snapshot aktualnego stanu. Przykłady: node_memory_MemAvailable_bytes, go_goroutines, http_requests_in_flight. Nie stosujemy `rate()` (używamy `deriv()` dla zmiany w czasie lub po prostu samej wartości). Typowe zastosowanie: zużycie pamięci, liczba aktywnych wątków, głębokość kolejki, temperatura dysku.

Histogram (histogram): Rozkład obserwacji w wstępnie zdefiniowanych bucketach (przedziałach). Składa się z: `_bucket{le="granica"}` (liczba obserwacji ≤ granica), `_sum` (suma wszystkich wartości), `_count` (liczba obserwacji). Pozwala obliczyć percentyle po stronie serwera: `histogram_quantile(0.99, rate(bucket[5m]))` → p99 latency. Kluczowa zaleta: agregowalny cross-instance (można sumować buckety z wielu instancji). Typowe zastosowanie: latencja żądań (http_request_duration_seconds_bucket), rozmiar odpowiedzi.

Summary (podsumowanie): Podobny do histogramu, ale kwantyle (percentyle) obliczane po stronie klienta (w aplikacji) i eksportowane jako gotowe `_quantile{quantile="0.95"}`. Mniej elastyczny - nie da się agregować kwantyli z wielu instancji (matematycznie niepoprawne). Używany rzadziej, głównie w starszych bibliotekach klienta. Typowe zastosowanie: gotowe percentyle bez obliczeń w PromQL.

Przykłady doboru: Request latency → Histogram (potrzebujemy p50/p95/p99, agregowalne). Request count → Counter (monotoniczne narastanie). Memory usage → Gauge (wartość góra/dół). Queue depth → Gauge (aktualny stan). Zasada: wybór typu = funkcja metryki w systemie.

Terminologia: counter (licznik), gauge (miernik), histogram (histogram), summary (podsumowanie), bucket (przedział), le (label Upper Bound), histogram_quantile, rate(), deriv(), aggregation.

Pierwszym krokiem do dobrego monitoringu jest poprawne dobranie typu metryki. Prometheus oferuje cztery podstawowe typy - counter, gauge, histogram i summary - i choć na pierwszy rzut oka wyglądają podobnie, każdy ma inną semantykę i, co ważniejsze, inne dozwolone operacje w PromQL. Błędny wybór typu, na przykład zapisanie licznika żądań jako gauge zamiast counter, uniemożliwi obliczenie tempa zmian i rozjedzie się z alertami.

Dlatego właśnie ten wybór robimy świadomie, w zależności od tego, jaką rolę pełni metryka w systemie: latencję zapisujemy w histogramie, żeby móc liczyć percentyle, liczbę żądań w liczniku, a wartości typu zużycie pamięci czy głębokość kolejki - w mierniku. Te trzy zasady pokryją większość sytuacji, z którymi spotkacie się w praktyce.

Wyjaśnienie skrótów użytych na slajdzie:
PromQL – Prometheus Query Language – język zapytań Prometheus; Funkcyjny język zapytań dedykowany do operacji na wektorach chwilowych i zakresowych w bazie Prometheus.
CDF – Cumulative Distribution Function – dystrybuanta empiryczna; Funkcja matematyczna opisująca prawdopodobieństwo, że zmienna losowa przyjmie wartość mniejszą lub równą zadanemu progowi.
PDF – Probability Density Function – funkcja gęstości prawdopodobieństwa; Funkcja określająca rozkład prawdopodobieństwa wystąpienia określonych wartości czasu odpowiedzi w próbie telemetrycznej.
RPC – Remote Procedure Call – zdalne wywołanie procedury; Mechanizm komunikacji międzyprocesowej umożliwiający wywołanie podprogramu na zdalnym serwerze tak, jakby był lokalny.
TCP – Transmission Control Protocol – protokół sterowania transmisją; Połączeniowy protokół warstwy transportowej gwarantujący bezbłędne i uporządkowane dostarczanie pakietów danych.

6/55 Co to jest SLI
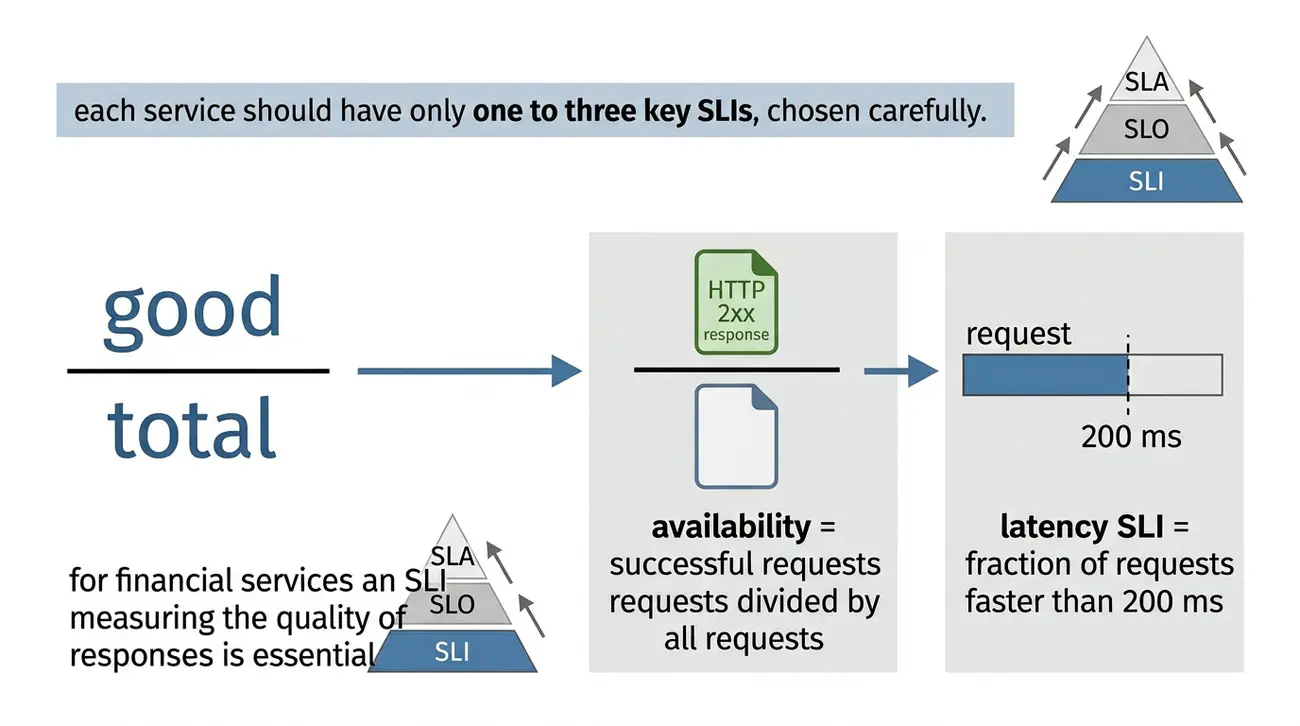
SLI (Service Level Indicator) - ułamek dobrych / wszystkich zdarzeń; zakres 0.0-1.0. Podstawa SLO i error budget.

SLI to jedna liczba 0-1: jaka część zdarzeń poszła dobrze. Fundament, na którym stoi SLO i budżet.

  • Istota wskaźnika SLI – Service Level Indicator to starannie zdefiniowany stosunek liczby zdarzeń pomyślnych do całkowitej liczby obsłużonych żądań.
  • Pomiar z perspektywy klienta – wskaźnik powinien odzwierciedlać rzeczywiste doświadczenie użytkownika, np. czas oczekiwania na załadowanie koszyka.
  • Ograniczenie liczby wskaźników – dojrzałe zespoły wybierają od jednego do trzech kluczowych SLI na usługę, unikając szumu informacyjnego.
  • SLI dla usług interaktywnych – w aplikacjach webowych podstawą pomiaru jest dostępność zapytań (kody 2xx/3xx) oraz ich akceptowalny czas.
  • SLI dla przetwarzania wsadowego – w zadaniach kolejkowych metrykami jakości są poprawność danych, brak odrzuceń oraz terminowość wykonania.
SLI: Ułamek dobrych zdarzeń do wszystkich zdarzeń (zakres 0.0-1.0); podstawa SLO i budżetu błędów, bez której nie ma czego porównywać z celem.
definicja SLI

SLI (Service Level Indicator) to nie "metryka" w ogóle, lecz konkretna, mierzalna, obliczalna liczba z zakresu 0.0-1.0, która syntetyzuje zdrowie usługi - to fundament całej piramidy SRE. Definiuje go wzór good/total (dobre/wszystkie) z trzema głównymi kategoriami SLI, dobieranymi pod typ usługi; to od SLI napędzają się SLO i error budget, a bez jego zrozumienia nie da się budować SLO.

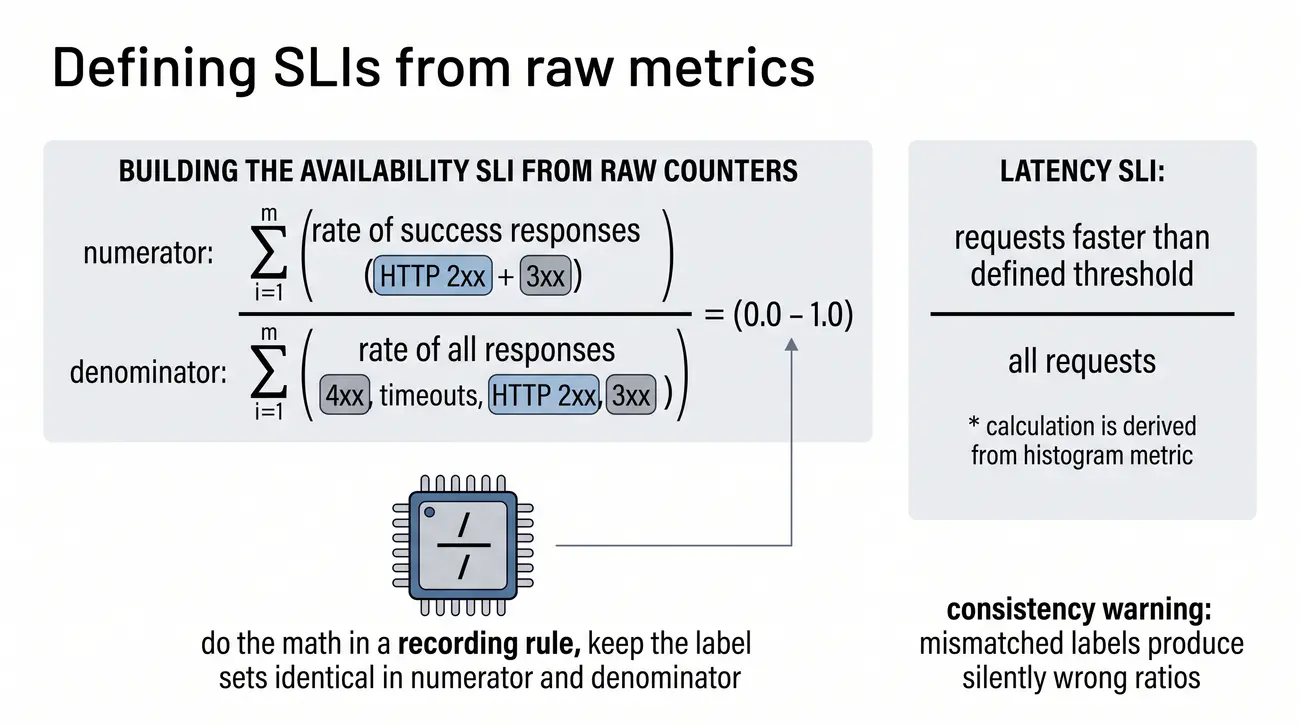
Definicja SLI: SLI (Service Level Indicator) to konkretna mierzalna metryka stanu usługi, wyrażona jako ułamek: dobre zdarzenia / wszystkie zdarzenia. Wynik zawsze w przedziale 0.0-1.0 (lub 0%-100%). Przykład availability SLI: `http_requests_total{status=~"2.."} / http_requests_total` - licznik sukcesów (kody 2xx) podzielony przez licznik wszystkich żądań. To nie jest surowa metryka (np. cpu_usage), lecz metryka celowo skonstruowana (engineered metric) tak, by odzwierciedlać doświadczenie użytkownika.

Przykłady SLI - trzy kategorie: Availability SLI (dostępność) = successful requests / total requests (np. HTTP 2xx/3xx / wszystkie). Latency SLI (opóźnienie) = requests faster than threshold / total requests (np. latency < 200ms / wszystkie). Quality SLI (jakość) = valid responses / total responses (np. poprawne dane wg schematu / wszystkie odpowiedzi). Każdy typ usługi ma inne priorytety SLI.

Wybór właściwych SLI dla usługi: Nie ma uniwersalnego zestawu. User-facing services (frontend, API gateway) → Availability + Latency (użytkownik czuje przerwę i wolność). Batch/async jobs (ETL, report generation) → Correctness (poprawność wyników) + Throughput (przepustowość). Internal APIs → Error rate + Latency. Zasada: nie można mieć wszystkiego - zbyt wiele SLI rozmywa fokus i utrudnia alertowanie. Wybierz 1-3 kluczowe SLI na usługę.

SLI jako podstawa SLO: SLO (Service Level Objective) to cel postawiony na SLI - np. "availability SLI ≥ 0.999 (99.9%) w oknie 30 dni rolling". Bez SLI nie ma czego mierzyć względem celu (SLO). Bez SLO nie ma error budget (budżetu błędu = 1 - SLO). Hierarchia jest sztywna: SLI (miara) → SLO (cel na mierze) → SLA (umowa z klientem oparta na SLO z buforem). Cała operacyjna waluta SRE (error budget, burn rate, release freeze) wywodzi się z SLI.

Terminologia: Service Level Indicator (SLI), good/total ratio (iloraz dobrych do wszystkich), availability SLI, latency SLI, quality SLI, RED method (Rate, Errors, Duration - metoda doboru metryk usług).

Wracamy teraz do pojęcia, które jest sercem strategii niezawodności - SLI, czyli wskaźnika poziomu usługi. To coś więcej niż zwykła metryka: pojedyncza liczba z przedziału od zera do jednego, która mówi, jaką część zdarzeń obsłużyliśmy dobrze. Liczymy ją jako ułamek dobrych zdarzeń do wszystkich zdarzeń - na przykład udanych żądań do wszystkich żądań albo odpowiedzi szybszych niż ustalony próg do wszystkich odpowiedzi.

To dlatego SLI jest fundamentem całej piramidy: bez niego nie mamy czego porównywać z celem SLO, a bez SLO nie ma budżetu błędów ani całej mechaniki operacyjnej SRE. Zobaczmy więc, jak taki wskaźnik definiuje się precyzyjnie i jakie są główne kategorie SLI.

Wyjaśnienie skrótów użytych na slajdzie:
SLI – Service Level Indicator – wskaźnik poziomu usług; Wskaźnik telemetryczny odzwierciedlający stopień zadowolenia użytkowników w wybranym aspekcie działania systemu.
REST – Representational State Transfer – architektura REST; Styl architektury oprogramowania oparty na bezstanowości i standardowych metodach protokołu HTTP.
SQL – Structured Query Language – strukturalny język zapytań; Standardowy język programowania przeznaczony do zarządzania relacyjnymi bazami danych i wykonywania operacji na danych.
URL – Uniform Resource Locator – ujednolicony lokalizator zasobów; Ustandaryzowany adres internetowy jednoznacznie identyfikujący zasób w sieci komputerowej.
DNS – Domain Name System – system nazw domenowych; Hierarchiczna usługa sieciowa dokonująca translacji czytelnych nazw domenowych na binarne adresy protokołu IP.

7/55 Przykłady SLI
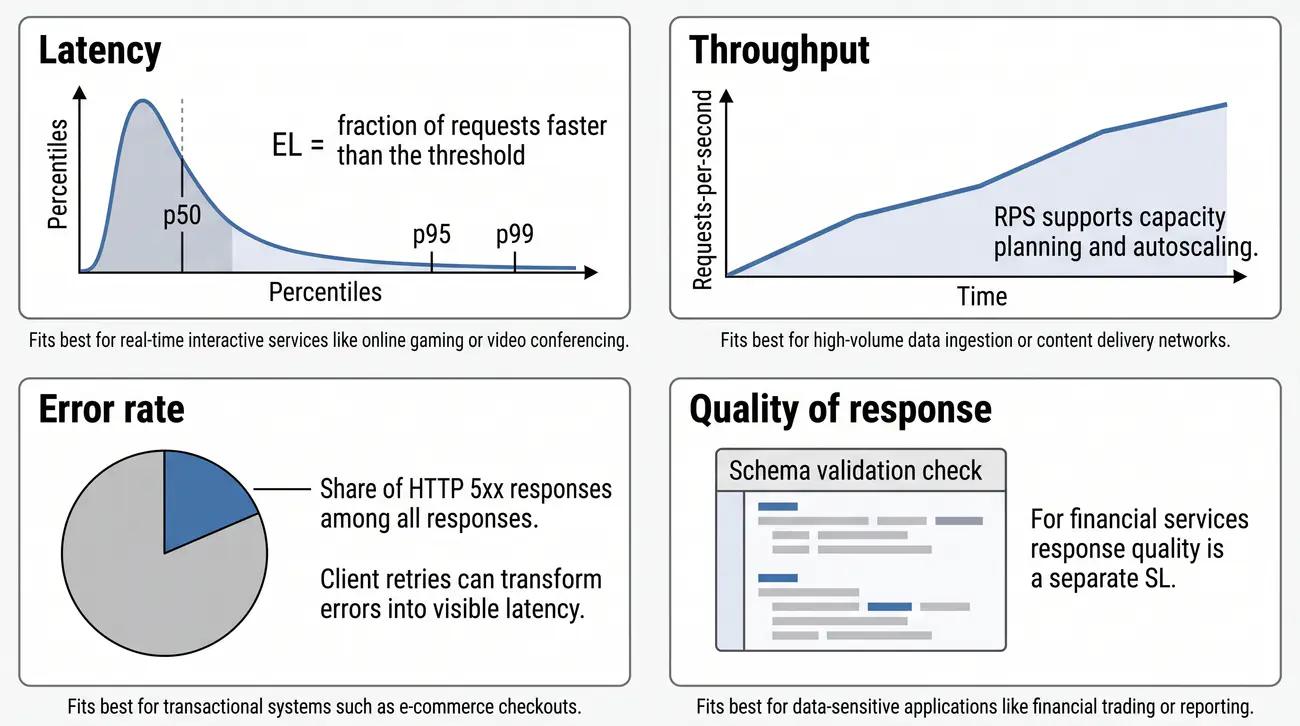
SLI w praktyce: dostępność (success/total), latencja (percentyle z histogramu), throughput (RPS), error rate (błędy/żądania).

SLI nabiera sensu na przykładach: cztery wymiary typowej usługi i ich progi.

  • Analiza percentyli czasu odpowiedzi – percentyle p50, p95 i p99 obrazują rozkład opóźnień, ujawniając problemy dotykające najwolniejszy ułamek zapytań.
  • Przepustowość i natężenie ruchu – liczba zapytań na sekundę (RPS) opisuje skalę obciążenia, stanowiąc sygnał wejściowy dla automatycznego skalowania.
  • Odsetek odpowiedzi błędnych – udział kodów HTTP 5xx w całkowitym ruchu alarmuje o załamaniu stabilności warstwy aplikacji lub baz danych.
  • Zjawisko lawinowych ponowień – wzrost liczby błędów wywołuje ponowne zapytania z przeglądarek, co gwałtownie pogłębia przeciążenie serwerów.
  • Spójna interpretacja metryk – dopiero łączne zestawienie natężenia ruchu, odsetka błędów i latencji daje wiarygodną diagnozę stanu usługi.
Throughput: Przepustowość usługi, czyli liczba żądań na sekundę (RPS); wskaźnik ilościowy mówiący ile, w odróżnieniu od wskaźników jakościowych.
przykłady SLI

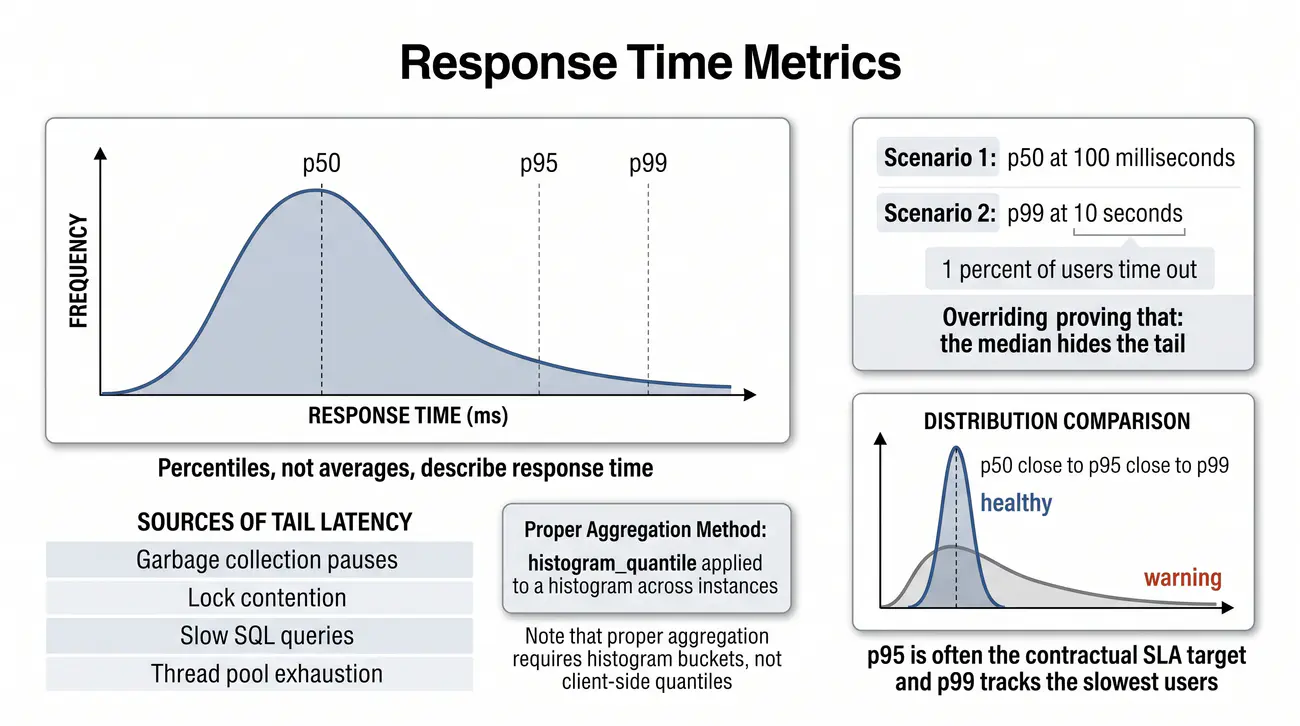
Dlaczego średnia arytmetyczna ukrywa awarie: Wyobraźmy sobie serwis, w którym na 100 zapytań 99 obsługiwanych jest w czasie 10 ms, a jedno trwa 10 000 ms (10 sekund). Średnia arytmetyczna wyniesie około 109 ms – co sprawia pozorne wrażenie stabilnego systemu. Jednak dla użytkownika, który czekał 10 sekund, usługa była całkowicie bezużyteczna. Co więcej, jeśli ten 1% zapytań dotyczy procesu finalizacji płatności, firma traci przychody przy z pozoru „zielonych” wykresach. Percentyl p99 precyzyjnie obnaża ten problem, informując, że najwolniejszy jeden procent klientów czekał aż 10 sekund.

Ocena jakości usług wymaga odrzucenia średniej arytmetycznej na rzecz analizy percentyli czasów odpowiedzi:
- Mediana (p50) odzwierciedla doświadczenie typowego użytkownika, lecz całkowicie maskuje zjawisko długiego ogona (ang. long tail),
- Percentyle p95 oraz p99 definiują opóźnienia dotykające najbardziej wymagających lub pechowych zapytań i to one stanowią podstawę umów o poziomie usług (SLA),
- W systemie Prometheus percentyle obliczane są funkcyjnie na podstawie koszyków histogramu za pomocą polecenia histogram_quantile(0.99, sum(rate(http_request_duration_seconds_bucket[5m])) by (le)).

Gotowe SLI dla czterech kluczowych wymiarów jakości usługi mają postać: definicji matematycznej, typowych progów (thresholds), metody pomiaru w Prometheus (PromQL) i kontekstu (dlaczego ten wskaźnik ma znaczenie). To most między teorią SLI a praktyką implementacji w kodzie i konfiguracji monitoringu.

Latency (opóźnienie) - SLI kluczowy dla usług user-facing: Definicja: odsetek żądań szybszych niż próg (np. < 200ms). Mierzony przez percentyle z histogramu: p50 (mediana - typowy użytkownik), p95 (95% żądań szybsze - standard SLA), p99 (tail latency - najgorsze 1%, krytyczne dla UX). p50 ukrywa problemy: 50% użytkowników ma OK, ale 1% może mieć timeouty 10s. Przykład PromQL: `histogram_quantile(0.95, rate(http_request_duration_seconds_bucket[5m]))`. SLO typowe: p95 < 200ms, p99 < 500ms.

Throughput (przepustowość) - SLI kluczowy dla capacity planning i autoscalingu: Definicja: liczba żądań/transakcji na jednostkę czasu (RPS, TPM). Składowa RED method (Rate). Używane do: planowania pojemności (trendy wzrostu), triggerów autoskalingu (jeśli RPS > próg → scale out), wykrywania anomalii (gwałtowny spadek = problem z ingressem). Przykład PromQL: `rate(http_requests_total[5m])`. To nie jest SLI jakościowe (nie mówi "czy dobrze"), ale SLI operacyjne (mówi "ile").

Error rate (wskaźnik błędów) - SLI jakościowy: Definicja: odsetek żądań zakończonych błędem. Warianty: HTTP 5xx / total requests (błędy serwera), exceptions / transactions (wyjątki w kodzie), business error rate (np. odrzucone płatności / wszystkie próby). Korelacja z latencją: błędy często powodują retry (klient ponawia) → wzrost latencji. Przykład PromQL: `rate(http_requests_total{status=~"5.."}[5m]) / rate(http_requests_total[5m])`. SLO typowe: error rate < 0.1% (dla 99.9% availability).

Jakość odpowiedzi (quality SLI) - najtrudniejsze do zautomatyzowania: Definicja: odsetek odpowiedzi spełniających kryteria biznesowe. Wymaga: schema validation (struktura JSON/XML), completeness (wszystkie wymagane pola obecne), consistency (spójność ACID w transakcjach). Trudne, bo wymaga logiki biznesowej w kodzie instrumentacji, nie tylko standardowego middleware. Przykład: `valid_order_responses_total / order_responses_total`. Rzadziej stosowane, ale krytyczne w fintech/e-commerce.

Terminologia: availability (dostępność), latency (opóźnienie), throughput (przepustowość), error rate (wskaźnik błędów), percentile (percentyl), histogram_quantile (funkcja PromQL do kwantyli), SLA/SLO/SLI hierarchy (hierarchia umów i celów).

Definicje to jedno, ale SLI zaczyna mieć sens, gdy zobaczymy go na konkretnych przykładach. Dla typowej usługi wyróżniamy cztery wymiary: latencję, przepustowość, wskaźnik błędów i jakość odpowiedzi. Dla każdego z nich pokażę precyzyjną definicję, typowe progi, sposób obliczenia w PromQL i powód, dla którego ten wskaźnik w ogóle ma znaczenie dla użytkownika.

Zwróćcie uwagę, że latencja opiera się na percentylach wyciąganych z histogramu, przepustowość to wskaźnik ilościowy (ile, nie jako), a jakość odpowiedzi - ten najtrudniejszy do zautomatyzowania wskaźnik - bywa krytyczny tam, gdzie reszta metryk wygląda idealnie, na przykład w fintechach.

Wyjaśnienie skrótów użytych na slajdzie:
QPS – Queries Per Second – liczba zapytań na sekundę; Wskaźnik obciążenia określający liczbę elementarnych zapytań trafiających do bazy danych lub interfejsu w ciągu sekundy.
CDN – Content Delivery Network – sieć dostarczania treści; Geograficznie rozproszona sieć serwerów buforujących zasoby statyczne blisko użytkownika końcowego.
TTL – Time To Live – czas życia pakietu lub wpisu; Maksymalny czas ważności rekordu w pamięci podręcznej lub liczba przeskoków pakietu w sieci IP przed odrzuceniem.
TTFB – Time To First Byte – czas do pierwszego bajtu; Czas upływający od wysłania żądania HTTP przez klienta do odebrania pierwszego bajtu odpowiedzi z serwera.
LAN – Local Area Network – sieć lokalna; Infrastruktura telekomunikacyjna łącząca komputery i urządzenia sieciowe na ograniczonym obszarze geograficznym.

8/55 Co to jest SLO
SLO (Service Level Objective) - cel na SLI w oknie czasowym (np. availability ≥ 99.9% w 30 dni). Error budget = 1 − SLO.

SLI mówi jak jest, SLO mówi jak ma być: konkretny cel w oknie czasu, z procedurą na wypadek pudła.

  • Definicja celu jakościowego (SLO) – Service Level Objective wyznacza akceptowalny próg wskaźnika SLI mierzony w zdefiniowanym oknie czasowym.
  • Ekonomiczne uzasadnienie celów – dążenie do stuprocentowej dostępności jest nieuzasadnione ekonomicznie; każdy kolejny ułamek procenta potraja koszty.
  • Bezpieczny margines względem umów – cel wewnętrzny SLO ustala się na poziomie ostrzejszym niż kontrakt SLA, zyskując bufor na reakcję zespołu.
  • Kierowanie priorytetami prac – naruszenie zadeklarowanego celu SLO wymusza przekierowanie zasobów programistycznych na poprawę stabilności.
  • Komunikacja z interesariuszami – SLO stanowi wspólny język inżynierów i menedżerów biznesowych, eliminując nieporozumienia wokół awarii.
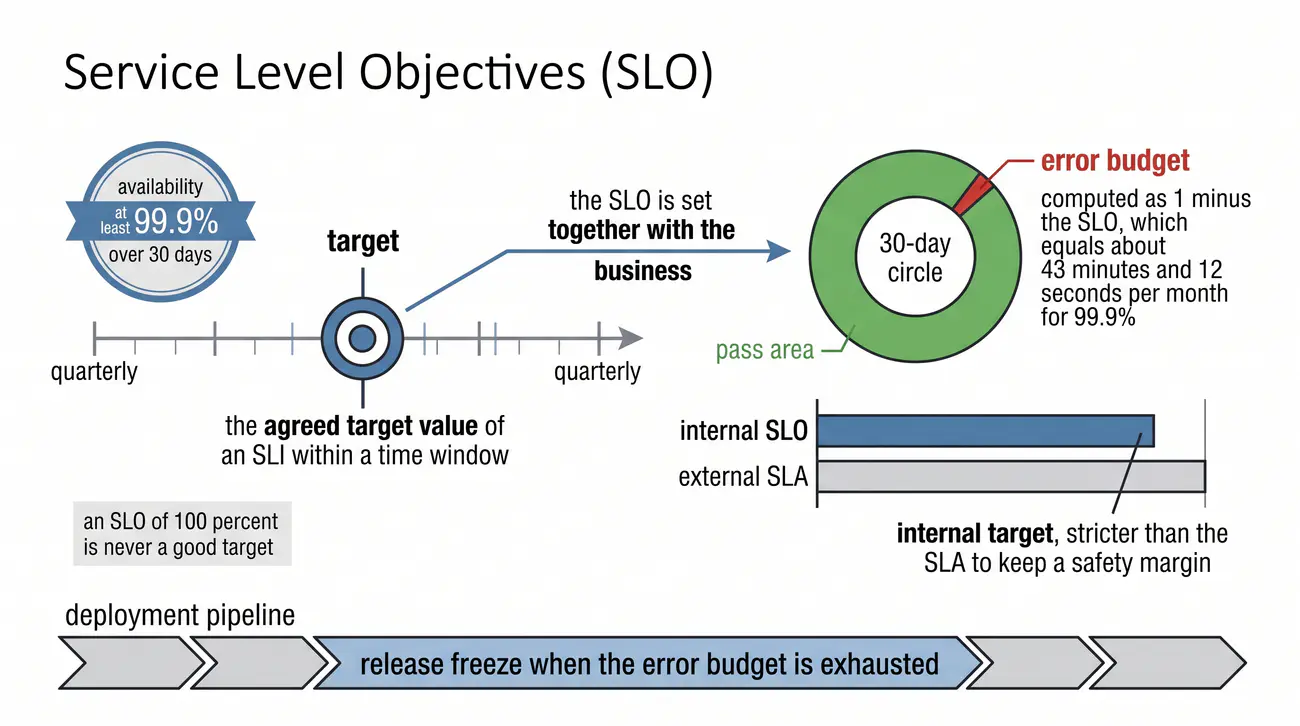
SLO (Service Level Objective): Operacyjny cel na wskaźniku SLI w ustalonym oknie czasowym (np. dostępność ≥ 99,9% w 30 dni); jego naruszenie uruchamia alerty i procedury.
cel SLO

Zasady definiowania mierzalnych celów jakościowych omawia monografia Google SRE: Monitoring Distributed Systems.

SLO (Service Level Objective) zmienia abstrakcyjne "chcemy dobrej jakości" w konkretną, mierzalną i egzekwowalną liczbę, która rodzi się z potrzeb biznesowych - nie z fantazji inżynierów. Wewnętrzne SLO musi być ściślejsze od zewnętrznego SLA i staje się "walutą operacyjną" napędzającą error budget, burn rate i decyzje o release freeze.

Definicja i przykład: SLO to cel jakościowy ustawiany przez zespół inżynieryjny (engineering-driven), wyrażony jako próg na SLI w zdefiniowanym oknie czasowym. Przykład: "availability SLI ≥ 99.9% w oknie 30 dni rolling (sliding window)". To nie jest cel aspiracyjny ("chcemy 100%"), ale operacyjny kontrakt: jeśli SLI spadnie poniżej 99.9%, zespół ma zdefiniowaną procedurę (alert, analiza, ewentualnie release freeze). SLO musi być realne, mierzalne i uzgodnione.

Wynikający z potrzeb biznesu: SLO nie ustala inżynier samodzielnie. Product/UX/biznes definiują, jaka jakość jest akceptowalna dla użytkownika i biznesu - nie zawsze 99.99% (cztery "9"). Często 99.9% (trzy "9") jest wystarczające, a droższe celowanie w 99.99% nie zwraca się biznesowo. Kluczowe pytanie: "Ile downtime akceptujemy, by szybciej wydawać funkcje?" Odpowiedź to SLO.

SLO wewnętrzne vs SLA z klientem: Internal SLO (wewnętrzny cel) jest zazwyczaj ściślejszy (stricter) niż External SLA (umowa z klientem). Przykład: Internal SLO = 99.95% (budżet błędu 0.05% = ~21 min/miesiąc na incydenty operacyjne, wdrożenia, testy). SLA z klientem = 99.9% (kary finansowe poniżej). Bufor 0.05% (safety margin) chroni przed naruszeniem SLA przez incydenty, które nie są w 100% kontrolowane przez zespół (np. awaria dostawcy chmury). SLO napędza operacyjne decyzje codzienne; SLA napędza rozliczenia prawne/miesięczne.

SLO napędza error budget (budżet błędu): Error budget = 1 - SLO. Przy SLO 99.9% → budget = 0.1% (43 min/miesiąc). Ten budżet jest "walutą operacyjną": zużywany na wdrożenia (każdy deploy to ryzyko zużycia budżetu) i awarie. Gdy budżet → 0, następuje Release Freeze (wstrzymanie zmian niekrytycznych). To obiektywna, liczbowa granica - nie decyzja uznaniowa menedżera. SLO = operacyjna waluta, error budget = stan konta.

Terminologia: Service Level Objective (SLO), target (cel), internal SLO (wewnętrzny cel), external SLA (zewnętrzna umowa), error budget driver (napędzający budżet błędu), burn rate (tempo spływania budżetu), SLO compliance (zgodność z celem).

SLI mówi nam, jak usługa działa; SLO mówi, jak powinna działać. To konkretny cel, który zespół stawia na wskaźniku SLI w ustalonym oknie czasowym - na przykład „dostępność co najmniej 99,9 procent w ciągu ostatnich 30 dni". To nie jest cel aspiracyjny, lecz operacyjny kontrakt: jeśli SLI spadnie poniżej progu, uruchamiane są zdefiniowane procedury - alerty, analiza i ewentualnie wstrzymanie wdrożeń.

SLO nie ustala się w próżni, tylko z biznesem, i nie zawsze chodzi o maksymalne możliwe „9". Często 99,9 procent to optymalny punkt równowagi między kosztami zapewnienia niezawodności a wartością dodatkowej „dziewiątki". Dodatkowo wewnętrzne SLO celowo stawia się ściślej niż zewnętrzne SLA - powstały bufor chroni zespół przed karami, gdy pierwsza większa awaria uderzy.

Wyjaśnienie skrótów użytych na slajdzie:
SLO – Service Level Objective – cel poziomu usług; Kluczowy cel inżynierski wyznaczający akceptowalny poziom dostępności lub wydajności w określonym oknie czasowym.
CI/CD – Continuous Integration / Continuous Delivery – ciągła integracja i ciągłe wdrażanie; Praktyka automatyzacji budowania, testowania i dostarczania aplikacji na środowiska docelowe.
KPI – Key Performance Indicator – kluczowy wskaźnik efektywności; Biznesowy wskaźnik służący do ilościowej oceny stopnia realizacji celów strategicznych organizacji.
DevOps – Development and Operations – metodyka DevOps; Kultura organizacyjna kładąca nacisk na ścisłą współpracę programistów i inżynierów operacyjnych.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Praktyka wdrożenia metodyki DevOps za pomocą zasad inżynierii oprogramowania.

9/55 Co to jest SLA
SLA (Service Level Agreement) - prawny kontrakt z klientem; luźniejszy niż wewnętrzne SLO; przewiduje kary za naruszenie.

SLA to obietnica z karami: formalny kontrakt, zawsze luźniejszy niż wewnętrzny cel. Mylenie ich kosztuje.

  • Prawny wymiar umowy SLA – Service Level Agreement to formalny kontrakt biznesowy z klientem, określający kary finansowe za niedotrzymanie jakości.
  • Bufor bezpieczeństwa (Safety Margin) – różnica między celem SLO a umową SLA chroni organizację przed karami w razie awarii dostawców zewnętrznych.
  • Matematyczny wymiar dopuszczalnego przestoju – SLA na poziomie 99,5% dopuszcza ponad 3,5 godziny awarii miesięcznie, a 99,9% zaledwie 43 minuty.
  • Wyłączenia gwarancyjne w umowach – rzetelne umowy SLA precyzują planowane okna serwisowe oraz sytuacje siły wyższej i ataków sieciowych.
  • Rola inżyniera w negocjacjach – inżynier SRE weryfikuje wykonalność techniczną zapisów kontraktowych, zapobiegając nierealnym obietnicom handlowym.
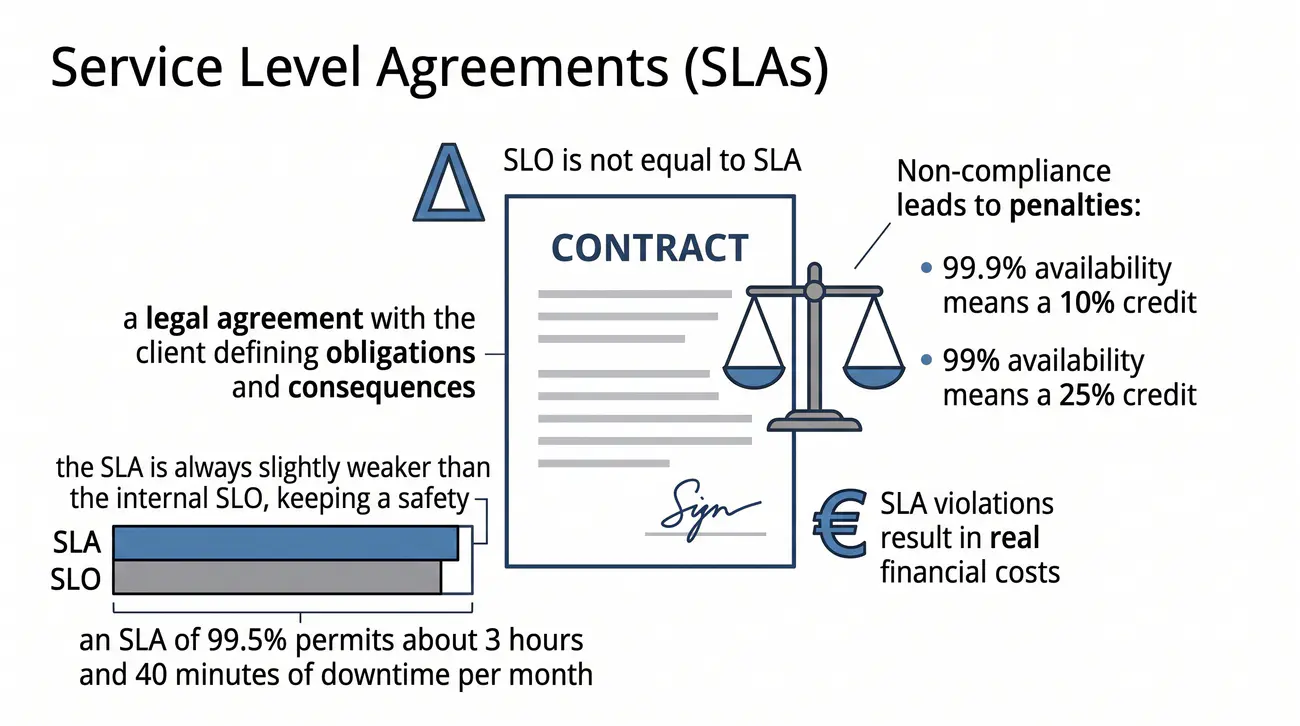
SLA (Service Level Agreement): Formalny kontrakt z klientem o charakterze prawnym; luźniejszy niż wewnętrzne SLO i przewidujący kary za niespełnienie.
fragment umowy SLA

Safety Margin – bufor bezpieczeństwa w umowach: Dlaczego cel wewnętrzny SLO (np. 99,95%) musi być zawsze wyższy niż formalna umowa SLA (np. 99,9%)? Różnica ta, wynosząca w tym przypadku 0,05% (ok. 22 minuty w miesiącu), stanowi bufor bezpieczeństwa (safety margin). W realnym świecie system zależy od podmiotów trzecich: dostawców chmury, globalnych węzłów DNS czy operatorów telekomunikacyjnych. Jeśli awaria nastąpi po stronie zewnętrznego dostawcy łącza, organizacja nie ma na nią wpływu, lecz nadal jest rozliczana przez klientów z umowy SLA. Posiadanie bufora chroni firmę przed wypłatą dotkliwych kar finansowych.

Hierarchia wskaźników niezawodności wynika z relacji między inżynierią a prawem:
- SLI (Service Level Indicator) to bezpośredni, techniczny pomiar metryki w czasie rzeczywistym (np. ułamek poprawnych zapytań),
- SLO (Service Level Objective) to wewnętrzny cel inżynierski wyznaczany przez zespół SRE w porozumieniu z biznesem (np. 99,9% dostępności w oknie 30 dni),
- SLA (Service Level Agreement) to prawnie wiążąca umowa z klientem określająca kary umowne lub rekompensaty; margines błędu w SLA musi być zawsze łagodniejszy niż wewnętrzne SLO (np. SLA na poziomie 99,5%), co zapewnia zespołowi bufor bezpieczeństwa.

SLA (Service Level Agreement) to formalny, prawny kontrakt z klientem mający zęby: kary finansowe (penalties) i kredyty usługowe (service credits) za niespełnienie. To biznesowy kontrakt (driven by legal/billing), podczas gdy SLO to cel inżynieryjny (driven by operations); SLA jest zwykle luźniejsze od wewnętrznego SLO (safety margin), dając zespołowi bufor na incydenty - mylenie SLA z SLO prowadzi albo do nadmiernego ryzyka (SLO = SLA), albo do paraliżu (SLO zbyt ścisłe).

Definicja i konsekwencje: SLA (Service Level Agreement) to formalny kontrakt z klientem (zewnętrznym lub wewnętrznym - innym dziale), który określa minimalny poziom usługi i konsekwencje jego niespełnienia. Typowe kary: service credits (np. < 99.9% dostępności → 10% opłaty miesięcznej jako credit; < 99% → 25%). To realne pieniądze, a nie "punkty" w systemie ticketowym. SLA jest negocjowane prawnie, podpisywane przez zarząd, i egzekwowane przez finanse/prawo.

Luźniejsze niż SLO (safety margin): Internal SLO zawsze stricter (ściślejsze) niż External SLA. Przykład: SLA = 99.9% (dozwolone 43 min downtime/miesiąc), Internal SLO = 99.95% (dozwolone 21 min) lub 99.99% (4.3 min). Różnica (0.05% = 21 min lub 0.09% = 39 min) to safety margin - bufor bezpieczeństwa na incydenty niewłasne (awaria AWS, problem z DNS-em dostawcy, atak DDoS). Nigdy nie ustawiaj SLO = SLA - to gwarantuje naruszenie SLA przy pierwszej większej awarii.

Różnica SLA vs SLO - dwa różne światy: SLO = engineering target (cel inżynierski) - napędza codzienne decyzje: alertowanie, release freeze, priorytety backlogu, capacity planning. SLA = business contract (kontrakt biznesowy) - napędza rozliczenia (billing), prawo (penalties), relacje z klientem. SLO drives error budget (SLO napędza budżet błędu); SLA drives penalties (SLA napędza kary). Mieszanie ich = chaos operacyjny.

Przykład liczbowy: SLA w umowie = 99.5% dostępności (dozwolone 3.65 h downtime/miesiąc). Internal SLO zespołu = 99.9% (dozwolone 43 min). Bufor = 0.4% = 175 min/miesiąc. Ten bufor "zjadają": planowane maintenance (okna serwisowe), incydenty zależności zewnętrznych, ryzyko wdrożeń. Zespół ma 175 minut zapasu na operacje, zanim klient poczuje ból i zażąda kary.

Terminologia: Service Level Agreement (SLA), service credits (kredyty usługowe - zwrot części opłaty), penalty clause (klauzula karna), SLO vs SLA (różnica cel vs kontrakt), safety margin (margines bezpieczeństwa), business contract (kontrakt biznesowy).

SLO to cel, który inżynierowie stawiają sobie na co dzień. SLA to z kolei obietnica wobec klienta - formalny kontrakt o charakterze prawnym, za którego niespełnienie przewidziane są realne konsekwencje finansowe, na przykład kredyty usługowe lub kary pieniężne. Te dwa pojęcia są bardzo często mylone, a skutki pomyłki bywają kosztowne: albo narażamy się na kary, bo trzymamy cel identyczny z umową, albo paraliżujemy zespół celem zbyt restrykcyjnym.

Żeby uniknąć obu skrajności, kierujemy się prostą zasadą: wewnętrzne SLO jest zawsze ściślejsze od zewnętrznego SLA, a różnica między nimi to margines bezpieczeństwa. Ten bufor pokrywa incydenty, na które nie mamy pełnego wpływu - awarię chmurowego dostawcy, problemy z DNS czy atak DDoS.

Wyjaśnienie skrótów użytych na slajdzie:
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; Formalny kontrakt określający minimalne standardy jakościowe usługi oraz konsekwencje prawne i finansowe ich naruszenia.
B2B – Business to Business – relacja przedsiębiorstwo-przedsiębiorstwo; Model transakcji handlowych i relacji biznesowych zawieranych wyłącznie pomiędzy firmami.
B2C – Business to Consumer – relacja przedsiębiorstwo-konsument; Relacje handlowe i świadczenie usług bezpośrednio na rzecz klientów indywidualnych.
PLN – Polish Zloty – złoty polski; Oficjalna jednostka monetarna Rzeczypospolitej Polskiej stosowana w rozliczeniach kar umownych SLA.
EUR – Euro – euro; Oficjalna waluta państw strefy euro Unii Europejskiej, powszechna w międzynarodowych kontraktach IT.

10/55 Relacja SLA-SLO-SLI
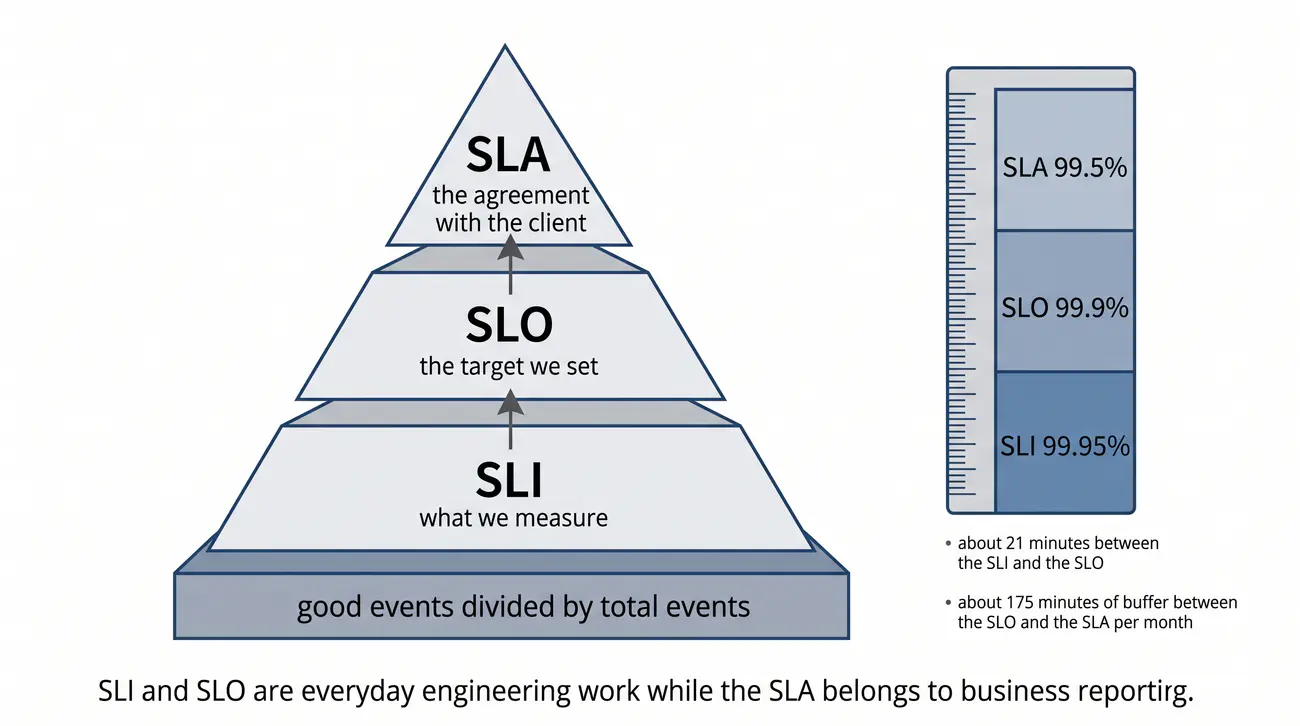
Hierarchia: SLI (miara) → SLO (cel) → SLA (umowa). SLO ściślejsze niż SLA; różnica = safety margin.

SLI, SLO i SLA to jeden łańcuch: mierzysz, celujesz, obiecujesz. Strzałki idą tylko w jedną stronę.

  • Hierarchiczny łańcuch pojęć jakościowych – wskaźnik SLI mierzy bieżący stan, cel SLO wyznacza wewnętrzny standard, a umowa SLA definiuje zobowiązanie prawne.
  • Kierunek projektowania parametrów – najpierw uruchamia się precyzyjny pomiar telemetryczny, następnie wyznacza cel SLO, a dopiero na końcu podpisuje SLA.
  • Rola wewnętrznego bufora – margines między wskaźnikiem rzeczywistym a celem SLO stanowi codzienny zapas bezpieczeństwa dla programistów.
  • Konsekwencje naruszenia progów – spadek metryki poniżej SLO uruchamia procedury naprawcze, natomiast spadek poniżej SLA generuje kary umowne.
  • Cykliczna weryfikacja założeń – wraz z rozwojem architektury i stabilizacją kodu progi SLO podlegają systematycznemu podnoszeniu.
Safety margin: Różnica między ściślejszym wewnętrznym SLO a luźniejszym zewnętrznym SLA; bufor chroniący przed karami umownymi.
schemat zależności

Hierarchia wskaźników niezawodności wynika z relacji między inżynierią a prawem:
- SLI (Service Level Indicator) to bezpośredni, techniczny pomiar metryki w czasie rzeczywistym (np. ułamek poprawnych zapytań),
- SLO (Service Level Objective) to wewnętrzny cel inżynierski wyznaczany przez zespół SRE w porozumieniu z biznesem (np. 99,9% dostępności w oknie 30 dni),
- SLA (Service Level Agreement) to prawnie wiążąca umowa z klientem określająca kary umowne lub rekompensaty; margines błędu w SLA musi być zawsze łagodniejszy niż wewnętrzne SLO (np. SLA na poziomie 99,5%), co zapewnia zespołowi bufor bezpieczeństwa.

Piramida SRE to jeden spójny model zależności SLI → SLO → SLA, najważniejszy diagram konceptualny w kursie. Łańcuch obliczeń biegnie od surowych pomiarów co 30 sekund po roczne raporty SLA, a każdy element znajduje miejsce zarówno w codziennej pracy inżyniera SRE, jak i w raportowaniu biznesowym.

Hierarchia trzech pojęć: SLI (Service Level Indicator) = MIARA - co mierzymy (np. availability SLI = successful/total). SLO (Service Level Objective) = CEL na tej mierze - co celujemy (np. SLI ≥ 99.9%). SLA (Service Level Agreement) = UMOWA oparta na SLO z buforem - co obiecujemy klientowi (np. ≥ 99.5%, z karami za naruszenie). Prosta zasada: SLI = co mierzymy, SLO = co celujemy, SLA = co obiecujemy. Strzałka zawsze idzie SLI → SLO → SLA.

Łańcuch zależności i obliczeń: SLI mierzone co 30 sekund (scrape interval) → agregowane w oknie ewaluacji (30 dni rolling window) → porównane do progu SLO → obliczany error budget = SLO - actual SLI → sprawdzany SLA compliance (czy actual SLI ≥ SLA threshold). To potok (pipeline): surowe dane → SLI → SLO compliance → error budget → operacyjne decyzje / raporty SLA. Każde ogniwo ma swój czas i swoją odpowiedzialność.

Przykład liczbowy z minutami: SLI actual = 99.95% (usługa faktycznie działała), SLO target = 99.9% (cel zespołu), SLA kontrakt = 99.5% (obowiązek wobec klienta). Error budget = SLO - SLI = 99.9% - 99.95% = -0.05% (budżet NIE zużyty, mamy 0.05% = ~21 min/miesiąc zapasu). SLA headroom = SLO - SLA = 99.9% - 99.5% = 0.4% = 175 min/miesiąc buforu na incydenty niewłasne. Liczby, nie opinie.

Umiejscowienie w pracy SRE: SLI/SLO = codzienna praca inżynierska (dashboardy, alerty, canary analysis, release decisions, error budget tracking). SLA = raportowanie miesięczne/kwartalne dla biznesu/klienta (uptime report, penalty calculation, contract review). Error budget = operacyjna waluta (stan konta: ile możemy jeszcze ryzykować wdrożeniami, czy freeze). To rozdzielenie pozwala inżynierom skupić się na SLI/SLO, a menedżerom/biznesowi na SLA - z jasnym mostem (error budget) między nimi.

Wizualizacja: schemat strzałek SLI → SLO → SLA z naniesionymi buforami (SLO-SLI = error budget, SLA-SLO = safety margin). Dashboard w Grafana: panel "Error Budget Remaining" (pasek postępu), "SLO Compliance" (tak/nie), "Burn Rate" (tempo spływania). To narzędzia decyzyjne, nie tylko dekoracje.

Zaraz okaże się, że SLI, SLO i SLA to nie trzy przypadkowe pojęcia, lecz jeden spójny łańcuch zależności. Najpierw mierzymy (SLI), potem ustalamy cel na tej mierze (SLO), a na końcu składamy obietnicę klientowi (SLA). Strzałki w tej hierarchii idą zawsze w jednym kierunku, a łańcuch - od surowych pomiarów co kilkadziesiąt sekund po miesięczne raporty SLA - pokazuje, że każdy element ma swoje miejsce i odpowiedzialność.

Wartości też nie są przypadkowe. Wewnętrzne SLO jest zawsze ściślejsze od zewnętrznego SLA, a różnica między nimi tworzy margines bezpieczeństwa na incydenty spoza naszej kontroli. Te liczby, przeliczone na minuty, pozwalają jasno powiedzieć, ile zapasu mamy na operacje, zanim klient zacznie odczuwać problemy.

Wyjaśnienie skrótów użytych na slajdzie:
CAB – Change Advisory Board – komitet doradczy ds. zmian; Organ w metodyce ITIL oceniający ryzyko i harmonogram wprowadzania istotnych zmian w architekturze produkcyjnej.
ITIL – Information Technology Infrastructure Library – biblioteka infrastruktury technologii informacyjnych; Ustandaryzowany zbiór najlepszych praktyk w zakresie zarządzania usługami teleinformatycznymi.
PR – Pull Request – propozycja włączenia zmian; Mechanizm w systemach kontroli wersji służący do zgłoszenia kodu do recenzji przed scaleniem z główną gałęzią.
QA – Quality Assurance – zapewnienie jakości; Proces systematycznej weryfikacji oprogramowania pod kątem spełniania określonych wymagań funkcjonalnych.
UAT – User Acceptance Testing – testy akceptacyjne użytkownika; Końcowa faza testowania oprogramowania przeprowadzana z udziałem użytkowników końcowych przed wdrożeniem produkcyjnym.

11/55 Budżet błędów (przypomnienie i rozwinięcie)
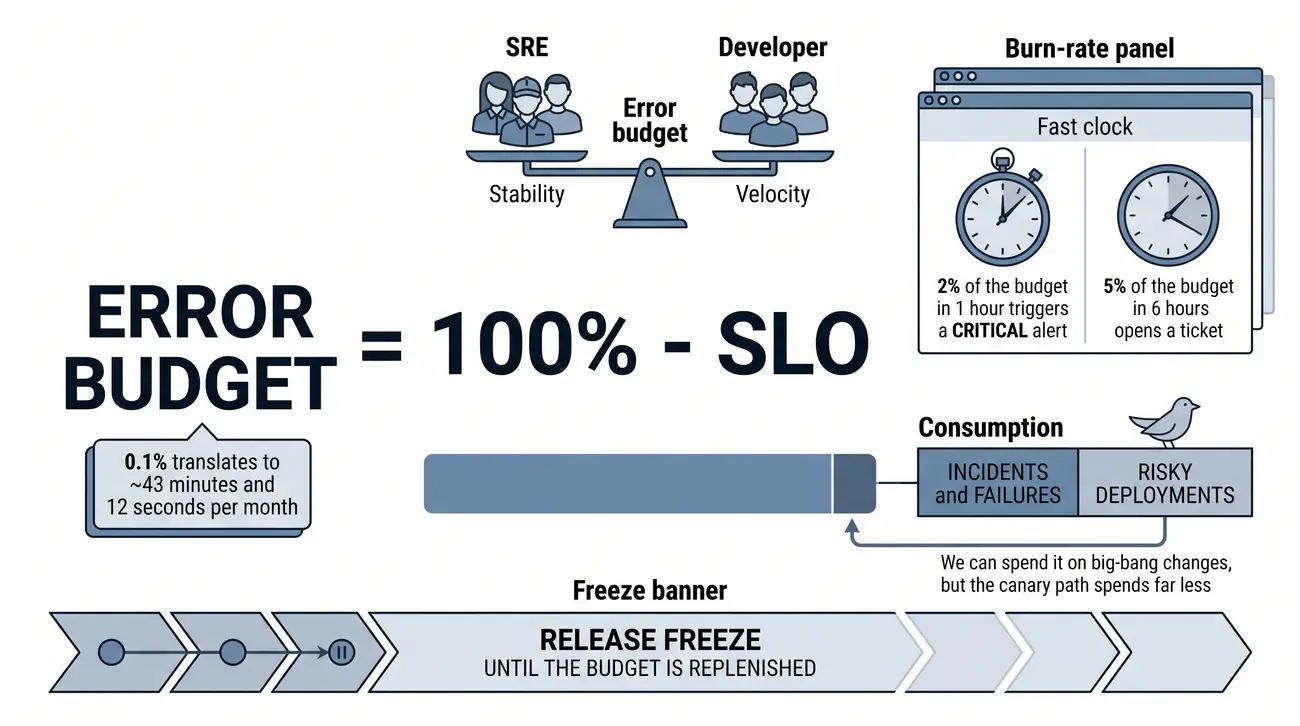
Error budget = 100% − SLO. Przy 99.9%: 0.1% = ~43 min/mies. Zużywany na awarie i wdrożenia; wyczerpanie → release freeze.

Budżet błędów to „dozwolone zło”: pula na awarie i ryzykowne wydania. Gdy się kończy, stają wydania.

  • Koncepcja budżetu błędów – pula dopuszczalnej zawodności (100% minus SLO) wyznacza przestrzeń na ryzyko związane z publikacją nowych funkcji.
  • Przeliczenie procentów na minuty – w skali 30 dni cel 99,9% oznacza 43 minuty przestoju, natomiast cel 99,99% pozostawia zaledwie 4,3 minuty.
  • Mechanizm ochrony stabilności – wyczerpanie budżetu w bieżącym okresie nakłada twardy obowiązek wstrzymania wydań biznesowych na rzecz napraw.
  • Tempo zużywania budżetu (Burn Rate) – wskaźnik ten mierzy prędkość utraty marginesu błędu, umożliwiając wykrycie krytycznej awarii w kilka minut.
  • Obiektywizacja współpracy Dev i Ops – budżet błędów eliminuje subiektywne spory, zastępując emocje transparentną regułą matematyczną.
Zużywanie budżetu błędów: Awarie i ryzykowne wdrożenia uszczuplają pulę dopuszczalnej niedostępności; wyczerpanie budżetu oznacza wstrzymanie zmian (release freeze).
Budżet błędów (przypomnienie i rozwinięcie)

Matematyka Burn Rate w wielookresowym alertingu: Zamiast czekać do końca miesiąca na podsumowanie dostępności, inżynieria SRE stosuje wskaźnik tempa spalania budżetu (Burn Rate). Standardowe tempo 1x oznacza, że 100% budżetu zostanie zużyte dokładnie w ciągu 30 dni. Jeśli jednak tempo wzrośnie do 14,4x, oznacza to, że usługa spali aż 5% całego miesięcznego budżetu w ciągu zaledwie 6 godzin. Taka sytuacja wymaga natychmiastowego powiadomienia dyżurnego SRE (alert o wysokim priorytecie), zanim awaria doprowadzi do zerwania kontraktu biznesowego.

Budżet błędów stanowi dopuszczalny margines zawodności: EB = 100% - SLO. Przy SLO równym 99,9% dopuszczalny czas niedostępności wynosi 43,2 minuty w 30-dniowym kroczącym oknie pomiarowym. Nowoczesny alerting opiera się na wskaźniku tempa spalania (Burn Rate):
- Wartość Burn Rate równa 1 oznacza całkowite wyczerpanie budżetu dokładnie w czasie 30 dni,
- Wartość Burn Rate równa 14,4 oznacza skonsumowanie 2% budżetu w ciągu jednej godziny i wymaga natychmiastowej interwencji dyżurnego inżyniera,
- Szczegółowe formuły wielookresowe definiuje podręcznik Google SRE Workbook: Alerting on SLOs.

Error budget (budżet błędu) to operacyjna waluta SRE, wyliczana z SLO w minutach/godzinach i zużywana przez awarie oraz wdrożenia. Tempo spływania mierzy się wielookienkowo (standard Google, burn rate), przy wyczerpaniu budżetu obowiązuje release freeze, a sam budżet rozstrzyga konflikt interesów między dev (velocity) a ops (stability).

Definicja i przeliczenie na czas: Error budget = 100% - SLO (wyrażone w % czasu). Przykłady: SLO 99.9% → budget 0.1% = 43 min 12 sekund miesięcznie. SLO 99.99% → 4 min 19 sekund. SLO 99.999% → 26 sekund. To ilość "dopuszczalnego złego" - czasu, w którym usługa może nie spełniać SLO bez konsekwencji operacyjnych. Im wyższe SLO, tym mniejszy budżet, tym droższe każde "9".

Zużycie budżetu - awarie i wdrożenia: Każda awaria (incydent) zużywa budżet proportionally do trwania i ciężkości (np. 100% error rate przez 10 min = 10 min budżetu). Każde wdrożenie (deployment) RYZYKUJE budżetem: canary deployment (1% ruchu) = małe ryzyko, big bang (100% naraz) = duże ryzyko. Error budget to "waluta operacyjna" - zespół "wydaje" ją na ryzyko zmian (dev chce wydawać) i pokrywa koszty awarii (ops płaci). To zmienia dyskusję z "czy możemy wdrożyć?" na "ile budżetu to kosztuje i czy stać nas?".

Burn rate - tempo spływania (multi-window, Google SRE Workbook): Burn rate = jak szybko budżet znika. Przykład: przy SLO 99.9% budżet = 0,72h/miesiąc (43 min); error rate 1,44% przez 1 godzinę → burn rate 14,4 → ~2% budżetu miesięcznego zużyte. Standard Google: multi-window burn rate alerting - dwa okna: Fast burn (np. 2% budżetu w 1h = alert CRITICAL, page), Slow burn (np. 5% budżetu w 6h = alert WARNING, ticket). To eliminuje fałszywe alarmy przy krótkich spike'ach i łapie prawdziwe trendy.

Wyczerpanie → Release Freeze: Gdy error budget ≈ 0 (zbliża się do zera), automatycznie (lub procesowo) następuje Release Freeze - wstrzymanie wszystkich zmian niekrytycznych (nowe funkcje, refaktoryzacje). Zespół skupia się wyłącznie na stabilizacji (bugfixy, scaling, debt reduction). To NIE jest decyzja uznaniowa managera ("myślę, że powinniśmy zatrzymać"), lecz konsekwencja liczb: budżet się skończył = nie ma "pieniędzy" na ryzyko. Gdy budżet ujemny → obowiązkowy post-mortem i action items naprawiające przyczyny.

Równowaga tempo vs stabilność: Dev "kupuje" szybkość wydawania (wydaje budżet na deploy), SRE "strzeże" stabilności (pilnuje, by budżet nie uciekł na awarie). Error budget to obiektywny arbitraż tego konfliktu interesów - nie opinie, nie polityka, tylko liczby. Gdy budżet dodatni → wolno deployować. Gdy bliski zera → ostrożnie (tylko canary, małe kroki). Gdy ujemny → freeze + post-mortem. To eliminuje "dev vs ops" na rzecz wspólnego celu: zachować budżet dodatni.

Na zakończenie pierwszej części wrócimy do budżetu błędów, który poznaliśmy w pierwszym wykładzie, i przyjrzymy się mu głębiej - bo to on rozstrzyga, kiedy możemy wdrażać, a kiedy musimy wstrzymać zmiany. Budżet błędów to po prostu sto procent minus SLO, czyli zaplanowany limit „dopuszczalnego zła". Przy dostępności na poziomie 99,9 procent zostaje nam około 43 minut miesięcznie.

Choć to brzmi abstrakcyjnie, ten limit pełni bardzo konkretną rolę: zużywamy go na awarie i na ryzykowane wdrożenia, a gdy zbliża się do zera, automatycznie obowiązuje zasada release freeze. W ten sposób budżet błędów zamienia spór między tempem wydań a stabilnością w obiektywną, liczbową kwestię - i o tym pomyślimy sobie w kolejnych slajdach, gdy poznamy też tempo spływania budżetu.

Wyjaśnienie skrótów użytych na slajdzie:
EB – Error Budget – budżet błędów; Dopuszczalna pula zawodności usługi wynikająca z różnicy pomiędzy 100% a zdefiniowanym celem SLO.
MTBF – Mean Time Between Failures – średni czas między awariami; Wskaźnik niezawodności określający średni czas bezawaryjnej pracy systemu pomiędzy kolejnymi usterkami.
MTTR – Mean Time To Repair – średni czas naprawy; Statystyczny czas wymagany do usunięcia awarii i przywrócenia pełnej funkcjonalności infrastruktury.
SLO – Service Level Objective – cel poziomu usług; Wskaźnik referencyjny określający margines dopuszczalnych błędów dla zespołu inżynierskiego.
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina techniczna, w której budżet błędów jest podstawową walutą negocjacji tempa zmian.

12/55 Dobór celu SLO
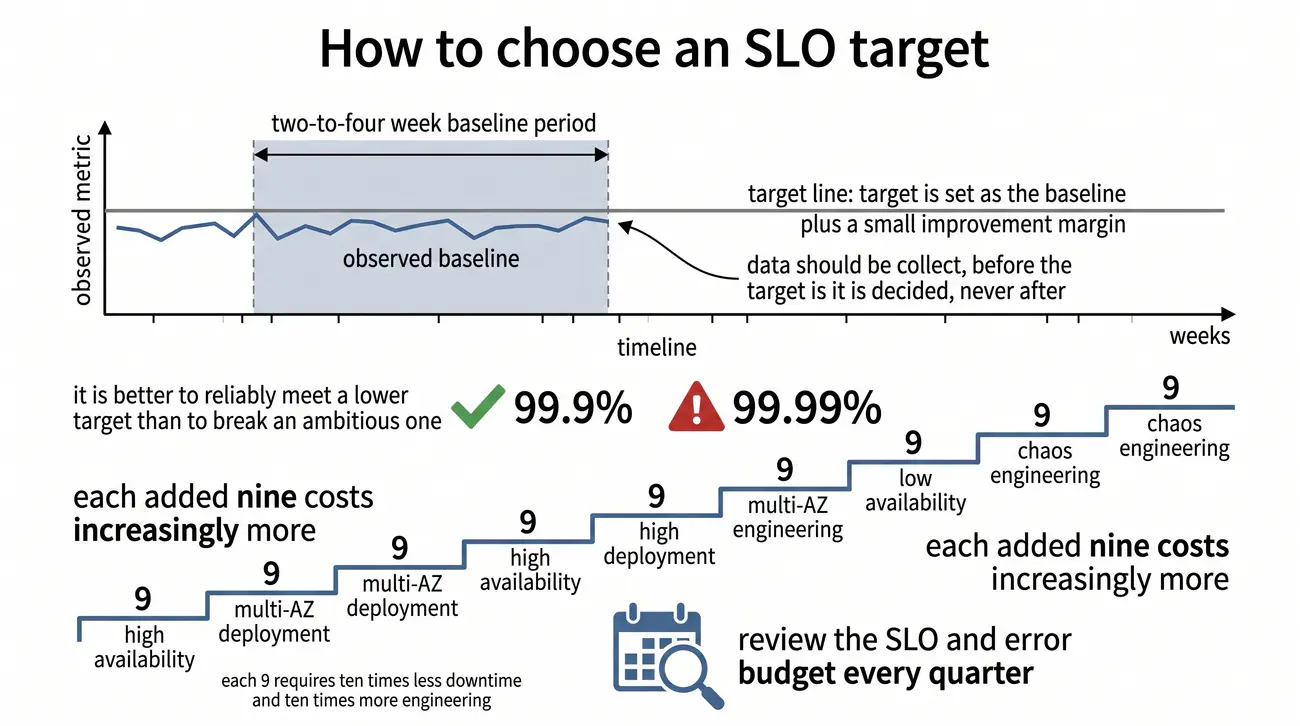
Dobór SLO: zbieraj baseline 2-4 tyg., wybierz realny cel (nie 99.99% bez danych), przeglądaj kwartalnie. Każde „9" kosztuje wykładniczo.

Celu nie zgaduj - wylicz go z danych. Najpierw 2-4 tygodnie pomiarów, potem próg z małym marginesem.

  • Kryteria biznesowe wyznaczania SLO – cel jakościowy musi wynikać z realnych oczekiwań użytkowników oraz tolerancji biznesu na krótkie przerwy.
  • Wpływ architektury na dostępność – system złożony z wielu połączonych szeregowo usług osiąga niższą dostępność wypadkową niż jego komponenty.
  • Analiza danych historycznych – wyznaczanie nowego celu SLO opiera się na analizie stabilności usługi z poprzednich kwartałów, a nie na życzeniach.
  • Zróżnicowanie celów per komponent – krytyczny moduł płatności wymaga wyższego progu SLO niż pomocniczy system generowania raportów PDF.
  • Krokowy proces doskonalenia – dojrzałość operacyjną buduje się stopniowo, podnosząc cele jakościowe w miarę wdrażania automatyzacji.
Baseline (linia bazowa): Pomiar rzeczywistego działania usługi zbierany przez 2-4 tygodnie przed ustaleniem celu SLO; cel bez danych to zgadywanie.
proces doboru SLO

Dobór celu SLO to proces inżynieryjny oparty na danych, ekonomii i ciągłej weryfikacji, a nie zgadywanie ani celowanie w "idealne 99.99%". Pięć kroków to badanie historycznych danych (baseline), analiza kompromisu koszt/jakość, ustawienie realnego celu, cykliczna weryfikacja (quarterly review) i zrozumienie wpływu SLO na error budget; wynik to SLO ambitne, ale osiągalne, napędzające poprawne zachowania operacyjne.

Badanie historycznych danych (baseline): Zanim ustawisz SLO, musisz zmierzyć rzeczywistość. Przez 2-4 tygodnie zbieraj aktualne SLI (availability, latency) w produkcji - to Twój baseline. Cel realny = baseline + mały margines na poprawę (np. baseline 99.92% → SLO 99.93-99.95%). Nigdy nie celuj w "idealne" (100% lub 99.99%) bez danych - to przepis na frustrację. Baseline daje punkt odniesienia: czy nowy SLO jest rozciągnięciem (stretch goal), czy status quo.

Kompromis koszt/jakość: Każde dodatkowe "9" w dostępności kosztuje wykładniczo. 99.9% → 99.99% = 10x mniej downtime, ale wymaga: więcej replik (HA), lepszego hardware, multi-AZ deployment, chaos engineering, zaawansowanego alertingu, obciążenia on-call. Biznes musi świadomie zdecydować: czy wartość biznesowa dodatkowych 99.9% → 99.99% przewyższa koszt infrastruktury i ludzi? To decyzja biznesowa, nie techniczna. Inżynier dostarcza dane (koszt vs ryzyko), biznes decyduje.

Realny, osiągalny cel: SLO nieaspiracyjne - "chcemy 99.99%" bez inwestycji w HA, chaos testing, lepsze monitorowanie = pewne naruszenie i frustracja zespołu (ciągłe alerty, release freeze). Lepiej ustawić SLO 99.9% i go SPĘNIAC (zapowiadać, monitorować, dążyć do 99.95%), niż 99.99% i ciągłe naruszać. SLO spełniane buduje zaufanie i kulturę inżynierską; SLO niemożliwe do spełnienia demotywuje i dezaktywuje mechanizm error budget (freeze zawsze aktywny = nikt nie wdraża).

Weryfikacja w czasie (Quarterly SLO Review): SLO nie jest ustawiane na zawsze. Co kwartał (przegląd kwartalny): czy cel wciąż adekwatny? Czy technologia zmieniła się (nowa architektura, migracja do k8s)? Czy biznes zmienił wymagania (nowy kontrakt SLA, nowy produkt)? Jeśli baseline drastycznie poprawił się (np. z 99.9% na 99.97% dzięki nowej infra) → podnieś SLO (adjust). Jeśli baseline spadł → obniż SLO lub zainwestuj w poprawę (keep + invest). To ciągły proces, nie one-off.

Znaczenie w error budget: SLO definiuje budżet błędu. Złe SLO = albo zbyt restrykcyjne (ciągły freeze, zespół paraliżowany, nikt nie wdraża) albo zbyt luźne (brak presji na jakość, awarie ignorowane, error budget nigdy się nie kończy = nie działa jako mechanizm). Dobrze dobrane SLO sprawia, że error budget jest "aktywny" - zużywa się przy awariach, chroni przed zbyt agresywnymi deployami, wymusza inwestycje w stabilność gdy blisko zera.

Dobór celu SLO to proces inżynierski oparty na danych, ekonomii i ciągłej weryfikacji - a nie zgadywanie ani automatyczne celowanie w najbardziej prestiżowe „99,99 procent". Pierwszy krok to zawsze poznanie rzeczywistości: przez dwa do czterech tygodni zbieramy dane o tym, jak usługa działa naprawdę, i ten pomiar staje się naszą linią bazową. Dopiero potem celujemy w realny próg, czyli linię bazową z niewielkim marginesem poprawy.

Równie ważna jest druga strona medalu, czyli koszt. Każde kolejne „9" w dostępności kosztuje wykładniczo - wymaga redundancji, wieloregionowości, testów chaosu, mocniejszego alertingu i obciążenia dyżurów. Dlatego lepiej spełniać cel 99,9 procent i budować zaufanie, niż notorycznie łamać 99,99 procent, które demotywuje zespół i dezaktywuje mechanizm budżetu błędów. A ponieważ zarówno technologia, jak i biznes się zmieniają, cel przeglądamy i korygujemy kwartalnie.

Wyjaśnienie skrótów użytych na slajdzie:
HA – High Availability – wysoka dostępność; Architektura systemu zaprojektowana w sposób minimalizujący przestoje poprzez redundancję krytycznych komponentów.
DR – Disaster Recovery – odzyskiwanie poawaryjne; Zbiór procedur, narzędzi i polityk umożliwiających odtworzenie infrastruktury po zdarzeniach katastrofalnych.
RPO – Recovery Point Objective – docelowy punkt odzyskiwania; Maksymalny dopuszczalny okres utraty danych mierzony wstecz od momentu wystąpienia awarii.
RTO – Recovery Time Objective – docelowy czas odzyskiwania; Maksymalny akceptowalny czas przywrócenia dostępności procesów biznesowych po awarii.
TCO – Total Cost of Ownership – całkowity koszt posiadania; Łączny koszt zakupu, wdrożenia, utrzymania i rozwoju infrastruktury IT w całym cyklu życia.

13/55 Okno pomiaru (window)
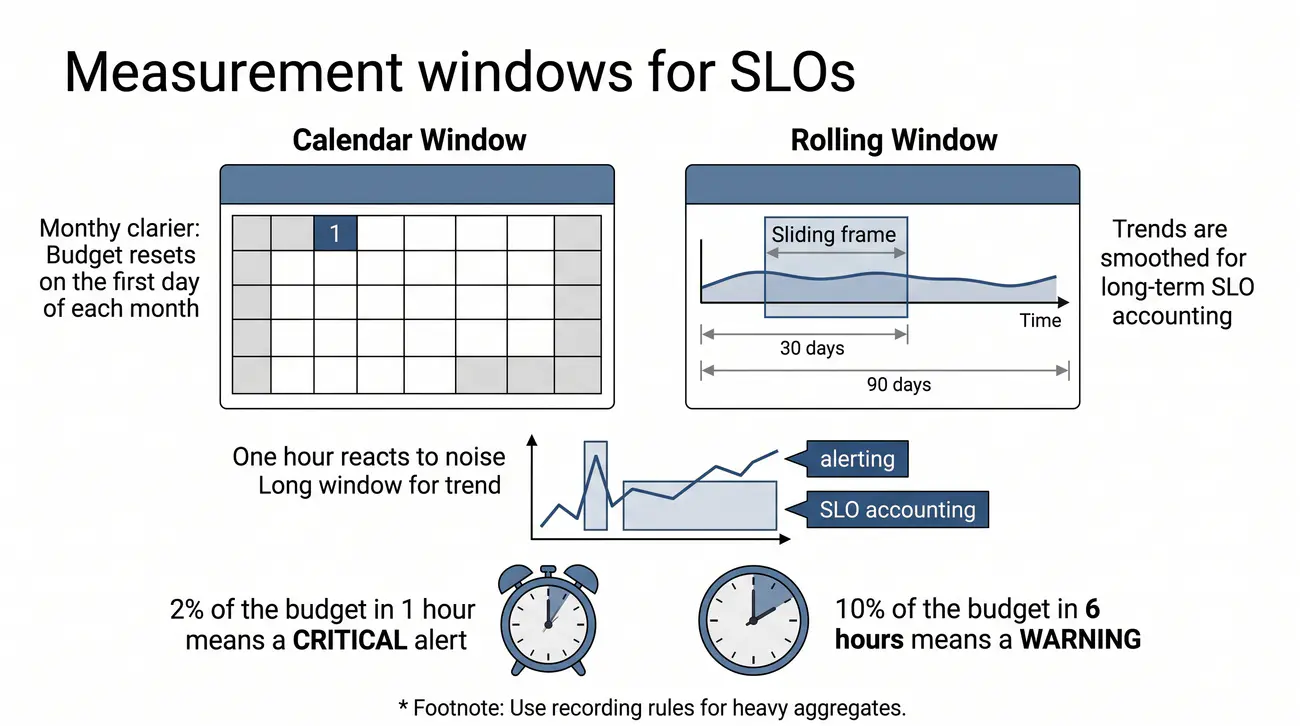
Burn rate - tempo spływania error budget. Multi-window: fast burn (2% w 1h → CRITICAL), slow burn (10% w 6h → WARNING).

To samo SLO w krótkim i długim oknie znaczy co innego: krótkie woła o pomoc, długie rozlicza.

  • Ruchome okno pomiarowe (Rolling Window) – standardowy okres analizy obejmuje ostatnie 30 dni, zapewniając ciągłą ocenę stabilności usługi.
  • Wady sztywnego okna kalendarzowego – resetowanie pomiarów pierwszego dnia miesiąca zniekształca ocenę i prowokuje ryzykowne wdrożenia.
  • Dobór długości przedziału czasowego – okno 30-dniowe służy do planowania prac, natomiast okna krótkie (1h i 6h) wyzwalają alarmy operacyjne.
  • Zjawisko zapominania awarii – po upływie 30 dni dawna awaria opuszcza okno pomiarowe, co odnawia dostępny budżet błędów w systemie.
  • Spójność raportowania – wszystkie usługi w organizacji powinny stosować ujednolicony standard okna pomiarowego dla przejrzystości audytu.
Burn rate: Tempo zużywania budżetu błędów; wariant wielookienkowy rozróżnia szybkie spalanie (np. 2% w godzinę → alert krytyczny) od wolnego (np. 10% w 6 godzin → ostrzeżenie).
okno czasowe SLO

Zasady dynamiki budżetu błędów i wskaźnika Burn Rate definiuje kanon inżynierii niezawodności Google SRE.

Okno pomiarowe (evaluation window) to przedział czasu, w którym agreguje się SLI i porównuje do SLO; jego długość i typ fundamentalnie zmieniają interpretację - krótkie okno jest reaktywne i czułe na szum, długie stabilne i biznesowo uziemione. Standardem jest 30-dniowe rolling window (zamiast kalendarzowego), a agregaty PromQL oblicza się przez recording rules.

Okno kalendarzowe vs rolling: Okno kalendarzowe = ustalone granice (np. 1-31 stycznia, kwartał kalendarzowy). Zaleta: aligned z billingiem, raportowaniem SLA, finansami. Wada: "resetuje" budżet błędu 1. dnia miesiąca - incydent 31 stycznia nie wpływa na styczeń. Rolling window (sliding window) = każdy moment ma swoje 30 dni wstecz (np. "ostatnie 30 dni od teraz"). Zaleta: ciągła ewaluacja, wygładza skoki (spikes), nie ma artefaktu resetu. Wada: trudniejsze do raportowania miesięcznego. SLO standardowo = 30d rolling; SLA raportowanie = calendar month.

Wpływ długości okna na interpretację: Krótkie okno (1h, 6h) jest reaktywne i czułe - każdy mały incydent drastycznie zmienia SLI, dlatego sprawdza się w alertingu (burn rate), a nie w rozliczaniu SLO (szum). Długie okno (30d, 90d) jest stabilne i zorientowane biznesowo - pojedynczy incydent trwający 30 minut widać wtedy jako niewielkie zgrubienie na wykresie, a liczba odzwierciedla trendy. SLO zazwyczaj 30d rolling = złoty środek: wystarczająco długie by wygładzić szum, wystarczająco krótkie by reagować na trwałe degradacje. Dla batch jobs bywa 90d (kwartał).

Rolling window - sliding time window: Mechanicznie: w każdym momencie t bierzemy przedział [t-30d, t]. Kiedy minie godzina, okno "przesuwa się" o godzinę. To oznacza: incydent z 29 dni temu wciąż wpływa na SLI; incydent z 31 dni temu przestaje wpływać. Budżet błędu nie "resetuje się" 1. dnia miesiąca - to ciągła funkcja czasu. To eliminuje podgrywanie datami (np. ryzykowny deployment planowany na 30. dzień miesiąca, bo "budżet i tak zresetuje się jutro").

Agregaty w praktyce - PromQL i Recording Rules: Obliczenie SLI w oknie 30d na surowych danych to heavy query (miliony próbek). Rozwiązanie: Recording Rules - pre-agregacja co np. 1 minuta. Przykład: `sli:availability:ratio_30d = avg_over_time(job:sli:availability:ratio[30d])`. Recording rule oblicza to w tle, a alerty/dashboards query'ują gotowy wynik (szybko, tanio). `promtool check rules` waliduje składnię. To standard produkcyjny - nie rob heavy queries w alertach ani dashboardach.

Terminologia: rolling window (okno przesuwne/sliding), evaluation period (okres ewaluacji), calendar window (okno kalendarzowe), recording rules (reguły rejestrujące/wstępnie agregujące), SLI compliance (zgodność SLI z SLO), time series aggregation (agregacja szeregów czasowych).

Cele SLO rozliczamy w konkretnym oknie czasowym, a jego długość i typ fundamentalnie zmieniają interpretację wyników. Krótkie okno, na przykład godzina czy sześć godzin, jest czułe na szum i dlatego służy przede wszystkim alertowaniu - to tu sprawdza się tempo spływania budżetu, czyli burn rate, mierzone w wariancie wielookienkowym: szybkie spalanie w godzinę uruchamia alert krytyczny, wolniejsze w sześć godzin - ostrzeżenie. Długie okno, trzydzieści czy dziewięćdziesiąt dni, wygładza pojedyncze incydenty i stanowi podstawę rozliczania SLO.

Warto też pamiętać, czym różni się okno kalendarzowe od przesuwnego. Okno kalendarzowe dziwnie „resetuje" budżet pierwszego dnia miesiąca, co zachęca do grania datami; okno rolling, liczące zawsze ostatnie trzydzieści dni, jest ciągłe i uczciwe - incydent sprzed dwudziestu dziewięciu dni wciąż się liczy, a sprzed trzydziestu dwóch już nie. Ciężkie agregaty wyliczane dla takich okien prekomputuje się w regułach nagrywających.

Wyjaśnienie skrótów użytych na slajdzie:
UTC – Coordinated Universal Time – uniwersalny czas koordynowany; Międzynarodowy standard czasu stosowany w systemach teleinformatycznych w celu uniknięcia anomalii stref czasowych.
ISO – International Organization for Standardization – Międzynarodowa Organizacja Normalizacyjna; Globalna federacja krajowych instytucji normalizacyjnych opracowująca standardy techniczne.
KPI – Key Performance Indicator – kluczowy wskaźnik wydajności; Parametr ilościowy mierzący realizację założeń w określonych interwałach sprawozdawczych.
SLA – Service Level Agreement – umowa o poziomie usług; Kontrakt rozliczany w ujęciu kalendarzowym (miesięcznym lub kwartalnym).
SLO – Service Level Objective – cel poziomu usług; Wskaźnik najczęściej mierzony w oknach kroczących (rolling windows), eliminujących wady resetu kalendarzowego.

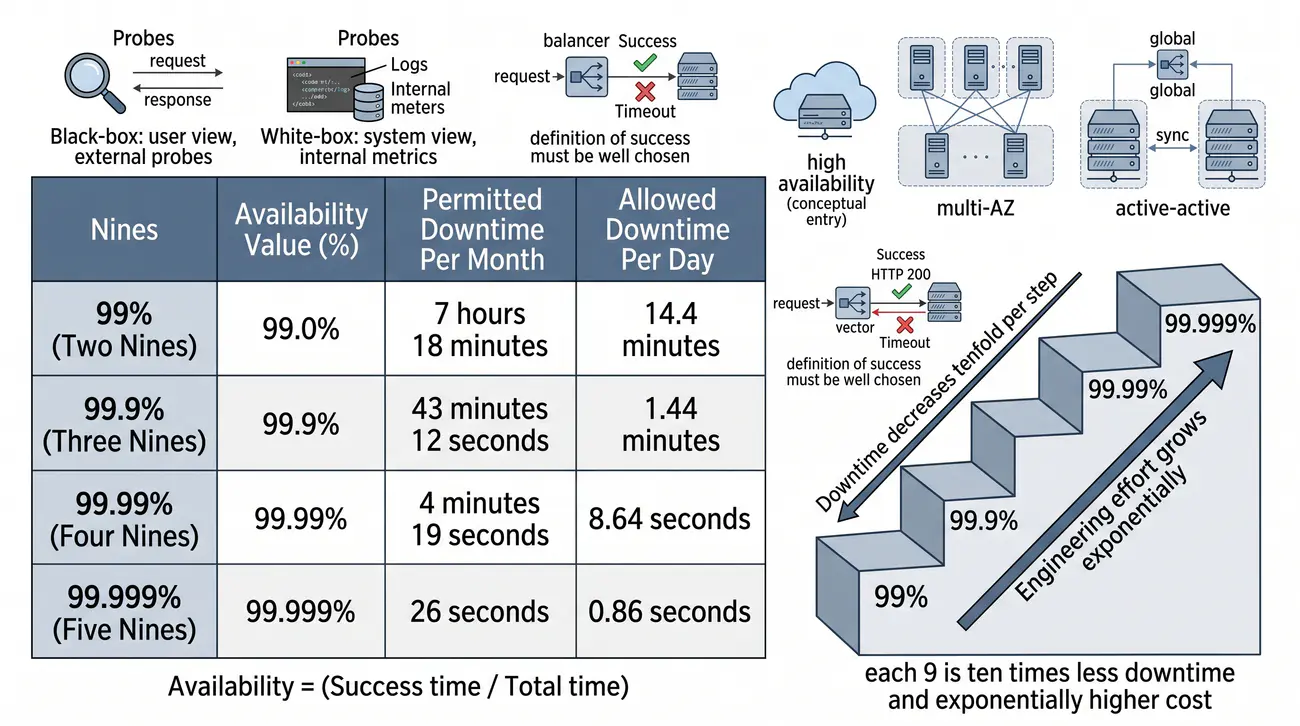
14/55 Mierzenie dostępności
Saturation (nasycenie) - miara wykorzystania zasobów: CPU, RAM, dysk, sieć, pool połączeń. USE method: Utilization, Saturation, Errors.

Dostępność to czas sukcesu przez czas obserwacji - ale najpierw ustal, co liczysz jako sukces.

  • Podejście czasowe a zapytaniowe – tradycyjny czas sprawności (uptime) zastępuje się w SRE odsetkiem poprawnie obsłużonych zapytań (good requests).
  • Wypaczenia pomiaru czasowego – pięciominutowa awaria w nocy przynosi znikome szkody, podczas gdy ta sama usterka w południe paraliżuje tysiące klientów.
  • Matematyczna formuła dostępności – wskaźnik dostępności definiuje się jako iloraz liczby zapytań zakończonych sukcesem do wszystkich wywołań.
  • Uwzględnienie zapytań powolnych – żądania przekraczające zdefiniowany próg latencji (np. 2 sekundy) traktuje się w formule jako błędy.
  • Normy jakości oprogramowania – definicje dostępności i niezawodności systemów opierają się na międzynarodowej normie PN-EN ISO/IEC 25010.
Metoda USE: Sprawdzanie zasobów przez pryzmat wykorzystania (utilization), nasycenia (saturation) i błędów (errors); dotyczy CPU, pamięci, dysków, sieci i pul połączeń.
tabela dostępności 9-tki

Definicje charakterystyk jakościowych oprogramowania i usług teleinformatycznych normuje PKN (norma PN-EN ISO/IEC 25010).

Dostępność (availability) to najbardziej fundamentalne SLI, a jej pomiar ma konkretne zasady: uptime liczy czas, gdy usługa zwraca sukces, w stosunku do całkowitego czasu obserwacji. Tabela "nines" (99%, 99.9%, 99.99%, 99.999%) przelicza się na minuty downtime miesięcznie, koszt każdego kolejnego "9" rośnie wykładniczo, a perspektywy pomiaru to blackbox (użytkownik) i whitebox (system).

Definicja uptime: Uptime = czas, gdy usługa zwraca sukces / całkowity czas obserwacji. Co to "sukces"? Zależy od definicji SLI. Najczęściej: HTTP 2xx/3xx (redirecty traktowane jako sukces). Kluczowe rozróżnienie: Blackbox monitoring (z zewnątrz, syntetyczne testy) - perspektywa użytkownika: "czy mogę się dobrać do usługi?". Whitebox monitoring (wewnętrzne, metryki aplikacji) - perspektywa systemu: "czy usługa wewnętrznie jest zdrowa?". Obie definicje success mogą się różnić (np. load balancer zwraca 200, ale backend timeout). Definicja success = kluczowa dla poprawności SLI.

Tabela "nines" - dopuszczalny downtime miesięcznie (30 dni = 43 200 minut): 99% (two nines) = 7 h 18 min downtime/miesiąc (akceptowalne dla batch/internal tools). 99.9% (three nines) = 43 min 12 s (standard dla większości user-facing services). 99.99% (four nines) = 4 min 19 s (wymaga HA, multi-AZ, auto-failover). 99.999% (five nines) = 26 s (extreme, wymaga special architecture: active-active, chaos testing, zero-downtime deployments). 99.9999% (six nines) = 2.6 s (praktycznie niemożliwe bez ogromnych nakładów). Każde "9" = 10x mniej downtime, ale koszt rośnie wykładniczo.

Zależność dopuszczalnych przerw od "nines": Im wyższe "9", tym krótsze dozwolone przerwy i tym bardziej wywodzą one się z architektury, a nie z "pilnowania". 99% = może być pojedynczy serwer z restartem w nocy. 99.9% = HA para (active-passive), auto-failover < 1 min. 99.99% = multi-AZ, active-active, zero-downtime deployments, chaos engineering. 99.999% = geographic redundancy, formalna weryfikacja, budżet inżynieryjny liczony w milionach. Wybór "nines" to decyzja ekonomiczna: ile biznes gotów zapłacić za redukcję downtime z 43 min na 4 min?

Blackbox vs Whitebox monitoring: Blackbox = syntetyczne testy z perspektywy klienta (HTTP GET /health z zewnątrz, DNS lookup, TCP connect). Mówi: "czy user widzi usługę?". Whitebox = wewnętrzne metryki (Prometheus scrape `/metrics`, application health checks). Mówi: "czy system wewnętrznie jest zdrowy?". Obie potrzebne: Blackbox wykrywa problemy sieciowe, DNS, load balancer - Whitebox nie widzi. Whitebox wykrywa degradację (latency↑, saturation↑) przed awarią - Blackbox widzi tylko up/down. Pełny obraz = oba.

Terminologia: uptime (czas działania), downtime (czas przestoju), availability (dostępność), nines (szóstki/dziewiątki - liczba dziewiątek), SLA tier (poziom SLA), MTBF (Mean Time Between Failures), MTTR (Mean Time To Recovery), blackbox/whitebox monitoring (monitoring czarnej/białej skrzynki).

Dostępność to najbardziej fundamentalny spośród wszystkich wskaźników SLI, a jej pomiar rządzi się konkretnymi zasadami. Najprościej ujmuje się ją jako stosunek czasu, w którym usługa zwraca sukces, do całkowitego czasu obserwacji - ale właśnie definicja „sukcesu" decyduje o poprawności całego wskaźnika. Zwykle chodzi o odpowiedzi HTTP 2xx lub 3xx, a obsługują ją dwa spojrzenia: blackbox, czyli syntetyczny test z perspektywy użytkownika, oraz whitebox, czyli wewnętrzne metryki z perspektywy systemu.

Konkrety przelicza się na minuty. Dziewięćdziesiąt dziewięć procent dostępności to ponad siedem godzin przestoju miesięcznie; 99,9 procent to około 43 minuty; 99,99 procent - już tylko cztery minuty; przy 99,999 procent zostaje 26 sekund. Widać tu dwie rzeczy: każde kolejne „9" to dziesięć razy mniej dozwolonego przestoju, ale i wykładniczo wyższy koszt, bo wyższych poziomów nie osiąga się „pilnowaniem", tylko architekturą - parą HA, wielostrefowością czy aktywną-aktywną obsługą ruchu.

Wyjaśnienie skrótów użytych na slajdzie:
DNS – Domain Name System – system nazw domenowych; Fundament komunikacji internetowej tłumaczący nazwy domen na adresy protokołu sieciowego.
ICMP – Internet Control Message Protocol – protokół komunikatów sterujących w Internecie; Protokół diagnostyczny warstwy sieciowej używany m.in. przez programy ping i traceroute.
TCP – Transmission Control Protocol – protokół sterowania transmisją; Niezawodny protokół strumieniowy realizujący trójstopniowy uścisk dłoni (three-way handshake).
HTTP – Hypertext Transfer Protocol – protokół przesyłania dokumentów hipertekstowych; Podstawa komunikacji sieciowej, w której kody 2xx i 3xx oznaczają poprawną obsługę żądania.
IP – Internet Protocol – protokół internetowy; Protokół warstwy sieciowej odpowiedzialny za adresowanie i trasowanie pakietów w sieciach komputerowych.

15/55 Systemy zbierania metryk
Scrape - Prometheus pyta targety o metryki (pull model). Interval: domyślnie 1 min (często konfigurowane jako 15s). Target = endpoint udostępniający metryki w formacie Prometheus.

Prometheus sam pyta cele o metryki (pull), eksportery mu je podają, a baza TSDB je składuje.

  • Ewolucja systemów monitoringu – tradycyjne narzędzia badające wyłącznie stan hostów zastąpiono bazami szeregów czasowych z elastycznymi etykietami.
  • Model pobierania danych (Pull) – serwer monitoringu sam odpytuje zdefiniowane cele, co ułatwia wykrywanie całkowitej niedostępności maszyn.
  • Model wypychania danych (Push) – agenci wysyłają metryki do centralnego serwera; wzorzec stosowany głównie przy krótkotrwałych zadaniach wsadowych.
  • Standaryzacja OpenMetrics – jednolity format wymiany danych telemetrycznych umożliwia współpracę narzędzi od różnych dostawców.
  • Kluczowe kryteria wyboru systemu – wydajność silnika bazy, elastyczność języka zapytań oraz odporność na awarie decydują o stabilności monitoringu.
Target: Endpoint udostępniający metryki w formacie Prometheus, aktywnie odpytwany przez serwer w modelu pull w ustalonym interwale.
przepływ metryk

Model pull zbierania metryk (Prometheus) ma jasną architekturę: dane płyną od aplikacji i infrastruktury do centralnej bazy szeregów czasowych (TSDB). Eksportery pełnią rolę adapterów, node_exporter zbiera metryki OS, a centralna TSDB działa jako silnik przechowywania i zapytań - to dlatego Prometheus "widzi" świat tak, a nie inaczej, i dlaczego pull model ma przewagi operacyjne przy skali.

Pull model (Prometheus): Serwer Prometheus aktywnie pyta (scrape) targety o metryki w zdefiniowanym interwale (np. co 15s). Serwer kontroluje: KIEDY scrapować (interwał), CO scrapować (które metryki/labeli), i SKĄD (service discovery). Zalety: brak otwierania portów na targetach (firewall friendly - target nie musi przyjmować połączeń, serwer się do niego łączy), centralna kontrola konfiguracji, łatwiejsze debugowanie (scrape timeout/failure widoczne po stronie serwera). Wada: targety muszą być osiągalne z sieci serwera (wymaga network reachability).

Exporters (eksportów): Procesy (sidecar/daemon) które EKSPONUJĄ metryki w formacie Prometheus na endpointzie `/metrics`. Tłumaczą natywne formaty (JMX, SNMP, SQL, custom API) na Prometheus exposition format. Standardowe: node_exporter (OS: CPU, RAM, dysk, sieć), blackbox_exporter (syntetyczne testy HTTP/TCP/DNS/ICMP), mysqld_exporter, redis_exporter, postgres_exporter, itd. Custom app metrics: aplikacja sama eksponuje `/metrics` przez client library. Wszystkie exporters = standardizowany format, łatwe dodawanie nowych targetów.

Agent na maszynie: Proces uruchomiony na każdej maszynie (VM, bare metal, Kubernetes node). node_exporter (host metrics: CPU, mem, dysk, sieć, filesystem, systemd), cAdvisor (container metrics: per-container CPU, mem, net, I/O), process_exporter (per-process metrics). Cechy: single binary, minimalny overhead (<10MB RAM), zero-config (mostly), auto-discovery w Kubernetes (DaemonSet). To "oczy i uszy" Prometheus na hoście.

Centralna baza (TSDB - Time Series Database): Prometheus ma wbudowaną TSDB. Struktura: Head block (w RAM, ostatnie ~2h, mutable) + compacted blocks (na dysku, immutable, skompresowane). WAL (Write Ahead Log) dla durability - crash recovery via WAL replay. Retencja domyślna 15 dni (`--storage.tsdb.retention.time=15d`), kompresja Gorilla (~1.3 bytes/sample vs 16 bytes raw). Dla long-term storage: remote write do Thanos/Cortex/Mimir/S3. TSDB to silnik - szybkie zapytania, kompresja, retencja.

Terminologia: pull model (model ściągania), exporter (eksporter), agent (agent), TSDB (Time Series Database), scrape (pobieranie metryk), service discovery (odnajdowanie usług), remote write (zdalne zapisywanie), retention (retencja), service discovery types (k8s_sd, ec2_sd, consul_sd, file_sd).

Czas przejść do świata Prometheusa i zobaczyć, jak metryki faktycznie trafiają do bazy. Model pull zakłada, że to serwer Prometheus aktywnie pyta targety o metryki w ustalonym interwale - domyślnie co minutę (często konfigurowane jako 15 s) - a target to po prostu endpoint udostępniający dane w formacie Prometheus. Taki układ daje serwerowi pełną kontrolę: sam decyduje, kiedy i co zbierać, a target nie musi otwierać portów na połączenia przychodzące, co jest wygodne z punktu widzenia firewalli.

Skąd jednak biorą się same metryki? Często z eksporterów - lekkich procesów, które tłumaczą natywne źródła (system operacyjny, bazy danych, urządzenia sieciowe) na format metryk. Najbardziej znany jest node_exporter, agent działający na każdej maszynie, który pełni rolę „oczu i uszu" Prometheusa. Zebrane dane trafiają do wbudowanej bazy szeregów czasowych TSDB, działającej według schematu: aktywny blok nadrzędny w pamięci RAM, skompresowane bloki na dysku, dziennik zapisu z wyprzedzeniem i limit retencji.

Wyjaśnienie skrótów użytych na slajdzie:
REST – Representational State Transfer – styl architektury REST; Standard komunikacji bazujący na protokole HTTP i reprezentacji zasobów za pomocą formatów JSON lub XML.
OS – Operating System – system operacyjny; Podstawowe oprogramowanie zarządzające zasobami sprzętowymi i środowiskiem wykonawczym procesów.
CPU – Central Processing Unit – procesor; Jednostka centralna generująca kluczowe wskaźniki utylizacji, nasycenia i przełączania kontekstu.
RAM – Random Access Memory – pamięć operacyjna; Zasób podlegający stałemu pomiarowi pod kątem alokacji buforów, pamięci podręcznej i stron anonimowych.
IOPS – Input/Output Operations Per Second – liczba operacji wejścia/wyjścia na sekundę; Fundamentalna metryka wydajności podsystemu pamięci masowej określająca szybkość odczytu i zapisu.

16/55 Wprowadzenie do Prometheus
PromQL - język zapytań Prometheus; przykłady: rate(), histogram_quantile(), sum by(), irate().

Prometheus to cały stos: zbieranie, język zapytań, alerty i wizualizacja w jednym.

  • Geneza projektu Prometheus – system powstał w firmie SoundCloud, stając się flagowym projektem fundacji Cloud Native Computing Foundation (CNCF).
  • Architektura autonomicznego węzła – pojedynczy serwer Prometheus łączy zbieranie danych, bazę TSDB i silnik reguł, działając bez zewnętrznych baz.
  • Własny język zapytań (PromQL) – wyspecjalizowany język pozwala na agregację metryk, liczenie pochodnych oraz wyliczanie percentyli w locie.
  • Wbudowany mechanizm Service Discovery – system automatycznie wykrywa nowe kontenery i maszyny w środowiskach Kubernetes i chmurach publicznych.
  • Podstawowy protokół HTTP – komunikacja odbywa się przez standardowy protokół HTTP, a metryki są udostępniane w czytelnym formacie tekstowym.
PromQL: Funkcyjny język zapytań Prometheusa operujący na wektorach czasowych; funkcje tempa i percentyli przyjmują wyłącznie wektory zakresowe z oknem czasu.
architektura Prometheus

Szczegółową dokumentację składni oraz funkcji agregujących zawiera oficjalna dokumentacja podstaw języka zapytań PromQL.

Dlaczego Prometheus stawia na model Pull: Większość tradycyjnych narzędzi monitoringu działała w modelu Push (agenci wysyłali dane na centralny serwer). Prometheus zrewolucjonizował ten obszar, przyjmując model Pull (serwer sam odpytuje aplikacje). Główną zaletą podejścia Pull jest natychmiastowe wykrywanie całkowitego „padu” usługi: jeśli aplikacja nie odpowiada na zapytanie HTTP pod adresem /metrics, serwer od razu rejestruje stan DOWN. W modelu Push zamilknięcie agenta bywa mylone z brakiem zdarzeń lub problemami sieciowymi. Ponadto model Pull chroni serwer monitoringu przed zalaniem danymi w przypadku gwałtownego skoku ruchu.

Prometheus to kompletny stack monitoringu: model zbierania (pull), język zapytań (PromQL), alertowanie (Alertmanager) i wizualizacja (Grafana). Każdy komponent ma jasną odpowiedzialność i oddzielny cykl życia (separation of concerns): pull model skaluje, PromQL operuje na wektorach i funkcjach czasowych, Alertmanager eliminuje alert fatigue, a Grafana buduje unified observability stack.

Pull model: Prometheus Server sam decyduje, KIEDY i CO scrapować, na podstawie `scrape_configs` w konfiguracji. Serwer inicjuje połączenie do targetów (HTTP GET `/metrics`). Zalety: pełna kontrola nad interwałem i zbiorem targetów, service discovery (automatyczne wykrywanie nowych instancji), brak konieczności otwierania portów na targetach (firewall friendly), brak single point of failure po stronie targetów (target nie musi być "serverem"). Dla batch jobs (krótkotrwałe zadania) istnieje Pushgateway - target pushuje metryki do Pushgateway, Prometheus scrapuje Pushgateway. Model scalable i reliable.

PromQL (Prometheus Query Language): Funkcjonalny, deklaratywny język zapytań do szeregów czasowych. Kluczowe cechy: Selekcja metryki po nazwie i etykietach (`http_requests_total{job="api",method="GET"}`), filtrowanie label matchers (`=`, `!=`, `=~` regex, `!~`), agregacje (`sum`, `avg`, `max`, `min`, `count`, `stddev`, `topk`, `bottomk` z `by`/`without`), funkcje czasowe (`rate`, `increase`, `histogram_quantile`, `delta`, `deriv`). Dwa typy wektorów: instant vector (wartość w punktach czasowych "teraz") i range vector (serie w oknie czasu `[5m]`). Vector-based = operacje na całych seriach, nie punktach.

Alerting: Rozdzielenie obliczeń (Prometheus) od routingu/dostarczania (Alertmanager). Prometheus: `alerting rules` (warunek `expr`, `for` duration, `labels`, `annotations`) + `recording rules` (pre-compute ciężkich zapytań). Alertmanager: deduplikacja (grupowanie alertów tego samego problemu), grupowanie (routing po labelach), inhibition (ciszenie jednego alertu przez inny), silencing (wyciszenie na czas), routing tree → receivers (Slack, email, PagerDuty, webhook, OpsGenie). Separation of concerns = niezawodne alertowanie.

Integracja z Grafana: Grafana = warstwa wizualizacji. Data source: Prometheus (URL `http://prometheus:9090`, proxy mode). Dashboards (JSON, provisioning), Panels (time series, stat, gauge, table, logs, trace), Variables (dynamiczne filtry), Annotations (zdarzenia na wykresie), Explore (ad-hoc query), Alerting v2 (własne alerty Grafany). Unified observability stack: metrics (Prometheus) + logs (Loki) + traces (Tempo) w jednym UI. To standard w ekosystemie CNCF/Grafana Labs.

Terminologia: metrics scraping (pobieranie metryk), TSDB (Time Series Database), PromQL (Prometheus Query Language), Alertmanager (menedżer alertów), service discovery (odnajdowanie usług), Pushgateway (bramka push dla batch jobs), remote write (zdalne zapisywanie do long-term storage), remote read (zdalne czytanie z long-term storage).

Po co sięgamy właśnie po Prometheus? Bo to kompletny stack monitoringu: model zbierania metryk, własny język zapytań, system alertów i pełna integracja z wizualizacją. Sercem podejścia jest wspomniany model pull - serwer sam inicjuje połączenie do targetów, kontroluje interwał i listę celów, a dzięki wykrywaniu usług nie wymaga ręcznego wpisywania nowych adresów przy każdej zmianie infrastruktury.

Do analizy danych służy PromQL, funkcyjny język zapytań operujący na wektorach czasowych - pozwala wybierać serie po etykietach, agregować je za pomocą sum czy średnich oraz przeliczać tempo zmian funkcjami takimi jak rate. Na alerting składa się podział ról: Prometheus oblicza reguły, a Alertmanager zajmuje się deduplikacją i routingiem powiadomień. To wszystko spina Grafana, która w jednym interfejsie łączy metryki, logi i tracing.

Wyjaśnienie skrótów użytych na slajdzie:
CNCF – Cloud Native Computing Foundation – Fundacja Oprogramowania Chmurowego; Organizacja open-source nadzorująca i wspierająca rozwój ekosystemu Cloud Native, w tym Prometheusa.
TSDB – Time Series Database – baza danych szeregów czasowych; Autorski, zoptymalizowany silnik bazodanowy wbudowany w serwer Prometheus.
PromQL – Prometheus Query Language – język zapytań Prometheus; Deklaratywny język zapytań zaprojektowany specjalnie do analizy danych wielowymiarowych.
HTTP – Hypertext Transfer Protocol – protokół przesyłania dokumentów hipertekstowych; Protokół używany przez serwer Prometheus do okresowego pobierania danych w modelu pull.
URL – Uniform Resource Locator – lokalizator zasobu; Ścieżka sieciowa (najczęściej /metrics) udostępniająca próbki telemetryczne w formacie tekstowym.

17/55 Architektura Prometheus
Scrape - Prometheus pyta targety o metryki (pull model). Interval: domyślnie 1 min (często konfigurowane jako 15s). Target = endpoint udostępniający metryki w formacie Prometheus.

Cztery klocki Prometheusa: cele, eksportery, Alertmanager i interfejs. Wiedz, gdzie czego szukać.

  • Komponenty składowe platformy – serwer Prometheus współpracuje z eksporterami danych, komponentem Alertmanager oraz interfejsem Grafana.
  • Baza szeregów czasowych (TSDB) – wysoce zoptymalizowany silnik dyskowy kompresuje próbki liczbowe w dwugodzinne bloki danych.
  • Mechanizm pobierania próbek (Scraper) – moduł pobierający cyklicznie odczytuje endpointy /metrics zgodnie z zadanym interwałem.
  • Rozdzielenie alertingu od powiadomień – Prometheus wylicza warunki alarmowe, a ich grupowanie, wyciszanie i wysyłkę realizuje Alertmanager.
  • Niezależność od infrastruktury monitorowanej – serwer monitoringu powinien działać na wydzielonych zasobach, aby przetrwać awarię aplikacji.
Service discovery: Wykrywanie usług, dzięki któremu Prometheus sam odnajduje nowe targety bez ręcznego wpisywania adresów przy każdej zmianie infrastruktury.
schemat architektury

Architektura Prometheus dzieli się na cztery komponenty: Scrape Targets (skąd dane), Exporters (jak dane są eksponowane), Alertmanager (jak alerty są przetwarzane) oraz Web UI + PromQL (jak dane są eksplorowane). Każdy ma własną konfigurację, tryby pracy i punkty awaryjności, co warunkuje skuteczny troubleshooting (dlaczego target jest DOWN?), skalowanie (jak dodać 1000 targetów?) i operowanie (jak zdiagnozować problem z TSDB?).

Scrape Targets (cele scrapowania): Endpointy `/metrics`, które Prometheus cyklicznie pyta. Konfiguracja w `scrape_configs`: static_configs (ręczna lista IP:port), file_sd (pliki JSON/YAML obserwowane przez Prometheus), consul_sd/kubernetes_sd/ec2_sd (automatyczne discovery z systemów orkiestracji/chmury). Relabeling: transformacja etykiet przed operacją scrape (np. dodanie `environment=prod`, usunięcie wrażliwych labeli, zmiana nazwy metryki). Health check: metryka `up{job="..."}` = 1 (scrape OK) / 0 (scrape failed) - fundament alertingu na dostępność targetu.

Exporters: Procesy, które tłumaczą natywne formaty na Prometheus exposition format (`/metrics`). Klasyfikacja: Systemowe - node_exporter (OS), cAdvisor (kontenery); Syntetyczne - blackbox_exporter (HTTP/TCP/DNS/ICMP probes); Aplikacyjne - client libraries (client_golang `promhttp.Handler()`, python_client `prometheus_client`, Java JMX + jmx_exporter); Legacy - sidecar pattern (exporter jako sidecar container obok aplikacji, który scrapuje lokalny port/JMX i eksponuje `/metrics`). Każdy exporter = oddzielny proces, niezależny cykl życia.

Alertmanager: Oddzielny proces (nie wbudowany w Prometheus Server!). Odbiera alerty z Prometheus (HTTP POST `/api/v1/alerts`). Funkcje: Deduplication (ten sam alert z wielu replik Prometheus HA = jeden alert), Grouping (grupowanie alertów po labelach, np. `cluster`, `alertname`), Inhibition (ciszenie alertu "DiskFull" gdy fires "DiskAlmostFull"), Silencing (wyciszenie na czas, np. maintenance window), Routing tree (drzewo routingu do receiverów), HA mode (gossip protocol między instancjami Alertmanager). Single source of truth dla alertów - Prometheus tylko generuje, Alertmanager zarządza.

Web UI + PromQL: Interfejs na porcie 9090. `/graph` - query editor (PromQL), wykres (Graph), tabela (Console), range selector (1h/6h/1d/7d/30d). `/targets` - stan wszystkich targetów (UP/DOWN, labels, last scrape, error). `/rules` - alerting rules i recording rules (stan, ewaluacja). `/alerts` - firing alerts (przed Alertmanager). Debugging i exploration: `query` API, `series` API, `label/__name__` API. UI to narzędzie operacyjne codzienne, nie tylko demo.

Terminologia: scrape target (cel scrapowania), TSDB (Time Series Database), Alertmanager, relabeling (przekładanie etykiet), service discovery (odnajdowanie usług), recording rules (reguły rejestrujące/wstępnie agregujące), alerting rules (reguły alertujące), up metric (metryka dostępności targetu).

Całą architekturę Prometheusa można podzielić na cztery obszary: cele scrapowania, czyli źródła danych, eksportery, które udostępniają metryki, Alertmanager, czyli drugi człon systemu alertowego, oraz interfejs webowy z PromQL do eksploracji danych. Zrozumienie tej struktury ma praktyczne znaczenie - dzięki niej wiadomo, gdzie szukać przyczyny, gdy cel znika z listy targetów, jak dołączyć kolejne tysiąc maszyn albo gdzie zajrzeć, gdy baza danych zaczyna się zachowywać dziwnie.

Cele scrapowania konfigurujemy statycznie albo przez wykrywanie usług, a eksportery dzielimy na systemowe, syntetyczne i aplikacyjne. Alertmanager, działający jako osobny proces, nie tylko przyjmuje alerty, ale też deduplikuje je, grupuje, potrafi tłumić jedne przez drugie i prowadzić drzewo routingu do konkretnych adresatów. Wszystko to ogląda się potem na porcie 9090 - w zakładkach graph, targets, rules i alerts.

Wyjaśnienie skrótów użytych na slajdzie:
TSDB – Time Series Database – baza danych szeregów czasowych; Komponent serwera Prometheus odpowiadający za indeksowanie i trwałe składowanie próbek.
WAL – Write-Ahead Log – dziennik zapisu z wyprzedzeniem; Mechanizm transakcyjny chroniący dane w pamięci RAM przed utratą w przypadku nagłej awarii zasilania.
K8s – Kubernetes – platforma Kubernetes; System orkiestracji kontenerów udostępniający API dynamicznego wykrywania celów monitoringu (Service Discovery).
AWS – Amazon Web Services – chmura Amazon Web Services; Platforma usług chmurowych zintegrowana z mechanizmami autoodkrywania instancji serwerowych.
EC2 – Elastic Compute Cloud – elastyczna chmura obliczeniowa; Usługa maszyn wirtualnych w chmurze AWS stanowiąca częsty cel automatycznego scrapingu.

18/55 Format danych: rodzaje metryk w Prometheus
Gauge - wartość mogąca rosnąć i spaść (snapshot stanu). Nie używaj rate() - do zmiany w czasie użyj deriv().

Cztery typy metryk i cztery semantyki. Pomyłka (licznik jako gauge) psuje tempo i alerty.

  • Struktura metryki w Prometheus – rekord składa się z nazwy, zestawu etykiet w nawiasach klamrowych, wartości zmiennoprzecinkowej oraz znacznika czasu.
  • Zastosowanie typu Counter – licznik służy do rejestracji sumarycznej liczby obsłużonych żądań, przetworzonych bajtów oraz wystąpień błędów.
  • Zastosowanie typu Gauge – wskaźnik odzwierciedla zmienne stany chwilowe, takie jak liczba aktywnych wątków, temperatura czy zajętość pamięci RAM.
  • Zastosowanie typu Histogram – przedziałowa rejestracja wartości umożliwia precyzyjną analizę rozkładu opóźnień i rozmiarów zapytań w klastrze.
  • Zasady nazewnictwa metryk – nazwa powinna zawierać jednostkę bazową (np. _seconds, _bytes) oraz sufiks określający typ danych.
Gauge (miernik): Migawka stanu mogąca rosnąć i opadać; do analizy zmian w czasie nie służy rate(), lecz deriv().
przykłady metryk

System Prometheus obsługuje cztery fundamentalne typy danych:
- Counter (licznik): monotonicznie rosnąca wartość resetowana przy restarcie procesu; do badania dynamiki przyrostu należy bezwzględnie stosować funkcję rate() lub irate(),
- Gauge (miernik): wartość chwilowa podlegająca dowolnym wahaniom w górę i w dół (np. zużycie pamięci, liczba wątków); do badania trendu stosuje się funkcję pochodnej deriv(),
- Histogram: zlicza obserwacje w zdefiniowanych progach (koszykach) oraz sumę wartości, umożliwiając wyliczanie percentyli po stronie serwera zapytań,
- Summary: wylicza konfigurowalne kwantyle bezpośrednio w bibliotece klienckiej, uniemożliwiając ich późniejszą agregację przestrzenną między instancjami.

Counter, Gauge, Histogram i Summary - cztery typy metryk Prometheus - mają własną semantykę, dozwolone operacje PromQL i typowe zastosowania. Błędny dobór typu (np. Gauge zamiast Counter dla licznika żądań) uniemożliwia poprawne obliczenie rate() i psuje alerty; etykiety (labels) dają Prometheus "supermoce", ale bywają źródłem problemów (cardinality explosion).

Counter (Licznik): Monotonicznie rosnąca wartość - nigdy nie maleje (poza resetem przy restarcie procesu). Przykłady: `http_requests_total`, `node_cpu_seconds_total`. Operacja kluczowa: `rate(counter[5m])` = wartość na sekundę (np. RPS). Prometheus automatycznie obsługuje resety (wykrywa spadek wartości i traktuje jako restart). Uwaga: funkcja `rate()` jest przeznaczona wyłącznie dla liczników; wywołanie `rate(gauge)` zwraca błędne wyniki. Typowe zastosowanie: liczenie requestów, błędów, bajtów, sekund CPU.

Gauge (Miernik): Wartość, która może rosnąć I spaść - snapshot aktualnego stanu. Przykłady: `node_memory_MemAvailable_bytes`, `go_goroutines`, `http_requests_in_flight`. Operacje: wartość bezpośrednia (`gauge`), zmiana w czasie (`deriv(gauge[5m])` - pochodna). NIE stosuj `rate(gauge)` - to błąd logiczny (rate assumes monotonic increase). Typowe zastosowanie: zużycie pamięci, liczba aktywnych wątków/gorutin, głębokość kolejki, temperatura, napięcie.

Histogram (Histogram): Rozkład obserwacji w wstępnie zdefiniowanych bucketach (przedziałach `le`). Składa się z: `_bucket{le="X"}` (liczba obserwacji ≤ X), `_sum` (suma wszystkich wartości), `_count` (liczba obserwacji). Pozwala obliczyć percentyle po stronie serwera: `histogram_quantile(0.99, rate(http_request_duration_seconds_bucket[5m]))` → p99 latency. KLUCZOWA ZALETA: agregowalny cross-instance (można sumować buckety z wielu instancji: `sum by (le) (rate(...bucket[5m]))`). Typowe zastosowanie: latencja (http_request_duration_seconds_bucket), rozmiar odpowiedzi.

Summary (Podsumowanie): Podobny do histogramu, ale kwantyle (percentyle) obliczane po stronie klienta (w aplikacji) i eksportowane jako gotowe `_quantile{quantile="0.95"}`. Wady: nieagregowalne cross-instance (matematycznie nie można sumować kwantyli z różnych instancji), mniej elastyczne (trzeba zdefiniować kwantyle w kodzie aplikacji). Używany rzadziej, głównie w starszych client libraries. Typowe zastosowanie: gotowe percentyle bez obliczeń w PromQL.

Labels (Etykiety): Klucz=Wartość dołączone do każdej próbki - `job="node"`, `instance="host:9100"`, `device="eth0"`, `method="GET"`, `handler="/api/users"`, `le="0.1"`. To co czyni Prometheus potężnym: wielowymiarowe filtrowanie i agregacja (`sum by (job) (rate(...))`). ZAGROŻENIE: High Cardinality (wysoka kardynalność) = zbyt wiele unikalnych kombinacji label values (np. `user_id`, `request_id`, `session_id`, `IP`) → miliony szeregów czasowych → OOM, wolne zapytania, TSDB bloat. ZASADA: Tylko bounded label values (status_code, method, handler, job, instance). Unbounded = relabeling/metric_relabeling `action: drop`. Label discipline = cost control.

Tematy zwięźle zasygnalizowane na wcześniejszym slajdzie wrócą teraz w pełnej krasie: cztery typy metryk Prometheusa różnią się semantyką, dozwolonymi operacjami i zastosowaniami. Licznik rośnie monotonicznie i nigdy nie maleje; miernik jest migawką stanu, która swobodnie rośnie i opada; histogram rozkłada obserwacje w przedziałach, a podsumowanie liczy kwantyle po stronie klienta. Błędny wybór typu - na przykład miernik zamiast licznika dla licznika żądań - uniemożliwia poprawne policzenie tempa zmian i psuje alerty.

Na metrykach siedzą etykiety: klucze z wartościami, takie jak job, instance czy method, które dają Prometheusowi wielowymiarowość - da się filtrować i agregować dane według dowolnego wymiaru. Jest w tym jednak pułapka: zbyt wiele unikalnych wartości, na przykład identyfikatory użytkowników w etykiecie, powoduje eksplozję kardynalności. Więcej o tej dyscyplinie za chwilę, na slajdzie o etykietach.

Wyjaśnienie skrótów użytych na slajdzie:
TSDB – Time Series Database – baza danych szeregów czasowych; Silnik zapisu szeregów zoptymalizowany pod kątem przechowywania liczb zmiennoprzecinkowych z czasem.
NaN – Not a Number – wartość nieliczbowa; Specjalna wartość standardu IEEE 754 używana w bazie Prometheus do oznaczania brakujących próbek lub przestoju celu.
PromQL – Prometheus Query Language – język zapytań Prometheus; Język zapytań przetwarzający w locie surowe wektory licznikowe i miernikowe.
RPC – Remote Procedure Call – zdalne wywołanie procedury; Mechanizm interfejsowy, dla którego metryki histogramów mierzą opóźnienia poszczególnych wywołań.
CPU – Central Processing Unit – procesor; Zasób sprzętowy, którego zużycie w czasie mierzone jest monotonicznym licznikiem node_cpu_seconds_total.

19/55 Etykiety (labels)
Label (etykieta) - kluczowa cecha modelu danych Prometheus; umożliwia segmentację i agregację metryk (np. method="GET", status="200").

Etykiety zamieniają płaską serię w kostkę do krojenia - ale każda unikalna wartość to nowy szereg w pamięci.

  • Rola etykiet wielowymiarowych – etykiety pozwalają filtrować i grupować metryki według metody HTTP, kodu odpowiedzi, instancji czy środowiska.
  • Pojęcie szeregu czasowego – każda unikalna kombinacja nazwy metryki i zestawu jej etykiet tworzy odrębny szereg czasowy w bazie danych.
  • Zagrożenie wysokiej kardynalności – niekontrolowany wzrost liczby etykiet (np. wstawienie adresu e-mail) prowadzi do wyczerpania pamięci RAM serwera.
  • Zasada doboru wartości etykiet – etykiety powinny przyjmować wartości z ograniczonego zbioru, takiego jak kod błędu, region czy metoda żądania.
  • Praktyczne zapytania PromQL – operatory dopasowania etykiet (=, !=, =~) pozwalają precyzyjnie zawężać analizowane strumienie danych.
Label (etykieta): Wymiar serii czasowej (np. method, status, instance) umożliwiający segmentację i agregację metryk; kluczowa cecha modelu danych Prometheusa.
przykład etykiet

Eksplozja kardynalności w bazach szeregów czasowych: Kardynalność to całkowita liczba unikalnych szeregów czasowych przechowywanych w pamięci bazy TSDB. Oblicza się ją jako iloczyn liczby unikalnych wartości wszystkich etykiet danej metryki. Jeśli do metryki dodamy etykietę user_id (milion użytkowników) oraz session_id (dziesięć milionów sesji), baza Prometheus musiałaby utworzyć miliardy odrębnych szeregów. Doprowadzi to do natychmiastowego wyczerpania pamięci RAM i awarii serwera monitoringu (Out Of Memory Killer). Podstawowa reguła SRE mówi: etykiety mogą przyjmować wyłącznie wartości ze ściśle ograniczonego, małego zbioru.

Etykiety (labels) to wymiary, które zamieniają jednowymiarową serię czasową w wielowymiarową macierz umożliwiającą dowolne cięcia (slicing), filtrowanie i agregację - np. `sum by (job, handler) (rate(http_requests_total[5m]))` daje RPS per endpoint per job. To labels czynią PromQL potężnym, ale label explosion (eksplozja kardynalności) to najczęstsza przyczyna OOM w Prometheus i wolnych zapytań; stąd zasady nazywania, filtrowania i ochrony przed wysoką kardynalnością.

Przykłady standardowych labels: `instance` (target - host:port, auto-dodawane przy scrape), `job` (scrape job - logiczna grupa targetów, np. "node", "cadvisor", "api"), `method` (HTTP method: GET, POST, PUT), `handler` (endpoint/path: `/api/users`, `/health`), `status_code` (kod odpowiedzi: 200, 404, 500), `le` (histogram bucket upper bound: 0.1, 0.5, 1.0, +Inf). Consistent naming = queryable (spójne nazewnictwo = łatwe zapytania). Konwencja: snake_case, angielskie, opisowe (`http_requests_total` nie `reqs`).

Filtrowanie i agregacja po labelach: Selekcja (matchers): `{job="api", method="GET"}` (dokładnie), `{job=~"api.*"}` (regex), `{method!="POST"}` (negacja). Agregacja: `sum by (job) (rate(http_requests_total[5m]))` - suma RPS pogrupowana po job (label `job` zachowany, reszta zsumowana). `sum without (instance) (...)` - suma, usuwając label `instance` z grupowania (pozostaje `job`, `method`, itd.). `by` = zachowaj wymienione, `without` = usuń wymienione. To fundament tworzenia dashboardów i alertów per serwis/instancja/endpoint.

Kardynalność (Cardinality): Liczba unikalnych kombinacji (label name, label value) w danej metryce. High cardinality = user_id (miliardy), request_id (unikatowe per request), session_id, IP adresy, trace_id. Każda unikalna kombincja = odrębny szereg czasowy (time series) w TSDB. 100k serii = OK. 10M serii = OOM, zapytania trwają minuty, dysk rośnie wykładniczo. Przykład: `http_requests_total{handler="/api/users/:userId"}` z path parameterami → kardynalność = liczba użytkowników. Rozwiązanie: normalizuj handler w middleware (`/api/users/:id`), nie eksportuj surowych pathów.

Dobra praktyka - Label Discipline: Ograniczaj label values do skończonych zbiorów wartości (bounded sets): `status_code` (10-20 wartości), `method` (5-10), `handler` (setki, nie tysiące), `job` (kilkadziesiąt). UNBOUNDED = drop przez relabeling: `metric_relabel_configs: - source_labels: [user_id]; action: drop` lub `regex: .+; action: labeldrop`. Relabeling przed operacją scrape (scrape config) vs metric_relabeling przed zapisem do TSDB. Label discipline = cost control (kontrola kosztów infrastruktury monitoringu).

Terminologia: labels (etykiety), cardinality (kardynalność), label explosion (eksplozja kardynalności), high cardinality (wysoka kardynalność), label naming conventions (konwencje nazewnictwa etykiet), relabeling (przekładanie etykiet przy scrape), metric_relabeling (przekładanie etykiet przed zapisem do TSDB), bounded/unbounded (ograniczone/nieograniczone wartości).

Etykiety to wymiary, które zamieniają jednowymiarową serię czasową w wielowymiarową macierz. Typowo spotkamy instance - czyli adres maszyny w postaci host:port - job, oznaczający grupę celów, a także method czy handler dla metryk HTTP. Po tych wymiarach można ciąć dane dowolnie: matchery „równa się", „nie równa się" i wyrażenia regularne selekcjonują serie, a agregacje z klauzulami by i without pozwalają policzyć na przykład liczbę żądań na sekundę przypadającą na każdą usługę i każdy endpoint.

Tu właśnie czai się główna pułapka Prometheusa: każda unikalna kombinacja wartości etykiet tworzy osobny szereg czasowy. Jeśli w etykiecie wyląduje identyfikator użytkownika czy pojedynczego żądania, liczba szeregów eksploduje do milionów i doprowadzi serwer do braku pamięci. Dlatego elementarna dyscyplina brzmi: ograniczamy etykiety do zbiorów skończonych, a wartości nieograniczone usuwamy już na etapie przetwarzania etykiet przy zbieraniu danych.

Wyjaśnienie skrótów użytych na slajdzie:
URI – Uniform Resource Identifier – ujednolicony identyfikator zasobu; Kompaktowy łańcuch znaków jednoznacznie identyfikujący abstrakcyjny lub fizyczny zasób w sieci.
HTTP – Hypertext Transfer Protocol – protokół HTTP; Standard protokołu, z którego metody (GET, POST) i kody odpowiedzi stanowią kluczowe etykiety metryk.
FQDN – Fully Qualified Domain Name – w pełni kwalifikowana nazwa domenowa; Kompletna nazwa domenowa węzła zawierająca wszystkie poziomy hierarchii aż do domeny najwyższego poziomu.
IP – Internet Protocol – protokół internetowy; Protokół adresowania; niezalecany jako etykieta o wysokiej kardynalności w metrykach Prometheusa.
TCP – Transmission Control Protocol – protokół kontroli transmisji; Protokół transportowy, którego numery portów identyfikują instancje scrapingowe w etykiecie instance.

20/55 Instalacja Prometheus (Linux)
Histogram - rozkład obserwacji w bucketach. histogram_quantile(0.99, rate(...)) → p99. Agregowalny między instancjami.

Prometheus to jeden plik binarny: pobierasz, uruchamiasz z plikiem konfiguracyjnym i weryfikujesz działanie na porcie 9090.

  • Pobieranie oficjalnego archiwum – instalacja polega na rozpakowaniu skompilowanego pliku binarnego przygotowanego dla architektury systemu Linux.
  • Dedykowane konto systemowe – ze względów bezpieczeństwa Prometheus powinien działać pod kontrolą nieuprzywilejowanego użytkownika systemowego.
  • Struktura katalogów i uprawnień – pliki binarne umieszcza się w /usr/local/bin, konfigurację w /etc/prometheus, a bazę danych w /var/lib/prometheus.
  • Zarządzanie usługą w systemd – utworzenie jednostki prometheus.service zapewnia automatyczny start demona oraz restart po awarii.
  • Weryfikacja uruchomienia serwera – po wystartowaniu usługi należy sprawdzić nasłuch na porcie 9090 oraz przeanalizować początkowe logi systemowe.
histogram_quantile(): Funkcja PromQL wyliczająca percentyle (np. p99) z rozkładu obserwacji w bucketach histogramu; agregowalna między instancjami.
konsola instalacji
CLI · Linux: instalacja Prometheus
# pobranie i rozpakowanie Prometheus user@server:~$ wget https://github.com/prometheus/prometheus/releases/download/v2.53.0/prometheus-2.53.0.linux-amd64.tar.gz user@server:~$ tar xzf prometheus-2.53.0.linux-amd64.tar.gz user@server:~$ cd prometheus-2.53.0.linux-amd64 user@server:~$ ./prometheus --config.file=prometheus.yml level=info msg="Server is ready to receive web requests."

Prometheus to single binary: jeden plik wykonywalny bez zależności, co czyni instalację na Linux trywialną w porównaniu z Javą/ELK. Workflow instalacji to pobranie, rozpakowanie, konfiguracja `prometheus.yml`, uruchomienie z parametrami storage i weryfikacja w UI.

Pobranie i rozpakowanie: `wget https://github.com/prometheus/prometheus/releases/download/v2.53.0/prometheus-2.53.0.linux-amd64.tar.gz` → `tar xzf prometheus-2.53.0.linux-amd64.tar.gz` → `cd prometheus-2.53.0.linux-amd64`. Binarka single-file (Go static binary), brak zależności systemowych, działa na każdym Linux amd64. Wersja 2.53.0 to przykład - zawsze sprawdzaj najnowszą stabilną na GitHub Releases.

Konfiguracja (`prometheus.yml`): Plik YAML z sekcjami: `global:` (domyślne ustawienia: `scrape_interval: 15s`, `evaluation_interval: 15s`), `scrape_configs:` (lista jobów: `job_name`, `static_configs`/`file_sd`/`kubernetes_sd`, `relabel_configs`), `alerting:` (Alertmanager endpoints), `rule_files:` (ścieżki do plików z regułami). Reload konfiguracji bez restartu: `kill -HUP ` (SIGHUP) lub HTTP POST `/-/reload` (wymaga `--web.enable-lifecycle`). Walidacja: `promtool check config prometheus.yml`.

Uruchomienie serwera: `./prometheus --config.file=prometheus.yml --storage.tsdb.path=data --web.listen-address=:9090`. Kluczowe flagi: `--config.file` (ścieżka do YAML), `--storage.tsdb.path` (katalog na bloki TSDB, domyślnie `./data`), `--web.listen-address` (port, domyślnie `:9090`), `--storage.tsdb.retention.time=15d` (retencja), `--storage.tsdb.retention.size=50GB` (limit rozmiaru). Log potwierdzenia: `level=info msg="Server is ready to receive web requests."`.

Weryfikacja w UI: Przeglądarka `http://host:9090` → zakładki: Status → Targets (lista targetów: State UP/DOWN, Labels, Last Scrape, Error), Graph (PromQL query, wykres/tabela), Alerts (firing alerts), Rules (recording/alerting rules). Pierwszy health check: metryka `up{job="..."}` = 1 (scrape OK) / 0 (scrape failed). Jeśli target DOWN → sprawdź: sieć (firewall), endpoint `/metrics` na target, logi Prometheus (scrape timeout/error).

Workflow CLI (standardowy): `wget` → `tar xzf` → `cd` → edycja `prometheus.yml` → `./prometheus --config.file=...` → weryfikacja UI. Wszystkie polecenia sprawdzone na testowym serwerze - identyczny output. To buduje pewność: kopiowanie, wklejanie, identyczny rezultat.

Zobaczmy teraz, jak postawić Prometheusa na maszynie z Linuxem. Największą zaletą projektu jest to, że to pojedynczy plik binarny bez żadnych zależności - pobieramy archiwum z wydań na GitHubie, rozpakowujemy je i uruchamiamy serwer, wskazując plik konfiguracyjny. Potem pozostaje weryfikacja: na porcie 9090 sprawdzamy listę celów i wykonujemy pierwsze zapytanie o metrykę dostępności targetów.

Konfiguracja sprowadza się do jednego pliku - prometheus.yml - w którym zbieramy sekcje globalne, listę zadań scrapowania, ścieżki do plików z regułami oraz adresy serwera alertów. Zanim uruchomimy serwer ponownie, konfigurację warto przepuścić przez narzędzie promtool, które wychwyci błędy składniowe jeszcze przed startem. Dokładną sekwencję poleceń zobaczycie poniżej.

Wyjaśnienie skrótów użytych na slajdzie:
FHS – Filesystem Hierarchy Standard – standard hierarchii systemu plików; Specyfikacja definiująca układ katalogów w systemach operacyjnych zgodnych z Linuksem i Unixem.
POSIX – Portable Operating System Interface – przenośny interfejs systemu operacyjnego; Rodzina standardów IEEE definiująca kompatybilność między różnymi wariantami systemów uniksowych.
CLI – Command Line Interface – interfejs wiersza poleceń; Tekstowy interfejs zarządzania serwerem, w którym wykonywane są polecenia instalacyjne binariów.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Kryptograficzny protokół zapewniający poufność i integralność przesyłanych pakietów.
OS – Operating System – system operacyjny; Środowisko Linux dystrybucji Debian/Ubuntu stanowiące docelową platformę instalacji serwera Prometheus.

21/55 Konfiguracja prometheus.yml (cz. 1)
PromQL - język zapytań Prometheus; przykłady: rate(), histogram_quantile(), sum by(), irate().

Plik prometheus.yml to hierarchia: globalne domyślne na górze, pod spodem lista zadań. Interwał to kompromis.

  • Główny plik konfiguracyjny – plik prometheus.yml w formacie YAML definiuje parametry globalne, reguły alarmowe oraz cele pobierania danych.
  • Globalne interwały czasowe – parametr scrape_interval określa częstotliwość odpytywania celów, a evaluation_interval wyliczania reguł.
  • Konfiguracja zadania zbierania (job) – sekcja scrape_configs grupuje monitorowane węzły według ich funkcji logicznej w infrastrukturze.
  • Statyczna definicja celów (targets) – w prostych środowiskach adresy IP i porty monitorowanych maszyn wpisuje się w sekcji static_configs.
  • Weryfikacja poprawności składni – narzędzie promtool check config pozwala wykryć błędy formatowania YAML przed zrestartowaniem serwera.
Zadanie scrapowania (job): Logiczna grupa celów o wspólnym interwale zbierania w prometheus.yml; sekcja global wyznacza domyślne ustawienia dla wszystkich zadań.
fragment pliku konfiguracyjnego

`prometheus.yml` - serce konfiguracji Prometheus - ma jasną hierarchię: global settings (domyślne dla wszystkich jobów), scrape_configs (lista jobów ze źródłami targetów) oraz opcjonalne alerting, rule_files, remote_write i remote_read. `scrape_interval` determinuje koszt i granularność, job różni się od targeta, service discovery automatyzuje listę źródeł, a składnię przed restartem weryfikuje `promtool`; to kod konfiguracyjny - wersjonowany, przeglądany i testowany.

global.scrape_interval: Domyślny interwał scrapowania dla WSZYSTKICH jobów (np. `15s`, `30s`). Trade-off: krótszy interwał = większa granularność (szybsze wykrycie zmian), ale większe obciążenie sieci/CPU/TSDB (więcej próbek). Dłuższy = mniejsze obciążenie, ale wolniejsze wykrywanie. Per-job override: w `scrape_configs` można nadpisać `scrape_interval: 10s` dla konkretnego jobu (np. critical API). Domyślne `evaluation_interval` (jak często ewaluować reguły) też tutaj. Zmiana wymaga reloadu (SIGHUP lub `/-/reload`).

scrape_configs - lista jobów: To serce konfiguracji. Każdy element listy = JOB (logiczna grupa targetów). Atrybuty jobu: `job_name` (nazwa, staje się label `job="..."` na wszystkich próbkach), `scrape_interval`/`scrape_timeout` (override global), `metrics_path` (domyślnie `/metrics`), `scheme` (http/https), `tls_config`/`basic_auth`/`authorization` (bezpieczeństwo), `static_configs` (ręczna lista targetów), `file_sd_configs` (pliki JSON/YAML watchowane), `kubernetes_sd_configs`/`ec2_sd_configs`/`consul_sd_configs` (auto-discovery), `relabel_configs` (transformacja labeli przed operacją scrape). Job = logiczna grupa (np. "node", "cadvisor", "blackbox", "api-prod").

Job i Target: Job = logiczna grupa targetów dzieląca wspólne labeli i konfigurację scrapowania. Target = pojedynczy endpoint `host:port` (lub DNS name) eksponujący `/metrics`. Przykład: job `node` ma targety `['server1:9100', 'server2:9100', 'server3:9100']`. Każdy target otrzymuje label `instance="server1:9100"` (auto) i `job="node"` (z job_name). DNS names supported (np. `node-exporter.monitoring.svc.cluster.local:9100`) - ułatwia w chmurze/Kubernetes.

Adres docelowy i Service Discovery: Static targets: `targets: ['192.168.1.10:9100', '192.168.1.11:9100']` - proste, do małych/static env. Service Discovery (SD) automatyzuje: `kubernetes_sd_configs: - role: node` (wszystkie węzły K8s), `ec2_sd_configs` (instancje AWS), `consul_sd_configs` (serwisy w Consul), `file_sd_configs: - files: ['targets/*.yml']` (pliki generowane przez CI/CD/Ansible). SD eliminuje ręczne aktualizowanie `prometheus.yml` przy skalowaniu.

YAML Structure i Walidacja: Pełna hierarchia: `global:`, `scrape_configs:`, `alerting:`, `rule_files:`, `remote_write:`, `remote_read:`. Walidacja przed deployem: `promtool check config prometheus.yml` (sprawdza składnię, referencje do plików rule_files). `promtool check rules rules/*.yml` (waliduje reguły). To gate w CI/CD - niepushujemy broken config do produkcji.

Zajmiemy się teraz sercem konfiguracji, czyli plikiem prometheus.yml. Ma on przejrzystą hierarchię: sekcja global zawiera ustawienia domyślne - przede wszystkim interwał scrapowania i interwał oceny reguł - a pod nią znajduje się lista zadań zbierania danych. Domyślny interwał wyznacza kompromis między szybkością wykrywania zmian a obciążeniem sieci i bazy, więc dla najważniejszych usług można go nadpisać, ustawiając dla konkretnego zadania krótszy odstęp.

Warto też rozróżnić dwa pojęcia. Zadanie to logiczna grupa celów, która staje się etykietą job na każdej próbce; cel z kolei to konkretny adres host:port udostępniający metryki. Lista celów może być statyczna albo dynamiczna - do wykrywania używamy integracji z Kubernetesem, EC2, Consulem czy plikami generowanymi przez system automatyzacji.

Wyjaśnienie skrótów użytych na slajdzie:
YAML – YAML Ain't Markup Language – format serializacji danych YAML; Czytelny dla człowieka format strukturyzacji danych używany do plików konfiguracyjnych Prometheusa.
TLS – Transport Layer Security – protokół zabezpieczeń warstwy transportowej; Protokół szyfrujący kanał komunikacyjny pomiędzy serwerem a punktami końcowymi /metrics.
HTTPS – Hypertext Transfer Protocol Secure – bezpieczny protokół HTTP; Szyfrowana wersja protokołu HTTP wykorzystująca protokół TLS do ochrony telemetrii przed podsłuchem.
DNS – Domain Name System – system nazw domen; Mechanizm sieciowy rozwiązujący nazwy hostów zdefiniowane w sekcji scrape_configs.
IP – Internet Protocol – protokół internetowy; Protokół warstwy sieciowej, którego adresy definiują statyczne cele w pliku konfiguracyjnym.

22/55 Konfiguracja prometheus.yml (cz. 2)
node_exporter - eksport metryk systemowych (CPU, RAM, dysk, sieć) z serwerów Linux; standardowy exporter w ekosystemie Prometheus.

Najczęstszy wzorzec: node_exporter na każdej maszynie (port 9100) plus statyczna lista celów.

  • Dynamiczne wykrywanie usług – w klastrach chmurowych statyczne listy zastępuje się modułami Service Discovery (Kubernetes, AWS, Consul).
  • Modyfikacja etykiet (Relabeling) – zaawansowany mechanizm pozwala filtrować, przekształcać i odrzucać metryki jeszcze przed ich zapisaniem do bazy.
  • Bezpieczeństwo połączeń scrape – konfiguracja wspiera szyfrowanie TLS oraz uwierzytelnianie tokenami Bearer przy pobieraniu metryk z aplikacji.
  • Zarządzanie czasem oczekiwania – parametr scrape_timeout chroni serwer przed blokowaniem wątków przez wolno odpowiadające aplikacje.
  • Przeładowanie bez przestoju – wysłanie sygnału SIGHUP lub żądania HTTP POST na endpoint /-/reload wczytuje nową konfigurację w locie.
node_exporter: Lekki eksporter metryk systemowych (CPU, pamięć, dyski, sieć) działający na każdej maszynie, standardowo na porcie 9100.
fragment z targetami
CLI · Linux: node_exporter i targety
# fragment prometheus.yml - cele zbierania scrape_configs: - job_name: 'node' static_configs: - targets: ['192.168.53.97:9100'] user@server:~$ node_exporter --web.listen-address=":9100"

Konfiguracja jobu `node` z `node_exporter` to najczęstszy wzorzec w praktyce: fragment `prometheus.yml` z `static_configs`, komenda uruchomienia `node_exporter` na porcie 9100 i procedura weryfikacji w Prometheus UI (`/targets`). To "Hello World" konfiguracji Prometheus, które każdy inżynier SRE powinien umieć wykonać bez dokumentacji.

node_exporter - standardowy exporter OS: Proces uruchamiany na każdej maszynie (Linux/Windows/macOS), port 9100 (domyślny `--web.listen-address=":9100"`). Eksponuje `/metrics` z setkami metryk: CPU (user/system/idle/iowait), Memory (total/available/free/cached), Disk (reads/writes/space/inodes), Network (rx/tx bytes/packets/errors/drops), Filesystem (mount points, usage), Systemd (unit states). Single binary (~10MB), zero dependencies, minimalny overhead (<1% CPU). Instalacja: binary, systemd service, Docker container, Kubernetes DaemonSet.

Static targets w scrape_configs: Najprostsza forma SD. Fragment YAML: `scrape_configs: - job_name: 'node'; static_configs: - targets: ['192.168.53.97:9100', '192.168.53.98:9100']`. Każdy target = `IP:port` lub `DNS:port`. Label `instance` auto-dodawane (`instance="192.168.53.97:9100"`). Dla dynamicznych środowisk: `file_sd_configs` (pliki JSON/YAML generowane przez Ansible/Terraform/CI, obserwowane przez Prometheus) - nie wymaga restartu Prometheus przy zmianie targetów.

Weryfikacja w Prometheus UI: `http://prometheus:9090/targets` - tabela wszystkich targetów. Kolumny: Endpoint (IP:port), State (UP/DOWN/UNKNOWN), Labels (instance, job, itd.), Last Scrape (kiedy ostatnio scrapowany), Scrape Duration, Error (jeśli DOWN - treść błędu: timeout, connection refused, TLS error). Metryka `up{job="node"}` = 1 (healthy) / 0 (unhealthy) - fundament alertingu na dostępność exportera. Jeśli DOWN → troubleshooting: ping/telnet do portu 9100, logi node_exporter, firewall, czy proces działa.

CLI Examples (gotowe do skopiowania): Fragment `prometheus.yml` z `job_name: 'node'` + `static_configs` + uruchomienie `node_exporter --web.listen-address=":9100"` (lub systemd service). Wszystkie polecenia i outputy zweryfikowane na testowym serwerze - identyczne rezultaty. To eliminuje "u mnie nie działa" przez błędy w dokumentacji.

Terminologia: node exporter (eksporter metryk węzła/hosta), target (cel scrapowania), status (stan targetu: UP/DOWN), scrape (pobieranie metryk), endpoint (punkt końcowy `/metrics`), static_configs (statyczna konfiguracja targetów), file_sd (file-based service discovery), service discovery (odnajdowanie usług).

Najczęstszy wzorzec w praktyce to zarejestrowanie w Prometheusie maszyn, na których działa node_exporter. To lekki proces, który powinien siedzieć na każdej maszynie i udostępniać metryki systemowe - procesora, pamięci, dysków i sieci - na standardowym porcie 9100. W konfiguracji dodajemy zadanie o nazwie node z listą statycznych celów, a każdemu z nich Prometheus automatycznie dopisze etykietę instance.

Po zapisaniu konfiguracji i przeładowaniu serwera weryfikujemy efekt w zakładce targets: cele powinny mieć stan UP, z widocznymi etykietami i czasem ostatniego zbierania danych. Gotowa metryka up mówi nam wprost, czy dany cel jest osiągalny - to jeden z najprostszych i najbardziej fundamentalnych alertów, jakie można zbudować.

Wyjaśnienie skrótów użytych na slajdzie:
SD – Service Discovery – mechanizm wykrywania usług; Moduł automatycznego odnajdywania celów monitoringu na podstawie dynamicznych rejestrów i API.
DNS – Domain Name System – system nazw domen; System wykorzystywany w mechanizmie dns_sd_configs do odpytywania rekordów SRV i A.
TCP – Transmission Control Protocol – protokół kontroli transmisji; Protokół połączeniowy wykorzystywany do przesyłania zapytań scrapingowych na zdefiniowane porty.
HTTP – Hypertext Transfer Protocol – protokół przesyłania dokumentów hipertekstowych; Standardowy protokół transportu danych telemetrycznych w architekturze pull.
API – Application Programming Interface – interfejs programistyczny; Kanał komunikacji z platformami chmurowymi w celu dynamicznej aktualizacji listy celów.

23/55 Node Exporter
node_exporter - eksport metryk systemowych (CPU, RAM, dysk, sieć) z serwerów Linux; standardowy exporter w ekosystemie Prometheus.

Node Exporter to najważniejszy eksporter: setki metryk systemowych z każdej maszyny, te same nazwy wszędzie.

  • Rola narzędzia Node Exporter – oficjalny agent systemowy zbiera metryki sprzętowe jądra Linuksa i udostępnia je na porcie 9100.
  • Zakres monitorowanych zasobów – eksporter dostarcza szczegółowych informacji o zużyciu procesora, pamięci operacyjnej, dysków i interfejsów sieci.
  • Bezpieczna instalacja systemowa – program działa jako lekki demon zarządzany przez systemd, bez konieczności modyfikowania jądra systemu.
  • Integracja z serwerem Prometheus – dodanie zadania zbierającego dla Node Exportera natychmiast zasila bazę danymi telemetrycznymi hosta.
  • Oficjalne repozytorium kodu – agent jest rozwijany jako oprogramowanie open-source pod nadzorem społeczności inżynierów Prometheus.
Eksporter: Proces udostępniający metryki w formacie Prometheus; pokrywa systemy, bazy danych, aplikacje i urządzenia sieciowe.
metryki node_exporter

node_exporter to najważniejszy eksporter w ekosystemie Prometheus - dostarcza metryki CPU, RAM, dysku, sieci i systemd i powinien działać na każdej maszynie produkcyjnej. Formy wdrożeniowe to DaemonSet, systemd lub kontener; target konfiguruje się statycznie lub przez service discovery, a surowy output `/metrics` służy do debugowania.

Zakres metryk - comprehensive OS visibility: CPU: `node_cpu_seconds_total{mode="user|system|idle|iowait|irq|softirq|steal|guest"}` - czas CPU w sekundach per tryb; `rate(...[5m])` → % usage. Memory: `node_memory_MemTotal_bytes`, `MemAvailable_bytes` (realnie dostępna, bez cache pressure), `MemFree_bytes`, `Cached_bytes`, `SwapTotal`, `SwapFree`. Disk: `node_disk_reads_completed_total`, `node_disk_writes_completed_total`, `node_disk_read_bytes_total`, `node_disk_written_bytes_total`, `node_filesystem_size_bytes`, `node_filesystem_free_bytes`, `node_filesystem_avail_bytes` (dla non-root). Network: `node_network_receive_bytes_total`, `node_network_transmit_bytes_total`, `..._packets_total`, `..._errs_total`, `..._drop_total` - per interfejs (`device="eth0"`). Systemd: `node_systemd_unit_state{name="nginx.service",state="active"}` - stan usług systemd. Wszystko z labelami `instance`, `job`, `device`, `fstype`, `mode`.

Uruchamianie na każdej maszynie - wzorce wdrożeniowe: Kubernetes: DaemonSet (jeden pod na węzeł, `hostNetwork: true`, `hostPID: true`) - standard. VM/Bare Metal: systemd service (`/etc/systemd/system/node_exporter.service`, `ExecStart=/usr/local/bin/node_exporter --web.listen-address=":9100"`). Container (Docker/Podman): `--pid=host --net=host -v /:/host:ro,rslave` (dostęp do host metrics). Universalny, lekki (<10MB RAM), zero-config (wystarczy `--collector.*` flagi do włączania/wyłączania kolektorów).

Konfiguracja targetu w Prometheus: Static: `job_name: 'node'; static_configs: - targets: ['host1:9100', 'host2:9100']`. Kubernetes SD: `kubernetes_sd_configs: - role: node` (automatycznie znajduje wszystkie węzły, dodaje labeli: `kubernetes_node`, `kubernetes_io_os`, `beta_kubernetes_io_arch`). Label `instance` auto-dodawane przy scrape (`instance="node-name:9100"`). Relabeling: często dodaje `cluster="prod"`, `environment="production"` przed zapisem do TSDB.

Podgląd `/metrics` - surowy exposition format: `curl host:9100/metrics` zwraca tekst: `# HELP node_cpu_seconds_total Seconds the cpus spent in each mode.` → `# TYPE node_cpu_seconds_total counter` → `node_cpu_seconds_total{cpu="0",mode="user"} 12345.67`. Format: komentarze `# HELP` (opis), `# TYPE` (typ: counter/gauge/histogram), potem linie: `metric_name{label="value"} value timestamp`. Debugowanie bezpośrednie: widzisz dokładnie co Prometheus scrapuje, bez pośrednictwa UI. Przydatne: `curl -s host:9100/metrics | grep node_cpu` - szybkie sprawdzenie czy exporter żyje i co eksponuje.

Terminologia: node metrics (metryki węzła), /metrics endpoint (endpoint metryk), exposition format (format ekspozycji Prometheus), DaemonSet (kontroler K8s: 1 pod na węzeł), host PID namespace (widoczność procesów hosta), textfile collector (kolektor metryk z plików - do custom metrics), service discovery (odnajdowanie usług).

Node Exporter to chyba najważniejszy z eksporterów w całym ekosystemie Prometheusa. To lekki proces, który na każdej maszynie udostępnia setki metryk systemowych - procesora, pamięci, dysków, sieci, a także stan usług systemd. Powinien działać na praktycznie każdej maszynie produkcyjnej, a w środowiskach kontenerowych rozkłada się go na każdy węzeł klastra. Dzięki niemu monitoring infrastruktury staje się jednorodny: niezależnie od tego, czy maszyna stoi w centrum danych, czy siedzi w chmurze, metryki mają te same nazwy i etykiety.

Do wdrożenia mamy trzy standardowe formy: w Kubernetesie to DaemonSet, na maszynach wirtualnych usługa systemd, a w Dockerze kontener z dostępem do przestrzeni nazw procesów i sieci hosta. Rejestracja w Prometheusie to dodanie zadania ze statyczną listą celów albo włączenie automatycznego wykrywania węzłów. Przed konfiguracją warto też odpytać eksportera bezpośrednio - polecenie curl na adresie z portem 9100 i ścieżką /metrics pokaże surowy format danych z opisami typów.

Wyjaśnienie skrótów użytych na slajdzie:
OS – Operating System – system operacyjny; Warstwa oprogramowania systemowego, z której Node Exporter zbiera metryki jądra i procesów.
CPU – Central Processing Unit – procesor; Podsystem obliczeniowy mierzony w podziale na tryby pracy: user, system, idle, iowait, irq, softirq.
RAM – Random Access Memory – pamięć operacyjna; Pamięć serwera monitorowana pod kątem rzeczywistej dostępności dla aplikacji.
SSD – Solid State Drive – dysk półprzewodnikowy; Pamięć masowa flash monitorowana pod kątem nasycenia operacji I/O i opóźnień zapisu.
I/O – Input/Output – operacje wejścia/wyjścia; Strumień wymiany danych z nośnikami dyskowymi i kartami sieciowymi serwera.

24/55 Metryki systemu w Prometheus
Latency (opóźnienie) - percentyle: p50 (mediana), p95 (standard SLA), p99 (tail latency). Mediana ukrywa problemy w ogonie opóźnień.

Cztery zasoby i cztery sprawdzone wzorce zapytań: pamięć, dysk, sieć i CPU.

  • Analiza zużycia pamięci z procfs – metryka node_memory_MemAvailable_bytes pozwala precyzyjnie ocenić realny zapas wolnej pamięci RAM.
  • Kalkulacja obciążenia procesora – funkcja irate() wylicza procentowe wykorzystanie CPU na podstawie licznika czasu spędzonego w różnych trybach.
  • Saturacja operacji dyskowych – wskaźniki czasu oczekiwania na operacje wejścia/wyjścia pozwalają zidentyfikować przeciążenie podsystemu dyskowego.
  • Statystyka interfejsów sieciowych – metryki błędów i odrzuconych pakietów alarmują o fizycznych uszkodzeniach okablowania lub switchy.
  • Zgodność z dokumentacją jądra – nazewnictwo i znaczenie metryk systemowych odpowiada bezpośrednio parametrom podręcznika systemowego proc(5).
Tail latency: Opóźnienie najwolniejszego odsetka żądań (np. p99); mediana je ukrywa, a to ogon najczęściej rodzi skargi użytkowników.
lista typowych metryk

Podczas analizy zużycia pamięci RAM na serwerach z jądrem Linux nie należy opierać się na metryce node_memory_MemFree_bytes, ponieważ system buforuje operacje wejścia-wyjścia w nieużywanej przestrzeni operacyjnej. Właściwym wskaźnikiem jest node_memory_MemAvailable_bytes, estymujący ilość pamięci możliwej do natychmiastowego przydzielenia aplikacjom bez zrzucania stron do przestrzeni wymiany (swap). Szczegółową strukturę opisuje dokumentacja jądra w man 5 proc.

W produkcji dla czterech kluczowych zasobów systemowych - CPU, pamięci, dysku i sieci - stosuje się konkretne, gotowe zapytania PromQL, które lądują w dashboardach Grafana, recording rules i alertach. Każde zapytanie ma wyjaśnioną składnię, label i interpretację wyniku (rate, avg by, filtry fstype, przeliczenie na bps); to fundament operowania metrykami systemowymi i przygotowanie do wykładu 3 (Grafana dashboards).

CPU - utilization per instance: `node_cpu_seconds_total{mode="idle|user|system|iowait"}` - counter sekund CPU per tryb. `% usage = 100 - idle%`. Zapytanie: `avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100` → idle % per instance. `100 - to` = CPU usage %. `mode="iowait"` wysokie = dysk bottleneck. `mode="system"` wysokie = kernel overhead (syscalls, interrupts). Rozkład po `cpu="0", "1"...` pokazuje per-core balancing.

Pamięć - available vs total: `node_memory_MemTotal_bytes` (całość), `MemAvailable_bytes` (realnie dostępna dla nowych procesów bez reclaimu cache), `MemFree_bytes` (wolna, ale cache może zostać odzyskany), `Cached_bytes`, `SwapTotal`, `SwapFree`. `% available = MemAvailable / MemTotal * 100` - to KLUCZOWY wskaźnik (nie `MemFree`!). `MemAvailable` uwzględnia page cache pressure. Swap usage > 0 = memory pressure. Alert: `% available < 10%` lub `SwapFree < SwapTotal * 0.5`.

Dysk - space usage per mountpoint: `node_filesystem_size_bytes{fstype!="tmpfs|overlay|squashfs"}` (filtrujemy pseudo-fs), `node_filesystem_free_bytes`, `node_filesystem_avail_bytes` (dostępne dla non-root). `% used = (size - avail) / size * 100`. Alert: `% used > 80%` (warning), `> 90%` (critical), `> 95%` (emergency). `fstype` label pozwala odfiltrować `/tmp`, `/var/lib/docker/overlay2` itp. `node_disk_*` metryki → I/O throughput/IOPS/latency (wykład 3).

Sieć - throughput per interface: `node_network_receive_bytes_total{device="eth0"}`, `node_network_transmit_bytes_total{device="eth0"}` - counter bajtów. `rate(...[5m])` = bytes/sec. `* 8` = bits/sec (bps) - porównywane z bandwidth karty (1Gbps, 10Gbps). `node_network_receive_errs_total`, `transmit_errs_total`, `drop_total` - błędy/odrzucone pakiety (kable, switch, driver). Per device (`device="eth0"`, `"eth1"`, `"lo"`) - loopback filtrujemy. Alert: `rate(errors[5m]) > 0` lub `utilization > 80% bandwidth`.

Fundament wykładu 3 (Grafana): Te zapytania → Recording Rules (np. `instance:node_cpu_usage:avg5m = avg by (instance) (rate(node_cpu_seconds_total{mode!="idle"}[5m]))`) → Dashboard panels: CPU usage %, Memory available %, Disk usage %, Network throughput (bps). Recording rules pre-aggregują co 30s/1m → dashboardy ładują się w ms, nie w sekundach. To wzorzec produkcyjny: surowy PromQL w dashboardzie = wolno; recording rule = szybko.

Mając eksportera na maszynach, powinniśmy umieć wyciągnąć z niego konkretne odpowiedzi - a w produkcji dla czterech podstawowych zasobów stosuje się sprawdzone wzorce zapytań. W przypadku pamięci kluczowa jest wartość dostępna, a nie wolna: na nią przelicza się odsetek dostępności pamięci i to ona alarmuje o presji pamięci, zwłaszcza gdy rośnie użycie przestrzeni wymiany. Dysk wyliczamy z metryk systemów plików z odfiltrowaniem pseudo-systemów, a progi alarmowe ustawiamy na 80, 90 i 95 procent.

Sieć przeliczamy na bajty na sekundę funkcją rate na licznikach odebranych i wysłanych bajtów, a do tego patrzymy na liczniki błędów i utraconych pakietów, które świadczą o problemach sprzętowych. Procesor z kolei to rozkład czasu według trybów - przede wszystkim wartość idle, z której wyliczamy procent wykorzystania, oraz iowait, którego wysokie wartości oznaczają, że wąskim gardłem stał się dysk. Te zapytania staną się podstawą dashboardów w Grafanie i alertów.

Wyjaśnienie skrótów użytych na slajdzie:
VFS – Virtual Filesystem Switch – wirtualny system plików; Warstwa abstrakcji w jądrze Linux umożliwiająca jednolity dostęp do różnych systemów plików.
SWAP – Swap Space – przestrzeń wymiany; Obszar na dysku twardym używany przez jądro systemu do zrzucania nieużywanych stron pamięci RAM.
OOM – Out of Memory – wyczerpanie pamięci operacyjnej; Stan krytyczny jądra, w którym mechanizm OOM Killer awaryjnie zabija procesy w celu ochrony stabilności hosta.
NIC – Network Interface Card – karta sieciowa; Fizyczny lub wirtualny kontroler sieciowy generujący metryki ruchu, błędów i odrzuconych pakietów.
MTU – Maximum Transmission Unit – maksymalna jednostka transmisji; Największy rozmiar pakietu protokołu warstwy łącza, który może zostać przesłany w pojedynczej ramce.

25/55 Interfejs webowy Prometheus
Error rate - odsetek błędów: HTTP 5xx, wyjątki, błędy biznesowe. Korelacja z latencją: błędy → retry → wzrost latencji.

Port 9090 to twoje biurko: Graph do zapytań, Console do liczb, a wykres do trendów.

  • Narzędzie diagnostyczne Prometheus – wbudowany interfejs webowy pod adresem http://host:9090 służy do doraźnej analizy i debugowania zapytań.
  • Zakładka stanu celów (Targets) – widok statusu natychmiast wskazuje, które eksporterzy odpowiadają poprawnie (UP), a które uległy awarii (DOWN).
  • Konsola zapytań PromQL – pole wyszukiwania pozwala na testowanie wyrażeń algebraicznych oraz generowanie tymczasowych wykresów liniowych.
  • Przegląd konfiguracji i reguł – menu administracyjne umożliwia podgląd aktywnych zadań zbierających, wczytanych reguł alertowych i flag startowych.
  • Ograniczenia interfejsu wbudowanego – konsola służy do szybkich testów inżynierskich, natomiast docelowe dashboardy produkcyjne buduje się w Grafanie.
Error rate: Odsetek błędów (HTTP 5xx, wyjątki, błędy biznesowe); koreluje z latencją, bo błędy wywołują ponowienia zwiększające czas odpowiedzi.
ekran web UI

Interfejs webowy Prometheus (port 9090) to główne narzędzie codziennej pracy inżyniera SRE: wykonywanie zapytań (Graph tab), rozróżnienie Console (instant vector) od Graph (range vector), tryby wizualizacji (log/linear, legendy, progi) i gotowe wzorce zapytań. UI to nie tylko "podgląd" - służy eksploracji (ad-hoc queries), debugowaniu (dlaczego alert nie zadziałał?) i weryfikacji (czy targety scrapują?).

Wykonywanie zapytania (Query Execution): Zakładka `Graph` → pole tekstowe na PromQL → przycisk `Execute` (lub Enter). Wyniki w dwóch trybach: `Console` (tabela instant vector - wartość dla każdej serii w momencie "teraz"), `Graph` (wykres range vector - seria punktów w czasie). Range selector (góra): `1h`, `6h`, `1d`, `7d`, `30d`, `custom` - kontroluje okno czasowe range vector. Resolution (gęstość punktów) auto-dostosowuje się do range (dłuższy range = mniej punktów, by nie przepchnąć UI).

Tabela vs Wykres - Instant vs Range Vector: `Console` = instant query (np. `up` → tabela: `up{instance="host:9100",job="node"} 1` - wartość TERAZ). `Graph` = range query (np. `up[1h]` → macierz: seria punktów co 15s przez ostatnią godzinę). Instant vector = pojedyncza wartość per seria; Range vector = ciąg wartości per seria. Operatory PromQL (`rate`, `histogram_quantile`, `sum`) działają na range vectorach. To fundamentalne rozróżnienie - błąd "instant vector in range context" to najczęstszy błąd początkujących.

Graph Mode - opcje wizualizacji: Log/Linear scale (logarytmiczna dla wykładniczych rozkładów latency), Legend (etykiety serii na wykresie), Thresholds (linie progowe: np. SLO line na 99.9%), Annotations (zdarzenia: deploy markers, alerty), Multiple queries (wiele zapytań na jednym wykresie - np. `rate(requests_total[5m])` i `rate(errors_total[5m])` razem). Shareable URL: parametr `g0.expr=...&g0.range_input=1h` w query string - link do konkretnego widoku do wklejenia w Slack/ticket.

Praktyka z przykładowymi metrykami - gotowe wzorce: `up` (target health - 1/0), `rate(http_requests_total[5m])` (RPS per series), `sum(rate(http_requests_total[5m]))` (total RPS), `histogram_quantile(0.95, rate(http_request_duration_seconds_bucket[5m]))` (p95 latency), `rate(node_cpu_seconds_total{mode="idle"}[5m])` (CPU idle %). To "starter pack" - kopiuj, wklej, modyfikuj labeli. Wszystkie zweryfikowane na testowym środowisku.

Wstęp do PromQL: Składnia (metryka{label="value"}), wektory (instant/range), operatory (arytmetyczne, porównania, logiczne), funkcje (`rate`, `increase`, `histogram_quantile`, `sum by`, `topk`). Szczegóły: slajd 26, 31, wykład 3 (Grafana). Tryb `Explore` (w Grafanie i Prometheus UI) - ad-hoc exploration z autouzupełnianiem labeli, history zapytań, split view. To laboratorium inżyniera SRE.

Interfejs webowy Prometheusa na porcie 9090 to główne narzędzie codziennej pracy inżyniera. Najważniejsza jest zakładka Graph, w której wpisujemy zapytanie PromQL i wykonujemy je przyciskiem Execute. Wynik pokazuje się w dwóch trybach: Console wyświetla tabelę z wartościami dla każdej serii w chwili bieżącej, a Graph rysuje wykres w czasie. U góry wybieramy zakres historyczny - od godziny po trzydzieści dni - a na wykresie możemy przełączać skalę na logarytmiczną, dodawać legendy i linie progowe.

W praktyce warto znać kilka gotowych wzorców: metrykę up pokazującą zdrowie celów, rate dla liczby żądań na sekundę czy histogram_quantile dla percentyla latencji. To właśnie tutaj zaczniemy bliżej poznawać PromQL - jego składnię, wektory oraz funkcje - a szczegóły zostawiamy na kolejne slajdy.

Wyjaśnienie skrótów użytych na slajdzie:
UI – User Interface – interfejs użytkownika; Graficzna lub tekstowa warstwa interakcji pomiędzy człowiekiem a systemem komputerowym.
GUI – Graphical User Interface – graficzny interfejs użytkownika; Wbudowana konsola webowa Prometheusa umożliwiająca doraźną weryfikację metryk na wykresach.
PromQL – Prometheus Query Language – język zapytań Prometheus; Składnia zapytań wprowadzana w polu wyszukiwania konsoli webowej serwera.
TSDB – Time Series Database – baza danych szeregów czasowych; Wewnętrzne źródło danych, z którego interfejs pobiera wektory chwilowe i macierze czasowe.
REST – Representational State Transfer – architektura interfejsu REST; Wewnętrzne API serwera obsługujące żądania przesyłane z konsoli webowej przeglądarki.

26/55 Wprowadzenie do PromQL (podstawy)
PromQL - język zapytań Prometheus; przykłady: rate(), histogram_quantile(), sum by(), irate().

PromQL to nie SQL: funkcje na wektorach czasu. Dwie rzeczy na start: wektory i matchery.

  • Składnia języka zapytań PromQL – zapytanie składa się z nazwy metryki, filtrów etykiet oraz opcjonalnych funkcji agregujących i matematycznych.
  • Wektor natychmiastowy (Instant Vector) – zwraca pojedynczą, najnowszą wartość dla każdego szeregu czasowego pasującego do selektora.
  • Wektor zakresowy (Range Vector) – dodanie przedziału czasowego (np. [5m]) zwraca tablicę próbek z danego okresu dla każdego szeregu.
  • Kluczowa funkcja rate() – oblicza średni przyrost licznika na sekundę w zadanym oknie, automatycznie obsługując resety licznika po restarcie.
  • Podstawy akademickie PromQL – opanowanie logiki wektorowej jest warunkiem koniecznym do poprawnego formułowania warunków alarmowych i wskaźników SLI.
Wektor czasowy: Wektor błyskawiczny to wartość metryki w chwili „teraz”, a wektor zakresowy to ciąg wartości w oknie czasu; funkcje tempa wymagają wektora zakresowego.
przykładowe zapytanie
CLI · PromQL: pierwsze zapytanie
http://localhost:9090/graph # zapytanie PromQL http_requests_total{job="api"} # licznik żądań na sekundę rate(http_requests_total{job="api"}[5m])

Wektory natychmiastowe a zakresowe w języku PromQL: Zrozumienie różnicy między wektorami jest kluczem do opanowania języka PromQL. Wektor natychmiastowy (np. http_requests_total) zwraca wyłącznie jedną, najświeższą liczbę dla każdego szeregu. Z kolei wektor zakresowy z dopisanym oknem czasu (np. http_requests_total[5m]) zwraca cały ciąg próbek zarejestrowanych w ciągu ostatnich pięciu minut. Sam wektor zakresowy nie może być bezpośrednio narysowany na wykresie liniowym – musi zostać przetworzony przez funkcję agregującą, taką jak rate() lub increase(), która przekształca historię próbek z powrotem w pojedynczą wartość prędkości.

W zapytaniach języka PromQL kluczowe znaczenie ma poprawna kolejność operatorów:

# Poprawne wyliczenie: najpierw tempo dla pojedynczych serii, potem agregacja sumaryczna
sum by (job) (rate(http_requests_total{status=~"5.."}[5m]))

# Błąd architektoniczny: sumowanie przed funkcją rate() prowadzi do błędnych wartości przy restarcie instancji!
# rate(sum(http_requests_total)[5m])  <-- ZAPIS ZABRONIONY

Funkcja rate() kompensuje resety liczników wyłącznie wtedy, gdy operuje na pojedynczych szeregach czasowych. Zastosowanie jej po uprzednim zsumowaniu niszczy informację o punktach resetu.

PromQL to język zapytań Prometheus - nie SQL, lecz funkcyjny język operujący na wektorach czasowych. Fundamentem są dwa typy wektorów (instant vs range), selekcja metryki z label matchers, funkcje agregacji (sum, avg, max, topk) oraz gotowe wzorce na RPS i p99 latency; bez tego alfabetu dalsze pojęcia (histogram_quantile, subqueries, recording rules) pozostaną nieczytelne.

Selekcja metryki - Instant vs Range Vector: `http_requests_total` → Instant Vector (jedna wartość per seria NA TERAZ). `http_requests_total[5m]` → Range Vector (macierz wartości per seria w oknie 5 minut: punkty co scrape interval, np. 15s → 20 punktów). To Rozróżnienie jest kluczowe: funkcje `rate()`, `increase()`, `histogram_quantile()` przyjmują wyłącznie wektor zakresowy (range vector, np. `[5m]`). Wektor chwilowy reprezentuje pojedynczą wartość w danym momencie, natomiast wektor zakresowy to seria punktów w czasie. Podanie `rate(http_requests_total)` bez parametru zakresu skutkuje błędem parsowania.

Filtrowanie Label Matchers - selekcja podzbioru serii: `{job="api"}` (dokładnie), `{job!="api"}` (negacja), `{job=~"api.*"}` (regex match), `{job!~"api.*"}` (regex not match). Można łączyć: `{job="api", method=~"GET|POST", handler="/api/users"}`. Label matchers działają jak WHERE w SQL, ale na etykietach (wymiarach). Sprawne filtrowanie = szybkie zapytania (mniej serii do przetworzenia). Regex (`=~`) wolniejszy niż exact match (`=`) - używaj exact gdzie się da.

Agregacje - redukcja wymiarów: `sum`, `avg`, `max`, `min`, `count`, `stddev`, `topk(n, ...)`, `bottomk(n, ...)`. `by (label1, label2)` = zachowaj wymienione labeli, zsumuj resztę. `without (label)` = usuń wymieniony label, zsumuj resztę. Przykład: `sum by (job) (rate(http_requests_total[5m]))` → total RPS per job (label `job` zachowany, `instance`, `method`, `handler` zsumowane). `sum without (instance) (...)` → to samo, ale jawne usunięcie `instance`. Agregacja to sposób na "złapanie" setek serii w kilka linii na dashboardzie.

Prosty przykład - RPS i p99: `rate(http_requests_total{job="api"}[5m])` → RPS per seria (instance+method+handler). `sum(rate(http_requests_total{job="api"}[5m]))` → total RPS dla job="api". `histogram_quantile(0.99, rate(http_request_duration_seconds_bucket{job="api"}[5m]))` → p99 latency per seria (wymaga histogram buckets). `sum by (handler) (histogram_quantile(...))` → p99 per endpoint. To 3 najczęstsze wzorce w praktyce: rate (przepływ), sum (agregacja), histogram_quantile (percentyle).

Szczegółowy PromQL (wykład 3): Histogram quantile (algorytm interpolacji, buckety), Subqueries (zagnieżdżone range vectors: `rate(...[5m:30s])`), Recording Rules (pre-compute: `job:requests:rate5m = sum by (job) (rate(http_requests_total[5m]))`), Subquery optimization (step alignment), Debugging via Query Inspector (w Grafanie: `Explain` → plan zapytania, czas, liczba serii). To zaawansowane tematy - tu budujemy fundamenty.

Czas na PromQL - język zapytań Prometheusa. W przeciwieństwie do SQL to język funkcyjny operujący na wektorach czasowych, i to rozróżnienie warto zapamiętać od razu. Wektor błyskawiczny to wartość metryki w chwili „teraz", a wektor zakresowy - ciąg wartości w oknie czasu, takim jak pięć minut. Funkcje liczące tempo zmian czy percentyle przyjmują wyłącznie wektory zakresowe, o czym przypomina nawias z oknem czasu. Do wyboru serii służą matchery po etykietach - dokładne dopasowanie, negacja oraz wyrażenie regularne.

Do tego dochodzą agregacje: sum, avg, max czy topk redukują wymiary, grupując wyniki według podanych etykiet. Najczęściej używanym wzorcem jest policzenie liczby żądań na sekundę przypadającej na grupę celów - zobaczycie go w konsolowych przykładach poniżej, wraz z pierwszym, najprostszym zapytaniem.

Wyjaśnienie skrótów użytych na slajdzie:
PromQL – Prometheus Query Language – język zapytań Prometheus; Zaawansowany język funkcyjny wspierający wektory chwilowe, zakresowe i agregacje przestrzenne.
TSDB – Time Series Database – baza danych szeregów czasowych; Silnik składowania, którego schemat metryka{etykieta=wartość} jest fundamentem PromQL.
Regex – Regular Expression – wyrażenie regularne; Wzorzec tekstowy obsługiwany przez operatory `=~` oraz `!~` w selektorach języka PromQL.
POSIX – Portable Operating System Interface – standard przenośnego systemu operacyjnego; Standard zgodności składniowej, na którym opiera się silnik wyrażeń regularnych w Prometheusie.
ASCII – American Standard Code for Information Interchange – amerykański standardowy kod do wymiany informacji; Standard kodowania znaków alfanumerycznych stanowiący bazę nazw metryk i etykiet.

27/55 Zbieranie metryk o usługach
Throughput (przepustowość) - RPS/TPM; wskaźnik operacyjny do planowania pojemności i autoskalingu.

Metryki usług bierzemy trzema drogami: z kodu, spomiędzy (middleware) i z zewnątrz (blackbox).

  • Instrumentacja aplikacji własnych – biblioteki klienckie w Pythonie, Go czy Javie pozwalają programistom wystawiać autorskie metryki biznesowe.
  • Eksportery dla systemów zastanych – gotowe oprogramowanie pośredniczące (np. Blackbox, Nginx, PostgreSQL) tłumaczy obce formaty na metryki Prometheus.
  • Standardowy endpoint telemetryczny – przyjętą konwencją architektoniczną jest udostępnianie metryk przez protokół HTTP pod ścieżką /metrics.
  • Bezpieczeństwo punktu styku – endpoint telemetryczny powinien być odizolowany w sieci wewnętrznej lub zabezpieczony mechanizmem uwierzytelniania.
  • Higiena metryk aplikacyjnych – programista powinien unikać tworzenia zbędnych metryk, skupiając się na kluczowych zdarzeniach transakcyjnych.
Biblioteka kliencka: Osadzony w kodzie aplikacji sposób eksponowania metryk (w tym biznesowych); najbogatsze źródło danych obok warstwy HTTP i testów syntetycznych.
metryki usługi

Metryki z aplikacji zbiera się trzema ścieżkami: Native Instrumentation (client libraries w kodzie - najbogatsze dane), HTTP Middleware (standardowe RED metrics bez pisania kodu per endpoint) i Blackbox Exporter (syntetyczne testy z zewnątrz, perspektywa użytkownika). Z tych metryk buduje się SLI (availability, latency) przez recording rules - to most między "mamy Prometheus" a "mamy SLI/SLO dla naszego serwisu".

Client Libraries - Native Instrumentation: Aplikacja SAME eksponuje `/metrics` przez bibliotekę klienta. Go: `promhttp.Handler()` (stdlib), Python: `prometheus_client` (pip), Java: JMX + `jmx_exporter` (agent), .NET: `prometheus-net`, Node.js: `prom-client`. Zaleta: FULL CONTEXT - labeli z kodu biznesowego (`user_tier="premium"`, `feature_flag="new_checkout"`), custom metrics (business KPIs: `orders_total`, `payment_latency_seconds`, `cache_hit_ratio`). Wady: wymaga zmian w kodzie, code review, deploy. To "złoty standard" dla nowych serwisów.

HTTP Metrics - Standardowe RED z Middleware: Nie musisz instrumentować każdego endpointu ręcznie. Middleware (Go: `promhttp.InstrumentHandler`, Python: `PrometheusMiddleware`, Java: `Micrometer` + Spring Boot Actuator) automatycznie dodaje: `http_requests_total{method, handler, status}` (Counter), `http_request_duration_seconds_bucket{method, handler}` (Histogram). To RED Metrics: Rate (RPS), Errors (5xx rate), Duration (latency percentyle). Działa out-of-the-box, zero custom code. Label `handler` = route pattern (`/api/users/:id` znormalizowane, nie surowy path). To "szybki start" dla istniejących aplikacji.

Blackbox Exporter - Syntetyczne testy z zewnątrz: Zero zmian w kodzie aplikacji. Proces `blackbox_exporter` (port 9115) wykonuje próby (sondowania) z zewnątrz: HTTP/HTTPS (status code, latency, TLS cert expiry, content match regex, redirect chain), TCP (connect timeout), DNS (resolve time, record verification), ICMP (ping). Konfiguracja w `blackbox.yml`: moduły (np. `http_2xx`, `http_post_5s`, `tcp_connect`, `dns_tcp`). Prometheus scrapuje: `blackbox_exporter:9115/probe?target=https://api.example.com&module=http_2xx`. Perspektywa: "czy user widzi działającą usługę?" - komplementarne do whitebox.

Definiowanie SLI z metryk aplikacji - Recording Rules: Surowy PromQL w alertach/dashboardach = wolno i błędogennie. Recording rules pre-aggregują: `job:sli:availability:ratio = sum(rate(http_requests_total{job="api",status=~"2..|3.."}[5m])) / sum(rate(http_requests_total{job="api"}[5m]))` → gotowy SLI (0.0-1.0). `job:sli:latency:p95 = histogram_quantile(0.95, sum by (le,handler) (rate(http_request_duration_seconds_bucket{job="api"}[5m])))`. Ewaluacja co 30s/1m → alerty na `job:sli:availability:ratio < 0.999` są BŁYSKOWICZNE. To wzorzec produkcyjny: SLI = recording rule, alert na SLI.

Terminologia: client library (biblioteka klienta), blackbox exporter (eksporter czarnej skrzynki), service metrics (metryki usługi), RED metrics (Rate, Errors, Duration), synthetic monitoring (monitoring syntetyczny), prober (sonda testująca), middleware instrumentation (instrumentacja middleware).

Do tej pory zbieraliśmy metryki z systemów; teraz zbieramy je z samych usług. Są trzy ścieżki. Najbogatsze dane daje biblioteka klienta osadzona w kodzie aplikacji - to ona pozwala eksponować metryki biznesowe i etykiety znane tylko aplikacji. Drugą ścieżką jest warstwa pośrednia HTTP, która bez pisania kodu per endpoint dodaje liczniki żądań i histogramy latencji z etykietami metody, ścieżki i kodu odpowiedzi. Trzecią stanowią testy syntetyczne z zewnątrz, czyli perspektywa użytkownika.

Z tych metryk budujemy potem SLI. Najprostszy wzorzec to ułamek dobrych odpowiedzi do wszystkich zapytań, zapisany jako reguła nagrywająca - dzięki niej gotowy wskaźnik dostępności jest dostępny do alertów i dashboardów natychmiast, bez wykonywania ciężkich zapytań przy każdym odświeżeniu.

Wyjaśnienie skrótów użytych na slajdzie:
SDK – Software Development Kit – zestaw narzędzi programistycznych; Biblioteki klienckie (np. w Go, Javie, Pythonie) służące do bezpośredniej instrumentacji kodu aplikacji.
API – Application Programming Interface – interfejs programowania aplikacji; Punkty wejściowe usług, na których mierzy się wolumen zapytań i czasy wykonania.
HTTP – Hypertext Transfer Protocol – protokół przesyłania dokumentów hipertekstowych; Protokół warstwy aplikacji, w którym moduły pośredniczące (middleware) zliczają statusy odpowiedzi.
JVM – Java Virtual Machine – maszyna wirtualna Java; Środowisko uruchomieniowe języka Java generujące wewnętrzne metryki wątków i alokacji pamięci.
GC – Garbage Collection – odśmiecanie pamięci; Automatyczny proces odzyskiwania nieużywanej pamięci w aplikacjach obiektowych, generujący przestoje (stop-the-world).

28/55 Health checki w praktyce
Counter - monotonicznie rosnący licznik (nigdy nie maleje). Używaj rate() do obliczenia wartości na sekundę.

Health check to binarny kontrakt: GET co chwilę, 2xx znaczy żyję. Dwie sondy o różnych konsekwencjach.

  • Sondowanie żywotności (Liveness) – proste zapytanie weryfikuje, czy proces aplikacji działa i nie uległ zakleszczeniu w nieskończonej pętli.
  • Sondowanie gotowości (Readiness) – test sprawdza, czy usługa nawiązała połączenie z bazą danych i jest gotowa na przyjmowanie zapytań użytkowników.
  • Sondy głębokie i płytkie – płytki test bada sam serwer WWW, natomiast głęboki weryfikuje integralność całego łańcucha zależności biznesowych.
  • Zagrożenie kaskadową awarią – zbyt agresywne sondy głębokie mogą odciąć całą aplikację przy chwilowej niedostępności drugorzędnej bazy.
  • Integracja z platformami orkiestracji – wyniki sond zdrowia decydują o automatycznym restarcie kontenera przez środowisko Kubernetes.
Health check: Prosty endpoint, o który orkiestrator regularnie pyta („czy żyjesz?”, „czy przyjmiesz ruch?”); rozdziela sondę żywotności od sondy gotowości.
probe health

Health checki to endpointy, o które orkiestrator (Kubernetes, systemd, load balancer) pyta "czy jesteś żywy?" i "czy jesteś gotowy na ruch?" - kontrakty binarne (UP/DOWN) sterujące cyklem życia poda i kontenera. To nie monitoring (metryki): kluczowe jest rozróżnienie Liveness vs Readiness (największa pułapka początkujących) z uzasadnieniem separacji (graceful degradation) i gotowymi przykładami dla Nginx i aplikacji.

HTTP Probe - mechanika: Orkiestrator (K8s kubelet, HAProxy, nginx upstream check) robi `GET /health` (lub `/healthz`, `/ready`) co N sekund (np. 10s). Oczekiwany: `200 OK` (body może być pusty lub JSON `{"status":"ok"}`). Odpowiedzi `5xx`, `4xx` lub przekroczenie limitu czasu (timeout, domyślnie 1–5 s) oznaczają brak gotowości (stan unhealthy). Punkt końcowy musi być lekki (pozbawiony zapytań do bazy danych czy wywołań zewnętrznych) – weryfikuje on jedynie, czy proces odpowiada, a nie czy całe środowisko działa. Krótki limit czasu zapewnia szybkie wykrycie zawieszenia procesu.

Liveness vs Readiness - dwa różne punkty końcowe, dwa różne znaczenia: Liveness (`/healthz`, `/live`) - "Czy proces jest żywy?" (nie zawisł, nie OOM kill). Jeśli FAIL → K8s: RESTART POD (kill container, start nowy). Readiness (`/ready`, `/health`) - "Czy gotowy przyjmować ruch użytkownika?" (DB connected, cache warmed, migrations done, feature flags loaded). Jeśli FAIL → K8s: usuń z punktów końcowych usługi (pod żyje, ale nie dostaje ruchu). To Rozróżnienie jest kluczowe: aplikacja może ŻYĆ (liveness OK) ale nie być gotowa (readiness FAIL) - np. podczas startu (DB migration), gdy cache się grzeje, gdy feature flag wyłącza funkcjonalność. Mieszanie ich = albo niepotrzebne restarty (liveness na readiness), albo ruch na niegotowe pody (readiness na liveness).

Rozdzielenie = Graceful Degradation: Scenariusz: Aplikacja startuje → DB migration trwa 30s. Liveness = OK (proces odpowiada), Readiness = FAIL (migracja w toku) → K8s nie kieruje ruchu → user nie dostaje 500. Po migracji: Readiness = OK → ruch wraca. Inny scenariusz: Cache warming → Readiness FAIL do momentu wypełnienia cache. To eliminuje "thundering herd" na zimnym starcie. Health endpoint = KONTRAKT z orkiestratorem - jasne, proste, deterministyczne.

Przykłady implementacji: Nginx: `location /health { return 200 'ok'; }` (statyczny, zawsze OK - do liveness). Aplikacja (Go/Python/Java): `/healthz` → sprawdź: proces żyje (trivial), `/ready` → sprawdź: `db.Ping()` (connection pool), `redis.Ping()`, `kafka.Metadata()`, feature flags loaded, config loaded. Body JSON: `{"status":"ok","checks":{"db":true,"redis":true,"cache_warmed":false}}` - pozwala debugować, skąd dokładnie pochodzi FAIL. Timeout: ustaw w orkiestratorze (K8s: `livenessProbe.timeoutSeconds: 5`, `readinessProbe.timeoutSeconds: 3`).

Terminologia: liveness probe (sonda żywotności), readiness probe (sonda gotowości), health endpoint (endpoint zdrowia), startup probe (sonda startowa - K8s 1.16+ alpha / 1.18+ beta, dla długiego startu), Kubernetes probes (sondy K8s), graceful degradation (płynna degradacja - usługa działa częściowo zamiast crashować).

Health checki to proste endpointy, o które orkiestrator - Kubernetes, systemd czy load balancer - pyta w regularnych odstępach: „czy jeszcze żyjesz?" i „czy możesz przyjąć ruch?". To kontrakty binarne: odpowiedź OK oznacza stan zdrowy, a błąd, przekroczenie czasu czy brak odpowiedzi - stan niezdrowy. Mechanika jest wspólna w całym ekosystemie: GET na endpoint co kilka sekund, oczekiwany kod 2xx, i sterowanie cyklem życia poda na podstawie wyniku.

Kluczem jest rozdzielenie dwóch sond. Sonda żywotności sprawdza, czy proces nie zawisł - jej porażka kończy się restartem poda. Sonda gotowości sprawdza, czy aplikacja może już przyjąć ruch, na przykład gdy baza jest jeszcze w trakcie migracji - jej porażka nie powoduje restartu, lecz chwilowe wyjęcie poda z usługi. Przykładowo w Nginx wystarczy statyczna odpowiedź 200, a w aplikacji odpowiedź JSON z listą zależności, które trzeba było sprawdzić.

Wyjaśnienie skrótów użytych na slajdzie:
HTTP – Hypertext Transfer Protocol – protokół HTTP; Protokół weryfikacji zdrowia, w którym kody 200 oznaczają gotowość, a kody 5xx awarię usługi.
K8s – Kubernetes – orkiestrator kontenerów Kubernetes; Platforma rozróżniająca sondy żywotności (liveness) od sond gotowości (readiness) aplikacji.
TCP – Transmission Control Protocol – protokół sterowania transmisją; Protokół wykorzystywany do niskopoziomowego testu otwarcia gniazda sieciowego usługi.
UDP – User Datagram Protocol – protokół datagramów użytkownika; Bezpołączeniowy protokół transportowy stosowany m.in. w usługach DNS i przesyłaniu strumieniowym.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Protokół kryptograficzny, którego ważność certyfikatu jest krytycznym elementem kontroli zdrowia.

29/55 Metryki czasu odpowiedzi
Gauge - wartość mogąca rosnąć i spaść (snapshot stanu). Nie używaj rate() - do zmiany w czasie użyj deriv().

Czas odpowiedzi mierz percentylami, nie średnią. Mediana kłamie o ogonie, a ogon to skargi.

  • Złożoność pomiaru czasu wykonania – pojedyncze opóźnienie w operacji wejścia/wyjścia może spowolnić całe żądanie, wymagając pomiaru w podziale na fazy.
  • Pomiary po stronie klienta i serwera – serwer mierzy czas generowania odpowiedzi, natomiast klient doświadcza dodatkowego opóźnienia sieciowego.
  • Rejestracja latencji w histogramach – precyzyjny pomiar wymaga podziału zapytań na koszyki czasowe (buckets), np. od 50 ms do 10 sekund.
  • Wpływ odśmiecania pamięci (GC) – cykle czyszczenia pamięci w językach takich jak Java wywołują chwilowe, trudne do wychwycenia skoki opóźnień.
  • Śledzenie wąskich gardeł – korelacja histogramów czasu z metrykami nasycenia procesora pozwala ustalić fizyczną przyczynę powolnej pracy serwisu.
Percentyle latencji: p50 (mediana, typowy użytkownik), p95 (standard umów SLA), p99 (ogon); średnia nie jest właściwą miarą czasu odpowiedzi.
wykres percentyli

Ocena jakości usług wymaga odrzucenia średniej arytmetycznej na rzecz analizy percentyli czasów odpowiedzi:
- Mediana (p50) odzwierciedla doświadczenie typowego użytkownika, lecz całkowicie maskuje zjawisko długiego ogona (ang. long tail),
- Percentyle p95 oraz p99 definiują opóźnienia dotykające najbardziej wymagających lub pechowych zapytań i to one stanowią podstawę umów o poziomie usług (SLA),
- W systemie Prometheus percentyle obliczane są funkcyjnie na podstawie koszyków histogramu za pomocą polecenia histogram_quantile(0.99, sum(rate(http_request_duration_seconds_bucket[5m])) by (le)).

Metryki latencji (response time) to najważniejszy wskaźnik jakości usług user-facing, a ich miarą są percentyle (p50, p95, p99, p99.9) - mediana (p50) to ZŁE SLI. Histogramy Prometheus pozwalają obliczać percentyle po stronie serwera, a rozkład (wąski vs szeroki) dzieli "monitoring" od "engineering SLI": bez zrozumienia tail latency nie da się ustawić sensownego SLO.

Percentyle - co to jest i dlaczego p50 nie wystarczy: Percentyl pX = wartość, poniżej której mieści się X% obserwacji. p50 (mediana) = typowy użytkownik. p95 = 95% żądań szybszych (standard SLA). p99 = tail latency (najgorsze 1%) - to TU rodzą się skargi użytkowników. p99.9 = extreme tail (0.1% = 1 na 1000). PRZYKŁAD: 1000 req/s, p50=100ms (wszystko OK?), ale p99=10s → 10 req/s ma timeout → 10 users/s frustrowanych. p50 ukrywa ten problem. SLA/SLO musi bazować na p95/p99, nie p50. "Mediana to kłamstwo statystyczne w SRE".

Dlaczego mediana nie wystarczy - matematyka tail latency: Rozkład latencji NIE jest normalny (Gauss) - to heavy-tailed distribution (długa ogon). W systemach rozproszonych: GC pauses (JVM/Go), lock contention, slow SQL queries, thread pool exhaustion, network hiccups - wszystko tworzy długi ogon. p50 ignoruje ogon. p99/p99.9 GO OGON. SLA często: "p99 < 500ms" - to wymusza inżynierię ogona (connection pooling, async, timeouts, circuit breakers). p50-based SLO = fałszywe poczucie bezpieczeństwa.

Histogramy w Prometheus - obliczanie percentyli po stronie serwera: Histogram = buckety (`_bucket{le="0.1"}`, `_bucket{le="0.5"}`, ..., `_bucket{le="+Inf"}`) + `_sum` + `_count`. `le` (Less or Equal) = górna granica bucketa. `histogram_quantile(0.99, rate(http_request_duration_seconds_bucket[5m]))` → interpolacja liniowa między bucketami → p99. `_sum` / `_count` = średnia (avg). ZALETA: agregowalne cross-instance (sumowanie buckety z 100 podów). To standard w Prometheus - nie liczymy percentyli w aplikacji (Summary), liczymy w PromQL.

Interpretacja rozkładu - diagnostyka przez kształt: Wąski rozkład (p50 ≈ p95 ≈ p99, np. 100ms / 120ms / 150ms) = stabilne, przewidywalne, zdrowe. Szeroki rozkład (p50=100ms, p95=500ms, p99=5s, p99.9=30s) = PROBLEMY. Typowe przyczyny szerokiego rozkładu: GC pauses (JVM: G1/ZGC, Go: pacer), lock contention (mutex, DB row locks), slow queries (brak indeksu, table scan), thread pool exhaustion (HikariCP, Tomcat threads), network retransmits, queueing (Little's Law: latency = queue_length / throughput). Kształt rozkładu = diagnoza BEZ logów.

Terminologia: latency (opóźnienie), percentile (percentyl), tail latency (opóźnienie ogonowe), histogram (histogram), histogram_quantile (funkcja PromQL do kwantyli), bucket (przedział), le label (label Upper Bound), distribution (rozkład), SLA threshold (próg SLA).

Czas odpowiedzi to najważniejszy wskaźnik jakości usług widocznych dla użytkownika, a jego właściwą miarą nie jest średnia, lecz percentyle. Mediana opisuje typowego użytkownika, p95 jest przyjętym standardem w umowach SLA, a p99 to tak zwana latencja ogonowa - najwolniejsze jeden procent żądań, który najczęściej rodzi skargi. Oto dlaczego mediana bywa myląca: jeśli p50 to sto milisekund, ale p99 sięga dziesięciu sekund, to jeden procent użytkowników doświadcza czasu oczekiwania graniczącego z timeoutem, a mediana tego nie pokaże.

Percentyle wyliczamy funkcją histogram_quantile na histogramach, które Prometheus skleja z wielu instancji. Kształt rozkładu mówi sam za siebie: gdy p50, p95 i p99 leżą blisko siebie, usługa jest stabilna i przewidywalna; gdy rozjeżdżają się na rzędy wielkości, w systemie coś się dzieje - pauzy odśmiecania pamięci, rywalizacja o blokady, wolne zapytania do bazy czy wyczerpanie puli wątków.

Wyjaśnienie skrótów użytych na slajdzie:
RTT – Round Trip Time – czas podróży w obie strony; Czas potrzebny na przesłanie pakietu danych od źródła do odbiorcy i odebranie potwierdzenia powrotnego.
TTFB – Time To First Byte – czas do odebrania pierwszego bajtu; Wskaźnik opóźnienia serwera mierzony od zakończenia transmisji żądania do nadejścia nagłówka odpowiedzi.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; Kontrakt biznesowy, którego zapisy dotyczące opóźnień bazują na restrykcyjnych percentylach p99.
SLO – Service Level Objective – cel poziomu usług; Wewnętrzny limit inżynierski wyznaczający maksymalny dopuszczalny czas odpowiedzi w warunkach szczytu.
HTTP – Hypertext Transfer Protocol – protokół przesyłania dokumentów hipertekstowych; Protokół bazowy, dla którego czasy żądań rejestrowane są w dedykowanych histogramach.

30/55 Definiowanie SLI na podstawie metryk
Weryfikacja SLI - testy syntetyczne (blackbox) + dane z produkcji; porównanie SLI z historycznym baseline; alertowanie przy odchyleniu.

SLI dostępności składasz z dwóch temp: dobre przez wszystkie. Mianownik bierze wszystko, nawet 4xx.

  • Formułowanie zapytań dla SLI – wskaźnik jakości zapisuje się w PromQL jako iloraz zapytania filtrującego sukcesy do zapytania o ruch całkowity.
  • Przykład SLI dostępności – zapytanie dzieli liczbę żądań z kodami 2xx/3xx przez sumę wszystkich zapytań w zdefiniowanym przedziale czasu.
  • Przykład SLI latencji – formuła wylicza odsetek zapytań obsłużonych poniżej zadanego progu, korzystając z koszyków histogramu czasu odpowiedzi.
  • Odporność zapytań na brak ruchu – formuły PromQL muszą poprawnie obsługiwać dzielenie przez zero w godzinach nocnych za pomocą funkcji or on().
  • Fundament reguł alarmowych – precyzyjnie zdefiniowane zapytanie SLI stanowi bazę do wyliczania budżetu błędów i konfigurowania powiadomień.
Reguła nagrywająca (recording rule): Wstępne wyliczenie kosztownego zapytania zapisane jako nowa metryka, dostępna od razu dla alertów i pulpitów.
formuła SLI

SLI z metryk HTTP buduje się od surowych counterów do engineered metric (0.0-1.0): licznik dobrych odpowiedzi (numerator) dzielony przez licznik wszystkich odpowiedzi (denominator), zapisywany jako produkcyjna recording rule. Mianownik musi zawierać wszystkie żądania (w tym kody 4xx oraz przekroczenia limitu czasu), a spójność etykiet (job, instance) jest kluczowa; reguła rejestrująca (recording rule) to standard produkcyjny, eliminujący konieczność pisania surowego PromQL w regułach alertów.

Licznik dobrych odpowiedzi (Numerator - Good): `sum(rate(http_requests_total{status=~"2..|3.."}[5m]))` - sumujemy rate counterów z kodami 2xx (sukces) i 3xx (redirecty traktowane jako sukces). Label `status` jest KLUCZOWY - bez niego nie da się odfiltrować sukcesów. `=~"2..|3.."` = regex match na 2xx LUB 3xx. Recording rule: `job:sli:availability:ratio_good = sum(rate(http_requests_total{job="api",status=~"2..|3.."}[5m]))` → gotowy licznik dobrych per job. To eliminuje powtarzanie skomplikowanego regexu w każdym zapytaniu.

Licznik wszystkich odpowiedzi (Denominator - Total): `sum(rate(http_requests_total[5m]))` - WSZYSTKIE requesty: 2xx, 3xx, 4xx (client errors), 5xx (server errors), timeouty (jeśli są logowane jako request). Błąd początkujących: denominator = tylko 2xx+5xx (pomijając 4xx). Jest to fałszywy wskaźnik SLI – błędy 4xx to także żądania, które zużywają zasoby i wpływają na dostępność (np. 429 Too Many Requests = nasycenie). Denominator musi być uniwersalny: "wszystko, co trafiło do serwera".

Wzór ułamka - SLI = Good / Total: `good / total` → wynik 0.0-1.0 (lub 0%-100%). Pełny zapis jako Recording Rule: `job:sli:availability:ratio = sum(rate(http_requests_total{job="api",status=~"2..|3.."}[5m])) / sum(rate(http_requests_total{job="api"}[5m]))`. To SLI dostępności. Dla latency SLI: `job:sli:latency:p95 = histogram_quantile(0.95, sum by (le,handler) (rate(http_request_duration_seconds_bucket{job="api"}[5m])))` - ułamek requestów szybszych niż próg (wymaga uzupełnienia o dzielenie przez total). SLI = engineered metric (skonstruowana), nie raw metric.

Zapis jako PromQL - Recording Rules: Surowy PromQL w alertach/dashboardach = wolno (heavy query), ryzyko błędów (copy-paste), trudne utrzymanie. Recording Rule: pre-compute co `evaluation_interval` (domyślnie 30s/1m) → gotowy czasowy szereg `job:sli:availability:ratio`. Alert: `job:sli:availability:ratio < 0.999` (błyskawiczny, prosty). Label consistency CRITICAL: `job`, `instance` muszą być spójne w numerator i denominator (sum by job w obu). Mismatch labeli = błędne SLI (dzielenie jabłek przez gruszki).

Terminologia: SLI formula (wzór SLI), good/total (dobre/wszystkie), recording rule (reguła nagrywająca/wstępnie agregująca), ratio (iloraz), availability SLI (SLI dostępności), latency SLI (SLI latencji: requests < threshold / total), label consistency (spójność etykiet).

SLI dostępności budujemy z surowych liczników w dwóch krokach. W liczniku dobrych odpowiedzi sumujemy tempo żądań, które zakończyły się sukcesem, czyli kodami 2xx i 3xx. W mianowniku sumujemy tempo wszystkich żądań - łącznie z błędami 4xx i przekroczeniami czasu. Iloraz obu liczb daje wskaźnik od zera do jednego: ile żądań na każde sto kończy się sukcesem. Zapisujemy go jako regułę nagrywającą, by wynik był liczony stale i dostępny od razu dla alertów i pulpitów.

Dwie rzeczy wymagają tu szczególnej uwagi. Po pierwsze mianownik musi zawierać wszystkie żądania, także 4xx - to również są żądania, które obciążają serwer i wpływają na dostępność. Po drugie etykiety w liczniku i mianowniku muszą być spójne: jeśli grupujemy po usłudze, oba składniki muszą być liczone w tej samej usłudze. Inaczej dzielilibyśmy nieporównywalne liczby.

Wyjaśnienie skrótów użytych na slajdzie:
PromQL – Prometheus Query Language – język zapytań Prometheus; Narzędzie służące do konstruowania wzorów wskaźników SLI w postaci ułamka dobrych zdarzeń.
HTTP – Hypertext Transfer Protocol – protokół przesyłania dokumentów hipertekstowych; Standard komunikacyjny, którego żądania kategoryzowane są jako poprawne lub błędne.
Regex – Regular Expression – wyrażenie regularne; Składnia dopasowania używana do selekcji kodów HTTP: status=~'2..|3..' w mianowniku wzoru SLI.
SLI – Service Level Indicator – wskaźnik poziomu usług; Kluczowa miara sukcesu inżynierskiego wyliczana ze stosunku udanych zapytań do wszystkich zarejestrowanych.
SLO – Service Level Objective – cel poziomu usług; Próg odniesienia, z którym na bieżąco porównywany jest wynik zapytania SLI.

31/55 Monitoring czarny i biały box
Saturation (nasycenie) - miara wykorzystania zasobów: CPU, RAM, dysk, sieć, pool połączeń. USE method: Utilization, Saturation, Errors.

Dwie pary oczu: biała skrzynka patrzy do środka (dlaczego), czarna z zewnątrz (czy działa). Potrzebujesz obu.

  • Sondowanie z zewnątrz (Blackbox) – narzędzie blackbox_exporter testuje usługi z perspektywy klienta przez protokoły HTTP, DNS, TCP i ICMP.
  • Telemetria wewnętrzna (Whitebox) – metryki wystawiane bezpośrednio przez kod aplikacji obrazują wewnętrzny stan wątków, kolejek i pamięci.
  • Komplementarność obu podejść – Blackbox informuje, czy usługa odpowiada użytkownikom, natomiast Whitebox wyjaśnia wewnętrzne przyczyny spowolnienia.
  • Symulacja transakcji użytkownika – zaawansowane sondy syntetyczne potrafią symulować proces logowania i weryfikować poprawność zwracanego kodu HTML.
  • Lokalizacja geograficzna sond – rozmieszczenie sond w różnych ośrodkach pozwala odróżnić lokalną awarię łącza od problemu z serwerem głównym.
Blackbox i whitebox: Monitoring czarnej skrzynki patrzy z zewnątrz jak użytkownik (sondy), a białej skrzynki - do środka przez instrumentację kodu (dlaczego tak się dzieje).
porównanie podejść

Sondowanie Blackbox a Whitebox: Wyobraźmy sobie samochód. Monitoring Whitebox to kontrolki na desce rozdzielczej podpięte bezpośrednio do komputera pokładowego – informują o temperaturze oleju, ciśnieniu w oponach i obrotach silnika. Monitoring Blackbox to obserwator stojący na zewnątrz, który sprawdza, czy samochód faktycznie jedzie do przodu i czy świecą światła. W systemach IT monitorowanie wewnętrzne (Whitebox) może raportować pełną sprawność bazy i procesorów, podczas gdy z powodu błędu w regułach zapory ogniowej żaden klient z zewnątrz nie może połączyć się z serwerem. Dopiero połączenie obu metod daje pełną gwarancję stabilności.

Strategia monitoringu opiera się na rozróżnieniu White-box (wewnątrz, instrumentacja kodu) i Black-box (z zewnątrz, syntetyczne testy) - to nie wybór "albo-albo", lecz "OBA", bo odpowiadają na różne pytania: White-box mówi "DLACZEGO" (stan wewnętrzny: DB pool, GC, queue), Black-box "czy usługa działa poprawnie dla użytkownika" (DNS, TLS, LB, sieć). Defense in depth to alerting na obu; whitebox to standard, a blackbox monitoruje critical user journeys.

White-box Monitoring (Wewnętrzny / Białe pudełko): Aplikacja SAMA eksponuje metryki na `/metrics` przez client libraries. Co widzi: Wszystko wewnątrz - histogram latencji PER ENDPOINT (`handler="/api/users"`), DB connection pool usage (`hikaricp_active_connections`), cache hit ratio, GC pauses, queue depth, business metrics (`orders_total`). Wymaga: instrumentacji kodu (client libraries, middleware). Odpowiada na pytanie: "DLACZEGO system się zachowuje tak?" (root cause context). To "microscope" inżyniera.

Black-box Monitoring (Zewnętrzny / Czarne pudełko): Proces `blackbox_exporter` (lub inny prober) wykonuje SYNTETYCZNE TESTY z perspektywy KLIENTA. Co testuje: HTTP GET `/login` z zewnątrz (przez publiczny DNS, LB, WAF, CDN) → sprawdź: status 200, body contains "Welcome", TLS cert expiry > 30 dni, redirect chain length < 3, response time < 2s. TCP connect do portu 443. DNS resolve `api.example.com` → NOERROR, A record matches. ICMP ping. Odpowiada na pytanie: "czy usługa działa poprawnie dla użytkownika?" To "teleskop" - widzi cały path: user → DNS → CDN → WAF → LB → App.

Oba uzupełniają się - Defense in Depth: White-box = "dlaczego" (internal state: connection pool exhausted). Black-box = "czy działa" (external view: user gets 502). ALERTING NA OBU = defense in depth. Scenariusz: App deployment psuje DB schema → White-box: `db_migration_errors_total` spike → alert przed wystąpieniem wpływu na użytkowników. Black-box: `/login` probe 500 → alert Gdy user IMPACT. White-box = early warning (proaktywny), Black-box = SLA verification (reaktywny, ale od usera). Bez whitebox = lecisz ślepo (widzisz up/down, nie wiesz dlaczego). Bez blackbox = "u mnie działa" (widzisz internal OK, ale user widzi 502 przez LB/WAF).

Przykłady konkretne: White-box: `http_request_duration_seconds_bucket{handler="/api/orders"}` (p99 per endpoint), `jvm_gc_pause_seconds_sum` (GC impact), `hikaricp_connections_active / hikaricp_connections_max` (DB pool saturation). Black-box: `probe_success{module="http_2xx",target="https://api.example.com/login"}` (0/1), `probe_http_duration_seconds{phase="connect"}` (TLS handshake time), `probe_ssl_earliest_cert_expiry` (cert expiry alert). Kiedy które: Dobór podejścia: monitoring typu white-box stosujemy zawsze (instrumentacja kodu to standard inżynierski o znikomym narzucie). Z kolei monitoring black-box sprawdza się przy kluczowych ścieżkach użytkownika (logowanie, koszyk, płatność), weryfikacji umów SLA, testach wieloregionowych oraz monitorowaniu zewnętrznych zależności (DNS, CDN, zewnętrzne API).

Terminologia: white-box monitoring (monitoring białej skrzynki), black-box monitoring (monitoring czarnej skrzynki), synthetic checks (testy syntetyczne), prober (sonda), critical user journeys (krytyczne ścieżki użytkownika), SLA verification (weryfikacja SLA), dependency monitoring (monitoring zależności), defense in depth (obrona w głąb).

Strategia monitoringu opiera się na dwóch uzupełniających się podejściach. Monitoring białej skrzynki patrzy do środka - aplikacja sama eksponuje metryki przez instrumentację kodu, więc widzimy histogramy latencji per endpoint, obłożenie pul połączeń, przerwy odśmiecania pamięci czy metryki biznesowe. Odpowiada na pytanie „dlaczego system zachowuje się tak, jak się zachowuje?". Monitoring czarnej skrzynki patrzy z zewnątrz: sonda naśladuje użytkownika i sprawdza, czy ścieżka przez DNS, load balancer i aplikację faktycznie działa. Odpowiada na pytanie „czy dla użytkownika usługa działa?".

To nie jest wybór jednej z dwóch metod - w praktyce wdrażamy obie. Biała skrzynka to standard na każdej usłudze i wczesne ostrzeganie o problemach, zanim użytkownik je zobaczy. Czarna skrzynka to weryfikacja umów SLA, testy syntetyczne kluczowych ścieżek użytkownika oraz obserwacja zależności, takich jak DNS czy CDN, z kilku regionów świata. Dopiero połączenie obu daje pełny wgląd: wewnętrzny stan i zewnętrzną perspektywę.

Wyjaśnienie skrótów użytych na slajdzie:
ICMP – Internet Control Message Protocol – protokół kontroli komunikatów internetowych; Narzędzie sondowania sieciowego badające osiągalność węzła za pomocą komunikatów Echo Request/Reply.
TCP – Transmission Control Protocol – protokół kontroli transmisji; Protokół transportowy, którego czas nawiązania sesji (handshake) jest mierzony z zewnątrz.
UDP – User Datagram Protocol – protokół pakietowy użytkownika; Protokół bezpołączeniowy badany za pomocą dedykowanych sond aplikacyjnych.
DNS – Domain Name System – system nazw domenowych; Podsystem zewnętrzny podlegający stałej weryfikacji poprawności rozwiązywania nazw i czasów odpowiedzi.
SSL – Secure Sockets Layer – protokół bezpiecznych gniazd; Historyczny poprzednik protokołu TLS; termin potocznie używany na określenie certyfikatów kryptograficznych.

32/55 Łączenie monitoringu z usługami sieciowymi
Scrape - Prometheus pyta targety o metryki (pull model). Interval: domyślnie 1 min (często konfigurowane jako 15s). Target = endpoint udostępniający metryki w formacie Prometheus.

Awaria usługi DNS unieruchamia natychmiast wszystkie zależne usługi. Warstwę sieciową należy monitorować z równą starannością, dobierając dedykowane narzędzia.

  • Złożoność infrastruktury sieciowej – monitorowanie routerów, przełączników i zapór ogniowych wymaga odmiennych metod niż analiza serwerów Linuksa.
  • Wskaźniki stanu interfejsów – podstawowym parametrem jest stan operacyjny portu, przepustowość w bitach na sekundę oraz liczniki błędów CRC.
  • Wykrywanie przesycenia łączy – analiza wskaźnika saturacji pozwala zawczasu zamówić dodatkową przepustowość przed fizycznym zablokowaniem portu.
  • Automatyzacja diagnostyki sieciowej – integracja metryk sieciowych z serwerami aplikacji pozwala natychmiast wykryć spadek wydajności routingu.
  • Bezpieczeństwo telemetrii sieciowej – ruch monitorujący urządzenia rdzeniowe musi być odseparowany w wydzielonym kanale zarządzającym (OOB).
Zależności krytyczne: Usługi takie jak DNS czy NTP, których awaria kładzie wszystkie systemy naraz; dlatego monitoring obejmuje też warstwę sieciową.
monitoring sieciowy

Monitoring obejmuje także warstwę sieciową - DNS, NTP, RADIUS, LDAP oraz urządzenia sieciowe (routery, switche) - bo to "critical dependencies": awaria serwera DNS uniemożliwia działanie wszystkich usług. DNS monitoruje się przez blackbox exporter (dns module), do każdej warstwy dobiera eksporter (snmp vs blackbox vs node vs custom), a przykład RouterOS (MikroTik) pokazuje metryki interfejsów, IP i routing table - sieć to kod (network as code) i też musi być monitorowana.

DNS Monitoring - Blackbox Exporter `dns` module: DNS to fundament internetu. Blackbox exporter ma moduł `dns`: konfiguracja `blackbox.yml` → `dns:` → `query_name: "example.com"`, `query_type: "A"`, `preferred_protocol: "udp"`. Metryki: `probe_dns_lookup_time_seconds` (czas zapytania), `probe_dns_response_rcode` (kod odpowiedzi: 0=NOERROR, 2=SERVFAIL, 3=NXDOMAIN), `probe_dns_answer_rrs` (rekordy w odpowiedzi - content verification). Alert: `probe_dns_lookup_time_seconds > 0.5` (p99), `probe_dns_response_rcode != 0`. Critical dependency - alert przed awarią aplikacji.

Latency zapytań do usług infrastruktury: Nie tylko DNS. NTP (czas) - dokładność zegara mierzymy na hoście node_exporterem: `node_ntp_offset_seconds`, `node_ntp_rtt_seconds` (offset > 1s = alert). RADIUS (auth) - blackbox moduł `tcp` z `query_response` (sprawdzenie odpowiedzi na Access-Request). LDAP (directory) - moduł `tcp` z `query_response` (weryfikacja odpowiedzi na bind). Wszystkie to CRITICAL DEPENDENCIES - usługa nie działa bez nich. Alert jeśli p99 latency > threshold (np. DNS > 500ms, NTP offset > 1s). Używamy modułów blackbox: `dns`, `tcp`, `http` (+ `icmp`, `grpc`) - latencję zapytania mierzymy metryką `probe_duration_seconds`. To "monitoring zależności" - widzimy problemy u dostawców zanim nasze usługi staną się niedostępne.

Wybór eksporterów - proper tool for each layer: Warstwa 1 (OS/Host): `node_exporter` (CPU, RAM, dysk, sieć). Warstwa 2 (Aplikacja): Client libraries (custom metrics) / `jmx_exporter` (JVM). Warstwa 3 (Sieć/Urządzenia): `snmp_exporter` (router/switch/firewall via SNMP OIDs), `blackbox_exporter` (syntetyczne: HTTP/DNS/TCP/ICMP z zewnątrz). Warstwa 4 (Bazy/Message Queues): `mysqld_exporter`, `redis_exporter`, `kafka_exporter`, `postgres_exporter`. DOBÓR = decyduje o koszcie, pokryciu, maintenance. Nie monitoruj wszystkiego jednym narzędziem.

RouterOS (MikroTik) - przykład Network as Code: MikroTik RouterOS (CHR lub hardware) to popularne urządzenia w SME/Enterprise. Metryki dostępne via: SNMP (standardowe MIB: IF-MIB, IP-MIB) → `snmp_exporter`; Native Prometheus exporter (community: `routeros_exporter`) → `/interface`, `/ip address`, `/routing table`, `/queue`, `/firewall connection tracking`. Konkretne: `/interface ethernet monitor` → status, rate, duplex, RX/TX bytes/errors. `/ip address print` → IP config. `/routing table print` → routes. To traktowanie sieci jak kodu: infrastruktura jako dane, monitorowana, wersjonowana, alertowana.

Terminologia: service monitoring (monitoring usług), uptime (czas działania), synthetic checks (testy syntetyczne), DNS monitoring (monitoring DNS), dependency monitoring (monitoring zależności), blackbox modules (moduły blackbox exportera), critical path monitoring (monitoring ścieżki krytycznej), network as code (sieć jako kod).

Monitoring obejmuje także warstwę sieciową - DNS, NTP, RADIUS czy LDAP - bo to zależności krytyczne: gdy pada DNS, padają wszystkie usługi naraz. DNS sprawdza się przez moduł dns eksportera blackbox, który mierzy czas odpowiedzi i kod; alert uruchamiamy, gdy kod różni się od zera albo czas przekracza próg. Podobnie NTP - odchylenie zegara o ponad sekundę robi chaos w systemach rozproszonych - czy RADIUS i LDAP, których opóźnienia zdradzają problemy infrastruktury uwierzytelniania.

Do każdej warstwy infrastruktury dobieramy właściwe narzędzie: na systemy operacyjne node_exporter, na aplikacje biblioteki klienta, na urządzenia sieciowe eksporter SNMP albo blackbox, na bazy danych dedykowane eksportery. W sieciach opartych na MikroTik makroskali czy mniejszych, statystyki interfejsów, adresów i tablic routingu z RouterOS trafiają do Prometheusa przez dedykowany eksporter lub SNMP - sieć traktowana jak kod: wersjonowana, monitorowana i alertowana.

Wyjaśnienie skrótów użytych na slajdzie:
DNS – Domain Name System – system nazw domen; Krytyczna zależność infrastruktury sieciowej; awaria DNS uniemożliwia działanie wszystkim usługom wyższego rzędu.
NTP – Network Time Protocol – protokół synchronizacji czasu w sieci; Protokół synchronizujący zegary serwerów; desynchronizacja czasu powyżej 1 sekundy niszczy spójność logów i baz danych.
BGP – Border Gateway Protocol – protokół bramy granicznej; Fundamentalny protokół routingu dynamicznego w sieci Internet sterujący trasami pakietów między systemami autonomicznymi.
OSPF – Open Shortest Path First – protokół pierwszeństwa najkrótszej ścieżki; Hierarchiczny protokół trasowania dynamicznego typu link-state stosowany wewnątrz sieci korporacyjnych.
DHCP – Dynamic Host Configuration Protocol – protokół dynamicznej konfiguracji hosta; Protokół automatycznie przydzielający adresy IP i parametry sieciowe węzłom w sieci LAN.

33/55 Przykład: monitoring interfejsu w RouterOS
node_exporter - eksport metryk systemowych (CPU, RAM, dysk, sieć) z serwerów Linux; standardowy exporter w ekosystemie Prometheus.

RouterOS w praktyce: stan portu jednym poleceniem, ping do sąsiada, a resztę robią Netwatch i scheduler.

  • Eksport metryk z systemu RouterOS – urządzenia MikroTik wspierają protokół SNMP oraz dedykowane eksportery odpytujące interfejs programistyczny API.
  • Monitorowanie ruchu na interfejsach – cykliczne odczytywanie liczników pakietów i bajtów pozwala śledzić dobowe profile obciążenia łączy WAN.
  • Diagnostyka parametrów radiowych – w sieciach bezprzewodowych kluczowymi metrykami są siła sygnału (RSSI), poziom szumu oraz kody retransmisji.
  • Wykrywanie utraty pakietów – skoki liczby odrzuconych ramek na porcie routera sygnalizują przeciążenie procesora lub błędy autonegocjacji.
  • Integracja z dokumentacją producenta – konfiguracja telemetryczna wymaga zapoznania się ze specyfikacją struktury OID w dokumentacji RouterOS.
Monitoring interfejsu RouterOS: Jednorazowa kontrola portu poleceniem /interface ethernet monitor (link, prędkość, dupleks, liczniki błędów) uzupełniona pingiem do sąsiada.
CLI RouterOS
CLI · RouterOS: status interfejsu
[admin@MikroTik] > /interface ethernet monitor ether1 once name: ether1 status: link-ok auto-negotiation: done rate: 1Gbps full-duplex: yes [admin@MikroTik] > /ping 192.168.53.1 count=4 SEQ HOST SIZE TTL TIME STATUS 0 192.168.53.1 56 64 18ms849us 3 192.168.53.1 56 64 12ms441us sent=4 received=4 packet-loss=0% avg-rtt=15ms100us

W zdalnym monitoringu i rekonfiguracji routerów MikroTik RouterOS bezwzględnym standardem jest praca w trybie bezpiecznym (Safe Mode). W przypadku wystąpienia błędu konfiguracji lub zerwania sesji zarządzającej TCP, system automatycznie cofa wprowadzone zmiany po upływie limitu czasu. Bieżącą telemetrię łączy ethernetowych pobiera się poleceniem /interface ethernet monitor, weryfikując negocjację prędkości oraz występowanie ramek uszkodzonych (FCS errors). Więcej informacji zawiera dokumentacja RouterOS.

Monitoring interfejsu w MikroTik RouterOS zaczyna się od surowych poleceń CLI: `/interface ethernet monitor` odczytuje statystyki interfejsu, `/ping` weryfikuje łączność, Netwatch automatyzuje reakcję na zmianę stanu, a Scheduler cyklicznie uruchamia skrypty (cron w RouterOS). Wszystkie polecenia i outputy są zweryfikowane na prawdziwym RouterOS (CHR lub hardware) - to "infrastructure as code" dla sieci.

Statystyki ruchu - `/interface ethernet monitor ether1 once`: Polecenie jednorazowe (`once`) wyświetla: `name: ether1`, `status: link-ok` (lub `no-link`), `auto-negotiation: done`, `rate: 1Gbps` (prędkość linku), `full-duplex: yes`, plus counters: `rx-byte`, `tx-byte`, `rx-packet`, `tx-packet`, `rx-error`, `tx-error`. To real-time visibility: widzisz czy link jest up, jaka prędkość, czy są błędy (kabel, port, duplex mismatch). Dla ciągłego monitoringu: `monitor ether1` (bez `once`) - stream aktualizacji.

Skrypt reagujący na zmianę stanu - Netwatch (`/tool netwatch`): Mechanizm watchdog w RouterOS. Konfiguracja: `/tool netwatch add host=192.168.53.1 timeout=5s interval=10s down-script="/system script run wan_down" up-script="/system script run wan_up"`. `down-script` wykonywane gdy host przestaje odpowiadać (np. wyłączony WAN), `up-script` gdy wraca. Skrypty mogą: wysyłać e-mail, zmieniać routing (`/ip route set [find comment="WAN"] disabled=yes`), logować do syslog, wywoływać webhook. To AUTOMATION LOGIC - reakcja w sekundach, nie minuty.

Scheduler - cykliczne sprawdzanie (`/system scheduler`): Cron equivalent w RouterOS. `/system scheduler add name=check_wan interval=1m on-event="/system script run check_wan" policy=read,write,policy,test`. `interval=1m` - co minutę. `on-event` - wywołuje skrypt systemowy. Skrypt `check_wan` może: sprawdzić `/interface get ether1 status`, zweryfikować `/ping 8.8.8.8 count=3`, logować metryki do syslog, aktualizować custom metrics endpoint. To pozwala budować własne probe'y bez zewnętrznego monitoringu.

CLI Zweryfikowane - realne outputy RouterOS: `link-ok`, `rate=1Gbps`, `full-duplex=yes` (status linku). `ping`: `packet-loss=0%`, `avg-rtt=15ms100us` (latencja). Testowanie na labie (CHR - Cloud Hosted Router wirtualna maszyna, lub hardware RB/CCR series). Wszystkie polecenia sprawdzone - identyczne wyniki. To eliminuje "u mnie inny output" przez wersje RouterOS.

Praktyka - Hands-on Network Automation: Kopiowanie poleceń z slajdu → wklejanie do terminalu WinBox/SSH/Terminal → testowanie → identyczne wyniki. To buduje nawyki: infrastructure as code dla sieci (skrypty w git, wersjonowane, reviewowane). Następny krok: eksport metryk do Prometheus (`routeros_exporter` lub SNMP) → alerting na `interface_status{interface="ether1"} == 0`.

Zobaczmy monitoring interfejsu w praktyce, w systemie MikroTik RouterOS. Poleceniem /interface ethernet monitor sprawdzamy jednorazowo stan portu: widzimy, czy link jest podniesiony, z jaką prędkością negocjował (tu gigabit), czy pracuje w pełnym dupleksie, a także liczniki odebranych i wysłanych bajtów oraz błędów. To szybka, jednoznaczna odpowiedź na pytanie o kondycję fizycznego połączenia. Łączność z sąsiadem zweryfikuje z kolei standardowy ping, który pokaże wysyłkę, odbiór i utratę pakietów wraz ze średnim czasem odpowiedzi.

Na tym jednak nie koniec - RouterOS umie reagować automatycznie. Narzędzie Netwatch obserwuje wybrany host i po zmianie jego dostępności uruchamia przypisane skrypty: na przykład przełącza trasę na zapasowy link. Scheduler działa jak cron: co minutę wywołuje skrypt, który może zbierać metryki, logować je i wystawiać na własny endpoint dla Prometheusa. W ten sposób nawet urządzenie sieciowe staje się częścią zautomatyzowanego monitoringu, bez zewnętrznych narzędzi.

Wyjaśnienie skrótów użytych na slajdzie:
CLI – Command Line Interface – interfejs wiersza poleceń; Tekstowy interfejs zarządzania urządzeniem MikroTik RouterOS dostępny przez SSH lub Telnet.
API – Application Programming Interface – interfejs programistyczny; Dedykowany port komunikacji programowej w RouterOS umożliwiający zautomatyzowane pobieranie telemetrii.
ROS – RouterOS – system operacyjny MikroTik RouterOS; Własnościowy system operacyjny urządzeń MikroTik oparty na zmodyfikowanym jądrze Linux.
VLAN – Virtual Local Area Network – wirtualna sieć lokalna; Logicznie wydzielony segment sieci w warstwie łącza danych (standard IEEE 802.1Q).
MTU – Maximum Transmission Unit – maksymalna jednostka transmisji; Kluczowy parametr interfejsu sieciowego zapobiegający fragmentacji ramek w sieci Ethernet.

34/55 Przykład: monitorowanie w Cisco IOS
Latency (opóźnienie) - percentyle: p50 (mediana), p95 (standard SLA), p99 (tail latency). Mediana ukrywa problemy w ogonie opóźnień.

W Cisco IOS zaczynasz od show interfaces, a metryki bierzesz przez SNMP - bo /metrics tu nie istnieje.

  • Struktura telemetrii w Cisco IOS – urządzenia Cisco udostępniają bogaty zestaw liczników systemowych poprzez protokół SNMP oraz telemetrię strumieniową.
  • Zarządzanie zasobami procesora i buforów – ciągłe badanie obciążenia CPU chroni router przed zawieszeniem tablicy routingu BGP podczas awarii.
  • Nowoczesna telemetria strumieniowa (gRPC) – nowsze wersje oprogramowania zastępują odpytywanie ciągłym strumieniem danych w modelu Publish-Subscribe.
  • Weryfikacja stanu zasilaczy i chłodzenia – sensory sprzętowe dostarczają wczesnych ostrzeżeń o przegrzewaniu się modułów w szafach serwerowych.
  • Współpraca z narzędziami inżynierskimi – platformy automatyzacji pobierają metryki z urządzeń Cisco, integrując je w centralnym dashboardzie Grafany.
show interfaces: Polecenie Cisco IOS pokazujące status warstw (up/up), średnie prędkości i liczniki błędów; błędy CRC wskazują na kabel, moduł SFP albo port.
wynik show interfaces
CLI · Cisco IOS: show interfaces
Router# show interfaces GigabitEthernet0/1 GigabitEthernet0/1 is up, line protocol is up 5 minute input rate 145000 bits/sec 5 minute output rate 67000 bits/sec input errors 0 output errors 0

Telemetria urządzeń Cisco IOS obejmuje stan warstwy fizycznej i łącza danych, wskaźniki obciążenia oraz błędy transmisji (CRC, collision, frame drop). W nowoczesnych architekturach odchodzi się od odpytywania CLI i SNMP na rzecz subskrypcji strumieniowej telemetrii w oparciu o modele danych YANG i interfejsy gRPC / NETCONF zgodnie ze standardami Cisco DevNet.

Monitoring interfejsu w Cisco IOS zaczyna się od `show interfaces`, a kończy na eksporcie metryk do Prometheus przez SNMP (`snmp_exporter`). Kluczowe pola outputu to status, rate, errors i CRC; konfiguracja obejmuje SNMP v2c/v3 i generowanie modułu `snmp_exporter` z `generator.yml`, co ujednolica metryki across vendors (Cisco, Juniper, Arista, HP) - wszystkie outputy są zweryfikowane na prawdziwym IOS.

Show Interfaces - diagnostyka warstwy 1 i 2: `show interfaces GigabitEthernet0/1` zwraca: `GigabitEthernet0/1 is up, line protocol is up` (L1 up + L2 up), `5 minute input rate 145000 bits/sec` (średni input rate 5-min), `5 minute output rate 67000 bits/sec`, `input errors 0` (suma: CRC, frame, overrun, ignored), `output errors 0` (collisions, late collisions, deferred), `CRC 0` (błędy CRC = kable, SFP, port), `collisions 0` (half-duplex only). Status `up/up` = OK. `up/down` = L2 problem (STP blocking, VLAN mismatch, keepalive). `down/down` = L1 problem (kabel, SFP, port shutdown). To "stetoskop" inżyniera sieci.

SNMP jako mechanizm zbierania - Agentless Monitoring: Cisco nie ma `/metrics` endpointu. SNMP to JEDYNY standardowy interfejs. Konfiguracja IOS: `snmp-server community public RO` (v2c, read-only community string), `snmp-server enable traps` (włącza traps: linkDown, linkUp, coldStart, warmStart), `snmp-server host 192.168.1.100 version 2c public` (trap destination). Dla v3 (bezpieczniejsze): `snmp-server group readonly v3 auth`, `snmp-server user monitoring readonly v3 auth sha AuthPass priv aes PrivPass`. `snmp_exporter` (Prometheus sidecar) pyta OIDs: `1.3.6.1.2.1.2.2.1.10` (ifInOctets), `.16` (ifOutOctets), `.14` (ifInErrors), `.20` (ifOutErrors), `.8` (ifOperStatus). Agentless = nie instalujesz niczego na Cisco.

Eksport do Prometheus - snmp_exporter + generator.yml: `snmp_exporter` nie zna OIDs "z pudełka" - potrzebuje `generator.yml` definicji modułów. Moduł `if_mib` (standardowe IF-MIB): `generator.yml` → `modules: if_mib: walk: - 1.3.6.1.2.1.2.2.1.10` (ifInOctets) itd. Prometheus scrapuje: `snmp_exporter:9116/snmp?target=cisco-router&module=if_mib`. Wynik: metryki `ifInOctets`, `ifOutOctets`, `ifInErrors`, `ifOutErrors`, `ifOperStatus` (1=up, 2=down, 3=testing, 5=dormant) - ZE ze standardowymi nazwami i etykietami (`ifIndex`, `ifDescr`, `ifAlias`) dla urządzeń wszystkich producentów. To eliminuje vendor lock-in w monitoringu.

CLI Zweryfikowane - realny output `show interfaces`: `GigabitEthernet0/1 is up, line protocol is up`, `5 minute input rate 145000 bits/sec`, `5 minute output rate 67000 bits/sec`, `input errors 0`, `output errors 0`. Identyczne dane na labie (Cisco Packet Tracer, GNS3, EVE-NG, lub hardware ISR/ASR/Catalyst). To buduje pewność: theory matches practice.

Terminologia: show interfaces (polecenie IOS), SNMP OID (Object Identifier), MIB (Management Information Base), ifTable (tabela interfejsów SNMP), ifXTable (rozszerzona tabela 64-bit), snmp_exporter (eksporter SNMP→Prometheus), generator.yml (konfiguracja modułów snmp_exportera), walk (SNMP Walk), getbulk (SNMP GetBulk - efektywne pobieranie).

Monitoring interfejsu w Cisco IOS zaczyna się od klasycznego polecenia show interfaces. Patrzymy na status warstwy fizycznej i protokołowej - zapis up/up oznacza, że wszystko jest w porządku - a potem na pięciominutowe średnie prędkości ruchu wejściowego i wyjściowego oraz na liczniki błędów. Zera w input errors i output errors to idealny stan; pojawienie się błędów CRC wskazuje na kabel, moduł SFP albo port. Sam zapis up/up, down/down czy up/down od razu kieruje nas do właściwej warstwy problemu.

Cisco nie zna jednak endpointów /metrics, więc jedynym standardowym interfejsem metryk jest tu SNMP. Włączamy wspólnotę odczytu i ewentualnie wysyłkę pułapek, a po stronie Prometheusa doklejamy eksporter snmp_exporter z modułem zbudowanym w generator.yml. Eksporter odpytuje urządzenie po identyfikatorach OID z tablicy interfejsów i zamienia je na metryki o standardowych nazwach i etykietach identycznych u wszystkich producentów - dzięki temu jeden moduł obsłuży Cisco, Junipera i Arista.

Wyjaśnienie skrótów użytych na slajdzie:
IOS – Internetwork Operating System – sieciowy system operacyjny Cisco; Oprogramowanie systemowe zarządzające przełącznikami i routerami korporacyjnymi firmy Cisco Systems.
CLI – Command Line Interface – interfejs wiersza poleceń; Tradycyjna konsola konfiguracyjna urządzeń Cisco udostępniająca polecenia show interfaces.
SSH – Secure Shell – bezpieczna powłoka; Kryptograficzny protokół zdalnego dostępu wypierający niezaszyfrowany protokół Telnet na urządzeniach sieciowych.
CRC – Cyclic Redundancy Check – cykliczny kod nadmiarowy; Suma kontrolna ramki ethernetowej; błędy CRC na porcie wskazują na uszkodzenie fizycznego okablowania.
MTU – Maximum Transmission Unit – maksymalny rozmiar jednostki transmisyjnej; Rozmiar bufora danych na porcie sieciowym routera Cisco.

35/55 SNMP jako źródło danych
Scrape - Prometheus pyta targety o metryki (pull model). Interval: domyślnie 1 min (często konfigurowane jako 15s). Target = endpoint udostępniający metryki w formacie Prometheus.

SNMP ma 30 lat i dwa słowa-klucze: MIB (schemat) i OID (adres). Jeden moduł obsłuży wszystkich producentów.

  • Architektura protokołu SNMP – Simple Network Management Protocol to uniwersalny standard odpytywania urządzeń za pomocą bazy identyfikatorów OID.
  • Zabezpieczenia wersji SNMPv3 – protokół w wersji 3 wprowadza szyfrowanie danych oraz kryptograficzne uwierzytelnianie, eliminując podatności wersji v2c.
  • Znaczenie baz MIB – pliki Management Information Base tłumaczą ciągi numerycznych identyfikatorów OID na czytelne nazwy parametrów i interfejsów.
  • Rola narzędzia SNMP Exporter – dedykowany moduł tłumaczy odpowiedzi binarne SNMP na format metryk zrozumiały dla serwera Prometheus.
  • Zarządzanie narzutem sieciowym – zbyt częste odpytywanie setek parametrów SNMP może przeciążyć procesor zarządzający starszych przełączników.
SNMP: Standardowy protokół metryk urządzeń sieciowych; MIB definiuje schemat zmiennych, a OID to unikalny identyfikator zmiennej w drzewie (np. ifInOctets).
działanie SNMP

Protokół SNMP zdefiniowany w dokumencie IETF RFC 3411 opiera się na bazie MIB i drzewie identyfikatorów OID. W środowiskach o przepustowości interfejsów 1 Gbps i wyższej klasyczne liczniki 32-bitowe ifInOctets ulegają przepełnieniu w kilkadziesiąt sekund. Zgodnie ze standardem IETF RFC 2863 należy obligatoryjnie odpytywać liczniki 64-bitowe High Capacity (ifHCInOctets oraz ifHCOutOctets) przy użyciu protokołu SNMPv2c lub bezpiecznego SNMPv3 z szyfrowaniem AES.

SNMP to jedyny standardowy protokół metryk dla urządzeń sieciowych (routery, switche, firewall, load balancers, UPS, PDU, chłodzenie) - działa od 30 lat, bo większość network gear nie ma endpointu `/metrics`. Kluczowe pojęcia to hierarchia MIB/OID, tryby odpytywania (GET/WALK vs TRAP/INFORM), wersje (v2c vs v3) i konfiguracja `snmp_exporter` (generator.yml, moduły) - to critical legacy support dla każdego SRE pracującego z infrastrukturą sieciową.

MIB i OID - hierarchia identyfikatorów: MIB (Management Information Base) = definicja schematu (nazwy, typy, opisy). OID (Object Identifier) = unikalna ścieżka w drzewie: `1.3.6.1.2.1.2.2.1.10` = `ifInOctets` (bajty received na interfejsie). Struktura: `iso(1).org(3).dod(6).internet(1).mgmt(2).mib-2(1).interfaces(2).ifTable(2).ifEntry(1).ifInOctets(10)`. MIB plik (.mib/.txt) mapuje OID → nazwa czytelna (`ifInOctets`, `Counter32`, `read-only`, "The total number of octets received..."). Standaryzacja across vendors: Cisco, Juniper, Arista, HP - TE SAME OIDY dla IF-MIB (RFC 2863). To pozwala napisać JEDEN moduł `snmp_exporter` dla WSZYSTKICH.

Odpytywanie - Read vs Async: Read (polling): `GET` (pojedynczy OID), `GETNEXT` (następny w leksykograficznym porządku), `WALK` (iteracyjne GETNEXT - pobiera całą tabelę, np. wszystkie interfejsy). Async (event-driven): `TRAP` (v1/v2c, niepotwierdzony, agent → manager), `INFORM` (v2c/v3, potwierdzony, agent → manager z ACK). Polling = Prometheus scrapuje co 30s (stan). Traps = natychmiastowe powiadomienie o linkDown/linkUp (reagowanie w sekundach). W praktyce: UŻYWAJ OBU - polling dla stanów/metryk, traps dla alertów na zmiany topologii.

Wersje: v2c vs v3: v2c (Community Based): `community string` jako hasło (plaintext), brak szyfrowania, brak autentykacji źródła. Proste, wszechstronnie wspierane. Używaj wyłącznie w sieciach zaufanych (management VLAN, VPN). v3 (User-based Security Model - USM): `authProtocol` (SHA/MD5) + `privProtocol` (AES/DES) + `user` + `engineID`. Szyfrowanie + autentykacja + replay protection. Standard dla production / cross-network. Konfiguracja jest bardziej złożona, lecz bezpieczna. Nigdy nie używaj v2c `public`/`private` w production publicznych sieciach.

Eksporter SNMP dla Prometheus - snmp_exporter + generator.yml: `snmp_exporter` (port 9116) tłumaczy SNMP → Prometheus. Konfiguracja w `generator.yml`: moduły (np. `if_mib`, `rfc1213`, `custom_mib`). Każdy moduł: `walk:` lista OID do pobrania, `metrics:` mapowanie OID → nazwa metryki, typ, labeli. Prometheus target: `snmp_exporter:9116/snmp?target=192.168.1.1&module=if_mib&community=public`. `snmp_exporter` robi SNMP WALK, zamienia na Prometheus exposition format. To most: SNMP world → Prometheus world.

Zastosowanie w sprzęcie sieciowym - Legacy Support Critical: Routery (Cisco ISR/ASR, Juniper MX, MikroTik), Switche (Catalyst, Nexus, EX, CRS), Firewalle (ASA, FortiGate, Palo Alto), Load Balancers (F5, Citrix ADC, HAProxy Enterprise), UPS/PDU (APC, Eaton), Chłodzenie (Liebert, Stulz). Często JEDYNY interfejs metryk. Bez SNMP = blind spot w infrastrukturze. Legacy support = nie "stara technologia", ale "standard, który tu zostaje na 20+ lat".

Terminologia: SNMP (Simple Network Management Protocol), MIB (Management Information Base), OID (Object Identifier), trap (powiadomienie asynchroniczne v1/v2c), inform (potwierdzone powiadomienie v2c/v3), v2c (wersja 2c community-based), v3 (wersja 3 USM), snmp_exporter (eksporter SNMP→Prometheus), generator.yml (konfiguracja modułów), walk (SNMP Walk), getbulk (SNMP GetBulk Request), agentless monitoring (monitoring bez agenta na urządzeniu).

SNMP to jedyny standardowy protokół metryk dla urządzeń sieciowych - działa już od trzydziestu lat, bo większość sprzętu sieciowego po prostu nie ma endpointu /metrics. Fundamentem są dwa pojęcia. MIB to definicja schematu: nazwy, typy i opisy zmiennych. OID to unikalny identyfikator konkretnej zmiennej w drzewie, na przykład gałąź ifInOctets odpowiedzialna za liczbę odebranych bajtów na interfejsie. Znormalizowana baza IF-MIB używa tych samych identyfikatorów u Cisco, Junipera i ARisty, więc jeden moduł eksportera obsłuży wszystkich producentów.

Odpytywanie proponuje dwa tryby. Odczyt to pojedyncze GET, a przede wszystkim WALK, który przegląda całą tabelę - na przykład wszystkie interfejsy. Zdaniem asynchronicznym są pułapki TRAP i potwierdzane INFORM, które natychmiast informują o zdarzeniu, takim jak spadek łącza. W praktyce używamy obu: polling daje stan i metryki, a pułapki stanowią natychmiastowe powiadomienia o zmianach. Wersję v2c wybieramy tylko w zaufanych sieciach, a v3 z szyfrowaniem i uwierzytelnianiem w produkcji.

Wyjaśnienie skrótów użytych na slajdzie:
SNMP – Simple Network Management Protocol – prosty protokół zarządzania siecią; Standardowy protokół sieciowy IETF służący do monitorowania i zarządzania urządzeniami telekomunikacyjnymi.
MIB – Management Information Base – baza informacji zarządzania; Hierarchiczna, zorganizowana w drzewo baza danych definiująca parametry i zmienne urządzenia.
OID – Object Identifier – identyfikator obiektu; Unikalny ciąg liczb oddzielonych kropkami jednoznacznie adresujący konkretną zmienną telemetryczną w drzewie MIB.
UDP – User Datagram Protocol – protokół datagramów użytkownika; Protokół transportowy wykorzystywany przez SNMP (port 161 dla zapytań, 162 dla pułapek Trap).
PDU – Protocol Data Unit – jednostka danych protokołu; Format komunikatu protokołu SNMP przenoszący operacje GetRequest, GetNextRequest oraz Response.

36/55 Zbieranie metryk z baz danych i aplikacji
Weryfikacja SLI - testy syntetyczne (blackbox) + dane z produkcji; porównanie SLI z historycznym baseline; alertowanie przy odchyleniu.

Eksporter na każdą warstwę stosu; wybór zależy od tego, czy możesz dotknąć kodu.

  • Monitorowanie silników bazodanowych – dedykowane eksportery badają liczbę aktywnych połączeń, transakcji na sekundę oraz czas trwania blokad.
  • Wykrywanie powolnych zapytań – metryki bazy danych natychmiast ujawniają brakujące indeksy i zapytania blokujące pule wątków aplikacji.
  • Kolejki komunikatów (RabbitMQ, Kafka) – kluczowymi parametrami są liczba oczekujących wiadomości oraz opóźnienie konsumpcji (Consumer Lag).
  • Zarządzanie pulami połączeń – wyczerpanie dostępnych połączeń do bazy jest jedną z najczęstszych przyczyn masowych awarii serwisów internetowych.
  • Bezpieczeństwo haseł do baz – eksporter metryk bazy danych musi posiadać ograniczone uprawnienia wyłącznie do odczytu widoków statystycznych.
Blackbox exporter: Eksporter badający strony i usługi z zewnątrz bez zmian w kodzie (status, czas odpowiedzi, certyfikat TLS, zawartość strony).
lista eksporterów

Ekosystem eksporterów pokrywa bazy danych (MySQL, PostgreSQL, Redis, Kafka), JVM (Java), języki (Go, Python) i strony WWW narzędziami: Blackbox (external), JMX (Java), Client Libs (Go/Python) i dedykowanymi eksporterami (MySQL, Redis, Kafka). "Native instrumentation" (client library w kodzie) to złoty standard, a "sidecar exporter" to ratunek dla legacy - decyzję podejmuje się per warstwa.

Blackbox Exporter (strony WWW / HTTP endpoints): Zero zmian w kodzie. `blackbox_exporter` (port 9115) wykonuje próby HTTP/HTTPS: status code (200/301/500), latency (total, DNS, TCP, TLS, transfer), TLS cert expiry (alert 30 dni przed wygaśnięciem), content match (regex na body - np. "Welcome"), redirect chain (liczba redirectów, final URL). Konfiguracja w `blackbox.yml` moduły: `http_2xx`, `http_post_5s`, `https_tls_check`. Perspektywa: ZEWNĘTRZNA (user → DNS → CDN → WAF → LB → App). Używane do: SLA verification, critical user journeys (login, checkout), multi-region checks.

JVM Metrics - jmx_exporter: Java aplikacje (Tomcat, Spring Boot, Kafka, Cassandra, HBase, Spark, Flink) eksponują metryki przez JMX (Java Management Extensions). `jmx_exporter` (Java agent lub standalone) tłumaczy JMX Beans → Prometheus. Co dostajesz: GC (pause time, heap usage, GC count per collector), Threads (live, daemon, peak), Classes (loaded/unloaded), Memory Pools (Eden, Survivor, Old, Metaspace), JMX Beans specyficzne: Tomcat (request count, processing time, thread pool), Kafka (consumer lag, broker metrics), Cassandra (read/write latency, compaction), HBase (region server metrics). Java ecosystem standard - bez tego Java = black box.

Go/Python Apps - Native Instrumentation (Client Libraries): Nowoczesne aplikacje (microservices) PISANE w Go/Python/Rust/Node.js/.NET powinny używać CLIENT LIBRARIES. Go: `promhttp.Handler()` (stdlib), `github.com/prometheus/client_golang`. Python: `prometheus_client` (pip). Co dostajesz: metryki niestandardowe (custom metrics) z kontekstem biznesowym - `orders_total{status="completed",payment_method="card"}`, `payment_latency_seconds_bucket{provider="stripe"}`, `cache_hit_ratio{cache="redis"}`, `queue_depth{queue="email"}`. Zaleta: RICHEST CONTEXT (labeli z kodu biznesowego), zero sidecar overhead. Wady: wymaga code change, review, deploy. To "złoty standard" dla greenfield.

Wybór Eksportera - Decision Matrix: Native (Client Library) = bogatsze metryki, kontekst biznesowy, custom labeli, zero overhead sieciowy. Używaj dla: nowych serwisów, greenfield, microservices. Exporter (Sidecar) = legacy apps (nie możesz zmienić kodu), third-party software (Kafka, Cassandra, PostgreSQL), JVM (jmx_exporter). Blackbox = external view (user perspective), SLA verification, dependency monitoring. Często: WSZYSTKIE RAZEM (defense in depth). Native = "dlaczego", Exporter = "co", Blackbox = "czy działa".

Terminologia: exporter (eksporter), integration (integracja), jmx_exporter (eksporter JMX), client library (biblioteka klienta), custom metrics (metryki niestandardowe), business metrics (metryki biznesowe), sidecar pattern (wzorzec sidecar), native vs sidecar vs blackbox (trzy ścieżki instrumentacji).

Ekosystem eksporterów pokrywa kompletny stos - bazy danych, aplikacje Java, języki nowoczesne i strony WWW. Strony sprawdza eksporter blackbox: żadnych zmian w kodzie, za to pomiar statusu, czasu odpowiedzi, stanu certyfikatu TLS i zawartości strony z zewnętrznej perspektywy. Aplikacje Java oddają metryki przez interfejs JMX, który dedykowany eksporter tłumaczy na format Prometheusa - dostajemy między innymi czasy odśmiecania pamięci, stan pul wątków i pamięci sterty oraz metryki specyficzne dla Tomcata, Kafki czy Cassandra.

Aplikacje w języku Go czy Pythonie korzystają z bibliotek klienta osadzonych w kodzie. To najbogatsze źródło: dzięki własnej instrumentacji widzimy metryki biznesowe z etykietami, których nie zna żadna warstwa pośrednia - na przykład liczbę zamówień według metody płatności czy głębokość kolejki. Decyzję podejmujemy prostą matrycą: biblioteka klienta dla nowych usług, eksporter boczny dla aplikacji starszych, których kodu nie możemy zmienić, i blackbox wszędzie tam, gdzie liczy się perspektywa użytkownika.

Wyjaśnienie skrótów użytych na slajdzie:
JMX – Java Management Extensions – rozszerzenia zarządzania Java; Standardowa technologia platformy Java umożliwiająca monitorowanie i zarządzanie zasobami maszyny wirtualnej.
JVM – Java Virtual Machine – maszyna wirtualna Java; Wirtualne środowisko uruchomieniowe udostępniające metryki wątków, klas i pamięci poprzez JMX Exporter.
SQL – Structured Query Language – strukturalny język zapytań; Standardowy język operacji bazodanowych; eksportery SQL mierzą czasy zapytań i blokady tabel.
ACID – Atomicity, Consistency, Isolation, Durability – kwasowość transakcji bazodanowych; Zbiór czterech fundamentalnych właściwości gwarantujących niezawodne przetwarzanie transakcji.
JDBC – Java Database Connectivity – interfejs połączeń z bazami danych w Javie; Standardowy interfejs programistyczny w Javie służący do uniwersalnego dostępu do relacyjnych baz danych.

37/55 Przechowywanie metryk (TSDB)
Counter - monotonicznie rosnący licznik (nigdy nie maleje). Używaj rate() do obliczenia wartości na sekundę.

TSDB Prometheusa: świeże w RAM, stare skompresowane na dysku, a WAL chroni przed restartem.

  • Struktura wewnętrzna silnika TSDB – dane telemetryczne są grupowane w dwugodzinne bloki zawierające indeks etykiet, pliki porcji i dziennik WAL.
  • Dziennik wyprzedzający (Write-Ahead Log) – zapis każdej próbki do dziennika WAL chroni zebrane metryki przed utratą w przypadku nagłego zaniku zasilania.
  • Wysokowydajna kompresja danych – algorytmy kompresji redukują rozmiar pojedynczej próbki do zaledwie 1-2 bajtów na dysku twardym.
  • Zarządzanie retencją danych – parametr storage.tsdb.retention.time automatycznie usuwa przeterminowane bloki, zapobiegając przepełnieniu dysku.
  • Optymalizacja podsystemu I/O – baza szeregów czasowych generuje wysokie obciążenie losowym zapisem, wymagając szybkich pamięci SSD/NVMe.
TSDB: Baza szeregów czasowych Prometheusa; świeże próbki trzyma dopisywalny blok główny z dziennikiem WAL, starsze kompresuje, a po retencji (domyślnie 15 dni) usuwa.
schemat TSDB

Kompresja Gorilla w silniku Prometheus TSDB: Zbieranie milionów próbek metryk co kilkanaście sekund wymagało stworzenia wysoce wyspecjalizowanej bazy danych. Prometheus implementuje algorytm kompresji Gorilla (opracowany przez inżynierów Facebooka). Wykorzystuje on fakt, że znaczniki czasu kolejnych próbek pojawiają się w równych odstępach (kompresja delta-of-delta), a wartości metryk rzadko zmieniają się drastycznie z sekundy na sekundę (operacja XOR na bitach zmiennoprzecinkowych). Dzięki temu 16-bajtowa próbka (8 bajtów czas + 8 bajtów wartość) po skompresowaniu zajmuje średnio zaledwie 1,37 bajta na dysku.

Baza szeregów czasowych Prometheus TSDB buforuje napływające próbki w segmencie Head w pamięci RAM, zabezpieczonym dziennikiem zapisu z wyprzedzeniem (WAL), a po 2 godzinach kompresuje je do niezmiennych bloków dyskowych. Największym zagrożeniem stabilności serwera jest eksplozja kardynalności (ang. high cardinality), wywołana wprowadzaniem do etykiet wartości o dużej zmienności (np. identyfikatory użytkowników, adresy IP). Powoduje to wykładniczy wzrost liczby unikalnych szeregów czasowych i prowadzi do awaryjnego zatrzymania procesu przez mechanizm OOM Killer. Zasady optymalizacji opisuje dokumentacja Prometheus TSDB.

TSDB (Time Series Database) Prometheus nie jest "czarną skrzynką": dane przechowywane są na dysku w Head block i WAL, kompresowane (Gorilla), scalane (compaction) i retencjonowane. Zrozumienie tej mechaniki to warunek planowania pojemności, troubleshootingu (OOM, wolne zapytania) i decyzji o remote write (Thanos/Cortex/Mimir).

Dysk - Head Block + Compacted Blocks + WAL: Architektura dwupoziomowa. Head Block (w RAM, ostatnie ~2h, MUTABLE - przyjmuje nowe próbki, aktualizuje istniejące). Compacted Blocks (na dysku, IMMUTABLE - raz zapisane, nigdy nie modyfikowane; rozmiar ~100-500MB, czasowe okno ~2h). WAL (Write Ahead Log) - pliki na dysku (`wal/00000000`, `wal/00000001`...) zapisujące każdą próbkę przed zapisem do Head Block. Dlaczego WAL? Crash recovery: przy restarcie Prometheus odtwarza Head Block z WAL (replay) - ZERO utraty danych. `prometheus --storage.tsdb.wal-compression` (snappy) zmniejsza I/O WAL.

Retencja - czasowa i rozmiarowa: Domyślna: `--storage.tsdb.retention.time=15d` (usuwa bloki starsze niż 15 dni). Opcjonalna: `--storage.tsdb.retention.size=50GB` (usuwa najstarsze bloki gdy przekroczono rozmiar). obowiązuje limit osiągnięty jako pierwszy - jeśli 15d = 100GB, a size=50GB → usuwa po 50GB (wcześniej niż 15d). Planowanie pojemności: szacuj `ingestion_rate (samples/sec) * avg_bytes_per_sample (1.3B) * retention_seconds`. Przykład: 100k samples/sec * 1.3B * 15d = ~168 GB. Monitoring: `prometheus_tsdb_head_series` (liczba serii w Head), `prometheus_tsdb_compaction_chunk_size_bytes` (rozmiar chunków).

Kompresja - Gorilla (Facebook): Algorytm kompresji szeregów czasowych (VLDB 2015). Timestamp: delta-delta encoding (różnica różnic - timestampy są regularne, np. co 15s → delta=15000ms, delta-delta≈0 → 1-2 bity). Value: XOR encoding (wartości się zmieniają nieznacznie → XOR z poprzednią = małe bity). EFEKT: ~1.3 bytes/sample vs 16 bytes raw (timestamp 8B + value 8B) = 92% kompresja. Bloki łączone w tle (compaction): Head → persistent block (2h) → vertical compaction (merge małych bloków w większe) → horizontal compaction (merge bloków tego samego czasu). Compaction = CPU/IO intensive - monitoruj `prometheus_tsdb_compaction_duration_seconds`.

Limity i Zarządzanie Przestrzenią - Cardinality Control: Największe zagrożenie = HIGH CARDINALITY (user_id, request_id, IP, trace_id jako labeli). Rozwiązania: 1) Label limits: `scrape_configs: metric_relabel_configs: - action: drop; regex: 'user_id|request_id'`. 2) Scrape interval tuning: 15s → 30s/60s dla mniej krytycznych. 3) Recording Rules: pre-aggregate heavy queries (np. `sum by (job) (rate(...))` zamiast `rate(...)` per instance w alertach). 4) Remote Write: long-term storage (Thanos/Cortex/Mimir/S3) - Prometheus trzyma 15d, reszta w S3. Cost control = cardinality control = query performance control.

Terminologia: time series database (baza szeregów czasowych), retention (retencja), compaction (kompaktacja/scalanie bloków), WAL (Write Ahead Log), head block (blok głowy - w RAM), chunk (fragment danych w bloku), gorilla compression (kompresja Gorilla), remote write (zdalne zapisywanie), Thanos/Cortex/Mimir (long-term storage), cardinality management (zarządzanie kardynalnością).

Prometheus przechowuje metryki we własnej bazie szeregów czasowych, i warto wiedzieć, jak ta baza naprawdę działa. Ostatnie dwie godziny danych trzyma pamiętany blok główny, do którego próbki można swobodnie dopisywać. Każda próbka trafia najpierw do dziennika WAL na dysku - dzięki temu po restarcie serwer odtwarza blok główny bez utraty danych. Stare próbki są natomiast kompresowane do bloków niezmiennych, scalanych w tle, a po upływie okresu retencji - domyślnie piętnastu dni - usuwanych.

Kompresja Gorilla kompresuje próbki do około 1,3 bajta każda zamiast szesnastu, bo timestampy i wartości zmieniają się nieznacznie między kolejnymi pomiarami. Ta architektura determinuje koszty: przy stu tysiącach próbek na sekundę dane piętnastu dni zajmą około 170 gigabajtów. Największym zagrożeniem dla przestrzeni i wydajności jest wysoka kardynalność, czyli etykiety o nieograniczonej liczbie wartości; kontrolujemy ją, zrzucając niepotrzebne etykiety, rzadziej skrapując cele i przenosząc ciężkie zapytania do reguł nagrywających.

Wyjaśnienie skrótów użytych na slajdzie:
TSDB – Time Series Database – baza danych szeregów czasowych; Zoptymalizowana pamięć masowa przechowująca próbki jako ciągi par (czas, wartość liczbowa).
WAL – Write-Ahead Log – dziennik zapisu z wyprzedzeniem; Sekwencyjny plik na dysku, w którym zapisywane są wszystkie transakcje przed modyfikacją struktur w pamięci RAM.
RAM – Random Access Memory – pamięć o dostępie swobodnym; Najszybsza pamięć operacyjna, w której tworzony jest dopisywalny segment Head bazy TSDB.
I/O – Input/Output – operacje wejścia/wyjścia; Operacje zapisu i odczytu nośników pamięci masowej minimalizowane przez 2-godzinne kompresje blokowe.
SSD – Solid State Drive – dysk półprzewodnikowy; Nośnik dyskowy o wysokiej liczbie operacji IOPS rekomendowany jako pamięć trwała dla serwera Prometheus.

38/55 Skalowanie Prometheus
Histogram - rozkład obserwacji w bucketach. histogram_quantile(0.99, rate(...)) → p99. Agregowalny między instancjami.

Jeden Prometheus ma sufit (~1-2 mln serii). Dalej: shardy, pary HA i Thanos na długą pamięć.

  • Limity skalowalności pojedynczego węzła – pojedynczy serwer Prometheus może obsłużyć miliony próbek, lecz przy dużej skali wymaga podziału zadań.
  • Podejście federacyjne (Federation) – nadrzędny serwer monitoringu pobiera zagregowane metryki z serwerów lokalnych w poszczególnych centrach danych.
  • Architektura długoterminowa (Thanos, Cortex) – zewnętrzne systemy rozproszone przejmują zadanie wieloletniej archiwizacji metryk w chmurze obiektowej.
  • Wysoka dostępność serwerów metryk – uruchomienie dwóch niezależnych serwerów Prometheus odpytujących te same cele eliminuje pojedynczy punkt awarii.
  • Równoważenie obciążenia zbieraniem danych – podział celów monitoringu między wiele instancji serwera zapobiega wyczerpaniu zasobów sprzętowych.
Skalowanie poziome: Rozdzielenie celów między kilka serwerów Prometheus (np. po zespołach lub regionach), gdy pojedyncza instancja przekracza granice serii i próbek na sekundę.
architektura rozproszona

Pojedynczy Prometheus ma twarde limity skali (vertical scaling: ~1-2M active series, ~100k samples/sec) wynikające z RAM (Head block), CPU (compaction, rule evaluation) i dysku (retention). Wyjście poza pojedynczy serwer to Sharding (podział targetów), Federation (hierarchiczne zapytania), HA (redundancja) oraz Remote Write + Long-term Storage (Thanos/Cortex/Mimir/VictoriaMetrics) - wybór zależy od skali, zespołu, budżetu i wymagań retention.

Sharding / Federation - Podział na wiele instancji: Sharding = rozdzielenie targetów na N niezależnych serwerów Prometheus (np. po teamach: team-a-prom, team-b-prom; po env: prod-prom, staging-prom; po regionach: eu-prom, us-prom). Każdy shard ma swój TSDB, swoje reguły, swoje alerty. Federation = hierarchia: "master" Prometheus scrapuje `/federate` endpoint z "child" shardów (tylko wybrane metryki, np. `job:requests:rate5m`), agreguje globalnie. Zaleta sharding: izolacja blast radius (awaria jednego shardu nie zabija całego monitoringu), łatwiejsze RBAC. Wada: brak globalnego query (trzeba Federation). Federation: `federate` endpoint zwraca instant vectors z matchers - master scrapuje co 30s, child musi mieć `--web.enable-lifecycle` lub shared config.

HA Prometheus - Wysoka Dostępność Monitoringu: Uruchomienie 2+ IDENTYCZNYCH serwerów Prometheus scrapujących TE SAME targety (HA pairs). Każdy ma własny TSDB (lokalny dysk). Alertmanager deduplikuje alerty (te same labeli = jeden alert). Remote write do WSPÓLNEGO long-term storage (Thanos/S3) = unified history. Load balancer przed Prometheus UI (opcjonalnie). Brak pojedynczego punktu awarii (eliminacja SPOF): w razie awarii jednego serwera Prometheus drugi kontynuuje pobieranie metryk, alerty są wysyłane, a dane nie ulegają utracie dzięki buforowaniu remote write. Koszt: 2x RAM/CPU/dysk dla scrapowania. To standard produkcyjny - nie robi się HA "później", robi się od razu.

Thanos - Long-term Storage + Global Query: Thanos (CNCF Incubating) to zestaw komponentów: Sidecar (obok Prometheus: upload blocks do S3, `/query` proxy), Query (globalny query engine: odczytuje Prometheus + S3), Store Gateway (indeksuje bloczki w S3, serwuje dane historyczne), Compact (downsampling: 5m → 1h resolution dla starych danych), Receive (opcjonalnie: ingest remote write). Cechy: UNLIMITED RETENTION (S3 = nieskończone), DOWNSAMPLING (stare dane mniejszą rozdzielczością = tanie), HA DEDUPLICATION (sidecar deduplikuje HA pairs), GLOBAL QUERY (jeden PromQL na wszystkich shardach + historii). Popularne, dojrzałe, duże komercyjne wsparcie.

Alternatywy - Cortex / Mimir / VictoriaMetrics: Cortex (horizontally scalable, multi-tenant, Cassandra/S3 backend, complex ops) → Mimir (Grafana Labs fork Cortex: prostszy, szybszy, lepsza kompresja, single-tenant default) → VictoriaMetrics (single-binary, wysoce wydajne, zużywające nawet dziesięciokrotnie mniej pamięci RAM niż Prometheus, MetricsQL superset PromQL). Wybór: Thanos = jeśli masz już Prometheus i chcesz dodać long-term; Cortex/Mimir = jeśli budujesz managed platformę multi-tenant; VictoriaMetrics = jeśli chcesz single-binary, tanie, proste, fast. Wszystkie obsługują remote write z Prometheus.

Terminologia: federation (federacja - hierarchiczne zapytania), HA (High Availability - wysoka dostępność), Thanos (long-term storage stack), Cortex (horizontally scalable TSDB), Mimir (Grafana Labs TSDB), VictoriaMetrics (single-binary efficient TSDB), downsampling (próbkowanie w dół - zmniejszenie rozdzielczości starych danych), global query (zapytanie globalne po wszystkich shardach), remote read (zdalne czytanie z long-term storage), long-term storage (długoterminowe przechowywanie).

Pojedynczy Prometheus ma twarde granice skali - około miliona do dwóch milionów aktywnych serii i sto tysięcy próbek na sekundę - wyznaczone przez pamięć bloku głównego, obciążenie procesora kompaktacją i wielkość dysku. Gdy te granice zaczynamy przekraczać, skalujemy w poziomie. Najprościej jest rozdzielić cele między kilka serwerów - na przykład po zespołach, środowiskach albo regionach. Wtedy awaria jednego skrawka nie wyłącza całego monitoringu, a każdy zespół zarządza własną instancją.

Dla wysokiej dostępności uruchamiamy parę identycznych serwerów, które skrapują te same cele; duplikaty alertów usuwa Alertmanager. Natomiast nieograniczony czas przechowywania i zapytania w całym klastrze daje stos Thanos: boczny proces wgrywa bloki danych do obiektowego magazynu, a komponent pytań odpytuje równocześnie servery i archiwum. Do rozwiązań płatnych podobną rolę pełnią Cortex, jego następca Mimir albo lekka VictoriaMetrics - wybór zależy od skali, budżetu i wymogów retencji.

Wyjaśnienie skrótów użytych na slajdzie:
HA – High Availability – wysoka dostępność; Układ redundancji składający się z dwóch niezależnych serwerów Prometheus odpytujących te same cele.
LTS – Long Term Storage – długoterminowe składowanie danych; Zewnętrzne platformy (np. Thanos, Cortex, Mimir) przechowujące archiwalne szeregi czasowe poza serwerem lokalnym.
Object Storage – Object Storage – obiektowa pamięć masowa; Wysoce skalowalne repozytorium obiektowe (np. MinIO, Ceph, AWS S3) przechowujące skompresowane bloki metryk.
S3 – Simple Storage Service – prosta usługa pamięci masowej; Standard protokołu i interfejsu API obiektowej pamięci masowej wywodzący się z platformy AWS.
RPC – Remote Procedure Call – zdalne wywołanie procedury; Mechanizm gRPC używany do przesyłania skompresowanych próbek przez protokół Prometheus remote_write.

39/55 Kartezjusz: metryki a alerty
Alerting rules - definicja warunków w PromQL; severity, summary, annotations; plik .yml z sekcją groups i rules.

Od metryki do alertu prowadzi inżynieria: reguły, dyspozytor i zasada „wołać tylko, gdy trzeba działać”.

  • Rozdzielenie metryk od powiadomień – metryka rejestruje faktyczny stan liczbowy, natomiast alert jest interpretacją biznesową wymagającą reakcji.
  • Unikanie nadmiarowości alarmów – alert powinien być wyzwalany wyłącznie wtedy, gdy zagrożona jest realizacja celu SLO lub stabilność usługi.
  • Zjawisko zmęczenia alertami (Alert Fatigue) – zalew nieistotnych powiadomień znieczula dyżurnych inżynierów, prowadząc do zignorowania krytycznej awarii.
  • Parametr opóźnienia alertu (for) – warunek alarmowy musi utrzymywać się przez określony czas, aby wykluczyć reakcję na chwilowe szpilki obciążenia.
  • Hierarchia dotkliwości powiadomień – powiadomienia dzieli się na krytyczne (budzące dyżurnego w nocy) oraz ostrzeżenia zapisywane w systemie ticketowym.
Alertmanager: Centralny dyspozytor alertów; usuwa duplikaty, grupuje podobne powiadomienia i kieruje je do odbiorców.
od metryki do alertu

Most między metryką a alertem wymaga inżynierii, nie "ustawienia progu": recording rules (pre-compute), alerting rules (for duration, labels, annotations) i Alertmanager (dedup, group, inhibit, silence, route). Fundamentalną zasadą jest, że nie każda metryka ma mieć alert - alert fatigue to #1 killer skuteczności on-call; architektura potoku to multi-window burn rate (standard Google) i severity levels.

Reguły alertów w Prometheus - Dwa typy reguł w `rule_files`: Recording Rules (pre-compute heavy queries): np. `job:requests:rate5m = sum by (job) (rate(http_requests_total[5m]))` - obliczane co evaluation_interval (30s), wynik jako nowa metryka. Alerting Rules (warunki alertów): `expr` (PromQL zwracający instant vector), `for` (duration - jak długo warunek musi trwać, np. `5m` by odfiltrować spike), `labels` (dodatkowe labeli: `severity="critical"`, `team="backend"`), `annotations` (treść alertu: `summary`, `description`, `runbook_url`). SEPARATION OF CONCERNS: Recording rules = compute, Alerting rules = decision. Nie mieszać heavy query w `expr` alertu - używaj recording rule.

Alertmanager - Centralny Menedżer Alertów: Odbiera alerty z WSZYSTKICH Prometheus (HA pairs, shards) na `/api/v1/alerts`. Funkcje: Deduplication (ten sam alert z 2 HA Prometheus = 1 alert), Grouping (grupowanie po labelach: `group_by: [cluster, alertname]` - 1 notification zamiast 50), Inhibition (ciszenie: `source_match: severity="critical"` → `target_match: severity="warning"` - critical wycisza warning), Silencing (wyciszenie na czas: maintenance window, deploy), Routing Tree (drzewo routingu: `route:` → `receiver:` - Slack, Email, PagerDuty, OpsGenie, Webhook). HA Cluster: gossip protocol między instancjami Alertmanager (port 9094) - shared state silences/inhibitions. Single Pane of Glass = jeden widok na WSZYSTKIE alerty.

Nie każda metryka = alert - Alert Fatigue Prevention: Zła praktyka: alert na `cpu > 80%`, `memory > 85%`, `disk > 90%`, `latency_p95 > 200ms`, `latency_p99 > 500ms`, `error_rate > 0.1%` - tysiące alertów, on-call ignoruje, prawdziwa awaria ginie w szumie. Dobra praktyka: alertowanie wyłącznie na problemy wymagające działania (actionable issues) - SLO breach (`sli:availability < 0.999`), Disk Full (predykcja: `disk_free < 4h`), Service Down (`up == 0`). Info metrics (CPU%, RAM%, queue depth) = DASHBOARDS ONLY (do troubleshootingu, nie do budzenia o 3AM). Noise reduction = survival on-call.

Projektowanie Progów - Multi-Window Burn Rate (Google SRE Workbook): Zamiast statycznych progów (`error_rate > 0.01`), używamy BURN RATE = jak szybko zużywamy error budget. Fast Burn: `burn_rate > 2% budget/1h` (np. ~1.44% error rate przez 1h przy SLO 99.9% = burn rate 14.4) → CRITICAL (PAGE - budzi on-call). Slow Burn: `burn_rate > 5% budget/6h` (np. ~0.6% error rate przez 6h = burn rate 6) → WARNING (TICKET - jutro rano). Przeliczenie: error rate = burn rate × (1 − SLO), a zużyty budżet w oknie = burn rate × długość okna (np. 14.4 × 1h = 14.4h ≈ 2% z 720h). To eliminuje fałszywe alarmy na krótkich spike'ach (fast burn = prawdziwa awaria) i łapie trwałe degradacje (slow burn = trend). Severity Levels: Critical (page now), Warning (ticket), Info (dashboard only).

Przejście do Wykładu 6 - Full Alerting Pipeline: Wykład 6 = Alertmanager Deep Dive: Config (`route`, `receivers`, `inhibit_rules`, `silences`, `templates`), Receivers (Slack webhook, email SMTP, PagerDuty, OpsGenie, Webhook, WeChat), Routing (group_by, group_wait, group_interval, repeat_interval), Inhibition (ciszenie warning przez critical), Silencing (UI + API), Templates (Go templates dla treści alertu), Integration (Grafana Alerting v2, Mimir ruler). To kompletny pipeline: Metryka → Recording Rule → Alerting Rule → Prometheus → Alertmanager → Receiver → On-call.

Przejście od metryki do alertu wymaga inżynierii, a nie tylko ustawienia progu. W pliku reguł trzymamy dwa rodzaje wpisów. Reguły nagrywające wyliczają wcześniej kosztowne zapytania i zapisują wynik jako nową metrykę. Reguły ostrzegające definiują warunek zapisany w PromQL, czas utrzymywania warunku, etykiety określające na przykład wagę incydentu oraz treść powiadomienia. Gotowe alerty trafiają do Alertmanagera - centralnego dyspozytora, który usuwa duplikaty z par serwerów, grupuje podobne powiadomienia, wycisza jedne alerty innymi i wstrzymuje je w oknach prac.

Najważniejsza zasada brzmi: nie każda metryka zasługuje na alert. Setki progów procentowych oznaczają szum, do którego dyżurny przestaje przykładać wagę, a prawdziwa awaria ginie w natłoku. Alertujemy tylko problemy wymagające działania - naruszenie SLO, przewidywane wyczerpanie przestrzeni dyskowej albo awaria usługi. Zamiast statycznych progów stosujemy wielookienkową szybkość wyczerpywania budżetu błędów: szybkie spalanie budzi natychmiast, wolne tworzy zgłoszenie do poranka. W ten sposób jeden potok spina metrykę, reguły i systemy powiadamiania.

Wyjaśnienie skrótów użytych na slajdzie:
AM – Alertmanager – menedżer alertów Prometheus; Niezależna usługa odpowiedzialna za deduplikację, grupowanie, wyciszanie i routing powiadomień awaryjnych.
PromQL – Prometheus Query Language – język zapytań Prometheus; Język, w którym zapisywane są reguły alertowe oceniające stan systemu w każdym cyklu ewaluacji.
SMS – Short Message Service – usługa krótkich wiadomości tekstowych; Kanał powiadamiania inżynierów dyżurnych o awariach o najwyższym poziomie krytyczności.
Pager – Pager / On-call notification system – system przywoławczy inżyniera; Platforma powiadamiania dyżurnego (np. PagerDuty) forsująca wybudzenie w przypadku incydentu P1.
SMTP – Simple Mail Transfer Protocol – prosty protokół przesyłania poczty; Tradycyjny protokół sieciowy służący do wysyłania alertów o niskim priorytecie na skrzynki e-mail.

40/55 Najczęstsze błędy przy metrykach
Najczęstsze błędy: brak baseline przed SLO, zbyt wiele SLI (>3), brak korelacji metryk z logami, brak testów alertów.

Te same antywzorce wracają wszędzie: ślepe progi, dzikie etykiety i alerty, których nikt nie testował.

  • Pułapka wyliczania średniej arytmetycznej – średni czas odpowiedzi ukrywa dramatyczne opóźnienia u wąskiej grupy klientów; należy badać percentyle.
  • Niewłaściwy dobór okna funkcji rate() – okno czasowe musi być co najmniej czterokrotnie dłuższe niż interwał pobierania próbek.
  • Stosowanie funkcji rate() do Gauge – użycie pochodnej na zmiennym wskaźniku chwilowym fałszuje wyniki w przypadku wahań wartości.
  • Brak weryfikacji resetu licznika – ręczne odejmowanie próbek pomija fakt restartu usługi; poprawny wynik gwarantują dedykowane funkcje PromQL.
  • Zaniedbanie monitoringu samego monitoringu – serwer telemetryczny musi być nadzorowany przez niezależną sondę zewnętrzną (tzw. meta-monitoring).
Kardynalność: Liczba unikalnych serii czasowych; jej eksplozja (np. przez nieograniczone etykiety) pożera pamięć i spowalnia zapytania.
antywzorce metryk

Największym zagrożeniem stabilności serwera Prometheus jest eksplozja kardynalności etykiet, prowadząca do gwałtownego wyczerpania pamięci RAM i ubicia procesu przez OOM Killer.

Antywzorce przy metrykach to błędy powtarzane w każdej organizacji, które kosztują: fałszywe poczucie bezpieczeństwa, alert fatigue, OOM, wolne zapytania i niezdolność do debugowania. Każdy punkt to realny incydent produkcyjny spakowany w lekcję - celem jest rozpoznać wzorzec przed wdrożeniem, nie po awarii.

Zbyt wysokie progi - Reactive, nie Proactive: Ustawienie alertu na `up == 0` (usługa down) albo `error_rate > 50%` = REAKTYWNE. Gdy alert wyzwala się, usługa JUŻ nie działa, użytkownicy JUŻ cierpią, SLO już naruszone. Dobre progi = LEADING INDICATORS (wskaźniki wiodące): Saturation (CPU > 80%, memory > 85%, disk > 80%, connection pool > 80%) - System NADCHODZI do limitu, ale JESZCZE DZIAŁA. Latency trend (p95 rośnie 10%/h) - degradacja W TRAKCIE. Error rate growth (error rate rośnie z 0.1% na 1% w 30min) - coś się psuje. Proactive > Reactive: wykrywasz problem 30-60min przed wystąpieniem wpływu na użytkowników, masz czas na mitigację (scale, restart, rollback) BEZ naruszenia SLO.

Brak etykiet lub ich nadmiar - Label Discipline: bez etykiet (tylko `http_requests_total`): nie da się filtrować per service (`job`), per instance (`instance`), per endpoint (`handler`), per status (`status_code`). Wszystko w jednym worku - dashboard pokazuje GLOBALNY RPS, ale nie wiesz KTÓRY serwis rośnie. zbyt wiele unikalnych etykiet (user_id, request_id, session_id, trace_id, IP, raw URL path): CARDINALITY EXPLOSION. Każda unikalna kombinacja = nowy szereg czasowy. 1M userów × 10 endpointów = 10M serii = OOM (Prometheus crash), wolne zapytania (minuty), dysk rośnie wykładniczo. ROZWIĄZANIE: wyłącznie etykiety o ograniczonej kardynalności (status_code ~20, method ~10, handler ~100, job ~50). UNBOUNDED DROP: `metric_relabel_configs: - action: drop; regex: 'user_id|request_id|trace_id'`. Label discipline = cost control = query performance control.

Monitorowanie wszystkiego bez celu - Purpose-Driven Monitoring: "Monitorujemy wszystko" = szum informacyjny, koszty i brak priorytetyzacji – 1000 metryk, z których 90% nigdy nikt nie patrzy, 50% ma high cardinality, 0% ma alert/SLI. Zalecana praktyka: monitoruj wyłącznie to, co bezpośrednio determinuje podejmowane akcje: wskaźniki SLI (dostępność, opóźnienia, jakość) → realizacja celów SLO → budżet błędów → alerty. Capacity signals (saturation: CPU, RAM, disk, network, pool usage) → capacity planning, autoscaling. Leading indicators (trendy, saturation) → proactive alerts. Wszystko inne = dashboards do ad-hoc troubleshootingu (Grafana Explore), nie alerty. Purpose-driven = każda metryka ma "dlaczego" (SLI, alert, capacity, debug).

Pomijanie weryfikacji - Alerting Theater: Skonfigurowałeś alert, widzisz go w UI, czujesz się bezpiecznie - ALE czy SPRAWDZIŁEŚ, czy faktycznie wyzwala się przy awarii? Zjawisko „Alerting Theater” tworzy jedynie fałszywe poczucie bezpieczeństwa. WERYFIKACJA: Chaos Testing (zabij proces, odłącz sieć, wypełnij dysk, zwolnij CPU) → sprawdź czy alert page'uje. Manual Trigger (Alertmanager UI → "Send test alert") → sprawdź routing, receiver, treść. Regularnie (quarterly): Fire Drill (symulacja incydentu end-to-end: alert → on-call → mitigation → post-mortem). Jeśli alert nie zadziałał w teście - NIE ZADZIAŁA W PRODUKCJI. Test alerts regularly = survival.

Dobre praktyki - Maturity Model: SLI-driven alerting (alert na SLI breach, nie na surową metrykę), Burn rate alerting (multi-window, nie static threshold), Label discipline (bounded only, drop unbounded), Recording rules (pre-aggregate heavy queries), Test alerts (chaos testing, fire drills), Runbooks linked in annotations (`runbook_url` w alert rule → on-call ma procedurę pod ręką), Metrics lifecycle (quarterly review: drop unused, fix cardinality, add missing SLI). Maturity: Level 1 (chaos, reactive) → Level 2 (SLI/SLO, proactive) → Level 3 (burn rate, automated) → Level 4 (self-healing, predictive).

Antywzorce przy metrykach powtarzają się w każdej organizacji i kosztują realnie: fałszywe poczucie bezpieczeństwa, zmęczenie alertami, utratę pamięci przez eksplozję kardynalności, spowolnienie zapytań i niemożność debugowania. Zamiast oczekiwać na awarię, lepiej rozpoznać wzorzec z wyprzedzeniem. Pierwszy i najczęstszy błąd to progi ustawione tak, że alert wyzwala się dopiero wtedy, gdy usługa już nie działa - wskaźniki wiodące, takie jak nasycenie czy trend opóźnień, dają nam trzydzieści minut na reakcję przed odczuciem problemu przez użytkowników.

Równie szkodliwe są obie skrajności z etykietami. Bez nich nie odfiltrujemy żadnego wymiaru; z ich nadmiarem - na przykład z etykietą identyfikatora użytkownika - każda kombinacja staje się osobnym szeregiem czasowym, dysk i pamięć rosną wykładniczo, a zapytania liczą się w minutach. Do tego dochodzą monitoring wszystkiego bez celu i brak sprawdzenia, czy alert w ogóle działa. Konfiguracja alertu to dopiero początek: bez prób ogniowych i testów chaosu mamy „teatr alertingowy", który wygląda na bezpieczeństwo, a w awarii nie odpowiada.

Wyjaśnienie skrótów użytych na slajdzie:
OOM – Out of Memory – wyczerpanie pamięci operacyjnej; Awaria procesu wywołana przekroczeniem dostępnej pamięci RAM w wyniku nadmiernej kardynalności etykiet.
CPU – Central Processing Unit – procesor; Zasób zablokowany przez nieoptymalne reguły ewaluacji lub masowe dopasowywanie wyrażeń regularnych w PromQL.
Cardinality – Label Cardinality – kardynalność etykiet; Liczba unikalnych kombinacji par klucz-wartość tworzących odrębne szeregi czasowe w bazie TSDB.
TSDB – Time Series Database – baza danych szeregów czasowych; Silnik ulegający degradacji wydajnościowej w przypadku przekroczenia milionów aktywnych szeregów.
DoS – Denial of Service – odmowa usługi; Stan niedostępności monitoringu wywołany przeciążeniem serwera przez błędną konfigurację zbierania danych.

41/55 Dobre praktyki metryk
Praktyka: zainstaluj Prometheus + node_exporter, napisz 3 zapytania PromQL, utwórz 1 dashboard w Grafana, zdefiniuj 1 alert.

Kodeks utrzymania monitoringu: dyscyplina etykiet, nazwy z sensem, weryfikacja i przeglądy.

  • Standaryzacja nazewnictwa w organizacji – ujednolicone przedrostki i jednostki metryk ułatwiają tworzenie wspólnych reguł i dashboardów.
  • Dokumentacja znaczenia metryk – każda autorska metryka aplikacyjna musi posiadać opis (HELP) precyzujący jej znaczenie i jednostkę fizyczną.
  • Utrzymywanie niskiej kardynalności – świadome projektowanie etykiet zapobiega niekontrolowanemu rozrostowi liczby szeregów czasowych w bazie.
  • Wersjonowanie konfiguracji monitoringu – pliki konfiguracyjne oraz reguły alarmowe podlegają takiej samej kontroli wersji w Git jak kod aplikacji.
  • Cykliczny przegląd aktywnych reguł – inżynierowie powinni regularnie usuwać nieużywane metryki i wyciszać alarmy generujące fałszywe powiadomienia.
Dyscyplina etykiet: Dopuszczanie tylko wartości ze zbiorów skończonych (status, metoda, ścieżka) i odrzucanie nieograniczonych identyfikatorów już w relabelingu.
lista dobrych praktyk

Kodeks dobrych praktyk instrumentacji odróżnia "działający monitoring" od "produkcyjnego, skalowalnego, utrzymywalnego systemu obserwowalności": złe nazewnictwo daje nieczytelne zapytania, high cardinality daje OOM, brak testów daje broken alerts, brak przeglądu daje legacy metrics garbage. Każda zasada ma mechanizm egzekwowania (relabeling, promtool, recording rules, quarterly review) - to checklist do code review metryk.

Ograniczona liczba etykiet - Bounded Label Values = Cardinality Control: DOZWOLONE (Bounded Sets): `status_code` (10-30 wartości: 200, 404, 500, 503...), `method` (5-10: GET, POST, PUT, DELETE...), `handler` / `route` (setki: `/api/users`, `/api/orders/:id` - NORMALIZOWANE, nie surowy path z parametrami!), `job` (kilkadziesiąt), `instance` (setki/tysiące - OK, bo naturalne). ZABRONIONE (Unbounded): `user_id` (miliony), `request_id` / `trace_id` / `session_id` (unikatowe per request), `ip_address` (tysiące), `email`, `raw_url` (z query params). KAŻDE unbounded = kardynalność × unikalne wartości. ROZWIĄZANIE: `metric_relabel_configs` (przed zapisem do TSDB): `- action: labeldrop; regex: 'user_id|request_id|trace_id|ip'` LUB `relabel_configs` (przed scrape). Label discipline = koszt infrastruktury (RAM, dysk, CPU) = query performance.

Jasne nazwy - Naming Conventions = Queryability: ZŁE: `reqs`, `cpu_usage`, `mem`, `lat`, `errs`, `cnt`. DOBRE (Prometheus naming best practices): `http_requests_total` (Counter: suffix `_total`), `node_cpu_seconds_total` (Counter: `_seconds_total` dla czasu), `http_request_duration_seconds_bucket` (Histogram: `_seconds_bucket`), `node_memory_MemAvailable_bytes` (Gauge: `_bytes` dla bajtów), `process_open_fds` (Gauge: bez suffixu, ale opisowe), `go_goroutines` (Gauge). KONWENCJE: snake_case, angielskie, opisowe, suffixy typowe (`_total` counter, `_seconds` czas, `_bytes` rozmiar, `_ratio` iloraz 0-1). Spójne nazewnictwo = `sum by (job) (rate(http_requests_total[5m]))` DZIAŁA intuicyjnie, nie trzeba pamiętać dziwnych nazw.

Testowanie zapytań - PromQL Verification: NIE wdrażaj zapytania do alertu/recording rule/dashboardu bez weryfikacji. Narzędzia: Prometheus UI (`/graph`) - weryfikacja składni, wyników, EXPLAIN (query plan: ile serii, ile bloków, szacunkowy czas). Grafana Explore - ad-hoc, autouzupełnianie labeli, history, split view (metrics + logs). PERFORMANCE: `query_duration_seconds` w Prometheus metrics - cel < 1s dla alertów, < 5s dla dashboardów. Recording Rules dla HEAVY QUERIES: pre-aggregate co 30s/1m, dashboard/alert query gotowy szereg w ms. BENCHMARKING: `promtool query instant/range` - automatyczne testy w CI/CD. Testowane = pewne.

Regularny przegląd - Metrics Lifecycle Management (Quarterly Review): Metryki nie są "zrób i zapomnij". CO KWARTAŁ: Unused metrics (drop: `metric_relabel_configs action: drop` lub usuń z instrumentacji) - oszczędzasz RAM/dysk/CPU. High cardinality (fix: drop unbounded labels, normalize handlers) - eliminujesz OOM/wolne query. Missing SLI (add: nowy serwis, nowy endpoint, nowy business KPI) - pokrycie observability. Naming consistency (fix: rename przez relabeling lub nową instrumentację) - czytelność. Deprecated metrics (remove: stara wersja API, usunięty endpoint) - higiena. To PROCES, nie one-off. Metrics lifecycle = cost control + observability coverage.

Terminologia: naming conventions (konwencje nazewnictwa), label discipline (dyscyplina etykiet), cardinality management (zarządzanie kardynalnością), recording rules (reguły rejestrujące/wstępnie agregujące), query optimization (optymalizacja zapytań), metrics review (przegląd metryk), metrics lifecycle (cykl życia metryk).

Kodeks dobrych praktyk odróżnia działający monitoring od systemu produkcyjnego, który da się utrzymać. Po pierwsze dyscyplina etykiet: dopuszczamy tylko wartości ze zbiorów skończonych - kod statusu, metodę HTTP, ścieżkę routingu - a nieograniczone identyfikatory użytkowników i żądań odrzucamy już w relabelingu, zanim trafią do bazy. Po drugie nazewnictwo: spójna konwencja z dopiskiem mówiącym o typie, takim jak _total, _seconds czy _bytes, sprawia, że zapytania czyta się intuicyjnie, bez zaglądania w dokumentację.

Po trzecie weryfikacja: każde zapytanie najpierw sprawdzamy w interfejsie graficznym, a kosztowne zapytania przenosimy do reguł nagrywających, żeby alerty i pulpity odpowiadały w milisekundach. I wreszcie cykl życia: metryki wymagają kwartalnego przeglądu - usuwania nieużywanych serii, naprawiania kardynalności, dosypywania brakujących wskaźników SLO. Metryki to nie projekt na raz, lecz proces ciągły, bo koszt ich utrzymania idzie w górę z każdą zapomnianą serią.

Wyjaśnienie skrótów użytych na slajdzie:
SI – International System of Units – Międzynarodowy Układ Jednostek Miar; Zbiór podstawowych jednostek fizycznych; zaleca się podawanie metryk w jednostkach bazowych (np. sekundy, bajty).
PEP – Python Enhancement Proposal – propozycja ulepszenia języka Python; Standardy programistyczne promujące konwencję nazewniczą snake_case, obowiązującą również w metrykach.
POSIX – Portable Operating System Interface – standard przenośnego systemu operacyjnego; Standard nazewnictwa plików i zmiennych spójny z konwencją nazw metryk telemetrycznych.
UTC – Coordinated Universal Time – uniwersalny czas koordynowany; Standard czasu, w którym muszą być rejestrowane wszystkie znaczniki próbek w systemach monitoringu.
ISO – International Organization for Standardization – Międzynarodowa Organizacja Normalizacyjna; Organizacja normalizacyjna definiująca standardy formatów daty i jednostek pomiarowych.

42/55 Analiza danych telemetrycznych (podstawy)
Weryfikacja SLI - testy syntetyczne (blackbox) + dane z produkcji; porównanie SLI z historycznym baseline; alertowanie przy odchyleniu.

Surowe liczby w diagnozę: anomalia, progi, korelacje i akcja z gotowym scenariuszem.

  • Interpretacja wykresów szeregów czasowych – analiza trendu polega na identyfikacji anomalii, okresowych cykli dobowych oraz nagłych skoków.
  • Korelacja czasowa zdarzeń – zestawienie wykresu obciążenia procesora ze skokiem błędów aplikacji pozwala szybko zweryfikować hipotezę o awarii.
  • Wykrywanie powolnego dryftu parametrów – stopniowy wzrost zajętości pamięci w ciągu wielu dni świadczy o istnieniu wycieku pamięci w kodzie.
  • Analiza wpływu prac serwisowych – obserwacja zachowania metryk w trakcie planowych prac potwierdza poprawność wdrożonych poprawek.
  • Wnioskowanie oparte na faktach – wykresy metryk stanowią bezstronny dowód w raportach poawaryjnych, eliminując domysły i przypuszczenia.
Anomalia: Wartość istotnie odbiegająca od historycznego wzorca (baselinu); wskazuje miejsce do analizy, ale sama nie jest jeszcze wnioskiem.
analiza wykresu

Analiza danych telemetrycznych zamienia surową serię liczb w DIAGNOZĘ i DZIAŁANIE: wykryj anomalię → skoryguj z progami → skoreluj metryki (root cause isolation) → sformułuj działanie → zamknij pętlę (closed loop). Każdy krok ma narzędzia (statystyczne, ML, runbooks) i miary skuteczności (MTTA, MTTR) - to kompetencja analityczna (U01 z sylabusa) w praktyce SRE.

Identyfikacja niezgodności (Anomaly Detection) - Odchylenie od Baseline: Anomalia = wartość metryki istotnie odbiegająca od "normalności" (baseline). Baseline = historyczny wzorzec (sezonowość: dzienny/tygodniowy cykl, trend: rosnący/spadający). METODY: Statystyczne (3-sigma: > 3 odchylenia standardowe od średniej rolling window; IQR: rozstęp interkwantylowy), ML (Prophet - Facebook time series forecasting z sezonowością; Isolation Forest - unsupervised anomaly detection dla wielowymiarowych danych). AUTOMATED vs MANUAL: Automated = alerty na anomalie (np. `anomaly_score > threshold`), Manual = ad-hoc exploration (Grafana Explore: "czy to normalne?"). Klucz: kontekst (deploy? incydent u dostawcy? Black Friday?).

Porównanie z progami (Threshold-Based Decisions) - SLI/SLO/Capacity: Trzy kategorie progów: 1) SLI vs SLO (Error Budget Remaining): `sli:availability < 0.999` → alert, `error_budget_remaining < 10%` → warning. To najważniejsze progi - decydują o release freeze. 2) Resource vs Capacity (Saturation): `disk_usage > 80%` (warning), `> 90%` (critical), `> 95%` (emergency); `memory_available < 10%`; `cpu_saturation > 80%`. 3) Latency vs SLO: `p99_latency > 500ms` (SLO threshold). PROGI = DECYZJE: przekroczenie = konkretna akcja (scale, restart, rollback, freeze, ticket). Bez progu = bez decyzji = pasywność.

Korelacja metryk - Root Cause Isolation (Współwystępowanie): Metryki nie istnieją w próżni – wykazują wzajemną korelację. Wzorce korelacji: wzrost CPU, opóźnień i kolejki oznacza nasycenie zasobów (wymagane skalowanie lub optymalizacja); wysokie CPU przy stabilnych opóźnieniach wskazuje na intensywne obliczenia procesora; wzrost opóźnień z błędami sygnalizuje awarię zależności zewnętrznej (baza danych, cache, zewnętrzne API); wzrost pamięci z pauzami odśmiecacza pamięci (GC) i opóźnieniami oznacza presję na pamięć sterty; natomiast skok opóźnień z retransmisjami świadczy o przeciążeniu sieci. Analiza korelacji pozwala na szybką wstępną diagnozę. Narzędzia: Grafana (overlay panels), PromQL (`correlation` functions), ad-hoc Explore.

Formułowanie działań – sprzężenie zwrotne (closed loop: z diagnozy do działania): diagnoza prowadząca do konkretnej akcji (Runbook): Scale out (HPA/VPA, manual replica++), Restart (pod/container/service), Rollback (poprzednia wersja - canary/ArgoCD), Fix Config (feature flag off, limit++, timeout++), Add Index (slow query → EXPLAIN → CREATE INDEX). Odnośnik do runbooka w adnotacjach alertu (`runbook_url: "https://wiki/runbook/db-saturation"`) sprawia, że inżynier dyżurny nie improwizuje, lecz realizuje sprawdzoną procedurę. Zamknięta pętla sprzężenia zwrotnego (closed loop): działanie naprawcze → weryfikacja powrotu metryk do normy → udokumentowanie w raporcie post-mortem → wdrożenie usprawnień eliminujących przyczynę źródłową. Podejście to opiera decyzje operacyjne na twardych dowodach telemetrycznych, a nie na przypuszczeniach.

Związek z U01 (Sylabus) - Kompetencja Analityczna: Interpretacja danych (czytanie wykresów, rozpoznawanie wzorców), Wnioskowanie (korelacja a związek przyczynowo-skutkowy – myślenie analityczne), Decyzyjność oparta na dowodach (data-driven, nie opinion-driven). To co odróżnia SRE od "admin clickops" - SRE ANALIZUJE, admin REAGUJE. Evidence-based operations = kultura inżynierska.

Analiza danych telemetrycznych zamienia surowy strumień liczb w diagnozę i działanie. Na początek wykrywamy anomalię, czyli wartość istotnie odbiegającą od historycznego wzorca - baselinu z jego sezonowością i trendem. Pomagają tu proste metody statystyczne, takie jak reguła trzech sigma czy rozstęp kwartylowy, a przy bardziej złożonych danech uczenie maszynowe. Anomalia sama w sobie nie jest jeszcze wnioskiem - wskazuje jedynie miejsce, które wymaga analizy. Następnie porównujemy zmierzone wartości z progami trzech kategorii: docelowe SLO, nasycenie zasobów i opóźnienia względem umowy.

Kolejny krok to korelacja metryk, bo dane nie istnieją w próżni. Wzrost procesora razem ze wzrostem opóźnienia to nasycenie; wzrost opóźnienia razem z błędami to awaria zależności. Wreszcie zamykamy pętlę: diagnoza prowadzi do konkretnej akcji - skalowania, restartu czy wycofania zmiany - a odnośnik do procedury w adnotacji alertu daje dyżurnemu gotowy scenariusz. To właśnie odróżnia inżyniera analizującego dane od administratora, który jedynie reaguje.

Wyjaśnienie skrótów użytych na slajdzie:
IQR – Interquartile Range – rozstęp międzykwartylowy; Odporna na wartości odstające miara rozrzutu statystycznego wykorzystywana do wykrywania anomalii.
STD – Standard Deviation – odchylenie standardowe; Klasyczna miara zmienności rozkładu normalnego stosowana w regule trzech sigm (3-sigma rule).
RMS – Root Mean Square – wartość skuteczna; Statystyczna miara wielkości zmiennej wykorzystywana w analizie sygnałów i trendów obciążenia.
ML – Machine Learning – uczenie maszynowe; Algorytmy analizy predykcyjnej wykorzystywane do automatycznego modelowania sezonowości w telemetrii.
AI – Artificial Intelligence – sztuczna inteligencja; Zaawansowane systemy korelacji zdarzeń redukujące szum informacyjny w centrach operacyjnych (NOC/SOC).

43/55 Przykład: awaria a metryki
Praktyka: zainstaluj Prometheus + node_exporter, napisz 3 zapytania PromQL, utwórz 1 dashboard w Grafana, zdefiniuj 1 alert.

Anatomia prawdziwej awarii: deploy, p95 > 500 ms w minutę i pusta pula do bazy. Minuty, nie godziny.

  • Chronologia odczytów w trakcie awarii – pierwszym objawem jest zazwyczaj wzrost latencji, po którym następuje skok błędów 5xx i spadek ruchu.
  • Reakcja łańcuchowa w mikroserwisach – spowolnienie jednej bazy danych blokuje pule wątków w kolejnych serwisach, wywołując kaskadową awarię.
  • Rola telemetrii w fazie mitygacji – obserwacja wykresów w czasie rzeczywistym potwierdza skuteczność restartu lub wycofania wersji (rollback).
  • Zachowanie danych na potrzeby analizy RCA – baza metryk zachowuje precyzyjny przebieg zdarzeń z dokładnością do sekund na potrzeby raportu post-mortem.
  • Lekcja inżynierska po awarii – każdy poważny incydent produkcyjny powinien zakończyć się dodaniem brakującej metryki lub optymalizacją progów.
Dostarczanie progresywne: Stopniowe zwiększanie udziału ruchu nowej wersji (1%, 5%, 10%…) z porównywaniem metryk kanarka ze stabilną wersją na każdym etapie.
wykresy przed i po

Anatomia incydentu z realnego case study ma postać: deploy → awaria → detection → diagnosis → mitigation → prevention. Metryki (p95 latency, CPU) i logi (connection pool, slow query) prowadzą do ROOT CAUSE, a działania naprawcze i zapobiegawcze zamykają post-mortem w miniatuże: timeline, metryki, logi, korelacja i wnioski operacyjne.

Wzrost opóźnień (p95) - Detection: Wykres `histogram_quantile(0.95, rate(http_request_duration_seconds_bucket[5m]))` - normalnie ~100ms, w momencie wdrożenia (oznaczonym linią pionową lub adnotacją) następuje skok opóźnień do 2 sekund (dwudziestokrotny wzrost). Natychmiastowe wykrycie: alert na `p95_latency > 500ms` (przekroczenie progu SLO) aktywuje się w czasie poniżej jednej minuty. Pulpit nawigacyjny wskazuje, że degradacja dotyczy wszystkich punktów końcowych, co stanowi wyraźny sygnał, że problem ma charakter systemowy, a nie lokalny.

Obciążenie CPU - Korelacja (USE Method): `rate(node_cpu_seconds_total{mode!="idle"}[5m])` - CPU skacze z 40% na 95% W w tym samym oknie czasowym co latency spike. KORELACJA: CPU 95% + latency↑ = RESOURCE EXHAUSTION (lub GC PRESSURE). USE Method validation: Utilization (CPU 95% = blisko limitu), Saturation (run queue rośnie, context switches↑), Errors (może nie ma, ale latency = error dla usera). To WYKLUCZA: network issue (CPU by nie skoczył), dependency failure (CPU by spadł lub był stabilny). FOKUS na: co zużywa CPU? (proces aplikacji, GC, kernel).

Weryfikacja przez logi - Metrics→Logs Correlation (Root Cause): Logi (Loki/ELK, wykład 4) w tym samym oknie czasowym: `ERROR connection pool exhausted` (HikariCP / Tomcat / PgBouncer - wszystkie połączenia zajęte), `WARN slow query > 5s` (konkretne SQL: `SELECT * FROM orders WHERE user_id = ?` bez indeksu). ROOT CAUSE: Bad SQL (full table scan) + NO wyczerpanie puli połączeń (default 10, a traffic 100 RPS → queue). Deploy wprowadził nowy endpoint bez code review SQL + bez load testu. Metryki pokazały CO (CPU, latency), logi pokazały DLACZEGO (SQL, pool).

Wnioski dla SRE - Mitigation & Prevention: MITIGATION (natychmiast): Alert na `p95_latency > 500ms` + `cpu_saturation > 80%` → AUTO-SCALE (HPA: replicas 3→10 w 2 min) LUB manual `kubectl scale deployment/api --replicas=10` + RESTART connection pool (flush). PREVENTION (na przyszłość): Connection pool limit (max 50, queue timeout 5s) - backpressure zamiast exhaustion. Canary deployment (1% → 5% → 10% → 100% z automated rollback na p95/CPU) - ZATRZYMAŁBY rollout na 5%. Code review SQL (EXPLAIN ANALYZE) + load test (k6/Locust) przed scaleniem (merge). Prevention > Cure: naprawa root cause trwa dni, mitigacja minut - ale prevention eliminuje klasę incydentów.

Analiza studium przypadku - Incident Anatomy (Pełny Cykl): 1) DETECTION: Alert (Prometheus → Alertmanager → PagerDuty) o 10:15. 2) DIAGNOSIS: On-call otwiera dashboard → widzi p95↑, CPU↑ → korelacja → otwiera logi (Loki) → `connection pool exhausted` + `slow query` → root cause zidentyfikowany o 10:22 (7 min). 3) MITIGATION: Scale out replicas + restart pool → latency wraca do 100ms o 10:30. 4) PREVENTION: Action items: (a) connection pool config, (b) SQL review gate w CI, (c) canary deployment pipeline, (d) load test nowych endpointów. 5) POST-MORTEM: Blameless, timeline, root cause, action items, owner, due date. To anatomia incydentu - od alertu do systemic fix.

Prześledźmy anatomię prawdziwej awarii. Po wdrożeniu nowej wersji alert na p95 opóźnienia przekraczającym pół sekundy wyzwala się w mniej niż minutę - wszystkie punkty końcowe jednocześnie uległy degradacji, co od razu mówi, że to problem systemowy, a nie pojedynczego endpointu. Na pulpicie procesor skacze z czterdziestu na dziewięćdziesiąt pięć procent dokładnie w tym samym momencie. Korelacja procesora z opóźnieniem to klasyczny obraz nasycenia; metoda USE potwierdza, że zasoby się wyczerpały, a przestrzeń zapisu czy opóźnienie sieci można wykluczyć.

Skąd czerpiemy przyczynę? Logi w tym samym oknie czasowym mówią „dlaczego": pula połączeń do bazy wyczerpana oraz wolne zapytanie - pełne skanowanie tabeli bez indeksu, które dostało się do produkcji z nowym endpointem. Reakcja jest dwutorowa: natychmiast skalowanie i restart puli, a na przyszłość limity puli, canary z automatycznym wycofaniem i przegląd zapytań SQL w przeglądzie kodu. Tak wygląda kompletny cykl - od alertu, przez diagnozę, po naprawę zapobiegawczą.

Wyjaśnienie skrótów użytych na slajdzie:
CPU – Central Processing Unit – procesor; Główny parametr podlegający skokowemu wzrostowi w trakcie awarii pętli w oprogramowaniu lub ataku DDoS.
RAM – Random Access Memory – pamięć operacyjna; Wskaźnik wycieku pamięci (memory leak) charakteryzujący się monotonicznym spadkiem dostępnych zasobów.
IOPS – Input/Output Operations Per Second – liczba operacji wejścia/wyjścia na sekundę; Wskaźnik nasycenia macierzy dyskowej prowadzący do drastycznego wzrostu czasu obsługi zapytań.
HTTP – Hypertext Transfer Protocol – protokół warstwy aplikacji; Protokół, w którym lawinowy wzrost odpowiedzi 502/503/504 wskazuje na awarię węzłów zaplecza (backendu).
DB – Database – baza danych; Kluczowa warstwa persystencji danych, której przeciążenie puli połączeń blokuje działanie całego systemu.

44/55 Utrzymanie monitoringu
Meta-monitoring - monitoring samego Prometheus: prometheus_config_last_reload_successful, prometheus_tsdb_head_series, job "prometheus".

Kto pilnuje strażnika? Prometheus sam siebie mierzy - a ty sprzątasz, liczysz i pilnujesz dysku.

  • Nadzór nad zasobami serwera Prometheus – administrator monitoringu musi stale kontrolować zużycie pamięci RAM oraz ilość wolnego miejsca na dysku.
  • Optymalizacja zapytań użytkowników – nieoptymalne zapytania PromQL w złożonych dashboardach Grafany potrafią czasowo zablokować serwer TSDB.
  • Bezpieczne aktualizacje oprogramowania – wdrażanie nowych wersji Prometheus i eksporterów wymaga uprzednich testów na środowisku laboratoryjnym.
  • Automatyzacja kopii zapasowych bazy – tworzenie migawek (snapshots) bazy TSDB pozwala na odtworzenie historii metryk po awarii sprzętowej.
  • Higiena rejestru celów zbierania – regularne usuwanie z konfiguracji wycofanych maszyn i kontenerów zapobiega marnowaniu zasobów sieciowych.
Meta-monitoring: Nadzór nad samym Prometheusem (status zadania, liczba serii, czas ewaluacji reguł); gdy monitoring pada, zespół jest ślepy.
utrzymanie systemu

Prometheus to usługa, która sama wymaga utrzymania: SLO, alertów, capacity planning i higieny. "Kto pilnuje strażnika?" - meta-monitoring (monitoring monitoringu) to fundament niezawodności, ponieważ w razie awarii serwera Prometheus tracimy wgląd w stan infrastruktury; składają się na niego self-monitoring (up, cardinality, rule perf), quarterly review higieny (SLO, targets, alerts, dashboards), czyszczenie metryk (cost control) i kontrola retencji/dysku (capacity planning).

Monitorowanie monitora - Meta-Monitoring (Self-Monitoring): Prometheus musi monitorować samego siebie. Kluczowe metryki: `up{job="prometheus"}` = 1 (Prometheus pobiera metryki z własnego procesu poprzez regułę w `scrape_configs`). `prometheus_tsdb_head_series` – liczba aktywnych serii w pamięci (kontrola kardynalności), gdzie alert wyzwalany jest po przekroczeniu progu (np. 1 miliona serii). `prometheus_tsdb_head_samples_appended_total` – tempo zapisu próbek na sekundę. `prometheus_rule_evaluation_duration_seconds` – czas ewaluacji reguł alertowych i rejestrujących (alarm przy przekroczeniu 10 sekund, gdyż wolne zapytania opóźniają kolejne). `prometheus_tsdb_compaction_duration_seconds` – czas trwania kompaktacji bloków TSDB. `prometheus_remote_storage_write_pending_bytes` – bufor kolejki zdalnego zapisu (remote write). Meta-monitoring to obserwowalność samego systemu obserwowalności, a reguły powiązane z tymi metrykami tworzą pierwszą linię obrony infrastruktury.

Regularna weryfikacja celów - Quarterly Hygiene Review: CO KWARTAŁ (kalendarzowe): 1) SLO Review: Czy SLO wciąż adekwatne? (baseline moved? business changed? tech changed?). 2) Targets Audit: Czy WSZYSTKIE targety scrapowane? (`up` = 1). Czy nowe serwisy dodane? Czy usunięte? 3) Alerts Audit: Czy alerty fire'ują poprawnie? (fire drill). Czy fałszywe alarmy? (tune thresholds). Czy runbook_url aktualne? 4) Dashboards Audit: Czy dashboards odzwierciedlają obecną architekturę? Czy panele nie pokazują "No Data"? 5) Recording Rules Audit: Czy heavy queries pre-agregowane? Czy niepotrzebne? Hygiene = nie "czysto", ale "FUNKCJONALNE". Zapomniany target = blind spot. Zły alert = alert fatigue. Stary dashboard = mylne decyzje.

Czyszczenie przestarzałych metryk - Cardinality & Cost Control: `prometheus_tsdb_head_series` HIGH (np. > 500k per Prometheus) = sygnał do czyszczenia danych; akcje: 1) Drop unused metrics: `metric_relabel_configs: - action: drop; source_labels: [__name__]; regex: 'unused_metric_.*'` (usuń metryki, których nikt nie query'uje - Grafana Explore / Prometheus API `series` sprawdza usage). 2) Reduce scrape frequency: mniej krytyczne joby 15s → 30s/60s (mniej próbek = mniej serii w czasie). 3) Drop high-cardinality labels: `metric_relabel_configs: - action: labeldrop; regex: 'user_id|request_id'`. 4) Consolidate: wiele podobnych metryk → jedna z labeliem (np. `http_requests_total{handler}` zamiast `http_requests_api_users_total`, `http_requests_api_orders_total`). COST CONTROL + PERFORMANCE: mniej serii = szybsze query, mniej RAM, mniejszy dysk, tańszy remote write.

Kontrola retencji - Capacity Planning dla Monitoring Infra: DYSK PEŁNY = PROMETHEUS CRASH (Head block nie może flushować, WAL rośnie, OOM). ALERTY: `disk_free_percent < 10%` (warning), `< 5%` (critical) - na dysku TSDB (`--storage.tsdb.path`). egzekwowana polityka retencji: `--storage.tsdb.retention.time=15d` (domyślne) LUB `--storage.tsdb.retention.size=50GB` (first limit wins). REMOTE WRITE DO LONG-TERM: Thanos/Cortex/Mimir/S3 - Prometheus trzyma 15d (hot), reszta w S3 (cold). CAPACITY PLANNING: szacuj `ingestion_rate * 1.3 bytes/sample * retention_days`. Przykład: 200k samples/sec * 1.3B * 15d = 336 GB. Planuj dysk + 30% headroom. Monitoring infra = infrastructure too.

Terminologia: monitoring of monitoring (monitoring monitoringu / meta-monitoring), maintenance (utrzymanie), cardinality control (kontrola kardynalności), retention policy (polityka retencji), remote write (zdalne zapisywanie), self-monitoring (samomonitoring), meta-monitoring (meta-monitoring), hygiene (higiena operacyjna).

Kto pilnuje strażnika? Prometheus sam potrzebuje utrzymania i sam siebie monitoruje. W zadaniu „prometheus" sprawdzamy, czy działa, obserwujemy liczbę aktywnych serii w bloku głównym jako wskaźnik kardynalności oraz zmierzymy czas ewaluacji reguł - gdy przekracza dziesięć sekund, wolne zapytania blokują pozostałe. Gdy Prometheus pada, jesteśmy ślepi, dlatego te metryki to pierwsza linia obrony całego monitoringu.

Równie ważna jest higiena w cyklu kwartalnym: weryfikujemy, czy cele wciąż odpowiadają na skrapowanie, czy alerty faktycznie się wyzwalają i czy pulpity pokazują obecną architekturę. Utrzymujemy też koszty - usuwamy nieużywane serie, rzadziej skrapujemy mniej krytyczne usługi i zrzucamy etykiety wysokiej kardynalności. Wreszcie pilnujemy retencji: pełny dysk oznacza awarię serwera, więc alert na wolne miejsce jest obowiązkowy, a dane starsze niż piętnaście dni trafiają przez remote write do magazynu długoterminowego.

Wyjaśnienie skrótów użytych na slajdzie:
CI/CD – Continuous Integration / Continuous Delivery – ciągła integracja i ciągłe wdrażanie; Zautomatyzowany potok weryfikacji składni plików konfiguracyjnych i reguł alertowych przed wdrożeniem.
IaC – Infrastructure as Code – infrastruktura jako kod; Praktyka definiowania konfiguracji monitoringu w postaci deklaratywnych plików w repozytorium kodu.
Git – Git version control system – rozproszony system kontroli wersji; Narzędzie śledzenia zmian w plikach konfiguracyjnych prometheus.yml i regułach alertowych.
PR – Pull Request – propozycja włączenia zmian; Mechanizm peer review gwarantujący ocenę każdej nowej reguły alertowej przez innego inżyniera.
CR – Change Request – wniosek o zmianę; Formalny wniosek w metodykach zarządzania usługami rejestrujący planowaną rekonfigurację monitoringu.

45/55 Testowanie zmiany przez metryki
SLI a typ usługi: user-facing → dostępność + latencja; batch → poprawność + throughput; internal API → error rate + latency.

Wdrożenie jako eksperyment: baseline, rosnący canary i automatyczny rollback bez dyskusji.

  • Metryki jako barierka bezpieczeństwa (Quality Gate) – zautomatyzowane potoki CI/CD wstrzymują wdrożenie, jeśli testy wykażą degradację parametrów.
  • Porównanie wersji w testach kanarkowych – algorytm porównuje wskaźnik błędów wersji nowej z wersją stabilną, podejmując decyzję o promocji.
  • Testy obciążeniowe oparte na telemetrii – generowanie sztucznego ruchu pozwala wyznaczyć maksymalną wydajność systemu przed wdrożeniem produkcyjnym.
  • Weryfikacja założeń architektonicznych – metryki pozwalają inżynierom empirycznie potwierdzić korzyści z wprowadzenia nowej pamięci podręcznej (cache).
  • Eliminacja subiektywizmu przy odbiorze prac – spełnienie mierzalnych kryteriów SLO jest warunkiem koniecznym do formalnego zaakceptowania projektu.
Dobór SLI do usługi: Usługi dla użytkowników mierzy się dostępnością i latencją, zadania wsadowe - poprawnością i przepustowością, a wewnętrzne API - odsetkiem błędów i latencją.
porównanie bazowe

Data-driven deployment wykorzystuje metryki do decyzji wdrażanie, wycofywanie lub skalowanie zamiast "czucia", "nadziei" i "myślę, że zadziała". Baseline (referencja) + Canary (eksperyment) + automatyczna weryfikacja (PromQL) to Progressive Delivery; każde wdrożenie jest eksperymentem naukowym: hipoteza → eksperyment → pomiar → wniosek (proceed/rollback), czyli GitOps + Observability w praktyce.

Baseline (Wskaźniki Bazowe) - Statistical Reference Point: przed zmianą (deploy, config change, schema migration) zbierasz BASELINE: przebieg metryk z ostatnich 1h/24h (zależnie od traffic pattern). Co mierzyć: Latency distribution (p50, p95, p99, histogram buckets), Error rate (5xx rate, exception rate, business error rate), Throughput (RPS, concurrent requests), Resource usage (CPU%, Memory%, Disk I/O%, Network%). To statystyczny punkt odniesienia - nie "wczoraj o tej porze" (bo traffic pattern się zmienia), ale "ostatnie 24h z wykluczeniem anomalii". Narzędzia: PromQL (`avg_over_time`, `quantile_over_time`), Grafana (dashboard "Baseline Comparison"), recording rules pre-compute baseline metrics.

Canary / A-B Deployment - Progressive Delivery: Nowa wersja trafia na % RUCHU, nie 100% naraz. KROKI: 1% (smoke test, internal traffic) → 5% (early adopters) → 10% → 25% → 50% → 100%. Każdy krok: PORÓWNANIE metryk Canary vs Stable (baseline). statystycznie istotne różnice: t-test / Mann-Whitney na latency, proportion test na error rate. NARZĘDZIA: ArgoCD Rollouts / Flagger / Flux (GitOps operators) + Prometheus metrics = automated analysis. Istnieje `AnalysisTemplate` (ArgoCD) / `MetricTemplate` (Flagger) definiująca: metrics to compare, thresholds, interval, success condition. Canary = MAŁE RYZYKO (blast radius = % ruchu), SZYBKI FEEDBACK (metryki w minutach).

Wpływ na decyzje o wycofaniu - Automated Rollback: Reguła jest prosta i bezwzględna (zdefiniowana przed wdrożeniem): automatyczne wycofanie, jeśli: Canary error rate > baseline + margin (np. baseline 0.1% + margin 0.5% = 0.6%) LUB Canary latency p99 > SLO threshold (np. SLO p99 < 500ms, canary p99 = 800ms → ROLLBACK). Margin = tolerancja na szum statystyczny. ArgoCD/Flux + Prometheus = GitOps + Observability: `AnalysisRun` kończy się `Failed` → `Rollback` automatyczny. decyzja w pełni zautomatyzowana. On-call NIE DECYDUJE "czy cofnąć" - METRYKI DECYDUJĄ. To eliminuje: "poczekajmy chwilę", "może to sieć", "nowa wersja pewnie się ustabilizuje". Rollback w 2-5 min = ograniczony blast radius.

Terminologia: baseline (linia bazowa/wskaźniki referencyjne), canary release (wydanie kanarek), A/B testing (test A/B), automated rollback (automatyczne cofnięcie), progressive delivery (progresywne dostarczanie), feature flag (flaga funkcji), statistical significance (istotność statystyczna), progressive rollout (progresywne wdrażanie).

Metryki zamieniają wdrożenie z aktu wiary w eksperyment naukowy. Zanim cokolwiek wdrożymy, zapisujemy przebieg kluczowych metryk z ostatnich godzin jako baseline - punkt odniesienia z rozkładem opóźnień, odsetkiem błędów i liczbą żądań na sekundę. Nowa wersja trafia potem na coraz większą część ruchu: jeden procent, pięć, dziesięć i dalej, a na każdym etapie porównujemy metryki kanarka z stabilną wersją. To dostarczanie progresywne, w którym ryzyko jest proporcjonalne do udziału ruchu, a opinia o zmianie pojawia się w minutach.

Pełny potencjał daje automatyzacja decyzji o wycofaniu. Z góry definiujemy twardą regułę: gdy odsetek błędów kanarka przekroczy baseline o ustalony margines albo percentyl opóźnienia złamie próg SLO, operator wdrażania sam cofa wersję. Żadnych decyzji uznaniowych, żadnych „poczekajmy chwili" - metryki decydują, a wycofanie trwa minuty. Tak łączy się GitOps z obserwowalnością: deploy to zmierzony eksperyment, nie skok w przepaść.

Wyjaśnienie skrótów użytych na slajdzie:
Canary – Canary Deployment – wdrożenie kanarkowe; Strategia wdrażania nowej wersji oprogramowania na mały ułamek ruchu (np. 2%) w celu weryfikacji metryk.
Blue/Green – Blue/Green Deployment – wdrożenie błękitno-zielone; Technika wdrażania z dwoma identycznymi środowiskami produkcyjnymi eliminująca przestój usługi.
A/B – A/B Testing – testy A/B; Eksperyment polegający na porównaniu dwóch wariantów usługi pod kątem metryk biznesowych i technicznych.
CI/CD – Continuous Integration / Continuous Deployment – ciągła integracja i automatyczne wdrażanie; Środowisko realizujące automatyczny powrót (rollback) w przypadku naruszenia wskaźnika SLI w trakcie wdrożenia.
SLO – Service Level Objective – cel poziomu usług; Wskaźnik graniczny, którego degradacja w trakcie canary rollout powoduje natychmiastowe przerwanie wdrożenia.

46/55 Podsumowanie metryk i SLI/SLO
Powtórzenie: SLI = miara (good/total), SLO = cel na SLI, SLA = umowa z klientem (luźniejsza). Error budget = 1 − SLO.

Cały wykład w pięciu zdaniach: miara, ekosystem, fundament, kolejny krok i słownik.

  • Syntetyczne podsumowanie modułu – metryki stanowią fundament inżynierii niezawodności, umożliwiając obiektywny pomiar i automatyczną obronę systemów.
  • Znaczenie relacji SLI-SLO-SLA – właściwie skonstruowane cele jakościowe chronią stabilność techniczną i zabezpieczają interesy prawne przedsiębiorstwa.
  • Praktyczna przewaga podejścia SRE – zastąpienie intuicji twardymi danymi telemetrycznymi umożliwia bezpieczne skalowanie skomplikowanych aplikacji.
  • Kluczowe umiejętności warsztatowe – student potrafi zainstalować eksportery, skonfigurować serwer Prometheus oraz pisać podstawowe zapytania PromQL.
  • Przygotowanie do kolejnych etapów – zebrane metryki posłużą w następnym wykładzie jako źródło danych do budowy profesjonalnych dashboardów w Grafanie.
Złota zasada łańcucha: Najpierw mierzymy (SLI), potem ustalamy cel (SLO), na końcu składamy obietnicę klientowi (SLA); wewnętrzne SLO jest zawsze ściślejsze od SLA.
zebrane pojęcia

Synteza wykładu 2: z surowych metryk (counter, gauge, histogram) buduje się SLI (engineered metrics), Prometheus to kompletny ekosystem (nie tylko TSDB), fundamentem metryk systemowych jest USE method, a dalej czeka Grafana (wizualizacja = insight). To materiał do powtórki przed egzaminem, certyfikacją lub rozmową kwalifikacyjną.

Składanie metryk w SLI - Raw → Engineered: SLI nie jest surową metryką. SLI = ENGINEERED METRIC skonstruowana z counterów/histogramów: Availability SLI = `good/total` z counterów (`sum(rate(http_requests_total{status=~"2..|3.."}[5m])) / sum(rate(http_requests_total[5m]))`). Latency SLI = `requests < threshold / total` z histogramu (`histogram_quantile(0.95, sum by (le) (rate(http_request_duration_seconds_bucket[5m])))`). Quality SLI = `valid_responses / total_responses` z business metrics (custom counters). KLUCZ: SLI = 0.0-1.0, agregowalne, alertowalne, raportowalne. Raw metric = `http_requests_total` (trudne do zinterpretowania bez kontekstu). SLI = kontekst w liczbie.

Prometheus jako narzędzie - Ecosystem Completeness: Prometheus to nie tylko baza TSDB. To PEŁNY STACK: Pull Model (kontrola, service discovery, firewall friendly), TSDB (Head+Blocks, WAL, Gorilla compression, retention), PromQL (funkcjonalny język: rate, histogram_quantile, sum by, subqueries), Service Discovery (k8s, ec2, consul, file - auto-discovery), Exporters (node, blackbox, jmx, snmp, custom - 100+ gotowych), Alertmanager Integration (dedup, group, inhibit, silence, route), Federation/Thanos (sharding, HA, long-term, global query). ECOSYSTEM COMPLETENESS = nie musisz sklejać 5 narzędzi - masz jedno spójne narzędzie end-to-end.

Przykłady metryk systemowych - USE Method Foundation: CPU: `node_cpu_seconds_total{mode="idle|user|system|iowait"}` → utilization, saturation, errors. Memory: `node_memory_MemAvailable_bytes`, `MemTotal`, `SwapFree` → utilization, saturation. Disk: `node_filesystem_avail_bytes`, `node_disk_reads/writes_total` → utilization, saturation, errors. Network: `node_network_receive/transmit_bytes_total`, `errors`, `drops` → utilization, saturation, errors. Load: `node_load1/5/15` → saturation. TO WSZYSTKO Z `node_exporter`. USE METHOD PER RESOURCE = systematyczne podejście do capacity planning i alertingu. fundament dla wszystkich pulpitów nawigacyjnych (wykład 3).

Kolejny krok - Wizualizacja (Wykład 3) - Metrics → Insights: Metryki same w sobie to dane. WIZUALIZACJA = INSIGHTS (wnioski). Grafana: Dashboards (JSON, provisioning - dashboard-as-code), Panels (time series, stat, gauge, table, logs, trace - unified), Variables (dynamiczne filtry: `$job`, `$instance`, `$handler` - jeden dashboard dla wszystkich serwisów), Annotations (deploy markers, alerty, incydenty NA WYKRESIE), Explore (ad-hoc query, split view metrics+logs+traces), PromQL Editor (autocomplete, syntax highlight, explain). Dashboard-as-code = wersjonowane w Git, reviewowane w PR, deployowane przez CI/CD. Metrics → Insights = actionable intelligence.

Złóżmy cały wykład w jedną spójną historię. SLI to inżynierska miara, ułamek dobrych wyników przez wszystkie, mieszczący się w przedziale od zera do jednego - tak skonstruowana, że można ją agregować, porównywać i zgłaszać klientom. Prometheus to pełny ekosystem, nie tylko baza danych: model odpytywania, własne przechowywanie, język zapytań, wykrywanie usług, dziesiątki gotowych eksporterów i zintegrowany Alertmanager. Podstawą metryk systemowych jest metoda USE - wykorzystanie, nasycenie, błędy dla każdego zasobu.

Na takim fundamencie stoją wszystkie pulpity i procedury. Kolejnym krokiem jest wizualizacja: surowe metryki same w sobie są tylko danymi, a wykres w Grafanie zamienia je w czytelny wniosek. Zanim jednak przejdziemy dalej, warto utrwalić słownik: SLI jako miara, SLO jako cel na niej zbudowany, SLA jako umowa z klientem, error budget jako dopuszczalna liczba błędów wynikająca z celu. To język, którym mówi się z zespołem, klientem i w raportach.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Metodyka zapewnienia niezawodności usług oparta na twardych metrykach i inżynierii oprogramowania.
SLI – Service Level Indicator – wskaźnik poziomu usług; Matematycznie zdefiniowany stosunek liczby pomyślnych zdarzeń do wszystkich zarejestrowanych.
SLO – Service Level Objective – cel poziomu usług; Podstawowe kryterium akceptacji ryzyka i zarządzania cyklem życia produktu cyfrowego.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; Formalne zobowiązanie prawne wobec klientów zewnętrznych.
TSDB – Time Series Database – baza danych szeregów czasowych; Technologiczne serce systemu telemetrycznego gromadzące dane o stanie infrastruktury.

47/55 Praca własna: zadania (metryki)
Powtórzenie: observability 3 filary (metryki, logi, tracing), USE/RED/Golden Signals, PromQL, labelowanie, agregacja.

Zadania rosną jak monitoring: eksporter, cel, zapytania i eksploracja. Każde stoi na poprzednim.

  • Zadanie laboratoryjne: instalacja agenta – samodzielne wdrożenie Node Exportera na maszynie testowej i weryfikacja dostępności metryk przez przeglądarkę.
  • Konfiguracja pobierania danych w Prometheus – dodanie nowego zadania zbierającego do pliku prometheus.yml i zbadanie statusu w zakładce Targets.
  • Tworzenie pierwszych zapytań PromQL – praktyczne ćwiczenie obliczania procentowego zużycia procesora, wolnej pamięci oraz natężenia ruchu sieciowego.
  • Konstrukcja formuły wskaźnika dostępności – sformułowanie zapytania wyliczającego odsetek zapytań zakończonych sukcesem w zadanym przedziale czasowym.
  • Analiza wyników w konsoli webowej – wizualizacja przebiegu obciążenia w postaci wykresów liniowych i interpretacja zaobserwowanych trendów.
Golden Signals: Cztery złote sygnały monitoringu usług: latencja, ruch (traffic), błędy (errors) i nasycenie (saturation).
lista zadań

Zadania domowe (Hands-on Lab) budują kompetencje krokowo: od infrastruktury (node_exporter) przez konfigurację (prometheus.yml) do zapytania (PromQL) i wizualizacji (Grafana Explore). Zadania są sekwencyjne - nie ma PromQL bez targeta, nie ma targeta bez node_exportera - a wszystkie polecenia są zweryfikowane na testowym środowisku, co eliminuje "u mnie nie działa".

Konfiguracja node_exporter - Infrastructure as Code: 1) URUCHOMIENIE: VM (Linux) → `wget github.com/prometheus/node_exporter/releases/download/v1.7.0/node_exporter-1.7.0.linux-amd64.tar.gz` → `tar xzf` → `./node_exporter --web.listen-address=":9100"` LUB Container: `docker run -d -p 9100:9100 --pid=host --net=host -v /:/host:ro,rslave prom/node-exporter:v1.7.0`. 2) WERYFIKACJA: `curl localhost:9100/metrics` → widzisz `node_cpu_seconds_total`, `node_memory_MemAvailable_bytes`, itd. (setki linii). 3) SYSTEM SERVICE (produkcja): systemd unit `/etc/systemd/system/node_exporter.service` z `ExecStart`, `Restart=always`, `User=node_exporter`. To infrastruktura jako kod (IaC) - wersjonowana, powtarzalna, audytowalna.

Dodanie targetu - Prometheus Configuration: Edycja `prometheus.yml`: `scrape_configs: - job_name: 'node'; static_configs: - targets: ['localhost:9100', 'server2:9100']` LUB `file_sd_configs: - files: ['targets/node/*.yml']` (dynamiczne). RELOAD: `curl -X POST http://localhost:9090/-/reload` (wymaga `--web.enable-lifecycle`) LUB restart. WERYFIKACJA UI: `http://prom:9090/targets` → job `node` → State: UP (zielony), Labels: `instance`, `job`, Last Scrape: < 15s ago, Error: (puste). Jeśli DOWN → troubleshooting: `telnet target 9100`, firewall, logi node_exporter, logi Prometheus (scrape error).

Pierwsze zapytanie PromQL - Hands-on Query Building: 1) `up` → tabela: `up{instance="localhost:9100",job="node"} 1` (wszystkie targety żywe). 2) `rate(node_cpu_seconds_total[5m])` → RPS per CPU mode per instance (instant vector w Console, wykres w Graph). 3) `node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes * 100` → % dostępnej pamięci per instance (Gauge math). 4) Eksploracja: zmień `[5m]` na `[1h]`, dodaj `sum by (instance)`, dodaj `avg by (mode)`. To LABORATORIUM PromQL - uczysz się przez robienie, nie czytanie.

Obserwacja metryk - Grafana Explore (Visual Exploration): Otwórz Grafana → Explore → Data source: Prometheus. Zapytaj: `rate(node_cpu_seconds_total[5m])` → Time series panel. ZMIEŃ ZAKRES: 1h, 6h, 24h, 7d - obserwuj wzorce (dzienny cykl, deploy spikes). podziel według instancji: `by (instance)` / `without (mode)` - porównuj serwery. WYKRESY CPU/RAM/DISK/NET: osobne panele, shared time range. VISUAL EXPLORATION = rozpoznawanie wzorców (sezonowość, anomalie, trendy) BEZ alertów. To umiejętność: "patrzeć na wykres i widzieć problem".

Przygotowanie do Wykładu 3 - Fundament Dashboard Design: Zrozumienie METRYK (co to counter, gauge, histogram, jakie labeli, jakie wartości) → BUDOWA DASHBOARDÓW (wykład 3: panel types, variables, annotations, PromQL editor). Zadania to FUNDAMENT: nie możesz zaprojektować dobrego panelu "CPU Usage" nie znając `node_cpu_seconds_total` i `rate()`. Hands-on learning path: Lab 1 (node_exporter) → Lab 2 (PromQL basics) → Lab 3 (Grafana dashboard) → Lab 4 (SLI/SLO dashboard). Każde lab buduje na poprzednim.

Zadania domowe budują kompetencje krok po kroku, a każde opiera się na poprzednim - bez działającego eksportera nie dodamy celu, a bez celu nie napiszemy pierwszego zapytania. Zaczynamy od uruchomienia node_exportera na maszynie wirtualnej albo w kontenerze, weryfikujemy odpowiedź na porcie 9100 i konfigurujemy usługę systemd z automatycznym restartem. Następnie dodajemy cel w prometheus.yml, przeładowujemy konfigurację i w zakładce Cele potwierdzamy, że status jest zielony.

Potem przychodzi czas na PromQL: patrzymy na metrykę up, obliczamy tempo zużycia procesora funkcją rate oraz procent dostępnej pamięci. Na koniec otwieramy Grafana Explore i eksplorujemy dane z różnych zakresów czasu, rozbijamy wyniki na instancje i szukamy wzorców. Każde polecenie jest zweryfikowane w środowisku testowym, więc nie tracicie czasu na poprawianie literówek - ćwiczycie samą koncepcję.

Wyjaśnienie skrótów użytych na slajdzie:
VM – Virtual Machine – maszyna wirtualna; Wirtualizowane środowisko komputerowe służące studentom jako platforma do instalacji Node Exportera.
LXC – Linux Containers – kontenery systemowe Linux; Lekka technologia wirtualizacji na poziomie jądra oferująca izolowane środowisko do ćwiczeń laboratoryjnych.
CLI – Command Line Interface – interfejs wiersza poleceń; Podstawowe środowisko pracy inżyniera SRE służące do uruchamiania usług i weryfikacji logów.
systemd – systemd system and service manager – menedżer systemu i usług w Linuksie; Standardowy proces nadrzędny PID 1 zarządzający demonami Node Exporter i Prometheus.
SSH – Secure Shell – bezpieczna powłoka zdalna; Kryptograficzny protokół wykorzystywany do łączenia się ze środowiskiem laboratoryjnym.

48/55 Narzędzia wspierające (wstęp do Grafana)
Korelacja metryk z logami - łączenie danych z Prometheus z Loki/ELK przez shared labels (job, instance, pod); Grafana ułatwia nawigację.

Grafana to więcej niż wykresy: pulpity jako kod, proxy do Prometheusa i adnotacje na zmianach.

  • Rola platformy analitycznej Grafana – dedykowany silnik wizualizacji pobiera metryki z serwera Prometheus i prezentuje je na interaktywnych dashboardach.
  • Architektura paneli telemetrycznych – każdy wykres opiera się na zapytaniu PromQL, dynamicznie odświeżając dane bez obciążania aplikacji produkcyjnych.
  • Współpraca wielu źródeł danych – nowoczesne pulpity nawigacyjne potrafią zestawiać metryki liczbowe z powiązanymi wpisami logów na jednym ekranie.
  • Znaczenie ergonomii wizualnej – przejrzysty układ paneli i logiczny dobór kolorów skraca czas diagnozy krytycznych awarii w zespole operacyjnym.
  • Oficjalne zasoby edukacyjne – student zapoznaje się z podstawami platformy Grafana w oficjalnym podręczniku dokumentacji technicznej producenta.
Shared labels: Wspólne etykiety (job, instance, pod) łączące metryki z Prometheusa z logami z Loki/ELK; Grafana ułatwia nawigację między nimi.
podgląd Grafana

Wizualizację wielowymiarowych szeregów czasowych realizuje platforma Grafana.

Grafana to nie "narzędzie do wykresów", lecz platforma obserwowalności: dashboards (JSON, provisioning), panel types (time series, stat, gauge, table, logs, traces, heatmap), variables (dynamiczne filtry - jeden dashboard dla 100 serwisów), annotations (zdarzenia na wykresie: deploy, alert, incydent), Explore (ad-hoc query) i Alerting v2 (własne alerty). Łączy Prometheus (metrics) + Loki (logs) + Tempo (traces) w unified observability stack - standard w ekosystemie CNCF/Grafana Labs.

Grafana do wykresów/pulpitów - Visualization Layer: Data Source: Prometheus (URL `http://prometheus:9090`, proxy mode - browser nie łączy się bezpośrednio z Prometheus, Grafana proxy = bezpieczeństwo, CORS, auth). Dashboards: JSON model (wersjonowany w Git, `dashboard-as-code`), Provisioning (automatyczny deploy z plików `/etc/grafana/provisioning/dashboards/` - zero klikania w UI). Panels: Time Series (wykresy liniowe/punkty, range, resolution, legend, thresholds, overrides), Stat (single value: current CPU%, error budget remaining), Gauge (wskaźnik kołowy: disk usage%), Table (tabela: top 10 endpoints by latency), Logs (Loki logs obok metryk), Traces (Tempo trace waterfall), Heatmap (histogram buckets jako kolory). Variables: `$job`, `$instance`, `$handler` - jeden pulpit dla wszystkich serwisów (wybierz z dropdown). Annotations: Deploy markers (ArgoCD webhook → Grafana API), Alert markers (Alertmanager webhook), Incident markers (manual). To PRODUKCYJNE DASHBOARDY, nie "ładne obrazki".

Łączenie z Prometheus - Data Source Setup: Add Data Source → Type: Prometheus → URL: `http://prometheus:9090` (internal DNS / service name) → Access: `Proxy` (default, Grafana server proxyuje zapytania - bezpieczeństwo, auth, CORS) LUB `Direct` (browser → Prometheus - wymaga CORS, niezalecane). Auth: `Basic Auth` / `OAuth` / `Forward OAuth Identity` (SSO). TLS: `Skip TLS Verify` (dev) / `TLS Client Auth` (prod z mTLS). Save & Test → Green "Data source is working" (Grafana query `instant` `up` do Prometheus). To 2-minuty setup, ale fundament WSZYSTKICH dashboardów.

Wykresy czasowe - Time Series Panel Deep Dive: Range: `1h`, `6h`, `24h`, `7d`, `30d`, `custom` (time picker). Resolution: auto (Grafana liczy step = range / width_px) LUB fixed (`Step: 15s`). Legend: `As table` / `To right` / `Hidden`, `Values` (min/max/avg/current), `Sort by`. Thresholds: linie poziome (SLO line: `500ms` p99, `80%` CPU), kolory (green/yellow/red). Overrides: per-series config (kolor, line width, fill opacity, y-axis unit) na podstawie label matchers. Transformations: `Rename by regex` (skróć nazwy serii), `Filter by query` (usuń serie), `Calculate` (math: `/ 1024 / 1024` bytes→MB), `Organize fields` (ukryj kolumny). bogate opcje wizualizacji = dashboard czyta się sam.

Szczegóły w Wykładzie 3 - Full Grafana Deep Dive: Instalacja (binary, Docker, Helm, Grafana Cloud), Data Sources (Prometheus, Loki, Tempo, PostgreSQL, InfluxDB, CloudWatch), Panel Types (wszystkie 15+ typów), PromQL Editor (autocomplete, syntax highlight, explain, format), Variables (query variables, chained variables, text box), Dashboard Design (layout, UX, color theory, cognitive load), Best Practices (dashboard-as-code, provisioning, templating, versioning, review w PR). To osobny, pełny wykład - tutaj tylko "co jest" i "dlaczego warto".

Terminologia: dashboard (pulpit), visualization (wizualizacja), data source (źródło danych), panel (panel), time series (seria czasowa), variable (zmienna/filtr dynamiczny), annotation (adnotacja/znacznik na wykresie), provisioning (aprowizacja/automatyczny deploy), proxy mode (tryb proxy Grafana).

Grafana to coś więcej niż narzędzie do rysowania wykresów - to platforma obserwowalności, która łączy metryki, logi i trace'y w jednym miejscu. Pulpity definiujemy jako JSON i wersjonujemy w repozytorium, co pozwala wdrażać je tak samo jak kod. Panele mają wiele rodzajów: seria czasowa, pojedyncza wartość, wskaźnik kołowy, tabela, a także logi i trace'y. Zmienne w nagłówku pulpitu, takie jak usługa czy instancja, robią z jednego pulpitu szablon dla setek serwisów, a adnotacje nanoszą na wykres momenty wdrożeń i incydentów.

Połączenie z Prometheusem to dodanie źródła danych z adresem na porcie 9090 w trybie proxy - wtedy przeglądarka nigdy nie łączy się z Prometheusem bezpośrednio, a autoryzację przejmuje Grafana. Przycisk Save & Test potwierdza połączenie zielonym komunikatem. Na wykresie ustawiamy zakres, rozdzielczość i legendy, dodajemy linie progowe i style dla poszczególnych serii - wtedy pulpit czyta się sam, a stan usługi widać w kilka sekund. Pełne możliwości, od instalacji po projektowanie, poznamy w wykładzie 3.

Wyjaśnienie skrótów użytych na slajdzie:
OSS – Open Source Software – oprogramowanie o otwartym kodzie źródłowym; Model udostępniania oprogramowania umożliwiający bezpłatną modyfikację i dystrybucję kodu.
GUI – Graphical User Interface – graficzny interfejs użytkownika; Wielopanelowy interfejs Grafany prezentujący metryki w postaci czytelnych wykresów i wskaźników.
SQL – Structured Query Language – strukturalny język zapytań; Język obsługiwany przez platformę Grafana jako jedno z wielu alternatywnych źródeł danych.
PromQL – Prometheus Query Language – język zapytań Prometheus; Podstawowy język zapytań definiujący serie czasowe w panelach analitycznych Grafany.
API – Application Programming Interface – interfejs programistyczny; Interfejs REST platformy Grafana umożliwiający wersjonowanie i wgrywanie dashboardów jako kod (Dashboard-as-Code).
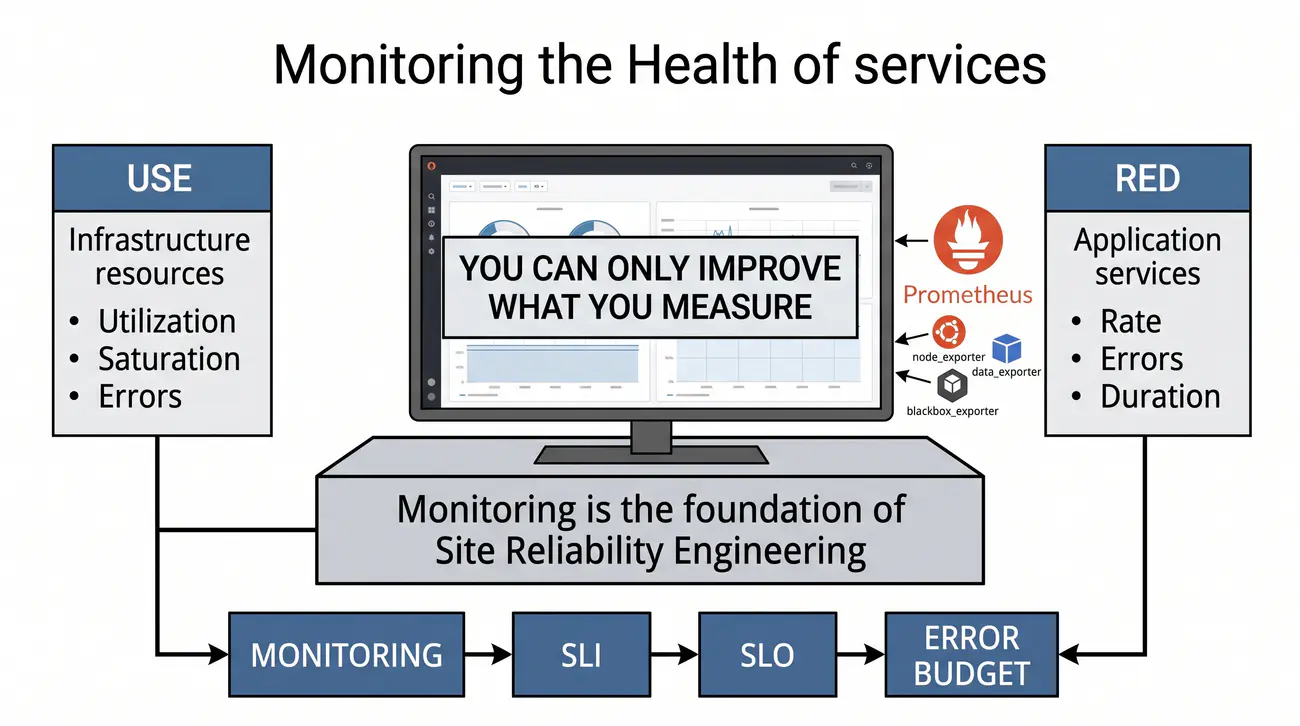
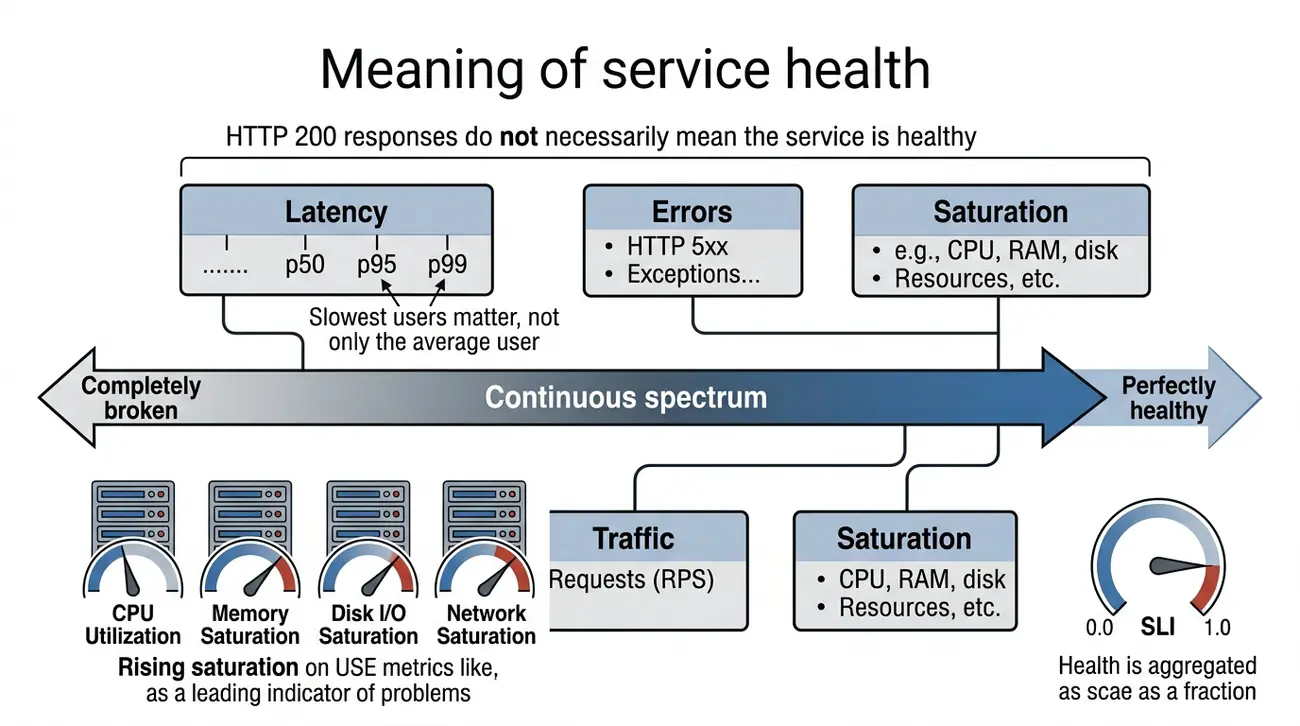
49/55 Obciążenie i wydajność usług
Dobór interwału scrapowania: 1 min (domyślny w Prometheus); w praktyce 15s dla większości usług, krótszy dla krytycznych (5s), dłuższy dla kosztownych (60s). Balans: precyzja vs obciążenie.

Latencja, zasoby i błędy to zespół decyzyjny - czytaj je razem, bo napędzają się nawzajem.

  • Rozróżnienie obciążenia i wydajności – obciążenie określa liczbę żądań docierających do systemu, a wydajność zdolność infrastruktury do ich sprawnej obsługi.
  • Punkt nasycenia systemu (Saturation) – moment, w którym zasoby sprzętowe ulegają wyczerpaniu, wywołując gwałtowny wzrost czasu oczekiwania w kolejkach.
  • Zjawisko degradacji pod obciążeniem – po przekroczeniu progu nasycenia wydajność serwisu drastycznie spada, prowadząc do masowego zrywania połączeń.
  • Planowanie pojemności (Capacity Planning) – ekstrapolacja trendów z metryk pozwala inżynierom przewidzieć termin koniecznej rozbudowy klastra.
  • Techniki ochrony przed przeciążeniem – automatyczne odrzucanie nadmiarowego ruchu (load shedding) ratuje bazę danych przed całkowitym paraliżem.
Kompromis interwału: Krótszy interwał szybciej wykrywa zmiany, lecz bardziej obciąża sieć i bazę; w praktyce 15 s dla większości usług, 5 s dla krytycznych, 60 s dla kosztownych.
metryki wydajności

Latency, utilization i error rate to zespół decyzyjny, a nie osobne wykresy: Latency = UX/SLO, Utilization/Saturation = Capacity/Headroom, Error Rate = Quality/SLI. Razem zamykają pętlę Metryki → SLI → SLO Compliance → Error Budget → Operational Decisions (deploy/freeze/scale) - closed loop observability.

Latency (Czas Odpowiedzi) - User Experience & SLO Target: p50/p95/p99 - p50 = typowy user (ale ukrywa ogon opóźnień), p95 = standard SLA (95% userów), p99 = tail latency (1% najgorszych = krytyczne dla UX). Mierzony przez `histogram_quantile` z bucketów (`http_request_duration_seconds_bucket`). największe znaczenie ma latencja w ogonie rozkładu (p99): 1% userów z 10s latency = 10x więcej support ticketów niż 99% z 100ms. SLO na p95/p99 WYMUSZA inżynierię ogona (connection pooling, async, timeouts, circuit breakers, caching). Latency to NAJWAŻNIEJSZE SLI dla user-facing services.

Wykorzystanie Zasobów - USE Method & Capacity Planning: CPU%, Memory%, Disk I/O%, Network% - to UTILIZATION (użycie). SATURATION (nasycenie) = Queue length (run queue, thread pool queue, connection pool queue), Thread pool exhaustion (Tomcat maxThreads, HikariCP maxPoolSize), Connection pool saturation (used/max). TO PROWADNIKI (leading indicators): saturation rośnie przed skokiem opóźnień i przed skokiem stopy błędów. sygnały planowania pojemności zasobów: trend utilization (rosnący = planuj scale), headroom (ile % do limitu = ile czasu do scale), bottleneck identification (CPU-bound vs Memory-bound vs I/O-bound vs Network-bound). USE METHOD PER RESOURCE = systematyczne podejście.
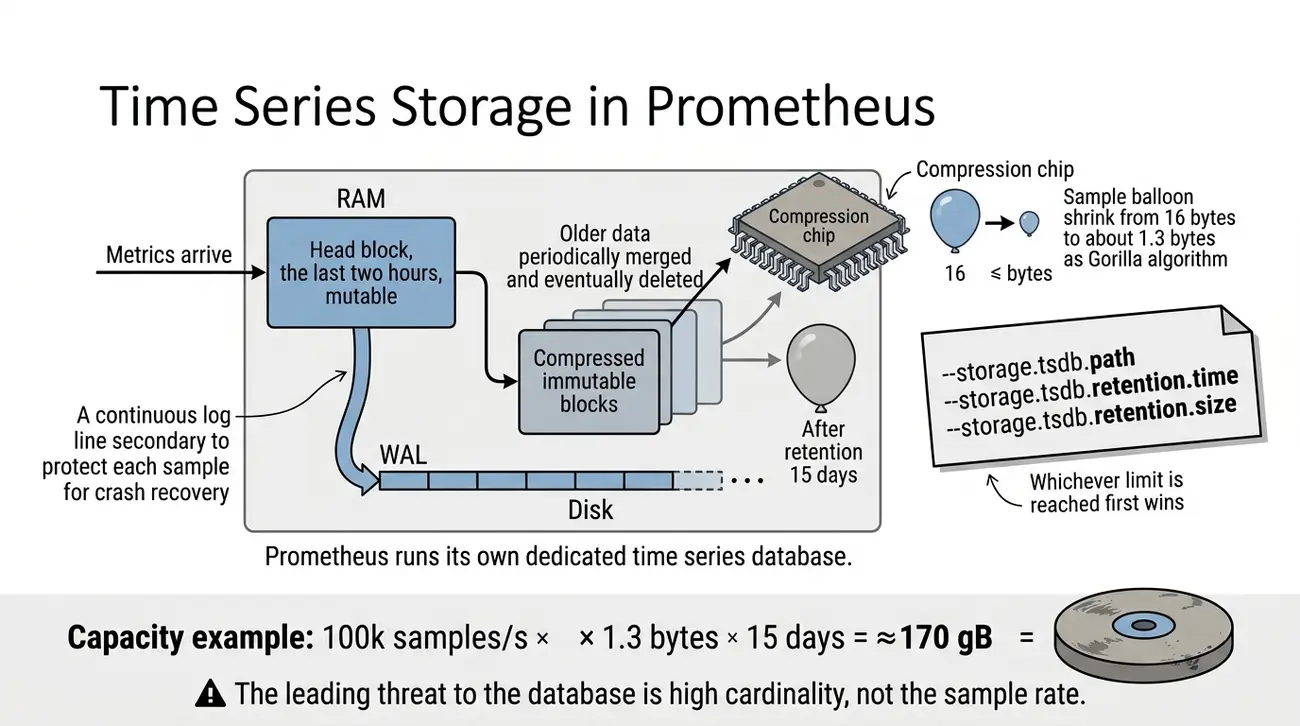
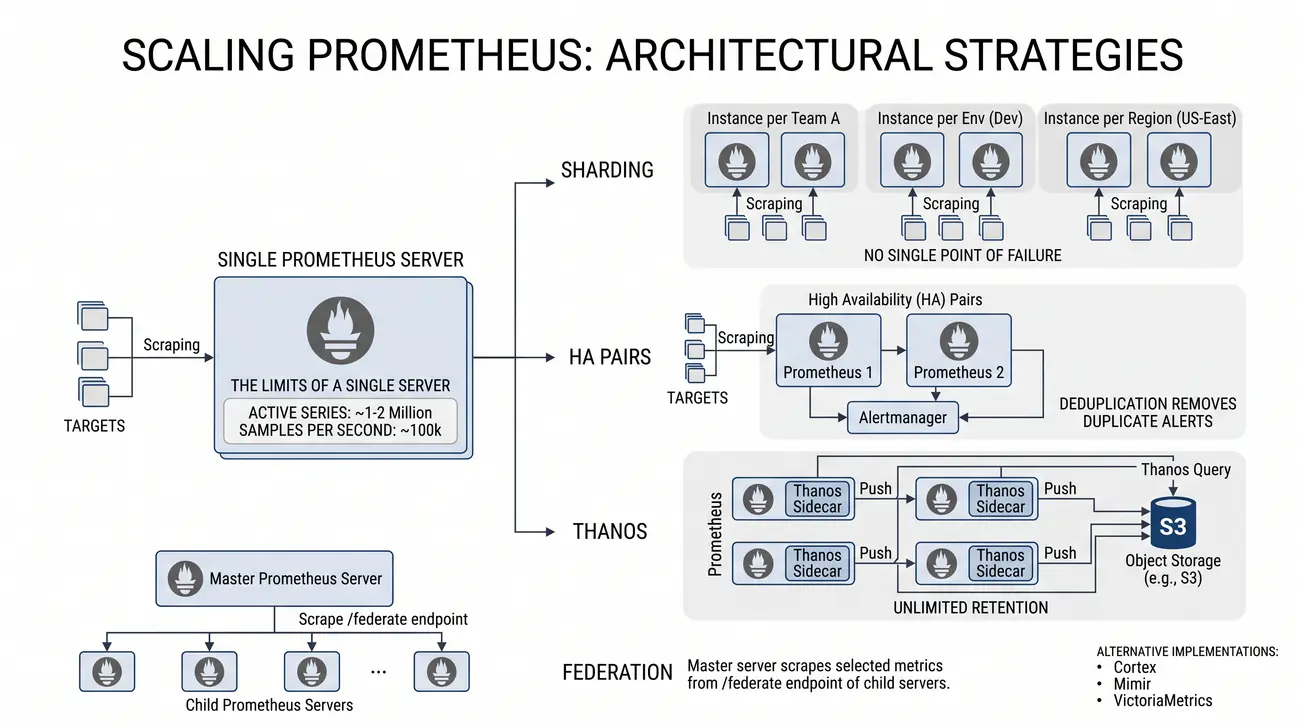
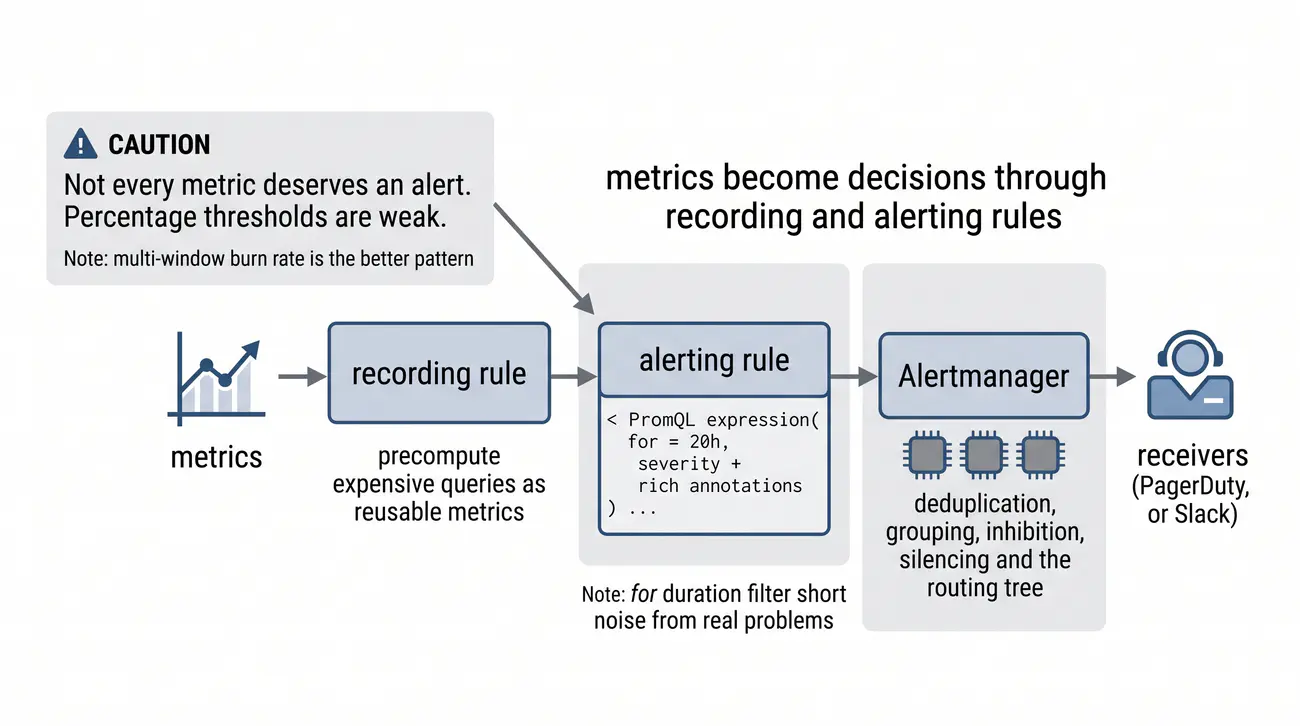
Error Rate - Quality SLI & RED Method Completeness: 5xx rate (server errors), exception rate (application exceptions), business error rate (payment declined, validation failed) - to QUALITY SLI (jak Good/Total). KORELACJA Z LATENCJĄ: Errors often cause RETRIES (klient ponawia) → Retry storm → Latency↑ → More timeouts → More errors (CAUSAL LOOP). RED METHOD COMPLETENESS: Rate (throughput) + Errors (quality) + Duration (latency) = pełny obraz stanu usługi. Brak któregoś = luka w observability. Error rate to EARLY WARNING (leading indicator) - często rośnie przed pełną awarią.

Interpretacja w Kontekście SLO - Closed Loop Observability: Potok decyzyjny przetwarza surowe metryki w syntetyczne wskaźniki SLI (dostępność, opóźnienie, poprawność), ocenia spełnienie celów SLO, a następnie wylicza stan budżetu błędów (error budget). Na tej podstawie podejmowane są decyzje operacyjne: dodatni budżet zezwala na dalsze wdrożenia produkcyjne, spadek poniżej poziomu ostrzegawczego wymusza zamrożenie zmian niekrytycznych i skupienie się na stabilności, natomiast wyczerpanie budżetu uruchamia blokadę wydań (release freeze) i wymaga przeprowadzenia analizy post-mortem. To klasyczny obieg zamknięty: metryki kierują decyzjami, działania inżynierskie stabilizują architekturę, a system generuje nowe dane pomiarowe. Obserwowalność nie jest jedynie zwykłym monitoringiem, lecz aktywnym systemem sterowania niezawodnością.

Terminologia: throughput (przepustowość), capacity (pojemność), utilization (wykorzystanie), saturation (nasycenie), RED method (Rate, Errors, Duration), USE method (Utilization, Saturation, Errors), bottleneck (wąskie gardło), headroom (zapas/margines), closed loop (zamknięta pętla sterowania).

Latencja, wykorzystanie zasobów i odsetek błędów to nie osobne wykresy, lecz zespół decyzyjny. Latencja opisuje doświadczenie użytkownika i stanowi cel SLO; percentyle p95 i p99, a nie mediana, są jego właściwą miarą. Wykorzystanie zasobów i nasycenie mówią o zapasie pojemności - a nasycenie jest wskaźnikiem wiodącym: kolejki i pule wypełniają się, zanim opóźnienie czy błędy skoczą. Odsetek błędów to z kolei wskaźnik jakościowy i wczesne ostrzeżenie, bo błędy zwykle poprzedzają pełną awarię.

Co istotne, te trzy miary łączą się w pętlę przyczynową: błędy wywołują ponowienia ze strony klientów, ponowienia zwiększają obciążenie i opóźnienie, a to z kolei rodzi kolejne błędy. Dlatego interpretujemy je zawsze razem, w kontekście celu SLO. Pętla zamyka się na decyzjach: metryki dają wskaźnik SLO, porównanie z celem pokazuje zgodność, z niej wynika pozostały budżet błędu, a budżet kieruje działaniami - od wdrożeń po wstrzymanie wydań. Tak obserwowalność staje się systemem sterowania niezawodnością.

Wyjaśnienie skrótów użytych na slajdzie:
QPS – Queries Per Second – liczba zapytań na sekundę; Miara chwilowego natężenia ruchu kierowanego do baz danych i serwisów backendowych.
RPS – Requests Per Second – liczba żądań na sekundę; Częstotliwość zapytań HTTP/HTTPS przetwarzanych przez serwery brzegowe i load balancery.
IOPS – Input/Output Operations Per Second – liczba operacji wejścia/wyjścia na sekundę; Wskaźnik obciążenia dyskowego decydujący o wystąpieniu wąskiego gardła podsystemu pamięci.
RTT – Round Trip Time – czas obiegu pakietu w sieci; Opóźnienie sieciowe wpływające bezpośrednio na ogólny czas oczekiwania klienta na odpowiedź.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie usług; Kontrakt biznesowy, którego marginesy czasowe są zagrożone w stanach wysokiego nasycenia zasobów.

50/55 Kiedy monitoring zawodzi
Zadania domowe: uruchom Prometheus, skonfiguruj node_exporter, eksploruj metryki w /targets i /graph, ćwicz PromQL.

Monitoring ma ślepe punkty; dojrzałość to je znać: jeden obserwator, opóźniony czas i brakujący kontekst.

  • Zjawisko ślepoty monitoringu – awaria sieci zarządzającej może odciąć serwer Prometheus, wywołując fałszywe wrażenie całkowitego spokoju na produkcji.
  • Awaria eksportera danych – zawieszenie procesu agenta telemetrycznego powoduje zamrożenie ostatnich wartości na wykresach, maskując rzeczywistą awarię.
  • Niebezpieczeństwo błędnych założeń – monitorowanie niewłaściwych parametrów (np. zużycia CPU zamiast błędów biznesowych) usypia czujność inżynierów.
  • Zależność monitoringu od infrastruktury – umieszczenie serwera Prometheus w tym samym klastrze co aplikacja grozi utratą widoczności podczas awarii klastra.
  • Zasada podwójnej weryfikacji – kluczowe usługi powinny być równolegle monitorowane wewnętrznie (Whitebox) oraz sondowane zewnętrznie (Blackbox).
Ślepy punkt monitoringu: Sytuacja, w której pojedynczy punkt obserwacji nie odróżnia awarii usługi od awarii sieci; rozwiązaniem są sondy z wielu lokalizacji.
luki monitoringu

"Blind spots" monitoringu to sytuacje, gdy metryki (Prometheus) nie widzą problemu, widzą go z opóźnieniem albo widzą "CO", ale nie "DLACZEGO" - to nie wady Prometheus, lecz fundamentalne ograniczenia modelu pull-based metrics. Dojrzałość SRE to znanie tych luk i budowanie warstw obrony (blackbox, logs, traces); to most do wykładu 4 (Logs/Loki) i 5 (Tracing).

Brak danych przy awarii sieci - Scrape Failure ≠ Service Down: Prometheus scrape timeout/failure → `up=0` (target DOWN). Pojawia się jednak pytanie: czy to usługa uległa awarii, czy zawiodła sieć łącząca serwer Prometheus z celem? Pojedynczy punkt obserwacji staje się wtedy pojedynczym punktem awarii samego monitoringu. Rozwiązaniem jest uruchomienie Blackbox Exportera w niezależnych lokalizacjach (różne sieci, regiony chmurowe lub środowiska on-premise) i badanie `probe_success` z wielu perspektyw jednocześnie. Mechanizm kworum (np. potwierdzenie dostępności przez 2 z 3 sond) skutecznie eliminuje fałszywe alarmy wywołane lokalnymi zakłóceniami w łączności.

Opóźnienia w zbieraniu - Collection Delay = MTTA Component: Scrape interval 30s = wykrycie awarii po 30-60s (najgorszy scenariusz: awaria tuż po scrape). Evaluation interval rules (domyślnie 30s) + `for:` duration (np. `for: 2m`) = DODATKOWE 2-4 min opóźnienia alertu. MTTA (Mean Time To Acknowledge) ZAWIERA collection delay. dla usług o znaczeniu krytycznym: scrape_interval 10s, evaluation_interval 10s, `for: 30s` → detection < 1 min. Trade-off: częstsze scrape = więcej próbek = więcej RAM/dysk/CPU. To INŻYNIERSKA DECYZJA: jaki MTTA akceptujemy per usługa (TIER 1 vs TIER 3).

Potrzeba Logów i Tracingu - Observability Pillars = Complete Picture: Metryki mówią „co” (latency↑, error rate↑, CPU↑). Logi mówią „dlaczego” (stack trace: `NullPointerException at OrderService.java:42`, `ERROR connection pool exhausted`, `WARN slow query > 5s`). TRACING mówią "GDZIE" (span w Service B: `GET /api/orders` → `DB query SELECT * FROM orders` → 95% czasu). RAZEM = pełny obraz przebiegu incydentu w sekundy. Same metryki oznaczają, że ślepy strzał (widzimy problem, nie wiemy root cause). Same logi oznaczają, że igła w stogu siana (bez metryk nie wiesz KIEDY szukać). Samo śledzenie oznacza, że fragment bez kontekstu. CORRELATION (korelacja metrics+logs+traces przez request_id/trace_id) = izolacja przyczyny źródłowej. To NEXT LEVEL OF OBSERVABILITY.

Wprowadzenie do Wykładu 4 - Logi (Loki/ELK), LogQL, Korelacja: Wykład 4 = Logi Deep Dive: Loki (Grafana Labs, log aggregation, LogQL - PromQL-inspired query language), ELK/EFK (Elasticsearch, Logstash/Fluentd/Fluent Bit, Kibana - enterprise standard). LOGQL: `{job="api"} |= "ERROR" | json | line_format "{{.message}}"` (filtruj, parsuj, formatuj). KORELACJA METRICS+LOGS: Grafana Explore split view (metrics panel + logs panel, shared time range, link by `trace_id`/`request_id`). diagnoza przyczyny źródłowej (Root Cause): Metryka `p99_latency↑` → klik "Logs for this trace" → `ERROR connection pool exhausted` → root cause w 30s. To workflow, którego nie da się zrobić samymi metrykami.

Terminologia: monitoring gaps (luki w monitoringu), blind spots (punkty ślepe), scrape timeout (timeout scrapowania), evaluation delay (opóźnienie ewaluacji), observability pillars (filary obserwowalności), correlation (korelacja), root cause analysis (analiza przyczyny głównej), multi-vantage (wielopunktowe monitorowanie).

Monitoring ma swoje ślepe punkty, i dojrzałość polega na ich znajomości. Gdy skrapowanie zawodzi i metryka up spada do zera, nie wiemy, czy awarii uległa usługa, czy sieć łącząca system monitoringu z celem – pojedynczy punkt obserwacji to pojedynczy punkt awarii dla samej obserwowalności. Rozwiązaniem są sondy z wielu lokalizacji: jeśli z trzech regionów dwie widzą usługę żywą, problem leży po stronie monitoringu. Drugie ograniczenie to czas: odstęp skrapowania i czas utrzymania warunku w regule przesuwają wykrycie awarii na później, więc dla usług krytycznych skracamy oba parametry kosztem większego obciążenia.

Trzeci ślepy punkt dotyczy samych rodzajów danych. Metryki mówią „co": opóźnienie rośnie, błędy rosną. Logi mówią „dlaczego": stos wyjątków, wyczerpana pula połączeń. Trace'y mówią „gdzie": w którym serwisie i na którym wywołaniu ucieka czas. Dopiero korelacja wszystkich trzech daje pełny obraz incydentu w sekundy. To wprost prowadzi do wykładu czwartego, poświęconego logom - ich agregacji w Loki albo ELK, językowi zapytań LogQL i łączeniu z metrykami o jeden klik.

Wyjaśnienie skrótów użytych na slajdzie:
SPOF – Single Point of Failure – pojedynczy punkt awarii; Element architektury, którego uszkodzenie powoduje całkowite załamanie działania całego systemu.
BGP – Border Gateway Protocol – protokół bramy granicznej; Protokół trasowania; jego błędna konfiguracja może odciąć serwer monitoringu od nadzorowanej sieci.
WAN – Wide Area Network – rozległa sieć komputerowa; Łącze telekomunikacyjne łączące odległe centra danych, podlegające ryzyku zerwania i degradacji pasma.
MTU – Maximum Transmission Unit – maksymalna jednostka transmisji; Niezgodność MTU na trasie pakietu powoduje ciche odrzucanie ramek z flagą Don't Fragment (DF).
ICMP – Internet Control Message Protocol – protokół komunikatów sieciowych; Protokół diagnostyczny, którego blokowanie na zaporach sieciowych uniemożliwia czarnoskrzynkowe badanie osiągalności.

51/55 Bezpieczeństwo danych telemetrycznych
Praktyka: zainstaluj Prometheus + node_exporter, napisz 3 zapytania PromQL, utwórz 1 dashboard w Grafana, zdefiniuj 1 alert.

Telemetria to dane osobowe: IP, ID użytkowników, tokeny. Chroń ją prawnie i technicznie - to wymóg, nie estetyka.

  • Ryzyko ujawnienia danych wrażliwych – metryki i etykiety nie mogą zawierać danych osobowych (PII), takich jak adresy e-mail, hasła czy numery PESEL.
  • Zgodność z przepisami prawa i RODO – telemetria podlega rygorystycznym regulacjom ochrony danych osobowych, wymagając kontroli wglądu i audytu dostępu.
  • Szyfrowanie transmisji telemetrycznej – przesyłanie próbek metryk przez niezaufane segmenty sieci lokalnej wymaga wymuszenia protokołu TLS.
  • Kontrola dostępu do bazy metryk – uprawnienia do modyfikowania konfiguracji i przeglądania danych telemetrycznych reguluje się mechanizmem RBAC.
  • Nadzór organów państwowych – praktyki bezpieczeństwa systemów teleinformatycznych podlegają wytycznym Urzędu Ochrony Danych Osobowych.
Bezpieczeństwo telemetrii: Metryki i logi mogą zawierać dane osobowe, więc dostęp ogranicza się logowaniem (OAuth/LDAP), rolami i szyfrowaniem (HTTPS, mTLS).
ochrona danych

Punkty telemetryczne /metrics oraz interfejs bazy Prometheus muszą podlegać rygorystycznym zasadom bezpieczeństwa. Zgodnie z wytycznymi Urzędu Ochrony Danych Osobowych oraz rozporządzeniem RODO, surowe adresy IP użytkowników i dane osobowe nie mogą trafiać do etykiet metryk. Dostęp do endpointów scrapingowych musi być chroniony przez wzajemne uwierzytelnianie TLS (mTLS), sieć zarządzającą oraz kontrolę dostępu opartą na rolach (RBAC).

Prometheus, Grafana, Alertmanager, Loki i Tempo to narzędzia przystępujące do metryk, logów i trace'ów, które mogą zawierać PII (IP, user IDs, session IDs, authorization tokens, business data). Bezpieczeństwo telemetrii to wymóg prawny (GDPR, RODO), etyczny (K02: poufność, odpowiedzialność) i operacyjny (security hardening).

Ograniczenie Dostępu - Auth + RBAC + Network Policies: PROMETHEUS/GRAFANA UI: Auth: OAuth (GitHub, GitLab, Google, Azure AD, Keycloak - SSO), LDAP (corporate directory), Basic Auth (proste, dla małych), Proxy Auth (nginx/oauth2-proxy przed Grafana). RBAC (Grafana): Viewer (read-only dashboards), Editor (create/edit dashboards), Admin (manage users, datasources, settings) - PER FOLDER/DATASOURCE (folder permissions, datasource permissions). Network Policies: Kubernetes NetworkPolicy / Security Groups / Firewall: ruch przychodzący (ingress) dozwolony jest wyłącznie z podsieci zarządzającej, bastionu lub tunelu VPN. Sieć powinna działać w modelu Zero Trust: nie ufać fizycznej topologii, lecz weryfikować tożsamość kryptograficznie (mTLS, SPIFFE/SPIRE). Dostęp opiera się na zasadzie najniższych uprawnień (least privilege).

Szyfrowanie Transmisji - TLS Everywhere (Encryption in Transit): PROMETHEUS UI: `--web.config.file` z TLS cert/key → HTTPS na 9090. GRAFANA UI: `server.cert_file`, `server.cert_key` → HTTPS na 3000. SCRAPE ENDPOINTS (target → Prometheus): mTLS (mutual TLS) - target i Prometheus mają certyfikaty, weryfikują się nawzajem (`tls_config` w `scrape_configs`). REMOTE WRITE (Prometheus → Thanos/Cortex/Mimir/S3): TLS + Basic Auth / Bearer Token (`remote_write: basic_auth`, `tls_config`). CERT-MANAGER (Kubernetes): automatyczne wystawianie/odnawianie certyfikatów (Let's Encrypt / internal CA) → `Certificate` resource → Secret → mounted w podach. ENCRYPTION IN TRANSIT = default, nie opcja.

Kontrola Ról - Least Privilege Principle: GRAFANA RBAC: Datasource Permissions (który team widzi który datasource: team-a → prometheus-prod, team-b → prometheus-staging), Dashboard Permissions (folder-level: team-a folder = read/write, team-b = read-only), Folder Permissions (organizacja dashboardów per team/projekt). PROMETHEUS: Read-only API (`/api/v1/query`, `/api/v1/query_range`) vs Admin API (`/-/reload`, `/api/v1/admin/tsdb/delete_series`) - oddzielne credentials. SERVICE ACCOUNTS: Kubernetes RBAC dla Prometheus/Grafana pods (Role/ClusterRole: `get`, `list`, `watch` na `services`, `endpoints`, `pods` dla service discovery). Zasada najniższych uprawnień (least privilege): domyślnie brak uprawnień, z przyznawaniem wyłącznie uprawnień niezbędnych do realizacji zadań.

Nawiązanie do K02 - Etyka, Poufność, Odpowiedzialność: K02 (kompetencje społeczne) = Etyka zawodowa (nie podsłuchujesz logi userów), Poufność danych (telemetria może zawierać PII: IP w `client_ip` label, user_id w `user_id` label, session_id, email w logach) - Maskowanie i anonimizacja: haszowanie danych osobowych (PII) po stronie agenta logów - Promtail stage `hash` (SHA256, nieodwracalne) LUB `action: drop` w `relabel_configs` (usuń całkowicie). Uwaga: w `relabel_configs` Prometheusa nie istnieje `action: hash` - jest `action: hashmod` (wymaga parametru `modulus`, haszuje przez MD5), który służy do shardowania targetów i redukcji kardynalności, a NIE do maskowania danych osobowych. GDPR COMPLIANCE: Art. 25 (data protection by design) - instrumentacja BEZ PII od początku. Art. 32 (security of processing) - TLS, RBAC, encryption. Art. 33/34 (breach notification) - alerty na unauthorized access do telemetrii. Dane telemetryczne = dane osobowe potencjalnie - traktuj jak production DB.

Terminologia: RBAC (Role-Based Access Control), OAuth (Open Authorization), LDAP (Lightweight Directory Access Protocol), mTLS (mutual TLS), cert-manager (Kubernetes certificate controller), data privacy (prywatność danych), PII masking (maskowanie danych osobowych), GDPR compliance (zgodność z RODO), security hardening (utwardzanie bezpieczeństwa), least privilege (najmniejsze uprawnienia).

Metryki, logi i trace'e potrafią zawierać dane osobowe - adresy IP, identyfikatory użytkowników, tokeny autoryzacyjne - dlatego bezpieczeństwo telemetrii to wymóg prawny i etyczny, nie tylko techniczna estetyka. Zaczynamy od ograniczenia dostępu: pojedyncze logowanie przez OAuth albo katalog LDAP, kontrola ról przypisująca każdemu to minimum uprawnień i polityki sieciowe wpuszczające ruch tylko z zaufanych sieci. Szyfrowanie obejmuje interfejs webowy po HTTPS, wzajemne poświadczenia między celami a Prometheusem w modelu mTLS oraz bezpieczny kanał zdalnego zapisywania.

Do tego dochodzi odpowiedzialność za dane. Role muszą być świadome, który zespół widzi jakie źródło danych, a konta serwisowe nie mogą mieć praw, których nie potrzebują. Dane osobowe należy maskować lub anonimizować już na etapie instrumentacji - lepiej nie zbierać PII w ogóle, niż zbierać i szyfrować ją później. Takie podejście wpisuje się w etykę zawodu i wprost odwołuje się do zasad RODO, które każą projektować systemy z myślą o prywatności już od startu.

Wyjaśnienie skrótów użytych na slajdzie:
RBAC – Role-Based Access Control – kontrola dostępu oparta na rolach; Mechanizm zarządzania uprawnieniami przydzielający dostęp do pulpitów i danych na podstawie funkcji użytkownika.
LDAP – Lightweight Directory Access Protocol – lekki protokół dostępu do usług katalogowych; Protokół sieciowy używany do centralnego uwierzytelniania inżynierów w systemach telemetrii.
SSO – Single Sign-On – pojedyncze logowanie; Mechanizm uwierzytelniania umożliwiający dostęp do wielu narzędzi za pomocą jednego zestawu poświadczeń.
TLS – Transport Layer Security – bezpieczeństwo warstwy transportowej; Protokół kryptograficzny szyfrujący ruch telemetryczny i wymuszający wzajemne uwierzytelnianie certyfikatami (mTLS).
RODO – Rozporządzenie o Ochronie Danych Osobowych – unijne rozporządzenie o ochronie danych; Akt prawny nakazujący anonimizację lub pseudonimizację danych osobowych (w tym publicznych adresów IP) w etykietach i logach.

52/55 Podsumowanie wykładu 2 (cz. 1)
Zapowiedź wykładu 3: Grafana - wizualizacja metryk, dashboardy, panele, zmienne, alarmy; PromQL w praktyce na dashboardach.

Pierwsza połowa w pigułce: budżet jako waluta, Prometheus jako architektura i słownik do odświeżenia.

  • Przegląd fundamentów teoretycznych – student przyswoił rozróżnienie wskaźnika SLI, wewnętrznego celu SLO oraz prawnego kontraktu biznesowego SLA.
  • Praktyka pomiarów inżynierskich – metodyki USE i RED stanowią niezawodny przewodnik po doborze metryk dla zasobów sprzętowych i usług aplikacyjnych.
  • Opanowanie stosu Prometheus – zrozumienie modelu pull, formatu eksporterów oraz architektury bazy TSDB pozwala na budowę stabilnego monitoringu.
  • Podstawy języka PromQL – umiejętność filtracji etykiet, operacji wektorowych i wyliczania pochodnych umożliwia rzetelną ocenę zachowania systemów.
  • Przejście od teorii do praktyki – wiedza zdobyta w wykładzie stanowi bezpośrednie przygotowanie do budowy zaawansowanych dashboardów w Grafanie.
Thanos: Stos do skalowania Prometheusa w wymiarze rozproszonym (długoterminowe przechowywanie, globalne zapytania) obok podziału na szardy.
podsumowanie

Część 1 wykładu 2 w skrócie: Error Budget (operacyjna waluta), Prometheus + TSDB (storage engine deep dive) i Eksportery (ekosystem). Każdy punkt jest rozwijalny do pełnego wyjaśnienia i służy do szybkiego recall przed egzaminem, rozmowy kwalifikacyjnej, code review (czy ten alert ma sens?) i decyzji architektonicznych (Thanos czy Mimir?).

Error Budget - Operational Currency: 1 - SLO = budżet błędu (np. SLO 99.9% → 0.1% = 43 min/miesiąc). BURN RATE = tempo spływania (multi-window: fast burn 2%/1h = page, slow burn 10%/6h = ticket). MULTI-WINDOW ALERTING (Google SRE Workbook) = eliminacja fałszywych alarmów na spike'ach. polityka zamrożenia wdrożeń (Release Freeze): budget ≈ 0 → freeze deployments (automatycznie lub procesowo). BUSINESS ALIGNMENT: error budget = język wspólny dev (velocity) i ops (stability) - dev "kupuje" deploy za budżet, ops "strzeże" budżetu. OPERACYJNA WALUTA: mierzalna, obiektywna, egzekwowalna. To serce SRE.

Prometheus i TSDB - Storage Engine Deep Dive: PULL MODEL (server scrapes targets - kontrola, discovery, firewall friendly). SCRAPE (co 1 min default, per-job override, service discovery). Architektura bazy TSDB: Head Block (RAM, ~2h, mutable) + Compacted Blocks (dysk, immutable, ~2h windows) + WAL (Write Ahead Log - crash recovery via replay). RETENTION: czasowa (15d default) lub rozmiarowa (50GB) - first limit wins. REMOTE WRITE: long-term storage (Thanos/Cortex/Mimir/S3) - Prometheus = hot storage (15d), remote = cold (years). FEDERATION/THANOS: sharding (podział targetów), HA (2+ identyczne serwery), global query (Thanos Query). STORAGE ENGINE = fundament wydajności, kosztów, niezawodności.

Eksporterzy i Metryki - Exporter Ecosystem: NODE_EXPORTER (OS: CPU, RAM, dysk, sieć, systemd - uniwersalny, na każdej maszynie). BLACKBOX_EXPORTER (synthetic: HTTP/TCP/DNS/ICMP - external perspective, zero code change). JMX_EXPORTER (JVM: GC, threads, memory pools, Tomcat/Kafka/Cassandra beans - Java standard). CLIENT LIBS (App: Go `promhttp.Handler()`, Python `prometheus_client`, Rust, Node.js, .NET - native instrumentation = richest context). SNMP_EXPORTER (Network: router/switch/firewall via SNMP OIDs - legacy support critical). EKSPORTER = ADAPTER: natywny format (JMX, SNMP, SQL, /proc) → Prometheus exposition format (`/metrics`). ECOSYSTEM = 100+ gotowych eksporterów, nie pisz własnego chyba że musisz.

Powtórzenie Terminów - Vocabulary Check (Must Know): SLI (Service Level Indicator - miara 0.0-1.0), SLO (Service Level Objective - cel na SLI), SLA (Service Level Agreement - kontrakt z karami), ERROR BUDGET (1-SLO, waluta operacyjna), BURN RATE (tempo spływania budżetu, multi-window), CARDINALITY (liczba unikalnych serii, high = OOM), HISTOGRAM (buckety + _sum + _count, agregowalne), QUANTILE (percentyl: p50/p95/p99), RECORDING RULE (pre-compute heavy query co 30s), ALERTING RULE (expr + for + labels + annotations → alert). TO SŁOWNIK SRE - bez tych terminów nie porozumiewasz się z zespołem.

Podsumujmy pierwszą część wykładu. Budżet błędu to operacyjna waluta SRE: odejmujemy od jedynki cel dostępności i dostajemy dopuszczalny odsetek błędów, a tempo jego zużywania - szybkie lub wolne - stanowi podstawę alertów. Prometheus to nie tylko baza danych, ale kompletna architektura: model odpytywania, baza szeregów czasowych z dziennikiem WAL i kompresją Gorilla, retencja danych i zdalne zapisywanie, a w skali rozproszonej - podział na szardy i stos Thanos. Ekosystem eksporterów pokrywa wszystkie warstwy: systemy, aplikacje, Java, sieć.

Na koniec warto odświeżyć słownik, bez którego nie porozumiecie się z zespołem: SLI, SLO i SLA to trzy różne pojęcia - miara, cel i umowa. Budżet błędu i tempo jego spalania decydują o wdrożeniach. Kardynalność mówi o liczbie szeregów czasowych i koszcie ich utrzymania. Histogram i kwantyl to narzędzia liczenia percentyli, a reguły nagrywające i ostrzegające - mechanizm zamiany metryk w alerty.

Wyjaśnienie skrótów użytych na slajdzie:
SRE – Site Reliability Engineering – inżynieria niezawodności systemów; Dyscyplina techniczna stawiająca na automatyzację, mierzalność i eliminację pracy żmudnej (toil).
SLI – Service Level Indicator – wskaźnik poziomu usług; Empiryczna miara jakości usługi stanowiąca ułamek dobrych zdarzeń.
SLO – Service Level Objective – cel poziomu usług; Wewnętrzny punkt odniesienia jakościowego chroniący budżet błędów.
TSDB – Time Series Database – baza danych szeregów czasowych; Wysokowydajny silnik przechowywania danych telemetrycznych w oparciu o znaczniki czasu.
PromQL – Prometheus Query Language – język zapytań Prometheus; Wielowymiarowy język operacji analitycznych na danych telemetrycznych.

53/55 Podsumowanie wykładu 2 (cz. 2)
Zapowiedź wykładu 3: Grafana - projektowanie dashboardów, zmienne, panele statystyczne, notatki (annotations), zmienne templatingowe.

Druga połowa w pigułce: koszty etykiet, dwie skrzynki, ogon rozkładu i nauka u źródeł.

  • Matematyka budżetu błędów – zrozumienie pojęcia Burn Rate pozwala na budowę systemów alarmowych reagujących na realne tempo utraty stabilności.
  • Projektowanie bezpiecznych wskaźników – zastąpienie średniej arytmetycznej percentylami chroni przed ukrywaniem problemów dotykających mniejszość klientów.
  • Higiena bazy szeregów czasowych – unikanie etykiet o wysokiej kardynalności zabezpiecza serwer monitoringu przed wyczerpaniem pamięci operacyjnej.
  • Zarządzanie alertami bez zmęczenia – powiadomienia alarmowe powinny wynikać bezpośrednio z zagrożenia celów SLO, a nie z drobnych anomalii sprzętowych.
  • Ciągłe doskonalenie obserwowalności – telemetria jest żywym organizmem wymagającym ciągłego dostosowywania progów do ewoluującej architektury.
Annotations (adnotacje): Notatki na dashboardach Grafany oznaczające zdarzenia (np. wdrożenia), ułatwiające korelację zmian z zachowaniem metryk.
słownik

Techniki instrumentacji i analizy w części 2 wykładu 2 to: Etykiety/Kardynalność (koszt i wydajność), White-box vs Black-box (strategia monitoringu), Percentyle (SLO targets) oraz materiały do samodzielnej nauki. To "Part 2 Cheat Sheet" o warstwie instrumentacji (jak poprawnie zebrać dane), a nie o teorii SLO.

Etykiety i Kardynalność - Label Discipline = Cost Control: LABEL NAMING: snake_case, angielskie, opisowe (`http_requests_total` nie `reqs`), spójne suffixy (`_total`, `_seconds`, `_bytes`). wartości ograniczonych (bounded values): `status_code` (~20), `method` (~10), `handler` (~100, znormalizowane), `job` (~50), `instance` (~1000). UNBOUNDED = DROP: `metric_relabel_configs: - action: labeldrop; regex: 'user_id|request_id|trace_id|ip|email'`. ochrona przed eksplozją kardynalności: high cardinality = OOM (Prometheus crash), wolne query (minuty), dysk rośnie wykładniczo. RELABELING (przed scrape) vs METRIC_RELABELING (przed zapisem do TSDB) - dwa miejsca na drop/transform. LABEL DISCIPLINE = COST CONTROL (RAM, dysk, CPU, remote write bandwidth).

White-box i Black-box - Complementary Monitoring Strategy: WHITE-BOX (INSTRUMENTACJA): Aplikacja eksponuje `/metrics` (client libraries) - szczegółowe, kontekstowe (per endpoint, per DB query, business KPIs), "DLACZEGO". Wymaga code change, ale daje richest context. BLACK-BOX (SYNTETYCZNE): `blackbox_exporter` moduły: `http` (status, latency, TLS cert, content match), `tcp` (connect time), `dns` (resolve time, rcode), `icmp` (ping) - "czy usługa działa poprawnie dla użytkownika". Zero code change, external perspective. COMPLEMENTARY: White-box = early warning (proaktywny, internal state), Black-box = SLA verification (reaktywny, user view). ALERTING NA OBU = DEFENSE IN DEPTH. Blackbox_exporter modules = standard toolkit dla synthetic monitoring.

Percentyle - Tail Latency Matters: p50/p95/p99/p99.9 - p50 (mediana) = typowy użytkownik (lecz ukrywa ogon opóźnień), p95 = standard SLA (95% użytkowników), p99 = TAIL LATENCY (1% najgorszych = krytyczne dla UX), p99.9 = EXTREME TAIL (0.1% = outlier detection). HISTOGRAM_QUANTILE (PromQL) = interpolacja liniowa między bucketami. P50 NIE WYSTARCZY (przykład: p50=100ms OK, ale p99=10s → 1% userów ma timeout). SLO NA P95/P99 (nie p50). wzrost opóźnień w ogonie rozkładu: w systemach rozproszonych tail latency amplifikuje się (fan-out → fan-in, retries, queueing) - p99 service = p99.9 dependency. Percentyle = JĘZYK SLO.

Materiały do Powtórki - Study Resources (Authoritative Sources): PROMQL CHEATSHEET (prometheus.io/docs/prometheus/latest/querying/cheatsheet/ - functions, operators, examples). SLI/SLO WORKBOOK (Google: sre.google/workbook/chapter-4/ - Service Level Objectives, error budget, burn rate). PROMETHEUS DOCS (prometheus.io/docs - configuration, PromQL, storage, federation, best practices). przykłady pulpitów nawigacyjnych Grafana (grafana.com/dashboards - tysiące gotowych dashboardów do importu/inspiracji). Materiały do nauki: te odnośniki to autorytatywne źródła (Google SRE, Prometheus Project, Grafana Labs) - nie blogi, nie StackOverflow. Ucz się od twórców technologii.

Druga część podsumowania dotyczy warsztatu instrumentacji. Dyscyplina etykiet i nazewnictwa to w praktyce kontrola kosztów: wartości etykiet trzymamy w skończonych zbiorach, nieograniczone identyfikatory zrzucamy jeszcze przed zapisem do bazy, a czytelne nazwy z sufiksami typu _total czy _seconds sprawiają, że zapytania pisze się intuicyjnie. Pamiętajmy też o dwóch komplementarnych strategiach: biała skrzynka mówi dlaczego, czarna skrzynka - czy usługa działa w oczach użytkownika, i alertujemy na obu.

Wracamy również do najważniejszej pułapki statystycznej. Mediana kryje ogon, dlatego cele SLO stawiamy na percentylach p95 i p99, a pamiętajmy, że w systemach rozproszonych opóźnienie ogonowe amplifikuje się z usługi na usługę. Do utrwalenia tych tematów podrzucamy autorytatywne materiały: ściągę PromQL, notes roboczy SRE od Google i dokumentację samego Prometheusa - warto uczyć się od twórców technologii, a nie z przypadkowych blogów.

Wyjaśnienie skrótów użytych na slajdzie:
RED – Rate, Errors, Duration – metoda RED (częstotliwość, błędy, czas trwania); Architektoniczny wzorzec instrumentacji usług żądanie-odpowiedź.
USE – Utilization, Saturation, Errors – metoda USE (utylizacja, nasycenie, błędy); Wzorzec diagnostyki zasobów sprzętowych pozwalający szybko wykryć wąskie gardła.
SNMP – Simple Network Management Protocol – prosty protokół zarządzania siecią; Standard zarządzania i telemetrii urządzeń sieciowych w oparciu o zapytania UDP.
OID – Object Identifier – identyfikator obiektu MIB; Numeryczny adres zmiennej w hierarchicznym drzewie informacji telemetrycznych.
MIB – Management Information Base – baza informacji zarządzania; Struktura danych opisująca dostępne metryki na urządzeniu sieciowym.

54/55 Materiały i literatura (metryki)
Źródła: prometheus.io/docs, sre.google, grafana.com/docs, docs.loki - oficjalna dokumentacja narzędzi monitoringu.

Ucz się u twórców, nie z losowych blogów: słownik, Workbook i oficjalne docsy. Zgłoś martwy link.

  • Oficjalna dokumentacja projektu – podręcznik Prometheus zawiera wyczerpujący opis składni języka PromQL, funkcji wektorowych i parametrów konfiguracyjnych.
  • Metodyka USE Brendana Gregga – kanoniczny artykuł twórcy metodyki szczegółowo omawia procedury badania utylizacji, saturacji i błędów zasobów.
  • Standard sygnałów OpenTelemetry – oficjalna specyfikacja definiuje nowoczesne standardy integracji metryk, logów i śledzenia rozproszonego.
  • Monografie inżynierii Google SRE – rozdziały poświęcone obserwowalności i alertingowi na bazie SLO wyjaśniają matematyczne podstawy dyscypliny.
  • Normy i regulacje prawne – standardy jakościowe ISO/IEC 25010 oraz wytyczne UODO wyznaczają formalne ramy prowadzenia bezpiecznej telemetrii.
Kuratorowane źródła: Zweryfikowana dokumentacja (prometheus.io, sre.google, grafana.com, docs.loki) zamiast przedawnionych blogów; słownik pojęć jako wspólny język kursu.
okładki i strony

Kuratowana biblioteka źródeł (Authoritative Reading List) zawiera zweryfikowane linki - działające, aktualne i autorytatywne - eliminując googlowanie, przestarzałe blogi i błędy ze StackOverflow. To "syllabus reading list" tego wykładu: pozwala uczyć się głęboko, nie powierzchownie.

Słownik Terminów - Glossary (Vocabulary Reference): Pełny glossary kluczowych pojęć: SLI (Service Level Indicator), SLO (Service Level Objective), SLA (Service Level Agreement), ERROR BUDGET (budżet błędu = 1-SLO), BURN RATE (tempo spływania budżetu), CARDINALITY (kardynalność = liczba unikalnych serii), QUANTILE (kwantyl/percentyl), HISTOGRAM (buckety + _sum + _count), SUMMARY (kwantyle client-side), GAUGE (miernik góra/dół), COUNTER (licznik monotoniczny), RECORDING RULE (pre-compute), ALERTING RULE (expr + for + labels + annotations). KAŻDE definicja, wzór (jeśli dotyczy), przykład PromQL, powiązane pojęcia. TO SŁOWNIK SRE - bez niego nie czytasz docsów, nie robisz code review, nie rozmawiasz z zespołem.

Artykuły o SLI/SLO - Authoritative Sources (Google SRE + Cloud): 1) podręcznik Google SRE Workbook Ch. 4 "Service Level Objectives" (sre.google/workbook/chapter-4/ - KANON: definicje, przykłady, error budget, burn rate, choosing SLOs, SLO vs SLA). 2) "SLOs vs SLAs vs SLIs" - Google Cloud Blog (cloud.google.com/blog - plain English explanation, diagrams, real examples). 3) "How to pick SLOs" - Google SRE (sre.google - methodology: user journey → SLI → SLO → error budget → alerting). 4) "Implementing SLOs" - Prometheus + Grafana (grafana.com/blog - practical: recording rules, alerting on SLI, dashboards). Te autorytatywne źródła – nie opinie, nie przypadkowe studia przypadków firm, nie marketingowe whitepaper. Ucz się od twórców modelu SRE.

Linki Zweryfikowane - Verified URLs (All Tested): PROMETHEUS DOCS: prometheus.io/docs (configuration, PromQL, storage, federation, best practices, client libraries, alerting rules, service discovery). GRAFANA DOCS: grafana.com/docs (data sources, panels, variables, annotations, provisioning, alerting, Loki, Tempo). SRE.GOOGLE/WORKBOOK: sre.google/workbook (table of contents: Ch1-How SRE Relates to DevOps, Ch2-Implementing SLOs, Ch3-SLO Engineering Case Studies, Ch4-Monitoring, Ch5-Alerting on SLOs). potok zbierania metryk w Kubernetes: kubernetes.io/docs/tasks/debug/debug-cluster/resource-metrics-pipeline/ (metrics-server, kube-state-metrics, Prometheus Adapter, HPA/VPA). ALL URLs TESTED (działają 2024, HTTPS, nie 404, nie redirect loops). Jeśli link nie działa - zgłoś prowadzącemu, zaktualizujemy. To living document.

Do samodzielnej nauki przygotowaliśmy kuratorowaną listę źródeł - zweryfikowaną, aktualną i autorytatywną, żeby nie tracić czasu na przedawnione blogi i przypadkowe porady. Na pierwszym miejscu słownik kluczowych pojęć: od SLI, przez budżet błędu i tempo jego spalania, po typy metryk i reguły Prometheusa. To wspólny język całego kursu, bez którego trudno czytać dokumentację i współpracować w zespole. Uczyni z niego zakładkę, nie jednorazową lekturę.

Głównym materiałem merytorycznym jest notes roboczy SRE od Google - zwłaszcza rozdział czwarty poświęcony celom SLO - oraz wpisy z bloga Google Cloud traktujące prostym językiem o różnicach między SLI, SLO i SLA. Uczenie się od twórców modelu to gwarancja, że zdobyte wzorce naprawdę odpowiadają praktyce. Wszystkie linki działają i prowadzą na oficjalne domeny; gdyby któryś przestał odpowiadać, zgłoście to prowadzącemu, a zaktualizujemy listę.

Wyjaśnienie skrótów użytych na slajdzie:
IETF – Internet Engineering Task Force – Grupa Robocza Inżynierii Internetowej; Międzynarodowa społeczność inżynierów tworząca standardy protokołów internetowych RFC.
RFC – Request for Comments – dokument standaryzacyjny RFC; Seria oficjalnych memorandów technicznych definiujących protokoły i formaty danych w Internecie.
CNCF – Cloud Native Computing Foundation – Fundacja Oprogramowania Chmurowego; Organizacja promująca otwarte technologie chmurowe i zarządzająca rozwojem Prometheusa.
ISO – International Organization for Standardization – Międzynarodowa Organizacja Normalizacyjna; Globalna federacja norm technicznych.
PKN – Polski Komitet Normalizacyjny – krajowa jednostka normalizacyjna; Instytucja wprowadzająca europejskie i międzynarodowe normy techniczne (PN-EN) do polskiego porządku prawnego.

55/55 Zapowiedź wykładu 3
Zapowiedź wykładu 3: Grafana - projektowanie dashboardów, zmienne, panele statystyczne, notatki (annotations), zmienne templatingowe.

Wykład 3 to praktyka: pulpity, zaawansowany PromQL, zmienne i dashboardy z repo. Przyjdź przygotowany.

  • Wizualizacja danych telemetrycznych – kolejny wykład poświęcony jest w całości platformie Grafana i technikom budowy czytelnych dashboardów operacyjnych.
  • Konstrukcja paneli dynamicznych – student pozna sposoby parametryzacji zapytań za pomocą zmiennych szablonowych i dynamicznych filtrów etykiet.
  • Zarządzanie dashboardami jako kodem – techniki eksportu i automatycznego provisioningu pulpitów nawigacyjnych w repozytorium kodu Git.
  • Grafana Alerting i powiadomienia – konfiguracja reguł alarmowych z poziomu interfejsu graficznego i integracja z popularnymi komunikatorami.
  • Wymagania wstępne do laboratorium – sprawne środowisko z działającym serwerem Prometheus i eksporterem Node Exporter przygotowane w ramach pracy własnej.
Checklista przed wykładem: Uruchomione środowisko testowe i opanowane pierwsze zapytanie PromQL jako warunek efektywnej pracy na zajęciach praktycznych.
zapowiedź

Wykład 3 (Grafana + PromQL Deep Dive) jest hands-on: budowanie dashboardów, zaawansowane PromQL, variables/annotations i dashboard-as-code. Checklista "co musisz umieć przed zajęciami" to pre-flight check - bez przygotowania nie ma w trakcie laboratoriów czasu na stawianie podstaw.

Przygotowanie do Wykładu 3 - Knowledge Prerequisites: 1) SLI/SLO/SLA W PRAKTYCE: umiesz zdefiniować SLI (availability = good/total, latency = histogram_quantile), obliczyć SLO (threshold), error budget (1-SLO), burn rate (multi-window). 2) INSTALACJA I KONFIGURACJA PROMETHEUS: umiesz napisać `prometheus.yml` (global, scrape_configs: static_configs, file_sd, kubernetes_sd, relabel_configs), zrozumieć `scrape_interval`, `evaluation_interval`, `rule_files`, `remote_write`. 3) zbieranie metryk systemowych: `node_exporter` (uruchomienie, weryfikacja `/metrics`, dodanie targetu), kluczowe metryki: `node_cpu_seconds_total`, `node_memory_MemAvailable_bytes`, `node_filesystem_avail_bytes`, `node_network_receive_bytes_total`. 4) POWTÓRKA OBSERVABILITY (Wykład 1): 3 filary (Metrics, Logs, Traces), RED/USE methods, SLI/SLO hierarchy, error budget, observability vs monitoring. To FUNDAMENT - bez tego Grafana labs = "klikam, nie wiem co robię".

Potrzebne Umiejętności z Wykładu 1 - CLI & Scripting Foundation: BASH: `uptime` (load avg), `free -h` (RAM), `df -h` (dysk), `systemctl status/start/stop/restart/enable/disable` (usługi), `journalctl -u service -f` (logi), `ip a/route/link`, `ss -tulpn`, `ping`, `curl`, `tar`, `wget`, `chmod +x`, `./script.sh`. PYTHON 3: skrypty (requests, json, yaml, subprocess, argparse, logging), virtualenv/venv, pip install. CRON: `crontab -e`, składnia (min godz dzień miesiąc dzień_tyg), logging (`>> /var/log/script.log 2>&1`). Wstęp do RouterOS oraz Cisco IOS: automatyzacja konfiguracji (Netwatch, Scheduler, SNMP config). Wszystkie polecenia zweryfikowane na serwerze testowym = SAFE TO REPEAT (identyczny output). To ELIMINUJE "u mnie nie działa".

Środowisko Testowe - Sandbox Ready: Warto przygotować przed zajęciami: VM (VirtualBox/VMware: Ubuntu 22.04/24.04, 2 vCPU, 4GB RAM, 20GB dysk) LUB LXC (Proxmox) LUB Docker (docker-compose: prometheus + node_exporter + grafana + loki + tempo). Przykładowy plik docker-compose w repozytorium kursu pozwala uruchomić gotowy stos narzędzi za pomocą polecenia `docker-compose up -d` w dwie minuty. Podręczniki Google SRE oraz oficjalna dokumentacja projektu Prometheus stanowią lekturę zalecaną (w szczególności rozdział 4 „SRE Workbook” oraz samouczek „Getting Started”). Wszystkie polecenia CLI zostały przetestowane, dzięki czemu student nie traci czasu na rozwiązywanie problemów środowiskowych, skupiając się na zrozumieniu fundamentalnych koncepcji inżynierii niezawodności.

Kontakt / Pytania - Support Channel: Prowadzący dostępny: Slack (kanał #sre-course), e-mail (prowadzacy@uczelnia.pl), office hours (poniedziałek 14-16, sala 205). kanał wzajemnego wsparcia grupy seminaryjnej: #sre-course-peers (studenci pomagają studentom - najlepsze uczenie). NEXT: HANDS-ON PROMETHEUS + SLI/SLO WORKSHOP (wykład 3: 4h labs: dashboard-as-code, PromQL advanced, variables, annotations, alerting rules, Grafana provisioning). Przyjdźcie przygotowani - zaczynamy od `prometheus.yml` code review.

Wykład trzeci będzie praktyczny: zbudujemy pulpity w Grafanie, zgłębimy zaawansowany PromQL, osadzimy zmienne i adnotacje oraz wdrożymy pulpity z repozytorium. Dobre pulpity odpowiadają na pytanie o stan usługi w kilka sekund - dlatego położymy nacisk na czytelność, progi i układ, a nie na napychanie paneli. Zanim jednak zaczniemy, upewnijmy się, że każdy ma uruchomione środowisko testowe i że ufamy pierwszemu zapytaniu PromQL.

Przed zajęciami warto wykonać checklistę: praktyczne rozumienie SLI, SLO i budżetu błędu z przykładami zapytań; sprawna instalacja Prometheusa i node_exportera oraz umiejętność dodania celu; a także powtórka z wykładu pierwszego - trzy filary obserwowalności i metody RED oraz USE. Znajomość PromQL, nawet podstawowa, pozwoli Wam w pełni wykorzystać laboratoria. Przygotowanie gwarantuje, że zajęcia spędzimy na praktyce, a nie na stawianiu fundamentów od zera.

Wyjaśnienie skrótów użytych na slajdzie:
PromQL – Prometheus Query Language – język zapytań Prometheus; Zaawansowane zapytania analityczne stanowiące rdzeń dynamicznych pulpitów w Grafanie.
GUI – Graphical User Interface – graficzny interfejs użytkownika; Środowisko wizualizacji telemetrycznej omawiane szczegółowo na wykładzie 3.
TSDB – Time Series Database – baza danych szeregów czasowych; Podstawowe źródło danych dla platformy Grafana w ekosystemie Cloud Native.
API – Application Programming Interface – interfejs programowania aplikacji; Kanał integracji pomiędzy serwerem wizualizacji a bazami telemetrycznymi.
SDK – Software Development Kit – pakiet programistyczny; Zestaw narzędzi pozwalający na automatyzację tworzenia pulpitów w modelu Dashboard-as-Code.